

Hyperskalare och AI-fokuserade infrastrukturoperatörer utvecklar i allt högre grad proprietära AI-acceleratorer och XPU:er för att hålla jämna steg med stora språkmodeller och komplexa resonemangsarbetsbelastningar. För att hantera de fysiska, minnes- och nätverksutmaningarna med att driftsätta proprietär kisel i stor skala har NVIDIA detaljerat sin NVLink Fusion-interconnect och NVHBM-anpassade base-die-minnesarkitektur . Den enhetliga portföljen är utformad för att överbrygga anpassad kisel med NVIDIAs befintliga skalbara nätverks- och MGX-rackskalaplattformar.
Den första deltagaren är Amazons Annapurna Labs, vars NVHBM-planer dök upp tillsammans med AWS-partnerskapets expansion med 2 miljoner GPU:er . Detta tillkännagivande tillhandahåller arkitekturen bakom detta samarbete och utser Trainium4 till den första Trainium-generationen med stöd för NVLink Fusion. NVIDIA etablerar också en standard NVHBM-implementering som är tillgänglig från flera minnesleverantörer, vilket minskar den tekniska ansträngningen att integrera och kvalificera minne mellan leverantörer. "NVHBM representerar en ny arkitektonisk metod för att förbättra prestanda och effektivitet för högbandbreddsminnen", säger Nafea Bshara, vice vd för Annapurna Labs på Amazon. "Vi ser fram emot att detta tekniksamarbete kommer att gynna framtida AWS-infrastrukturdesigner."
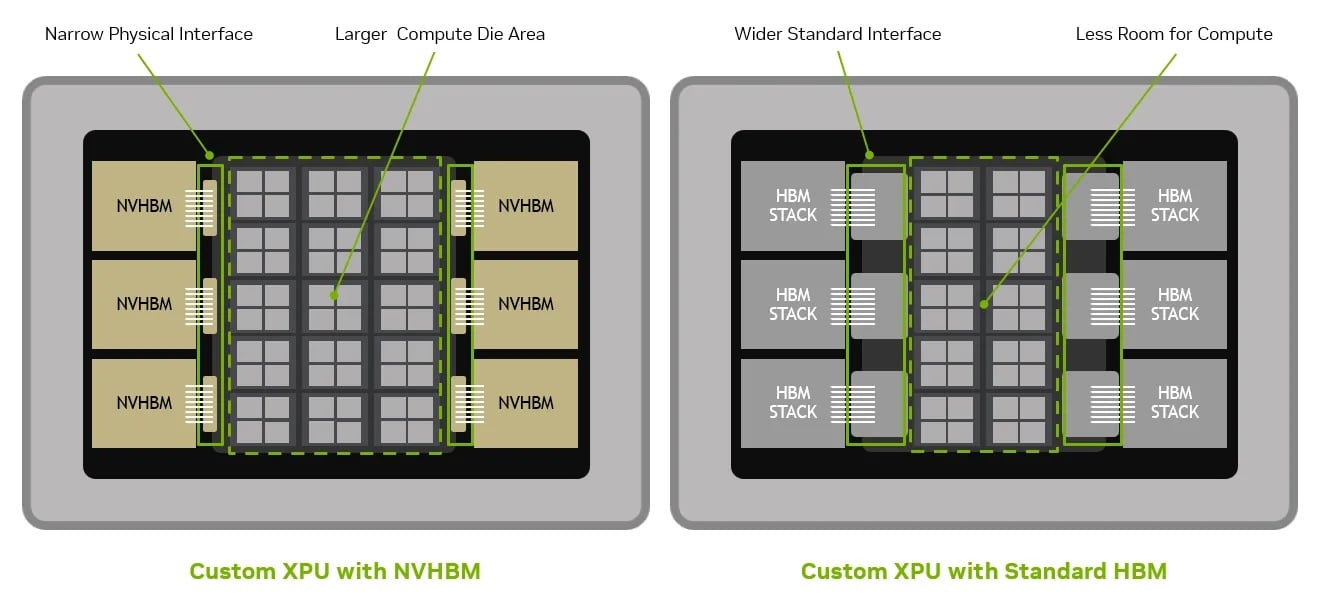
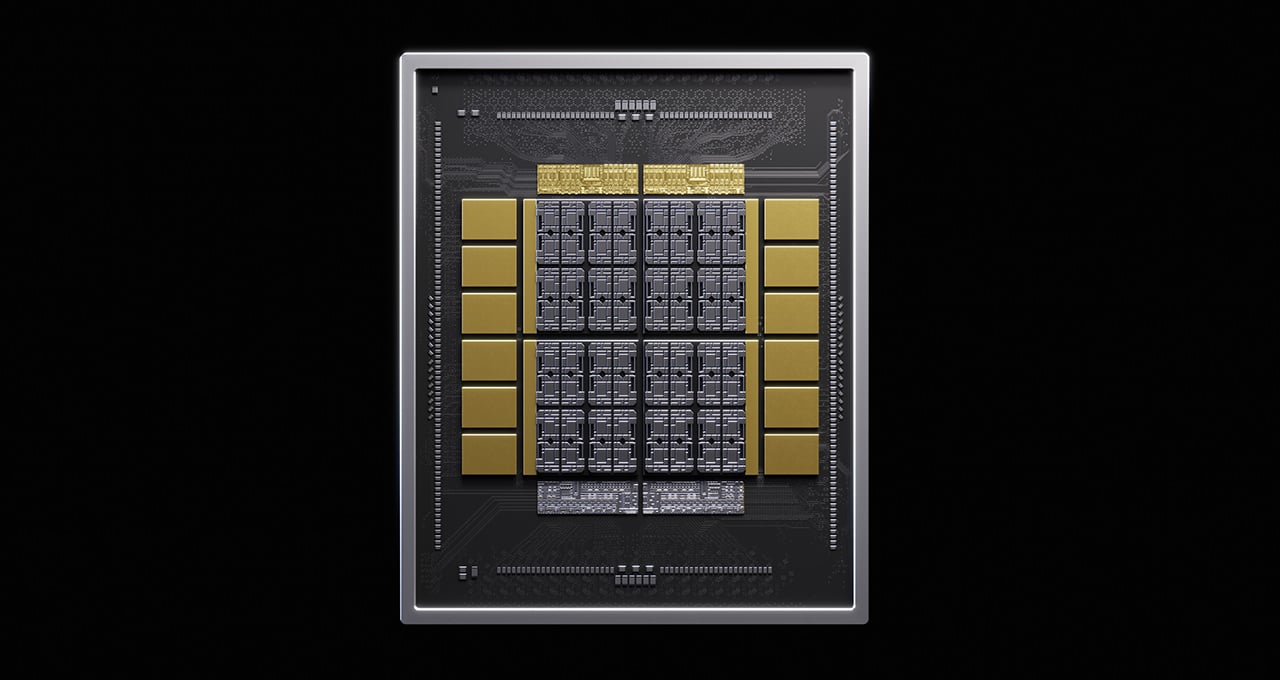
Att distribuera anpassade XPU:er i datacenter med hög densitet kräver balans mellan beräkningslogik, strömfördelning, termisk overhead och minne med hög bandbredd. Integrering och kvalificering av avancerade minnesstackar skapar ofta betydande flaskhalsar i paketering och utveckling. Genom NVLink Fusion och NVHBM kan designers utnyttja förvaliderade baschips och gränssnitts-IP, vilket minskar integrationskomplexiteten och snabbar upp time-to-market.
Minnesbandbredd och latensoptimering
Moderna AI-arbetsbelastningar, särskilt stora modellinferenser och agentiska pipelines, ställer stora krav på minnesgenomströmning för att läsa modellvikter, aktiveringar och nyckelvärdes-cacheposter (KV). NVHBM tillhandahåller en anpassad basbricka som utvecklats i samarbete med minnestillverkare, vilket ger upp till 30 procent högre minnesbandbredd per stack jämfört med standardspecifikationen för JEDEC HBM4E.
| Leverans | NVHBM-förmån |
| Bandbredd | Upp till 30 % mer minnesbandbredd jämfört med standard HBM4e |
| Area | Effektivare gränssnittsanslutningar möjliggör upp till 25 % mer beräkningsyta för ytterligare XPU-funktioner |
| Effekt | Upp till 15 % lägre HBM-strömförbrukning jämfört med standard HBM4e ger besparingar för tusentals XPU:er |
Tabell 1. NVHBM ger tre huvudsakliga fördelar på plattformsnivå till AI-acceleratorprogram: högre minnesbandbredd, mer paket- och kiselyta och lägre HBM-strömförbrukning.
Denna bandbreddsökning minimerar utbrändhet av beräkningsmotorer under minnesbundna faser av exekveringen. Genom att accelerera dataöverföringar mellan HBM-stackarna och den inbyggda beräkningslogiken kan acceleratorer upprätthålla högre utnyttjandegrad och förbättra genereringshastigheterna för tokens per användare under täta inferensarbetsbelastningar.
Omfördelning av kretsarean och PHY-optimering
Kiselutrymmet på moderna acceleratorpaket är strikt begränsat, vilket kräver att konstruktörer balanserar utrymmet mellan beräknings-ALU:er, matrismotorer, inbyggt SRAM och perifera gränssnitt. Standard HBM-arkitekturer kräver breda fysiska gränssnitt som förbrukar betydande layoutyta.
NVHBM åtgärdar detta genom att flytta minneskontrollern direkt in i 3D HBM-stacken och använda ett anpassat fysiskt lager (PHY). Denna metod ger upp till 67 procents minskning av PHY och perifert stödområde jämfört med vanliga HBM4E-implementeringar, samtidigt som den förenklar mellanliggande spårningsrouting för att återvinna upp till 80 procent mer användbar kisel över hela layouten. Det smalare minnesgränssnittet frigör paketutrymme, vilket gör det möjligt för konstruktörer att utöka den centrala AI-beräkningskretsen med upp till 30 procent för att lägga till fler matriskärnor, vektorenheter eller cachehierarki inom ett fast fysiskt kuvert.
Energieffektivitet och utrymme i anläggningsskala
Strömfördelning är fortfarande en av de snävaste begränsningarna i storskaliga datacenter, vilket direkt påverkar acceleratorns termiska design och kylkrav. NVHBM minskar HBM:s strömförbrukning med 15 procent jämfört med standard HBM4E.
På kiselnivå sänker reducerad minneseffekt det termiska trycket, vilket ger ytterligare elektriskt utrymme för att driva datorkärnor vid högre, ihållande frekvenser. I anläggningsskala mångdubblas dessa energibesparingar avsevärt. I ett teoretiskt datacenter på 1 gigawatt med 2 000 watts XPU:er kan den reducerade minneseffektprofilen frigöra tillräckligt med termisk och elektrisk kapacitet för att stödja upp till 15 000 ytterligare XPU:er.
Rackskalig integration via NVLink Fusion
Medan NVHBM optimerar prestanda på individuell paketnivå, fungerar NVLink Fusion som brygga på systemnivå. Genom att använda dedikerade NVLink Fusion-chiplets kan anpassade XPU:er anslutas direkt till sjätte generationens NVLink-skalningsstruktur , vilket förenar alla acceleratorer i ett rack till en enda sammanhängande minnes- och beräkningsdomän.
Denna uppskalningsstruktur är avgörande för avancerade parallelliseringsscheman som expertparallellism (EP) och WideEP, där distribuerade expertmixmodeller kräver synkronisering med låg latens av aktiveringar och dolda tillstånd över flera fysiska enheter. Anpassade processorer kan också länkas till värdprocessorer via NVLink-C2C.
Genom att integrera semi-anpassad kisel i NVIDIAs bredare ekosystem för hårdvara och mjukvara gör NVLink Fusion det möjligt för operatörer att distribuera heterogena miljöer som blandar anpassade XPU:er med vanliga NVIDIA GPU:er under en standardiserad MGX-rackarkitektur, vilket förenklar drift och arbetsbelastningsprovisionering.


 Amazon