

VAST Data har utökat sitt samarbete med AMD kring AI-infrastruktur för molnleverantörer och företag som distribuerar utbildning, inferens, hämtningsförstärkt generering och agentiska AI-tjänster. Initiativet kombinerar VAST AI-operativsystemet med 6:e generationens AMD EPYC-processorer , AMD Instinct GPU:er, AMD-nätverkshårdvara och ROCm-programvara.
Samarbetet återspeglar ett bredare infrastrukturskifte från utbildningsfokuserade AI-kluster till miljöer som också måste stödja persistent kontext, hög samtidighetsinferens och multi-turn agent-arbetsflöden. Dessa implementeringar lägger ökad vikt vid dataflytt, KV-cachehantering, GPU-utnyttjande och möjligheten att leverera låg latensåtkomst till stora modell- och kontextdatauppsättningar.
VAST positionerar sin Disaggregated Shared Everything- arkitektur, eller DASE, som det delade datalagret för dessa miljöer. Plattformen kombinerar fil- och objektlagring, databaser, händelseströmning och datatjänster under ett enhetligt globalt namnområde. Den tillhandahåller också funktioner för flera hyresgäster och arbetsbelastningsisolering för AI-moln som driver samtidiga kund- och applikationsarbetsbelastningar.
EPYC 9006-plattformar för VAST CBox- och EBox-system
VAST har valt sjätte generationens AMD EPYC-processorer, tidigare kodnamnet Venice, för sina nästa generations CBox- och EBox-plattformar. Företaget planerar att använda processorerna i sina sjätte generationens CBox- och tredje generationens EBox-system, vilka ligger till grund för VAST AI-operativsystem.
Stöd för AMD EPYC 9006 introducerar PCIe Gen6-anslutning till VAST-hårdvaruplattformen. VAST uppger att det nya gränssnittet fördubblar generations I/O-bandbredden, vilket förbättrar fil- och objektlagringshastigheten samtidigt som det minskar latensen för datatjänster som databaser, datalager och händelseströmmande arbetsbelastningar som levereras via VAST DataBase och DataEngine.
För AI-infrastruktur kan högre I/O-bandbredd bidra till att minska flaskhalsar mellan beräknings-, nätverks- och NVMe-lagringsresurser. Detta är särskilt relevant för modellinläsning, hämtningspipelines, åtkomst till kontrollpunkter och externaliserade KV-cache-arbetsflöden där GPU-minneskapaciteten ensam är otillräcklig för att behålla aktiv kontext.
Referensarkitektur kombinerar Helios, VAST och DriveNets
VAST, AMD och DriveNets utvecklar också en referensarkitektur för AI-infrastruktur byggd kring AMD Helios rackskaliga AI-infrastruktur, VAST AI-operativsystemet och DriveNets AI Fabric-nätverk.

Referensarkitekturen är avsedd att ge distributionsvägledning för modellträning, inferens, förstärkningsinlärning och KV-cache-arbetsbelastningar. Den inkluderar storleks- och tillgänglighetsöverväganden för organisationer som bygger AI-fabriker som kräver delad datainfrastruktur och högpresterande nätverk tillsammans med GPU-beräkning.
VAST nämnde även utökat samarbete med leverantörerna av inferensprogramvara TensorMesh och EmbeddedLLM. Ekosystemarbetet fokuserar på produktionsinferensarkitekturer för agentiska AI-applikationer, även om specifika produktintegrationer och tillgänglighetsdetaljer inte offentliggjordes.
KV-cacheavlastning riktar sig mot hög samtidighetsinferens
En central del av tillkännagivandet är utökat stöd för KV-cache med hjälp av AMD Instinct GPU :er, AMD Infinity Context, ROCm-programvara och VAST AI-operativsystemet.
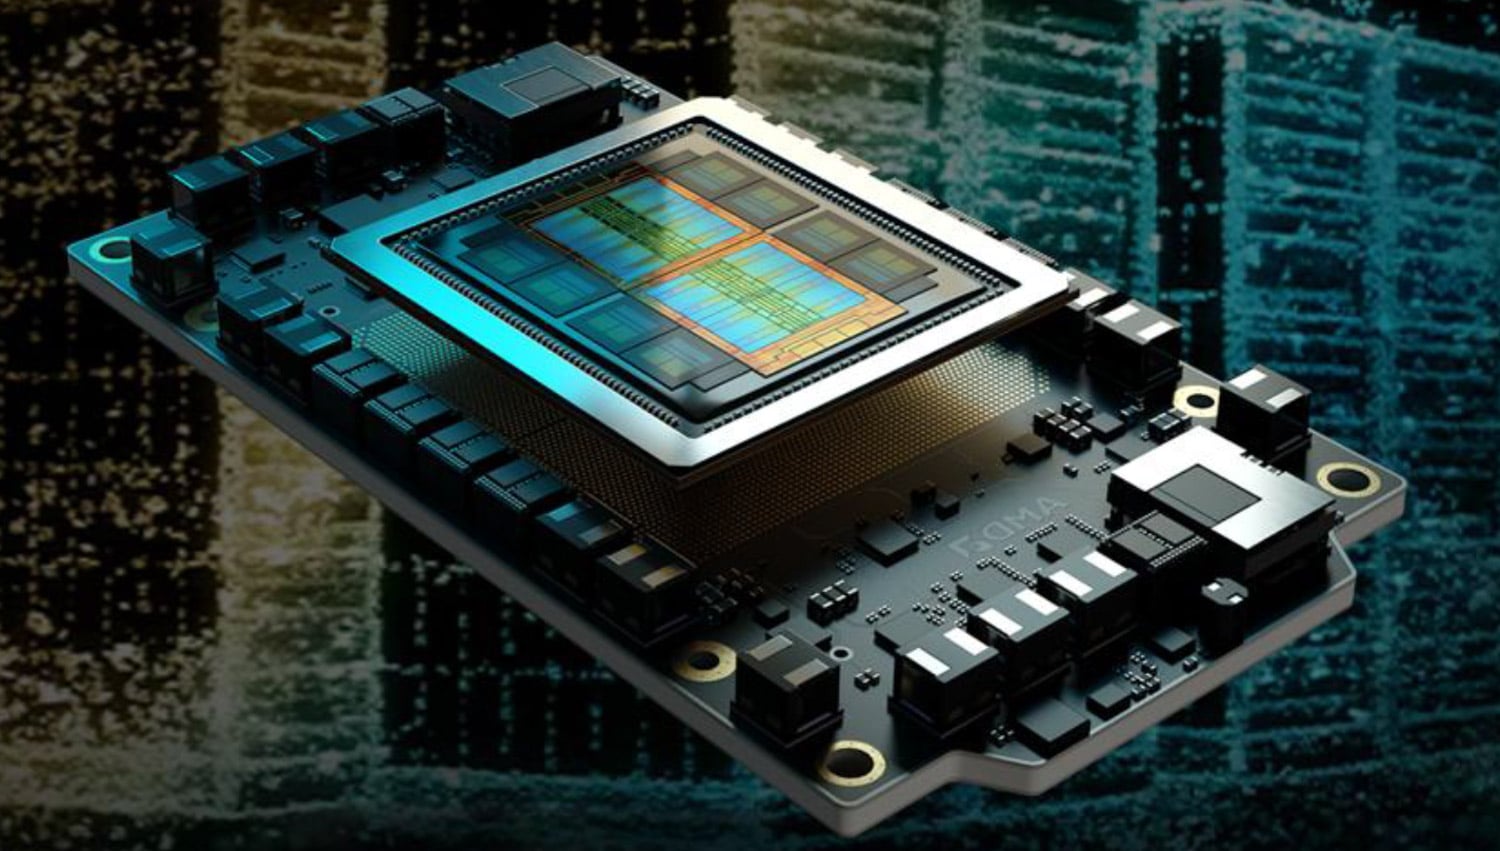
KV-cachedata lagrar mellanliggande uppmärksamhetsstatusinformation som genereras under inferens. Att behålla dessa data förbättrar prestandan för interaktioner över flera varv och arbetsbelastningar med lång kontext, men stora cache-utrymmen kan förbruka betydande GPU-minne. Att externalisera eller nivåindela KV-cache till en högpresterande lagringsplattform kan frigöra GPU-minne för aktiva arbetsbelastningar samtidigt som kontexten bibehålls för efterföljande inferensförfrågningar.
VAST rapporterade tidiga tester med en AMD Instinct MI355X GPU som visade en 9x förbättring i tid till första token och 9.7x högre token-genomströmning när VAST användes för KV-cache-avlastning i agentiska AI-arbetsbelastningar med hög samtidighet. Företaget noterade att dessa resultat beror på hårdvarans baslinje, arbetsbelastningens egenskaper och lagringskonfigurationen.
Integrationen tillämpar även VAST-livscykelpolicyer på KV-cachedata. Denna funktion är avsedd att automatiskt låta cachade information upphöra att gälla och radera den, vilket är relevant när inferenskontexten innehåller känsliga, personliga eller reglerade data.
Pensando Pollara 400 ansluter GPU:er till delad lagring
Arkitekturen använder AMD Pensando Pollara 400 AI NIC för att ansluta AMD Instinct GPU:er till VAST-lagringsklustret. Enligt VAST stöder NIC-kortet dataöverföring mellan GPU och lagring via NFS över TCP och RDMA, vilket möjliggör åtkomst till NVMe SSD-baserade VAST-kluster för KV-cache och bredare inferensdatakrav.
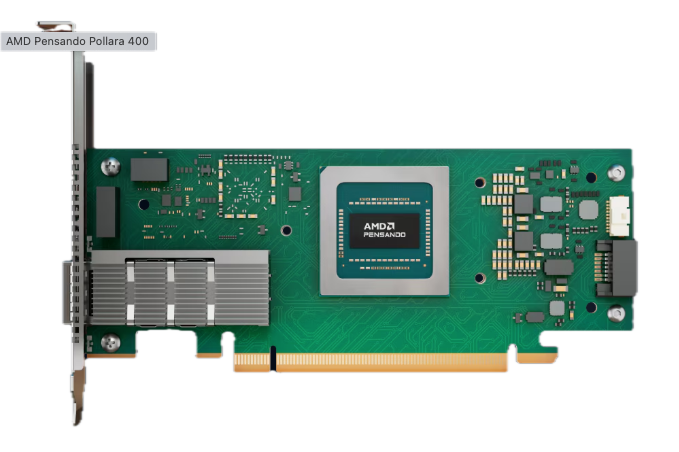
Den resulterande designen är avsedd att stödja AI-miljöer som behöver skala kontexthantering oberoende av GPU-minne. Istället för att behandla lagring som ett separat persistenslager positionerar VAST plattformen som ett data- och exekveringslager som kan hantera modeller, databaser, strömmande data, fildata och AI-kontext över distribuerad infrastruktur.
För AI-molnleverantörer syftar metoden till högre GPU-utnyttjande och förbättrad driftseffektivitet i takt med att implementeringar går bortom GPU-uthyrning och batchträning till persistent inferens och agentiska AI-tjänster.


 Amazon