

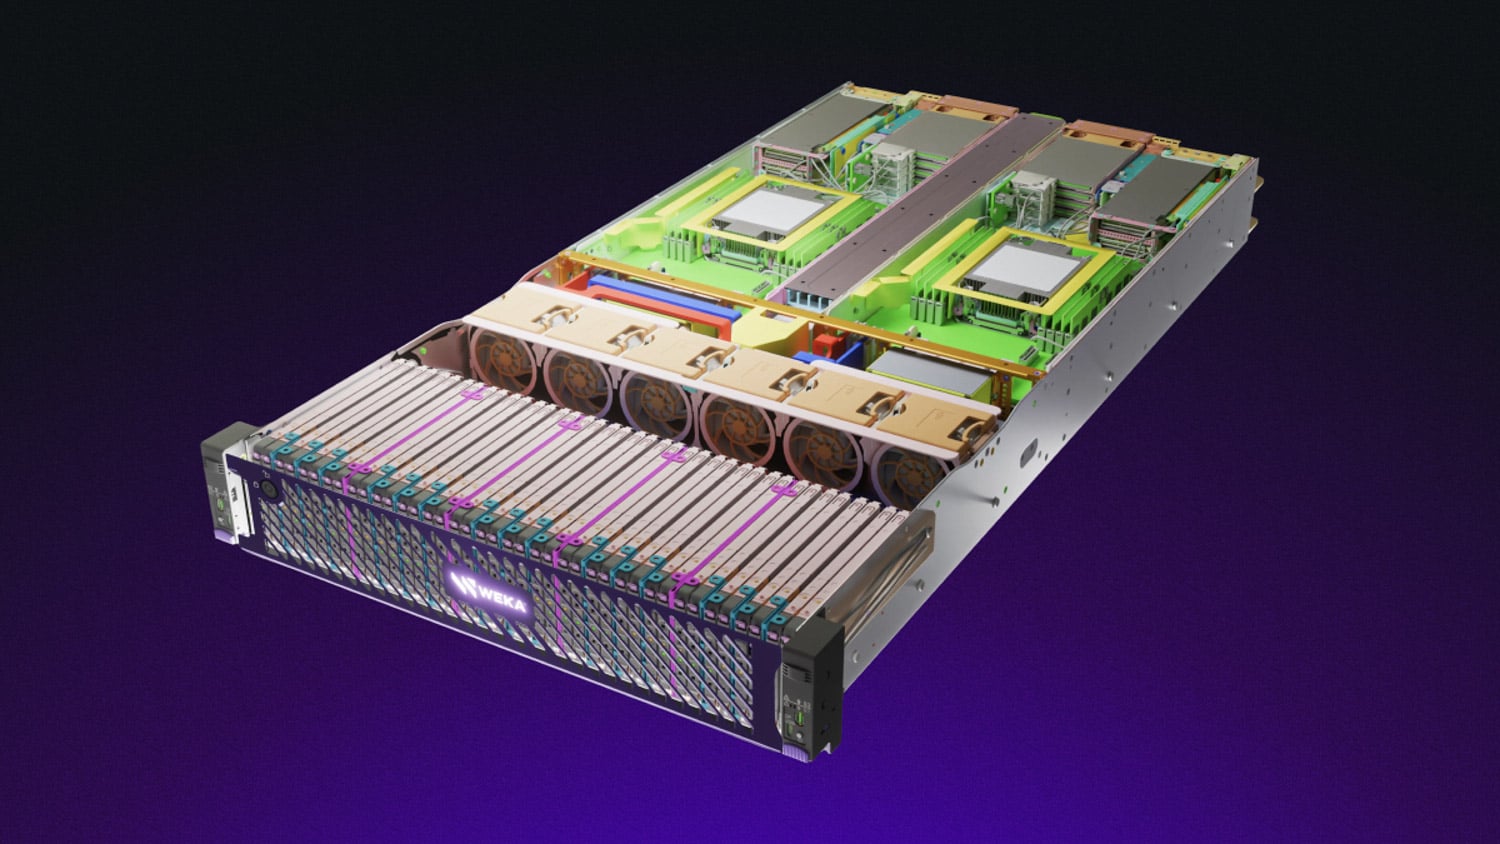
WEKA har lanserat två uppkopplade produkter: NeuralMesh 6, deras hittills mest betydande programvaruversion, och WEKApod 3, en ny generation lagringsenheter designade och konstruerade av WEKA för att köra den. NeuralMesh 6 kan fortfarande distribueras på kundvald hårdvara, medan WEKApod tillhandahåller den nyckelfärdiga lösningen och levereras med programvaran förinstallerad. NeuralMesh 6 introducerar native multi-tenancy, en kombinerad fil-och-objekt-protokollstack, metadatadriven datamobilitet, alltid-på-datareduktion med avtalsgarantier, Kubernetes-native operationer och integrerad observerbarhet. WEKApod 3 är specialdesignad hårdvara byggd för att köra denna programvara med vad företaget hävdar är den högsta kapaciteten och prestandatätheten som finns tillgänglig i ett enda rack, med tre konfigurationer, Nitro, Prime och Prime Max, inriktade på maximal prestanda, balanserad kapacitet respektive maximal densitet.
Båda tillkännagivandena ramar in lanseringen kring ett gemensamt marknadsskifte: i takt med att AI-arbetsbelastningar går från träning mot långkontextbaserad, agentbaserad och hämtningsdriven inferens i produktionsskala, är det lagrings- och minnesinfrastruktur, inte bara GPU-antalet, som i allt högre grad avgör kostnaden per token och uppnåelig dataflöde.
NeuralMesh 6: Multitenancy, enhetliga protokoll och datamobilitet
NeuralMesh 6 kombinerar funktioner som WEKA hävdar att AI-infrastrukturoperatörer traditionellt har behövt pussla ihop från olika leverantörer: multitenancy, en enhetlig protokollstack för filer och objekt, datamobilitet mellan webbplatser, kontinuerlig datareduktion, Kubernetes-nativ hantering och integrerad observerbarhet, allt integrerat i en enda programvarustack istället för att monteras från separata delar.
Multitenancy är uppdelat i två nivåer som kan kombineras. Composable Clusters ger isolering på hårdvarunivå, med dedikerad CPU, minne och lagringsenheter per hyresgäst, avsedd för ankarhyresgäster som behöver garanterade resurser och förutsägbar prestanda. Virtual Multi-Tenancy lägger till VPC-liknande nätverksisolering genom WEKAs Virtualized RDMA Data Fabric, som stöder privata VLAN, överlappande IP-adressutrymmen, servicekvalitet och kryptering per hyresgäst med oberoende nyckelhantering och oberoende LDAP- eller Active Directory-autentisering per hyresgäst. Virtual Multi-Tenancy skalar till mer än 1 000 isolerade logiska hyresgäster per kluster, med etablering av nya hyresgäster på under 30 minuter. De två nivåerna komponeras, så ett enda WEKA-hårdvarukluster som kör 50 Composable Clusters kan stödja upp till 50 000 logiskt isolerade hyresgäster på samma fysiska infrastruktur, vilket möjliggör tillväxt från dussintals till tiotusentals utan att omstrukturera systemet.
På protokollsidan implementerar NeuralMesh 6 en nativ S3-stack där samma fysiska datablock är adresserbara via S3 och POSIX samtidigt, snarare än via en gateway som översätter mellan dem. En fil som skrivs via NFS eller POSIX är omedelbart läsbar från S3, och vice versa, vilket eliminerar dubbla kopior av hela datamängden som vanligtvis ackumuleras när data flyttas mellan tränings-, finjusterings- och inferenssteg. WEKA byggde S3-implementeringen specifikt för AI-åtkomstmönster och stöder 2 000 till 5 000 samtidiga S3-anslutningar per nod, ungefär fem gånger samtidigheten jämfört med konventionella S3-arkitekturer, där S3 över RDMA möjliggör nollkopieringsöverföring direkt till GPU-minne.
Datamobilitet hanteras genom metadata-först-replikering, vilket gör en destinationsmiljö omedelbart bläddrbar snarare än att kräva en fullständig datakopia innan en arbetsbelastning kan starta. Data hydreras på begäran, vilket minskar WAN-trafik och gör det möjligt för organisationer att placera arbetsbelastningar där GPU-kapacitet finns snarare än där data ursprungligen skrevs. Den här versionen lägger till asynkron replikering och fjärrcachning som ett första steg mot en bredare federation och ett globalt namnområde över webbplatser och moln.
Den replikeringsförmågan ligger redan till grund för verkliga implementeringar: Sam Tabar, VD för WhiteFiber, sa att NeuralMeshs intelligenta replikering låter företaget synliggöra datamängder över olika webbplatser och hämta exakt den data som varje jobb behöver till nästa GPU-allokering, samma arkitektur som ligger bakom Project Redwood , det 111.2 Tbps superkluster över flera datacenter som vi behandlade tidigare denna månad.
Datareduktion upp till 6 gånger kapacitetsbesparingar
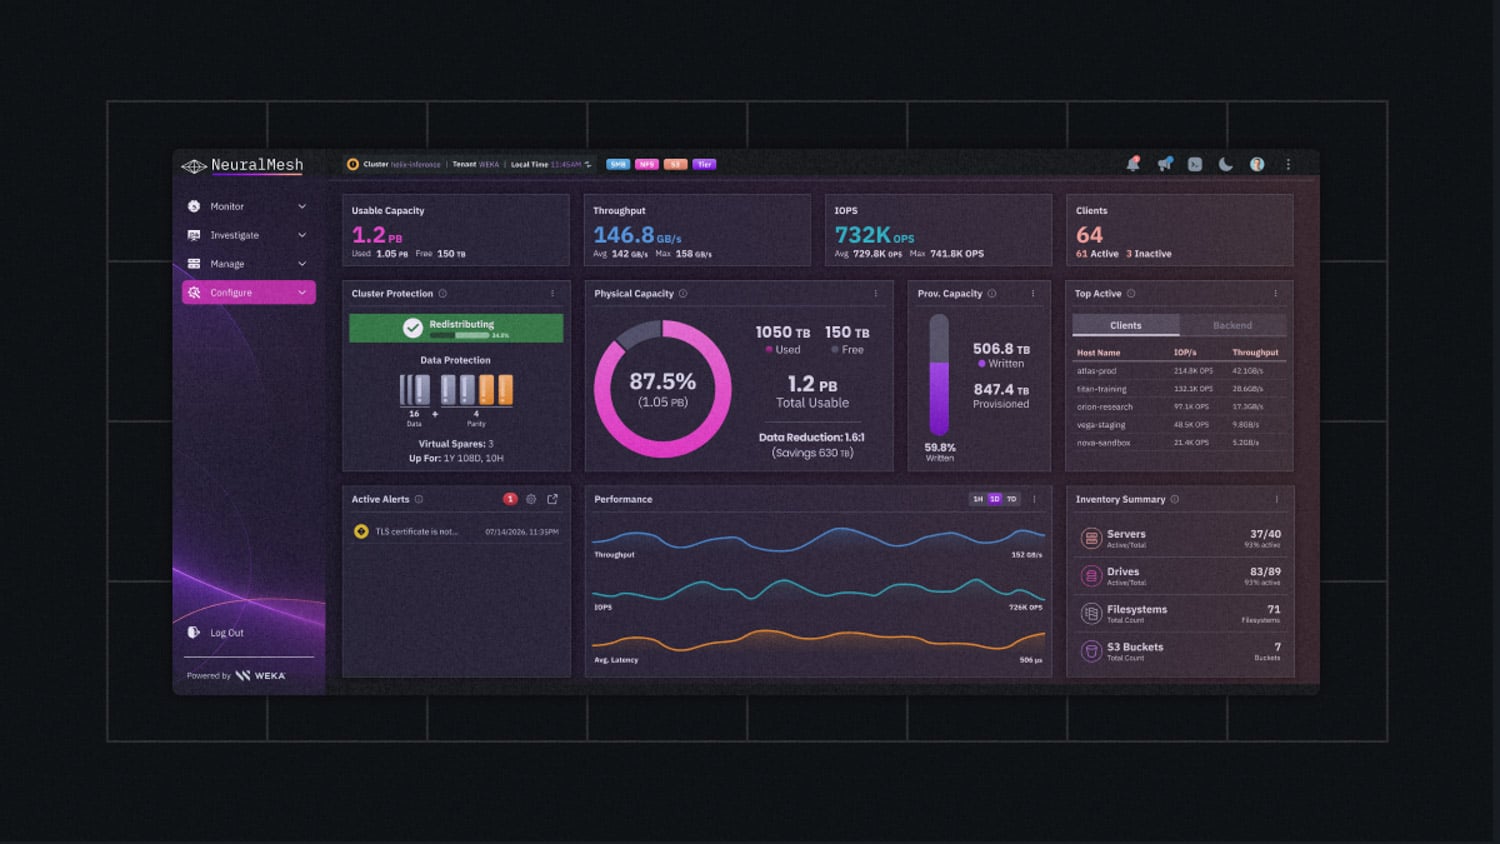
NeuralMesh 6 möjliggör även datareduktion, inklusive fingeravtryck, likhetshashning, deduplicering och komprimering, som standard i varje distribution, med en skrivkostnad under 5 %, upp till 6x kapacitetsbesparingar på AI-träningsdata och en avtalsenlig garanti som täcker både reduktionsförhållande och prestandapåverkan. En ny Kubernetes-operatör automatiserar klusterdistribution och livscykelhantering för organisationer som kör Kubernetes som standardmodell, vilket enligt WEKA minskar distributionstiden från veckor till timmar. NeuralMesh Observe, som ingår utan extra kostnad i varje distribution, tillhandahåller SaaS-baserade instrumentpaneler för flera kluster, diagnostik på klientnivå och aviseringar som dirigeras till Slack, PagerDuty eller e-post.
WEKA rapporterar att de använder sin Augmented Memory Grid- funktion i produktion, vilket utökar GPU-minnet genom att snabba upp åtkomst till persistent KV-cache till NeuralMesh-hanterad NVMe-lagring på Oracle Cloud Infrastructure. Jämförelser med OCI H100-infrastruktur visade 10 gånger högre token-genomströmning, 10 gånger fler samtidiga användare och 7 gånger fler tokens per GPU, vilket WEKA säger mäts mot DRAM-baserade alternativ. Pablo Selem, senior chef för mjukvaruutveckling på OCI, karakteriserade tillvägagångssättet som att det tar bort minnesflaskhalsar så att kunderna kan uppnå högre genomströmning och fler användare från samma GPU-fotavtryck.
WEKApod 3: Anpassad hårdvara byggd kring programvaran
WEKApod 3 är WEKAs egen hårdvarudesign snarare än en referensarkitektur byggd på tredjepartschassin från OEM. Företaget säger att ett enda WEKApod-rack levererar 1.1 exabyte effektiv kapacitet på en hårdvarubeläggning av 441.5 PB råkapacitet, vilket gör det till det första single-rack-systemet som överstiger en exabyte effektiv kapacitet. Dataflödet per rack är klassat till 10.2 TB/s med 210 miljoner IOPS. WEKA rapporterar 267 % högre effektiv kapacitetstäthet och 114 % högre dataflödestäthet per rackenhet än det näst bästa allmänt tillgängliga alternativet i varje kategori.
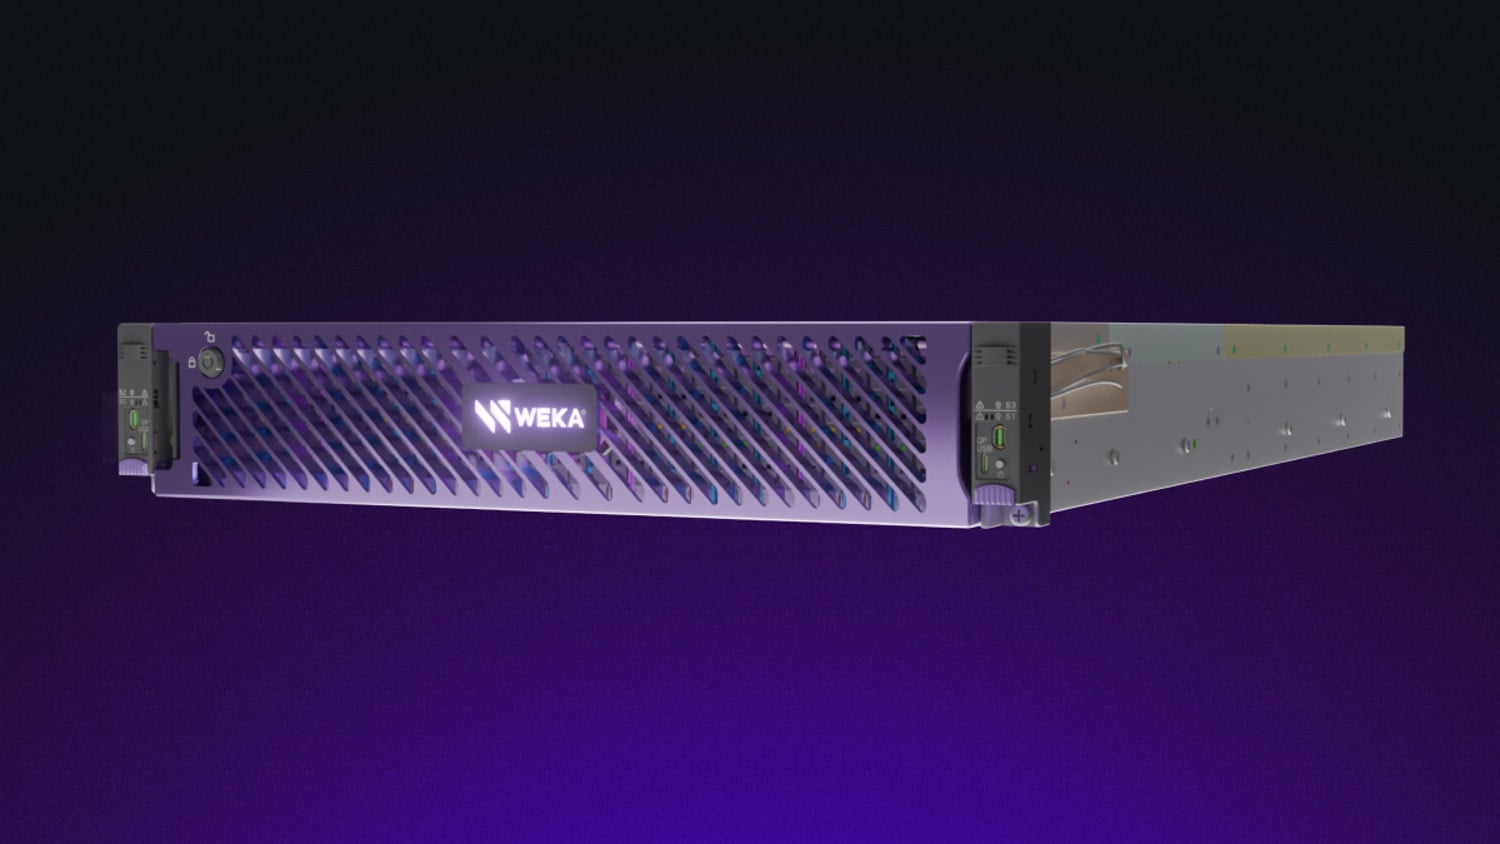
Designen bygger på en PCIe Gen 6 intern struktur, en kabelbaserad hårddiskanslutning snarare än ett bakplan, NVIDIA ConnectX SuperNIC- nätverk för Spectrum-X Ethernet-anslutning och en programvaruhanterad termisk arkitektur klassad för 35°C omgivningsdrift som stryper NVMe-ström under termisk stress istället för att stängas av. WEKA har flera patentansökningar inlämnade för chassit, hårddiskanslutning, termisk hantering och servicevänlighetsdesign. Servicevänlighetsfunktioner inkluderar hot-plug-bara startdiskar med en GUI-guidad utbytesprocess som WEKA säger tar cirka 10 minuter istället för ett flera timmar långt underhållsfönster, tillsammans med headless, molndriven rackskalig distribution via NeuralMesh Home.
Tre konfigurationer för olika arbetsbelastningsprioriteringar
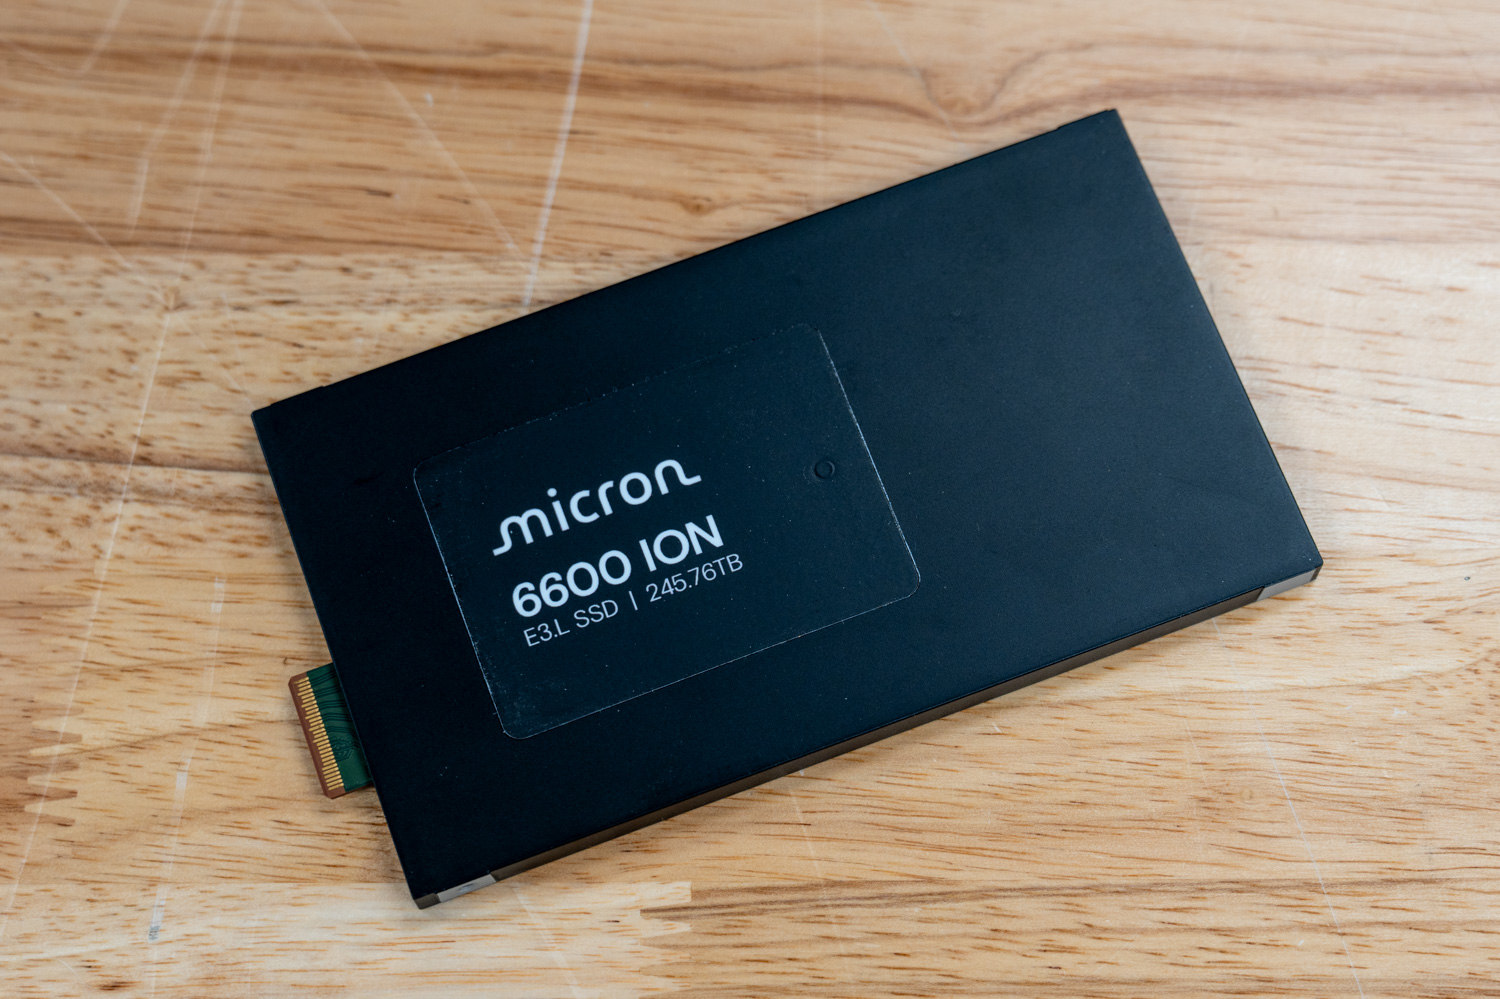
WEKApod Nitro är utformad för arbetsbelastningar där lagringsbandbredd är avgörande, vilket säkerställer att GPU:erna förblir mättade. Den har ett chassi med två rackenheter och fyra noder, fyra oberoende feldomäner och 56 TLC-enheter, som stöds av NVIDIA ConnectX-nätverk med dubbla portar som levererar 800 Gb/s dataflöde. WEKApod Prime betonar balanserad kapacitet och prestanda med en AlloyFlash-blandning av TLC- och QLC-enheter, inrymda i ett liknande chassi med fyra noder och två rackenheter som stöder 56 enheter. WEKApod Prime Max maximerar kapaciteten i en kompakt form: ett chassi med två rackenheter och två noder som innehåller 70 NVMe-enheter, med hjälp av Microns 245.76 TB 6600 ION SSD :er, kombinerat med NeuralMeshs objektlagrings- och datareduceringstekniker, för att uppnå en effektiv kapacitet på 1.1 exabyte i ett enda 56U-rack. För att få en uppfattning om vad den där enheten gör med rackmatematiken, räknar vår 6600 ION effekt- och densitetsrapport ut en exabyte i sex rack istället för 22.
AlloyFlash, nivåindelningsfunktionen som gör Prime- och Prime Max-konfigurationerna användbara, dirigerar automatiskt latenskänsliga operationer till TLC-flash samtidigt som bulkkapacitetsdata dirigeras till QLC, vilket är ungefär 30–40 % billigare per terabyte, utan att kunden behöver konfigurera det. Detta är den tydligaste punkten där programvaruversionen NeuralMesh 6 och hårdvaruversionen WEKApod 3 är en och samma produkt: programvarans nivåindelningslogik gör hårdvarukonfigurationerna med högre densitet användbara vid produktionsprestandanivåer, snarare än bara ett större kapacitetsnummer på ett specifikationsblad.
WEKA baserar sitt hårdvarubeslut på nuvarande begränsningar för datacenter: Byggandet av datacenter i USA lades ner 2025 för första gången sedan 2020, köer för nätanslutningar på större marknader tar nu fyra till sju år, och Morgan Stanley förutspår ett elunderskott på 49 gigawatt i USA fram till 2028. Detta utöver pågående problem med NAND-leveranser och längre ledtider för OEM. WEKA menar att lagring som är ineffektiv vad gäller rackutrymme och ström direkt konkurrerar med GPU:er om begränsade fysiska resurser. Genom att hantera sin egen hårdvaruleveranskedja snarare än att förlita sig på OEM-kanaler, tror man sig kunna erbjuda mer förutsägbar prissättning och ledtider för kunder som planerar storskaliga infrastrukturprojekt.
Jason Hardy, vice vd för lagringsteknik på NVIDIA, sa att Spectrum-X Ethernet-nätverk ger WEKApod 3 den högbandbreddiga och låglatensbaserade strukturen som behövs för att hålla datavägen mellan lagring och GPU tydlig i stor skala. Steve McDowell, chefsanalytiker på NAND Research, menade att inferens i produktionsskala är ett annat infrastrukturproblem än träning, där tokens per rack, tokens per watt och kostnad per inferens vid ihållande belastning blir de viktiga mätvärdena, ett poängkort som han säger att köpare bör utvärdera varje leverantör mot. Jeremy Werner, senior vice vd och general manager för Microns Core Data Center Business Unit, tillade att den nya WEKApod-arkitekturen med Microns 245 TB SSD-diskar levererar 15.8 petabyte i ett 2U-fotavtryck, vilket bevarar kraft och utrymme för ytterligare beräkning.
Tillgänglighet
NeuralMesh 6 förväntas bli allmänt tillgänglig under andra halvan av 2026. Nuvarande WEKA-kunder kan uppgradera utan extra kostnad via standardkanaler. WEKApod Nitro, Prime och Prime Max finns nu tillgängliga för beställning via WEKAs distributörs- och VAR-nätverk, med leveranser från hösten 2026 och NeuralMesh 6 förinstallerat. Dessutom erbjuds WEKApod nu i konfigurerbara SKU:er för första gången i denna generation, vilket gör det möjligt för kunder att välja chassityp, minne, hårddiskkapacitet och antal hårddiskar, och stödja system från under 1 PB upp till 100 PB eller mer i en enda installation.


 Amazon