

ASUS ExpertCenter Pro ET900N G3 är den andra GB300 DGX Station vi har testat och den första vi har haft praktisk erfarenhet av i labbet; vår MSI XpertStation WS300-testning kördes på distans. Den använder samma NVIDIA-kisel som vi testade i MSI XpertStation WS300: en Grace Blackwell Ultra Desktop Superchip med 72 Grace-kärnor, en B300 GPU, 252 GB HBM3e, 496 GB LPDDR5X och en ConnectX-8 SuperNIC med två 400GbE-portar. ASUS har paketerat den fixerade kärnplattformen i ett snyggt torn byggt för skrivbords-AI, och lagt till några detaljer som inte finns på WS300: två bärhandtag på toppen, en dedikerad fläkt riktad mot ConnectX-8 optikburarna och ett 1 600 W nätaggregat klassat 80 PLUS Titanium.
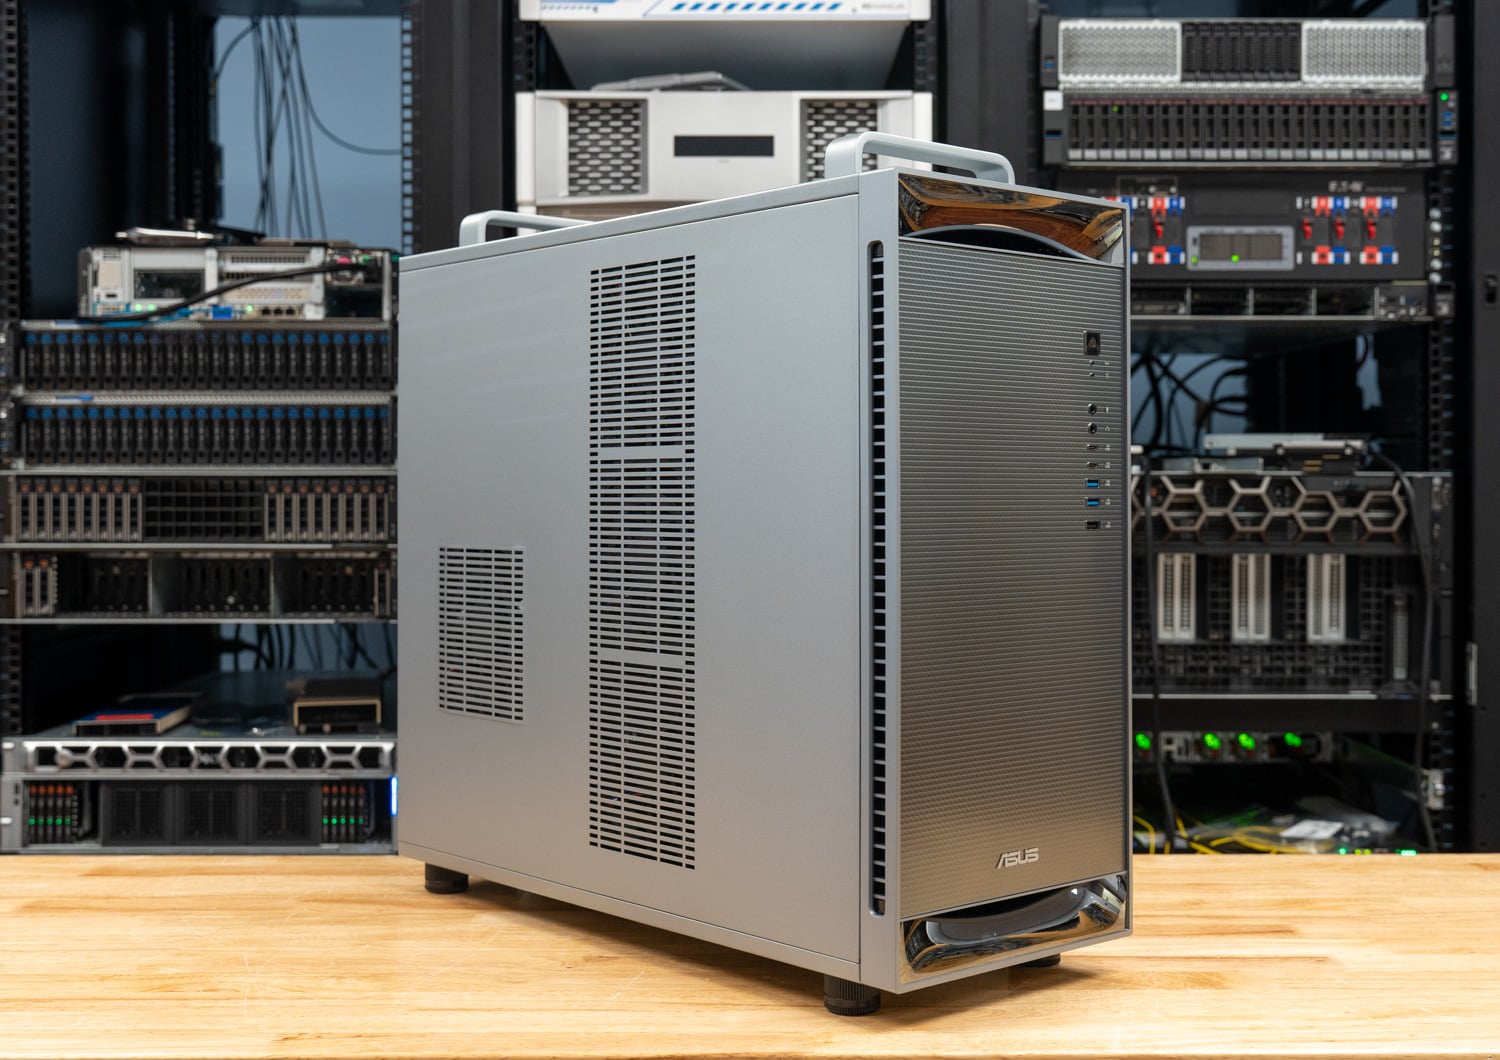
ASUS skickade ET900N G3 till labbet för ungefär en veckas benchmarking, fotografering och fysiska kontroller, med ett RTX PRO 2000 installerat. För själva plattformen, B300, Grace, NVLink-C2C, MIG och vad en DGX Station är till för, täcker WS300-recensionen den delen. Den här recensionen handlar om vad ASUS byggde kring Superchip, och om siffrorna håller måttet mot det första GB300-tornet vi testade.
ASUS ExpertCenter Pro ET900N G3 Specifikationer
| Specifikation | ASUS ExpertCenter Pro ET900N G3 |
|---|---|
| Plattformöversikt | |
| Superchip | NVIDIA GB300 Grace Blackwell Ultra stationär dator med superchip |
| CPU | NVIDIA Grace, 72 Arm Neoverse V2-kärnor |
| GPU | NVIDIA Blackwell Ultra (B300), upp till 20 PFLOPS NVFP4 med sparsity |
| CPU-GPU Interconnect | NVLink-C2C, 900 GB/s dubbelriktad |
| Minne | |
| Koherent minne | 748GB |
| GPU-minne | 252 GB HBM3e, 7.1 TB/s |
| CPU-minne | 496 GB LPDDR5X, 396 GB/s, 4x SOCAMM |
| lagring | |
| Starta enheter | 2x M.2 2280 PCIe 5.0 x4 (M-nyckel), utrustat med 2x 2 TB NVMe i RAID 1 |
| Expansionsenheter | 2x M.2 2280 (M-nyckel), PCIe 6.0 x4 per ASUS, öppna från fabriken |
| nätverk | |
| SuperNIC | NVIDIA ConnectX-8, 2x QSFP112 400GbE |
| ethernet | 1x Marvell 10 GbE 1x Realtek 1GbE (BMC) |
| Expansion | |
| PCIe-kortplatser | 1 x PCIe 5.0 x16 2x PCIe 5.0 x16 (x8 signaler) |
| Tilläggs-GPU | Upp till ett NVIDIA RTX PRO Blackwell-kort; testenheten levereras med ett RTX PRO 2000 Blackwell |
| I / O | |
| Front | 2x USB 10 Gbps typ-C 2x USB 10 Gbps typ-A 1x USB 2.0 Hörlurs- och mikrofonuttag |
| Bakre | 4x USB 10 Gbps typ-A 1x Micro-USB COM (BMC seriell konsol) 1x Mini DisplayPort (BMC) 3x ljuduttag |
| Management och säkerhet | |
| BMC | ASPEED AST2600 med AMI MegaRAC-firmware, IPMI och Redfish |
| Säkerhet | Inbyggd TPM 2.0 |
| Kraft och kylning | |
| Strömförsörjning | 1x 1 600 W ATX, 80 PLUS Titanium |
| Kylning | Sluten AIO-vätskekylning (enligt ASUS) med kylplattor på GB300, SOCAMM och ConnectX-8; främre och övre radiatorer, bakre chassifläkt, dedikerad fläkt över QSFP112-burarna |
| drifttemperatur | 10C till 35C |
| Programvara och formfaktor | |
| Operativ system | Ubuntu med NVIDIA AI-utvecklarverktyg; ASUS säger att Windows-baserat AI-utvecklingsstöd är planerat |
| Mått | 584 x 232 x 565 mm (23.0 x 9.1 x 22.3 tum), enligt ASUS anvisningar |
| Vikt | 27 kg netto, 32 kg brutto |
Design och bygga
ASUS klär ET900N G3 som en arbetsstation för företag, med ett chassi i borstad silver, en mörk meshfront, en kromad kåpa och fot, och ett ASUS-märke lågt placerat på framsidan. Proportionerna är vad plattformen dikterar: 584 x 232 x 565 mm enligt ASUS lista, vilket är lite högre och en aning smalare än WS300 med sina 529 mm höga, 570 mm djupa och 246 mm breda. Med en vikt på 27 kg är det inte ett system som man rör sig ledigt på, och det är där det första ASUS-specifika beslutet kommer in i bilden. Två metallhandtag på den övre kanten, ett framtill och ett baktill, låter två personer lyfta tornet på ett skrivbord eller i en vagn utan att behöva ta tag i panelerna. De ser lite malplacerade ut på en kontorsmaskin tills man har varit tvungen att bära ett GB300-torn över ett labb.
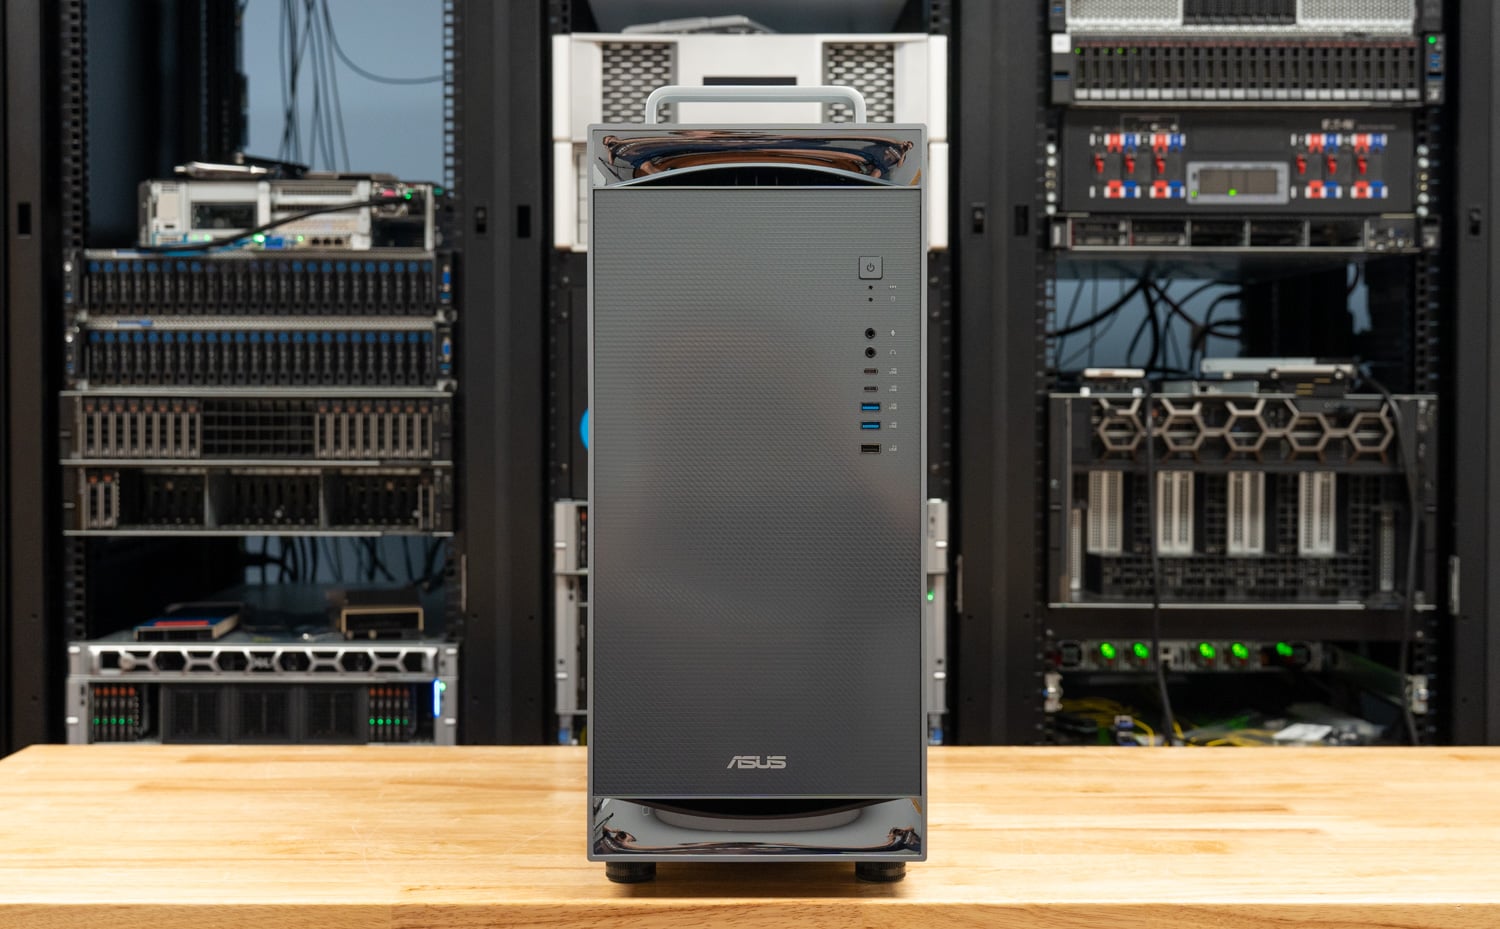
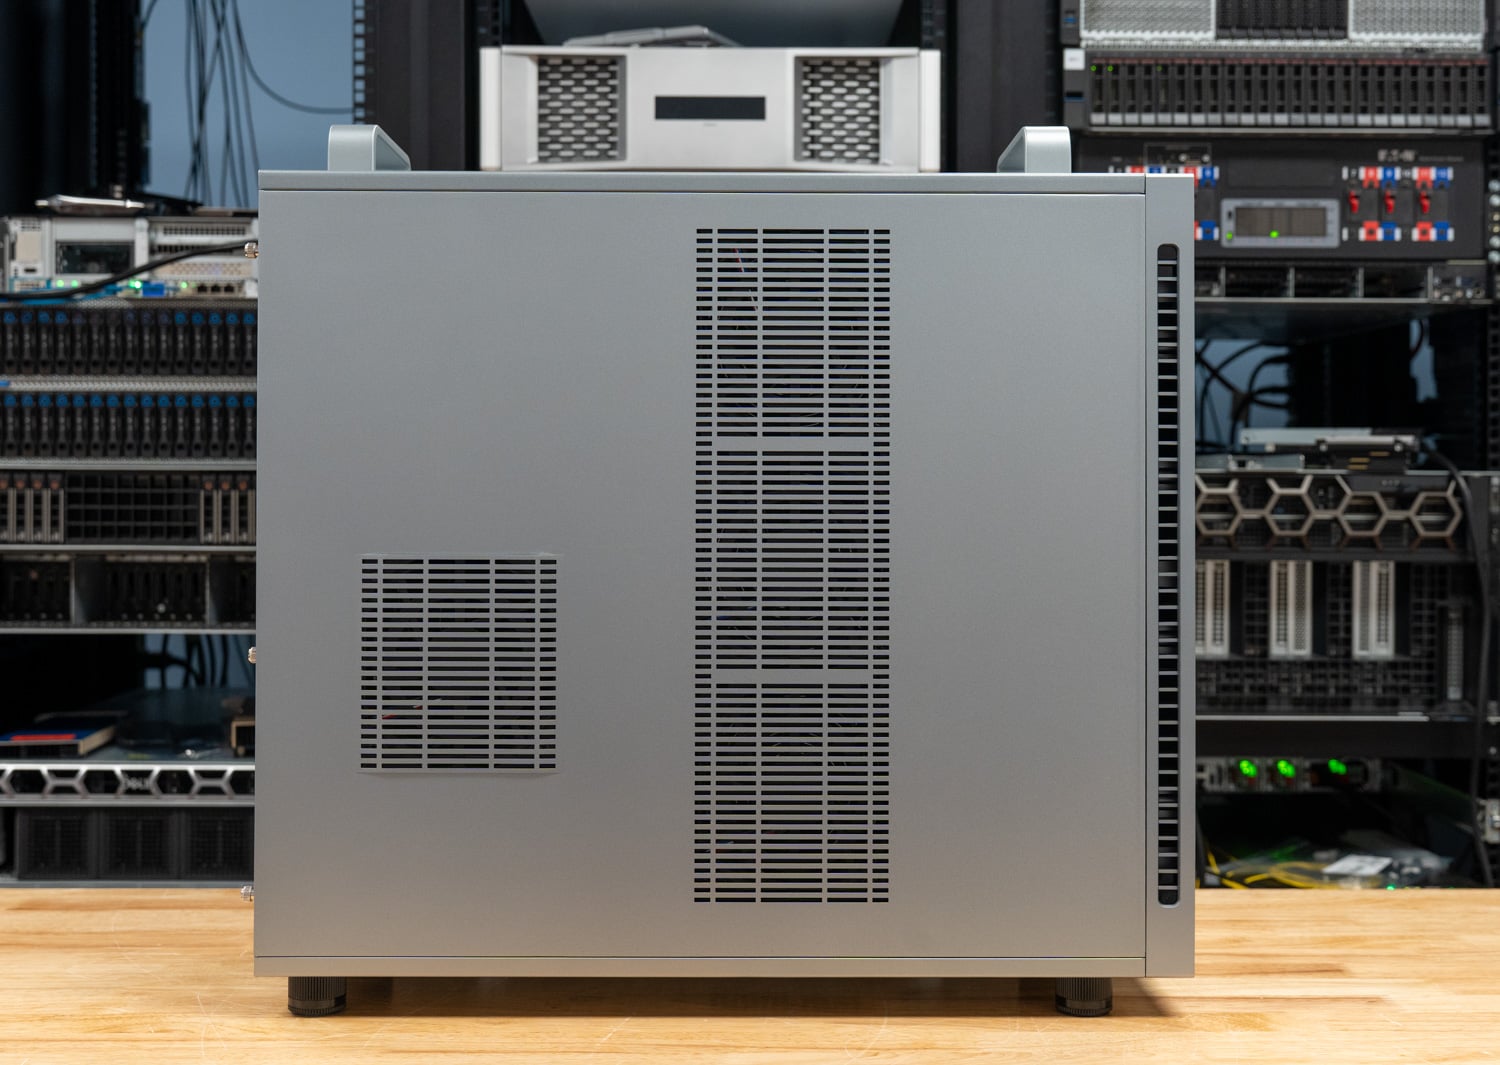
Frontpanelen har strömbrytaren, två 10 Gbps USB Type-A-portar, två 10 Gbps USB Type-C-portar, en USB 2.0-port och separata hörlurs- och mikrofonuttag, alla arrangerade i en vertikal remsa längst upp till höger på mesh-panelen. Sidopanelen är en stor ventilerad platta, med en lång perforerad kolumn framtill för kylarintaget och ett mindre fyrkantigt galler bakåt som är i linje med systemfläktarna. Det finns inget fönster och ingen belysning, vilket passar målgruppen.
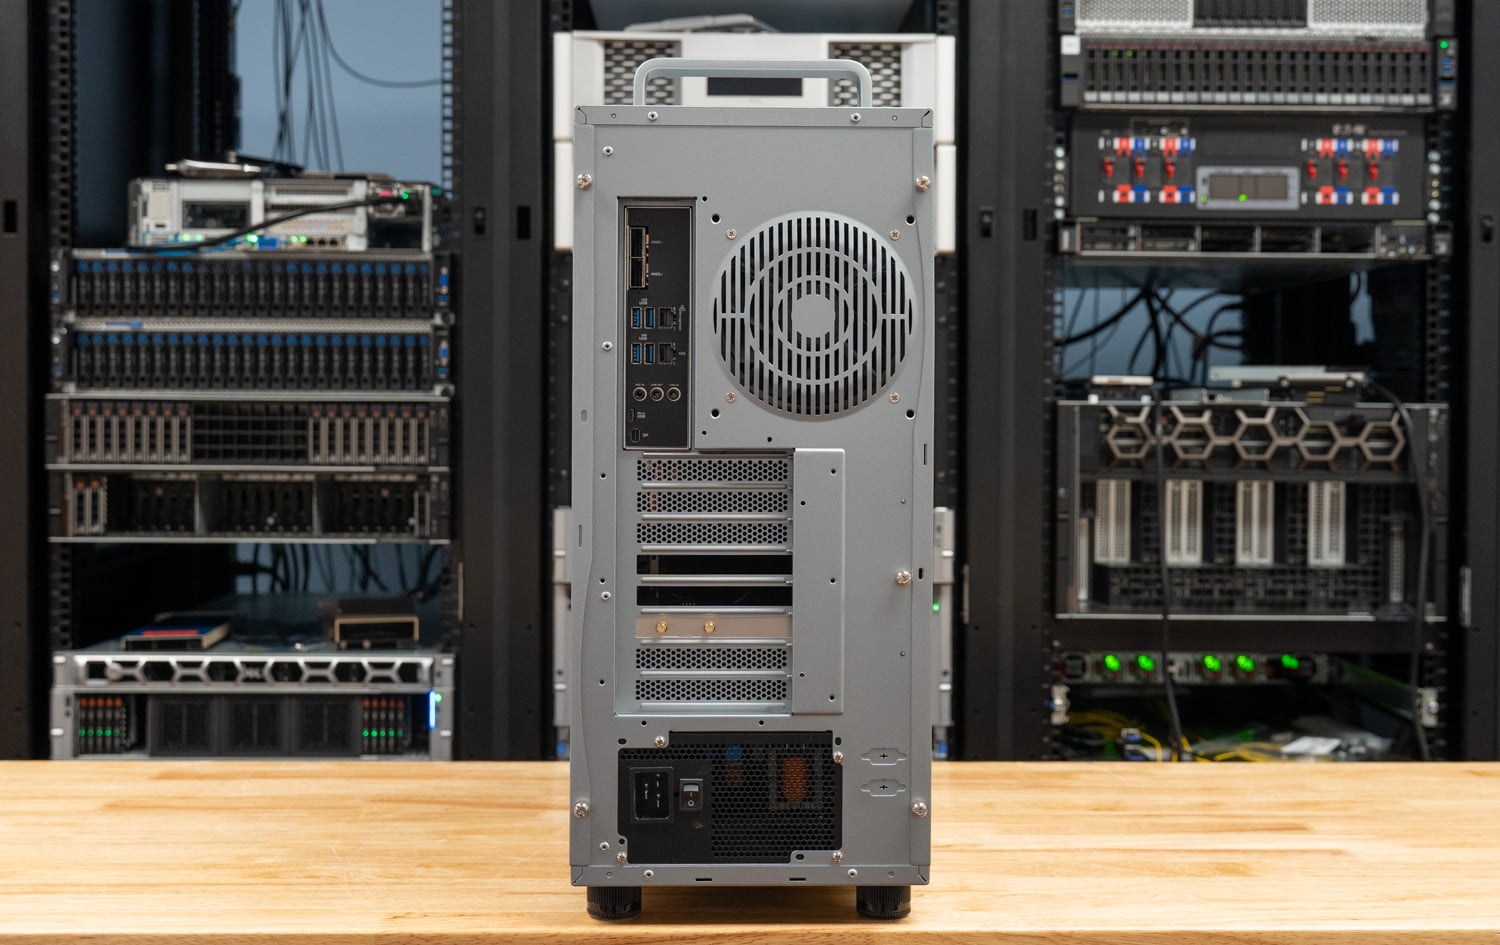
Runt baksidan separerar layouten arbetsstationens I/O från serverns hårdvara under. Det övre klustret innehåller de fyra 10 Gbps USB Type-A-portarna, 10 GbE- och 1 GbE RJ45-uttagen, de tre ljuduttagen, BMC:ns Micro-USB-konsolport och Mini DisplayPort som BMC:n driver för installation. De två QSFP112-burarna för ConnectX-8 sitter högst upp på I/O-skölden; en utsugsfläkt sitter bredvid dem; de tre expansionsplatskåporna löper längs mitten; och strömförsörjningen med sin C19-ingång sitter längst ner. Precis som på WS300 är Mini DisplayPort en BMC-utgång för initial installation och felsökning; alla som vill ha en stationär dator på den här maskinen behöver RTX PRO-kortet.
Inuti ET900N G3
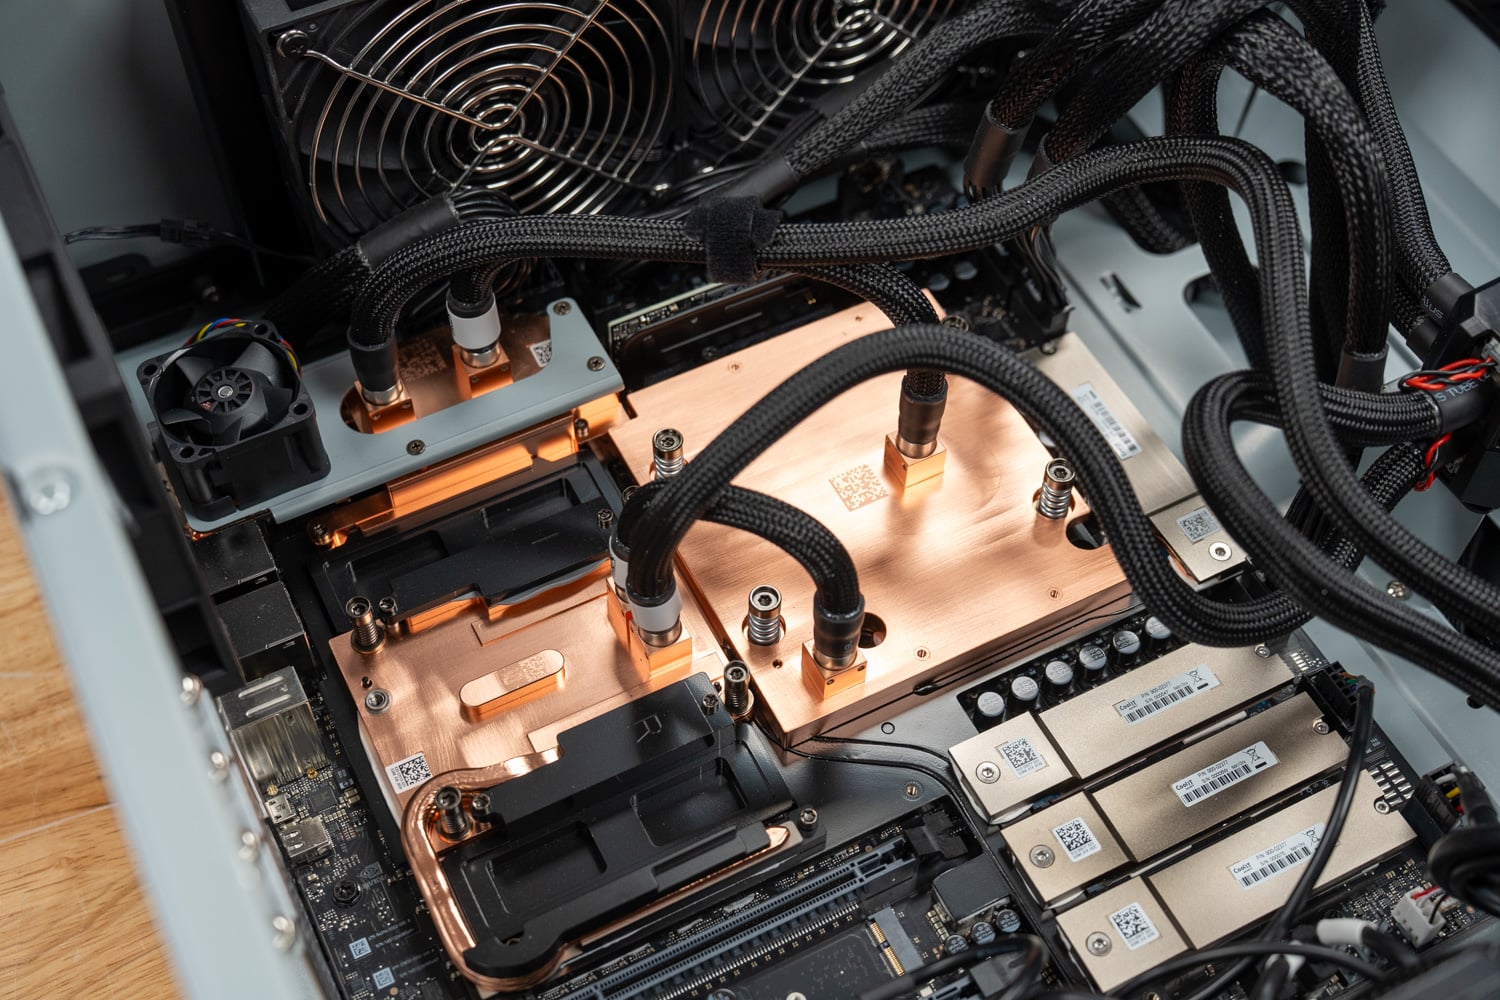
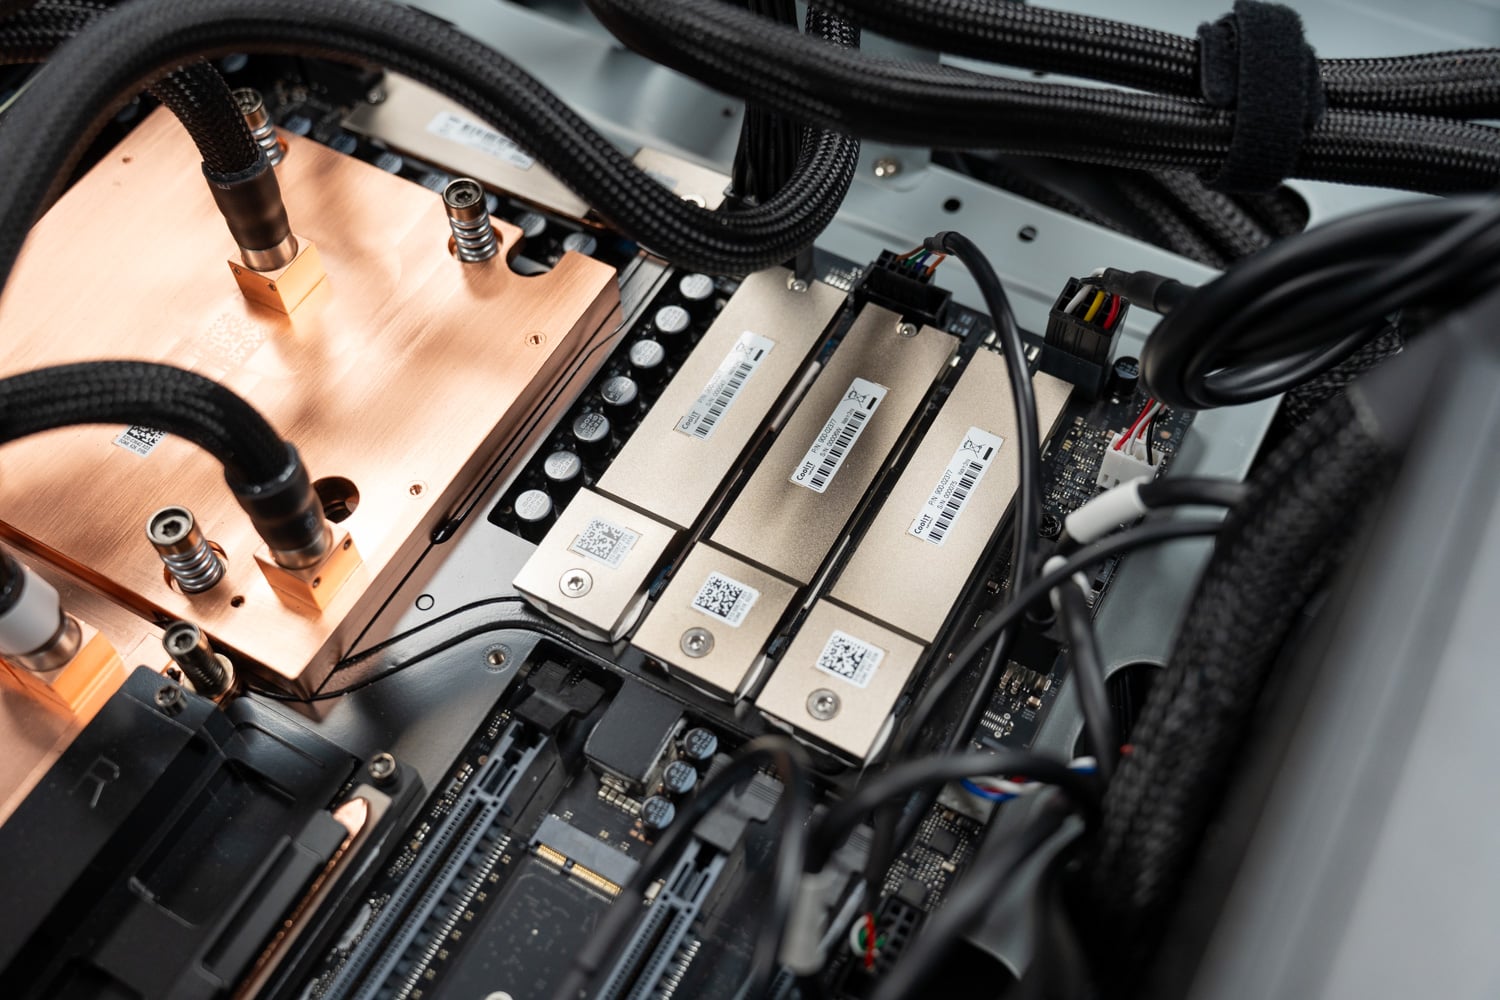
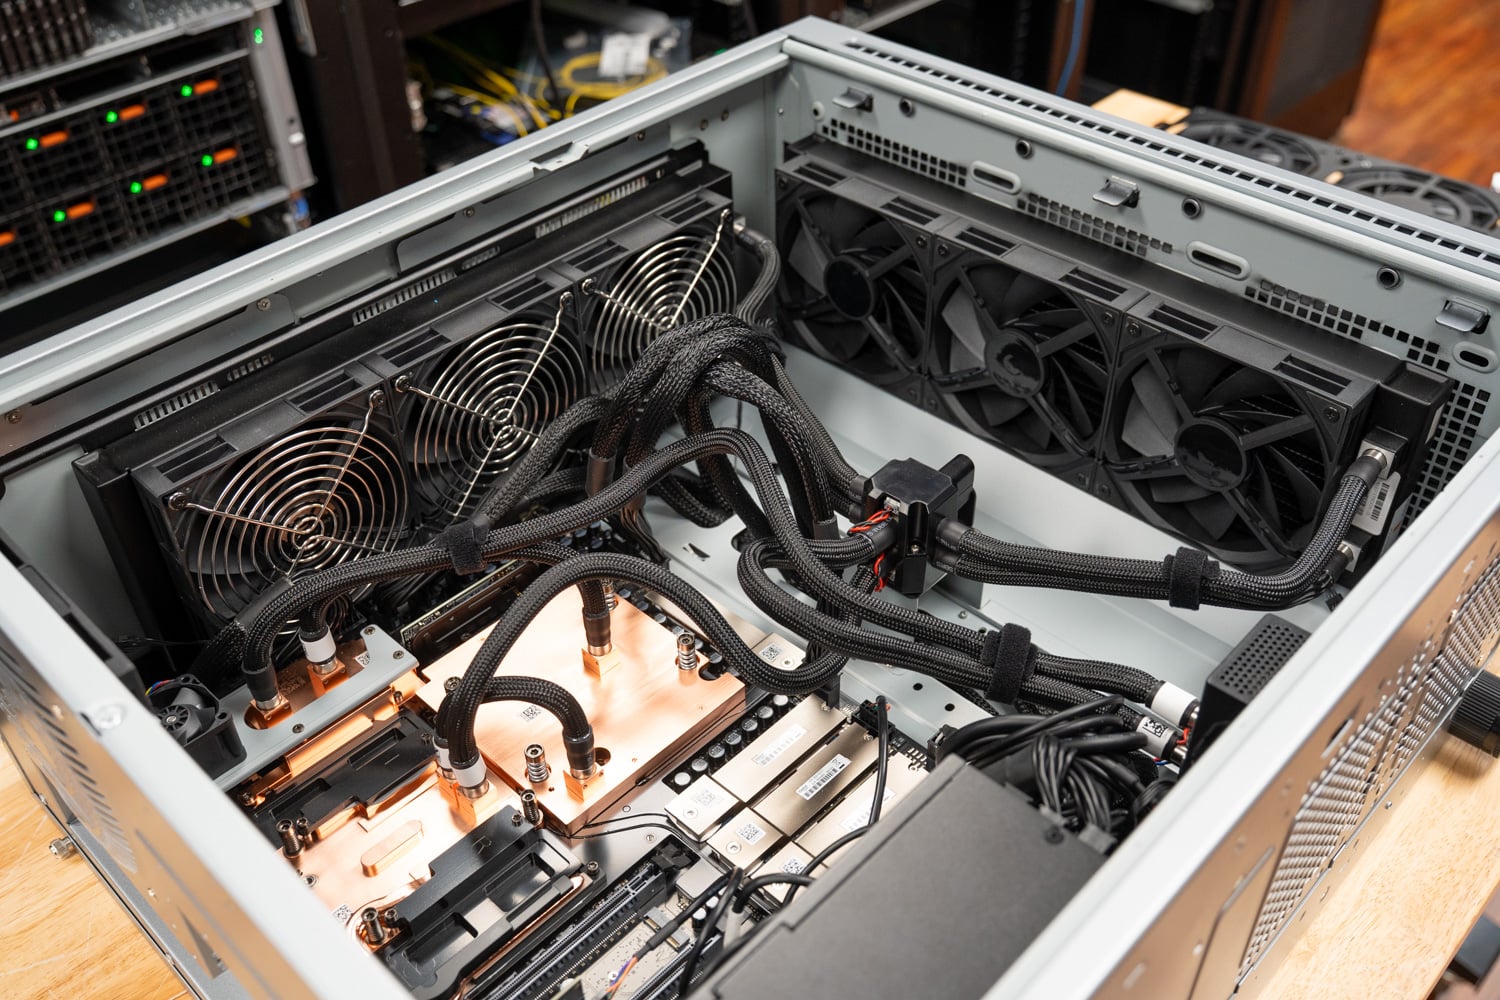
Med sidopanelen avtagen verkar ET900N G3 vara en nära släkting till WS300, vilket är förväntat med tanke på att båda delar samma NVIDIA-baskort. GB300 Superchip sitter under en kopparplatta till vänster om chassit, med SOCAMM-modulerna under sina egna kopparplattor bredvid och ConnectX-8 under ett tredje block nära den bakre I/O-enheten. Flätade rör löper från blocken till ett fördelningsrör monterat på chassits tvärbalk, och därifrån till radiatorerna. De tre fullängds PCIe-kortplatserna sitter under Superchip, strömförsörjningen upptar det nedre främre hörnet och ett metallhölje täcker kabelvägen längs botten.
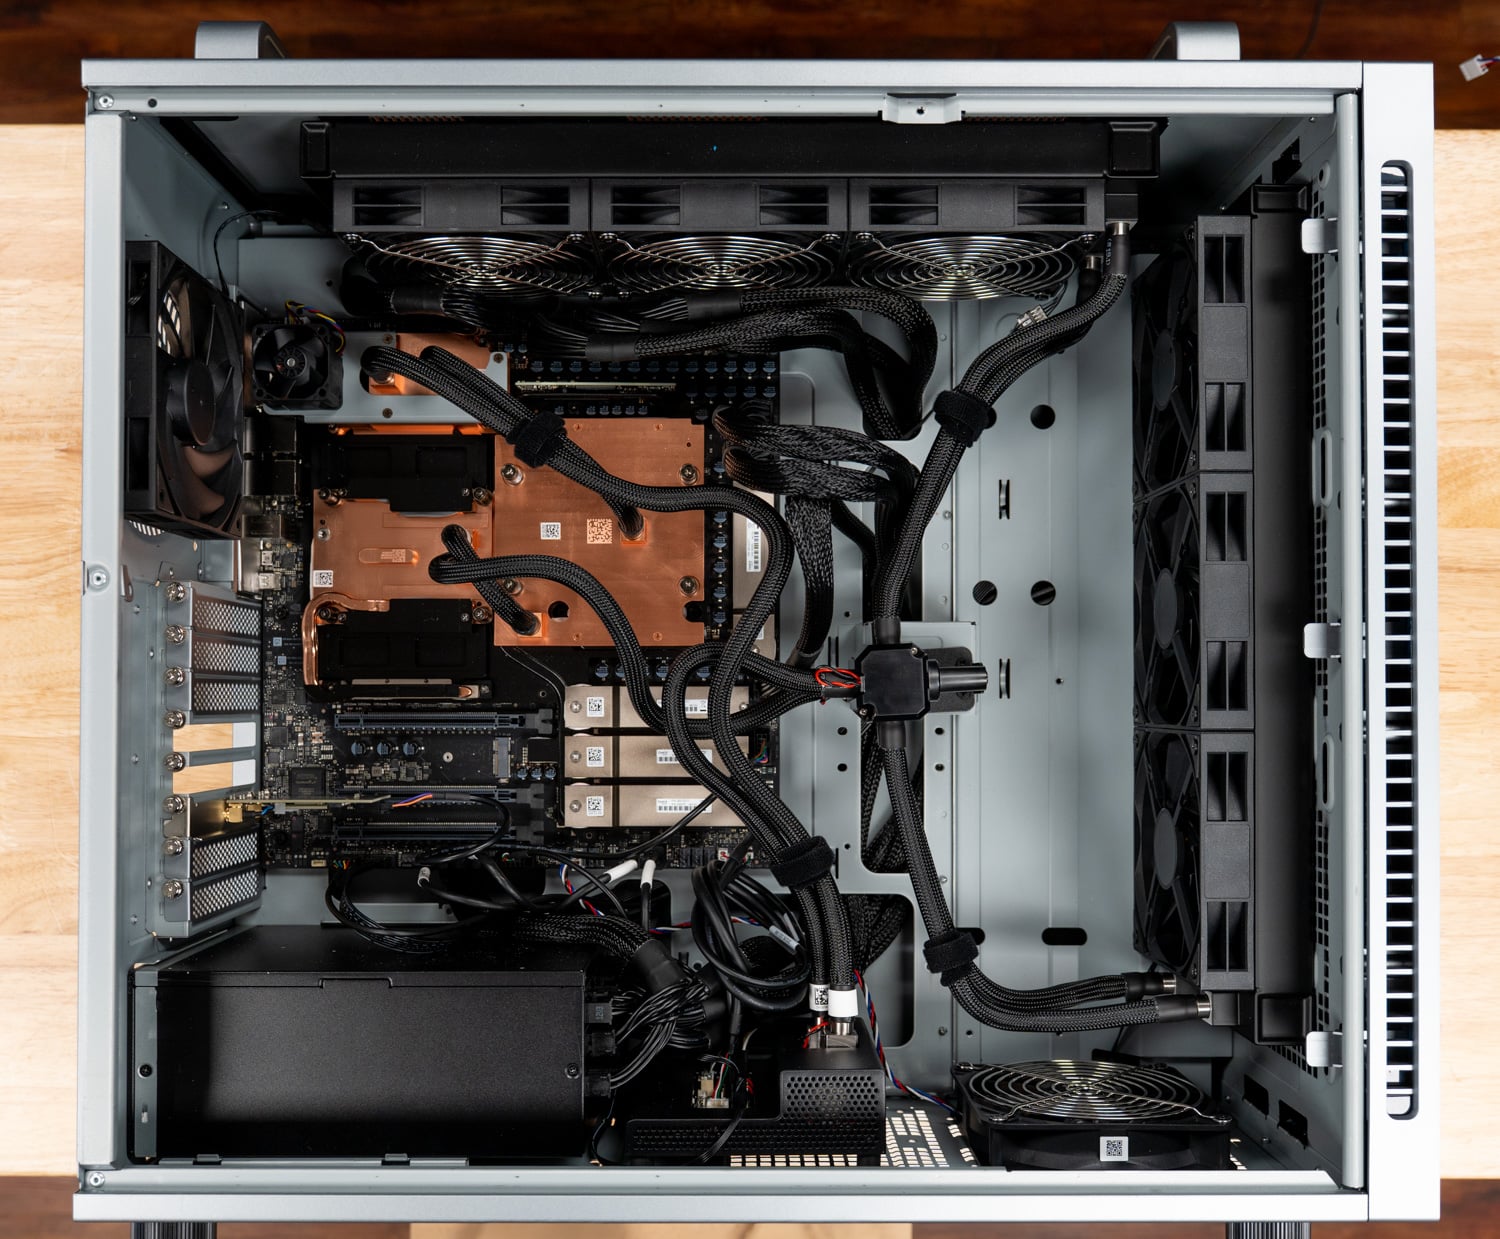
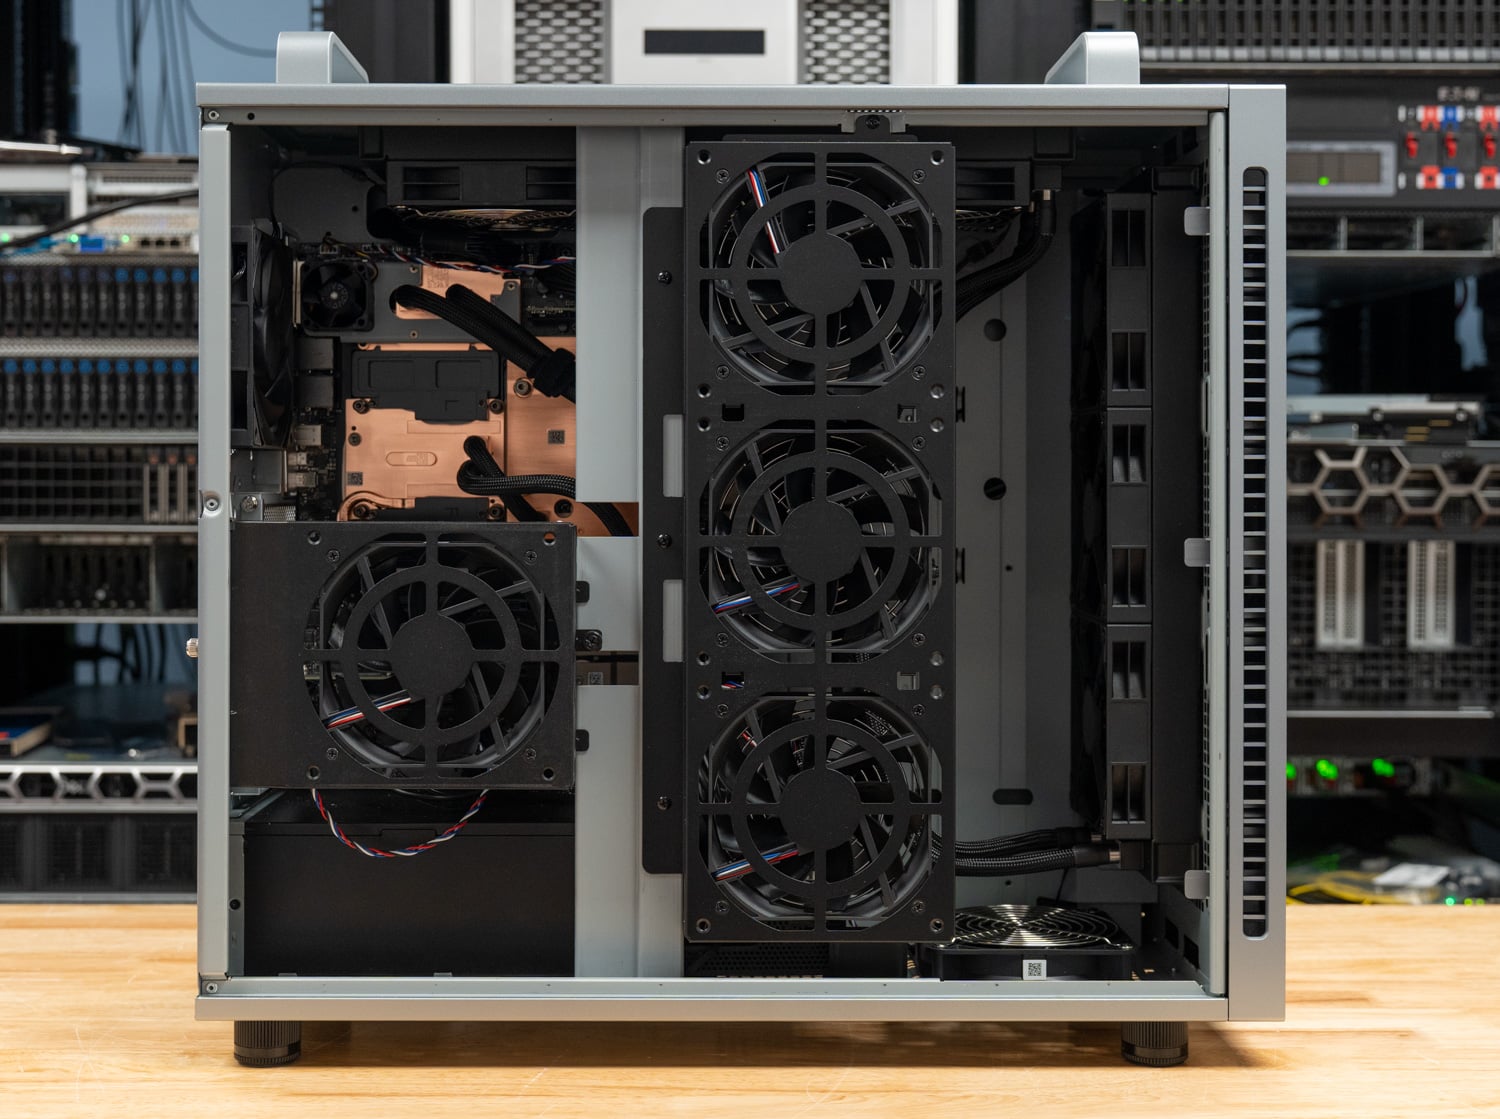
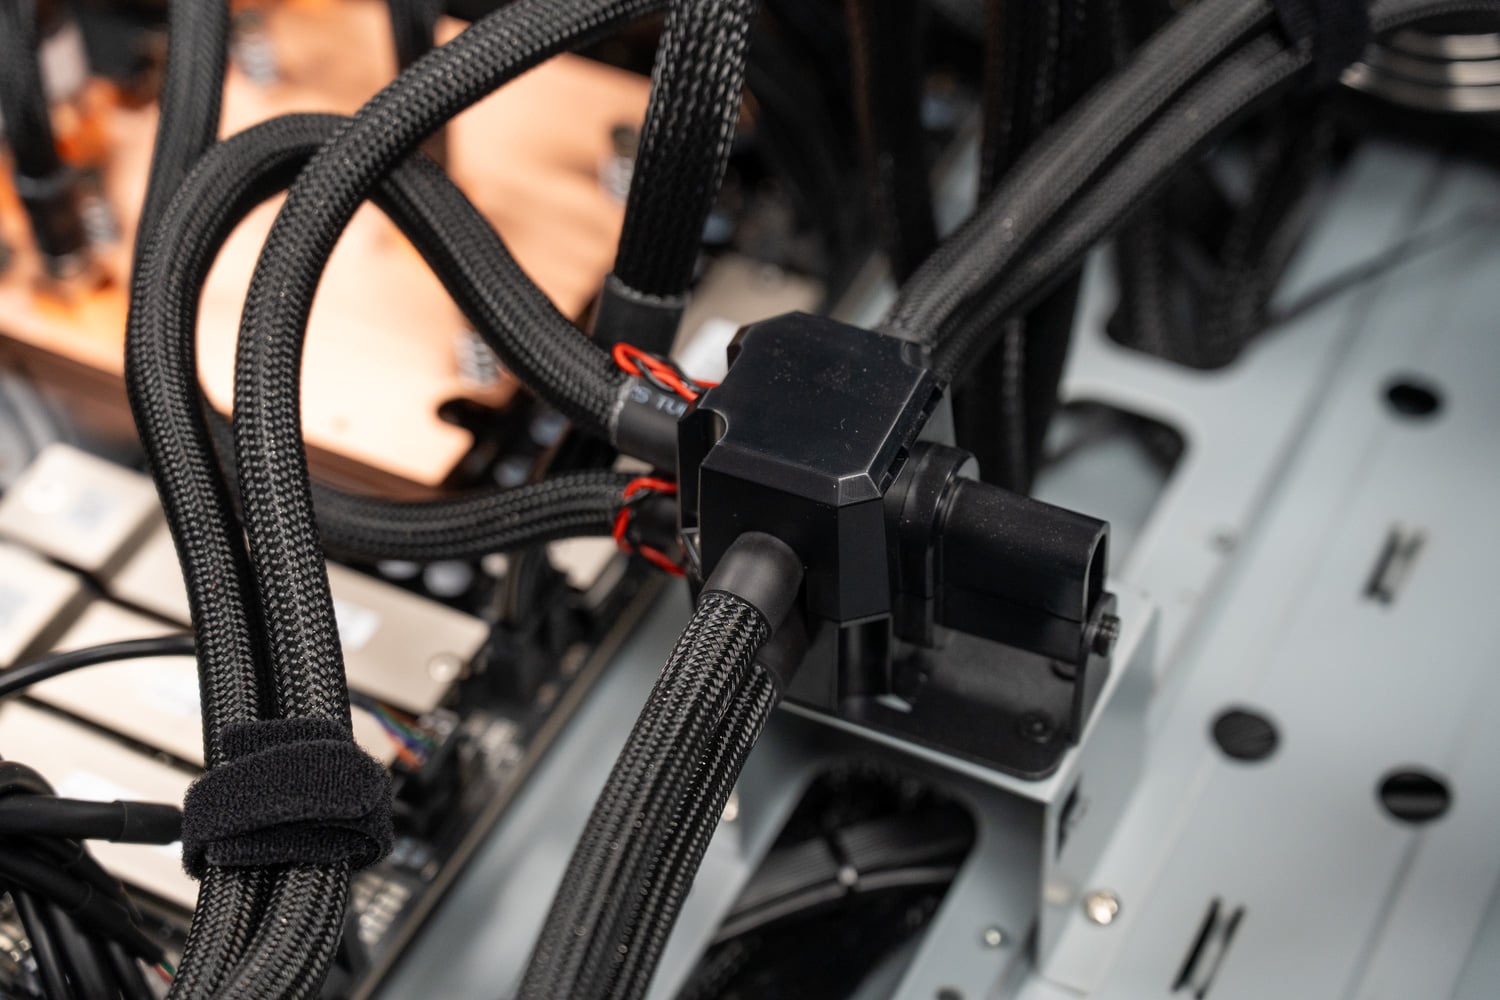
Arrangemanget inuti följer samma mönster som WS300: en kylare monterad vertikalt bakom det främre gallret och en andra längs toppen, var och en med en rad fläktar, plus en chassifläkt bak. Kylvätskeledningarna är hylsade och fästa vid tvärbalken med kardborreband, och grenröret konsoliderar löpningarna från de fyra kylplattorna så att endast två ledningar når varje kylare.
Optikfläkten
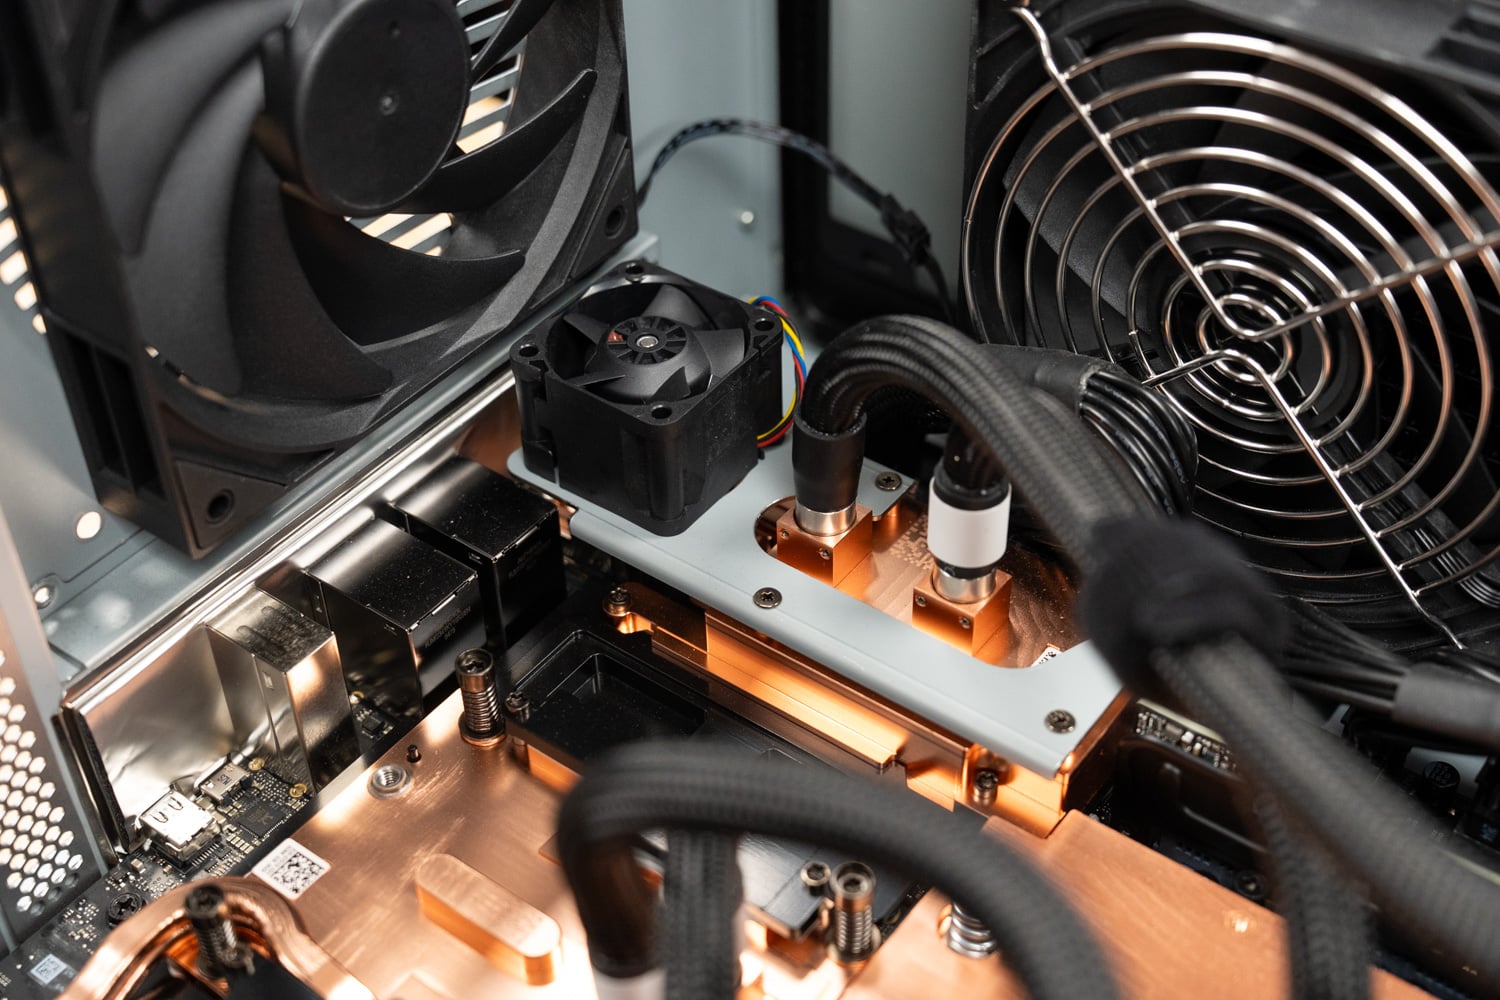
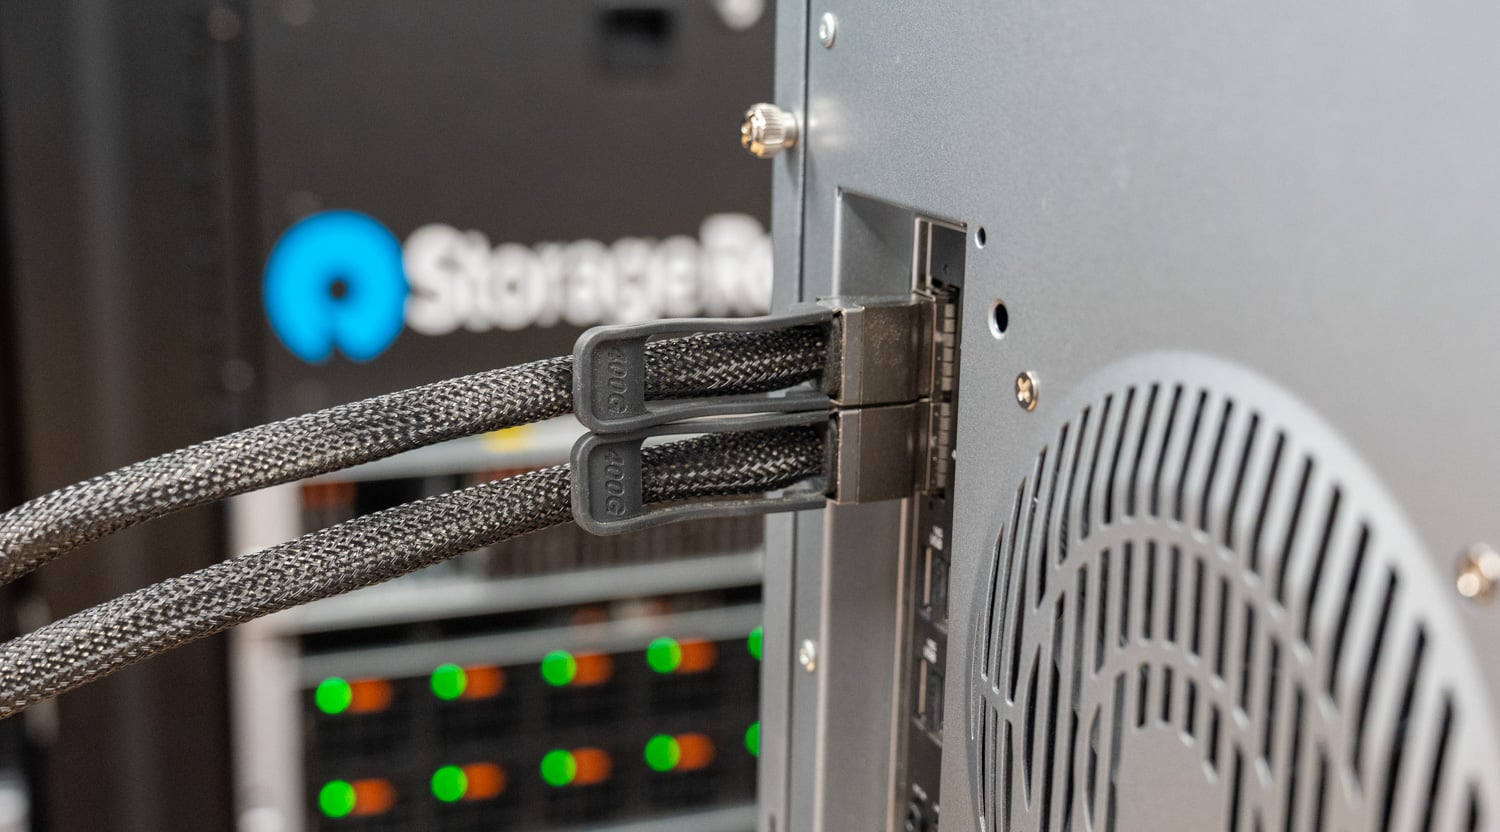
Det enda kylelementet som saknar motsvarighet i WS300 är en liten fläkt monterad på ett fäste ovanför ConnectX-8-kylplattan, riktad mot QSFP112-burarna. Vätskeslingan hanterar själva SuperNIC-kiseln, men 400G optiska transceivrar genererar sin egen värme och sitter i metallburar som kylplattan bara kan nå via ledning. I andra tester har vi noterat att ConnectX-8 blir varm under ihållande belastning och att optiken i sig kan bli varm, så en dedikerad luftflödesväg över burarna är ett bra designelement för alla som planerar att köra ET900N G3 på fiber i timmar i sträck. Med DAC:er, vilket är hur vi kabelanslutit den till en andra GB300-station för en djupdykning med klustrad inferens som fortfarande pågår, har fläkten mindre att göra.
Lagring, expansion och strömförsörjning
ASUS levererade ET900N G3 med en enda 2TB NVMe-enhet för operativsystemet och NVIDIA-programvarustacken, i paret av M.2 2280-kortplatser som är anslutna till Grace via PCIe 5.0 x4. Det andra paret kortplatser hänger på ConnectX-8:s integrerade PCIe-switch och levererades tomma.
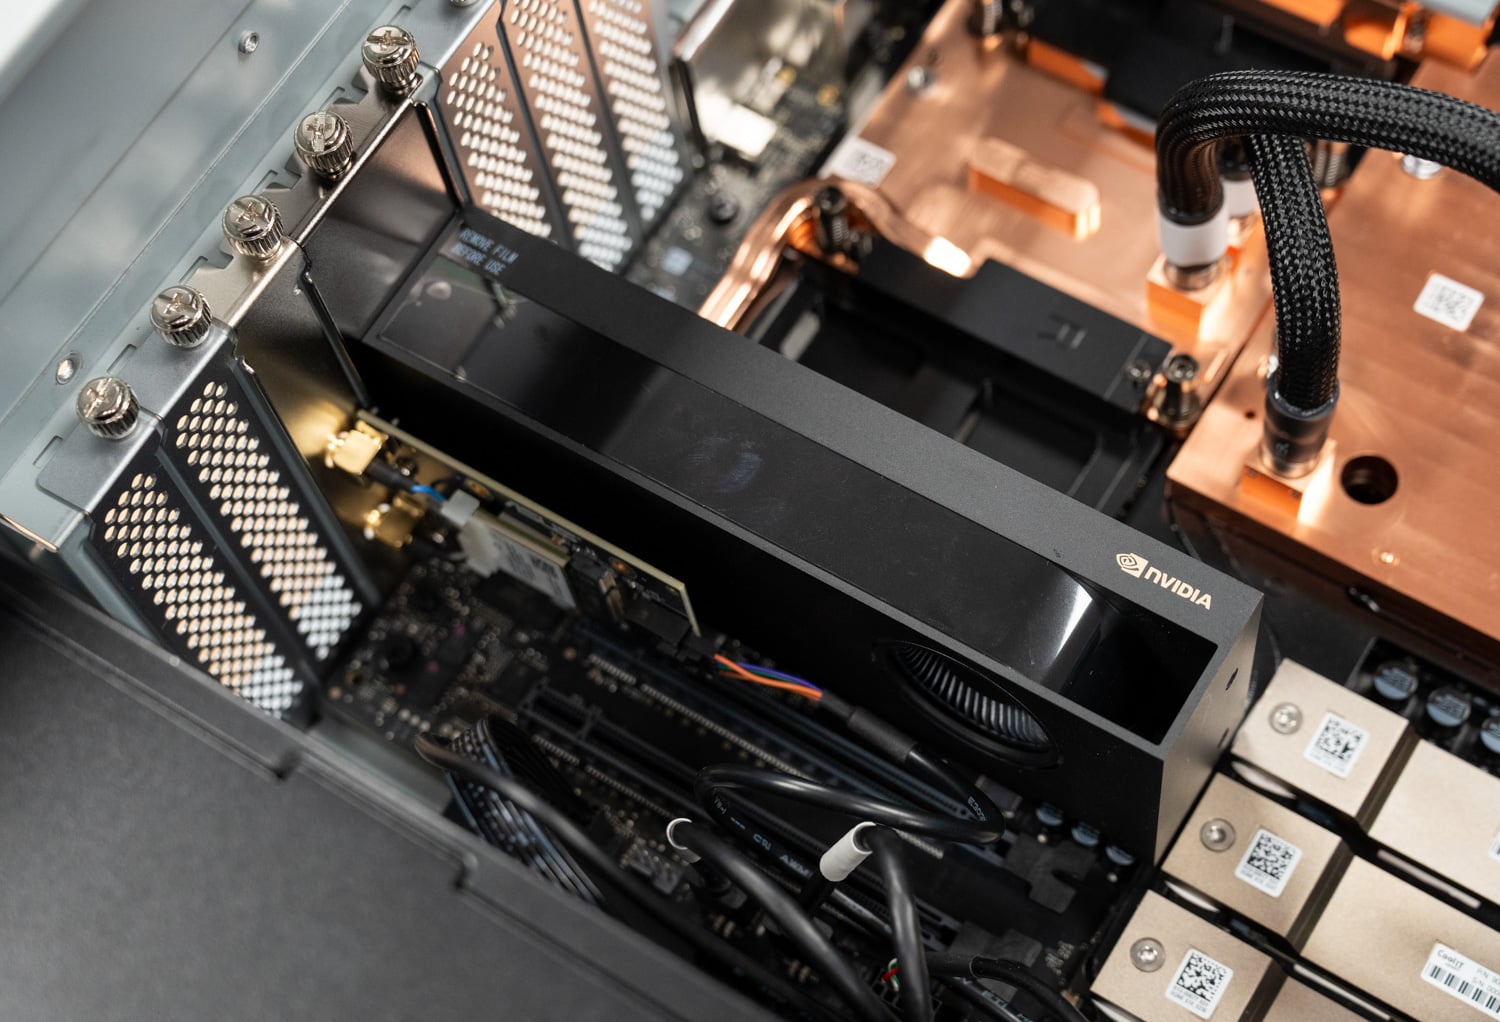
Vår testenhet levererades med ett NVIDIA RTX PRO 2000 Blackwell i PCIe 5.0 x16-kortplatsen, vilket är en av de konfigurationer som ASUS listar. Kortet ger bildkvalitet utan att dra nämnvärt ur GB300:s strömförbrukning, och ASUS säger att chassit kan hantera upp till ett RTX PRO Blackwell-kort. Vi tog bort RTX PRO 2000 innan vi testade, så Superchip hade hela acceleratorns strömförbrukning, samma villkor som vi använde för WS300, och vi testade inte ett högpresterande RTX PRO-kort i detta chassi. Den vägen, och vad den gör med den delade strömförbrukningen, är något vi kommer att ta upp i en kommande GB300 Station-recension.
Nätaggregatet är en 1 600 W ATX-enhet som ASUS klassar som 80 PLUS Titanium, ett steg över Platinum-enheten i WS300. Titanium kräver 94 % effektivitet vid 50 % belastning på 115 V-ingång jämfört med 92 % för Platinum, och det är den enda nivån som sätter ett golv vid 10 % belastning, så ET900N G3 borde förbruka några tiotals watt mindre vid vägguttaget under en full GB300-belastning. Budgeten delas fortfarande: Grace, B300, pumpar, fläktar, lagring och eventuella RTX PRO-kort drar från samma 1 600 W, och NVIDIAs vsloshd-tjänst flyttar utrymmet mellan Superchip och ett tilläggs-GPU när deras förbrukning ändras, utan någon fast gräns för någon av dem. WS300-recensionen går igenom den policyn, och den är oförändrad här. En dedikerad 20A-krets är fortfarande kravet för nordamerikanska installationer.
Anslutningar
ConnectX-8:s två QSFP112-portar är ET900N G3:s länk till allt annat: lagring, en andra DGX-station eller en klusterstruktur. Dessa portar används redan i labbet, och ET900N G3 är ansluten till en andra GB300-station via 400G DAC:er för en djupdykning i klustrad inferens som vi kommer att publicera separat. 10GbE Marvell-porten hanterar vanlig värdtrafik, och Realtek 1GbE-porten är dedikerad till BMC:n.
Testanteckningar
Varje resultat i den här recensionen kommer från den enhet som ASUS levererade till vårt labb, i originalminneskonfigurationen med 252 GB HBM3e och 496 GB LPDDR5X. Systemet kördes utan ett RTX PRO-kort installerat, så GB300 Superchip hade acceleratorns fulla strömbudget, vilket matchade villkoren för våra WS300-tester. Programvarustacken, vLLM-konfigurationen, arbetsbelastningsprofilerna och samtidighetssvepet är desamma som de vi använde för WS300, så de två tornen kan jämföras direkt. Denna recension avser endast prestanda; vi har inte mätt strömförbrukning eller temperatur på den här enheten.
Arbetsbelastningarna är samma två vLLM live-inferensprofiler som vi kör på varje lokalt AI-system: en lika stor arbetsbelastning med 512 inmatnings- och 512 utmatningstokens, och en förfyllningstung arbetsbelastning med 8 192 inmatnings- och 1 024 utmatningstokens, svepta från en till 128 samtidiga strömmar. För modellerna i frontier-skalan jämför vi med en Dell PowerEdge XE7740 GPU-server utrustad med två eller fyra RTX PRO 6000 -kort, det närmaste alternativet med en enda box för dessa kontrollpunkter. För de mindre modellerna jämför vi med en enda RTX PRO 6000 i samma XE7740, en enda H200 NVL i en Dell PowerEdge R770 och en GB10 DGX Spark representerad av Acer Veriton GN100 , samma Spark som vi använde i WS300-recensionen. ET900N G3-siffrorna nedan är de exakta värdena från körloggarna; Jämförelsesystemets siffror läses från våra resultatdiagram.
Inferensprestanda
Frontiermodeller på den koherenta minnespoolen
GB300:s existensberättigande är att den betjänar modeller på båda sidor om B300:s gräns på 252 GB HBM3e, så vi börjar med fyra kontrollpunkter som sträcker sig över den: DeepSeek V4 Flash och MiniMax M2.7 får plats i HBM med gott om plats, MiniMax M3 får nätt och jämnt plats och flyttar en del av sina experter till Grace-minne, och GLM-5.2 avlastar ungefär hälften av sin vikt. På andra sidan av varje diagram finns det närmaste alternativet i en enda låda: RTX PRO 6000-kort tillsammans i PowerEdge XE7740, med expertavlastning till värdminne där det behövs.
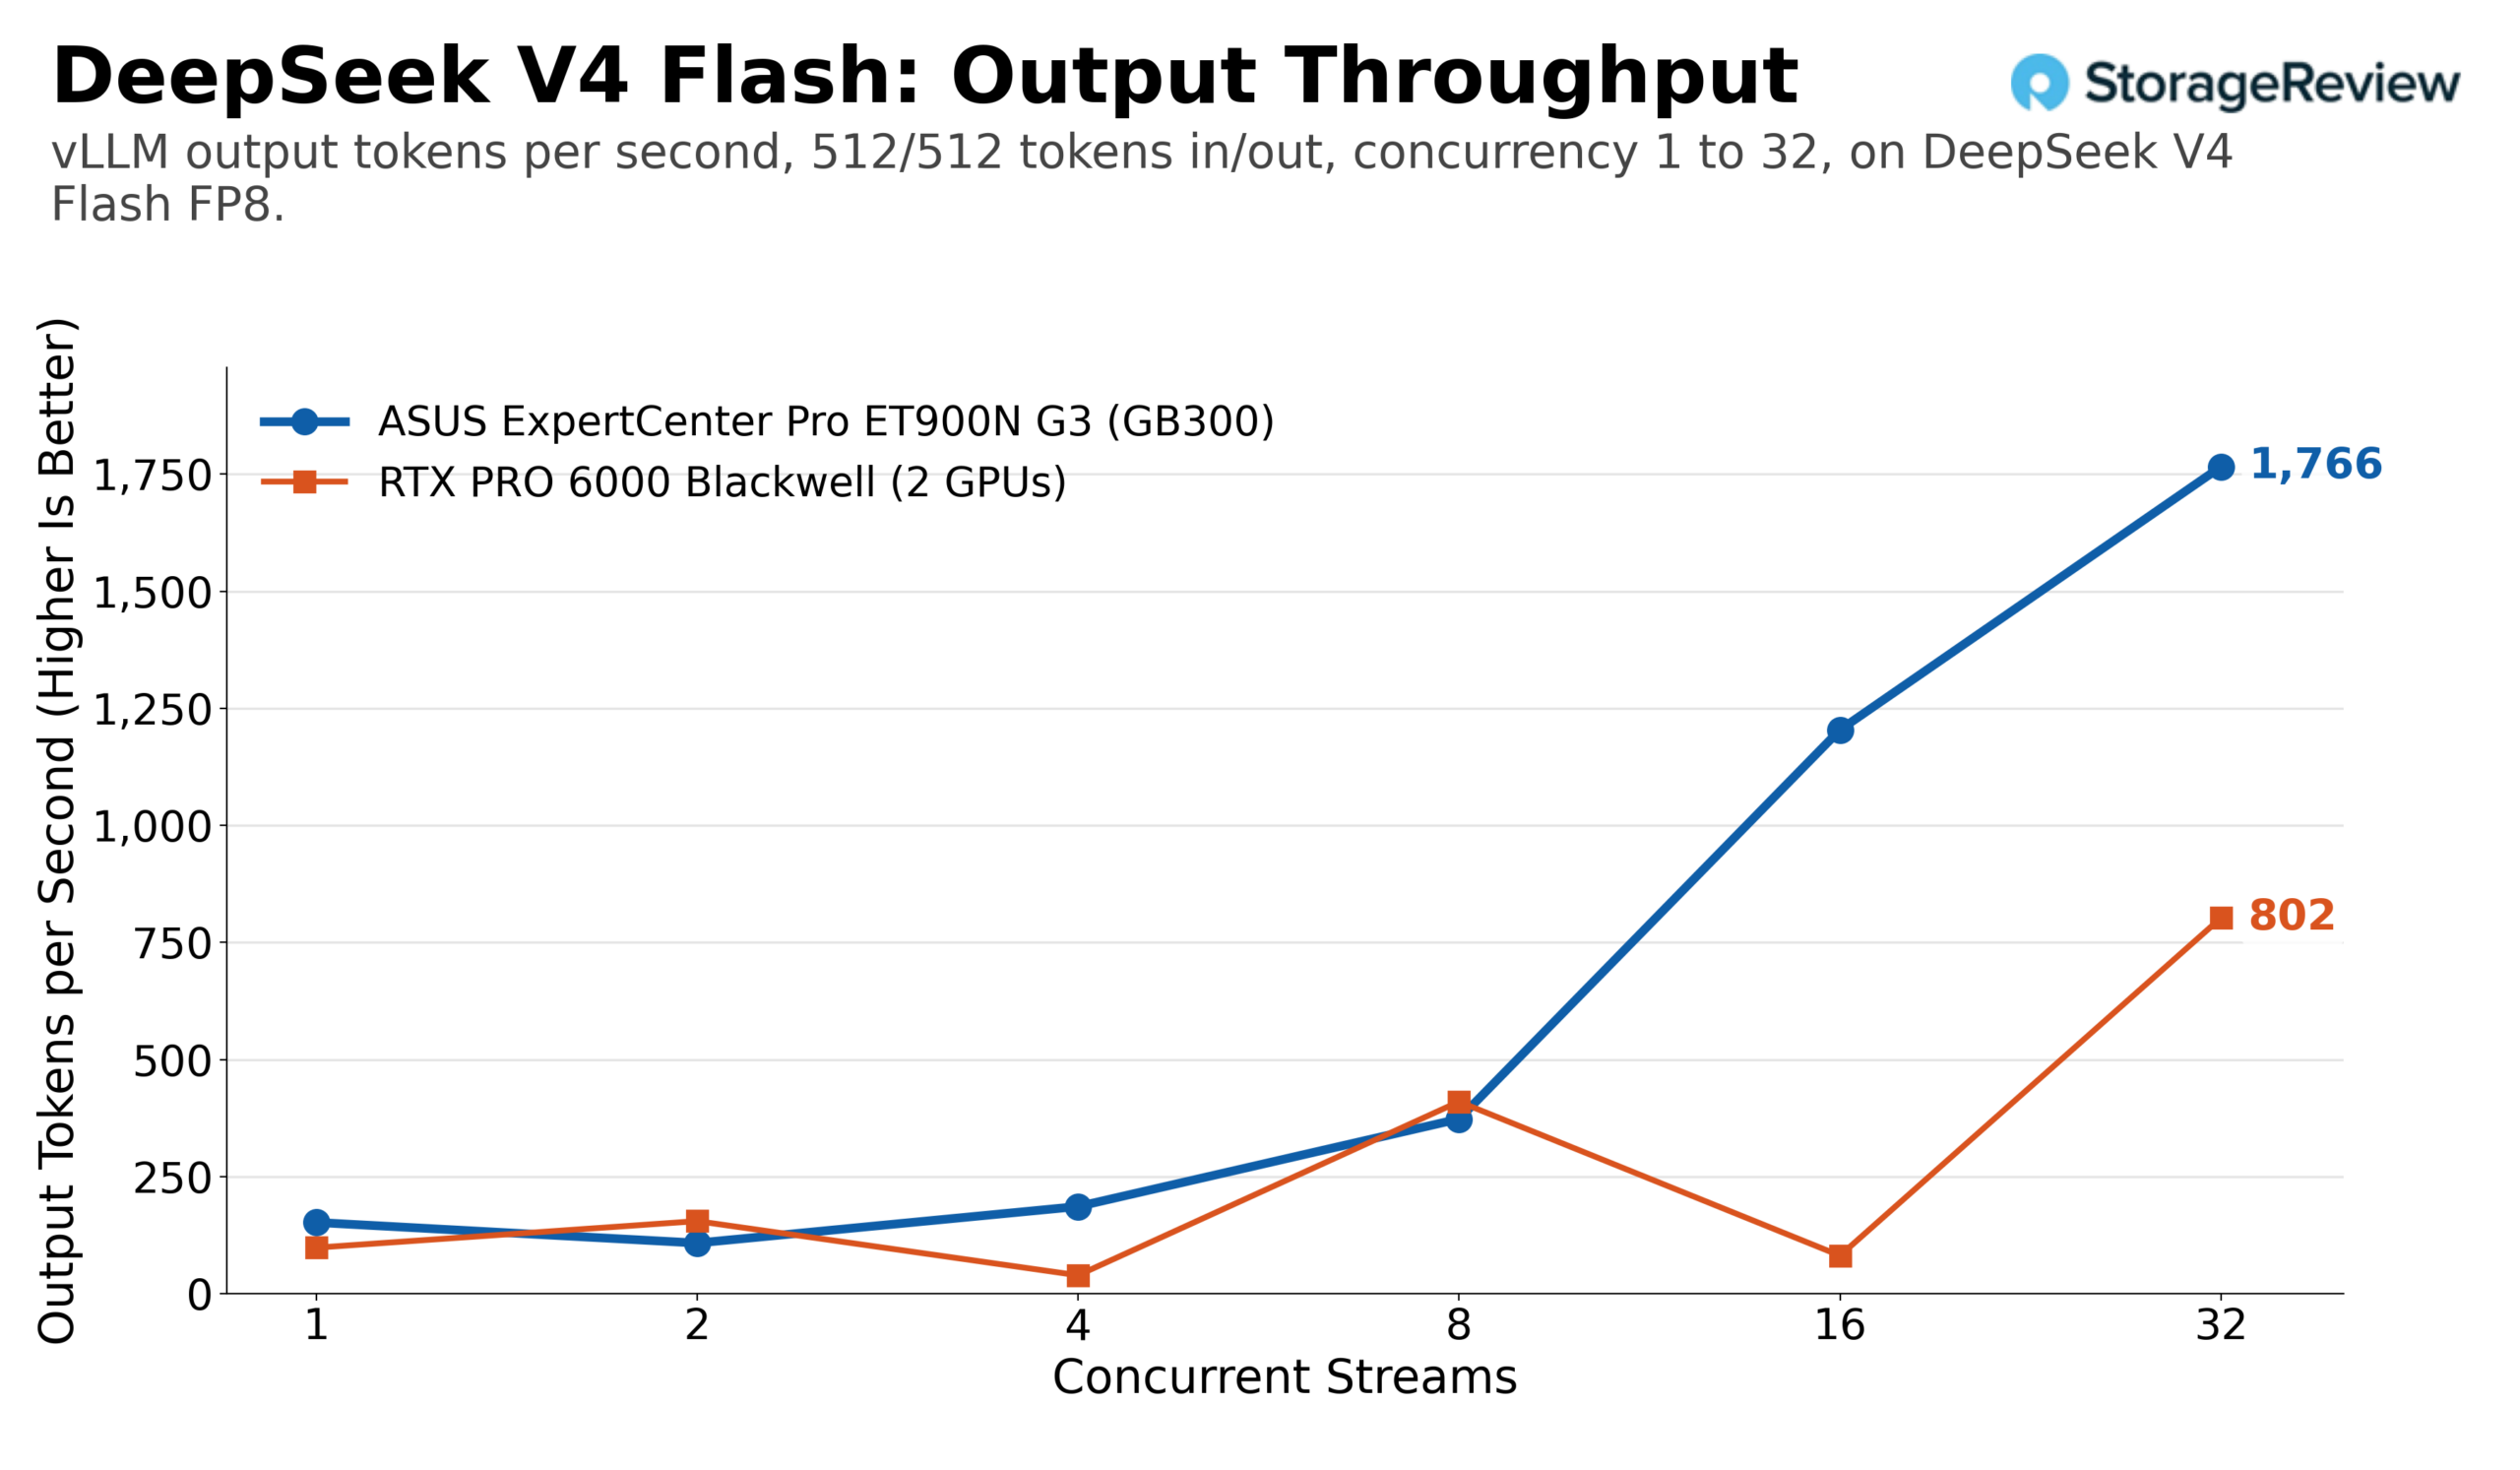
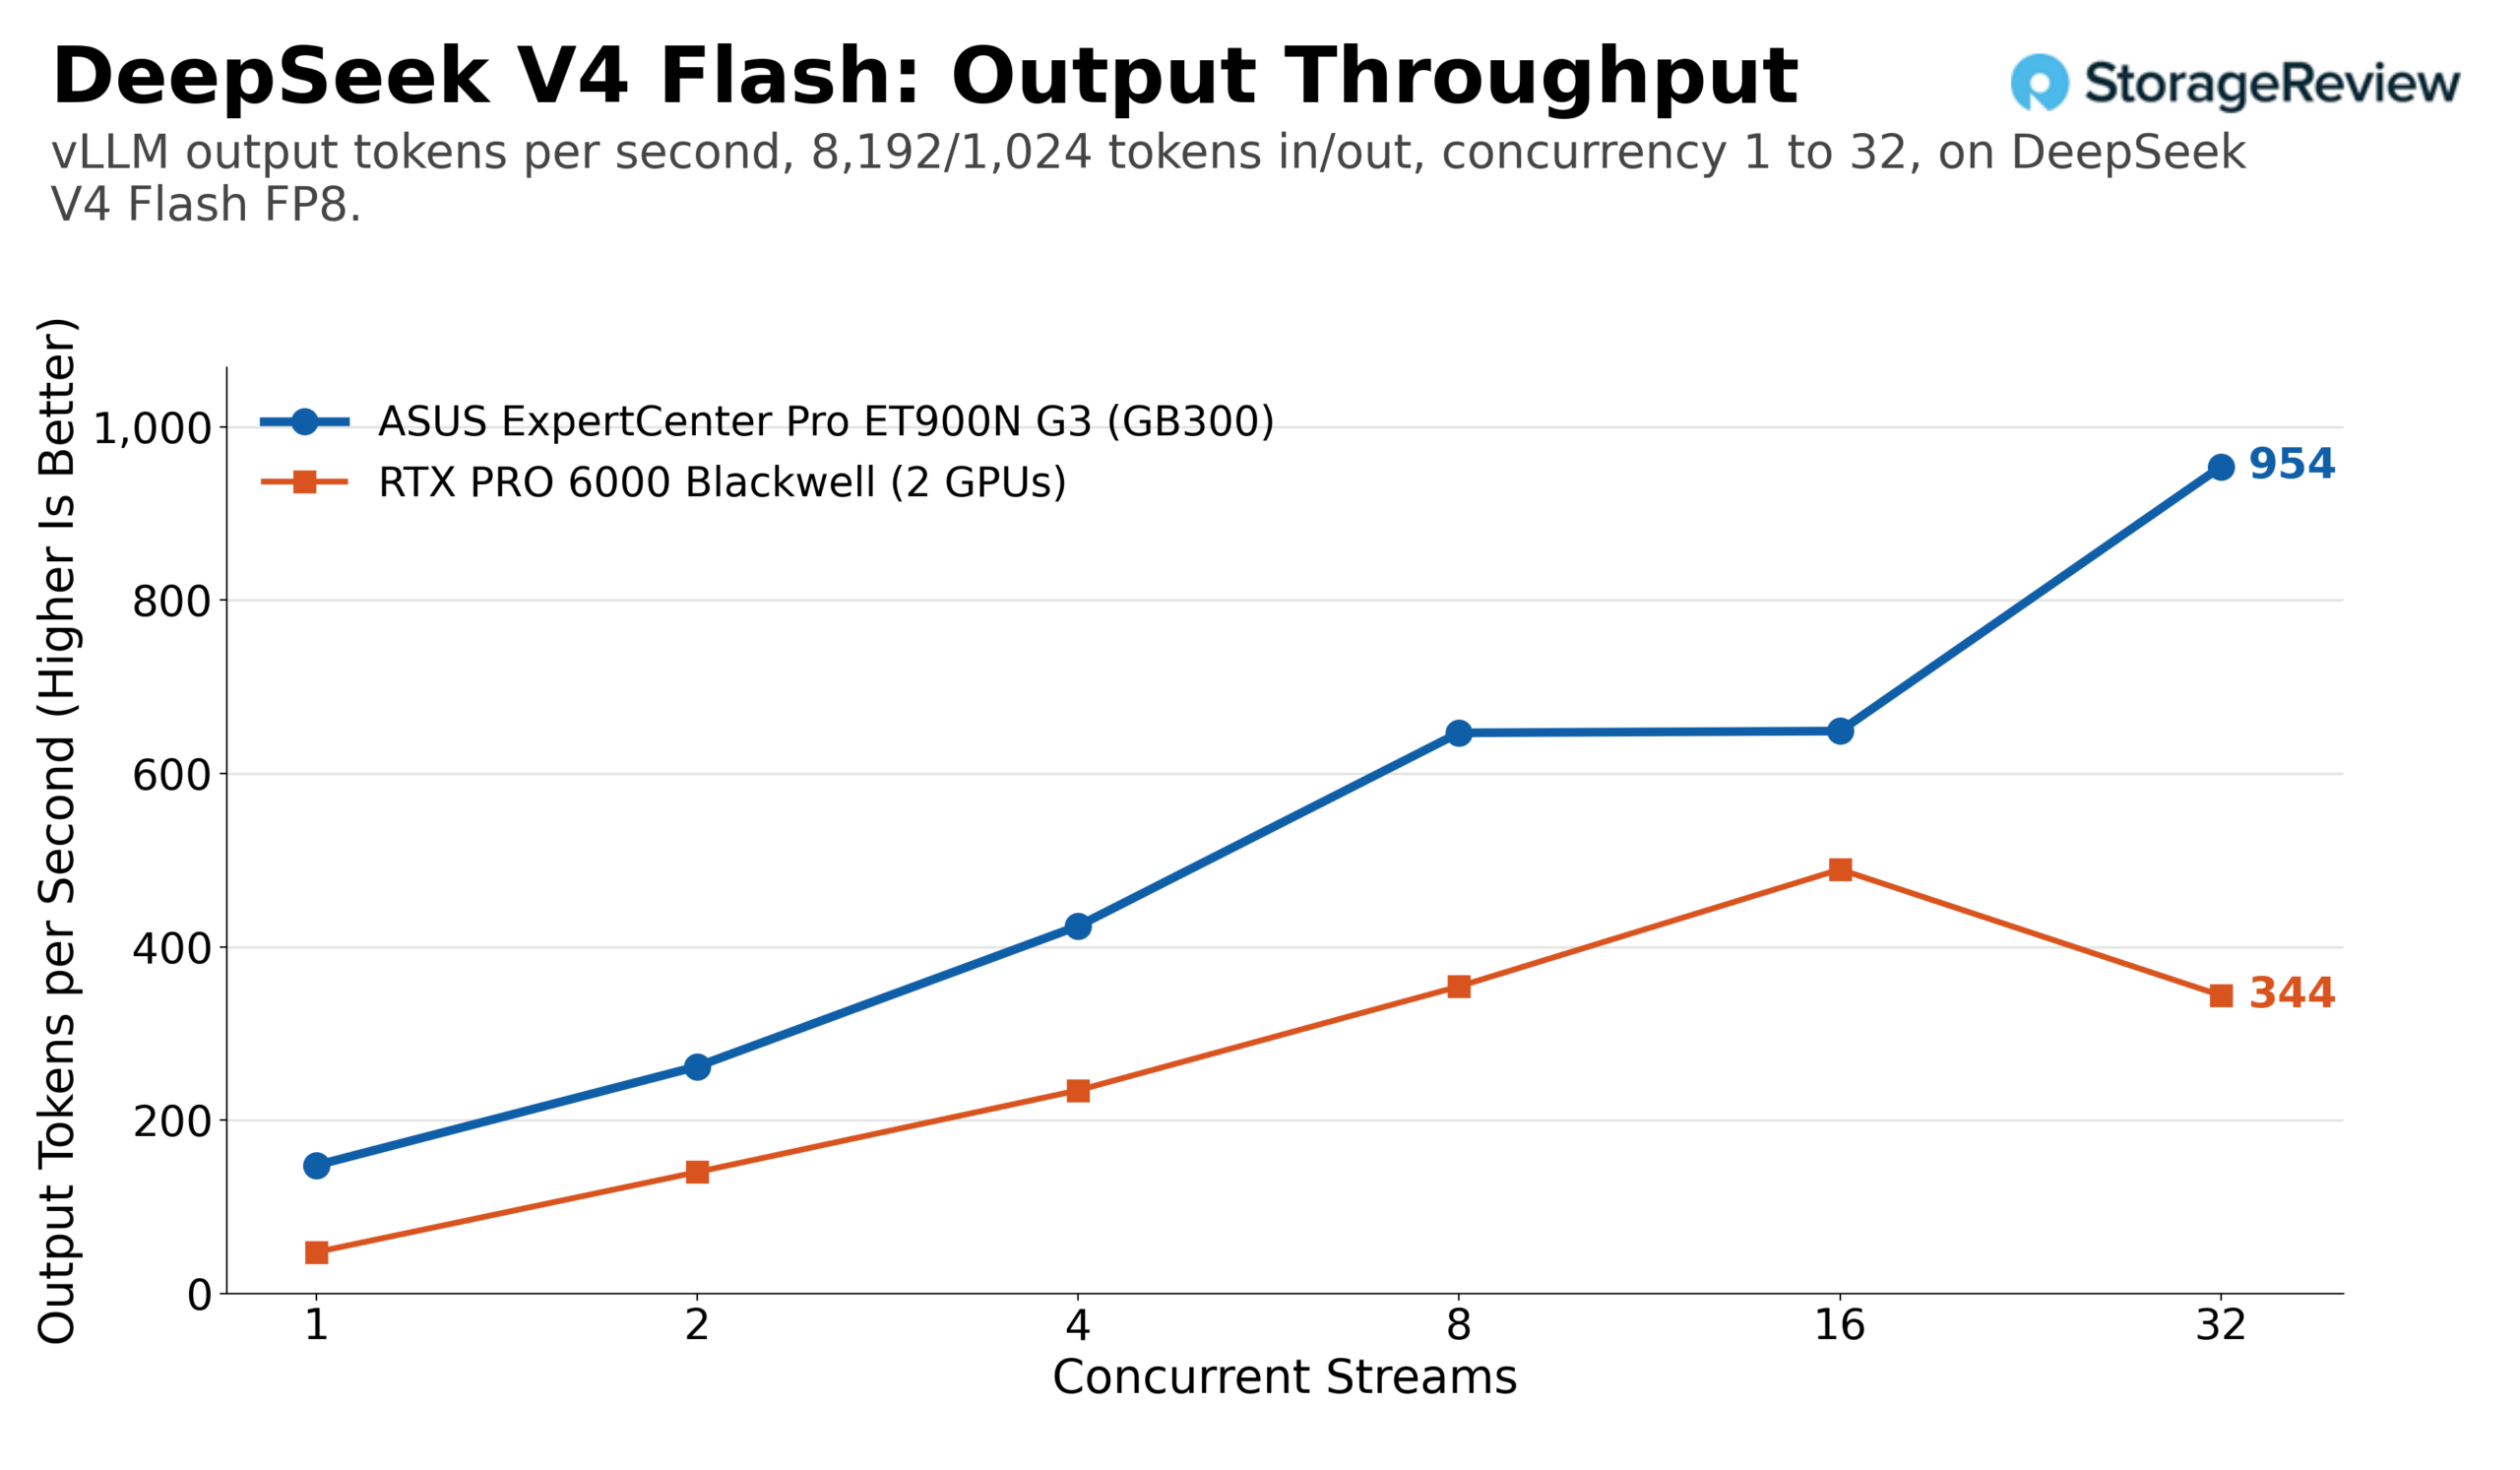
DeepSeek V4 Flash är det enkla fallet: en inbyggd FP8-kontrollpunkt på cirka 20 GB som B300 hanterar utan ansträngning. Utdataflödet på samma arbetsbelastning ökade från 152 tokens per sekund med 1 ström till 1 766 med 32 strömmar, vilket ger den totala token-genomflödet 3 532. På den prefill-tunga profilen ökade ET900N G3 från 148 till 954 utdatatokens per sekund, med totalt 8 587 tokens. Ett par RTX PRO 6000-kort nådde en topp på nära 800 utdatatokens per sekund på samma arbetsbelastning och cirka 490 på långa prompter, med en ojämn kurva vid låg samtidighet.
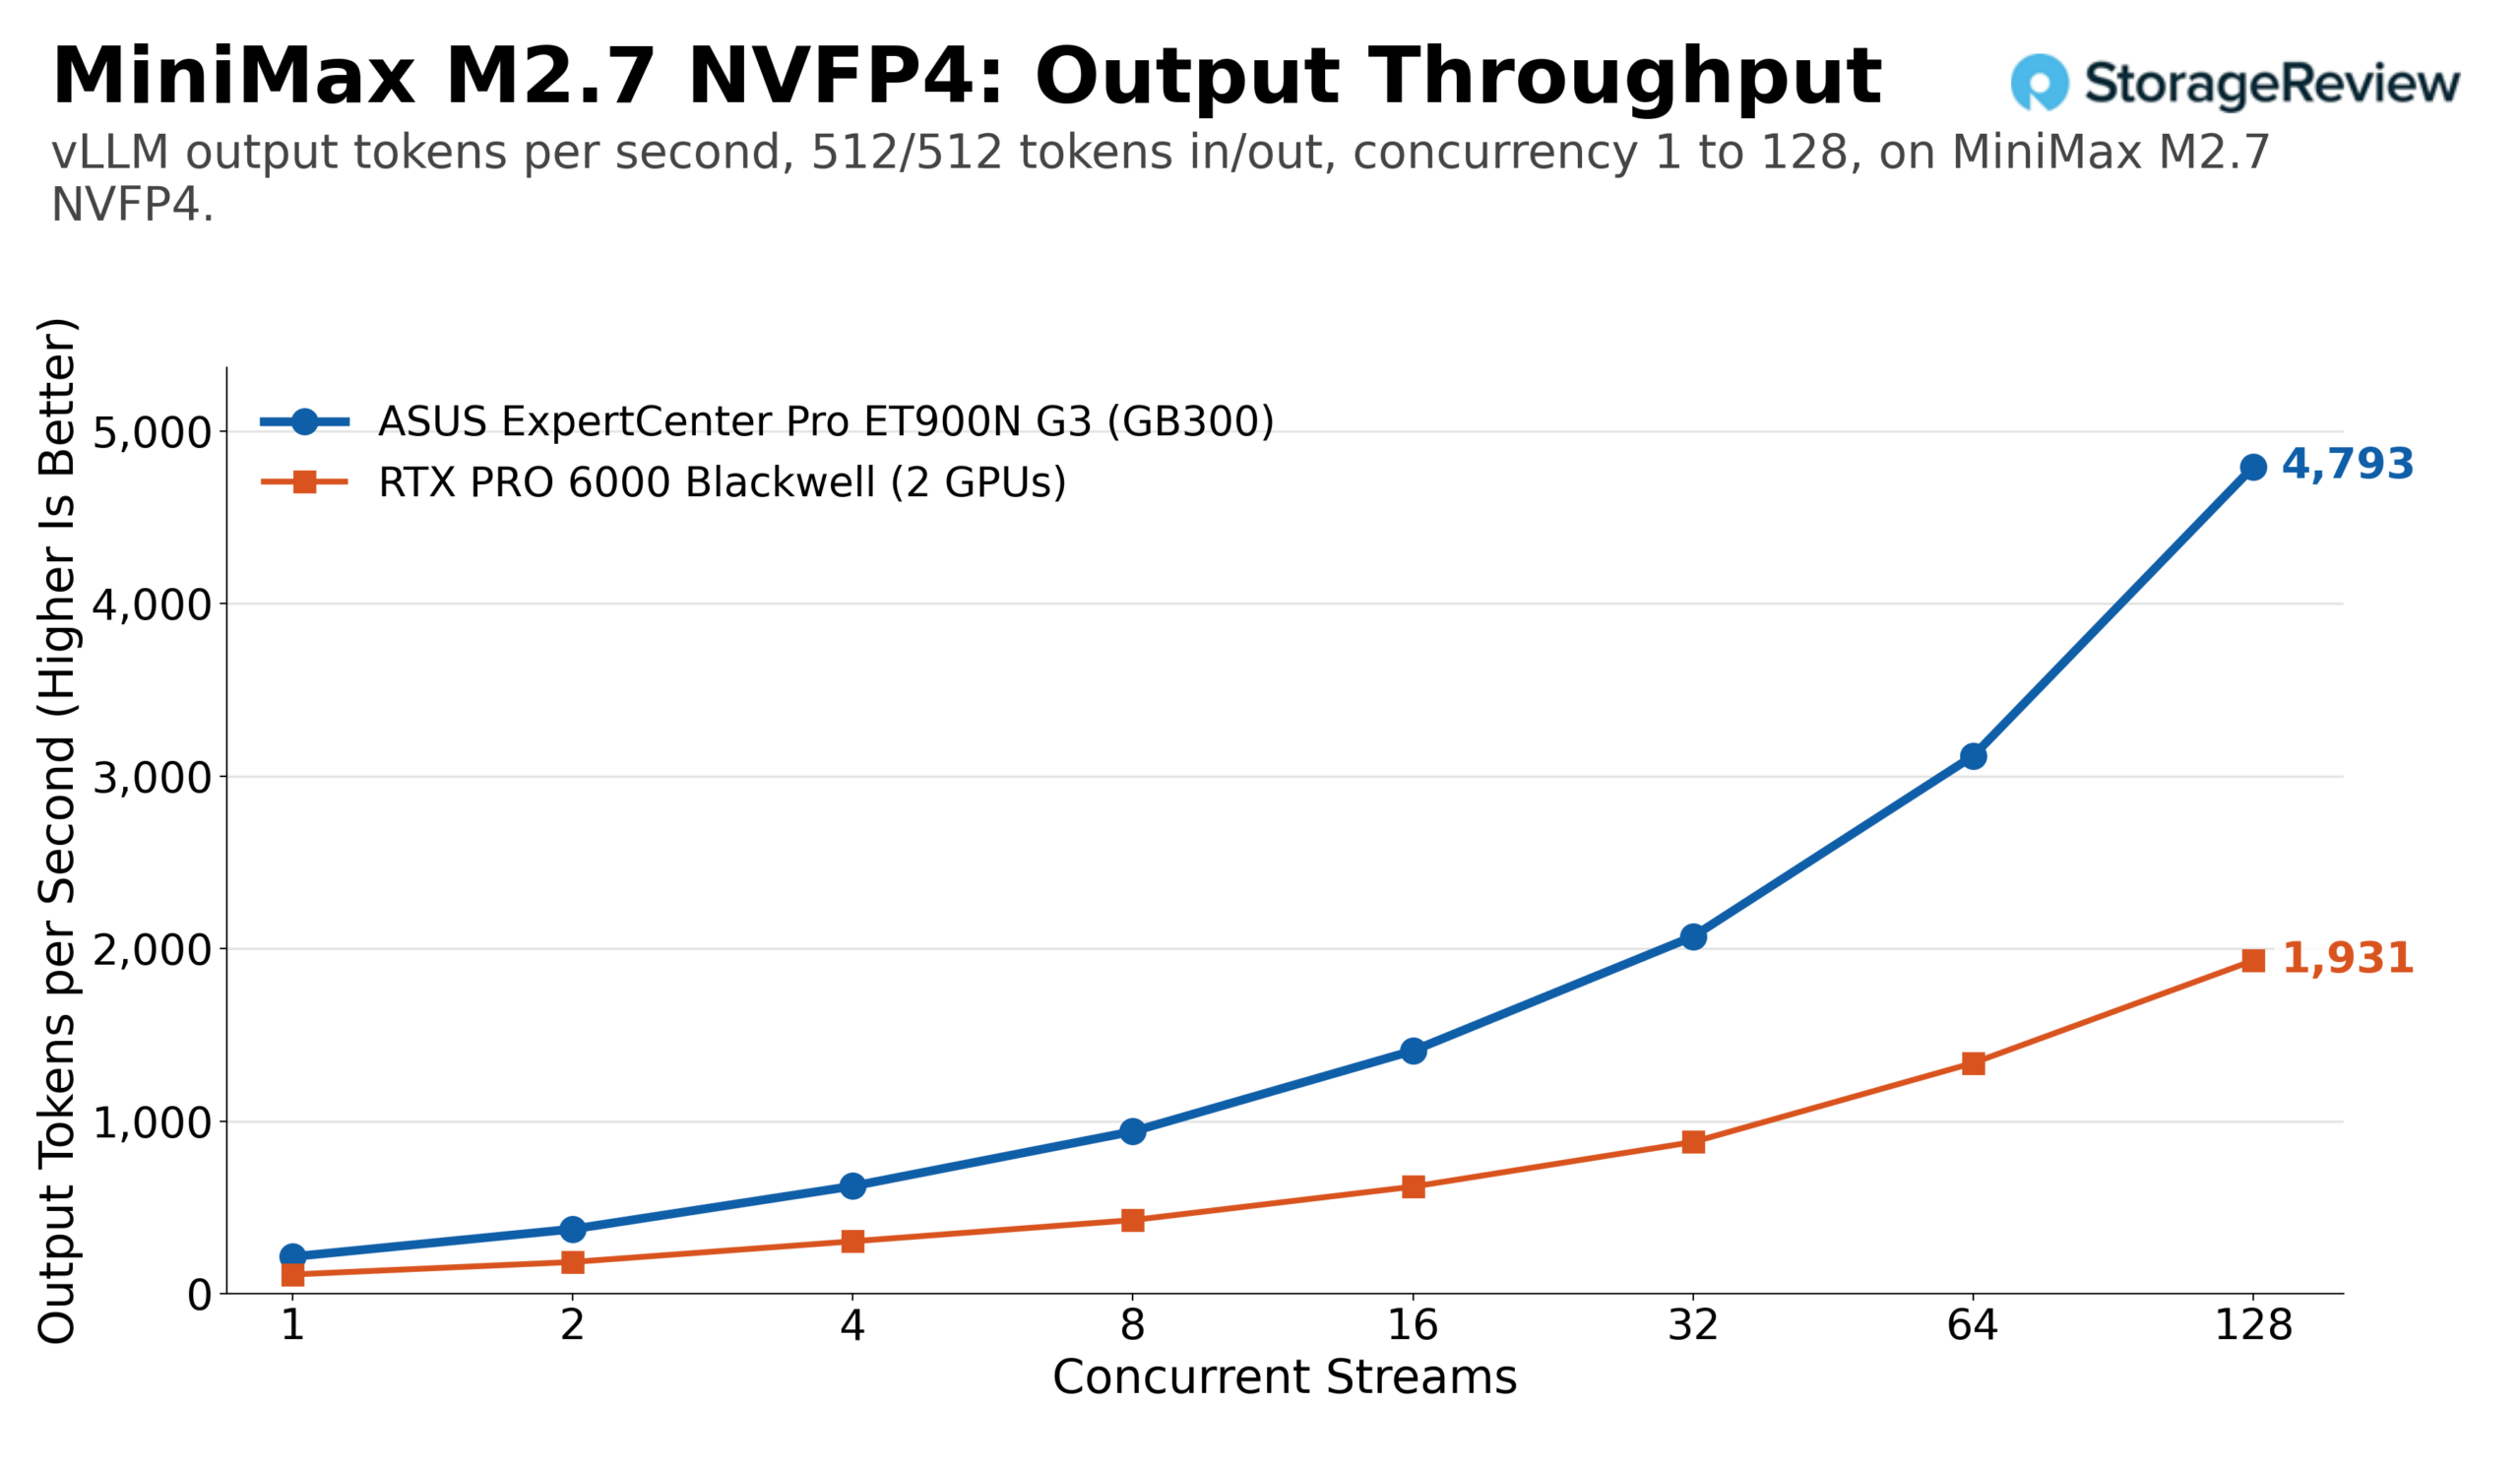
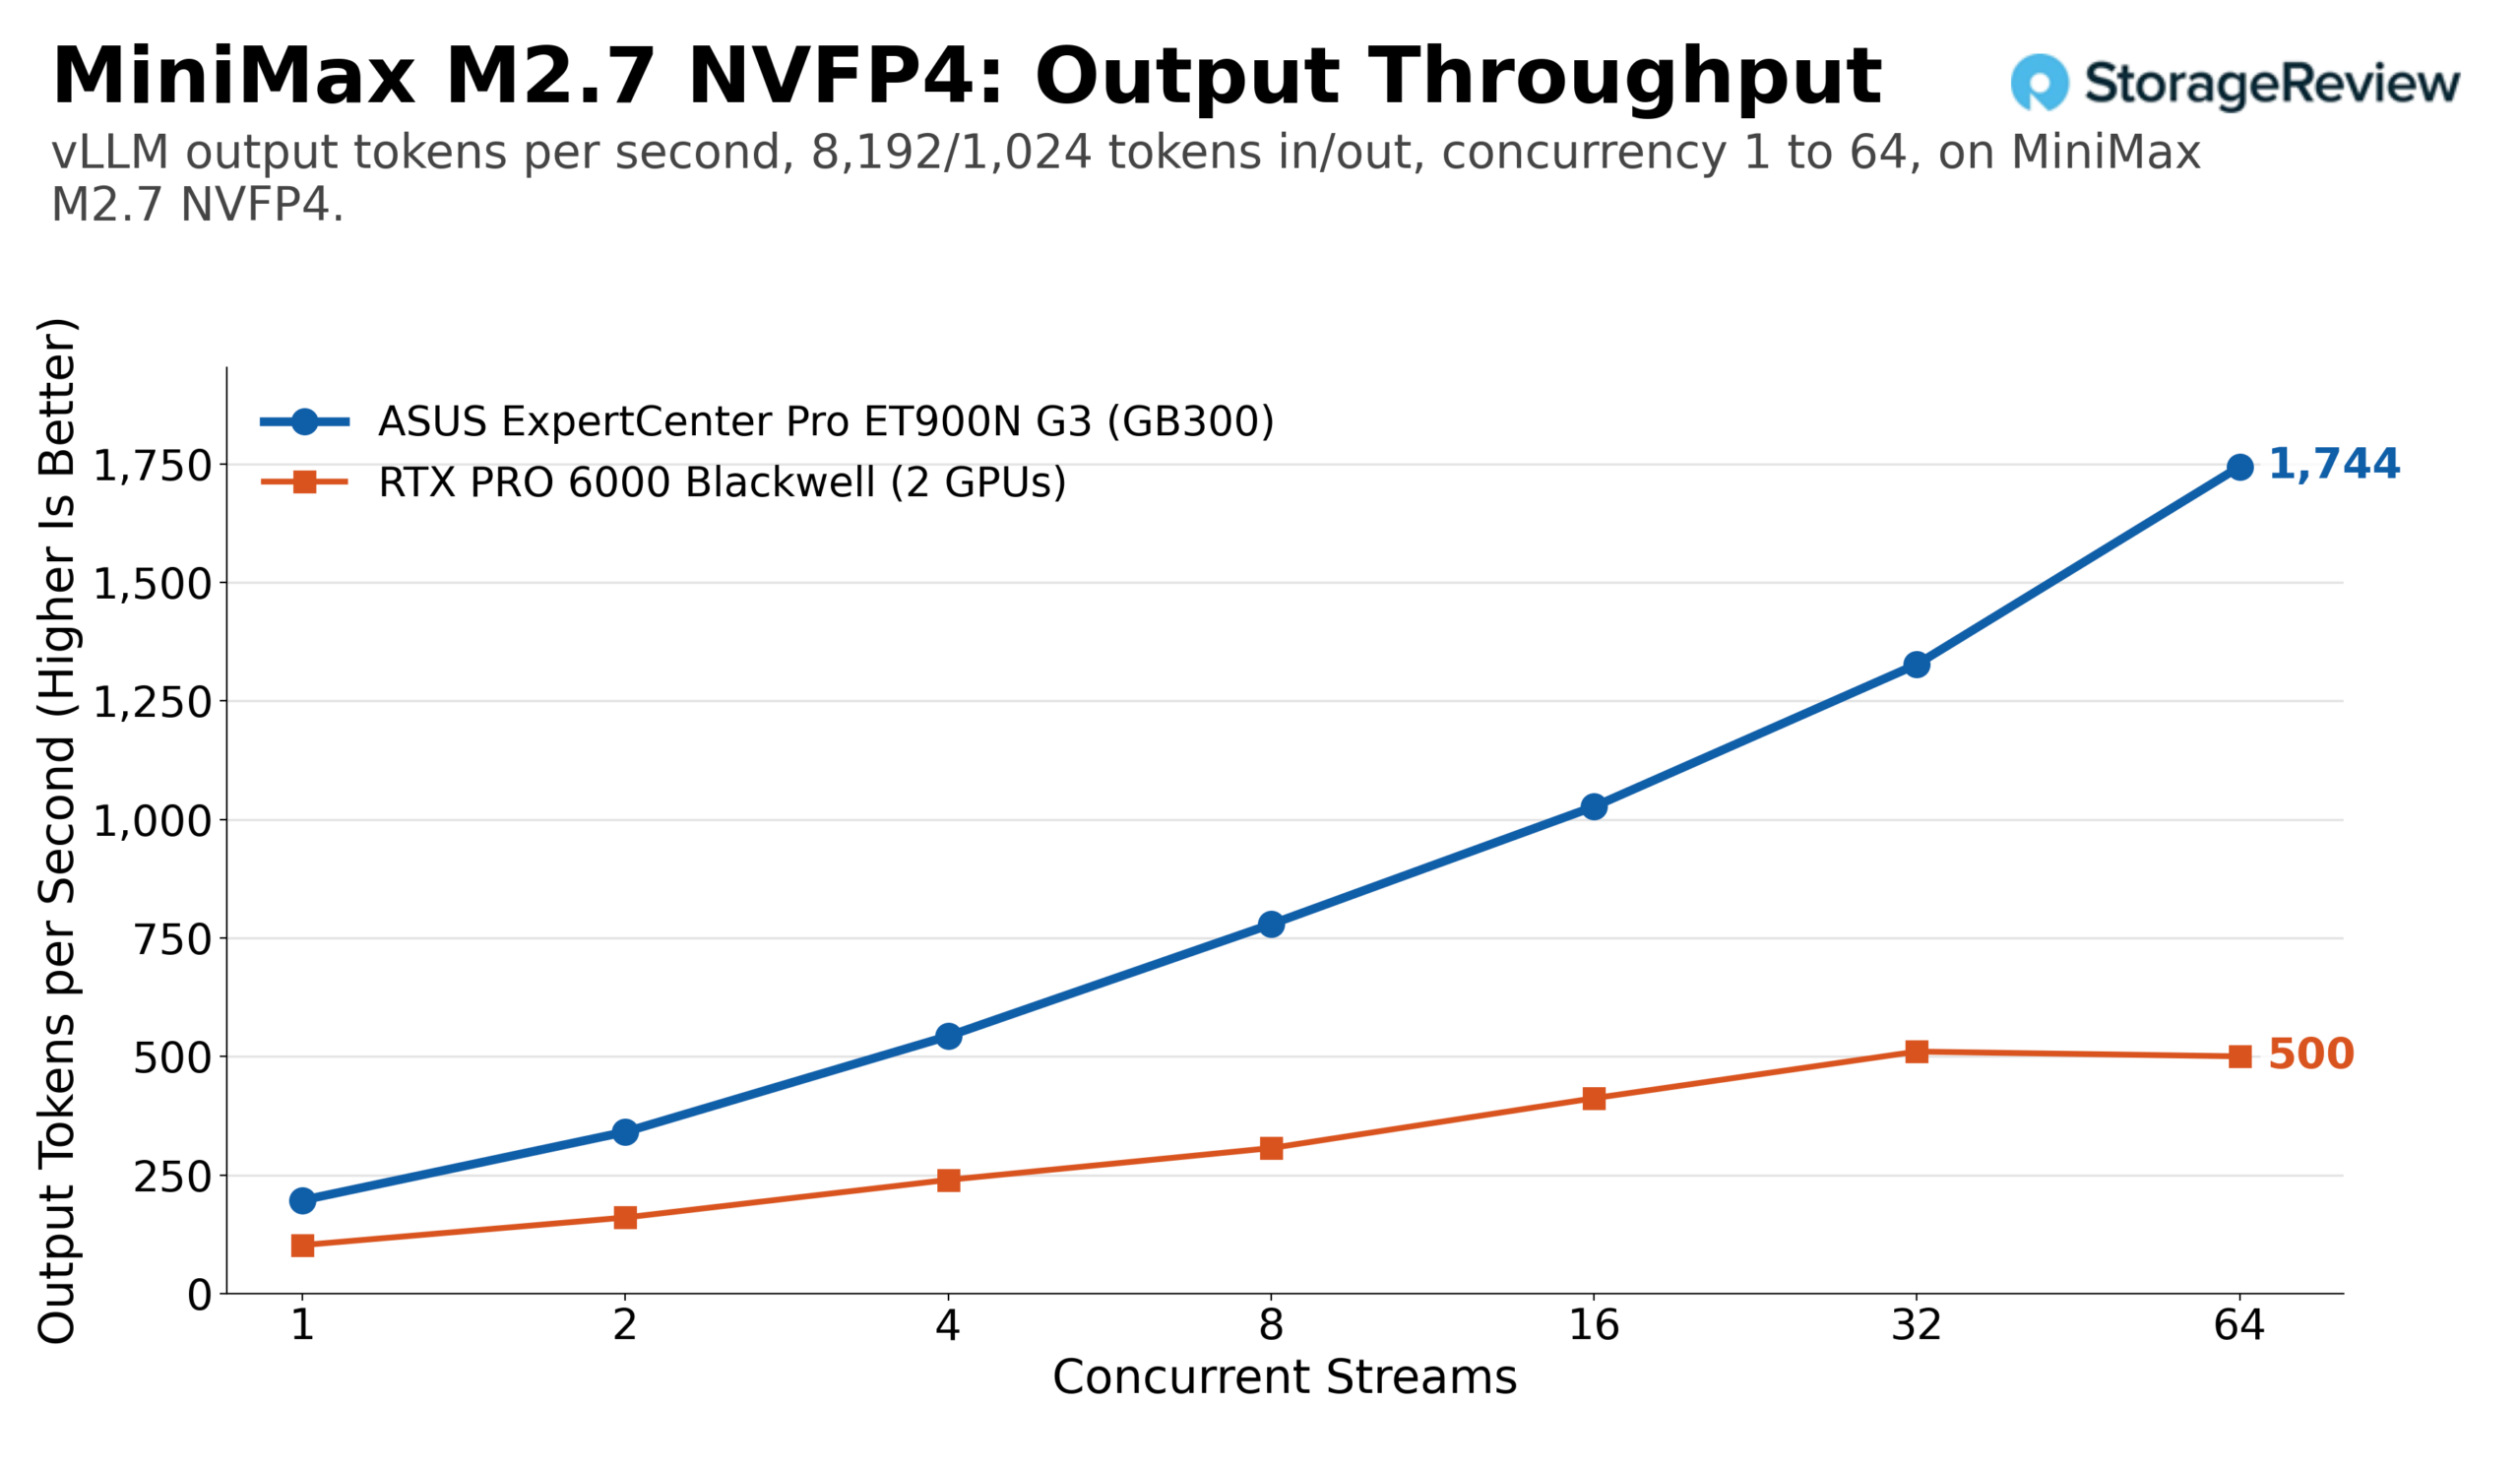
MiniMax M2.7 i NVIDIAs NVFP4-kvantisering upptar cirka 125 GB HBM och skalade längst av de fyra. Den lika stora arbetsbelastningen ökade från 214 utdatatokens per sekund på en ström till 4 793 på 128 strömmar, och den totala genomströmningen nådde 9 586. Den förfyllningstunga körningen skalade till 1 744 utdatatokens per sekund och totalt 15 700 tokens per sekund vid 64 strömmar. Två RTX PRO 6000-kort följde samma form på mindre än halva höjden, med en topp på nära 1 930 utdatatokens per sekund på samma arbetsbelastning och cirka 510 på de långa prompterna.
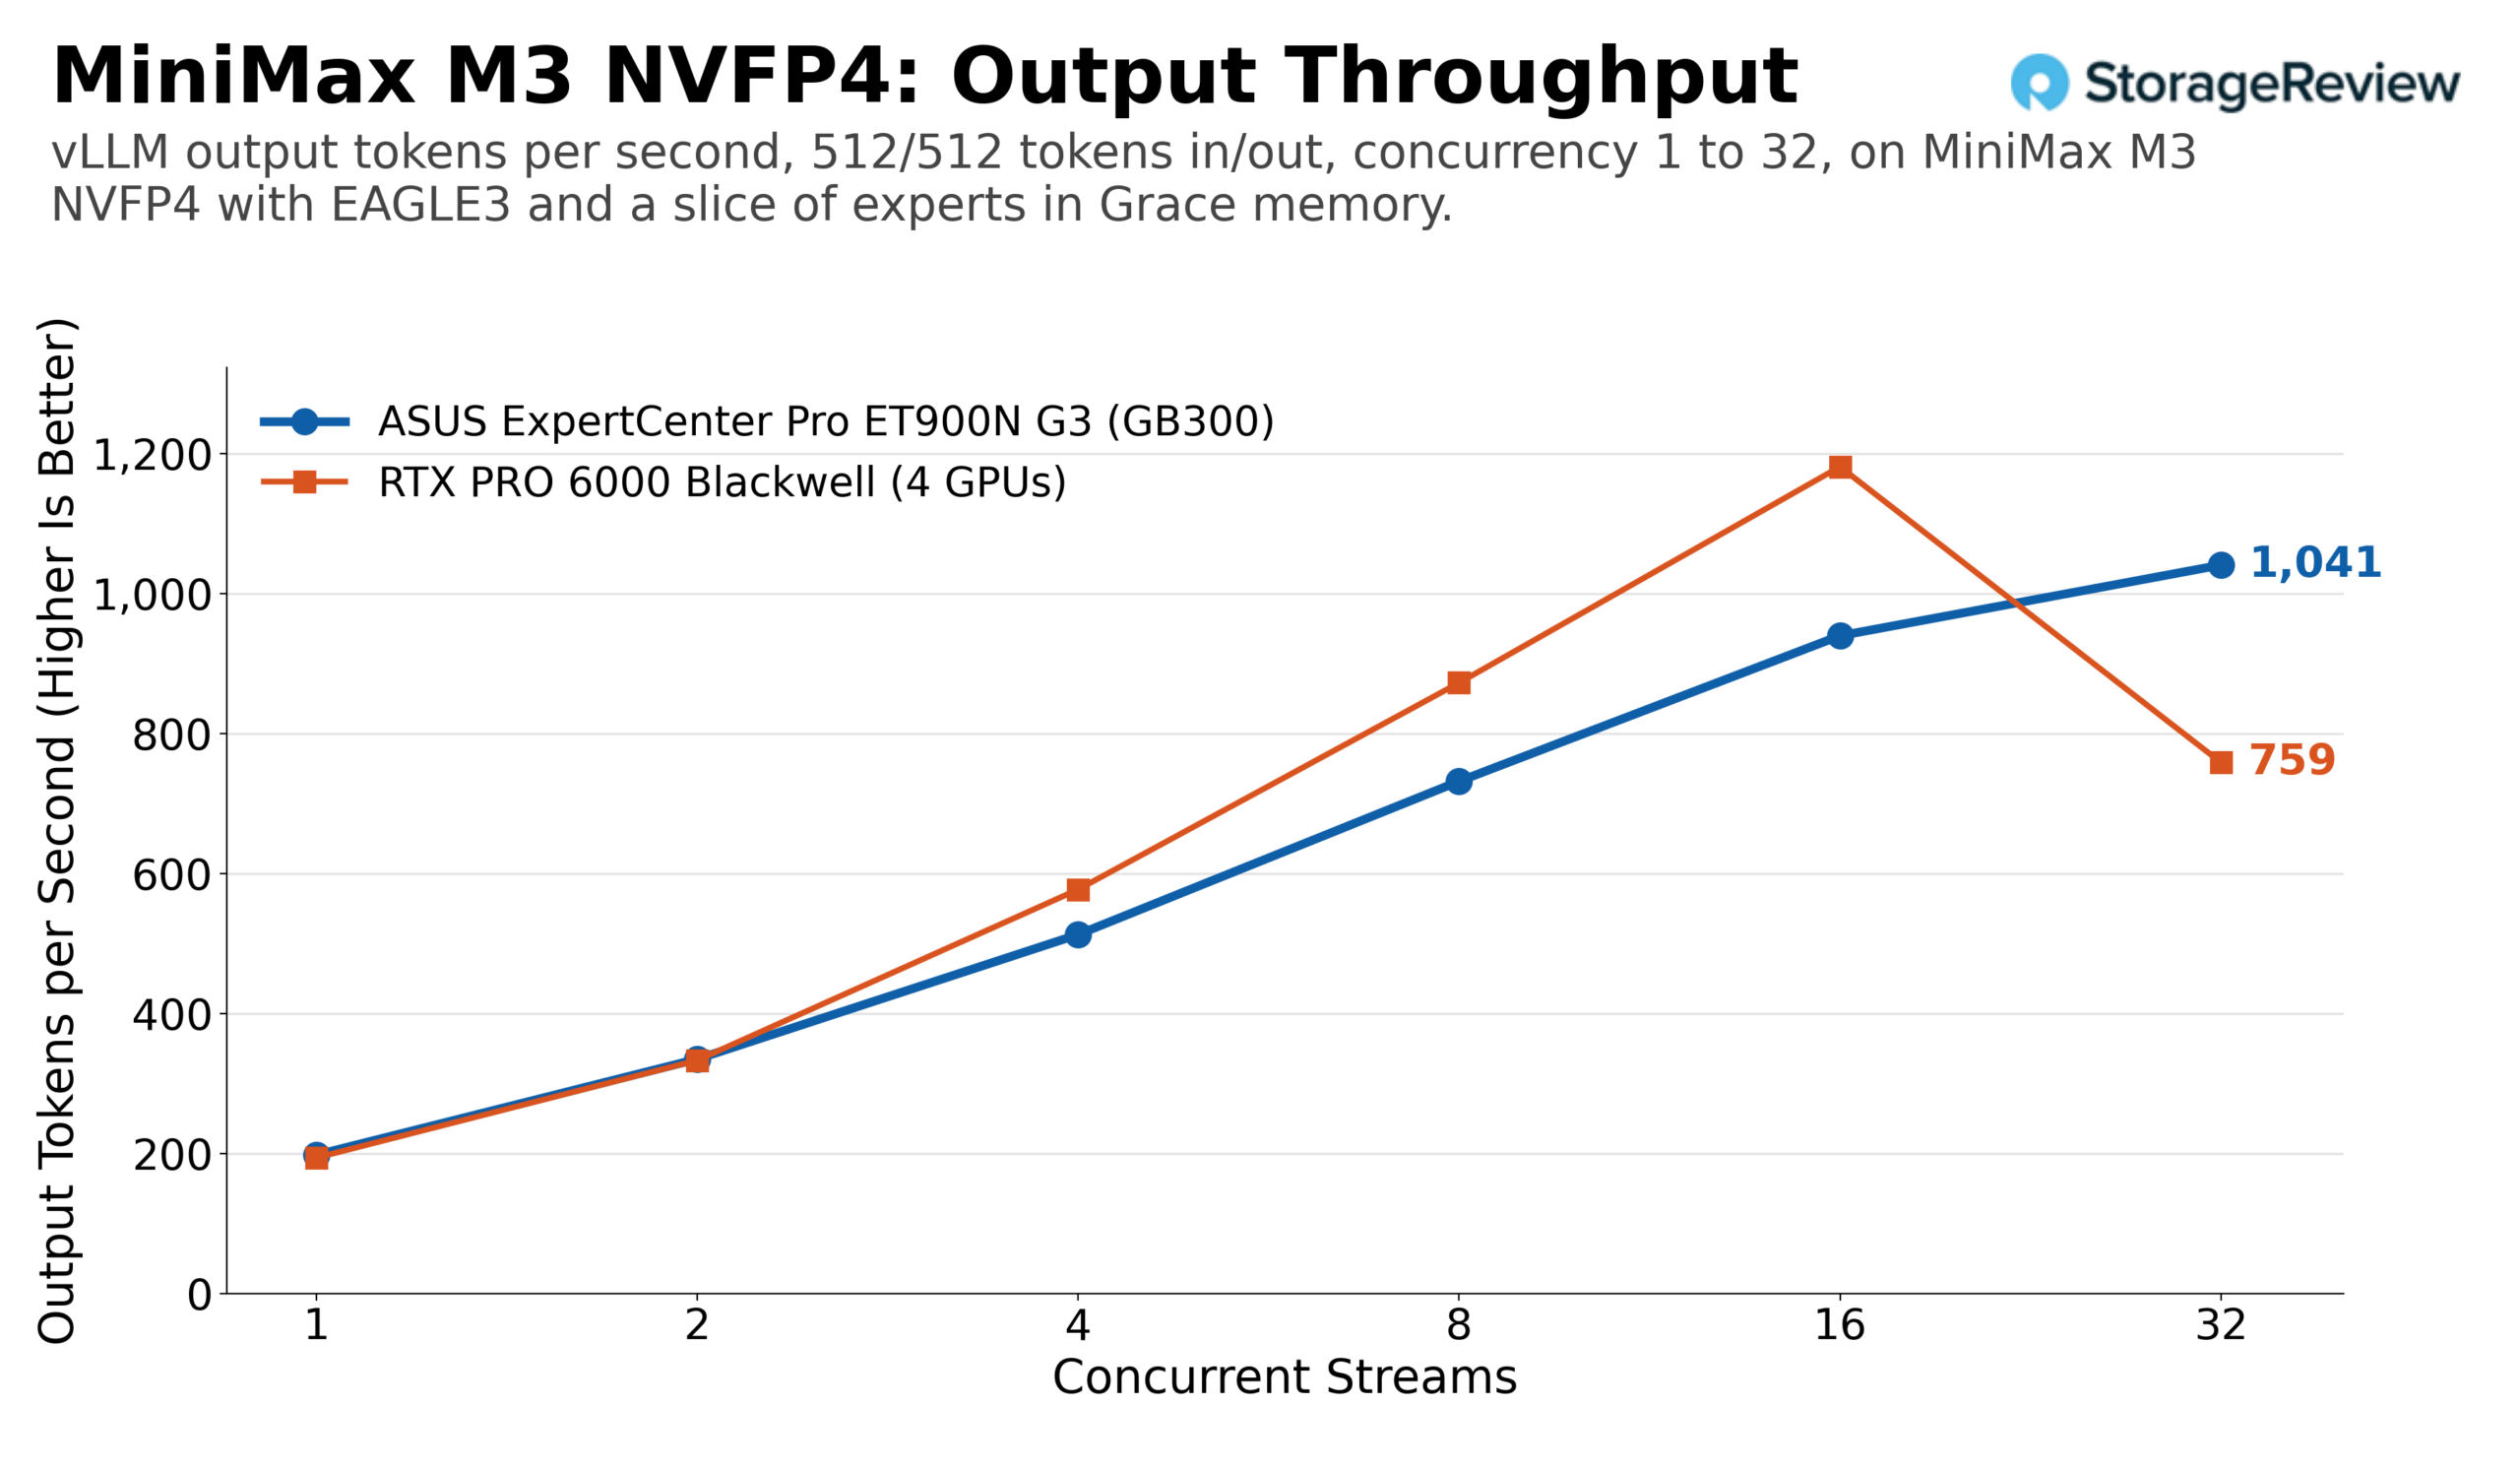
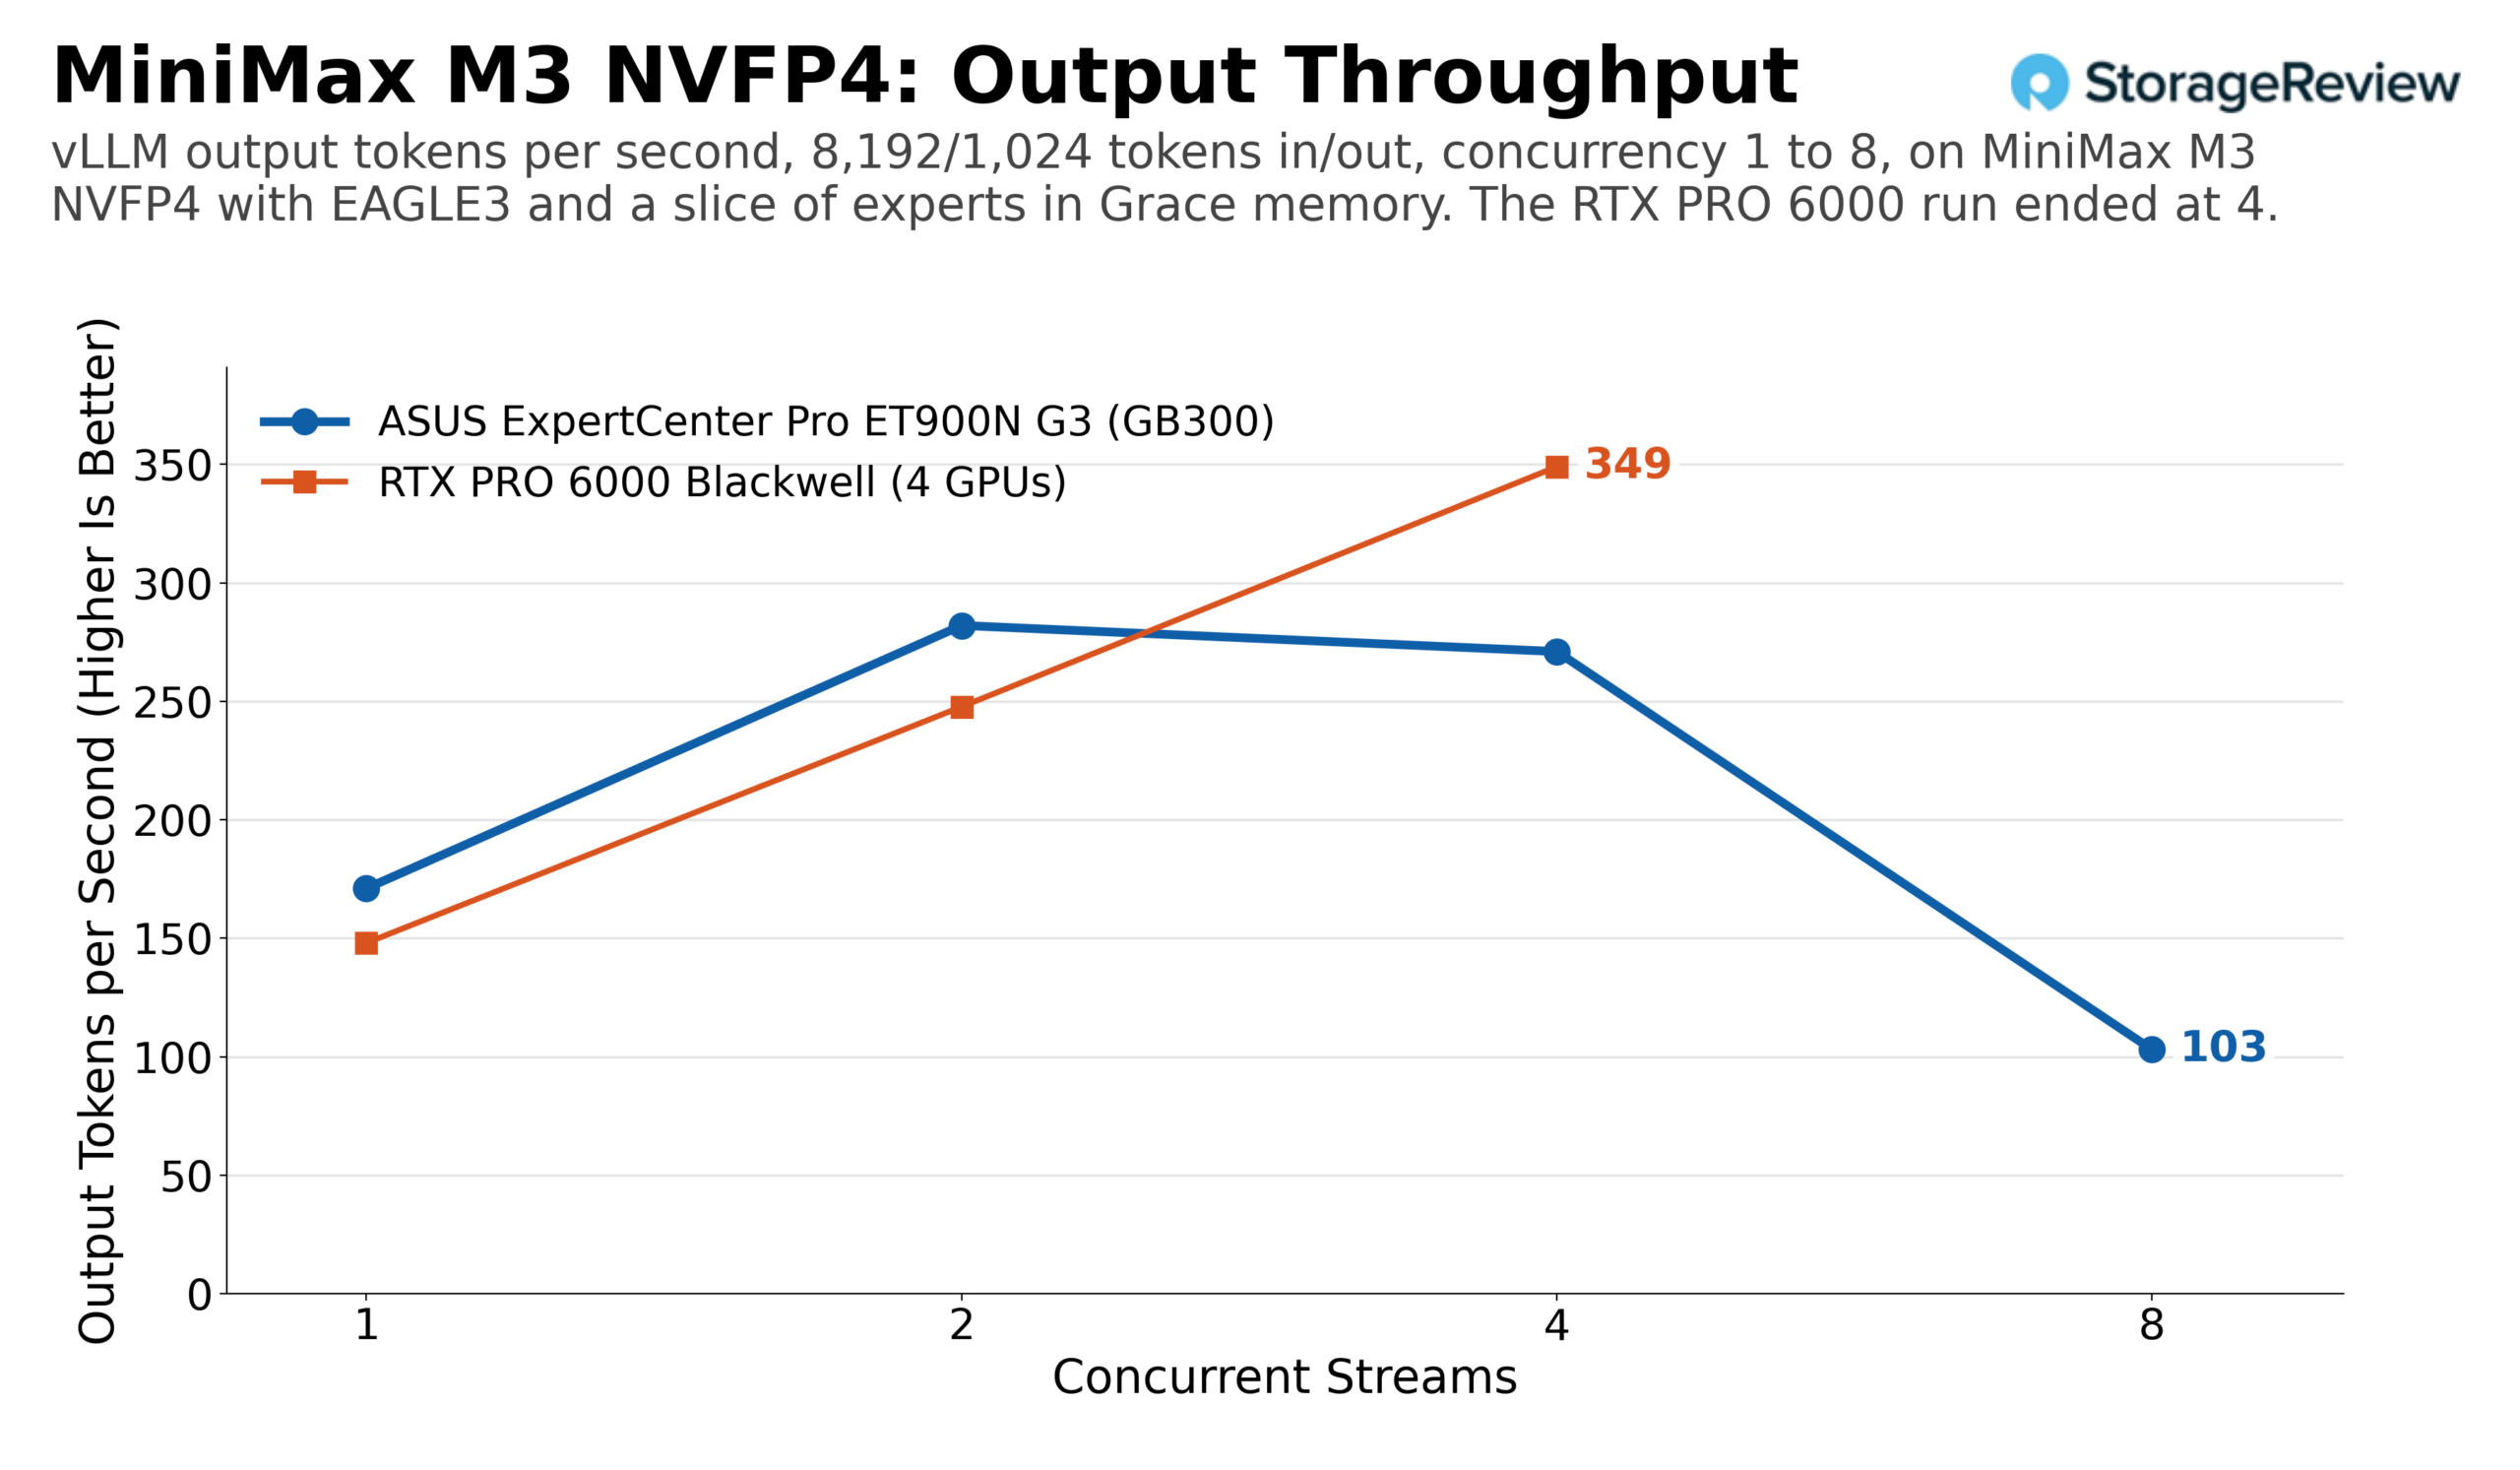
MiniMax M3 visar hur det är att knappt få plats i minnet. NVFP4-kontrollpunkten är mindre än 252 GB, men runtime- och KV-cachen behöver också utrymme, så en del av experterna finns i Grace-minnet, och varje avkodningssteg som berör dem korsar NVLink-C2C. Med spekulativ avkodning av EAGLE3 nådde ET900N G3 1 041 utdatatokens per sekund vid 32 strömmar med samma arbetsbelastning, och den förfyllningstunga profilen nådde sin topp på 282 vid två strömmar, höll 271 vid fyra och sjönk till 103 vid åtta när de långa prompterna förbrukade den återstående cachen. Fyra RTX PRO 6000-kort med samma spekulativa avkodare höll jämna steg genom åtta strömmar och drog ledningen vid 16 strömmar med cirka 1 180 utdatatokens per sekund, för att sedan falla tillbaka till ungefär 760 vid 32 strömmar. På den prefill-tunga profilen rymde fyrkortsboxen cirka 349 utdatatokens per sekund vid fyra strömmar jämfört med Stationens 271. En modell som ligger precis vid HBM-gränsen är det enda stället i den här uppsättningen där 384 GB VRAM över fyra kort konkurrerar med 252 GB HBM plus offload.
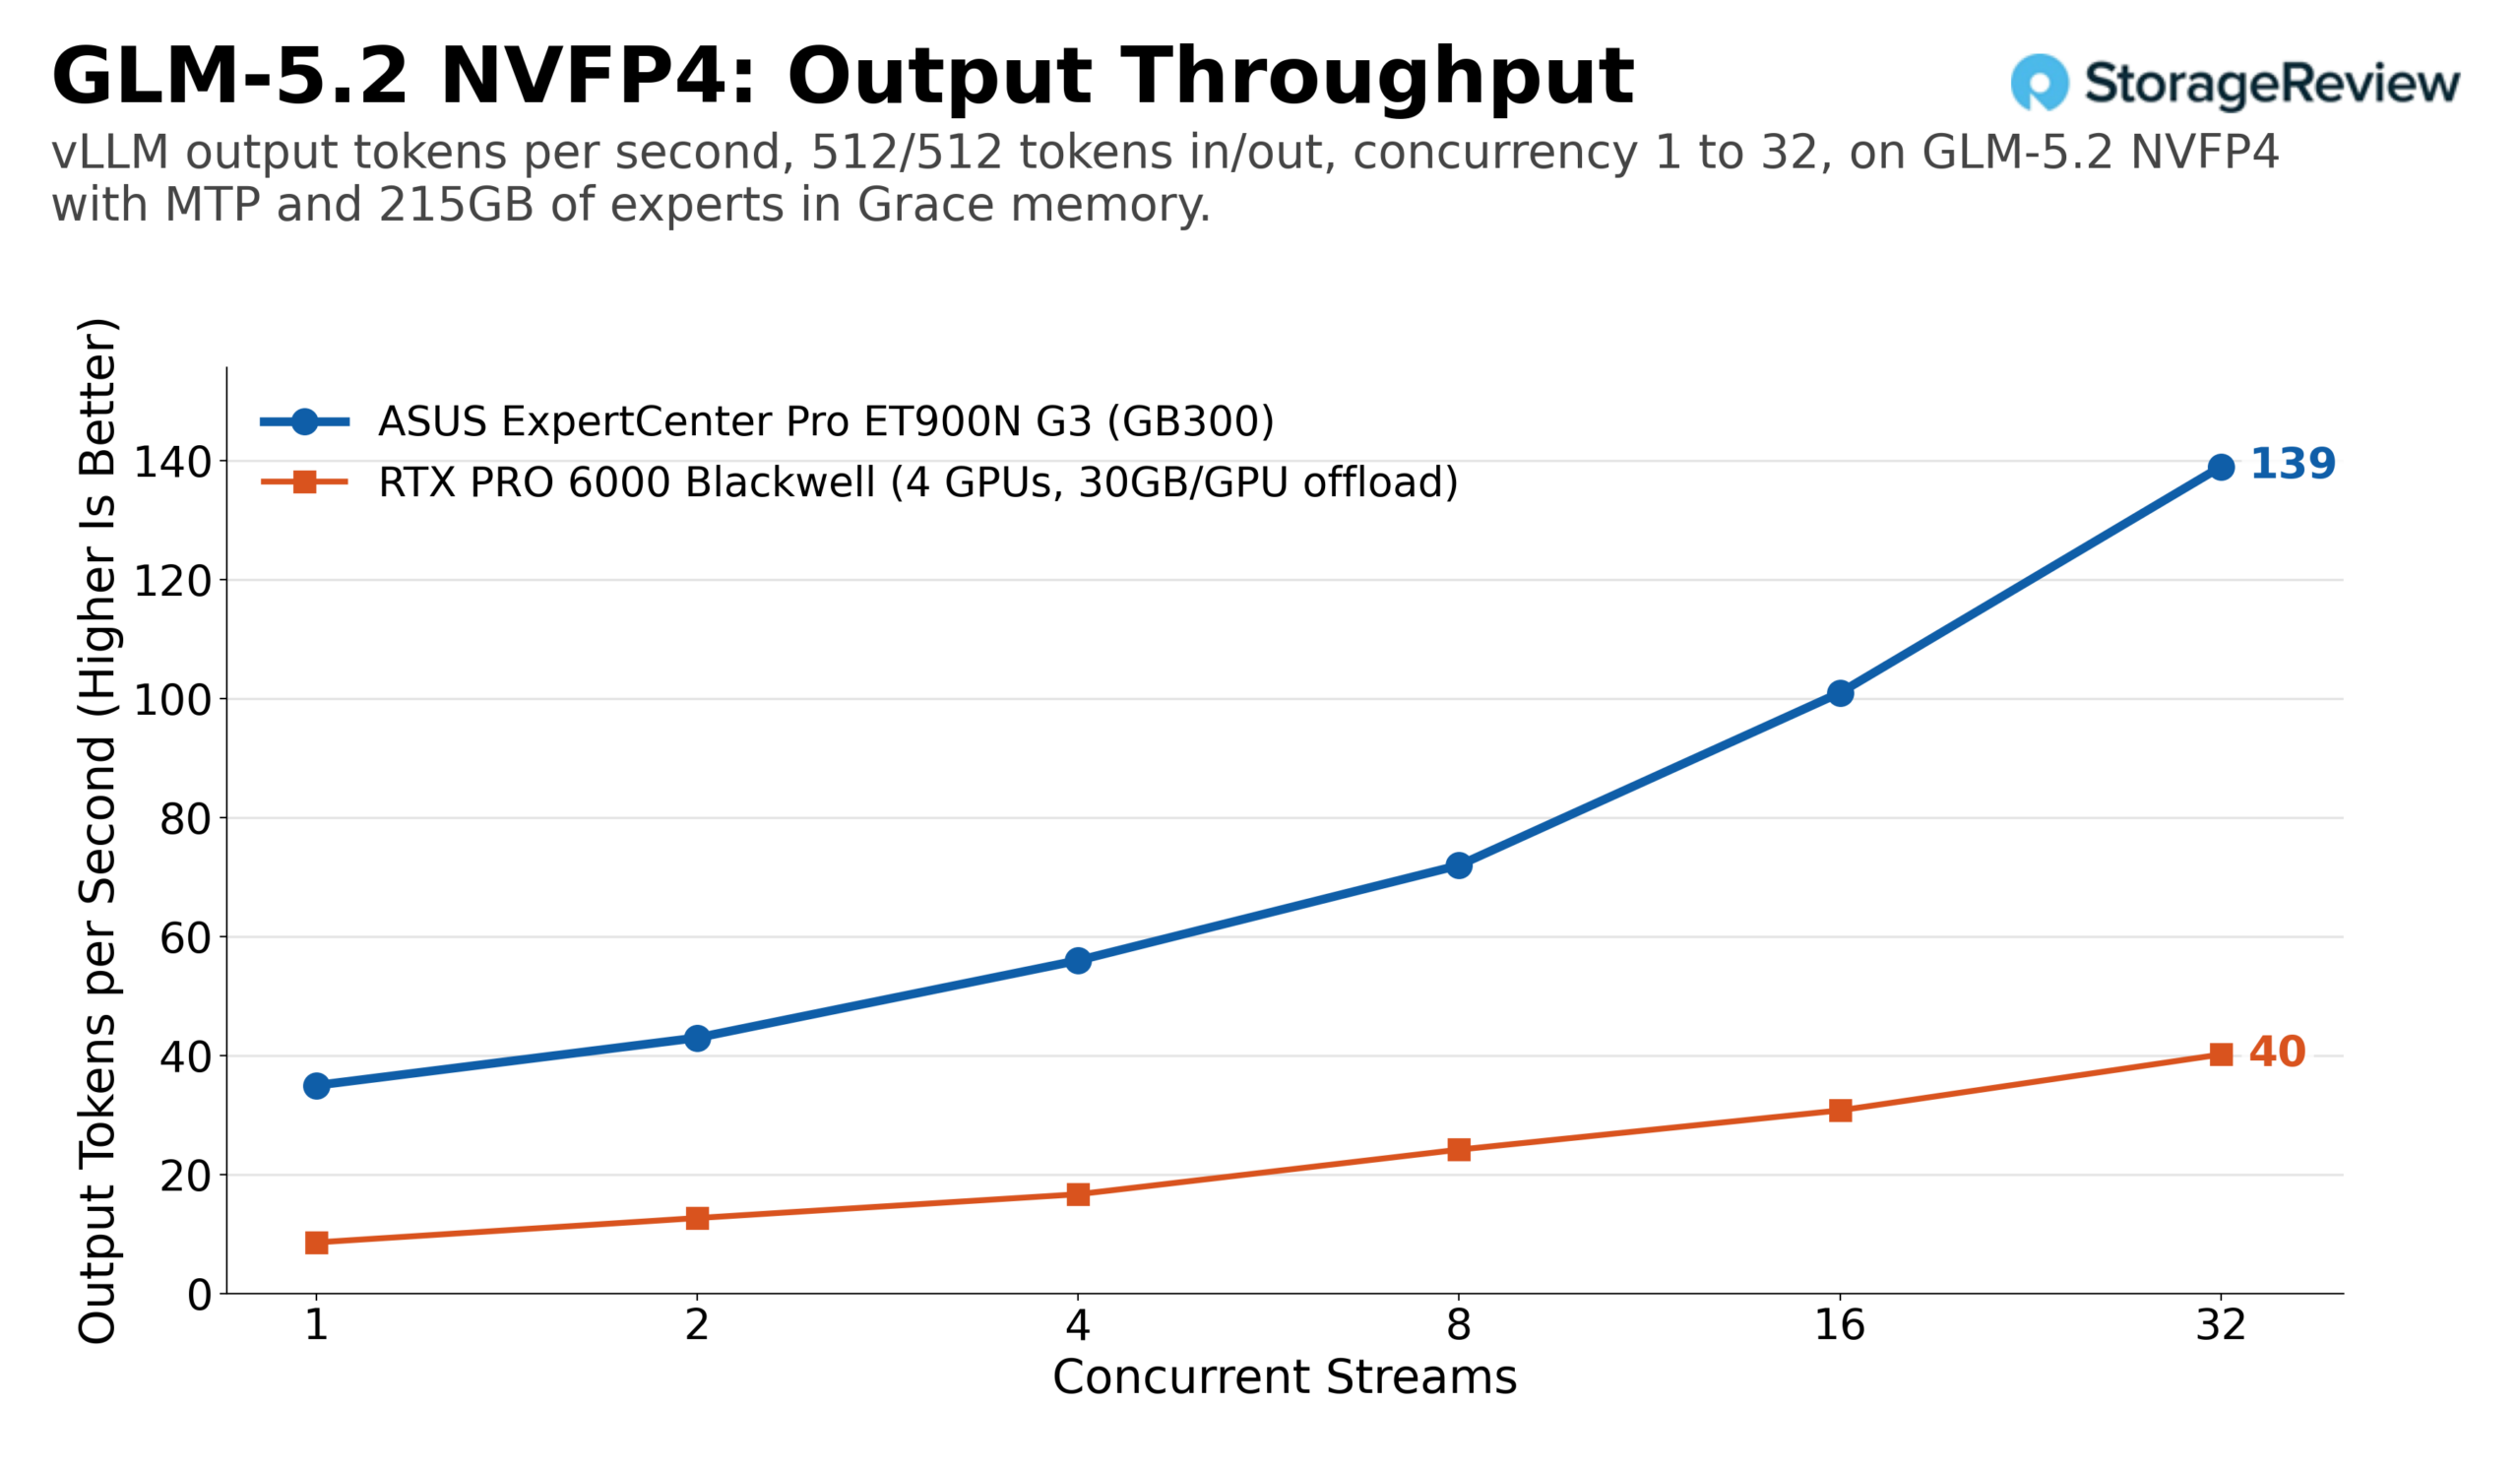
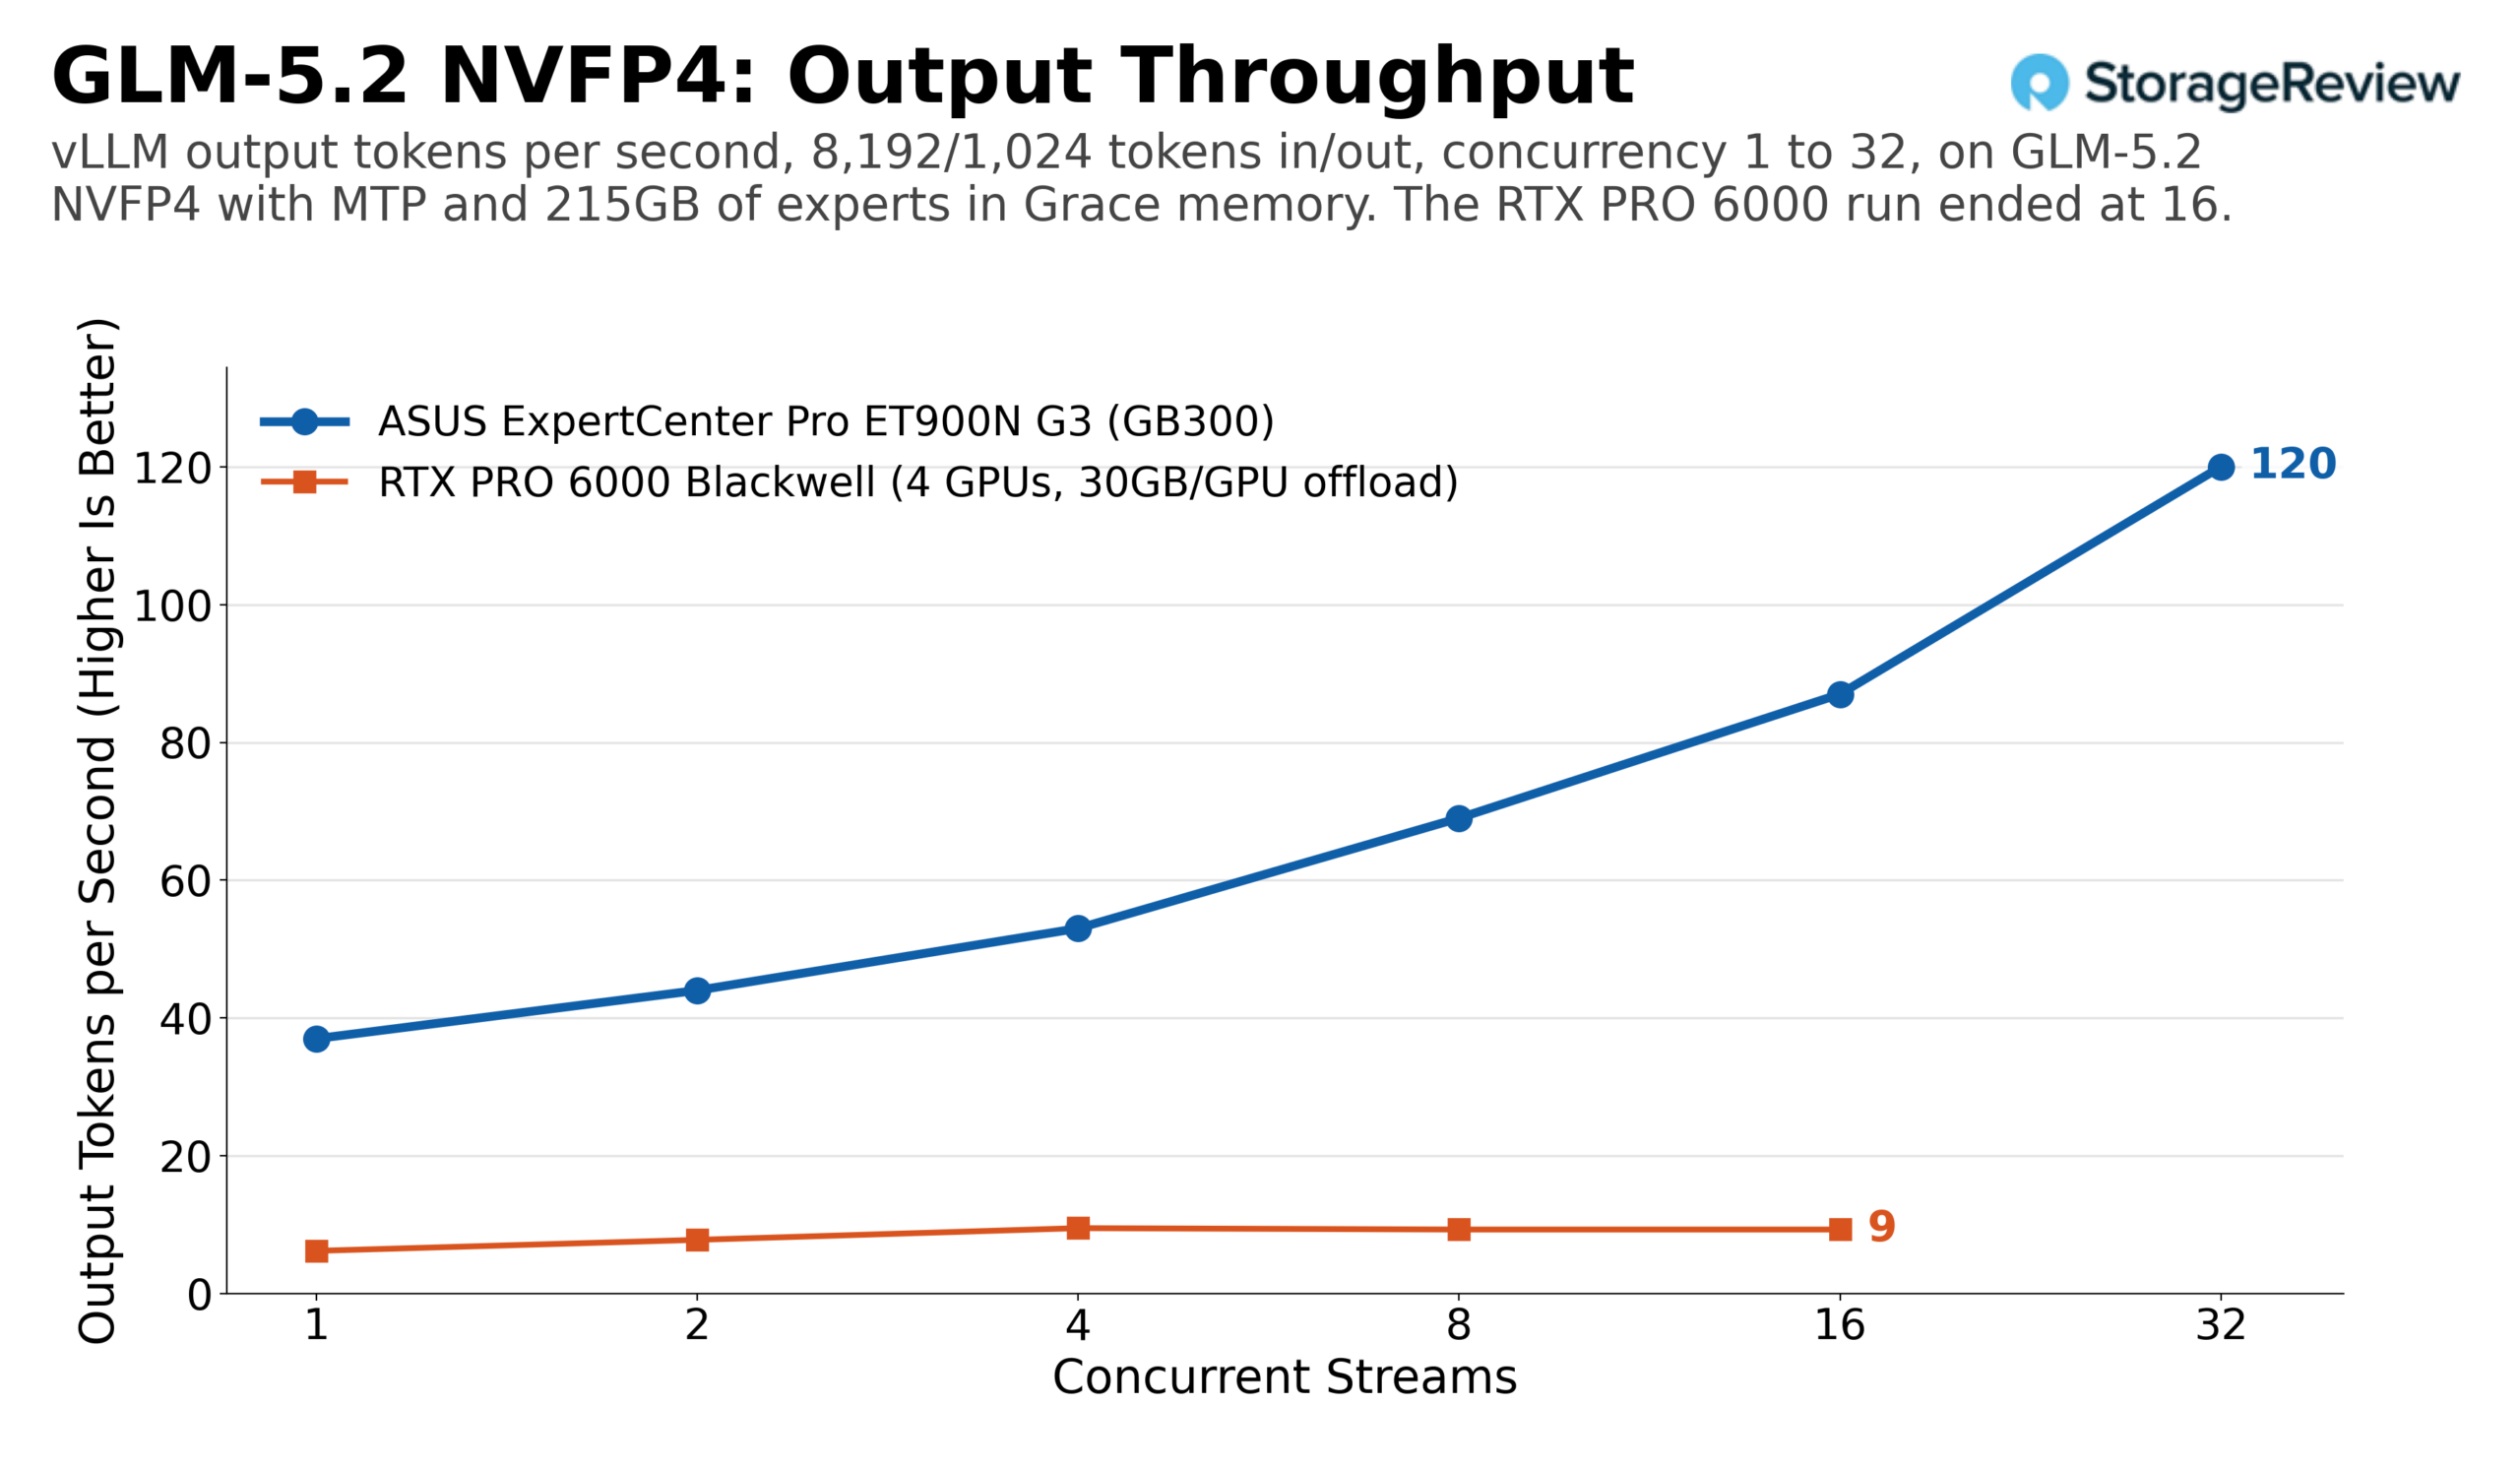
GLM-5.2 är det användningsfall som endast den koherenta poolen möjliggör. NVFP4-kontrollpunkten lagrar cirka 215 GB expertvikter i Grace-minne med spekulativ MTP-avkodning, och ET900N G3 hanterade den med 35 utdatatokens per sekund för en ström och 139 för 32 strömmar på samma arbetsbelastning, med en total genomströmning på 277. På den förfyllningstunga profilen gick svepningen till 32 strömmar, vilket nådde 120 utdatatokens per sekund och 1 079 totala tokens. Fyra RTX PRO 6000-kort, som vart och ett avlastade cirka 30 GB till värdminne, hanterade cirka 40 utdatatokens per sekund vid 32 strömmar, och planade ut till ungefär 9 till 10 på långa prompter från fyra strömmar och framåt. Ingetdera systemen får en 433 GB-modell att kännas snabb, men GB300:s 396 GB/s LPDDR5X och 900 GB/s NVLink-C2C-väg till avlastade experter fortsätter att skalas där PCIe-anslutet värdminne över fyra kort slutar.
Jämfört med MSI WS300 ligger ET900N G3:s resultat för frontmodellen inom cirka 1 % på alla punkter vi kan jämföra: 1 766 utdatatokens per sekund på DeepSeek V4 Flash vid 32 strömmar på båda tornen, 4 793 mot 4 801 på MiniMax M2.7 vid 128, 1 041 på MiniMax M3 vid 32 på båda och 139 på GLM-5.2 vid 32 på båda.
Delade modeller mot RTX PRO 6000, H200 NVL och DGX Spark
Den andra halvan av benchmarkingen använder modeller som är tillräckligt små för att varje system ska kunna hantera dem: GPT-OSS-20B och 120B i native MXFP4; Llama 3.1 8B i BF16 och FP8; Mistral Small 24B i BF16 och FP8; och Qwen3 Coder 30B i BF16 och FP8. Nytt sedan WS300-recensionen är ett enda H200 NVL, NVIDIAs 141 GB Hopper-kort, vilket ger jämförelsen en datacenteraccelerator en generation tillbaka i tiden.
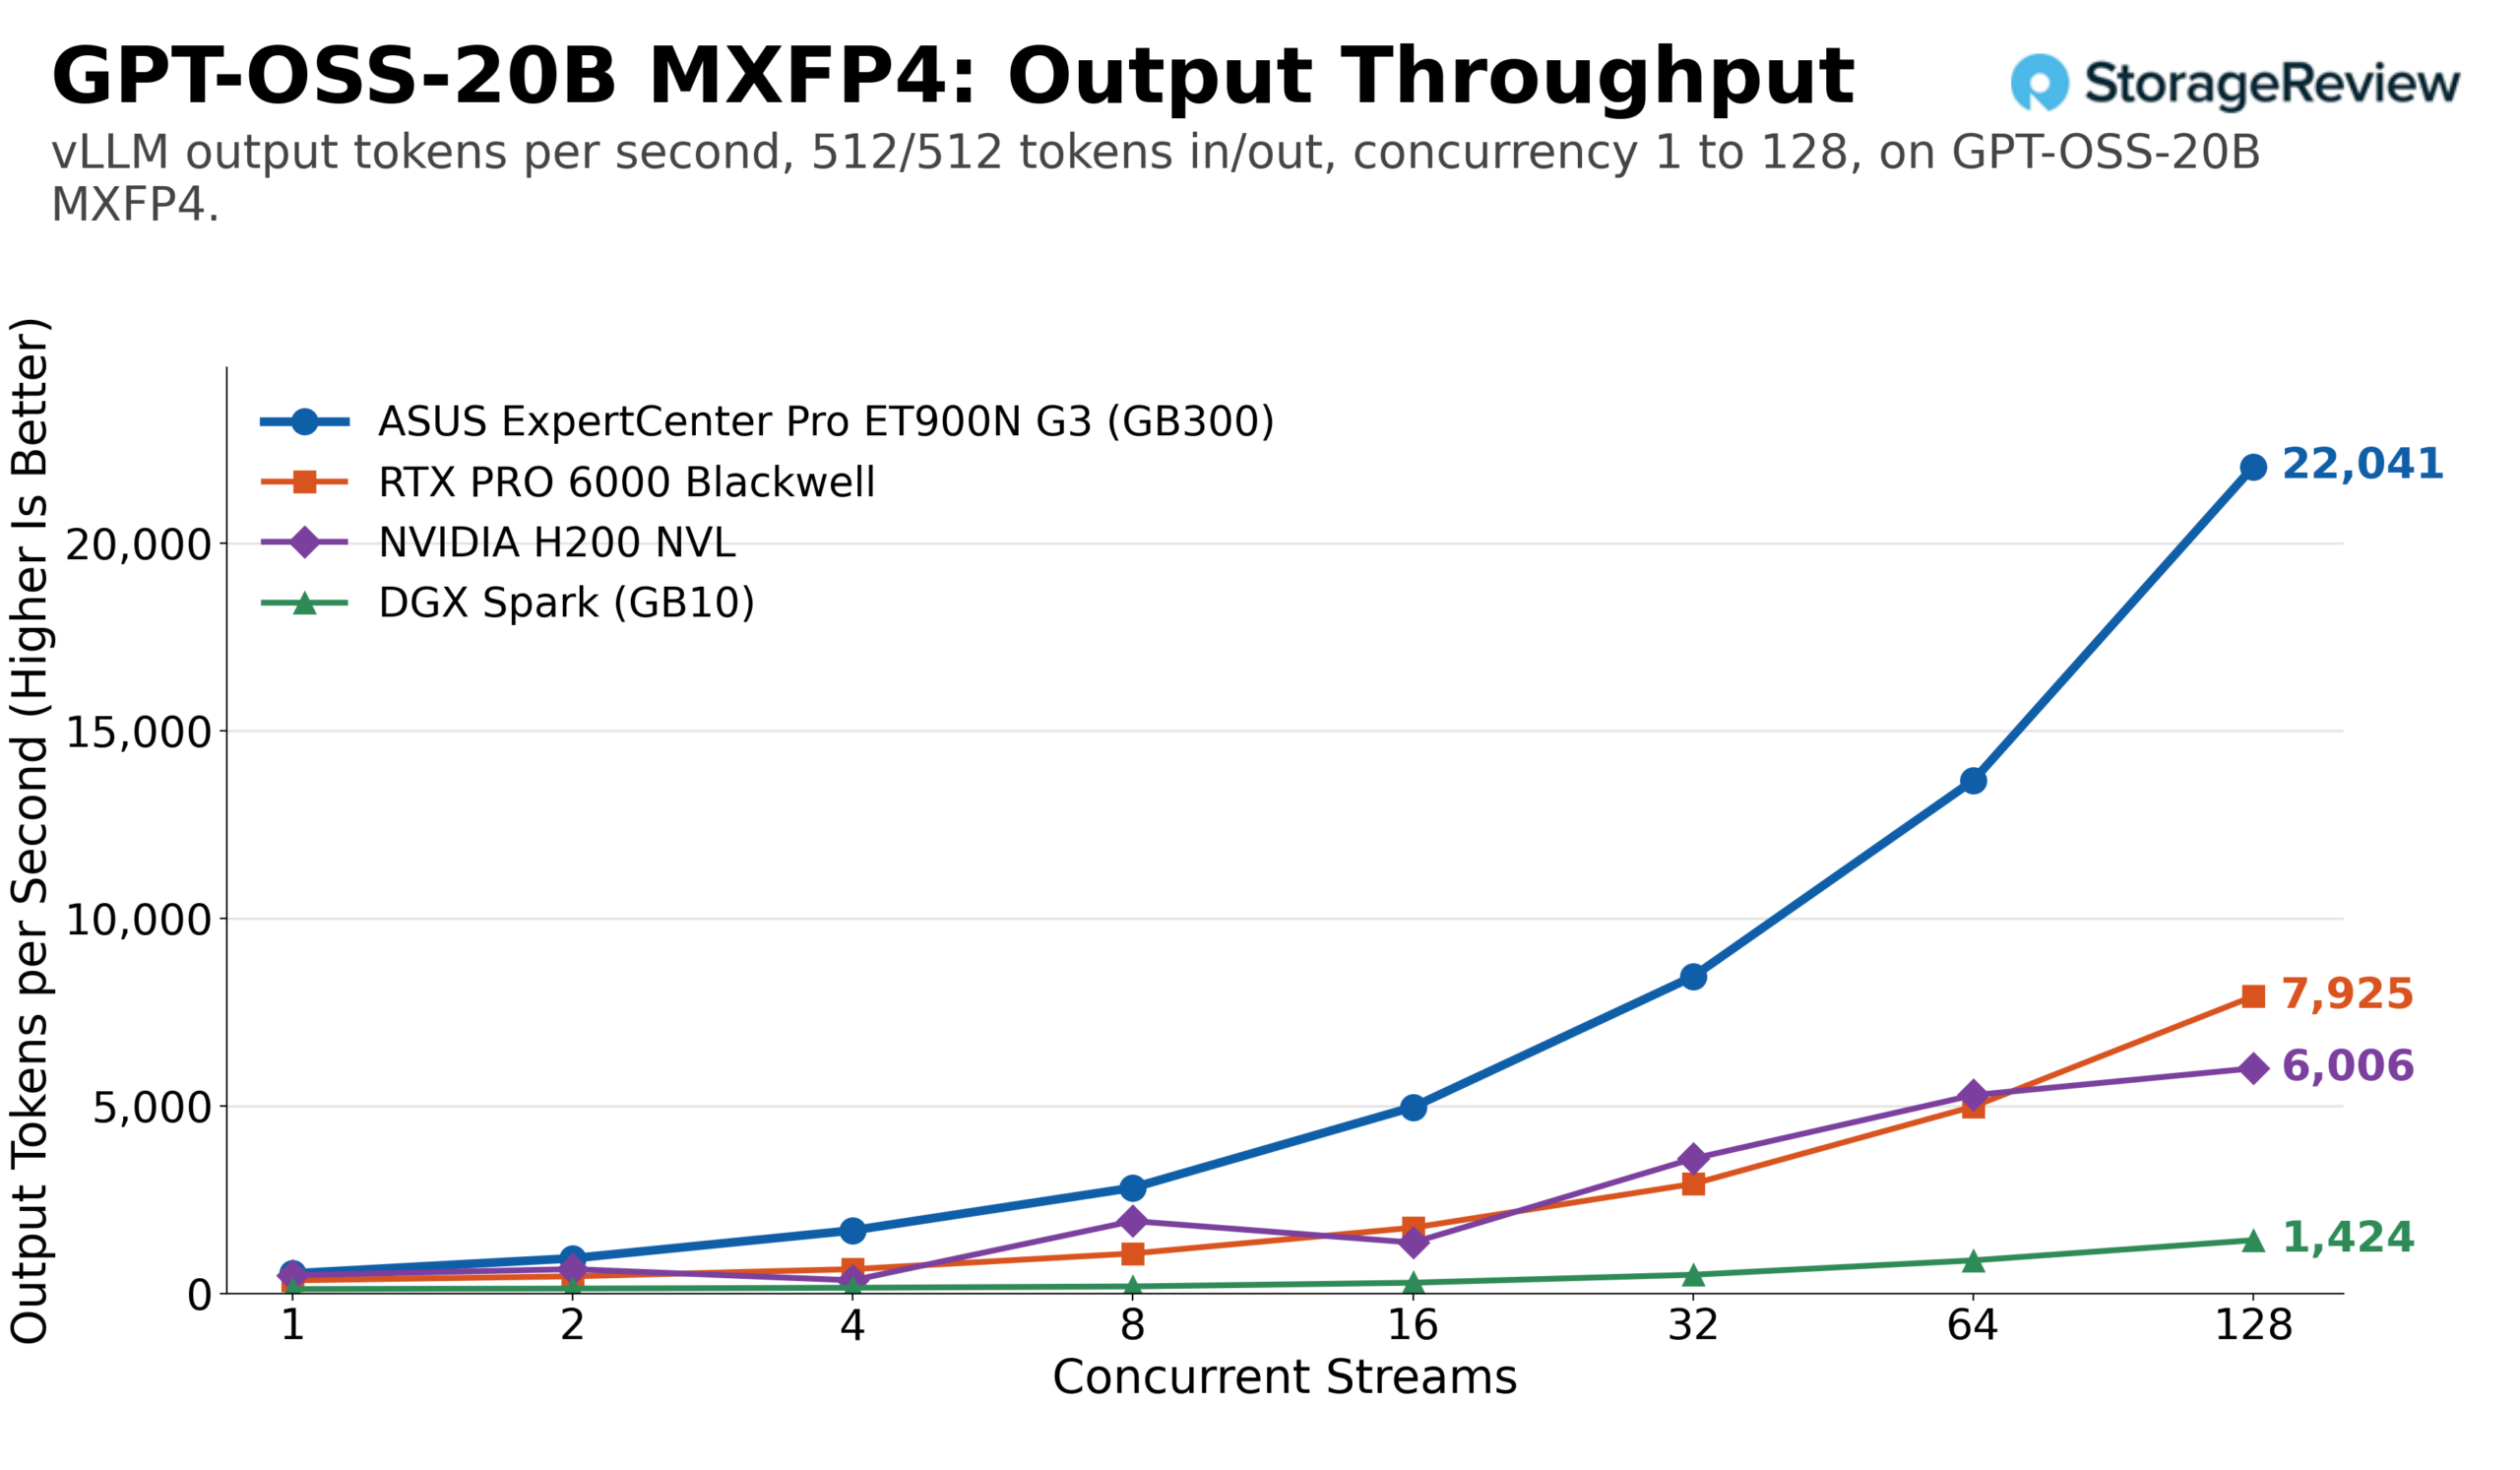
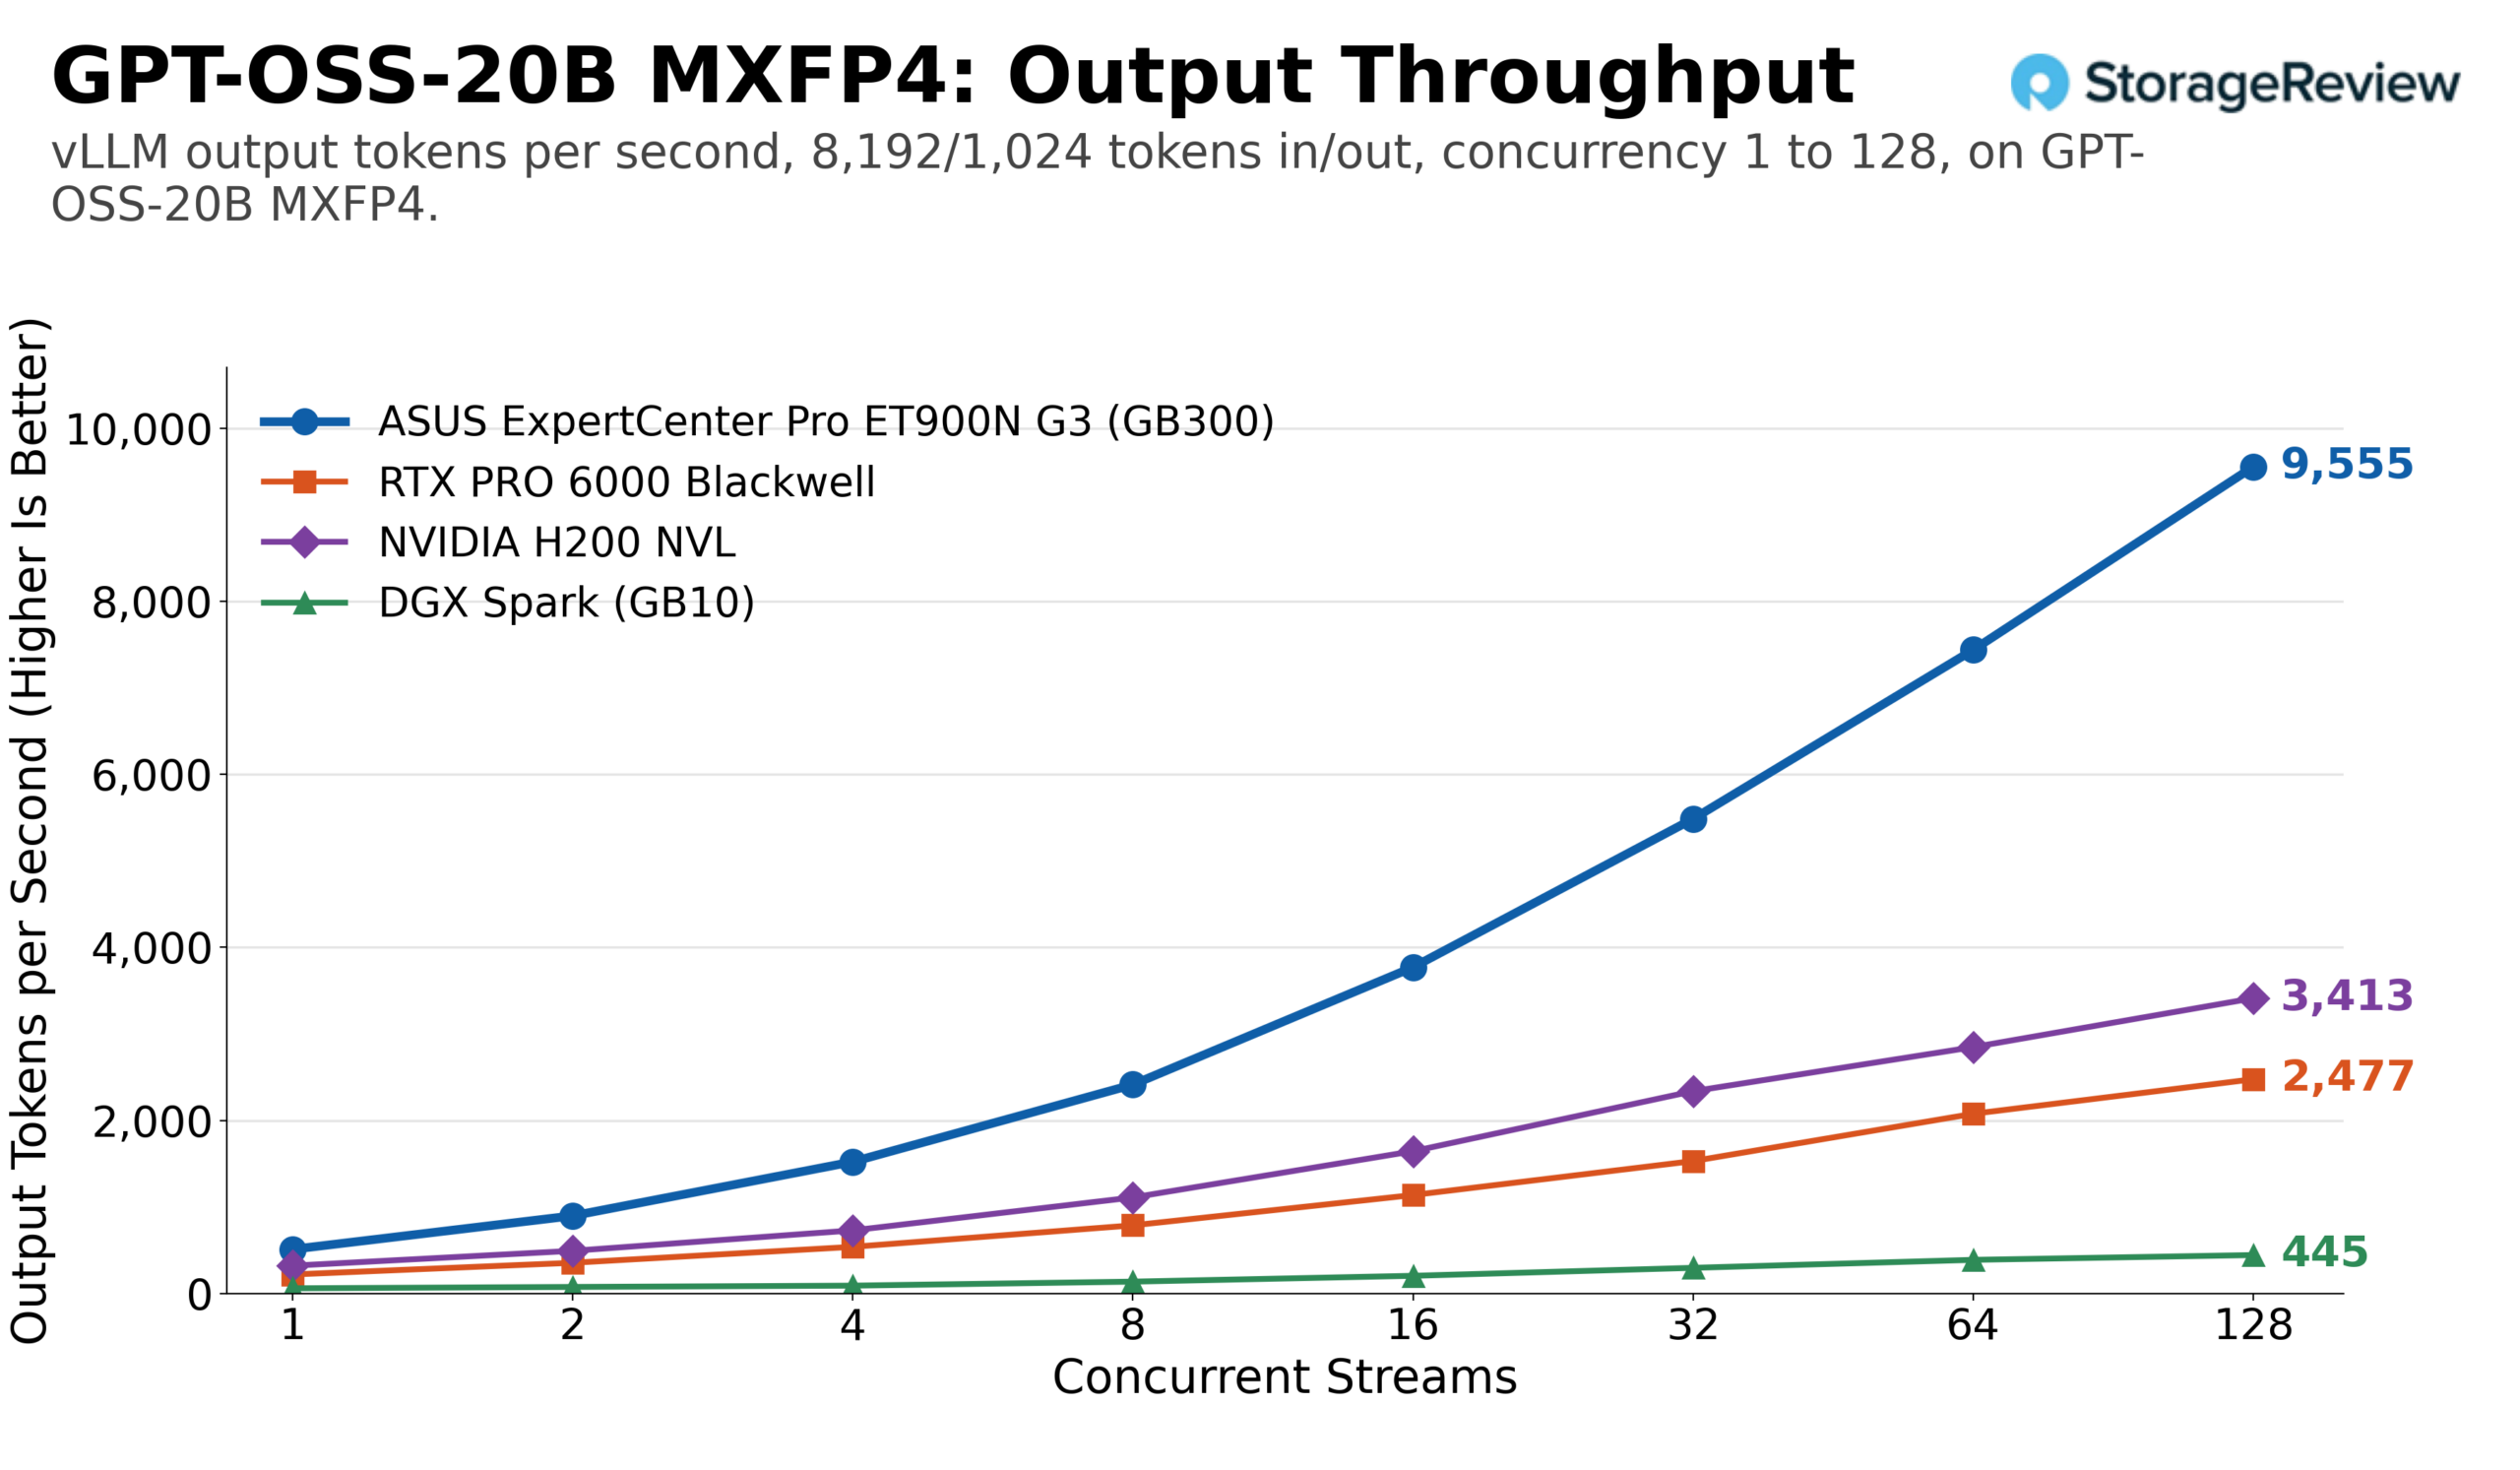
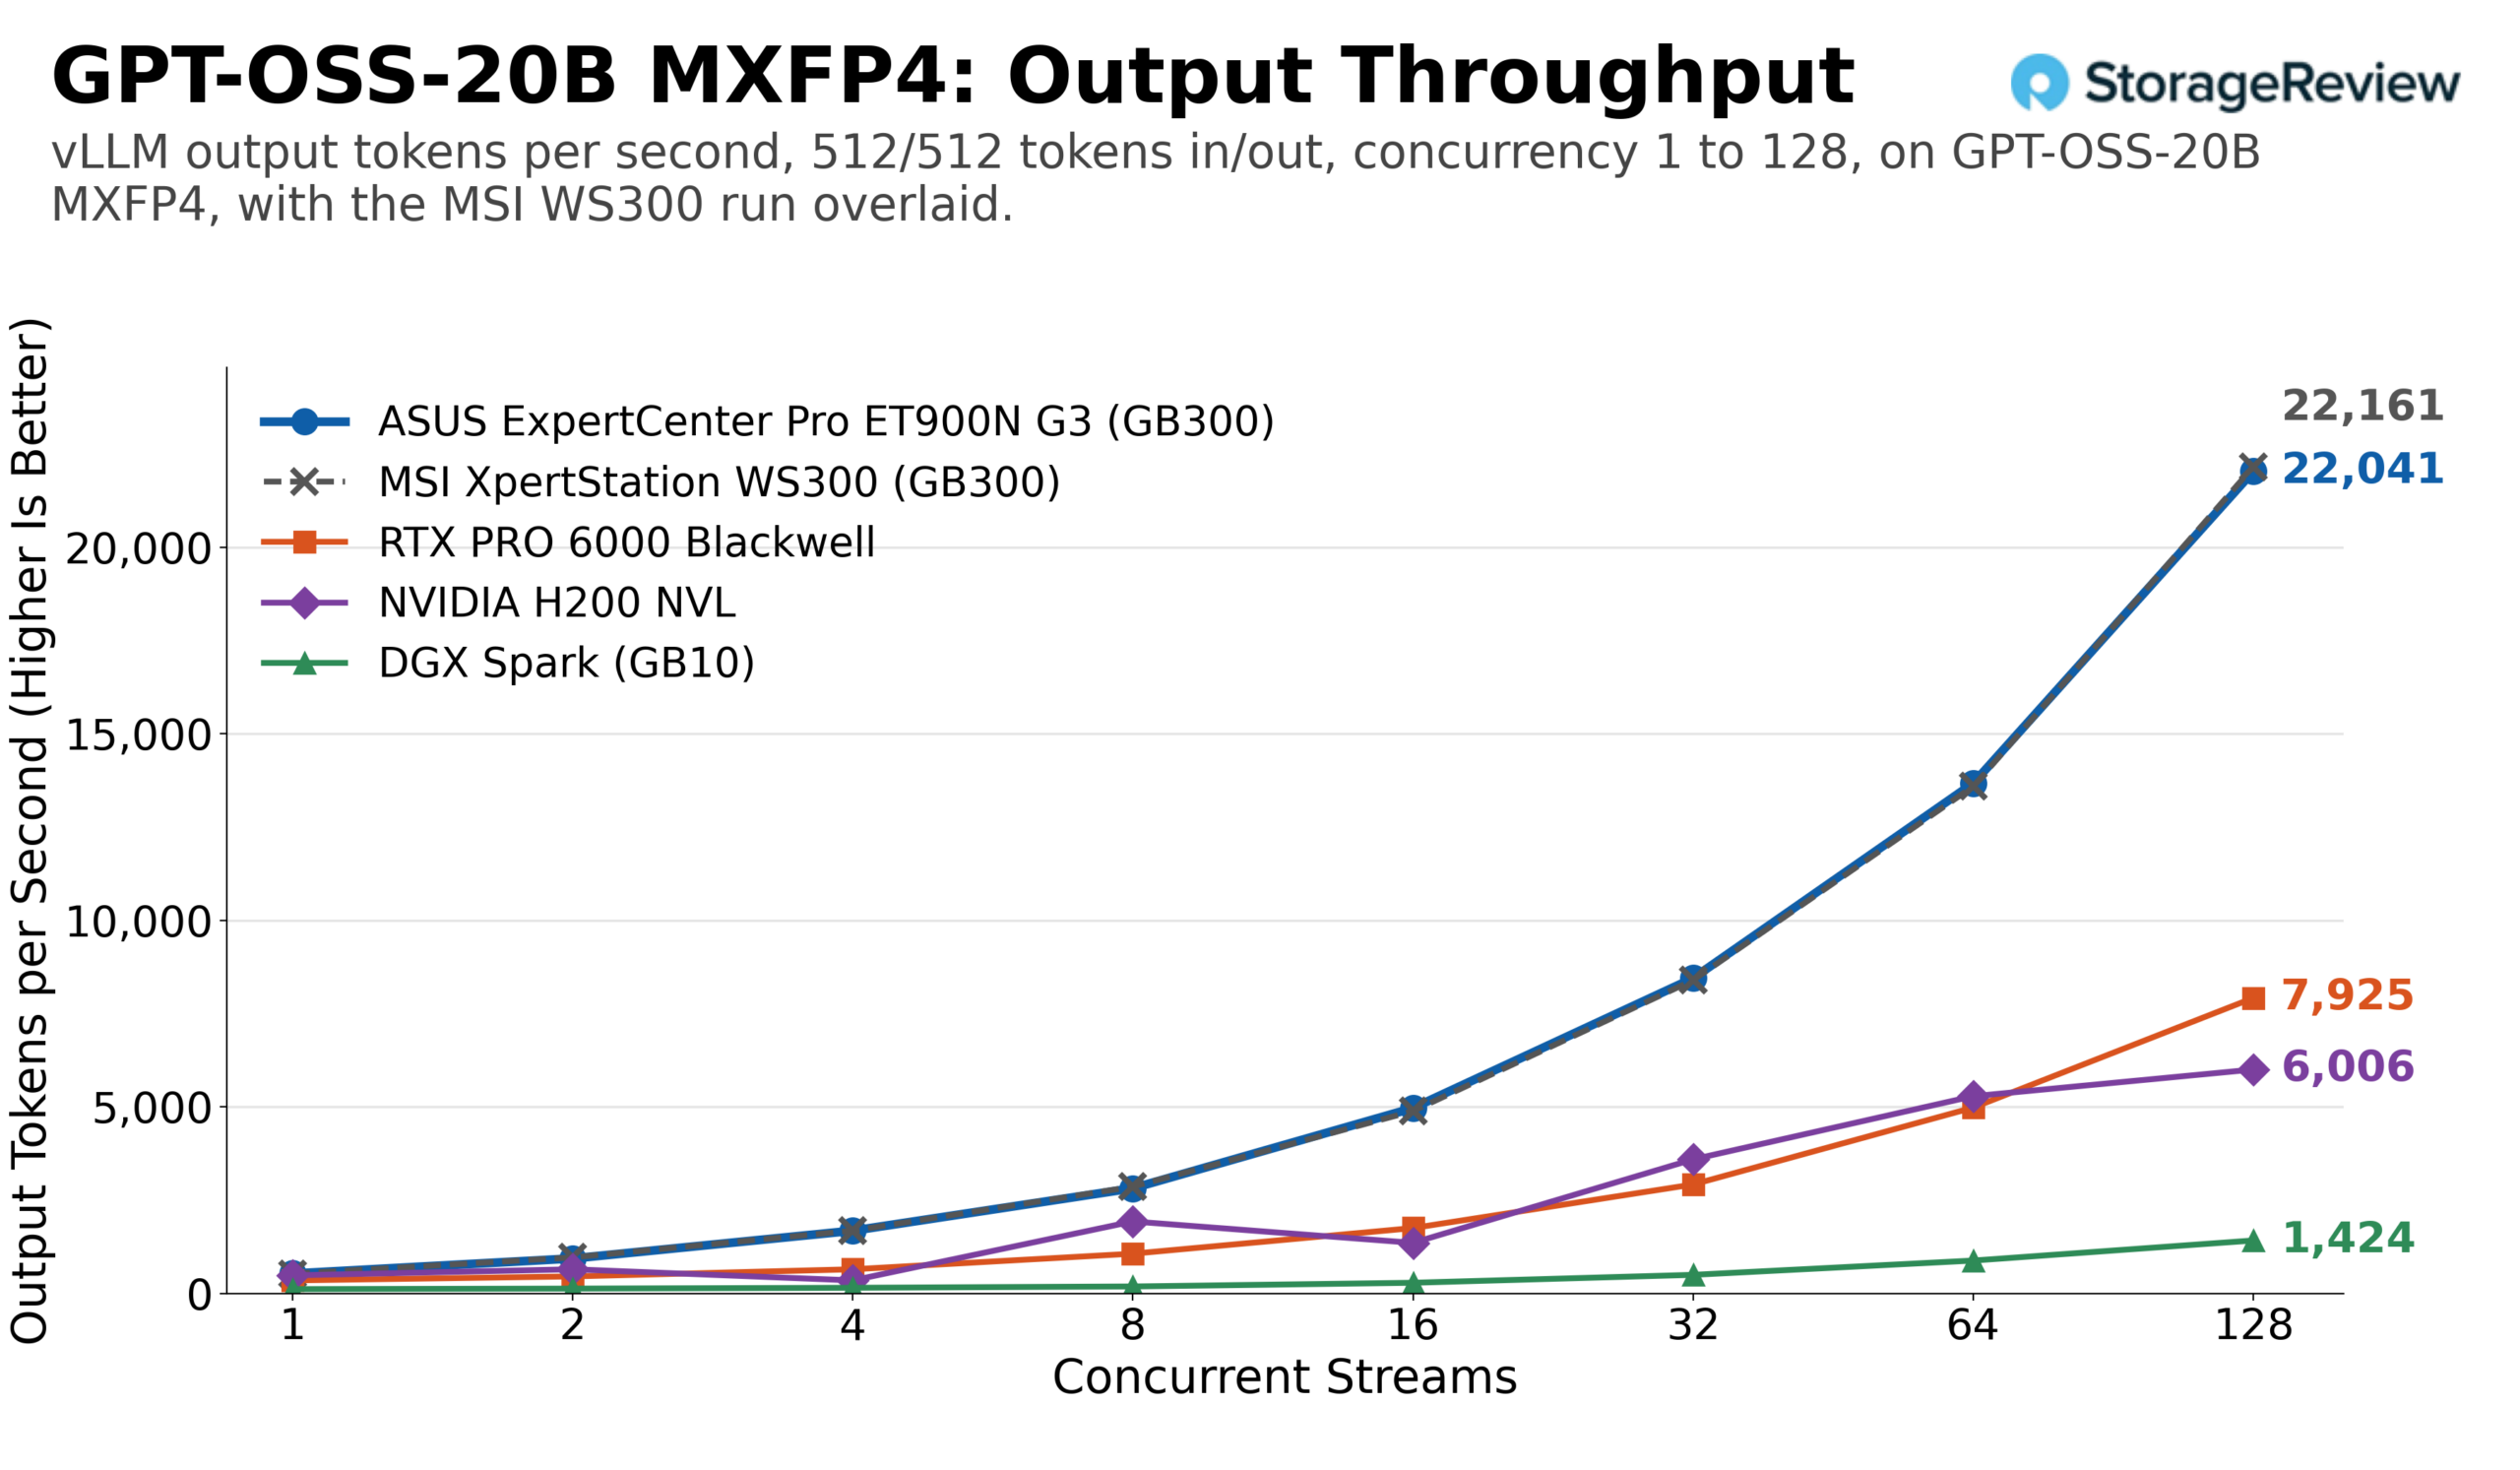
GPT-OSS-20B är det vänligaste testet i serien, en kontrollpunkt som alla system hanterar bekvämt, och med samma arbetsbelastning skalade ET900N G3 till 22 041 utdatatokens per sekund vid 128 strömmar, eller totalt 44 082, jämfört med cirka 7 920 för RTX PRO 6000, 6 010 för H200 NVL och 1 420 för DGX Spark. I enkelströmsläge producerade Stationen 536 utdatatokens per sekund, jämfört med kortets 354, H200:s 489 och Sparks 120. Den förfyllda profilen vidgade gapet: 9 555 utdatatokens per sekund och 85 994 totalt vid 128 strömmar för Stationen, med RTX PRO 6000 på cirka 2 480, H200 NVL på 3 410 och Spark på 445.
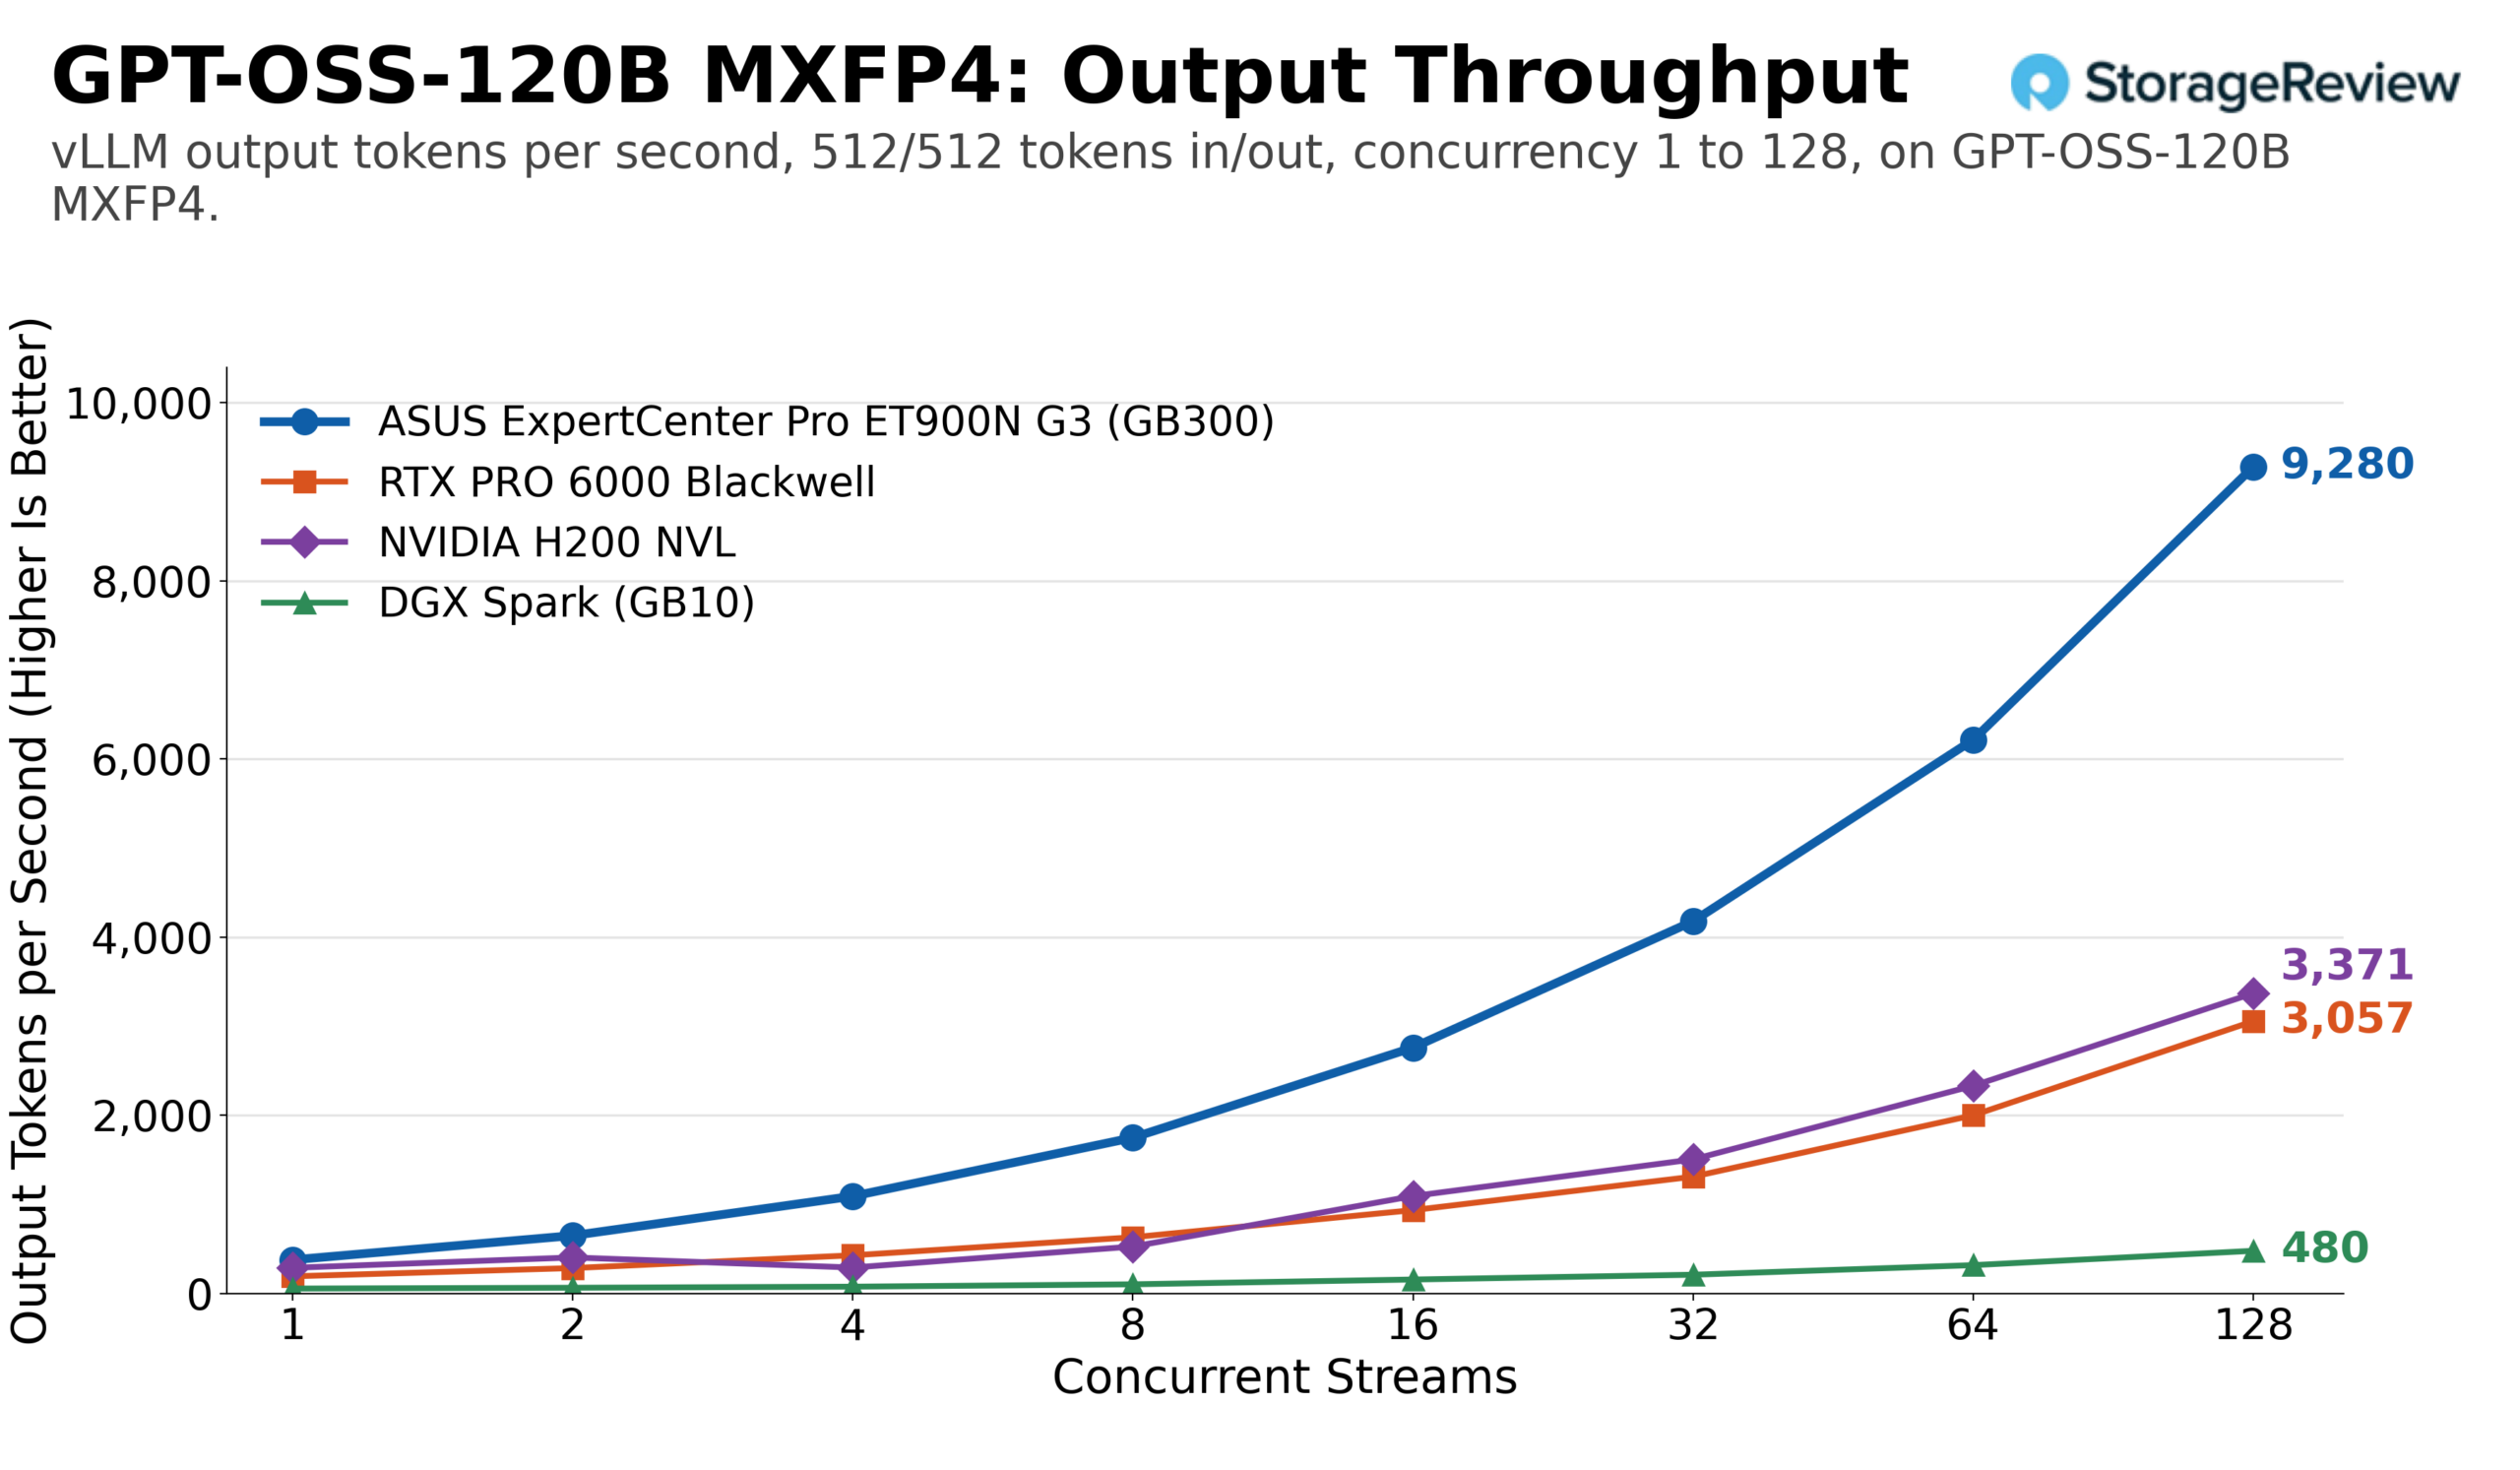
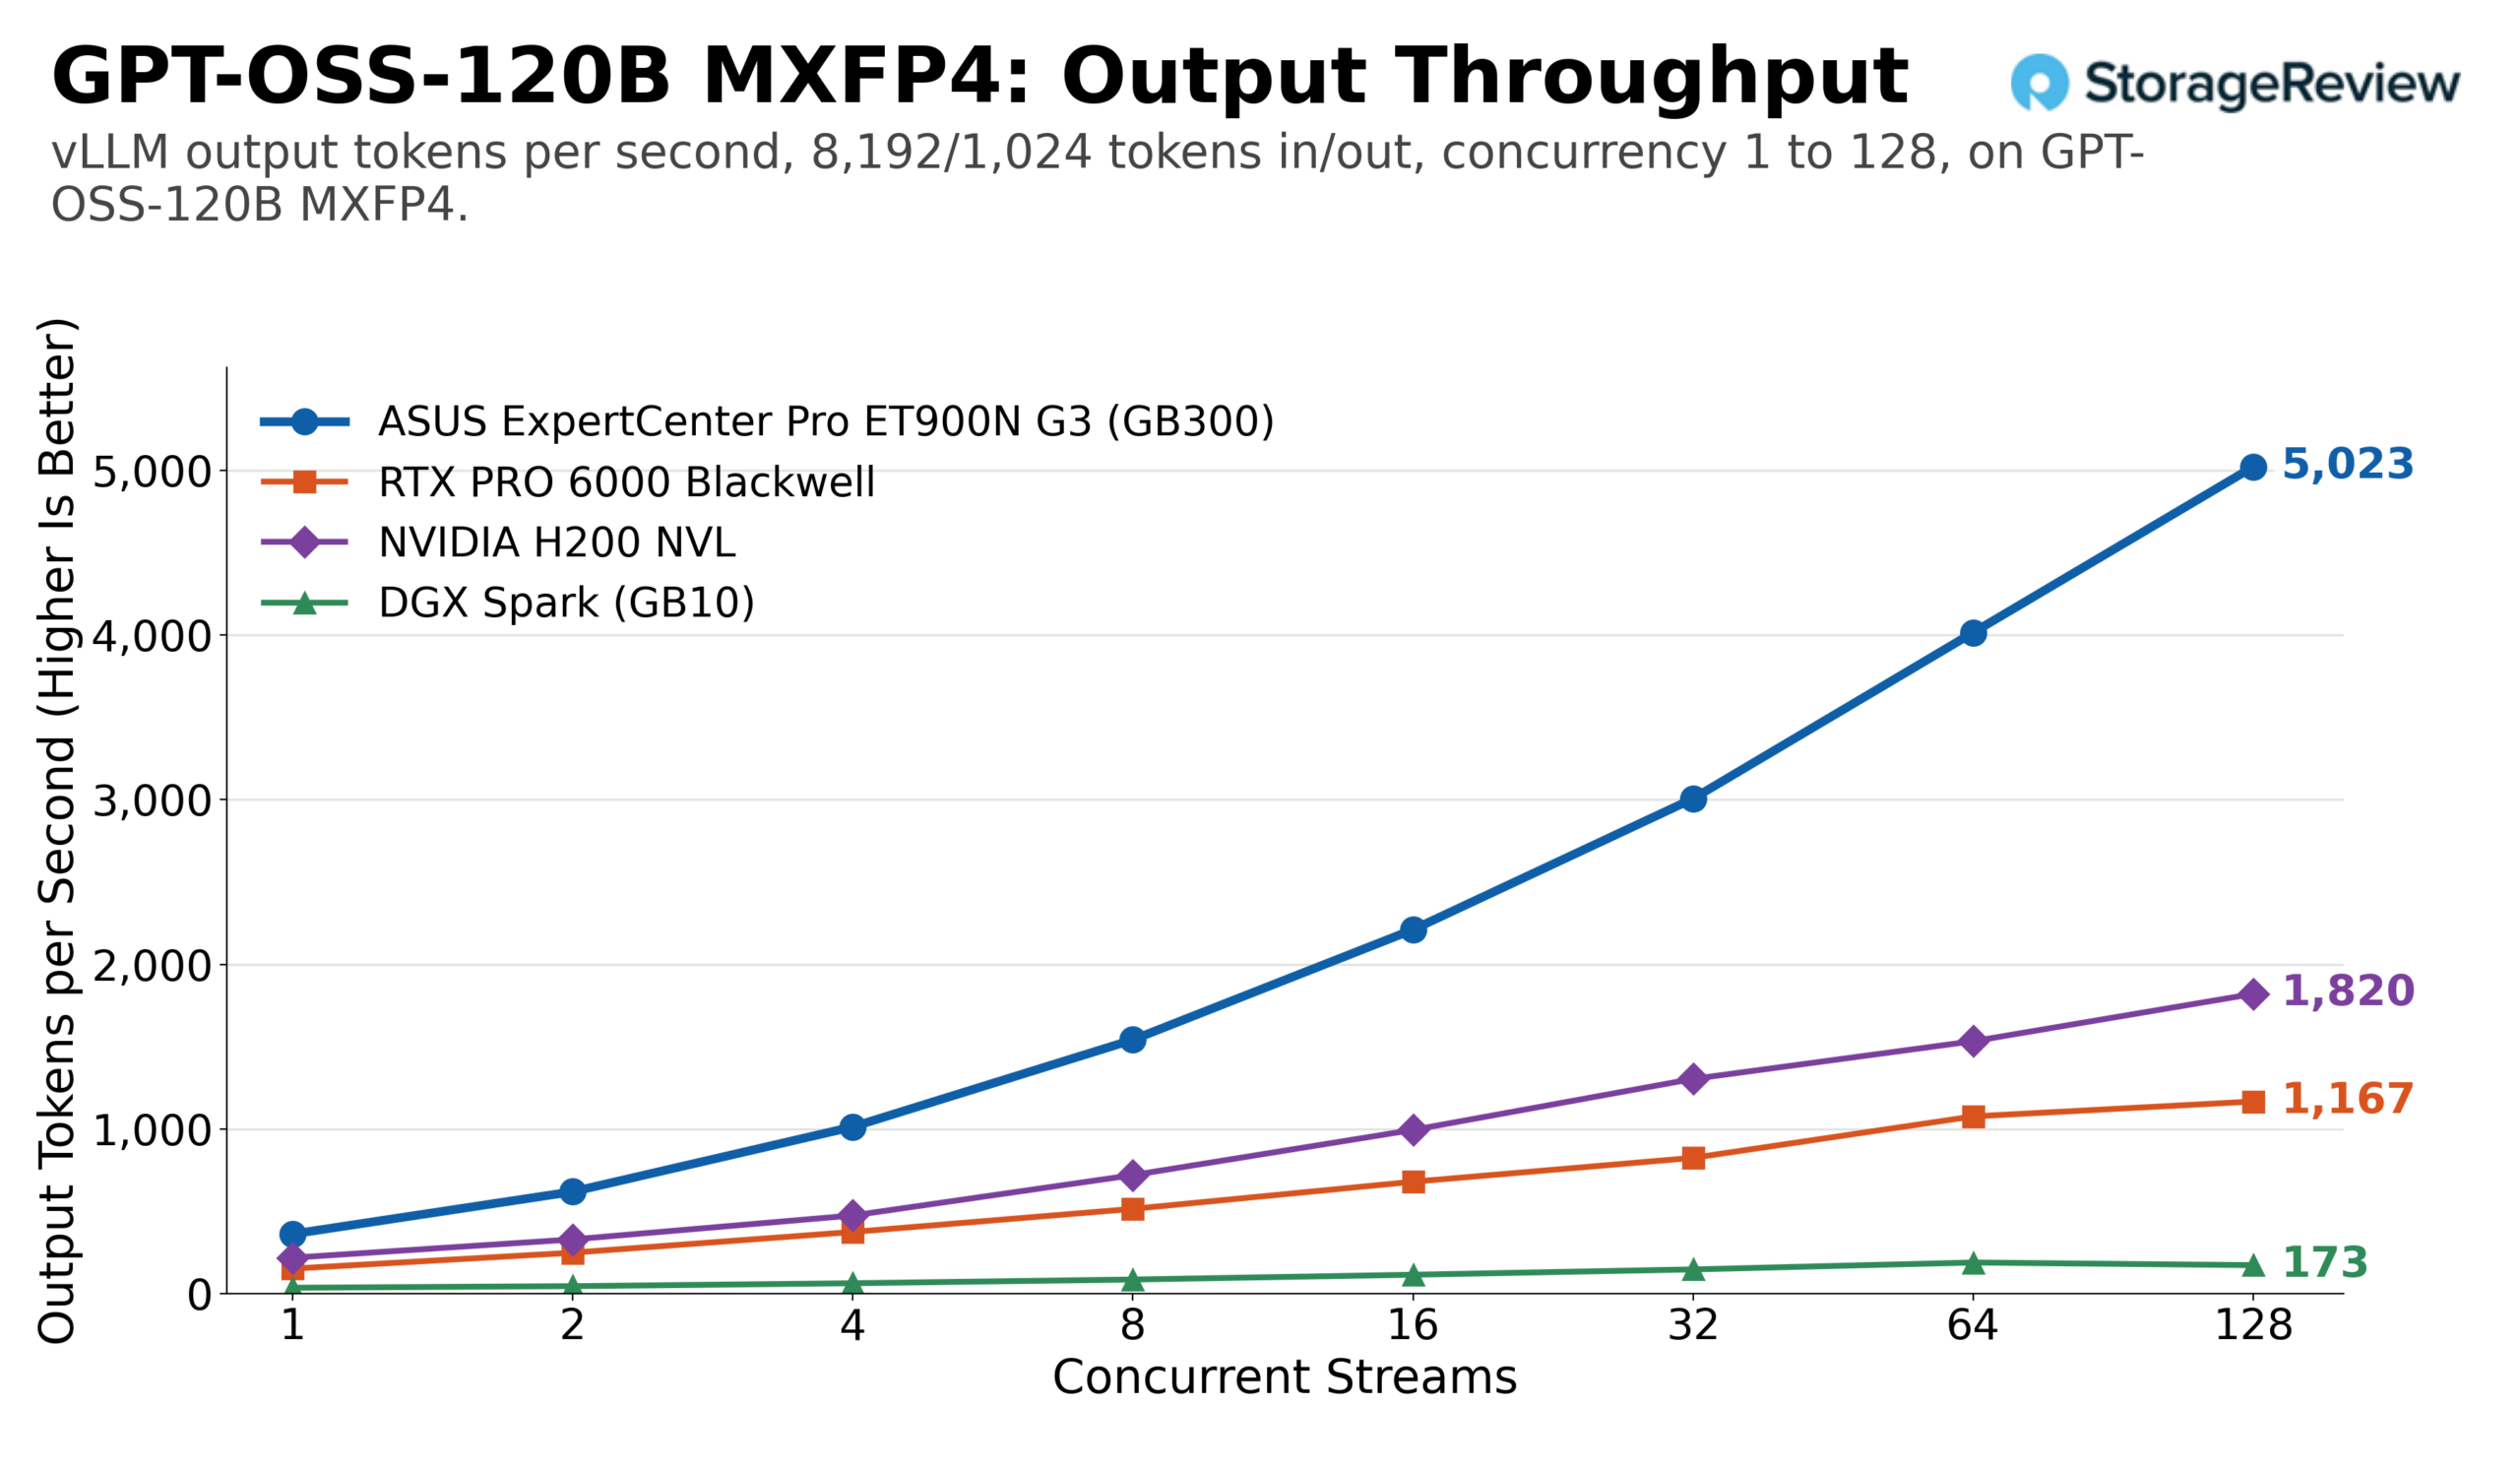
Det är vid GPT-OSS-120B som minnet börjar sortera fältet. ET900N G3 nådde 9 280 utdatatokens per sekund med samma arbetsbelastning vid 128 strömmar, ungefär tre gånger RTX PRO 6000 vid 3 060, 2.8 gånger H200 NVL vid 3 370 och mer än 19 gånger Spark vid 480. Under långa uppmaningar fick de mindre systemen slut på KV-cacheutrymme tidigt: RTX PRO 6000 nådde som mest cirka 1 170 utdatatokens per sekund och H200 NVL vid nästan 1 820, medan Station fortfarande klättrade vid 128 strömmar och slutade på 5 023, med en total genomströmning på 45 205 tokens per sekund.
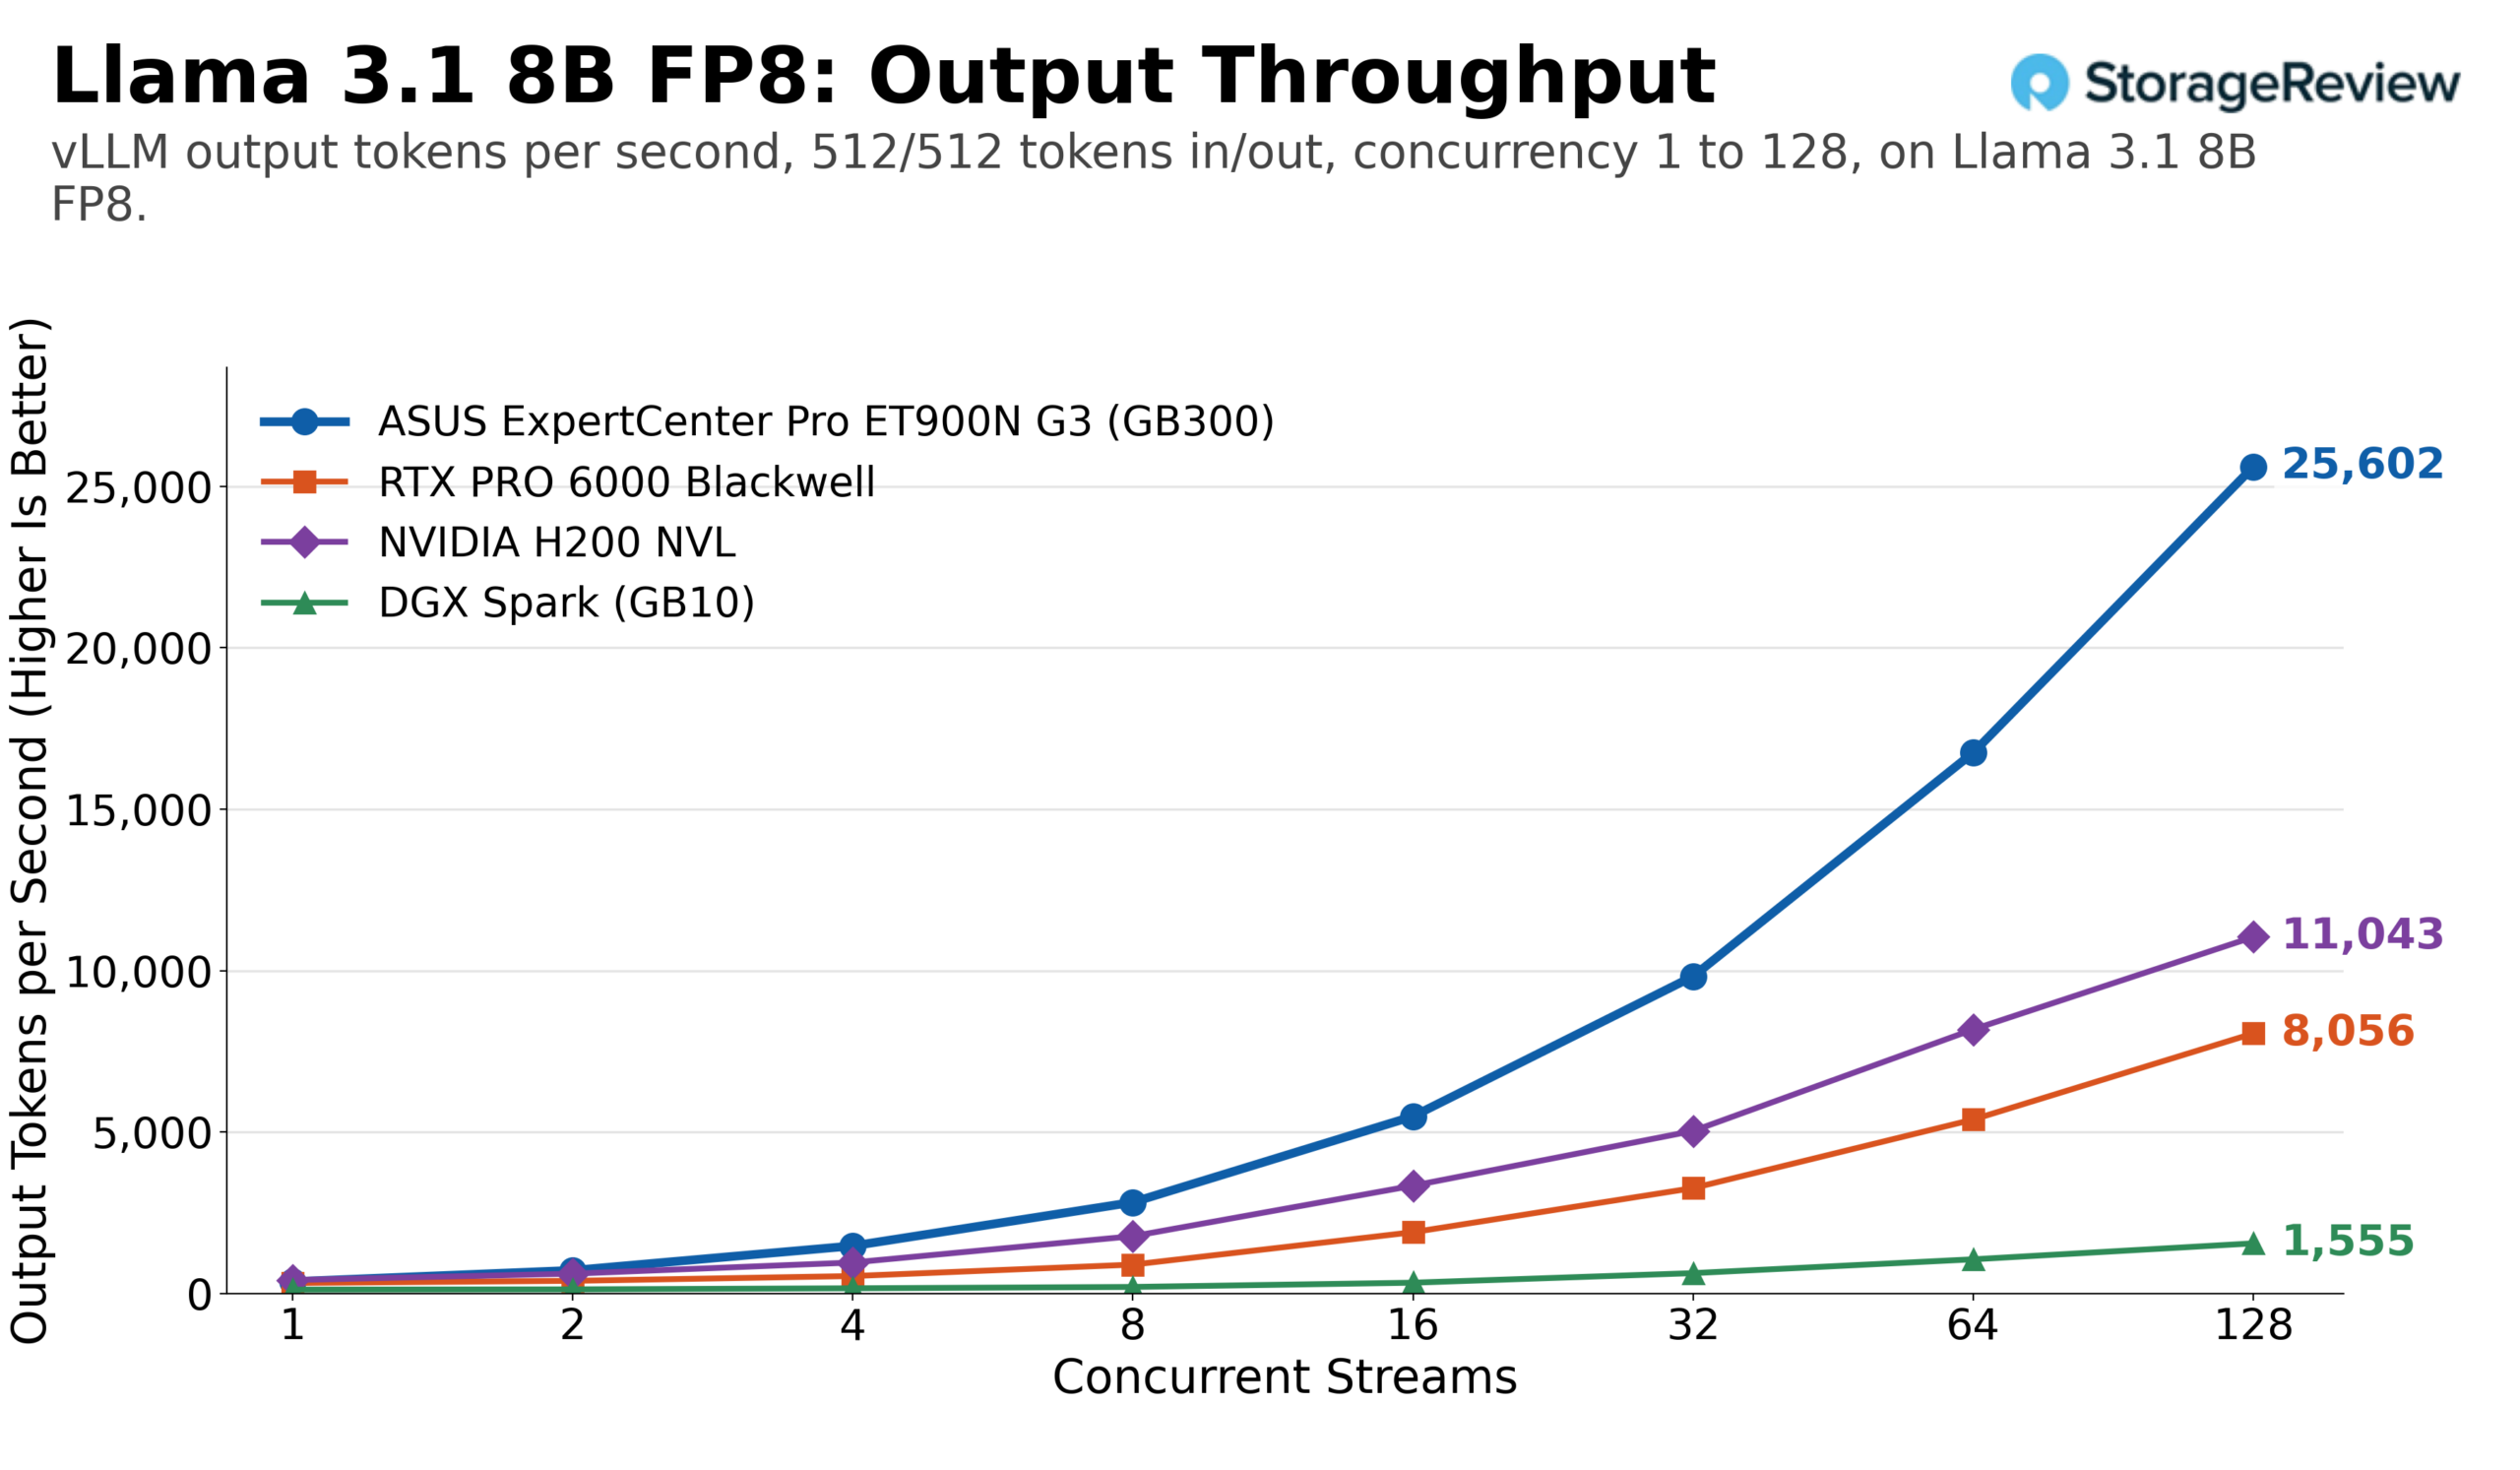
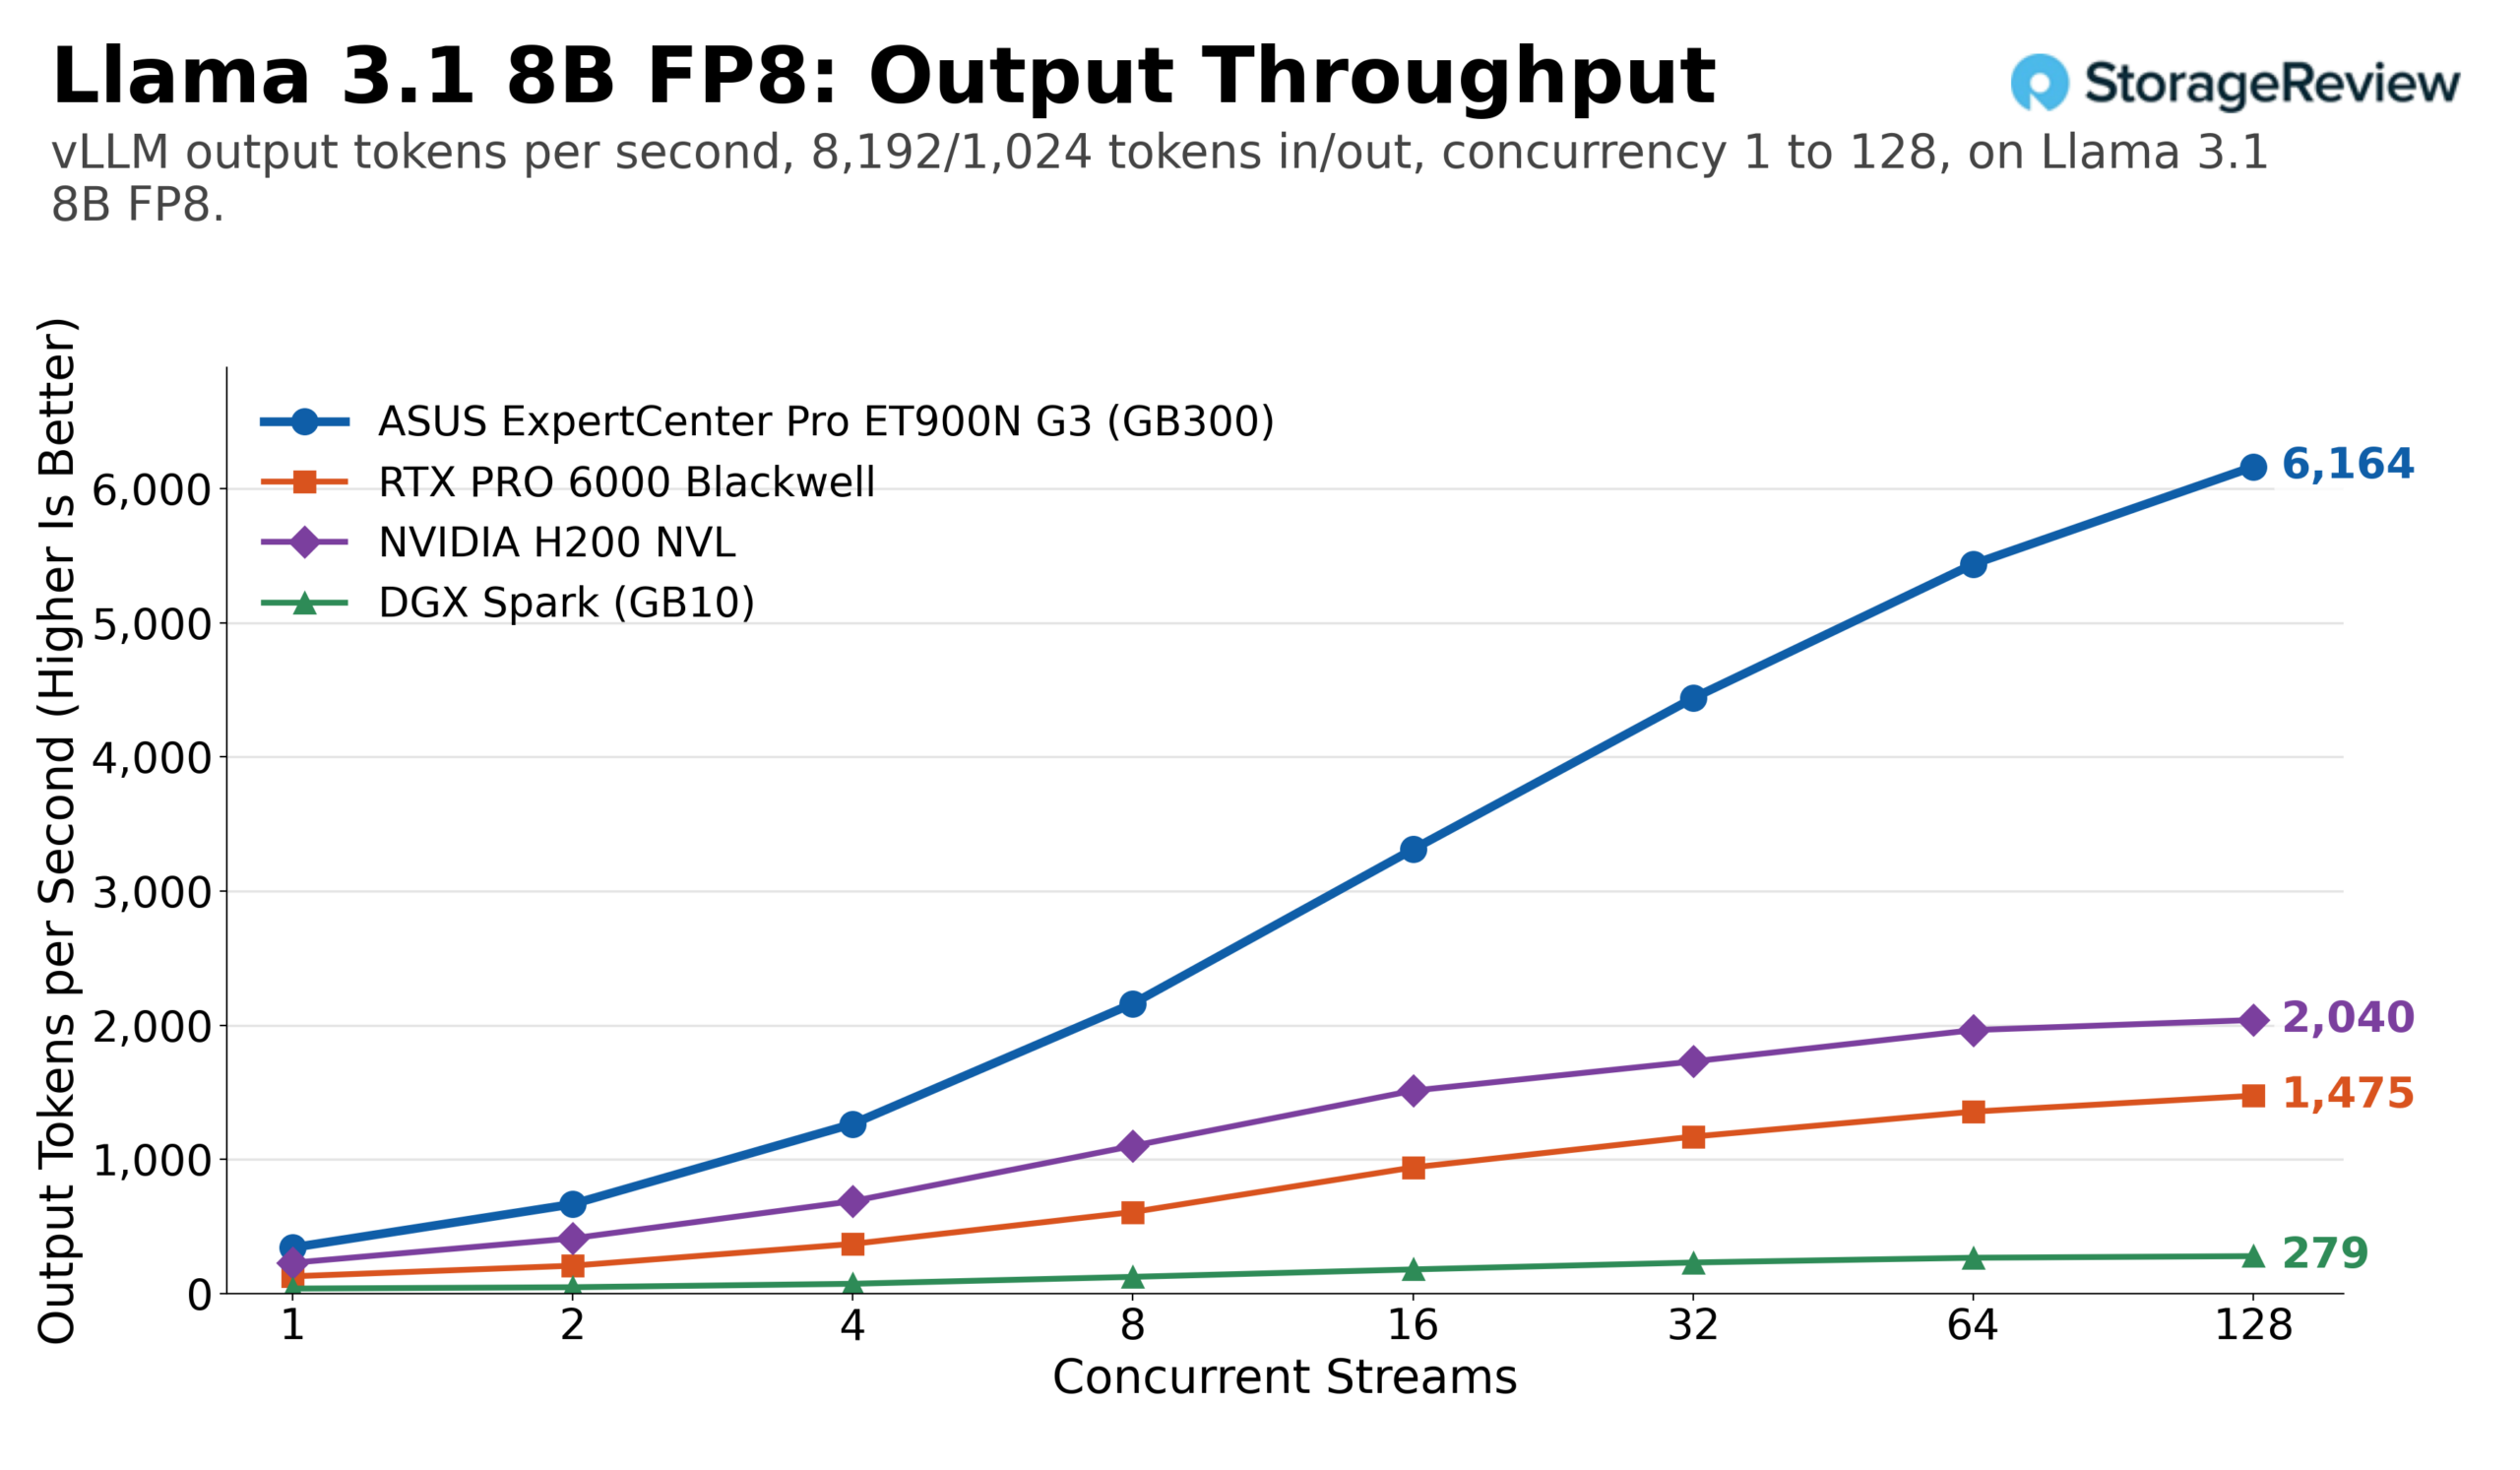
Llama 3.1 8B vid FP8 är det högsta enskilda numret i uppsättningen. ET900N G3 genererade 25 602 utdatatokens per sekund över 128 strömmar med samma arbetsbelastning, totalt 51 205, jämfört med cirka 8 060 för RTX PRO 6000 och 11 040 för H200 NVL. Att gå från BF16 till FP8 lyfte Station med cirka 50 % (från 17 074 till 25 602), medan RTX PRO 6000 ökade med cirka 70 % och H200 NVL med cirka 37 % från samma förändring. Den förfyllningstunga profilen komprimerade allt, med Station på 6 164 utdatatokens per sekund, kortet på 1 480 och H200 på 2 040.
Mistral Small 24B producerade vid FP8 de bredaste förhållandena. ET900N G3 nådde en topp på 11 075 utdatatokens per sekund vid samma arbetsbelastning, 3.4 gånger RTX PRO 6000 på 3 240, 2.4 gånger H200 NVL på 4 610 och nästan 20 gånger Spark på 559. Under långa uppmaningar nådde RTX PRO 6000 en topp på 32 strömmar och cirka 480 utdatatokens per sekund innan den sjönk tillbaka; H200 NVL nådde en topp på cirka 854 och Station nådde 2 302 vid 128 strömmar.


Qwen3 Coder 30B, en modell med blandade experter och ett litet antal aktiva parametrar, är där skillnaden mellan enskilda strömmar minskar. Vid en ström och lika stor arbetsbelastning levererade RTX PRO 6000 cirka 232 utdatatokens per sekund till Stationens 319 och H200 NVL:s 308. Batchning återställer ordningen: vid 128 strömmar nådde ET900N G3 12 439 utdatatokens per sekund vid FP8, 3.1 gånger kortet vid 3 990 och 1.7 gånger H200 NVL vid 7 450. På den förfyllningstunga profilen nådde Stationen 3 837 utdatatokens per sekund, medan RTX PRO 6000 nådde sin topp på cirka 880 vid 64 strömmar och H200 NVL på cirka 1 820.


Bland de delade modellerna landade ET900N G3 på 2.8 till 3.4 gånger högre än för ett enda RTX PRO 6000 och 1.7 till 3.7 gånger högre än för ett H200 NVL vid full samtidighet, med marginalen över båda som vidgades under långa prompter i takt med att deras KV-cacheutrymme tog slut. Jämfört med WS300 ligger dessa fyra återigen inom 1 %: 22 041 mot 22 161 på GPT-OSS-20B, 9 280 mot 9 294 på GPT-OSS-120B, 11 075 mot 11 157 på Mistral Small FP8 och 12 439 mot 12 425 på Qwen3 Coder FP8. Den fullständiga jämförelsen av 14 modeller, inklusive de tre modellerna med större gap, finns i nästa avsnitt.
Två torn, ett baseboard: ASUS ET900N G3 vs MSI WS300
ET900N G3 och MSI XpertStation WS300 är samma NVIDIA GB300 DGX Station-baskort i två OEM-chassin, och båda har genomgått samma 14 modeller, samma två arbetsbelastningar och samma samtidighetssvep på samma vLLM-bygge. Diagrammet nedan jämför ET900N G3:s maximala genomströmning över alla modeller med WS300:s.
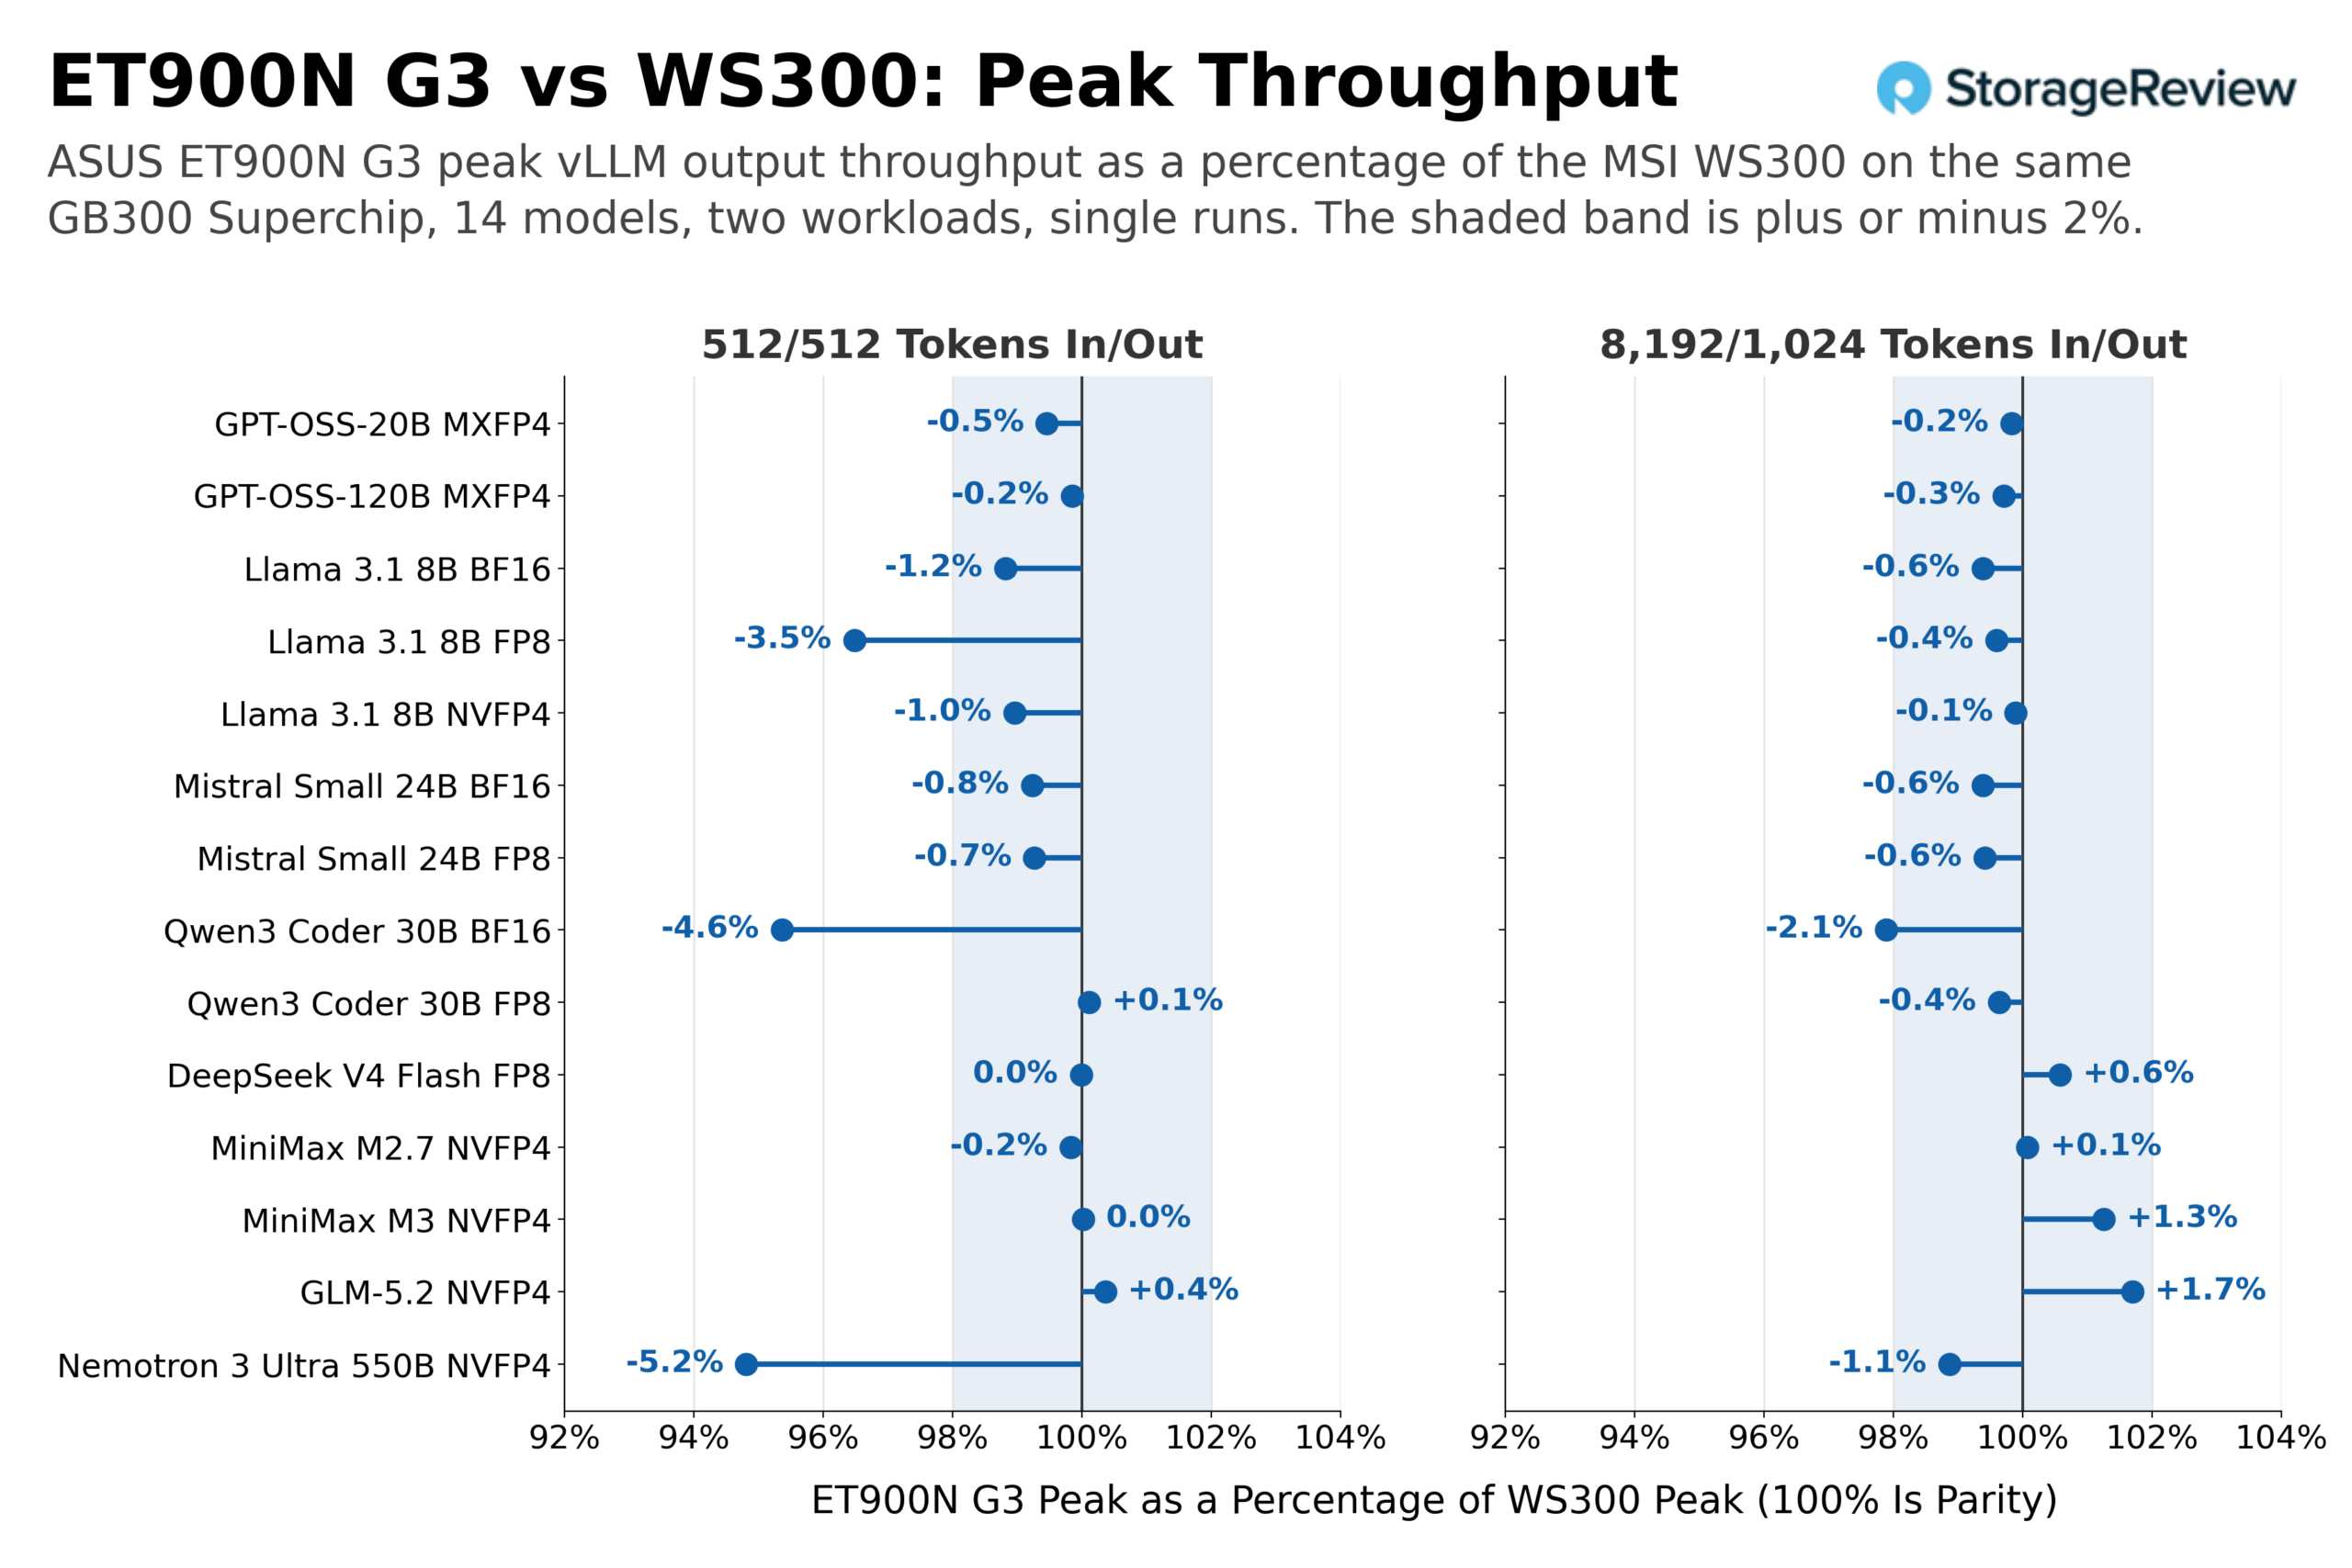
Av de 28 modell-arbetsbelastningsparen hamnar 24 inom 2 % av varandra, och de flesta av dessa är bara en bråkdel av en procent till WS300:s fördel. Fyra ligger utanför det bandet, tre av dem med samma arbetsbelastning: Llama 3.1 8B FP8 med 3.5 % under WS300 (25 602 mot 26 536 utdatatokens per sekund), Qwen3 Coder 30B BF16 med 4.6 % under (10 000 mot 10 486) och Nemotron 3 Ultra 550B med 5.2 % under (159 mot 168), plus Qwen3 Coder 30B BF16 återigen med 2.1 % under på de långa prompterna. Varje siffra här är en enda körning på varje torn, så ett gap på 2 till 5 % mellan tre modeller av 14 är inte något vi kommer att sätta på chassit; Vi noterar bara data och deltat mellan de två. Modellerna som förlitar sig på den koherenta minnespoolen, MiniMax M3 och GLM-5.2, landar på paritet eller högre på båda arbetsbelastningarna; det är resultatet vi tror är viktigast för plattformen: Grace-avlastningsvägen presterar likadant i ASUS chassin som i MSIs.
| Modell | WS300 8 192/1 024 | ET900N G3 8 192/1 024 | Delta | WS300 8 192/1 024 | ET900N G3 8 192/1 024 | Delta |
|---|---|---|---|---|---|---|
| GPT-OSS-20B MXFP4 | 22,161 | 22,041 | -0.5% | 9,572 | 9,555 | -0.2% |
| GPT-OSS-120B MXFP4 | 9,294 | 9,280 | -0.2% | 5,038 | 5,023 | -0.3% |
| Llama 3.1 8B BF16 | 17,278 | 17,074 | -1.2% | 3,520 | 3,498 | -0.6% |
| Llama 3.1 8B FP8 | 26,536 | 25,602 | -3.5% | 6,189 | 6,164 | -0.4% |
| Llama 3.1 8B NVFP4 | 28,698 | 28,400 | -1.0% | 6,744 | 6,737 | -0.1% |
| Mistral Small 24B BF16 | 7,922 | 7,861 | -0.8% | 1,643 | 1,633 | -0.6% |
| Mistral Small 24B FP8 | 11,157 | 11,075 | -0.7% | 2,316 | 2,302 | -0.6% |
| Qwen3-kodare 30B BF16 | 10,486 | 10,000 | -4.6% | 3,830 | 3,749 | -2.1% |
| Qwen3-kodare 30B FP8 | 12,425 | 12,439 | + 0.1% | 3,851 | 3,837 | -0.4% |
| DeepSeek V4 Flash FP8 | 1,766 | 1,766 | 0.0% | 948 | 954 | + 0.6% |
| MiniMax M2.7 NVFP4 | 4,801 | 4,793 | -0.2% | 1,743 | 1,744 | + 0.1% |
| MiniMax M3 NVFP4 | 1,041 | 1,041 | 0.0% | 278 | 282 | + 1.3% |
| GLM-5.2 NVFP4 | 138 | 139 | + 0.4% | 118 | 120 | + 1.7% |
| Nemotron 3 Ultra 550B NVFP4 | 168 | 159 | -5.2% | 142 | 140 | -1.1% |
GPT-OSS-20B, det tätaste fallet med högst genomströmning i uppsättningen, och GLM-5.2, avlastningsfallet, visar överlappningen utan förhållande: på båda spårar WS300:s körning ET900N G3:s punkt för punkt.
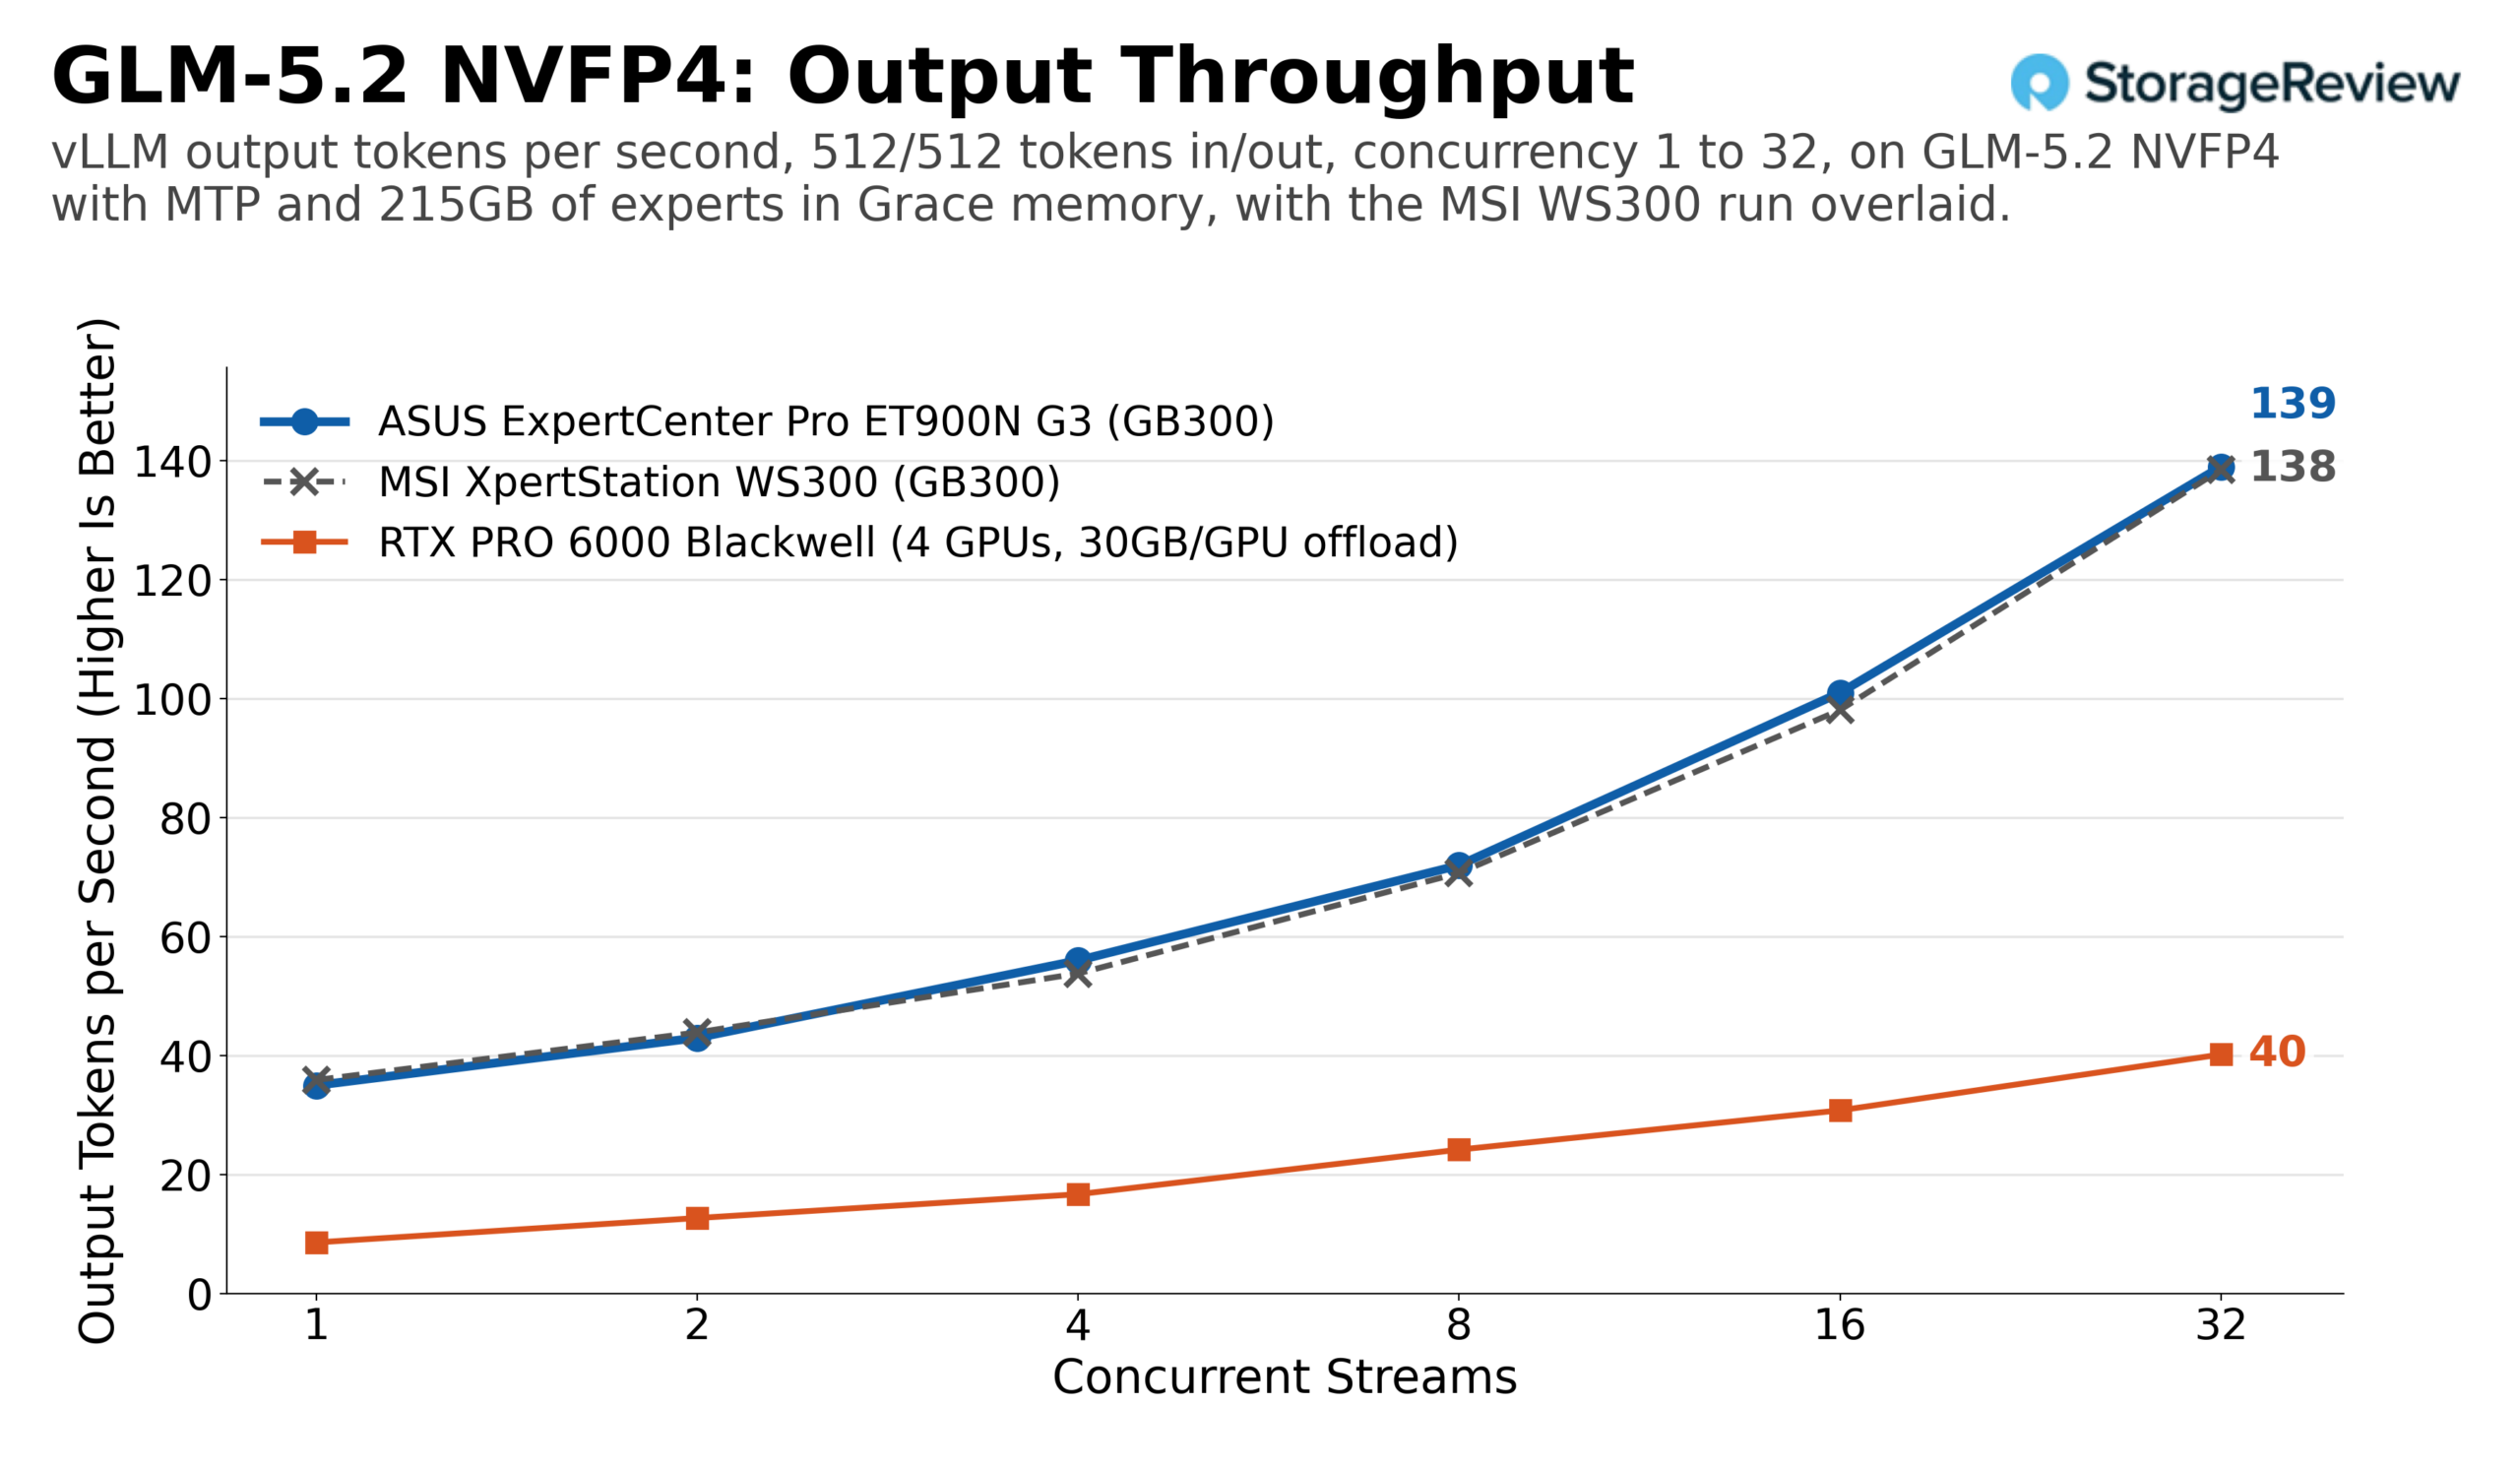
Det här är jämförelsen vi kommer att bygga vidare på allt eftersom fler GB300-tornmodeller kommer genom labbet. HP:s ZGX är nästa, med fler att följa, och alla kör samma svep, så eventuella skillnader mellan OEM-implementeringar kommer att visas här, i ett diagram per tornmodell, med modelldiagrammen som visar de råa kurvorna.
Slutsats
ASUS ExpertCenter Pro ET900N G3 gör vad en andra implementering av en referensplattform borde: den bekräftar den första. Över 14 modeller och två arbetsbelastningar landade dess maximala vLLM-genomströmning inom 2 % av MSI XpertStation WS300 på 24 av 28 jämförelser, från 1 766 utdatatokens per sekund på DeepSeek V4 Flash till 22 041 på GPT-OSS-20B, med fyra single-run-outliers mellan 2 och 5 % under, och den levererade GLM-5.2 med 215 GB expertminne i Grace till hastigheter som fyra RTX PRO 6000-kort inte kunde nå. GB300 Superchip sätter taket, och ASUS gjorde ett bra jobb med genomförandet.
Det ASUS lägger till är praktiskt: handtagen förvandlar ett 27 kg tungt torn till något som två personer kan flytta utan att behöva greppa i panelerna, fläkten över QSFP112-burarna åtgärdar ett potentiellt problem för alla som kör 400G-optik i timmar, och Titanium-aggregatet minskar några watt vid väggen. Arm-värden, 20A-kretsen, den enda BMC-skärmutgången och den delade budgeten på 1 600 W när ett stort kort installeras är plattformsrealiteter som gäller lika för båda tornen.
GB300 DGX Station är fortfarande den mest kapabla enheten vi någonsin har lagt på ett skrivbord, och ASUS har gjort sin version till ett bra sätt att köpa den på.
På vår Bästa stationära datorer för lokal AI leaderboard, the ET900N G3 now stands alongside the WS300 as a tested alternative in the Best GB300 System slot.



 Amazon