

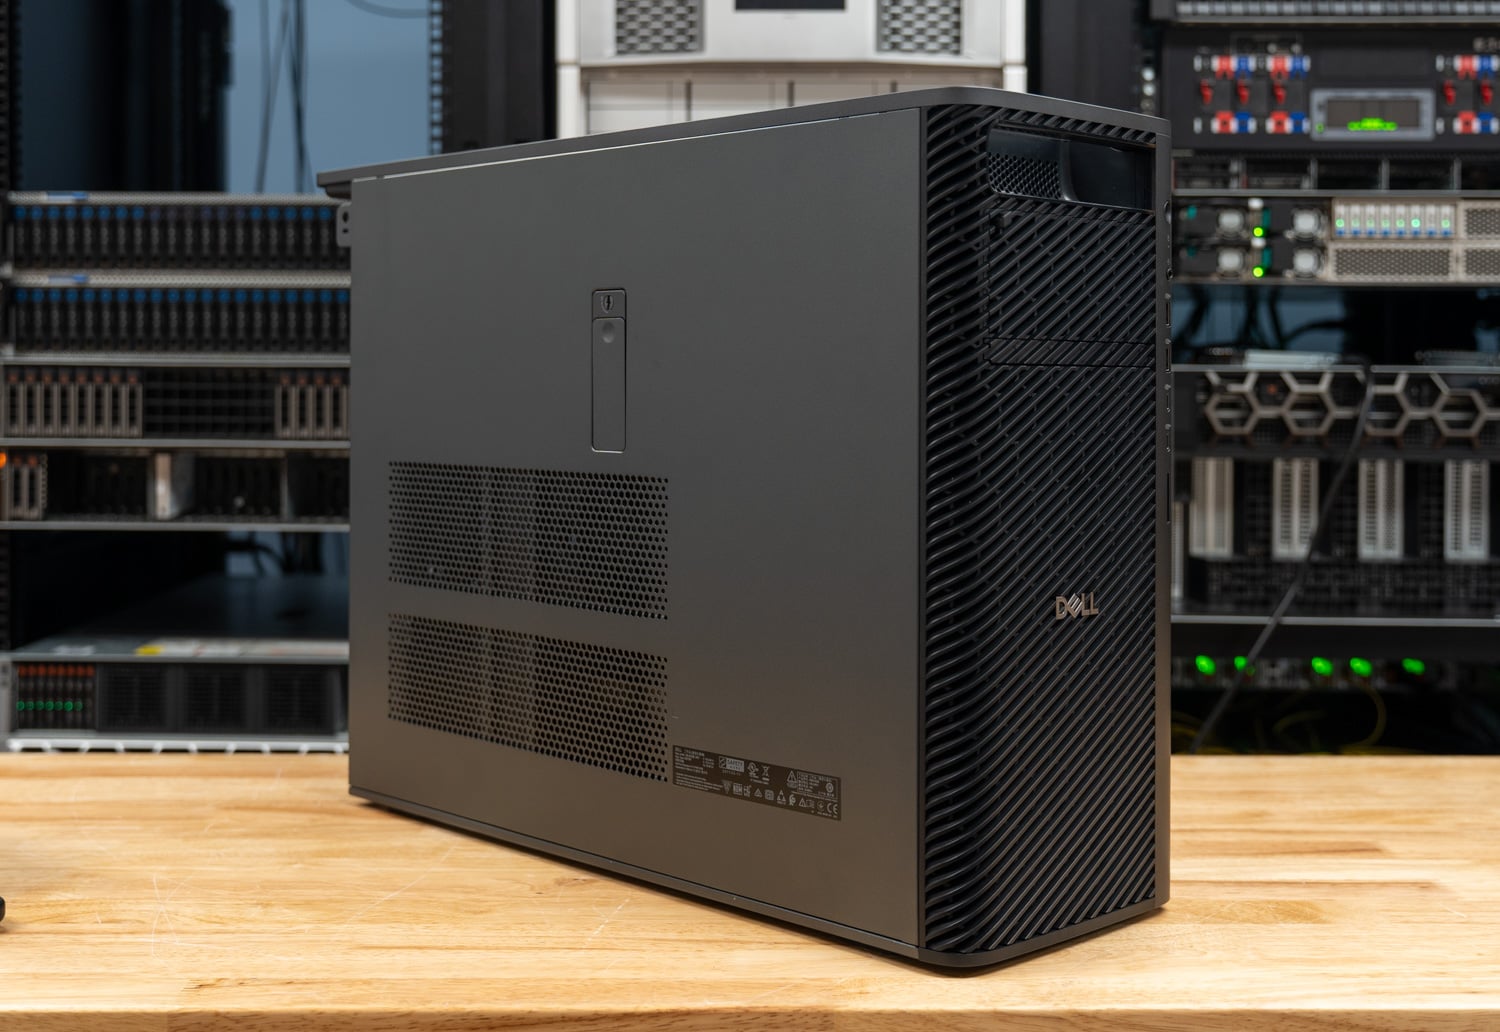
Dell Pro Precision 9 T4 är den enda sockelbaserade tornprocessorn i toppen av Dells Pro Precision-serie, och vår testmodell är konfigurerad för lokal AI i en skala som de flesta arbetsstationer inte kan nå. Den kombinerar Intels 86-kärniga Xeon 698X med 256 GB DDR5-6400 ECC-minne, två 300W NVIDIA RTX PRO 6000 Blackwell Max-Q-kort med 96 GB GDDR7 vardera, två 2TB Gen5 SSD-diskar och en 25GbE-adapter med dubbla portar, som drivs av en 2400W-strömförsörjning. Konfigurerad på samma sätt på Dell.com listas den för cirka 66 600 dollar.
Key Takeaways
- Två GPU:er förvandlar en modell som inte får plats på ett kort till en användbar modell. MiniMax M2.7 genererade vid 129.3 GB 83.7 tokens per sekund för en användare när den fördelades över båda RTX PRO 6000-korten, 2.8 gånger de 30.3 tokens per sekund med ett kort och resten av modellen i systemminnet.
- Den andra GPU:n skalade servering med 1.85 till 2.02 gånger och inbäddning med 1.92 gånger. Maximal llama.cpp-utdata ökade från 582.5 till 1 176,1 tokens per sekund på Ministral 3 3B och från 424.8 till 787.9 på gpt-oss 120B med en server per GPU, och inbäddningen av en miljon Wikipedia-passager minskade från 890 till 464 sekunder.
- En andra GPU minskade en LoRA-epok med 37 procent. En epok av LoRA på Ministral 3 8B tog 31.5 minuter på en GPU och 19.7 minuter på två, vilket slutade med hold-out-förluster på 1.169 och 1.167.
- Minnesbandbredd är där T4:s Xeon drar framåt. STREAM Triad nådde 328 GB/s, 53 procent över Threadripper PRO 9995WX i Precision 7875, och T4 avslutade OpenFOAM-drivAer-lösningen på 293 sekunder mot 556 och en 10-miljardsiffrig y-cruncher-körning på 53.9 sekunder mot 83.7.
- Precision 7875 är ledande när det gäller kärnbundet CPU-arbete. 96-kärniga Threadrippern låg 37 procent före i 7-Zip och 30 procent före i Blender Monster, och den slutförde LLVM-bygget på 43.7 sekunder mot 58.4.
Var Pro Precision 9 T4 sitter
Dell positionerar T4 som sin flaggskeppsarbetsstation med en enda sockel för organisationer som behöver maximal beräkningstäthet och expansionsmöjligheter, med AI-utveckling, teknisk simulering och vetenskaplig databehandling högst upp på listan över arbetsbelastningar. Den ligger över Dell Pro Precision 9 T2 , som använder samma Granite Rapids-WS Xeon 6-arbetsstationsplattform i ett mindre chassi med en GPU. T4 har åttakanalsprocessorerna i toppen av serien, upp till 86 kärnor och plats för upp till fyra grafikkort, beroende på modell.
Processoralternativen på Dell.com börjar vid 12-kärnig Xeon 634 och går vidare genom 64-kärnig Xeon 696X till 86-kärnig Xeon 698X i vår enhet, som har 336 MB cache, en basfrekvens på 2.0 GHz, en maximal frekvens på 4.8 GHz och en effekt på 350 W. Minnet går upp till 4 TB DDR5 RDIMM fördelat på 16 platser, och vår enhet fyller åtta av dem med 32 GB moduler med 6400 MT/s. Grafikkortet börjar vid ett enda RTX A400, och antalet kort beror på modellen: Dells konfigurator listar fyra RTX A1000-kort, tre RTX PRO 4000 Blackwell-kort, två 300 W RTX PRO 6000 Max-Q-kort eller ett 600 W RTX PRO 6000.
Baskonfigurationen listas till 5 925 dollar på Dell.com. Vår konfiguration lägger till 8 300 dollar för Xeon 698X, 15 000 dollar för 256 GB minne och 30 820 dollar för paret RTX PRO 6000 Max-Q-kort före lagring, nätverk och den 36-månaders ProSupport-uppgradering som Dell automatiskt lägger till i en version på den här nivån.
Bygg och design
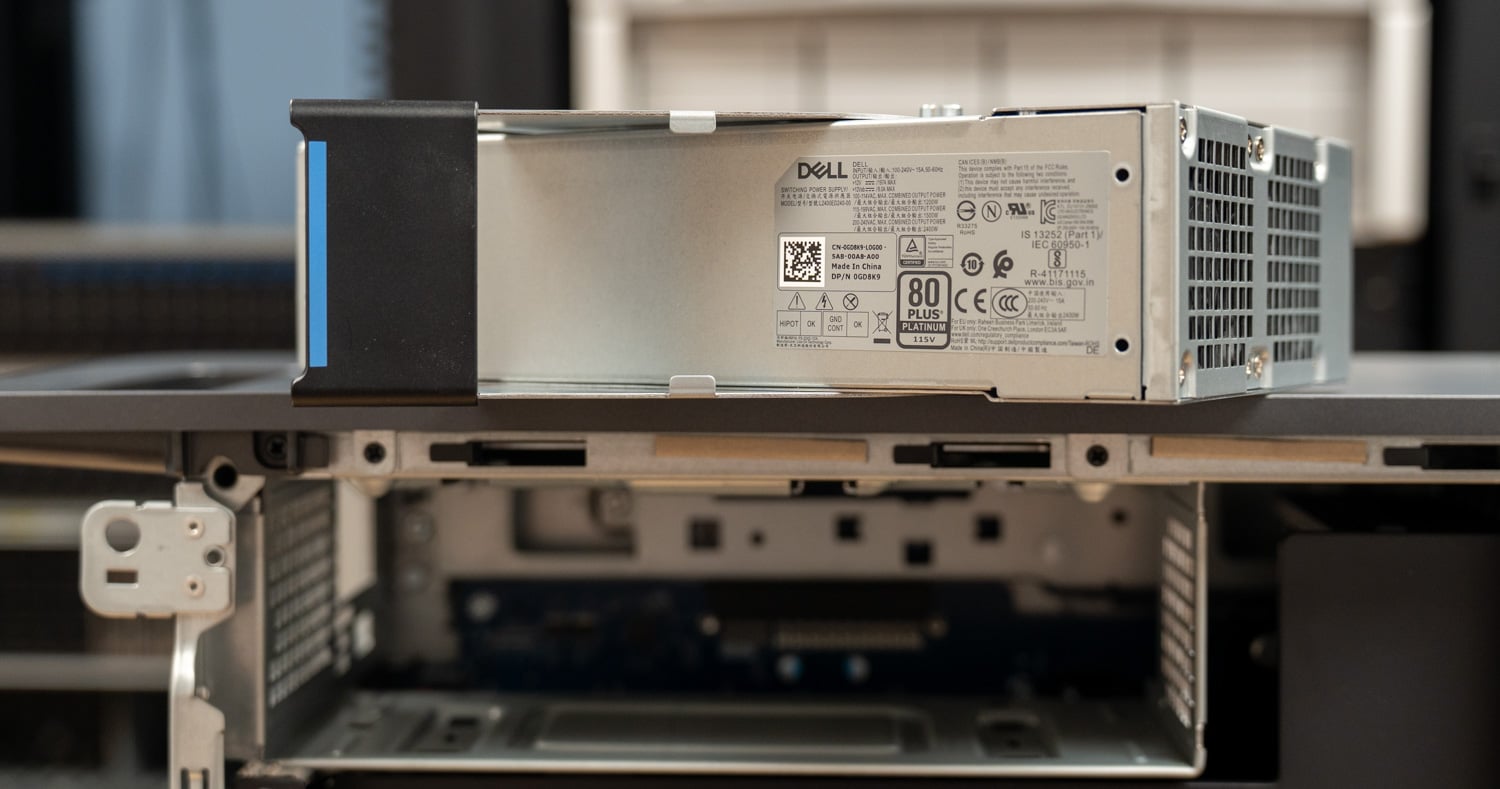
T4 är ett fullstort torn med höjden 449.8 mm, bredden 203.7 mm och djupet 617.5 mm, och Dell listar den med en minimumvikt på 24.1 kg och en maxvikt på 33.6 kg beroende på konfiguration. Vår enhet använder 2400W Platinum-nätaggregatet, som Dells konfigurator väljer för den dubbla RTX PRO 6000-konfigurationen, och en 1500W-strömförsörjning är standard på lättare modeller.
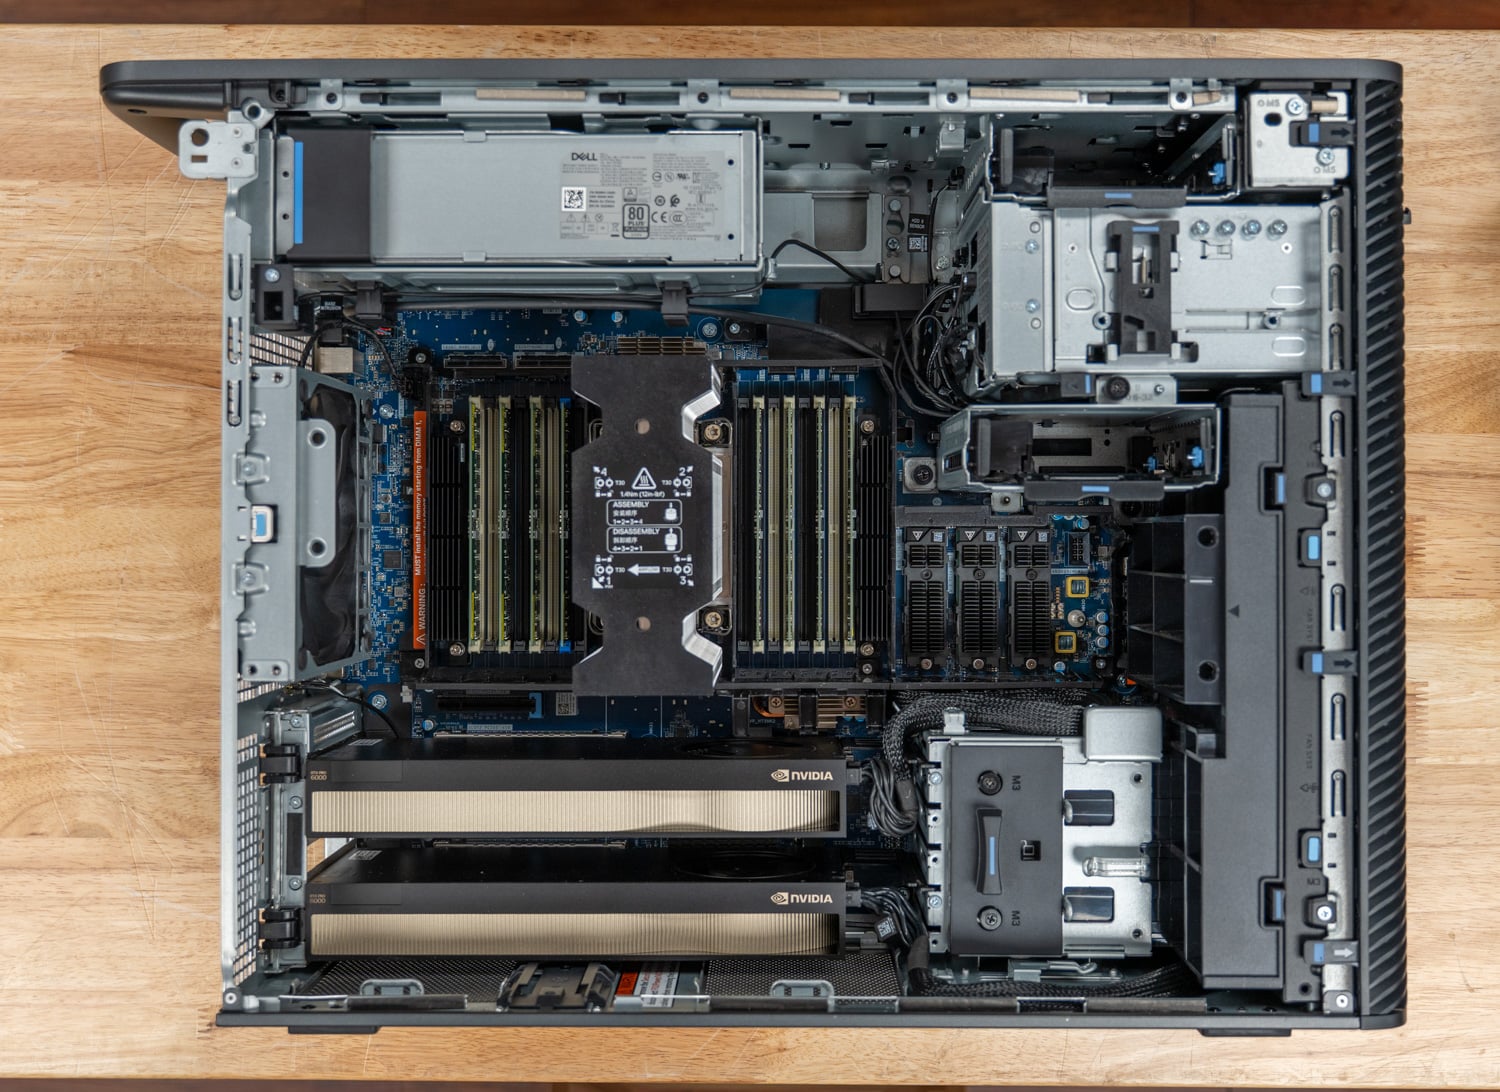
Servicevänligheten är en styrka hos T4, med början i verktygslös åtkomst via en spärr på sidopanelen och en 2400W nätadapter som skjuts ut manuellt från den övre bakre delen av chassit. Allt annat, inklusive grafikkort och SSD-diskar, tas ut med en stjärnskruvmejsel, och Dells blå beröringspunkter markerar de delar som tas ut för hand. Laboratoriet fann att plattformen var enkel för en användare att reparera i fält, vilket är viktigt för en arbetsstation i det här priset.
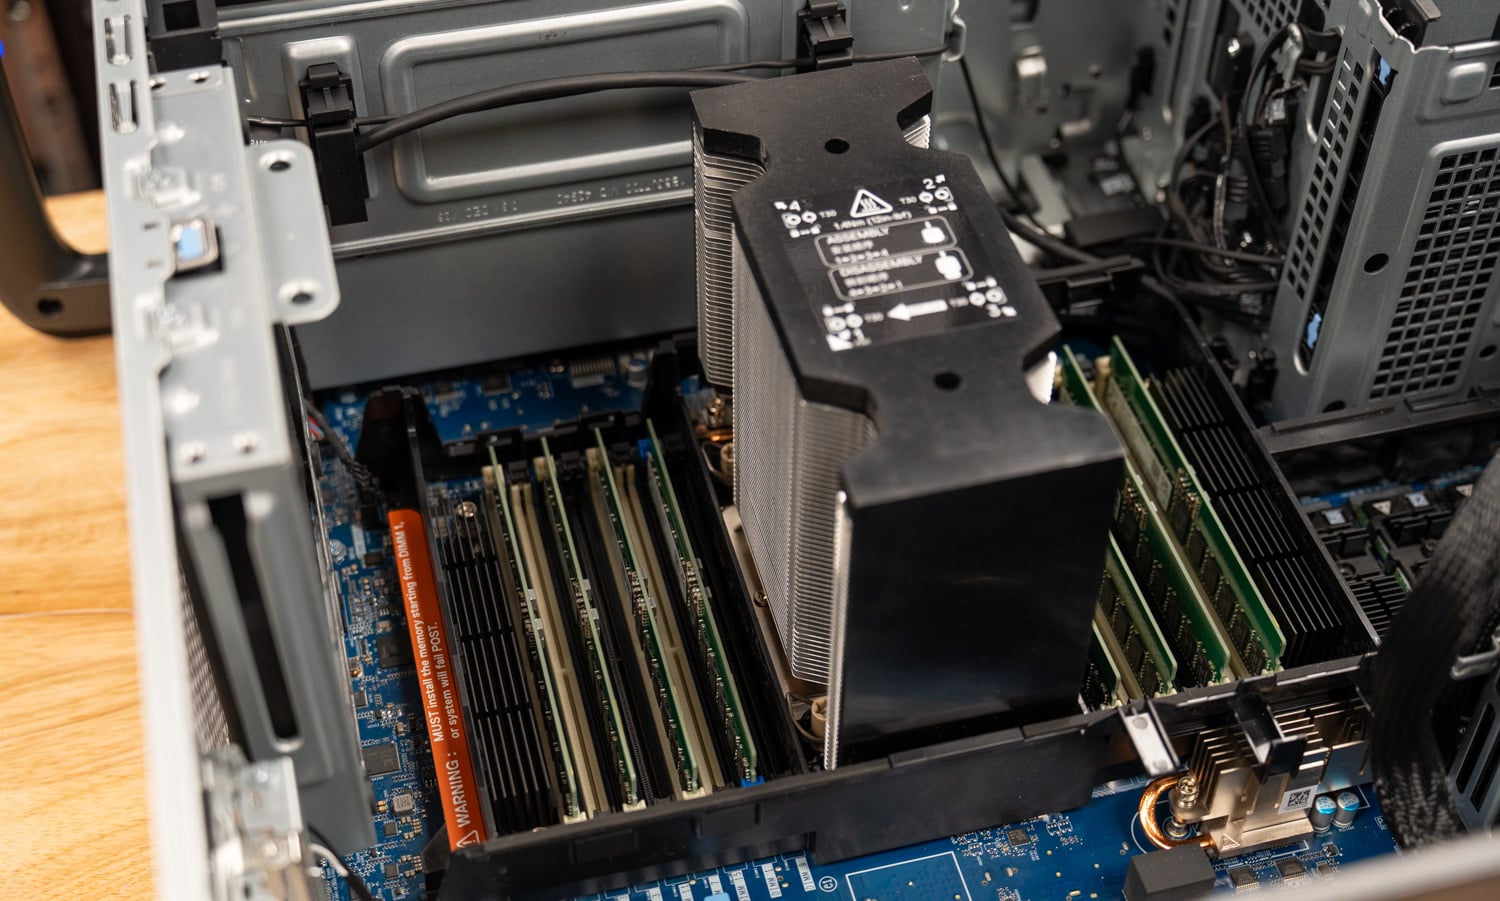
Kylning är det bästa utförandet vi sett från Dell i den här typen av tornkort. Luften rör sig framåt och bakåt, och stora, formmonterade kåpor driver den neråt och över processorn och minnet samtidigt som den kanalen hålls separat från PCIe-området. De två 300W-grafikkorten hämtar därför från en separat luftström och ärver inte värme från 350W Xeon. Med kåporna på plats sitter två fläktar mellan processorzonen och kortfacket, och enheten har samma blå beröringspunkter och lyfts ut för åtkomst till minnet.
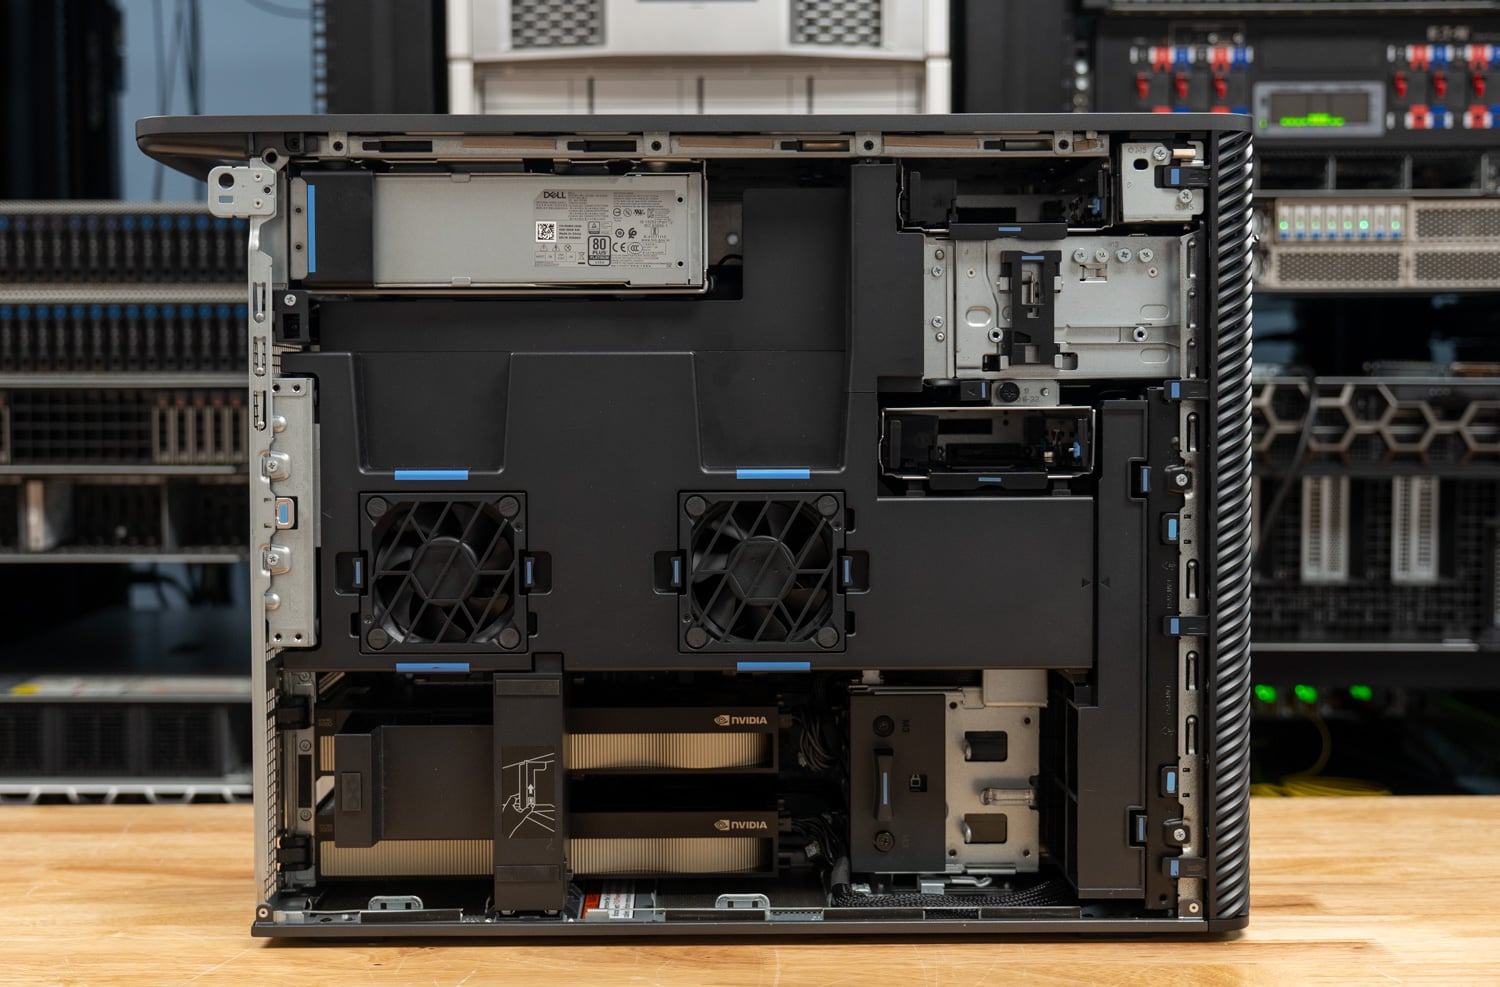
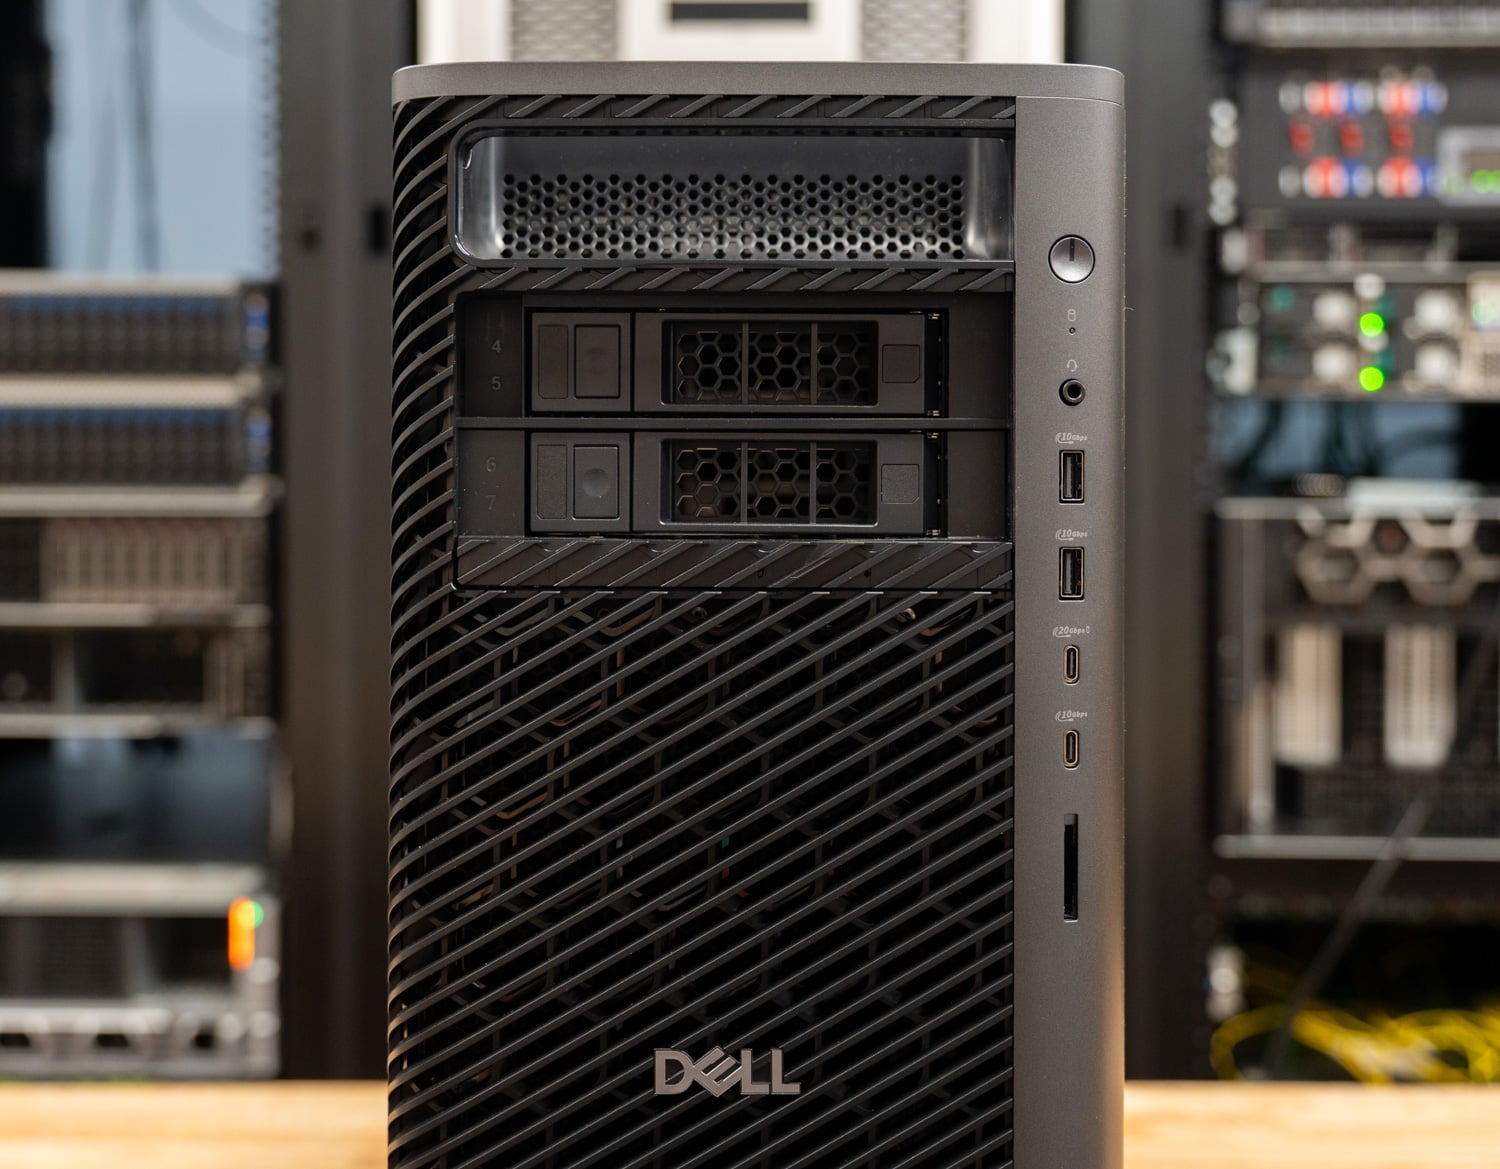
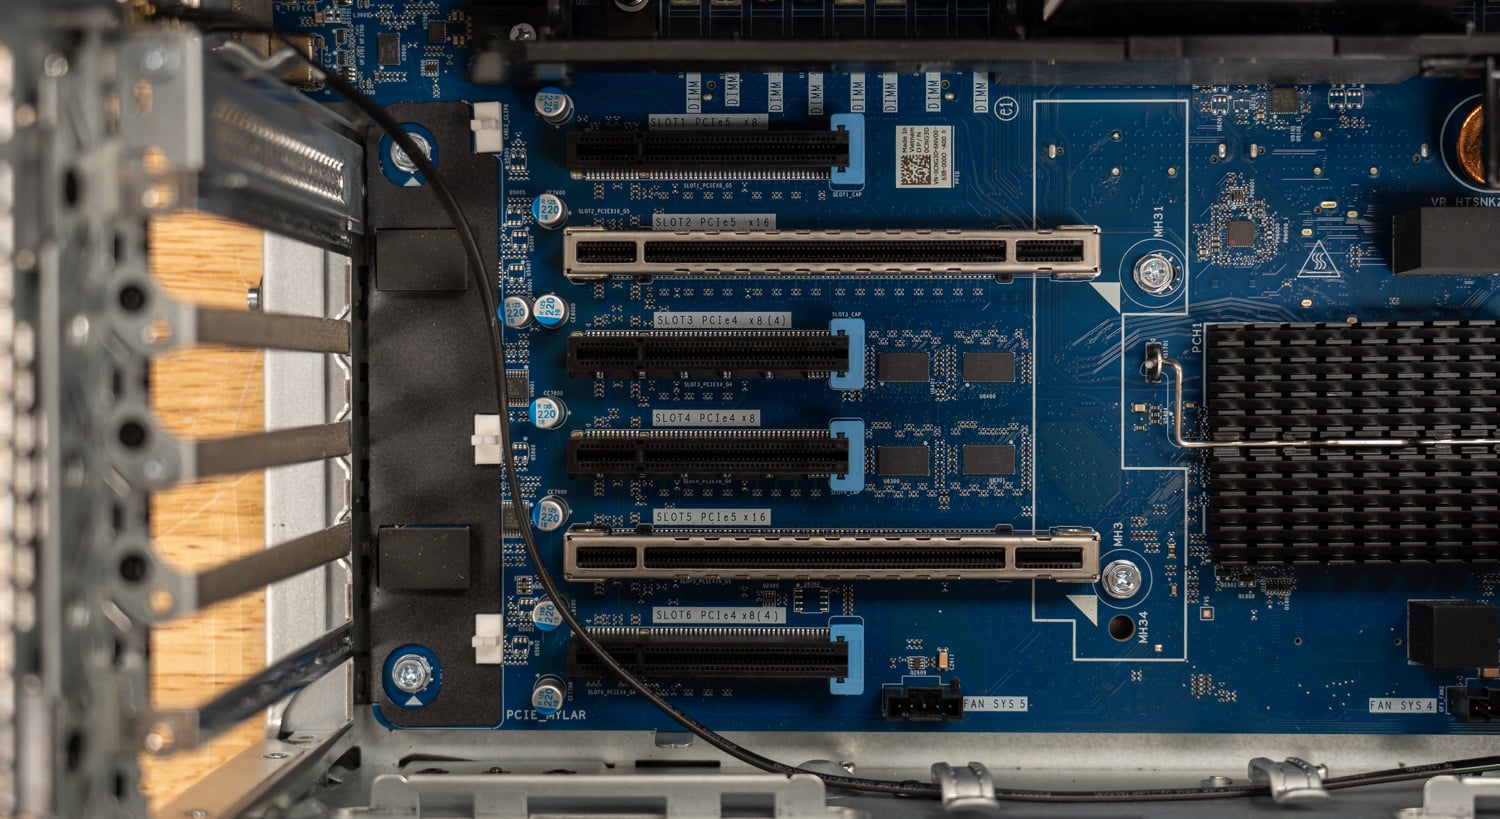
Expansionen sker genom sex PCIe-kortplatser i full höjd: två Gen5 x16-kortplatser som rymmer grafikprocessorerna, en Gen5 x8, en Gen4 x8 och två Gen4-kortplatser med x8-kontakter och x4-kablage. Lagringsutrymmet omfattar tre interna M.2 Gen5-kortplatser och en Gen4-kortplats, två interna 3.5-tums SATA-fack och en främre FlexBay som rymmer upp till fyra NVMe-enheter eller två 3.5-tumsenheter, med en valfri tunn optisk enhet. Vår enhet startar från en intern 2 TB Gen5-enhet och rymmer ytterligare en 2 TB Gen5-enhet i en intern M.2-kortplats.
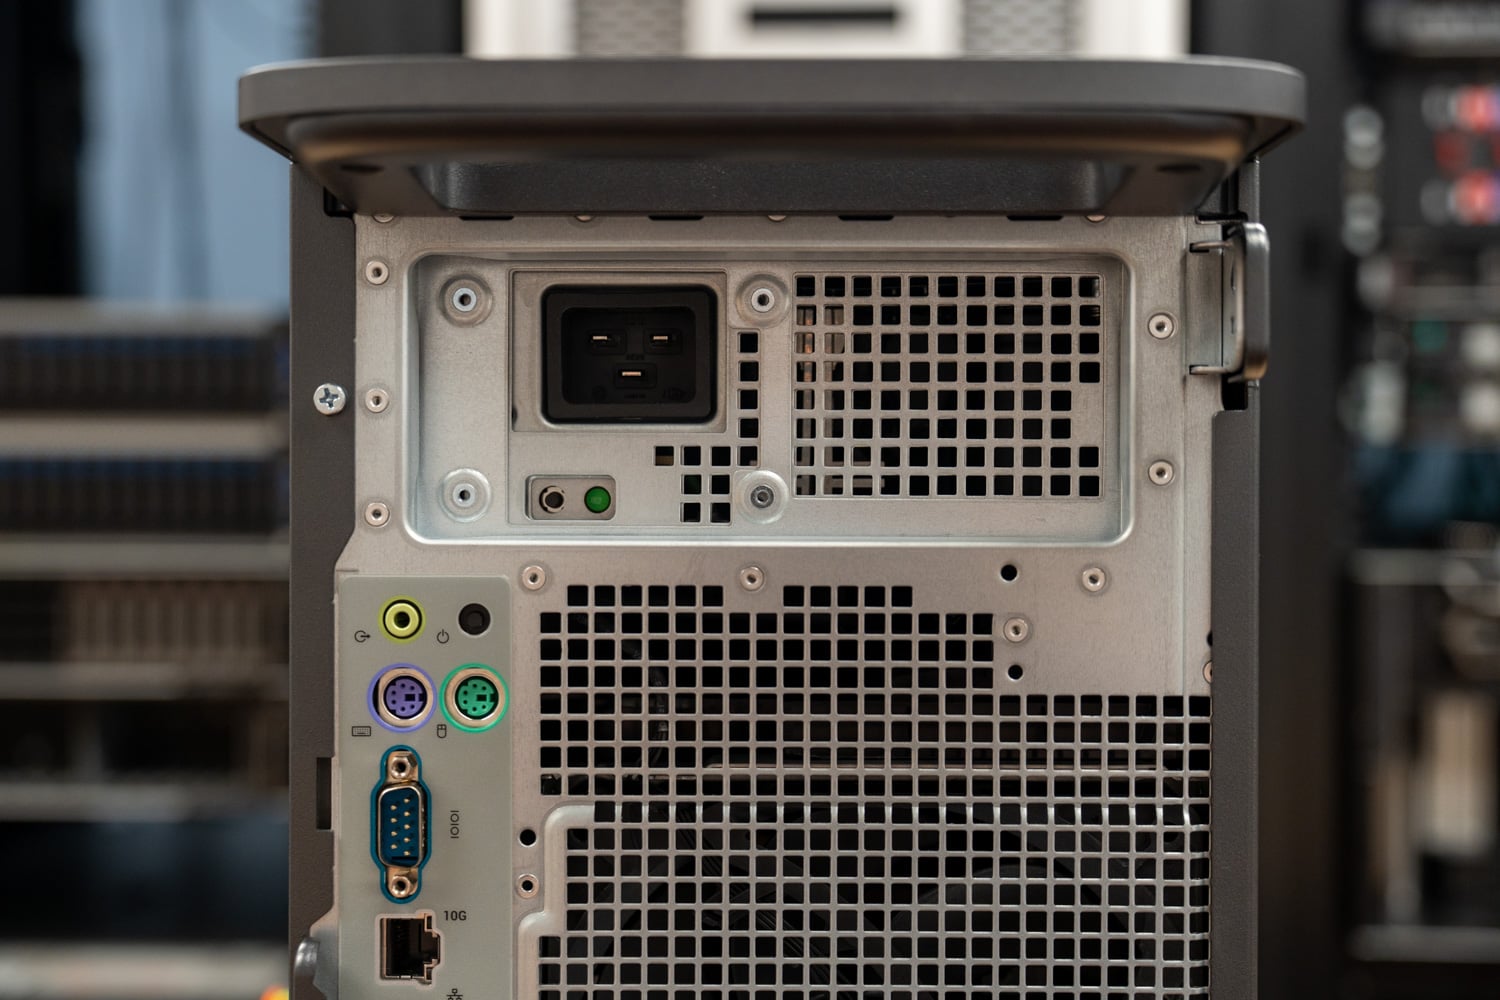
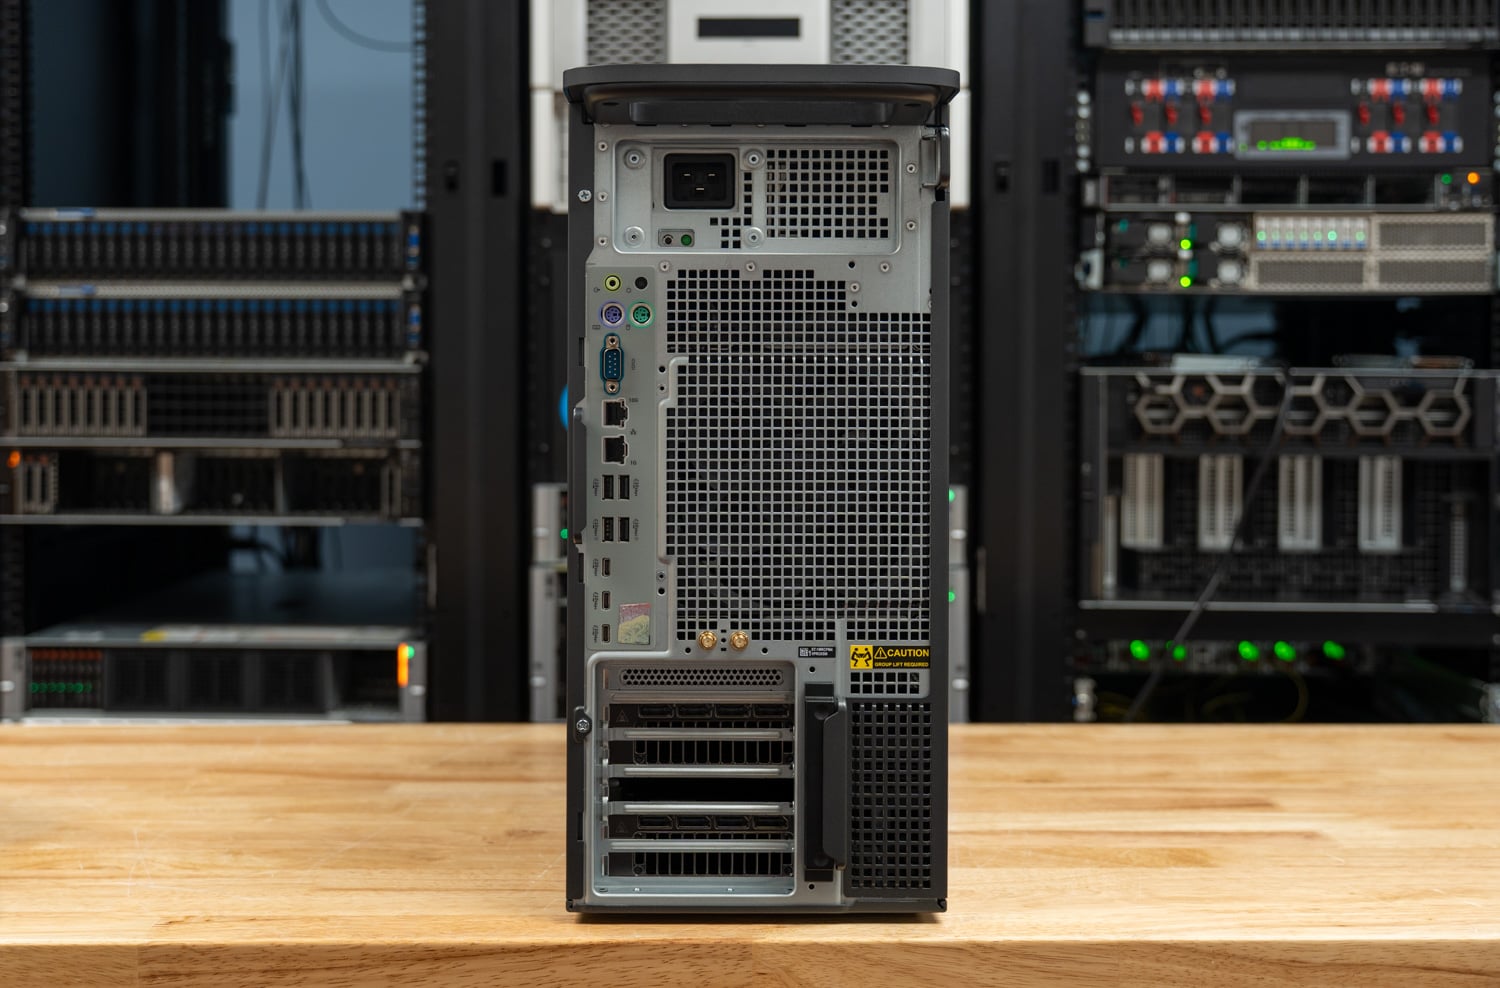
Frontpanelen har ett headsetuttag, två 10 Gbps USB-A-portar, en 20 Gbps USB-C-port med PowerShare, en 10 Gbps USB-C-port och en SD-kortplats som tillval. Baksidan har 10 GbE- och 1 GbE RJ-45-portar, fyra 10 Gbps USB-A-portar, två 10 Gbps USB-C-portar, en 20 Gbps USB-C-port, serieport, två PS/2-portar och linjeutgång. Vår enhet har Intel E810-XXV 25 GbE SFP28-adapter med dubbla portar, MediaTek Wi-Fi 7 MT7925 med Bluetooth 5.4, en mediekortläsare och Dells dubbla USB-C-tilläggskort.
Säkerhet och hantering omfattar TPM 2.0, Dell SafeBIOS, intrångsdetektering i chassit, stöd för självkrypterande hårddiskar, säker BIOS-radering och Intel vPro Enterprise. Dell listar T4 med upp till 85 procent återvunnen plast i viktiga komponenter, 90 procent återvunnet aluminium i handtagen och 11 procent återvunnet stål i chassit, och konfigurationen är ENERGY STAR-kvalificerad.
Dell Pro Precision 9 T4 Specifikationer
| Specifikation | Dell Pro Precision 9 T4 (testad) |
|---|---|
| plattform | |
| Modell | Dell Pro Precision 9 T4 (PW9T4260) |
| Processorn | Intel Xeon 698X, 86 kärnor, 172 trådar, 336 MB cache, 2.0 GHz bas, upp till 4.8 GHz, 350 W |
| Processoralternativ | Xeon 634 (12 kärnor) till Xeon 698X (86 kärnor) |
| Minne | 256 GB (8x 32 GB) DDR5-6400 RDIMM ECC 16 platser, upp till 4 TB |
| Grafiken | 2x NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, 96 GB GDDR7 vardera, 300 W vardera |
| Operativ system | Windows 11 Pro för arbetsstationer (testad på Ubuntu 26.04.1 LTS) |
| lagring | |
| Som konfigurerad | 2x 2TB M.2 2280 Gen5 x4 TLC SED (båda i interna M.2-kortplatser) |
| Interna platser | 3x M.2 2230/2280 Gen5 NVMe 1x M.2 2230/2280 Gen4 NVMe 2x 3.5-tums SATA |
| FlexBay | Upp till 4 NVMe-enheter plus valfri smal ODD eller 2x 3.5-tums SATA |
| Expansion och anslutning | |
| PCIe-kortplatser | 2x Gen5 x16 1x Gen5 x8 1x Gen4 x8 2x Gen4 x8 (x4 elektriska) |
| nätverk | Intel E810-XXV 25GbE SFP28 med dubbla portar (tillägg) Inbyggd 10GbE och 1GbE RJ-45 MediaTek Wi-Fi 7 MT7925, Bluetooth 5.4 |
| Främre hamnar | 1x USB-C 20 Gbps med PowerShare 1x USB-C 10 Gbps 2x USB-A 10 Gbps Headset jack SD-kortplats (tillval) |
| Bakre hamnar | 1x USB-C 20 Gbps 2x USB-C 10 Gbps 4x USB-A 10 Gbps Seriell, 2x PS/2, linjeutgång |
| Kraft och fysisk | |
| Strömförsörjning | 2400W Platinum (1500W-tillval) |
| Mått | 449.8 x 203.7 x 617.5mm (17.70 x 8.01 x 24.31in) |
| Vikt | 24.1 kg till 33.6 kg (53.1 till 74.1 lb) beroende på konfiguration |
| Garanti | ProSupport med service på plats efter fjärrdiagnostik, 36 månader |
| Pris | 65 000 dollar i bas Cirka 66 600 dollar konfigurerat (Dell.com) |
Testuppsättning och metodik
Vi testar avancerade arbetsstationer på Linux, och alla fyra systemen i den här recensionen körde Ubuntu 26.04.1 LTS på kärna 7.0.0-43 med NVIDIA-drivrutin 595.99.02, CUDA 13, llama.cpp build b11716 och Ollama 0.40.3, på Linux prestandaprofil. Resultaten kommer från tre verktyg: sr-client för lokala AI- och klientarbetsbelastningar, sr-harness för kompilering, komprimering, krypto, webbservering och y-cruncher, och sr-suite r5.28 för GROMACS, OpenFOAM, ClickHouse, Valkey och minnesbandbredd. Varje resultat är medianvärdet av upprepade passeringar.
Alla fyra systemen kördes med BIOS-termiskt läge inställt på Ultra Performance, och T4 körde BIOS 1.2.0. T4-kabelhärvan använde sr-kabelhärva 3.3, Precision 7875 använde 3.5, och båda T2:orna använde 3.6, med samma testuppställning för alla dessa utgåvor.
Varje jämförelsesystem är ett Dell-torn med RTX PRO 6000 Blackwell-grafikkort. Dell Precision 7875 parar ihop 96-kärniga Threadripper PRO 9995WX med samma två RTX PRO 6000 Max-Q-kort och 512 GB DDR5-5600, vilket gör den till den närmaste matchningen. Dell Pro Precision 9 T2 kör 24-kärniga Xeon 658X med ett Max-Q-kort, och Dell Pro Max Tower T2 kör 24-kärniga Core Ultra 9 285K med 600W RTX PRO 6000, vilket visar vad den högre effektgränsen lägger till per GPU.
| konfiguration | CPU | Minne | GPU | Test Drive | BIOS termiskt läge |
|---|---|---|---|---|---|
| Dell Pro Precision 9 T4 | Xeon 698X, 86 kärnor | 256 GB DDR5-6400 (8 kanaler) | 2x RTX PRO 6000 Max-Q (300W) | 2TB SK hynix PCB01 Gen5 | Ultra Performance |
| Dell Precision 7875 | Threadripper PRO 9995WX, 96 kärnor | 512 GB DDR5-5600 (8 kanaler) | 2x RTX PRO 6000 Max-Q (300W) | 2TB Samsung Gen4 | Ultra Performance |
| Dell Pro Precision 9 T2 | Xeon 658X, 24 kärnor | 128 GB DDR5-6400 (4 kanaler) | 1x RTX PRO 6000 Max-Q (300W) | Samsung PM9E1 Gen5, 2TB-diskar i en striped array | Ultra Performance |
| Dell Pro Max Tower T2 | Core Ultra 9 285K, 24 kärnor | 128 GB DDR5-4400 (2 kanaler) | 1x RTX PRO 6000 (600W) | 2TB Samsung PM9F1 Gen4 | Ultra Performance |
Lokal AI-prestanda
Varje system här har minst ett RTX PRO 6000 Blackwell med 96 GB GDDR7, så resultaten för en enda GPU mäter kortet, dess effektgräns och hur snabbt plattformen matar det. T4:ans två kort är det som skiljer den från mängden, och våra tester med två GPU:er kör varje modell på tre sätt där det gäller: två oberoende servrar, en per GPU, för dataflöde; en modell uppdelad i lager över båda korten; och, för MiniMax M2.7, ett kort med resten av modellen i systemminnet.
LLM-serverar på en GPU
| llama.cpp-server, en GPU (utdatatokens/s, högre desto bättre) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| Ministral 3 3B, en förfrågan | 240.5 | 252.6 | 243.8 | 261.6 |
| Ministral 3 3B, topp | 582.5 | 637.6 | 602.6 | 658.8 |
| Ministral 3 8B, en förfrågan | 166.8 | 171.1 | 167.3 | 194.5 |
| Ministral 3 8B, topp | 383.6 | 398.9 | 384.9 | 477.5 |
| Qwen3.8 27B, en förfrågan | 54.9 | 55.4 | 53.8 | 64.5 |
| Qwen3.8 27B, topp | 158.1 | 162.8 | 155.8 | 194.7 |
| gpt-oss 120B, en förfrågan | 166.9 | 171.2 | 164.5 | 193.0 |
| gpt-oss 120B, topp | 424.8 | 458.4 | 413.1 | 520.7 |
| gpt-oss 120B, en förfrågan, tid till första token (ms, kortare är bättre) | 1,189 | 1,181 | 1,213 | 844 |
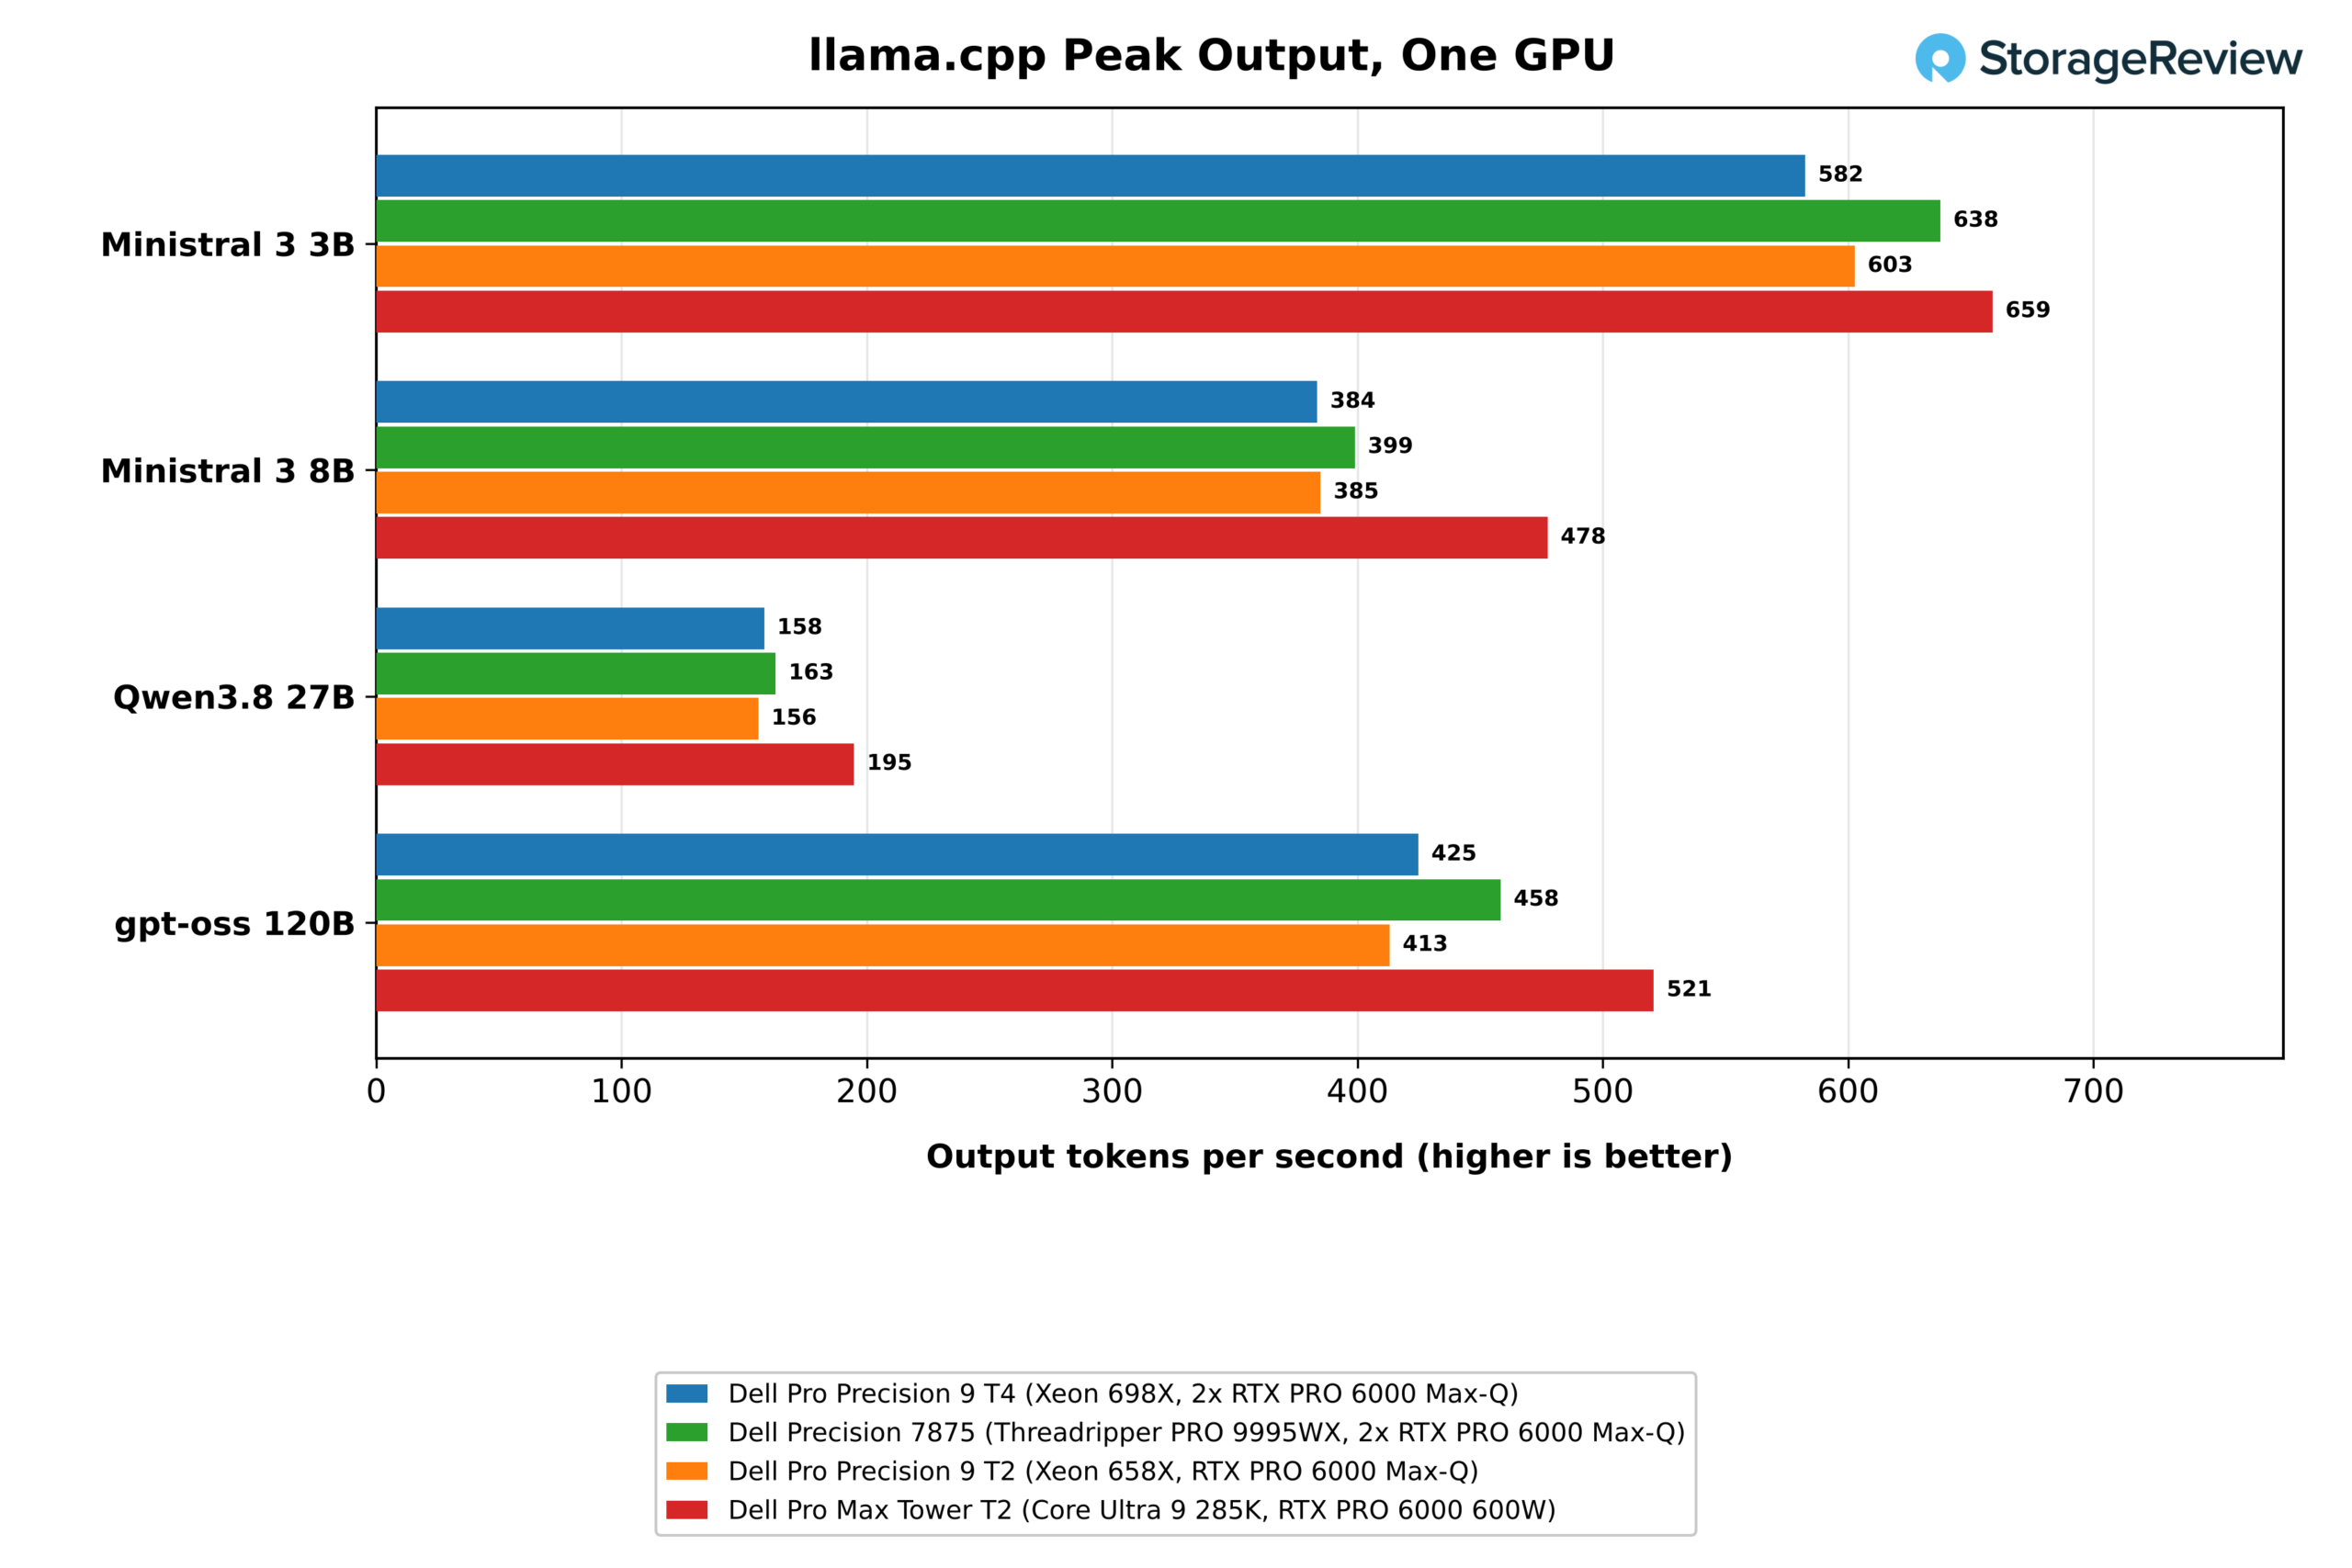
På en GPU landar T4 där kortets gräns på 300W sätter den. Den genererade 166.9 tokens per sekund för en användare på gpt-oss 120B och nådde en topp på 424.8 över 64 samtidiga förfrågningar, inom 1 till 9 procent av Precision 7875:s identiska Max-Q-kort över alla fyra modeller och i nivå med Pro Precision 9 T2. 600W-kortet i Pro Max Tower T2 är 13 till 25 procent snabbare som mest på alla modeller och når 520.7 tokens per sekund på gpt-oss 120B.
Två GPU:er: Repliker och delade modeller
| llama.cpp-server, två GPU:er (utdatatokens/s, högre desto bättre) | Dell Pro Precision 9 T4 | Dell Precision 7875 |
|---|---|---|
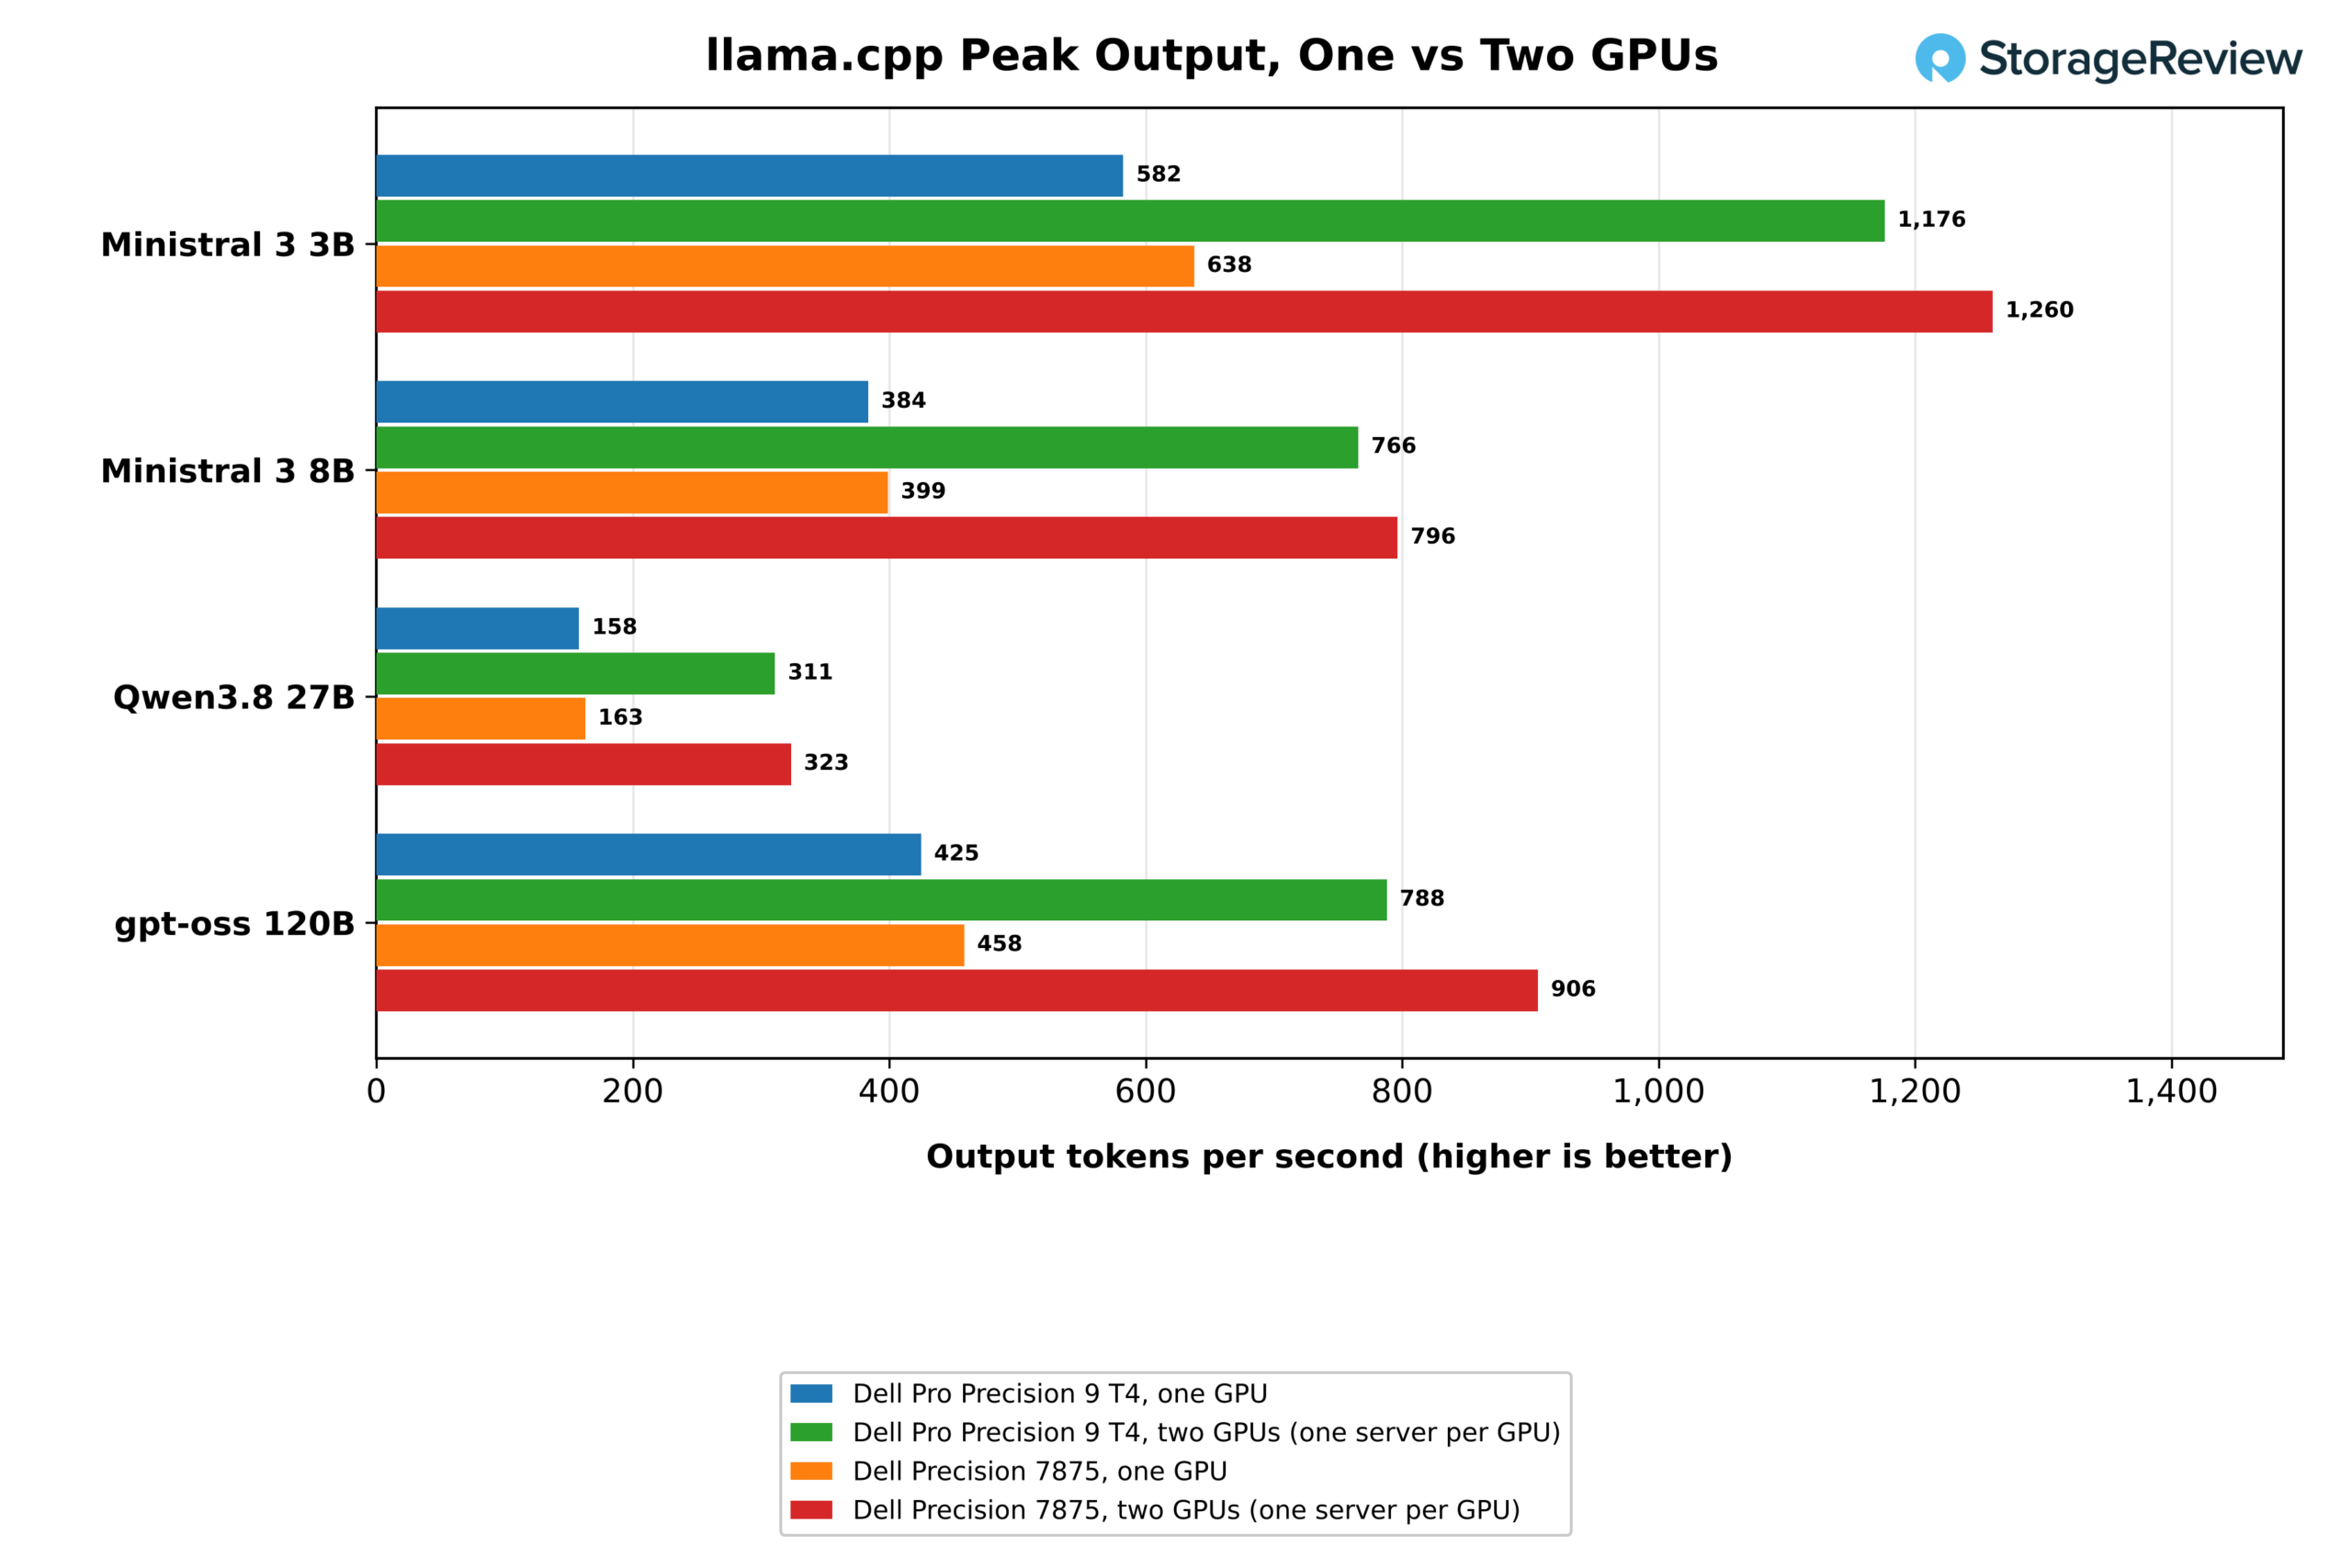
| Ministral 3 3B, topp, en server per GPU | 1,176.1 | 1,260.2 |
| Ministral 3 8B, topp, en server per GPU | 765.7 | 796.4 |
| Qwen3.8 27B, topp, en server per GPU | 310.8 | 323.2 |
| gpt-oss 120B, topp, en server per GPU | 787.9 | 905.8 |
| gpt-oss 120B, en begäran, uppdelad per lager | 170.6 | 182.4 |
| gpt-oss 120B, topp, uppdelad i lager | 539.2 | 619.4 |
Att köra en server per GPU ökade T4:s maximala utdata med 1.85 till 2.02 gånger över de fyra modellerna. Topputdata ökade från 582.5 till 1 176,1 tokens per sekund på Ministral 3 3B, från 383.6 till 765.7 på 8B-modellen och från 158.1 till 310.8 på Qwen3.8 27B, en skalning med 1.97 till 2.02 gånger. gpt-oss 120B skalades 1.85 gånger till 787.9 tokens per sekund på T4 och 1.98 gånger till 905.8 på Precision 7875, som nådde sin topp vid 128 samtidiga förfrågningar, där T4 nådde sin topp på 64.
Att dela gpt-oss 120B lagervis över båda korten är det långsammare sättet att använda den andra GPU:n när modellen redan får plats på ett av dem. Den betjänade en användare med 170.6 tokens per sekund, inom 3 procent av ett enda kort, och nådde en topp på 539.2, 27 procent över en GPU och långt under de 787.9 som två replikor levererade. Den delade layouten förtjänar sin plats med modeller som inte får plats på ett kort, och det är där MiniMax M2.7 kommer in i bilden.
| llama.cpp-server, gpt-oss 120B, 8 192 token-prompter, 1 024 token-utdata | T4, en grafikkort | T4, två GPU:er, en server per GPU | T4, två GPU:er, uppdelade i lager | Precision 7875, två GPU:er, en server per GPU |
|---|---|---|---|---|
| 1 samtidiga: total dataflöde (tokens/s) | 1,502 | 1,504 | 1,536 | 1,530 |
| 1 samtidiga: tid till första token, median (ms, lägre desto bättre) | 1,189 | 1,180 | 719 | 1,189 |
| 8 samtidiga: total dataflöde (tokens/s) | 2,760 | 4,820 | 3,300 | 4,949 |
| 8 samtidiga: utdata per användare (tokens/s) | 38.3 | 66.9 | 45.8 | 68.7 |
| 8 samtidiga: tid till första token, median (ms, lägre desto bättre) | 2,654 | 2,523 | 1,622 | 2,472 |
| 64 samtidiga: total dataflöde (tokens/s) | 3,823 | 7,091 | 4,853 | 7,557 |
| 64 samtidiga: utdata per användare (tokens/s) | 6.6 | 12.3 | 8.4 | 13.1 |
| 64 samtidiga: tid till första token, median (ms, lägre desto bättre) | 3,874 | 3,226 | 2,852 | 2,867 |
Den fullständiga svepet på gpt-oss 120B visar hur det andra kortet ändrar kurvan, med total genomströmningsräkning av prompt- och utdatatokens tillsammans. En GPU steg från 1 502 tokens per sekund för en enskild förfrågan till 2 760 vid åtta och 3 823 vid 64, där varje användare fick 6.6 utdatatokens per sekund. Med en server per GPU kördes åtta förfrågningar med 4 820 och 64 förfrågningar nådde 7 091, 1.85 gånger ett kort, med 12.3 tokens per sekund per användare. En uppdelning av modellen nådde en lägre topp på 4 853 men returnerade en enskild användares första token på 719 ms mot 1 189 ms.

MiniMax M2.7: En modell som är för stor för ett kort
| MiniMax M2.7 Q4_K_M, 129.3 GB (högre är bättre om inte annat anges) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| En GPU plus system-RAM, en begäran (tokens/s) | 30.3 | 32.8 | 22.6 | 15.8 |
| En GPU plus system-RAM, maximalt (tokens/s) | 35.5 | 39.1 | 27.7 | 18.0 |
| En GPU plus system-RAM, tid till första token (ms, kortare desto bättre) | 16,224 | 16,143 | 16,216 | 18,522 |
| Två GPU:er uppdelade per lager, en begäran (tokens/s) | 83.7 | 85.0 | Enkel GPU | Enkel GPU |
| Två GPU:er uppdelade efter lager, topp (tokens/s) | 127.3 | 129.5 | Enkel GPU | Enkel GPU |
| Två GPU:er uppdelade efter lager, tid till första token (ms, kortare är bättre) | 3,138 | 3,162 | Enkel GPU | Enkel GPU |
| Kall belastning, en GPU plus RAM (s, lägre desto bättre) | 40.5 | 65.8 | 37.6 | 81.1 |
| Kall belastning, två GPU:er delade (s, lägre desto bättre) | 27.6 | 50.7 | Enkel GPU | Enkel GPU |
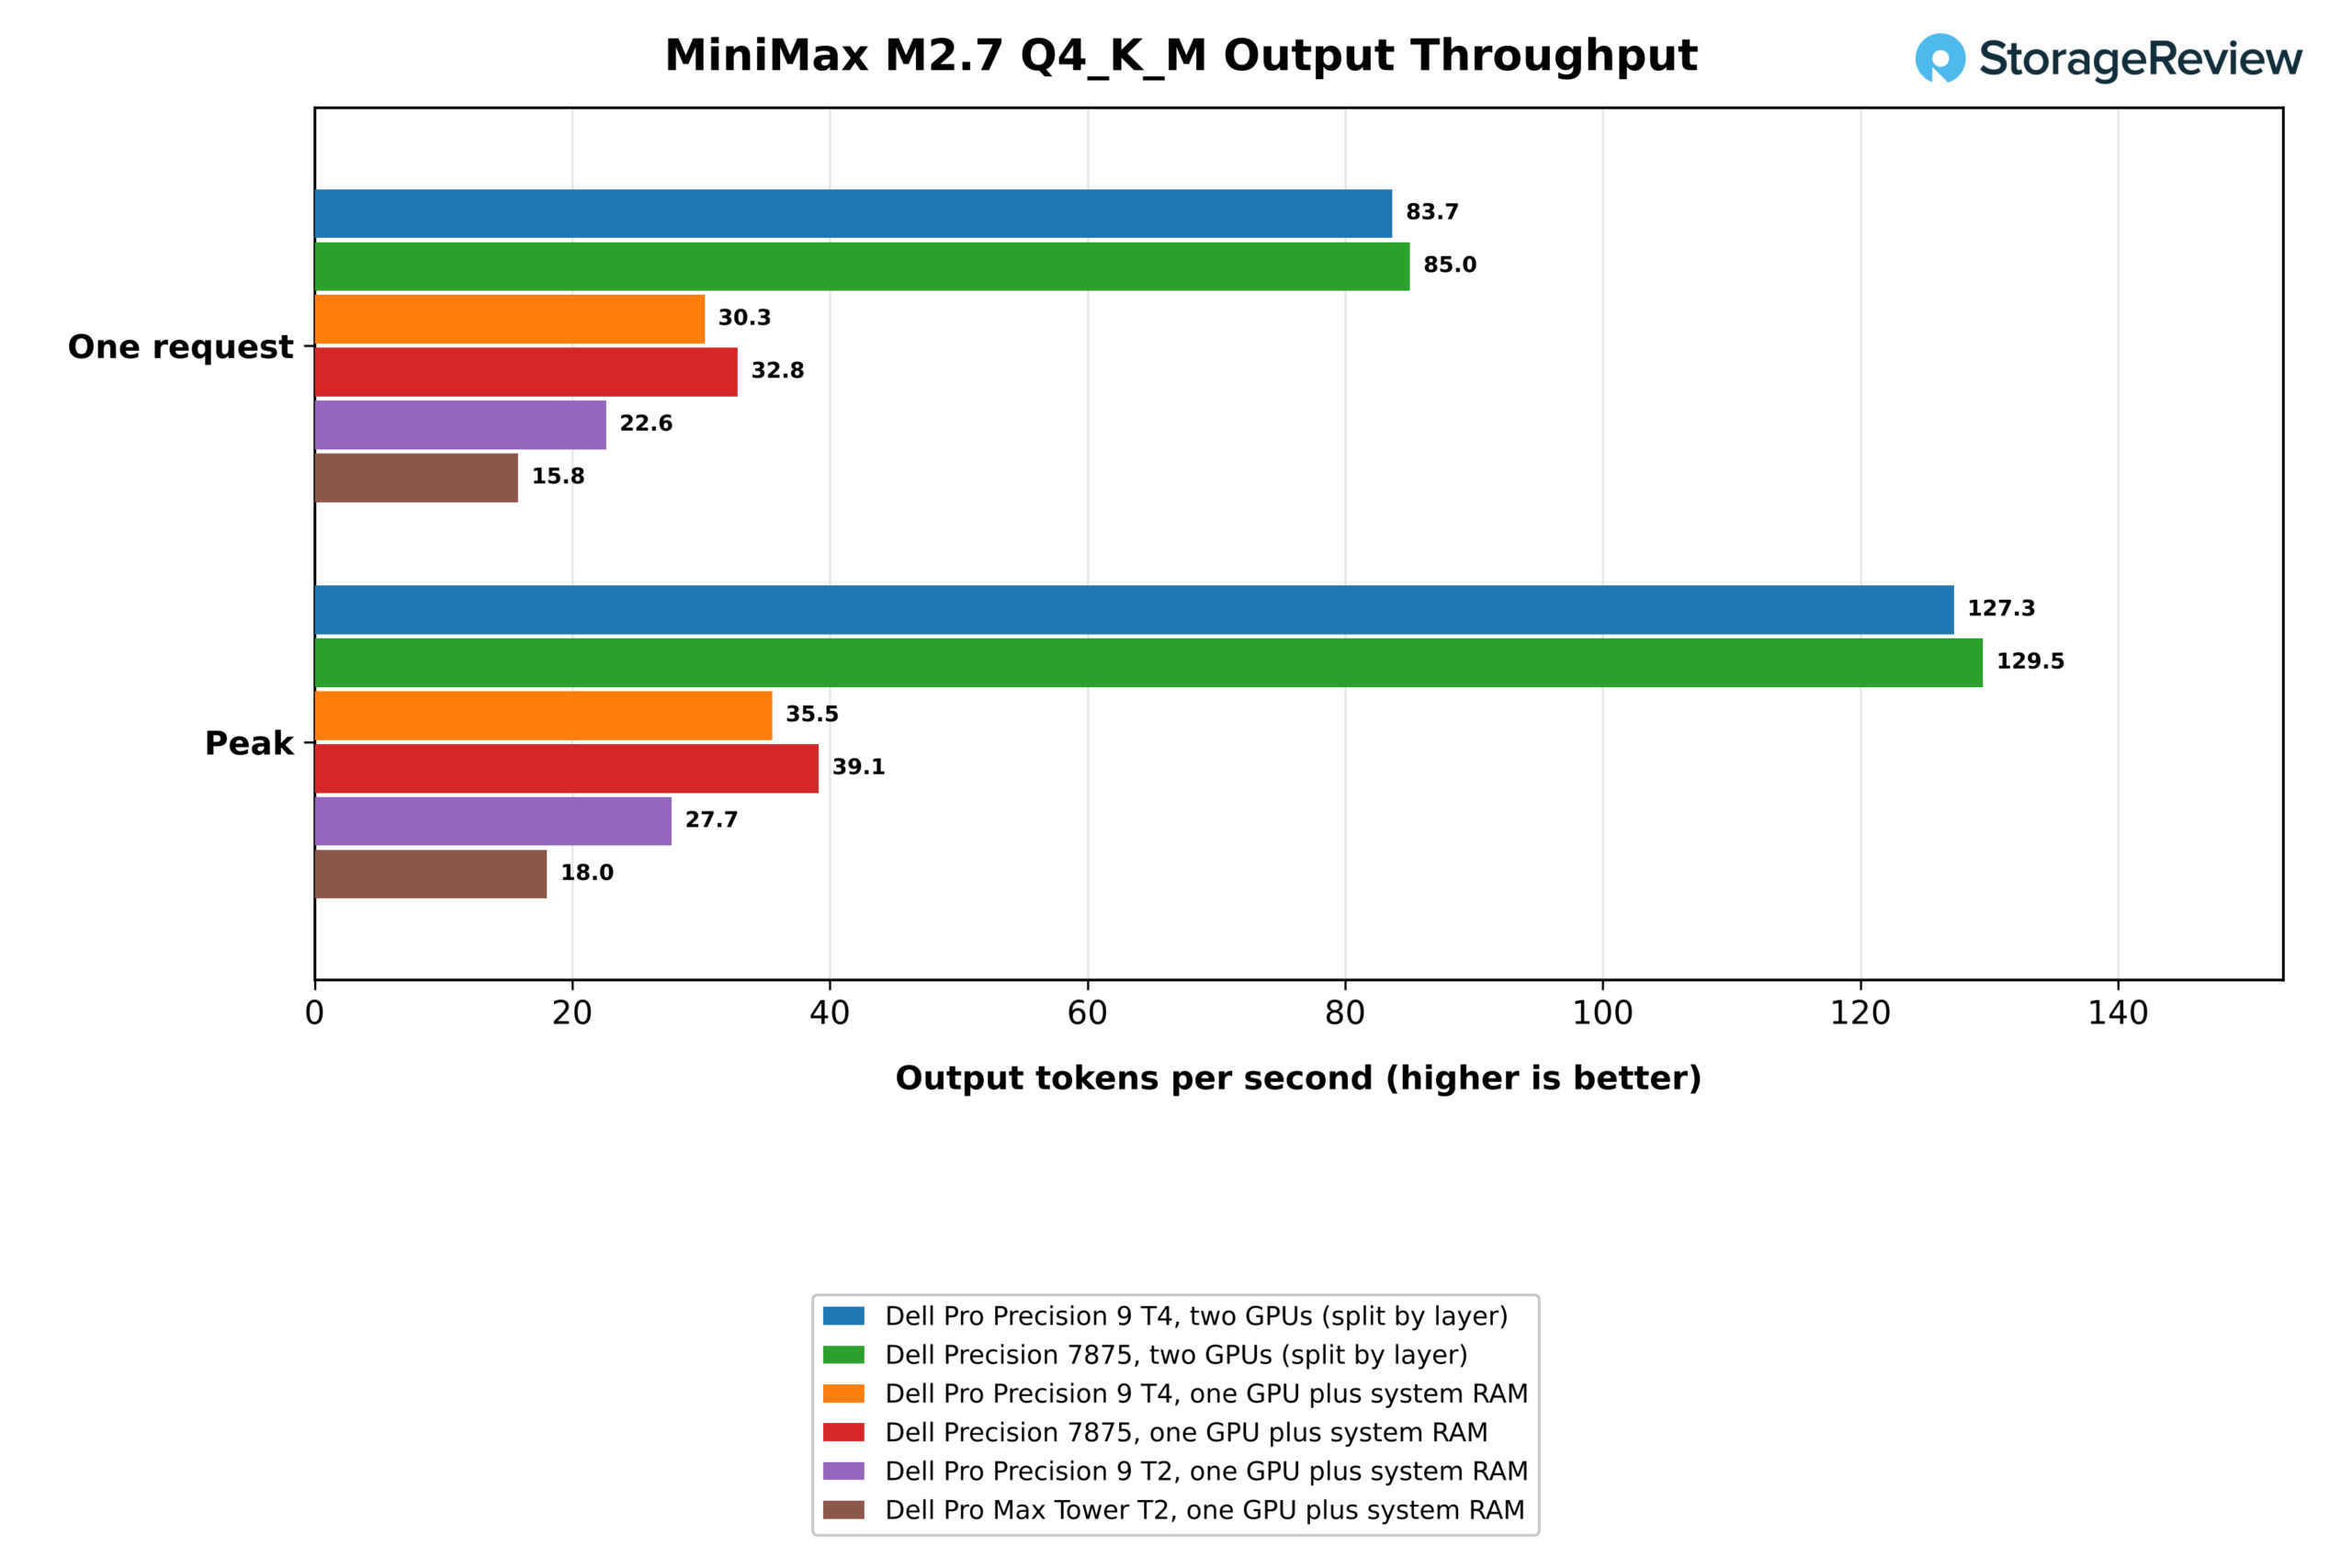
MiniMax M2.7 är en expertmodell med 230 miljarder parametrar, och vår 4-bitars kvantisering tar 129.3 GB, mer än de 96 GB som finns på ett RTX PRO 6000. På ett kort med resten i systemminnet genererade T4 30.3 tokens per sekund för en användare och det tog 16.2 sekunder att returnera den första token. Fördelat på båda korten genererade den 83.7 tokens per sekund, 2.8 gånger snabbare, returnerade den första token på 3.1 sekunder och nådde en topp på 127.3 tokens per sekund jämfört med 35.5.
Resultaten för en enda grafikprocessor visar hur mycket värdplattformen spelar roll när en modell väl laddas ner i systemminnet. T4:ans åtta kanaler med DDR5-6400 placerar den 34 procent före fyrkanals-Pro Precision 9 T2 med 22.6 tokens per sekund och 1.9 gånger före tvåkanals-Pro Max Tower T2 med 15.8, även om Pro Max Tower T2:s 600W-kort är snabbare på alla modeller som passar. Precision 7875 överträffade T4 med 32.8 tokens per sekund med 35 procent mindre minnesbandbredd, så bandbredden ensam avgör inte detta resultat. Vi rapporterar 7875:ans ledning som uppmätt och har inte isolerat dess orsak.
Modellladdning
| Ollama 0.40.3 och llama.cpp-modellen laddas (s, lägre desto bättre) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| gpt-oss:20b (12.8 GB), kall | 5.79 | 7.61 | 5.57 | 7.95 |
| gpt-oss:20b, varm | 3.45 | 2.50 | 3.47 | 3.05 |
| gpt-oss:120b (60.9 GB), kall | 15.16 | 25.80 | 15.16 | 28.18 |
| gpt-oss:120b, varm | 7.49 | 5.01 | 7.87 | 6.81 |
| gpt-oss:120b, kall, en kopia på varje GPU | 26.47 | 35.55 | Enkel GPU | Enkel GPU |
| MiniMax M2.7 (129.3 GB), kall, en GPU plus RAM | 40.5 | 65.8 | 37.6 | 81.1 |
| MiniMax M2.7, varm, en GPU plus RAM | 28.6 | 15.2 | 36.7 | 80.5 |
Kalla laddningar gynnar Gen5-diskarna, där T4 laddar gpt-oss:120b från sin SK hynix Gen5 SSD på 15.2 sekunder, vilket matchar Pro Precision 9 T2 och är långt före 25.8 och 28.2 sekunder på Gen4-utrustade Precision 7875 och Pro Max Tower T2. Varma laddningar från sidcachen är i omvänd ordning, med 7875 på 5.0 sekunder mot 7.5 på T4, och att ladda en kopia på varje GPU samtidigt tog 26.5 sekunder på T4.
Hämtningsförstärkt generering i stor skala
| RAG över 1 002 067 Wikipedia-avsnitt | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| Inbäddning, en GPU (passager/s) | 1,126 | 1,196 | 1,141 | 1,388 |
| Bädda in väggtid, en GPU (s, lägre desto bättre) | 890 | 838 | 878 | 722 |
| Inbäddning, två GPU:er (passager/s) | 2,162 | 2,371 | Enkel GPU | Enkel GPU |
| Bädda in väggtid, två GPU:er (s, lägre desto bättre) | 464 | 423 | Enkel GPU | Enkel GPU |
| HNSW-indexuppbyggnad (s, lägre desto bättre) | 27.3 | 34.8 | 46.3 | 118.6 |
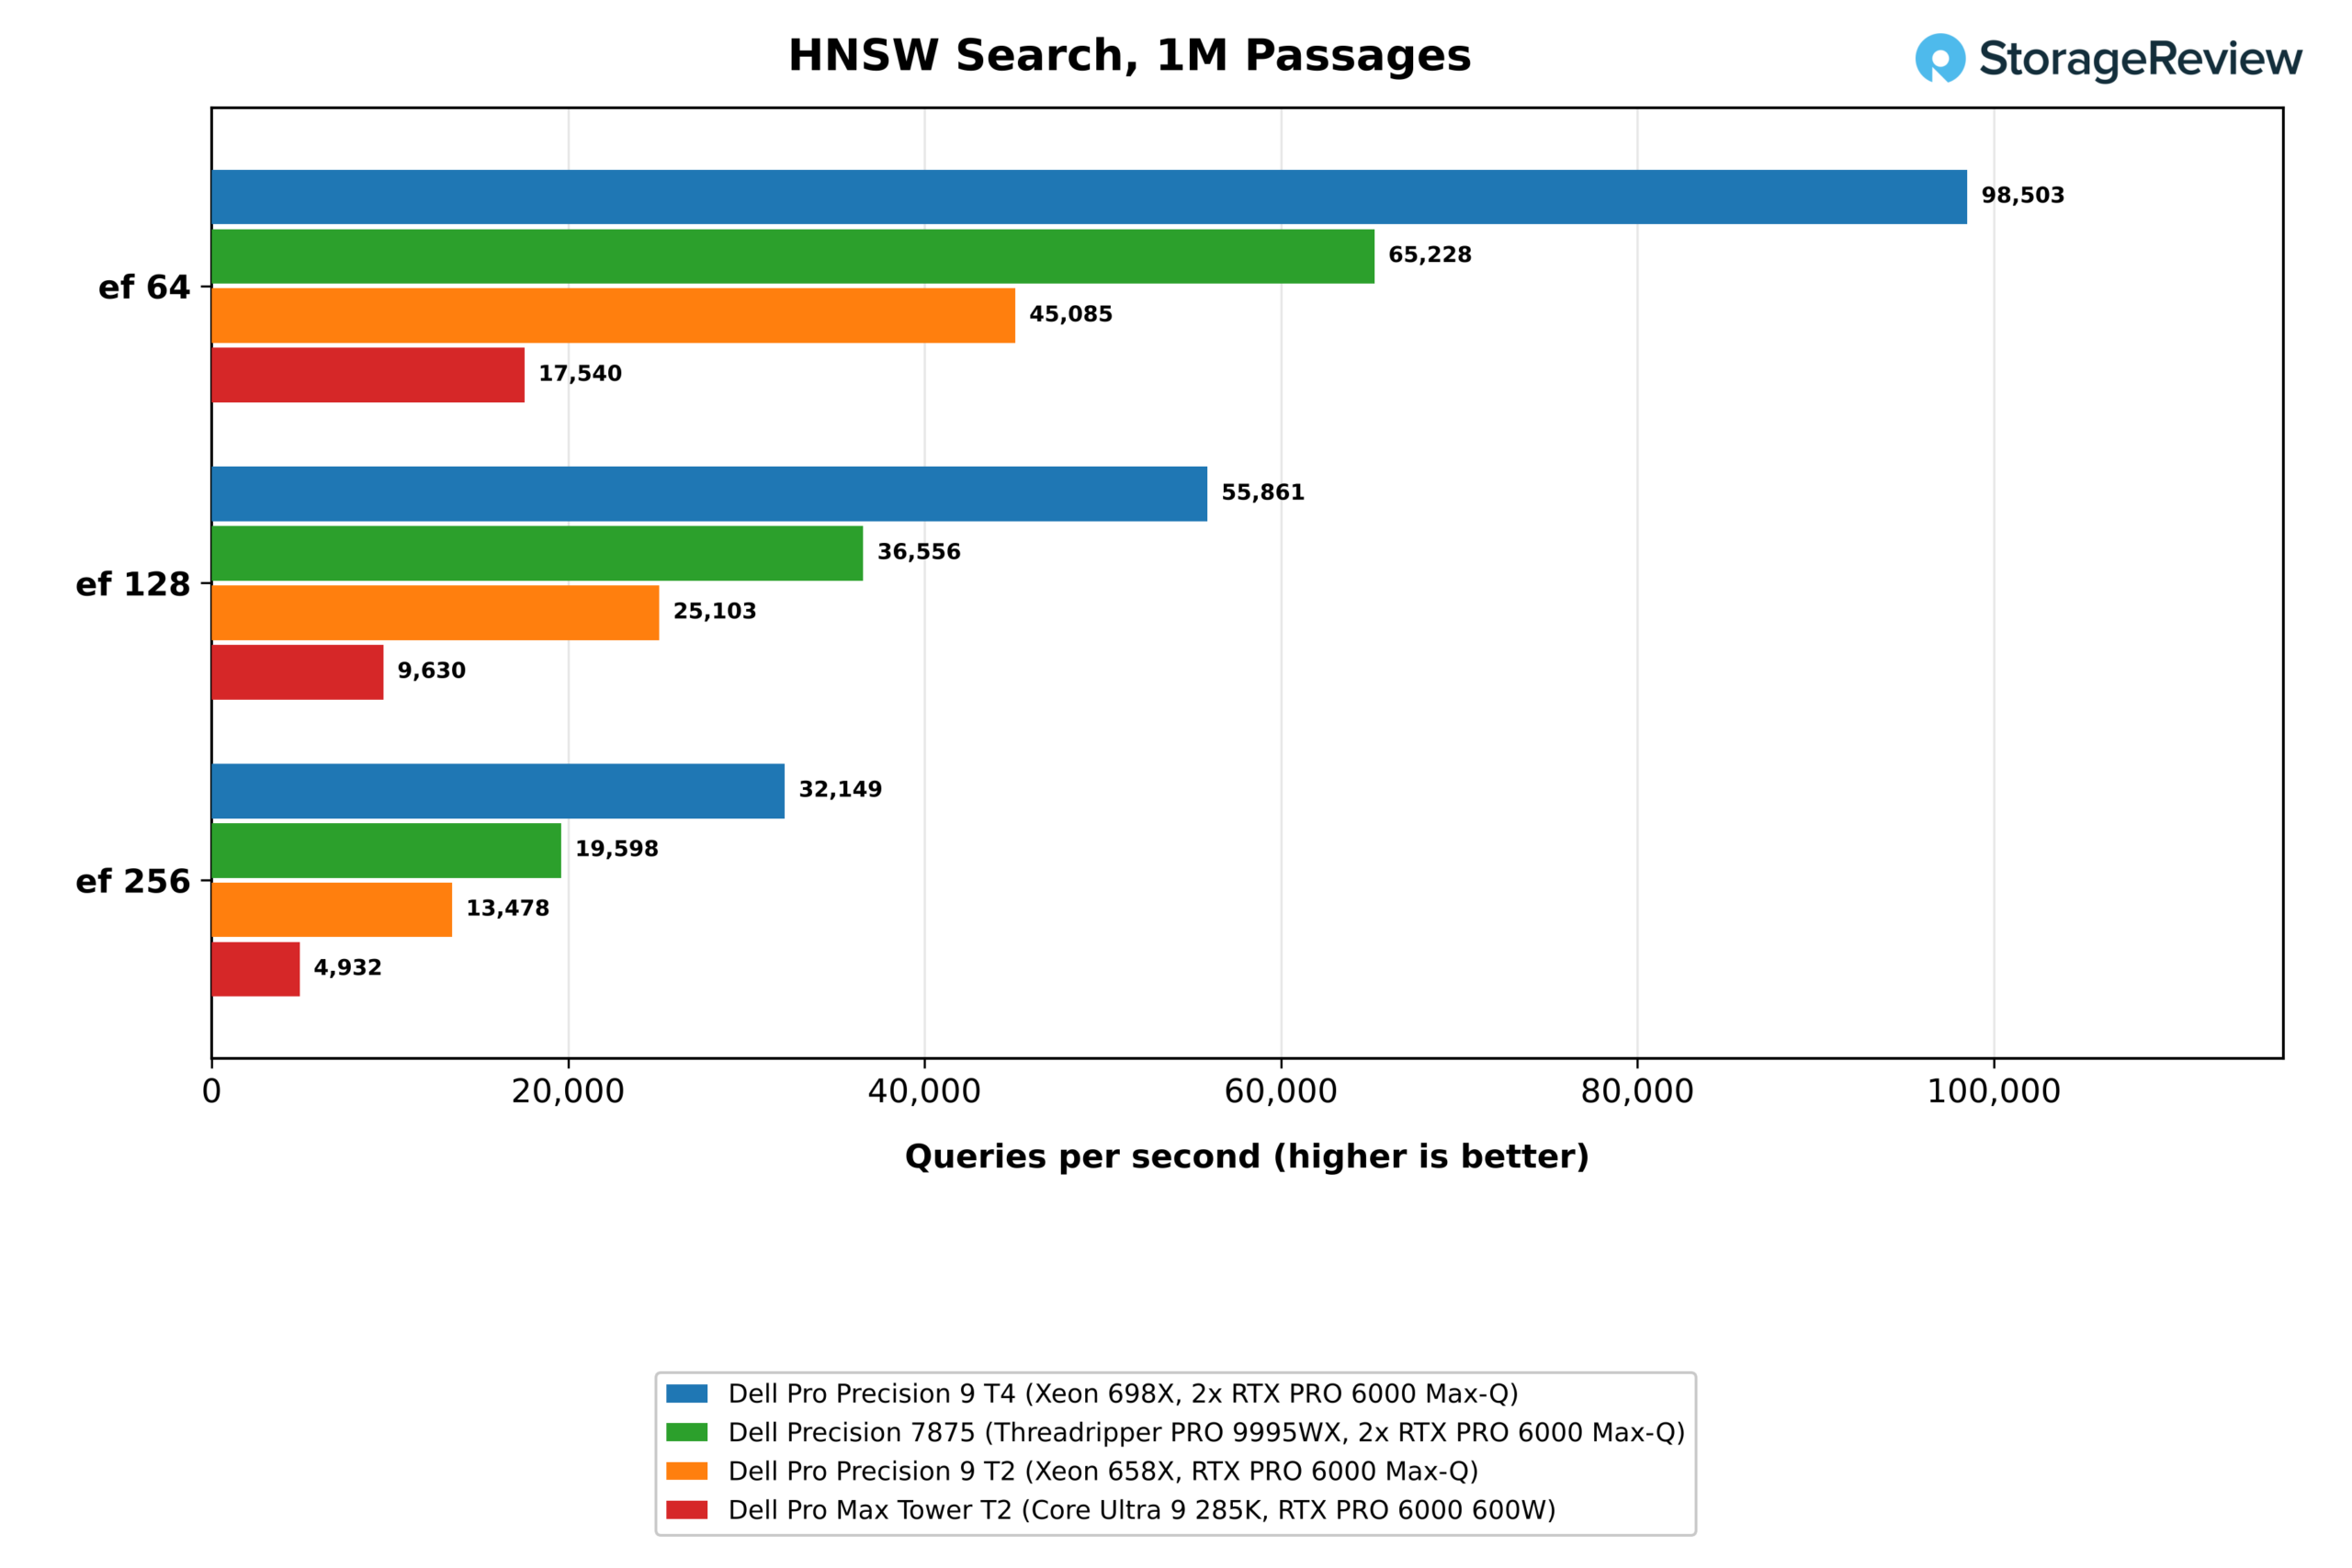
| HNSW-sökning, ef 64 (frågor/s) | 98,503 | 65,228 | 45,085 | 17,540 |
| HNSW-sökning, ef 256 (frågor/s) | 32,149 | 19,598 | 13,478 | 4,932 |
| Recall@5 jämfört med exakt sökning, ef 256 (%) | 97.59 | 97.67 | 97.26 | 97.70 |
| Fråga att besvara p50 (s, lägre desto bättre) | 0.123 | 0.082 | 0.117 | 0.095 |
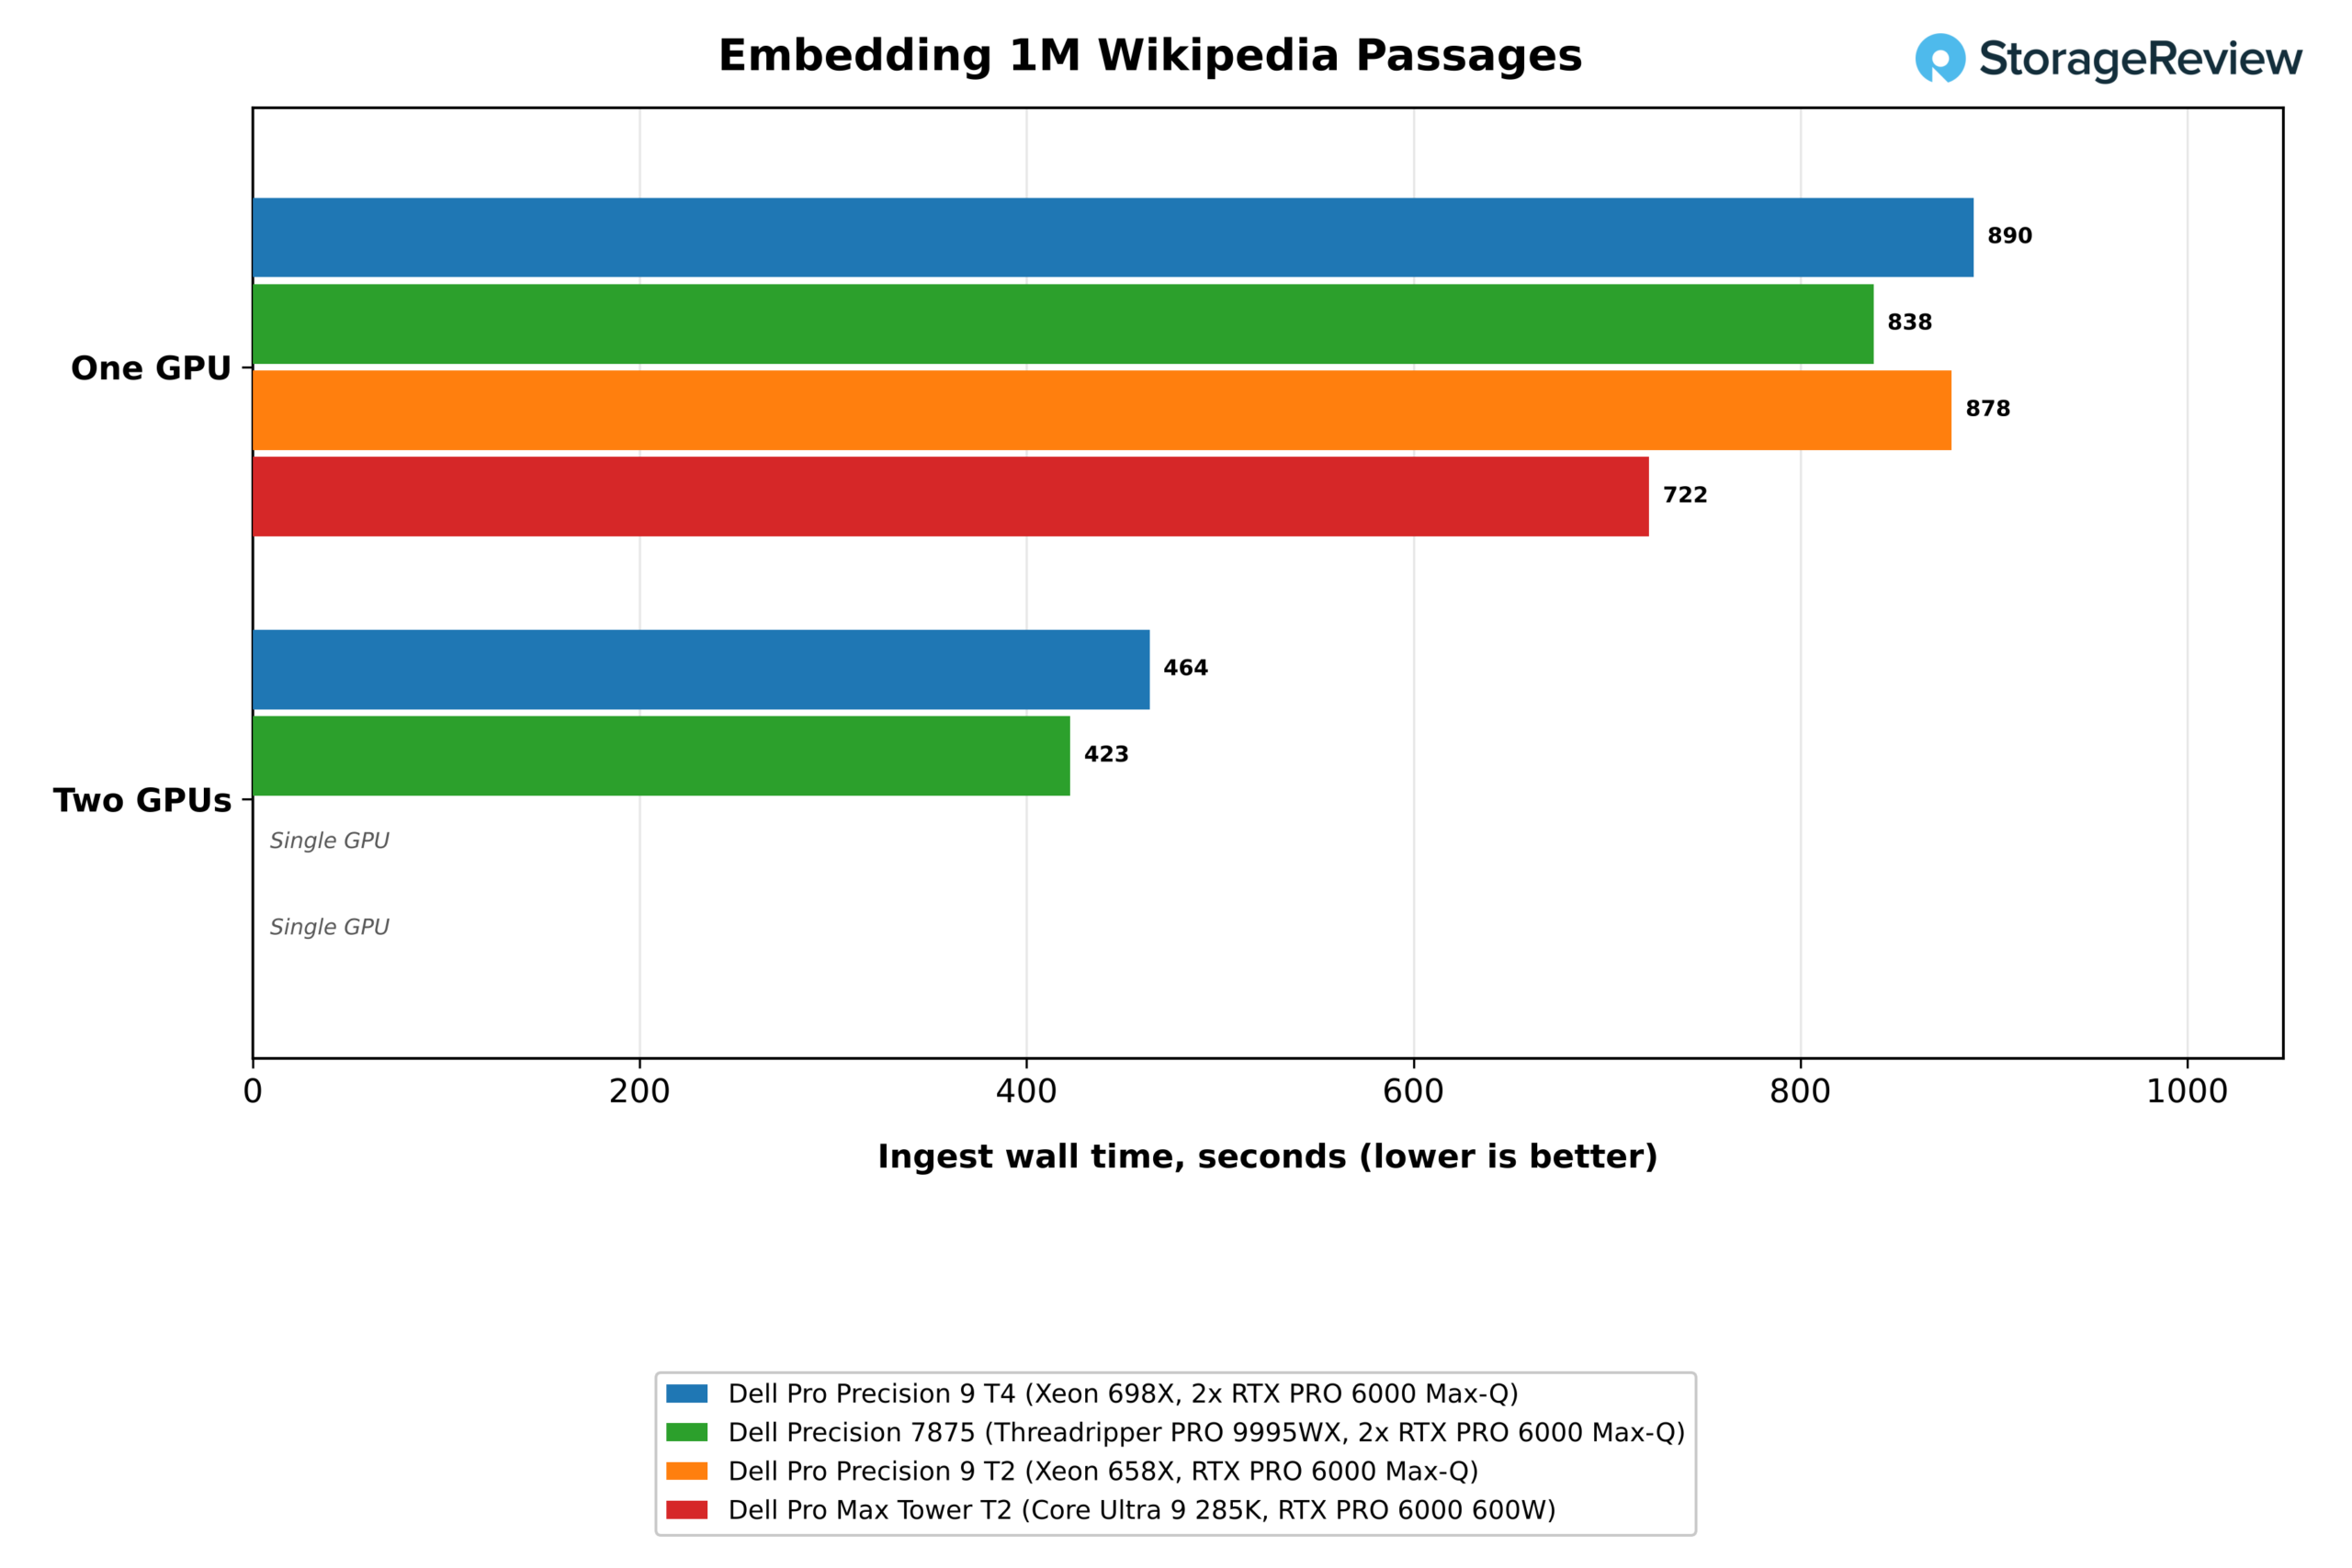
RAG-at-scale-testet gömmer SQuAD-frågor bland en miljon Wikipedia-passager, bäddar in dem med nomic-embed-text, bygger ett HNSW-index och svarar med Phi-4-mini. Inbäddningen tog 890 sekunder på en T4-GPU och 464 sekunder på två, en 1.92x hastighetsökning, och Precision 7875 klarade på 423 sekunder på två kort. 600W-kortet i Pro Max Tower T2 är den snabbaste enskilda GPU:n här med 722 sekunder.
Indexbyggande och vektorsökning körs på processorn, och det är där T4 leder. Den byggde HNSW-indexet på 27.3 sekunder mot 34.8 på Precision 7875 och 118.6 på Pro Max Tower T2, och sökte med 98 503 frågor per sekund vid ef 64, 1.51 gånger 7875 och 5.6 gånger Core Ultra-systemet. Vid ef 256 höll den 32 149 frågor per sekund med 97.6 procents återkallelse mot exakt sökning, och svaren kom tillbaka inom en median på 0.12 sekunder.
Finjustering
| Ministral 3 8B LoRA, BF16, en epok av Dolly 15k | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| Epokträningstid, en GPU (minuter, lägre desto bättre) | 31.5 | 27.2 | 30.6 | 22.3 |
| Genomströmning, en GPU (tokens/s) | 1,584 | 1,834 | 1,631 | 2,236 |
| Utesluten förlust före och efter träning, en GPU | 1.534 till 1.169 | 1.534 till 1.172 | 1.534 till 1.167 | 1.534 till 1.167 |
| Epokträningstid, två GPU:er (minuter, lägre desto bättre) | 19.7 | 18.1 | Enkel GPU | Enkel GPU |
| Genomströmning, två GPU:er (tokens/s) | 2,528 | 2,754 | Enkel GPU | Enkel GPU |
| Hastighetsökning från den andra GPU:n | 1.60x | 1.50x | Enkel GPU | Enkel GPU |
| Undanhållen förlust efter träning, två GPU:er | 1.167 | 1.168 | Enkel GPU | Enkel GPU |
LoRA-testet, som sträcker sig över en epok, finjusterar Ministral 3 8B i BF16 på Dolly 15k över 1 849 steg och får 200 hold-out-exempel per 100 steg. Varje system startade med en hold-out-förlust på 1.534 och slutade mellan 1.167 och 1.172, så resultatet som skiljer dem åt är den tid epoken tar. En T4 GPU slutförde på 31.5 minuter med 1 584 tokens per sekund, inom 3 procent av Pro Precision 9 T2 på samma Max-Q-kort. Precision 7875 tog 27.2 minuter, och 600W-kortet i Pro Max Tower T2 tog 22.3.
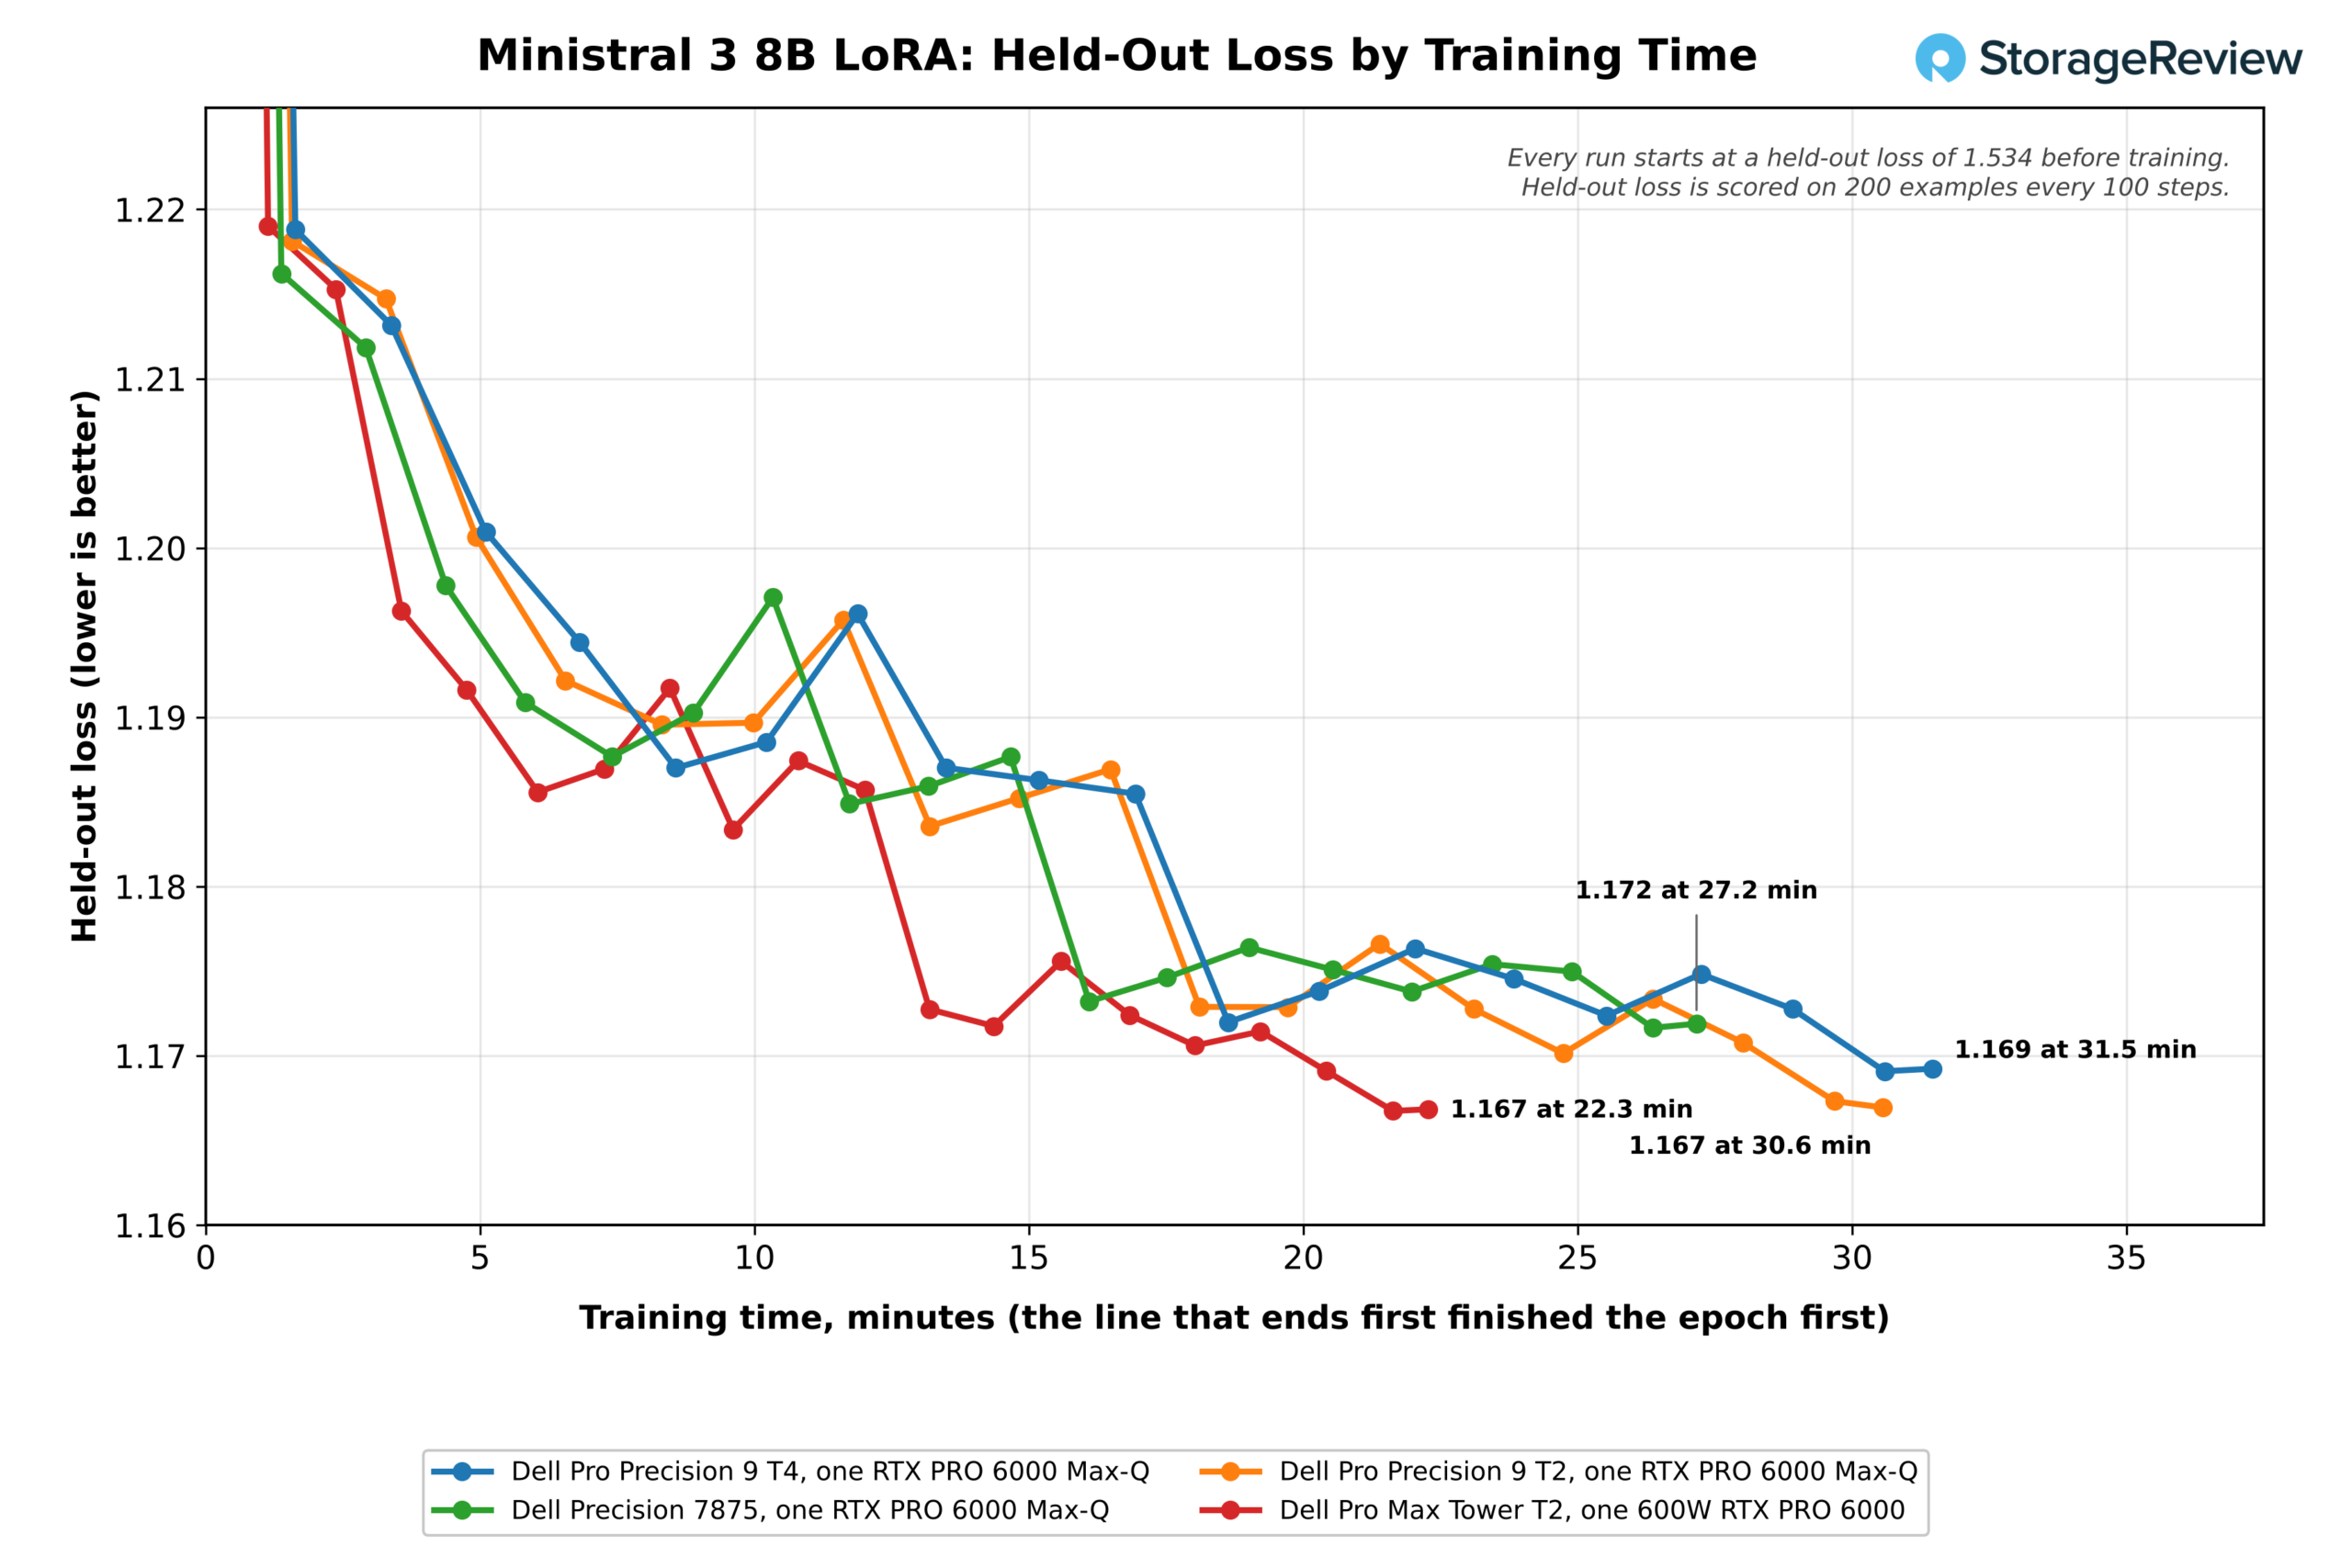
Förlusten vid stopp på T4 minskade från 1.534 till 1.219 under de första 100 stegen, 1.6 minuter in i träningen, och sjönk sedan till 1.169 under resten av epoken. Genom att lägga till den andra GPU:n minskades T4:ans epok till 19.7 minuter med 2 528 tokens per sekund, en 1.60x hastighetsökning som slutade före det enda 600W-kortets 22.3 minuter. Precision 7875 slutförde sin två-GPU-epok på 18.1 minuter, en 1.50x hastighetsökning, och körningarna med två GPU:er slutade med förluster vid stopp på 1.167 och 1.168.
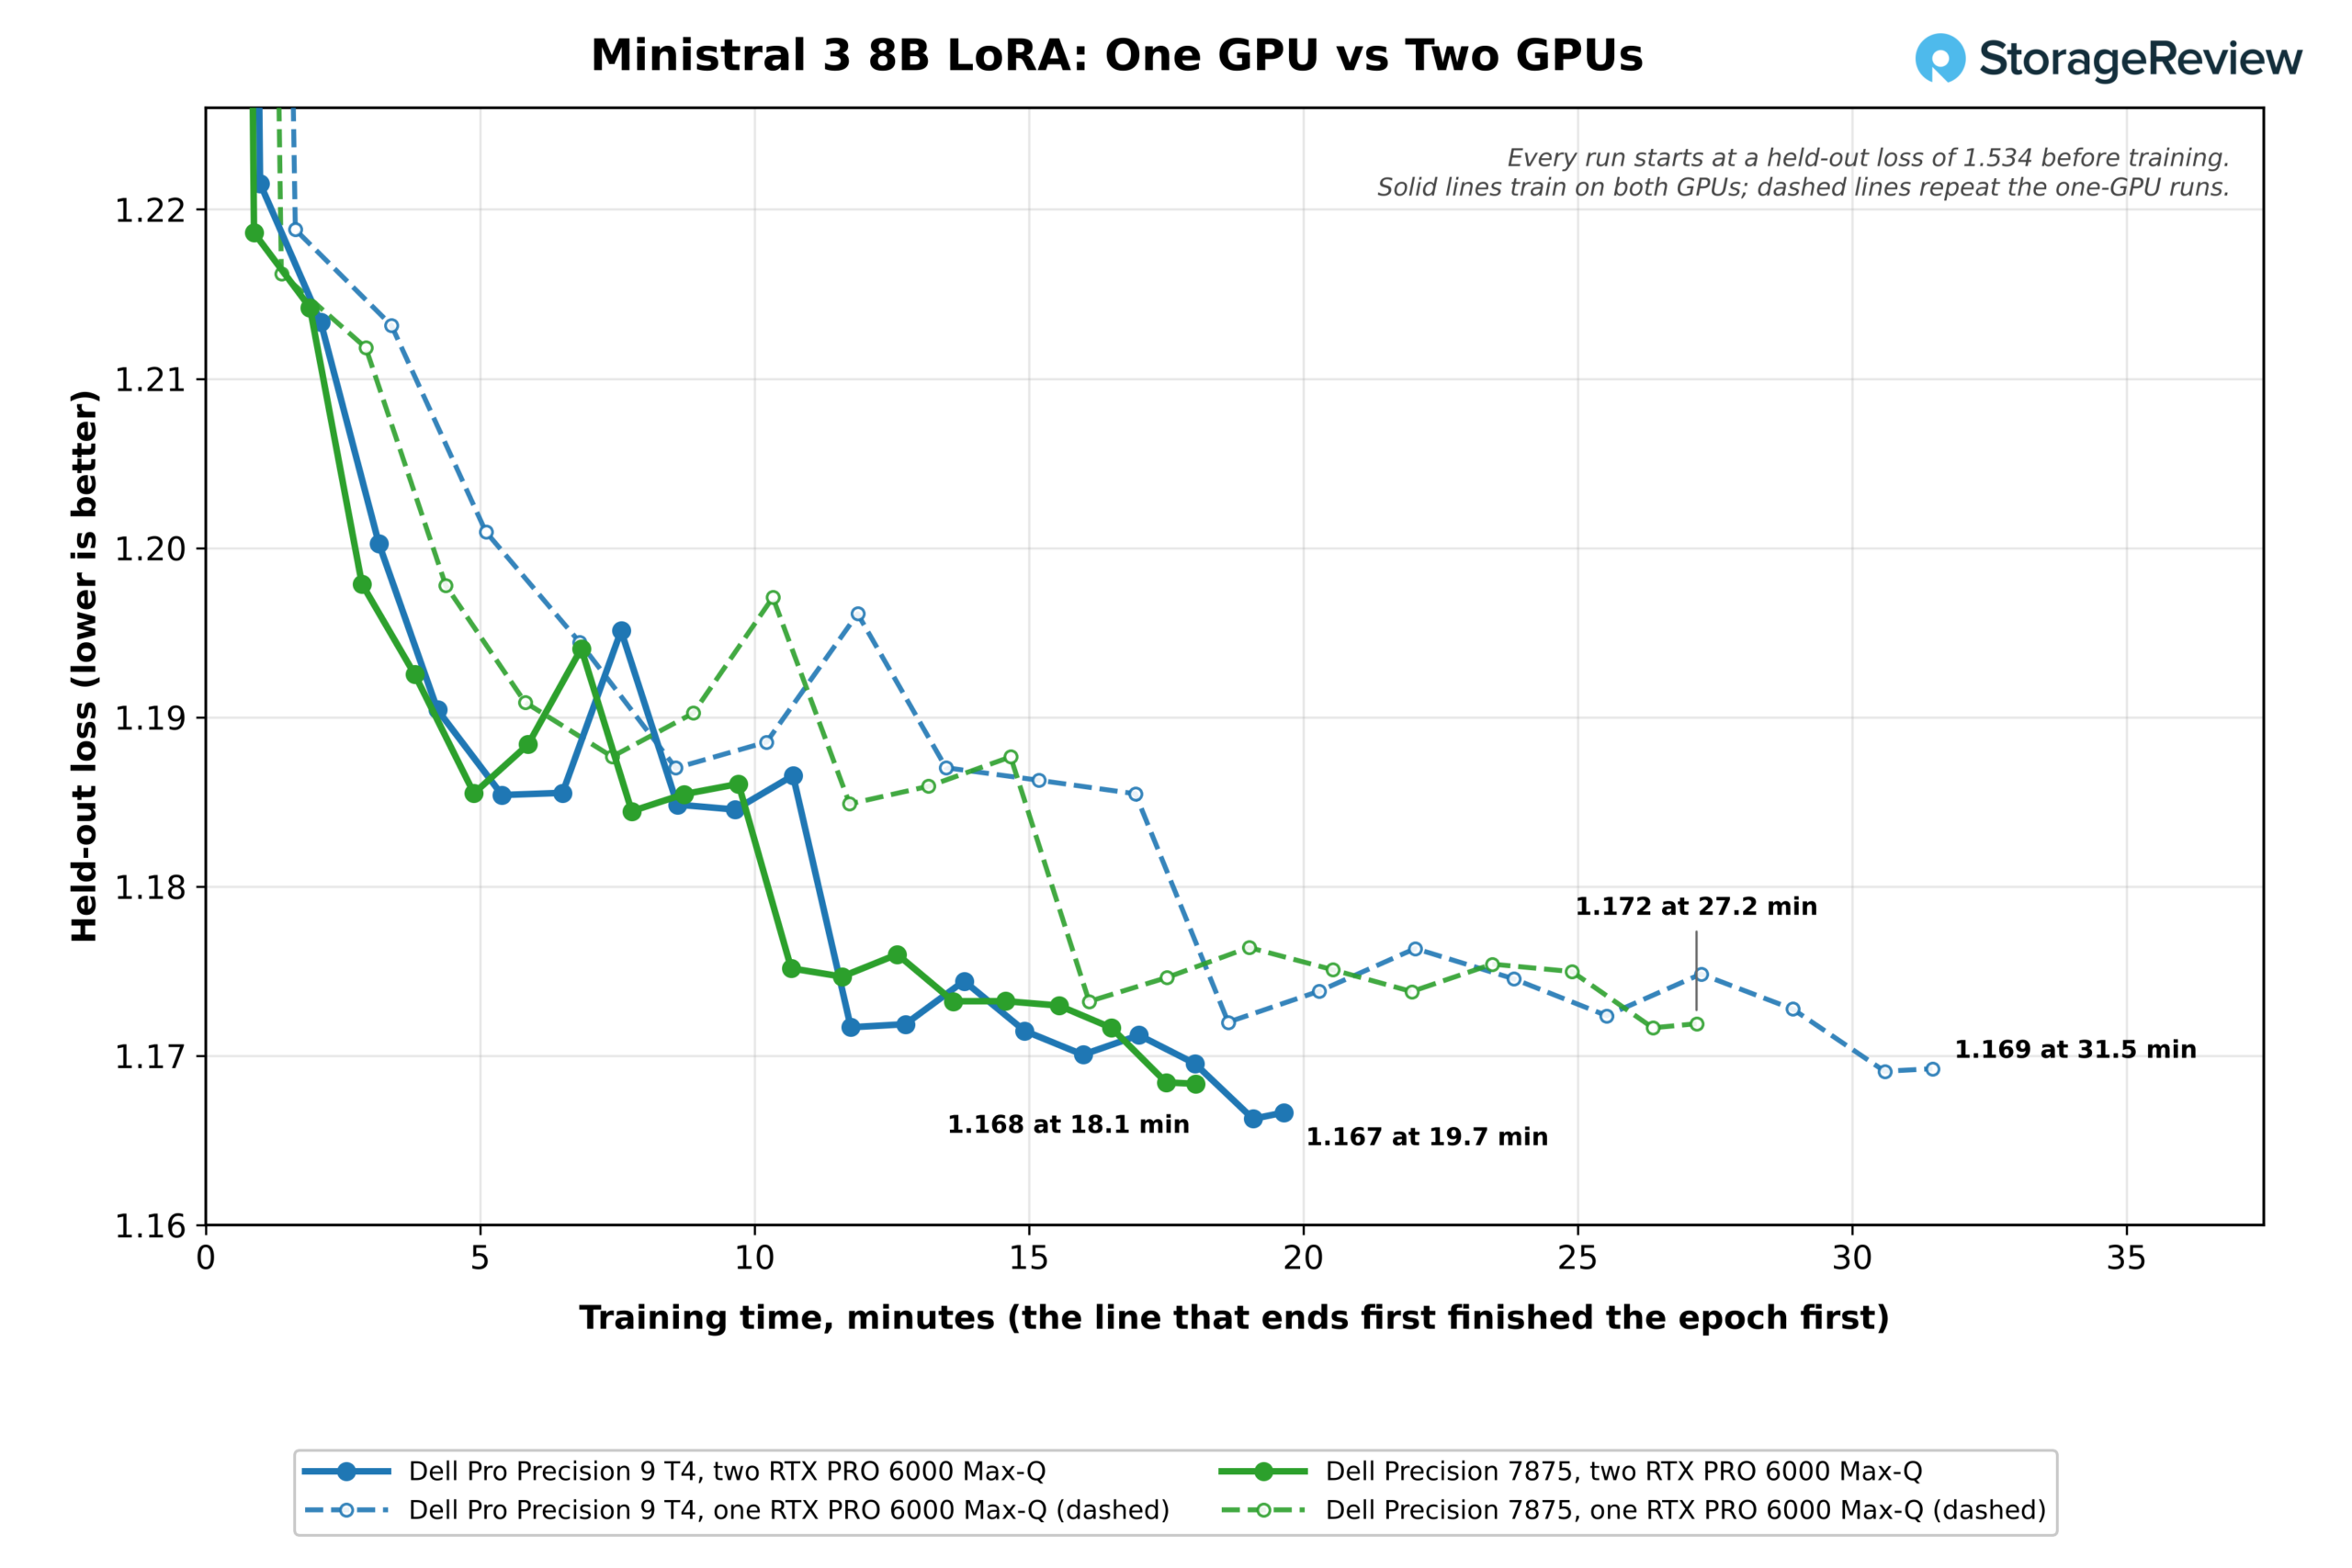
Båda korten körs dataparallellt med två exempel per GPU och gradienter ackumuleras till samma globala batch på åtta, över fyra omgångar på en GPU och två omgångar på ett par, så körningen med två GPU:er ser samma exempel i varje steg och landar på samma förlust. Med två korta exempel per GPU i varje omgång har det andra kortet lite arbete att absorbera och gradientutbyte tar en större andel av varje steg. Epoken nådde sin topp på 19.5 GiB GPU-minne på ett kort och 19.7 GiB per kort på två, en bråkdel av de 96 GB som varje RTX PRO 6000 har.
Kodningsagent, småskalig RAG och bildgenerering
| Kodningsmedel, RAG och bildgenerering (högre desto bättre om inte annat anges) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| Kodningsagent, gpt-oss:20b 64K, lyckade körningar (av 3) | 3 | 2* | 2* | 2* |
| Kodningsagent, gpt-oss:120b 128K, lyckade körningar (av 3) | 3 | 3 | 3 | 3 |
| Kodningsagent, gpt-oss:120b, genereringshastighet (tokens/s) | 161.5 | 167.9 | 166.7 | 183.2 |
| RAG, 20 963 passager, intag (passager/s) | 304.6 | 433.8 | 392.1 | 371.6 |
| RAG-svarsgenerering, Phi-4-mini (tokens/s) | 372.5 | 410.0 | 402.8 | 415.8 |
| FLUX.2 klein 4B BF16, 1024×1024 (bilder/min) | 40.96 | 43.03 | 41.32 | 54.25 |
| Z-Image Turbo 6B BF16 (bilder/min) | 17.29 | 17.67 | 17.27 | 23.83 |
| Qwen-Image 20B BF16 (bilder/min) | 2.43 | 2.45 | 2.39 | 3.20 |
*Flaggad av sviten: en av de tre agentkörningarna på det här systemet klarade inte alla 11 tester.
T4 klarade varje körning av kodningsagenter på varje modellnivå, inklusive alla tre gpt-oss:20b-körningar vid en 64K-kontext där de andra tre systemen klarade två av tre, och den genererade 161.5 tokens per sekund på gpt-oss:120b. Bildgenerering körs på en GPU, så T4:ans 40.96 bilder per minut på FLUX.2 klein i BF16 ligger på samma nivå som de andra Max-Q-systemen och bakom 600W-kortet vid 54.25.
CPU-prestanda
CPU-resultaten jämför T4:ans 86 Xeon-kärnor med Precision 7875:s 96 Threadripper-kärnor, med de två 24-kärniga T2:orna som referenspunkter. Threadripper har tio kärnor till och ger 192 trådar till Xeons 172. T4 leder där minnesbandbredd avgör resultatet, och 7875 leder där kärnantal och klockfrekvenser gör det.
Komprimering, rendering och kompilering
| Testa | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| 7-Zip, alla trådar (GIPS) | 619.8 | 850.0 | 285.1 | 172.7 |
| 7-Zip, en tråd (GIPS) | 8.85 | 10.58 | 9.27 | 11.04 |
| Blender 4.5 Monster (prover/min) | 961.8 | 1,253.8 | 400.7 | 303.0 |
| Blender 4.5 Junkshop (prover/min) | 641.9 | 849.7 | 266.9 | 191.9 |
| Blender 4.5 Klassrum (prover/min) | 442.8 | 612.2 | 187.2 | 147.1 |
| HandBrake x265 (fps) | 31.4 | 41.7 | 41.5 | 40.0 |
| HandBrake SVT-AV1 (fps) | 159.4 | 255.8 | 198.5 | 122.6 |
| LLVM 21 build (s, lägre desto bättre) | 58.4 | 43.7 | 106.4 | 155.9 |
| Linuxkärna allmodconfig (s, lägre desto bättre) | 312 | 264 | 537 | 843 |
| OpenSSL AES-256-GCM, alla trådar (GB/s) | 882.6 | 1,139.1 | 371.2 | 137.0 |
| nginx, 1 000 anslutningar (förfrågningar/s) | 414,468 | 467,128 | 323,567 | 153,732 |
T4 fick 619.8 GIPS i 7-Zip och 961.8 samplingar per minut i Blender Monster, 2.2 och 2.4 gånger 24-kärniga Pro Precision 9 T2. Precision 7875 låg 37 procent före i 7-Zip och 30 procent före i Blender, och den slutförde LLVM-bygget på 43.7 sekunder mot 58.4, och Linux-kärnans allmodconfig-bygge på 264 sekunder mot 312. Hastighet per kärna är T4:ans svaga punkt, med den lägsta 7-Zip-poängen på en tråd i denna grupp på 8.85 GIPS.
HandBrakes x265-kodning är avvikaren i den här tabellen, och orsaken är mer kodaren än processorn. De andra tre systemen landade alla mellan 40.0 och 41.7 fps med 24 eller 96 kärnor, så x265 skalar inte med kärnantal vid denna förinställning, och T4:ans 31.4 fps överensstämmer med dess lägre hastighet per kärna på de trådar som x265 använder. Under kodningen snittade T4:an cirka 1 GHz över sina 172 trådar vid 51C till 64C, vilket visar att det mesta av chipet var inaktivt. SVT-AV1 skalade bättre, vid 159.4 fps på T4 jämfört med 255.8 på 7875.


Minnesbandbredd, simulering och matematik
| Testa | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| STREAM-triaden (MB/s) | 328,329 | 215,177 | 141,832 | 45,102 |
| OpenFOAM 13 drivAer, 3M celler, lös (s, lägre desto bättre) | 293 | 556 | 826 | Slutförde inte |
| GROMACS benchPEP, alla kärnor (ns/dag) | 1.243 | 1.034 | Inte kört | Inte kört |
| GROMACS benchMEM, 16 kärnor (ns/dag) | 68.09 | 84.94 | 78.03 | 54.26 |
| OpenBLAS DGEMM, alla kärnor (GFLOPS) | 3,664 | 4,745 | 2,319 | 1,063 |
| OpenBLAS LU solve N=20000 (GFLOPS) | 1,660 | 1,172 | 1,616 | 858 |
| y-cruncher Pi, 1B siffror (s, lägre desto bättre) | 4.01 | 7.45 | 8.51 | 24.61 |
| y-cruncher Pi, 10B siffror (s, lägre desto bättre) | 53.9 | 83.7 | 119.2 | 347.9 |
| y-cruncher Pi, 25B siffror (s, lägre desto bättre) | 155.6 | 259.6 | Inte kört | Inte kört |
Åtta kanaler med DDR5-6400 ger T4 328 GB/s i STREAM Triad, 53 procent över Precision 7875:s DDR5-5600 och 2.3 gånger högre än fyrkanals Pro Precision 9 T2. Bandbreddsbundet arbete följer: T4 löste 3-miljoners OpenFOAM-driverfallet på 293 sekunder mot 556 på 7875 och 826 på Pro Precision 9 T2, medan Pro Max Tower T2 inte avslutade inom svitens 150-minutersgräns. T4 körde också 22.6-miljoners cellchassit på 6 851 sekunder.

GROMACS benchPEP, det stora all-core-fallet för molekylär dynamik, kördes med 1.243 ns/dag på T4 mot 1.034 på 7875, och LU-lösningen nådde 1 660 GFLOPS mot 1 172. y-cruncher beräknade 10 miljarder siffror i Pi på 53.9 sekunder mot 83.7 på 7875 och 25 miljarder på 155.6 sekunder mot 259.6. Tät beräkning som stannar i cachen gynnar Threadripper, som ledde OpenBLAS DGEMM med 4 745 GFLOPS mot 3 664.


Databaser och tjänster
| Testa | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| ClickBench-test, 43 frågor (s, lägre desto bättre) | 3.21 | 2.88 | 4.80 | 10.44 |
| ClickBench kallkörning, 43 frågor (s, lägre desto bättre) | 6.45 | 7.09 | 6.92 | 14.22 |
| Valkey-cache, SET (förfrågningar/s) | 666,714 | 1,138,696 | 914,832 | 1,719,108 |
| Valkey-cache, GET (förfrågningar/s) | 865,353 | 1,279,429 | 991,576 | 1,648,278 |
| Stockfisk, alla trådar (Mnps) | 68.21 | 168.27 | 45.44 | 37.42 |
| PyPerformance go (ms, lägre desto bättre) | 74.3 | 66.0 | 72.1 | 56.7 |
ClickHouse körde de 43 ClickBench-frågorna på 3.21 sekunder i hett läge och 6.45 sekunder i kallt läge på T4, 0.33 sekunder efter 7875 i hett läge och 0.64 sekunder före i kallt läge. Valkey föredrar snabba kärnor framför många kärnor, och T4:ans 666 714 SET-förfrågningar per sekund ligger efter alla tre jämförelsesystem, där Core Ultra 9 285K i Pro Max Tower T2 leder med 1.72 miljoner. Det mönstret matchar T4:ans resultat med en tråd och är värt att väga in för latensbundna tjänster.
Med alla 172 trådar laddade och processorn på ett medelvärde på 87C sökte T4:an 68.21 miljoner noder per sekund i Stockfish, 1.5 gånger Pro Precision 9 T2 med 48 trådar och långt under hälften av 7875:ans 168.27 på 192 trådar. Testet överskred också tiden under T4:ans första fullständiga körning innan ett fristående omtest gav denna siffra. Vi rapporterar resultatet som uppmätt och har inte isolerat orsaken till den svaga skalningen.
Lagringsprestanda
| fio, 25 GiB fotavtryck (högre desto bättre) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Tower T2 |
|---|---|---|---|---|
| Sekventiell läsning 128K (MB/s) | 14,152 | 7,089 | 20,914 * | 7,234 |
| Sekventiell skrivning 128K (MB/s) | 10,078 | 5,265 | 12,564 | 6,772 |
| Slumpmässig avläsning 4K, topp (IOPS) | 2,306,346 | 993,569 | 3,214,066 | 1,538,387 |
| Slumpmässig skrivning 4K, topp (IOPS) | 1,830,776 | 787,388 | 2,353,766 | 1,326,030 |
*Flaggad av sviten för varians mellan körningar efter en omkörning.
T4:ans 2TB SK hynix Gen5-startdisk läste med 14 152 MB/s och skrev med 10 078 MB/s, ungefär dubbelt så mycket som den sekventiella läsningen jämfört med Gen4-diskarna i Precision 7875 och Pro Max Tower T2, och den nådde en topp på 2.31 miljoner slumpmässiga läs-IOPS och 1.83 miljoner slumpmässiga skriv-IOPS. Pro Precision 9 T2:s sekventiella läsning på 20 914 MB/s överstiger vad en Gen5 x4-länk har, vilket passar systemets testvolym, en stripe-array av Samsung PM9E1 Gen5-diskar. Vi testade enbart T4:ans startdisk, och den andra 2TB-disken ingick inte i denna körning.

Termiska och klockor under belastning
| Dell Pro Precision 9 T4 | CPU Max (C) | CPU-medelvärde (C) | Genomsnittlig CPU-klocka (MHz) |
|---|---|---|---|
| 7-Zip | 93 | 80.6 | 1,967 |
| Blandare | 91 | 85.7 | 2,587 |
| gromacs | 96 | 81.3 | 1,313 |
| LLVM-bygge | 83 | 74.5 | 2,127 |
| OpenBLAS | 80 | 62.9 | 1,325 |
| LLM-tjänstgöring | 84 | 65.0 | 924 |
| Finjustering | 71 | 61.2 | 854 |
| RAG i stor skala | 74 | 64.4 | 987 |
| lagring | 64 | 55.4 | 942 |
Med BIOS i Ultra Performance-läge nådde Xeon 698X sin topp på 93C i 7-Zip och 96C i GROMACS, och klockvärdena i tabellen är medelvärden för alla 172 logiska processorer. Blender och Stockfish laddar varje tråd och höll 2.5 GHz till 2.6 GHz, över chipets bas på 2.0 GHz. GROMACS och OpenBLAS laddar 64 och 86 fysiska kärnor och lämnar de återstående trådarna inaktiva nära 0.8 GHz, vilket är anledningen till att deras medelvärden ligger på cirka 1.3 GHz. GPU-lett arbete höll processorn svalare, på ett medelvärde på 61C till 65C under LLM-servering, finjustering och RAG, eftersom dessa tester lutar mot grafikkorten.

Slutsats
Dell Pro Precision 9 T4 är byggd för lokalt AI-arbete, och det andra RTX PRO 6000 visar det. Två Max-Q-kort ökade toppdataflödet för servrar med 1.85 till 2.02 gånger över fyra modeller och inbäddningsdataflödet med 1.92 gånger, minskade en LoRA-epok på Ministral 3 8B från 31.5 till 19.7 minuter och ökade MiniMax M2.7, en modell som är för stor för ett kort, från 30.3 till 83.7 tokens per sekund för en enskild användare. På gpt-oss 120B nådde en server per GPU totalt 7 091 tokens per sekund vid 64 förfrågningar, medan uppdelning av modellen över båda korten returnerade en enskild användares första token på 719 ms jämfört med 1 189 ms.

Åtta kanaler med DDR5-6400 gav Xeon 698X en ledning på 53 procent i minnesbandbredd jämfört med Threadripper PRO 9995WX. Den bandbredden gav T4 snabbare sökresultat för OpenFOAM, GROMACS benchPEP, y-cruncher och HNSW än Precision 7875, och T4:s Gen5-lagring laddade stora modeller snabbare. Chassit förtjänar också beröm, med den bästa kyllayouten vi sett från Dell i den här klassen och verktygslös åtkomst till nätaggregatet.
7875 ligger fortfarande före på kärnbunden rendering, komprimering och kompilering med 18 till 38 procent, och med 60 procent i SVT-AV1. Xeons hastighet per kärna låg efter alla system i denna grupp, vilket visades i Valkey och andra lätt trådade tjänster. Finjustering på en enda GPU var också långsammare på T4, där LoRA-epoken tog 31.5 minuter mot 27.2 på 7875 och 22.3 på 600W-kortet i Pro Max Tower T2, där alla system slutförde inom 0.005 minuter från samma förlust.
För cirka 66 600 dollar, konfigurerat på Dell.com, passar T4 team som vill betjäna, bädda in och finjustera modeller lokalt, inklusive modeller som behöver mer än 96 GB GPU-minne, tillsammans med minnesbunden simulering och analys på samma maskin. Köpare vars arbete mestadels består av rendering och kompilering kommer att tycka att Threadripper-plattformen är snabbare, och köpare som behöver en enda GPU kan få samma kort i den mindre Pro Precision 9 T2.

Topplista: Dell Pro Precision 9 T4 har utnämnts till bästa Xeon Tower för lokal AI på vår topplista över bästa stationära datorer för lokal AI .


 Amazon