

Fungible förändrar hur lagringsplattformar utformas genom att ta bort begränsningar för befintliga lagringsarkitekturer med lanseringen av Fungible Storage Cluster, FSC 1600 högpresterande lagringsnod. Fungible Storage Cluster levererar en högpresterande, NVMe/TCP-disaggregerad lagringslösning med låg latens som är helt transparent för applikationer på hög nivå. Fungible Storage Cluster (FSC) drivs av Fungible DPU™ och är en högpresterande, säker, utskalad disaggregerad all-flash-lagringsplattform.
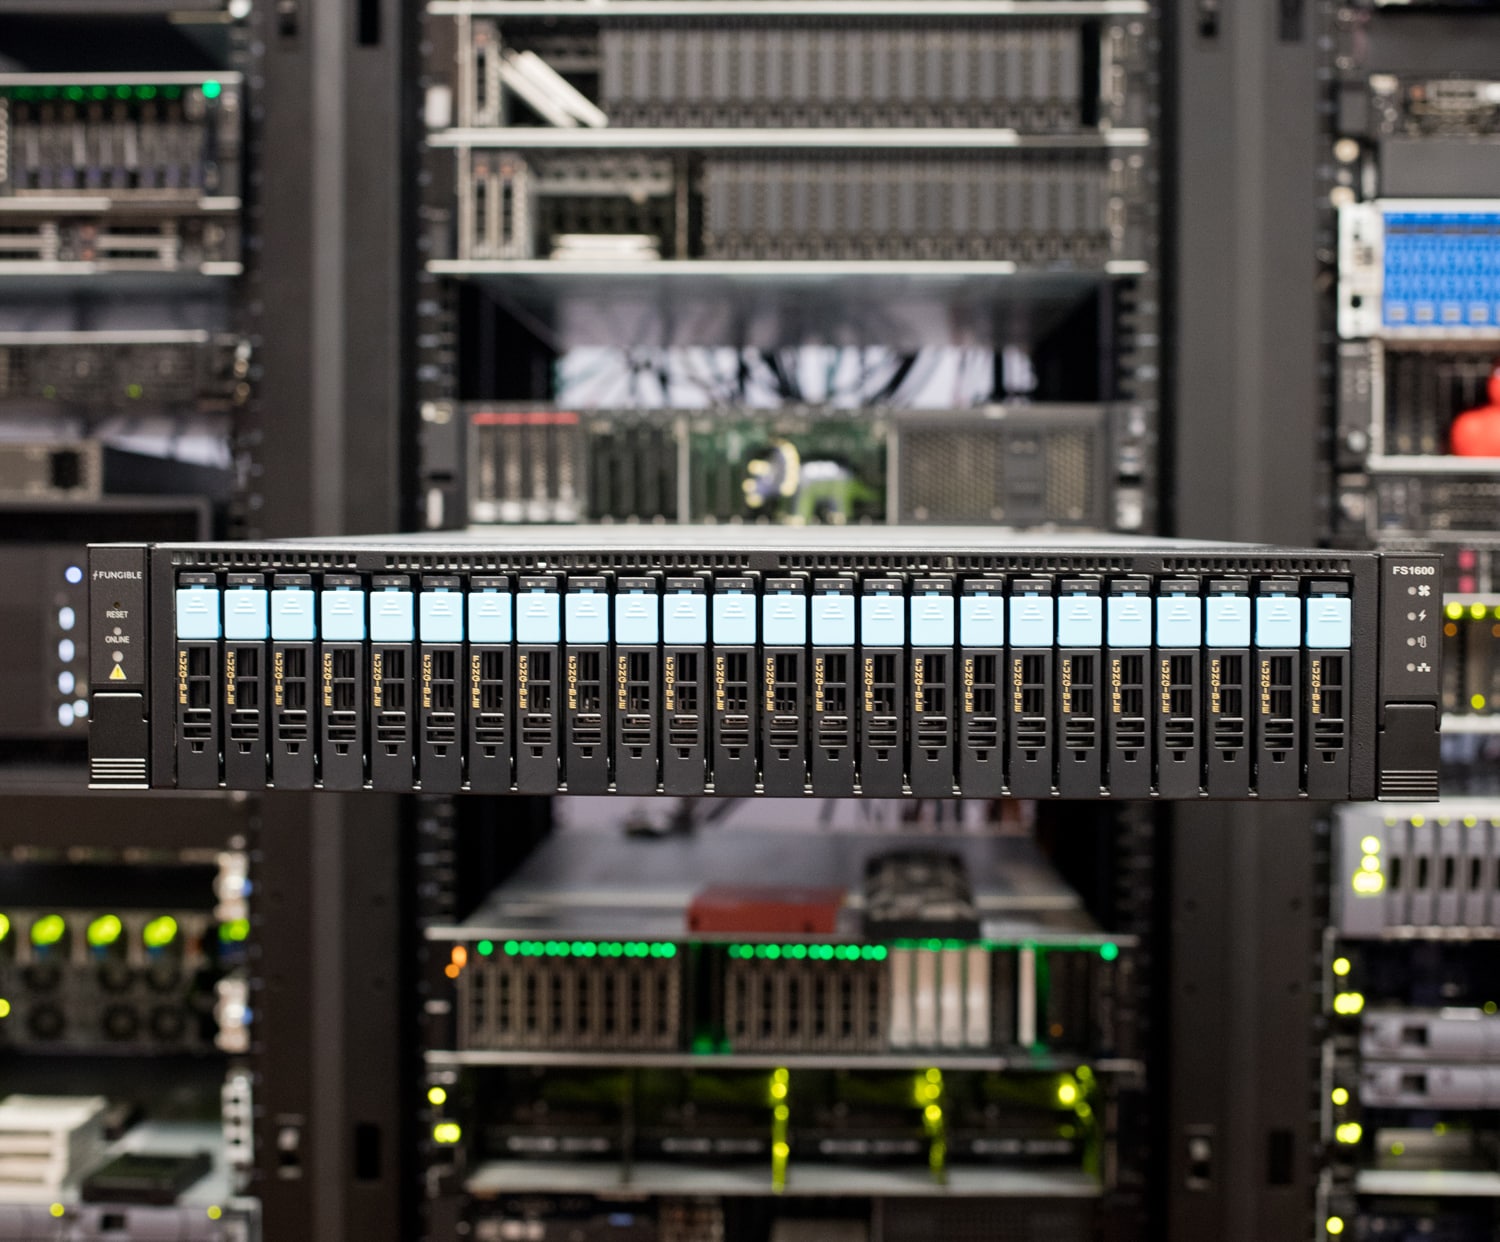
Svängbar FS1600 Flash Array
En Data Processing Unit (DPU) är i huvudsak ett system på ett chip. Vanligtvis består en DPU av en mikroprocessor med flera kärnor, ett nätverksgränssnitt och accelerationsmotorer som avlastar datacentrerade uppgifter som nätverk, lagring, virtualisering, säkerhet och analysfunktioner. DPU:er och SmartNIC:er fortsätter att vinna popularitet i datacenter för företag och molnleverantörer.
Ocuco-landskapet Svängbar FSC1600 Förvaringskluster
FS1600 drivs av två Fungible Data Processing Units. En unik Fungible innovation, DPU representerar en ny klass av mikroprocessorer designade från grunden för att leverera oöverträffad prestanda och effektivitet vid drift av infrastrukturtjänster.
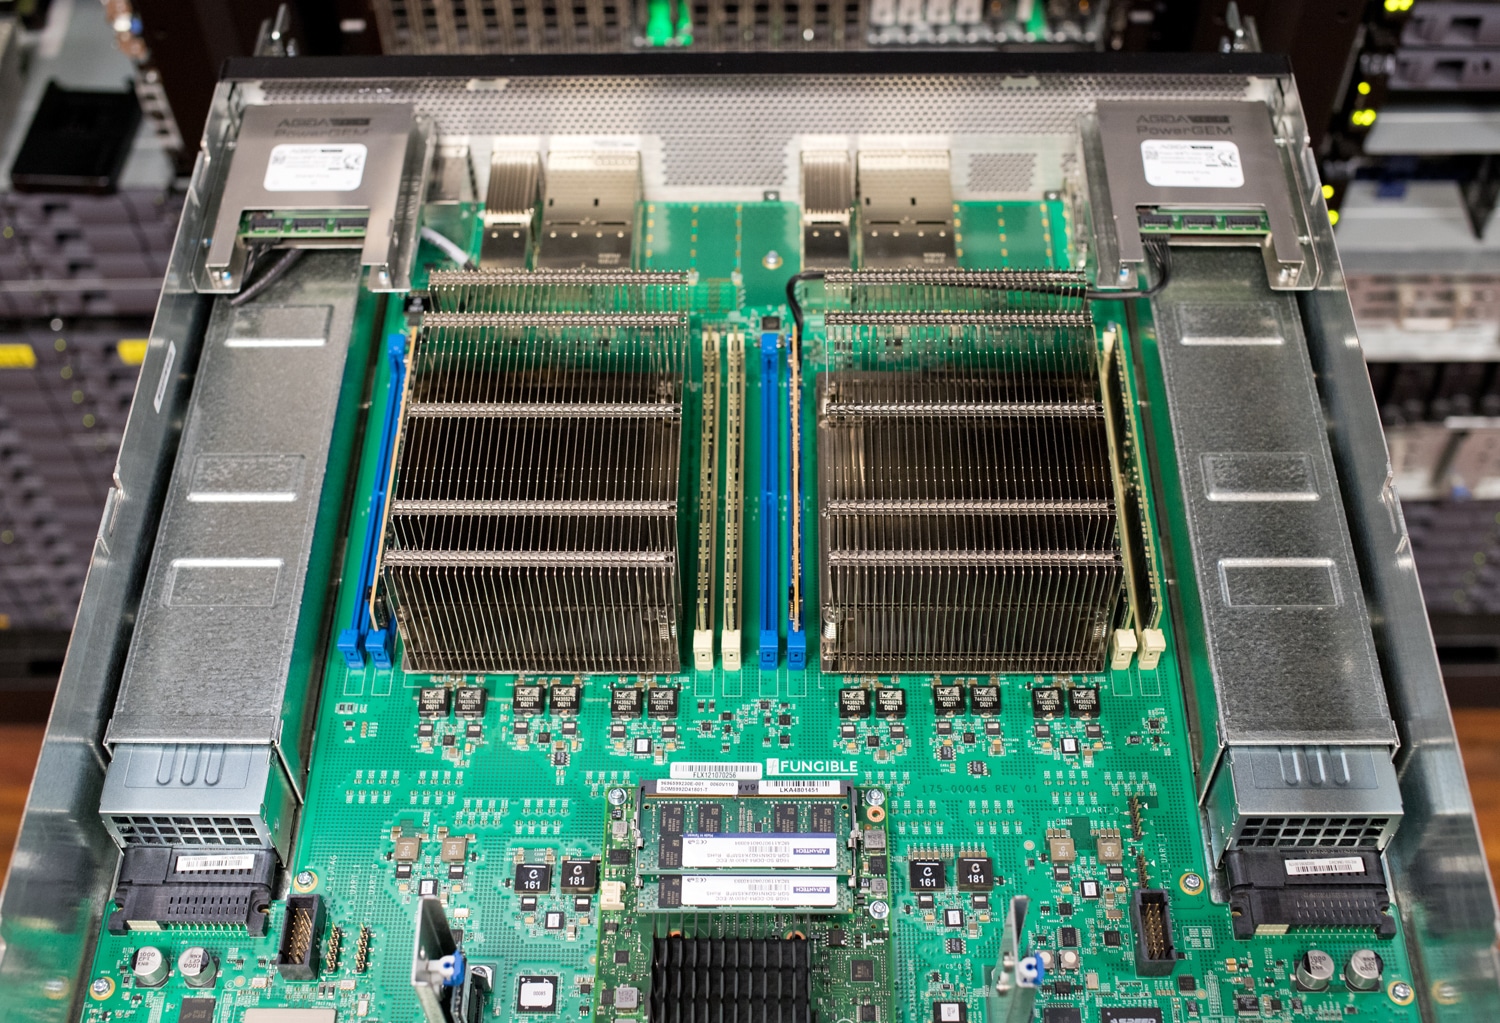
Svängbar FS1600 interner
Medan de flesta lagringsplattformar är x86-baserade, är FS1600 rotad i grundläggande Fungible DPU-teknik. Designad specifikt för att köra datacentrerade arbetsbelastningar mer effektivt än processorer, DPU:n gör att FS1600 kan leverera högre prestanda. FS1600 har en slumpmässig läshastighet på 13M IOPS Raw-blockläsprestanda (4KB), en genomströmning på 75 GB/s per nod och läsfördröjningar på +10μs för prestanda som är mycket effektivare än DAS-system (direct-attached storage) och ger en 96.5 % Performance Efficiency Procent (PEP).
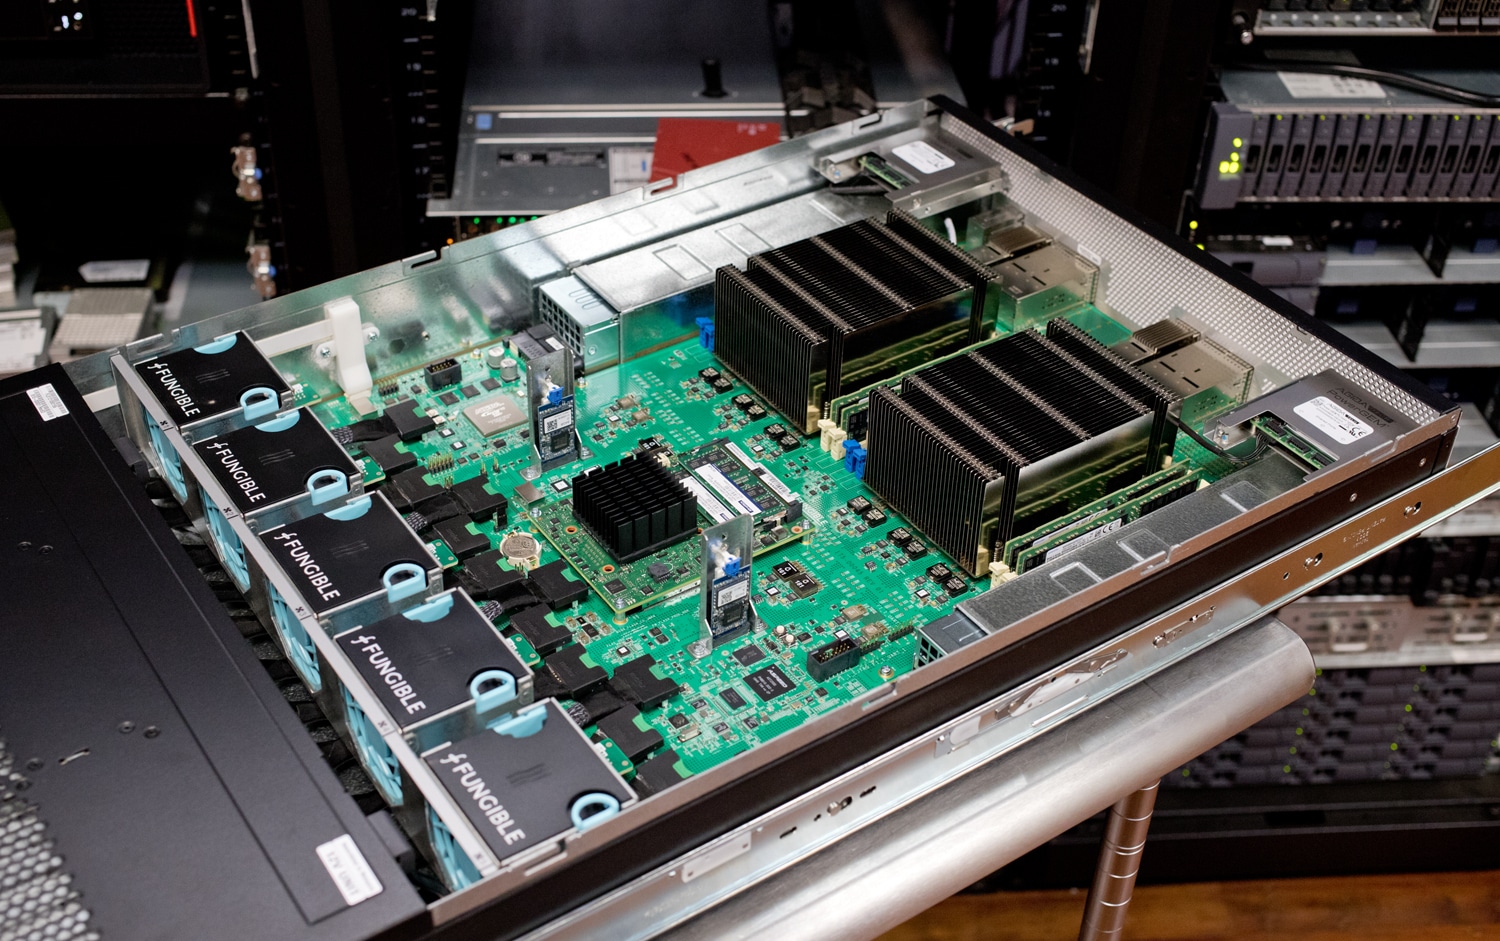
DPU-hårdvaruacceleratorerna inkluderar komprimering, raderingskodning, kryptering, reguljärt uttryck, djuppaketinspektion och DMA, som arbetar med en linjehastighet på 800 Gb/s. Med raderingskodning, om en nod misslyckas, byggs data om med hjälp av paritet och databitar från andra noder, medan värden tillhandahåller en alternativ väg för att komma åt data genom multi-pathing. FS1600, kompatibel med NVMe/TCP och hanteringsprogramvara via Container Storage Interface (CSI) för Kubernetes och Openstack för virtuella datorer, kan vara en drop-in ersättning för befintliga lagringssystem. Det finns inga krav på specialagenter som använder värd-CPU-resurser; endast en standard NVMe/TCP-drivrutin krävs. Och befintliga applikationer kräver inga ändringar.
S1 & F1 DPU-modeller
Det finns två Fungible DPU-modeller: S1 DPU och F1 DPU. Fungible-familjen av processorer utnyttjar samma maskin- och mjukvarudesign och delar samma programmeringsmodell. Men även om F1 DPU är designad för högpresterande fristående apparater som lagring, säkerhet, AI och analysservrar, maximerar S1 DPU prestanda inom en standard PCIe-adapters fotavtryck och kraftomslutning.
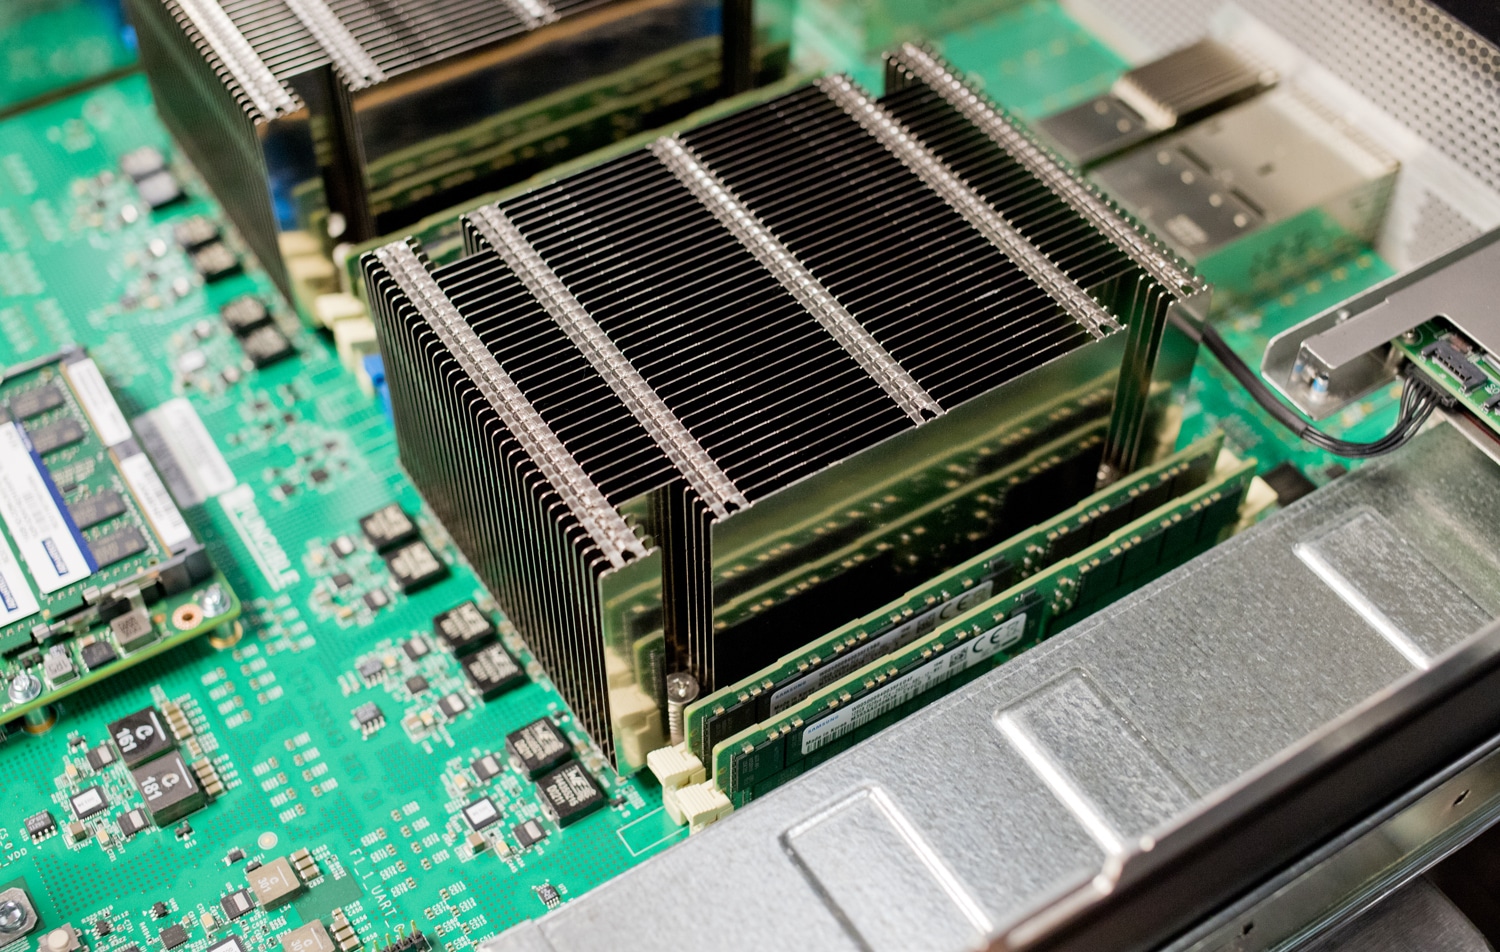
Fungible S1 DPU är optimerad för att kombinera datacentrerade beräkningar inom servernoder och att effektivt flytta data mellan noder. Datacentrerade beräkningar kännetecknas av tillståndsbearbetning av dataströmmar med höga hastigheter, vanligtvis av nätverk, säkerhet och lagringsstackar.
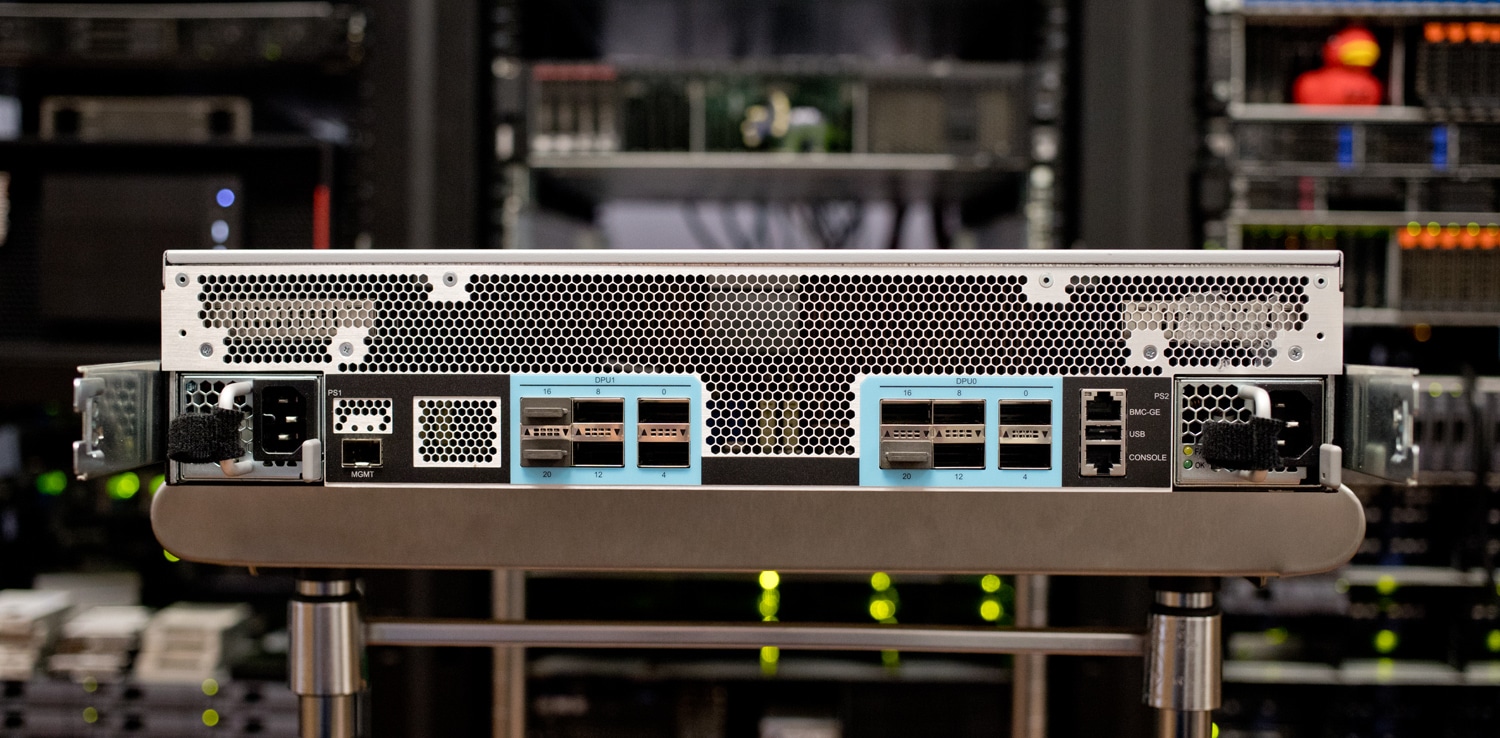
Svängbara FS1600 bakre portar
S1 DPU underlättar datautbyte mellan servernoder genom sin TrueFabric™-teknologi. TrueFabric är ett storskaligt IP-over-Ethernet-tygprotokoll som ger total nätverkstvärsnittsbandbredd med låg genomsnittlig och svansfördröjning, end-to-end QoS, överbelastningsfri anslutning och säkerhet mellan servernoder. TrueFabric-protokollet är helt standardkompatibelt och interoperabelt med TCP/IP över Ethernet, vilket säkerställer att datacentret Spine-Leaf-nätverket kan byggas med vanliga Ethernet-switchar av standardtyp.
FunOS
Dataplanet för både S1 och F1 DPU kör FunOS™, ett specialbyggt operativsystem skrivet i högnivåprogrammeringsspråk (ANSI-C). FunOS kör stackarna för nätverk, lagring, säkerhet, virtualisering och analys. Kontrollplanet kör ett standardoperativsystem (t.ex. Linux) och innehåller agenter som gör att ett kluster av både S1 och F1 DPU:er kan hanteras, kontrolleras och övervakas av en uppsättning REST API:er. Dessa REST API:er kan integreras i standard- eller tredjeparts orkestreringssystem som Kubernetes CSI-plugins, OpenStack, OpenShift, etc.
Genom att kombinera dessa nyckelfunktioner till en enda lösning möjliggör Fungible DPU-familjen av processorer hyperdisaggregering och sammanslagning av beräknings- och lagringsresurser – och levererar en högpresterande, massivt skalbar komponerbar infrastruktur för nästa generations datacenter!
Vad utgör ett kluster
FSC™ består av ett kluster av två eller flera Fungible FS1600-lagringsmålnoder och tre Fungible Composer-noder. Programvaran Fungible Composer hanterar kontrollplanet, en centraliserad hanteringslösning som konfigurerar, hanterar, orkestrerar, kontrollerar och distribuerar Fungible Storage Cluster. Composer-noderna tillhandahåller tjänster som lagring, nätverkshantering, telemetri, nodhantering för logginsamling och en API-gateway som ger extern åtkomst till tjänsterna som tillhandahålls av Fungible Composer.
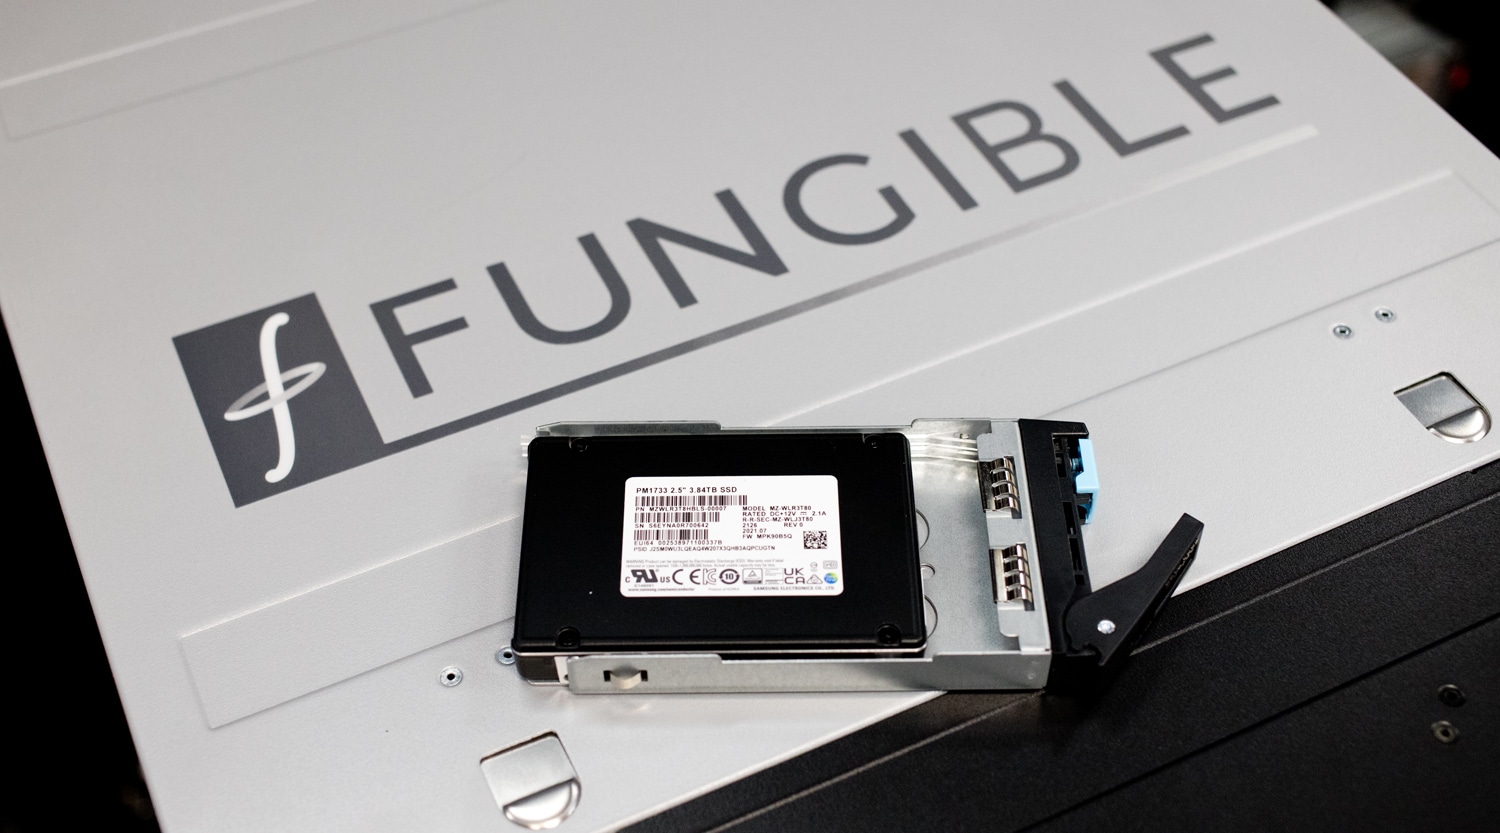
Fungible Storage Cluster levererar en högpresterande, NVMe/TCP-disaggregerad lagringslösning med låg latens som är helt transparent för applikationer på hög nivå. Varje FS1600 stöder upp till 24 U.2 NVMe/TCP SSD:er, och prestandan skalas linjärt från så liten som 70TB till flera PB:er.
Use Cases
Molnbaserad lagring för hyperuppdelning : FSC erbjuder molnleverantörer ett alternativ till konventionell lagring. Genom att uppdela lagring möjliggör FSC oberoende skalning av beräkning och lagring, ökad utnyttjandegrad, minskad server-SKU, minskad hanteringskomplexitet och ökad flexibilitet.
Artificiell intelligens/Maskininlärning: Moderna AI/ML-arbetsbelastningar kräver vanligtvis massiv parallellitet i prestanda, låg latens och stor kapacitet. FSC, i kombination med mycket skalbara parallella filsystem, eliminerar flaskhalsar i lagring för att uppnå oöverträffad prestanda, latens och effektivitet för dessa moderna arbetsbelastningar.
Molnbaserade högpresterande databaser : Många av dagens högpresterande skalbara databaser använder DAS för att uppfylla latenskrav. Dessa databaser erbjuder vanligtvis hållbarhet genom klustrade redundansscheman som replikuppsättningar eller primär-sekundära konfigurationer. Om en server går sönder bevaras data på en annan server. FSC bevarar DAS-liknande latenser samtidigt som det erbjuder förbättrad lagringsutnyttjande och klustrad redundans, men med lägre kapacitetskostnader.
Förenklad IT-hantering
Utöver alla prestandafördelar som kommer med FS1600 och Fungible DPU, finns det också en förenklad hanteringsmetod. Fungible levererar ett hanteringsverktyg för säkra datacenter med flera hyresgäster via en enda glasruta. Instrumentpanelen Fungible Composer kommer att göra en IT-administratörs dag mer produktiv och ger information som behövs för att effektivt hantera de dagliga datacenterfunktionerna.
Svängbar kompositör
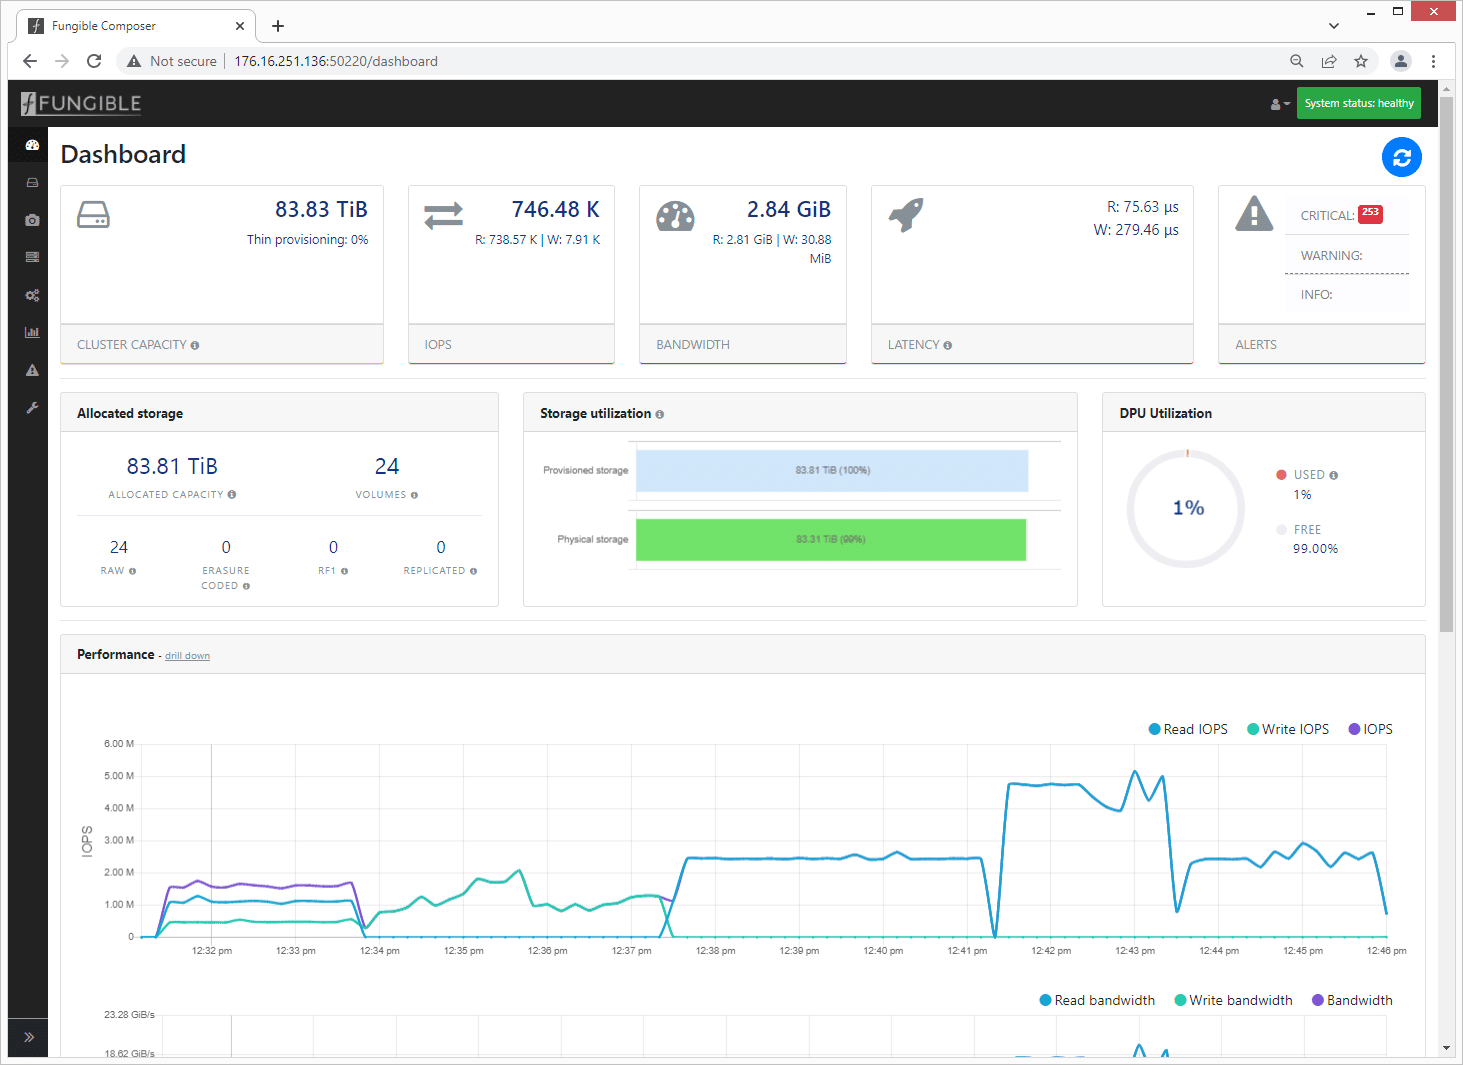
Instrumentpanelen Fungible Composer är enkel att använda med massor av detaljer för spårning, hantering, konfiguration och prestandaövervakning. Den översta fliken kommer att indikera det anslutna systemet, med en fullständig visning av klusterdetaljer, IOPS, lagringsdetaljer, såväl som eventuella larm som behöver åtgärdas.
Ikonerna på skärmens vänstra sida ger omedelbar tillgång till specifika hanteringsverktyg.
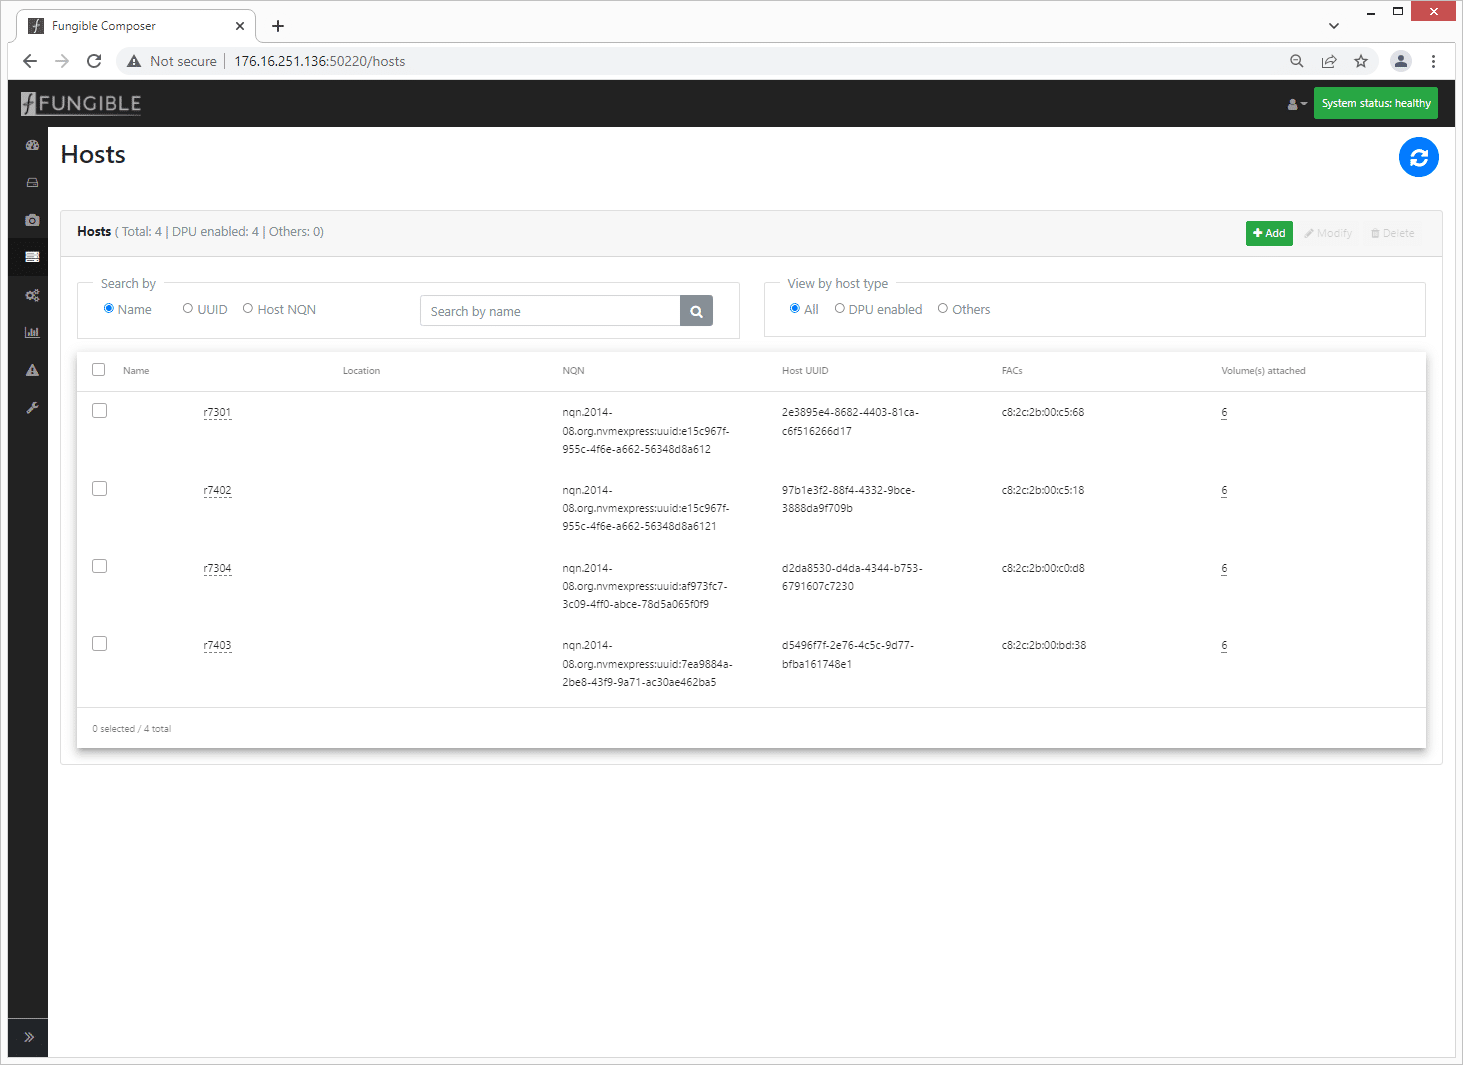
Beroende på detaljerna som tillhandahålls vid driftsättning av fungible enheter, kommer värdtabellen att ge administratören en snabb översikt över de anslutna värdarna med alternativ för att gå ner till en specifik värd.
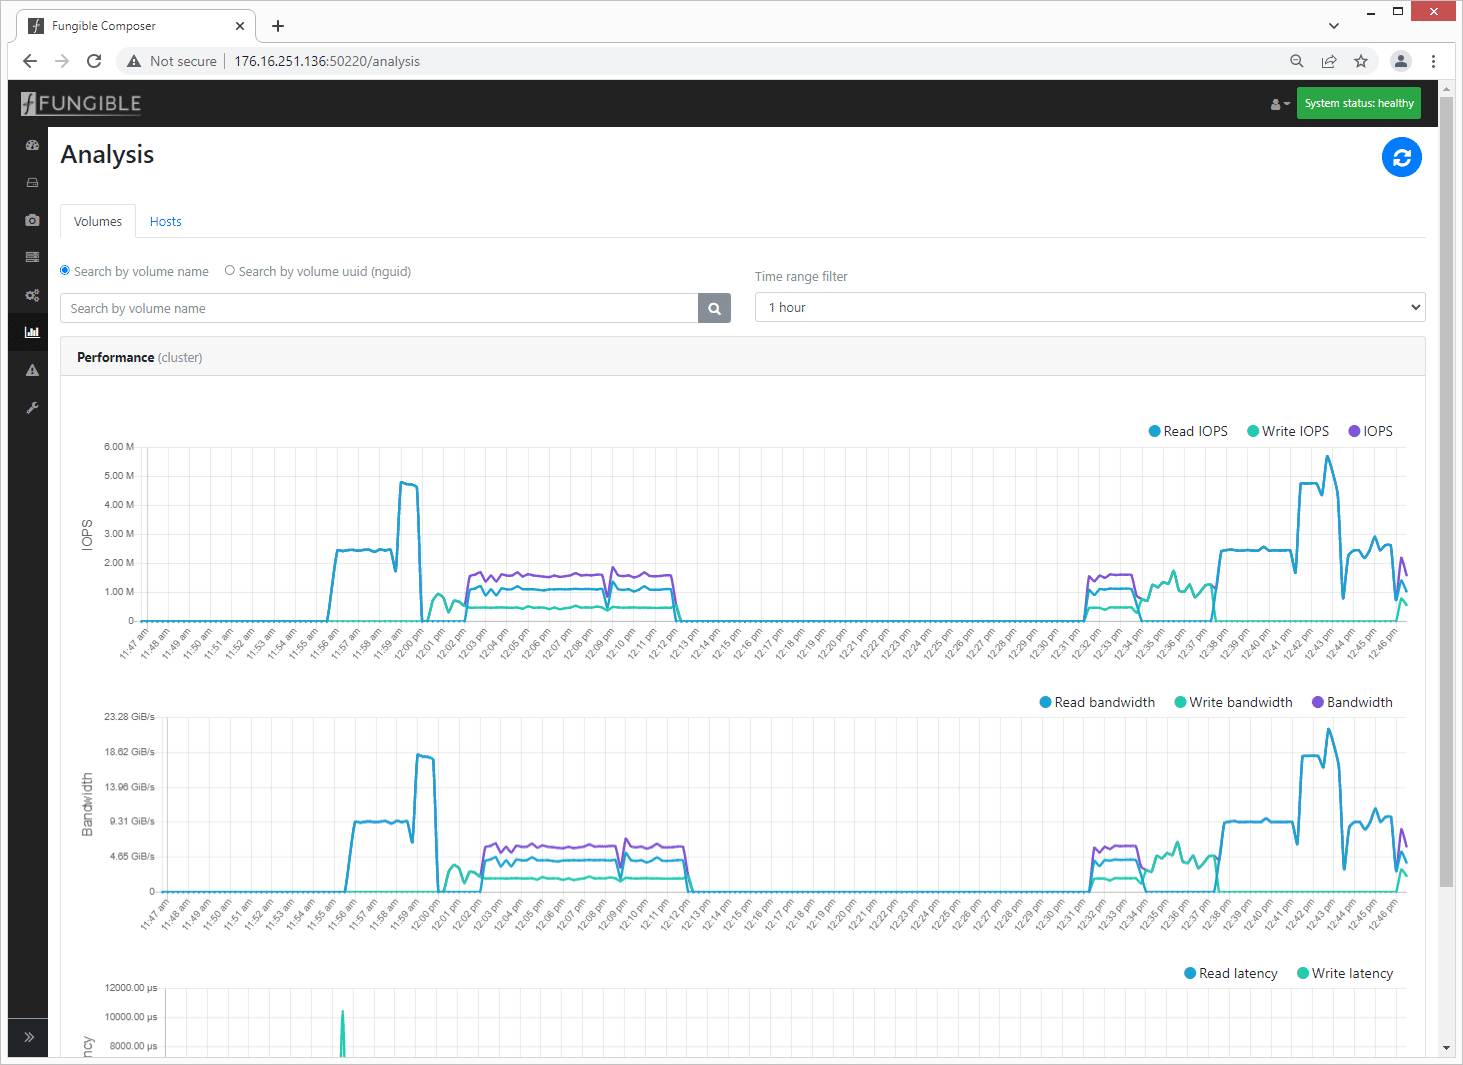
För prestandadata, genom att välja analysikonen, kommer skärmen att fyllas med detaljer för klusterprestanda, vilket ger en snabb överblick över IOPS, bandbredd och latens.
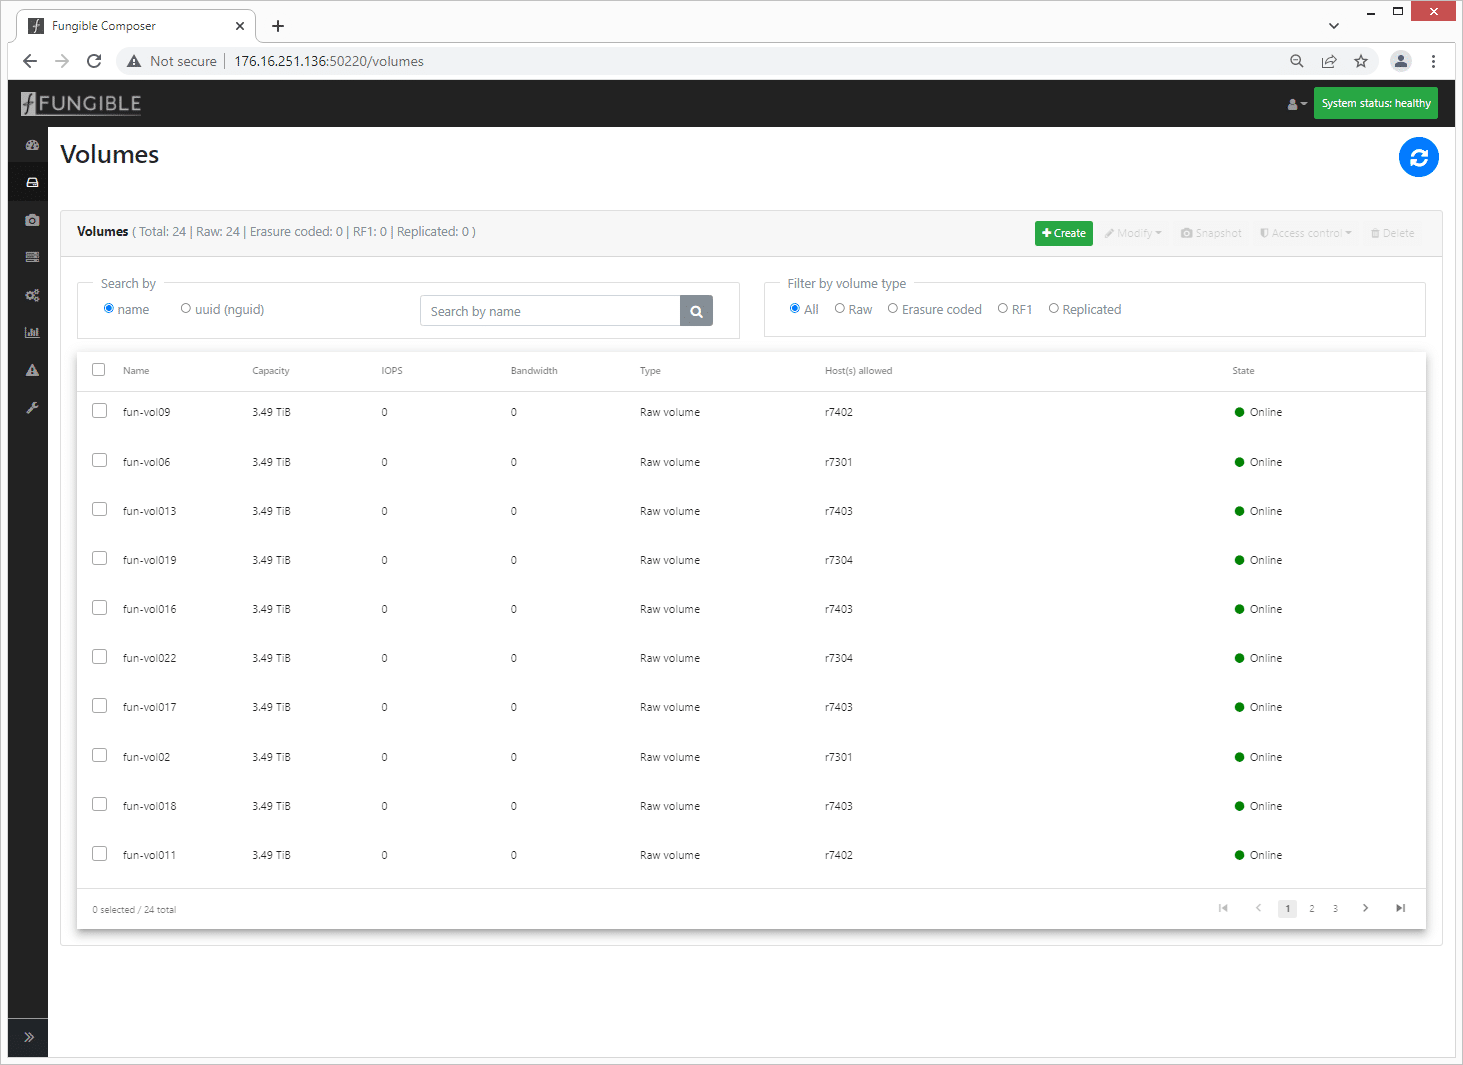
Volymdetaljen ger en snabb överblick över tillståndet för varje volym. Härifrån kan du borra ner till enskilda volymer för mer detaljer.
Installationsdetaljer
1 x Fungible FSC1600
- 8 x 100GbE anslutningar
- 24 x 3.84 TB NVME-enheter
4 x Dell R740xd
- 1 x Fungible FC200
- 1 x 100GbE anslutning
- 1 x NVIDIA ConnectX-5
- 1 x 100GbE anslutning
- 2 x Intel Xeon Gold 6130 CPU @ 2.10 GHz
- 1 256 GB DRAM
volymerna
- Totalt 192 100G RAW-volymer
- 16 x 4K RAW-volymer per värd
- 16 x 8K RAW-volymer per värd
- 16 x 16K RAW-volymer per värd
Testprocess
Testförberedelser inkluderade förkonditionering av alla volymer med en skrivbelastning för att fylla dem innan testarbetsbelastningar påbörjades. Volymerna dimensionerades för att anpassas till blockstorleken för den tillämpade arbetsbelastningen. För testning användes 4K, 8K och 16K volymer för 4K slumpmässiga, 8K slumpmässiga respektive 64K sekventiella arbetsbelastningar. Vi utnyttjade NVMe över TCP-protokollet och med en enda nod testades lagring utan ett skyddsschema.
Varje FIO-iteration mellan Fungible DPU:erna eller 100GbE NIC:erna balanserades för att erbjuda en liknande latensprofil. 100GbE NIC-arbetsbelastningen ökades sedan för att driva högre prestanda, vilket resulterade i mer latens och CPU-användning.
Under det inledande testskedet länkades FIO-jobben till NUMA-noden där korten installerades. DPU eller NIC byttes ut och placerades i samma PCIe-plats mellan varje test. Ingen speciell justering utöver att ställa in serverns BIOS-profil till Prestanda behövdes på servernivå. För varje loadgen installerade vi Ubuntu 20.04.2 Live Server.
Svängbar FS1600 Sammanfattning av prestandaresultat
Svängbar FC200 IOPS
| Arbetsbelastning | Värd 1 | Värd 2 | Värd 3 | Värd 4 |
| 4k läser | 2019k | 2015k | 2016k | 2012k |
| 4k skriver | 2244k | 2020k | 2280k | 2203k |
| 64 läser | 167k | 166k | 166k | 166k |
| 64k skriver | 161k | 168k | 164k | 186k |
| 8k 70r/30w | 1118k / 479k | 1105k / 474k | 1075k / 461k | 1117k / 479k |
Svängbar FC200 bandbredd
| Arbetsbelastning | Värd 1 | Värd 2 | Värd 3 | Värd 4 |
| 4k läser | 7886 MB/s | 7871 MB/s | 7873 MB/s | 7858 MB/s |
| 4k skriver | 8766 MB/s | 7890 MB/s | 8905 MB/s | 8606 MB/s |
| 64 läser | 9.80 GiB/s | 10.1 GiB/s | 10.2 GiB/s | 10.1 GiB/s |
| 64k skriver | 8732 MB/s | 10.2 GiB/s | 11.3 GiB/s | 11.4 GiB/s |
| 8k 70r/30w | 8732MiB /3743MiB/s | 8632MiB/3699MiB/s | 8395MiB/3598MiB/s | 8729MiB /3741MiB/s |
100 GbE NIC IOPS
| Arbetsbelastning | Värd 1 | Värd 1 Ramped | Värd 2 | Värd 3 | Värd 4 |
| 4k läser | 980k | 2019k | 1108k | 1102k | 1120k |
| 4k skriver | 968k | 2776k | 494k | 1025k | 1011k |
| 64 läser | 140k | 118k | 125k | 141k | 140k |
| 64k skriver | 72.5k | 179k | 40.1k | 100k | 47.0k |
| 8k 70r/30w | 498k / 213k | 1147k / 491k | 597k / 256k | 567k / 243k | 595k / 255k |
100 GbE NIC-bandbredd
| Arbetsbelastning | Värd 1 | Värd 1 Ramped | Värd 2 | Värd 3 | Värd 4 |
| 4K Läs |
3828 MB/s | 7887 MB/s | 4330 MB/s | 4303 MB/s | 4374 MB/s |
| 4K Skriv |
3783 MB/s | 10.6 GiB/s | 1931 MB/s | 4005 MB/s | 3950 MB/s |
| 64K Läs | 8761 MB/s | 7269 MB/s | 7804 MB/s | 8832 MB/s | 8753 MB/s |
| 64K Skriv |
4529 MB/s | 10.9 GiB/s | 2505 MB/s | 6251 MB/s | 3000 MB/s |
| 8K 70R/30W | 3889MiB/1667MiB/s | 8958MiB/3839MiB/s | 4663MiB/1998MiB/s | 4427MiB/1897MiB/s | 4646MiB/1991MiB/s |
Ocuco-landskapet Svängbar FS1600 är en artist
Vi visste när vi gick in i den här recensionen att Fungible FS1600 var snabb; det rådde ingen tvekan om. Även om de enskilda korten i varje värd var mättade, inklusive DPU och NIC, hade arrayen fortfarande prestanda över. Det primära fokuset var hur NIC och DPU:er jämförs för NVMe/TCP-arbetsbelastningar som använder samma lagringsarray med liknande testscenarier. DPU:er har medfört otroliga fördelar för lagringsmarknaden. De kan ladda bort aktivitet från processorn, vilket frigör den för att hantera andra uppgifter som applikationsarbetsbelastningar med den I/O eller bandbredden. Genom att begränsa vårt fokus till en enda värd ser vi dessa fördelar.
Svängbar DPU
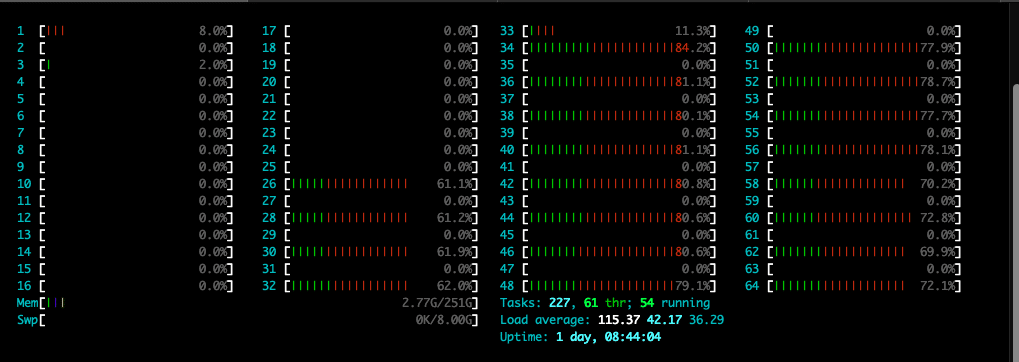
Om du håller varje arbetsbelastnings genomsnittliga latens likadan, kan du se att DPU:n kan driva ungefär dubbelt så mycket prestanda som NIC. Här mätte vi 2.02M IOPS 4K slumpmässig avläsning från Fungible DPU, med en genomsnittlig latens på 0.474ms. Om vi tittar på CPU-användningen i realtid under denna arbetsbelastning kan vi se att arbetsbelastningen finns i CPU-kärnorna som specificeras i FIO-arbetsbelastningen.
fio –group_reporting –time_based –runtime=10m –rw=randread –bs=4k –iodepth=5 –numjobs=12 –ioengine=libaio –direct=1 –prio=0 –cpus_allowed_policy=split –cpus_allowed=25,27,29,31,33,35,37,39,41,43,45,47,49,51,53,55,57,59,61,63, 0 –randrepeat=XNUMX
100 GbE NIC
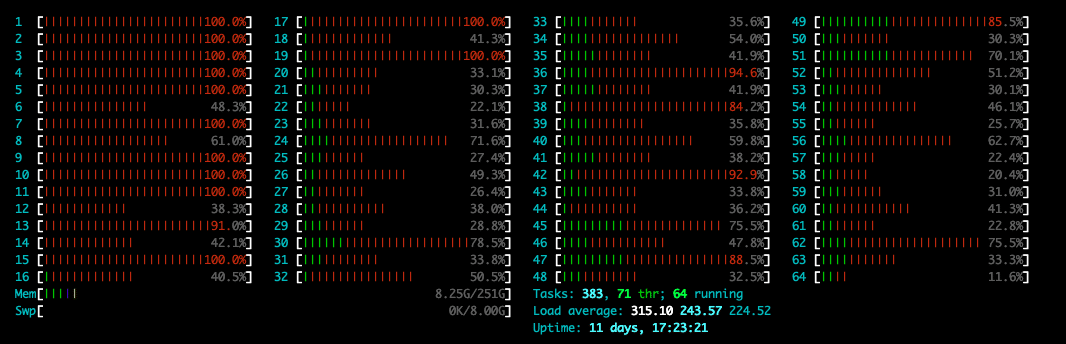
Därefter flyttade vi till 100GbE NIC, som kan köra 980k IOPS med en genomsnittlig latens på 0.39ms. IO-djupet och antalet jobb reducerades från DPU:n för att hålla latensen i schack, men om du tittar på CPU-användningen ser du snabbt var fördelarna med DPU:n kommer in. Medan NIC tilldelades samma CPU-kärnor i FIO-jobbet , hade den mycket bredare systemanvändning. Det finns en avvägning mellan att CPU utnyttjas för back-end-processer (NIC, adaptrar, etc.) i en produktionsserver kontra front-end-processer som applikationsarbetsbelastningar. Här ser vi NIC-drivrutinen konsumera CPU-cykler medan DPU:n hålls internaliserad.
fio –group_reporting –time_based –runtime=10m –rw=randread –bs=4k –iodepth=4 –numjobs=6 –ioengine=libaio –direct=1 –prio=0 –cpus_allowed_policy=split –cpus_allowed=25,27,29,31,33,35,37,39,41,43,45,47,49,51,53,55,57,59,61,63, 0 –randrepeat=XNUMX
100 GbE NIC Ramped
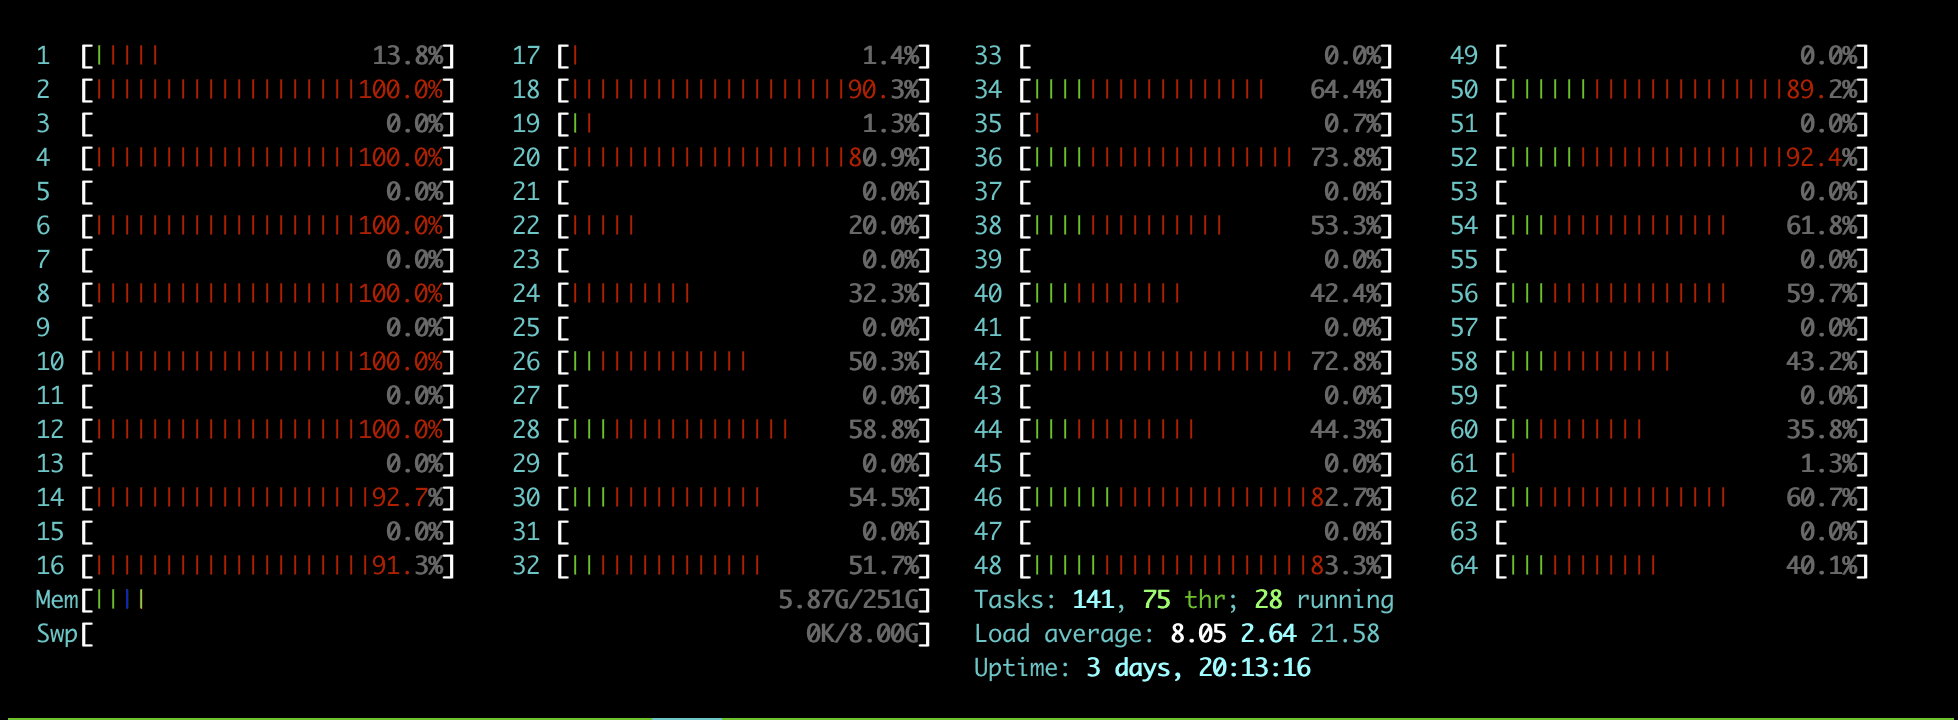
Slutligen flyttade vi till den avstämda 100GbE NIC-arbetsbelastningen, som kunde komma upp till samma prestandanivå som DPU:n, runt 2.02M IOPS. Kostnaden för den högre hastigheten är dock latens, som ökade avsevärt till 2.6 ms och högre topplatens. Detta var från att skala joddjupet från 4 till 16 och antalet jobb från 6 till 20. Även om fokus kan vara centrerat på den ökade latensen, ser du på CPU-användningen, kan du se att nästan alla systemresurser fokuseras på I/O-aktiviteten, vilket inte lämnar mycket till andra processer. För företag som försöker göra sina serverdistributioner mer täta och effektiva är det lätt att se att inte alla I/O skapas lika och hur DPU:er snabbt förändrar lagringsmarknaden.
fio –group_reporting –time_based –runtime=10m –rw=randread –bs=4k –iodepth=16 –numjobs=20 –ioengine=libaio –direct=1 –prio=0 –cpus_allowed_policy=split –cpus_allowed=14-63 –randrepeat 0
slutord
Vi har arbetat med Fungible FS1600 och deras DPU:er i ett antal veckor nu. Även om själva arrayen inte kräver några snygga kablar eller ändringar, ville vi vara noggranna i analysen för att på djupet förstå effekten av DPU:er. Det är inte så att DPU:er i sig är helt nya, men de blir äntligen kommersiellt tillgängliga i företagsbaserade lösningar, inte bara vetenskapsprojekt. Och för att vara tydlig, är DPU-implementeringar inte likadana, så det är viktigt att förstå infrastruktur- och prestandaimplikationerna i designbeslut.
I denna DPU-värld framstår Fungible som ganska unik. De gick efter en skräddarsydd lösning när företaget startade redan 2015, och tog på sig betydande pengar för att bygga företaget i slutet av 2016. Det var ungefär när Mellanox tillkännagav sin första version av en DPU, kallad BlueField. Även om det skulle kunna hävdas att Fungible skulle ha gjort bra att adoptera BlueField, har att gå sin egen väg resulterat i en betydande teknik- och ledarskapsfördel. Fungible har full kontroll över sin stack och kan enkelt utnyttja DPU:er på både klienten och målet. Eller inte, beslutet ligger hos kunderna. Men i våra tester ser vi betydande fördelar med att gå från början till slut med Fungible.
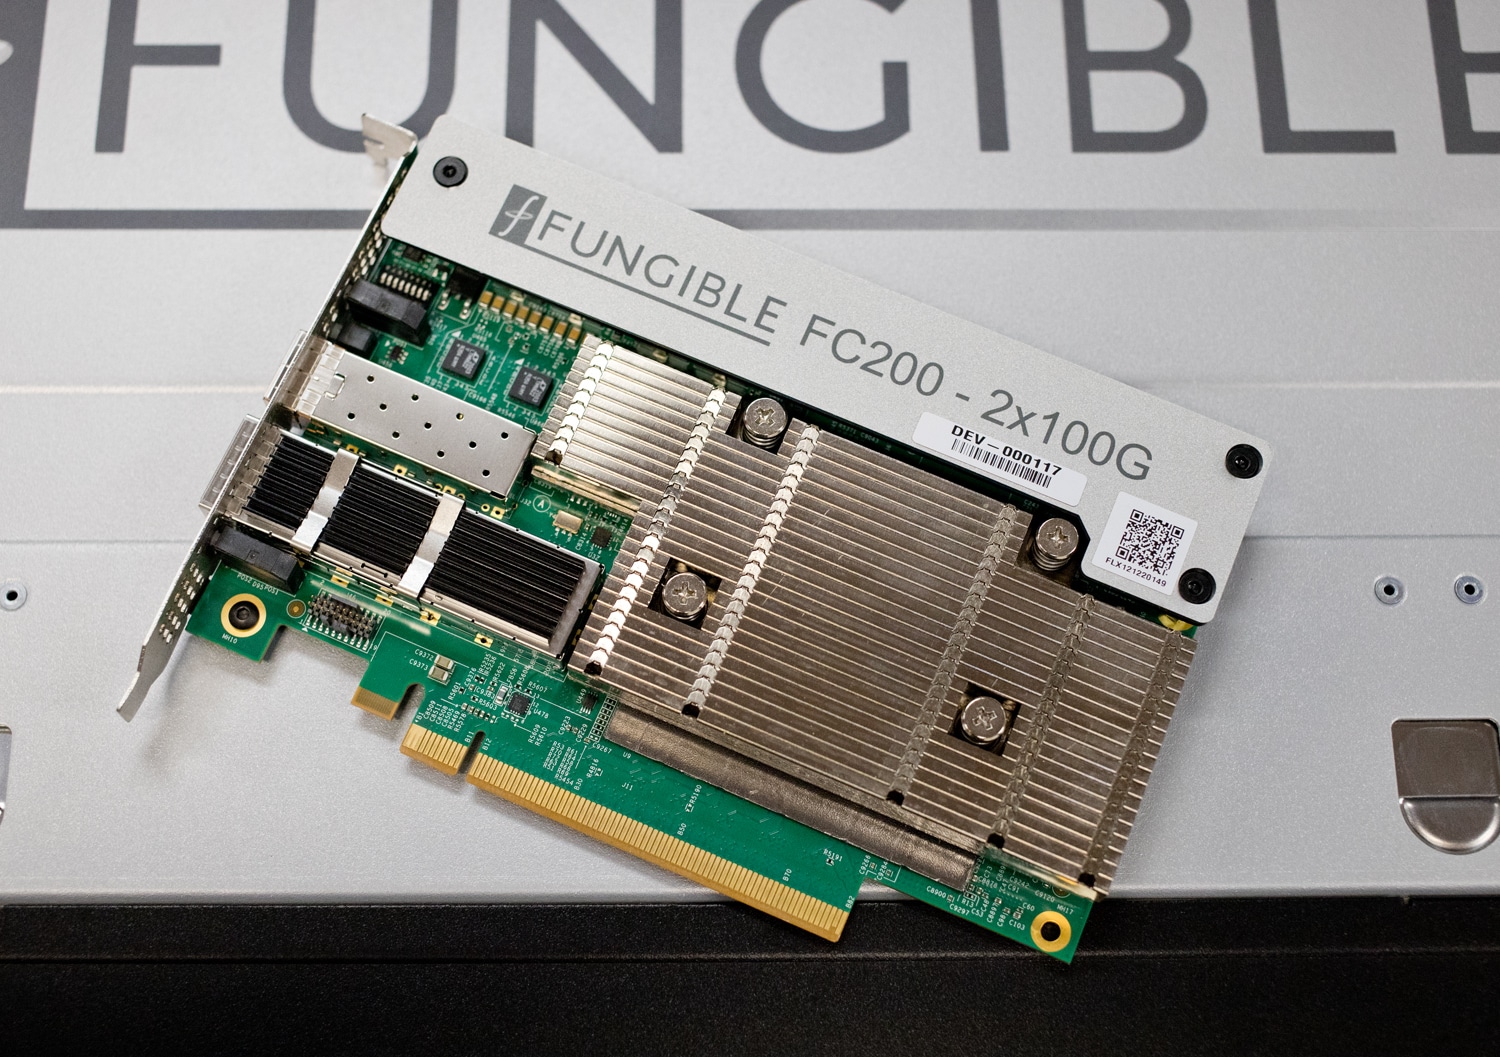
Fungible som kommer in med DPU:er som utnyttjas i lagringsarrayen och värddatorn kompletterar en bild som erbjuder en enorm fördel när det gäller prestanda. DPU:er avlastar resurser som annars skulle tilldelas systemprocessorn, vilket ger en intressant kombination när den används på båda sidor av ekvationen. När du kan utnyttja Fungible FC200 istället för ett traditionellt nätverkskort, ser du enorma betydande vinster med I/O-hastighet samt lägre CPU-användning. Enbart om vi tittar på vår 4K slumpmässiga läsöverföring, kunde FC200 köra över 2M IOPS med 0.474ms latens, medan NIC kunde göra omkring 1M IOPS vid 0.39ms. Att rampa upp nätverkskortet för att driva 2M IOPS var möjligt men till en betydande kostnad för latens och systemresurser.
Svängbar FC200 DPU
DPU:er som en klass har en enorm potential när det gäller att låsa upp den inbyggda prestanda som finns tillgänglig i flashlagring. Även om detta redan är ett sant uttalande idag, blir matematiken ännu mer gynnsam för DPU:er när teknik som Gen5 SSD:er och snabbare sammankopplingar kommer ut på marknaden. Att betala x86-premien för att hantera PCIe-banor är helt enkelt inte vettigt när det kommer till applikationer som kan dra nytta av dessa komponenter och äldre arkitekturer är helt enkelt inte lika skalbara.
Fungible har övertygande hårdvara och mjukvara med lagringsnoden FS1600 och acceleratorkort. De har också nyligen siktat på att disaggregera GPU:er , vilket erbjuder kunderna en mer komplett stack för HPC- och AI-arbetsbelastningar. Det kommer att finnas flera vinnare inom det snabbt framväxande DPU-området, men Fungible är definitivt en att hålla ett öga på. Organisationer som behöver få ut det mesta av sin lagring bör definitivt testa en FS1600.


 Amazon