

Lenovo ThinkSystem SR650 V4 är en flexibel och kraftfull 2U-rackserver med 2 socklar, utformad för att möta behoven inom branscher som molntjänster, telekommunikation och högpresterande datoranvändning (HPC). Oavsett om du optimerar för skalbara arbetsbelastningar eller framtidssäkrar ditt datacenter med högdensitetsberäkning, erbjuder SR650 V4 meningsfulla uppgraderingar jämfört med sin föregångare, SR650 V3.

Skillnader mellan Lenovo SR650 V4 och SR650 V3
Processorer
Processorkapaciteten markerar en av de mer betydande uppgraderingarna i SR650 V4. Medan SR650 V3 förlitade sig på fjärde generationens skalbara Intel Xeon-processorer, introducerar SR650 V4 Intel Xeon 6-plattformen (tidigare kodnamnet "Granite Rapids"). Vår recension fokuserar på P-core-arkitekturen (Performance-core), som är utformad specifikt för beräkningsintensiva arbetsbelastningar. V4 stöder en eller två processorer med upp till 86 P-kärnor per sockel (upp till 172 trådar), vilket ger högre kärnhastigheter (upp till 4 GHz) och TDP:er på upp till 350 W.
Denna övergång gör det möjligt för organisationer att hantera mer krävande applikationer per server, vilket minskar deras fysiska fotavtryck. Arkitekturen skapar en robust grund för virtualisering och tung databasdrift. Dessutom stöder V4:ans arkitektur massiv PCIe-bandbredd, med upp till 88 PCIe 5.0-banor per processor, vilket är avgörande för att mata moderna höghastighetsnätverkskort och NVMe-lagringsarrayer utan flaskhalsar.
| CPU-modell | Kärnor / trådar | Bas Frekv | Max Turbo | L3 Cache | TDP |
|---|---|---|---|---|---|
| 6787P | 86 / 172 | 2.0 GHz | 3.8 GHz | 336 MB | 350 W |
| 6781P | 80 / 160 | 2.0 GHz | 3.8 GHz | 336 MB | 350 W |
| 6767P | 64 / 128 | 2.4 GHz | 3.9 GHz | 336 MB | 350 W |
| 6761P | 64 / 128 | 2.5 GHz | 3.9 GHz | 336 MB | 350 W |
| 6760P | 64 / 128 | 2.2 GHz | 3.8 GHz | 320 MB | 330 W |
| 6747P | 48 / 96 | 2.7 GHz | 3.9 GHz | 288 MB | 330 W |
| 6745P | 32 / 64 | 3.1 GHz | 4.3 GHz | 336 MB | 300 W |
| 6741P | 48 / 96 | 2.5 GHz | 3.8 GHz | 288 MB | 300 W |
| 6740P | 48 / 96 | 2.1 GHz | 3.8 GHz | 288 MB | 270 W |
| 6737P | 32 / 64 | 2.9 GHz | 4.0 GHz | 144 MB | 270 W |
| 6736P | 36 / 72 | 2.0 GHz | 4.1 GHz | 144 MB | 205 W |
| 6732P | 32 / 64 | 3.8 GHz | 4.3 GHz | 144 MB | 350 W |
| 6731P | 32 / 64 | 2.5 GHz | 4.1 GHz | 144 MB | 245 W |
| 6730P | 32 / 64 | 2.5 GHz | 3.8 GHz | 288 MB | 250 W |
| 6724P | 16 / 32 | 3.6 GHz | 4.3 GHz | 72 MB | 210 W |
| 6714P | 8 / 16 | 4.0 GHz | 4.3 GHz | 48 MB | 165 W |
| 6530P | 32 / 64 | 2.3 GHz | 4.1 GHz | 144 MB | 225 W |
| 6527P | 24 / 48 | 3.0 GHz | 4.2 GHz | 144 MB | 255 W |
| 6521P | 24 / 48 | 2.6 GHz | 4.1 GHz | 144 MB | 225 W |
| 6520P | 24 / 48 | 2.4 GHz | 4.0 GHz | 144 MB | 210 W |
| 6517P | 16 / 32 | 3.2 GHz | 4.2 GHz | 72 MB | 190 W |
| 6515P | 16 / 32 | 2.3 GHz | 3.8 GHz | 72 MB | 150 W |
| 6511P | 16 / 32 | 2.3 GHz | 4.2 GHz | 72 MB | 150 W |
| 6507P | 8 / 16 | 3.5 GHz | 4.3 GHz | 48 MB | 150 W |
| 6505P | 12 / 24 | 2.2 GHz | 4.1 GHz | 48 MB | 150 W |
Minne
När det gäller minne förbättrar SR650 V4 V3:ans kapacitet avsevärt och maximerar delsystemets prestanda. Den stöder DDR5-minneshastigheter på upp till 6400 MHz (1 DIMM per kanal), ett betydande hopp från föregående generations gräns på 4800 MHz. Systemet har 32 DIMM-platser (16 per processor) fördelade över åtta minneskanaler per processor. Den stöder standard RDIMM, 3DS RDIMM och de nya Multiplexed Rank DIMM (MRDIMM), som kan arbeta med hastigheter upp till 8000 MHz för bandbreddskrävande applikationer. Med 256 GB 3DS RDIMM stöder servern hela 8 TB totalt systemminne.

Dessutom introducerar V4 stöd för CXL 2.0 (Compute Express Link) minnesutbyggnad. Administratörer kan installera upp till 12 CXL-minnesmoduler i E3.S-enhetsfacken (specifikt E3.S 2T-formfaktorn). Detta gör att systemet kan skala minneskapacitet och bandbredd utöver traditionella processoranslutna gränser, vilket minskar beräkningslatensen för nästa generations arbetsbelastningar och sänker den totala ägandekostnaden (TCO) genom att stranda mindre minne.
lagring
Lenovo SR650 V4-lagringskapaciteten visar ett skifte mot högpresterande NVMe-densitet och flexibla formfaktorer. V4 stöder äldre 3.5-tums- och 2.5-tumshårddiskar, men introducerar massivt stöd för E3.S NVMe-formfaktorn. Systemet kan hantera upp till 32x E3.S 1T-hårddiskar eller 12x E3.S 2T-hårddiskar, vilket ger högre densitet och förbättrad värmehantering jämfört med traditionella U.2 SSD-diskar.

Avgörande är att V4 stöder direkt NVMe-anslutning utan överprenumeration (1:1), vilket säkerställer att höghastighetslagring inte flaskhalsas av PCIe-fildelning. Inkluderingen av M.2 hot-swap-startalternativ för hårddiskar förbättrar ytterligare servicevänligheten.
nätverk
För nätverk har SR650 V4 två dedikerade OCP 3.0-kortplatser, som båda stöder PCIe Gen 5 x16. Detta är en viktig uppgradering som möjliggör redundant nätverksuppkoppling med hög hastighet (t.ex. 200 GbE med dubbla portar eller 400 GbE med en port) utan att förbruka vanliga PCIe-riserkortplatser. Övergången till PCIe 5.0 fördubblar den teoretiska bandbredden (32 GT/s vs. 16 GT/s), vilket gör V4 kapabel att hantera den mest krävande moln- och AI-nätverkstrafiken.

Kraft och kylning
SR650 V4 erbjuder förbättrade strömförsörjningsalternativ, från 800 W upp till 3200 W, tillgängliga i effektivitetsnivåerna Titanium och Platinum. Systemet stöder även -48 V DC och HVAC/HVDC-alternativ för att möta specifika datacenterkrav.

För att hantera värme från processorer och minne med hög TDP introducerar Lenovo Neptune-vätskekylningsalternativ. "Compute Complex Neptune Core Module" använder öppen vätskekylning för att avlägsna värme från processorer, minne och spänningsregulatorer, och kan fånga upp över 80 % av servervärmen och avsevärt minska kylkostnaderna för datacentret.
Sammantaget levererar SR650 V4 ett rejält språng framåt vad gäller prestanda, densitet och termisk effektivitet för moderna företagsmiljöer.
Lenovo ThinkSystem SR650 V4-specifikationer
| Specifikation | Detaljer |
|---|---|
| Systemspecifikationer | |
| Formfaktor | 2U-rack |
| Processorn | Upp till 2x Intel Xeon 6700/6400-serien (P-kärnor); Upp till 86 kärnor per processor; Upp till 350 W TDP |
| Minne | 32 DIMM-platser (16 per processor); stöder TruDDR5 RDIMM-minnen upp till 6400 MHz och MRDIMM-minnen upp till 8000 MHz |
| Minnesutvidgning | Stöder CXL 2.0-minnesmoduler i E3.S 2T-formfaktor (upp till 12x DIMM-moduler) |
| Minne max | Upp till 8 TB systemminne (med 256 GB 3DS RDIMM-moduler) |
| Diskenhetsfack | Fram: Upp till 24x 2.5″ NVMe/SAS/SATA, 16x 3.5″ SAS/SATA eller 32x E3.S NVMe Mitten: Upp till 8x 2.5″ enkelt byte Bak: Upp till 8x 2.5″ eller 4x 3.5″ hot-swap |
| Lagringskontroll | Upp till 36 inbyggda NVMe-portar (1:1-anslutning); RAID/HBA-stöd |
| Nätverksgränssnitt | Två OCP 3.0 SFF-kortplatser med PCIe 5.0 x16-värdgränssnitt |
| PCI Expansion Slots | Upp till 10x PCIe 5.0-kortplatser (bak); valfria PCIe-kortplatser framtill |
| GPU-support | Upp till 10x enkelbredds GPU:er eller 2x dubbelbredds GPU:er |
| Hamnar | Fram: Extern diagnostikport, USB (tillval) och Mini-DP Bak: 2x USB 3.0, 1x VGA, 1x RJ-45-hantering, seriellt uttag som tillval |
| Kylning | Upp till 6x hot-swap-fläktar (N+1 redundans); Neptune-vätskekylningsmoduler som tillval |
| Strömförsörjning | Upp till två redundanta AC/DC-nätaggregat som kan bytas under drift (800–3200 W) |
| Systems Management | XClarity Controller 3 (XCC3); XCC3 Premier som tillval |
| säkerhets~~POS=TRUNC | TPM 2.0, PFR Root of Trust (NIST SP800-193), chassintrång, låsbar ram |
| Operativsystem | Microsoft Windows Server, RHEL, SLES, Ubuntu Server |
| Garanti | 3 års grundgaranti (konfigurerbar) |
| Mått | 87 mm (3.4 tum) H x 440 mm (17.3 tum) B x 800 mm (31.5 tum) D |
| Vikt | Maxvikt: 38.8 kg (85.5 lb) |
Lenovo ThinkSystem SR650 V4 Design och konstruktion
Lenovo ThinkSystem SR650 V4 är en standard 2U-plattform som effektivt utnyttjar sitt fysiska skal och balanserar komponentdensitet med luftflöde och servicevänlighet. Chassit mäter 3.4 cm på höjden, 17.3 cm på bredden och 31.5 cm på djupet, med en maximal konfigurerad vikt på 85.5 kg. Dessa mått placerar den i linje med andra 2U-företagsservrar samtidigt som den ger tillräckligt djup för högpresterande processorer, täta minneskonfigurationer och flexibla lagringsbakplan.
Lenovos etablerade ThinkSystem-industridesign är omedelbart igenkännbar, med ett styvt stålchassi och tydlig, funktionell märkning. Internt är layouten ren och ändamålsenlig, med betoning på rakt luftflöde, modulära komponentzoner och verktygslös åtkomst för rutinmässig service. Den övergripande konstruktionen känns robust och välkonstruerad, vilket återspeglar en plattform utformad för kontinuerlig drift i datacentermiljöer snarare än estetiskt tilltalande.
Frontpanelen
Frontpanelen är mycket konfigurerbar. Vårt testsystem är utrustat med ett 8-facks 2.5-tums bakplan för hårddiskar, men chassit skalas enkelt upp till 16 eller till och med 24 fack med minimal ansträngning. Kunder kan också välja 3.5-tumsfack för högre råkapacitet eller de nyare E3.S-bakplansalternativen för högpresterande NVMe-densitet. AnyBay-stöd gör att SAS-, SATA- och NVMe-hårddiskar kan samexistera i samma hårddiskbur, vilket ger betydande flexibilitet för blandad lagring.

Frontpanelen innehåller viktiga operatörskontroller: en strömbrytare, en ID-knapp och status-LED-lampor som indikerar systemets hälsa och nätverksaktivitet. En utdragbar informationsflik ger snabb åtkomst till XCC:ns nätverksåtkomstetikett och serienummer. Valfri lokal anslutning inkluderar en Mini DisplayPort och USB-portar för åtkomst från kraschvagn, vilket är ovärderligt för felsökning i datacenter med låg energiförbrukning.
baksida
Baksidan av chassit är utformad för maximal I/O-densitet. Det kan rymma upp till 10 PCIe Gen 5-platser, beroende på riserkonfigurationen. Inkluderingen av två OCP 3.0-platser frigör standard PCIe-riserkort för andra tilläggskort, såsom GPU:er eller lagringskontroller.
Förutom expansionsmöjligheter finns den inbyggda BMC-nätverksporten för hantering, två USB-A-portar och en VGA-utgång för lokal konsolåtkomst på bakpanelen. Dubbla hot-swap-nätaggregat är monterade på baksidan, vilket bibehåller servicevänligheten utan att påverka luftflödet eller expansionslayouterna.
Inre
Internt är layouten ren och optimerad för luftflöde. 32 DIMM-platser flankerar dubbla CPU-sockel, arrangerade för att upprätthålla obehindrad kylning från fram till bak från en uppsättning av sex högpresterande hot-swap-fläktar på chassits framsida. Fläktarna är helt verktygslösa och lätt utbytbara, och hela fläkthållaren kan tas bort utan verktyg. Att ta bort hållaren ger obehindrad direktåtkomst till AnyBay-lagringsutrymmet, vilket förenklar service, uppgraderingar och byte av bakplan.

Lagringskablarna är snyggt dragna längs chassits sidor för att undvika att blockera luftflödet till processorerna och minnet. För konfigurationer som använder Neptune-vätskekylningsmoduler ändras den interna layouten något för att rymma kylvätskeslingorna, men kärnans servicevänlighet förblir hög. M.2-startmodulen är monterad på luftplåten eller hårddiskburen, vilket möjliggör enkel åtkomst utan att ta bort andra komponenter.
XClarity Controller 3
SR650 V4 har den nya XClarity Controller 3 (XCC3). Denna hanteringsmotor erbjuder en betydande prestandauppgradering jämfört med tidigare generationer, med snabbare starttider och ett mer responsivt HTML5-gränssnitt. Platform Resource Manager tillhandahåller detaljerad telemetri om ström- och temperaturstatus, vilket hjälper administratörer att optimera datacentrets effektivitet.
XCC3 stöder ett brett utbud av fjärrstyrningsfunktioner, inklusive fjärrstyrning (KVM), montering av virtuella medier och uppdateringar av firmware. Gränssnittet är intuitivt och ger en översikt över systemets hälsa, aktiva händelser och hårdvaruinventering. För automatisering har XCC3 fullt stöd för Redfish REST API:er.
Lenovo ThinkSystem SR650 V4 prestanda
Det här avsnittet granskar benchmarkresultat från Blender, y-cruncher, vLLM och Phoronix. Inledande tester utfördes på Lenovo ThinkSystem SR650 V4 utrustad med Intel Xeon 6740P-processorer, vilket gjorde det möjligt för oss att utvärdera plattformens prestandafokuserade P-core-arkitektur och totala dataflöde under CPU-bundna arbetsbelastningar. Halvvägs genom granskningen justerade vi systemkonfigurationen för att möjliggöra GPU-accelererad testning. Övergången var enkel, underlättad av Lenovos GPU-aktiveringsuppgraderingskit, som inkluderar högpresterande fläktar, uppgraderade kylflänsar, ett reviderat luftflödeshölje och GPU-kompatibla riser utformade för att stödja kraftfullare acceleratorer. Installationen krävde inga betydande chassiändringar och integrerades snyggt med den befintliga systemlayouten.
Med de uppgraderade kylnings- och luftflödeskomponenterna installerade lade vi till en enda NVIDIA L40S GPU till plattformen. Detta gjorde det möjligt för oss att utöka testningen till att omfatta GPU-accelererade arbetsbelastningar som Blender GPU-rendering och inferensfokuserade benchmarks, samtidigt som vi bibehöll stabila temperaturer och konsekvent systembeteende. Uppgraderingens modulära natur framhäver SR650 V4:s flexibilitet, vilket gör att den enkelt kan övergå från en effektivitetsorienterad CPU-konfiguration till en balanserad CPU+GPU-plattform som är lämplig för blandade beräkningsarbetsbelastningar.
Lenovo ThinkSystem SR650 V4-konfiguration:
- CPU: 2x Intel Xeon 6740P
- Minne: 1TB RAM
- Förvaring: 4 x 960 GB SSD-diskar
- GPU: NVIDIA L40S
Blender 4.5
Blender är ett 3D-modelleringsprogram med öppen källkod. Detta benchmark kördes med hjälp av Blender Benchmark-verktyget. Poängen mäts i samplingar per minut, där högre värden indikerar bättre prestanda.
I Blender CPU-testet levererar Lenovo ThinkSystem SR650 V4 solid renderingsprestanda i alla scener, med 1136.99 samplingar per minut i Monster, 707.60 i Junkshop och 562.53 i Classroom. Resultaten återspeglar stark flertrådad skalning från de dubbla Intel Xeon 6740P-processorerna, med jämn prestanda allt eftersom scenens komplexitet ökar.
| Blender CPU (prover per minut; högre desto bättre) | Lenovo ThinkSystem SR650 V4 (2x Intel Xeon 6740P, 1 TB RAM) |
|---|---|
| Monster | 1136.99 |
| Junkshop | 707.60 |
| Klassrum | 562.53 |
I Blender CPU utan SMT-benchmark visar SR650 V4 en betydande ökning av renderingsdataflödet och når 4686.40 samplingar per minut i Monster, 2223.96 i Junkshop och 2385.98 i Classroom. GPU-resultaten belyser systemets förmåga att accelerera komplexa renderingsarbetsbelastningar och leverera betydligt högre dataflöde jämfört med rendering med enbart CPU.
| Blender CPU (ingen SMT) (Prover per minut; högre desto bättre) | Lenovo ThinkSystem SR650 V4 (2x Intel Xeon 6740P, 1 TB RAM) |
|---|---|
| Monster | 4686.40 |
| Junkshop | 2223.96 |
| Klassrum | 2385.98 |
y-cruncher
y-cruncher är ett flertrådat, skalbart program som beräknar Pi och andra matematiska konstanter upp till biljoner siffror. Sedan lanseringen 2009 har det blivit ett populärt benchmarking- och stresstestprogram för överklockare och hårdvaruentusiaster.
I y-cruncher skalar Lenovo rent allt eftersom problemets storlek ökar, vilket framhäver plattformens starka flertrådade beräkningsprestanda och minnesbandbredd. Med dubbla Intel Xeon 6740P-processorer och 1 TB RAM slutför systemet en 1 miljardsiffrig Pi-beräkning på drygt 20 sekunder och bibehåller en jämn effektivitet upp till 25 miljardsiffriga siffror, vilket tar 362 sekunder. Resultaten visar förutsägbar skalning under ihållande CPU- och minnesbelastning, vilket gör SR650 V4 väl lämpad för tunga matematiska arbetsbelastningar och stresstestscenarier.
| Y-Cruncher (total beräkningstid) | Lenovo ThinkSystem SR650 V4 (2x Intel Xeon 6740P, 1 TB RAM) |
|---|---|
| 1 miljard | 20.715 s |
| 2.5 miljard | 44.412 s |
| 5 miljard | 81.937 s |
| 10 miljard | 152.743 |
| 25 miljard | 362.566 |
vLLM Online-servering LLM-inferensprestanda
vLLM är den mest populära inferens- och servingsmotorn med hög genomströmning för LLM:er. vLLM:s onlineserving benchmark är ett prestandautvärderingsverktyg som mäter den verkliga servingskapaciteten hos denna inferensmotor under samtidiga förfrågningar. Den simulerar produktionsarbetsbelastningar genom att skicka förfrågningar till en körande vLLM-server med konfigurerbara parametrar, inklusive förfrågningshastighet, in-/utmatningslängder och antal samtidiga klienter. Benchmarket mäter viktiga mätvärden, inklusive genomströmning (tokens per sekund), tid till första token och tid per utmatningstoken (TPOT), vilket hjälper användare att förstå hur vLLM presterar under olika belastningsförhållanden.
Vi testade inferensprestanda över en omfattande uppsättning modeller som spänner över olika arkitekturer, parameterskalor och kvantiseringsstrategier, och utvärderade dataflödet under olika samtidighetsprofiler.
Tät modellprestanda
Täta modeller följer den konventionella LLM-arkitekturen, där alla parametrar och aktiveringar används under inferens, vilket resulterar i mer beräkningsintensiv bearbetning än deras glesa motsvarigheter. För att heltäckande utvärdera prestandaegenskaper över modellskalor och kvantiseringsstrategier, jämförde vi flera täta modellkonfigurationer från Llama 3.1 8B-familjen.
Llama 3.1 8B Precision FP8
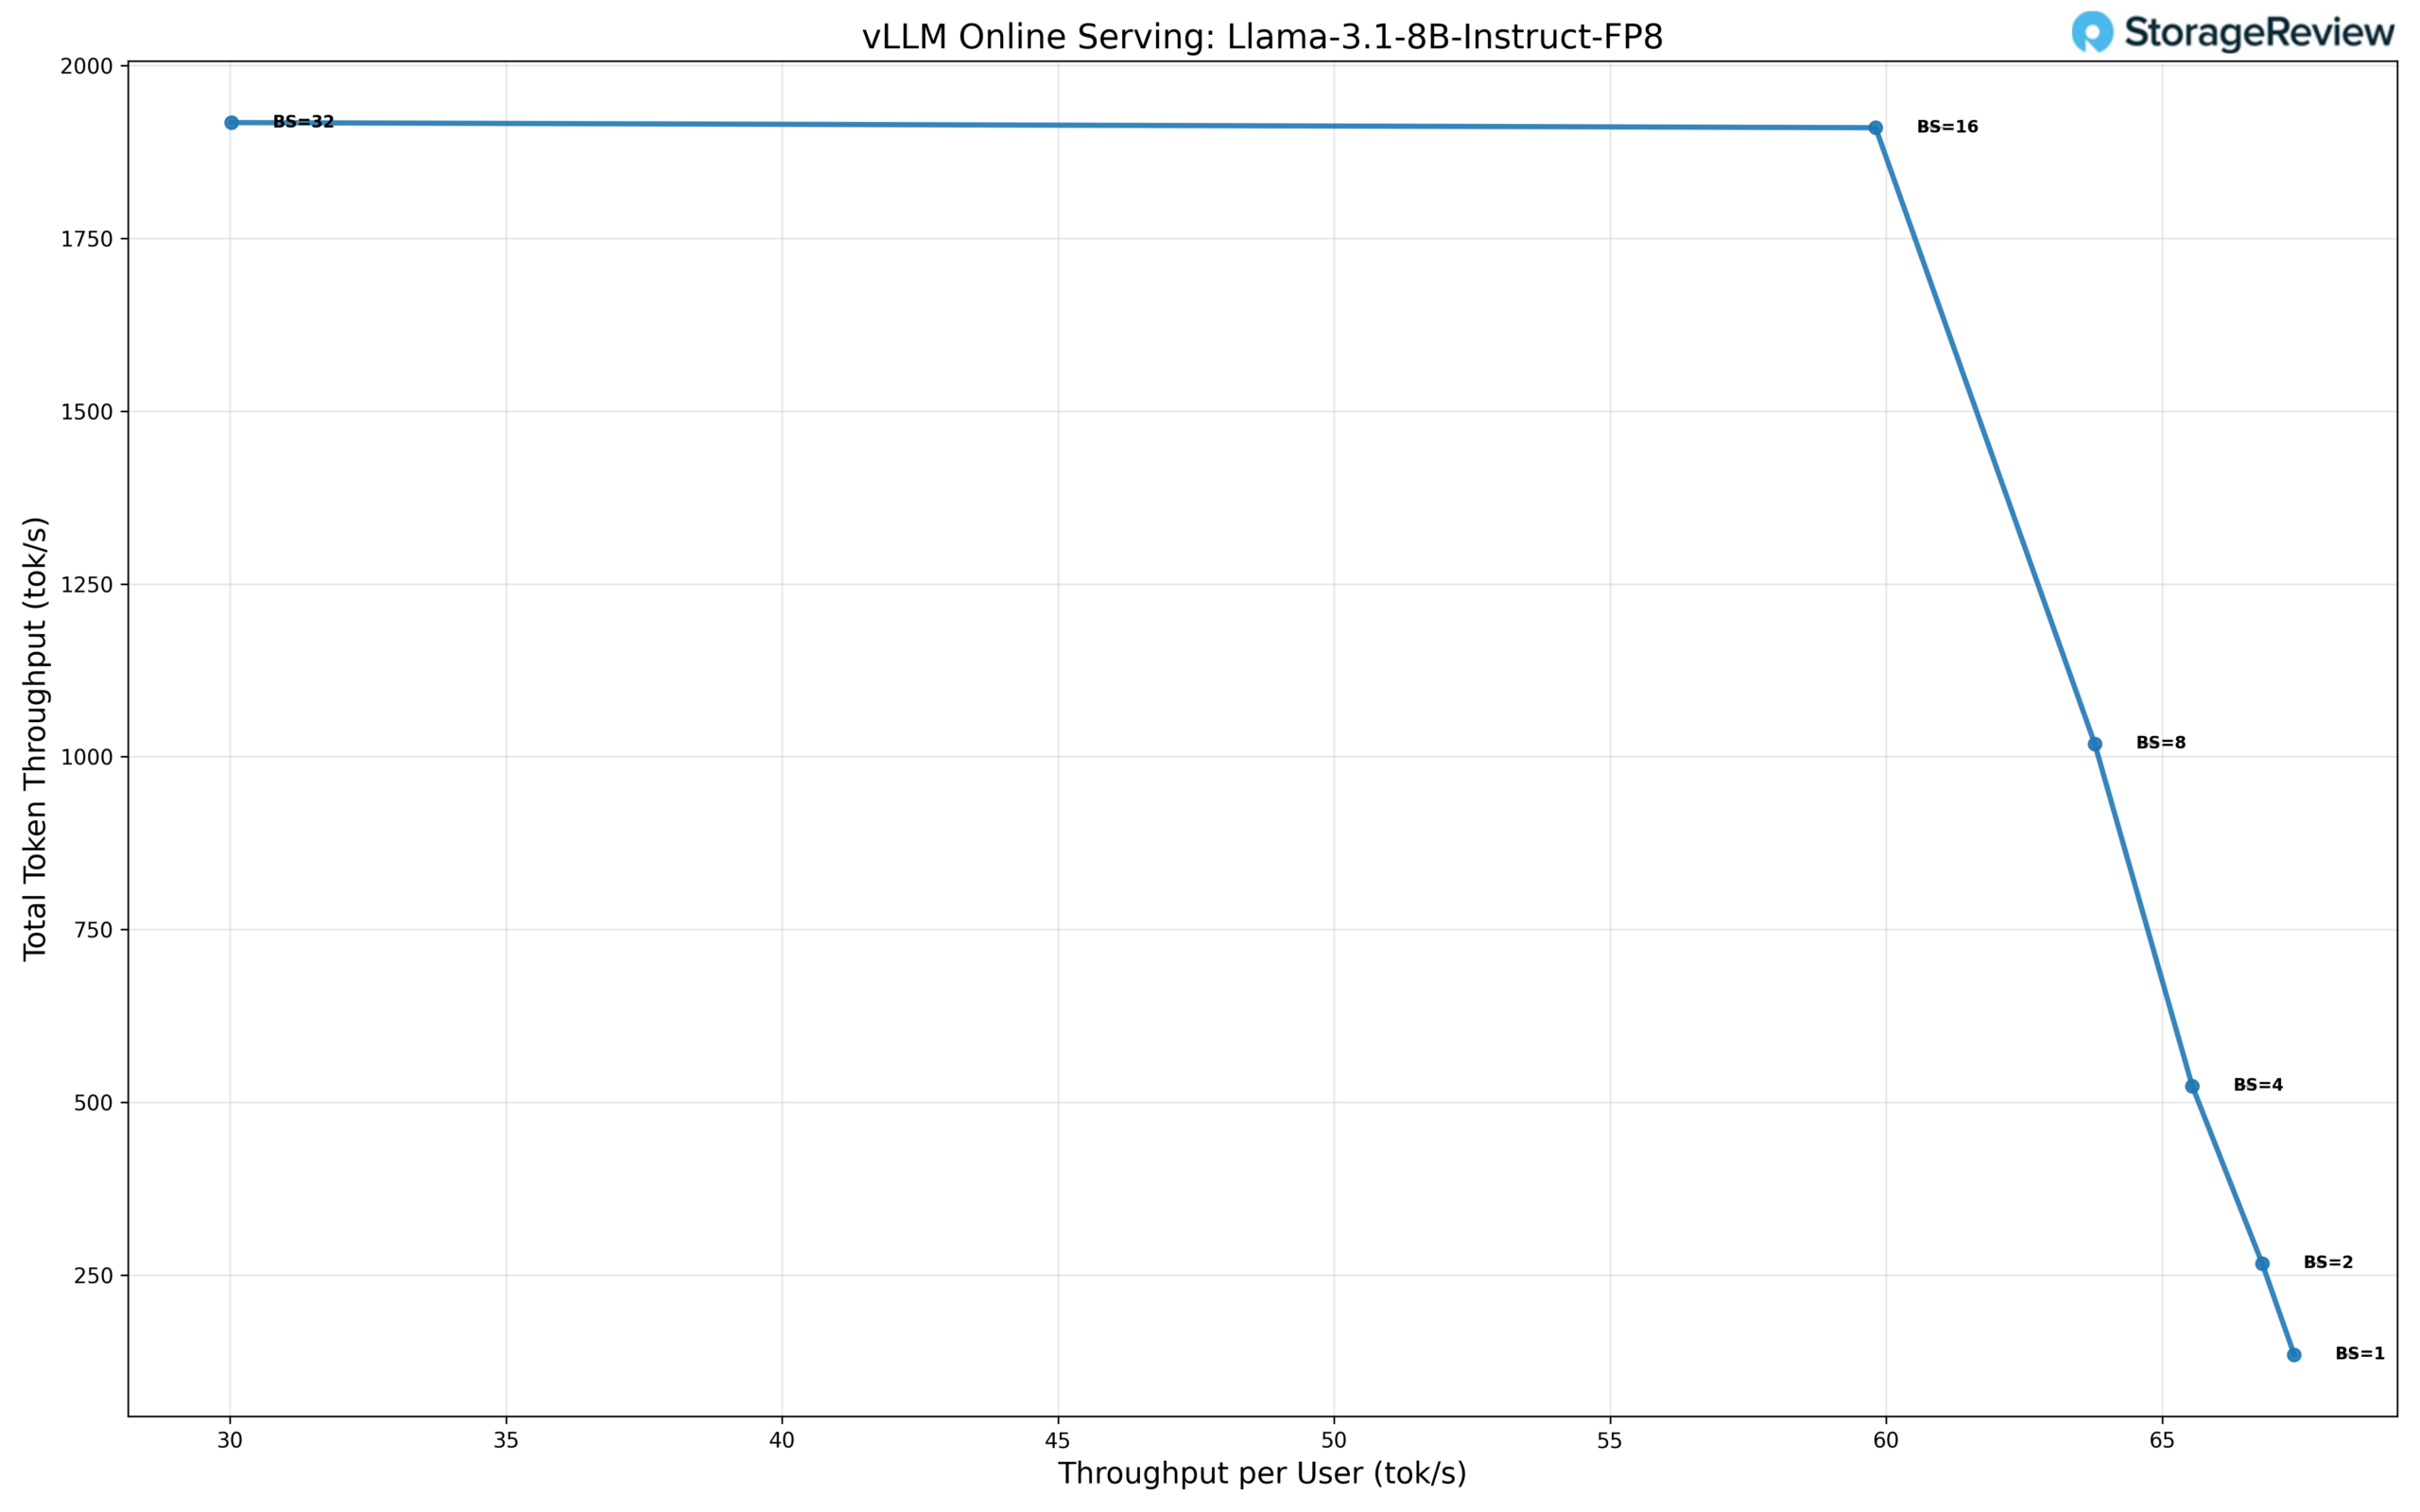
Llama 3.1 8B-modellen som körs i FP8-precision visar en annan skalningsprofil än standardprecisionskonfigurationen, där effektivitet prioriteras vid måttliga samtidighetsnivåer samtidigt som genomströmning utanför toppnivåer hanteras vid högre batchstorlekar. Vid samtidighet med en enda användare (BS=1) levererar modellen 67.8 tok/s per användare, med en total genomströmning på 135.6 tok/s och en TPOT på cirka 3.1 ms, vilket ger en lägre baslinje för en enda ström jämfört med full precision.
Allt eftersom batchstorleken ökar skalas den totala dataflödet snabbt medan dataflödet per användare minskar på ett kontrollerat sätt. Vid BS=2 ökar dataflödet till totalt 271 tok/s, med 66.8 tok/s per användare. Vid BS=4 når det totala dataflödet 523 tok/s, och vid BS=8 levererar modellen 1 017 tok/s, med 63.6 tok/s per användare. Latensen förblir stabil genom dessa lägre samtidighetsnivåer, vilket gör FP8 väl lämpat för lätta inferensscenarier med flera användare.
Skalningen fortsätter till BS=16, där modellen bibehåller en total genomströmning på 1 918 tok/s, med 60.0 tok/s per användare. Vid BS=32 platåar den totala genomströmningen på cirka 1 920 tok/s, med genomströmningen per användare som sjunker till 30.0 tok/s. Denna platå indikerar att FP8-konfigurationen når sin mättnadspunkt tidigare än standardprecision, vilket gynnar effektivitet och förutsägbarhet framför maximal aggregerad genomströmning.
Sammantaget uppnår FP8 en ökning på ungefär 14 gånger i total dataflöde från BS=1 till sin topp vid BS=16-32. Latensen förblir konstant upp till BS=16 och planar sedan ut i takt med dataflödet vid högre samtidighet, vilket framhäver FP8 som ett praktiskt val för balanserade, latenskänsliga inferensarbetsbelastningar snarare än extrem batchskalning.
Llama 3.1 8B Standard Precision
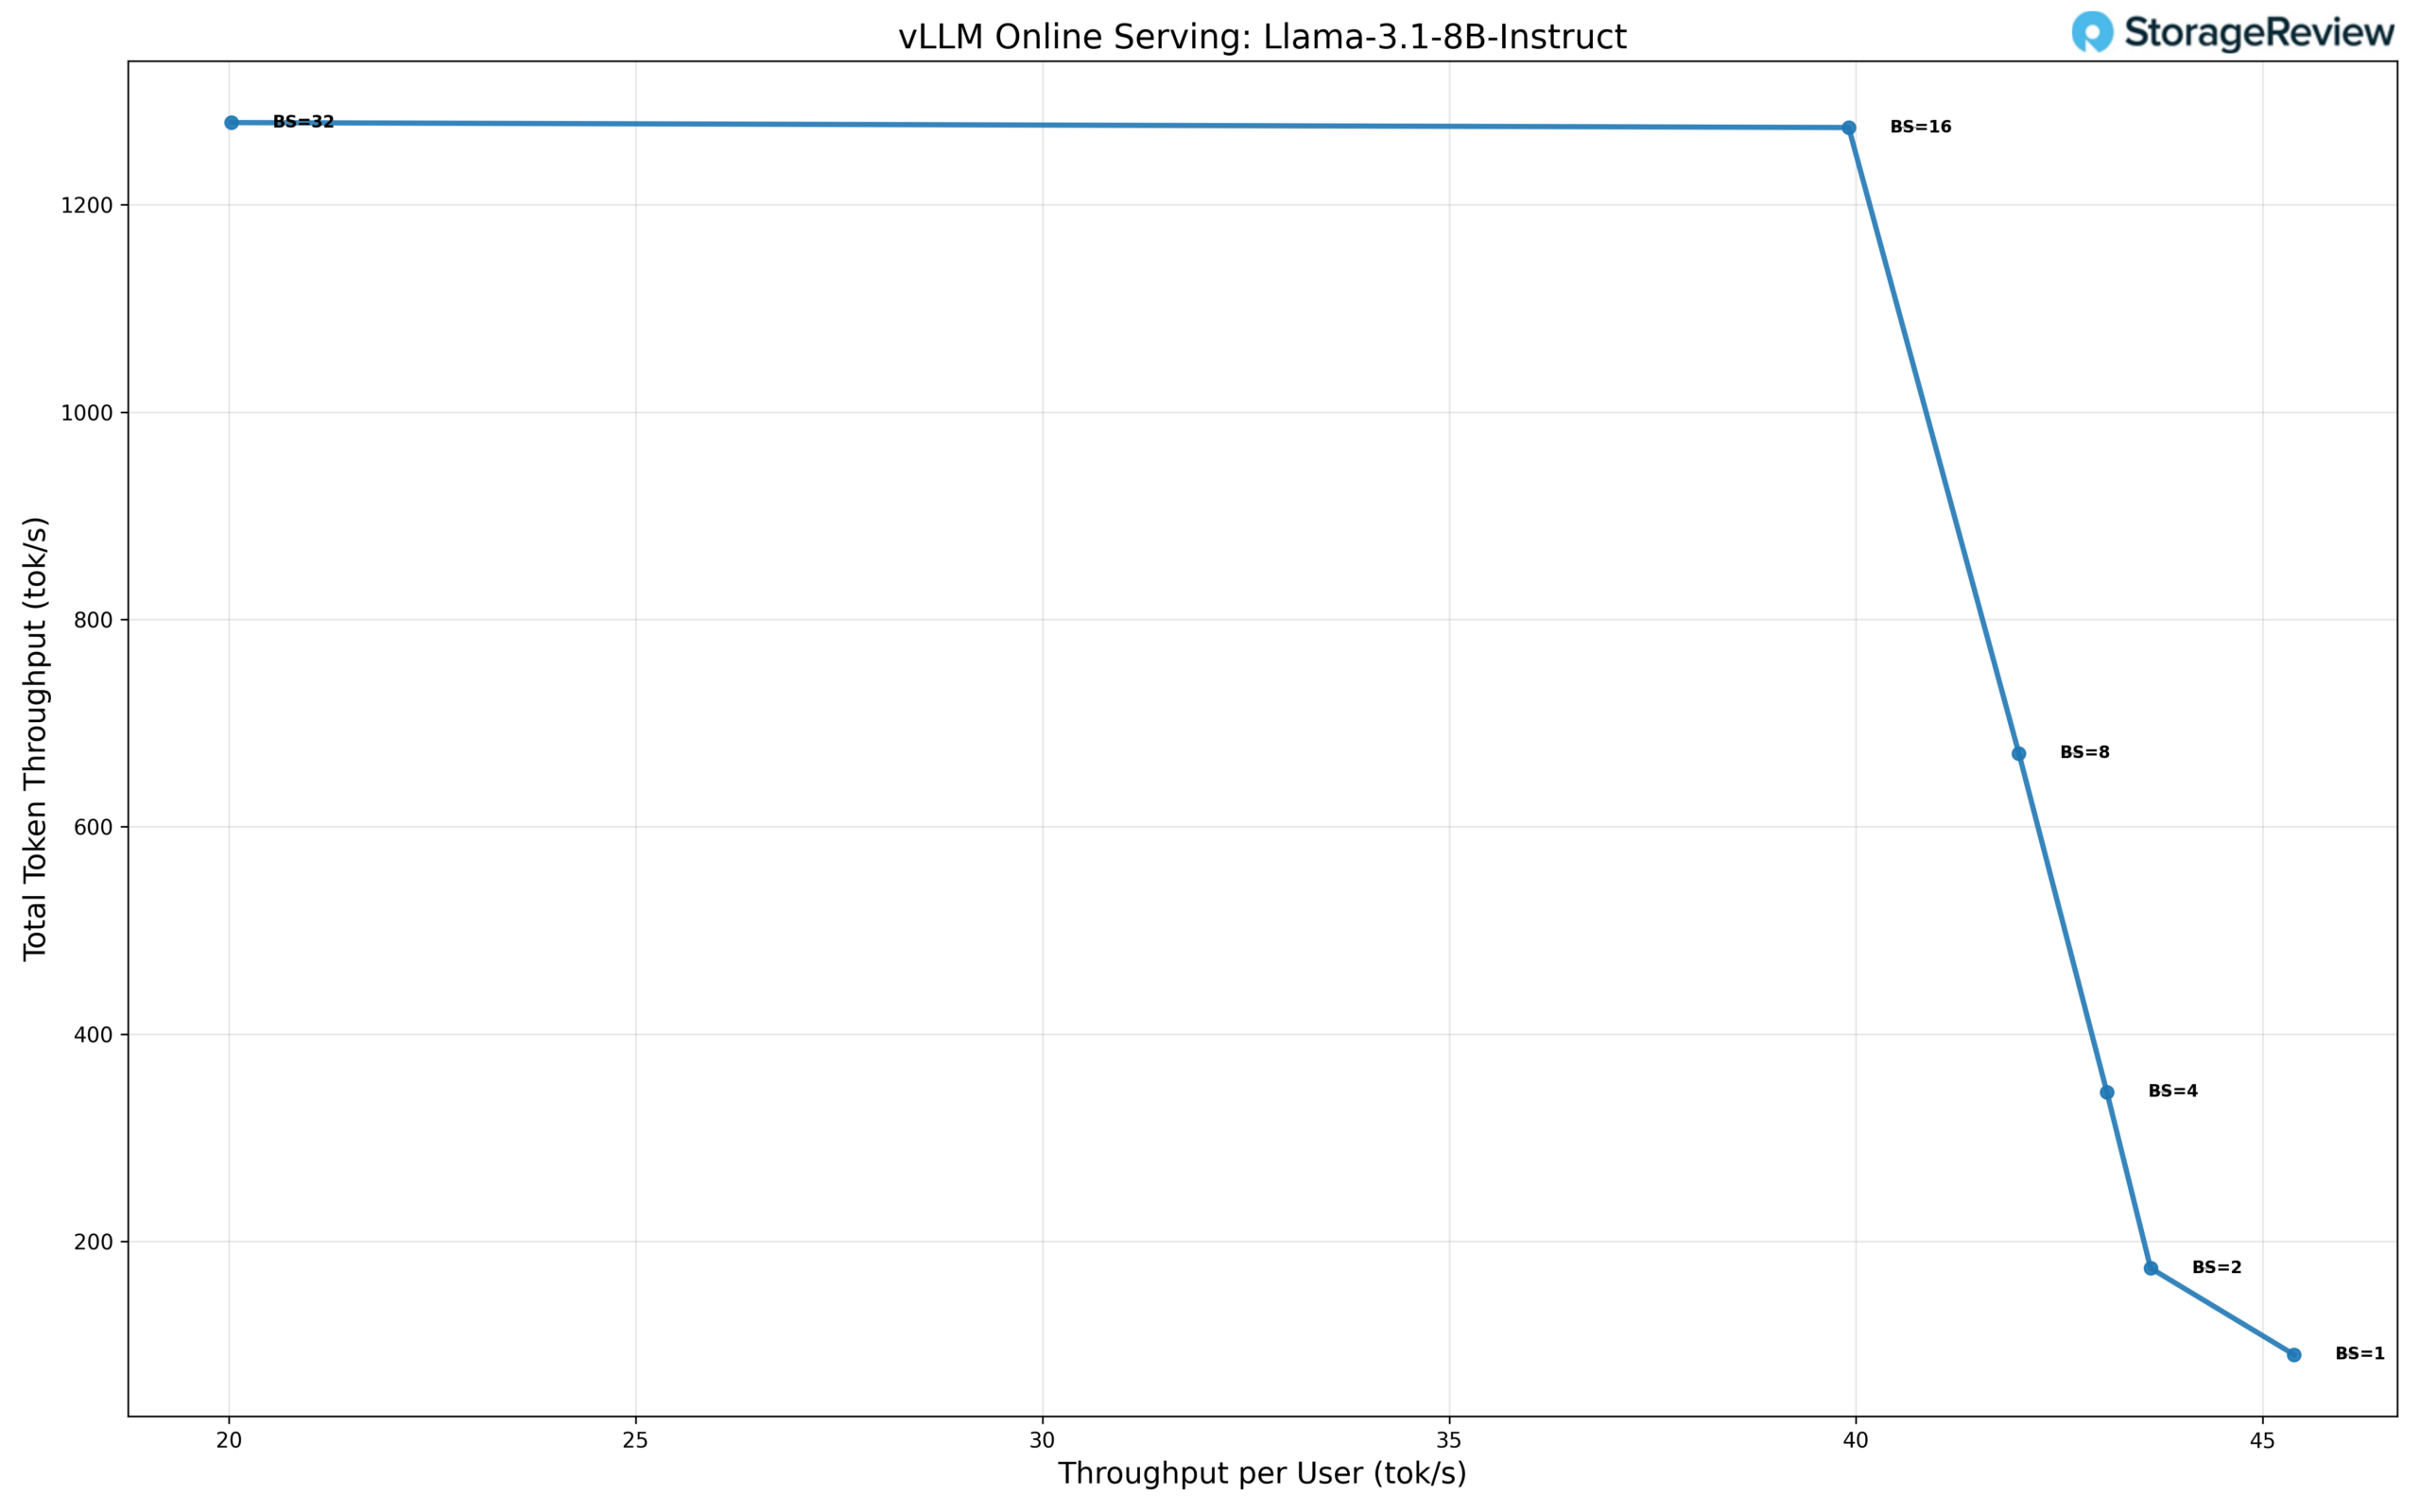
Vid standardprecision uppvisar Llama 3.1 8B-modellen förutsägbart skalningsbeteende vid lägre samtidighetsnivåer, med stark prestanda per användare vid små batchstorlekar och stadigt ökande aggregerad dataflöde allt eftersom samtidigheten ökar. Vid drift med en användare (BS=1) levererar modellen cirka 45.8 tok/s per användare, vilket ger ett totalt dataflöde på 91.6 tok/s och etablerar en solid baslinje för latenskänsliga arbetsbelastningar.
Allt eftersom samtidigheten ökar skalas det totala dataflödet effektivt medan dataflödet per användare minskar gradvis. Vid BS=2 ökar det totala dataflödet till 176 tok/s, med 44.0 tok/s per användare, och vid BS=4 når dataflödet 344 tok/s, med 43.0 tok/s per användare. Detta beteende fortsätter till BS=8, där modellen bibehåller ett totalt dataflöde på 672 tok/s, med 42.0 tok/s per användare, vilket indikerar god användning utan betydande försämring per användare.
Skalningen fortsätter till BS=16, där den totala dataflödet når sin topp på cirka 1 280 tok/s, med 40.0 tok/s per användare. Vid BS=32 förblir den totala dataflödet i praktiken oförändrat runt 1 280 tok/s, medan dataflödet per användare sjunker till 20.0 tok/s, vilket signalerar mättnad i exekveringspipelinen. Denna platå tyder på att modellen, vid standardprecision, når sin optimala driftspunkt runt BS=16, vilket balanserar dataflöde och responsivitet.
Sammantaget uppnår standardprecision en ökning på ungefär 14 gånger i total dataflöde från BS=1 till sin topp, med stabil prestanda per användare genom måttliga samtidighetsnivåer. Denna profil gör standardprecision väl lämpad för distributioner som prioriterar konsekvent latens och förutsägbar skalning framför aggressiv batchutökning.
Sparsam modellprestanda
Glesa modeller, särskilt arkitekturer med blandade experter (MoE), är en framväxande metod för att effektivt skala språkmodeller. Dessa arkitekturer upprätthåller ett högt totalt antal parametrar samtidigt som de bara aktiverar en delmängd av parametrar per token, vilket potentiellt erbjuder förbättrad prestanda per aktiv parameter.
Qwen3-Coder-30B-A3B FP8-prestanda
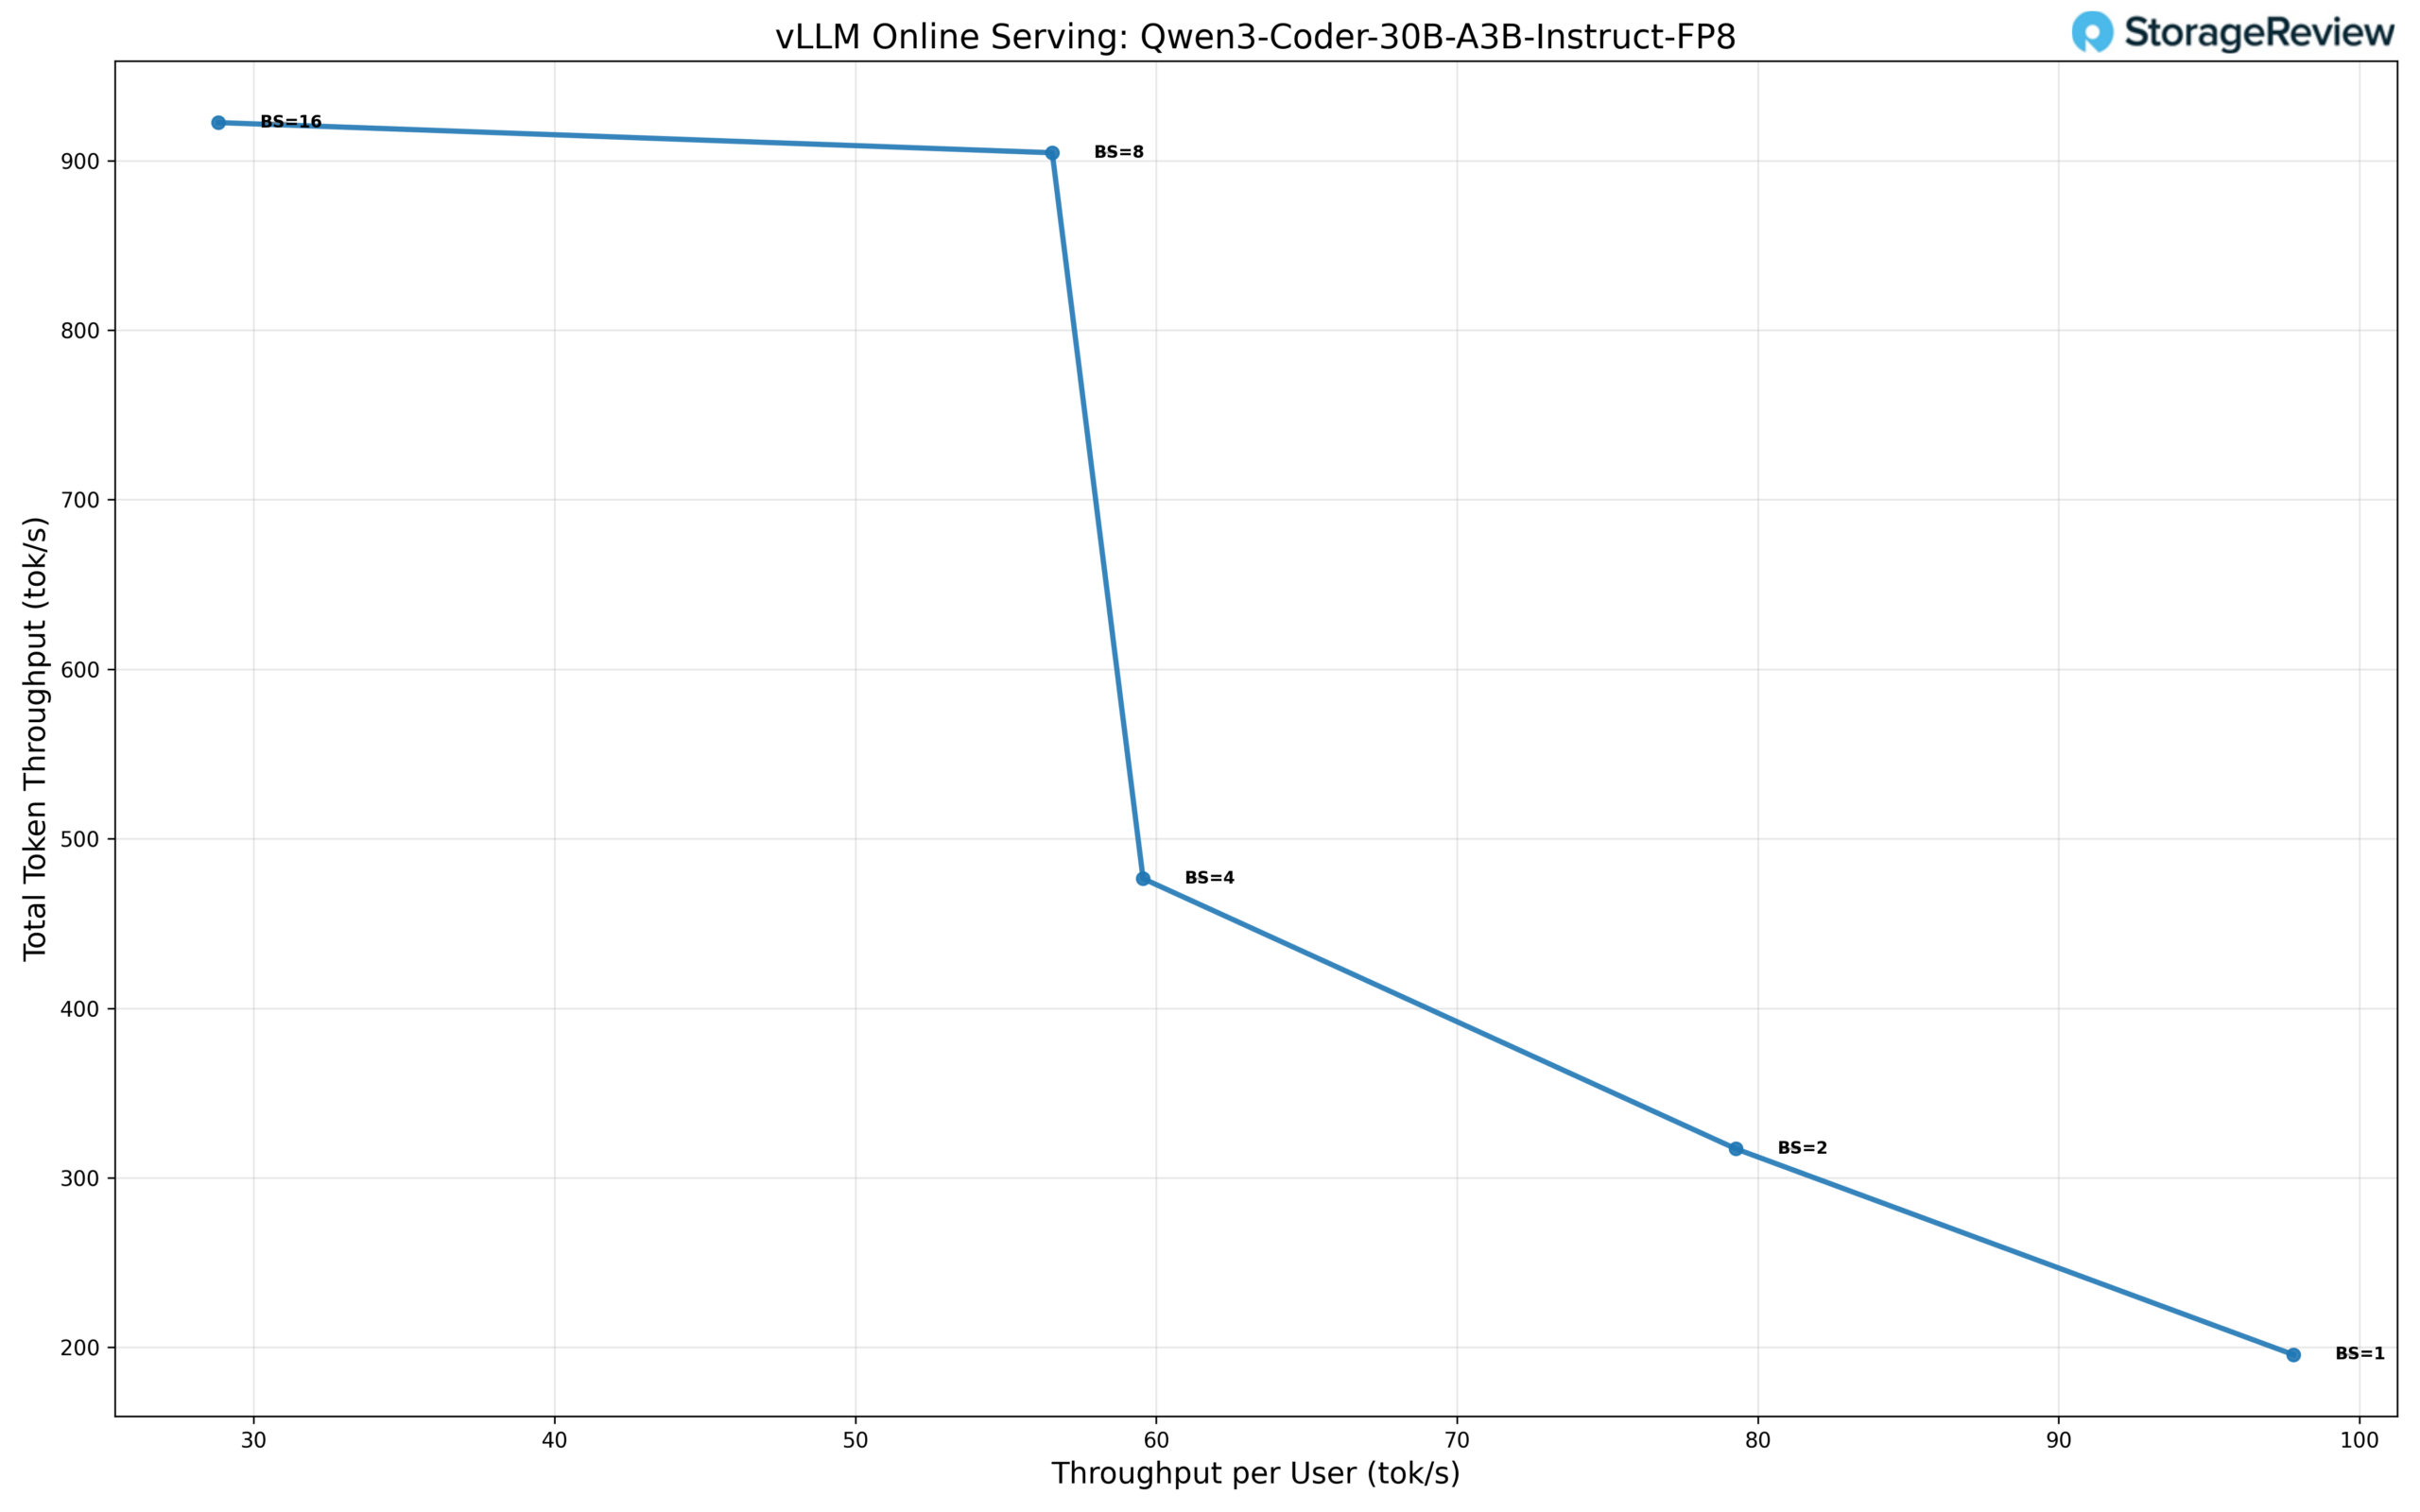
Qwen3-Coder-30B-A3B-modellen som körs i FP8-precision uppvisar en skalningsprofil som är optimerad för måttlig samtidighet, vilket ger stark prestanda per användare samtidigt som mättnad når tidigare än mindre modeller. Vid drift med en användare (BS=1) uppnår modellen cirka 98 tok/s per användare, med en total dataflöde på 196 tok/s, vilket etablerar en hög baslinje för en enda ström som återspeglar modellens optimering för kodgenereringsarbetsbelastningar.
Allt eftersom samtidigheten ökar skalas den totala dataflödet effektivt medan dataflödet per användare minskar på ett kontrollerat sätt. Vid BS=2 ökar den totala dataflödet till 317 tok/s, med 79 tok/s per användare, och vid BS=4 levererar modellen en total dataflödeshastighet på 477 tok/s vid 59 tok/s per användare. Dessa resultat visar effektivt utnyttjande av tillgängliga beräkningsresurser genom låg till måttlig batchning, utan abrupt försämring av svarstiden per användare.
Modellen når sin maximala aggregerade dataflödeshastighet vid BS=8, med en total dataflödeshastighet på cirka 905 tok/s, med 56 tok/s per användare. Skalning fortsätter marginellt fram till BS=16, där den totala dataflödeshastigheten ökar något till 920 tok/s, medan dataflödet per användare sjunker till 29 tok/s, vilket indikerar mättnad av inferenspipelinen. Utöver denna punkt ger ytterligare samtidighet minimala vinster i total dataflödeshastighet samtidigt som det påverkar prestandan per användare avsevärt.
Sammantaget levererar Qwen3-Coder-30B-A3B FP8 en ökning på ungefär 4.7 gånger i total dataflöde från BS=1 till sin topp vid BS=16. Latens- och dataflödesegenskaper tyder på att denna konfiguration är bäst lämpad för måttliga arbetsbelastningar med flera användare som kräver hög prestanda per begäran. Extrem batchskalning är dock inte det primära målet.
Mikroskalningsdatatypprestanda
Mikroskalning representerar en avancerad kvantiseringsmetod som tillämpar finkorniga skalningsfaktorer på små viktblock snarare än enhetlig kvantisering över stora parametergrupper. NVIDIAs NVFP4-format implementerar denna teknik genom en blockerad flyttalrepresentation där varje mikroskaleblock med 8–32 värden delar en typisk exponent som skalningsfaktor. Denna granulära metod bevarar numerisk precision samtidigt som 4-bitarsrepresentation uppnås, vilket bibehåller det dynamiska omfång som är avgörande för transformatorarkitekturer. Formatet integreras med NVIDIAs Tensor Core-arkitektur, vilket möjliggör effektiv blandad precisionsberäkning med dekompression under matrisoperationer.
GPT-OSS-20b-prestanda
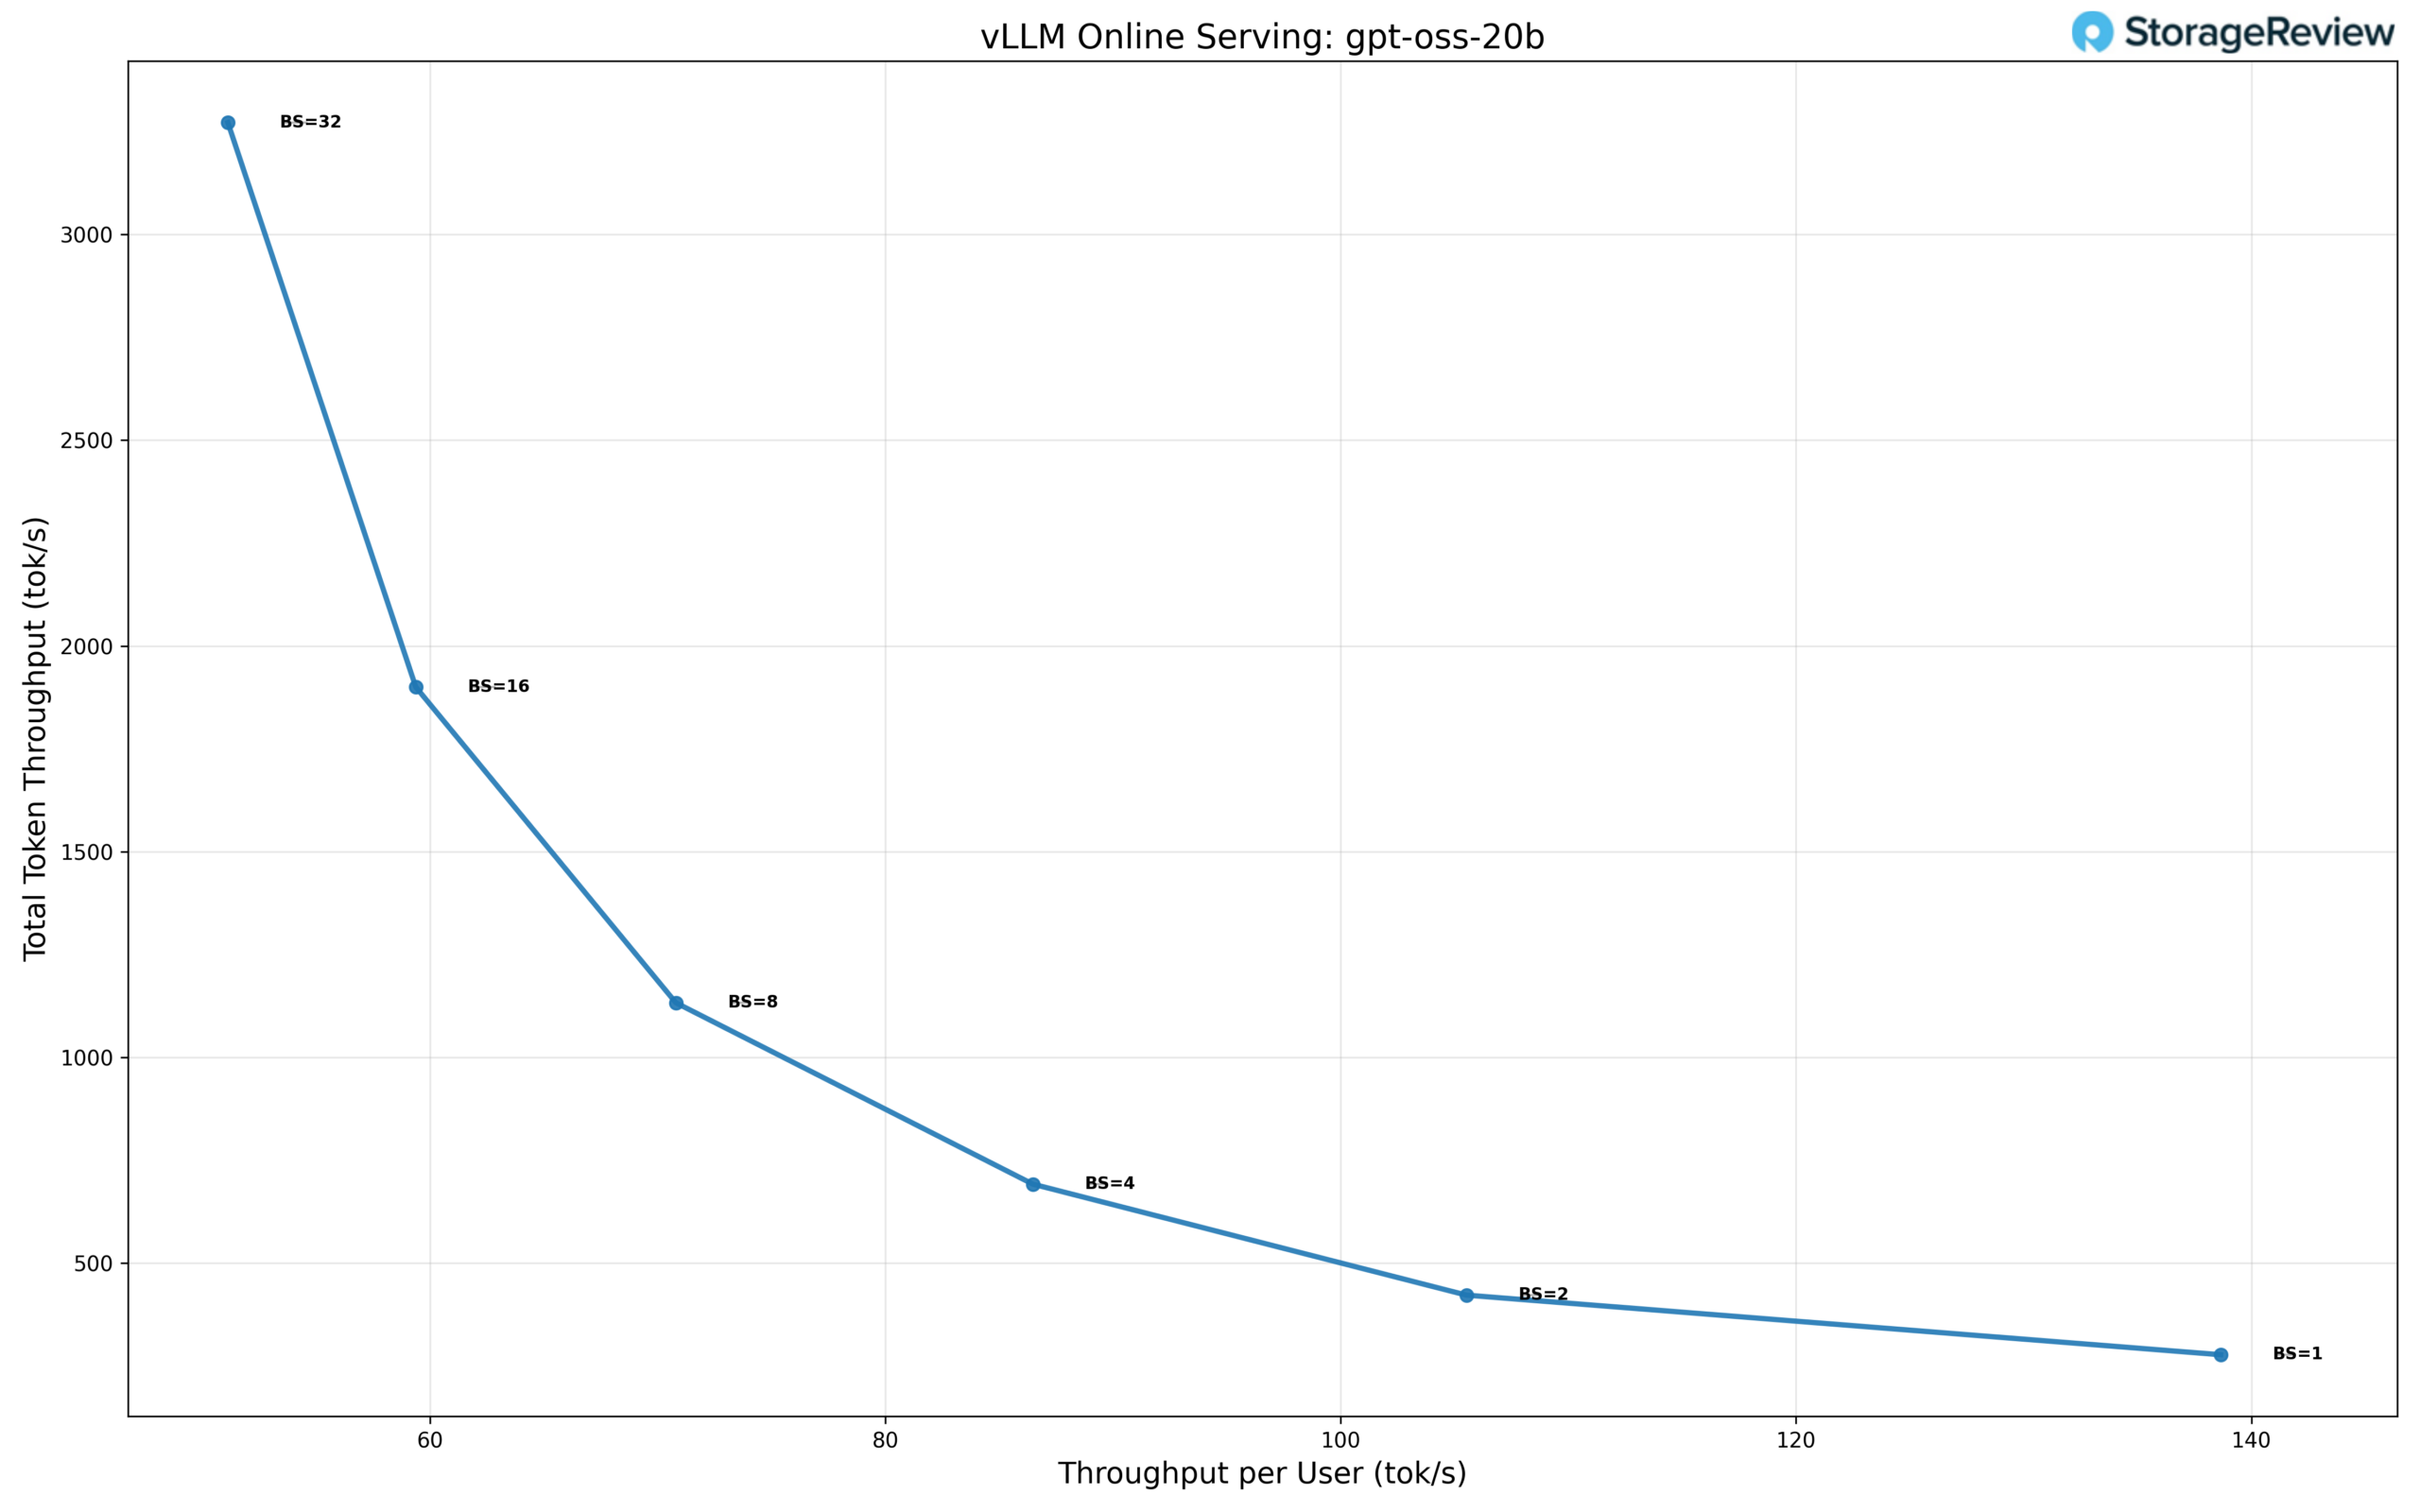
Modellen gpt-oss-20b uppvisar starka skalningsegenskaper över ökande samtidighetsnivåer, med särskilt hög aggregerad dataflödeshastighet vid större batchstorlekar. Vid samtidighet med en enda användare (BS=1) levererar modellen cirka 138 tok/s per användare, vilket resulterar i en total dataflödeshastighet på 276 tok/s, vilket etablerar en stark baslinje för inferens från en enda ström.
Allt eftersom samtidigheten ökar skalas det totala dataflödet aggressivt medan dataflödet per användare minskar som förväntat. Vid BS=2 ökar det totala dataflödet till 420 tok/s, med 105 tok/s per användare, och vid BS=4 når dataflödet totalt 690 tok/s, med 86 tok/s per användare. Denna stadiga utveckling indikerar effektivt utnyttjande av tillgängliga beräkningsresurser genom låg till måttlig batchning.
Skalningen fortsätter till BS=8, där modellen uppnår en total dataflödeshastighet på cirka 1 120 tok/s vid 70 tok/s per användare, och BS=16, där den totala dataflödeshastigheten ökar till 1 900 tok/s, med 60 tok/s per användare. Dessa resultat visar att gpt-oss-20b bibehåller relativt hög prestanda per användare även när samtidigheten ökar, vilket gör den väl lämpad för scenarier med flera användare.
Modellen når sin maximala aggregerade dataflödeshastighet vid BS=32, och levererar ett totalt dataflöde på cirka 3 250 tok/s, med ett dataflöde per användare som sjunker till 50 tok/s. Detta representerar en ökning med 11.8 gånger i totalt dataflöde jämfört med prestanda för en enda användare. Medan dataflödet per användare fortsätter att minska vid högre batchstorlekar, förblir den totala skalningseffektiviteten stark, vilket indikerar att modellen drar nytta av högre samtidighet utan att stöta på en tidig mättnadspunkt.
Sammantaget uppvisar gpt-oss-20b en balanserad skalningsprofil som kombinerar hög prestanda för en enda användare med stark batchskalning. Detta gör det till ett övertygande alternativ för distributioner som behöver både responsiv individuell inferens och hög aggregerad dataflöde under tyngre belastning av flera användare.
Phoronix-riktmärken
Phoronix Test Suite är en automatiserad benchmarkingplattform med öppen källkod som stöder över 450 testprofiler och 100+ testsviter via OpenBenchmarking.org. Den hanterar allt från att installera beroenden till att köra tester och samla in resultat, vilket gör den idealisk för prestandajämförelser, hårdvaruvalidering och kontinuerlig integration.
Bandbredd för strömminne
SR650 V4 levererade 369.6 GB/s minnesbandbredd, vilket visar på stark dataöverföringshastighet för dataintensiva arbetsbelastningar och bekräftar god prestanda för flerkanaligt minne.
7-zip-komprimering
Med 584 499 MIPS uppvisade systemet utmärkta komprimerings- och dekomprimeringsprestanda, vilket återspeglar solid flerkärnig effektivitet och stark heltalskapacitet.
Kärnkompilera
Servern slutförde allmod-kärnbygget på 256.175 sekunder, ett respektabelt resultat som belyser dess förmåga att hantera parallell kompilering och utvecklararbetsflöden effektivt.
Apache Web Server
Med 61 654 R/s uppvisade SR650 V4 stark webbserverprestanda och upprätthöll en hög förfrågningshastighet lämplig för frontend-hosting eller lätta virtualiseringsstackar.
OpenSSL-verifiering
Med en hastighet av 712.6 miljarder byte per sekund uppvisade plattformen robust kryptografisk verifieringsprestanda, vilket bekräftade processorns kapacitet för säkra, certifikattunga operationer.
| Phoronix-riktmärken | Lenovo ThinkSystem SR650 V4 |
|---|---|
| Stream | 369,58.3 MB / s |
| 7-ZIP | 584,499 MIPS |
| Kärnkompilera (allmod) | 256.175 sekunder |
| Apache (förfrågningar per sekund) | 61,654.47 XNUMX kr/s |
| Öppna SSL | 712 633 776 990 byte/s |
Slutsats
ThinkSystem SR650 V4 är den typ av plattformsuppdatering som är viktig eftersom det inte bara är ett CPU-byte. Lenovo använde den här generationen för att driva meningsfulla förbättringar inom de områden som begränsar verkliga implementeringar: minnesbandbredd, tillgänglighet av PCIe-banor, lagringstäthet och möjligheten att anpassa konfigurationen när behoven förändras. Övergången till Intel Xeon 6 ger fler kärnalternativ och mer I/O-utrymme per sockel, och det omgivande plattformsarbetet, inklusive snabbare DDR5 med MRDIMM-stöd och valfri CXL-expansion, ger SR650 V4 en väg att förbli relevant när arbetsbelastningar blir mer minneskrävande.
På lagringssidan, trots vår begränsade granskningskonfiguration med U.2, erbjuder Lenovos satsning mot E3.S högre NVMe-densitet med 1:1-anslutning och renare termiska egenskaper, vilket ligger i linje med hur modern infrastruktur byggs, särskilt för virtualiseringsstackar som vill ha mer lokal flash, och för AI-anslutna pipelines där matning av GPU:er är lika viktigt som rå beräkning. De dubbla OCP 3.0 Gen5 x16-kortplatserna är också en praktisk uppgradering: du kan driftsätta seriösa nätverk utan att offra PCIe-kortplatser som du hellre reserverar för acceleratorer, lagring eller specialadaptrar.
Om du använder SR650 V3 och känner dig begränsad av minneshastighet, PCIe-utrymme eller NVMe-densitet, är SR650 V4 ett övertygande steg framåt. Den bevarar den servicevänlighet och konfigurerbarhet som gjorde SR650-serien populär, samtidigt som den lägger till den typ av plattformsbana som hjälper IT-team att undvika att måla in sig i ett hörn. Oavsett om du bygger ett virtualiseringskluster, moderniserar skalbara tjänster eller sätter ihop en balanserad CPU/GPU-nod, uppfyller SR650 V4 de krav som ställs och lämnar utrymme för vad som kommer härnäst.


 Amazon