

NVIDIA RTX PRO 4500 Blackwell Server Edition är kortet som NVIDIA byggt för de servrar som de flesta företag redan äger. Det är ett 165W-kort med en enda plats, passivt kylt, 32 GB GDDR7 och hela Blackwell-funktionsuppsättningen: femte generationens Tensor-kärnor med FP4, fjärde generationens RT-kärnor, tre kodare och tre avkodare, samt stöd för Multi-Instance GPU som kan dela upp det i två isolerade 16 GB-partitioner. Det ersätter L4 som ingångspunkt till NVIDIAs RTX PRO-servrar och passar i en 2U PowerEdge, ProLiant eller ThinkSystem utan problem med strömförsörjning eller kylning.

NVIDIAs förslag på kortet är rätt storlek: de flesta företag bygger inte AI-fabriker; de driver luftkylda datacenter i tidigare fas med hårda begränsningar av rackkapacitet, och de behöver ett första accelererat beräkningssteg som inte kräver en ny serverklass. Eller så arbetar de vid kanten, där RTX PRO 4500 är bättre anpassat till de arbetsbelastningar och strömbegränsningar som vanligtvis avgör vad som kan driftsättas.
RTX PRO 6000 Blackwell täcker toppen av den marknaden med 96 GB och upp till 600 W. 4500 behåller samma arkitektur och halverar allt annat ungefär, så kunder med mindre modeller, många mindre uppgifter eller en budget per dollar per watt för utskalning får Blackwell utan att betala för headroom de inte kommer att använda.
Arbetsbelastningarna för denna klass av GPU är väl förstådda: inferens för små språkmodeller, vision AI och videoanalys, generering av vektorsökning och inbäddning, transkodning och virtuella arbetsstationer under vGPU 20. Den hävdar att den är över 5 gånger snabbare än L4 för inferens för små och medelstora modeller och upp till 10 gånger snabbare på Nemotron-modeller, och dess lanseringspartners omfattar NTT DATA för edge-video, Pacific Biosciences för sekvensering och Nokia för AI-RAN-basstationer. AWS byggde sina nya G7-instanser på den som en ersättning för G6.
Vi har redan testat kortet mot L4-kortet i en HPE ProLiant DL145 Gen11 i vår RTX PRO 4500 edge-recension , där det levererade 2.7 gånger L4:ans dataflöde. Den här recensionen svarar på hur nära det kommer 350W, dubbla L40S-kortet med dubbla kortplatser som har varit standardkortet för vanliga processorer i två år, och vad RTX PRO 6000 ovanför det tillför i extra minne och kraft.
För att ta reda på det satte vi 4500 i en Dell PowerEdge R770 mot en L40S och L4, lade till RTX PRO 6000 Blackwell-data från vår Dell Pro Max Tower T2 med både standardeffekten 600W och en kapacitet på 450W som matchar vad R770 tillåter en GPU-plats, och körde vLLM online-server över fyra modeller med två kontextlängder.
Som en kort förhandsvisning, vid typiska chatt- och agentkontextlängder håller 4500 jämna steg med L40S på FP8- och BF16-modellerna med mindre än hälften så mycket effekt; vid 8K-ingång visar 32 GB bildbuffert sina begränsningar; och NVFP4, precisionen som NVIDIA leder deras Blackwell-presentation med, presterar i linje med resten av sortimentet på denna vLLM-bygge.
Key Takeaways
- L40S-dataflöde vid 165 W i en kortplats: Vid 512 token input och output matchade eller överträffade 4500 L40S på alla FP8- och BF16-modeller vi körde, 1 107 vs. 995 tokens/s på Ministral 3 14B FP8 och 2 006 vs. 1 988 på Ministral 3 3B, från ett kort klassat för 47 procent av L40S:s kraft och hälften av dess kortplatser.
- Ungefär 3 gånger så stor som L4:an den ersätter: 2.8x till 3.6x L4:ans utgångsflöde vid kort kontext, vid 2.3x L4:ans moderkortseffekt.
- 32 GB har ett tak: Vid 8K-indata låg 4500 efter L40S med 17 till 33 procent och dess kurvor planade ut vid samtidighetsnivå 8 där L40S fortsatte att klättra till 16. Utplattningen beror på att KV-cachen tar slut, och 32 GB sätter den gränsen.
- NVFP4 är en mjukvaruhistoria, på varje kort: På Qwen3.8-27B NVFP4 producerade 4500 320 tokens/s vid samtidighet 32, L40S 480 utan FP4-hårdvara alls, och RTX PRO 6000 621. NVFP4-sökvägen i denna vLLM-bygge skalar inte med minnesbandbredd på någon av dem, medan MAMF-svepet visar att 4500:ans FP4-hårdvara når 568.6 TFLOPS mot 280.1 i FP8.
- Vad det större kortet ger dig: Med en gräns på 450W, den maximala effekten en Dell R770 GPU-plats tillåter, körde RTX PRO 6000 ungefär dubbelt så mycket som 4500 vid korta intervall och 2.5x till 3.2x vid 8K. Dess fulla effekt på 600W gav 1 till 2 procent vid korta intervall och 4 till 9 procent vid långa intervall utöver det, så det mesta av vad 6000 levererar jämfört med 4500 är minne.
NVIDIA RTX PRO 4500 Blackwell Server Edition Specifikationer
Två kort bär namnet RTX PRO 4500 Blackwell, och de är liknande men inte samma produkt. Workstation Edition, som tillkännagavs på GTC 2025, är ett 200W, aktivt kylt kort med dubbla kortplatser, fyra DisplayPort-utgångar och 896 GB/s minnesbandbredd. Server Edition som vi recenserar här anlände på GTC 2026 som ett 165W, passivt, headless-kort med en enda kortplats med 800 GB/s, och det byter ut skärmutgångarna och en del klockutrymme mot datacenterfunktioner: MIG, konfidentiell databehandling, en tredje NVENC och NVDEC, och vGPU 20-stöd. Underst har de samma 10 496-kärniga GPU och 32 GB GDDR7 med ECC.
NVIDIAs data visar att kretsarna har 45.6 miljarder transistorer på 378 mm² av TSMC 4nm specialkisel med 82 fjärde generationens RT-kärnor, vilket motsvarar 82 SM och 328 Tensor-kärnor. Det är GB203-siffror, samma kretsfamilj som RTX 5080, lätt nedtonade. Tensor-siffrorna nedan är NVIDIAs toppar med gleshet; densitet är hälften, vilket NVIDIAs egen peakTOPS-binär bekräftar vid 805 TFLOPS FP8 och 403 TFLOPS FP16 mätt på detta kort.
| Specifikation | RTX PRO 4500 Blackwell SE | L4 | L40S | RTX PRO 6000 Blackwell SE |
|---|---|---|---|---|
| Plattformöversikt | ||||
| arkitektur | NVIDIA Blackwell | NVIDIA Ada Lovelace | NVIDIA Ada Lovelace | NVIDIA Blackwell |
| CUDA Cores | 10,496 | 7,424 | 18,176 | 24,064 |
| RT Cores | 82 (4:e generationen) | 58 (3:e generationen) | 142 (3:e generationen) | 188 (4:e generationen) |
| GPU-minne | 32GB GDDR7 med ECC | 24GB GDDR6 | 48GB GDDR6 med ECC | 96GB GDDR7 med ECC |
| Minnesgränssnitt | 256-bitars | 192-bitars | 384-bitars | 512-bitars |
| minnesbandbredd | 800GB / s | 300GB / s | 864GB / s | 1,597GB / s |
| Prestanda (NVIDIA-toppvärden, Tensorhastigheter med gleshet) | ||||
| FP32 | 51 TFLOPS | 30.3 TFLOPS | 91.6 TFLOPS | 120 TFLOPS |
| FP16 / BF16 Tensor | 406 TFLOPS | 242 TFLOPS | 733 TFLOPS | 1 PFLOPS |
| FP8-tensor | 811 TFLOPS | 485 TFLOPS | 1,466 TFLOPS | 2 PFLOPS |
| FP4-tensor | 1.6 PFLOPS | Stöds inte | Stöds inte | 4 PFLOPS |
| RT Core Performance | 154 TFLOPS | Inte listad | 209 TFLOPS | 355 TFLOPS |
| Kraft och formfaktor | ||||
| Max korteffekt | 165W | 72W | 350W | Upp till 600W (konfigurerbar) |
| Formfaktor | Enkelspår, FHFL 4.4 "x 10.5" |
Enkelspår, HHHL | Dubbelkortplats, FHFL 4.4 "x 10.5" |
Dubbelfack, FHFL (luft) Enkelspår, FHXL (vätska) |
| Termisk | Passiv | Passiv | Passiv | Passiv (luft) eller vätska |
| Strömkontakt | 1x PCIe CEM5 16-stift | Spelautomatdriven | 1x 16-stift | 1x PCIe CEM5 16-stift |
| Interconnect | PCIe 5.0 x16 | PCIe 4.0 x16 | PCIe 4.0 x16 | PCIe 5.0 x16 |
| Vikt | 1,055g | Inte listad | Inte listad | Inte listad |
| Funktioner | ||||
| GPU för flera instanser | Upp till 2x 16 GB | Nej | Nej | Upp till 4x 24 GB |
| NVENC / NVDEC | 3x / 3x | 2x / 4x | 3x / 3x | 4x / 4x |
| Konfidentiell databehandling | Som stöds | Nej | Nej | Som stöds |
| vGPU-stöd | Ja (vGPU 20) | Ja | Ja | Ja |
Design och bygga
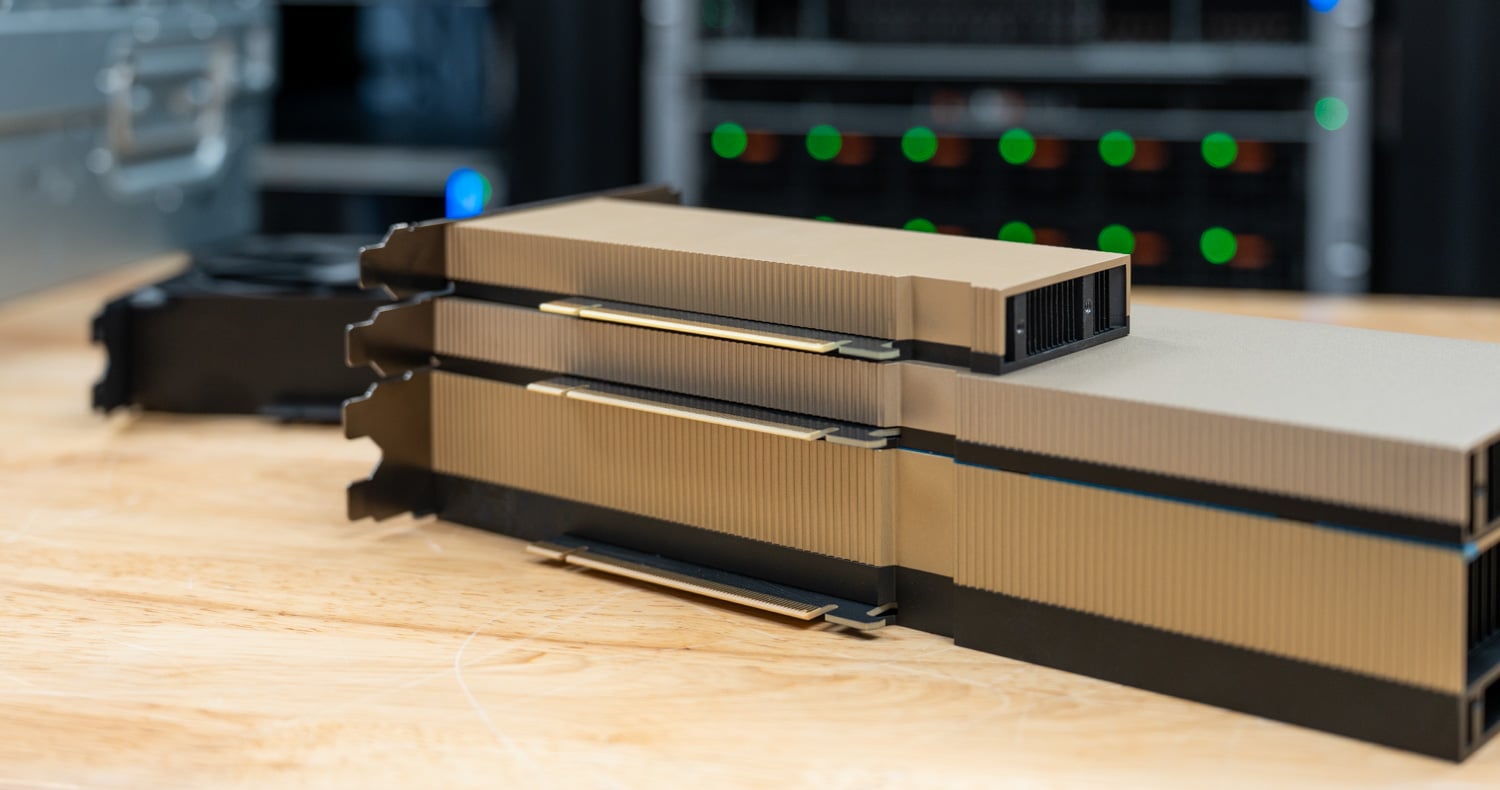
4500 Server Edition är ett moderkort i fullhöjd och full längd, 4.4 tum högt och 10.5 tum långt, och det fyller en enda plats. Det är en viktig förändring från L4, som var ett kort i halvhöjd och halv längd. L4 är fortfarande den jämförelsemodell den jämför med, men formfaktorn har flyttats till FHFL för att ge plats åt minnet, 16-pins strömingången och en kylfläns som kan avge 165 W enbart med chassiets luftflöde.

Den formfaktorn är det enda verkliga brytet från L4, som passade alla HHHL-kortplatser och drog sina 72W från kortplatsen, så den passade i 1U-servrar och små Edge-boxar. 4500 är fullhöjd, fulllängd och behöver 16-pinskabeln, och de 1U-mainstreamservrar vi arbetar med, bland annat Dells nuvarande 1U PowerEdge-linje, når som mest HHHL- eller FHHL-kort utan den kontakten.
I praktiken är detta ett 2U-kort, eller ett för de få whitebox 1U-chassin som är byggda kring FHFL-kortplatser, så en butik som köpte L4:or för 1U eller edge-boxar får ingen drop-in-ersättning.
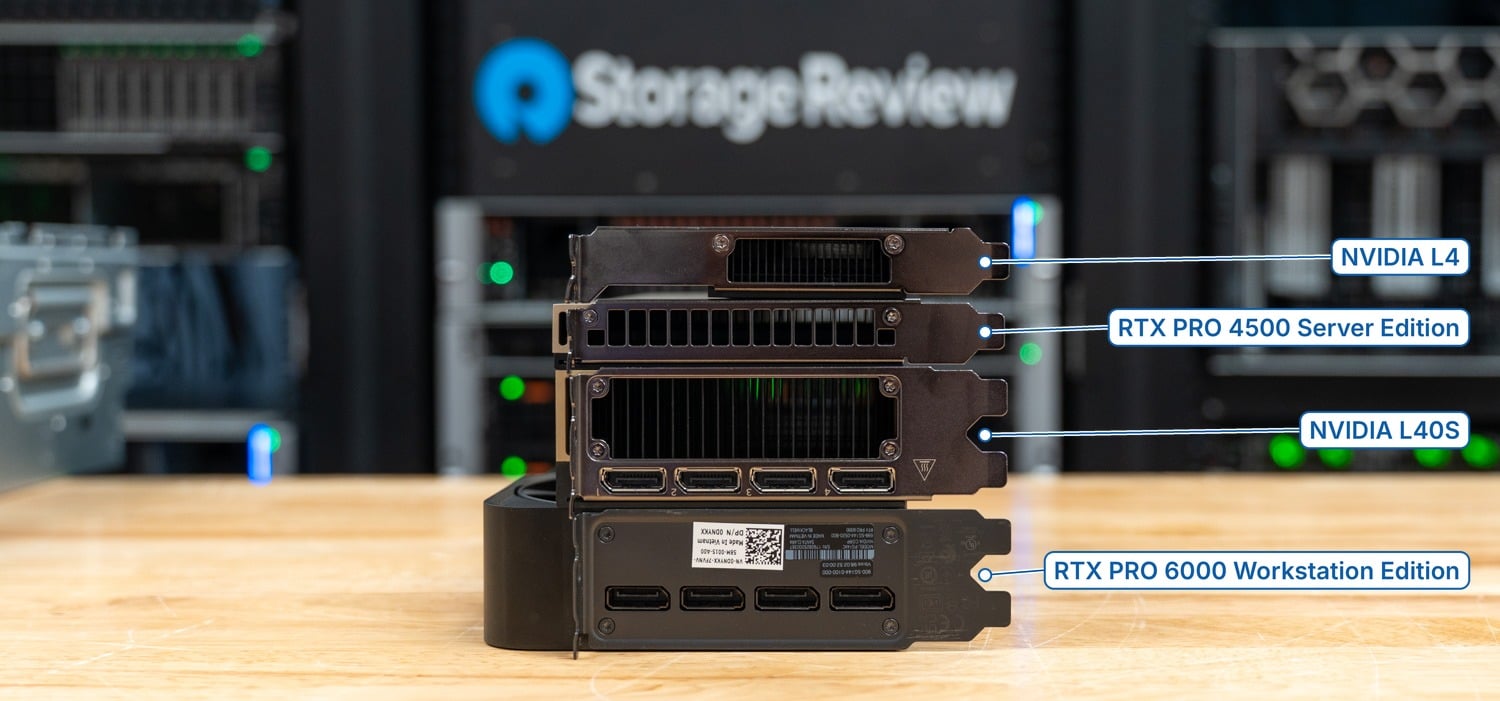
Staplad kant på kant med L4 ovanför och L40S nedanför, behöver 4500 en plats där L40S behöver två, vilket är anledningen till att en 2U-server som tar fyra kort med dubbel bredd kan ta åtta av dessa, och hur AWS G7-instanser kör upp till åtta av dem per värd.
Strömförsörjningen sker via en enda PCIe CEM5 16-pinskontakt, samma kontakt som RTX PRO 6000 använder, utan extra 8-pinsalternativ. Kylningen är helt passiv, så kortet är beroende av serverns fläktar och kommer att strypa i ett chassi som inte kan flytta luft genom det, vilket är normalt för klassen, och alla andra grafikkort har samma krav.
Kortet har inga skärmutgångar, så grafikarbetet, oavsett om det gäller virtuella vGPU-arbetsstationer eller rendering, går ut över nätverket, och fästet ventileras. De tre nionde generationens NVENC- och tre sjätte generationens NVDEC-motorer lägger till 4:2:2 H.264- och HEVC-kodning och -avkodning jämfört med L4:ans generation, och NVIDIA anger dubbelt så hög H.264-avkodningshastighet per NVDEC-motor jämfört med L4:an. Bilden på fästet nedan gör uppdelningen synlig: L4:an och 4500 har ventiler och inget annat, medan L40S och RTX PRO 6000 Workstation Edition har fyra DisplayPort-utgångar vardera.
Var RTX PRO 4500 Blackwell Server Edition passar in
NVIDIAs tolkning är att kortets ”centrala värde är kombinationen av AI, beräkning, grafik och videoacceleration i en 165 W, passiv design med en enda plats”, byggd för servrar ”där rackdensitet, strömförsörjning och kylning är primära begränsningar för distribution.” Det ligger i vad NVIDIA kallar det vanliga datacenter- och edge-segmentet av RTX PRO-serverportföljen, under RTX PRO 6000 Blackwell Server Edition och över ingenting; det är instegspunkten för Blackwell-serverlinjen.
Jämfört med L4-modellen anger NVIDIA upp till 10x förbättringar i små modeller med sina Nemotron Nano-modeller (NVFP4 på 4500 mot FP8 på L4), upp till 4x förbättringar i videosammanfattning med Cosmos Reason 2, 1.9x förbättringar i SPECviewperf 15 vid 4K och 1.8x strömningsdensitet. Jämfört med processorer anger de upp till 50x förbättringar i vektordatabasarbete med cuVS CAGR i Milvus och upp till 100x förbättringar i Vision AI, båda mätta på åttakorts 4500-servrar jämfört med EPYC 9654-system med dubbla socklar.
Dells serverteam berättade för oss att de ser 4500 i vanliga rack, eftersom tre 32 GB 4500-kort kostar nästan lika mycket som ett 96 GB 6000-kort, och då vinner oftast det större kortet. Detta är ett kort för en server som annars inte skulle ha någon GPU eller ett L4-kort, och passar inte optimalt för en server som var designad för att få en eller flera 6000-kort.
Testuppsättning
Vi installerade 4500, L40S och L4 i vår Dell PowerEdge R770, konfigurerad med två Intel Xeon 6787P-processorer (86 kärnor vardera) och 2 TB DDR5-6400 över 32 DIMM-minnen, med NVIDIA-drivrutinen 595.71.05. Testkörningarna använde NGC vLLM 26.08-py3-behållaren, som innehåller vLLM 0.27.1 på CUDA 13.4.1, så programvarustacken är identisk för alla kort. Varje kort testades individuellt vid sin standardströmgräns, och R770 anger varje korts fulla betyg: Dell listar L4 med 72 W, 4500 med 165 W och L40S med 350 W i det chassit.
RTX PRO 6000 Blackwell är arbetsstationskortet i vår Dell Pro Max Tower T2, med samma lagringsenhet och drivrutin. NVIDIA anger arbetsstations- och serverutgåvorna identiskt med 600W, och de profilerar samma i våra tester, så det ersätter serverkortet. För övrigt har vi en recension av RTX PRO 6000 Server- korten i ett XE7740 om du vill gräva i hur dessa kort kan skalas.
Vi körde 6000 två gånger: en gång med standardeffekten 600W och en gång med en verifierad effektgräns på 450W tillämpad via nvidia-smi, eftersom 450W är det mesta R770 kan leverera till ett 6000 i en GPU-plats, och det är den siffra en köpare som väljer mellan ett 4500 och ett 6000 för en typisk 2U-server bör jämföra sig med. Värdplattformen skiljer sig åt för 6000, men vid dessa GPU-bundna serverbelastningar påverkar CPU- och PCIe-topologin resultatet betydligt mindre än effektgränsen gör.
Vi använde vLLM:s benchmark för online-serving på samtidighetsnivåerna 1, 2, 4, 8, 16 och 32 med två förfrågningsformer: 512 indatatokens och 512 utdatatokens, vilket approximerar chatt och korta agentomgångar, och 8 192 indatatokens med 1 024 utdata, vilket approximerar RAG- och dokumentarbete där förfyllning dominerar och KV-cachefyllningar. Modellerna valdes för att passa det minsta kortet i gruppen där det var möjligt, så L4:ans 24 GB sätter golvet: Ministral 3 3B Reasoning och Ministral 3 8B Reasoning i BF16, Ministral 3 14B Instruct i FP8, och Qwen3.8-27B i NVFP4, vilket passar 32 GB-kort och uppåt men inte L4.
Vi rapporterar genomströmning för utdatatokens på varje samtidighetsnivå och anger totalt genomströmning, inklusive förfyllda tokens, där det förändrar bilden.
Vad som inte finns här: större modeller som endast korten på 48 GB och större kan hantera, MIG-partitionering, vGPU, videotranskodning, mätad strömförbrukning, konfigurationen med två kort i 4500-serien och datacenterkorten över denna klass.
Maximalt uppnåeliga Matmul FLOPS (MAMF)
MAMF är ett GEMM-test med hållbar densitet som rapporterar den bästa matmul-genomströmningen ett kort når vid varje precision, vilket gör det till det enklaste sättet att kontrollera om FP4-hårdvaran fungerar när serverstacken är ute ur bilden. 4500 nådde 135.9 TFLOPS i BF16, 280.1 i FP8 och 568.6 i NVFP4, där varje steg ner i precision nästan fördubblar genomströmningen. Jämfört med NVIDIAs densitetstoppar på 202, 406 och 811 TFLOPS, är det 67 % till 70 % av toppen vid varje precision, och det stämmer överens med NVIDIAs egna cuBLAS-siffror för kortet på 133, 275 och 534.
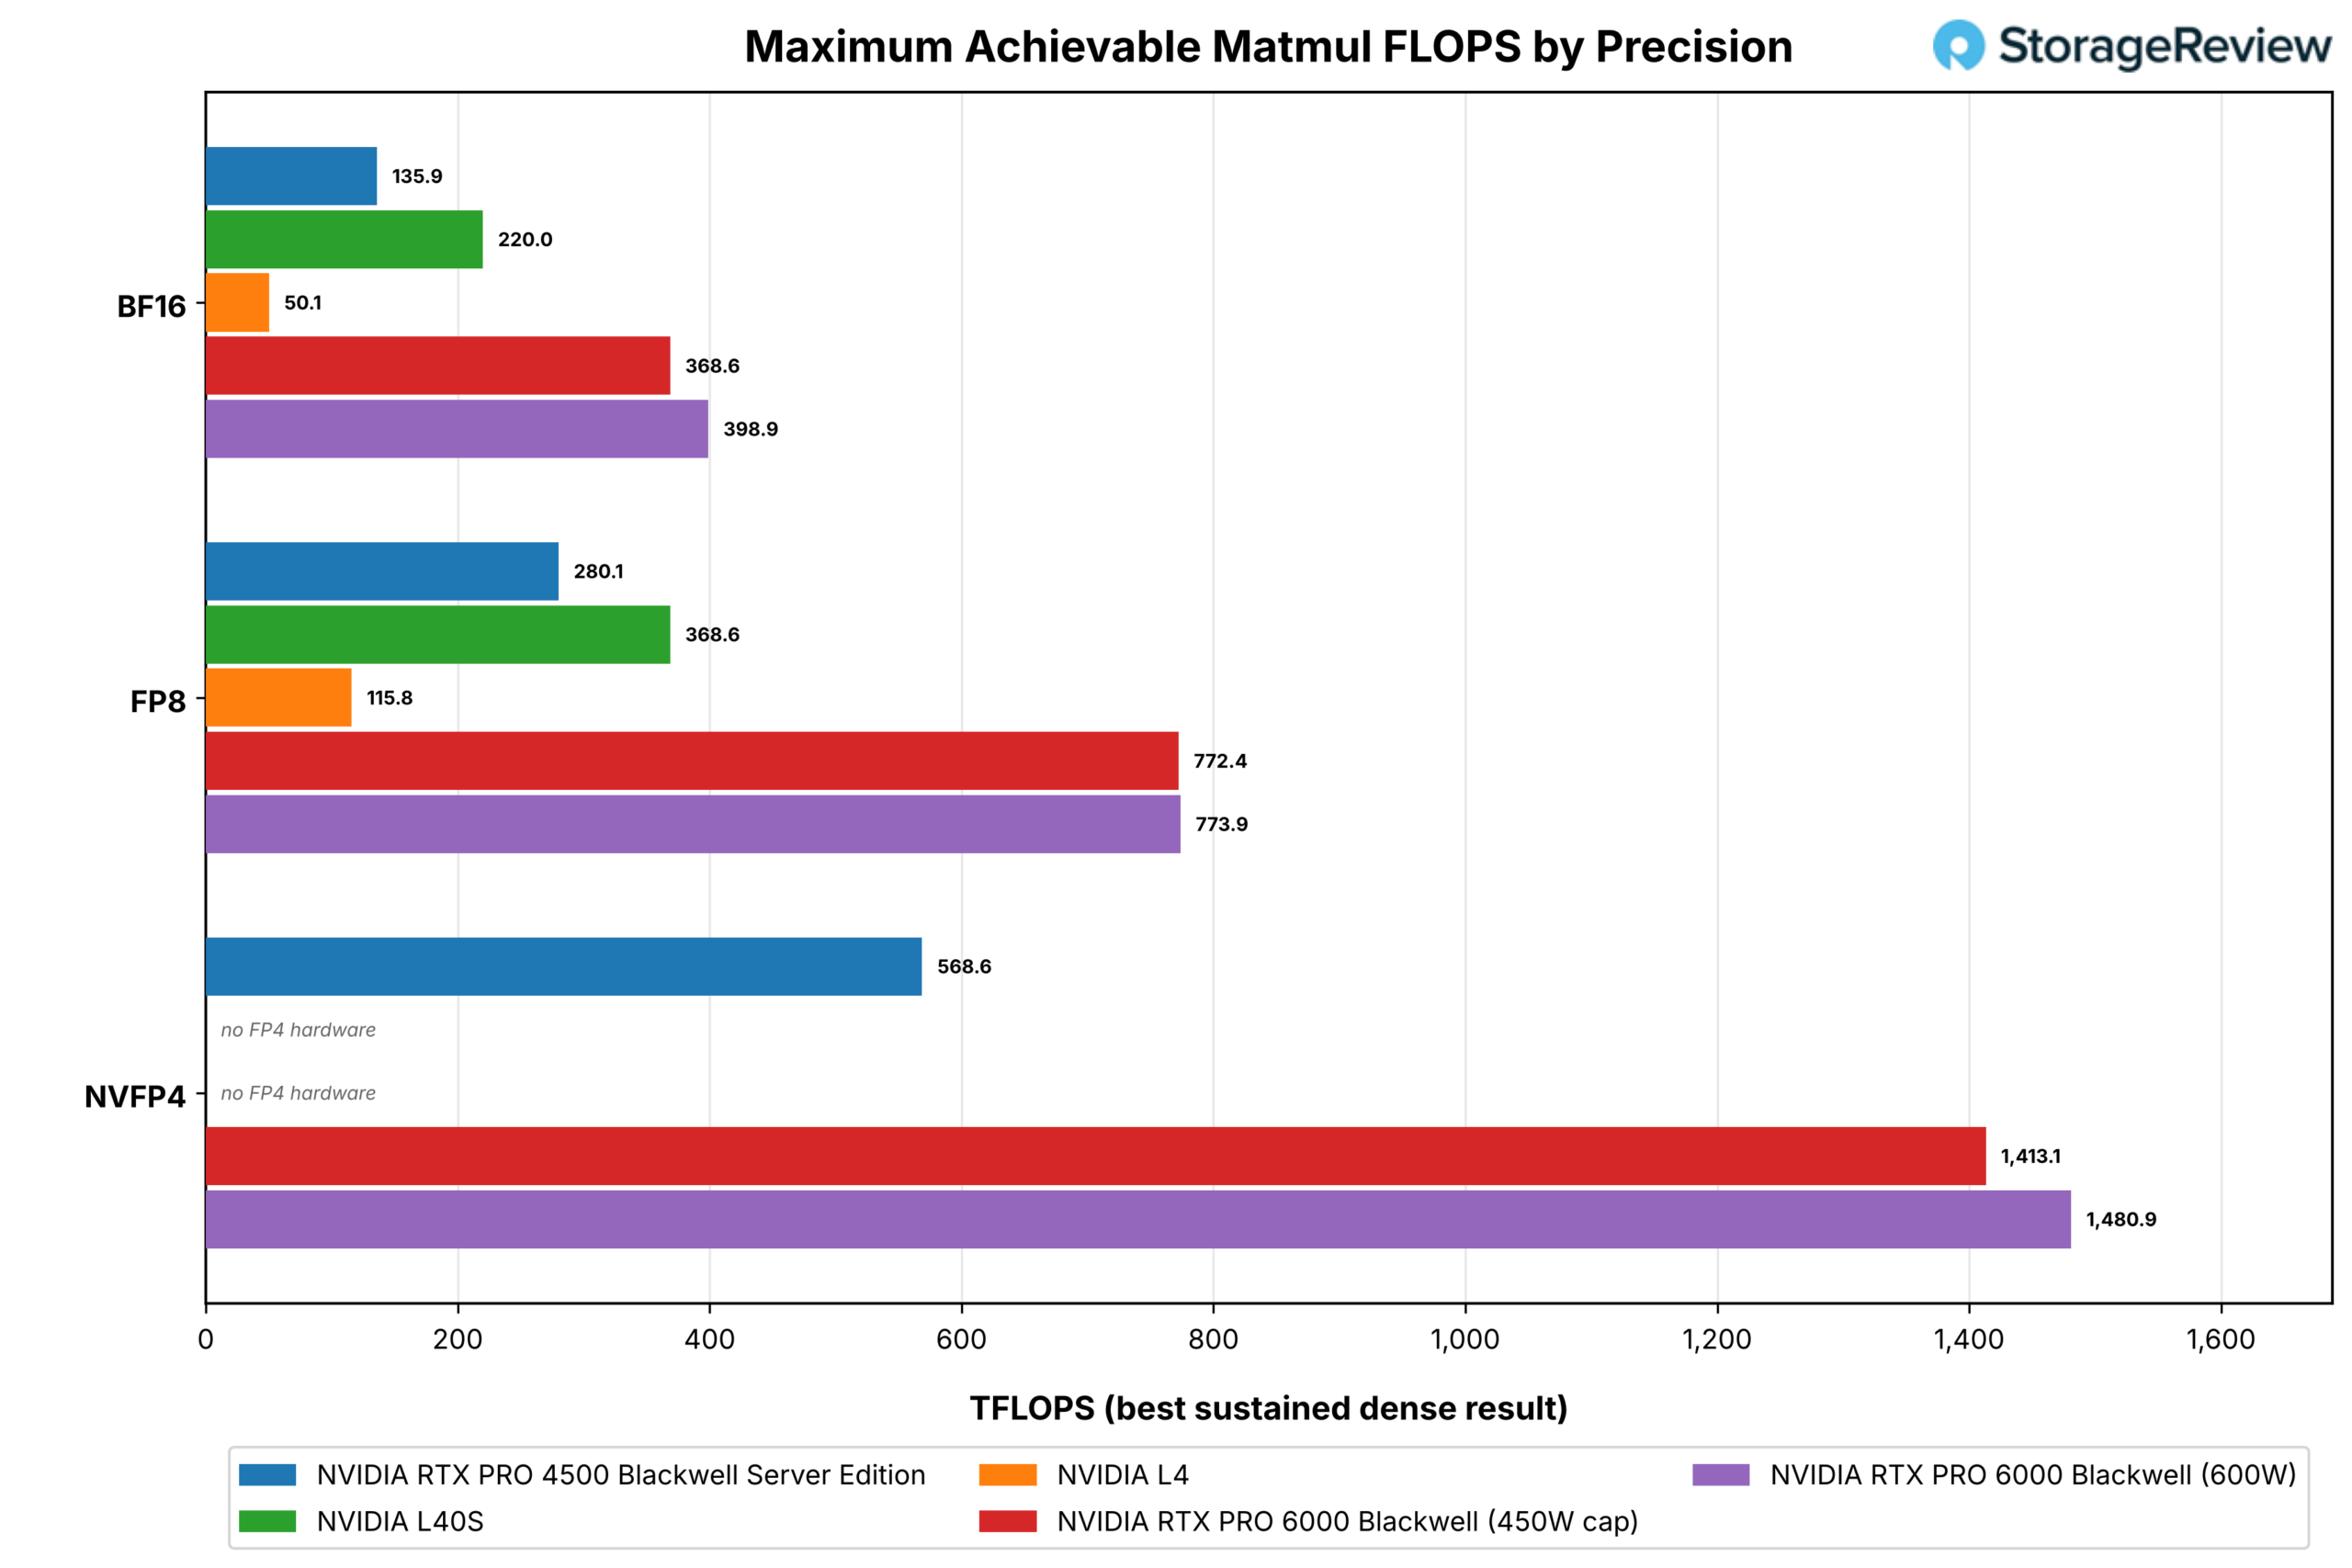
RTX PRO 6000 skalade på liknande sätt och nådde 398.9, 773.9 och 1 480,9 TFLOPS vid 600W, 2.6x till 2.9x 4500 över de tre precisionerna, vilket matchar vad chipets storlek och effektbudget förutspår. Vid 450W-gränsen nådde den 368.6, 772.4 och 1 413,1: FP8 rörde sig inte, BF16 förlorade 8 procent och NVFP4 förlorade 5 procent, vilket innebär att 6000:ans FP8-tensorväg ligger under 450W i detta test, och de andra två precisionerna bara sveper i taket. L40S nådde 220.0 och 368.6 TFLOPS i BF16 och FP8, och L4 nådde 50.1 och 115.8; inget av Ada-korten har FP4 Tensor-hårdvara.
Den användbara jämförelsen är 4500:ans NVFP4-resultat mot alla andras FP8: 568.6 TFLOPS är 1.5 gånger L40S:s FP8-tak och 74 % av de maxade 6000:orna, från ett 165W-kort. Det är FP4-fördelen, och den finns på GEMM-nivå. De följande vLLM-servingresultaten visar att den inte har nått serving stack i den här builden, och MAMF-resultatet antyder att servingssiffrorna kommer att fortsätta växa i takt med att NVFP4-kärnorna kommer ikapp.
vLLM Online-visning: Kort sammanhang (512/512)
Kortfattat presenterar 4500 sitt argument: på de tre FP8- och BF16-modellerna var dess genomströmning vid samtidighet 32 1 107 tokens/s på Ministral 3 14B mot 995 för L40S, 1 017 mot 1 005 på Ministral 3 8B och 2 006 mot 1 988 på Ministral 3 3B. Var och en av dessa är ett Blackwell-kort på 165W som matchar eller slår ett Ada-kort på 350W, och kurvorna ligger ovanpå varandra från samtidighet 1 till 32, så detta är inte bara ett toppresultat. L4 landade på 364, 279 och 704 på samma modeller, vilket placerar 4500 på 2.8x till 3.6x sin föregångare.

RTX PRO 6000 visar vad resten av Blackwells budget levererar. Med en maxeffekt på 450W nådde den 2 161, 2 042 och 4 069 tokens/s på samma tre modeller, 1.95x till 2.03x 4500; vid sina fulla 600W nådde den 2 283, 2 139 och 4 155, vilket är 2.06x till 2.1x. De två 6000-kurvorna ligger ovanpå varandra genom concurrency 16 på varje modell och skiljer sig endast med 2 till 5 procent vid 32, så i korta förhållanden tillför de sista 150W lite. Jämfört med 4500 är det dubbelt så mycket dataflöde från ett kort med 3x så mycket minne och, i R770, 2.7x så mycket kortplatskraft.

Den totala dataflödet, vilket även inkluderar 512 förfyllda tokens per begäran, följer samma ordning: 2 215 tokens/s för 4500 på 14B-modellen mot 1 990 för L40S och 727 för L4, med 6000 på 4 323 med begränsning och 4 566 på 600W. Skillnaden till L4 är störst på 8B-modellen på 3.6x och smalast på 3B-modellen på 2.8x, och skillnaden till L40S överstiger aldrig 12 procent till 4500:s fördel.

vLLM Online-visning: Lång kontext (8K/1K)
Vid 8 192 inmatade tokens förändras bilden, och orsaken syns i kurvornas form. På Ministral 3 14B FP8 följer 4500 L40S genom samtidighet 8, planar sedan ut vid cirka 180 tokens/s, medan L40S fortsätter till 230 vid samtidighet 16 och håller sig där. 8B-modellen gör detsamma: 185 tokens/s för 4500 vid 32 mot 277 för L40S, där 4500 planar ut vid 8 och L40S vid 16. På 3B-modellen planar båda korten ut vid 16, 384 mot 475.

Anledningen är KV-cachekapacitet: varje samtidig 8K-förfrågan behöver sin kontext på kortet, och när vikterna är laddade rymmer en 32 GB bildbuffert färre av dem än en på 48 GB. När vLLM får slut på KV-utrymme slutar den att lägga till användbar samtidighet, och dataflödeslinjen blir platt. 4500 ger upp 17 till 33 procent till L40S vid samtidighet 32 på dessa modeller av den anledningen enbart; beräkningssidan är inte flaskhalsen, vilket de korta kontextresultaten visar. L4, med 24 GB och 300 GB/s, är platt från samtidighet 4 på alla modeller, vid 34 till 130 tokens/s.

6000:ans 96 GB går aldrig på kompromiss i det här testet, och dess kurvor fortsätter att klättra till 32 på alla modeller. Vid 450W-gränsen nådde den 552, 589 och 973 tokens/s, 2.5x till 3.2x jämfört med 4500; vid 600W nådde den 608, 639 och 1 033, eller 2.7x till 3.5x. Det är här som strömförbrukningsgränsen syns: förfyllning i lång kontext håller 6000 beräkningsbundet längre, så det begränsade kortet ger upp 4 till 9 procent vid samtidighet 16 och 32, jämfört med 2 till 5 vid kort kontext. Hur som helst vidgas förhållandet till 4500 från 2x till ungefär 3x, och minnet är orsaken mer än strömförbrukningen.

Om din arbetsbelastning är dokumentfrågor och svar, RAG över långa kontexter, eller agenter som har stora verktygsutdata, är minne den dominerande specifikationen, och 4500:ans 32 GB är en samtidighetsbegränsning. Om det är chatt, klassificering eller korta agentomgångar, är det inte det. Total dataflöde vid 8K/1K domineras av förfyllning och upprepar samma ordning: 1 713 tokens/s för 4500 på 14B-modellen mot 2 070 för L40S och 381 för L4, med 6000 vid 4 971 begränsade och 5 474 vid 600W.
NVFP4: Där programvaran sätter taket
Qwen3.8-27B i NVFP4 är den enda modellen i gruppen som använder FP4 Tensor-hårdvaran som Blackwell leder med, och resultatet är den plattaste uppsättningen kurvor i recensionen. Vid samtidighet 32 i korttidstestet producerade 4500 320 tokens/s; L40S, 480 och RTX PRO 6000 nådde 621, med maxeffekt, och 616 vid 600W. Vid samtidighet 1 landade varje kort mellan 17 och 22 tokens/s på en 27B-modell, inklusive 6000 med 1.6 TB/s GDDR7, där samma kort levererar 99 tokens/s i en enda ström på 14B FP8-modellen.

L40S har ingen FP4 Tensor-hårdvara, så vLLM kör en NVFP4-kontrollpunkt genom att avkvantisera vikterna och beräkna med högre precision, en minnesbandbreddsbunden väg, och den slår 4500 med 1.5x. 6000, som har samma FP4-hårdvara som 4500 och 2x sin bandbredd, landar på samma ungefär 2x över 4500 som skiljer de två korten åt överallt annars, och dess 450W- och 600W-körningar ligger inom 1 procent av varandra vid varje samtidighet, så kärnan är inte heller strömförbrukningsbunden.
Mönstret över alla fyra serierna, med en enda ströms genomströmning som inte rör sig med minnesbandbredden och ett concurrency-32-tak på 480 till 621 oavsett GPU under, pekar på NVFP4-kärnvägen i denna vLLM-version som gränsen på varje kort.

Vid 8K/1K nådde 4500 153 tokens/s vid samtidighet 32, jämfört med 190 för L40S och 402 och 425 för 6000 med och utan begränsning. Det är samma KV-cache-begränsade former som FP8- och BF16-modellerna visade, där 6000:ans 96 GB återigen är anledningen till att den fortsätter att klättra medan de andra planar ut.
NVIDIA har FP4 på detta kort med 1 221 tokens/s på Llama 3.1 8B vid 2K/256 och 905 tokens/s på Nemotron 3 Nano 30B A3B under TensorRT-LLM, så hårdvaran levererar under NVIDIAs stack. Vad data säger idag är att NVFP4 på detta kort är en vLLM-mjukvaruhistoria som delas av alla GPU:er vi testat, och köpare som räknar med FP4-genomströmning bör testa sin serverstack innan de räknar med den.
Genomströmning per nominell watt
Vi mätte inte effekten i den här omgången, så den tillgängliga effektivitetsberäkningen den här gången är mot varje korts testade effektgräns. På Ministral 3 14B FP8 vid samtidighet 32 levererar 4500 6.7 utdata tokens/s per nominell watt, jämfört med 2.8 för L40S, 5.1 för L4, 4.8 för RTX PRO 6000 vid dess 450W-kapsling och 3.8 för 6000 vid 600W. På 3B-modellen gäller följande förhållande: 12.2 för 4500, 5.7 för L40S, 9.8 för L4, 9.0 för 6000 med kapsling och 6.9 för 6000 vid 600W.
4500 är det mest effektiva kortet i gruppen sett till detta mått på kort sikt, och Capped 6000 är det enda som kommer nära. Att dra ner 6000 till 450W kostar det 2 till 5 procent av dataflödet och ger tillbaka 25 procent av sin strömförbrukning, vilket är anledningen till att dess effektivitetssiffra ökar med en fjärdedel. L4 förblir konkurrenskraftig på detta mått eftersom 72W är en mycket liten nämnare, men den behöver tre gånger så många slots och servrar för att nå samma dataflöde, vilket är den handel som 4500 byggdes för att avsluta.
Vid 8K/1K ändras ordningen: 4500 landar på 1.2 tokens/s per nominell watt på 14B-modellen, capped 6000 på 1.2 och 600W 6000 på 1.0, med L40S på 0.7. När 4500 får slut på KV-cache slutar dess dataflöde att öka medan dess effekt inte gör det, så i långa loppet matchar 6000 vid 450W den effektiviteten och levererar 2.9 gånger mer arbete per slot.
Slutsats
RTX PRO 4500 Blackwell Server Edition gör precis vad NVIDIA säger att de gör: den placerar Blackwell i en kortplats, en strömförbrukningsbudget och en chassiklass som tidigare toppade på ett L4-kort. På de modeller som de flesta vanliga servrar kör, små och medelstora instruktioner och resonemangsmodeller i chattlängdskontext, levererar den L40S-genomströmning från ett kort med en kortplats som är klassat till mindre än hälften av L40S:s strömförbrukning, och tre gånger vad L4:an klarade.
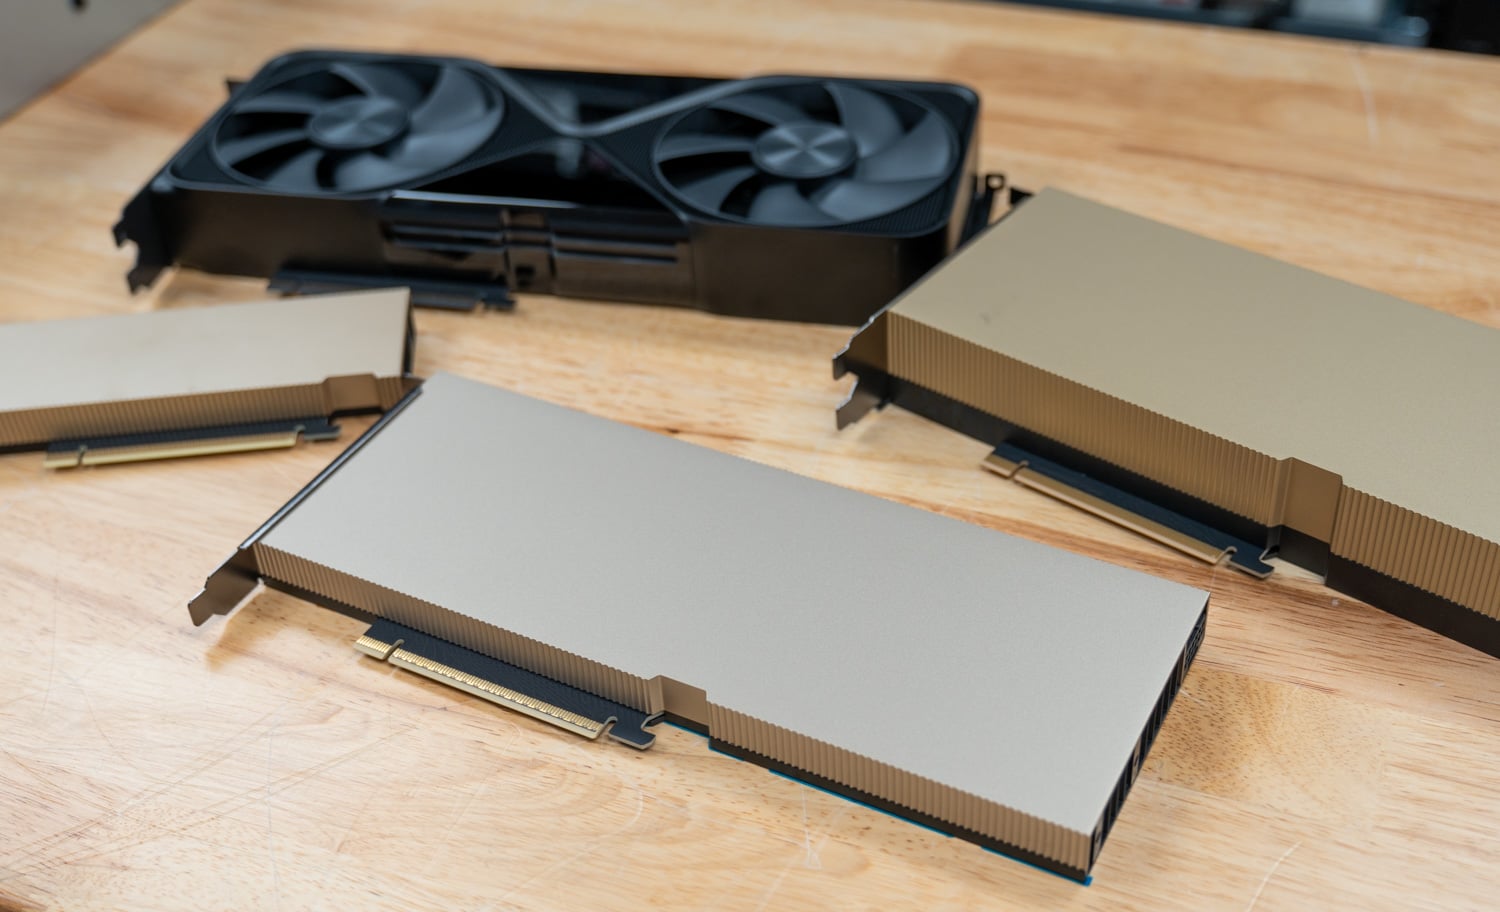
Det finns naturligtvis begränsningar. Börjar med minnet: 32 GB är tillräcklig viktkapacitet för de modeller som det här kortet riktar sig till, men det begränsar samtidighet vid långa kontexter, där L40S:s 48 GB och särskilt 6000:s 96 GB drar åt sig hållet, och där 6000 kör ungefär 3 gånger 4500 vid samma begäran även med sin kapacitet hållen till vad samma server skulle tillåta.
NVFP4, Blackwells precisionsmodell, presterar i linje med kort som inte har någon FP4-hårdvara på denna vLLM-version, även om MAMF-svepet visar att FP4-hårdvaran levererar dubbelt så mycket som kortets FP8-hastighet på GEMM-nivå, så FP4-fördelen är något att verifiera på din egen stack, men det finns helt klart fler fördelar via programvara.
Alla med 2U-servrar, eller ett 1U-chassi som använder ett FHFL-kort, som behöver lägga till inferens, visuell AI, transkodning eller virtuell arbetsstationskapacitet utan att behöva röra strömförsörjning eller kylning, kommer att tycka att RTX PRO 4500 passar utmärkt. Dessutom bör alla som fortfarande kör L4-serverar och har vuxit ifrån 24 GB vara entusiastiska över 4500. För organisationer vars arbetsbelastningar är tillräckligt långsiktiga eller med flera hyresgäster för att behöva 48 GB eller mer per kort, är RTX PRO 6000 det bättre alternativet.
NVIDIA har gjort bra ifrån sig att utse två tydliga simbanor för dessa kort, och 4500 fyller gapet mellan L4 och 6000 i AI-kanten medan det bara drar 165W.
Topplista: RTX PRO 4500 Blackwell Server Edition har platsen för bästa single-slot-grafikkort på vår topplista över bästa företagsgrafikkort , där även data för L40S och RTX PRO 6000 från denna recension visas.



 Amazon