

Qumulo File System är Qumulos unika mjukvarudefinierade distribuerade filsystem som spänner över datacentret, privata och offentliga moln. Dess mjukvara är byggd för hybridmolnet, vilket gör att den kan köras på förkonfigurerade och förkvalificerade hårdvaruplattformar av industristandard, såväl som inbyggt över flera offentliga moln. I vårt labb hade vi möjlighet att studera Qumulos mjukvara och några av dess viktigaste funktioner. I just den här recensionen tar vi en titt på Qumulos filsystem och dess grafiska användargränssnitt (GUI).
För att förnya sig är organisationer beroende av modern lagring, datainfrastruktur, äldre och molnbaserade applikationer och tjänster och molnlagring, såväl som ostrukturerad datahantering och plattformar. Men ostrukturerad data håller på att bli en smärta för företag som vill migrera till molnet eller utnyttja en hybrid-molnmodell, eftersom denna typ av data skapar en ny datasilo; i de flesta tillgängliga molnplattformar. IT-avdelningen står inför denna konsekvens att det oftare än inte är överväldigat att hantera arbetsbelastningar i två olika filsystem: det i sina lokaler och ett i molnet.
Det verkliga problemet är dock inte molnplattformar eller ostrukturerade dataplattformar. Vi använder fortfarande äldre fillagring som inte är lämplig för att göra övergången till molnet. Som Qumulo framhåller har IT förändrats, men fillagring har inte gjort det. De sista framgångsrika fillagringsarkitekturerna skapades för mer än 15 år sedan innan molnet blomstrade. Däremot bör modern fillagring vara molnklar: förena alla ostrukturerade datatyper, skala till miljarder filer, spänna över flera datacenter och själva molnet. Ge också synlighet och automatisering med realtidsanalys och API-driven kontroll.
Qumulo: ett molnfärdigt filsystem
Qumulo identifierar sig som en annan typ av lagringsföretag och hävdar att han har det första filsystemet för att hantera hybridmolnarbetsbelastningar och tillhandahålla molnbaserade fildatatjänster. Med denna mjukvara riktar företaget sig mot ostrukturerade dataplattformar och driver applikationer och mikrotjänster för byggare och utvecklare. Qumulos filsystemprogramvara är tillgänglig i det offentliga, privata och hybridmolnet.
Lager av Qumulos programvara inkluderar:
- Plattformar. Nuvarande hårdvaruplattformar inkluderar HPE och Fujitsu, och publika moln AWS och GCP. Qumulo tillkännagav också nyligen möjligheten att flytta data från fil till objekt för att utnyttja molnbaserade applikationer och tjänster som utnyttjar objektdata.
- Operativsystemet. Baserat på standard Ubuntu Linux.
- Scalable Block Store (SBS). Grunden till Qumulo. Möjliggör skalning, portabilitet, skydd och prestanda.
- Filsystemet. Det möjliggör skalbara filantal och högpresterande filoperationer. Det ger också realtidsinsikt om prestanda och kapacitet.
- Datatjänster. Skydda, säkra och hantera data i Qumulo-plattformen med hjälp av verktyg av företagsklass. Detta lager består av fem funktioner: ögonblicksbilder, replikering, kvoter, revision och rollbaserad åtkomstkontroll (RBAC).
- Management och programmerbarhet. Möjliggöra att bygga integrerade lösningar med Qumulo-plattformen och administratörer att automatisera och hantera sina datatjänster.
- Dataåtkomst och autentisering. Aktivera åtkomst till data med hjälp av standardapplikationer och operativsystem samtidigt som du säkerställer säkerhet i företagsklass. Detta lager stöder företagsåtkomstprotokoll, inklusive NFS, SMB och FTP.
Vårt fokus här är filsystemet, som bygger på konceptet att organisera data i logiska strukturer och möjliggöra arbetsbelastningar med massiva filantal. Filsystemet använder en distribuerad arkitektur som presenterar ett enda namnområde. Använda plattformar är delade-ingenting-kluster av oberoende noder, där varje nod ger kapacitet och prestanda. Och individuella noder koordinerar konsekvent med varandra, vilket gör det möjligt för alla klienter att ansluta till vilken nod som helst och läsa och skriva i namnområdet. Denna struktur är mycket intressant; Syftet är att skapare ska samarbeta om datamängder när de rör sig genom datans livscykel. Det ger också realtidsinsikt i prestanda och kapacitetsutnyttjande, även när system skalas till petabyte och miljarder filer.
Qumulo filsystem organiserar data i kataloger och presenterar data för SMB- och NFS-klienter med möjligheten att dela data över protokoll, vilket ger flera olika användare och applikationstyper tillgång till samma data. Filsystemet har unika egenskaper där det sticker ut: användningen av B-träd och en inbyggd dataanalysmotor i realtid.
Med hjälp av B-trädstrukturen kan Qumulo skala till miljarder filer utan att uppleva problem som är vanliga i andra system. B-träd är särskilt väl lämpade för system som läser och skriver ett stort antal datablock eftersom de är "grunda" datastrukturer som minimerar mängden I/O som krävs för varje operation när antalet data ökar. Dessa strukturer är idealiska för filsystem och omfattande databasindex.
En annan viktig del av Qumulo filsystem är den datamedvetna förmågan med en analysmotor i realtid. Datamedvetenhet innebär multidimensionell insyn i lagringssystemet, vilket ger kraftfulla insikter om systeminnehåll, aktivitet, användare och mer. Med Qumulos realtidsanalys kan lagringsadministratörer snabbt övervaka lagringsanvändning och prestanda, inklusive genomströmning och latens. Denna synlighet ger organisationer möjlighet att få kontroll över sin ostrukturerade data och minska de totala drifts- och kapitalkostnaderna genom att proaktivt hantera nuvarande behov och bättre förutsäga framtida lagringskrav. Qumulos webbgränssnitt, som granskas i avsnittet nedan, tar denna synlighet till nästa systemhanteringsnivå.
Med sin mjukvaruarkitektur och sitt speciella filsystem tillåter Qumulo organisationer att uppnå affärsmål som tidigare var omöjliga enbart i det lokala datacentret. En av fördelarna med Qumulo är att köra sitt filsystem på plats och sedan köra exakt samma programvara i molnet. Företaget är välkänt som en leverantör av utskalad fillagring. Nu, med hjälp av molnets elasticitet och skalan av både molnberäknings- och molnlagringsinfrastruktur, tillsammans med Qumulos mjukvara, är det mycket kraftfullt att flytta data fram och tillbaka, och enkelt skala ut eller skala upp datacentret. Till exempel kan företag ta sina lokala appar som de är, flytta upp dem till molnet, och det fungerar bara. Och om en användare har fildata som de vill utnyttja med molntjänster som maskininlärning eller AI, kommer Qumulos Shift-funktionalitet att kopiera data till ett molnobjektlager för att få tillgång till molnbaserad applikationsinnovation.
När organisationer flyttar dessa arbetsbelastningar till molnet vill de också förstå hur deras data presterar. Samma upplevelse som Qumulos analys erbjuder för hårdvaruplattformar finns i molnet, vilket erbjuder en fullständig hybrid-molnupplevelse. Antingen om företag kör programvaran i en fysisk apparat eller i molnet, är programvaran densamma, inklusive samma GUI och kapacitet.
För mer information om funktioner och möjligheter rekommenderar vi att du besöker den tekniska dokumentationen på Qumulos webbplats.
Qumulo Performance
Prestandakonfiguration
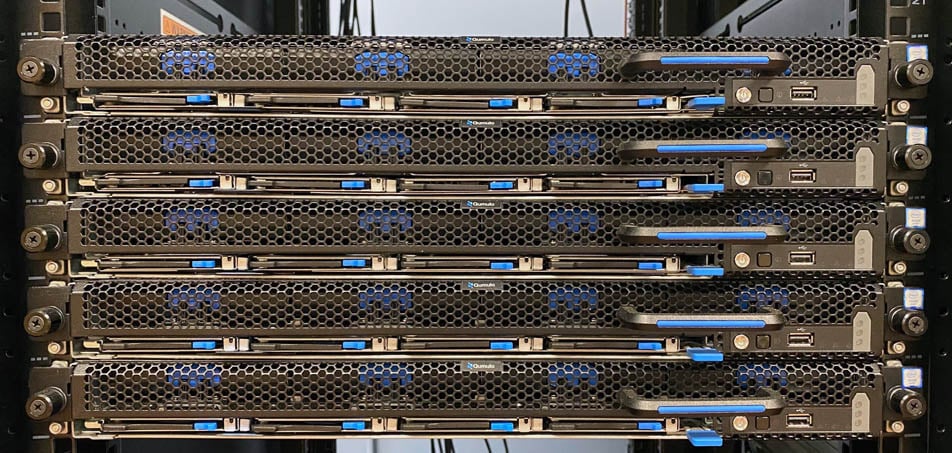
Konfigurationen av Qumulo-noderna i vårt 5-nodskluster inkluderade dubbla 25GbE-portar i LACP med fyra 480GB SATA SSD:er och tolv 6TB SATA HDDs vardera. För våra lagringstester tillhandahöll vi ett enda NFS-namnområde till våra åtta Dell EMC PowerEdge R740xd-servrar, var och en med en enda 25G-port tilldelad vSwitch som ansluter till NFS-resursen. Vi använde sedan våra 16 CentOS LoadGens i VMware, var och en med dubbla 125 GB vDisks tilldelade, vilket gav oss totalt 4TB fotavtryck på klustret.
När det gäller benchmarking av lagringsmatriser är applikationstestning bäst, och syntetiska tester kommer på andra plats. Även om det inte är en perfekt representation av faktiska arbetsbelastningar, hjälper syntetiska tester till baslagringsenheter med en repeterbarhetsfaktor som gör det enkelt att göra jämförelser mellan äpplen och äpplen mellan konkurrerande lösningar. Dessa arbetsbelastningar erbjuder en rad olika testprofiler som sträcker sig från "fyra hörn"-tester, vanliga tester av databasöverföringsstorlek, såväl som spårfångst från olika VDI-miljöer. Alla dessa tester utnyttjar den vanliga vdBench-arbetsbelastningsgeneratorn, med en skriptmotor för att automatisera och fånga resultat över ett stort beräkningstestkluster. Detta gör att vi kan upprepa samma arbetsbelastningar över ett brett utbud av lagringsenheter, inklusive flash-arrayer och individuella lagringsenheter.
Med Qumulo-lagringsarrayen optimerad för stora blocköverföringar fokuserade våra tester på 64K, 1024K och 2048K sekventiella överföringar.
profiler:
- 64K sekventiell läsning: 100 % läsning, 32 trådar, 0-120 % iorat
- 64K sekventiell skrivning: 100 % skrivning, 32 trådar, 0-120 % iorate
- 1024K sekventiell läsning: 100 % läsning, 32 trådar, 0-120 % iorat
- 1024K sekventiell skrivning: 100 % skrivning, 32 trådar, 0-120 % iorate
- 2048K sekventiell läsning: 100 % läsning, 32 trådar, 0-120 % iorat
- 2048K sekventiell skrivning: 100 % skrivning, 32 trådar, 0-120 % iorate
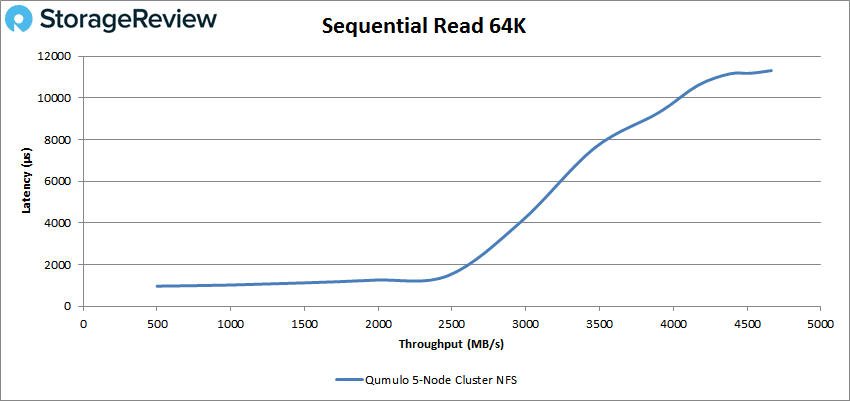
Först ut är vår 64K sekventiella benchmark 74,619 4.66 IOPS eller 11.3 GB/s med en latens på XNUMX ms.
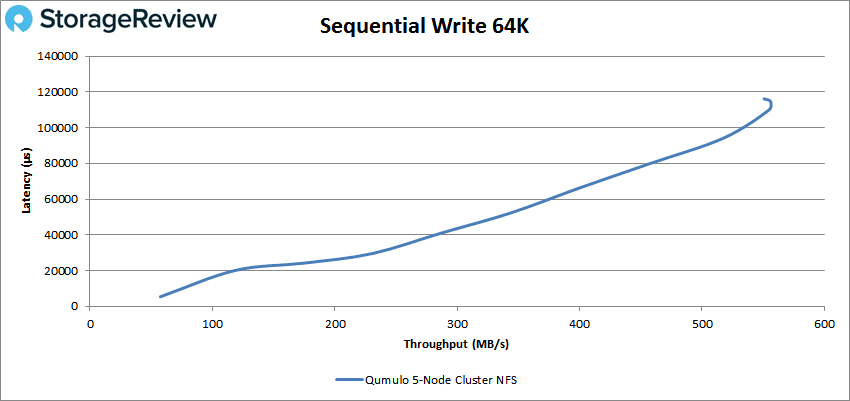
64K skrivning såg en toppprestanda på cirka 9K IOPS eller 555MB/s med en latens på 110ms.
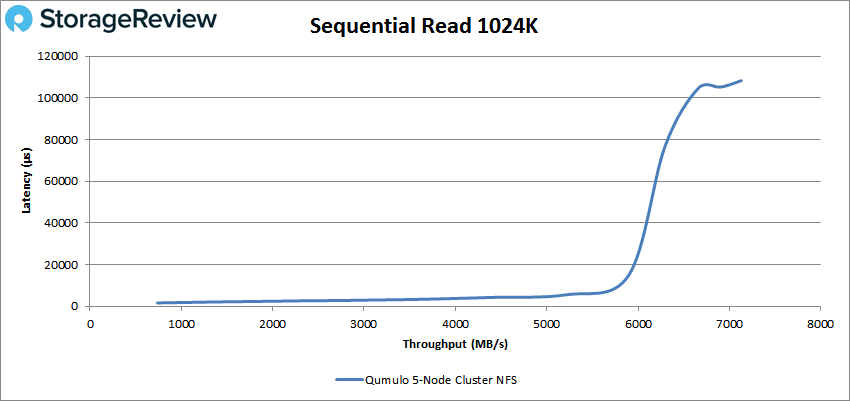
Därefter går vi vidare till våra 1024K-tester. För läsning såg vi en toppprestanda på 7,128 7.13 IOPS eller 108 GB/s med en latens på XNUMXms.
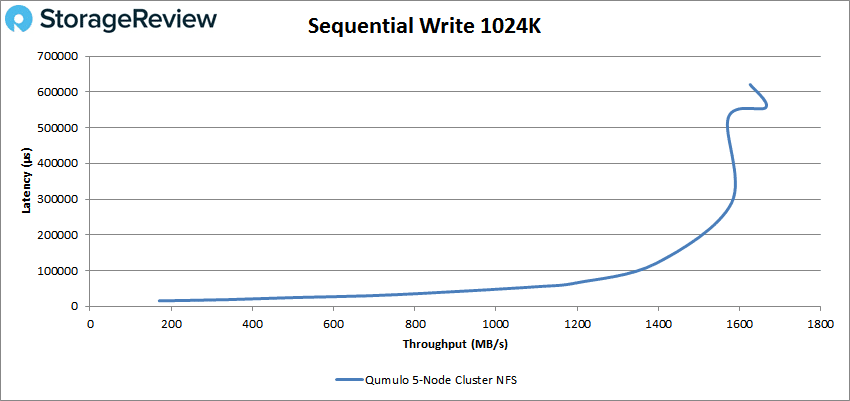
1024K Write såg en topp på ungefär 1,670 1.6 IOPS eller 557 GB/s med en latens på XNUMX ms innan några tappade.
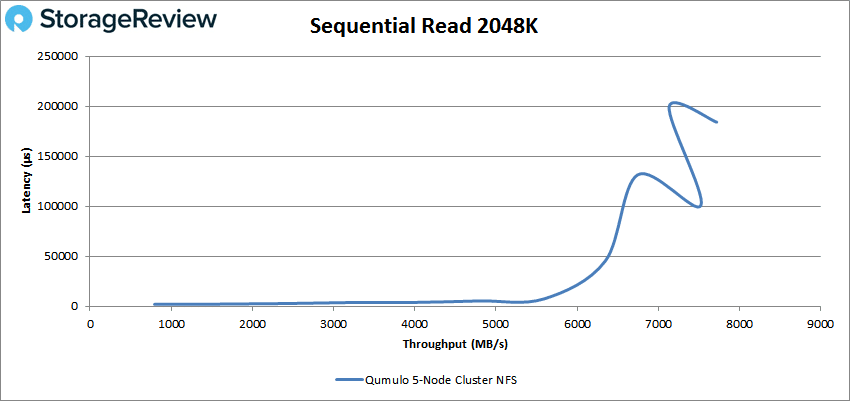
Våra sista sekventiella riktmärken är våra 2048K. I läsprestanda såg vi en topp på 3,858 7.7 IOPS eller 184 GB/s med en latens på XNUMX ms.
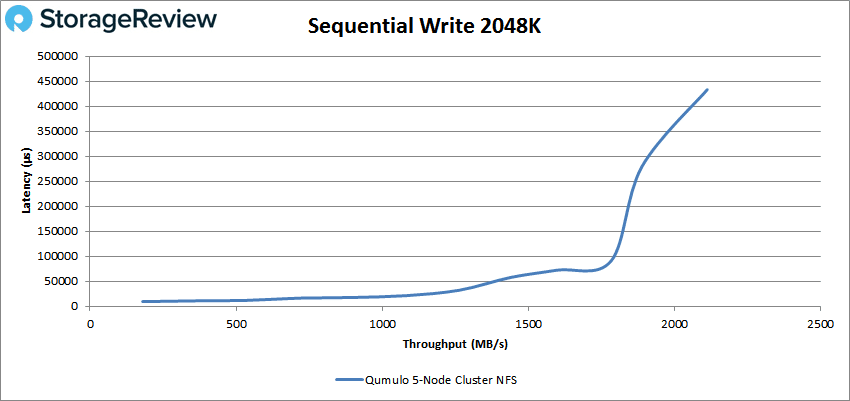
Slutligen, i vår 2048K-skrivning såg vi en topp på 1,055 2.1 IOPS eller 433 GB/s med en latens på XNUMXms.
Qumulo Web UI Översikt
I följande avsnitt överblickar vi Qumulos webbanvändargränssnitt och några av dess nyckelkonfigurationer. Företaget erbjuder detta webbaserade användargränssnitt för administratörer att distribuera, hantera och övervaka datacenter och molnmiljöer.
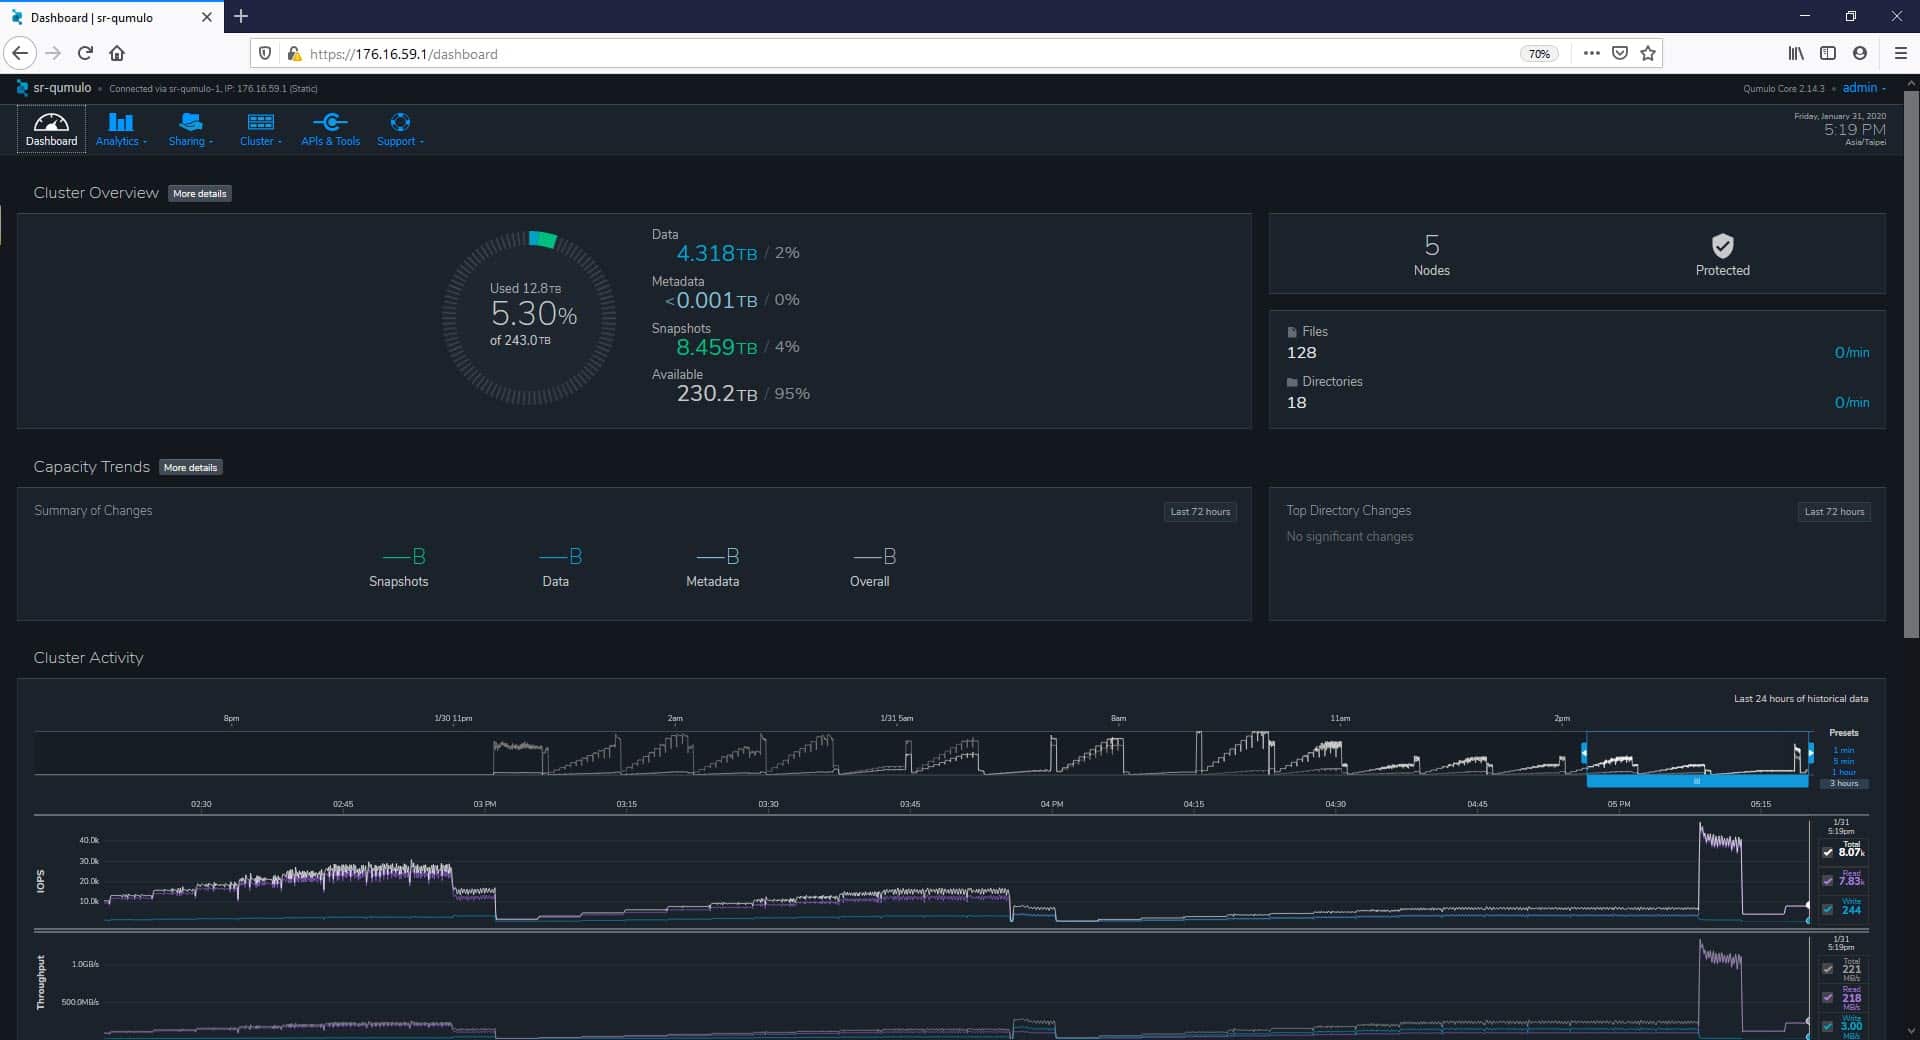
Efter att ha loggat in på klustret som admin, kommer vi direkt till Dashboard-sidan. Vid det här laget inser vi omedelbart det unika och moderna webbgränssnittet som föreslagits av Qumulo. Detta webbgränssnitt består av en intuitiv meny välorganiserad i flikar; vi ser det längst upp till vänster på skärmen, som snabbt inkluderar alla kategorier som behövs för att distribuera, hantera och övervaka vår infrastruktur. Huvudmenyn består av flikarna Dashboard, Analytics, Delning, Kluster, API:er och verktyg och Support. Genom att peka på dessa flikar visar gränssnittet en rullgardinslista för åtkomst till alla olika sidor som gränssnittet erbjuder. I det övre högra hörnet kan användare se den aktuella programvaruversionen, tiden (baserat på webbläsarens klient lokal tid) och den aktuella inloggade användaren.
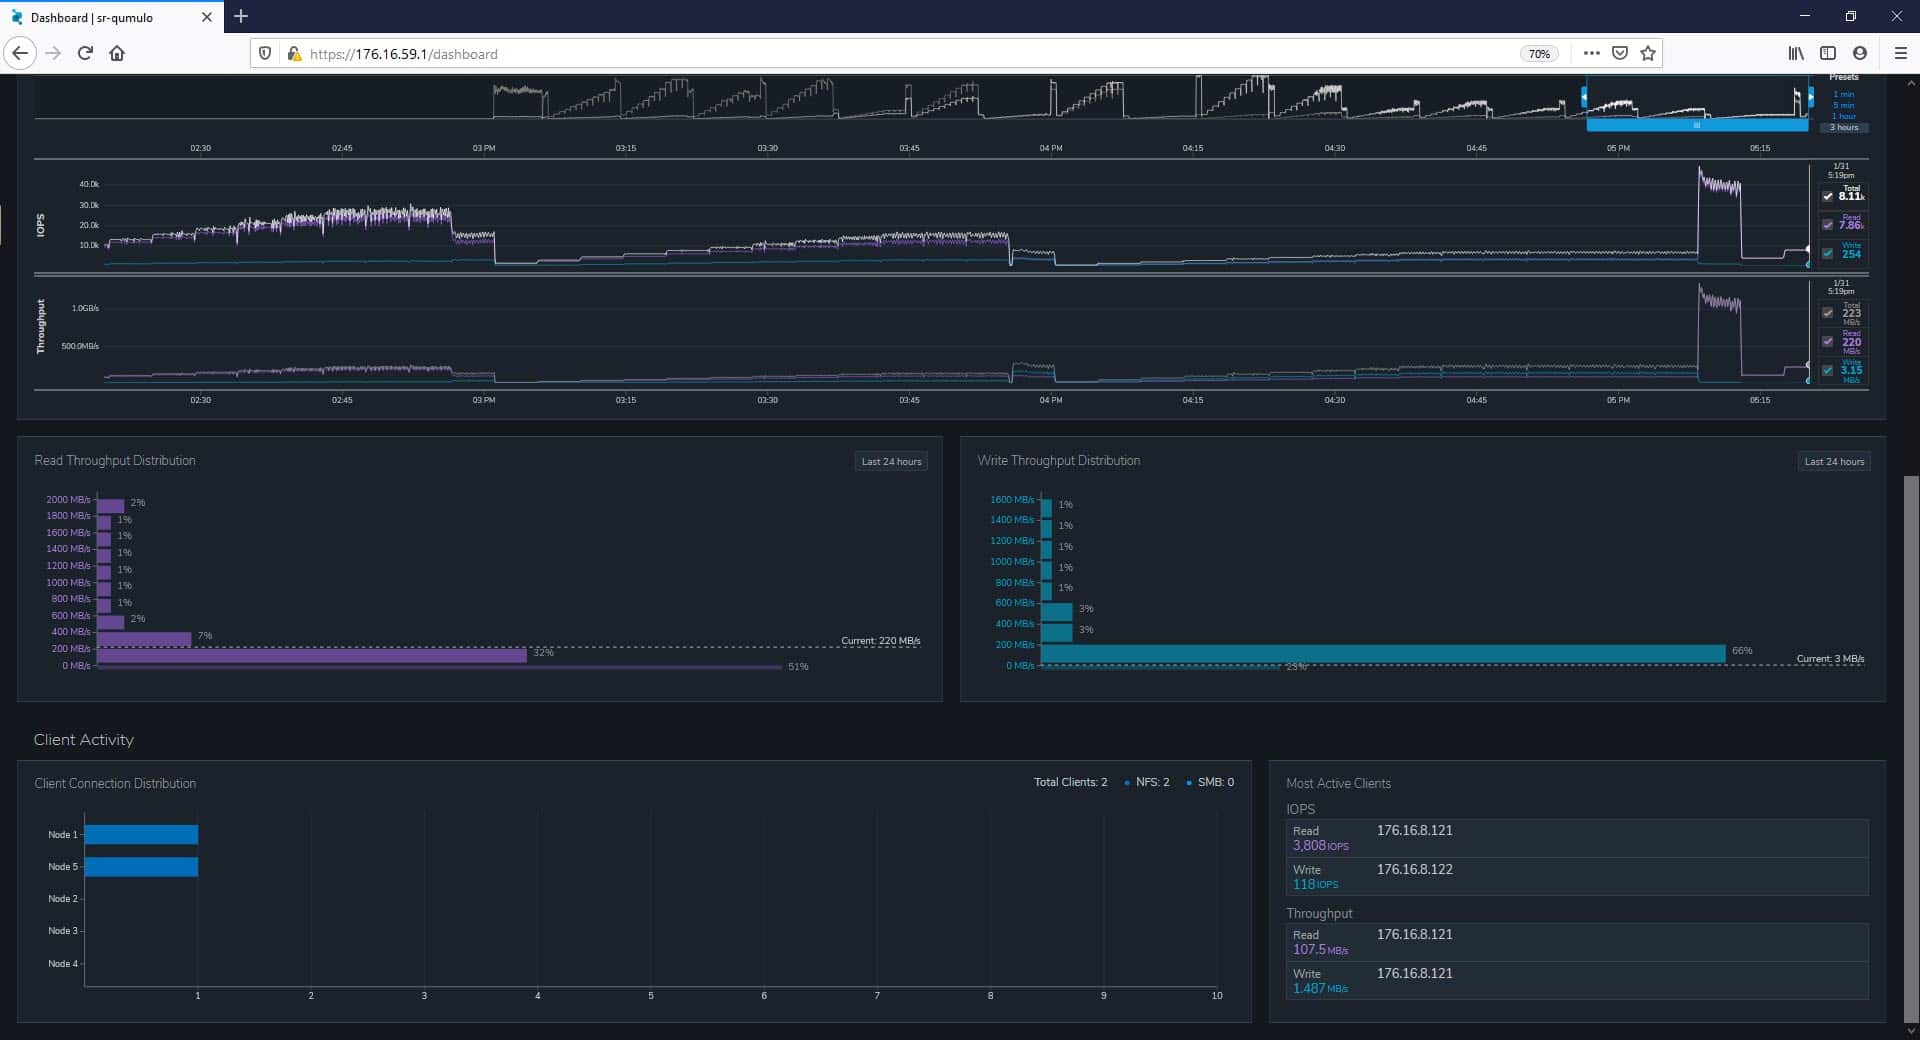
Ändå, på Dashboard-sidan märker vi en attraktiv UI-layout som underlättar övervakningen av infrastrukturer och där vi kan observera olika kritiska områden som klusteröversikt, kapacitetstrender, klientaktivitet och i realtid klusteraktivitet.
Ett koncept som vi gillade särskilt med UI, i Dashboard-området, är den dynamiska interaktionen med alla dess element. Till exempel, under Cluster Activity, kan man enkelt dra för att flytta, expandera eller begränsa den önskade informationsaktiviteten som vi vill övervaka, inom 24 timmar. Här har vi också några förinställningar med perioder på 1 min, 5 min, 1 timme, och standard, 3 timmar. Mätvärdena (IOPS och genomströmning) kommer att anpassas efter toppdata.
Scrollar vi nedåt på Dashboard-sidan hittar vi området Client Activity.
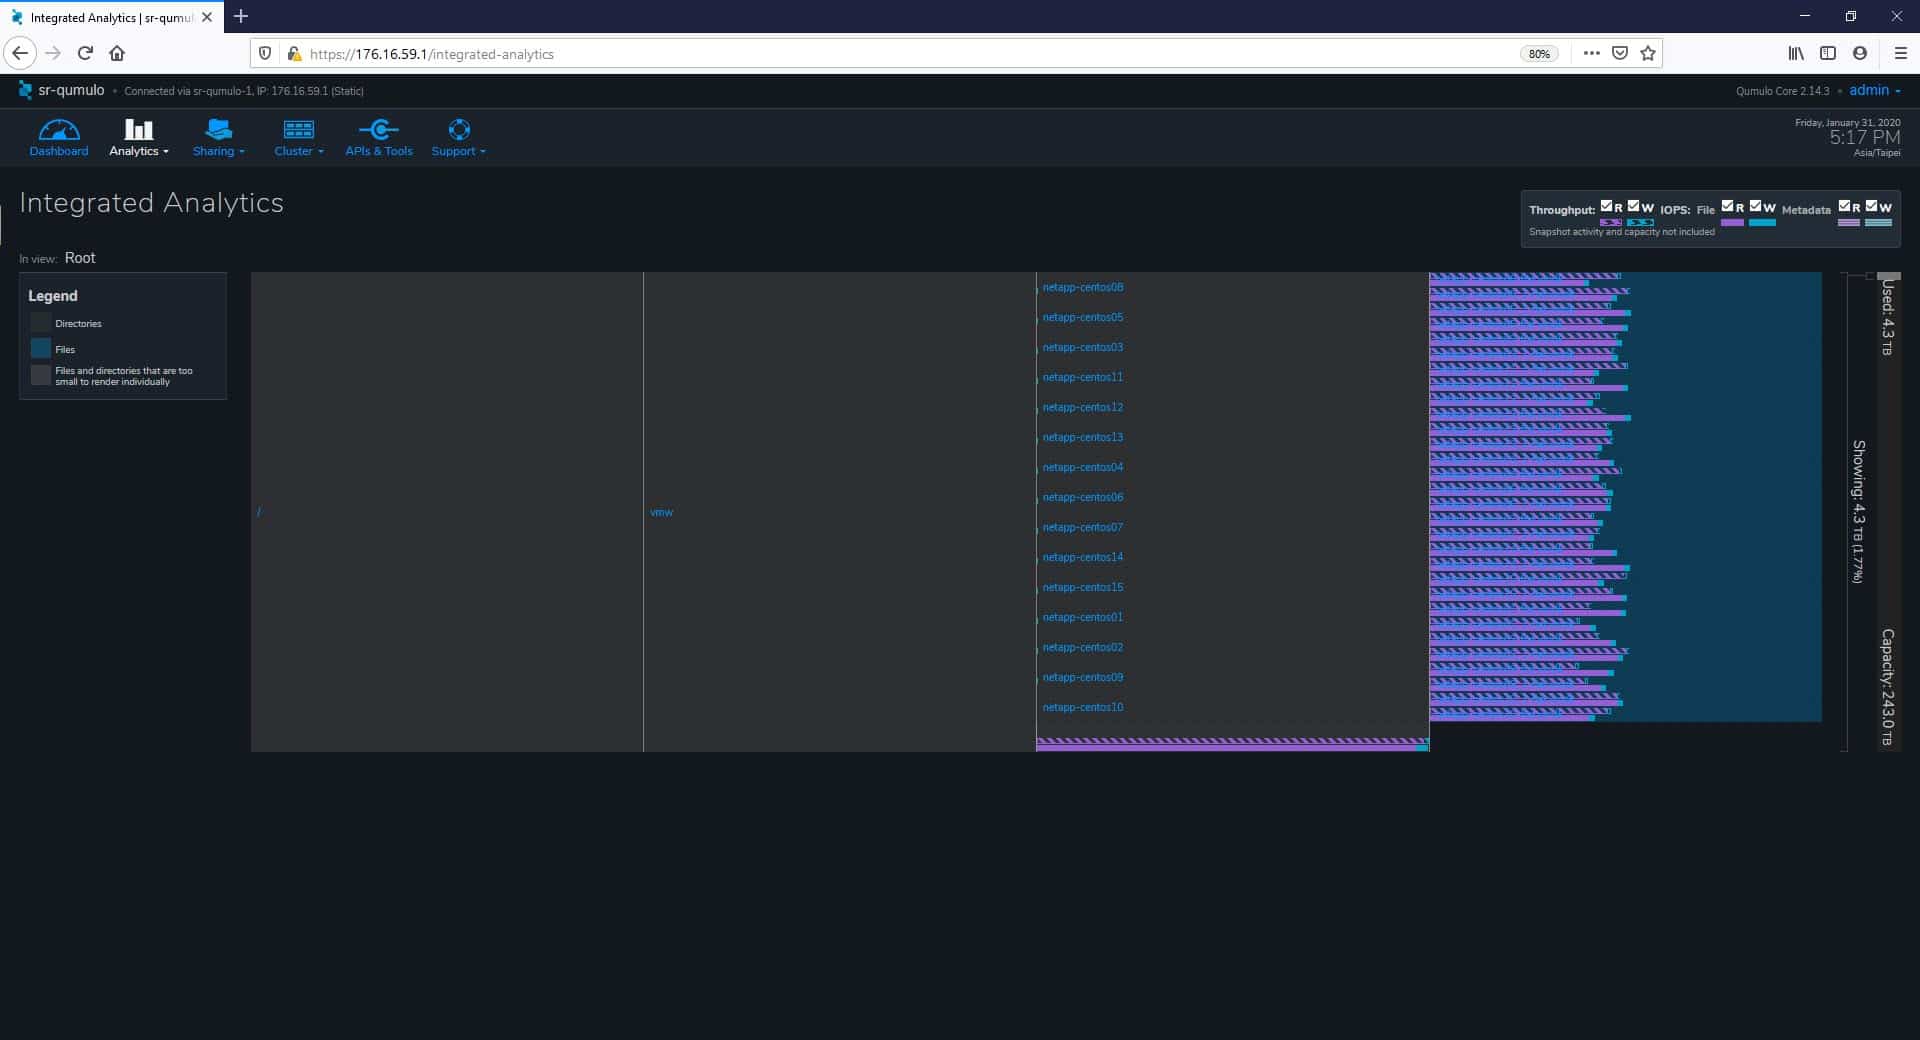
Nu går vi direkt till området där Qumulo sticker ut, analysen. Som tidigare nämnts tillåter Qumulo administratörer att hantera data och användare i realtid. Under Analytics > Integrated Analytics kan vi se informationsrutan till vänster fylld med de klienter som använder mest resurser i systemet, och med kataloger och filer som aktivt läses och skrivs. Denna information visas när du klickar på en specifik katalog eller underkatalog.
Genom att flytta till sidan Kapacitetsutforskare, fortfarande under fliken Analytics, kan vi se hur kapaciteten är fördelad på systemet. Först har vi en allmän översikt över katalogens kapacitet, listad från största till minsta.
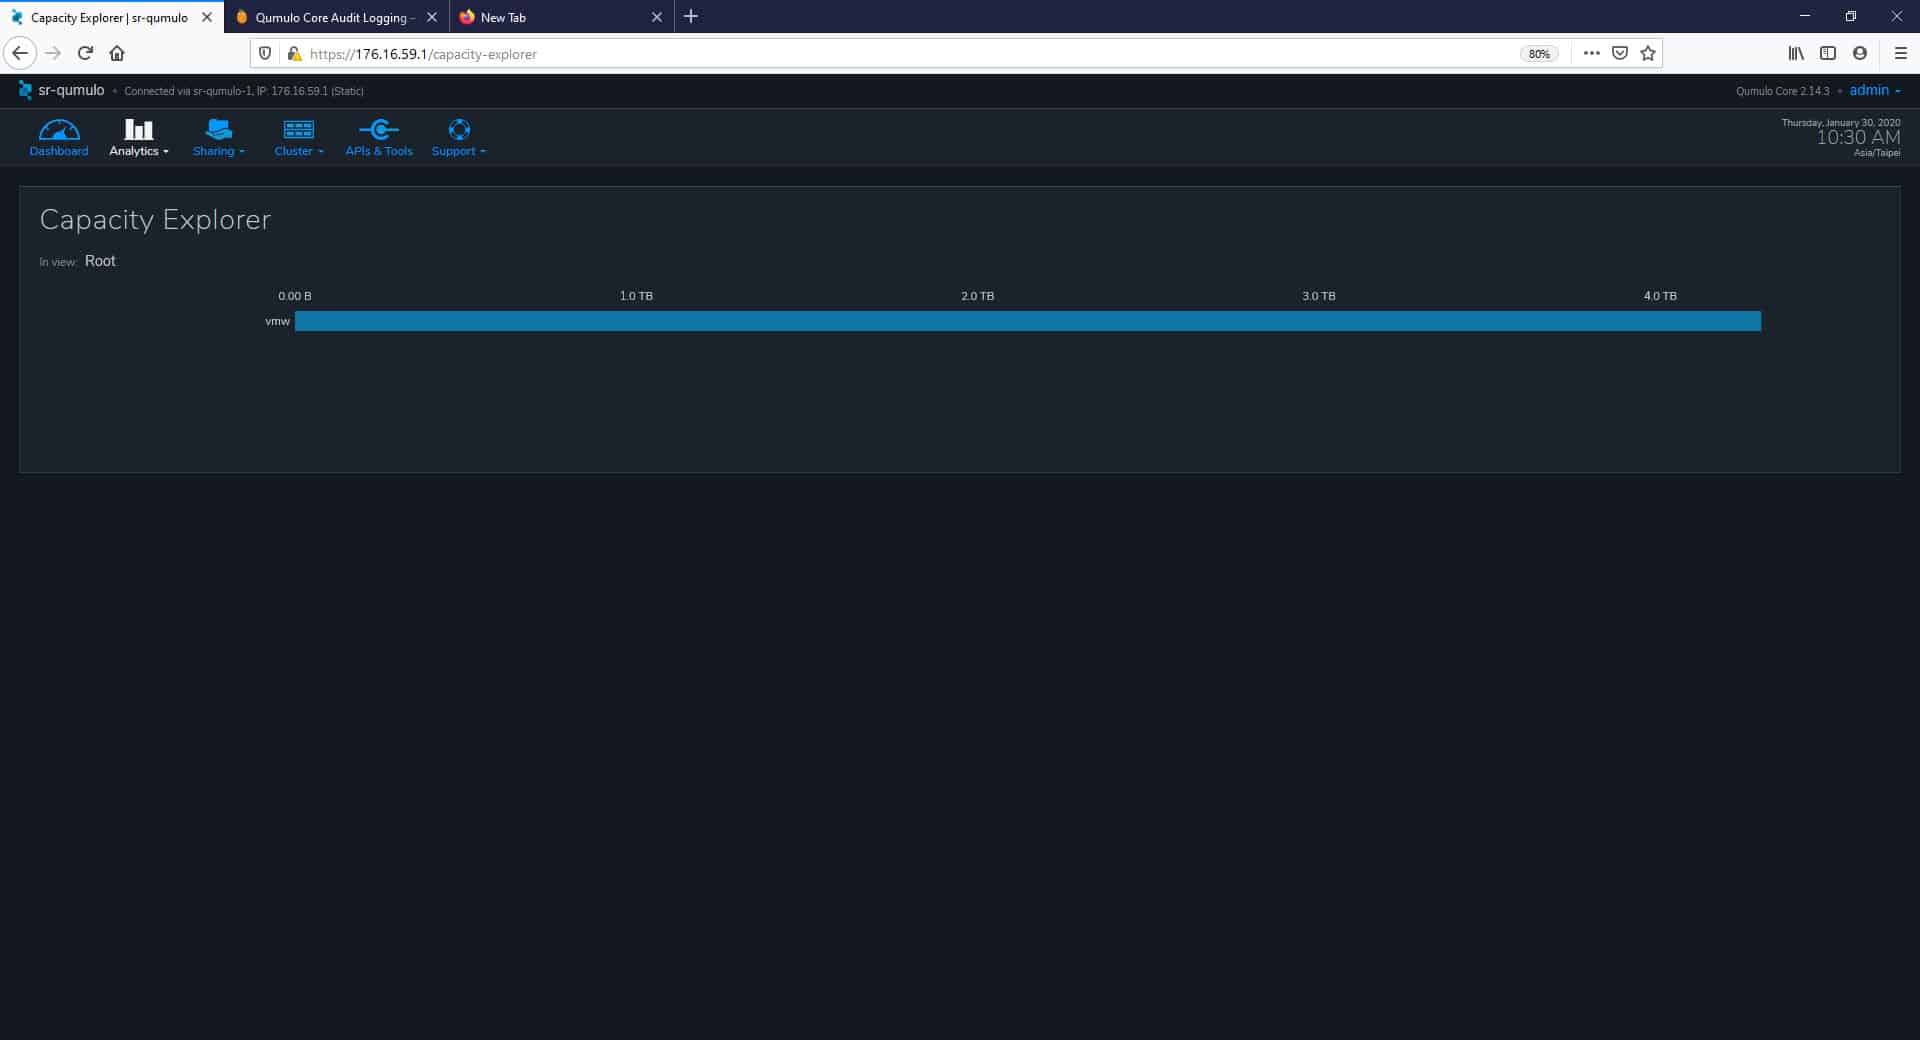
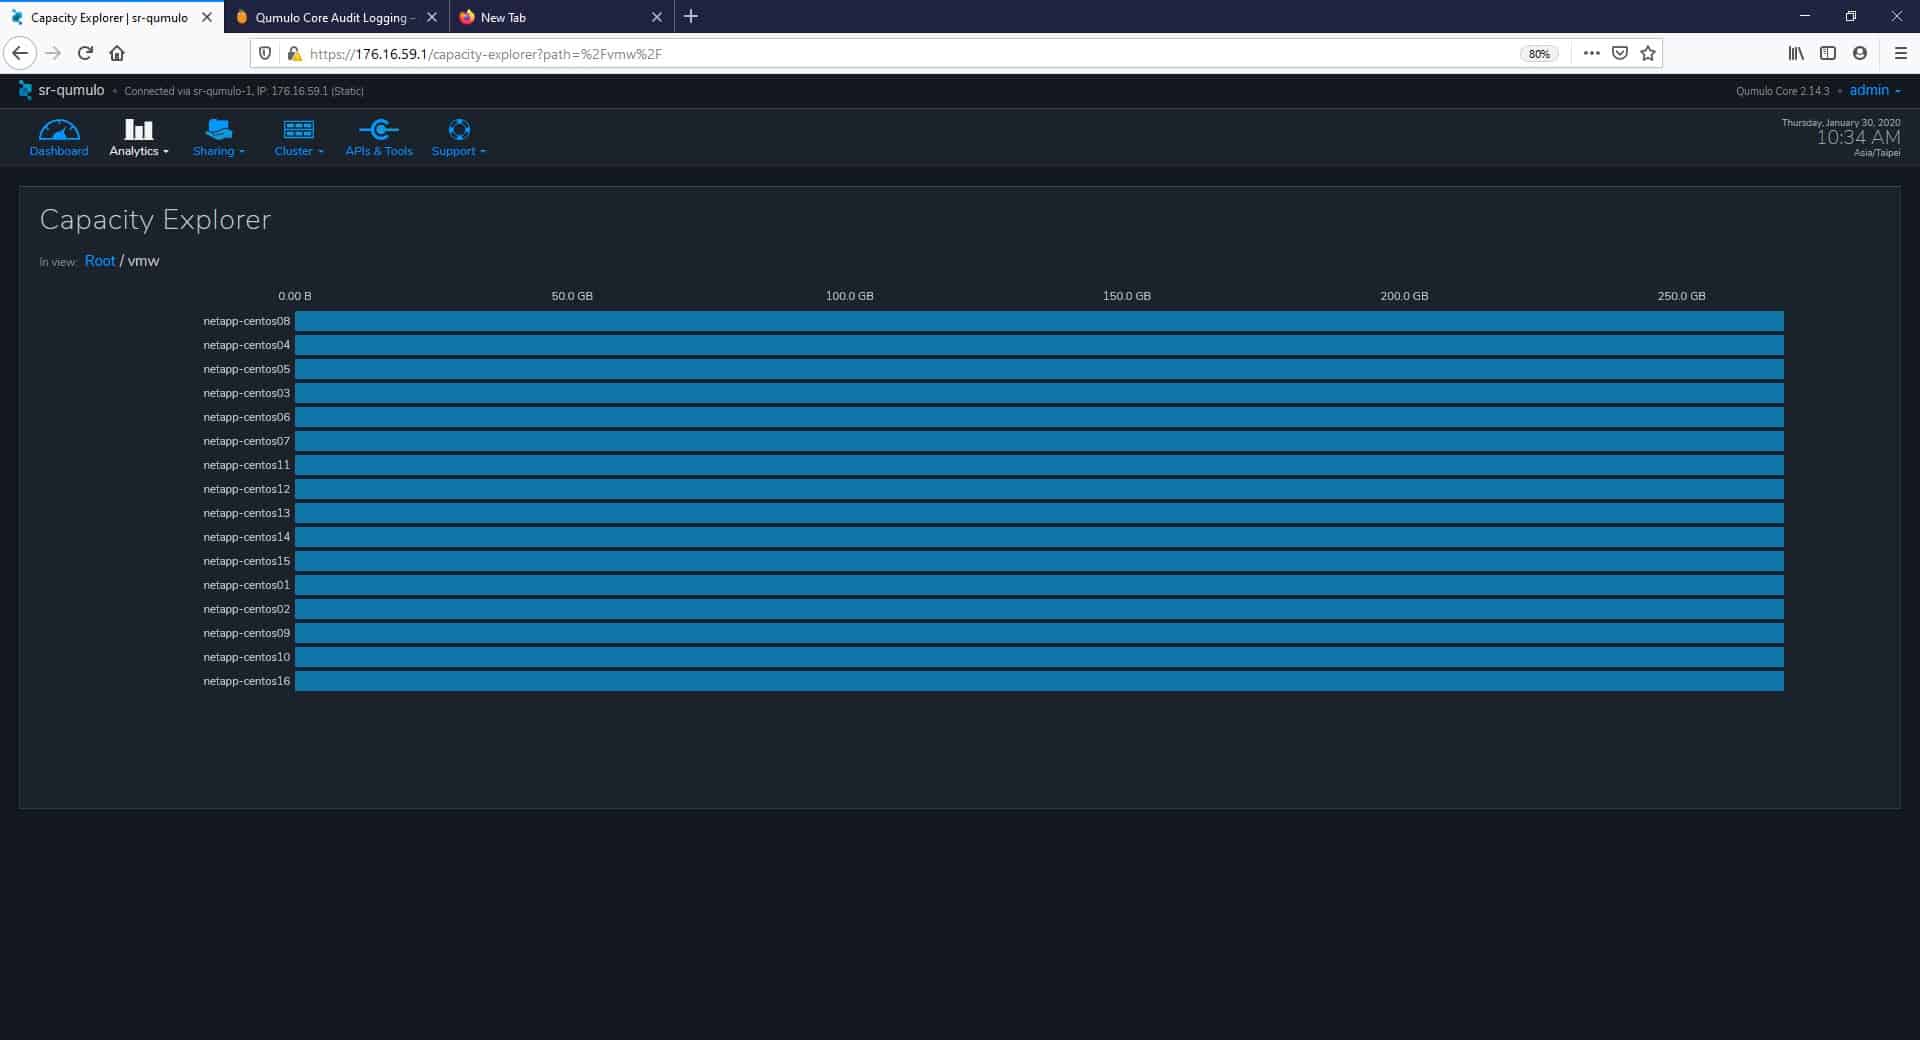
Genom att klicka på en katalog kan vi gräva ner och utforska var och en av dem i ett mer detaljerat perspektiv. Som ett exempel visar bilden nedan underkatalogerna som finns i katalogen med namnet "vmw."
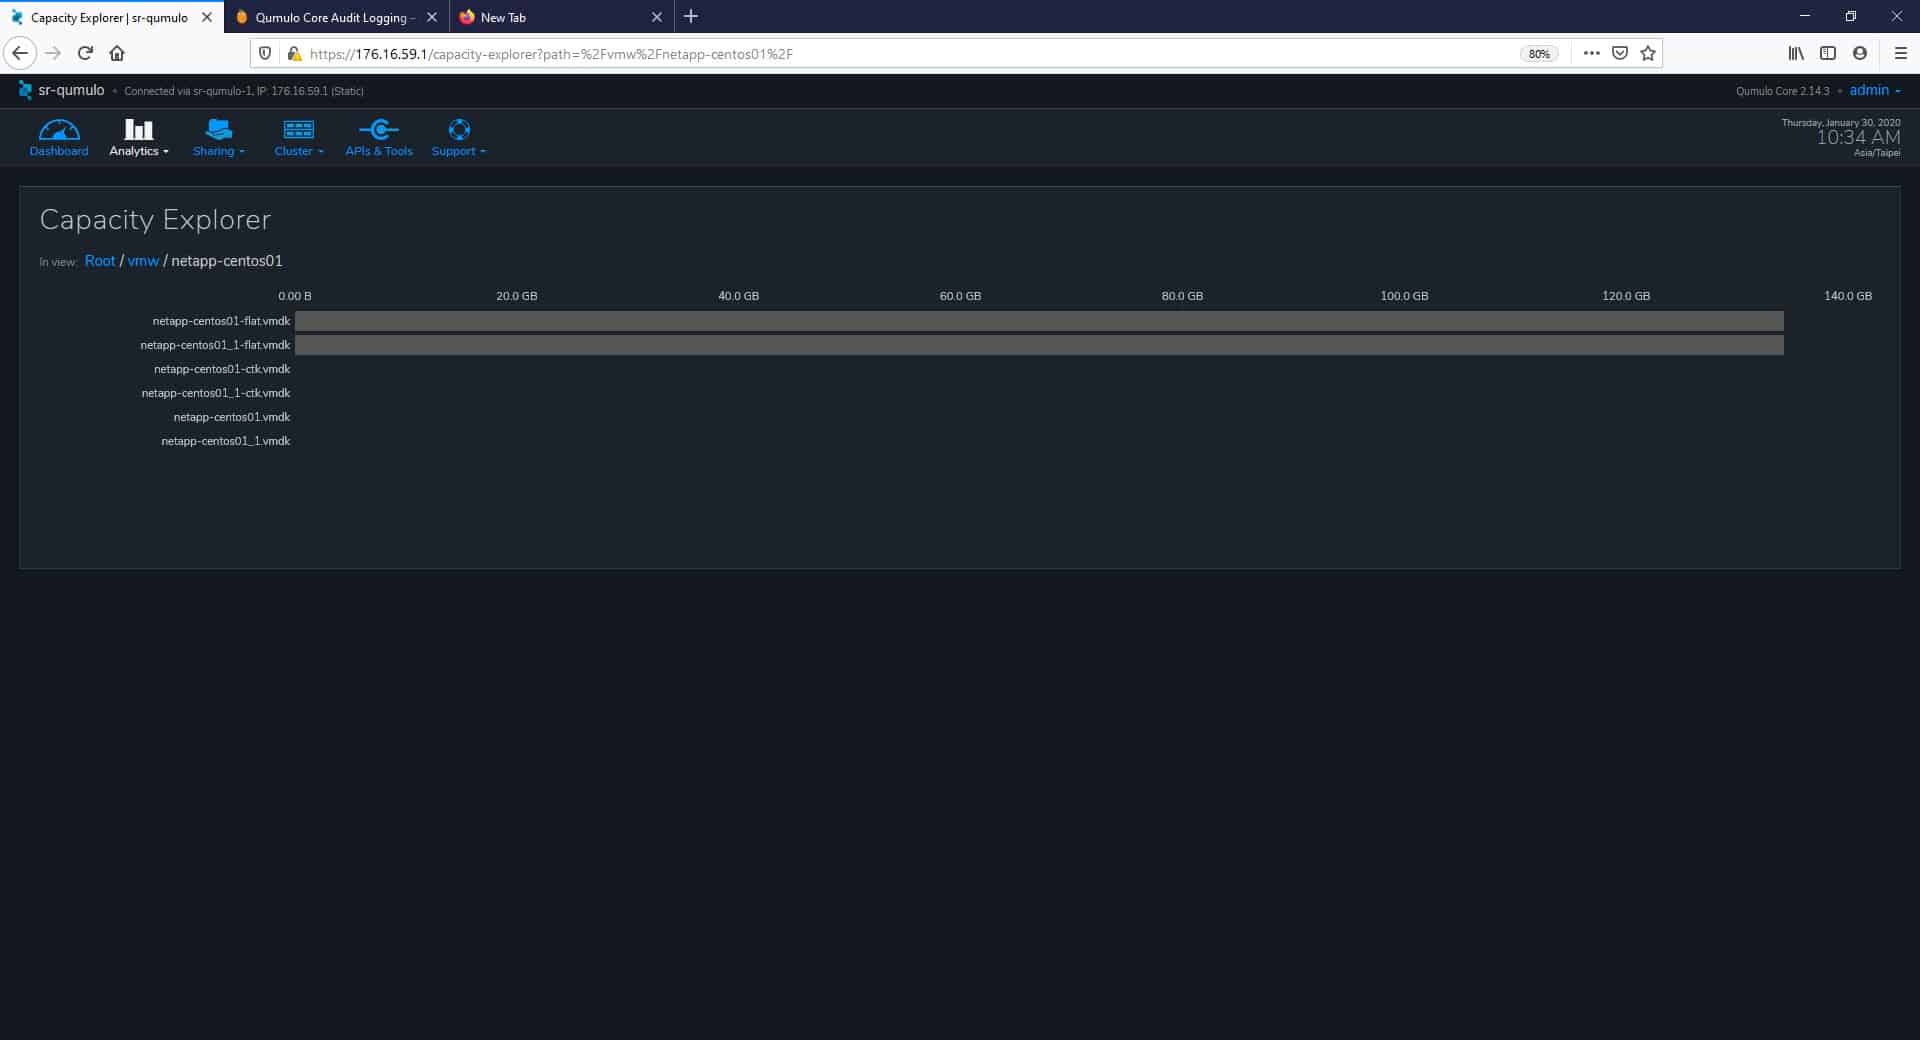
Och om vi fortsätter att klicka på underkatalogerna kan vi så småningom nå detaljer på filnivå. Den här gången klickade vi på underkatalogen med namnet "netapp-centos01".
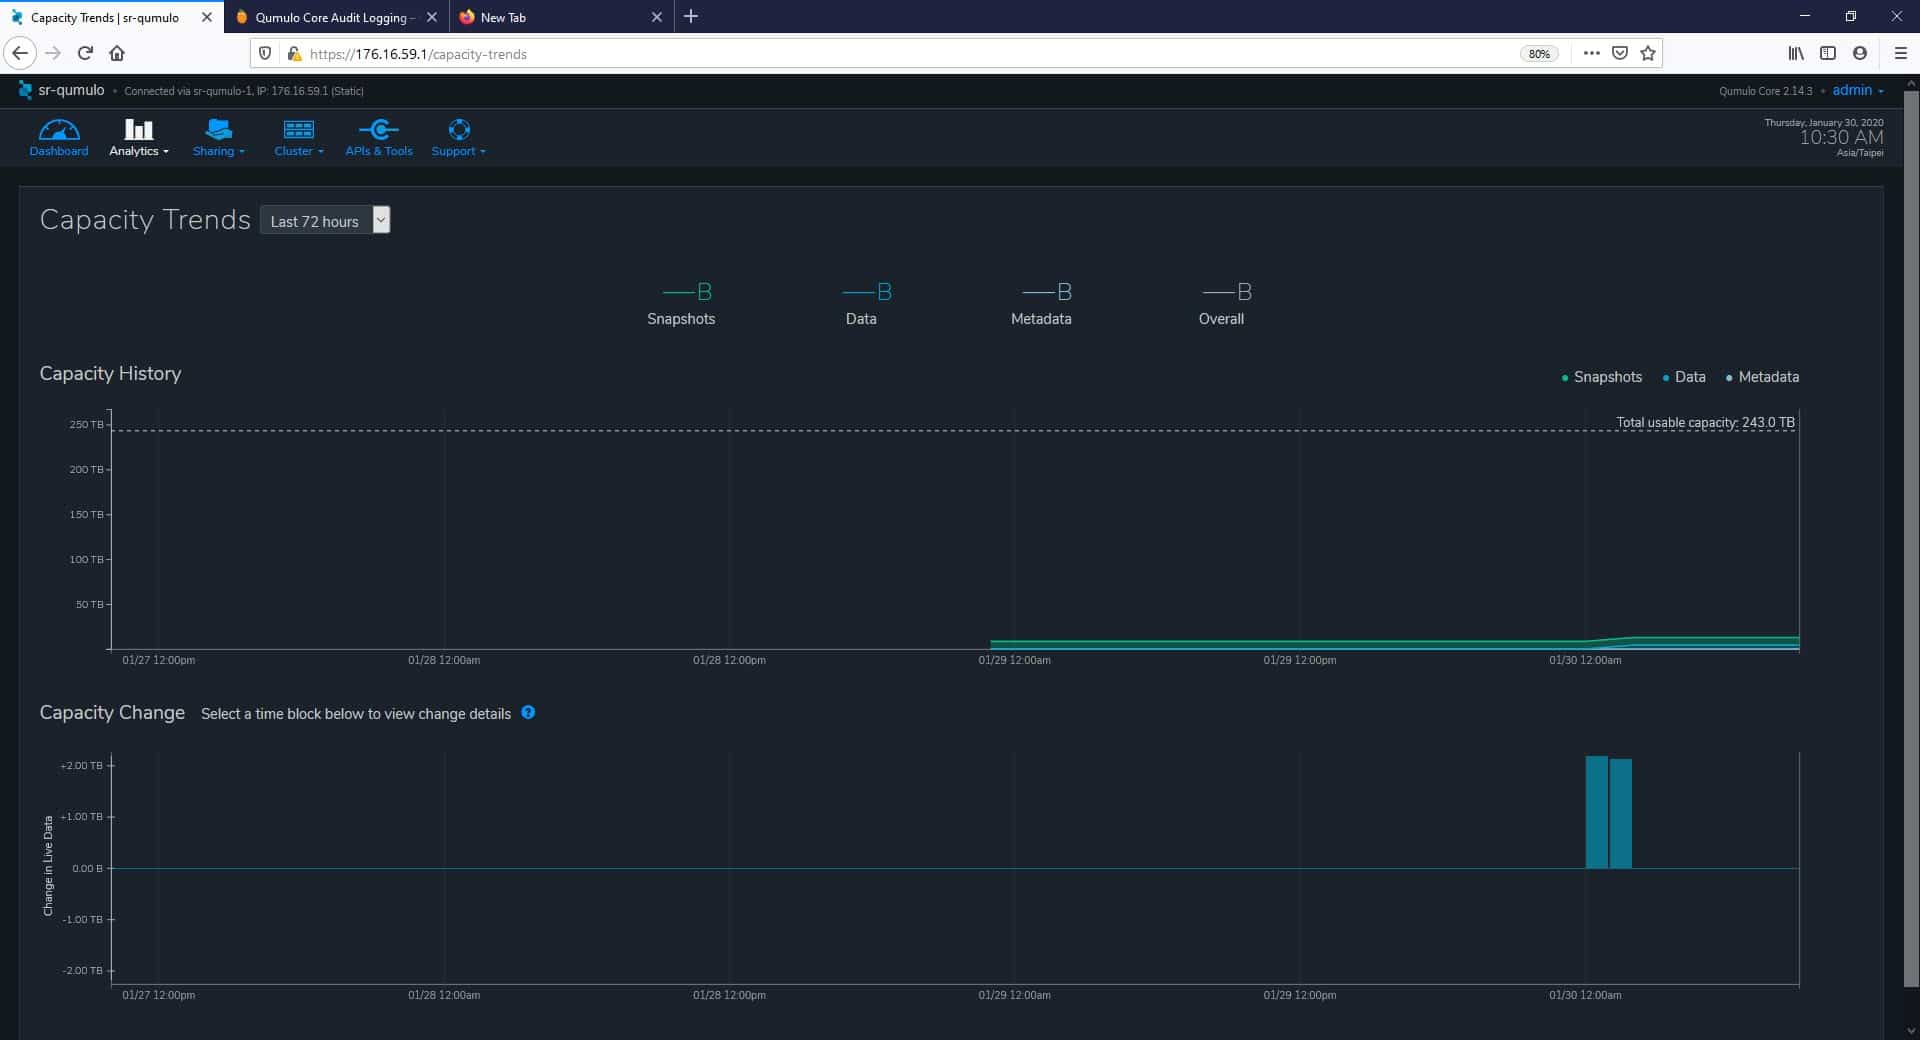
Nästa sida under analys är Kapacitetstrender. Härifrån kan vi få alla detaljer som behövs för att övervaka och hantera kapacitetsanvändningen övertid för klustret. De två huvudområdena här är Capacity History och Capacity Change. Dessa kapaciteter inkluderar metadata, data och ögonblicksbilder (exkluderas endast i Capacity Change). Historik och ändringar av kapaciteten kan snabbt filtreras efter tidsramar för de senaste 72 timmarna, de senaste 30 dagarna eller de senaste 52 veckorna. Det här är fantastiska alternativ som hjälper lagringsadministratörer att visualisera och hantera klustret för skala och att utforska betydande kapacitetsförändrande händelser.
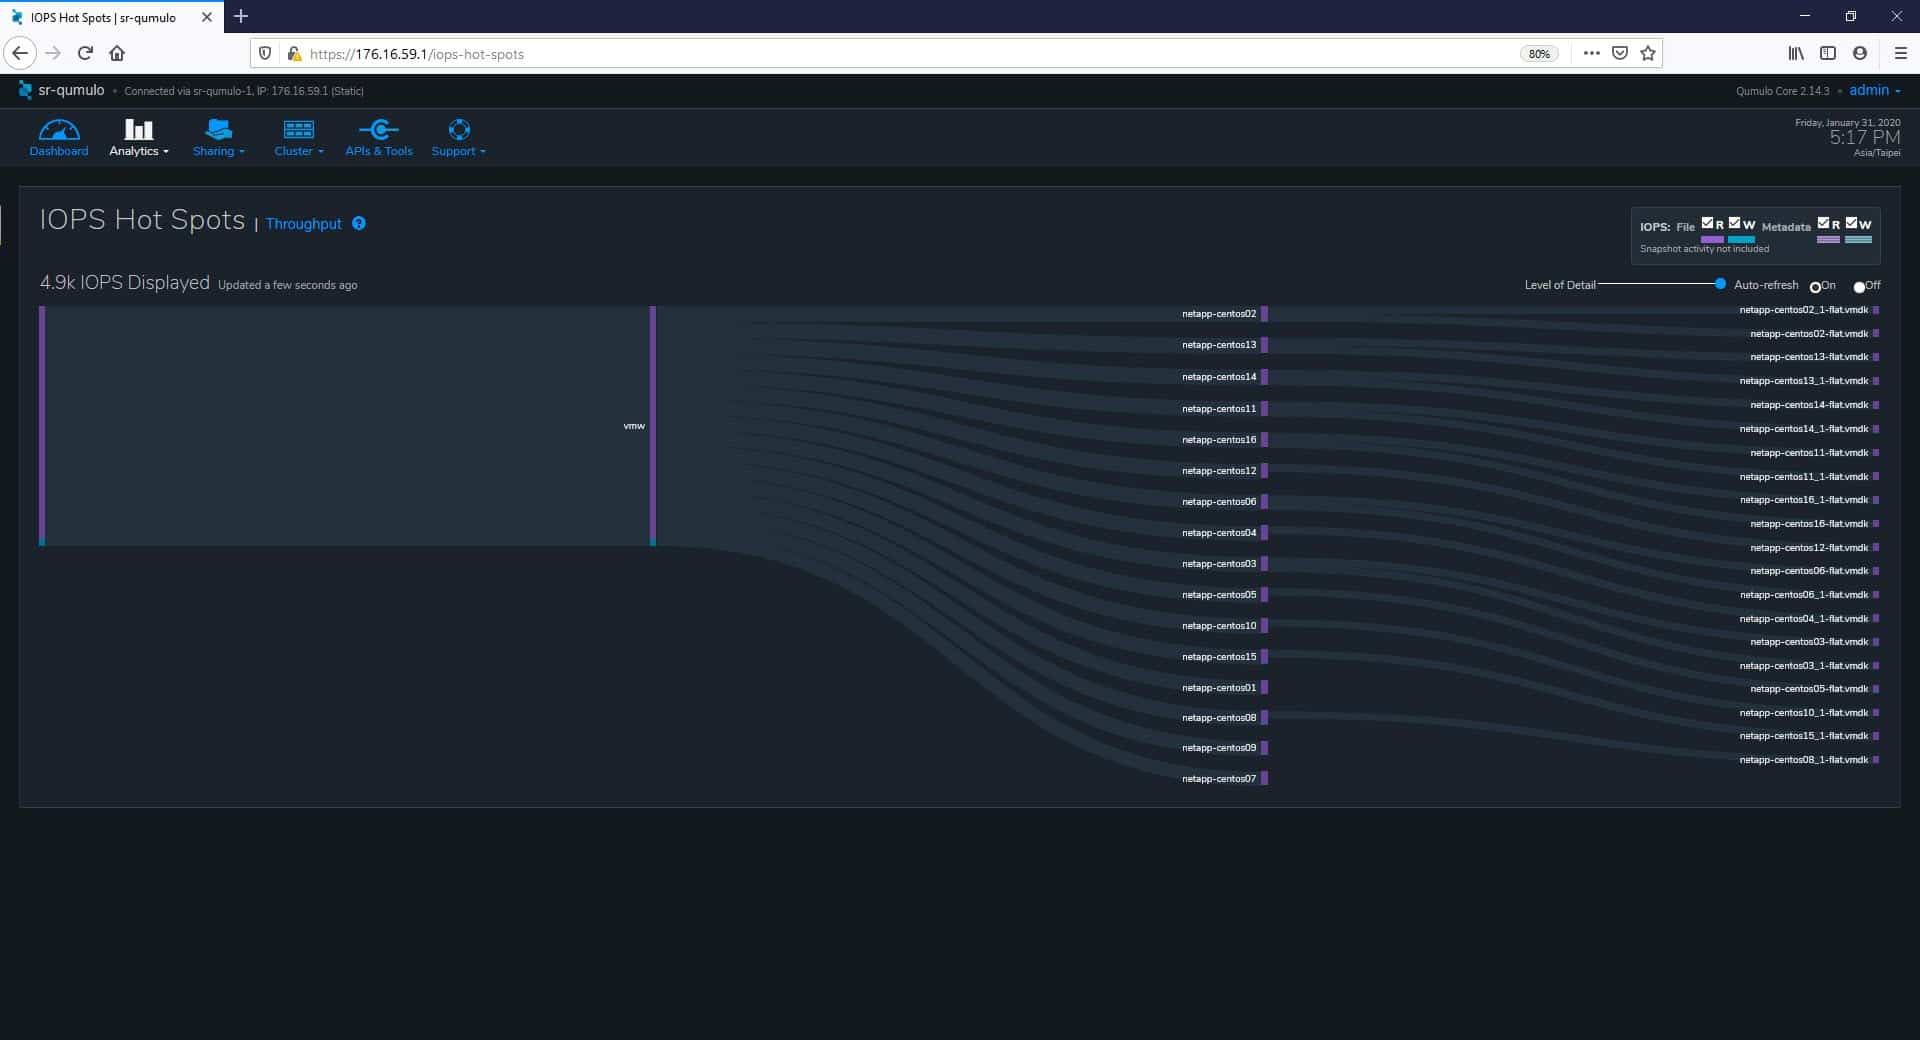
Nästa avsnitt som vi utforskade under fliken Analytics är Aktivitet, där vi kan hitta Hotspots för genomströmning, IOPS Hot Spots, Klienter och Paths. Sidan IOPS Hot Spots låter oss identifiera in-/utdata per sekund hotspots i vårt lagringssystem. Grafen visar de mest aktiva katalogerna när det gäller läs-/skrivoperationer för filer och metadata. Detaljnivån för dessa data kan justeras med hjälp av reglaget längst upp till höger i grafen. Ett bra alternativ för att pausa displayen är också tillgängligt, från alternativknappen Auto-refresh.
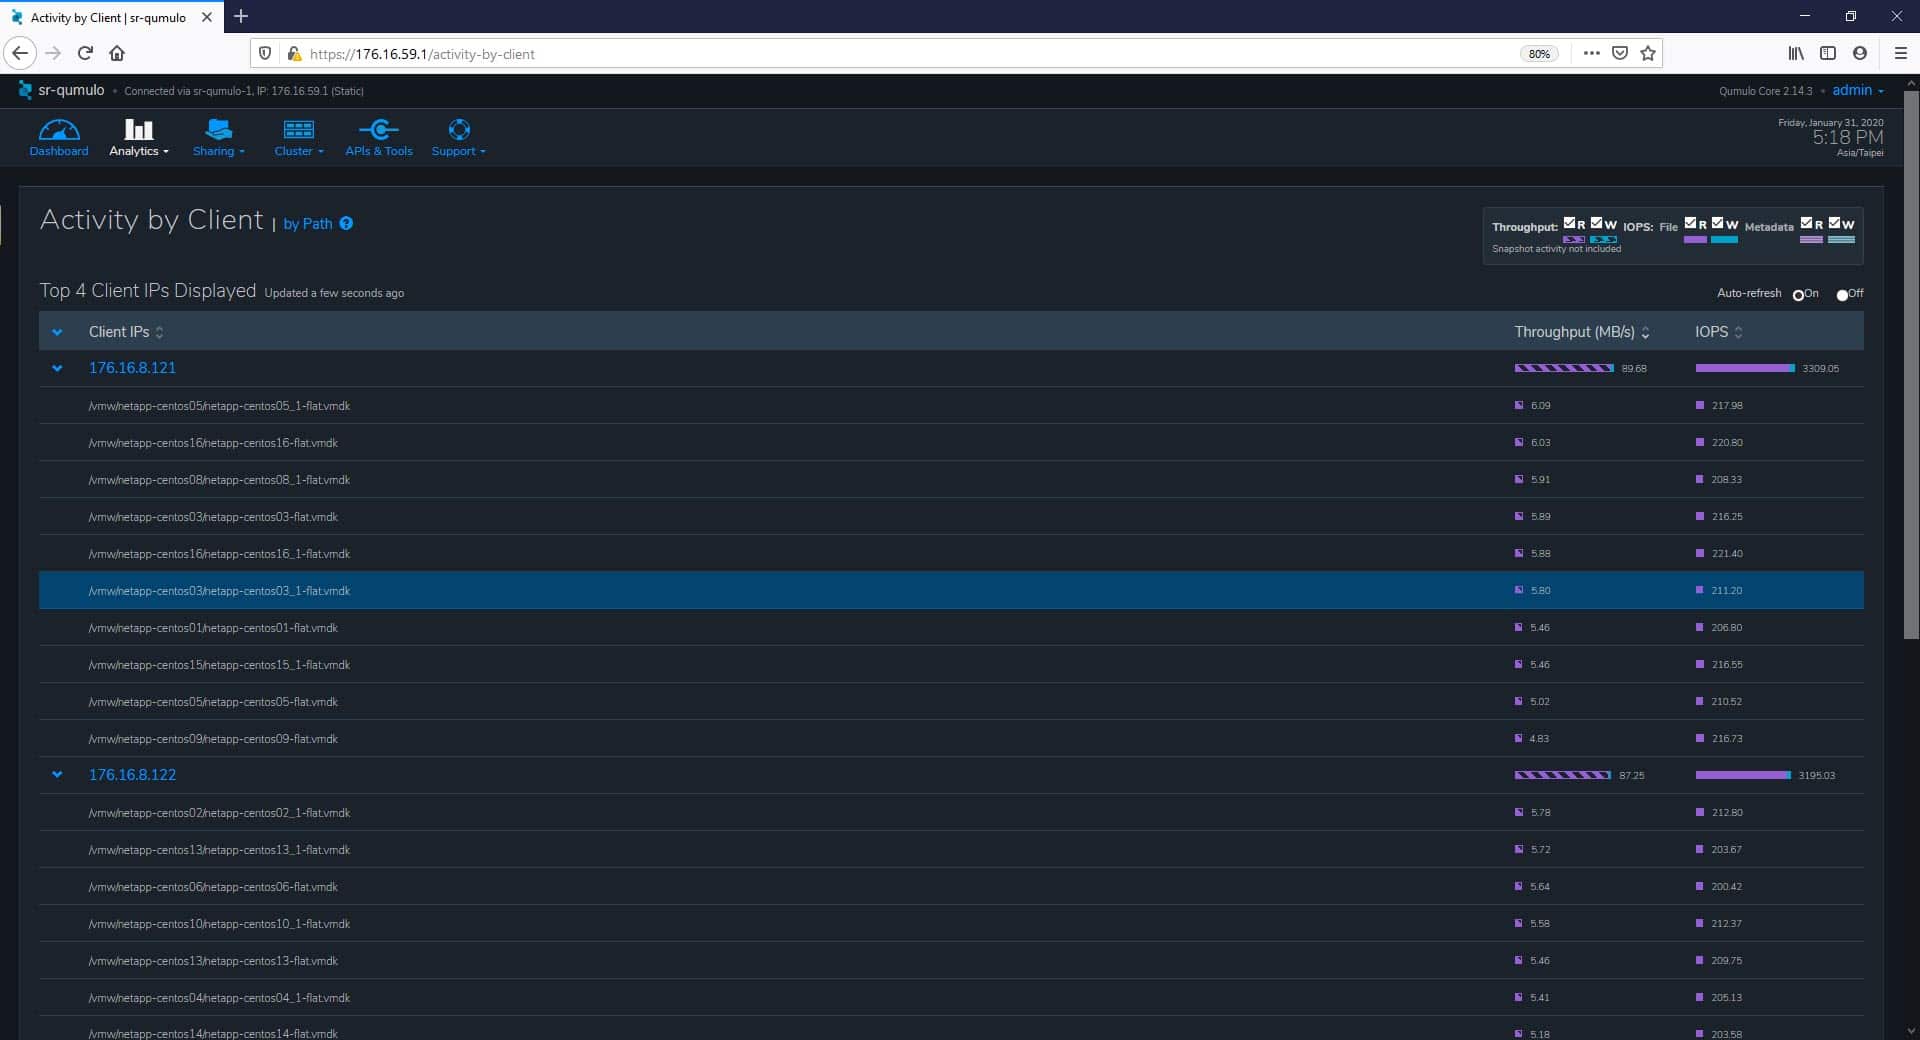
Vi kan också övervaka kundaktivitet. Analysen låter oss se vilka kunder som är mest aktiva när det gäller genomströmning och IOPS.
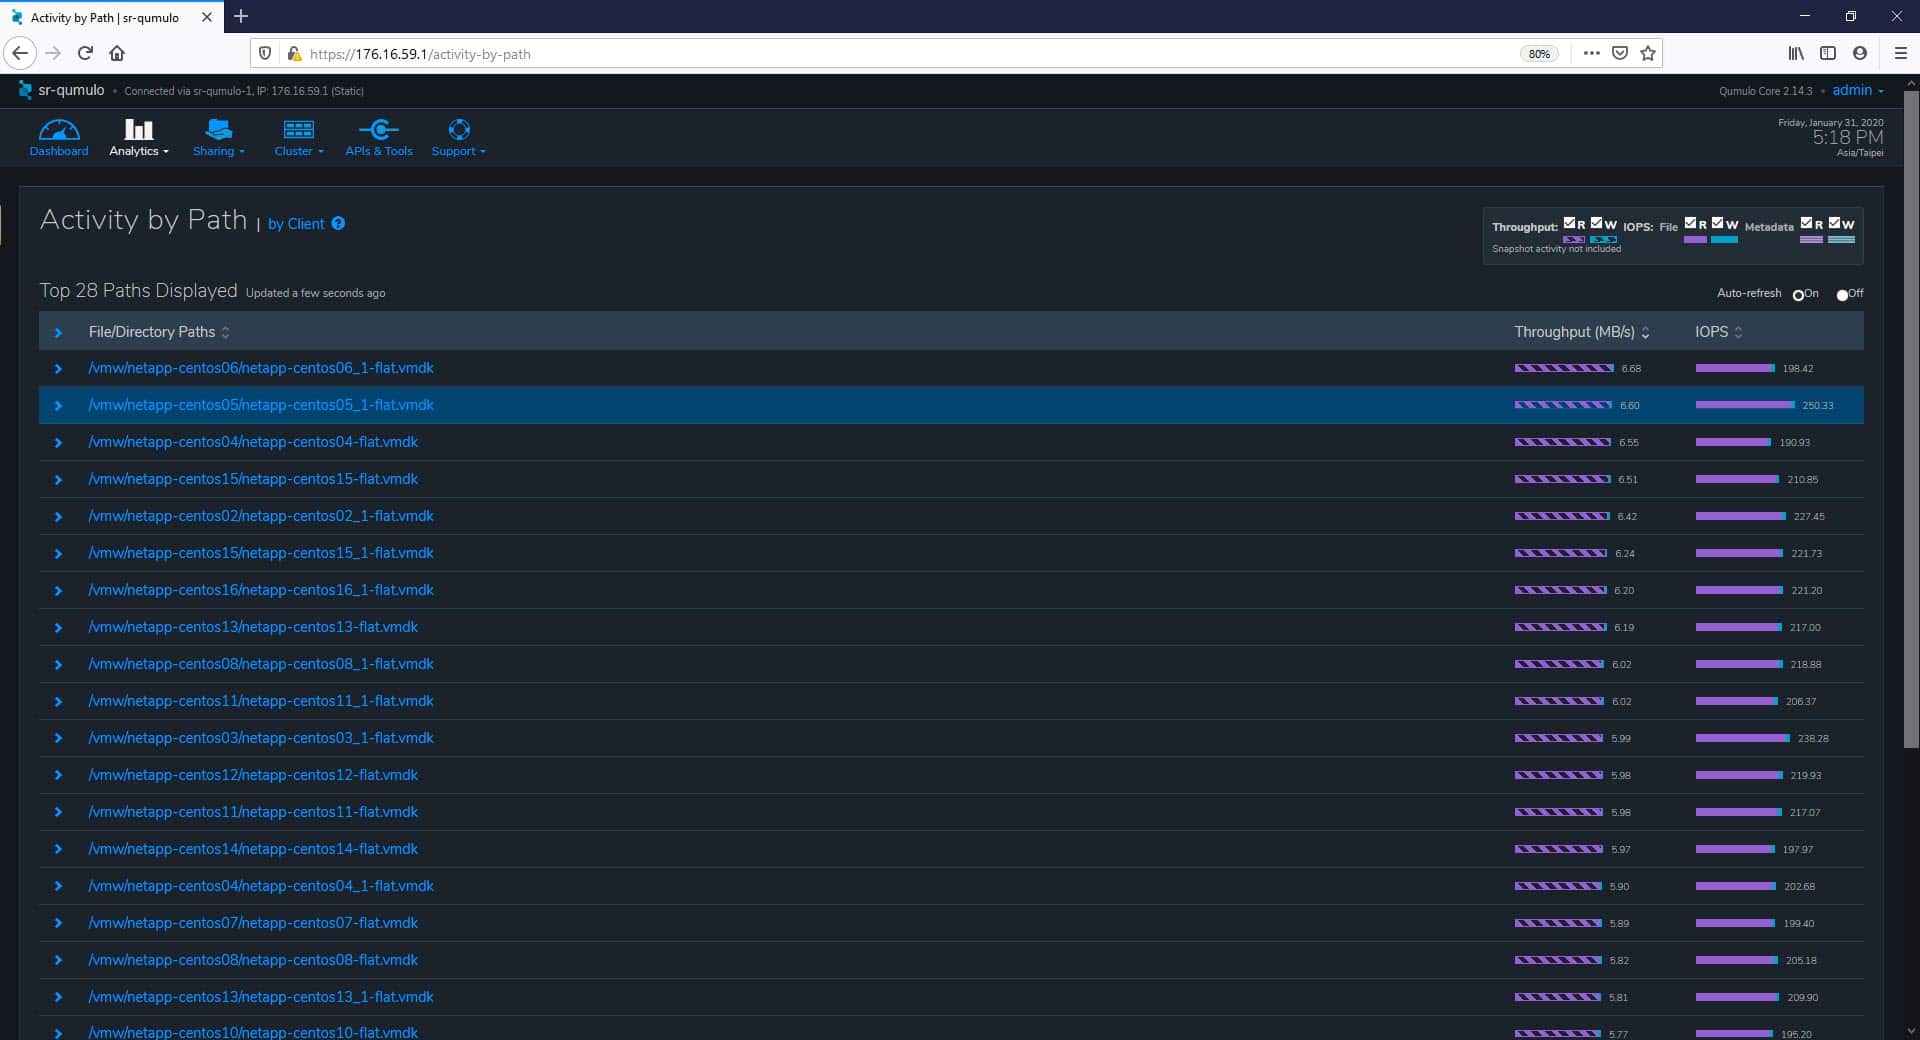
Och även molnövervakar vi aktivitet via Path.
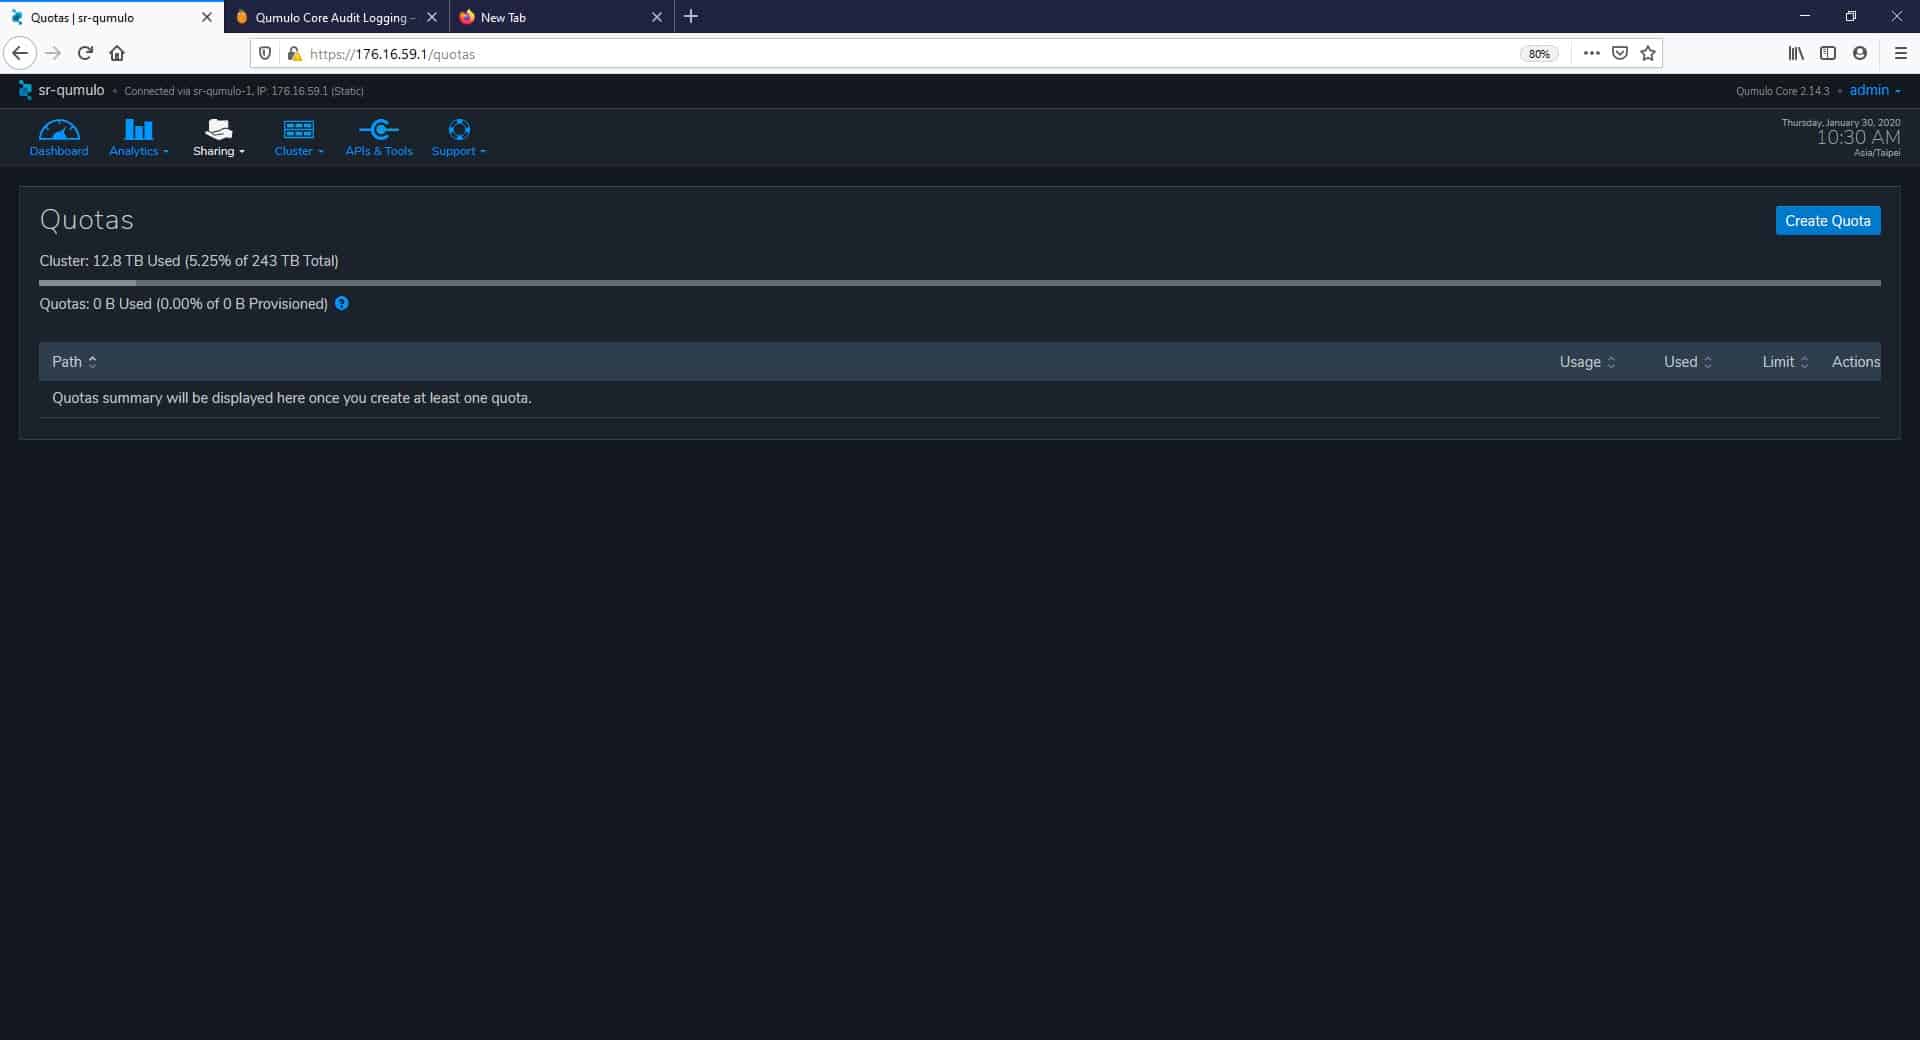
Nästa flik i huvudmenyn är Delning, och här är den första sidan vi analyserar Quotas. Qumulo möjliggör kapacitetskvoter i realtid, vilket låter administratörer specificera hur mycket kapacitet en given katalog får använda för filer. Från den här sidan kan vi skapa, redigera eller ta bort kvoter.
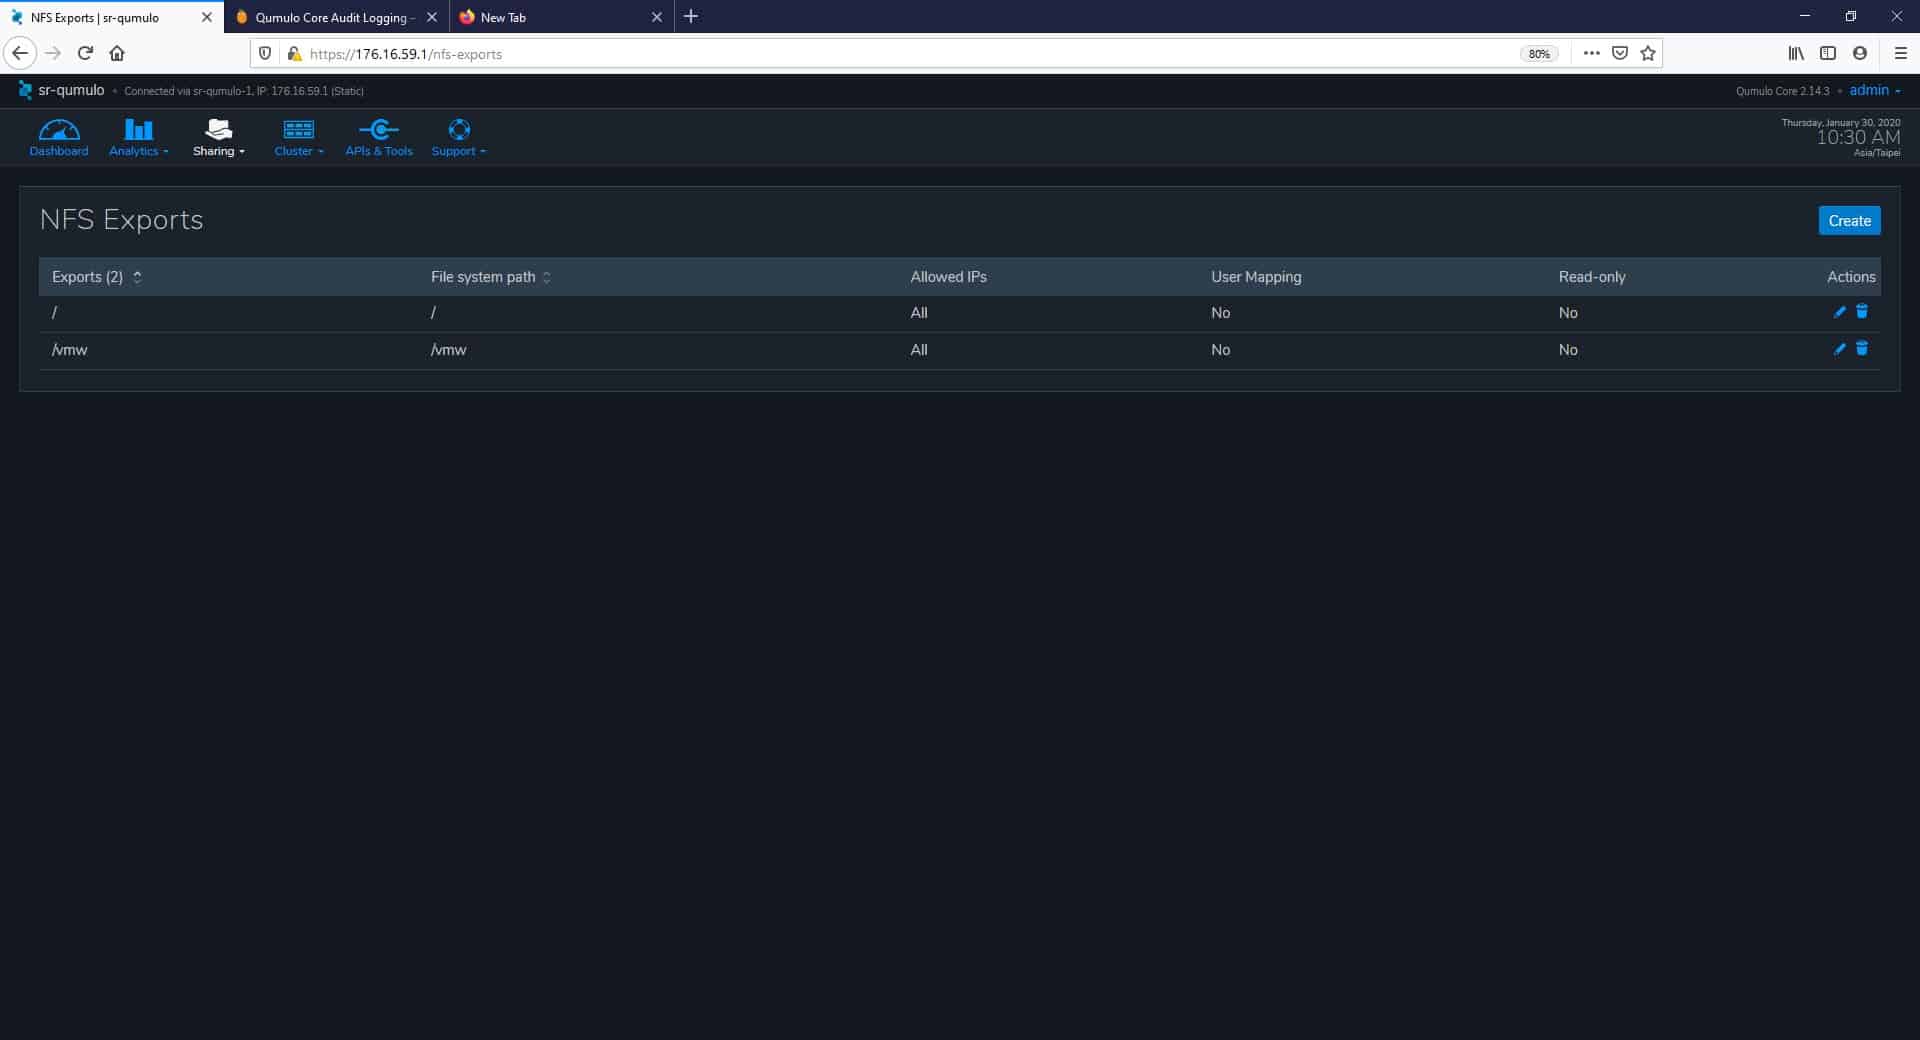
De följande två sidorna är NFS-exporter och SMB-delningar som tillåter klienter att dela data som lagras i en viss katalog. Under NFS Exports, till exempel, kan vi skapa nya exporter, samt redigera och ta bort dem.
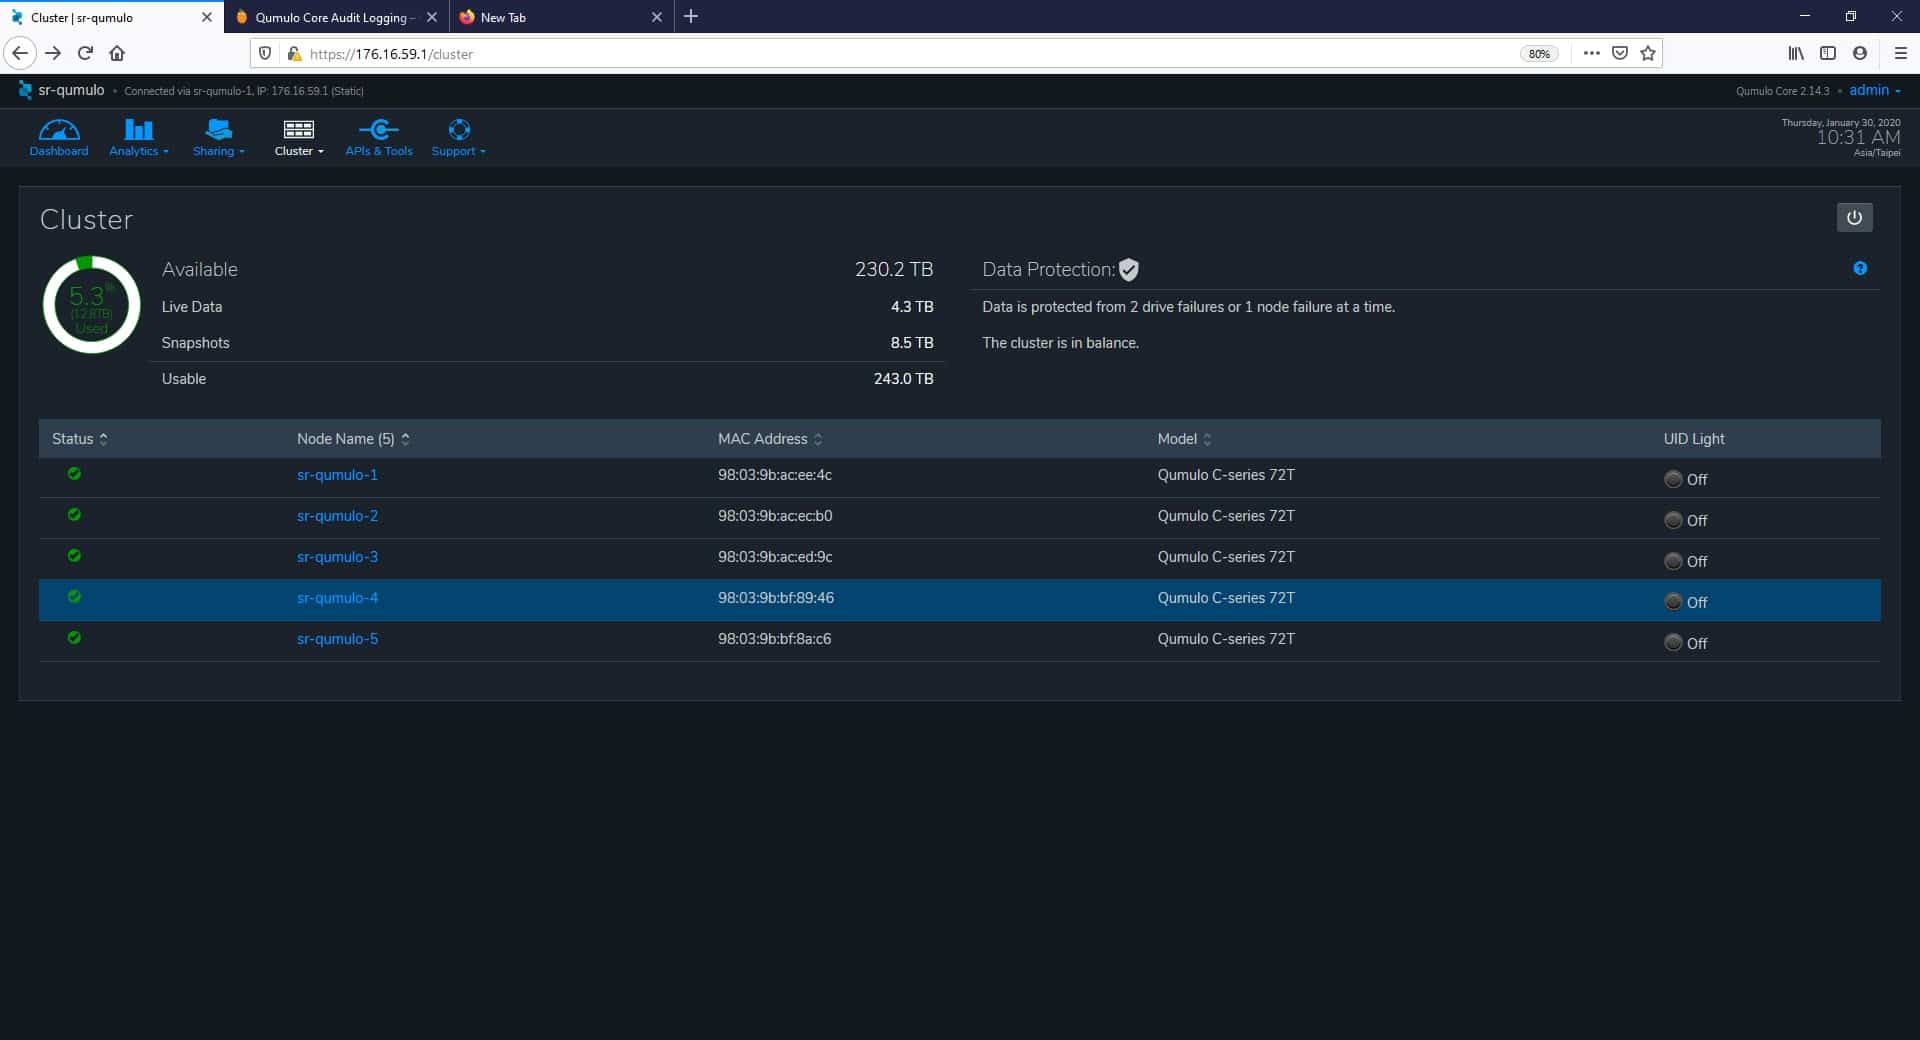
Nästa upp i huvudmenyn är Cluster. Under menyn Cluster hittar vi olika konfigurationer och alternativ relaterade till klustret och systemet i stort. På den första sidan, Översikt, har vi viktig kapacitetsinformation om vårt kluster och dess noder.
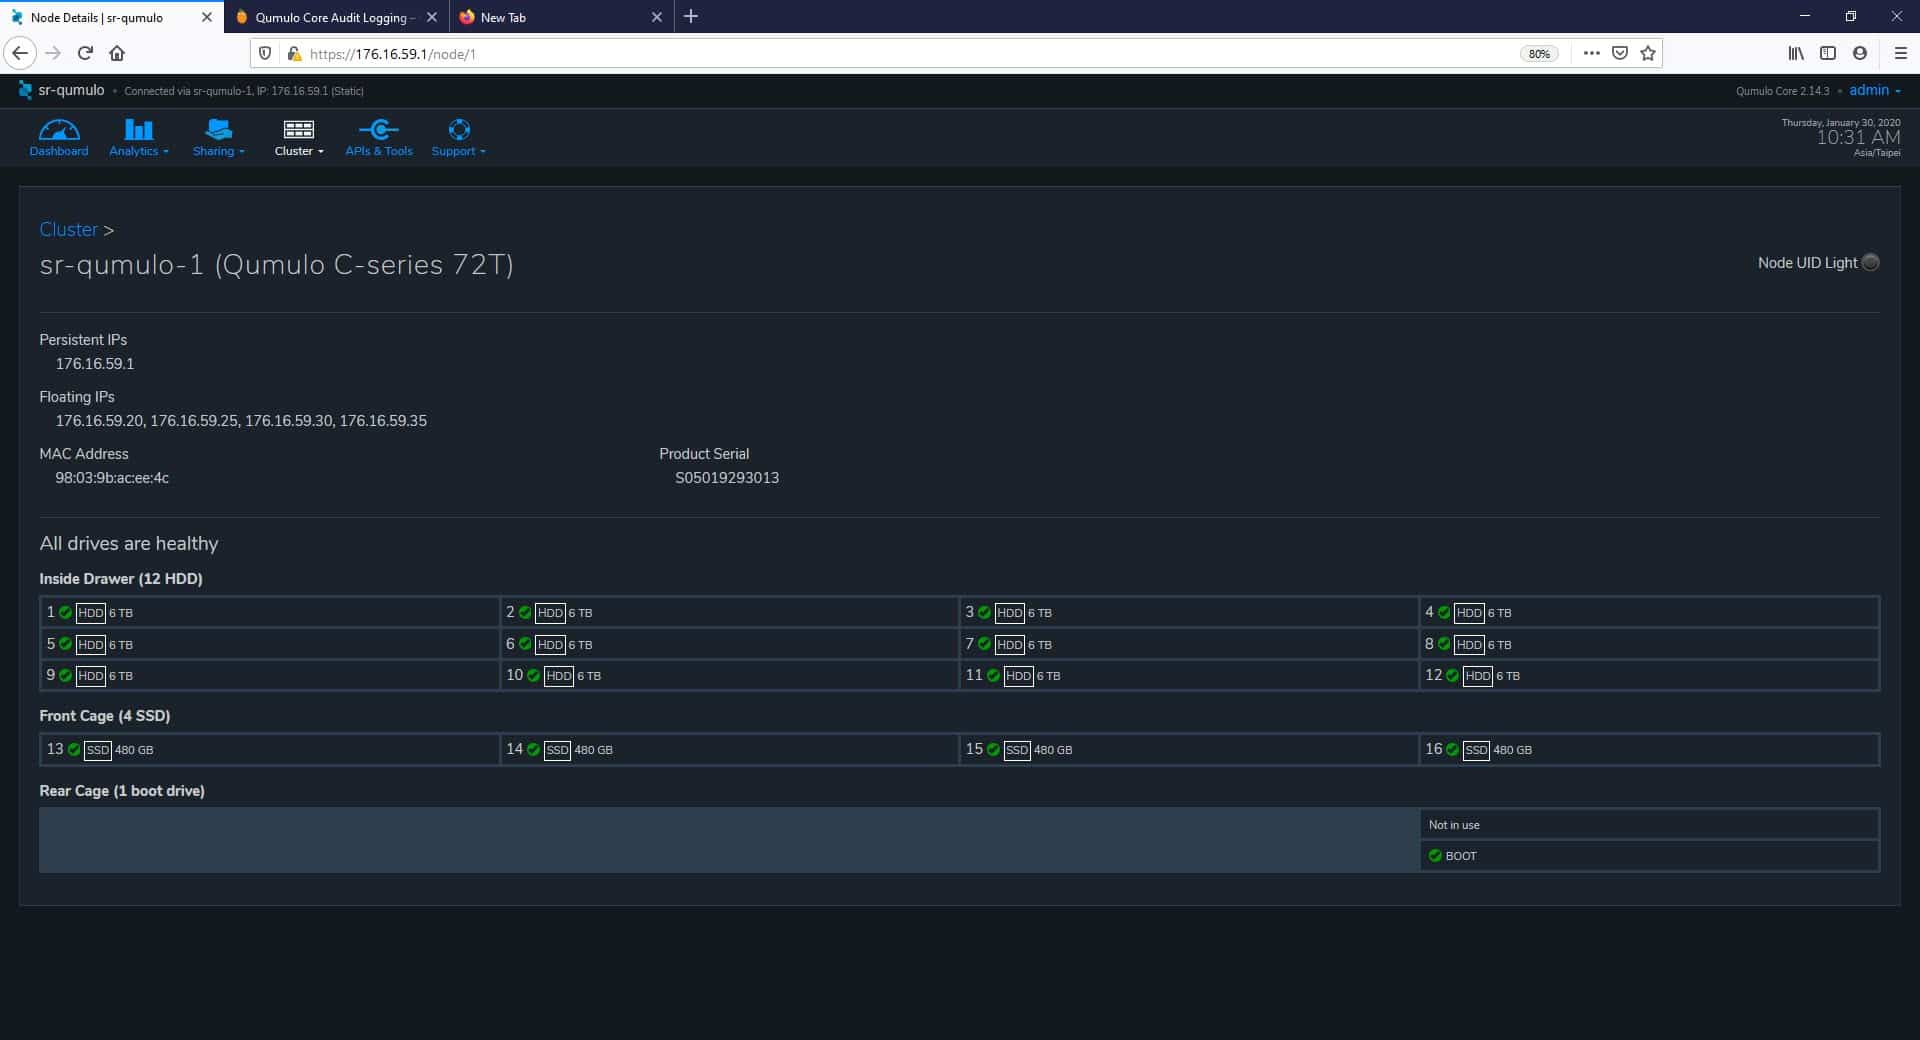
Genom att klicka på en av noderna kan vi borra ner i mer specifika hårdvarudetaljer. Som ett exempel klickar vi på noden "sr-qumulo-1" för att upptäcka relevant nätverksinformation och drivande hälsostatus.
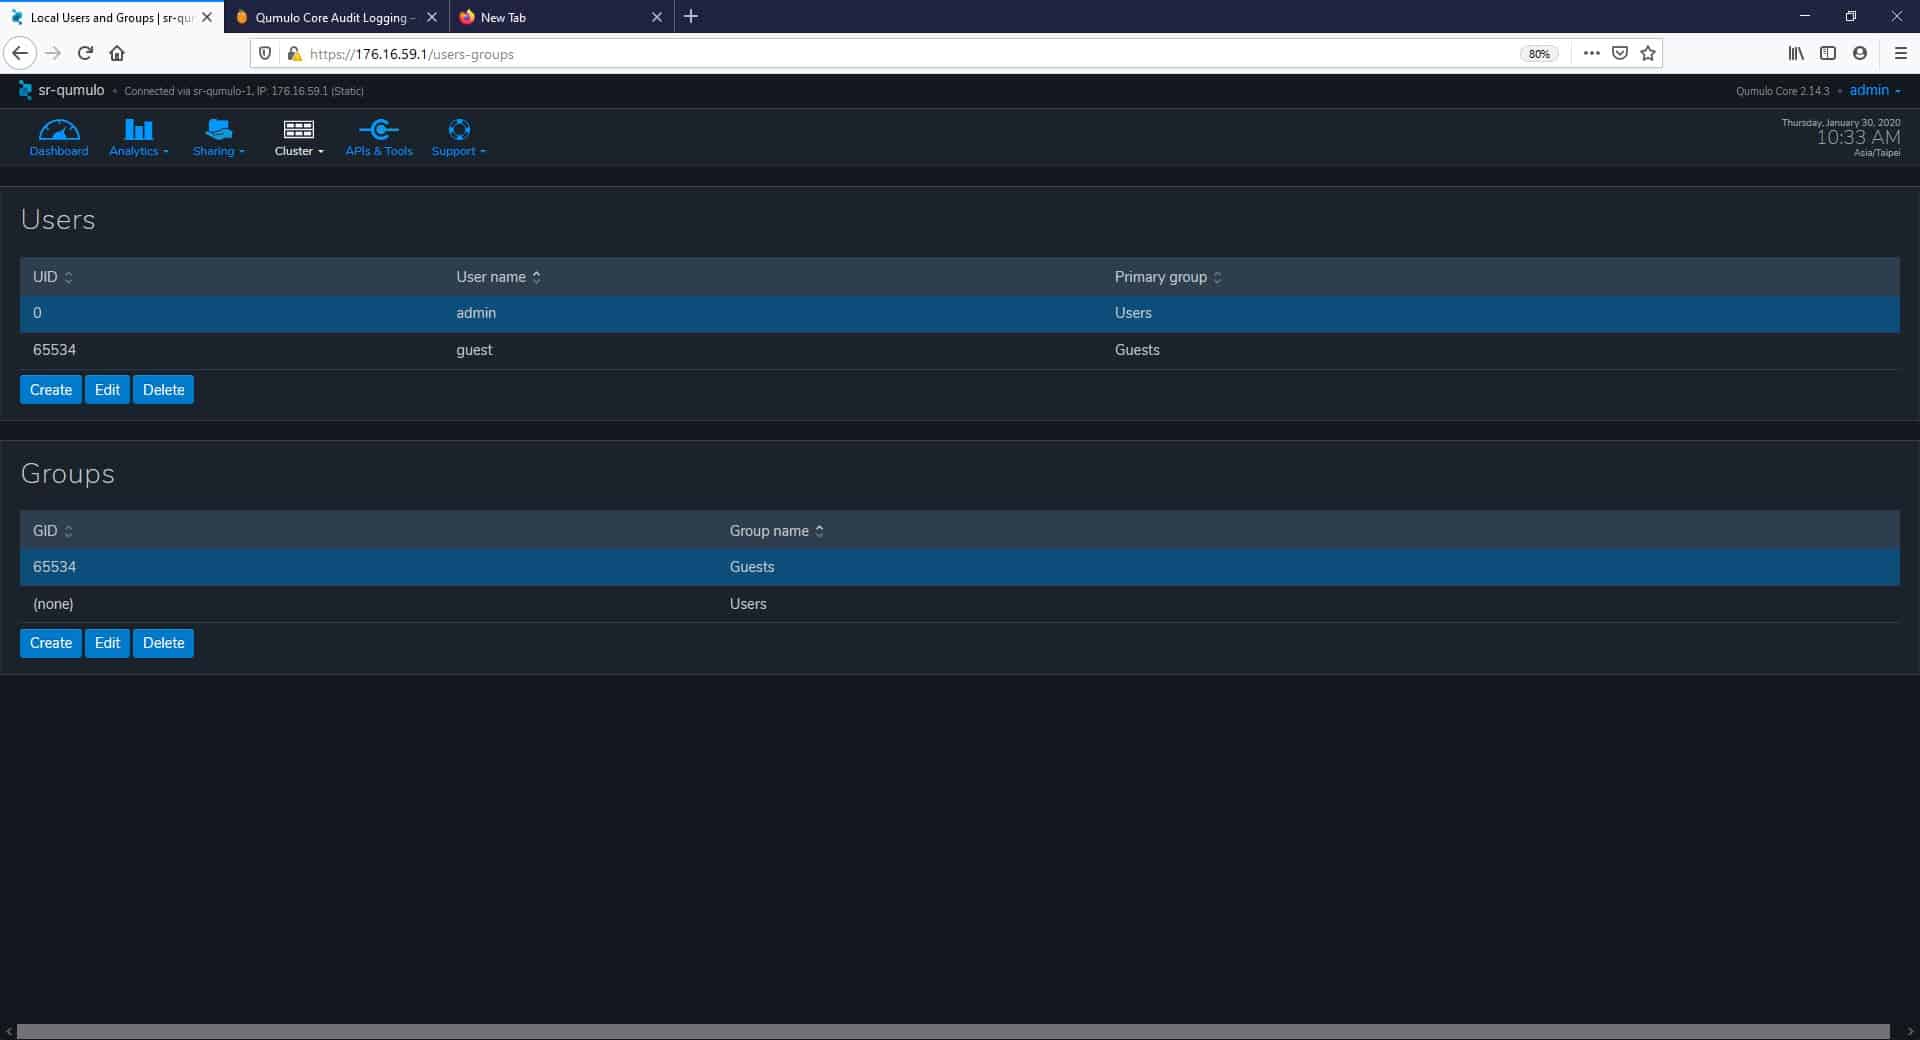
Under klustermenyn hittar vi även kritiska lagringsfunktioner som ögonblicksbilder och replikering. Och fler alternativ, inklusive nätverkskonfiguration, byta namn på klustret, lägga till en ny värd i klustret och mer. Ställ även in FTP- och SMB-protokollen. Slutligen, på den här menyn, kan vi hantera autentisering och auktorisering. Bilden nedan visar sidan Lokala användare och grupper som ett exempel.
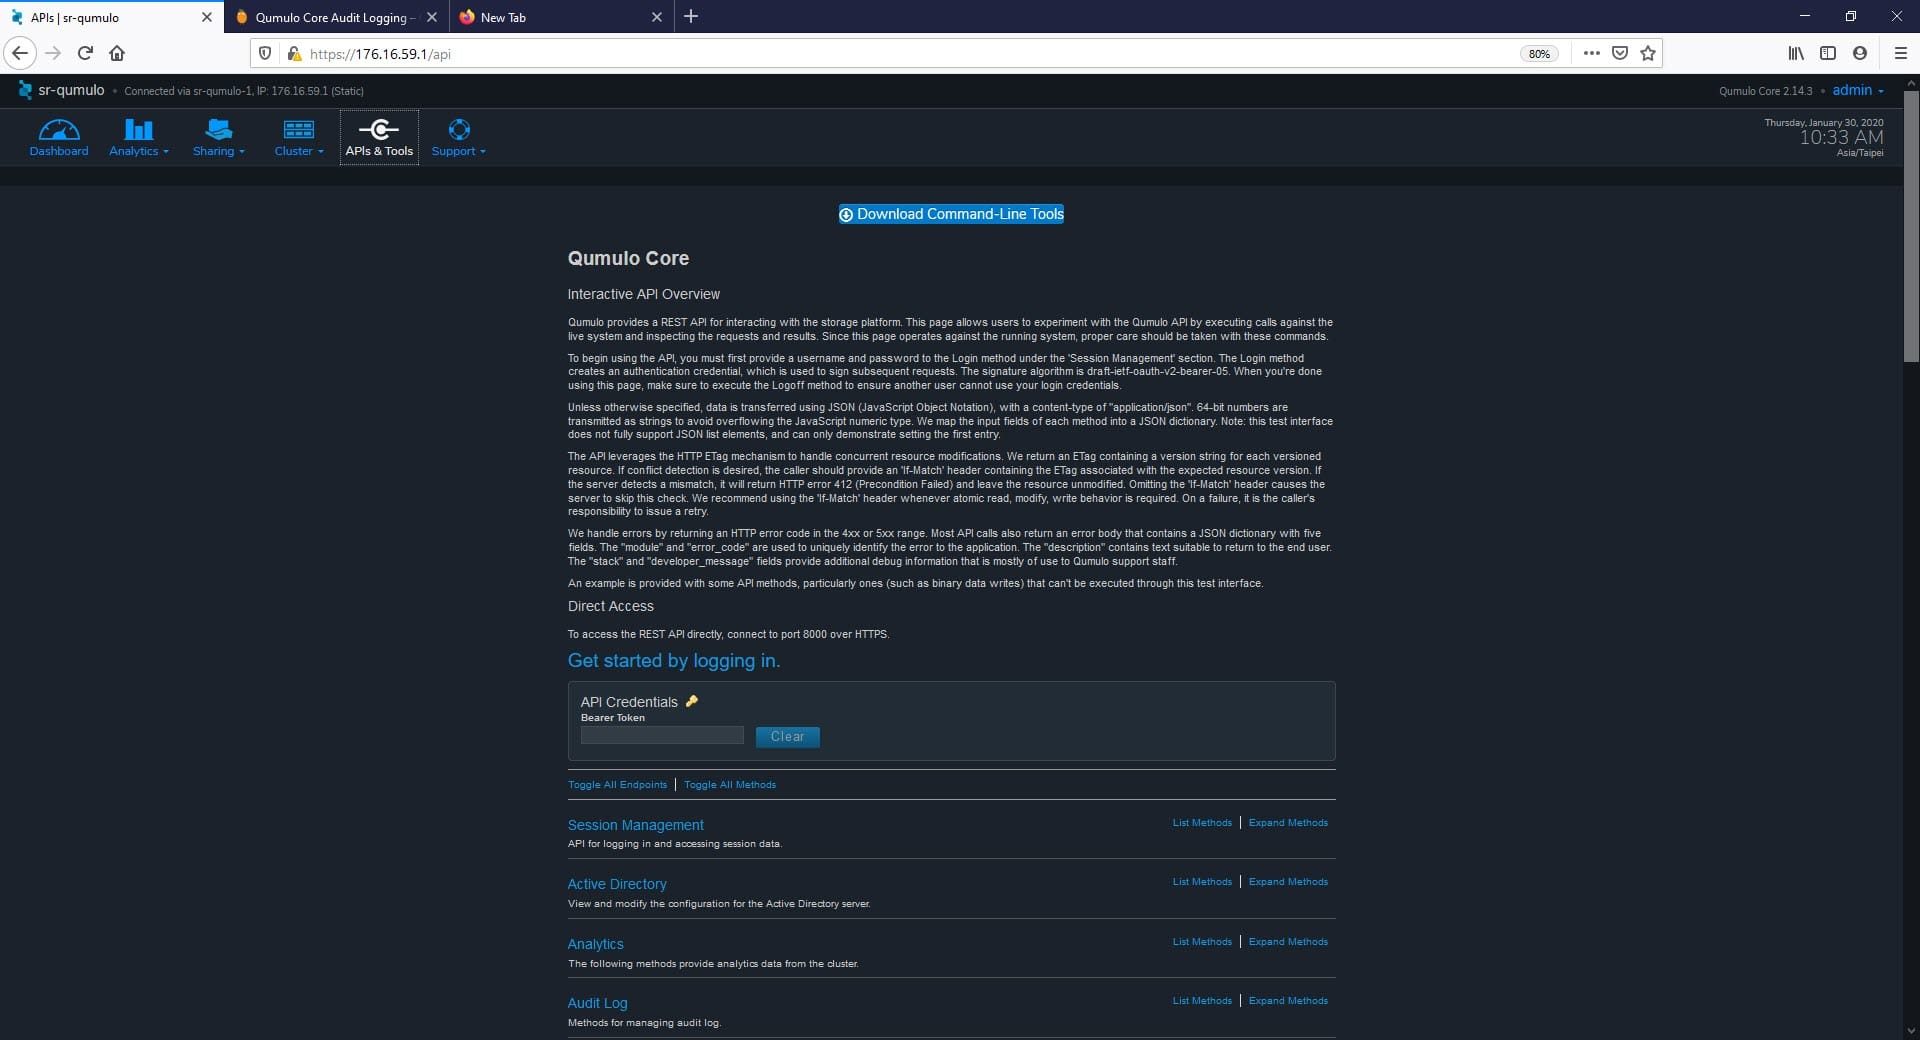
Från fliken API och verktyg kan vi komma åt Qumulo Core-sidan direkt i användargränssnittet. Här kan vi ladda ner python-klientbiblioteksinpackningar och CLI för Qumulo Core REST API.
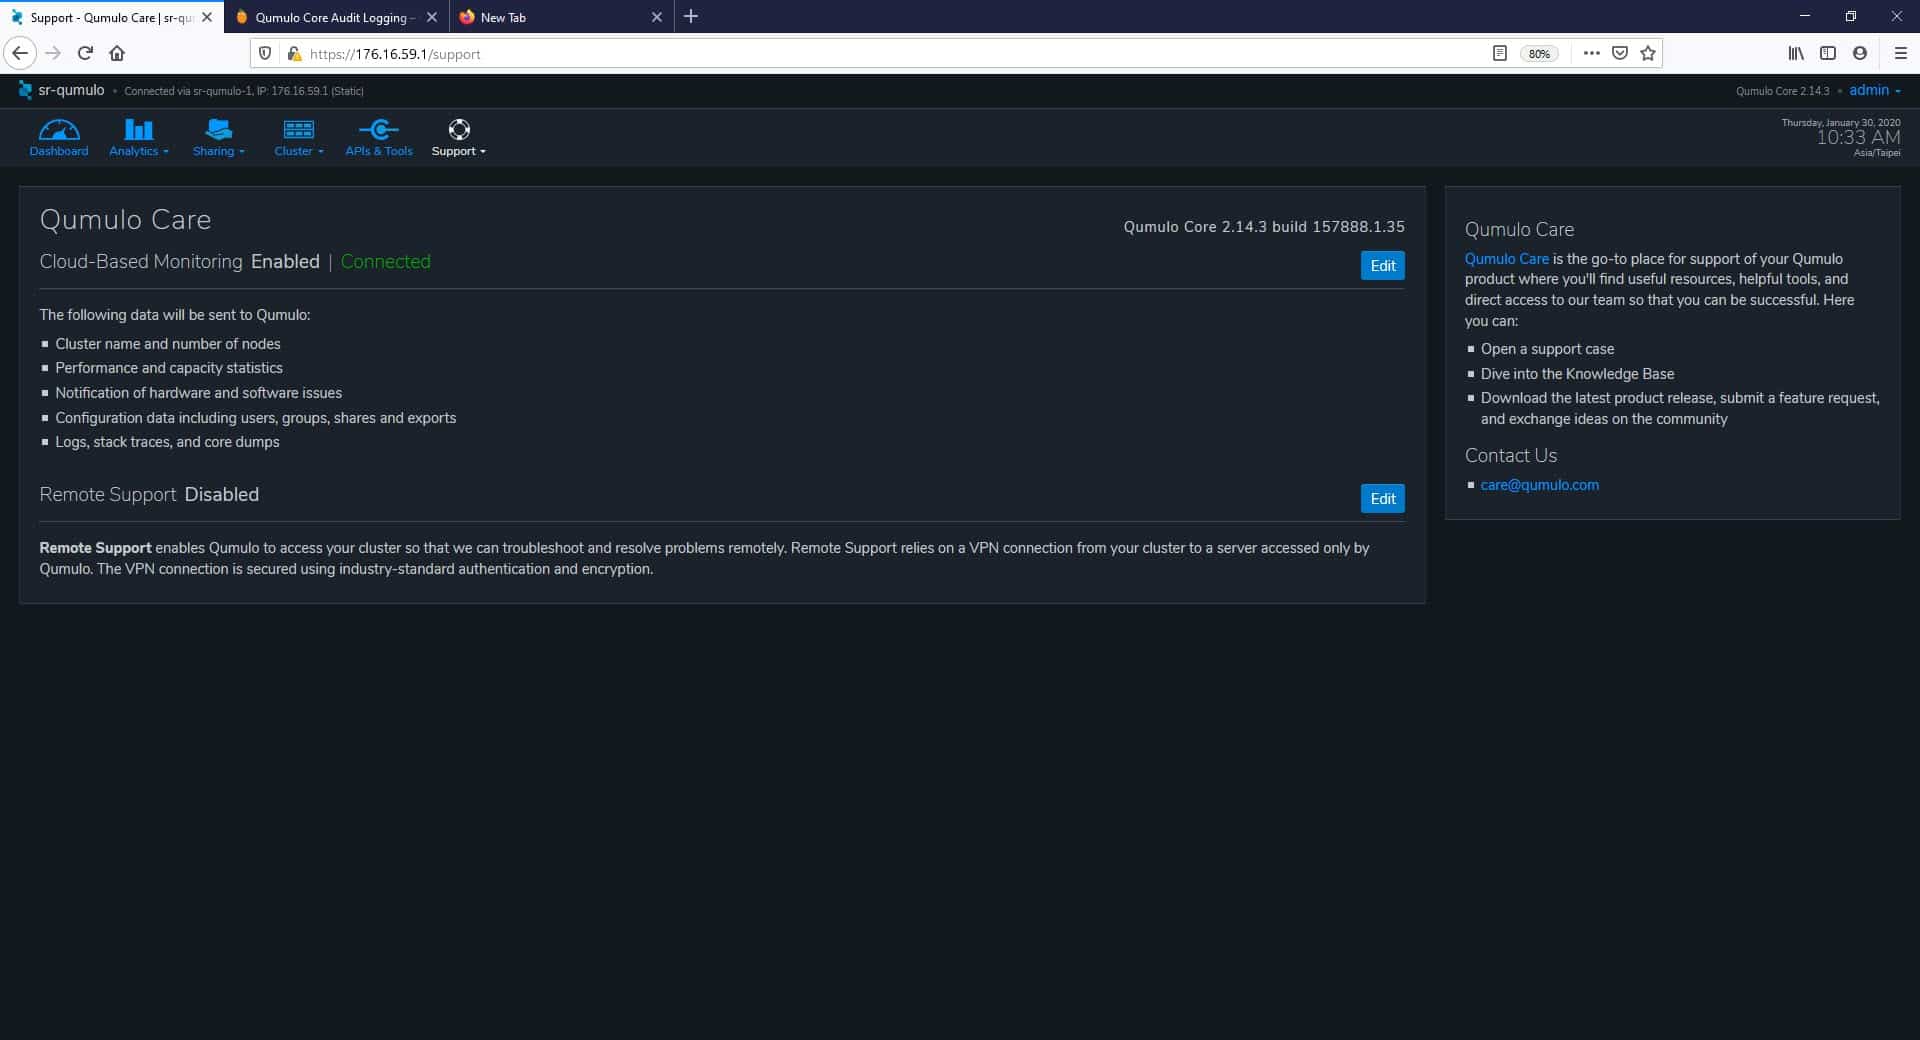
Den sista fliken i menyn är Support, och den första sidan vi hittade här är Qumulo Care, en molnbaserad övervakningstjänst som vi kan aktivera för att skicka data till Qumulo. På så sätt kunde Qumulo-teamet felsöka bättre och påskynda alla klusterrelaterade problem.
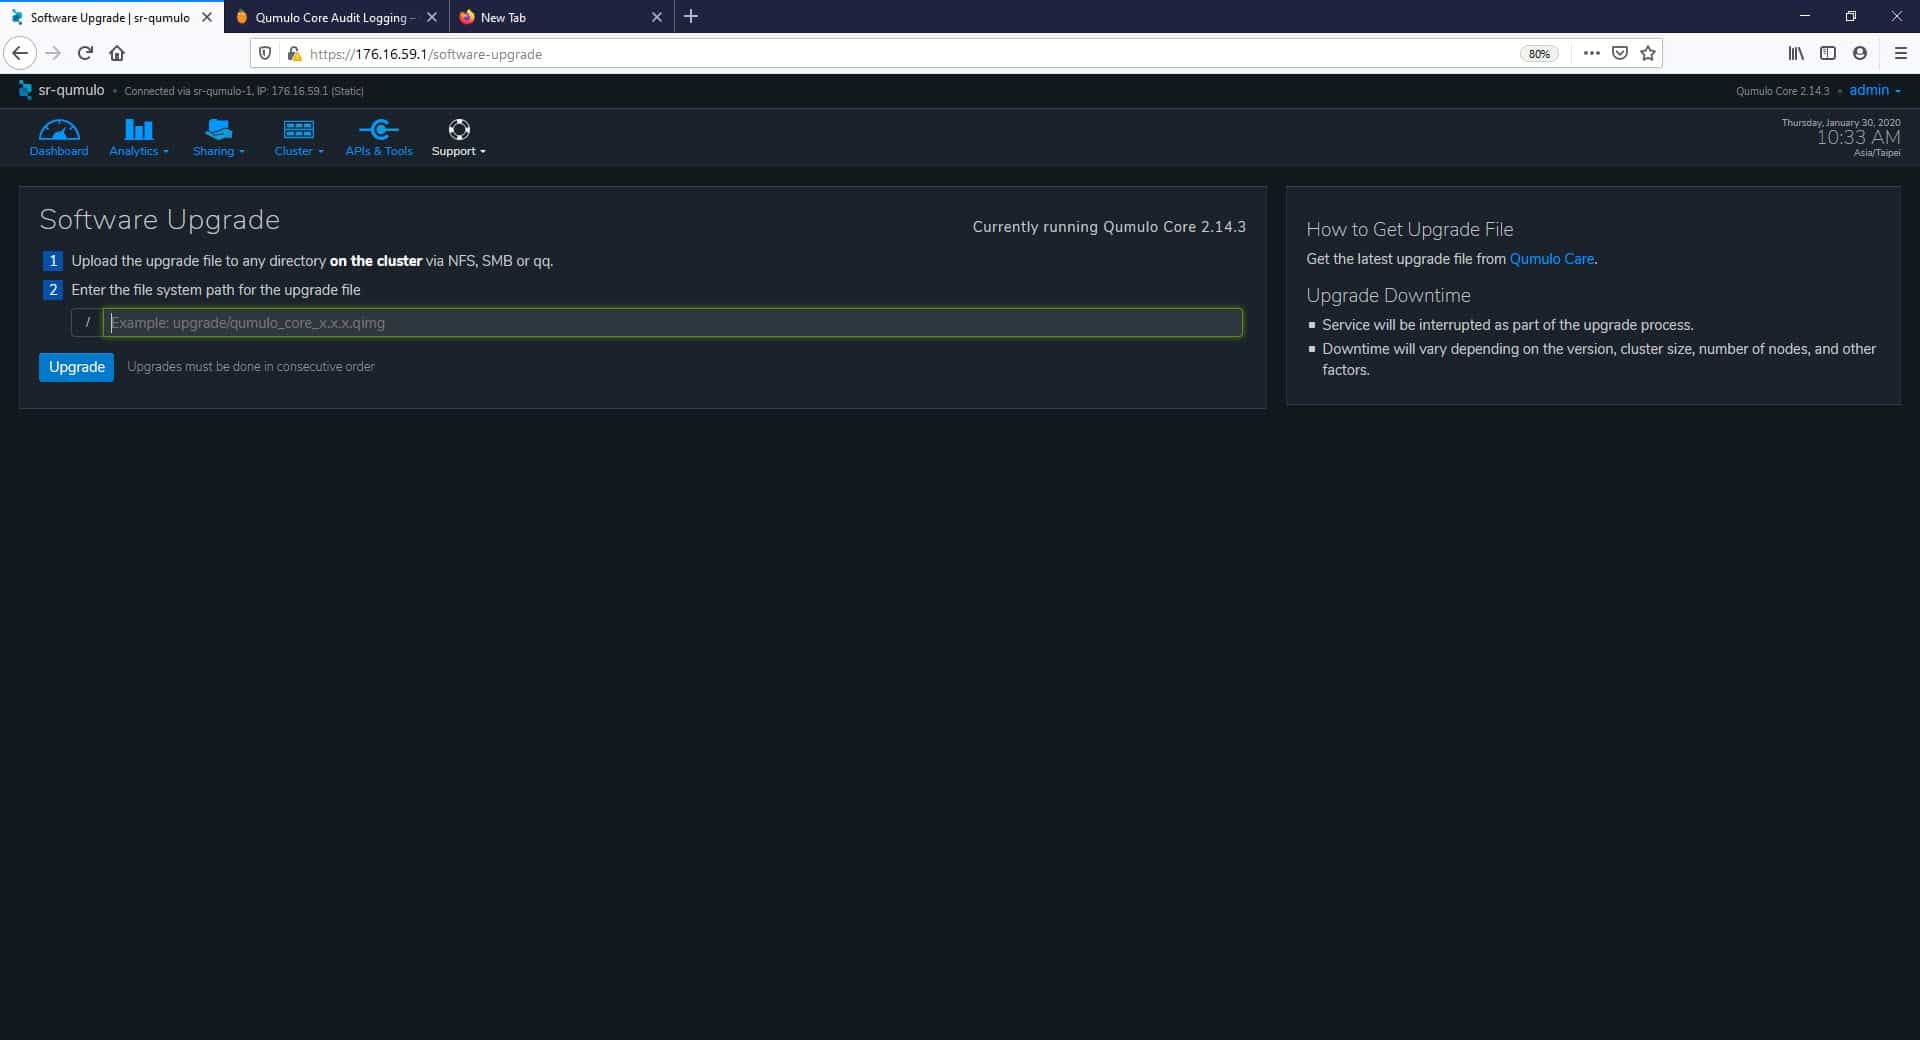
Slutligen, på menyn, har vi sidan Software Upgrade.
Slutsats
För att förnya sig är organisationer beroende av ostrukturerade dataplattformar och datamedveten lagring, som är dåligt betjänad av tillgängliga lösningar. I den här recensionen studerade vi Qumulo File System, utvecklat för att erbjuda ostrukturerad data i alla miljöer. Qumulo är bland pionjärerna inom datamedveten lagring och molnfildatatjänster, med sin unika mjukvarudefinierade lösning för hybridmolnet.
I det sista avsnittet av den här artikeln tog vi en titt på Qumulos webbgränssnitt. Tidigare har vi överblickat grafiska användargränssnitt (GUI) för några av de mest populära server- och lagringsenheterna, och den här gången var vi glada över att få en överblick över Qumulos färska GUI. Vid första anblicken blir vi medvetna om det här GUI:s eleganta design, den utmärkta användarupplevelsen och hur enkelt det är med administratörens dagliga hantering.
Sammantaget ger Qumulos mjukvara sina kunder en exceptionell uppsättning möjligheter, övervaknings- och planeringsverktyg. Mjukvaran förenklar resan till molnet. Den stöder datarörelse med lift-and-shift molnmigrering samtidigt som den tillhandahåller kraftfull realtidsanalys för att upptäcka och få omedelbar insikt i vad som händer med vår värdefulla data.


 Amazon