

Seit Jahren ist automatisiertes Storage Tiering (Speicherschichtung) eine unverzichtbare Lösung für Unternehmen, die ihren Rechenzentrumsfußabdruck effizient verwalten and gleichzeitig die Gesamtbetriebskosten (TCO) senken möchten. Strategin är enkel: Man använder algoritmer och riktlinjer med automatisk tidsstyrning och håller den aktiva informationen på de primära uppgifterna, medan de inte är aktiva i den kostnadseffektiva Speicherkategorien. In den letzten Jahren har sich Cloud Tiering som en robust, kostnadseffektiv Lösung herauskristalliserad, die Verlagerung inaktiverad Daten auf kostengünstige Objektspeicher in der Cloud förbrukad. Med ThinkSystem DM-seriens ermöglicht Lenovos företag för förvaltning av Daten och Cloud-alternativ med en intelligent speicherlösung. Diese Cloud-Strategie befasst sich erfolgreich mit Kapazität, Agilität und Sicherheit in Hybrid-Cloud-Umgebungen, ohne die Verwaltbarkeit, Sicherheit eller Leistung zu beeintrechtigen.
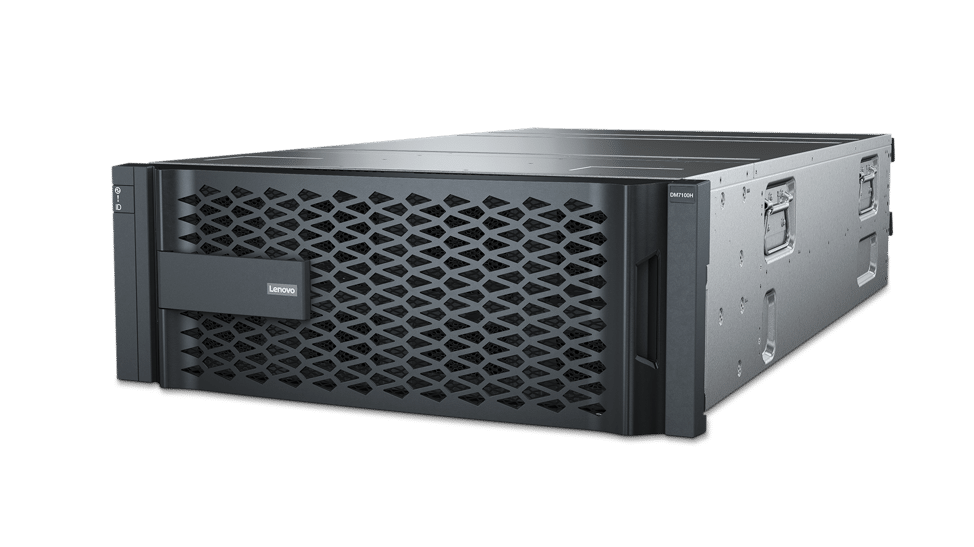
Denna artikel beskrivas som Lenovo ThinkSystem Speicherlösungen och DM-serien är en End-to-End-strategi för Rechenzentren, från Vor-Ort-installationen i molnet. Zunächst werden wir enige grundlegende Konzepte zur Datenspeicherung, zum Cloud Tiering och zu nya Herausforderungen beim Speichermanagement ansprechen. Wir werfen einen Blick auf das Datenmanagement-Ökosystem von Lenovo und darauf, wie sich das Unternehmen mit der DM-Serie auf dem Speichermarkt hervorhebt. Se till att det finns en precision Blick på ONTAP-programvaran och FabricPool-Storage-Tiering-Richtlinien. Och schließlich tid från unserem Labor från die Einrichtung och Validierung der Cloud-Tiering-Lösung av Lenovo.
In einem traditionellen Rechenzentrumsmodell beginnt ein wachsendes Unternehmen mit dem Sammeln kritischer Daten und Dateien in seinen Räumlichkeiten. Diese Daten sind jedoch irgendwann veraltet und es wird nur noch selten auf sie zugegriffen, wodurch wertvolle Leistung und Kapazität des primären und sekundären Speichers in Anspruch genommen wird, was sich auf kritische Arbeitslasten auswirkt. Die Archivierung dieser Daten war in der Vergangenheit eine praktische Lösung für Unternehmen; dadurch stehen die Daten jedoch nicht sofort zur Verfügung, wenn sie plötzlich benötigt werden.
Dieses Problem hat bei IT-Organisationen das Bewusstsein dafür gewickt, Speicherebenen mit unterschiedlichen Kapazitäts-, Kosten- und Leistungsmerkmalen in Betracht zu ziehen. Darüber hinaus müssen sie die Anforderungen an das Datenwachstum über mehrere und Cloud-Umgebungen hinweg anerkennen und darauf vorbereitet sein, diese zu erfüllen. Cloud Tiering ist die Antwort, and es must in modernen Speicharchitekturen berücksichtigt werden. Andernfalls wird ein wachsender Datenfußabdruck die Investitionen des Unternehmens in hochleistungsfähige Primärspeicher in seinem Rechenzentrum überfordern.
Die Cloud als Speicherstufe
Wenn fortschrittlichere Technologien zugänglich werden, können besthende Speicherebenen nach Bedarf transformiert and weitere hinzugefügt were, um die mehrstufige Speicherarchitektur weiter zu diversifizieren. Die Cloud hat IT-Organisationen neue Möglichkeiten eröffnet, indem sie Speicherlösungen von öffentlichen Cloud-Anbietern als zusätzliche (untere) Ebene ermöglicht. Wenn sie gut konzipiert und ausgeführt wird, ist die Cloud eine ausgezeichnete und kostengünstigere Lösung as eine niedrigere On-Prem-Tier-Lösung.
Auf primären Speicherebenen, die Flash für extrem hohe Leistung nutzen, könnten etwa 50% der kalten Daten der Cloud zugewiesen werden. Snapshot-Kopien och unstrukturierte Daten gehören häufig in diese Kategorie, einschließlich unternehmenskritischer Anwendungen. Auf sekundären Ebenen können bis zu 90 % der im Speicher befindlichen Cold-Daten aus Sicherungskopien stammen. All diese wertvollen Daten, auf die nur gelegentlich zugegriffen wird, könnten ebenfalls in die Cloud verschoben werden. Till den beliebten Cloud-Anbietern och -Diensten, die bereit sind, inaktiva data in die Cloud to verschieben, hören Azure Blob-Speicher, AWS S3 och Google Cloud Storage.
Wie beim automatisierten Speicher-Tiering vor Ort können wir Richtlinien und Regeln zur Verwaltung der Daten für die Cloud erstellen. Die Bedingungen erlauben es uns, Files direkt von vor Ort in die öffentliche Cloud zu übertragen. Die Richtlinien werden auf diverse Weise angewendet Beispielsweise können Daten auf der Grundlage der Dateierweiterung, von Mustern, die im Dateinamen enthalten sind, or danach, who often inerhalb onees bestimmten Zeitraums auf die Datei zugegriffen wird, verschoben were. Denna letzte Option ist wahrscheinlich das best Szenario, bei dem Speicherdateien und -blöcke mit Temperaturwerten versehen werden, wobei neu geschriebene Daten als heiß och inaktive as kalt gekennzeichnet werden. Genom att implementera ener Reihe von Richtlinien für die Speicherausrichtung können kalte Daten schnell in die Cloud verschoben werden, indem Regeln nach Bedarf eller nach Zeitplan ausgeführt werden.
Neue Herausforderungen bei der Speicherverwaltung
Die Hauptherausforderungen, die heute auf dem Markt im Zusammenhang mit der Verwaltung von Hybrid-Cloud-Daten zu beobachten sind, besthen aus Volumen and Vielfalt, Datengeschwindigkeit and Datenintegrität.
Das Datenvolumen wächst nahezu exponentiell. IT-Organisationen müssen nicht nur das Datenwachstum in den Griff bekommen, sondern auch das Datenwachstum und die Datenverwaltung in verschiedenen Umgebungen. Die Menge und Vielfalt der erzeugten Daten ist nach wie vor überwältigend. Ohne die Möglichkeit, diese data in einer Hybrid-Cloud-Lösung zu speichern, zu kategorisieren och zu verarbeiten, entgehen Unternehmen wichtige Erkenntnisse über ihre Kunden och ihr Geschäft. Darüber hinaus wird vorhergesagt, dass das Datenvolumen bis 2025 um das 10-fache (ca. 163ZB) ansteigen wird, angetrieben durch IoT und Spitzentechnologie. Wenn Daten das wertvollste Gut sind, müssen sie mit Sorgfalt behandelt werden und in der Lage sein, Erkenntnisse für gezielte Entscheidungen zu liefern und gleichzeitig einen Blick in die Zukunft zu ermöglichen. Darüber hinaus ist es für die Kaufentscheidungen der Kunden von entscheidender Bedeutung, effizientere Wege zur Verarbeitung dieser Daten zu finden, um sie in einen Wert umzuwandeln.
Auch IT-Bedrohungen entwickeln sich weiter – und die Sicherheit der Infrastruktur ist ein ständiger Kampf. En bra sökningsstrategi är bäst där, en solid grundlag för att arbeta, när du vill, exakt för att veta, vill, vad och vilka uppgifter som är säkrade Ena solche Strategier för företag, som måste betala för att undvika, att använda dataskydd med nya skadliga program, katastrofer och Vorschriften verbunden sind, die erhebliche Risiken für den Betrieb darstellen. Datensicherheit ist für Unternehmen von absoluter Wichtigkeit, sei es zum Schutz vor Datenverlust oder zur Gewährleistung der Datenintegrität. Hier deckt Lenovo alle Möglichkeiten ab und stellt sicher, dass die Daten seiner Kunden stets geschützt sind.
Lenovo ThinkSystem Speicherlösung
Neue Entwicklungen zu antizipieren ist ebenso eine Herausforderung wie die best Speicher- and Cloud-Strategie to verfolgen. Die Branche hat jedoch bereits enorma Investitionen in Forschungsökosysteme and -plattformen getätigt, die dem Unternehmen einen Mehrwert und Möglichkeiten bieten. Mit dem nästa strategischen Schritt für die Speicherbranche hat Lenovo seine Lösung auf die wichtigsten Herausforderungen im Datenmanagement zugeschnitten. Dieser kluge Schritt av Lenovo zielt darauf ab, seinen Kunden die ultimative Lösung zu bieten und bietet eine einzigartige Mischung aus Produkten und Dienstleistungen, die es Unternehmen ermöglicht, die Hybrid-Cloud optimal zu nutzen.
Lenovo är ett unikt teknologiunderstöd på marknaden, då Lenovo Data Center Group (DCG) har en End-to-End-Rechenzentrumslösung anbietet. Läs mer om Lenovo med sina Intelligent Device Group (IDG)-Ökosystem ett End-to-End-Sicherheits- och Software-Verwaltung. Mit diesen Angeboten och der ThinkSystem DM-Serie från Lenovo har företag ihre Infrastruktur verbessern och jede in ihrer Umgebung laufende Arbeitslast bewältigen.
ThinkSystem DM Series är Lenovos Flaggschiff-Speicherlösung, en vielseitige Datenmanagement-Suite för strukturerad och ostrukturerad data bietet. Sie reicht vom Einstiegsbereich bis hin zur oberen Mittelklasse und bietet datenintensive Funktionen wie integrierte Datenreduzierung, Datenschutz und Datensicherheit Jede der DM-Serien kan integrierte Hybrid-Cloud-Funktionen für Lösungen von Public-Cloud-Anbietern bereitstellen. Gleichzeitig baut Lenovo seine End-to-End NVMe-Angebote mit der kürzlich veröffentlichten DM7100F-Serie aus und plant noch in diesem Jahr, das Angebot von End-to-End NVMe auf weitere Einstiegs-Workloads für Kunden för NV-meterne-infrastrukturweiten, um schaffen.
FabricPools
Datahanteringssviten från DM-seriens datahanteringssvit är tillgänglig för Flash, Festplatte och Cloud och vereinfacht så Speicherumgebungen. Denna programvara är enkel att betjäna och flexibel, för effektiva uppdateringar och utvärderingar över robusta dataverwaltungsfunktioner för en enkel molnintegrering. Insgesamt zielt die DM-Serie darauf ab, die Bereitstellung und Verwaltung von Daten zu vereinfachen und Unternehmensanwendungen zu fördern, dh sie ist zukunftssicher für Dateninfrastrukturen.
Neben der bordeigenen Datenmanagement-Funktionalität steht die FabricPool Cloud Tiering-Technologie zur Verfügung. Sie ermöglicht das automatisierte Tiering von Daten auf kostengünstige S3-Objektspeicherebenen, die sich antingen vor Ort or in the öffentlichen Cloud befinden. Im Gegensatz zu manuellen Tiering-Lösungen automatisiert FabricPool das Tiering von Daten, um die Speicherkosten zu senken. Aktiva data verbleiben auf Hochleistungslaufwerken och inaktiva Daten blev till Objektspeicher gestaffelt, wobei die Funktionalität och die Dateneffizienz der DM-Serie erhalten bleiben.
FabricPool unterstützt en bred palett av öffentlichen Cloud-Anbietern och deren Speicherdienste. Dazu hören Amazon S3, Alibaba Cloud Object Storage Service, Microsoft Azure Blob Storage, Google Cloud Storage, IBM Cloud Object Storage och privata moln. Kunden profitieren auch von der Beibehaltung der integrierten Datenreduzierungsfunktionen beim Verschieben von Daten in und aus der Cloud. Dies spart Transportkosten, wenn Daten aus der Cloud zurückversetzt werden müssen. Darüber hinaus schützt die integrierte Datenverschlüsselung sowohl die Daten under Übertragung in die Cloud as auch die Daten in der Cloud. Dadurch wird sichergestellt, dass es under des gesamten Cloud-Tiering-Prozesses keine Schwachstellen gibt.
FabricPool Richtlinien
FabricPool hat två primära Anwendungsfälle: die Rückgewinnung von Kapazität auf dem Primärspeicher eller die Verkleinerung des sekundären Speicherplatzes. Unser Schwerpunkt in diesem Artikel ligger auf der Möglichkeit, Kapazität im Primärspeicher zurückzugewinnen. Es gibt drei verschiedene and einzigartige Richtlinien für das Cloud Tiering av Primärspeicher: Auto-Tiering, nur Snapshots and All-Tiering.
Die Beibehaltung von Daten, auf die nur selten zugegriffen wird and die mit Produktivitätssoftware, abgeschlossenen Projecten and alten Datensätzen auf Primärspeicher verbunden sind, ist one ineffiziente Nutzung von Hochleistungs-Flash-Speicher. Das Tiering dieser Daten zu ett objektspeicher är ett enkelt verktyg, förhanden Flash-Kapazität zurückzugewinnen och die erforderliche Kapazität in Zukunft zu reduzieren. Die Auto-Tiering-Richtlinie skiftar alla Cold Blocks i volymen på Cloud-Ebene. När du är så fälld Lesevorgänge gelesen blev, blev kallade Datenblöcke auf der Cloud-Ebene heiß och blev auf die lokala Ebene übertragen. Beim Lesen durch sequentielle Lesevorgänge, z. B. in Verbindung mit Index- und Antiviren-Scans, bleiben kalte Datenblöcke auf der Cloud-Ebene kalt und werden nicht auf die local Ebene geschrieben.
Snapshot-Kopien können häufig mehr as 10 % einer typischen Speicherumgebung beanspruchen. Obwohl dessa Point-in-Time-Kopien för die Datensicherung och die Notfallwiederherstellung unerlässlich sind, blev sie nur selten verwendet och ange en ineffiziente Nutzung av Hochleistungs-Flash dar. Policyn för Snapshot-Only Tiering för FabricPool är en enkel bild, Speicherplatz på Flash-Speicher zurückzugewinnen. Under unserer-tester blev Snapshot-Only som Richtlinie för Testen av Cloud-Tiering-Operationens användning. Kalte Snapshot-Blöcke i volymen, som inte är tillgänglig för det aktiva filsystemet, har överförts i Cloud-Ebene. Wenn sie gelesen were, were kalte Datenblöcke auf der Cloud-Ebene heß and were auf die local Ebene übertragen.
Eine der häufigsten Anwendungen von FabricPool ist das Verschieben ganzer Datenmengen in Clouds. Abgeschlossene Projekte, Legacy-Reports eller Historic Aufzeichnungen sind ideal Kandidaten, die in one costgünstige Objektspeicherung gestaffelt werden können. Då Verschieben hela volymen erföljs under Einstellung der All Tiering Policy auf einem Volumen. Diese Richtlinie wird in erster Linie für sekundäre Daten- und Datensicherungsvolumen verwendet. Sie kann jedoch auch dazu verwendet werden, all Daten in Lese-/Schreib-Volumes zu staffeln.
Data in Volumen, die all Tiering Policy verwenden, blev sofort som kallad gekennzeichnet och så snabb som möglich in die Cloud gestaffelt. Es muss nicht eine Mindestanzahl von Tagen abgewartet werden, bevor die Daten als "kalt" and "gestaffelt" gekennzeichnet werden. Wenn sie gelesen were, bleiben kalte Datenblöcke auf der Cloud-Ebene kallad and were nicht auf die local Ebene zurückgeschrieben.
Med Lenovo steht auch en vierte Option für die Abstufung zur Verfügung, die träffad as "Keine" Abstufung bezeichnet wird. Be diesem Vorgang werden keine Daten gestaffelt, så att alla Daten in Flash verwaltet werden können. Ett bra spel för din användning av ögonblicksbilder i DevOps-Umgebungen, i den här häufig die früheren Point-in-Time-Kopien verwendet werden.
Lenovo Storage Cloud Tiering Konfiguration
Om de funktioner och funktioner som Lenovo Speicherlösung för Cloud för att testa, har vi arbetat i unserem Labor en DM7000F-Modell eingerichtet.
Zunächst haben wir mit Azure Blob Storage, unserer Cloud-Lösung für diesen Test, einen Speichercontainer erstellt. Här är det bra, den breda palett från Lenovos angeboten Optionen till beachten, till denen Alibaba Cloud, Amazon S3, Google Cloud, IBM Cloud och andra hören. Under testerna pågår, Microsoft Azure Blob Storage för molnet som Cloud-Tier för FabricPool för att använda. Nachdem wir die Einrichtung des Cloud-Speichers abgeschlossen hatten, war es an der Zeit, sich bei der GUI-Oberfläche des DM7000 anzumelden.
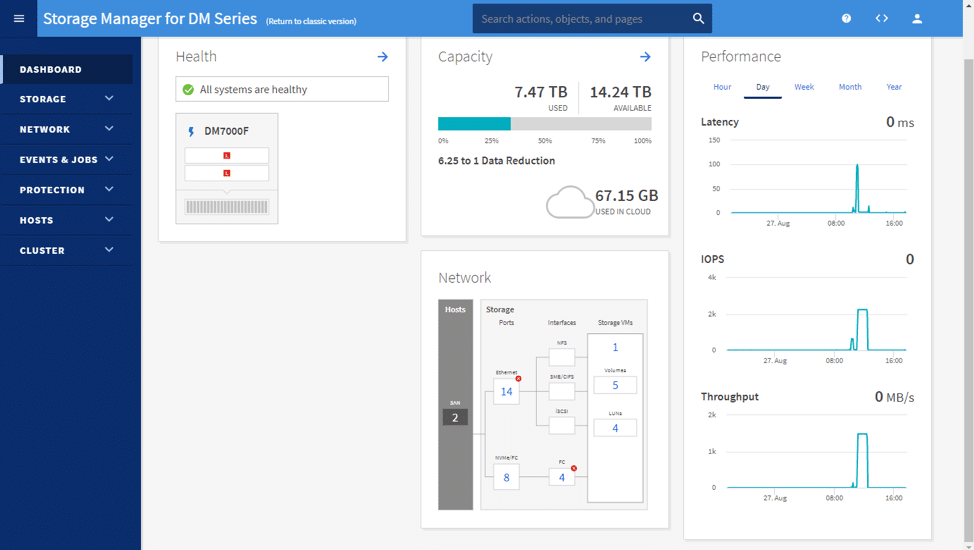
Sobald man angemeldet är, ärscheint die Standard-Dashboard-Seite. Das Dashboard seigt den Zustand, die Kapazität, die Leistung och die Netzwerkinformationen des fraglichen Arrays an.
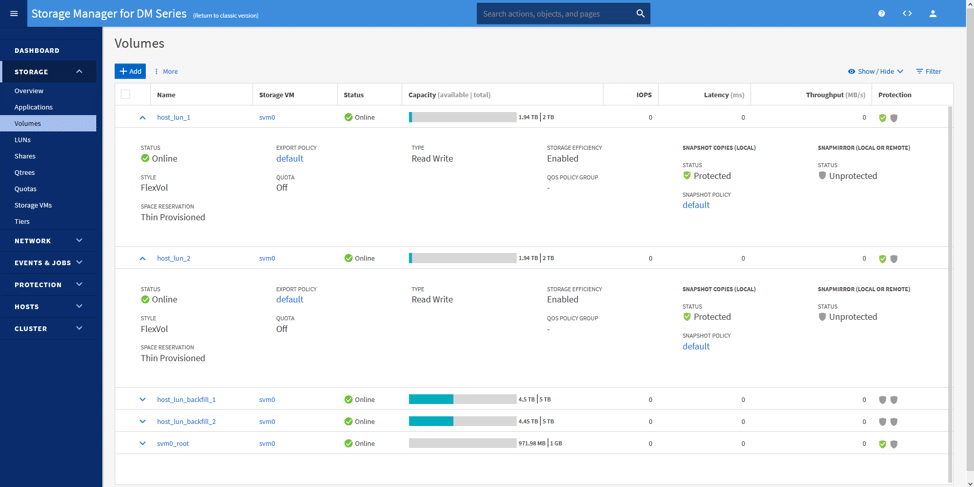
Wir har sedan två Volumen (eines pro Controller) och två VMs (eines för jedes Volumen) är ställda. Der Plan war, diese VMs laufen zu lassen und sie dann für eine Weile untätig zu lassen. Detta är följande bild som används i volymen: host_lun_1 och host_lun_2.
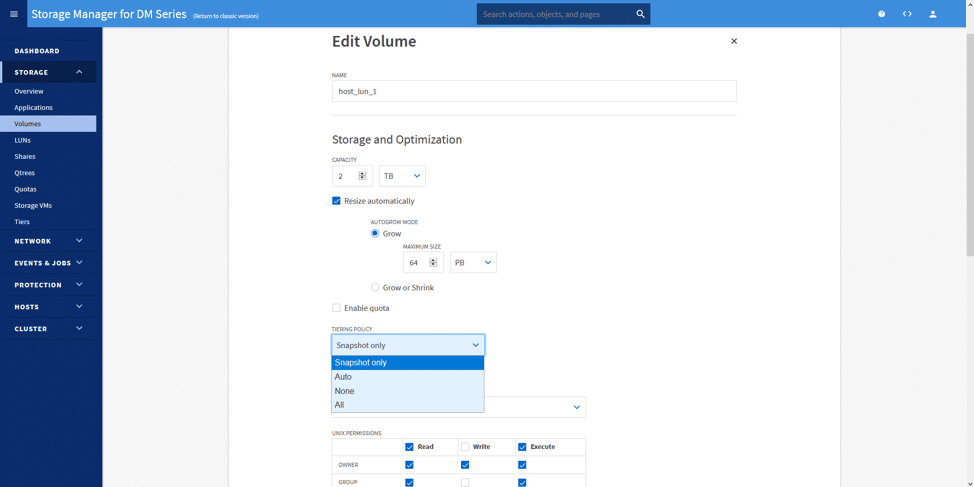
While der Bearbeitung oder Erstellung des Volumens können wir die gewünschte Einstufungsrichtlinie auswählen. Hier haben wir nur Snapshot ausgewählt. När Tiering-Politik auswählen, wandern unsere Daten (die nach jedem Snapshot as kalt angesehen werden) i den Azure Blob Storage, där i ett hintergrundintervall som är ställt. Das Intervall läuft zu seiner eigenen Zeit und sagt voraus, wann die Arbeitslasten am wenigsten beeinträchtigt werden.
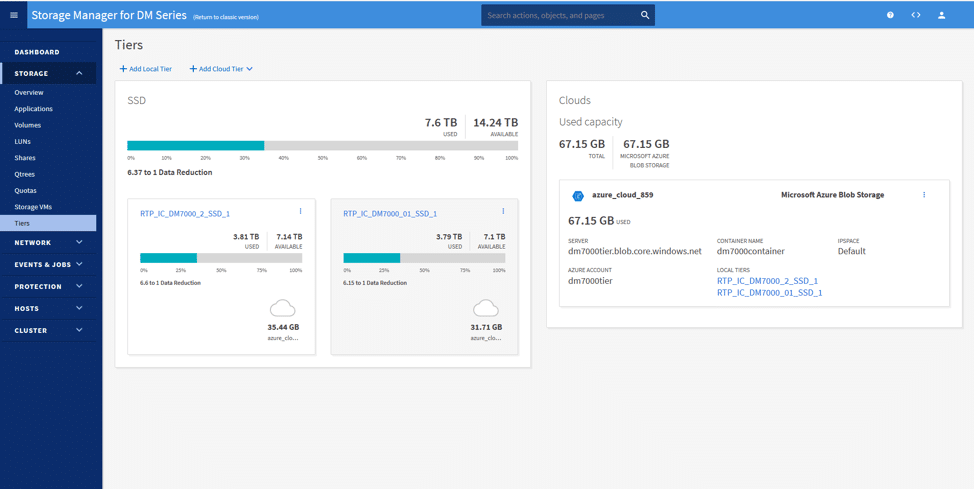
Unter der Tiers-Seite können wir unsere Cloud-Ebene aus den öffentlichen Moln hinzufügen. Här har Azure Blob Storage-Ressource angehängt och mit bådan lokalen Speicherebenen verbunden. Unter dem Bild unten sehen Sie zwei Ressourcen, die mit Azure verbunden sind.
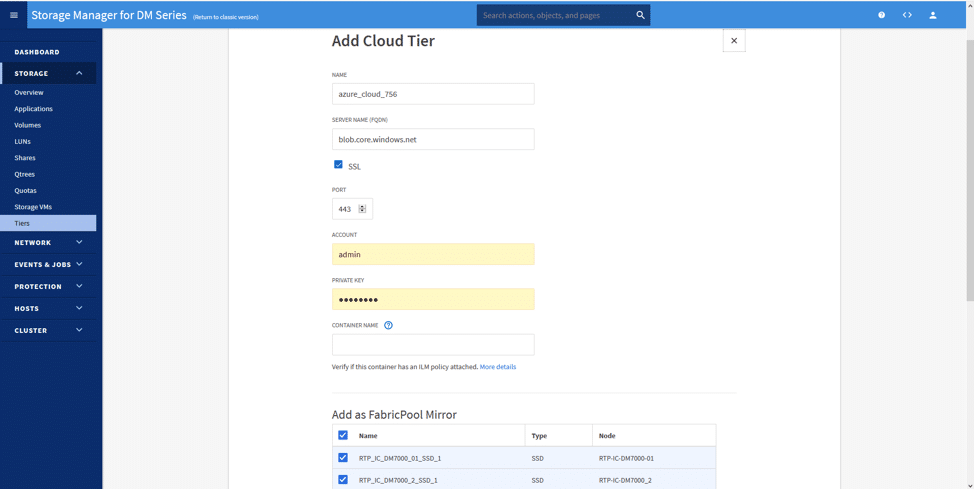
Konfigurationen är enkel; genom att klicka på "Add Cloud Tier" (Cloud-Ebene hinzufügen) och Auswahl der gewünschten Cloud (i detta Szenario Azure) kan användas för att skapa Cloud-Ebene-effekter.
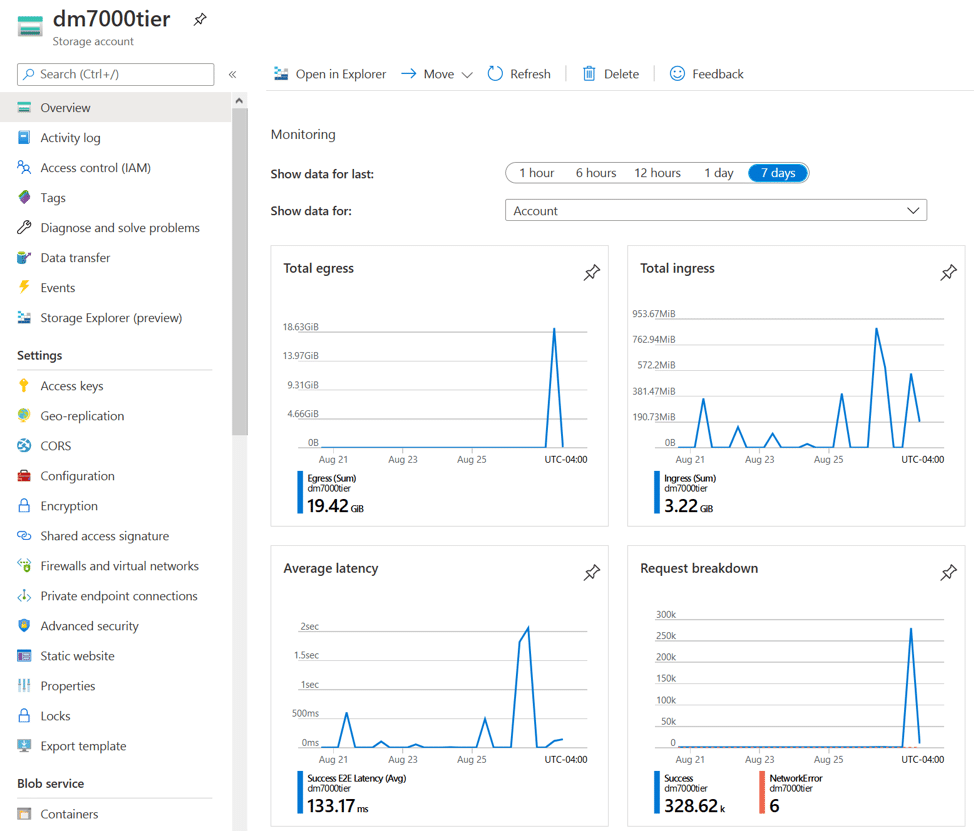
Du behöver inte göra något av Azure Storage-Account-Dashboard från sowohl Daten anzeigen, dö i Azure engehen (inträde), som auch Daten, die aus Azure herausgehen (egress). Die små Spitzenwerte, die jeden Tag angezeigt werden, sind neue Momentaufnahmen von Daten, die nach Azure übertragen werden. Auf der andra Seite zeigen die Austrittsspitzen ausgehende Daten und illustreren eine Snapshot-Wiederherstellung von einem Volume zum Zurückfahren.
Avslutande kommentarer
Im Allgemeinen ist die Cloud und die Verwaltung der Daten ein breites, sich entwickelndes Thema in Unternehmen. Lenovo möchte Lösungen anbieten, die Kunden auf wechselnde Anforderungen vorbereiten, sei es im Rechenzentrum oder über Hybrid-Cloud-Umgebungen. Wir bei StorageReview sind ziemlich beeindruckt av Lenovos Ansatz für ihre Speicher-Arrays. Under denna utvärdering har du kommit tillbaka, som är Tiering av Daten i Cloud vom Storage Manager för DM-seriens funktioner och fungerar som Flash-kapazitet eller i Cloud-versionen. Wichtig ist, dass das DM7000F-Speichersystem diese Flexibilität bietet, ohne Änderungen an der Infrastruktur vorzunehmen. Funktionaliteten är enkel att implementera
Unterstützt von der DCG och IDG sehen wir Lenovo in ener starken Position auf dem Datenspeichermarkt. Ihre Speicherlösungen ermöglichen es den Kunden, das zu kaufen, was sie heute benötigen, und gleichzeitig die Cloud zu nutzen, um die Anforderungen an das Datenwachstum der Zukunft zu erfüllen. Das Ergebnis ist, dass das Lenovo Cloud Tiering die Kosten reduziert und Unternehmen die Flexibilität ermöglicht, die sie sich wünschen, wenn sie eine Investition in Speicherlösungen in Erwägung ziehen.
Lenovo ThinkSystem DM Series Speicher-arrayer
Detta meddelande har skrivits av Lenovo. Alla in diesem Bericht zum Ausdruck gebrachten Ansichten och Meinungen basieren auf unserer unvoreingenommenen Sicht auf das/die in Frage kommende(n) Produkt(e).


 Amazon