

AMD 宣布推出 Pensando Pollara 400,这是业界首款完全可编程的 AI 网络接口卡 (NIC)。这款创新解决方案旨在加速 AI 工作负载,兼容正在开发的超级以太网联盟 (UEC) 标准,并针对增强数据中心 GPU 之间的通信进行了优化。Pollara 400 AI NIC 代表着在构建可扩展、高性能的 AI/ML 工作负载、生成式 AI 和大型语言模型基础架构方面迈出了重大一步。
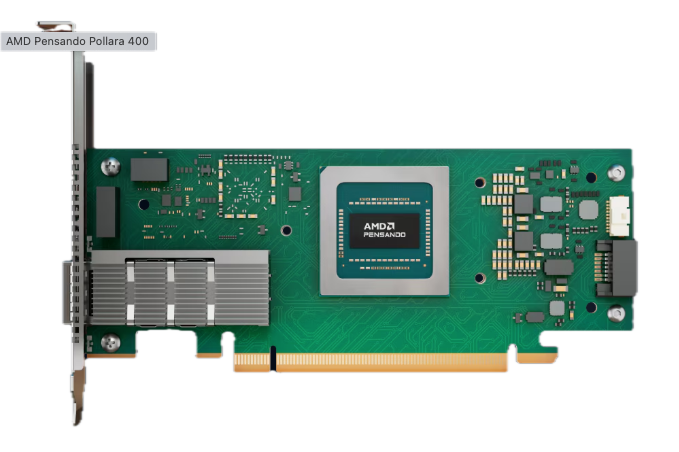
随着人工智能的发展,企业面临着开发类似计算基础架构的挑战,这些基础架构既要提供最佳性能,又要具备适应未来需求的灵活性。这一发展的关键因素在于高效扩展节点内 GPU 通信网络。AMD 致力于在不牺牲性能的情况下保留客户选择权并降低总体拥有成本 (TCO),这一点在 Pollara 400 AI NIC 中得到了充分体现。该解决方案使企业能够创建面向未来的人工智能基础架构,同时保持与开放生态系统的兼容性。
利用高级网络加速人工智能工作负载
最大化 AI 集群性能是云服务提供商、超大规模企业和企业的首要任务。然而,许多组织将网络视为瓶颈,限制了 GPU 的利用率。虽然数据传输速度至关重要,但只有优化网络以满足现代 AI 工作负载的需求时,它才有益。
| 规格 | 信息 |
|---|---|
| 最大带宽 | 400 Gbps |
| 外形 | 半高半长(HHHL) |
| 主机接口 | PCIe Gen5.0 x16 |
| 以太网接口 | QSFP112(NRZ/PAM4 串行器/解串器) |
| 以太网速度 | 25/50/100/200/400 Gbps |
| 以太网配置 | 最多支持4个端口: 1个400G 2个200G 4个100G 4个50G 4个25G |
| 管理学 | 通过 SMBus 的 MCTP |
Pensando Pollara 400 AI NIC 通过提供智能负载均衡、拥塞管理、快速故障转移和丢失恢复功能来应对这些挑战。这些功能可确保充分利用网络和计算资源,从而实现更长的正常运行时间、更快的作业完成速度以及更高的规模可靠性。随着 AI 工作负载的复杂性和规模不断增长,Pollara 400 AI NIC 提供了必要的工具,以消除瓶颈并释放 AI 基础架构的全部潜力。
面向未来的可编程解决方案
Pollara 400 AI NIC 采用 AMD P4 架构,提供完全可编程的硬件流水线,带来无与伦比的灵活性。这种可编程性使客户能够适应新标准(例如 UEC 制定的标准),或创建针对其特定工作负载设计的定制传输协议。与需要新一代硬件来支持新兴功能的传统硬件不同,Pollara 400 使企业无需等待硬件更新即可升级其 AI 基础设施。
Pollara 400 的主要特性包括支持多种传输协议,例如 RoCEv2、UEC RDMA 和其他以太网协议,从而确保与各种工作负载兼容。智能数据包喷射、乱序数据包处理和选择性重传等高级功能可优化带宽利用率并降低延迟,这对于训练和部署大型 AI 模型至关重要。路径感知拥塞控制和快速故障检测可确保近乎线速的性能,并最大限度地减少 GPU 空闲时间,即使在瞬时拥塞或网络故障期间也是如此。
开放生态系统优势
AMD 的开放生态系统方法确保了与供应商无关的兼容性,使企业能够构建既能满足当前需求,又能根据未来需求进行扩展和编程的 AI 基础架构。此策略无需昂贵的基于单元的大缓冲区交换结构,从而降低了资本支出 (CapEx),同时确保了高性能。
Pensando Pollara 400 AI NIC 已在全球一些最大的横向扩展数据中心得到验证。云服务提供商 (CSP) 之所以选择这款解决方案,是因为它兼具可编程性、高带宽、低延迟和丰富的功能。通过在开放的生态系统中构建可扩展的基础架构,AMD 帮助企业打造面向未来的 AI 环境,同时带来即时的性能优势。


 Amazon