

Cerebras Systems 正式发布了第四代晶圆级 AI 超级计算平台CS-4,专为前沿训练和高并发推理工作负载而设计。该系统采用三颗全新开发的晶圆级引擎 3 (WSE-3) Turbo 处理器,并搭载于全新设计的 Nexus 机架级平台中。Cerebras 声称,该系统的推理性能最高可达基于 GPU 解决方案的 30 倍,这一数据基于GPT-OSS-120B数据集,该数据集显示每位用户每秒可处理超过 4,400 个令牌,同时每瓦吞吐量也比上一代 CS-3 提高了 10 倍。
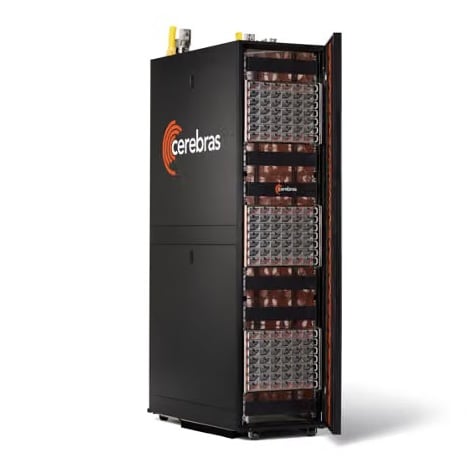
CS-4旨在解决离散多节点GPU集群固有的系统性扩展限制,在这些集群中,芯片间通信、电源转换损耗和散热限制经常会降低持续计算效率。Cerebras将该平台定位为能够满足推理工作负载的两端需求,既能提供复杂智能体工作流程和交互式推理所需的亚毫秒级响应时间,又能提供超大规模数据中心所需的聚合容量,从而最大限度地提高每千兆瓦的计算密度。
互连架构的改进是该平台多处理器扩展能力的核心。CS-4 将晶圆间互连延迟降低至 2 微秒,使多晶圆互连架构能够以接近单片集成的方式运行。这种超低延迟架构使 CS-4 能够在参数超过 10 万亿的模型上维持每秒超过 1,000 个令牌的生成速度,从而弥补了以往参数数量增加导致交互式令牌交付速率严重下降的性能差距。

Nexus机架架构和晶圆级背包
CS-4 的一项重大工程革新是 Cerebras Nexus 平台架构,这是一种模块化机架式解决方案,围绕独立的计算、电源和 I/O 域构建。计算密度由全新设计的后置晶圆级扩展舱 (Wafer-Scale Backpack) 实现,该扩展舱垂直连接至主电源阵列。每个扩展舱都是一个独立的单元,内部包含直接对芯片的液冷歧管、负载点电源转换级、高速网络路径以及位于硅晶圆正后方的板载控制电子设备。通过将核心计算层与主电源分配框架隔离,Cerebras 将系统组件数量减少了 50%,自动化组装率提高了 60%,并将数据中心部署时间缩短至数小时。

通过将直流-直流电压调节模块的位置比传统服务器主板更靠近硅片边界100倍,电源传输效率得到了显著提升。这种负载点布局降低了电阻性电源分配网络(PDN)的损耗,使Nexus框架能够为每个WSE-3 Turbo处理器提供两倍的功率,从而实现更高的持续时钟频率,而不会出现过热降频。

I/O 子系统也进行了扩展,新增了可编程晶圆 I/O 模块,可将边缘到边缘的交换矩阵带宽提高一倍,同时降低传输延迟。系统网络以两种模式运行:标准 RoCE v2(基于融合以太网的 RDMA)接口,用于以低延迟方式连接到传统企业网络和第三方加速器节点;以及专有的直接晶圆链路,可在机架内和机架间相邻系统之间提供直接、无交换机的互连路径。
CS-4 和 WSE-3 涡轮增压器规格
| CS-4系统 | |
| 卓越 | 带三个模块化计算背包的有源电源架 |
| 晶圆级引擎 | 每个系统配备 3 个 WSE-3 涡轮增压器 |
| 人工智能计算 | 750 PFLOPS* |
| 内存带宽 | 129.6PB/秒 |
| 片上结构带宽 | 160.5PB/秒 |
| I/O带宽 | 7.2 Tbit/s |
| I/O延迟 | 2微秒 |
| WSE-3 TURBO(每片晶圆) | |
| 晶体管/硅 | 4万亿个晶体管;46,225平方毫米,台积电5纳米工艺 |
| AI核心/片上SRAM | 900,000万个核心;44GB内存 |
| 人工智能计算 | 250 PFLOPS* |
| 内存带宽 | 43.2PB/秒 |
| 片上结构带宽 | 53.5PB/秒 |
| I/O带宽 | 2.4 Tbit/s |
| *AI 计算结果显示为稀疏 FP16 | |
分解推理和可用性
在架构上,CS-4 原生支持解耦式推理拓扑。在企业和云环境中,运维人员可以使用专用的外部预填充加速器(例如AMD Helios或 AWS Trainium)来解耦推理的计算阶段,这些加速器用于接收提示上下文并构建模型状态。然后,计算密集型 KV 缓存通过高速链路路由到 CS-4 的海量 SRAM 结构,以实现超低延迟的自回归令牌生成。
Cerebras 确认 CS-4 平台的初始生产部署和出货将于本季度开始。


 Amazon