

戴尔科技集团宣布对其戴尔人工智能平台(Dell AI Platform)进行两项重大更新,该平台由戴尔与AMD合作开发,旨在帮助企业从试点人工智能部署扩展到全面生产环境。此次更新重点在于高性能训练基础设施和模块化架构,以平衡成本、可扩展性和运维控制。
此次更新引入了一种大规模配置,该配置采用配备AMD Instinct MI355X GPU和 AMD EPYC CPU 的戴尔 PowerEdge XE9785 服务器节点。它专为要求严苛的 AI 工作负载而设计,包括模型训练、预训练和高吞吐量推理。该平台集成了戴尔 PowerSwitch 网络和 PowerScale 存储,确保跨部署的基础架构堆栈一致。
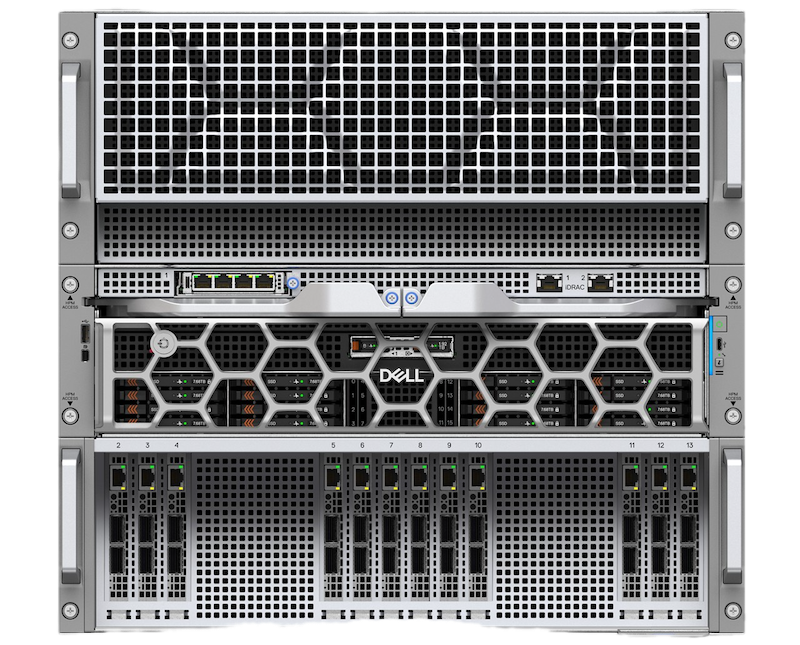
采用 AMD Instinct MI355X GPU 可提升单节点内存容量,从而支持更大规模的模型,并实现更高效的集群扩展。此配置面向拥有持续性 AI 工作负载且需要大规模可预测性能的企业和服务提供商。
第二项增强功能扩展了戴尔的模块化 AI 工厂架构,使其支持AMD Instinct MI350P PCIe GPU和 AMD EPYC CPU。该配置采用戴尔 PowerEdge XE7745和 R7725 服务器、PowerSwitch 网络和 PowerScale 存储,并与戴尔 AI 数据平台集成。对于正在从试点阶段过渡到生产阶段的企业而言,这是一种经济高效的方案,能够根据具体瓶颈逐步扩展计算、内存、存储和网络资源。
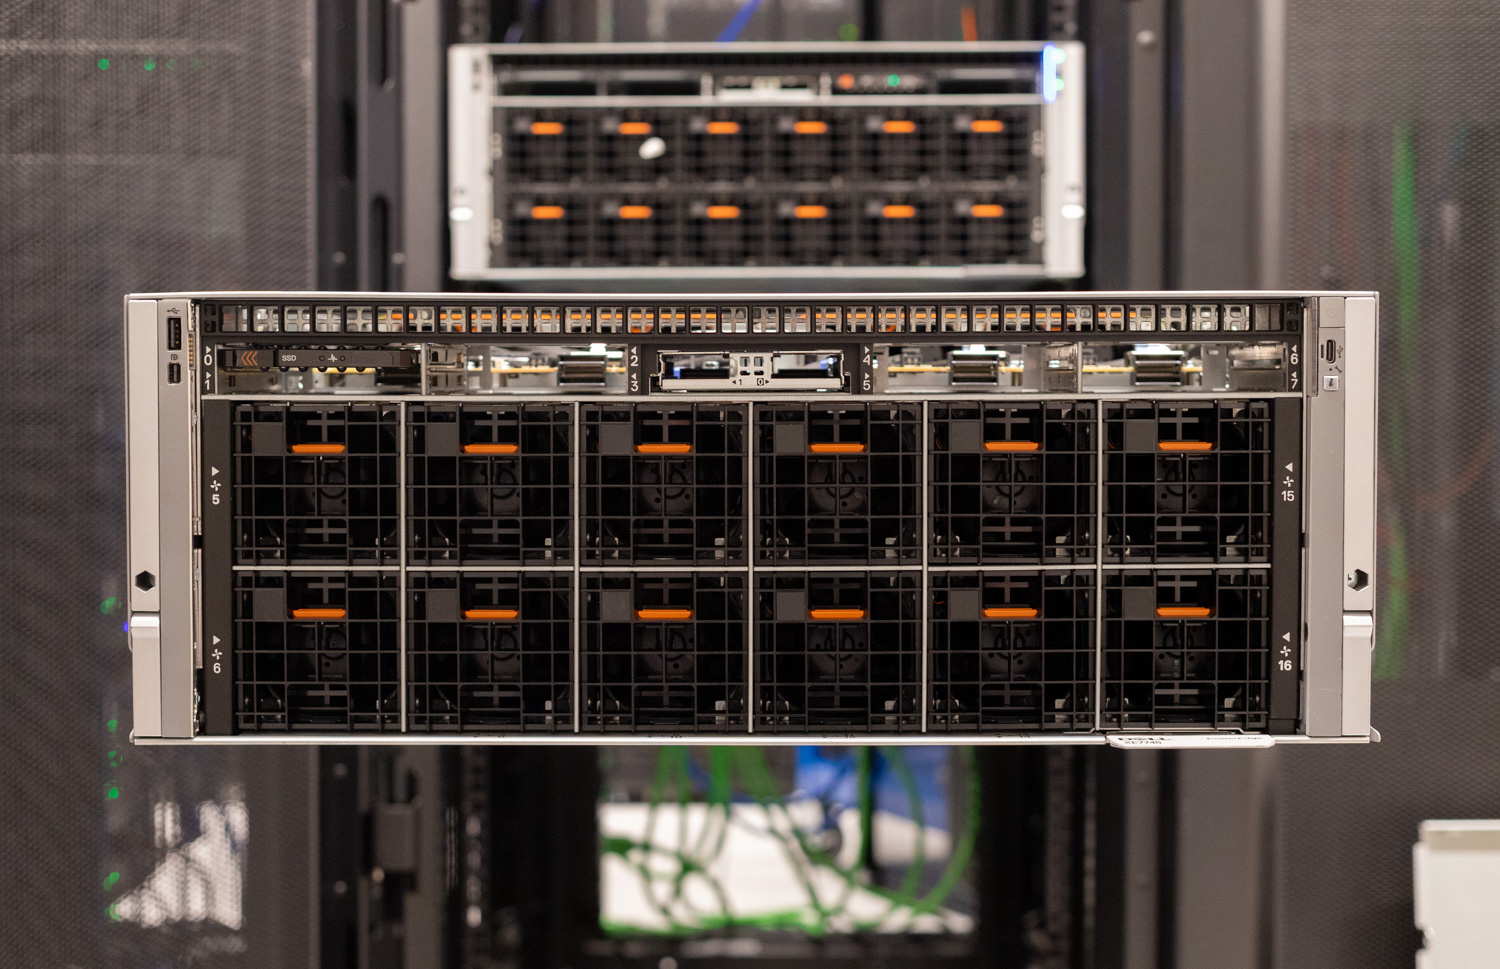
两种配置均基于 AMD ROCm 软件栈,并支持 PyTorch 和 vLLM 等开放框架。与戴尔自动化平台的集成提供了部署和生命周期管理功能,从而简化了集群的配置和扩展。
戴尔还引用了Omdia 的一项研究结果,该研究对比了本地部署和公有云方案。报告显示,采用配备 AMD Instinct MI355X GPU 的 PowerEdge XE9785 服务器的配置方案,凭借基础设施效率和开放的软件生态系统,可实现高达 65% 的总体拥有成本降低。
模块化设计旨在实现可预测的人工智能扩展
戴尔将更新后的平台定位为模块化设计,支持从小规模测试到企业级生产的统一部署路径。企业可以从仅使用两块GPU的单节点配置开始,然后随着需求的增长,通过添加计算节点、GPU容量、存储和网络带宽进行扩展。这种方法既能重复利用初始基础设施投资,又能以可控的增量进行扩展。
该平台的设计也充分考虑了工作负载的灵活性。通过采用 AMD 的企业级 AI 软件栈和开放框架,无需构建专用基础设施,即可支持多种 AI 应用场景。这不仅提高了模型的可移植性,还降低了管理多个环境的运维成本。
安全性和治理仍然是该平台设计的核心。通过优先考虑本地部署,戴尔降低了外部风险敞口,并保持了对数据本地性的控制。AMD 的企业级 AI 资源管理器提供了额外的治理功能,包括策略控制和访问管理,以帮助企业强制执行数据保护和合规性要求。


 Amazon