

微软今天在 OCP 全球峰会上发布了 Azure Maia 300,这是其自主研发的第三代推理加速器,也是首款采用多芯片架构的产品。每个加速器都配备一个台积电 N2P 计算芯片和八个 HBM4 显存堆栈,在 950W TDP 的功耗下,可提供 288GB 的内存,吞吐量高达 18TB/s。一个 Maia 300 机架可容纳 96 个这样的加速器,总功耗为 167kW。微软声称,与领先的基于 GPU 的系统相比,Maia 300 的每兆瓦令牌吞吐量提高了 40%,机架级令牌吞吐量更是 Maia 200 的 7 倍。作为微软所称的千兆瓦级 Maia 部署计划的一部分,该产品将于 2027 年开始投入生产部署。
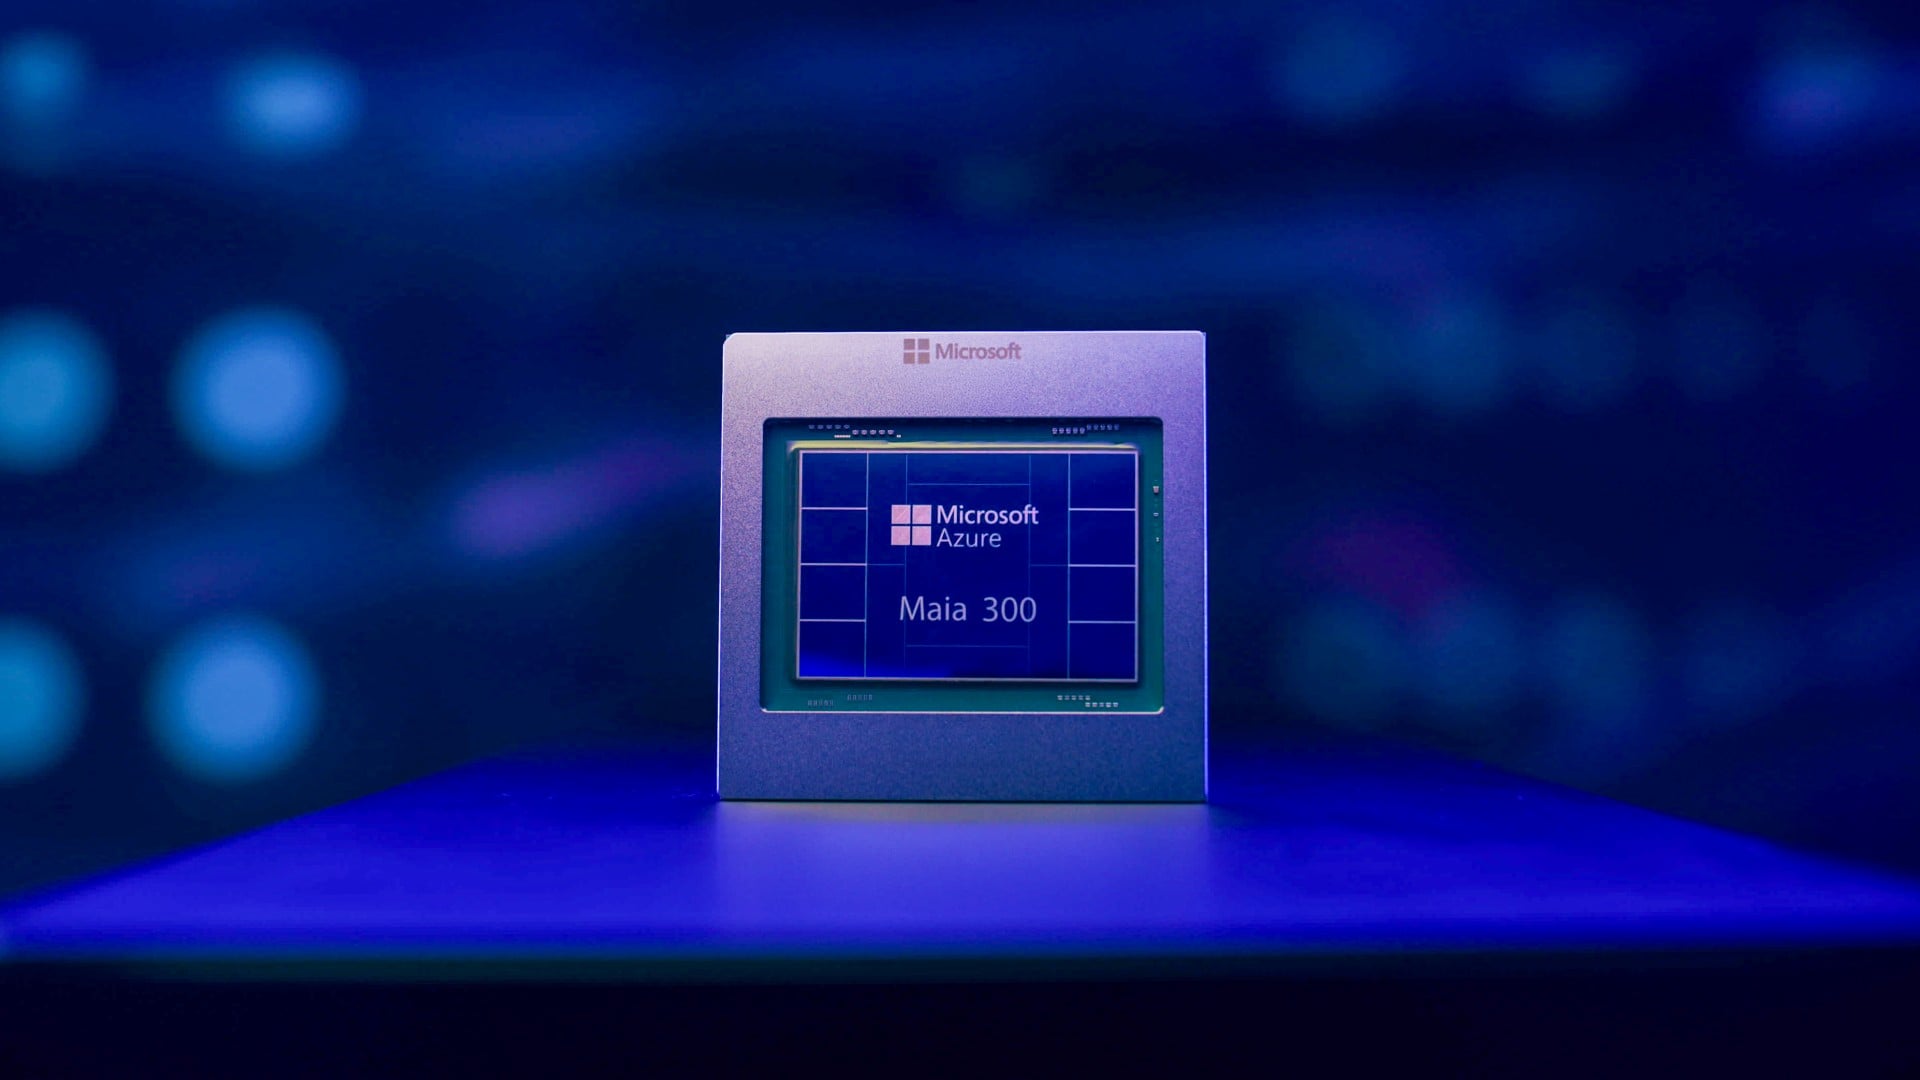
Maia 300 芯片:N2P 计算芯片,八个 HBM4 内存堆栈,32 个 400G 端口
Maia 200 采用单芯片 N3P 设计,配备六个 HBM3E 内存堆栈。Maia 300 则将设计拆分为一个基于 N2P 的主计算芯片、两个 I/O 芯片和四个内存芯片,其中八个 HBM4 内存堆栈将容量从 216GB 提升至 288GB,带宽从 7.1TB/s 提升至 18TB/s。峰值计算性能有所下降:FP4 模式下为 13.8 POPS,FP8 模式下为 6.9 POPS,分别比 Maia 200 的 10.1 POPS 和 5.1 POPS 有所提升,因此,与内存带宽提升 2.5 倍相比,FP4 计算性能提升了 37%。微软对该芯片的总结是:带宽提升了 2.5 倍,容量提升了 33%,每瓦 HBM 带宽约为 Maia 2 的两倍。
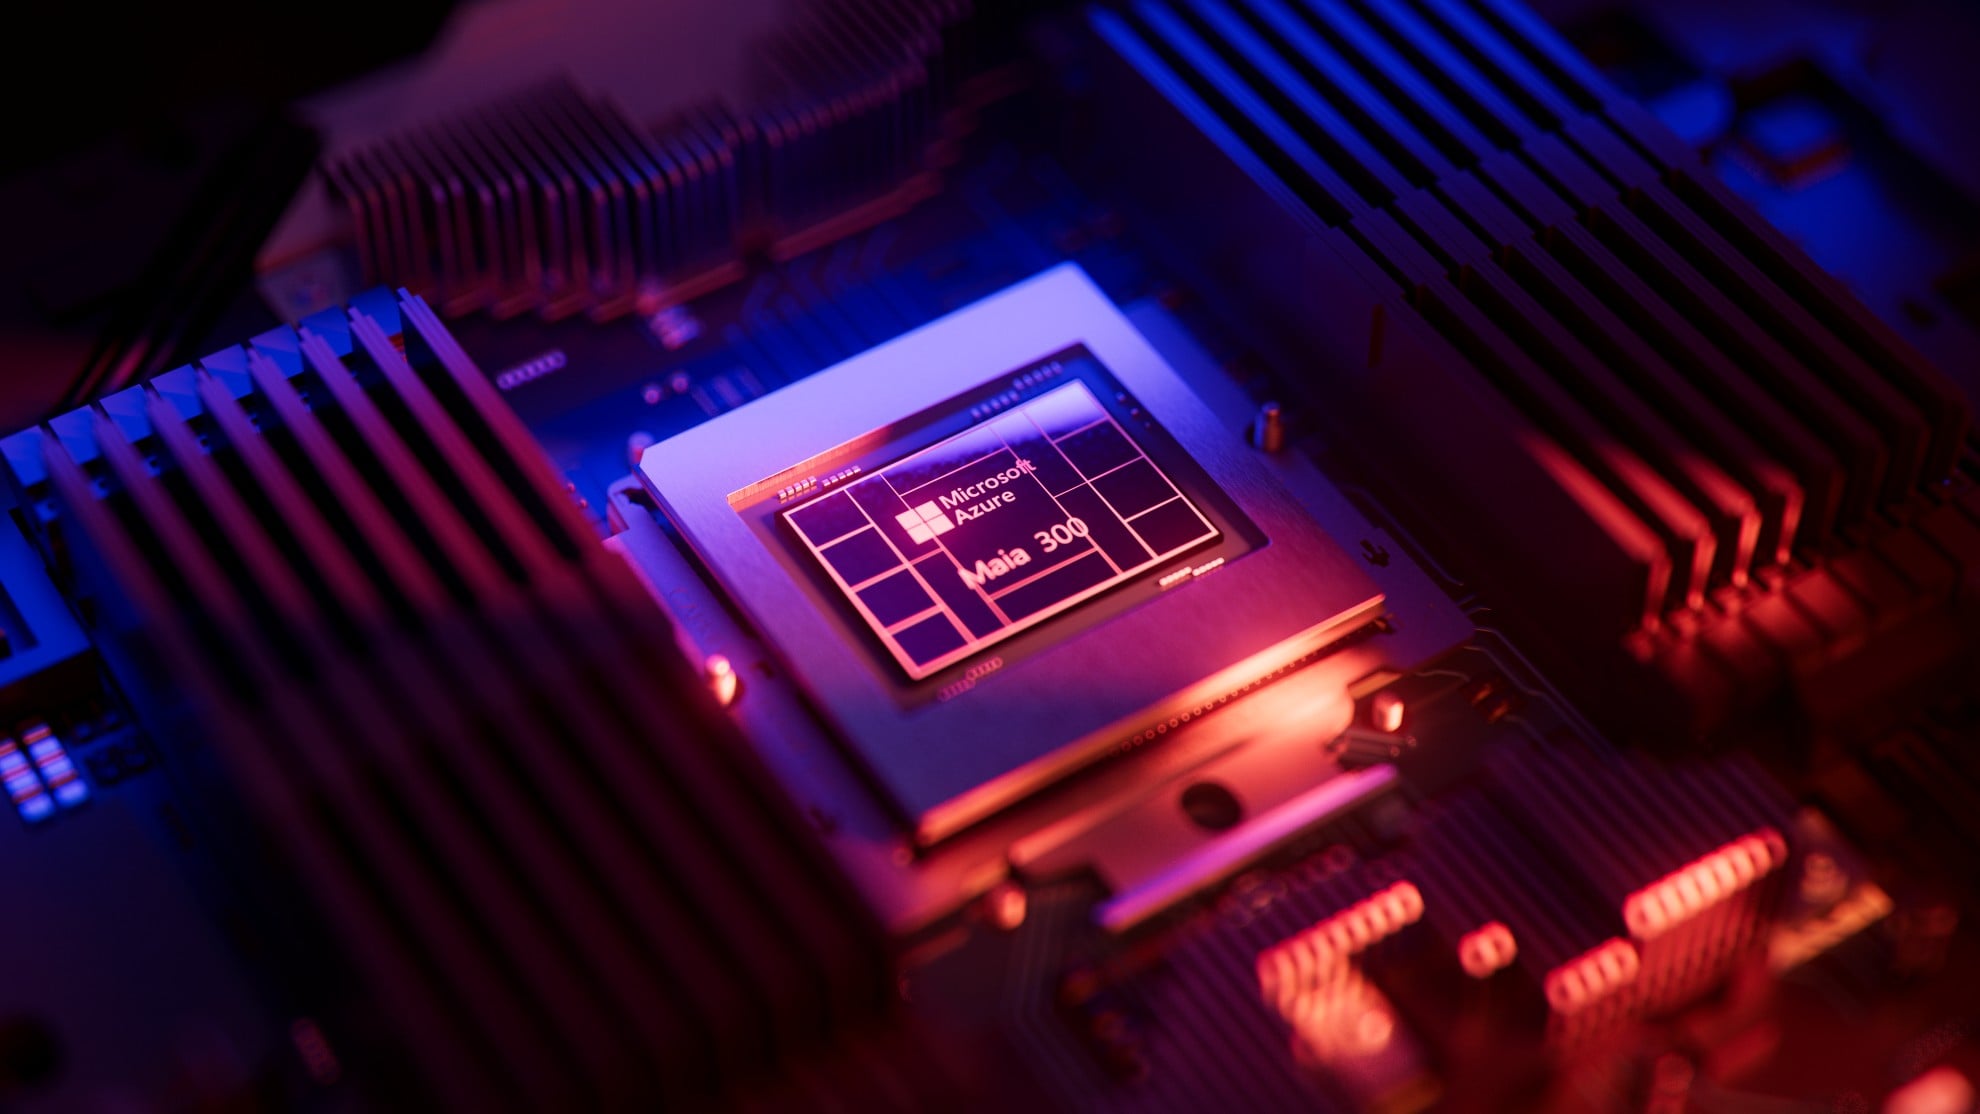
计算部分由四个集群组成,每个集群包含 12 个 tile,每个 tile 包含一个张量单元、一个向量处理器、一个重塑器、一个 DMA 引擎和一个本地 SRAM,集群共享 SRAM 和位于其上方的片上网络 (SoC)。微软将这种方法称为软件定义数据流架构:软件将数据放置在这些本地内存、DMA 引擎和网络中。SoC 通过片上 AI 网络控制器(即扩展架构)向主机提供 PCIe Gen6 x16 接口和 32 个 400Gb/s 以太网端口。
在 Maia 300 上,内存组织方式从统一访问 (UAL) 改为跨芯片的 NUMA 布局,以便将数据放置在靠近使用它的计算单元的位置。此外,通过增强 MXFP4 和硬件数据类型转换,精度进一步降低,旨在减少计算和键值缓存存储中每个令牌移动的字节数。内核还可以使用片上 SRAM 作为软件管理的暂存区,从而避免对 HBM 造成流量压力。微软将每瓦性能的提升归功于这些改进,尽管 TDP 从 750W 增加到 950W,但该公司声称每瓦性能提升了 2.5 倍以上。
每个机架96个加速器,超级舱共12,288个。
Maia 300 机架将加速器数量翻倍至 96 个,并将机架功率从 64kW 提升至 167kW,这意味着每个加速器插槽的功耗约为 1.74kW(包含网络、冷却和电源转换)。根据微软的数据,整个机架可提供 27.6TB 的 HBM 内存、1,728TB/s 的总 HBM 带宽以及 1,324 POPS 的 FP4 运算能力,而 Maia 200 机架的相应数据分别为 10.4TB、341TB/s 和 485 POPS。每个加速器的双向扩展带宽从 2.8TB/s 提升至 3.2TB/s,采用微软定制 AI 传输协议的双层以太网扩展网络,其超级集群 (superpod) 可容纳 12,288 个加速器,是上一代产品(约 6,000 个)的两倍。
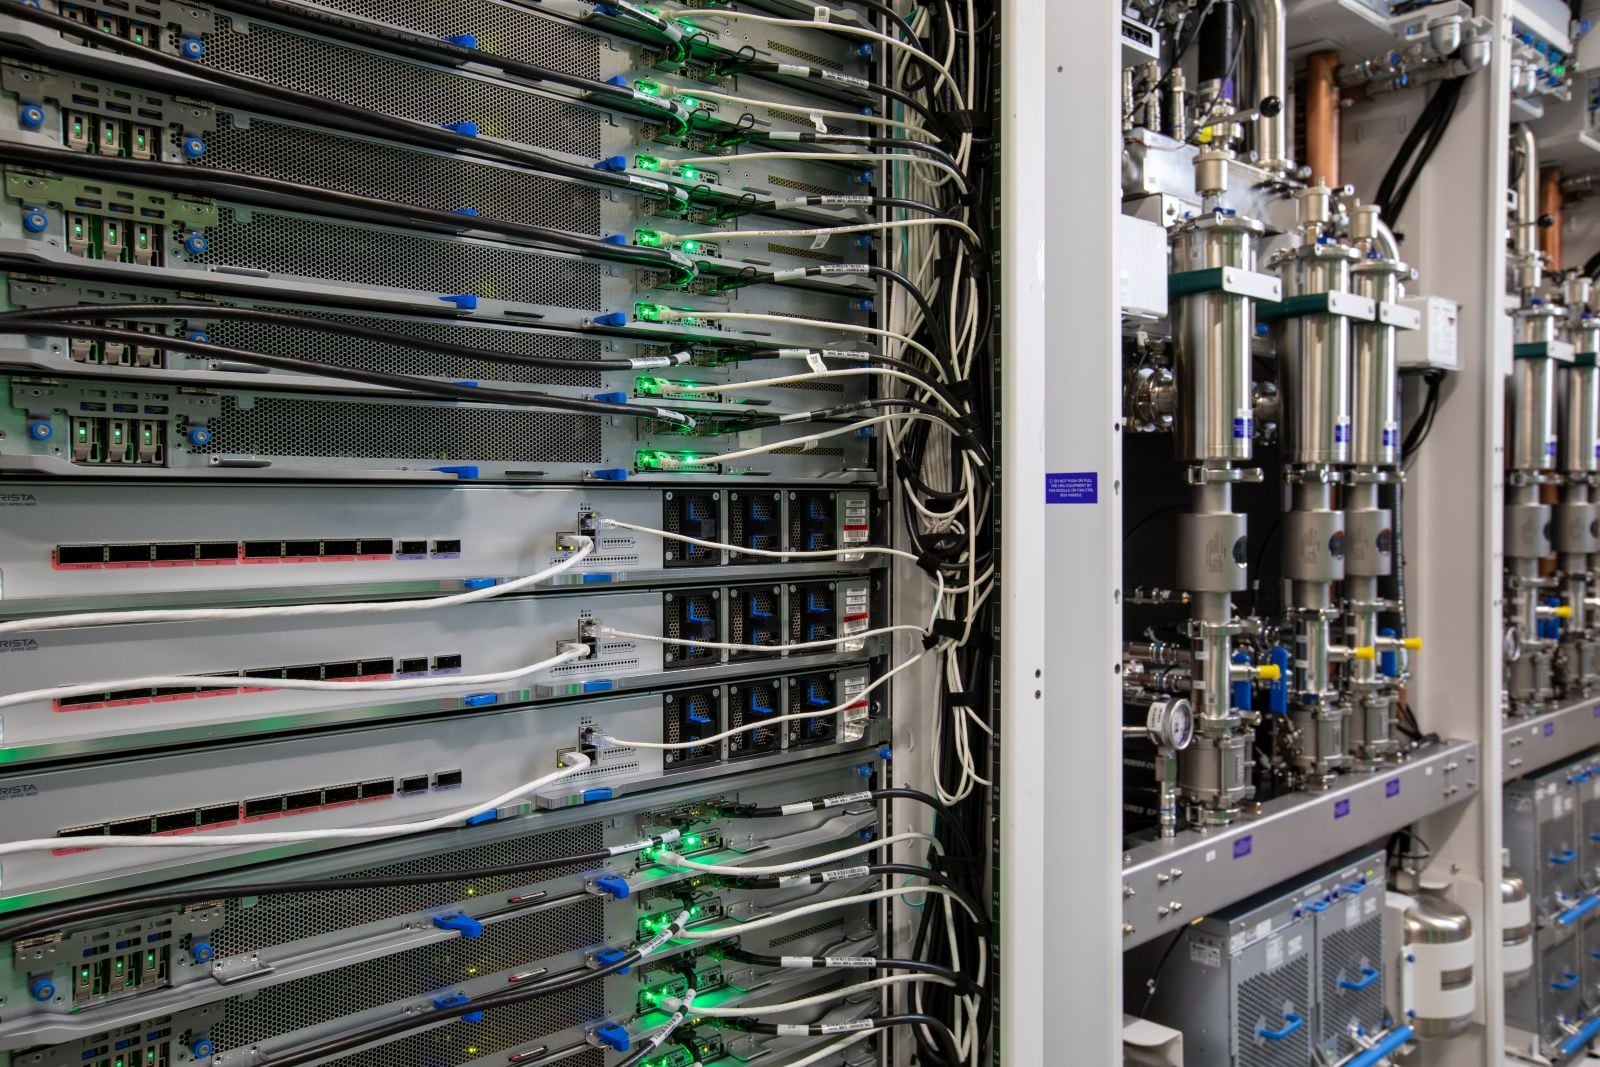
微软的机架图显示,作业通过横向扩展架构分片到各个机架,分片之间进行专家并行通信,这种流量模式正是大型混合专家模型在服务运行时产生的。该公司表示,相同的通信模型适用于超级集群中的任何加速器,因此,一个跨越 16 个加速器的作业和一个跨越四个机架的作业使用相同的语义。
Maia 300 规格
| 规格 | 玛雅 300 | 玛雅 200 |
|---|---|---|
| 加速器 | ||
| 工艺应用 | 多小芯片、N2P 计算芯片 | 单体式 N3P |
| FP4峰 | 13.8 流行音乐 | 10.1 流行音乐 |
| FP8峰 | 6.9 流行音乐 | 5.1 流行音乐 |
| SoC TDP | 950W | 750W |
| HBM | 8 x HBM4,288GB,18TB/s | 6 x HBM3E,216GB,7.1TB/s |
| 主机接口 | PCIe Gen6 x16 | 没有说明 |
| 扩展带宽(双向) | 3.2TB/秒 | 2.8TB/秒 |
| 后端网络 | 采用 AI 传输的双层以太网扩展,32 x 400Gb/s | 采用人工智能传输的双层以太网扩展 |
| 机架和纵向扩展领域 | ||
| 每架加速器数量 | 96 | 48 |
| 机架功率 | 167千瓦 | 64千瓦 |
| 机架式高密度脂蛋白(HBM)容量 | 27.6TB | 10.4TB |
| 机架式 HBM 带宽 | 1,728TB/秒 | 341TB/秒 |
| 机架 FP4 峰值 | 1,324 流行音乐 | 485 流行音乐 |
| 规模化领域 | 约12,288个加速器 | 约6,000个加速器 |
Maia 300 的市场定位以及其宣称的依据
Maia 200 目前已在 Microsoft Copilot 和 MAI 模型团队的生产环境中投入使用,GitHub Copilot 和 Microsoft Foundry 也将在年底前迁移到该平台。微软表示,Maia 200 正在美国、欧洲和澳大利亚进行部署,其每瓦的令牌数比其 GPU 基础设施高出 1.7 倍,用于 Teams、Copilot 和 Cowork 中的内置 AI 功能。
“我们将从 2027 年开始将 Azure Maia 系列扩展到千兆瓦级部署,使 Maia 成为微软产品和服务的主要推理系统,”微软云与人工智能执行副总裁 Scott Guthrie 在宣布 Maia 300 时写道。NVIDIA 和 AMD 仍然是微软训练集群中的一员,微软尚未将 Maia 作为 Azure 客户可以租用的实例类型提供。其宣称的效率优势——每兆瓦的令牌数比领先的基于 GPU 的系统高出 40%——并未指明具体的 GPU、型号或服务配置,而且由于 Maia 只能在微软内部运行,因此公司外部人员无法对其进行测试。
已公布的规格确实支持这一设计:每个加速器的内存带宽提升了 2.5 倍,FP4 计算能力提升了 37%,机架式服务器在功耗仅为 Maia 200 机架式服务器 2.6 倍的情况下,实现了 5.1 倍的 HBM 带宽。这是一款专为长上下文和智能推理的解码阶段而设计的芯片,该阶段的瓶颈在于为算术单元提供数据。它也展示了超大规模数据中心在拥有端到端工作负载的情况下如何调整推理部分的规模。我们曾在 1 月份报道过Maia 200 的发布,微软表示将在 11 月份的 Ignite 大会上公布更多细节。



 Amazon