

史蒂夫·普尔 (Steve Poole) 是全球众多利用网络力量的研究人员之一。 这位洛斯阿拉莫斯国家实验室 (LANL) 的杰出资深科学家预见到,使用包括在 NVIDIA Quantum InfiniBand 网络上运行的数据处理单元 (DPU) 在内的加速计算可带来巨大的性能提升。
在欧洲和美国,其他 HPC 开发人员正在开发将通信和计算工作卸载到 DPU 的方法。 他们利用 NVIDIA BlueField-2 DPU 内的 Arm 内核和加速器的强大功能为超级计算机增压。
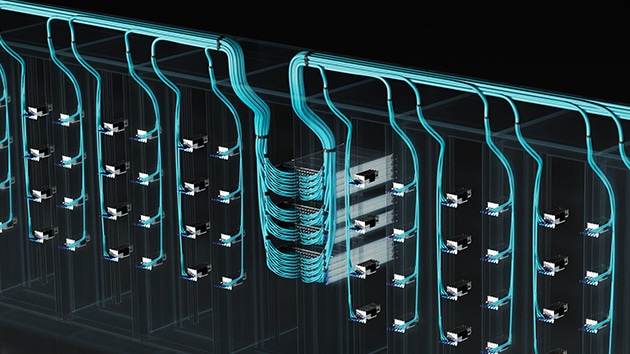
用于 DPU 的开放 API
Poole 的工作是与 NVIDIA 多年广泛合作的一部分,该合作的目标是将计算多物理应用程序的速度提高 30 倍。 它包括使用 BlueField 及其 NVIDIA DOCA 软件框架在计算存储、模式匹配等方面的开创性技术。
这些努力还将有助于进一步定义 OpenSNAPI,这是一个任何人都可以用来利用 DPU 的应用程序接口。 Poole 主持统一通信框架的 OpenSNAPI 项目,该联盟为 HPC 应用程序提供异构计算,其成员包括 Arm、IBM、NVIDIA、美国国家实验室和美国大学。
“DPU 是我们整体解决方案不可或缺的一部分,我看到在不久的将来使用 DOCA 和类似软件包的巨大潜力,”Poole 说。
快 10-30 倍的闪存
LANL 已经感受到网络计算的力量,这要归功于它创建的 DPU 驱动的存储系统。 Accelerated Box of Flash(ABoF,如下图所示)将固态存储与 DPU 和 InfiniBand 加速器相结合,以加速 Linux 文件系统的性能关键部分。 它比类似的存储系统快 30 倍,并将成为 LANL 基础架构中的关键组件。
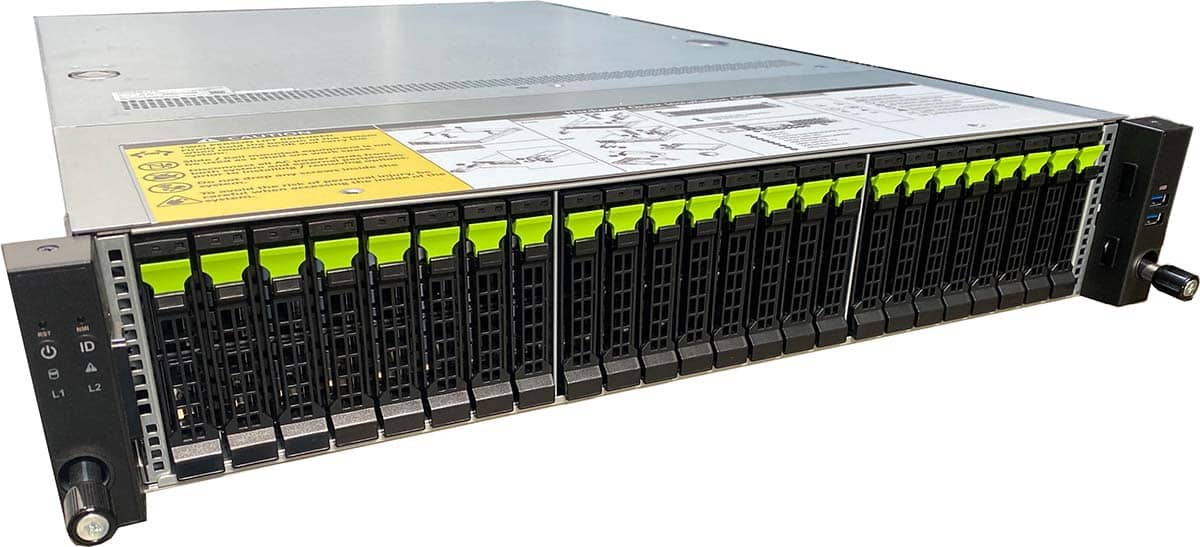
Flash 加速盒的功能原型。 硬件组件都是标准的,便于采用。 加速器和存储设备放置在前托架的 U.2 插槽中,同时还有一个用于加速器硬件的内部 PCIe(外围组件互连高速)插槽。
ABoF 使“更多的科学发现成为可能。 将计算放在存储附近可以最大限度地减少数据移动并提高模拟和数据分析管道的效率,”LANL 研究员 Dominic Manno 在最近的 LANL 博客中说。
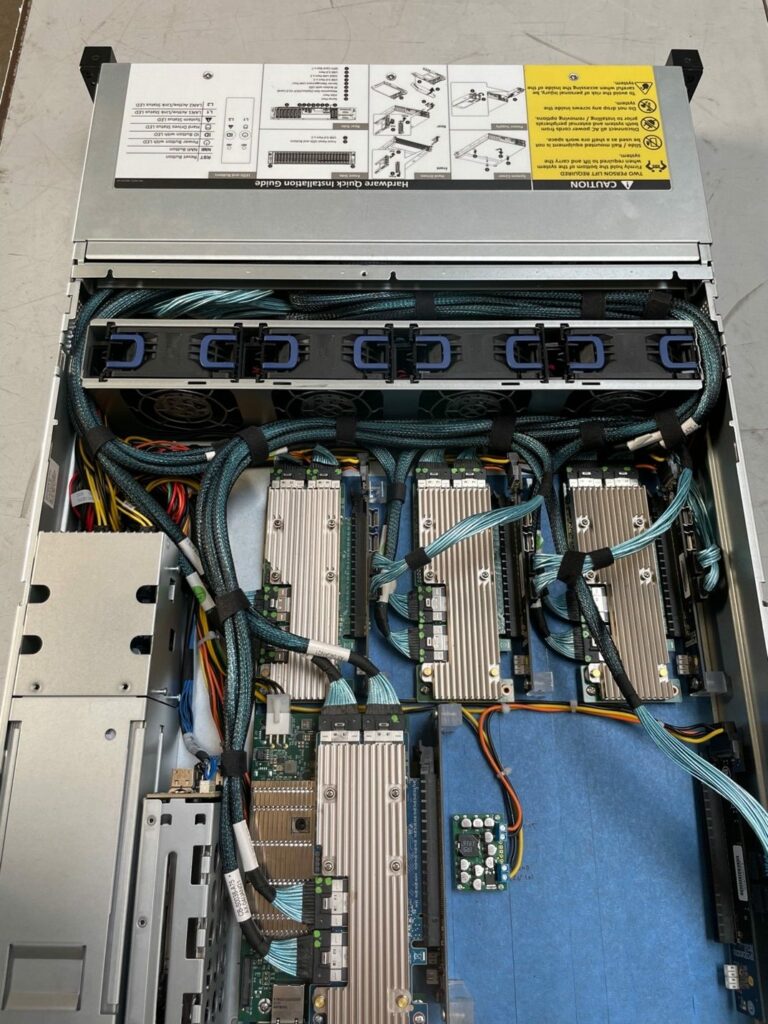
Accelerated Box of Flash 的内部视图显示了 NVMe SSD(机箱正面)与 BlueField-2 DPU 的连接。 右上角是加速器的 PCIe 位置。 该演示使用了 Eideticom NoLoad 设备。
企业中的 DPU
我们已经看到不少分布式处理单元 (DPU) 进入主流企业数据中心。例如,VAST Data在其新型 Ceres 全闪存存储节点中就采用了 DPU。虽然 DPU 是一项竞争性技术,但Fungible也已将其应用于存储和解耦式 GPU 产品中。显然,我们仍处于早期阶段,但网络和系统管理员应该尽快了解 DPU 如何助力提升系统和应用程序的交付效率。


 Amazon