

历史上,GPU 读取的每一个存储数据都必须经过主机 CPU,CPU 负责管理文件系统、提交命令并返回数据。对于大型顺序传输而言,这种开销可以忽略不计,但当每秒处理数百万次 512 字节的操作时,就会成为瓶颈。在圣克拉拉举行的 2026 年 FMS 大会上,NVIDIA 发布了新的软件和一项行业倡议,旨在消除这一瓶颈。
此次发布的核心内容是 cuFile,这是一个允许 GPU 直接读写存储设备的 API。NVIDIA 将 cuFile 及其完整的支持软件栈开源,代码托管在 GitHub 上新成立的 XIO-SIG 组织中。创始维护者包括 Google、Intel、Meta 和 NVIDIA。此外,NVIDIA 还正式启动了 Storage-Next 项目,该项目至少从 GTC 2025 大会起就已公开讨论。Storage-Next 目前已汇集了 40 多家存储和闪存厂商,例如 DDN、KIOXIA 和 Micron,以及控制器制造商、散热专家和标准组织。这些参与者正在共同定义当客户端是 GPU 而非 CPU 时,存储设备应该如何运行。
问题:主机介导的 I/O
传统上,GPU 系统采用以主机为中心的 I/O 模型。CPU 负责调度 GPU 任务、准备数据,并发起 GPU 与网络或存储之间的所有数据传输。每个操作都遵循一定的顺序:GPU 内核完成,控制权返回给 CPU,CPU 设置传输,然后启动下一个内核。每次操作的成本主要包括内核启动和 CPU-GPU 同步开销,以微秒为单位。对于批量传输而言,这种开销可以忽略不计,但对于细粒度操作而言,这种开销就变得相当显著了。
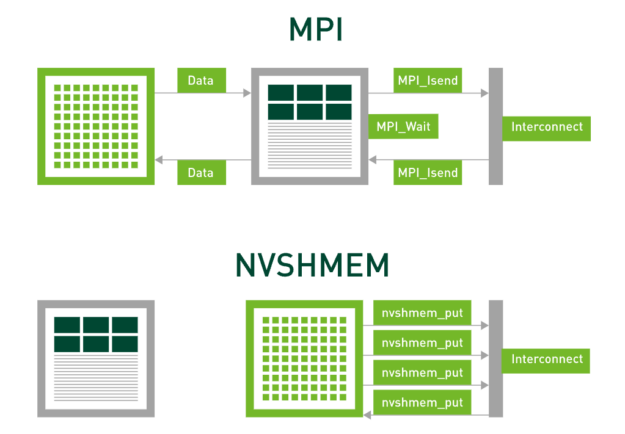
对于 GPU 间的通信,NVIDIA 通过 NVSHMEM 消除了主机参与,使设备代码能够直接发起传输并将其与计算重叠。其影响显著:当 GROMACS 将其光环交换通信从 MPI 迁移到 NVSHMEM 时,通信从关键路径中移除,并与计算完全重叠。
存储过程保留了主机中介模型。从 NVMe 驱动器读取数据仍然会将控制权交还给 CPU,运行文件系统并等待完成。训练过程可以容忍这种情况,因为它的读取操作量大且频率低。但推理过程则不然。提供键值缓存条目、嵌入向量和向量搜索结果每秒会产生数百万次小的随机读取操作,而每次读取操作都需要 CPU 参与。
GPU 启动的 I/O 和 SCADA
SCADA(可扩展、加速的数据访问)将 NVSHMEM 模型应用于存储,使 GPU 能够启动和管理自己的存储 I/O。
这项基础研究成果是 BaM(Big Accelerator Memory,大型加速内存),由 NVIDIA、IBM、伊利诺伊大学和布法罗大学联合发表于 ASPLOS 2023 会议。BaM 展示了 GPU 直接管理 NVMe 驱动器,将各个线程生成的小请求合并并缓存,从而在无需主机干预的情况下维持接近驱动器饱和的队列深度。在相同的硬件配置下,BaM 处理数据分析工作负载的速度比 CPU 发起的访问快 5.3 倍,并且从闪存执行图工作负载的硬件成本比将相同数据存储在主机内存中最多可降低 21.7 倍。
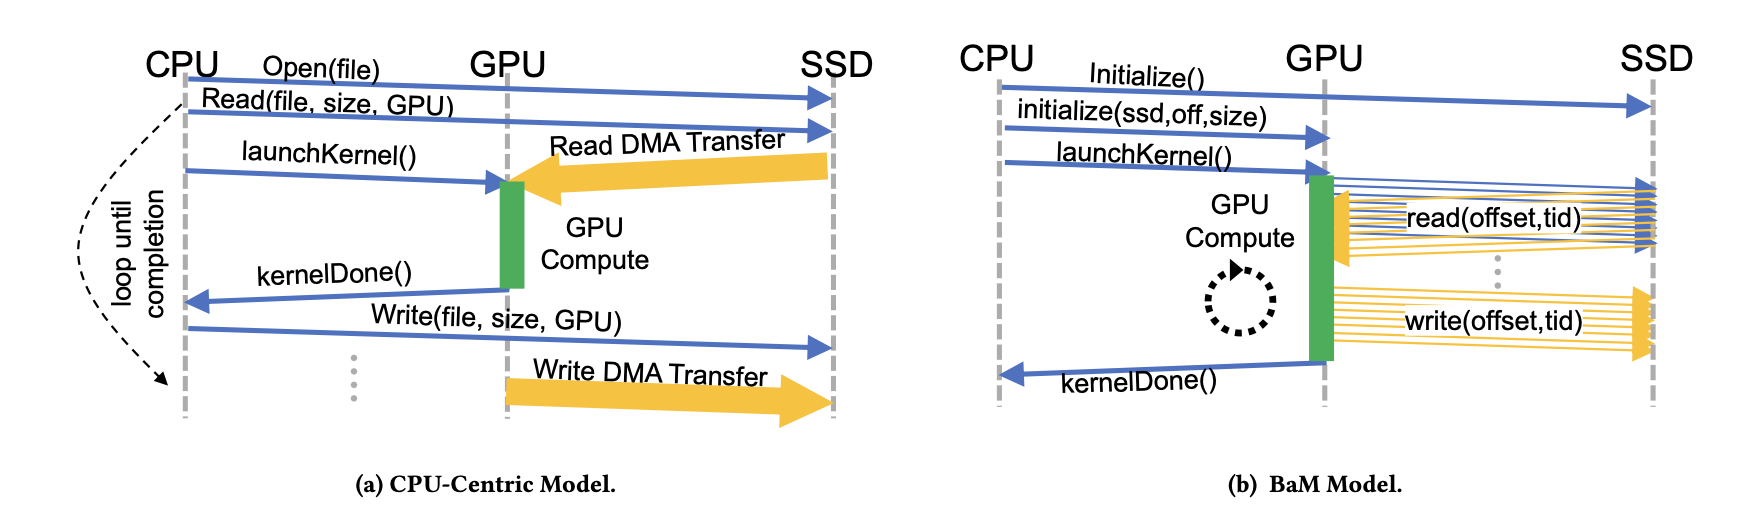
SCADA是其产品化形式。GPU上的运行时环境位于内核线程和存储设备之间。它将分散的小请求合并成读取操作,这些操作要么从GPU缓存中获取数据,要么发送到驱动器,驱动器可以是本地NVMe固态硬盘,也可以是远程存储服务器。
必须限制对设备的直接访问,因为对共享驱动器的原始访问可能导致一个应用程序读取或损坏另一个应用程序的数据。NVIDIA 的设计将权限级别分开。应用程序中对性能至关重要的部分以非特权模式运行,位于可信计算基之外。特权组件在设置时使用标准的 Linux 安全机制,为每个应用程序与其授权存储设备之间配置受保护的访问。NVIDIA 指出,正是这种权限分离和基于 Linux 的互操作性,使得该技术栈以开源形式发布,而不是作为封闭的 CUDA 组件发布。
SCADA 与 GPUDirect 存储有何不同
每次存储操作都包含数据路径(移动的字节)和控制路径(请求的构建、提交和完成处理)。GPUDirect Storage (GDS) 于 2019 年推出,并于 2021 年开始供货,它将 CPU 从数据路径中移除:通过 cuFile,数据通过 DMA 在驱动器和 GPU 内存之间传输,无需在主机 RAM 中使用缓冲缓冲区。NVIDIA 的发布资料显示,DGX-2 的 CPU 路径速度上限为 50GB/s,而 GDS 能够合并路径,使速度上限接近 200GB/s。DDN、VAST、WEKA、Pure Storage 和其他主要 AI 存储厂商均已通过 GDS 认证。控制路径仍然保留在 CPU 上:主机软件仍然决定要获取哪些数据并发出每个请求,而 GPU 是 DMA 的目标,而不是发起者。
在大传输量的情况下,这种分配方式效果很好。1MB 的读取操作可以将控制路径的成本分摊到几乎为零。但当读取量达到 512 字节时,情况就相反了。每次请求的固定成本占据主导地位,CPU 的负载会远高于硬盘的负载。SCADA 将控制路径转移到 GPU 上,GPU 通过保持数十万次操作的运行,以与吸收内存延迟相同的方式吸收每次操作的延迟。
两者并存:cuFile 用于批量传输,SCADA 用于大量小随机读取。
Storage-Next 和 512 字节问题
SCADA 负责 GPU 端。Storage-Next 则负责硬盘端,目前针对不同的工作负载进行了优化。
企业级固态硬盘 (SSD) 十年来一直针对 4KB 随机读取进行优化,以匹配数据库和虚拟化的访问模式。大多数控制器处理 512 字节读取和 4KB 读取所需的工作量大致相同,因此小于 4KB 的请求会以 4KB 的成本运行。推理访问模式则更小:嵌入数据占用几百字节,键值缓存块远小于 1KB。如果从针对 4KB 优化的驱动器来处理这些数据,则会导致 8 倍的读取放大,从而浪费带宽和控制器缓存。当存储数十 TB 的小对象时,这种放大效应决定了闪存作为存储层的可行性。
Storage-Next 旨在围绕更小的存储单元重新设计驱动器、控制器和系统。该项目在 GTC 2025 大会上正式亮相,目前已在进行中,其目标是在功耗和尾延迟限制下,最大限度地提高每个 GPU 的 512 字节 IOPS。在 FMS 大会上,NVIDIA 公布了成员名单,涵盖了 40 多家存储和闪存厂商,并指定 SCADA 作为构建框架。
参考结果是美光在SC25大会上演示的单台服务器在SCADA编程模型下实现了230亿512字节随机读取IOPS:该服务器由44块美光9650 PCIe Gen6 SSD组成,这些SSD位于三台博通PEX90000 Gen6交换机之后,由三台H100驱动,安装在H3平台Falcon 6048机箱内。该数值约为44块SSD总额定IOPS(5.5万)的95%。
这个数字的构成至关重要。230亿次512字节的读取操作相当于大约118GB/s的有效载荷,这相当于四到五个硬盘可以顺序传输的数据量。真正的突破在于操作次数。如果仅通过主机软件来维持如此庞大的运算量,光是提交和完成的处理就需要占用数十个CPU核心,而演示中使用的单个CPU几乎处于空闲状态。如果将这些操作分配到GPU的十万多个线程上,每个线程每秒只需执行几千次操作。
SSD 的性能如今已成为关键因素。美光 9650 是首款 PCIe Gen6 SSD,顺序读写速度高达 28GB/s,随机读取 IOPS 更是达到了创纪录的 5.5 万。美光在演示中表示,其性能可从 1 个硬盘线性扩展到 44 个硬盘。铠侠 (Kioxia) 的 GP 系列是一款专为 512 字节访问而设计的 XL-Flash SSD,目前正在 Storage-Next 计划下进行开发。NVIDIA 的 Storage-Next 路线图要求 PCIe Gen7 SSD 的单块 IOPS 达到 100 亿,包括 Marvell 在内的控制器厂商目前正朝着这个目标进行设计。要达到这样的性能,需要重新设计控制器,改进针对小负载的纠错机制,并制定定义 GPU 原生驱动器行为的标准。
映射到训练和推理
这两条路径对应两种访问模式。训练过程受限于带宽。它会传输大型顺序分片,并定期写入数TB的检查点,在此期间GPU处于空闲状态。在这种传输规模下,CPU开销可以忽略不计,因此GDS和新开源的cuFile协议栈仍然是正确的接口,其性能以每GPU的GB/s和检查点持续时间来衡量。
推理性能受限于 IOPS。KV缓存(会话中已处理的每个标记的注意力状态)会随着上下文长度的增加而增长。智能体部署会同时运行数千个并发会话。这很快就会超出 GPU 内存的限制,而重新计算已驱逐的条目比重新读取它们消耗更多的 GPU 时间。标准设计采用分层缓存,缓存从 GPU 内存溢出到系统内存再到闪存,并通过大量的随机小读取操作进行填充。向量搜索和嵌入查找也遵循相同的模式。这正是 SCADA 系统所追求的访问模式,也是 NVIDIA 以 512 字节 IOPS 而非带宽来衡量性能的原因。从闪存而非内存中提供 KV 缓存会增加每个 GPU 支持的上下文数量和并发用户数量,从而决定每个用户的服务成本。
硬件:Vera BlueField-4 STX 和 CMX
平台层采用的是NVIDIA Vera BlueField-4 STX,这是在 GTC 2026 上推出的机架级存储架构,并于本周进行了扩展。STX 将 Vera Rubin 平台与 BlueField-4 存储处理器相结合,每个处理器都集成了 Vera Arm 内核、800Gb/s 的集成网络以及大约 6 倍于 BlueField-3 的计算能力。
在FMS大会上,NVIDIA发布了这些核心的基准测试结果。一个代表适用于所有流量的内联数据服务存储系统的两阶段压缩和加密流水线,在Vera芯片上的吞吐量最高可达x86 CPU的3.21倍。这意味着目前在存储控制器中占用x86核心的加密、压缩和验证功能,可以迁移到Vera芯片上,从而降低功耗。NVIDIA的BlueField软件框架DOCA负责在数据路径中强制执行安全策略。基于STX的CMX上下文内存存储将BlueField-4背后的闪存池化为共享的KV缓存层,用于长上下文推理。来自DDN、戴尔、HPE、IBM、VAST Data、WEKA等合作伙伴的系统预计将于2026年下半年上市。
关闭的思考
战略架构清晰:NVIDIA 正在发布 GPU 用于访问存储的接口,开源其实现,并组织 40 多家供应商来规范底层硬件的行为。开放 cuFile 打破了 NVIDIA 将该层保留在 CUDA 内部的惯例。但只有当驱动器、控制器和阵列供应商都基于此接口进行开发时,GPU 发起的存储接口才能真正发挥作用。英特尔加入维护行列是一个值得关注的信号。作为当前存储系统中 x86 芯片的主要供应商,英特尔正在支持旨在将该芯片从 I/O 路径中移除的软件。
美光的演示证明了这种方案的可行性。三块GPU驱动44块第六代固态硬盘,使其读写速度达到额定读写速度的约95%,而这种小块大小的固态硬盘一直以来都被业界忽视。现在的问题在于执行:代码需要上线GitHub,SCADA系统需要从框架发展成为受支持的CUDA组件,以及厂商需要批量出货针对小块读取优化的固态硬盘。以上数据来自NVIDIA及其合作伙伴,并非独立测量结果。我们将在今年下半年STX系统到实验室后进行测试。


 Amazon