

闪迪已完成首款高带宽闪存芯片的流片。该公司在8月13日举行的2026年投资者日活动上,在题为“HBF路线图”的幻灯片中展示了该芯片,旁边还附有一张芯片实物图。幻灯片的后半部分介绍了首批HBF推理产品样品:即将于2027年推出。

对于任何新的硅芯片而言,流片都是一个重要的里程碑。它意味着设计已经完成并最终确定到掩模版上,这标志着架构从纸面设计转变为硅片实体。但这距离产品问世还有很长的路要走。晶圆需要从晶圆厂返回,芯片必须达到目标规格,良率必须提升到经济可行的水平,然后芯片还必须能够承受堆叠成8层和16层结构,并在其下方放置一个工作逻辑芯片和控制器。之后还有热性能和耐久性认证、用于实际处理存储器的加速器软件开发,以及以季度为单位的客户认证周期。闪迪告诉投资者,这些步骤中的第一步已经完成。
Sandisk 表示 HBF 的性能如何
HBF采用NAND闪存而非DRAM,并将其封装在类似HBM的封装中,与加速器并排排列。根据SanDisk官方发布的HBF产品介绍,第一代产品每个堆叠容量为512GB,由1.6个256Gb的芯片组成,读取带宽为16TB/s。SanDisk声称,在成本相近的情况下,HBF的容量可达HBM的8到16倍,且封装尺寸、堆叠高度和功耗均与HBM4非常接近。由于采用NAND闪存,因此它是非易失性的,无需进行刷新操作。
产品概况介绍中的路线图更进一步。第二代产品的目标是吞吐量超过 2TB/s,单堆栈容量高达 1TB,功耗仅为第一代的 0.8 倍;第三代产品则将吞吐量提升至 3.2TB/s 以上,单堆栈容量高达 1.5TB,功耗仅为第一代的 0.64 倍。投资者日演示文稿清晰地阐述了目标工作负载:混合专家级 LLM、长上下文长度和大型键值缓存,其架构开发过程中充分考虑了主要云和人工智能客户的反馈。
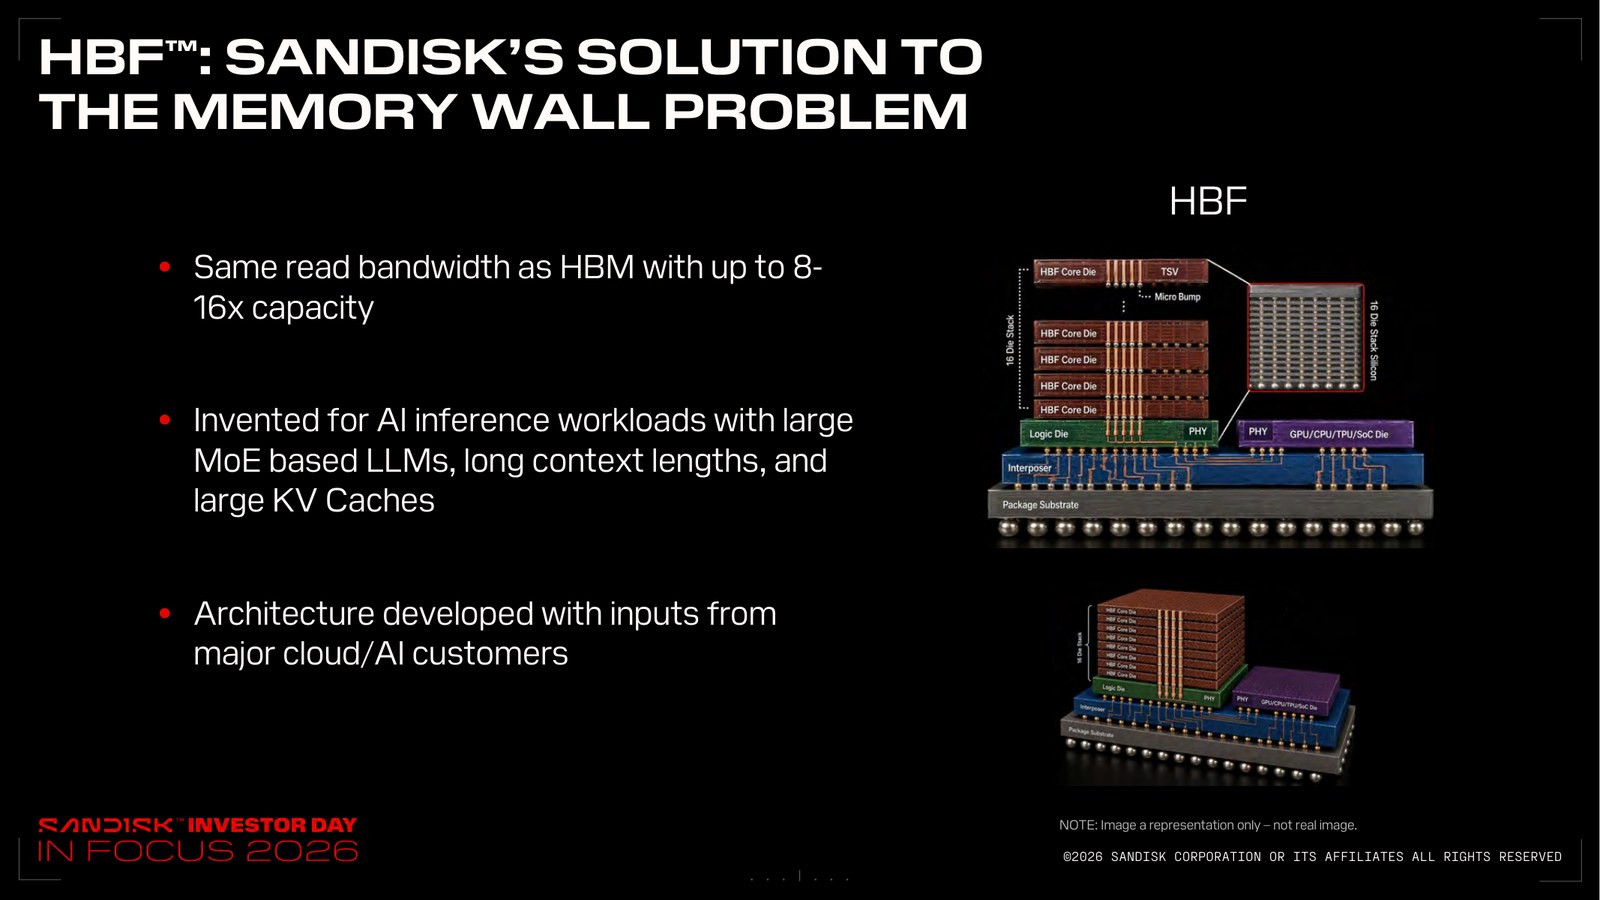
该文档还列出了三种部署方案。HBF 可以增强 HBM,填充 xPU 周围的部分堆栈位置,而 HBM 则保留其余位置。它也可以完全替换 HBM 堆栈,占用空间相近。或者,它可以以分离的方式部署,存储解码权重和键值缓存,而较小的 HBM 层则用作缓存。这种灵活性比听起来更重要,因为它允许 HBF 接入插槽,而无需加速器厂商放弃 HBM。
闪迪屏幕上显示的内部数字
闪迪展示了一张推理令牌输出对比图,分别涵盖了单颗 HBF GPU、四颗 HBF GPU 和八颗 HBM GPU。基于此,该公司提出了两项声明,均标明基于内部测试。第一项是资本支出效率提升 8 倍,指的是运行该模型所需的最低配置:单颗 HBF GPU 即可达到八颗 HBM GPU 的水平。第二项是 GPU 效率提升 2 倍:四颗 HBF GPU 即可达到八颗 HBM GPU 的相同令牌输出。产品资料还补充了一个相关的模拟结果:在读取 Llama 3.1 405B 的预训练权重时,HBF 的性能与无限容量的 HBM 相比,差距仅为 2.2%。
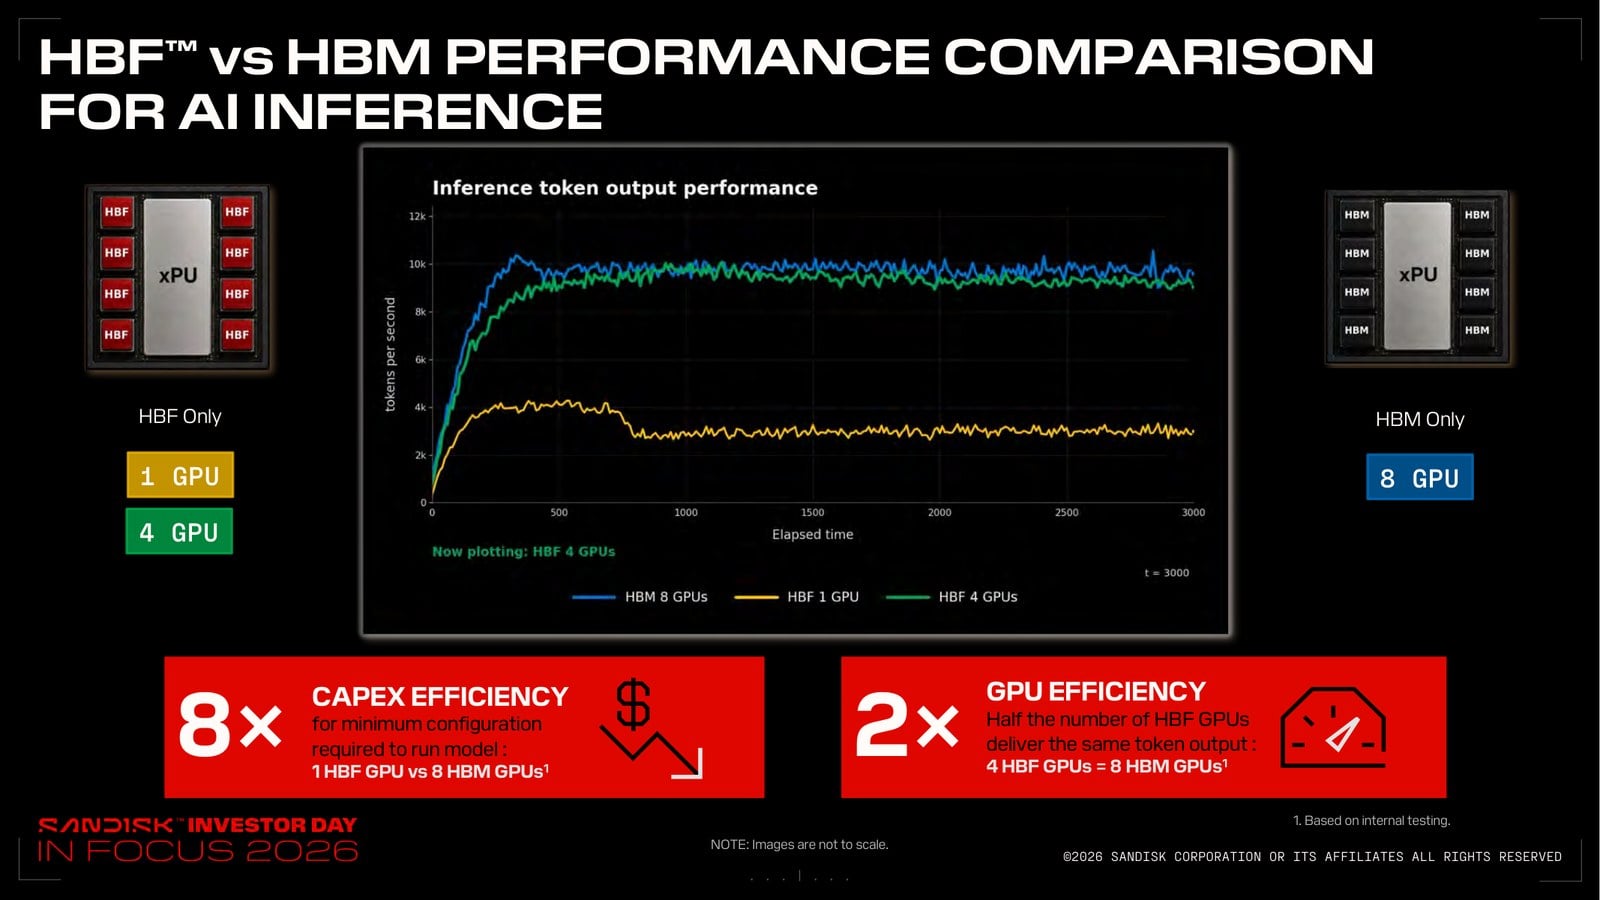
这些数据来自厂商提供的未发布芯片,而且相关图表中并没有每秒令牌数的坐标轴数值。不过,它们仍然能说明问题:如果一个模型在相同带宽和大致相同功耗下,能够加载到比现有模型大 8 到 16 倍的内存中,那么你需要的加速器数量就会减少,而且现有加速器的等待时间也会缩短。
时间线现状
为了便于规划,闪迪的两份声明大致确定了时间表。2025年8月,该公司表示,首批HBF样品计划于2026年下半年推出,采用HBF的AI推理设备预计将于2027年初上市。截至2026年8月的投资者日,首批HBF推理产品样品预计将于2027年推出。随着设计转化为芯片,新型存储器的时间表逐渐确定,而本周期内的第一代平台由于认证方面的实际情况而有所调整。流片表明HBF正在稳步推进。
生态系统方面比硅谷方面进展更快。
标准制定工作进展比产品开发更快。8月3日,SanDisk和SK海力士通过开放计算项目(OCP)发布了首个HBF技术规范,此时距离该联盟成立仅六个月,谷歌和Tensorent等公司也参与了贡献。我们当时报道了该规范及其定义。Tensorent的Jim Keller在发布会上被任命为技术顾问委员会成员。
SK海力士是该规范的共同制定者之一,并在2026年FMS展会上展示了其分层存储器方案。SK海力士在决定该方案最终是成为行业标准还是单一厂商产品方面也扮演着重要角色。目前,闪迪已经完成了芯片流片,公开了规范,并计划在2027年提供样品。下一个真正的考验是芯片能否达到标准,而这将取决于晶圆厂的报告,希望闪迪能在不久的将来就此发表更多评论。



 Amazon