

Scality 今日发布了 Scality AI Inference Factory,这是一个开源软件栈,用于在客户自有基础设施上运行开源权重模型。Scality 负责验证、交付和维护整个软件栈,该软件栈将 Scality 的AI 数据基础设施 (ADI)对象存储置于推理层下方,作为共享的键值 (KV) 缓存。Scality AI Inference Factory 的目标用户是希望寻找替代按令牌计费云推理方案的企业、政府机构和新型云服务提供商。
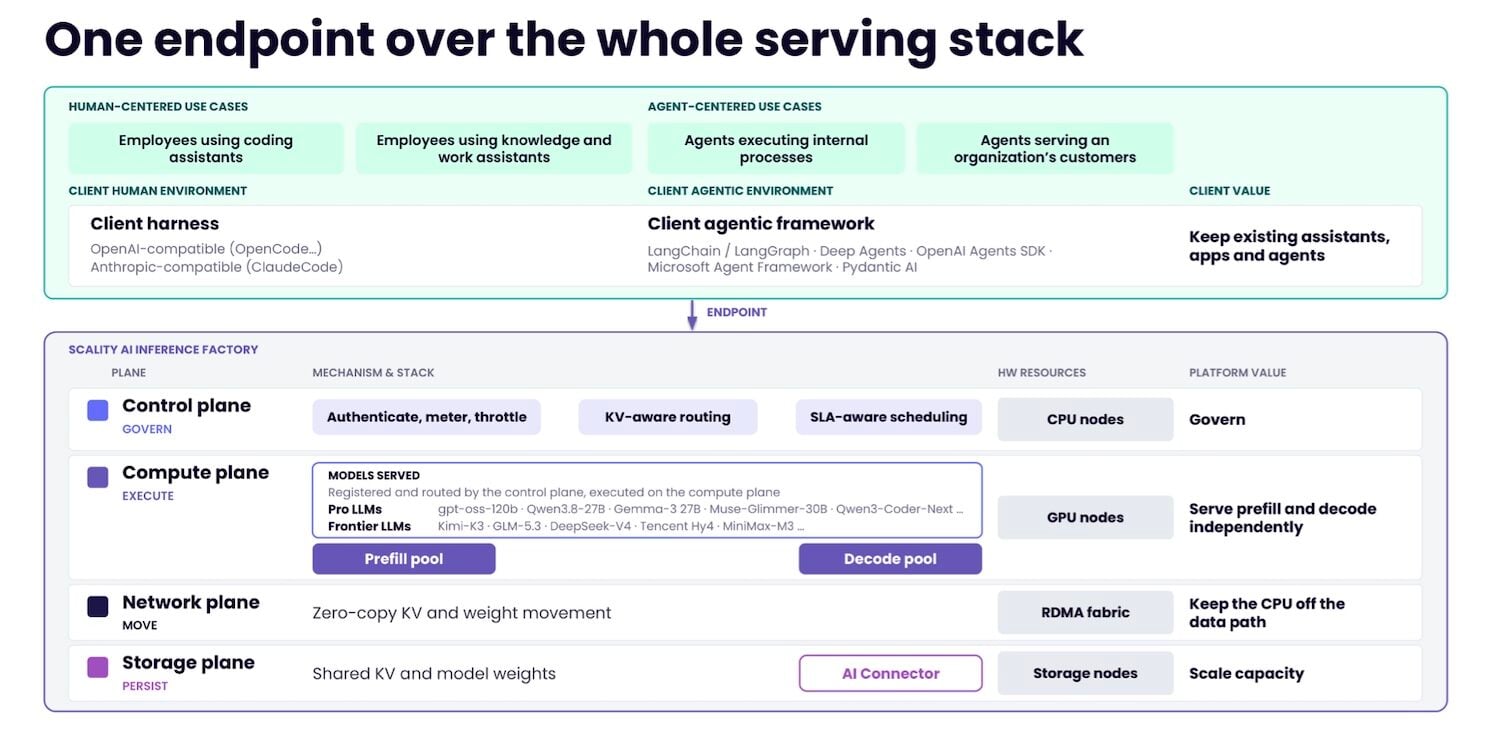
Scality 将此次发布定位为以成本和控制为核心。每个被证明有效的流程都会增加代币价格,提供商可以根据自身需求更改模型版本和量化方式,而受监管的机构则必须将提示、文档和代码发送到他们自身并未运行的基础设施。该技术栈的目标应用包括编码助手、专用聊天机器人和代理应用程序。Scality 表示,一旦开发者将 Claude Code、Codex 和 OpenCode 等工具指向本地端点,它们就能继续正常工作。
基于 RDMA 的解耦式服务架构和键值缓存
该技术栈结合了经过验证的开放权重模型、基于 vLLM 和 Dynamo 构建的服务层(将预填充和解码分离,使每个 GPU 池能够独立扩展)以及控制平面(用于验证和计量请求、将请求路由到持有相关上下文的 GPU,并根据 SLA 目标调度任务)。底层是 ADI,它存储模型、企业数据和推理状态,并通过 Scality AI Connector 连接到 GPU。
ADI 的主要任务是将 KV 缓存保存在 GPU 高带宽内存之外。预填充池计算新提示符的缓存并将其写入 ADI,解码池则将其读取回来,这样任何解码 GPU 都可以处理任何返回的会话。vLLM 将缓存分割成固定大小的命名块,ADI 将这些块存储为对象。在此过程中,AI 连接器将 S3 控制平面替换为一个精简版的控制平面,该控制平面使用单次身份验证,并丢弃了 XML 和多部分帧。
读取数据时,GPU 会预留内存并告知 ADI 要将哪个对象放入该内存。存储服务器通过 PCIe 将对象从 TLC NVMe 固态硬盘移动到其 RAM 中,然后网卡通过 RDMA 将对象直接写入 GPU 内存,因此数据绕过了 CPU、内核和软件栈。Scality 表示,该路径可以达到 GPU 和存储之间网络线路速率的 97%。
Scality 首席技术官 Giorgio Regni 描述了这对服务器服务带来的变化:“Scality ADI 上的 KV 缓存速度足够快,可以放在服务器服务路径中。从 ADI 恢复上下文的速度与 GPU 内存的速度处于同一数量级,比重新计算快 14 倍,而且 GPU 始终保持忙碌状态。存储不再是把 KV 缓存放在 GPU 服务器内部的原因。”
基准和内部绩效指标
Scality 特意在一个规模较小的实验室中进行测试:一台八 GPU 服务器、五台几代前的存储服务器和四条 100Gb/s 的 RDMA 链路,这使得网络成为瓶颈。Scality 表示,其产品本身运行在 400Gb/s 的网络架构上,但并未透露测试服务器中使用的 GPU 型号。
从 ADI 恢复的 14K 个令牌上下文的首次令牌获取时间为 166 毫秒,比从 HBM 提供相同上下文慢 83 毫秒。重新计算该上下文耗时 2.3 秒,因此检索速度提高了 14 倍。在 GLM-5.2 上,使用 438,764 个令牌的上下文时,重新计算耗时 529 秒,读取耗时 7.3 秒,两者相差 72 倍。此外,该单次会话产生了 189GB 的键值缓存,平均每个令牌约 430KB,超过了模型加载到所有八个 GPU 后 HBM 的剩余空间。
在第二次测试中,每个 GPU 运行一个 vLLM 实例,ADI 拥有 8TB 的键值缓存,是单个 GPU 内存的 80 多倍,大约是整个服务器内存的 10 倍。从 69GB 到 8TB 的所有缓存大小下,首令牌延迟都保持在 355 到 373 毫秒之间,令牌间延迟也没有变化,因为获取操作在首令牌之前就已经完成。Scality 表示,该容量支持多达 1,000 个并发会话,且无需重新计算即可恢复。
加载模型权重的路径相同,Gemma-3 27B 的 54.86GB 权重在 1.9 秒内加载到单个 GPU 上,Scality 表示这比 GPU 服务器本地驱动器的读取速度快近 10 倍,因为读取操作分散到存储层的多个驱动器上。这大约相当于 28.9GB/s 的速度,约占四个 100Gb/s 链路总速度的 58%。Scality 还表示,根据负载情况,一个 GPU 每天最多可以交换模型一千次。
Scality 还表示已将修复程序提交至上游。vLLM 的 KV 卸载连接器每次恢复时都会获取大约五倍于实际所需的缓存块,Scality 在不修改 vLLM 核心代码的情况下修复了该连接器。此外,它还扩展了开源的 ModelExpress 加载器,使其可以直接从对象存储中提取权重。Scality 表示,最终发布的代码栈中不包含任何 Scality 修改的组件。
硬件兼容性和分层
Scality AI 推理工厂可部署在戴尔、HPE、联想和超微的标准服务器上。ADI 在 NVMe 上以 PB 级规模运行,并通过 RDMA 访问 HDD 以实现大容量键值缓存。单一命名空间可自动将数据分层存储在 TLC 闪存、HDD 和可选磁带上,从而使模型权重、企业数据和冷缓存能够根据读取频率分别存储在不同的介质上。
经过验证的模型系列包括 Mistral、Gemma、gpt-oss、Qwen、Kimi、GLM 和 DeepSeek,并且该技术栈兼容 OpenCode、Hermes、Goose、LangGraph 和 Pydantic AI 等框架和代理框架。每个组件都以开代码形式发布,因此客户可以查看推理状态的存储和传输方式,并提交更改供 Scality 的工程师审核。
Scality AI推理工厂现已推出软件许可版和完全托管服务版。Scality今天在巴黎举行的Scality Day活动上展示了该技术栈及其参考架构。


 Amazon