

Supermicro 推出了基于 NVIDIA Vera Rubin NVL4 平台的全新高性能计算 (HPC) 数据中心构建模块解决方案 (DCBBS) 蓝图。此次发布将 Supermicro 的 DCBBS 架构战略从企业级 AI 部署扩展到科学计算环境,为部署大规模 HPC 和 AI 基础设施提供了一个参考框架。
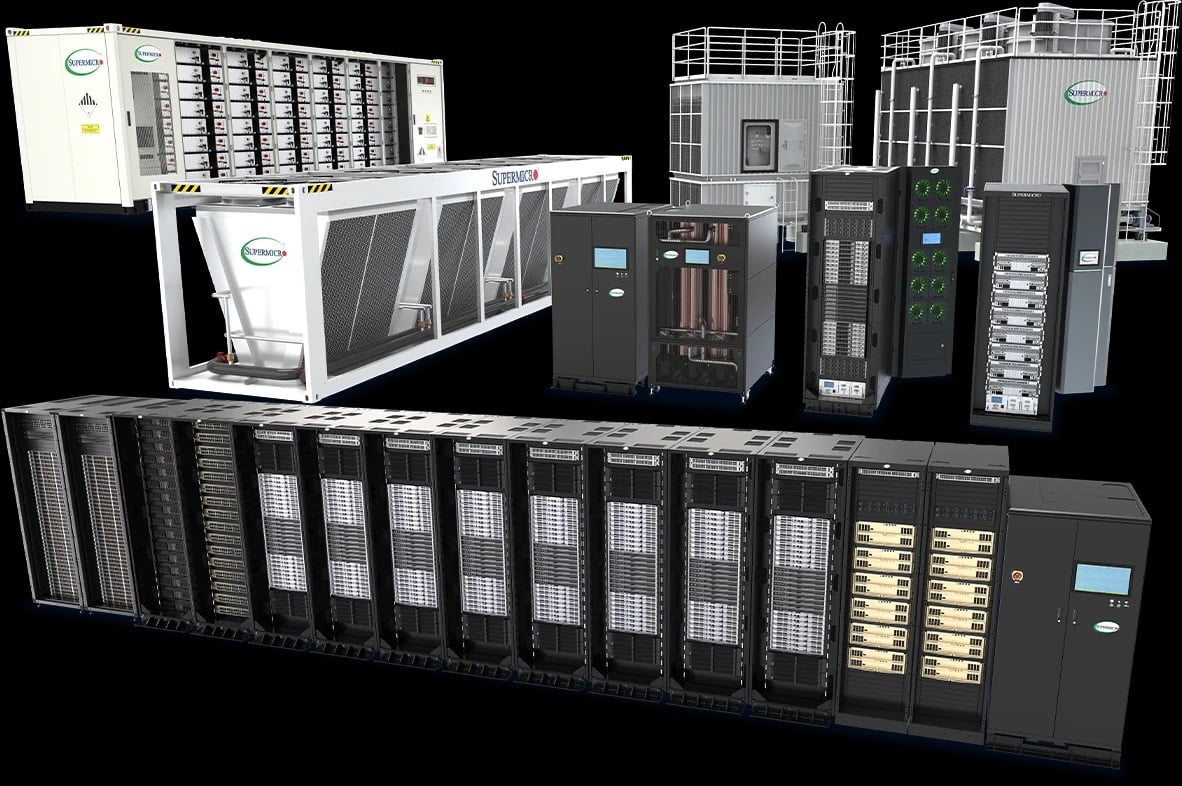
新的设计方案沿用了今年早些时候发布的 NVIDIA Vera Rubin NVL72 和NVIDIA HGX Rubin NVL8 DCBBS设计,并将同样的集成方法应用于科研机构、国家实验室和超级计算中心。Supermicro 的 DCBBS 框架将计算、网络、液冷、配电和设施基础设施整合到一个预先设计的部署模型中,从而降低了实施复杂性并加快了集群部署速度。
Supermicro总裁兼首席执行官梁志强表示,人工智能正成为现代科学研究的重要组成部分。他指出,能够快速部署先进基础设施的机构将更有利于推动未来的科学发现。他还强调,公司在构建大规模液冷GPU集群方面的经验是这一新蓝图的关键因素。
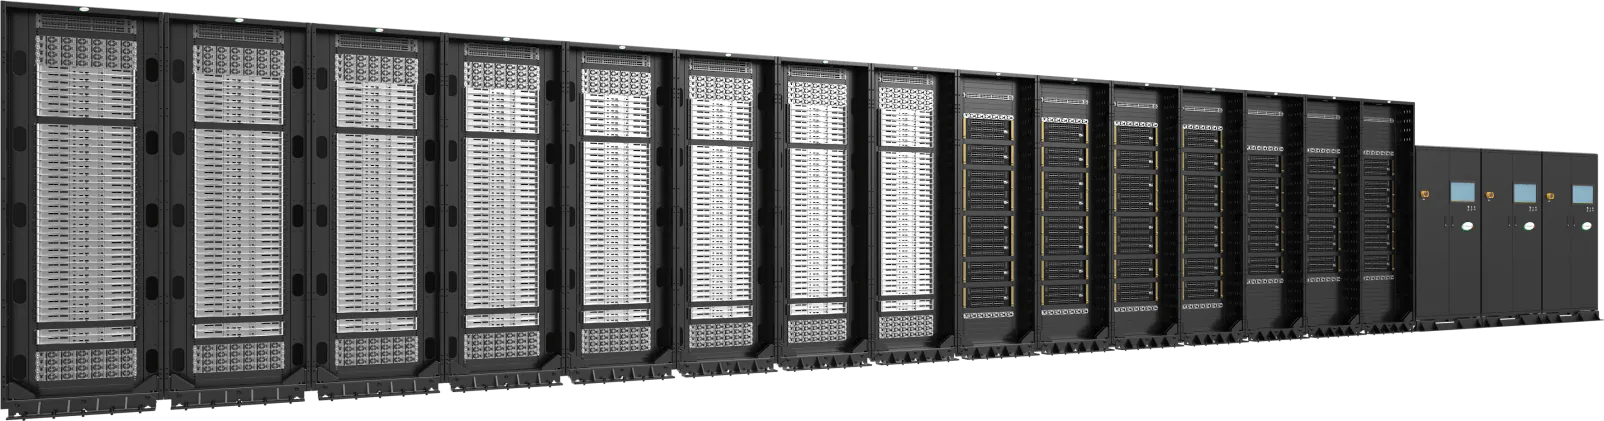
专为融合型高性能计算和人工智能工作负载而设计
该蓝图围绕传统高性能计算模拟与人工智能加速计算日益融合的趋势而构建。研究机构越来越多地将双精度模拟工作负载与机器学习和人工智能模型相结合,以缩短开发周期,并加速气候建模、药物发现、材料科学和能源研究等领域的科学发现。
Supermicro 将NVIDIA Vera Rubin NVL4平台定位为这些混合工作负载的基础,它将大规模 GPU 加速与 CPU 资源和高性能网络相结合。该公司指出,其部署方法基于构建包含超过 100,000 万个 GPU 的液冷超级计算集群所积累的经验。
端到端部署方法论
DCBBS 蓝图概述了 Supermicro 用于大规模液冷基础设施项目的部署流程。
项目首先进行现场设施评估,评估内容包括装卸货平台通道、数据中心机房尺寸、楼层承重能力以及现有电力和冷却基础设施。评估结果将用于制定针对特定场地的部署方案。
系统集成在Supermicro的生产工厂内完成,包括机架组装、布线以及系统级(L10)和集群级(L11)验证测试,所有工作均在发货前完成。交付后,部署服务包括机架安装、网络集成、电源和散热连接、调试以及运行验证。
Supermicro 还提供持续的支持服务,包括针对关键任务研究和生产环境的现场响应选项。
Vera Rubin NVL4 可扩展单元架构
该蓝图以可重复使用的 NVIDIA Vera Rubin NVL4 可扩展单元为中心进行组织,可以复制以创建从约 3.2MW 部署到接近千兆瓦规模的设施的集群。
每个可扩展单元由八个液冷计算机架组成,采用定制的 52U 机箱。该配置支持 288 个 NVIDIA Vera Rubin NVL4 节点,最多可集成 1,152 个NVIDIA Rubin GPU和 576 个 NVIDIA Vera CPU。单个机架的运行功率为 362kW。
散热采用 Supermicro 的 DLC-2 直接液冷架构。每个可扩展单元包含三个并排的冷却分配单元,每个单元的额定功率高达 1.8MW,采用 2+1 冗余配置。该冷却设计融合了芯片级冷板、垂直冷却液分配歧管以及 Supermicro 的 PG25-A 冷却液配方。
网络基于 NVIDIA Quantum-X800 InfiniBand 基础架构,提供分布式高性能计算 (HPC) 和人工智能 (AI) 工作负载所需的低延迟、高带宽互连。此外,还提供液冷网络配置。
每个计算机架的电源供应由八个 72kW 电源架负责,而两个机架顶部管理交换机提供带外监控和控制。
GB200 NVL4 部署可立即投入使用
除了基于 Vera Rubin 架构的架构外,Supermicro 还表示,基于 NVIDIA GB200 NVL4 的配置可立即提供给寻求近期部署方案的组织。
该公告反映了行业持续向集成式机架级基础设施设计转型,将计算、网络、电源、冷却和管理功能整合到预先验证的部署模型中。随着人工智能和高性能计算工作负载的不断融合,供应商越来越注重降低部署复杂性,同时支持更高的机架密度和液冷环境。


 Amazon