

Supermicro 今日联合 IBM 和 NVIDIA 发布了一款 KV 缓存存储解决方案,该方案将长上下文推理背后的键值状态从 GPU 转移到共享的全闪存层。该方案整合了基于 AMD EPYC 9005 处理器的 Supermicro Petascale 存储服务器、IBM Storage Scale、NVIDIA Dynamo 和 NVIDIA Spectrum-X 以太网,并由 IBM 发布的经过验证的参考架构(以 Redbook 的形式呈现)作为支持。该方案最显著的优势在于,在 130,000 万个令牌的提示中,与需要从头开始重新计算上下文的 GPU 相比,首次令牌生成时间缩短了 56 倍。
为什么键值缓存需要存储层
推理过程分为两个阶段:预填充阶段将提示信息转换为词元,并将其传递给模型以生成中间键值状态;解码阶段则根据这些状态逐个生成响应词元。将键值状态保存在持久缓存中,可以让系统在下一轮、下一个代理步骤或共享同一上下文的下一个请求中重用该状态,从而避免重新计算。
代理工作流、编码助手、长上下文 RAG 和多轮应用程序会产生大量的这种状态,从而迅速溢出 GPU 和 CPU 内存,这就是为什么 Supermicro、IBM 和 NVIDIA 正在构建网络存储层的原因。
在这个设计中,NVIDIA Dynamo 管理缓存层次结构并通过 NIXL 传输数据块;IBM Storage Scale Erasure Code Edition 提供共享文件层;而 Petascale 服务器则提供闪存及其背后的 PCIe Gen5 通道。Supermicro 表示,这三家公司在集群级别上对高并发和嘈杂邻居网络流量环境下的该堆栈进行了测试,并将测试结果定位为交钥匙解决方案,包括工厂机架集成和现场部署,据称可将部署时间从数周缩短至数天。
测试配置
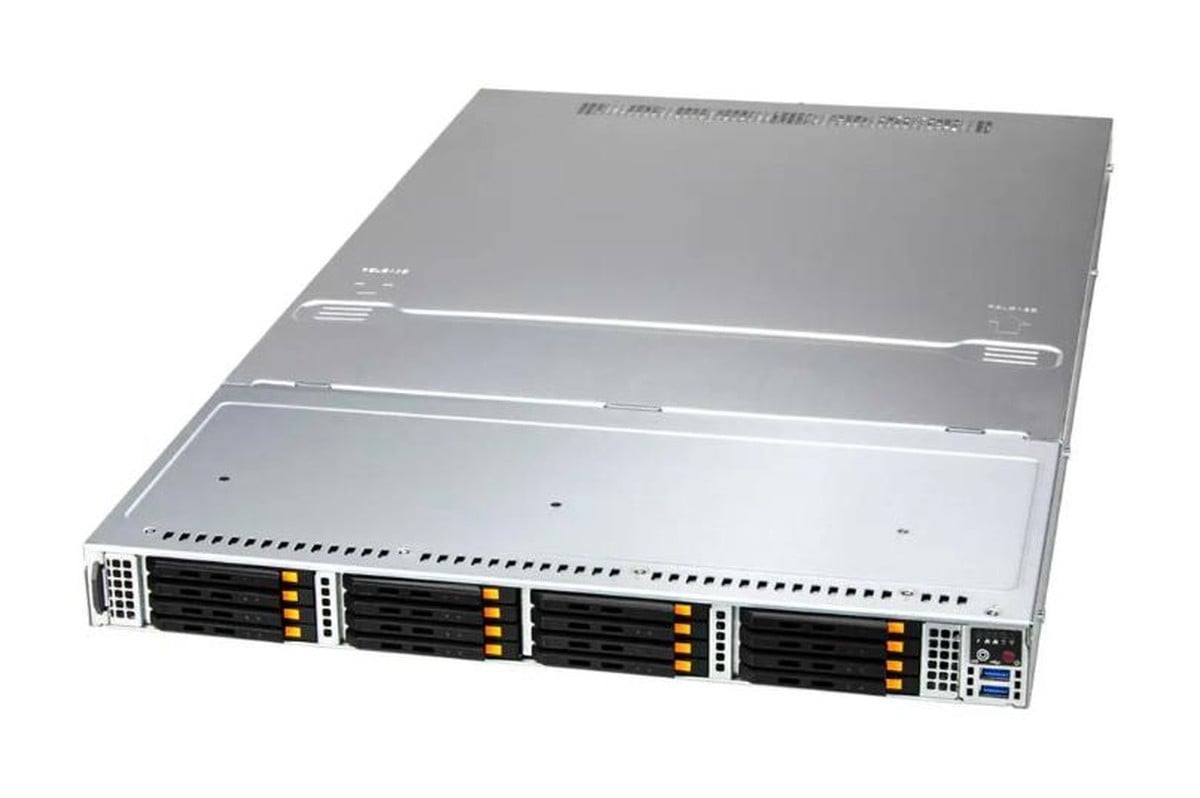
该参考架构采用八个 Supermicro ASG-1115S-NE316R Petascale 节点,每个节点均为 1U 系统,配备一颗 AMD EPYC 9535 处理器和 16 块 Micron 7.68TB E3.S NVMe 固态硬盘,每个节点拥有 122.88TB 的原始闪存容量,八个节点总计约 983TB。每个节点客户端配备一块双端口 200Gb NVIDIA BlueField-3 B3220 固态硬盘,后端存储配备一块 400Gb ConnectX-7 固态硬盘,采用脊叶式架构,并配备三台 Spectrum-X SN5600 交换机和 800Gb/s 上行链路。
存储节点运行 RHEL 9.6 和 IBM Storage Scale ECE 6.0.0.1,采用 8+2P 纠删码布局,IBM 根据之前的测试,表示该八节点层的读取吞吐量为 315GB/s。
| 元件 | KV缓存参考架构(经测试) |
|---|---|
| 存储层 | |
| 存储节点 | 8 个 Supermicro ASG-1115S-NE316R (1U,单插槽) |
| 每个节点的 CPU | AMD EPYC 9535,128 条 PCIe Gen5 通道(64 条用于 NVMe,64 条用于网络) |
| 每个节点的闪存容量 | 16块美光7.68TB E3.S NVMe固态硬盘(122.88TB原始容量) |
| 每个节点的网络 | NVIDIA BlueField-3 B3220,双端口 200Gb(客户端) NVIDIA ConnectX-7 400Gb(存储后端) |
| 交换 | 3 台 NVIDIA Spectrum-X SN5600,脊叶式架构,800Gb/s 上行链路 |
| 存储软件 | IBM Storage Scale 纠删码版本 6.0.0.1,8+2P RHEL 9.6 |
| 推理客户端 | |
| 系统 | Supermicro SYS-212GB-FNR (NVIDIA MGX),Ubuntu 24.04 |
| 用于基准测试的GPU | 1块NVIDIA RTX PRO 6000 Blackwell显卡,扣除权重和CUDA图计算后,剩余19.6GiB内存用于KV缓存。 |
| 客户网络 | 2 个 NVIDIA BlueField-3 B3140H 400Gb/s 显卡,客户端带宽最高可达 80GB/s |
| 模型和软件 | openai/gpt-oss-120b (MXFP4) vLLM 0.14.1 NVIDIA Dynamo 0.9.0 与 NIXL NVIDIA AIPerf 基准测试客户端 |
| 缓存分层 | 主机层和本地层均设置为零;所有 1.4 万个缓存令牌均由存储扩展层提供服务。 |
基准测试客户端是一台 Supermicro SYS-212GB-FNR MGX 系统,测试结果来自该系统中的一块 NVIDIA RTX PRO 6000 Blackwell GPU,运行的是 vLLM 0.14.1 和 Dynamo 0.9.0 下的 MXFP4 格式的 openai/gpt-oss-120b 模型。
在权重和 CUDA 图之后,剩余 19.6GiB 的 GPU 内存用于键值缓存,足以在 GPU 本身存储约 1.14 万个令牌。测试中,主机内存和本地层级均设置为零,因此每个缓存块都来自 Storage Scale,从而确保结果仅衡量存储路径本身,不受混合层级结构的影响。
首次代币交付时间提高 56 倍,吞吐量提高 22 倍
在没有缓存的情况下,120B 型号的首次令牌处理时间 (TTFT) 从 10,000 个输入令牌时的 0.572 秒增加到 130,000 个输入令牌时的 32.14 秒,这是因为 GPU 需要重新计算完整的上下文。启用存储规模的键值缓存后,TTFT 在相同范围内保持在 0.193 秒到 0.57 秒之间,这与 130,000 个输入令牌时的 56 倍数值以及 Supermicro 在其公告中提到的 0.377 秒的误差范围相符。IBM、Supermicro 和 NVIDIA 进行了这些测试,我们并未进行测试或审核结果。
吞吐量测试通过 28 个并发连接发送了 200 个请求,这些请求来自 100 个不同的提示,总计 24 万个令牌和 825GB 的键值缓存数据,缓存初始为空。重新计算基准测试的完成时间为每秒 0.19 个请求,耗时 1,048 秒;存储扩展层在 46.94 秒内达到了每秒 4.26 个请求,性能提升了 22 倍,其中包括填充缓存的冷启动成本。
第三次运行增加了四个客户端,它们通过同一交换矩阵推送 200GB/s 的无关网络流量。缓存配置下,每秒处理 3.6 个请求,200 个请求耗时 55.56 秒,比干净运行慢了约 9 秒,但仍是基线的 18 倍。IBM 将这一小的性能损失归因于 Spectrum-X 交换矩阵将缓存流量与后台负载隔离。
“智能体人工智能和长上下文应用依赖于在多个步骤中高效地重用上下文信息,而NVIDIA Dynamo有助于协调分布式推理,从而使企业能够从每个GPU获得更高的可用吞吐量,”NVIDIA人工智能推理产品负责人Shruti Koparkar表示。“通过将NVIDIA Dynamo和Spectrum-X以太网与Supermicro Petascale存储服务器和IBM Storage Scale相结合,该KV缓存解决方案创建了一个高性能的共享存储层,可以减少冗余计算,缩短首次令牌到达时间,并帮助客户扩展弹性人工智能推理服务。”
尺寸以及数字之外的内容
IBM 的容量规划指南指出,对于 70 亿至 7 亿容量的存储型号以及最多 64 个 GPU,四节点架构(4+2P)的可用容量为 67%;经测试,八节点架构(8+2P)的可用容量为 80%,适用于 34 亿至 120 亿容量的存储型号以及 100 至 256 个 GPU,需要 100 至 300GB/s 的读取带宽;而对于容量更大的存储型号以及 300 个或更多 GPU,需要 300GB/s 及以上读取带宽的存储型号,16 个或更多节点架构(16+3P)的可用容量为 84%。Storage Scale ECE 本身可扩展至 256 台存储服务器。
单GPU测试设置是主要缺陷。参考架构的设计容量足以支持数百个GPU,但论文中的所有结果都来自一块RTX PRO 6000显卡,搭配IBM标称速度为315GB/s的八节点983TB闪存层。因此,存储端远未达到饱和,而且这些测试也无法展现当整个GPU集群同时拉取缓存时,TTFT的性能表现。
Supermicro尚未公布该解决方案的定价或上市日期,公告中也没有提供GPU利用率数据。该方案与DDN在AI400X3M上集成的Dynamo KV缓存加速方案类似,区别在于该方案运行在通用的Supermicro服务器上,并通过以太网连接到IBM文件系统。
“随着人工智能工作负载从训练扩展到推理,企业和新云平台需要部署高吞吐量的推理工作负载,以应对智能体人工智能和长上下文、多轮次生成式人工智能等挑战,因此需要消除瓶颈以提高GPU效率,”超微公司总裁兼首席执行官梁志强表示。“我们与IBM和NVIDIA合作推出的解决方案清晰地展现了这些性能优势。”



 Amazon