

我们一直致力于挑战计算极限,但这次的挑战对象是圆周率π(e)。继去年突破100万亿位大关之后,我们决定更进一步,将圆周率π的已知位数推至105万亿位。也就是说,3之后是105,000,000,000,000位数字。我们对平台进行了一些更新,在此过程中发现了一些令人惊讶的事情,也学到了一些东西——包括圆周率π的第105万亿位数字:6!
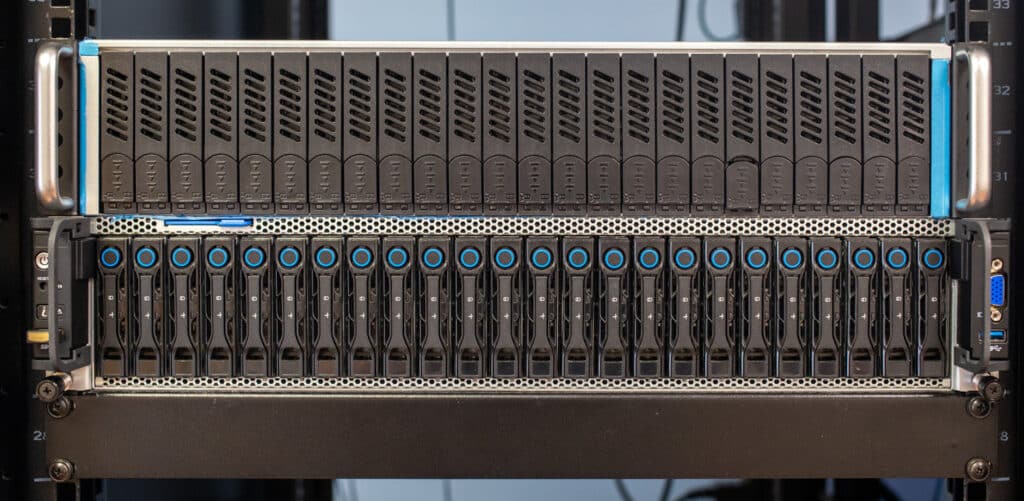
StorageReview 实验室实现了 105 万亿位数字的破世界纪录,凸显了现代硬件令人难以置信的功能。这一成果由配备 2TB DRAM 和近 PB Solidigm QLC SSD 的尖端 128P 1.5 核 AMD EPYC Bergamo 系统提供支持,代表了计算和存储技术领域的里程碑式成就。
项目挑战
在100万亿的数字化进程中,我们遇到了一些技术限制。例如,该服务器平台仅支持前端插槽16个NVMe SSD。虽然我们拥有充足的 CPU 能力,但此计算在处理过程中以及输出最终 TXT 文件时在后端需要大量存储。
为了解决上次的存储问题,我们使用 PCIe NVME 适配器雪橇来挤入另外三个 SSD。然后,对于输出,请注意,我们在 RAID0 中有一个 HDD 存储服务器,并有一个 iSCSI 共享返回计算盒。这次,我们想让这个服务器更加“企业化”一点,所以我们请了一些朋友来帮忙。有趣的是,向服务器添加一堆 NVMe SSD 并不像看起来那么容易。
硬件
这项宏伟工程的核心是双处理器 AMD EPYC 9754 Bergamo 系统,每个处理器拥有 128 个核心。AMD 的处理器以其在复杂度极高的计算任务(人工智能、高性能计算、大数据分析)中的卓越性能而闻名,提供了所需的强大动力。此外,1.5TB 的 DRAM 内存确保了快速的数据处理和传输速度。同时,近 1PB 的Solidigm QLC 固态硬盘提供了前所未有的存储容量和可靠性。
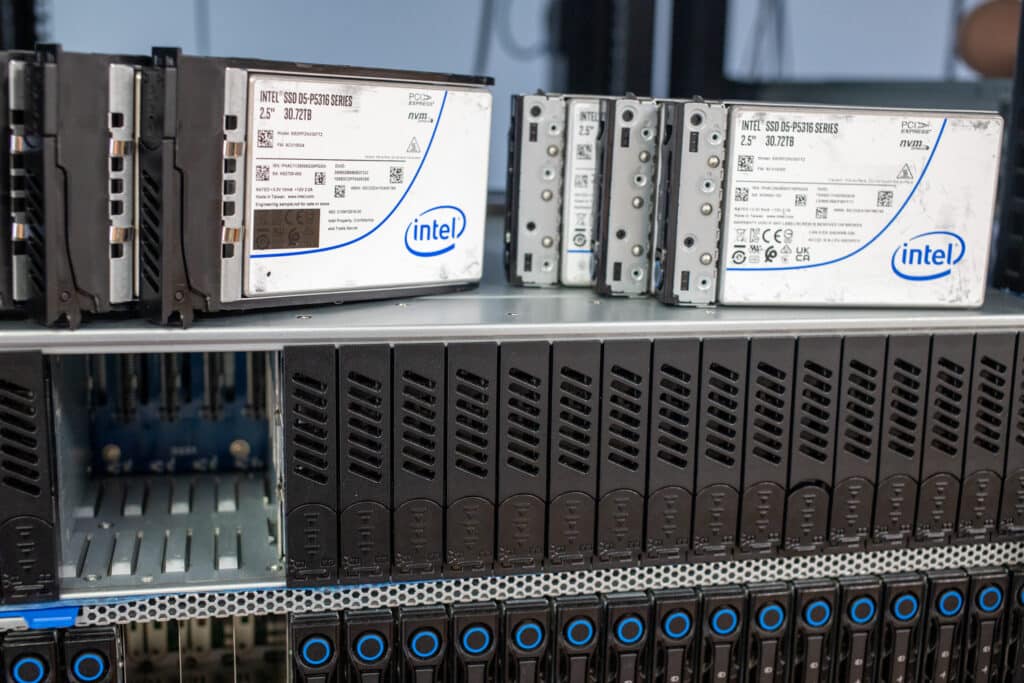
我们的基础机箱平台与去年相同(QCT 盒子),但我们将 CPU 升级为 AMD EPYC 9754 Bergamo 芯片。我们想要追求速度和小数点的改进,同时避免使用存储进行计算,这意味着我们必须调用 SerialCables 来提供 JBOF。这本身就带来了一些挑战,我们将在下面详细介绍。
| 参数 | 价值 |
|---|---|
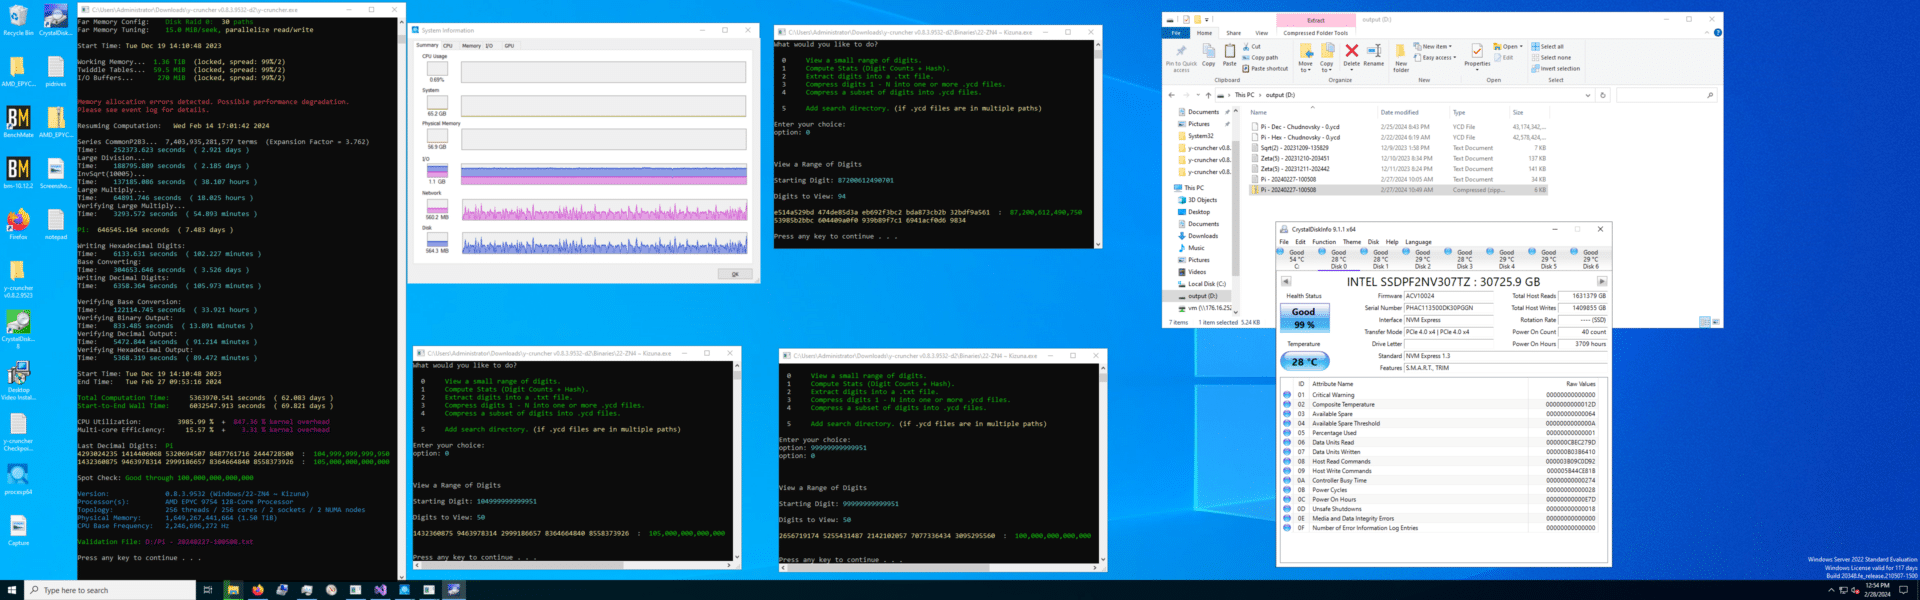
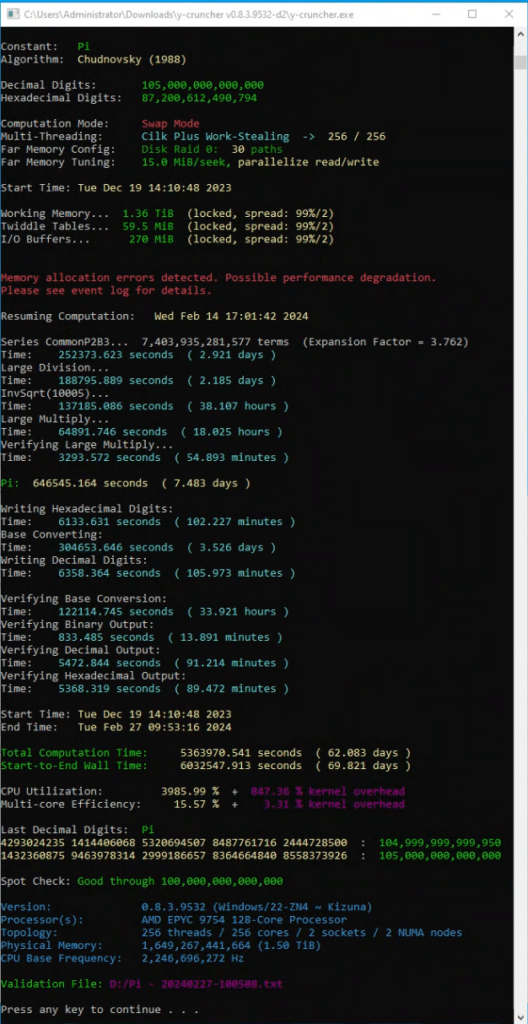
| 开始日期 | 19 年 14 月 10 日星期二 48:2023:XNUMX |
| 结束日期 | 27 年 09 月 53 日星期二 16:2024:XNUMX |
| 总计算时间 | 5,363,970.541 秒 / 62.08 天 |
| 开始到结束的挂墙时间 | 6,032,547.913 秒 / 69.82 天 |
计算期:2023 年 12 月 14 日至 2024 年 2 月 27 日,共 75 天。
- CPU: 双 AMD Epyc 9754 Bergamo 处理器,256 个内核,在 BIOS 中禁用同时多线程 (SMT)。
- 记忆: 1.5 TB DDR5 RAM。
- 存储: 36 个 30.72TB Solidigm D5-P5316 SSD。
- SerialCables JBOF 中的 24 个 30.72TB Solidigm D5-P5316 SSD
- 直接连接服务器中的 12 个 30.72TB Solidigm D5-P5316 SSD。
- 操作系统: Windows Server 2022 (21H2)。
通向 105 万亿美元之路
| 参数 | 价值 |
|---|---|
| 常数 | Pi |
| 算法 | 楚德诺夫斯基 (1988) |
| 小数位数 | 105,000,000,000,000 |
| 十六进制数字 | 87,200,612,490,794 |
| 线程模式 | Cilk Plus 工作窃取 -> 256 / 256 |
| 工作记忆 | 1,492,670,259,968 (1.36 TiB) |
| 总内存 | 1,492,984,298,368 (1.36 TiB) |
| 逻辑最大检查点 | 157,783,654,587,576 (144 TiB) |
| 逻辑峰值磁盘使用率 | 534,615,969,510,896 (486 TiB) |
| 逻辑磁盘字节读取 | 44,823,456,487,834,568 (39.8 PiB) |
| 写入的逻辑磁盘字节数 | 38,717,269,572,788,080 (34.4 PiB) |
遇到挑战
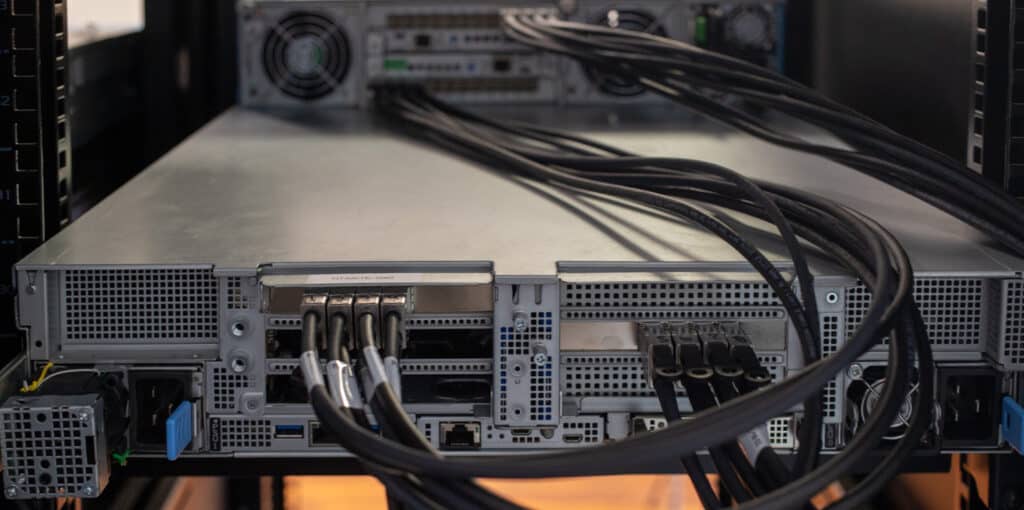
为了扩展处理器可用存储空间,本次运行新增了一个组件:NVMe JBOF。我们的测试平台提供了 16 个 NVMe 硬盘位,其余 8 个仅支持 SATA 连接。虽然我们之前运行 100 万亿次时利用了三个内部 PCIe U.2 适配器将 NVMe 硬盘数量扩展到了 19 个,但这并非最佳方案。因此,在本次重测中,我们添加了一个Serial Cables 的 24 盘位 U.2 JBOF,这在两方面都带来了显著提升:增加了计算交换存储空间和内部输出文件存储空间。从此告别了疯狂的 RAID 0 硬盘存储服务器!
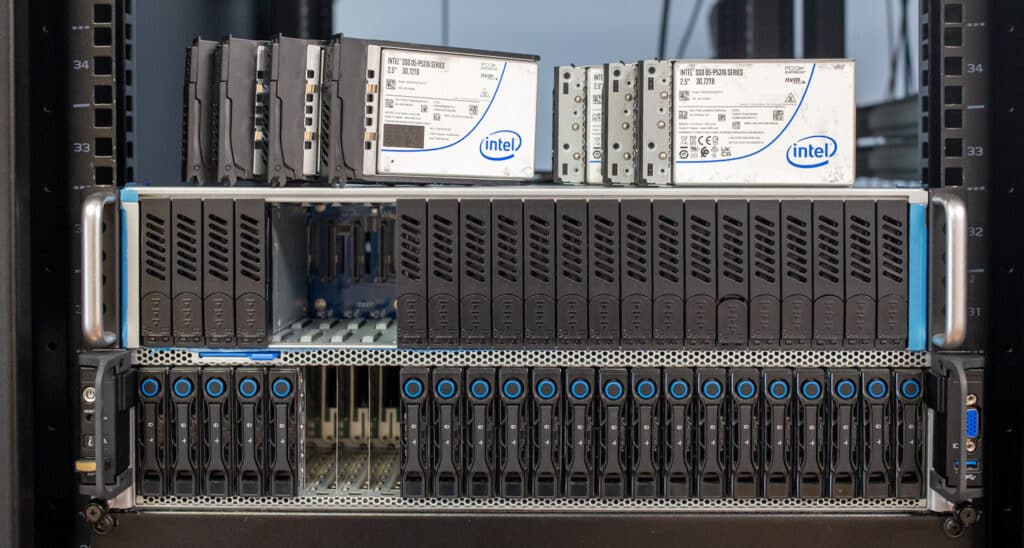
串行电缆 24 盘位 JBOF 使我们能够将原始运行的驱动器数量增加近一倍。我们为 y-cruncher 交换空间分配了 30 个驱动器,留下 6 个 SSD 用于存储空间 RAID5 输出卷。这种方法的一个巨大优势出现在输出阶段,我们不会像第一个 10T Pi 迭代那样受到单个 100Gb 连接的速度的阻碍。虽然 JBOF 解决了驱动器总数问题,但它确实引入了一个限制:单个驱动器性能。
在具有直连 U.2 SSD 的服务器中,每个驱动器有四个 PCIe 通道。如果每个驱动器直接连接到主板,则相当于 96 个 PCIe 通道可容纳 24 个 SSD。 JBOF 的总带宽受到它可以连接回主机的 PCIe 通道数量的限制。
在本例中,我们使用了两个 PCIe 交换主机卡,将 JBOF 分成两组,每组 12 个 SSD。每组 12 个 SSD 共享 16 个 PCIe 通道。虽然在将 SSD 连接到我们的主机方面仍然具有相当大的优势,但我们确实遇到过通过 JBOF 运行的交换驱动器落后于直接连接到服务器的驱动器的情况。这不是 JBOF 的错。这只是技术限制,或者更确切地说是服务器可以使用的 PCIe 通道数量的限制。
精明的读者可能想知道为什么我们在这次运行中停在 36 个 SSD,而不是增加到 40 个。这是一个有趣的故事。在许多服务器中,可寻址 PCIe 空间都有其限制。在我们的例子中,在 38 个驱动器数量中,最后一个 SSD 占用了 USB 芯片组的 PCIe 地址,我们失去了对服务器的控制。为了安全起见,我们将其减少到 36 个 SSD,这样我们仍然可以进入 BIOS 或登录服务器。突破界限确实会带来一些令人惊讶的发现。
诊断洞察力和解决方案
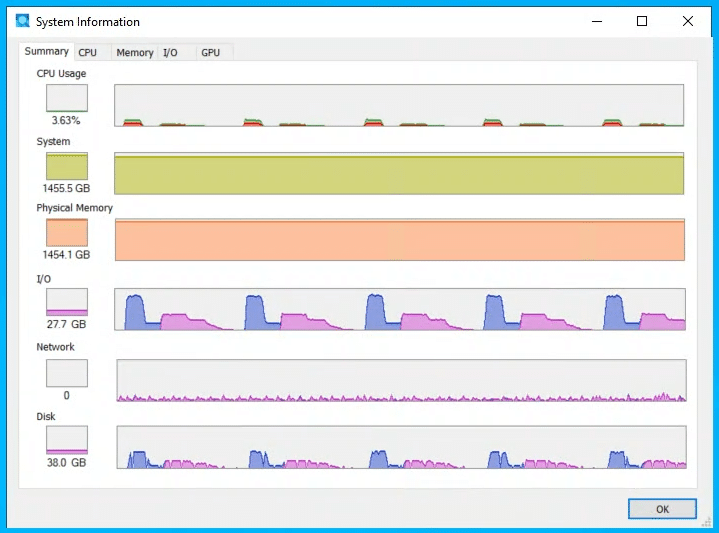
我们遇到的两大挑战中的第一个与性能相关。我们发现了阿姆达尔定律的实际应用。在进行大规模交换模式操作时,y-cruncher 在我们的 256 核 AMD Bergamo 系统上似乎会“卡住”,这引发了一个奇怪的问题。这种卡住表现为 CPU 和磁盘 I/O 活动的缺失,这挑战了人们对软件行为的传统预期。这促使我们深入研究并行计算和硬件交互的复杂性。
发现过程表明,该程序并未真正挂起,而是以严重有限的容量运行,在庞大的 256 核设置中以单线程运行。这种不寻常的行为引发了人们对阿姆达尔定律潜在影响的质疑,特别是因为所涉及的操作不是计算密集型的,并且不应在配备 1.5 TB RAM 的系统上造成严重延迟。
当问题在消费级台式机上重现时,调查出现了意想不到的转折,凸显了即使在配置较低的系统中,阿姆达尔定律也会带来严重的后果。这促使研究人员对问题的根本原因进行更深入的调查,最终发现Zen4架构特有的CPU风险与超对齐及其对内存访问模式的影响有关。
在 AMD 处理器上,代码中的循环加剧了这个问题,由于其简单的性质,该循环的执行速度应该比观察到的要快得多。根本原因似乎是 AMD 的加载存储单元对内存别名处理效率低下。要解决这一复杂问题,既需要使用 AVX512 对循环进行矢量化来减轻超级对齐风险,又需要通过增强并行性来解决阿姆达尔定律导致的速度下降问题。这种综合方法不仅解决了眼前的问题,而且还对 y-cruncher 的计算过程进行了重大优化,为高性能计算环境中解决类似挑战奠定了先例。
下一个问题是在计算的最后步骤中遇到的,计算会意外停止,并且无法提供有关崩溃原因的信息。 Alexander Yee 获得了远程访问权限,这是十多年来第一次需要开发人员的直接干预来完成 Pi 记录。
我们没有参与此次诊断过程,但N63乘法算法的AVX512代码路径中存在一个关键的浮点运算错误。Alexander远程诊断了该错误,提供了修复后的二进制文件,并从检查点恢复运行,最终在实施关键软件修复后成功完成了计算。
反思与前进
这一努力说明了高性能计算的复杂性和不可预测性。解决这些挑战创造了新的 Pi 计算记录,并为软件开发和测试方法提供了宝贵的见解。最新的 y-cruncher 版本 v0.8.4 修复了已发现的问题,有望增强未来计算的稳定性。
将 Pi 计算到 105 万亿位数字绝非易事。它涉及细致的规划、优化和执行。 StorageReview 团队结合开源和专有软件,优化了算法过程,以充分利用硬件的功能,减少计算时间并提高效率。
Solidigm QLC SSD 凭借 PCIe Gen4 饱和读取性能和高达 61.44TB 的行业领先容量,提供令人难以置信的结果。 Solidigm 战略规划和营销副总裁 Greg Matson 表示:“想象一下这些驱动器可以在高性能计算或人工智能密集型应用中实现什么。”我们很高兴 Solidigm 的 SSD 能够为 Storagereview 计算 pi 的第二次破纪录尝试提供动力。他们的努力证明了 Solidigm 存储驱动器的真正功能,为数据密集型人工智能应用打开了一个充满可能性的世界。”
结语
Pi 的 105 万亿位数字的运行比我们预期的要复杂得多。反思一下,我们应该预料到会遇到新的问题;毕竟,我们正在完成一项以前从未完成过的计算。但随着 100 万亿次计算使用更多的“管道胶带和铁丝网”配置完成,我们认为我们已经完成了。最终,大家齐心协力才让这台设备冲过终点线。
虽然我们与合作伙伴一起为这一破纪录的成绩感到高兴,但我们必须问:“这到底意味着什么?” Pi 的 5 万亿位数字可能不会对数学产生巨大的影响。尽管如此,我们仍然可以在计算工作负载和支持它们的现代底层硬件的需求之间划清界限。从根本上来说,这项工作反映出,无论是企业数据中心集群还是大型 HPC 安装,正确的硬件都至关重要。
在计算圆周率时,存储空间完全限制了我们的计算。更快的CPU有助于加速计算,但许多新的世界纪录的瓶颈在于设备本地存储容量。这次,我们再次利用了Solidigm D5-P5316 30.72TB固态硬盘,使系统拥有超过1.1PB的原始闪存空间。正是这些固态硬盘让我们能够突破之前的纪录,达到圆周率小数点后105万亿位。
这确实引出了一个有趣的问题。我们的许多粉丝都知道,Solidigm的 D5-P5336 固态硬盘容量高达 61.44TB ,而D5-P5430固态硬盘的容量也高达 30.72TB ,并且提供多种规格和容量选择。我们已经评测过这些硬盘,并在社交媒体上发布了许多展示这些惊人高密度硬盘的帖子。32 块这样的固态硬盘加起来接近 2PB 的存储容量,不禁让人好奇,圆周率 105 万亿位小数究竟能保持多久的世界最大存储容量?我们认为,应该不会太久。
已知最大的 Pi 十进制数字
1432360875 9463978314 2999186657 8364664840 8558373926:数字到 105,000,000,000,000


 Amazon