

NVIDIA GeForce RTX 5080 将于 30 月 5090 日与旗舰 RTX 999 一同推出,定位为 NVIDIA Blackwell 系列中更实惠的高性能选择。它的售价为 1,999 美元,比 5090 美元的 RTX XNUMX 略低,但仍提供尖端性能。这使得它很可能成为开发人员、内容创作者和游戏玩家的最爱,他们希望获得顶级功能,但又不想花旗舰产品的价格。
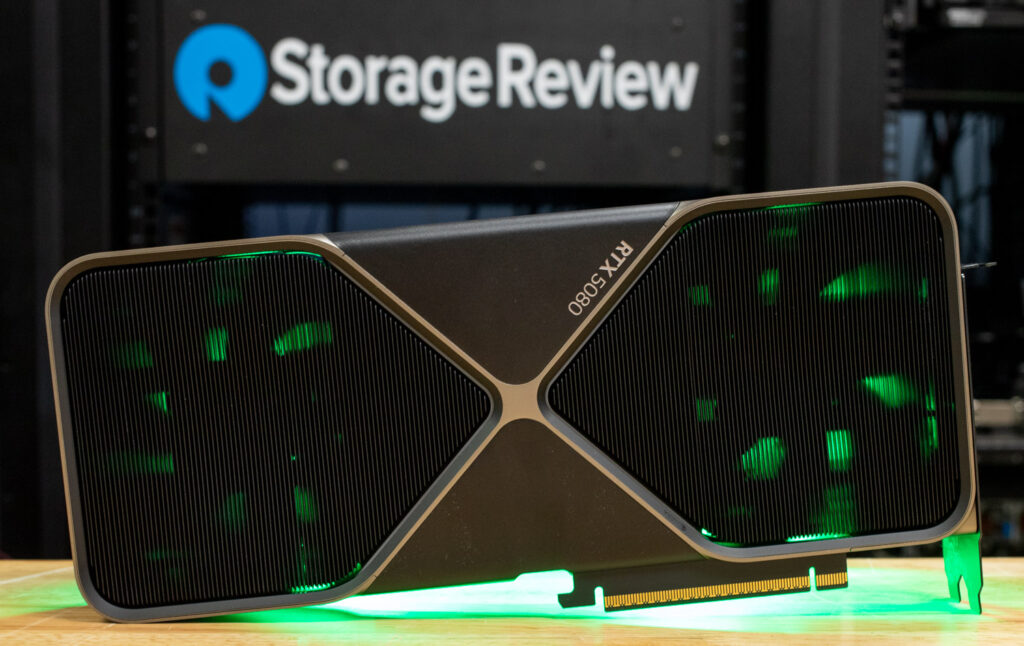
RTX 5080 搭载了与 RTX 5090 相同的先进 AI 功能,并将 NVIDIA 的最新创新技术(例如带有多帧生成和光线重建功能的 DLSS 4)带给更广泛的用户群体。这些技术重新定义了游戏性能和视觉保真度,使 RTX 5080 即使在要求最高的游戏中也能提供流畅的帧速率和惊艳的画面。
规格
RTX 5080 拥有 10,752 个 CUDA 核心,比 RTX 4080 的 9,728 个核心有显著提升,但与 RTX 5090 的 21,760 个核心相比仍有差距。这意味着它在游戏和 AI 加速工作负载方面具有出色的性能,尽管上限略低于旗舰产品。
| GPU 比较 | NVIDIA RTX 6000 Ada | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 5080 | NVIDIA RTX 5070 |
| GPU名称 | AD102 | GB202 | AD102 | GB203 | GB205 |
| 卓越 | 阿达洛夫莱斯 | 布莱克威尔2.0 | 阿达洛夫莱斯 | 布莱克威尔2.0 | 布莱克威尔2.0 |
| 工艺尺寸 | 5纳米 | 4纳米 | 5纳米 | 4纳米 | 4纳米 |
| 晶体管 | 76,300百万 | 92,200百万 | 76,300百万 | 45,600百万 | 31,000百万 |
| 密度 | 125.3米 / 平方毫米 | 123.9米 / 平方毫米 | 125.3米 / 平方毫米 | 120.6米 / 平方毫米 | 117.9米 / 平方毫米 |
| 模具尺寸 | 609mm² | 744mm² | 609mm² | 378mm² | 263mm² |
| 槽宽 | 双槽 | 双槽 | 三槽 | 双槽 | 双槽 |
| 尺寸 | 267mm x 122mm | 304毫米x 137毫米x 48毫米 | 304毫米x 137毫米x 61毫米 | 304毫米x 137毫米x 48毫米 | 242 mm x 112 mm |
| TDP | 300W | 575W 瓦 | 450W 瓦 | 360W 瓦 | 250W 瓦 |
| 输出 | 4 个显示端口 1.4a | 1 个 HDMI 2.1b,3 个 DisplayPort 2.1b | 1 个 HDMI 2.1、3 个 DisplayPort 1.4a | 1 个 HDMI 2.1b、3 个 DisplayPort 2.1b | 1 个 HDMI 2.1b、3 个 DisplayPort 2.1a |
| 电源连接器 | 1x 16针 | 1x 16针 | 1x 16针 | 1x 16针 | 1x 16针 |
| 总线接口 | PCIe 4.0 x16 | PCIe 5.0 x16 | PCIe 4.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 |
| 基地时钟 | 915 MHz | 2017 MHz | 2235 MHz | 2295 MHz | 2165 MHz |
| 提升时钟 | 2505 MHz | 2407 MHz | 2520 MHz | 2617 MHz | 2510 MHz |
| 记忆时钟 | 2500 MHz 20(Gbps 有效) | 2209 MHz(有效28 Gbps) | 1313 MHz(有效21 Gbps) | 2366 MHz(有效30 Gbps) | 2209 MHz(有效28 Gbps) |
| 内存大小 | 48 GB | 32 GB | 24 GB | 16 GB | 12 GB |
| 内存类型 | GDDR6 | GDDR7 | GDDR6X | GDDR7 | GDDR7 |
| Magistrala pamięci | 384 bit | 512 bit | 384 bit | 256 bit | 192 bit |
| 内存带宽 | 960 GB /秒 | 1.79 TB / s | 1.01 TB / s | 960.0 GB /秒 | 672.2 GB /秒 |
| CUDA核心 | 18,176 | 21,760 | 16,384 | 10,752 | 6,144 |
| TMU | 568 | 680 | 512 | 336 | 192 |
| 个ROPs | 192 | 192 | 176 | 128 | 64 |
| SM 计数 | 142 | 170 | 128 | 84 | 48 |
| 张量核心 | 568 | 680 | 512 | 336 | 192 |
| RT核心 | 142 | 170 | 128 | 84 | 48 |
| L1缓存 | 128 KB(每个 SM) | 128 KB(每个 SM) | 128 KB(每个 SM) | 128 KB(每个 SM) | 128 KB(每个 SM) |
| L2缓存 | 96MB | 88 MB | 72 MB | 64 MB | 40 MB |
| 像素率 | 481.0 GPixel / s | 462.1 GPixel / s | 443.5 GPixel / s | 335.0 GPixel / s | 160.6 GPixel / s |
| 纹理速率 | 1,423 格塞尔/秒 | 1,637 格塞尔/秒 | 1,290 格塞尔/秒 | 879.3 格塞尔/秒 | 481.9 格塞尔/秒 |
| FP16(一半) | 91.06 万亿次浮点运算 (1:1) | 104.8 万亿次浮点运算 (1:1) | 82.58 万亿次浮点运算 (1:1) | 56.28 万亿次浮点运算 (1:1) | 30.84 万亿次浮点运算 (1:1) |
| FP32(浮点数) | NVIDIA RTX 5090 | 104.8 TFLOPS | 82.58 TFLOPS | 56.28 TFLOPS | 30.84 TFLOPS |
| FP64 (双精度) | 91.06 TFLOPS | 1.637 万亿次浮点运算 (1:64) | 1,290 GFLOPS(1:64) | 879.3 GFLOPS(1:64) | 481.9 GFLOPS(1:64) |
| 发行价格(美元) | 6,799万美金 | $1,999 | $1,599 | $999 | $549 |
RTX 5080 配备 16GB GDDR7 显存,位宽为 384 位,为现代游戏和创意应用提供了充足的带宽。虽然它不及 RTX 5090 的 32GB 显存和 512 位位宽,但对于大多数用户来说已经绰绰有余。RTX 5080 的 TDP 为 360W,比 RTX 4080 更耗电,但比 RTX 5090 的 575W 更易于管理。因此,它更适合配置标准高端 PC 的用户。
想要深入了解 Blackwell 架构和 50 系列 GPU 的创新技术,请查看我们的RTX 5090 评测。
建筑与设计
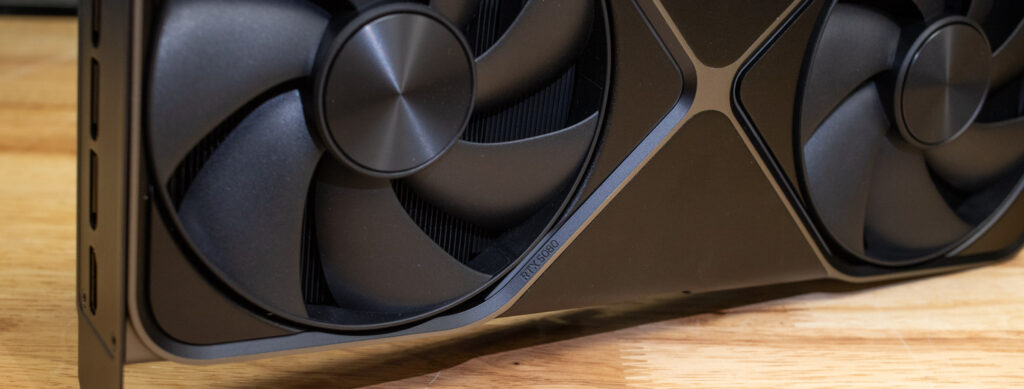
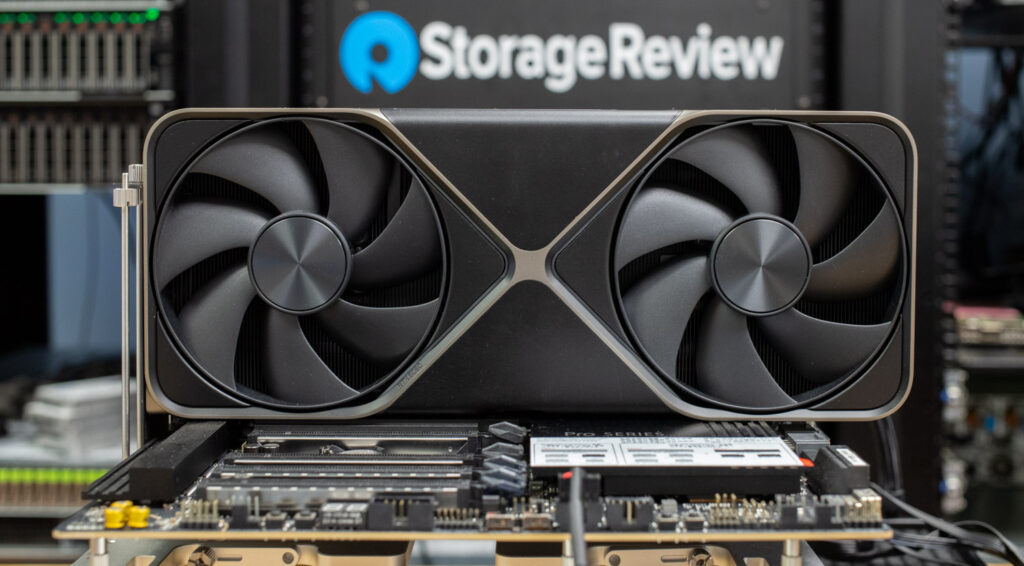
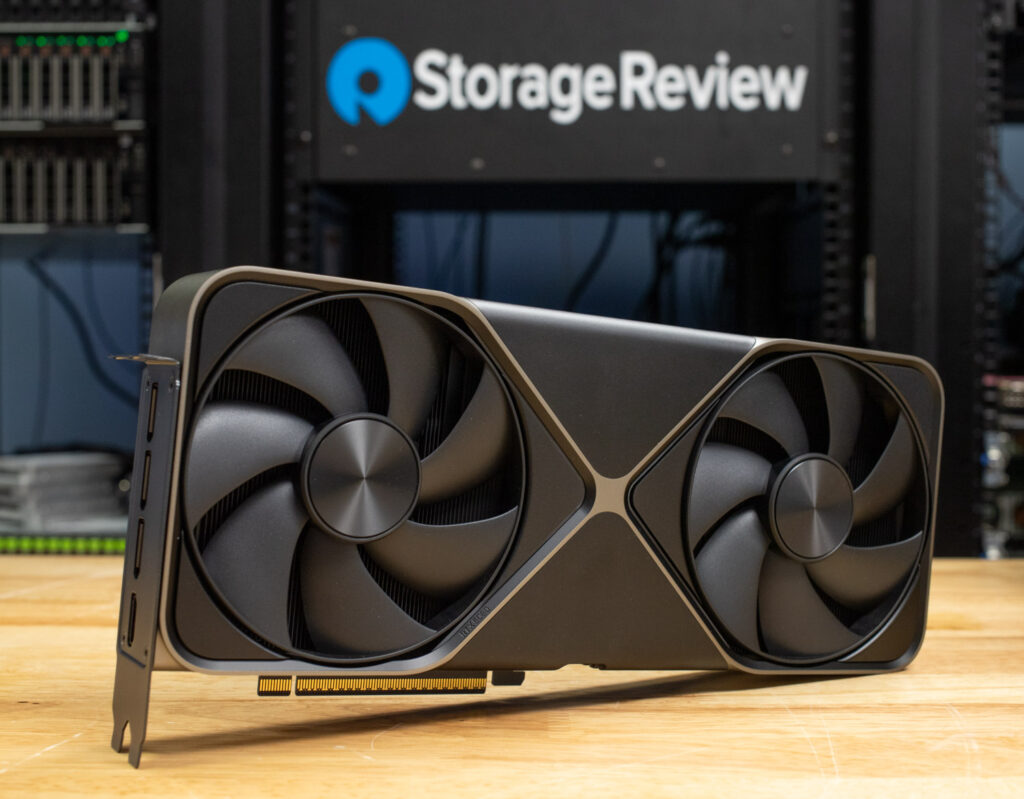
RTX 5080 保留了 NVIDIA Founders Edition 显卡的时尚双插槽设计,使其比三插槽 RTX 4090 更紧凑。它具有与 3 相同的 5090D 蒸汽室和双轴流风扇,即使在重负载下也能确保高效冷却。与 5090 不同,RTX 5080 采用传统导热化合物而不是液态金属。GeForce RTX 5080 在我们的露天测试台上在正常温度下运行没有问题,尽管它在负载下的功耗比 GeForce RTX 5090 低得多。
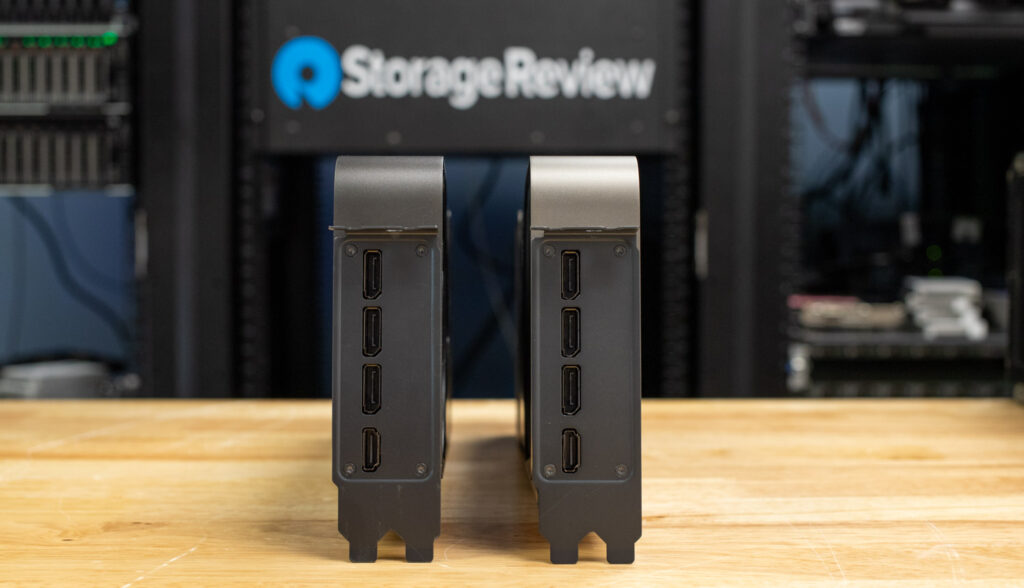
(右图为 5090)(左图为 5080)
该卡的尺寸为长 304 毫米 x 宽 137 毫米 x 高 48 毫米,非常适合大多数高端 PC 构造。其双插槽外形确保与各种机箱兼容。流通式冷却设计改善了气流,即使在重负载下也能保持卡的凉爽和安静。
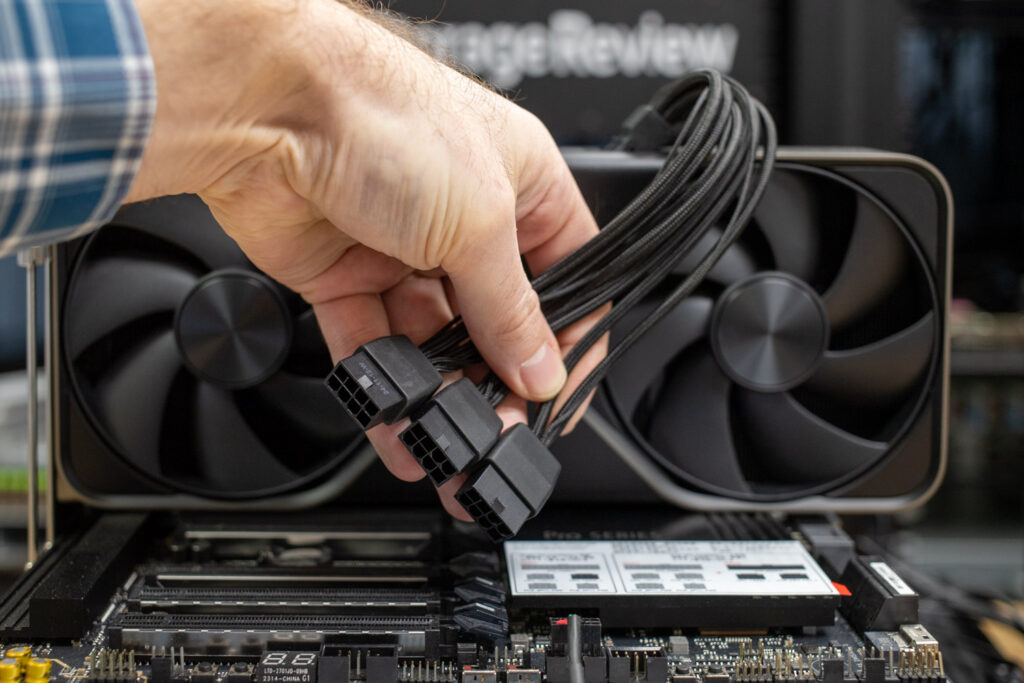
1 个 16 针至 3 个 8 针连接器
主要特点和性能
RTX 5080 与 RTX 5090 拥有许多相同的 DNA,包括 Blackwell 架构和对具有多帧生成的 DLSS 4 的支持。虽然 RTX 5080 的原始性能不如其大哥 RTX 4080,但与上一代 RTX XNUMX 相比,它的性能仍然令人印象深刻,因此对于游戏玩家和创作者来说,它都是一个极具吸引力的升级产品。
游戏和人工智能功能
RTX 5080 受益于与 RTX 5090 相同的 AI 驱动游戏技术进步,包括 DLSS 4 和光线重建。这些特性使显卡即使在最苛刻的游戏中也能提供更流畅的帧速率和更高的视觉保真度。与 5090 一样,RTX 5080 利用 DLSS 4 的多帧生成功能,在每个渲染帧中生成多达三个 AI 帧。这显著提升了支持的游戏的性能,使 4K 高刷新率游戏体验更加轻松。
RTX 5080 的 128 个 RT 核心(相比 RTX 5090 的 170 个)依然能提供出色的光线追踪性能,在游戏中实现逼真的光照、阴影和反射效果。虽然 RTX 5090 更适合处理繁重的 AI 工作负载,但 RTX 5080 的第五代 Tensor 核心和 FP4 精度仍然使其成为从事 AI 辅助工作流程的创作者的理想选择。
NVIDIA GeForce RTX 5080 评测 – 性能基准
为了最大限度地发挥新款 NVIDIA GeForce RTX 5080 的性能,我们使用了高性能 AMD ThreadRipper 平台。该系统配备 64 核 CPU 和水冷回路,可提供 CPU 功率,确保 GPU 以最大容量运行而不会出现瓶颈。使用相同的配置来测试 NVIDIA GeForce RTX 6000 Ada、5090 和 4090,以确保对所有显卡进行公平比较。以下是完整的系统配置:
StorageReview AMD ThreadRipper 测试平台
- 主板: 华硕 Pro WS TRX50-SAGE WIFI
- CPU: AMD Ryzen Threadripper 7980X 64 核
- RAM: 32GB DDR5 4800MT/s
- 存储: 2TB 三星 980 Pro
- OS: Windows 11 Pro for Workstations
- 司机: NVIDIA 571.86 GameReady 驱动程序
UL Procyon:AI 文本生成
Procyon AI 文本生成基准测试通过提供简洁一致的评估方法,简化了 AI LLM 性能测试。它允许对多个 LLM 模型进行重复测试,同时最大限度地降低大型模型规模和可变因素带来的复杂性。该基准测试由 AI 硬件领域的领先企业共同开发,优化了本地 AI 加速器的使用,从而实现更可靠、更高效的性能评估。以下测试结果均使用 TensorRT 进行测试。
Procyon AI 文本生成基准测试显示,在所有测试项目中,RTX 5080 的性能都紧随 RTX 6000 Ada 之后。在Phi测试中,RTX 5080 的得分为 4,400 分,略低于 RTX 6000 Ada 的 4,508 分,但两款显卡在每秒输出令牌数和总持续时间方面表现相近——RTX 5090 和 4090 的得分更高,分别为 5,749 分和 4,958 分。
在Mistral测试中,RTX 5080 得分 4,635,高于得分 4,255 的 6000 Ada,但仍落后于 5090(6,267)和 4090(5,094)。5080 的每秒输出令牌数 (TOS) 比 6000 Ada 更快,且总持续时间略短。
在Llama3 测试中,RTX 5080 的得分为 4,424,优于 6000 Ada 的 4,026,但仍落后于 5090(6,104)和 4090(4,849)。在该测试中,5080 的每秒输出令牌数高于 6000 Ada,但两款显卡的总体持续时间相近。
最后,在Llama2测试中,RTX 5080 得分 4,790,低于 5090 (6,591) 和 4090 (5,013),但略优于得分 3,957 的 6000 Ada。5080 的令牌输出速度比 6000 Ada 更快,总持续时间也略短于 6000 Ada。总体而言,RTX 5080 提供了出色的 AI 图像生成性能,在四项测试中的三项中都保持了对 6000 Ada 的竞争优势。
| UL Procyon:AI 文本生成 | NVIDIA RTX 5080 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| 菲总分 | 4,400 | 5,749 | 4,958 | 4,508 |
| Phi 输出时间到第一个标记 | 0.277小号 | 0.244小号 | 0.255小号 | 0.288小号 |
| 每秒输出 Phi 令牌数 | 209.459 代币/秒 | 314.435 个代币/秒 | 244.343 个代币/秒 | 228.359 个代币/秒 |
| Phi 总时长 | 14.908小号 | 10.280小号 | 12.872小号 | 13.869小号 |
| 米斯特拉尔总成绩 | 4,635小号 | 6,267 | 5,094 | 4,255 |
| Mistral 输出第一个令牌的时间 | 0.347小号 | 0.297小号 | 0.322小号 | 0.419小号 |
| 每秒 Mistral 输出代币数 | 163.598 个代币/秒 | 255.945 个代币/秒 | 183.266 个代币/秒 | 166.633 个代币/秒 |
| 米斯特拉尔总持续时间 | 18.933小号 | 12.593小号 | 17.010小号 | 19.092小号 |
| Llama3 总体评分 | 4,424 | 6,104 | 4,849 | 4,026 |
| Llama3 输出第一个标记的时间 | 0.283小号 | 0.234小号 | 0.259小号 | 0.348小号 |
| Llama3 每秒输出令牌数 | 136.177小号 | 214.285 个代币/秒 | 150.039 个代币/秒 | 138.620 个代币/秒 |
| Llama3 总时长 | 21.985小号 | 14.304小号 | 19.991小号 | 22.062小号 |
| Llama2 总体评分 | 4,790 | 6,591 | 5,013 | 3,957 |
| Llama2 输出第一个标记的时间 | 0.493小号 | 0.419小号 | 0.500小号 | 0.679小号 |
| Llama2 每秒输出令牌数 | 83.653 个代币/秒 | 134.502 个代币/秒 | 92.853 个代币/秒 | 78.532 个代币/秒 |
| Llama2 总时长 | 35.703s | 23.018小号 | 32.448小号 | 38.923小号 |
UL Procyon: 人工智能图像生成
Procyon AI 图像生成基准测试提供了一种一致且准确的方法,用于衡量各种硬件(从低功耗 NPU 到高端 GPU)上的 AI 推理性能。它包含三项测试:针对高端 GPU 的 Stable Diffusion XL (FP16)、针对中等性能 GPU 的 Stable Diffusion 1.5 (FP16) 以及针对低功耗设备的 Stable Diffusion 1.5 (INT8)。该基准测试会为每个系统使用最佳推理引擎,从而确保结果的公平性和可比性。
在这项AI图像生成基准测试中,RTX 5080表现出色,但仍落后于更高端的RTX 5090和4090。在稳定扩散1.5 (FP16)测试中,RTX 5080得分为4,650分,略高于6000 Ada的4,230分,但低于5090(8,193分)和4090(5,260分)。5080的图像生成速度也慢于5090和4090,每张图像耗时1.344秒,而5090和4090分别为0.763秒和1.188秒,但仍然快于6000 Ada(1.477秒)。
在稳定扩散 1.5 (INT8)测试中,RTX 5080 的得分为 55,683,低于 5090 (79,272) 和 4090 (62,160),但高于 6000 Ada (55,901)。5080 的图像生成速度(每张图像 0.561 秒)慢于 5090 (0.394 秒) 和 4090 (0.503 秒),但略快于 6000 Ada (0.559 秒)。
在稳定扩散XL (FP16)测试中,5080 的得分为 4,257 分。它再次逊色于 5090 (7,179 分) 和 4090 (5,025 分),但明显优于 6000 Ada (3,043 分)。5080 的图像生成速度为每幅图像 8.808 秒,慢于 5090 (5.223 秒) 和 4090 (7.461 秒),但快于 6000 Ada (12.323 秒)。
虽然 RTX 5080 一直落后于高端型号,但它在所有(总体得分)测试中保持了对 6000 Ada 的竞争优势,以相对较低的价格提供了稳定的图像生成性能。
| UL Procyon:AI 图像生成(总分:越高越好) | NVIDIA RTX 5080 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| 稳定扩散 1.5 (FP16) – 总体得分 | 4,650 | 8,193 | 5,260 | 4,230 |
| 稳定扩散 1.5 (FP16) – 总时间 | 21.503小号 | 12.204小号 | 19.011小号 | 23.639小号 |
| 稳定扩散 1.5 (FP16) – 图像生成速度 | 1.344 秒/图像 | 0.763 秒/图像 | 1.188 秒/图像 | 1.477 秒/图像 |
| 稳定扩散 1.5 (INT8) – 总体得分 | 55,683 | 79,272 | 62,160 | 55,901 |
| 稳定扩散 1.5 (INT8) – 总时间 | 4.490小号 | 3.154小号 | 4.022小号 | 4.472小号 |
| 稳定扩散 1.5 (INT8) – 图像生成速度 | 0.561 秒/图像 | 0.394 秒/图像 | 0.503 秒/图像 | 0.559 秒/图像 |
| 稳定扩散 XL (FP16) – 总体得分 | 4,257 | 7,179 | 5,025 | 3,043 |
| 稳定扩散 XL (FP16) – 总时间 | 140.928s | 83.573小号 | 119.379小号 | 197.172小号 |
| 稳定扩散 XL (FP16) – 图像生成速度 | 8.808 秒/图像 | 5.223 秒/图像 | 7.461 秒/图像 | 12.323 秒/图像 |
乐士马克
Luxmark 是一个 GPU 基准测试,它使用开源光线追踪渲染器 LuxRender 来评估系统在处理高度详细的 3D 场景方面的性能。该基准测试适用于评估服务器和工作站的图形渲染能力,特别是对于视觉效果和建筑可视化应用程序,其中准确的光模拟至关重要。
在 Luxmark 基准测试中,RTX 5080 在“食物”场景下得分 13,637,落后于得分 23,141 的 RTX 5090。RTX 4090 的得分 17,171 也高于 5080。RTX 6000 Ada 的得分为 14,873,略高于 5080。在“大厅”场景下,5080 的得分为 30,815,低于 5090 的 51,725 和 4090 的 38,887。不过,它的性能略优于得分 32,132 的 RTX 6000 Ada。虽然 RTX 5080 的性能不及高端型号,但它与 6000 Ada 的性能非常接近,尤其是在“食物”和“大厅”场景下。
| Luxmark(越高越好) | NVIDIA RTX 5080 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| 食物评分 | 13,637 | 23,141 | 17,171 | 14,873 |
| 霍尔斯 | 30,815 | 51,725 | 38,887 | 32,132 |
Geekbench 6
Geekbench 6是一款跨平台基准测试软件,用于衡量系统整体性能。Geekbench 浏览器允许您将任何系统与 Geekbench 6 进行比较。
Geekbench 6 结果显示,RTX 5080 的 GPU OpenCL 得分为 265,397。它远远落后于更高级别的 RTX 5090,后者得分为 374,807。RTX 4090 和 RTX 6000 Ada 表现类似,得分分别为 333,384 和 336,882。5080 的得分明显较低,落后 41,423 4090 分,表明与 90 系列卡和 6000 ada 型号相比,在这项基准测试中存在明显的性能差距。
| Geekbench(越高越好) | NVIDIA RTX 5080 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| GPU OpenCL 分数 | 265,397 | 374,807 | 333,384 | 336,882 |
的V-Ray
V -Ray基准测试使用先进的 V-Ray 6 引擎,测量 CPU、NVIDIA GPU 或两者的渲染性能。它采用快速测试和简单的评分系统,使用户能够评估和比较系统的渲染能力。对于寻求高效性能洞察的专业人士而言,它是一款必不可少的工具。
V-Ray 基准测试得出的结论是,RTX 5080 表现良好,路径得分为 9,311。虽然更高级别的 RTX 5090 以 14,764 条路径领先,但 5080 的性能与 RTX 1,000 的 4090 条路径和 RTX 10,847 Ada 的 6000 条路径相差 10,766 分以内,表明它在本次测试中竞争力十足。
| V-Ray(越高越好) | NVIDIA RTX 5080 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| 虚拟路径 | 9,311 | 14,764 | 10,847 | 10,766 |
NVIDIA GeForce RTX 5080 功耗
功耗是任何高端计算平台的重要组成部分。每一代新 GPU 在负载下都会消耗更多电量,这意味着需要更大的电源和充足的冷却气流。然而,功耗与性能还有另一个方面:更快的 GPU 可能会达到更高的峰值,但每个工作负载的持续时间会减少。
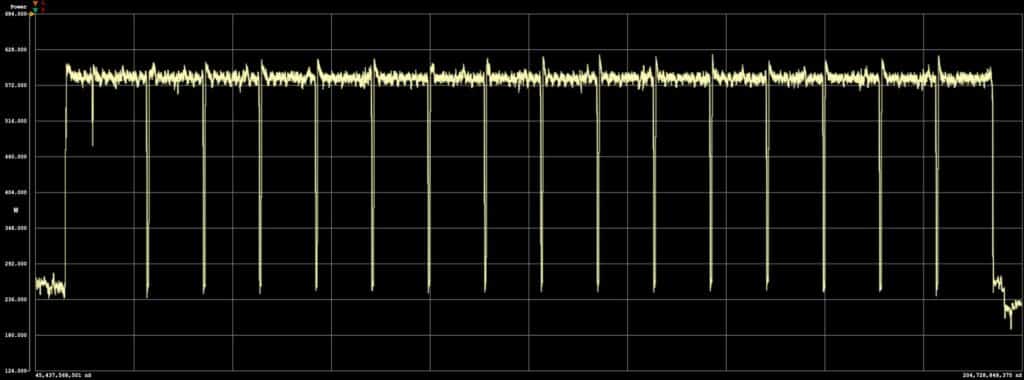
在 CES 2025 的编辑日上,NVIDIA 讨论了 Blackwell 架构在能效方面的提升,我们希望看到它在 AI 驱动的工作负载中得到充分体现。我们利用测试实验室中的Quarch Mains Analyzer,测量了运行Procyon AI Image Generator Stable Diffusion XL FP16 测试时系统的总功耗。该工作负载将每块 GPU 的功耗推向极限,每张生成图像的起始点和终止点都清晰可见。本文将介绍新款 GeForce RTX 5090 与上一代 GeForce RTX 4090 和 RTX 6000 Ada 的性能对比。
NVIDIA GeForce RTX 5080 的峰值功耗为 360W。在运行 Procyon AI 图像生成测试时,系统功率从测试准备时的 239W 增加到 GPU 负载下的 584W,上升了 345W。我们测量了创建测试中倒数第二张图像所需的能量,耗时 8.7 秒,耗电 1.39Wh。
结语
NVIDIA GeForce RTX 5080 是 50 系列产品线中的佼佼者,它以更实惠的价格提供尖端功能和出色性能。它非常适合图形密集型用例,这些用例需要最新的 AI 驱动工作负载进展,而无需花大价钱购买旗舰 RTX 5090。对于那些追求绝对最佳性能的人来说,5090 是最佳选择——但对于其他人来说,RTX 5080 可能是最受欢迎的选择。
在价格方面,NVIDIA 列出的 GeForce RTX 5080 售价为 999 美元,仅为 GeForce RTX 5090 价格的一半。不过,最令人惊讶的是,当你查看上一代 40 系列型号的范围时,GeForce RTX 5080 的入门价格低于 GeForce RTX 4080,后者的售价为 1,199 美元。因此,虽然 RTX 5090 仍将带来很大的变化,但对于想要最新功能集的人来说,RTX 5080 的价格很有吸引力。它还有一个额外的好处,那就是功耗低于 GeForce RTX 4090,因此对于平台可以支持 450W 但不支持 575W GPU 的买家来说,RTX 5080 无需进行硬件更改即可插入。
在性能方面,我们将其与 GeForce RTX 5090、GeForce RTX 4090 和 RTX 6000 Ada 进行了对比。与上一代顶级消费者和工作站产品相比,NVIDIA GeForce RTX 5080 的表现令人惊讶地出色。虽然它在我们的 AI 工作负载中没有击败 GeForce RTX 4090,但落后并不多。RTX 5080 在渲染工作负载方面表现更差,但与价格高得多的显卡相比表现良好。
总体而言,NVIDIA GeForce RTX 5080 以 999 美元的标价提供了很大的价值,使其成为渲染、AI 或游戏工作负载的不错选择。


 Amazon