

对快速、高质量视频内容的需求从未如此强烈。在当今的媒体格局中,小型新闻团队、独立内容创作者和活动制作团队都需要实时捕捉、编辑和发布专业级素材,而且通常无需后期制作团队或集中式基础设施的支持。
正因如此,随着素材数量的激增和重复使用需求的增加,通过边缘制作系统提供的本地 AI 搜索正成为必需。边缘工作流程使团队能够在拍摄时直接处理素材,从而消除了瓶颈,使创作者能够减少寻找和管理素材的时间,从而将更多时间投入到制作最佳内容上。
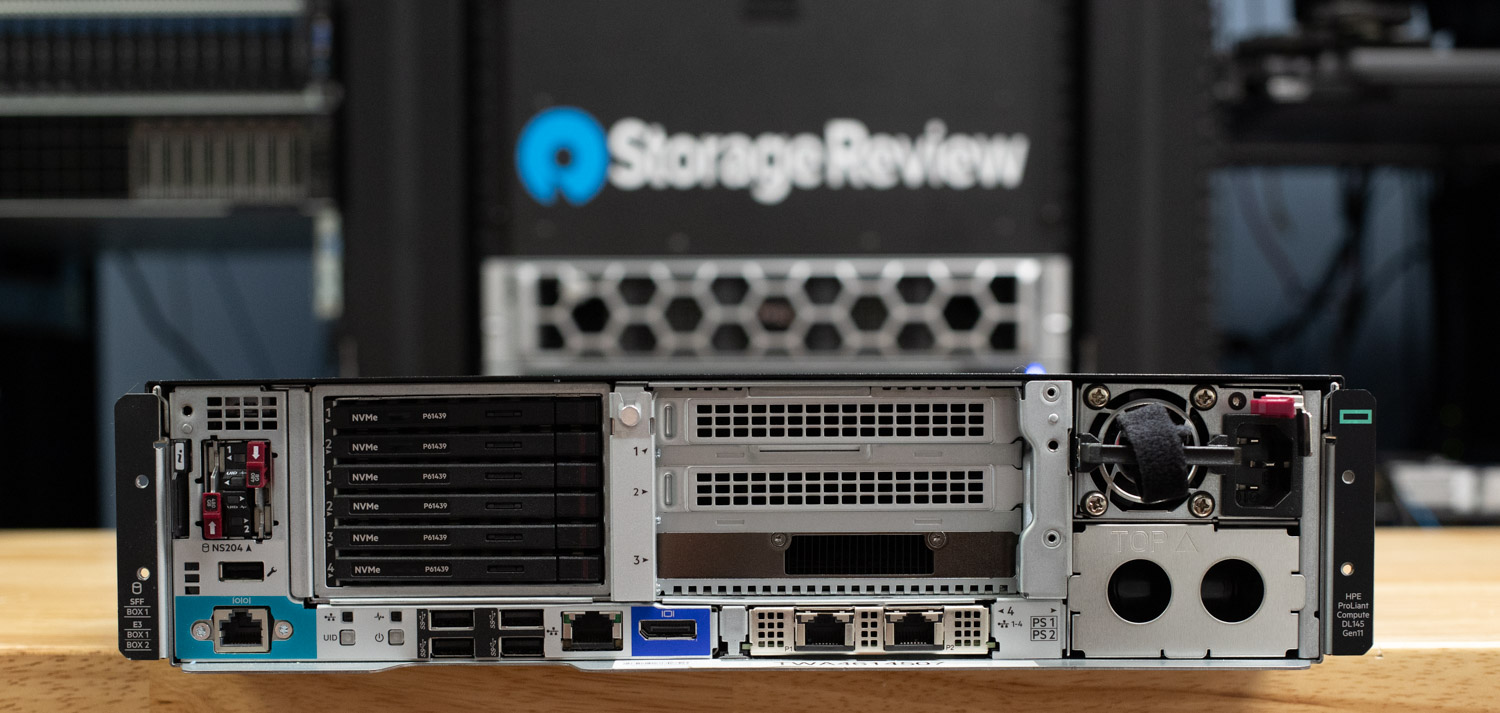
Axle AI是一款人工智能驱动的媒体资产管理和自动化平台,专为这种分散式、快节奏的工作流程而设计。它与业界领先的硬件(例如 HPE ProLiant DL145 Gen11 服务器、NVIDIA L4 GPU 和 Solidigm PCIe Gen5 SSD)相结合,打造出功能强大且便携的制作环境。即使是最精简的团队,也能从中受益,获得专业的 AI 辅助媒体处理能力。
系统架构概述
HPE ProLiant DL145 Gen11 边缘服务器是 Axle AI 在空间、电力和散热受限的现场和活动环境中部署的理想之选。这款服务器采用 2U 短深度设计,深度仅为 16 英寸,专为便携性和在狭小空间(例如移动机架和航空箱)中的安装而设计。与传统企业级设备不同,它支持 -5°C 至 55°C 的扩展工作温度范围,非常适合控制性较差的环境。尽管体积小巧,但它提供企业级功能,例如冗余电源和启动驱动器选项,使其成为需要强大、边缘计算能力强的基础设施且无需承担全尺寸硬件开销的团队的理想之选。
在CPU方面,DL145支持AMD EPYC 8004(Siena)系列处理器,核心数从8个到64个不等。我们的测试系统配备了EPYC 8434P处理器,拥有48个核心和96个线程。其TDP为200W,在能效和计算能力之间取得了良好的平衡,使其成为高强度工作负载的理想选择。该处理器支持96条PCIe 5.0通道,并提供6通道DDR5内存,最高速度可达4800 MT/s,拥有出色的内存带宽。虽然Axle AI的最低配置要求是至少16个CPU核心和32GB内存,但我们的配置远超这些要求,拥有48个核心和256GB的DDR5内存。
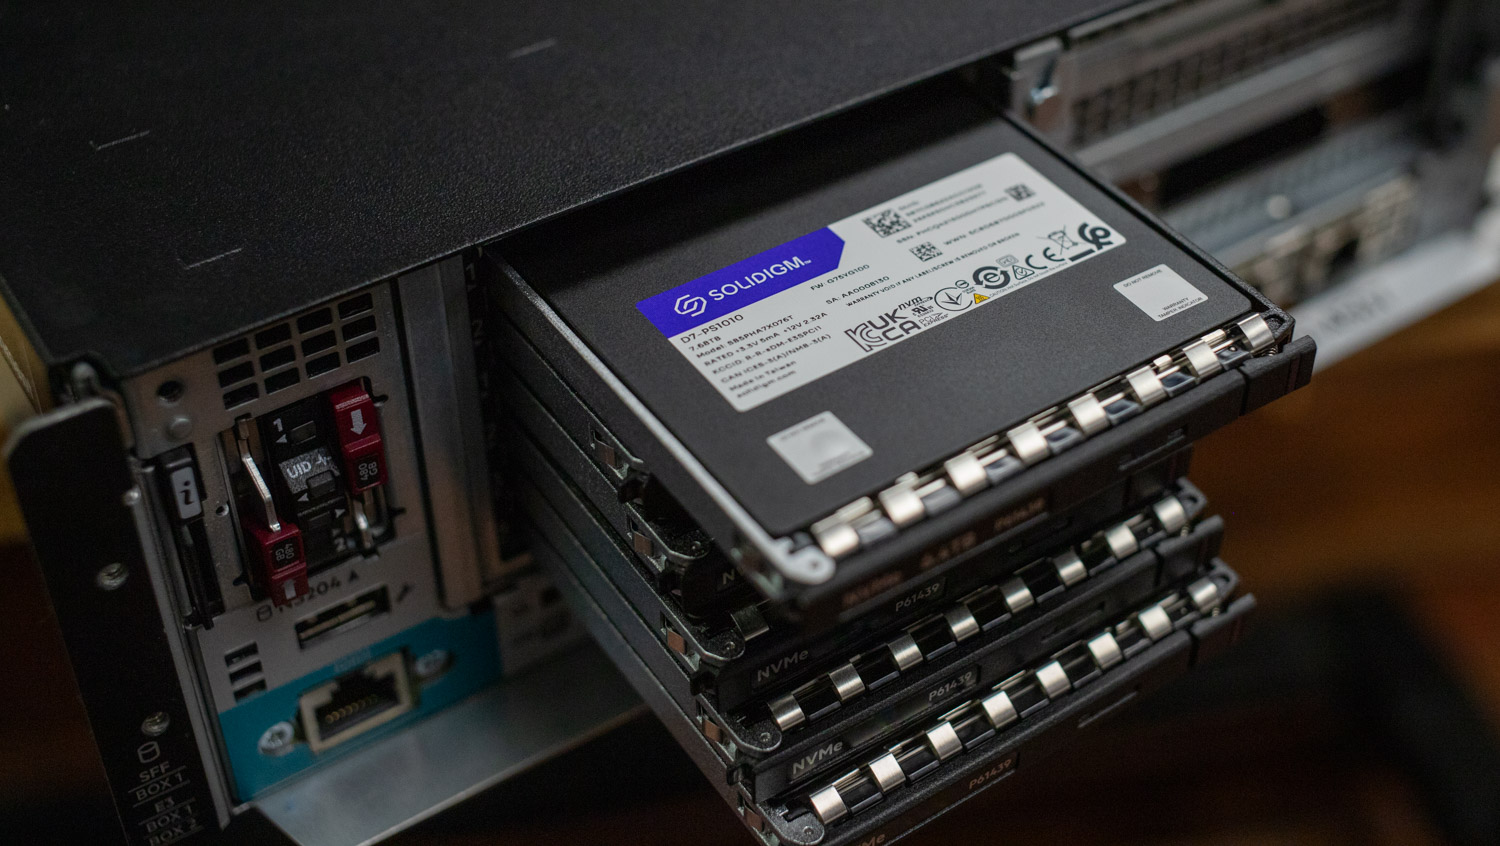
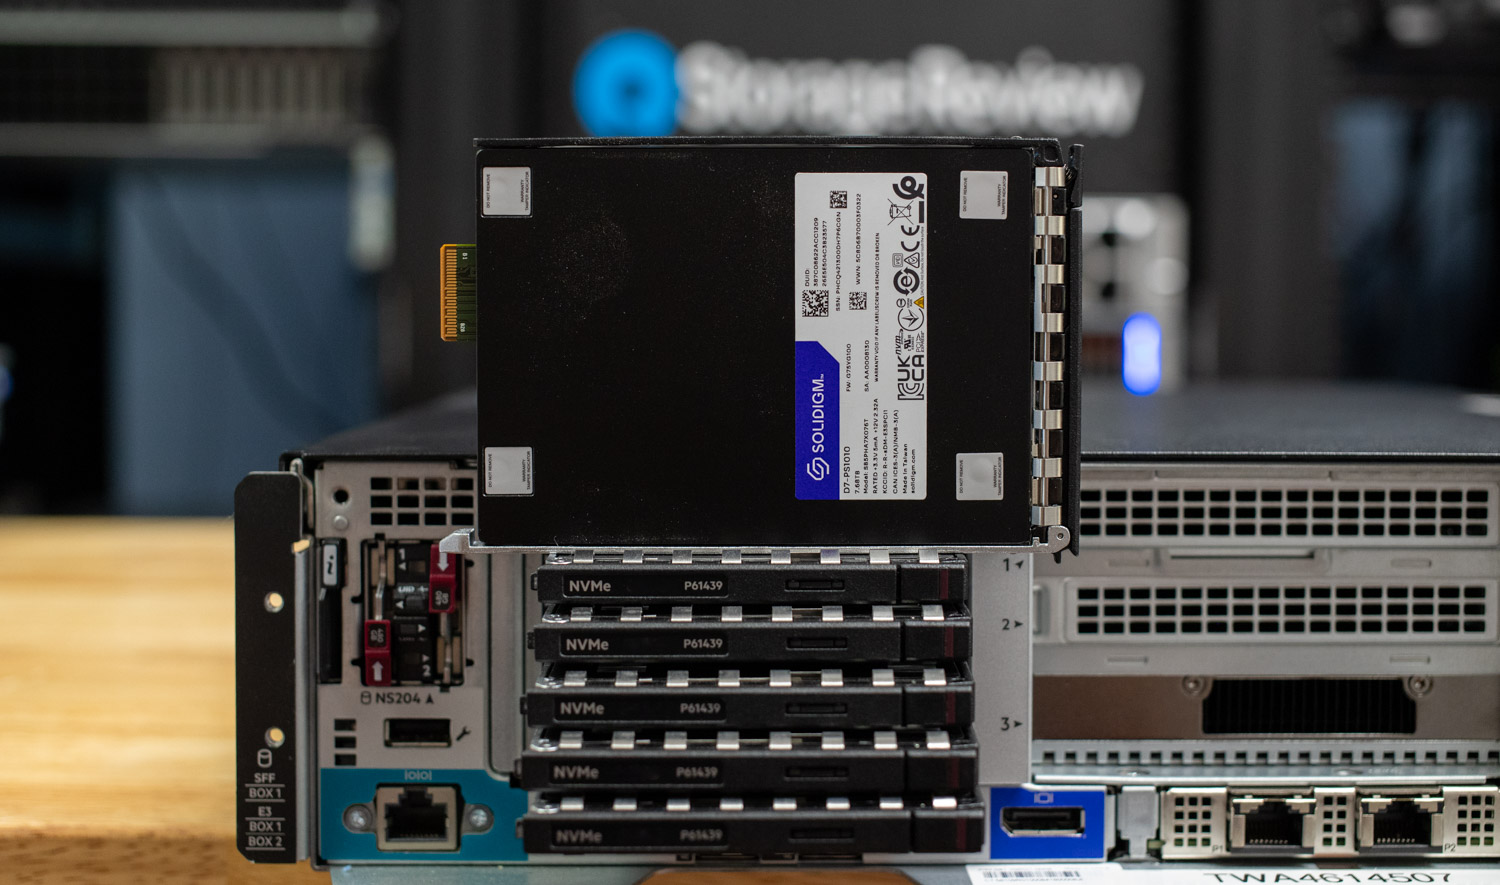
存储性能在任何媒体流程中都至关重要,而 DL145 最多支持六个 EDSFF E3.S NVMe 硬盘,以满足这些需求。在我们的配置中,我们使用了六个 Solidigm D7-PS1010 E3.S SSD,每个容量为 7.68 TB。这些 PCIe 5.0 x4 硬盘可提供高达 14,500 MB/s 的读取速度和 10,000 MB/s 的写入速度,总计可提供近 46 TB 的高速存储。这些 SSD 专为 AI 和媒体工作流程而设计,具有出色的能效,并且与传统 NVMe 硬盘相比,在特定流程阶段可提供高达 50% 的吞吐量提升。对于需要额外容量的团队,此配置可扩展至每个硬盘 15.36 TB,从而在紧凑的外形尺寸中提供总计 92 TB 的快速密集存储。
DL145 最多支持三个单槽 GPU,在我们的配置中,我们部署了一块 NVIDIA L4 加速器,这是一款基于 Ada Lovelace 架构的节能型加速器。L4 专为视频处理、AI 推理、视觉计算和虚拟化工作负载而设计,在仅消耗 72 瓦功耗的情况下,即可提供强大的性能。它配备 24 GB GDDR6 显存,并通过 PCIe 4.0 x16 接口进行供电和数据传输。Axle AI建议至少配备 16 GB 显存,而 L4 额外配备了 8 GB 显存,轻松满足高分辨率媒体任务和 AI 驱动操作的需求。
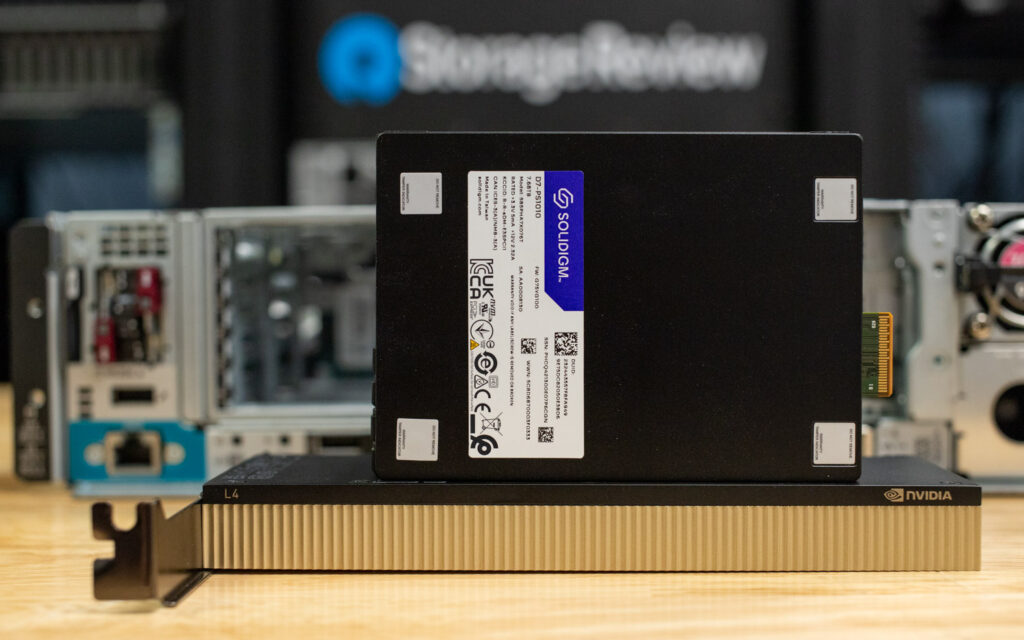
Nvidia L4 单槽 GPU
在应用层,我们使用 Proxmox 虚拟环境 (8.3.5) 部署了 Axle AI MAM 和 Axle AI 标签。系统配置了两个专用虚拟机:一个运行 Axle AI MAM,另一个运行 Axle AI 标签。这种结构将媒体管理和 AI 驱动的元数据处理清晰地分离,同时仍允许组件之间无缝通信。
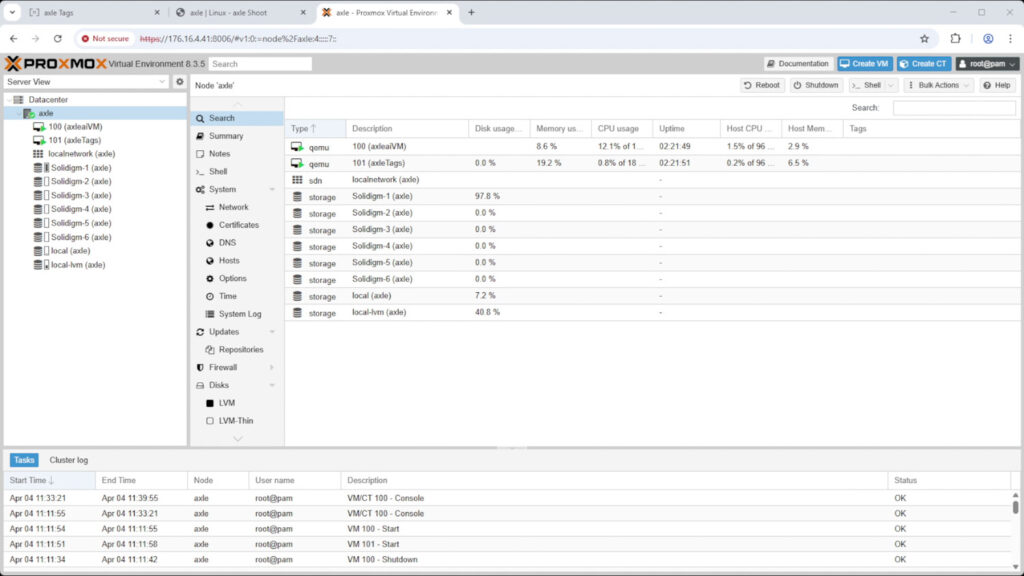
Proxmox环境和硬件总结
Axle AI Tags 与 MAM 协同运行,提供本地 AI 功能,包括语义向量搜索、对象和徽标识别以及可训练的人脸检测。它部署在 Docker 容器中,并通过 PCIe 直通利用 NVIDIA L4 GPU 实现高效的实时推理。基于浏览器的训练和管理界面支持灵活调整,其模块化设计支持 Intel/NVIDIA 或 AMD/NVIDIA 硬件配置。Axle AI Tags 不仅在我们的设置中与 MAM 完全集成,还提供 REST API 兼容性,以便与其他平台配合使用。
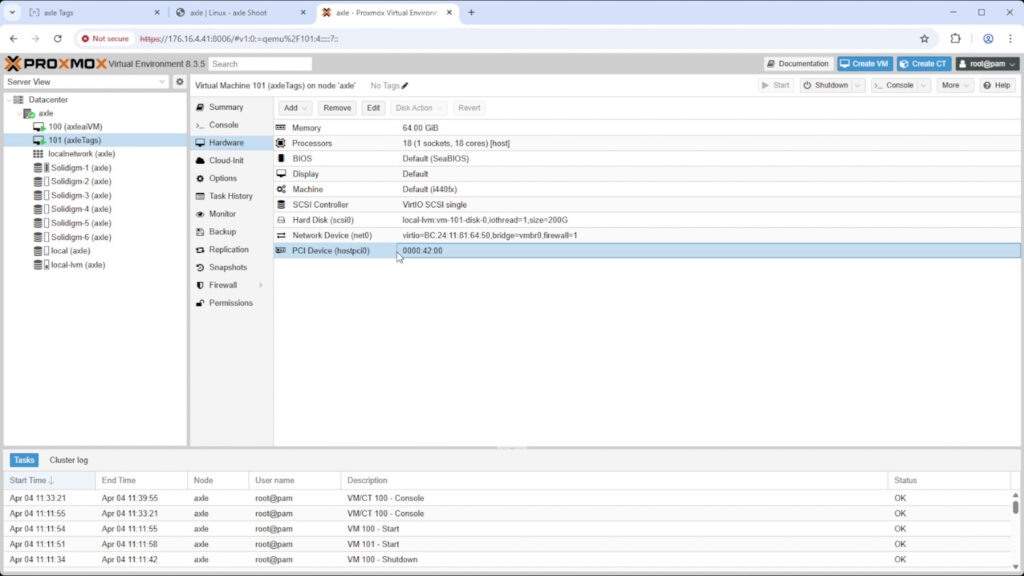
Axle AI Tags虚拟机的硬件配置
Solidigm PS1010 硬盘安装在 Axle AI MAM 虚拟机中,确保高速、低延迟地访问素材。通过虚拟化整个堆栈并为每个组件分配专用计算资源,此设置可提供更高的正常运行时间、更佳的资源管理和多用户支持,远超单个工作站所能提供的功能。这使其成为协作式、高容量制作环境的理想选择。
这些组件共同构成了一个紧密集成的硬件解决方案,可实现快速、本地化、AI 驱动的媒体工作流程。对于需要在空间和电力有限的情况下,同时又需要 AI 处理能力的远程团队来说,这是一个高效的现场就绪平台。
HPE ProLiant DL145 Gen11 性能
在深入进行基准测试之前,下表概述了 HPE ProLiant DL145 Gen11 的系统配置。在运行 Proxmox 的虚拟化安装上使用 Axle AI 进行测试时,系统已过渡到 Ubuntu Server 22.04.5,以测量 GDSIO 和 FIO 测试中的存储性能。
| HPE ProLiant DL145 第 11 代 | 硬件总览 |
|---|---|
| 中央处理器 | 单个 AMD EPYC 8434P |
| 内存 | 256GB 纠错码 DDR5 |
| 存放 | 6块 Solidigm D7-PS1010 E3s SSD,7.68TB |
| 引导存储 | NS204 端口 2x 已填充(480GB Samsung PM9A3 M.2) |
| GPU | 单个 NVIDIA L4 |
| 运行系统 | Ubuntu Server 22.04.5 |
峰值合成性能
FIO 测试是一款灵活而强大的基准测试工具,用于测量存储设备(包括 SSD 和 HDD)的性能。它评估各种工作负载(例如顺序和随机读/写操作)下的带宽、IOPS(每秒输入/输出操作)和延迟等指标。此测试旨在捕捉峰值性能,并在多种工作负载下测试存储系统,使其特别适用于比较不同的设备或配置。在本例中,我们执行了全表面测试,充分利用了驱动器的全部容量,以全面了解其持续的性能特征。
在使用128K块的顺序读取测试中,该系统的带宽达到56.4 GB/s,持续IOPS高达430,000,平均延迟为1.78毫秒。相同块大小下的顺序写入性能达到45.4 GB/s,IOPS高达346,000,平均延迟为2.22毫秒。在使用4K块的随机读取操作中,该系统的带宽达到46.6 GB/s,IOPS高达11.4万,平均延迟仅为0.269毫秒,突显了NVMe存储阵列在密集访问模式下的高吞吐量潜力。4K随机写入操作的带宽达到29.1 GB/s,IOPS高达7.1万,平均延迟为0.432毫秒,即使在碎片化访问下也展现出强大的持续写入能力。
| HPE DL145 Gen 11 FIO 基准测试摘要 | 带宽 – GB/s | IOPS | 平均延迟 |
|---|---|---|---|
| 顺序读取(128K) | 56.4 GB /秒 | 430k | 1.78毫秒 |
| 顺序写入(128K) | 45.4 GB /秒 | 346k | 2.22毫秒 |
| 随机读取 (4KB) | 46.6 GB /秒 | 11.4M | 0.269毫秒 |
| 随机写入 (4K) | 29.1 GB /秒 | 7.1M | 0.432毫秒 |
GPU 直接存储
我们在这个测试平台上进行的测试之一是 Magnum IO GPU 直接存储 (GDS) 测试。GDS 是 NVIDIA 开发的一项功能,允许 GPU 在访问存储在 NVMe 驱动器或其他高速存储设备上的数据时绕过 CPU。GDS 无需通过 CPU 和系统内存路由数据,而是实现 GPU 和存储设备之间的直接通信,从而显著降低延迟并提高数据吞吐量。
GPU 直接存储的工作原理
传统上,当 GPU 处理存储在 NVMe 驱动器上的数据时,数据必须先经过 CPU 和系统内存,然后才能到达 GPU。这个过程会造成瓶颈,因为 CPU 会成为中间人,增加延迟并消耗宝贵的系统资源。GPU 直接存储通过使 GPU 能够通过 PCIe 总线直接从存储设备访问数据,消除了这种低效率。这种直接路径减少了与数据移动相关的开销,从而实现了更快、更高效的数据传输。
AI 工作负载(尤其是涉及深度学习的工作负载)是高度数据密集型的。训练大型神经网络需要处理数 TB 的数据,数据传输的任何延迟都可能导致 GPU 利用率不足和训练时间延长。GPU Direct Storage 通过确保尽快将数据传送到 GPU、最大限度地减少空闲时间并最大限度地提高计算效率来解决这一挑战。
此外,GDS 对于涉及流式传输大型数据集的工作负载(例如视频处理、自然语言处理或实时推理)尤其有益。通过减少对 CPU 的依赖,GDS 可加速数据移动并释放 CPU 资源以用于其他任务,从而进一步提高整体系统性能。
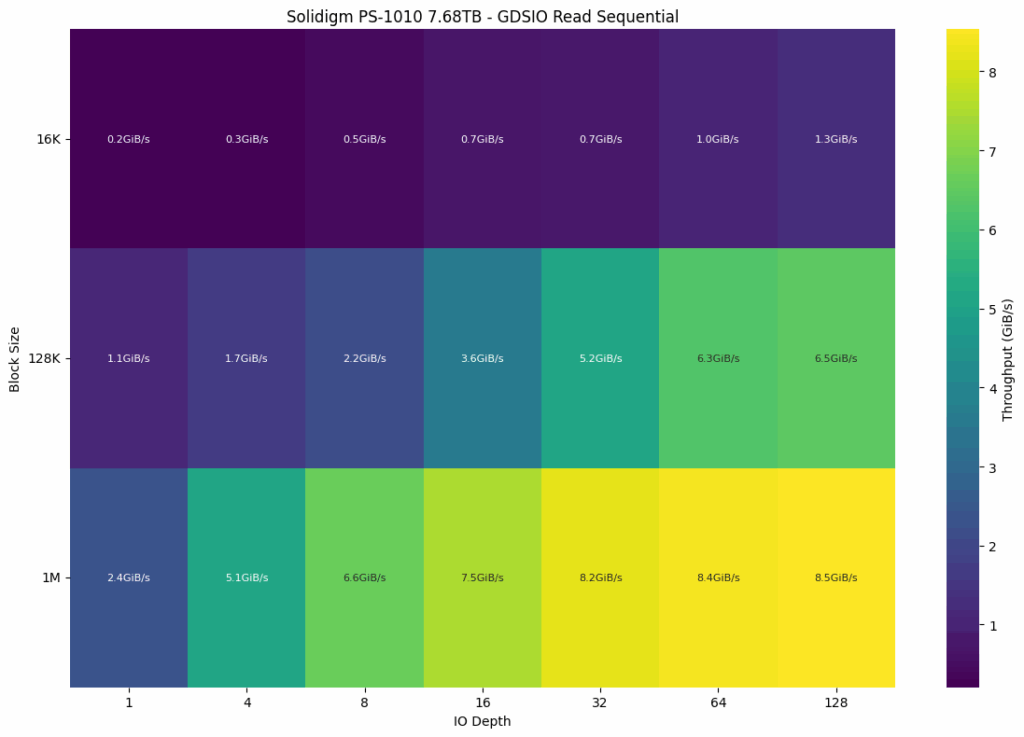
GDSIO 顺序读取
在 Solidigm PS1010 7.68TB 硬盘的 GDSIO 顺序读取测试中,性能随块大小和 I/O 深度显著变化。在最小的 16K 块大小下,吞吐量在队列深度为 0.2 时仅为 1 GiB/s,并逐渐上升至 1.3 深度时的 128 GiB/s,表明在该粒度下的可扩展性有限。当块大小增加到 128K 时,性能提升更为显著,从 1.1 GiB/s 开始,在最高深度时攀升至 6.5 GiB/s。块大小为 1M 时获得了最佳结果,吞吐量最初达到 2.4 GiB/s,在队列深度为 8.5 时达到峰值 128 GiB/s,这表明硬盘的最佳性能配置是通过较大的顺序读取和更深的队列实现的。
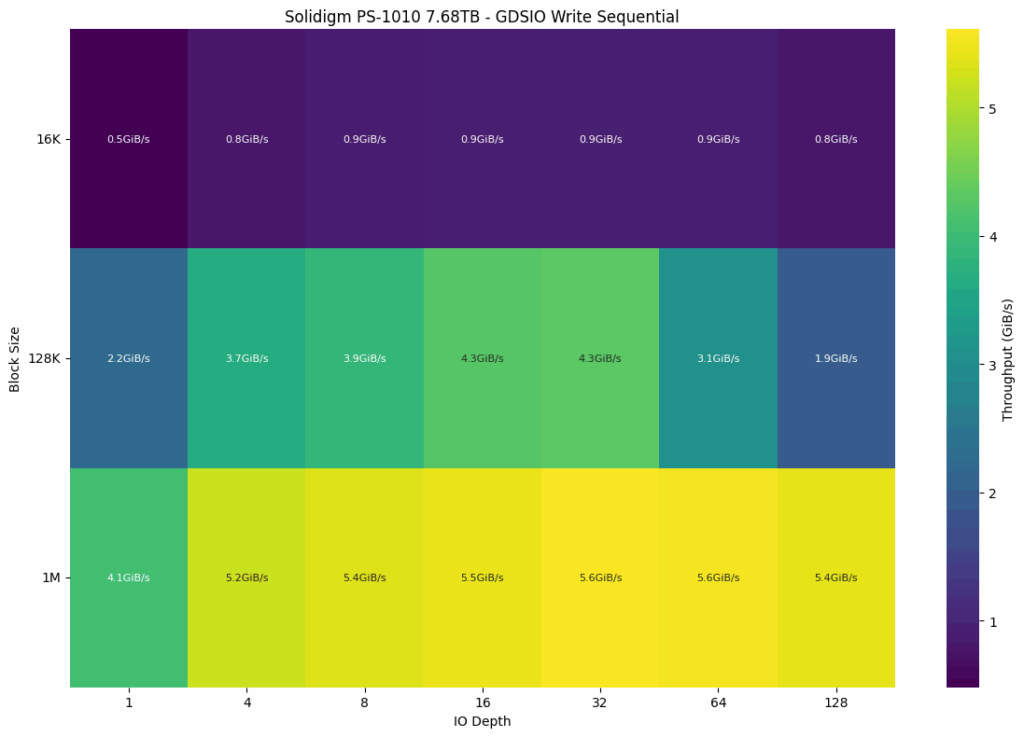
GDSIO 顺序写入
Solidigm PS1010 的顺序写入性能在较大的块大小下表现出良好的可扩展性,但在中等规模工作负载下,队列深度较高时会有所下降。在最小的 16K 块大小下,写入速度起始于 0.5 GiB/s,在队列深度 0.9 到 8 之间达到 64 GiB/s 的峰值,然后在深度 0.8 时略微下降至 128 GiB/s。在 128K 块大小下,性能起始于 2.2 GiB/s,在深度 4.3 时提升至 32 GiB/s 的高点,然后在最深的队列中下降至仅 1.9 GiB/s,这表明写入可能已达到饱和或受到限制。在 1M 块大小下实现了最佳的持续性能,吞吐量从深度 4.1 时的 1 GiB/s 平稳扩展到深度 5.6 和 32 时的 64 GiB/s,并在深度 128 时保持稳定。
GDSIO 摘要
下表清晰地细分了 Solidigm D7-PS1010 SSD 上收集的 GDSIO 性能指标,包括延迟和 IOPS,测量数据分别以 16K、128K 和 1M 的块大小和 128 的 IOPS 进行测量。在队列深度为 128 的情况下,延迟和 IOPS 会随着块大小的变化而变化。16K 块的平均读取延迟为 1.549 毫秒,IOPS 为 82.3K,而写入延迟为 2.429 毫秒,IOPS 为 52.6K。使用 128K 块时,读取延迟增加到 2.414 毫秒(IOPS 为 52.9K),写入延迟增加到 8.050 毫秒(IOPS 为 15.9K)。在 1M 的情况下,读取延迟达到 14.643 毫秒(IOPS 为 8.7K),写入延迟上升到 23.030 毫秒(IOPS 为 5.6K)。
| GDSIO 图表(16K、128K、1M 块大小平均值) | HPE DL145 Gen 11(6 个 Solidigm D7-PS1010 E3s SSD 7.68TB) |
|---|---|
| (16K 块大小 128 IO 深度)平均读取 | 1.3 GiB/秒(1.549毫秒)IOPS:82.3K |
| (16K 块大小 128 IO 深度)平均写入 | 0.8GiB/秒(2.429毫秒)IOPS:52.6K |
| (128K 块大小 128 IO 深度)平均读取 | 6.5 GiB/秒(2.414毫秒)IOPS:52.9K |
| (128K 块大小 128 IO 深度)平均写入 | 1.9 GiB/秒(8.050毫秒)IOPS:15.9K |
| (1M 块大小 128 IO 深度)平均读取 | 8.5 GiB/秒(14.643毫秒)IOPS:8.7K |
| (1M 块大小 128 IO 深度)平均写入 | 5.4 GiB/秒(23.030毫秒)IOPS:5.6K |
边缘媒体制作
Axle AI 是什么?
Axle AI 是一个基于 AI 的本地媒体资产管理 (MAM) 平台,旨在简化中小型媒体团队的视频工作流程。它可以自动执行关键任务,例如采集、标记和媒体搜索,而无需承担传统 MAM 系统的成本或复杂性。Axle AI 专为速度和易用性而设计,使团队无论在办公室还是远程办公,都能更高效地管理和交付内容。
该平台支持整个制作流程。它自动采集素材、创建代理、使用对象识别、人脸检测和语义搜索等功能应用人工智能驱动的元数据,并与 Adobe Premiere Pro 和 DaVinci Resolve 等行业标准编辑工具集成。这使得团队能够快速定位、编辑和发布内容,避免瓶颈或延迟。
实际用例
Axle AI 深受各类媒体团队的信赖,包括广播公司、纪录片制作人、企业视频部门、营销机构以及现场活动制作人。这些团队通常跨地域办公,需要可靠地访问其媒体库,而无需繁重的基础设施。
借助 Axle AI,用户可以通过基于浏览器的界面进行远程协作,该界面可即时访问代理媒体。剪辑师可以在其首选的非线性编辑系统 (NLE) 中立即开始剪辑素材,而制片人和相关人员则可以实时审阅、标记或批准剪辑片段(无需传输大文件或具备专业技术技能)。
无论您的团队规模是五人还是五十人,Axle AI 都能实现更快、更高效的工作流程。其简洁的界面、快速的部署以及与现有存储系统的兼容性,使其成为大批量分布式媒体制作的智能解决方案。
对即时社交媒体的强烈需求极大地加快了媒体制作的速度。这种心态非常普遍,“不争第一,就是最后”的心态,尤其是在直播活动及其相关的内容创作方面。媒体公司需要一种高效的方式来组织和快速审核大量素材。像 Axle AI 这样的工具,能够缩减到小规模操作,使这种工作流程在现场变得切实可行。如果与合适的工作流程(例如可以同时录制代理文件和原始素材的摄像机)搭配使用,效率将大幅提升。
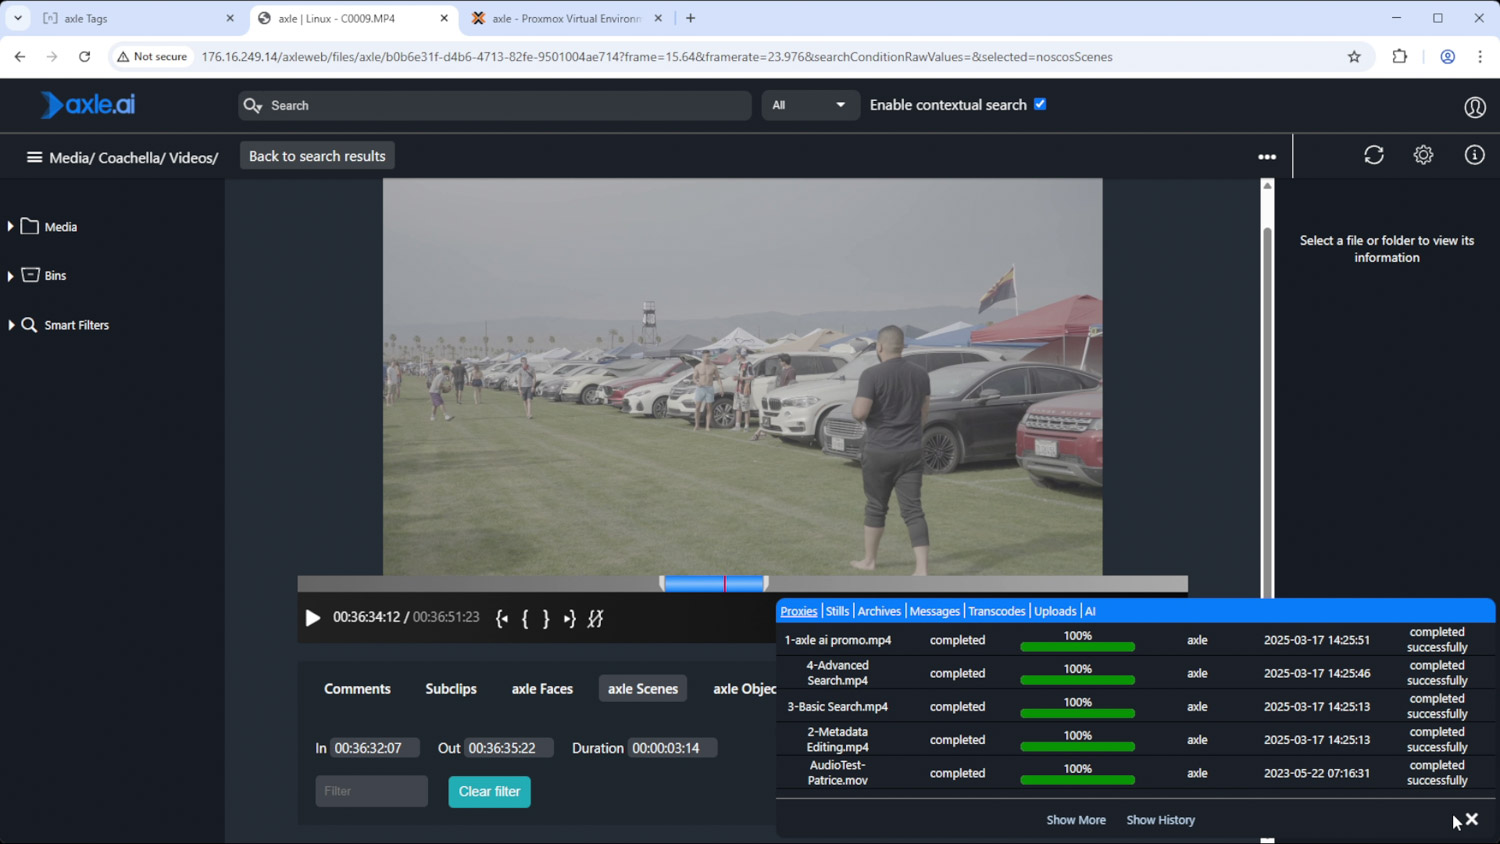
在采集时同时保存高分辨率和低分辨率代理媒体,并在 Axle AI 标签中立即处理较小的代理文件,几乎可以立即搜索所有素材。Axle AI 与大多数主流非线性编辑软件(例如 Adobe Premiere Pro、DaVinci Resolve 和 Avid Media Composer)的集成,让剪辑师可以立即开始工作。这也大大减轻了制作团队的负担,使他们能够专注于其他任务或避免倦怠。
传统上,记录一直是媒体采集工作流程中最费力且最常被忽略的环节之一。Axle AI 会使用 AI 生成的场景描述(而非传统的元数据字段)自动记录媒体,让剪辑师在仔细查看片段内容之前就能读取其中的内容。它还提供语义搜索工具,使剪辑师和制作人能够使用概念和主题快速找到相关素材,而无需依赖特定的标签。
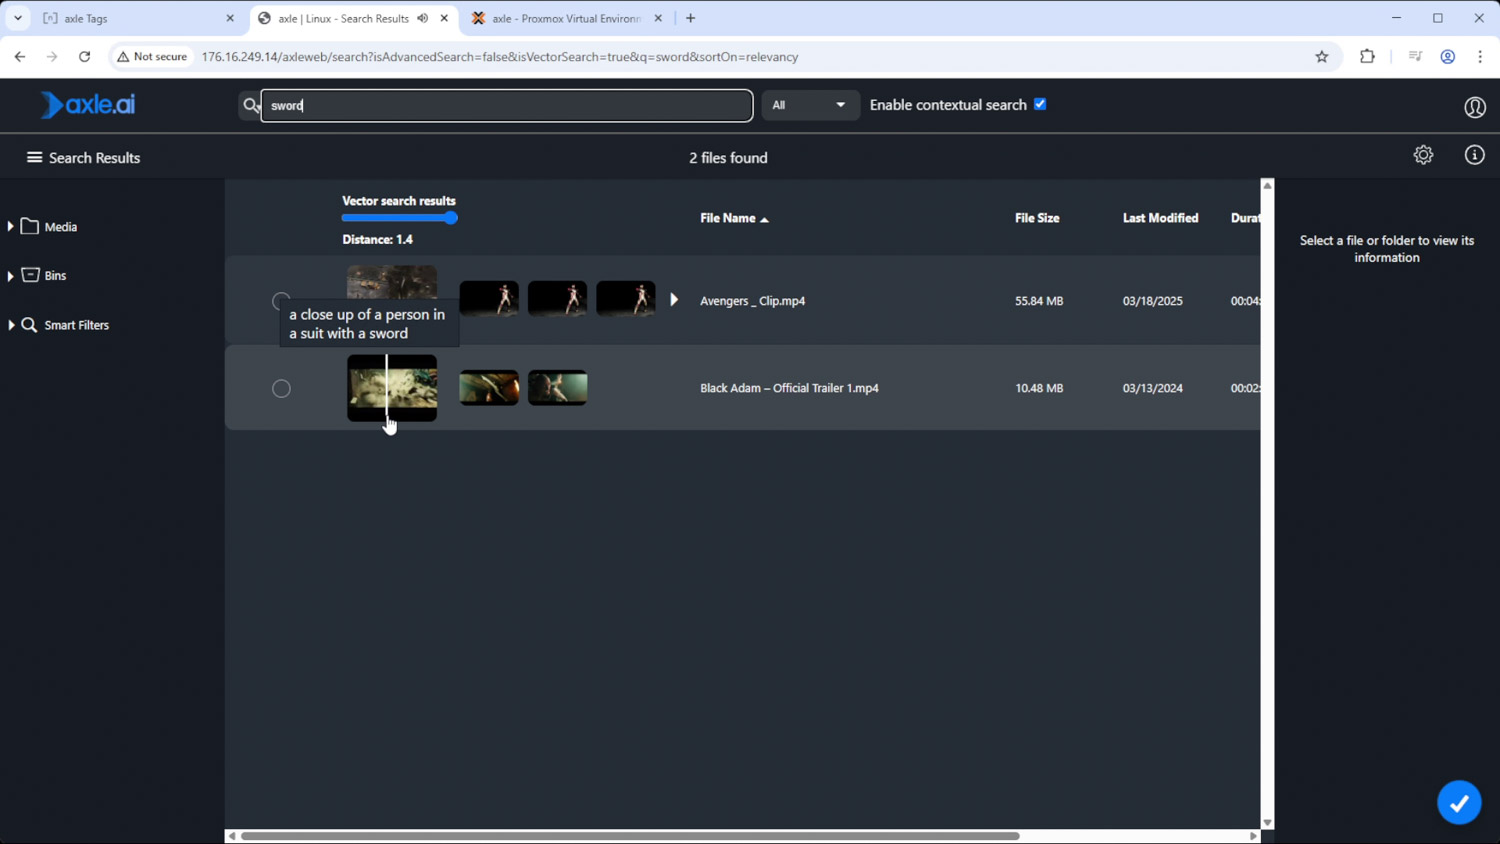
可扩展性也至关重要,因为并非所有工作都需要快节奏的现场媒体制作。Axle AI 可以安装在功能更强大的固定系统上,并通过网络共享访问媒体公司积压的素材。这使得编辑和制作人能够更快地找到相关媒体,甚至发现他们之前可能没有考虑过的、在档案库中“丢失”的素材。内容创作者和广播公司可以从这种积压索引中受益匪浅,从原本闲置在服务器上的媒体中创造更多价值。虽然它并非万无一失,但它可以帮助媒体公司在媒体创作过程中一些最耗时的环节上抢占先机。
HPE ProLiant DL145 Gen11 作为此边缘 AI 部署的硬件基础,在紧凑的空间内实现了计算密度、存储吞吐量和 GPU 加速之间的完美平衡。该系统搭载 48 核 AMD EPYC 8434P 处理器,该处理器属于节能型 8004 系列,针对多线程工作负载进行了优化,同时保持了低功耗。该配置包括 256GB RAM 和单个 NVIDIA L4 GPU,这是一款高效的加速器,非常适合边缘 AI 推理。存储配置了六个 Solidigm D7-PS1010 E3.S SSD,每个 SSD 的容量为 7.68TB,为媒体资产和元数据密集型工作负载提供了充足的高性能闪存。DL3 Gen145 支持最多三个单宽 GPU 和总共六个 E11.S 驱动器,能够根据要求严苛的视频和 AI 用例进行扩展。此设置强调了精心组装现代硬件组件(包括 CPU、GPU 和 SSD)的重要性,以便为边缘为中心的 AI 工作流程(例如由 Axle AI 提供支持的工作流程)提供卓越的性能。
结语
Axle AI 正在改变视频内容的制作方式,尤其适用于资源有限的实时工作团队。通过将智能媒体资产管理与强大的推理工具相结合,Axle AI 实现了传统媒体资产管理 (MAM) 系统无法比拟的自动化和响应速度。我们构建的设备与 HPE ProLiant DL145 Gen11 边缘服务器、NVIDIA L4 GPU 和 Solidigm Gen5 SSD 搭配使用,可提供针对现代媒体工作流程优化的紧凑型高性能环境。无论是在现场使用还是作为混合编辑流程的一部分,此配置都提供了一种可扩展且高效的方式,可以比以往更快地提取、标记、搜索和交付视频内容,同时不会影响质量或控制。对于那些需要在快节奏的内容环境中保持领先地位的团队来说,边缘基础设施与 AI 辅助工作流程的结合将带来显著的竞争优势。



 Amazon