

Pi表示圆的周长与其直径的比值,它有无数个从不重复或结束的小数位。 计算无穷大的 Pi 不仅仅是数学家的一项激动人心的任务; 这也是一种让计算能力和存储容量通过最终耐力测试的方法。 到目前为止,谷歌的 Cloud 保持着 100 万亿位最大圆周率求解的世界纪录。 截至今天,StorageReview 已经匹配了他们的数量,而且只用了一小部分时间。
天空中的圆周率,云层之上
去年,谷歌云开发者倡导者 Emma Haruka Iwao 宣布,她和她的团队已经将 Pi 计算到了 100 万亿位,打破了她自 31.4 年以来的 2019 万亿位的记录。他们使用了一个名为 y-cruncher 的程序,该程序运行在谷歌云的计算引擎上,大约需要 158 天才能完成并处理大约 82 PB 的数据。 最后,该运行还会产生大量的云计算和存储发票,再加上组织将特定工作负载带回本地的势头越来越大,这给了我们一个有趣的想法……
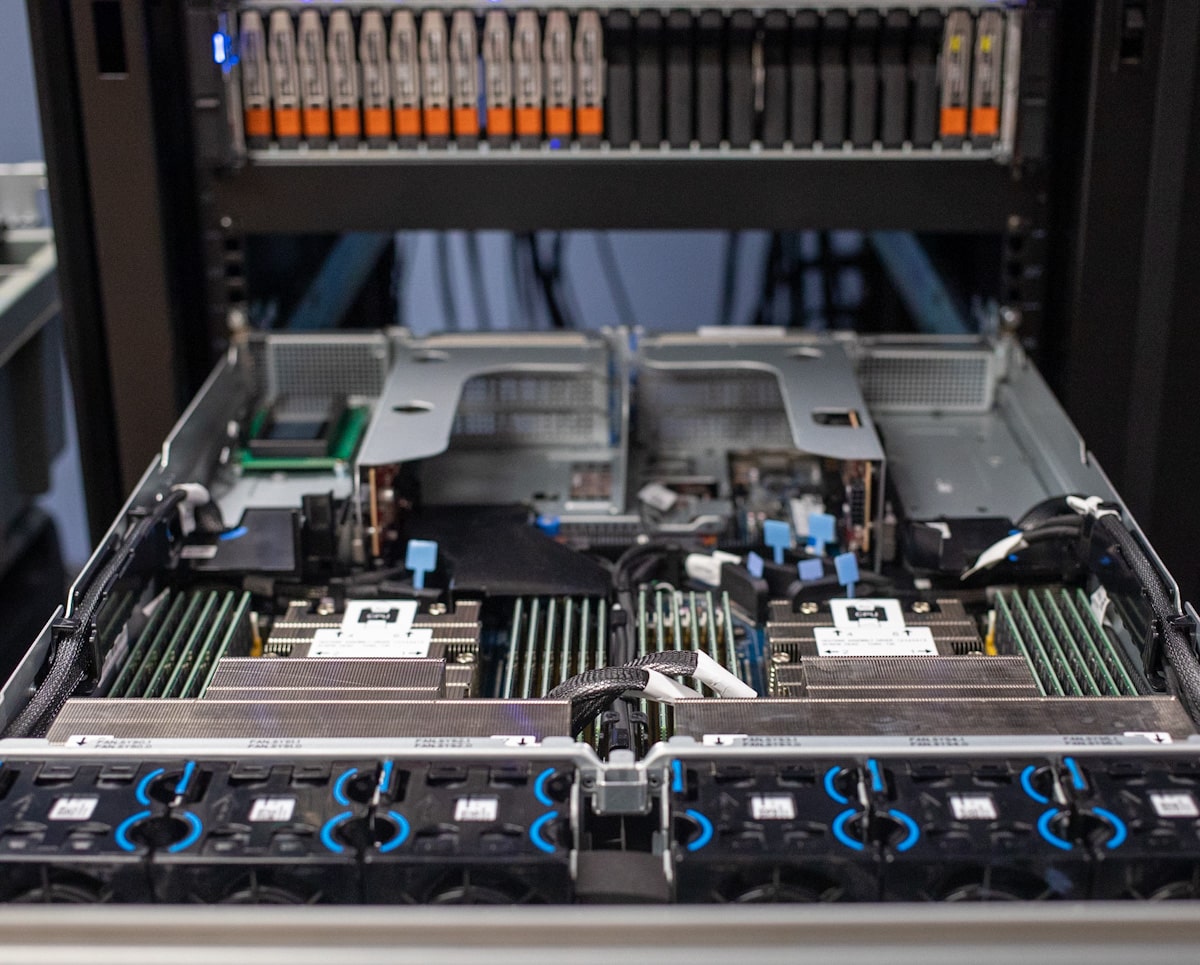
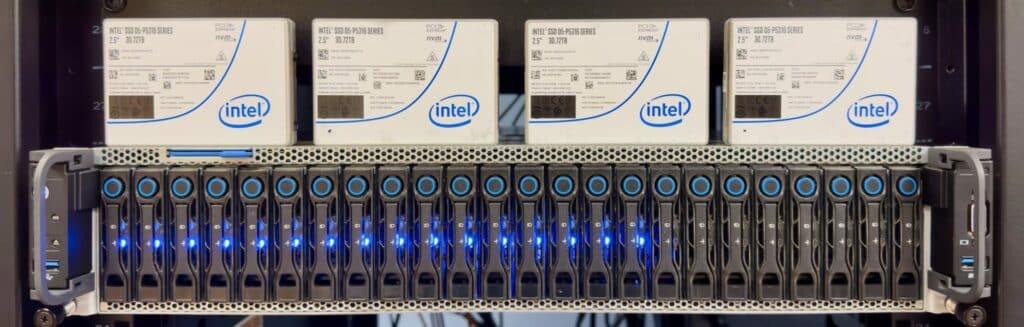
我们对 Emma 和 Google Cloud 的成就印象深刻,但我们也想知道能否以更快的速度、更低的成本实现同样的目标。在 StorageReview.com,我们拥有业内一些最新、最顶尖的硬件,包括AMD EPYC 第四代处理器、Solidigm P5316 固态硬盘以及数量惊人的锂电池。我们巧妙地利用这些资源,打造了一台高性能服务器,配备了近 600TB 的 QLC 闪存和独特的高可用性电源解决方案。
以下是我们计算系统的规格:
- 2 x AMD EPYC 9654(96 核,2.4 GHz,3.7 GHz 加速)
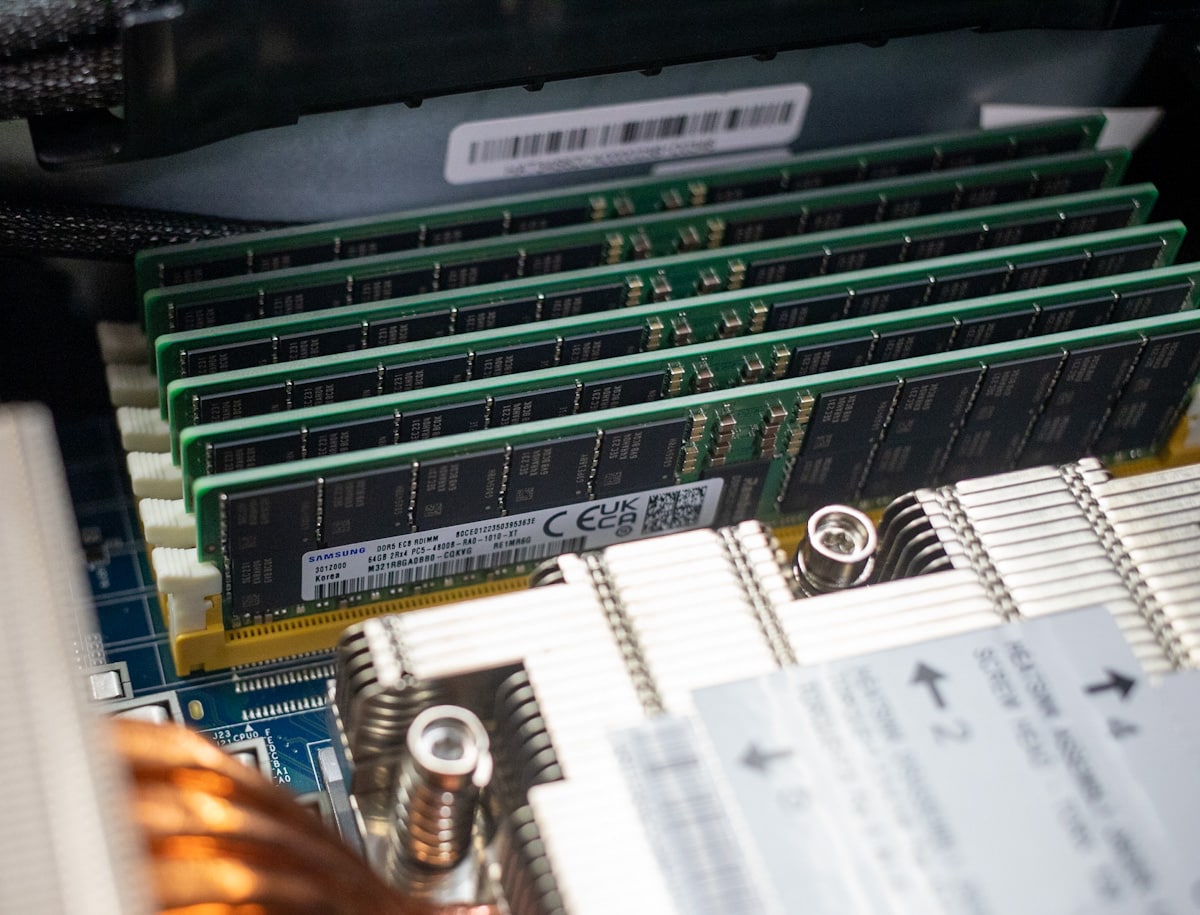
- 24 个 64GB DDR5-4800 DIMM,总容量 1.5TB
- 19点¯x Solidigm 30.72TB QLC P5316 固态硬盘
- Windows Server 2022 标准版 21H2
- 程序: y 粉碎机 通过 Alexander Yee
虽然硬件总量可能看起来很极端,但直接购买我们的硬件的成本仍然只是在云中运行相同工作负载六个月的一小部分。
数据中心:由 Madmen 设计
当我们为这个测试设计我们的装备时出现的第一个问题是,“我们如何提供一个足够大的连续体积来存储一个包含 100 万亿位 Pi 的文本文件?”(这绝对是一个直接的引用我们完全说过的话)。 数学很简单,1 个 Pi 数字 = 1 个字节,有 100 万亿个十进制数字意味着我们需要 100TB 的空间,另外需要 83TB 的空间来计算 83 万亿个十六进制数。 值得庆幸的是,这是 StorageReview,如果我们知道如何做一件事,那就是在压力过大的情况下存储大量数据。
不幸的是,就连 Kevin 的看门人大小的闪存驱动器钥匙圈上也没有 183TB 的闪存驱动器(目前)。 因此,在实验室中查看和测试各种方法并探索映射 NAS 或文件共享的多种方法后,我们通过测试注意到 y-cruncher 喜欢对其正在使用的磁盘进行直接 IO 控制; 不仅是交换磁盘,还有文件输出目录。 为 y-cruncher 提供一个可以向其发送 SCSI 命令的卷是我们唯一的选择,因为它会产生最佳性能。
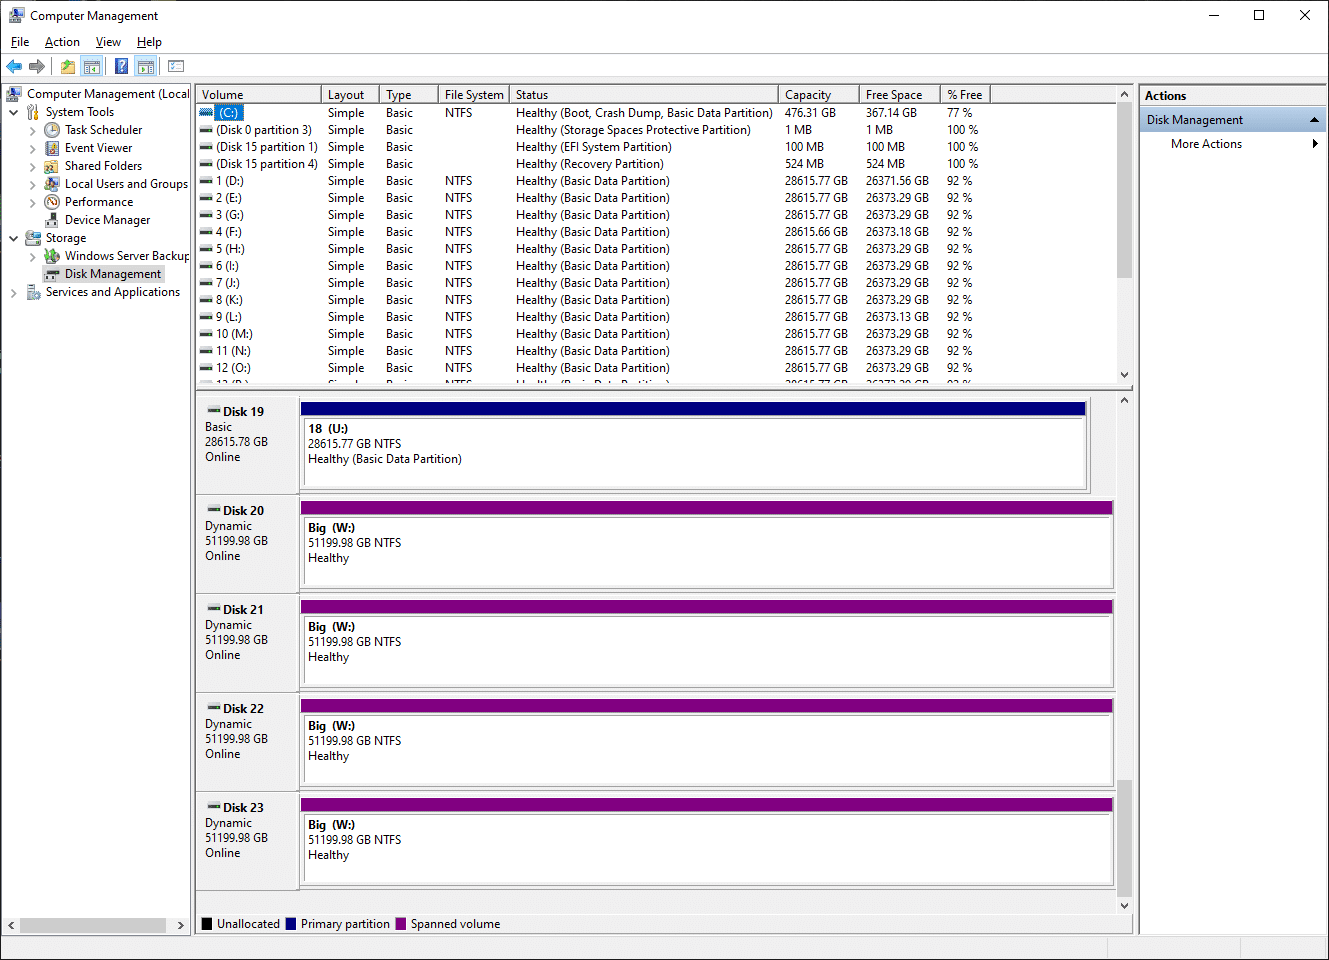
因此,接下来唯一合乎逻辑的做法是使用 iSCSI 目标连接到Supermicro 存储服务器来存储输出文件,这些文件太大,无法存储在本地计算主机上的任何单个卷中。该平台在高容量存储方面更为传统,它“仅”承载了 200TB 的存储空间,分布在四个 50TB 的 LUN 上,我们将其条带化部署在我们的计算平台上。
虽然 RAID 0 可能会引起一些人的注意,但在我们的辩护中,文件服务器存储是从镜像的 Windows 存储空间池中分割出来的,因此远程主机上可以使用冗余。 然后它通过双端口 10G 接口进行多路径连接,直接连接并在两台服务器之间硬连线。 从这个等式中删除一个开关是有目的的,因为这个 Pi 平台被设计为完全独立运行,以防主实验室离线。
虽然在StorageReview实验室,电源保护并非总是首要考虑因素,但如此大规模的项目(历时数月)需要采取极端措施来确保正常运行时间。我们使用了三台EcoFlow Delta Pro便携式电源,每台都具备3600W的输出功率和3600Wh的电池容量。
AMD Genoa 服务器使用了两台电源,其中一台 Delta Pro 电源之间串联了一台Eaton 5PX不间断电源,以缓解 EcoFlow 在断电期间的切换延迟。文件服务器则专用于一台 Delta Pro 电源,并配备一台Eaton 5PX G2电源以减少传输延迟。
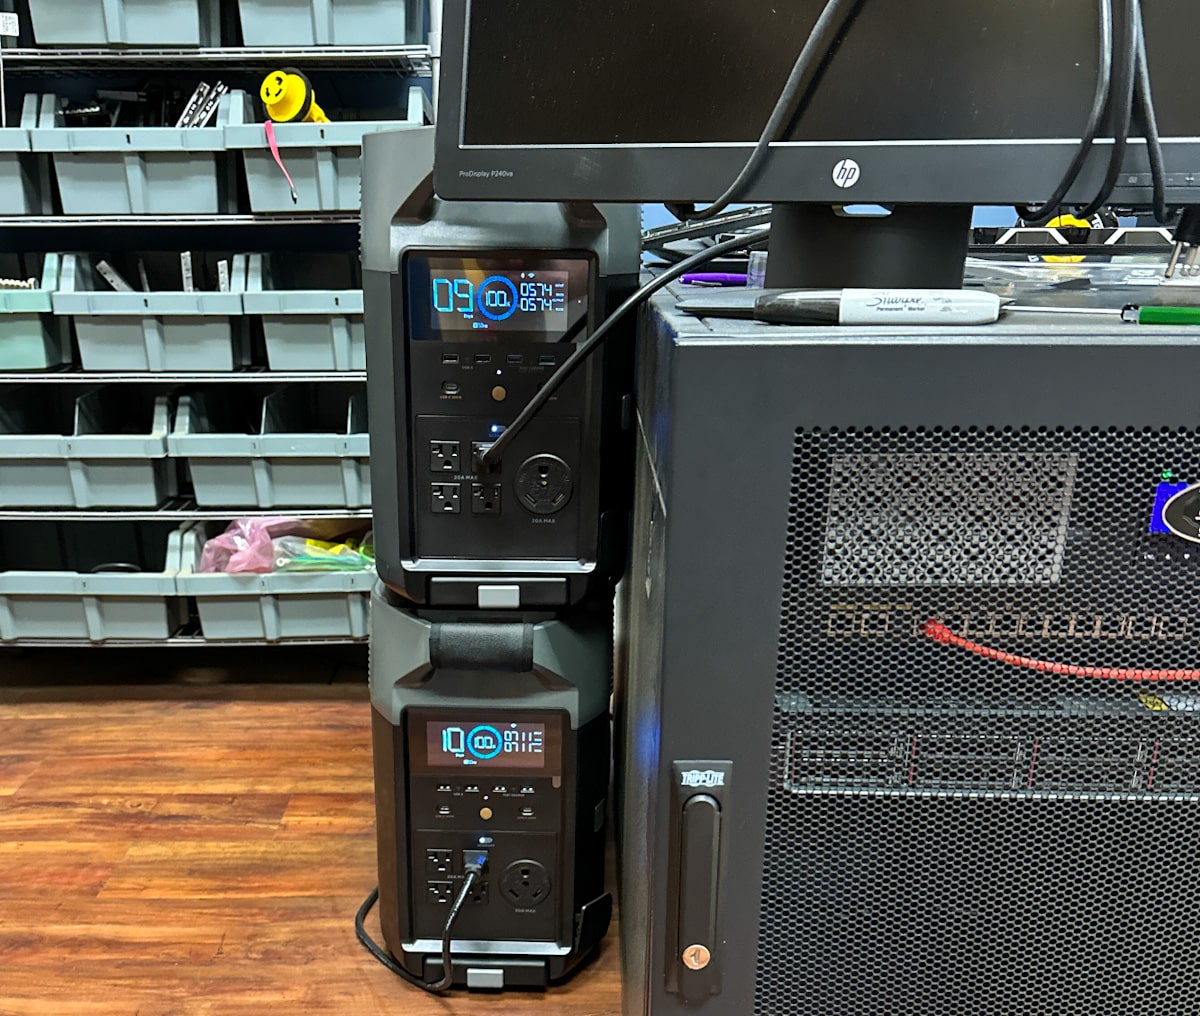
简而言之,我们打造了一款功能强大的 UPS,将高容量便携式电站的优势与现代数据中心级备用电池设备的可靠性相结合。 在峰值计算负载下,我们的电池运行时间为 4-8 小时。 在整个 100T Pi 运行过程中,我们遇到了无数风暴,但我们可以轻松入睡,因为我们知道 Pi 运行会保持运行。
肉、土豆和 Pi。 很多很多的Pi…
我们在美国东部时间 9 年 17 月 40 日星期四 47:2023:10 开始计算,并在美国东部时间 05 年 27 月 37 日星期一 2023:54:17 结束。 经过的 Pi 计算时间为 35 天 48.96 小时 59 分 10 秒,包括编写和验证在内的总时间为 46 天 49.55 小时 XNUMX 分 XNUMX 秒。
可用总存储空间为 530.1TB,不包括用于写入的 200TB iSCSI 目标。以下是 y-cruncher 验证文件中的一些计数器亮点,该文件可供下载和验证。
重要的数字
开始日期:9 年 17 月 40 日星期四 47:2023:XNUMX
工作模式:
- 常量:Pi
- 算法:Chudnovsky (1988)
- 小数位数:100,000,000,000,000
- 十六进制数:83,048,202,372,185
- 工作内存:1,512,978,804,672 (1.38 TiB)
- 总内存:1,514,478,305,280 (1.38 TiB)
逻辑磁盘计数器:
- 逻辑最大检查点:150,215,548,774,568 (137 TiB)
- 逻辑峰值磁盘使用:514,540,112,731,728 ( 468 TiB)
- 逻辑磁盘总字节读取:40,187,439,132,182,512 (35.7 PiB)
- 写入的逻辑磁盘总字节数:35,439,733,386,707,040 (31.5 PiB)
数字不说谎:
- 总计算时间:4728948.966 秒
- 从开始到结束的墙时间:5136409.559 秒
- 最后一位小数:
- 4658718895 1242883556 4671544483 9873493812 1206904813:99,999,999,999,950
- 2656719174 5255431487 2142102057 7077336434 3095295560:100,000,000,000,000
结束日期:10 年 05 月 27 日星期一 37:2023:XNUMX
100万亿前的十位数是3095295560。
我们用大约三分之一的时间将 Pi 计算到 100 万亿位,部分原因是与 Google 的方法相比所有本地交换存储空间。 这显示了本地连接的 Solidigm P5316 QLC SSD 以及 AMD EPYC 第四代处理器令人难以置信的性能、密度和效率。
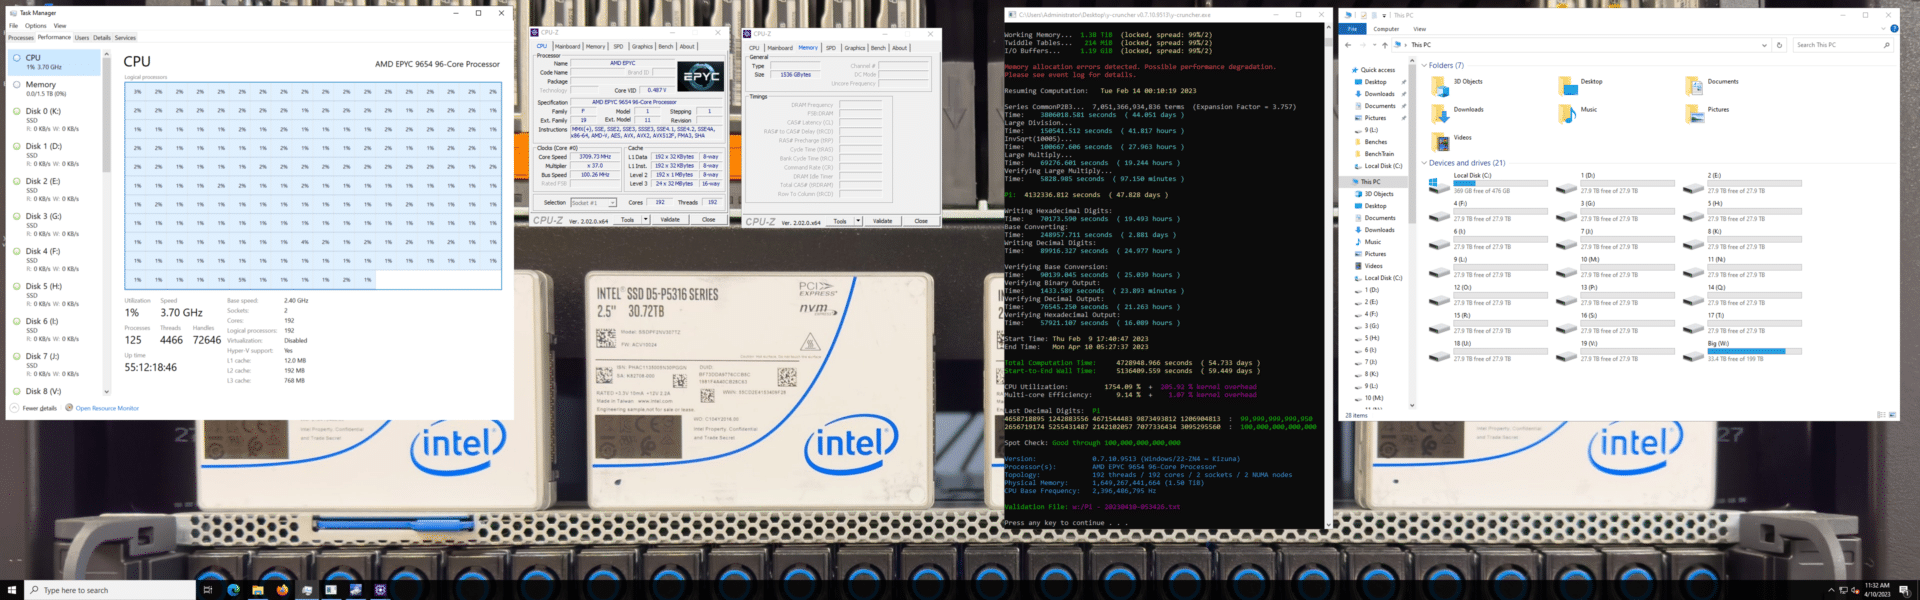
本地存储是这种速度运行不可或缺的一部分。 虽然谷歌的运行可以利用近乎无限量的存储,但它仅限于 100Gb 的网络接口。 说 100Gb 很慢很奇怪,但在我们的测试规模下,它成为一个巨大的瓶颈。 在交换写入突发期间,我们测量到 Solidigm P5316 QLC SSD 的累计传输速度超过 38GB/s。
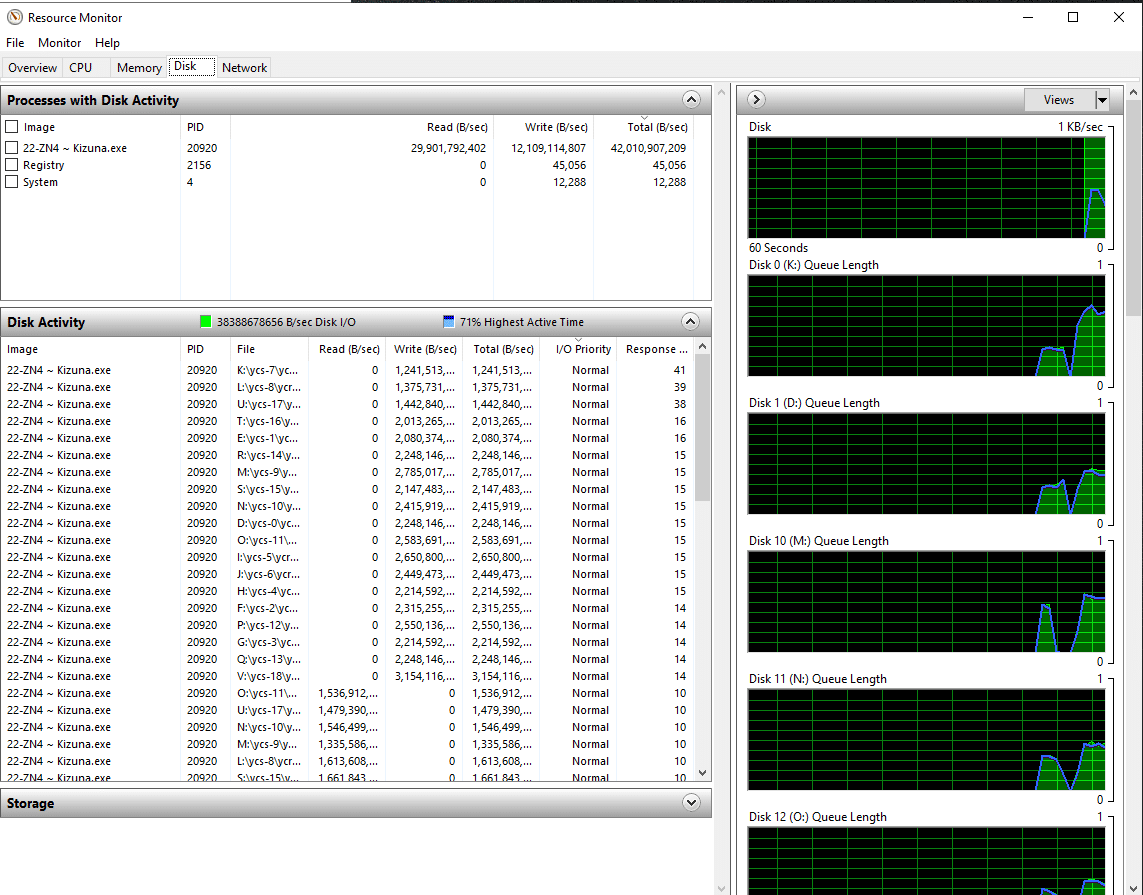
读取速度甚至更高。 在网络方面,您需要多个 400Gb 链路(冗余)来传输该数量的数据。 虽然并非不可能,但许多云环境并不是为该级别的带宽而构建的。 Oracle 的裸机密集 I/O 实例可能最接近这种原始速度规模,但仅限于 54.4 个 NVMe SSD 和 XNUMXTB 的总容量。
用于性能、耐用性和密度的 Solidigm QLC 闪存
为了便于进行如此重要的计算,我们需要尽可能快地找到空间,而且需要大量空间。 交换模式是 y-cruncher 中的一项功能,它允许使用磁盘执行计算,这是执行主内存无法容纳的大型计算所必需的。 并行使用多个驱动器对于获得更好的性能是必要的,并且为了进一步提高性能,可以使用固态驱动器 (SSD)。 但是,过去不推荐使用,因为对其写磨损的理论分析并不令人鼓舞。
使用 y-cruncher 的交换模式而不是依赖操作系统页面文件是必不可少的,因为 y-cruncher 中的内存访问模式不是直接磁盘友好的。 值得庆幸的是,y-cruncher 的交换模式旨在通过最小化磁盘寻道和使用顺序磁盘访问来克服此限制。 y-crunchers 交换模式用于具有 0 个驱动器的 RAID 19 配置,这使应用程序可以直接 IO 访问 NVMe 磁盘以获得最佳性能。
我们在测试中使用的 Solidigm P5316 SSD 采用 PCIe Gen4 接口,配备 144 层 QLC NAND 闪存。 它们提供卓越的性能,具有高达 7 GB/s 的顺序读取速度和高达 3.6 GB/s 的顺序写入速度。
QLC 固态硬盘因其在不影响存储容量和高效性能的情况下降低开支的能力而受到认可。 这使得 QLC SSD 技术有利于许多业务情况。 例如,VAST Data 将这些驱动器整合到他们的产品中,以消除硬盘驱动器的必要性。 同时,Pliops 采用带 QLC 驱动器的加速卡,以实现快速且经济高效的解决方案。
自 2021 年底以来,我们的实验室就已经有了这些驱动器,并对其进行了多次测试,但这是迄今为止最密集和最广泛的测试之一。 在我们使用的 19 个驱动器中,所有驱动器在计算开始时都处于 99-100% 的运行状况。
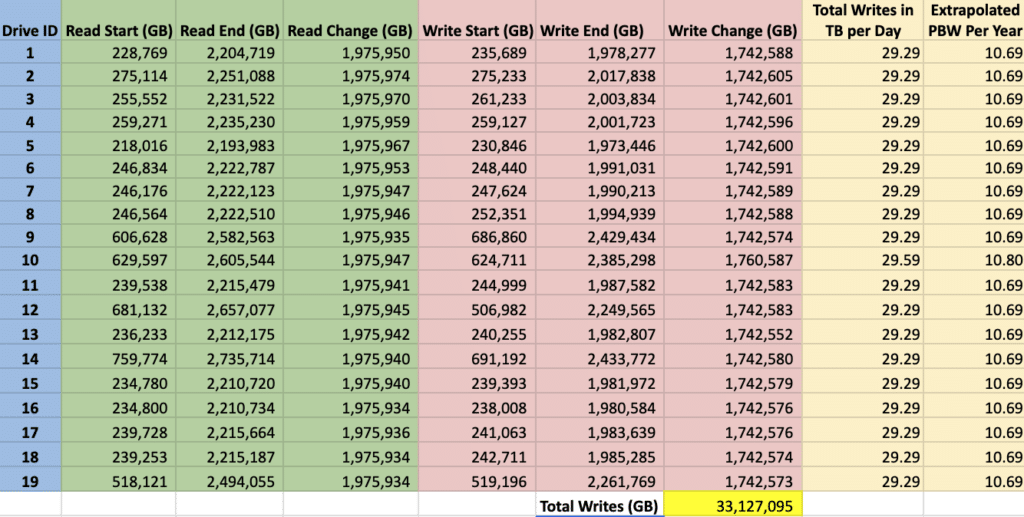
在此计算运行的 54.5 天中,我们总共向驱动器写入了 33,127,095 GB,或每个驱动器约 1,742,500 GB。 将其转换为我们运行期间的每日超量,即每个驱动器每天超过 29TB。
推断模拟的长期工作负载大约是每个驱动器每年写入 10.69PB 的数据。 Solidigm 列出了 P5316 的耐用性,随机工作负载为 22.9PBW,顺序工作负载为 104.6PBW。 由于 Pi 工作负载在其持续时间内保持爆发状态,而不会对闪存造成很大压力,因此它的行为非常连续,将工作负载推向了 Solidigm 耐久性范围的高端。
这意味着您可以让它们承受类似的工作量近十年,然后才会耗尽生命。 至少可以说令人印象深刻,考虑到这是 QLC NAND,并且驱动器保修期为五年。 任何担心磨损这些驱动器的人都可以使用此用例作为 QLC 已为企业准备就绪的另一个验证点。
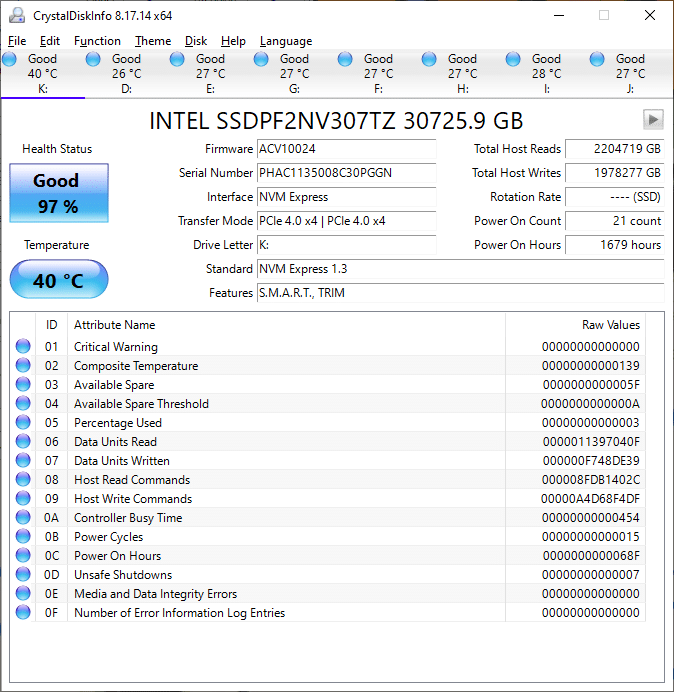
在 59.5 天的运行结束时,服务器中所有驱动器的健康状况报告为 97-98%。 我们几乎没有对这些驱动器的耐用性产生影响。
史诗般的 AMD EPYC CPU
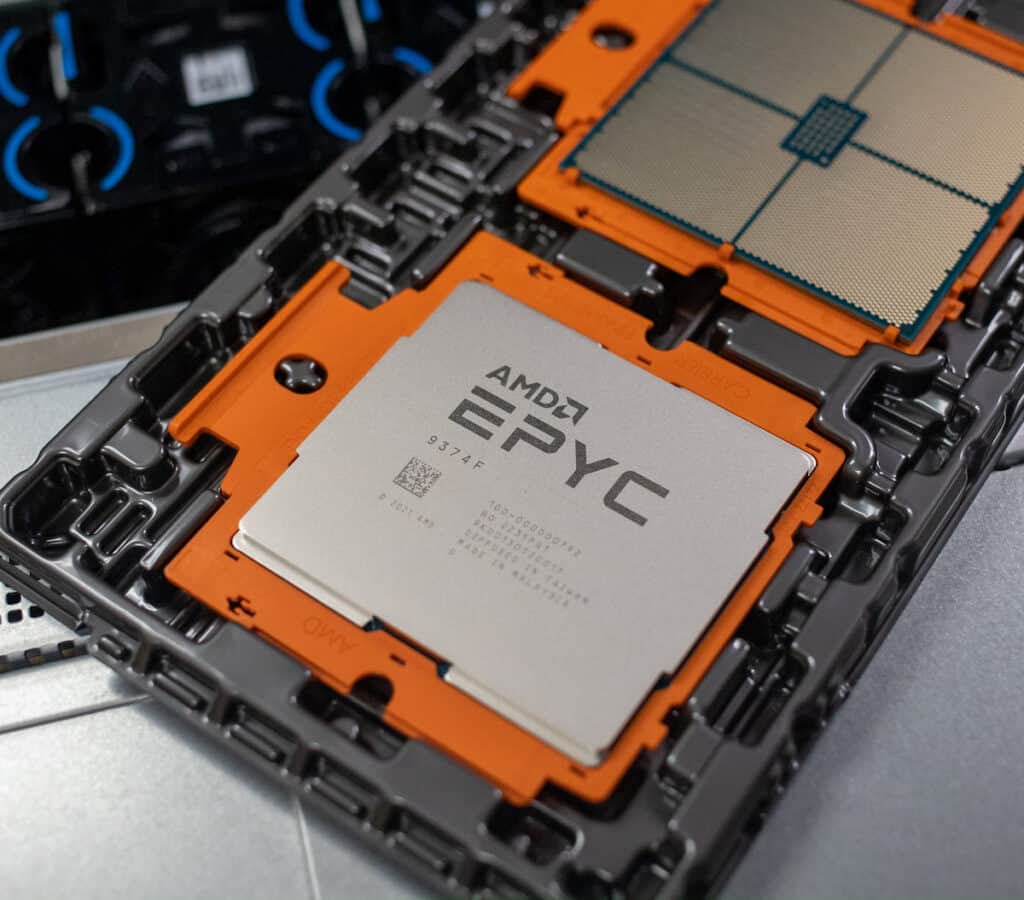
AMD EPYC(霄龙)第四代处理器基于 Zen 4 微架构和 4nm 工艺,是业界首款 5nm x5 数据中心处理器。 它们支持多达 86 个通道的 DDR12 内存、AVX-5 VNNI 和 BFloat512 指令,以增强 AI 和 ML 应用程序的性能。 它们的每核性能比英特尔的 Ice Lake 处理器高出 16%,是 AMD 上一代 EPYC Milan 处理器的两倍。
调整是这次运行的重要组成部分,因为我们已经通过更小的、以前保存的 Pi 计算记录(例如 1 亿和 10 亿)进行了广泛的测试和迭代。 通过对 BIOS 进行一些调整并使用 10 亿次运行时间作为指标,我们能够为该工作负载实现显着的性能改进。 与利用云资源相比,这给了我们显着的优势,因为我们可以对平台进行精细控制以针对我们的应用程序对其进行优化,而现成的云实例无法提供这种选择。
我们首先在 BIOS 中禁用 SMT,然后在较小的测试运行时间上取得了几个百分点的改进。 我们探索的下一个选项是 C 状态。 我们注意到,在运行 y-cruncher 时,CPU 往往会频繁地跳入和跳出低功耗 c 状态,因为它会逐步执行不同的进程。
BIOS 设置的调整,包括禁用 SMT 和控制 C 状态,结合对操作系统的一些性能调整,是提高此工作负载性能的关键因素。 非常感谢 y-Cruncher 的 Alexander Yee 和一位来自超频领域的朋友 Forks,感谢他们帮助指出 Windows 和 y-Cruncher 中的一些调整和设置,以帮助完成这次运行。
π; 100T 极速跑,100%。 怎么办?
好吧,伙计们,当我们结束这个 Pi-lgrimage 时,让我们花点时间沉浸在仅 100 天计算 Pi 的 54 万亿位数字的荣耀中! 多亏了 y-cruncher 程序、AMD EPYC(霄龙)第四代处理器的强大力量,以及快如闪电的 Solidigm P4 QLC SSD,我们见证了一项让您的计算器脸红的成就。
突破原始计算机能力和海量数据存储的界限,我们值得信赖的本地连接 QLC 闪存单元团队真正闪耀了光芒。 Solidigm P5316 SSD 具有出色的耐用性和性能,就像商业世界的超级英雄伙伴。 我们不要忘记我们的便携式发电站和强大的备用电池设备,确保我们的 Pi-rade 保持运转——即使大自然母亲试图为我们完美烘烤的庆祝活动下雨。
因此,当我们告别这场破纪录的 Pi 盛会时,让我们为未来数学和计算机科学世界的无限可能性干杯。 干杯!


 Amazon