

几乎一周过去了,我们没有从 IT 供应商那里听到他们的解决方案对涉及人工智能、深度学习、机器学习或边缘智能的组织的影响。 然而,问题是缺乏关于这些解决方案如何影响每项任务的性能的实质性见解。 最近,我们决定通过与位于波兰的 AI 和 HPC 解决方案构建商 byteLAKE 合作,看看我们是否可以为此做点什么。 主要目标是评估存储和 GPU 对 AI 工作负载的影响。
存储对人工智能的影响
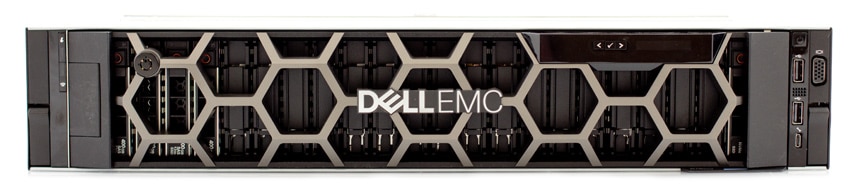
最初,我们想验证一个普遍的观点:本地存储会影响 AI 模型的性能。我们在实验室里使用了一台Dell EMC PowerEdge R740xd服务器,配置了两颗 Intel Xeon Gold 6130 CPU 和 256GB 内存。我们使用三种不同的本地存储方案运行了 byteLAKE AI 测试。测试中,我们使用了传统的KIOXIA PX04S SSD,以及速度更快的Samsung 983 ZET和Intel Optane 900P。
在基准测试中,我们分析了人工智能学习过程的性能。测试中,我们针对真实场景运行学习过程。本次测试是byteLAKE产品之一——EWA Guard的训练流程的一部分。该产品基于最新的YOLO(You Only Look Once)模型,YOLO是一款先进的实时检测模型。该模型包含一个输入层、22个卷积层、5个池化层、2个路由层、一个重组层和一个检测层。
作为性能的基本指标,我们使用了 5000 个 epoch 的训练执行时间。 对每个存储配置重复基准测试 XNUMX 次,平均值如下所示。
结果:
- 铠侠 98h 24m
- 三星 98 小时 44 小时
- 英特尔 98h 42
数据清楚地表明,本地存储对性能没有影响。 测试范围从 SATA SSD 到最新最好的 Optane,没有任何影响。 也就是说,在数据进出方面,存储可能发挥更重要的作用,但对于 AI 的计算而言,在这种情况下没有影响。
GPU 和存储对 AI 的影响
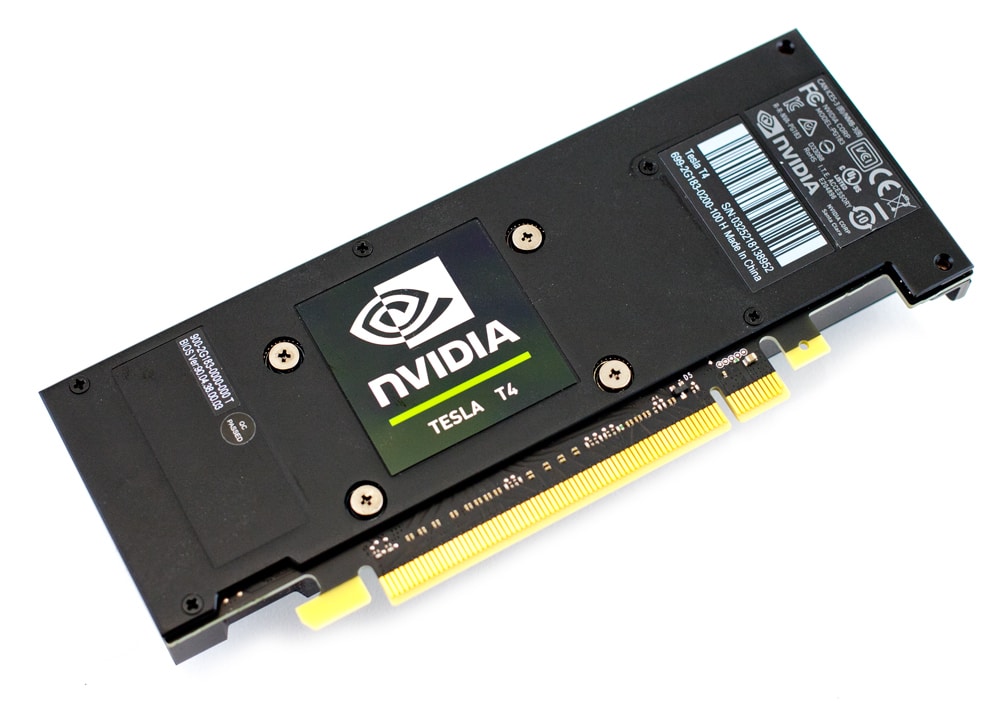
有了存储数据,我们将单个 NVIDIA T4 添加到 PowerEdge 以衡量 GPU 对 AI 的影响。 对于此测试,我们也运行了相同的三种存储配置。
结果:
- 铠侠 4 小时 30
- 三星 4 小时 28 米
- 英特尔 4 小时 27 分钟
正如预期的那样,GPU 产生了影响,实际上是指数级的影响,推动了 22 倍的改进。 随着 GPU 加速 AI 的整体性能,有人认为更快的存储可能会产生影响。 然而,情况并非如此,因为 SATA 驱动器正好符合高速 NVMe。
结论
在此测试中,我们发现使用更快的存储设备不会提高学习性能。 这里的主要原因是 AI 模型的复杂结构。 学习的时间要长于数据读取的时间。 换句话说,使用当前一批图像进行学习的时间比阅读下一批图像所需的时间要长。 因此,存储操作隐藏在 AI 计算之后。
在添加 NVIDIA T4 时,有人认为人工智能的更快处理会导致存储对性能产生影响。 在本次测试中情况并非如此,因为即使使用 T4,AI 模型仍然具有更重的学习组件并且不需要特别快速的存储。
虽然需要做更多的工作来进一步测试特定组件和系统对 AI 的影响,但我们相信这些初始数据是有用的,并且是对话的良好起点。 我们需要应用程序数据,以便能够从 IT 的角度更好地了解哪里是正确的杠杆,以及哪里的预算支出可以产生最有影响力的结果。 当然,这在很大程度上也取决于此活动发生的位置,无论是在数据中心还是边缘。 现在,我们欢迎 byteLAKE 和其他处于 AI 矛尖的人的参与,以帮助提供有用的数据来帮助回答这些紧迫的问题。
这是我们首次进行人工智能测试,但绝不会是最后一次。byteLAKE 联合创始人 Mariusz Kolanko 表示,他们一直在开发一款名为CFD Suite(用于计算流体动力学 (CFD) 的人工智能,旨在加速求解器)的产品,该产品中的深度学习过程需要大量数据才能完成每个训练周期。事实上,这种模型可能会对大数据领域的模型训练造成更高的存储负载,并可能影响深度学习过程本身的性能。归根结底,与任何应用程序一样,了解应用程序的需求并分配合适的数据中心资源至关重要。人工智能显然并非万能的解决方案。



 Amazon