

2026年11月13日更新:戴爾Pro Precision 9 T4 榮獲「最佳本地AI至強塔式伺服器」稱號;塔式伺服器部分現已按主機平台分組;「我們的排名方法」部分新增了在Linux系統下使用llama.cpp測試套件進行測試的塔式伺服器。 10月24日,Mac Studio的評測結果已更新,涵蓋了蘋果公司9月開始發售的M5 Max和M5 Ultra機型。
本頁排名的所有系統均經過 StorageReview 實驗室的測試。我們直接對本地 AI 效能進行基準測試:vLLM 線上服務吞吐量、首次令牌獲取時間以及每個輸出令牌的運算時間,測試模型包括 GPT-OSS-120B、Llama 3.1 8B、Mistral Small 3.1 24B 和 Qwen3 Coder 30B,此外還包括 MAMF 計算測試效率和 GDS 計算測試效率。所有系統排名均非基於規格表。
2026 年本地 AI 桌面系統的關鍵問題在於統一記憶體與獨立顯存的選擇。 NVIDIA 基於 GB10 的 DGX Spark 和 AMD 的 Ryzen AI Max(Strix Halo)等桌上型設備,以設備的價格,將 128GB 的統一記憶體整合到單一晶片後,即可支援原本需要多個獨立 GPU 才能實現的型號。
工作站塔式機憑藉其強大的吞吐量脫穎而出:RTX PRO 6000 Blackwell 系列顯示卡每秒可處理更高的令牌數,但成本和功耗也高出數倍。本頁面使用同一套測試套件,將兩者分別進行分級排名,因為最終選擇取決於您計劃運行的最大型號以及您所需的響應速度。
一覽
| 項目類別 | 系統 | 記憶體應用 | GPU(測試/最高) | 全部評論 |
|---|---|---|---|---|
| 最佳桌面人工智慧系統 | NVIDIA DGX Spark | 128GB 統一 LPDDR5X | GB10整合(固定) | DGX Spark 評測 |
| 最佳 GB10 實現 | 宏碁 Veriton GN100 | 128GB 統一 LPDDR5X | GB10整合(固定) | Veriton GN100 評測 |
| 最佳 x86 替代方案 | AMD 銳龍 AI Halo(Strix Halo) | 最高支援 128GB 統一 LPDDR5X 內存 | Radeon 8060S 整合顯示卡(固定) | Ryzen AI Halo 評測 |
| 最好不要使用獨立顯示卡 | HP Z2 Mini G1a | 統一LPDDR5X(運行GPT-OSS 120B) | 整合式顯示卡,無獨立顯示卡(已修復) | Z2 Mini G1a 評測 |
| 最佳GB300系統 | MSI XpertStation WS300(替代產品:ASUS ET900N G3) | 748GB 一致性(252GB HBM3e + 496GB LPDDR5X) | GB300整合(固定) | XpertStation WS300 評測 |
| 本地人工智慧的最佳塔 | 戴爾Precision 7875 | 192GB GDDR7 (2× 96GB) | 2× RTX PRO 6000 / 2 最大 | Precision 7875 評測 |
| 最適合本地人工智慧的至強塔式處理器 | 戴爾專業版 Precision 9 T4 | 192GB GDDR7 (2× 96GB) | 2× RTX PRO 6000 Max-Q / 2 最大 | Pro Precision 9 T4 評測 |
| 最佳多GPU平台 | HP Z8 Fury G6i | 經測試,最大支援 192GB GDDR7 記憶體 / 最高可達 384GB | 已測試 2 塊 RTX PRO 6000 / 最多 4 塊 | Z8 Fury G6i 評測 |
| 極致之選 | Comino Grando RTX PRO 6000 | 768GB GDDR7 (8× 96GB) | 8× RTX PRO 6000 / 8 最大 | 科米諾格蘭多評論 |
桌面人工智慧設備
戴爾稱之為桌上型AI、英偉達稱之為個人AI超級電腦的設備層級,以犧牲峰值吞吐量為代價,換取更高的模型容量、能效和價格。這些系統配備128GB統一內存,能夠輕鬆運行高量化的70B級模型,甚至可以擴展到120B級,而這些工作負載通常需要在塔式電腦上配備多個獨立GPU才能完成。
本級必備實驗室閱讀資料:我們的DGX Spark 熱測試比較了以下 GB10 系統中的 OEM 散熱設計,該測試適用於此類中的所有設備,直到這些平台進行修訂為止。
最佳桌上型AI系統:NVIDIA DGX Spark
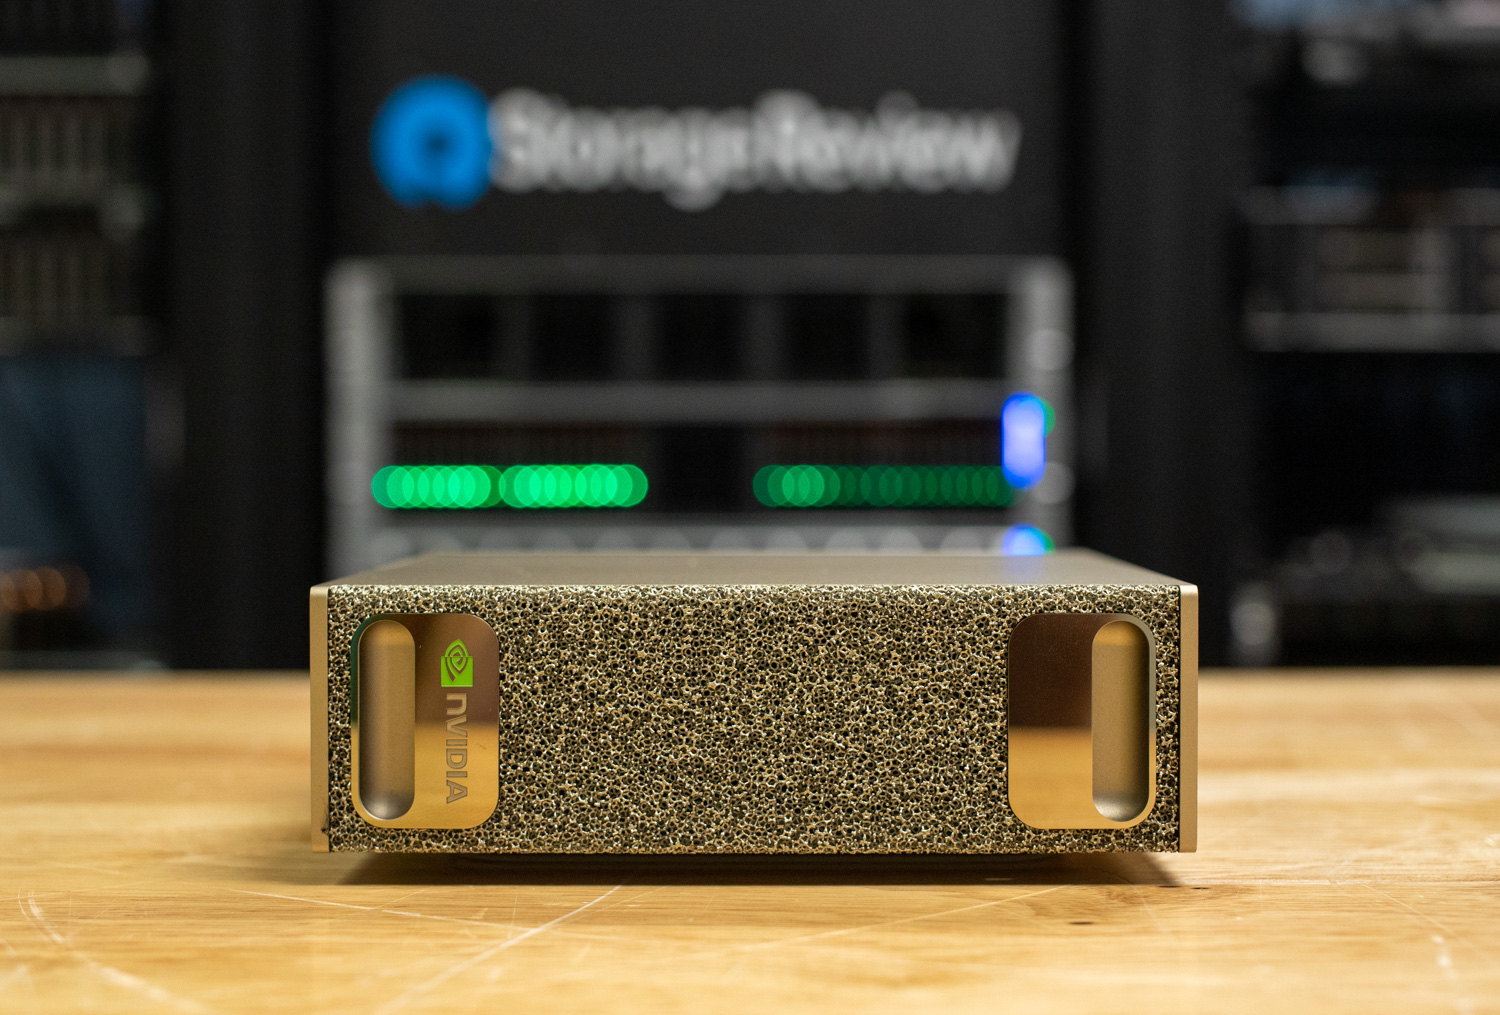
DGX Spark 是衡量其他所有桌面級 AI 設備的標竿。它搭載GB10 Grace Blackwell 超級晶片,配備 20 核心 Arm CPU 和 128GB 統一 LPDDR5X 內存,以及雙 ConnectX-7 200GbE 端口,是我們測試過的唯一一款開箱即用即可集群的設備:我們的雙節點分佈式推理測試在 Dell、GIGABY 和 HP 的工作節點上通過水行負載流水線負載。
如今,叢集儲存方案有了更經濟實惠的切入點:NVIDIA於 10 月 23 日發布了 64GB 的 DGX Spark SKU,售價 4,999 美元,透過相同的六家 OEM 廠商銷售。兩塊 DGX Spark 可以透過 200GbE 網路線連接,組成 128GB 的儲存池;NVIDIA 聲稱,在 Qwen3.8 27B 測試中,叢集儲存的效能可達單區塊 128GB 儲存的 1.7 倍,但我們尚未對此進行測試。其 CUDA 軟體堆疊仍然是同類產品中最強大的。
此平台的唯一硬性限制是儲存:每個 GB10 系統在單一短 M.2 插槽上的容量上限約為 4TB。我們採用八台 Spark 共享儲存方案來解決這個問題:一個受控的 QLC 陣列透過每台 Spark 系統自帶的 100GbE 連接埠提供服務,其中單一客戶端的讀取速度為 10.8GiB/s,與我們在 GB10 系統中測得的最快內部 M.2 固態硬碟速度相當多;固態硬碟的負載速度相差不到 13%。
最佳 GB10 實現方案:宏碁 Veriton GN100
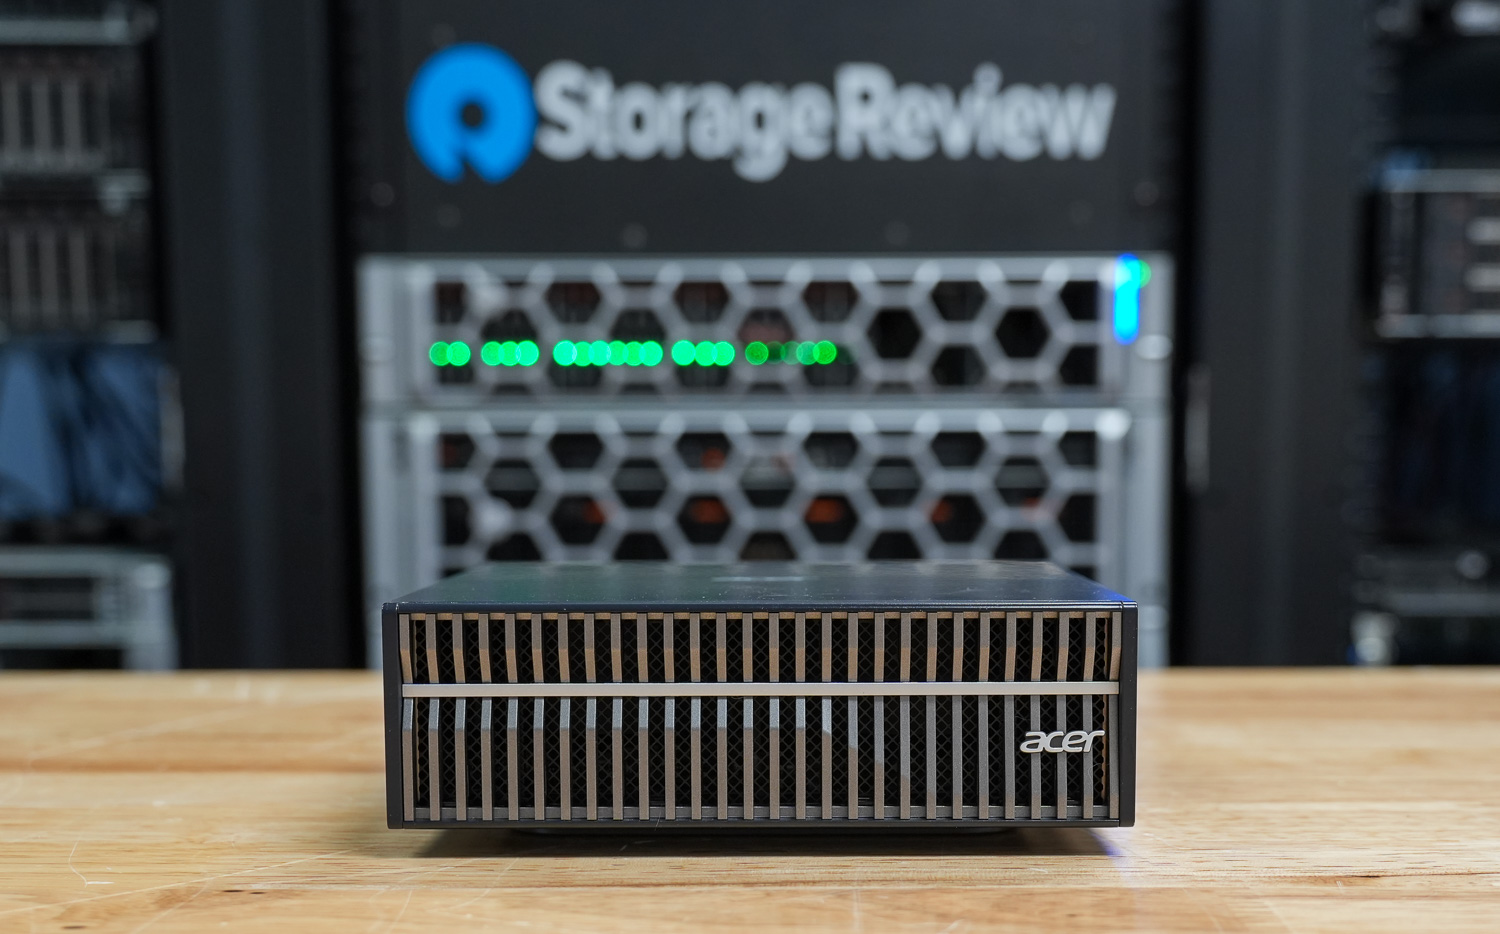
在GB10 OEM系統中,散熱設計是真正的區別所在,而Veriton GN100在我們的測試中脫穎而出。所有GB10主機都採用相同的晶片和記憶體配置,因此持續效能取決於散熱。據我們所知,我們這次對多廠商主機散熱性能的比較測試是目前唯一公開發表的此類研究。
最佳 x86 替代方案:AMD Ryzen AI Halo
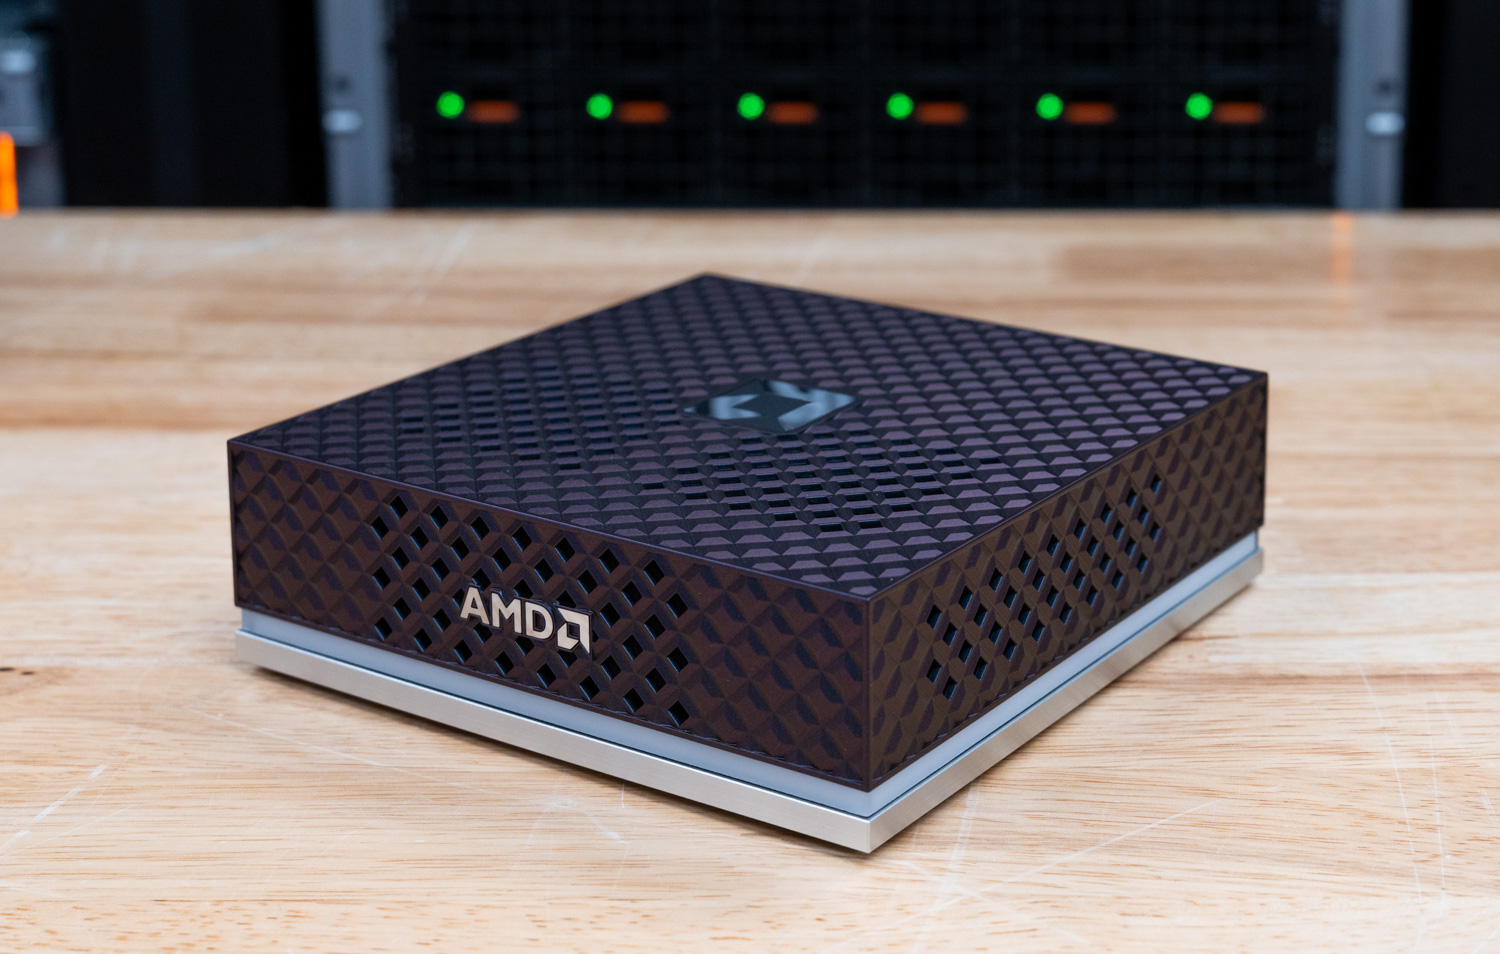
如果您需要 Windows 或標準的 x86 軟體堆疊,Strix Halo 是桌面解決方案。 AMD的 Ryzen AI Max+ 395 平台配備 128GB 統一記憶體和雙作業系統配置,在我們的測試中,它能夠處理 200 億參數等級的模型,直接挑戰 DGX Spark,而無需依賴 Arm/DGX 作業系統。
最佳無獨立顯示卡機種:HP Z2 Mini G1a
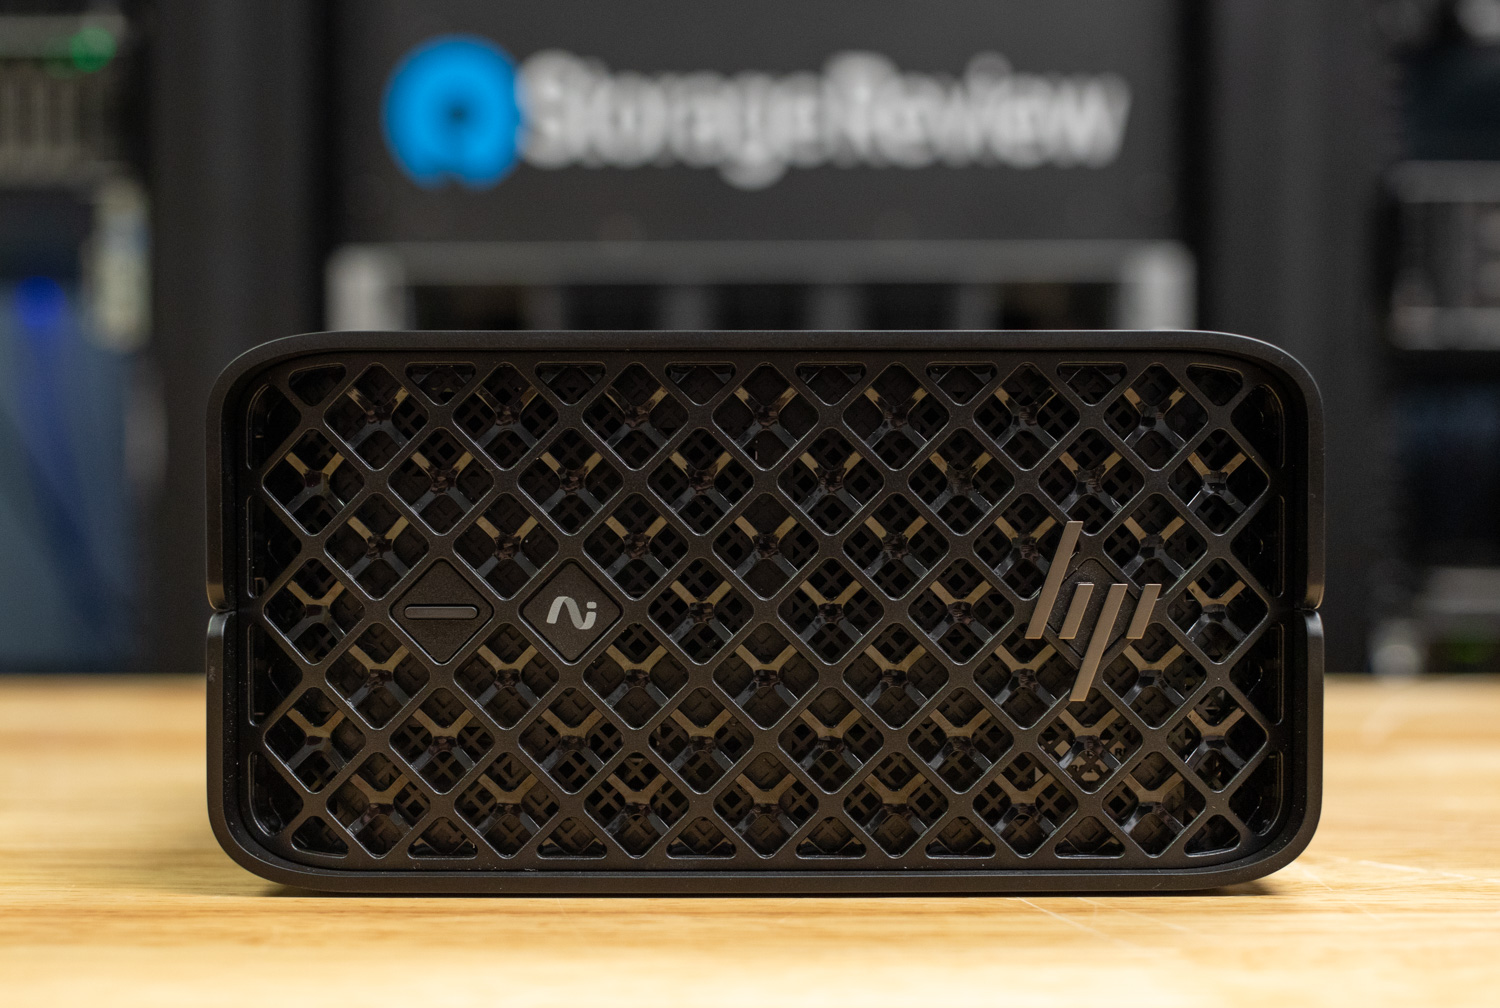
Z2 Mini G1a 運作的是 GPT-OSS 120B 分區表,完全沒有配備獨立顯示卡。惠普的這款迷你工作站將 AMD 的 Ryzen AI Max+ PRO 處理器裝入緊湊、靜音且對 IT 人員友好的機箱中,它仍然是統一內存 x86 系統如何改變小型辦公電腦性能的最有力證明。
最佳 GB300 系統:MSI XpertStation WS300
WS300 是我們實驗室測試的首台 GB300 DGX 工作站,它重新定義了設備級硬體的效能上限。 Grace Blackwell Ultra 超級晶片擁有 748GB 的一致性內存,包括 252GB 的 HBM3e 和 496GB 的 LPDDR5X,支援 20 petaFLOPS 的 FP4 運算能力。在我們的測試中,它運行了一個 433GB 的 GLM-5.2 檢查點,其中 216GB 的專家權重儲存在 Grace 記憶體中。這樣的配置顯然不適合放在辦公桌旁使用。與所有 DGX 系列系統一樣,它運行的是 DGX 作業系統而非 Windows;如此龐大的記憶體容量需要相應的系統支援。
就價格和功耗而言,它更接近塔式機殼的高階產品,而非上一代GB10系列,但目前市面上還沒有其他同類產品能與之匹敵。一個顯而易見的問題——1,300W的功率在塔式機箱中是否會導致部分頻率降低——現在有了確切的答案:我們對WS300進行了深入的散熱測試,在2.8小時的持續運行中,Blackwell Ultra核心的溫度保持在60℃,主頻穩定在2.07GHz,沒有出現任何溫度,並且在滿載熱量下還留熱的情況下還留出熱量。
GB300 的替代選擇:華碩 ExpertCenter Pro ET900N G3 是我們測試過的第二款 GB300 DGX 工作站,它再次印證了該平台的卓越性能:在 14 款機型和兩種工作負載下,28 項峰值吞吐量對比中有 24 項與 WS300 項與 WS300 的相干WS300。華碩為這款 27 公斤重的機殼增加了提手,在 400G 光碟機上方配備了專用風扇,並採用了 80 PLUS 鈦金認證電源。兩款機殼皆能提供相同的平台效能;請閱讀我們的ET900N G3 評測,以了解兩款機殼的比較詳情。
叢集擴展:現在對兩座塔式伺服器透過各自的 400G 連接埠連接在一起的情況進行了測量,而不是承諾:我們的GB300 叢集測試將 ASUS 和 HP Station 與兩個 DAC 配對,在 NCCL 集體測試中達到了 98% 的線路速率,並將 GLM-5.2(一個 433 Grace 的記憶體類型, 32 個流的每秒 139 個輸出令牌增加到 1,525 個,並最終在 256 個流的情況下達到 3,141 個。
適合單一工作站的模型規模有所不同:預填/解碼分解使 GLM-5.3 Flash 短提示吞吐量增加了兩倍,而 DeepSeek V4.1 Flash 每秒輸出 5,248 個令牌,是該系列中最高的輸出。
實驗室:HP ZGX Fury AI工作站
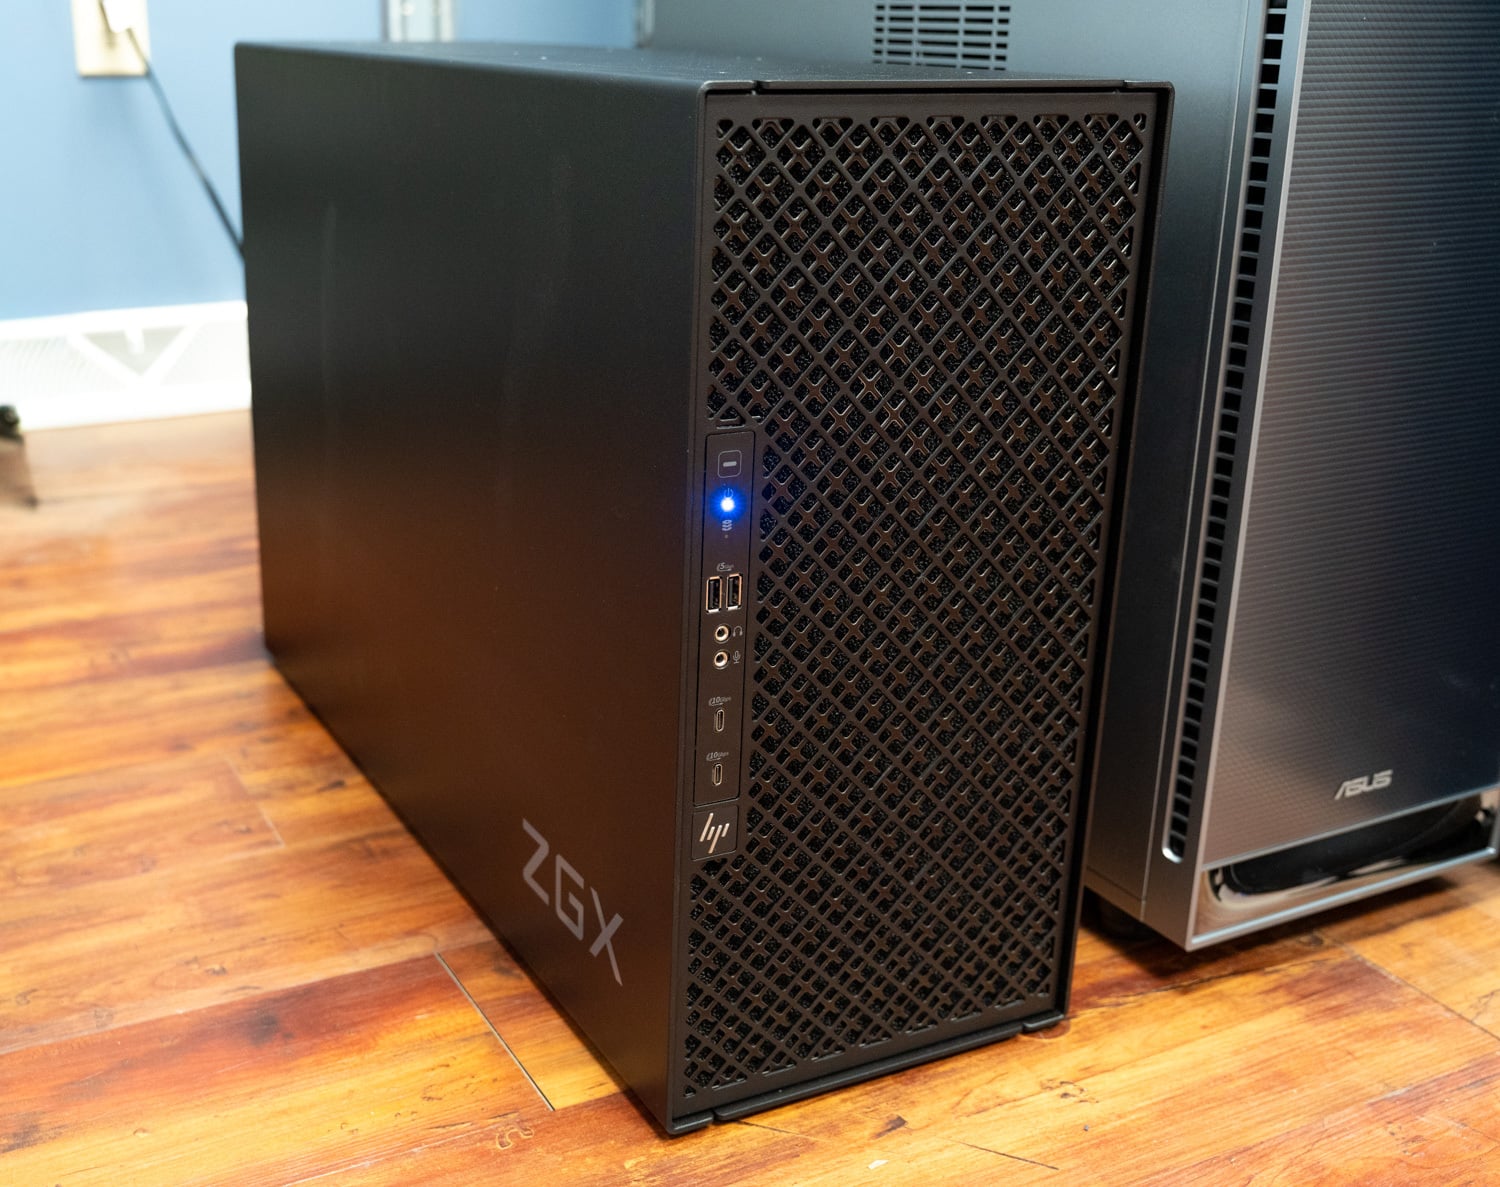
惠普的 ZGX Fury AI Station 現在已在我們的實驗室中。它與上文提到的 MSI XpertStation WS300 一樣,都基於 NVIDIA GB300 Grace Blackwell Ultra 平台,這使得我們有機會首次在同一測試平台上比較兩家廠商對 DGX Station 架構的不同實現方式:散熱、噪音、持續運行頻率以及實際使用體驗。
它的首批公開測試資料已經出爐:在我們的雙站GB300叢集測試中, ZGX Fury作為第二台伺服器,負責執行GLM-5.3 Flash解耦配置的解碼任務,以及所有張量並行測試的一半任務。目前,針對ZGX Fury的單獨評測正在進行中,待其自身測試資料出爐後,我們將對其進行排名。
ZGX Fury 是微軟首批以DGX Station for Windows命名的兩款系統之一,另一款是搭載 GB300 顯示卡的戴爾 Pro Precision。 NVIDIA 已將 Windows 版本列入第四季上市計畫。該硬體與我們在 Ubuntu 系統上測試過的 GB300 塔式機相同,但該版本的伺服器堆疊是直接運行在 Windows 系統上還是在 WSL 環境下運行,目前尚無定論。
即將面世:AMD Threadripper Halo Station
AMD 的 Threadripper Halo Station 將於 2026 年 IFA 展會上發布,目前尚未進入任何實驗室測試。它是針對 NVIDIA GB300 系列顯示卡的首款直接解決方案。 ?也表示未來可擴充至四張加速卡和 576GB HBM 記憶體。整個系統採用液冷散熱,而這款 x86 主機避免了我們在 WS300 評測中提到的 Arm 工具鏈相容性問題。
目前尚不清楚這些型號在 PCIe 連接顯示卡和 NVLink-C2C 連接方面的表現如何,AMD 尚未公佈任何基準測試、定價或上市信息,因此目前只能作為觀察對象,而非推薦產品。更多詳情請參閱我們的發布報告;只有在硬體到貨實驗室後,我們才會將其納入排名。
同時測試的產品:桌面人工智慧設備
這些系統都經過了相同的實驗室流程,是可靠的選擇,但沒有佔據類別位置:戴爾 Pro Max with GB10、華碩 Ascent GX10、技嘉 AI TOP ATOM、惠普 ZGX Nano G1n和惠普 EliteDesk 8 Mini G1a。
用於本地人工智慧的工作站塔
當回應時間比購置成本更重要時(例如互動式編碼助理、多用戶服務、具有長工具呼叫鏈的代理管線),獨立顯存仍是最佳選擇。本文根據推理吞吐量和記憶體上限對這些桌上型電腦進行排名,並列出我們測試的GPU配置以及機箱最大容量,因為機箱的最終容量與我們測試的配置同樣重要;桌上型電腦需要配備兩個或更多GPU才能在此部分排名。單GPU桌上型電腦,包括配備96GB RTX PRO 6000的機型,在我們的Windows客戶端套件的「最佳桌面工作站」頁面上進行排名,因為它們回答的是不同的問題。
我們也按主機平台對塔式伺服器進行分組,因為顯示卡背後的CPU和記憶體決定了塔式伺服器如何處理超出GPU記憶體範圍的模型、向量搜尋以及通常與機器共享的模擬工作。 Precision 7875領銜Threadripper陣營,是塔式伺服器的首選;Pro Precision 9 T4領先Xeon陣營;而Core Ultra陣營則在我們實驗室測試雙GPU Core Ultra塔式伺服器時才會出現。
最適合本地AI的塔式機:戴爾Precision 7875
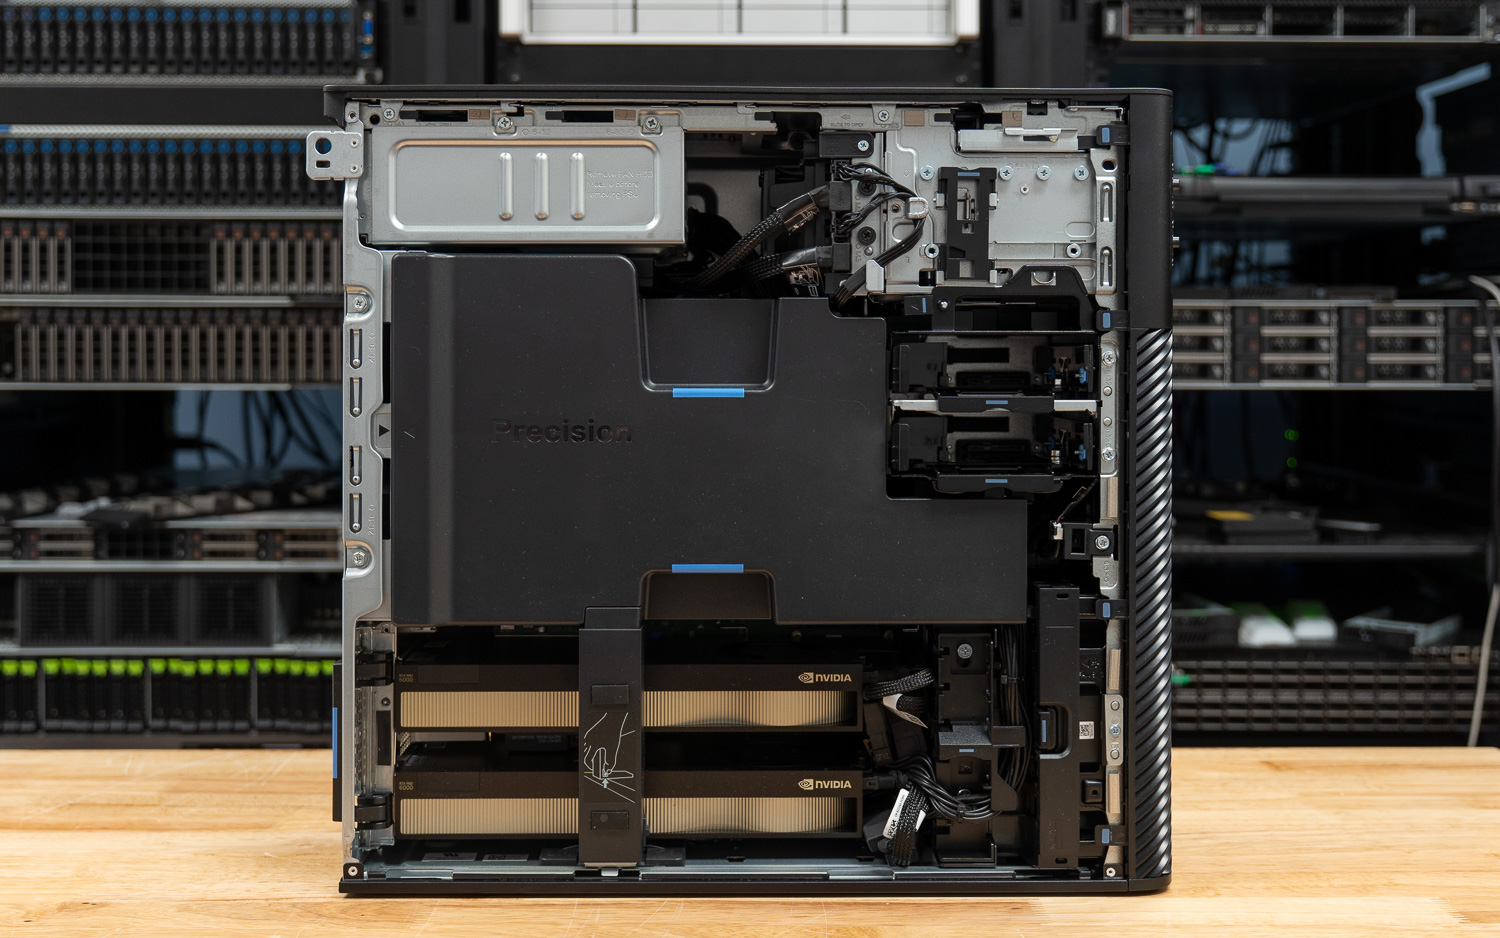
Precision 7875 搭載兩塊 RTX PRO 6000 Blackwell GPU,是我們測試過的速度最快的標準尺寸本地推理系統。它配備 Threadripper PRO 9995WX 處理器,兩塊顯示卡共 192GB 顯存,能夠將 100B 級模型完全加載到 GPU 內存中,並提供交互式級別的首令牌響應時間,這是任何統一內存設備都無法企及的。不過,要注意的是,7875 機箱最多支援兩塊雙寬顯示卡,因此我們測試的雙 GPU 配置已經是極限配置,無法再增加第三塊顯示卡。
最適合本地AI的Xeon塔式機:戴爾Pro Precision 9 T4
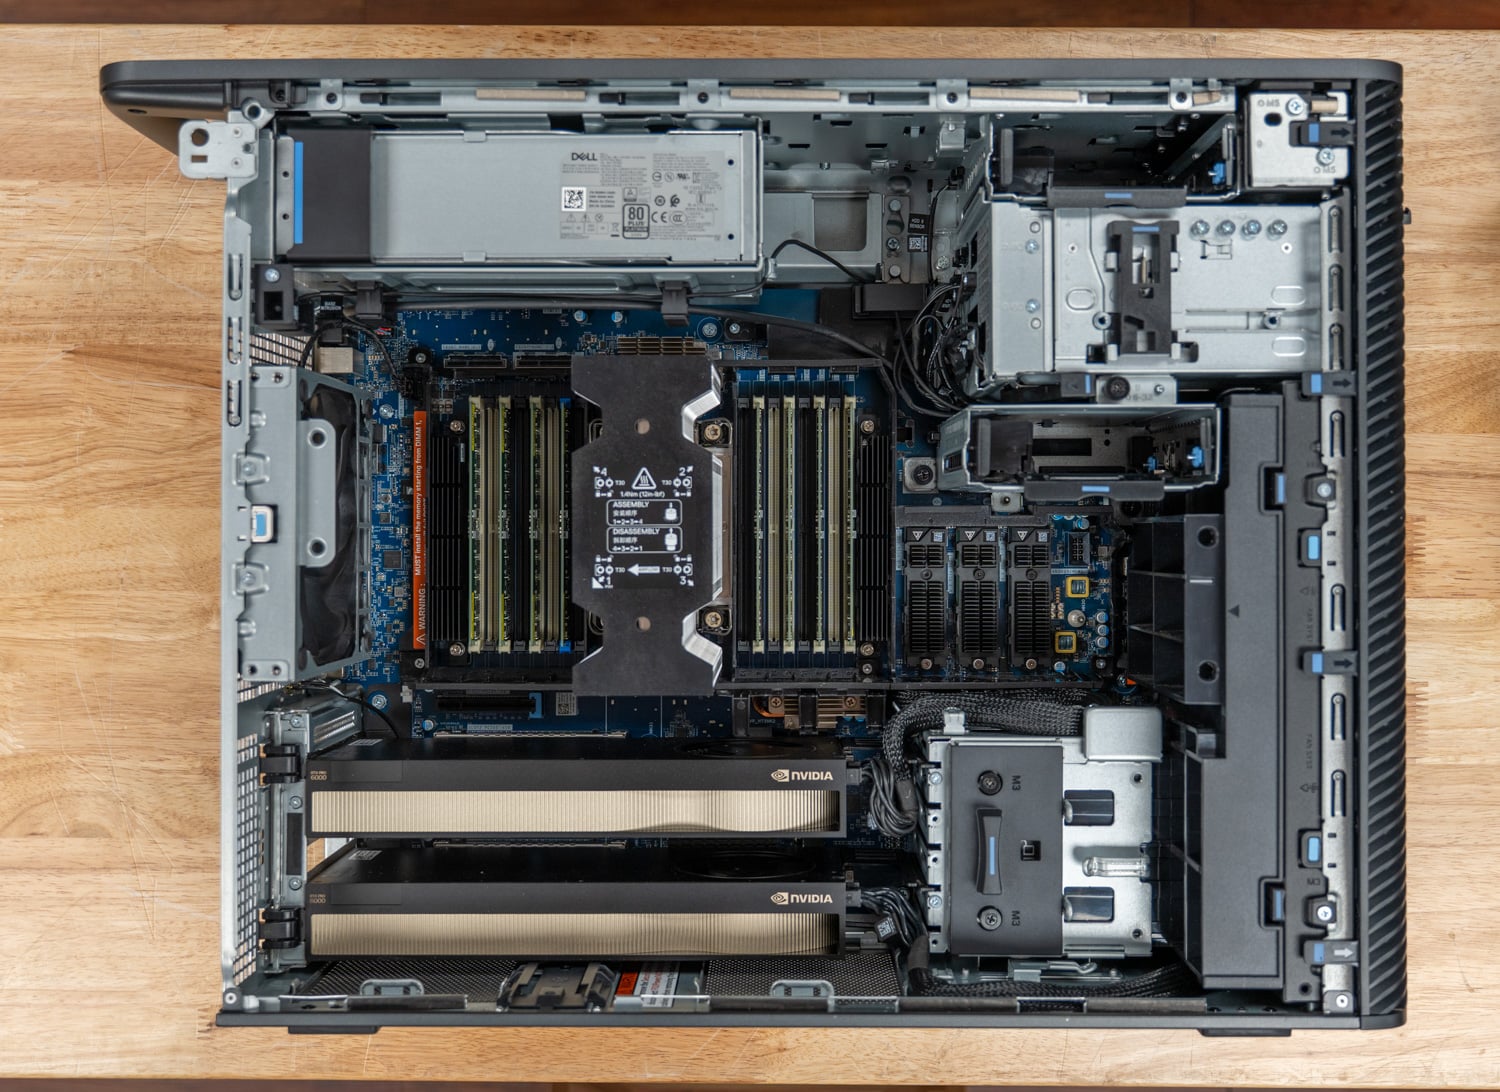
Pro Precision 9 T4 在 GPU 方面與 Precision 7875 不相上下,但在 Xeon 處理器支援的所有方面都更勝一籌。其兩張 RTX PRO 6000 Max-Q 顯示卡在單 GPU 模式下的效能與 7875 的同款顯示卡相差不到 1% 到 9%,在雙 GPU 模式下進行微調後,效能差距也小於 10%。 MiniMax M2.7 記憶體容量高達 129.3GB(單張顯示卡容量不足以滿足需求),兩張顯示卡共享的測試結果顯示,其單用戶每秒可產生 83.7 個令牌,而 7875 則為 85.0 個令牌。
差異在於主機:八通道 DDR5-6400 記憶體為 86 核心 Xeon 698X 處理器提供了 328GB/s 的記憶體頻寬,比 7875 高出 53%,這在模型運行中得到了充分體現。 HNSW 向量搜尋的運行速度是 7875 的 1.51 倍,索引建置時間從 34.8 秒縮短至 27.3 秒,OpenFOAM drivAer 求解時間從 556 秒縮短至 293 秒。其 Gen5 啟動盤冷啟動 gpt-oss:120b 也只需 15.2 秒,而 7875 則需要 25.8 秒。
7875 仍然是最佳選擇,因為它在所有 GPU 密集型吞吐量測試中都勝過 T4,而且其 Threadripper 處理器在核心密集型渲染和編譯任務中速度提升了 18% 到 38%。 T4 是一款塔式伺服器,專為需要在一台機器上同時運行模型、模擬和分析的團隊而設計,戴爾的配置器將其顯示卡配置上限設為兩張 RTX PRO 6000 系列顯示卡。在評測時,其在戴爾官網上的配置價格約為 66,600 美元。
最佳多GPU平台:HP Z8 Fury G6i
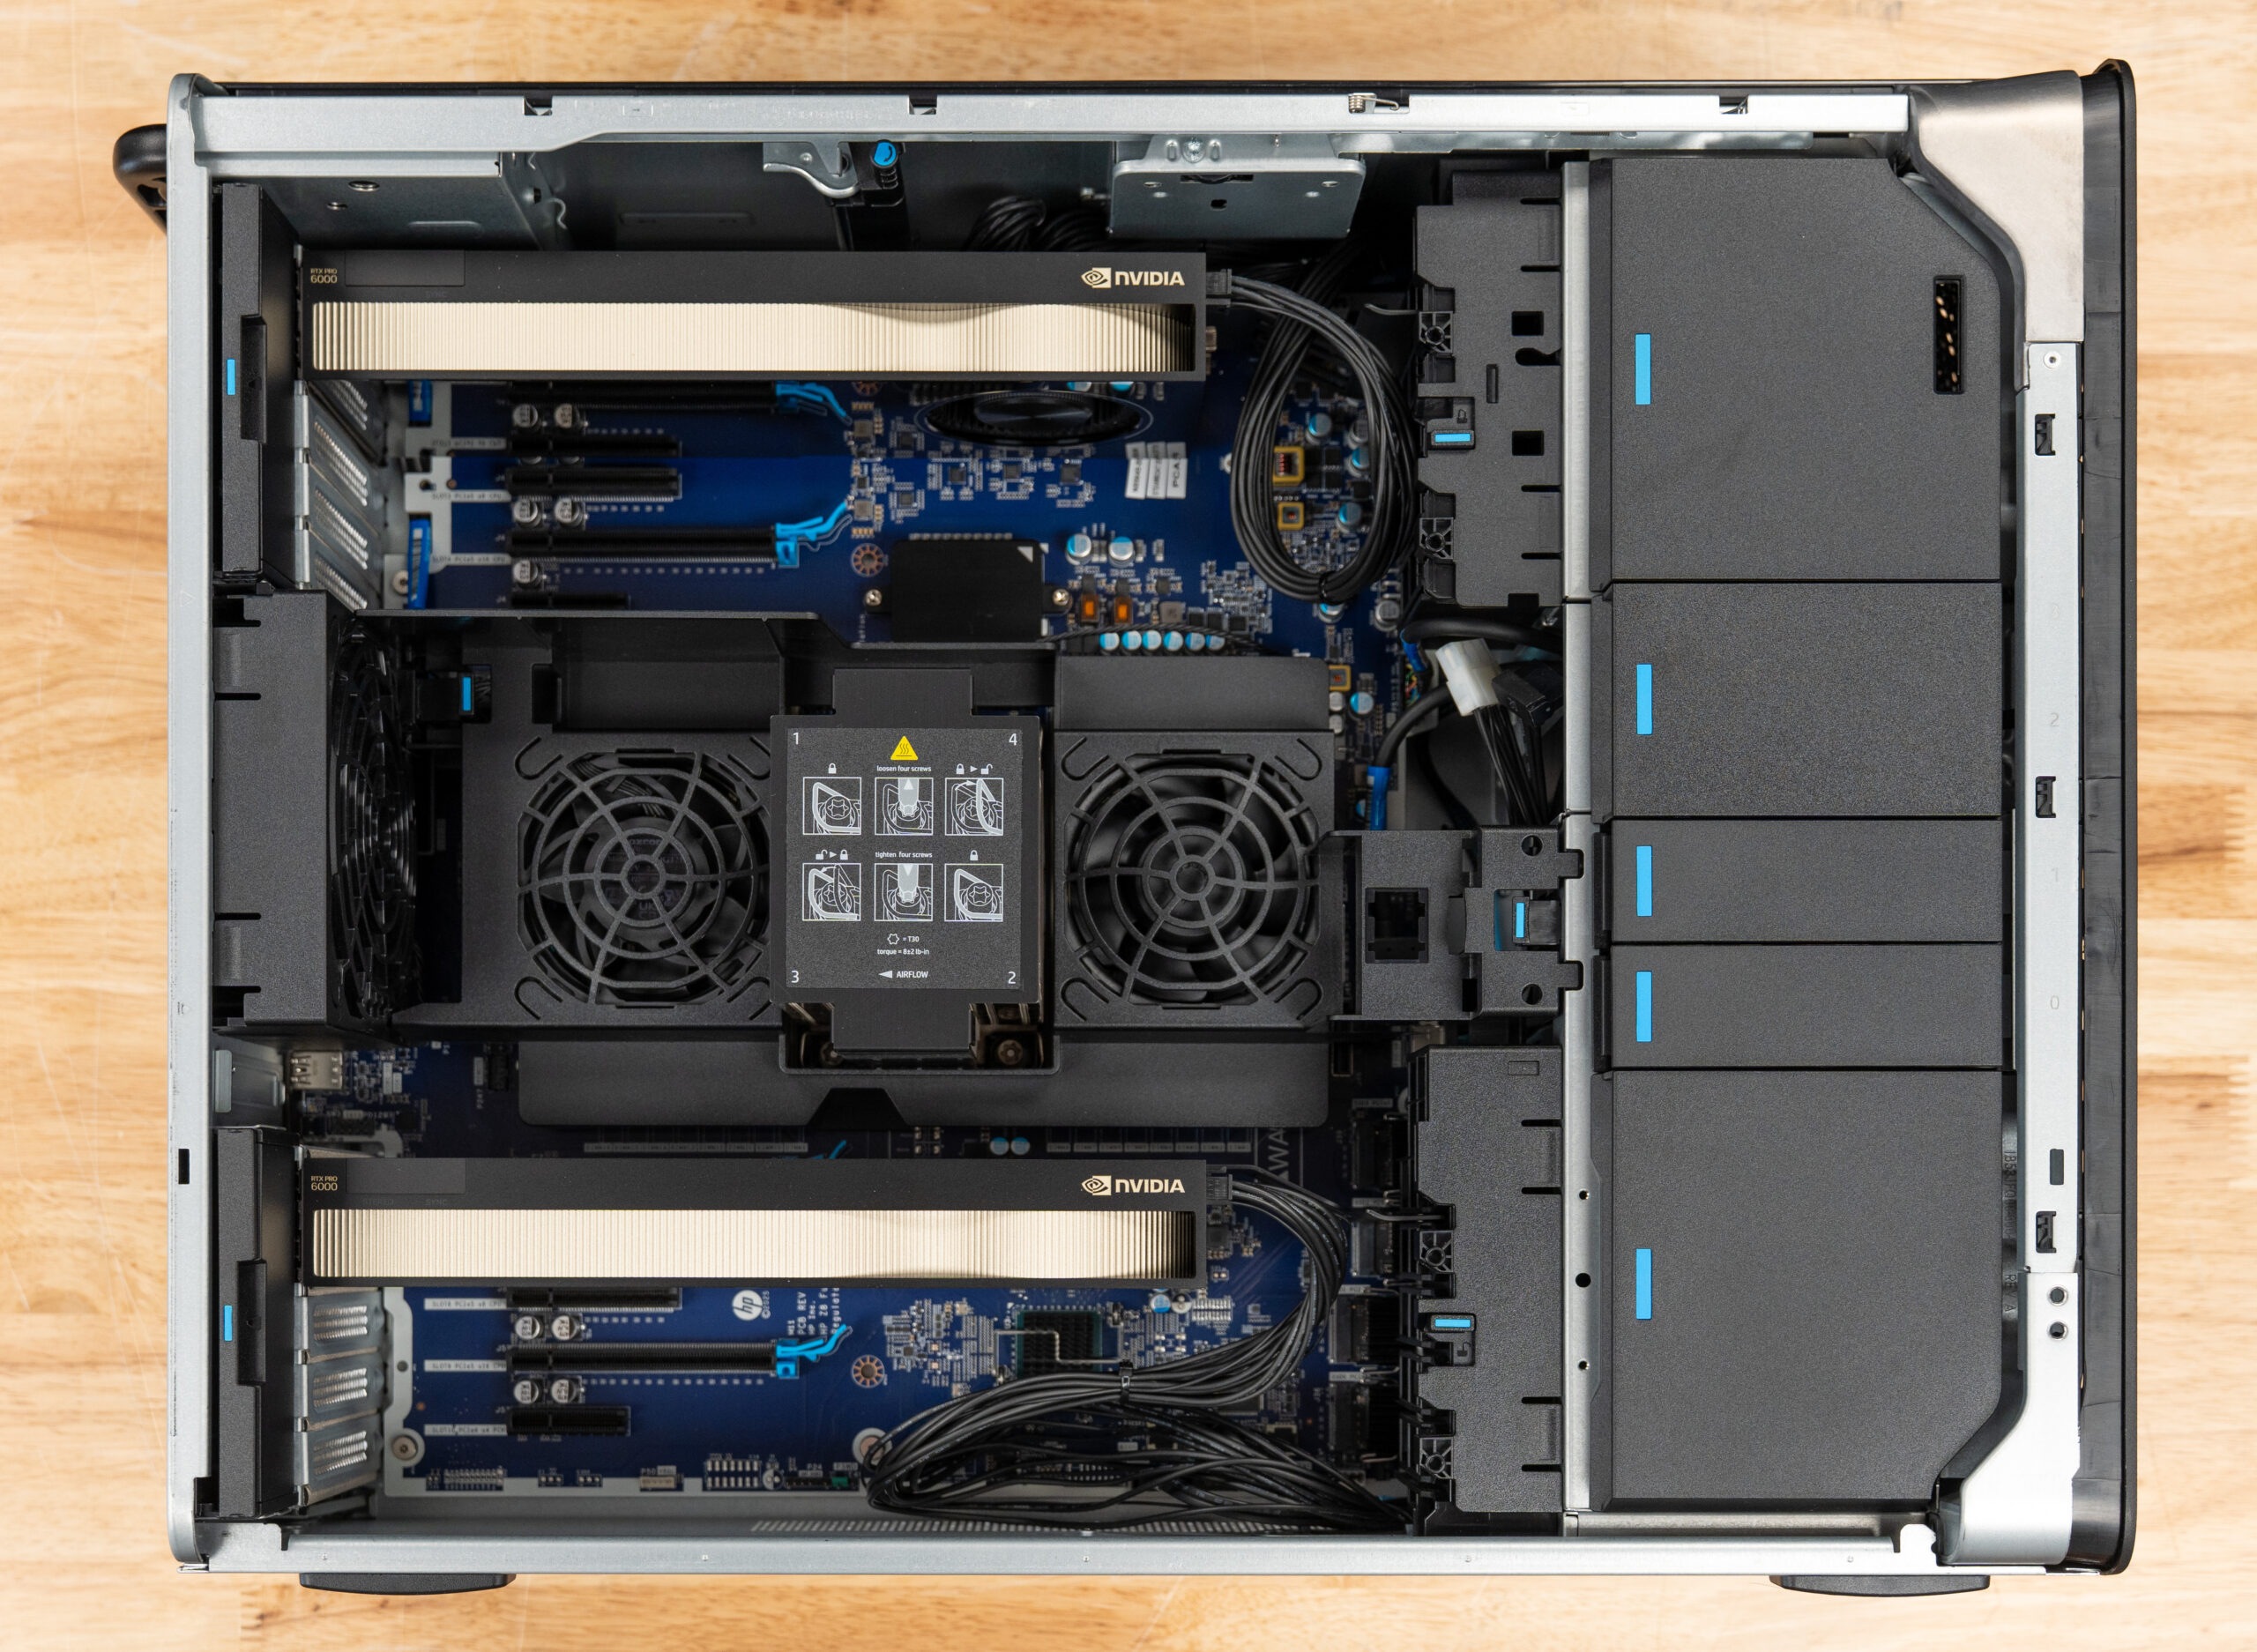
如果您打算升級到更多顯示卡,Z8 Fury G6i 就是您的理想之選。我們評測的這台主機搭載了兩張 RTX PRO 6000 Max-Q 顯示卡,共 192GB 記憶體。但這款機殼配備雙電源,總功率高達 2700W,最多可支援四張 Blackwell 架構的顯示卡和 384GB 記憶體。測試配置與最大配置之間的差距正是關鍵所在:我們測試過的所有標準 OEM 機箱中,沒有哪一款能提供如此大的顯示卡擴展空間,而且從兩張顯示卡升級到四張顯示卡無需更換機箱。
終極選擇:Comino Grando RTX PRO 6000
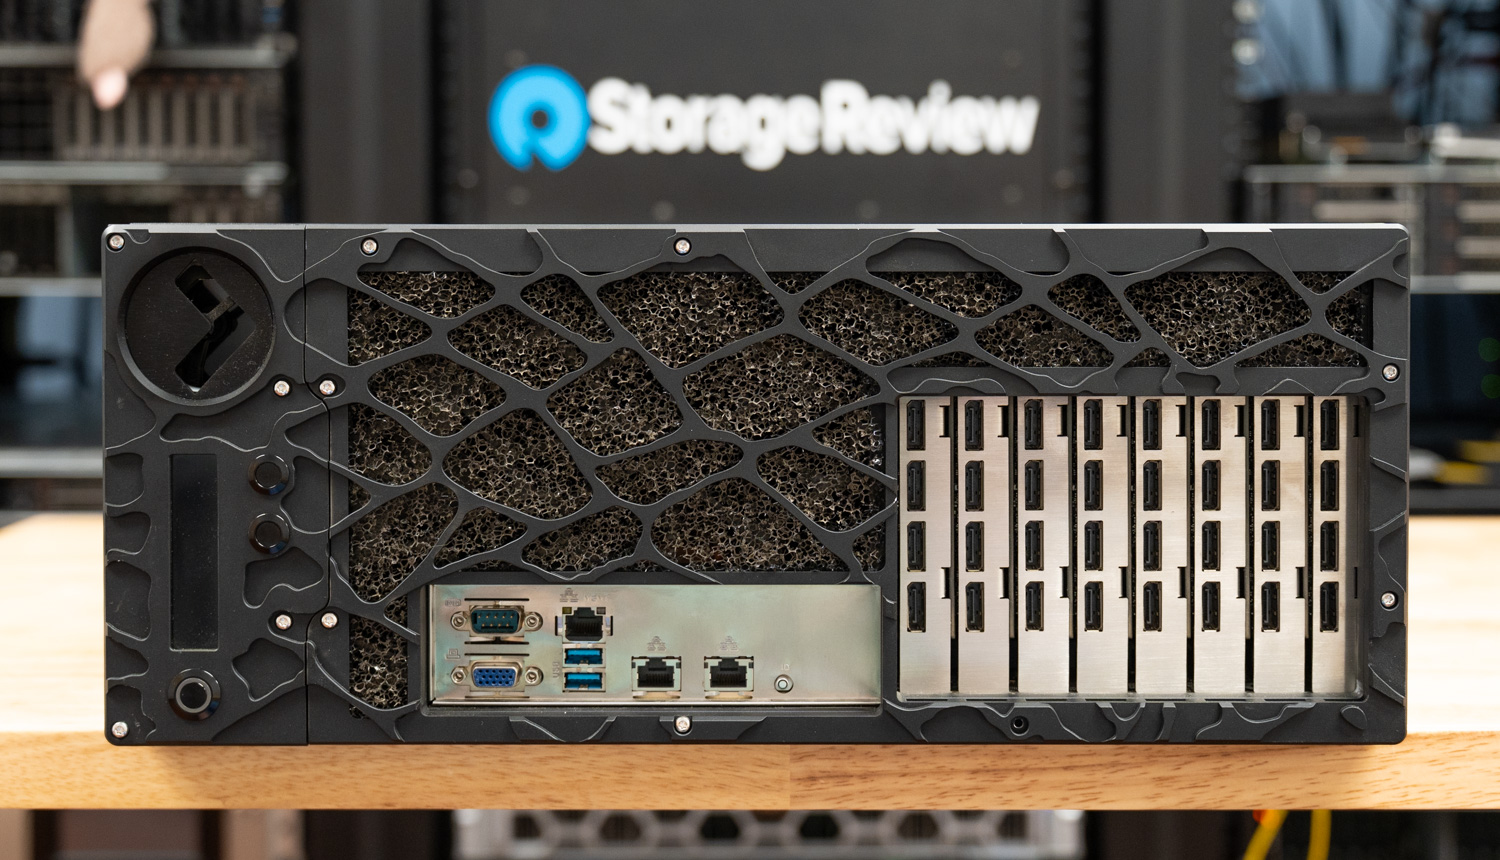
Grando 採用 4U 液冷機箱,配備 768GB 記憶體:專為找不到合適位置的使用者而設計。我們評測的這台 Grando 搭載了八張 96GB 顯存的 RTX PRO 6000 Blackwell 顯示卡,達到了機殼的最大容量。 Comino 的液冷散熱系統能夠讓這八張顯示卡全天候滿載運行,而不會出現降頻現象。這樣的顯存容量甚至超過了許多機架式伺服器,而它卻可以放在辦公桌旁。它的價格確實不菲,但噪音控制卻很出色。它特意出現在這份榜單上,是為了證明桌面級顯示卡的容量上限。
我們的排名方式
StorageReview 排行榜遵循三條規則,第一條是只有經過實驗室測試的系統才能上榜:如果我們沒有對系統進行基準測試,可以提及,但不能將其列入類別。第二條是每個系統只能依照一項測試指標排名一次。上述主機也曾出現在我們桌面工作站排行榜上,該排行榜基於 SPECworkstation 和渲染性能,直到 2026 年 10 月該頁面遷移到單 GPU 系統;它們在該排行榜上的成績仍保留在評測文章中,而在這裡,它們則根據推理吞吐量和內存上限進行排名。
第三,存在准入門檻:系統需要兩塊或更多GPU,並透過在Linux下使用vLLM Serving或我們的llama.cpp套件進行測試,或者需要一個至少96GB的共享記憶體池供模型使用。即使配備96GB顯示卡,單GPU塔式機也能在我們的Windows用戶端套件的「最佳桌面工作站」頁面上獲得排名。
排名綜合考慮了 vLLM 線上服務吞吐量、首代令牌響應時間、單次輸出代幣響應時間、MAMF 計算效率、GDSIO 存儲性能和市場價格。在同一評分區間內,由編輯進行排名。我們使用最新的 llama.cpp 測試套件對測試塔進行排名,排名依據包括服務吞吐量、首令牌回應時間、模型負載、RAG 值和微調結果。當推出新的測試塔時,我們會使用該測試套件重新測試對比測試塔。供應商在排名發布前無法查看排名,且本頁面所有排名均不收取費用。
本機 AI 桌面常見問題解答
最適合智能體人工智慧的桌面電腦是什麼?
諸如編碼代理、工具呼叫管道和多步驟自主任務等代理工作負載對吞吐量和延遲的敏感度遠高於單次聊天應用,因為代理會將多個模型呼叫與龐大的上下文關聯起來。這有利於塔式伺服器:戴爾 Precision 7875 的獨立顯存可提供持續的首令牌回應時間,從而確保長代理鏈的回應速度。對於預算有限的代理實驗,GB10 等級設備可以以較低的速度運行相同的堆疊。我們完整的設定指南請參閱《面向代理 AI 的記憶體、GPU 和儲存》。
本地運行70B模型需要多少記憶體?
一般來說,一個 4 位元量化的 70 位元組模型在上下文上下文之前大約需要 40-48GB 的模型可存取記憶體;而長時間的互動式使用則需要更多記憶體。這就是為什麼 128GB 統一記憶體的裝置能夠很好地處理 70 位元組級模型,以及為什麼單 GPU 塔式機出現在我們「最佳桌面工作站」頁面上的原因。
運行這些系統需要特殊權限嗎?
對於設備層來說,答案是否定的:GB10 級機上盒和 Strix Halo 系統都能在標準的辦公電源插座上輕鬆運作。至於塔式機箱,則需要與大樓業主深入探討。一台配置齊全的 HP Z8 Fury G6i 可以搭載兩個總功率高達 2700W 的電源,這超過了標準 15 安培、120 伏特電路的供電能力;而 Comino Grando 機箱則配備了 2000W 的熱插拔電源,需要 180-264V 的輸入電源。
在從本頁頂部購買任何產品之前,請先檢查牆壁插座的供電能力;專用電路或 208/240V 電源可能是全套 GPU 配置實際成本的一部分。散熱也遵循同樣的原理,因為每一瓦的功耗最終都會散發到房間內。
Mac 版 Studio 怎麼樣?
目前還沒有,因為我們還沒有進行實驗室測試。蘋果公司於9月22日開始發售搭載M5 Max和M5 Ultra處理器的Mac Studio,其中M5 Max最高配備128GB統一內存,起價2,499美元;M5 Ultra最高配備512GB內存,起價5,499美元。 512GB配置(對於超大容量機型而言最為重要)預計將於10月下旬上市,蘋果尚未公佈價格。如果我們進行測試,將會像本頁上的其他系統一樣,根據測試結果進行排名。
哪款至強工作站最適合本地人工智慧?
戴爾Pro Precision 9 T4是我們評選出的最佳本地AI至強塔式伺服器。它配備兩張RTX PRO 6000 Max-Q顯示卡,在單GPU服務模式下,效能僅比基於Threadripper處理器的Precision 7875低1%到9%。此外,它還能將一塊129.3GB的MiniMax M2.7記憶體分配到兩張顯示卡上,每秒處理83.7個令牌。同時,其八通道DDR5-6400記憶體為向量搜尋和模擬提供了高達53%的記憶體頻寬。儘管如此,Precision 7875仍然是我們選出的GPU吞吐量最佳的塔式伺服器。


 Amazon