

Cerebras Systems 正式發布了第四代晶圓級 AI 超級運算平台CS-4,專為前緣訓練和高並發推理工作負載而設計。系統採用三顆全新開發的晶圓級引擎 3 (WSE-3) Turbo 處理器,並搭載於全新設計的 Nexus 機架級平台中。 Cerebras 聲稱,該系統的推理性能最高可達基於 GPU 解決方案的 30 倍,這一數據基於GPT-OSS-120B數據集,該數據集顯示每位用戶每秒可處理超過 4,400 個令牌,同時每瓦吞吐量也比上一代 CS-3 提高了 10 倍。
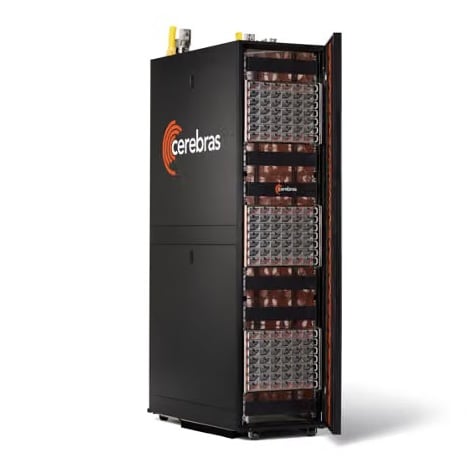
CS-4旨在解決離散多節點GPU叢集固有的系統性擴展限制,在這些叢集中,晶片間通訊、電源轉換損耗和散熱限制經常會降低持續運算效率。 Cerebras將此平台定位為能夠滿足推理工作負載的兩端需求,既能提供複雜智能體工作流程和交互式推理所需的亞毫秒級響應時間,又能提供超大規模數據中心所需的聚合容量,從而最大限度地提高每千兆瓦的計算密度。
互連架構的改進是該平台多處理器擴充能力的核心。 CS-4 將晶圓間互連延遲降低至 2 微秒,使多晶圓互連架構能夠以接近單晶片整合的方式運作。這種超低延遲架構使 CS-4 能夠在參數超過 10 兆的模型上維持每秒超過 1,000 個令牌的生成速度,從而彌補了以往參數數量增加導致互動式令牌交付速率嚴重下降的效能差距。

Nexus機架架構與晶圓級背包
CS-4 的一項重大工程革新是 Cerebras Nexus 平台架構,這是一種模組化機架式解決方案,圍繞著獨立的運算、電源和 I/O 域構建。計算密度由全新設計的後置晶圓級擴展艙 (Wafer-Scale Backpack) 實現,垂直連接至主電源陣列。每個擴展艙都是獨立的單元,內部包含直接對晶片的液冷歧管、負載點電源轉換級、高速網路路徑以及位於矽晶圓正後方的板載控制電子設備。透過將核心運算層與主電源分配框架隔離,Cerebras 將系統組件數量減少了 50%,自動化組裝率提高了 60%,並將資料中心部署時間縮短至數小時。

透過將直流-直流電壓調節模組的位置比傳統伺服器主機板更靠近矽片邊界100倍,電源傳輸效率得到了顯著提升。這種負載點佈局降低了電阻性電源分配網路(PDN)的損耗,使Nexus框架能夠為每個WSE-3 Turbo處理器提供兩倍的功率,從而實現更高的持續時脈頻率,而不會出現過熱降頻。

I/O 子系統也進行了擴展,新增了可程式晶圓 I/O 模組,可將邊緣到邊緣的交換矩陣頻寬提高一倍,同時降低傳輸延遲。系統網路以兩種模式運作:標準 RoCE v2(基於融合乙太網路的 RDMA)接口,用於以低延遲方式連接到傳統企業網路和第三方加速器節點;以及專有的直接晶圓鏈路,可在機架內和機架間相鄰系統之間提供直接、無交換器的互連路徑。
CS-4 和 WSE-3 渦輪增壓器規格
| CS-4系統 | |
| 卓越的建築 | 帶有三個模組化計算背包的主動電源架 |
| 晶圓級引擎 | 每個系統配備 3 個 WSE-3 渦輪增壓器 |
| 人工智慧運算 | 750 PFLOPS* |
| 內存帶寬 | 129.6PB/秒 |
| 片上結構頻寬 | 160.5PB/秒 |
| I/O頻寬 | 7.2 Tbit/s |
| I/O延遲 | 2微秒 |
| WSE-3 TURBO(每片晶圓) | |
| 電晶體/矽 | 4兆個電晶體;46,225平方毫米,台積電5奈米工藝 |
| AI核心/片上SRAM | 900,000萬個核心;44GB內存 |
| 人工智慧運算 | 250 PFLOPS* |
| 內存帶寬 | 43.2PB/秒 |
| 片上結構頻寬 | 53.5PB/秒 |
| I/O頻寬 | 2.4 Tbit/s |
| *AI 計算結果顯示為稀疏 FP16 | |
分解推理和可用性
在架構上,CS-4 原生支援解耦式推理拓撲。在企業和雲端環境中,維運人員可以使用專用的外部預填充加速器(例如AMD Helios或 AWS Trainium)來解耦推理的運算階段,這些加速器用於接收提示上下文並建立模型狀態。然後,計算密集型 KV 快取透過高速鏈路路由到 CS-4 的海量 SRAM 結構,以實現超低延遲的自回歸令牌產生。
Cerebras 證實 CS-4 平台的初始生產部署和出貨將於本季開始。


 Amazon