

Cloudera推出了 Cloudera Anywhere Cloud,這是一個混合資料和 AI 平台,旨在跨公有雲、主權環境和私人本地基礎架構建置、部署和擴展生產級工作負載。該平台既可作為獨立部署運行,也可直接整合到現有的企業資料湖中。它提供了一個集中式控制平面,可實現自動化管理、模組化服務配置和統一的資料治理,而無需將資料遷移到本機儲存層之外。
架構概述與工作負載遷移
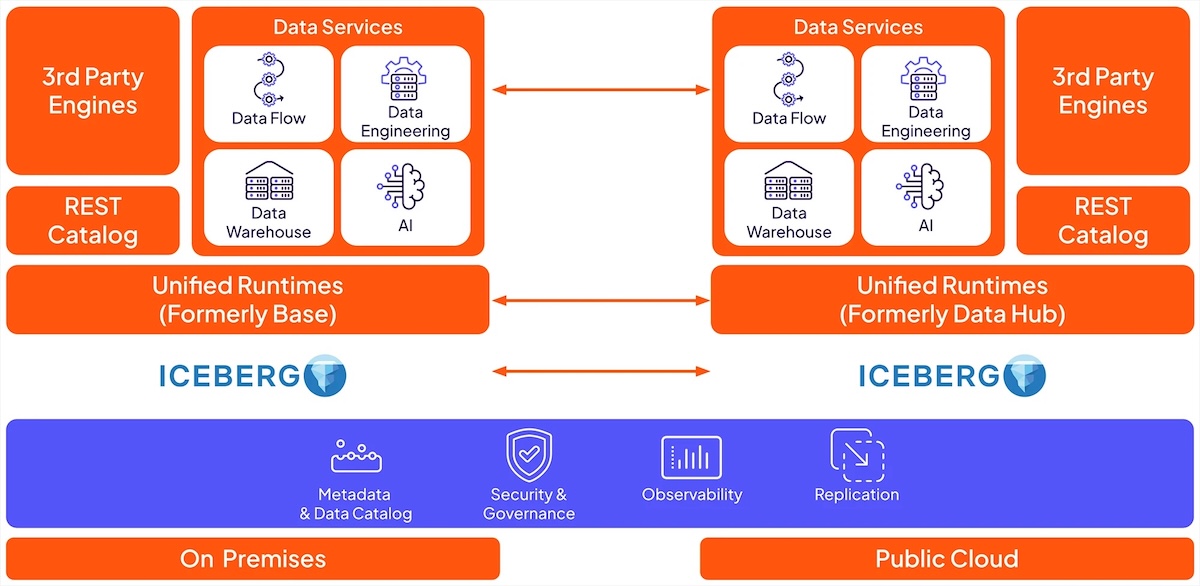
Cloudera Anywhere Cloud 採用模組化、解耦架構,將運算服務與底層儲存基礎架構分開。這種設計允許技術團隊部署獨立的分析引擎,包括 Apache Spark、Apache Kafka 和 Trino,以及透過自助式市場藍圖部署自訂的開源或第三方引擎。該系統使用標準 API、Apache Iceberg 開放式表格式和 Polaris 目錄,將異質基礎架構上的這些分散式運算引擎連接起來,消除了專有資料格式和自訂整合開銷。
基礎設施效能瓶頸和複雜的資料駐留要求常常阻礙企業人工智慧管道從試點階段過渡到生產階段。 Cloudera 引述最近的一項研究發現,73% 的 IT 領導者認為基礎設施效能限制阻礙了營運計畫的推進。 Cloudera Anywhere Cloud 透過支援在地化工作負載部署來解決這種營運延遲問題。應用程式可以根據業務、監管或硬體要求在指定位置運行,無需在不同環境中複製或傳輸大型資料集。
治理、智能體自動化與控制
該平台在分散式儲存和運算節點上整合了原生零信任安全控制。此框架可在主權雲、私有雲和公有雲層級之間維護資料沿襲、存取邊界和持續合規性。部署會自動繼承現有的企業治理策略,以保護資料主權和智慧財產權。
為了簡化日常運維,Cloudera 在控制介面中整合了一個智慧助理。該助手能夠將自然語言指令轉換為可執行的操作任務,例如啟動運算引擎、配置基礎設施資源以及協調跨連接環境的端到端資料管道。
Cloudera首席產品長Leo Brunnick表示:「企業級人工智慧已經超越了僅依賴公有雲的模式。企業不應該在創新和控制之間做出選擇。Cloudera Anywhere Cloud將雲端的速度和靈活性直接帶到企業資料上。這使企業能夠在保持對其數據和智慧財產權的完全所有權的同時,加速人工智慧計劃的實施,並優化其基礎設施、代幣和業務的基礎設施。
此次發布是 Cloudera 近期基礎設施策略擴張的又一舉措,其中包括與 VAST Data 聯合推出的 AI 工廠堆疊。 Cloudera 本週將在新加坡舉行的 EVOLVE 大會上展示 Cloudera Anywhere Cloud。
透過 NVIDIA cuDF 實現 GPU 加速的 Spark
在發布新平台的同時,Cloudera也宣佈在其 Cloudera Data Engineering 中為 Apache Spark 4.1 提供原生 GPU 加速,該加速基於 NVIDIA 的 cuDF CUDA-X 庫建置。 cuDF 外掛程式無需更改 PySpark 或 SQL 程式碼即可加速現有的 Spark 管線,Cloudera 將其定位為一種在降低雲端運算成本的同時更快地準備 AI 就緒資料的方法,並且該功能已作為 Anywhere Cloud 的一部分整合到 Cloudera Data Engineering 中。


 Amazon