

戴爾已通過鎧俠 (KIOXIA) 245.76TB NVMe SSD 的認證,使其符合軟體定義的 ObjectScale 要求,從而在一台 2U 伺服器中實現了 9.83PB 的原始快閃記憶體容量。這項密度里程碑的實現,建立在戴爾今年稍早在 ObjectScale 4.2 和 4.3 版本中詳細介紹的資料路徑改進工作之上。這些改進旨在透過原生 S3 over RDMA、LLM 的鍵值 (KV) 快取卸載、改進的區塊儲存引擎以及透過 S3 Tables 直接支援 Apache Iceberg,實現高吞吐量 AI 訓練、小物件管線效率和推理加速。
密度里程碑:採用 245 TB KIOXIA SSD,在 2U 機架空間內達到 9.83 PB 的儲存容量
隨著企業級 AI 資料湖在模型訓練、微調和合規性資料保留等多個層面不斷擴展,機架密度、散熱管理和機房空間限制已成為主要的設計變數。為了滿足每個機架單元的原始容量需求,戴爾已對KIOXIA 的 245.76 TB NVMe SSD 進行了認證,使其可用於在戴爾 PowerEdge R7725伺服器上運行的軟體定義 ObjectScale 。
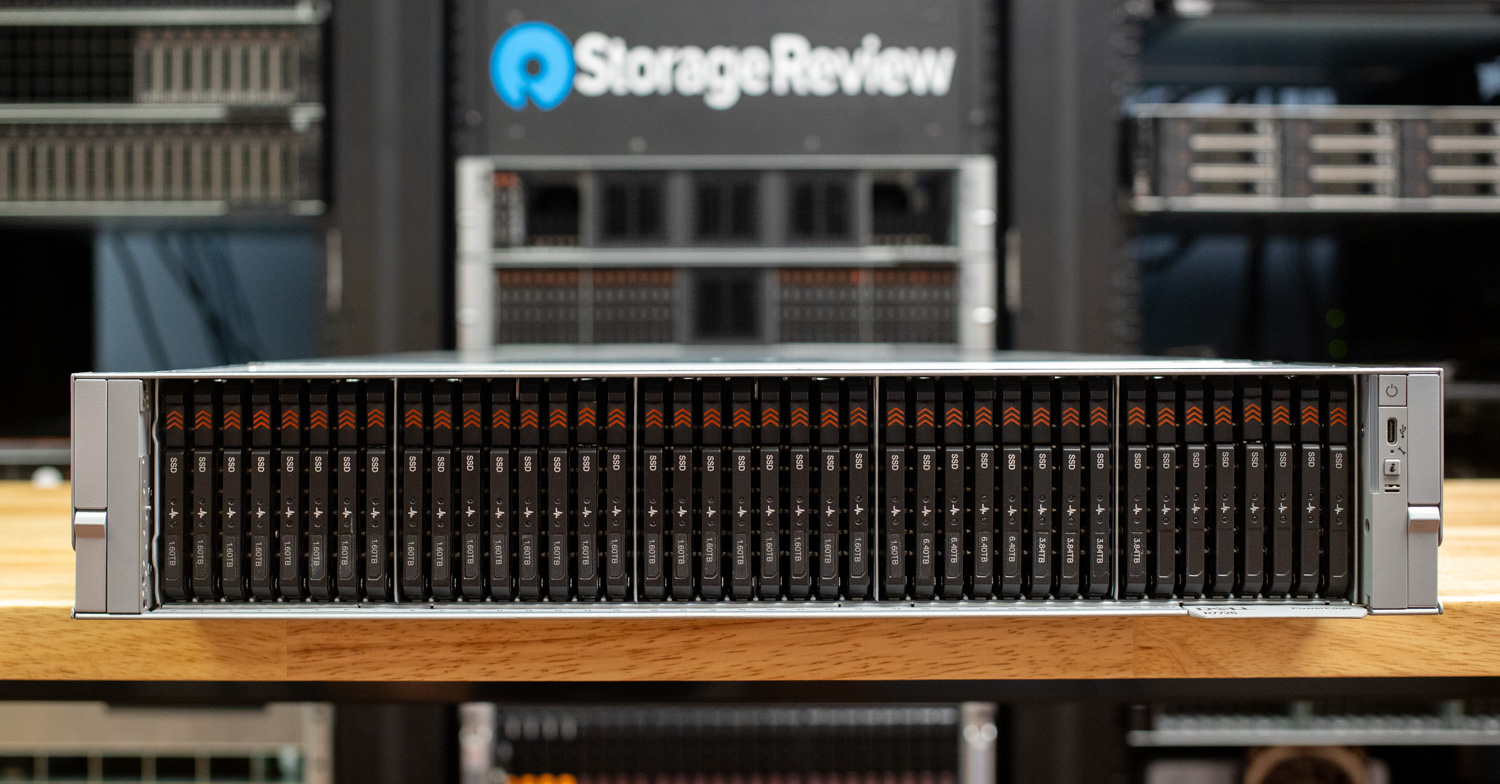
ObjectScale 透過在單一 2U 機殼內安裝 40 塊 245.76 TB 的隨身碟,實現了 9.83 PB 的原始全快閃容量;我們去年夏天對平台進行了評測。這種高密度儲存方案的目標用戶是企業級人工智慧工廠、向量資料庫、大型分析儲存庫以及網路安全平台,這些應用需要多 PB 級的非結構化存儲,同時還要最大限度地降低功耗、散熱負荷和佈線複雜性。有關 245TB 快閃記憶體與硬碟相比在功耗和機架數量方面的具體差異,請參閱我們的Micron 6600 ION 報告。
吞吐量提升和小物件架構
在經過認證的戴爾PowerEdge伺服器上進行軟體定義部署後,戴爾內部測試表明,每個節點的讀取吞吐量最高可達40 GB/s,比上一代全快閃物件平台提升了8倍。戴爾也指出,一家英國高頻交易客戶在生產環境中實現了約280 GB/s的聚合讀取吞吐量。這些數據與我們在硬體本身測得的結果相符:去年11月,我們對R7725xd進行了測試,該平台在內部NVMe池上的讀取吞吐量超過300 GB/s,在NVMe-oF RDMA上的讀取吞吐量達到160 GB/s。該測試直接對伺服器進行了效能表徵,而不是在其上運行ObjectScale,但它確定了軟體所能達到的效能上限。
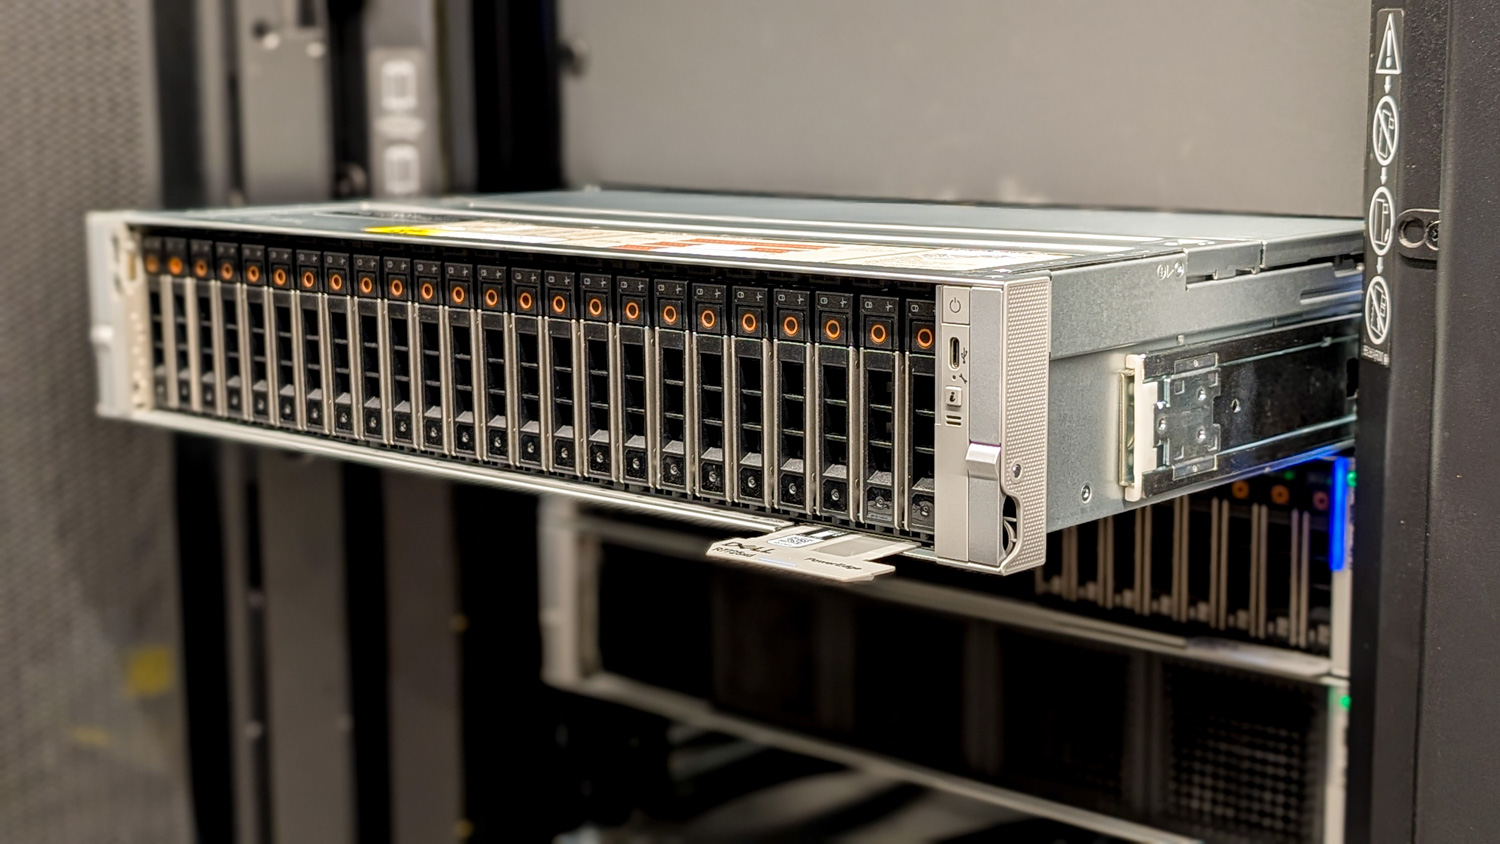
為了消除處理數百萬個小型特徵集、向量區塊和遙測日誌的管道中常見的元資料瓶頸,ObjectScale 採用了一種優化的區塊儲存引擎。此架構在跨節點應用糾刪碼之前,會將小型有效載荷聚合到統一的 128MB 區塊中。對於典型的 10KB 文件,單一區塊可容納超過 10,000 個對象,從而顯著降低元資料開銷。
這種分塊方法還重建了驅動器故障重建流程,將需要重建的分片總數從數十億減少到數百萬,從而將高密度 NVMe 驅動器的恢復時間從數週縮短到數小時。在條帶層級驗證的內聯校驗和減少了主機 CPU 用於後台完整性掃描的週期數。此外,ObjectScale 4.2 中重新設計的鍵值儲存 (KVS) 記憶體效率提高了約 4 倍,元資料磁碟佔用空間減少了 30% 到 60%。
基於 RDMA 的 S3 和推理加速
ObjectScale 4.3 將 S3 over RDMA 擴展到戴爾的全快閃產品組合,包括XF960、EXF900 和軟體定義 PowerEdge R7725xd 部署。該平台利用 RoCEv2 網路和戴爾的 S3-over-RDMA SDK,繞過核心 TCP 開銷和 CPU 中斷,在主機 GPU 和後端 NVMe 媒體之間建立直接記憶體路徑。內部測試表明,與標準的 S3 over TCP 相比,該方案可將吞吐量提高高達 230%,延遲降低 80%,客戶端 CPU 使用率降低高達 98%。
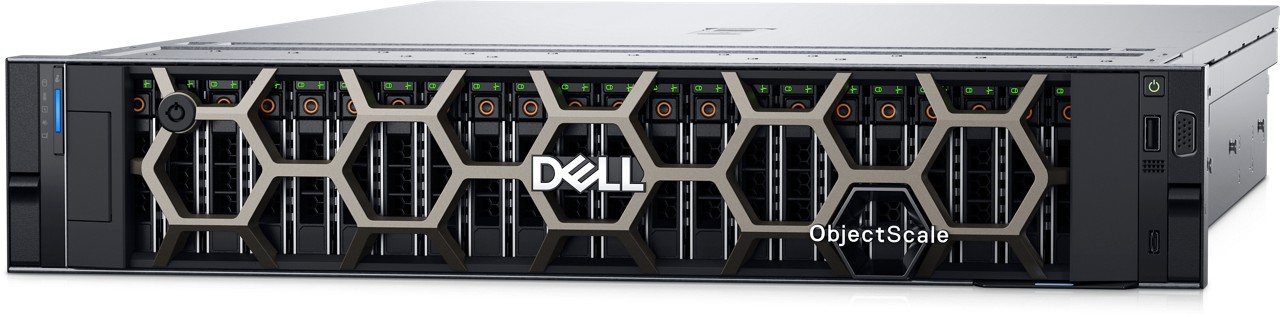
對於推理架構而言,ObjectScale 可作為外部層用於KV 快取卸載。由於長上下文推理會迅速耗盡 GPU 上的 HBM 和 VRAM,因此與 vLLM、LMCache 和 NVIDIA 的 NIXL 庫集成,使得推理框架能夠透過 RDMA 加速的 S3 將活躍注意力狀態直接溢出到 ObjectScale。戴爾報告稱,與未進行快取卸載的標準 vLLM 相比,首次令牌時間 (TTFT) 最多可提升 19 倍,令牌吞吐量最多可提升 5.3 倍,多輪吞吐量幾乎提升 3 倍。此外,戴爾在其與競爭對手物件平台進行的直接對比測試中,TTFT 約為 0.86 秒。
原生 S3 表與橫向擴充效率
ObjectScale 4.3 也引入了原生 S3 表格功能(戴爾將其列為技術預覽版),該功能將 Apache Iceberg 開放式表單式直接嵌入到儲存桶層中。包括 Trino、Starburst、Spark 和 Flink 在內的查詢引擎可以直接對 S3 儲存桶進行分析,無需專用暫存區或將 ETL 資料移至單獨的資料倉儲。戴爾表示,與傳統資料倉儲配置相比,此架構的資料攝取速度最高可提升 2 倍,查詢速度最高可提升 4.5 倍。
底層儲存效率得益於 24+2 和 24+4 糾刪碼設定文件,戴爾表示,這些設定檔可將寫入放大率降低高達 75%。在 EX500 等高容量 HDD 平台上,戴爾報告稱,大物件攝取速度提升高達 25%,中等大小物件的寫入效能提升高達 2 倍。針對特定工作負載的儲存桶壓縮支援 Snappy、LZ4、ZSTD 和 Deflate 演算法,並提供遙測功能以進行財務運作成本追蹤。配置和編排與雲端原生工具(包括 Kubernetes 容器物件儲存介面 (COSI) 和 Terraform 提供者)原生整合。


 Amazon