

微軟推出了 Maia 200,這是一款全新的客製化推理加速器,旨在提升大規模 AI 代幣產生的經濟效益。 Maia 200 被定位為微軟首個專為 AI 推理優化的晶片和系統平台。
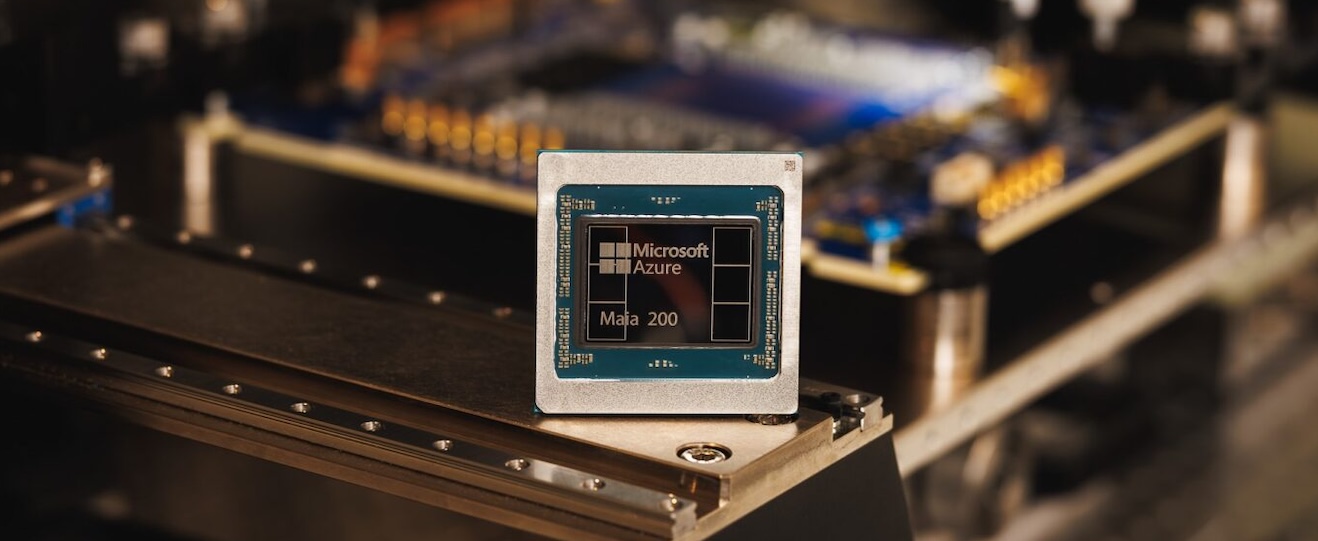
微軟將人工智慧推理建構為一個“高效前沿”,旨在平衡能力和準確性與成本、延遲和能耗。實際上,這個前沿會根據工作負載的不同而有所變化:互動式輔助駕駛優先考慮低延遲,批量摘要和搜尋強調每美元的吞吐量,而高級推理則需要在較長的上下文視窗和多步驟執行下保持持續效能。微軟傳達的訊息是,基礎設施不能再千篇一律,Azure 需要提供一系列針對不同推理場景進行最佳化的服務選項。
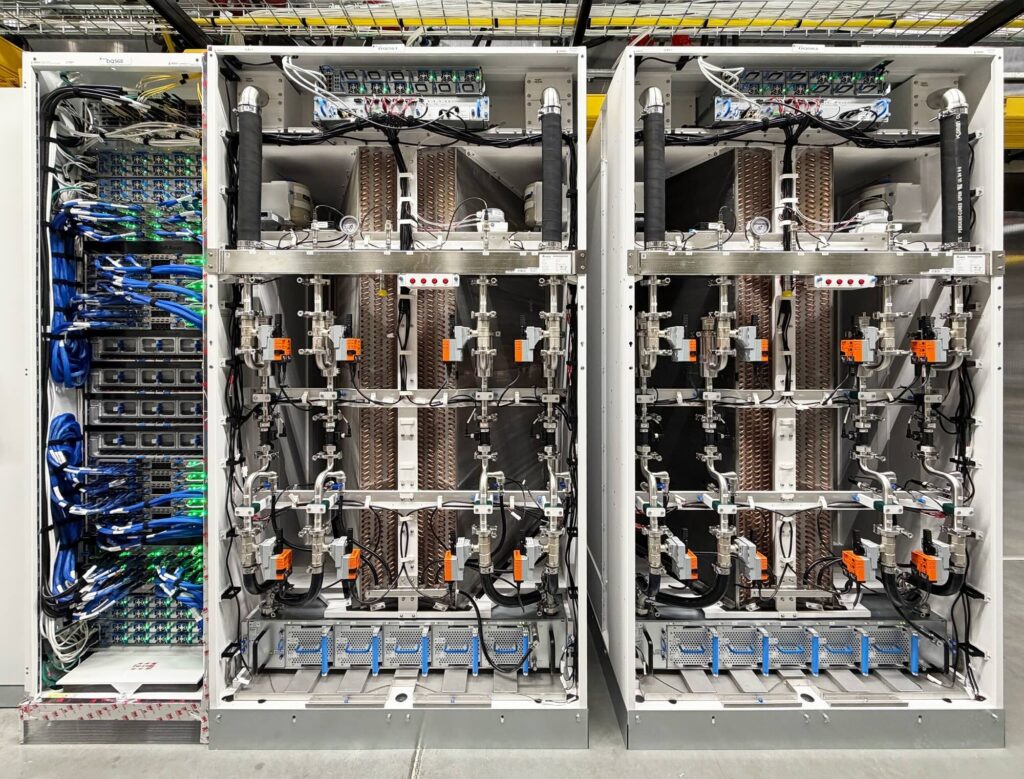
Microsoft Maia Rack
微軟表示,Maia 體現了涵蓋軟體、晶片、系統和資料中心的全端解決方案,並聲稱與目前部署在其伺服器上的最新一代硬體相比,每美元的效能提升了 30%。隨著智慧代理應用程式變得越來越複雜和應用越來越廣泛,微軟將這種整合式設計定位為一項基礎性優勢。
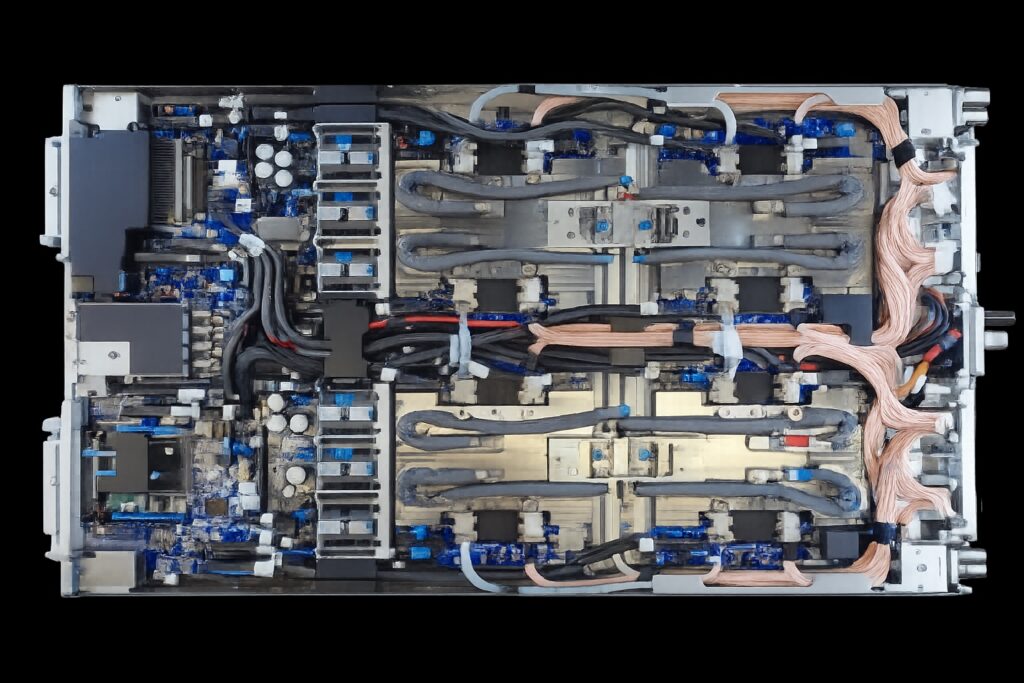
微軟 Maia 200 伺服器刀片
Maia 200:主要架構特點和峰值規格
Maia 圍繞著窄精度執行、旨在減少片外流量的內存層次結構以及旨在保持多加速器推理效率的以太網擴展設計而構建。
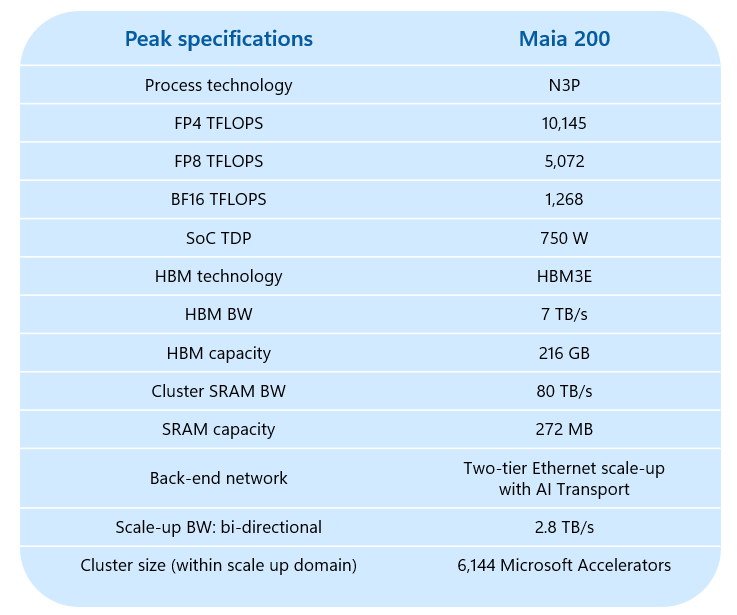
微軟重點介紹了Maia的幾個峰值規格和設計要點。 Maia採用台積電N3製程的最佳化窄精度資料通路,FP4峰值運算能力高達10.1 PetaOPS。微軟正大力推廣FP4這種成本效益高的推理格式,力求實現更高的每美元、每瓦功耗的代幣產量。
記憶體是本次評測的重點。 Maia 整合了 272MB 片上 SRAM 和 216GB HBM3e 顯存,微軟宣稱其 HBM 頻寬高達 7TB/s。其目標是將關鍵工作集保留在晶片內部,透過提高局部性降低 HBM 頻寬需求,並透過減少片外資料傳輸來提升能源效率。
為了實現資料傳輸,Maia 將多層 DMA 子系統與分層片上網路結合,從而為異質、記憶體密集型工作負載保持可預測的效能。微軟強調資料傳輸和運算之間的重疊,以及對張量友善佈局的結構化支援。
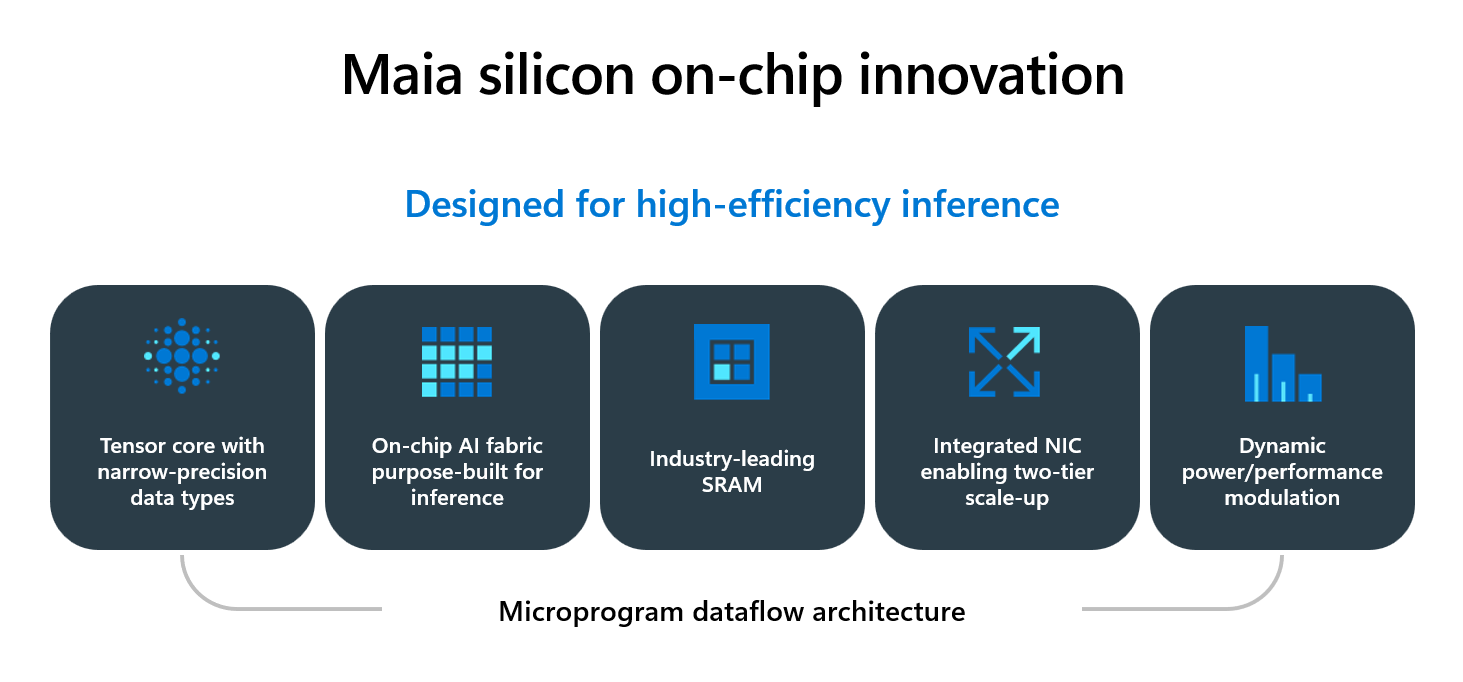
為了實現規模化擴展,Maia 整合了片上網卡和基於乙太網路的互連,雙向頻寬高達 2.8TB/s。微軟表示,該設計支援最多 6,144 個加速器的兩層規模化擴展架構,旨在為大型推理叢集提供高頻寬、低延遲的通訊。
基於瓦片和叢集的微架構
Maia 的計算設計採用分層結構。最小單元是 tile,它結合了用於矩陣運算和卷積的 Tile 張量單元 (TTU) 以及作為可編程 SIMD 引擎的 Tile 向量處理器 (TVP)。每個 tile 由多存儲體 tile SRAM (TSRAM) 供電,並使用 tile 級 DMA 引擎來傳輸數據,而不會導致計算管線停頓。一個輕量級控制處理器負責協調任務的分配,並利用硬體訊號量來實現資料傳輸和運算之間的緊密同步。
Tile 組成集群,透過集群 SRAM (CSRAM) 實現共享局部性,並引入第二個 DMA 層,用於在 CSRAM 和共封裝 HBM 之間暫存資料。微軟也指出,Tile 和 SRAM 的冗餘設計旨在提高良率和可製造性,同時保持程式設計模型的一致性。
窄幅精密對焦:FP4 與混合精度
微軟正大力押注窄精度作為提升推理效率的關鍵,並引用業界經驗表明,FP4 能夠在保持推理精度的同時降低運算和記憶體成本。 Maia 的 TTU 針對 FP8、FP6 和 FP4 進行了最佳化,並支援混合精度模式,例如 FP8 活化值乘以 FP4 權重。 TVP 支援 FP8 以及 BF16、FP16 和 FP32,以滿足那些受益於更高精度的算子的需求。整合的重塑器能夠以線速將低精度格式上轉換,從而避免在計算過程中出現瓶頸。
微軟聲稱 Maia 上的 FP4 吞吐量是 FP8 的 2 倍,是 BF16 的 8 倍,這使得該架構能夠在推理密集型部署中實現更高的每秒令牌數和更強的每瓦效能。
針對局部性和確定性進行調整的記憶體子系統
Maia 的片上 SRAM 分為集群級和 tile 級兩個池,這兩個層級都完全由軟體管理。微軟將此定位為對記憶體佈局和局部性的確定性控制,既可以由開發人員直接完成,也可以透過編譯器和執行時間決策來實現。
該公司描述了幾種預期模式:GEMM 核心可以將中間資料區塊保留在 TSRAM 中,以避免與 HBM 的往返通訊;注意力核心可以將關鍵張量和部分積本地固定,以減少移動開銷;集體通訊可以在 CSRAM 中緩衝有效載荷,同時在 TSRAM 中進行累加,以避免多節點操作期間 HBM 壓力過大。微軟也強調 CSRAM 可用作跨核心管線的瞬態緩衝區,旨在減少密集算子鍊和融合工作負載中的停頓。
資料傳輸:定製片上網路(NoC)加多層直接存取管理(DMA)。
微軟認為,推理效能通常受限於資料傳輸而非尖峰數學吞吐量,因此 Maia 在可預測的資料傳輸和低延遲控制訊號方面投入了大量資源。片上互連被描述為一個跨越集群、瓦片、記憶體控制器和 I/O 單元的網狀結構,並具有獨立的邏輯平面,分別用於高頻寬張量流量和對延遲敏感的控制流量。這種分離旨在防止同步、中斷和小訊息被大批量傳輸阻塞。
微軟也提到,分層廣播可以減少冗餘的HBM讀取,叢集流量本地化可以確保熱點資料在叢集內部流動,Tile到Tile的SRAM存取可以在不呼叫HBM的情況下實現叢集內資料共享,QoS機制可以優先處理緊急的控制和輸出流量。 DMA引擎依Tile、叢集和網路角色分層,支援跨記憶體層和片外連結的並發傳輸,同時也能持續進行運算。
縱向擴充網路:片上網卡、乙太網路和ATL
為了實現多加速器推理,Maia 使用了整合式網卡和基於乙太網路的縱向擴展架構,該架構圍繞著微軟的 AI 傳輸層 (ATL) 構建。微軟表示,ATL 可在標準乙太網路上進行端對端傳輸,旨在與通用的多廠商交換器配合使用,同時添加了資料包噴射、多路徑路由和抗擁塞流量控制等傳輸特性。
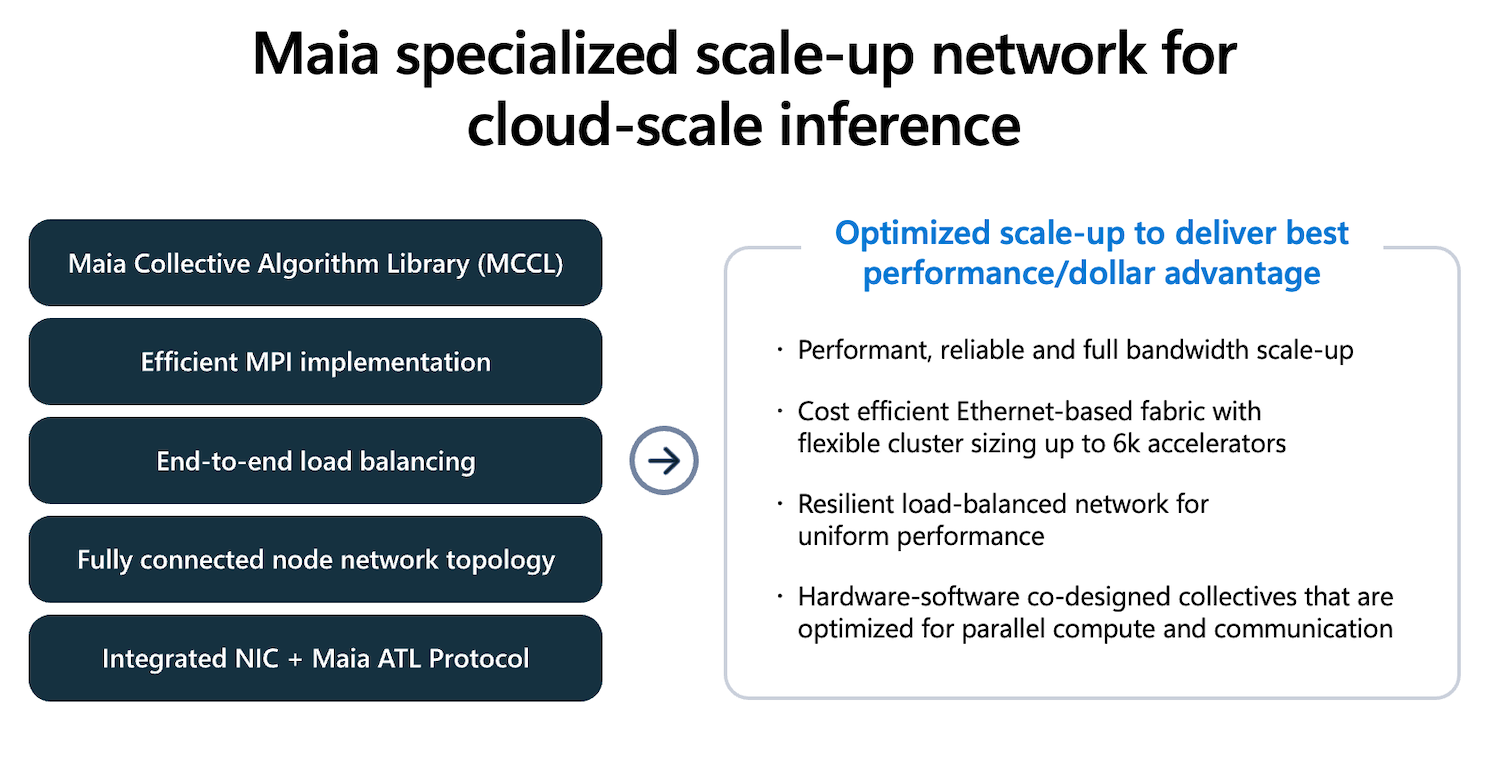
微軟也描述了一種旨在減少對外部交換器依賴的本地張量並行流量的拓撲結構選擇。該公司的全連接四路架構 (FCQ) 將四個加速器透過直接鏈路連接在一起,使高強度的本地集群無需使用交換式網路。第二層架構則擴展到 FCQ 範圍之外的更大集群,微軟認為這種規模的集群更適合推理同步模式,而非訓練模式下的全連接行為。
在叢集操作的軟體方面,微軟重點介紹了與硬體協同設計的微軟叢集通訊庫 (MCCL),旨在提升擴展效率。該公司指出,MCCL 透過計算和 I/O 重疊、分層集群、動態演算法選擇和管線調度等方式來隱藏延遲並降低網路壓力。
Azure 整合與部署模型
微軟將 Maia 定位為 Azure 原生加速器,而非獨立加速器。它的設計與 Azure 的機架、電源和機械標準保持一致,這些標準也適用於第三方 GPU 系統,從而簡化部署和維護,並支援在同一資料中心內建置異質加速器叢集。
Maia 平台同時適用於風冷和液冷環境,並配備了面向高密度機架的第二代液冷擴展模組。在維運方面,該平台與 Azure 控制平面集成,可實現生命週期管理、運行狀況監控、韌體部署和叢集工作流程,旨在減少升級和維護期間對服務的影響。
微軟表示,Maia 將成為其異質 AI 基礎設施的一部分,支援多種模型,包括 OpenAI 最新的 GPT-5.2 模型,並將用於為 Microsoft Foundry 和 Microsoft 365 Copilot 中的 AI 工作負載提供支援。該公司強調,可以使用與 Azure GPU 叢集相同的工具來調度、分區和監控工作負載,旨在實現可移植性,並能夠在不重新編排流程的情況下,針對每美元效能、延遲或容量進行最佳化。
開發者工具鏈:Maia 200 SDK、Triton Path 和底層控制
微軟發布了 Maia 200 SDK,該 SDK 支援 PyTorch 等常用入口點,並提供多層控制。選用功能包括用於核心產生的 Maia Triton 編譯器路徑、針對 tile 和叢集架構最佳化的核心庫,以及用於明確管理資料移動、SRAM 放置和並行執行的微軟巢狀並行語言 (NPL)。
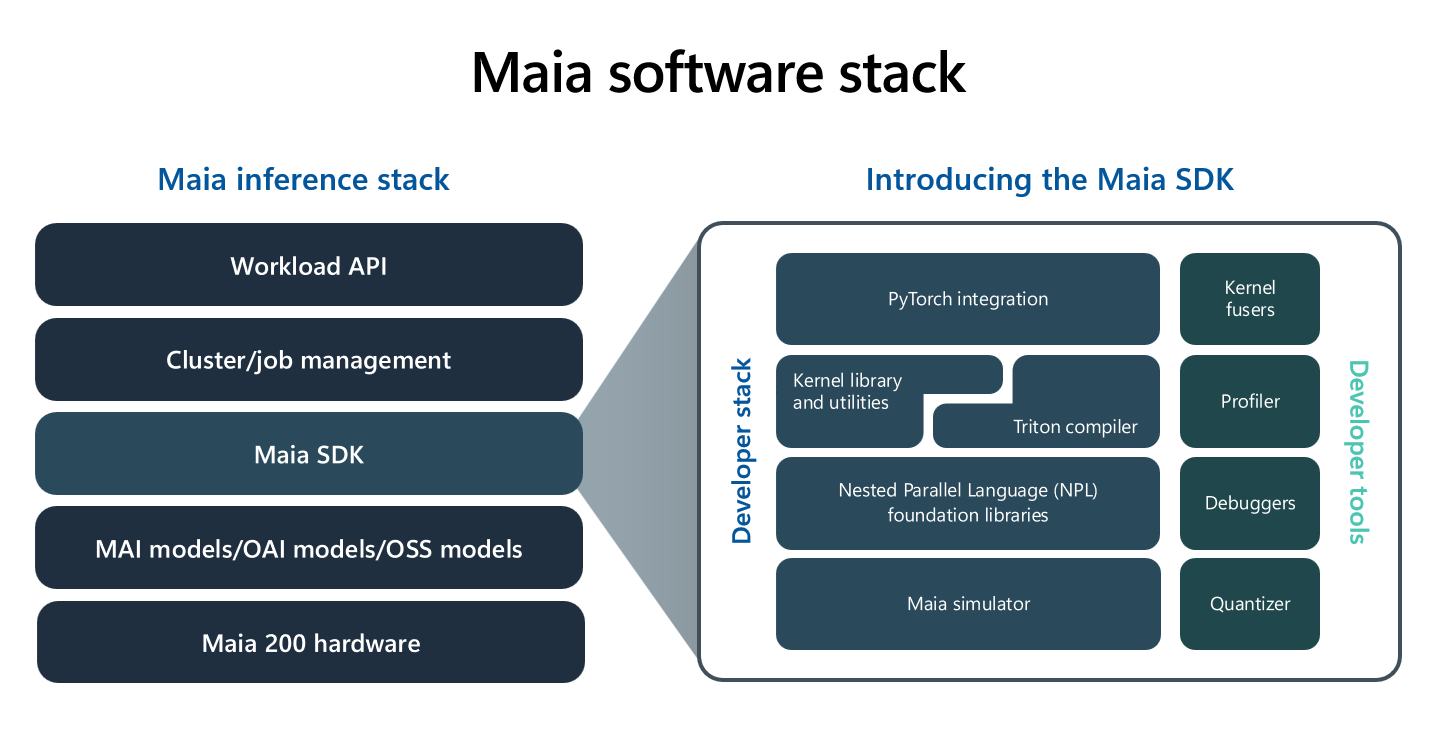
該SDK還包括模擬器、編譯器管線、效能分析器、調試器以及量化和驗證工具。微軟將其定位為一種儘早進行原型設計和效能調優、診斷瓶頸並提高整個技術堆疊利用率的方法。
底線
微軟將 Maia 200 定位為一款專為推理而打造的平台,專注於每美元和每瓦的代幣收益,其架構重點在於窄精度計算、軟體管理的 SRAM 局部性以及直接集成在晶片上的基於以太網的擴展架構。該公司宣稱,與現有硬體相比,Maia 200 的每美元效能提升了 30%,這得益於晶片、網路、系統和 Azure 運維之間的協同優化。


 Amazon