

在快速發展、不斷發展的人工智能 (AI) 領域,NVIDIA DGX GH200 成為創新的燈塔。 這個強大的系統在設計時考慮了最苛刻的人工智能工作負載,是一套完整的解決方案,旨在徹底改變企業處理生成式人工智能的方式。 NVIDIA 提供了新的詳細信息,展示了 GH200 如何結合在一起,並通過這種最新一代 GPU 技術實現 AI 性能的巔峰。
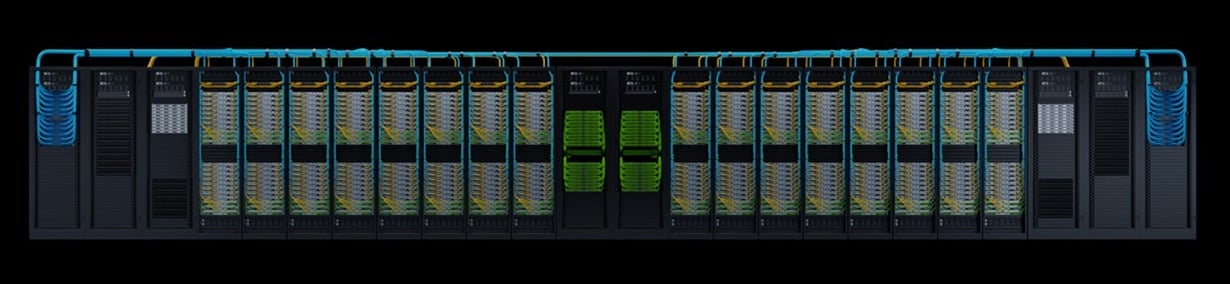
NVIDIA DGX GH200:完整的解決方案
DGX GH200 不僅僅是一款精美的機架硬件;它還是一款出色的機架硬件。 它是一個將高性能計算 (HPC) 與人工智能相結合的綜合解決方案。 它旨在處理最複雜的人工智能工作負載,提供真正無與倫比的性能水平。
DGX GH200 將完整的硬件堆棧(包括 NVIDIA GH200 Grace Hopper Superchip、NVIDIA NVLink-C2C、NVIDIA NVLink 交換機系統和 NVIDIA Quantum-2 InfiniBand)整合到一個系統中。 NVIDIA 通過專門為加速模型開發而設計的優化軟件堆棧來支持這一切。
| 規格 | 信息 |
|---|---|
| GPU | 料斗 96 GB HBM3,4 TB/秒 |
| 中央處理器 | 72核臂Neoverse V2 |
| CPU內存 | 高達 480 GB LPDDR5,速度高達 500 GB/s,能效比 DDR4 高 5 倍 |
| CPU 到 GPU | NVLink-C2C 900 GB/s 雙向相干鏈路,能效比 PCIe Gen5 高 5 倍 |
| GPU 到 GPU | NVLink 900 GB/s 雙向 |
| 高速輸入輸出 | 4 個 PCIe Gen5 x16,速度高達 512 GB/s |
| TDP | 可配置為 450W 至 1000W |
擴展 GPU 內存
NVIDIA Grace Hopper Superchip 配備擴展 GPU 內存 (EGM) 功能,旨在處理具有大量內存佔用的應用程序,這些內存佔用大於其自己的 HBM3 和 LPDDR5X 內存子系統的容量。 此功能允許 GPU 從系統中的所有 CPU 和 GPU 訪問高達 144TB 的內存,並可以以 LPDDR5X 速度進行數據加載、存儲和原子操作。 EGM 可與標準 MAGNUM IO 庫配合使用,並且可由 CPU 和其他 GPU 通過 NVIDIA NVLink 和 NVLink-C2C 連接進行訪問。
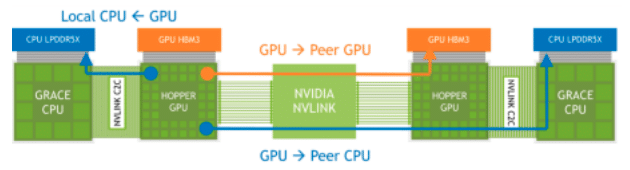
NVLink 內存訪問連接的 Grace Hopper 超級芯片
NVIDIA 表示,NVIDIA Grace Hopper Superchip 上的擴展 GPU 內存 (EGM) 功能通過提供巨大的內存容量,顯著增強了大型語言模型 (LLM) 的訓練。 這是因為法學碩士通常需要大量內存來存儲其參數、計算和管理訓練數據集。
能夠從系統中的所有 CPU 和 GPU 訪問高達 144TB 的內存,可以更高效地訓練模型。 大內存容量應該會帶來更高的性能、更複雜的模型,以及處理更大、更詳細的數據集的能力,從而有可能提高這些模型的準確性和實用性。
NVLink 開關係統
隨著大型語言模型 (LLM) 的需求不斷突破網絡管理的界限,NVIDIA 的 NVLink 交換機系統仍然是一個強大的解決方案。 該系統利用第四代 NVLink 技術和第三代 NVSwitch 架構的強大功能,為 DGX GH256 系統中令人印象深刻的 200 個 NVIDIA Grace Hopper 超級芯片提供高帶寬、低延遲連接。 結果是驚人的 25.6 Tbps 全雙工帶寬,標誌著數據傳輸速度的大幅飛躍。
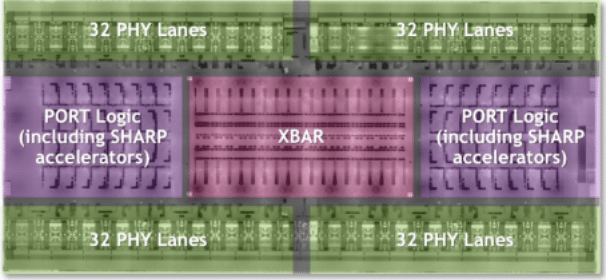
DGX GH200 超級計算機 NVSwitch 第四代 NVLink 邏輯概述
在 DGX GH200 系統中,每個 GPU 本質上都是一個愛管閒事的鄰居,能夠刺探 NVLink 網絡上其他 GPU 的 HBM3 和 LPDDR5X 內存。 與 NVIDIA Magnum IO 加速庫相結合,這個“愛管閒事的鄰居”可以優化 GPU 通信,有效地擴展並加倍降低有效網絡帶寬。 因此,雖然你的法學碩士培訓正在增壓,溝通費用也在增加,但人工智能操作正在得到渦輪增壓。
DGX GH200 中的 NVIDIA NVLink 開關係統能夠通過促進大量 GPU 之間的高帶寬、低延遲連接,顯著增強 LLM 等模型的訓練。 這使得 GPU 之間的數據共享更快、更高效,從而提高模型的訓練速度和效率。 此外,每個 GPU 都能夠從 NVLink 網絡上的其他超級芯片訪問對等內存,從而增加了可用內存,這對於大參數 LLM 至關重要。
雖然 Grace Hopper 超級芯片令人印象深刻的性能無疑是人工智能計算領域的遊戲規則改變者,但該系統的真正魔力發生在 NVLink,其中跨多個 GPU 的高帶寬、低延遲連接可實現數據共享和效率達到一個全新的水平。
DGX GH200系統架構
DGX GH200 超級計算機的架構雖然複雜,但設計卻經過精心設計。 由 256 個 GH200 Grace Hopper 計算托盤和一個 NVLink 交換機系統組成,形成兩層 NVLink 胖樹。 每個計算托盤都裝有 GH200 Grace Hopper Superchip、網絡組件、管理系統/BMC 以及用於數據存儲和操作系統執行的 SSD。
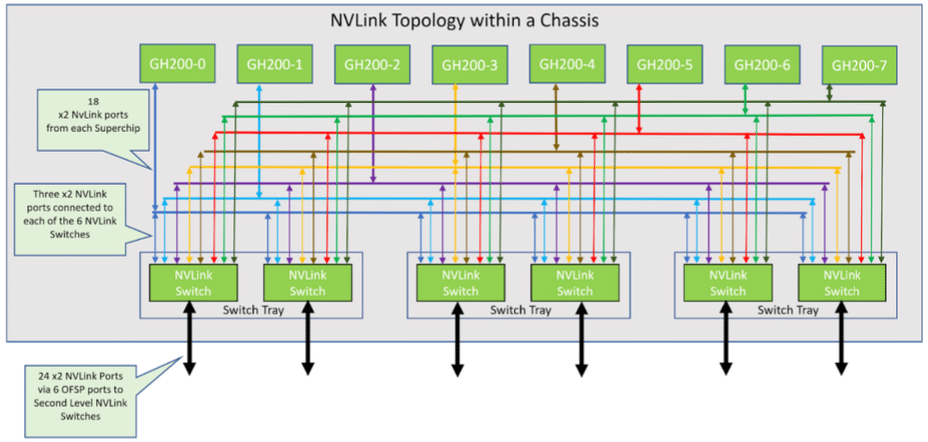
8-GraceHopper Superchip 機箱中的 NVLink 拓撲
| 項目類別 | 信息 |
|---|---|
| CPU / GPU | 1x NVIDIA Grace Hopper 超級芯片,帶 NVLink-C2C |
| 圖形處理器/圖形處理器 | 18 個 NVLink 第四代端口 |
| 網路相關 | 1x NVIDIA ConnectX-7,帶 OSFP: > NDR400 InfiniBand 計算網絡 1x 雙端口 NVIDIA BlueField-3,帶 2x QSFP112 或 1x 雙端口 NVIDIA ConnectX-7,帶 2x QSFP112: > 200 GbE 帶內以太網 > NDR200 IB存儲網絡 帶外網絡: > 1 GbE RJ45 |
| 儲存 | 數據驅動器:2x 4 TB(U.2 NVMe SSD)SW RAID 0 操作系統驅動器:2x 2 TB(M.2 NVMe SSD)SW RAID 1 |
在此設置中,八個計算托盤鏈接到三個一級 NVLink NVSwitch 托盤,以建立單個 8-GPU 機箱。 每個 NVLink 交換機托盤都擁有兩個 NVSwitch ASIC,它們通過定制盲插電纜盒連接到計算托盤,並通過 LinkX 電纜連接到二級 NVLink 交換機。
由此產生的系統包含 36 個二級 NVLink 交換機,連接 32 個機箱,形成綜合性 NVIDIA DGX GH200 超級計算機。 如需了解更多信息,請參閱表 2 了解帶有 Grace Hopper Superchip 的計算托盤的規格,並參閱表 3 了解 NVLink 交換機規格。
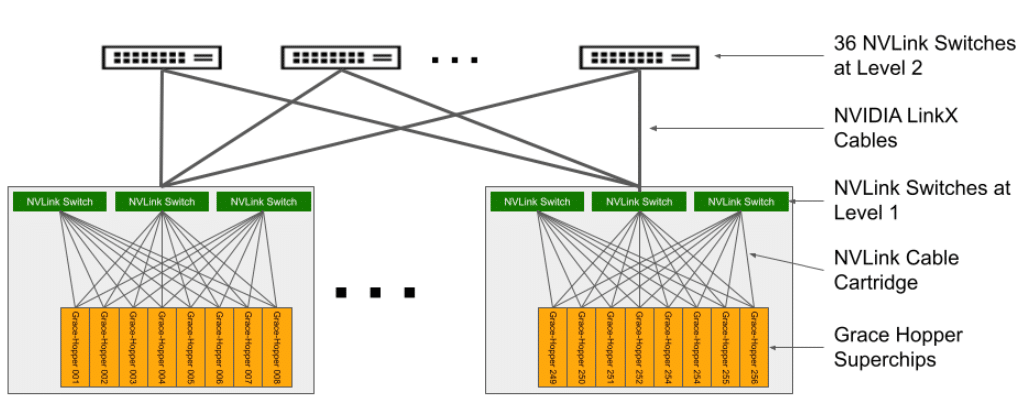
DGX GH200 NVLink 拓撲
DGX GH200的網絡架構
NVIDIA DGX GH200 系統融合了四種複雜的網絡架構,可提供尖端的計算和存儲解決方案。 首先,由 NVIDIA ConnectX-7 和 Quantum-2 交換機構建的計算 InfiniBand 結構形成了軌道優化的全胖樹 NDR400 InfiniBand 結構,可實現多個 DGX GH200 單元之間的無縫連接。
其次,存儲結構由 NVIDIA BlueField-3 數據處理單元 (DPU) 驅動,通過 QSFP112 端口提供高性能存儲。 這建立了一個專用的、可定制的存儲網絡,巧妙地防止流量擁塞。
帶內管理結構作為第三架構,連接所有系統管理服務並促進對存儲池、Slurm和Kubernetes等系統內服務以及NVIDIA GPU Cloud等外部服務的訪問。
最後,以 1GbE 運行的帶外管理結構通過底板管理控制器 (BMC) 監督 Grace Hopper 超級芯片、BlueField-3 DPU 和 NVLink 交換機的基本帶外管理,優化操作並防止與其他服務衝突。
釋放 AI 的力量 – NVIDIA DGX GH200 軟件堆棧
DGX GH200 擁有開發人員所需的所有原始功率; 它不僅僅是一台奇特的超級計算機。 這是關於利用這種力量來推動人工智能向前發展。 毫無疑問,與 DGX GH200 捆綁的軟件堆棧是其突出的功能之一。
這套全面的解決方案包含多個優化的SDK、函式庫和工具,旨在充分發揮硬體的效能,確保高效的應用程式擴充和更佳的效能。然而,DGX GH200軟體堆疊的廣度和深度遠非此處贅述,請務必查閱NVIDIA的相關白皮書,深入了解其軟體堆疊。
DGX GH200 的存儲要求
為了充分利用 DGX GH200 系統的功能,將其與平衡的高性能存儲系統配對至關重要。 每個 GH200 系統都能夠通過 NDR25 接口以高達 200 GB/s 的速度讀取或寫入數據。 對於 256 個 Grace Hopper DGX GH200 配置,NVIDIA 建議採用 450GB/s 的聚合存儲性能,以最大限度地提高讀取吞吐量。
需要通過適當的存儲來推動人工智能項目和底層 GPU 的發展,這是今年夏季最流行的貿易展會巡迴討論。 事實上,我們參加過的每場演出都有其主題演講的某些部分專門討論人工智能工作流程和存儲。 然而,這次討論有多少只是重新定位現有的存儲產品,以及有多少會帶來人工智能存儲的有意義的增強,還有待觀察。 目前下結論還為時過早,但我們從存儲供應商那裡聽到了許多傳言,這些傳言有可能為人工智能工作負載帶來有意義的變化。
跨越了一個障礙,更多的障礙還在後面
雖然 DGX GH200 簡化了人工智能開發的硬件設計,但重要的是要認識到在生成人工智能領域還存在其他相當大的挑戰; 訓練數據的生成。
生成式人工智能模型的開發需要大量的高質量數據。 但原始形式的數據並不能立即使用。 它需要大量的收集、清理和標記工作,以使其適合訓練人工智能模型。
數據收集是第一步,涉及獲取和積累大量相關信息,這通常既耗時又昂貴。 接下來是數據清理過程,需要一絲不苟地關注細節,以識別和糾正錯誤,處理丟失的條目,並消除任何不相關或冗餘的數據。 最後,數據標記的任務是監督學習的一個重要階段,涉及對每個數據點進行分類,以便人工智能能夠理解並從中學習。
訓練數據的質量至關重要。 骯髒、質量差或有偏見的數據可能會導致人工智能做出不准確的預測和有缺陷的決策。 仍然需要人類專業知識,並且需要付出巨大的努力來確保培訓中使用的數據既充足又具有最高質量。
這些過程並非易事,需要大量的人力和資金資源,包括對訓練資料的專業知識,這凸顯了人工智慧開發除了硬體之外的複雜性。 NeMo Guardrails等專案正在努力解決其中的一些問題,旨在確保生成式人工智慧的準確性和安全性。
關閉的思考
NVIDIA DGX GH200 是一個完整的解決方案,旨在重新定義人工智能領域。 憑藉其無與倫比的性能和先進功能,它成為推動人工智能未來發展的遊戲規則改變者。 無論您是希望突破可能性界限的 AI 研究人員,還是希望利用 AI 力量的企業,DGX GH200 都是一款可以幫助您實現目標的工具。 隨著原始計算能力變得更加普遍,觀察如何處理訓練數據的生成將會很有趣。 在有關硬件版本的討論中,這一方面經常被忽視。
考慮到所有因素,重要的是要承認 DGX GH200 系統的高成本。 DGX GH200 並不便宜,其高價標籤使其完全屬於最大的企業和資金最雄厚的人工智能公司(NVIDIA,打我,我想要一個)的領域,但對於那些有能力負擔得起的實體DGX GH200 代表了一種範式轉變的投資,有可能重新定義人工智能開發和應用的前沿。
隨著越來越多的大型企業採用這項技術並開始創建和部署先進的人工智能解決方案,它可能會導致人工智能技術更廣泛的民主化。 創新有望滲透到更具成本效益的解決方案中,使小公司更容易使用人工智能。 基於雲的 DGX GH200 計算能力訪問變得越來越廣泛,使小型企業能夠按使用付費的方式利用其功能。 雖然前期成本可能很高,但 DGX GH200 的長期影響可能會波及整個行業,有助於為各種規模的企業創造公平的競爭環境。


 Amazon