

NVIDIA正式發布了NVIDIA Groq 3 LPX,這是一款專為 Vera Rubin NVL72 平台打造的互動式推理加速器。隨著企業級 AI 工作負載從原始模型預訓練轉向即時推理和自主代理編排,基礎設施需求也在改變。代理工作流程需要迭代式的多步驟執行,其中令牌產生過程中的延遲會累積到自動化推理路徑、外部工具查詢和多代理通訊中。
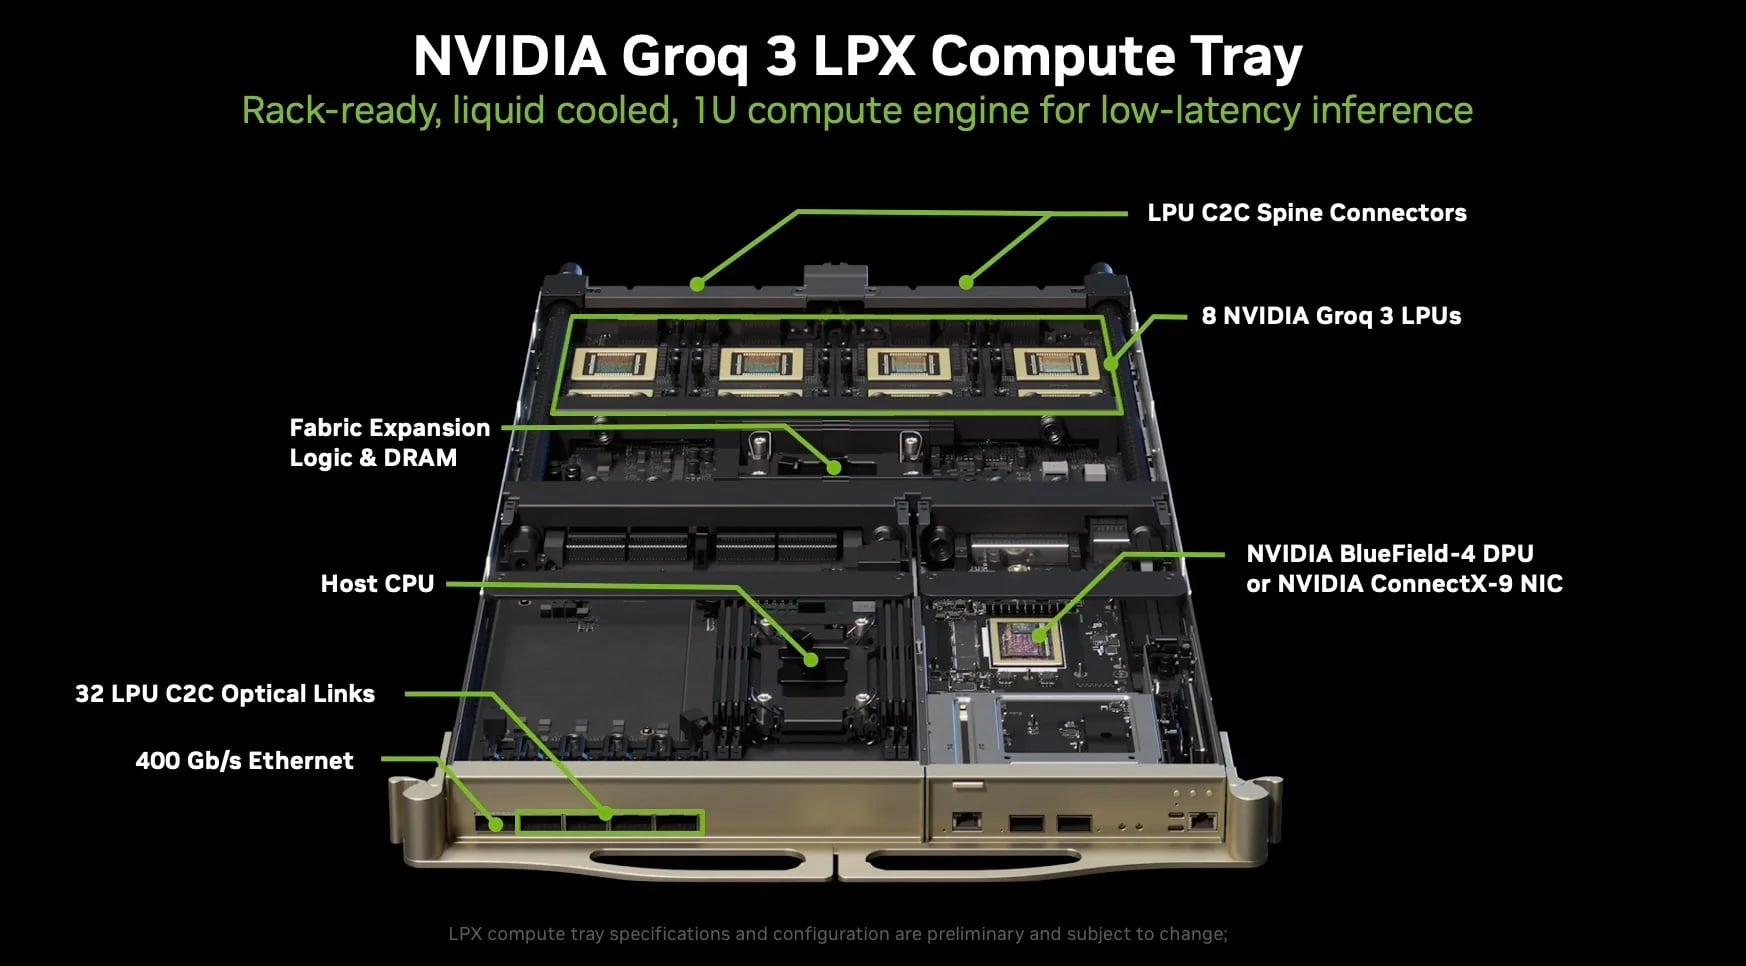
Groq 3 LPX 架構尤其擅長解碼階段。每個 2U 液冷運算托架都搭載 16 個 Groq 3 LPU,以及主機 CPU、擴充邏輯和 DRAM,並配備 BlueField-4 DPU 或 ConnectX-9 網路卡,正面設有 32 個 LPU 晶片間光鏈路和 400Gb/s 乙太網路介面。在與 Vera Rubin NVL72 系統協同部署的異質環境中,NVIDIA Rubin GPU 負責處理大量輸入資料集的上下文資訊擷取和預填充計算,而 Groq 3 LPX 單元則負責處理對延遲敏感的令牌輸出產生。
架構和基準性能
在運行開源 Gemma 4 31B 模型並啟用 10 萬個令牌的活動上下文視窗後,Groq 3 LPX 的標準 Artificial Analysis 效能評估達到了每秒 3,400 個令牌的輸出速率。 NVIDIA 指出,此吞吐量比在相同長上下文參數下效能最接近的替代平台快 4 倍,Artificial Analysis 也將其記錄為該模型測得的最快結果。值得注意的是,NVIDIA 的資料來自 8 月 21 日在私有預發布端點上測得的結果,而其他資料則來自實際的無伺服器生產端點。對於需要持續解析龐大程式碼庫、複雜 API 模式和密集技術文件的企業代理架構而言,在 10 萬個代幣的視窗內保持極高的產生速度至關重要。
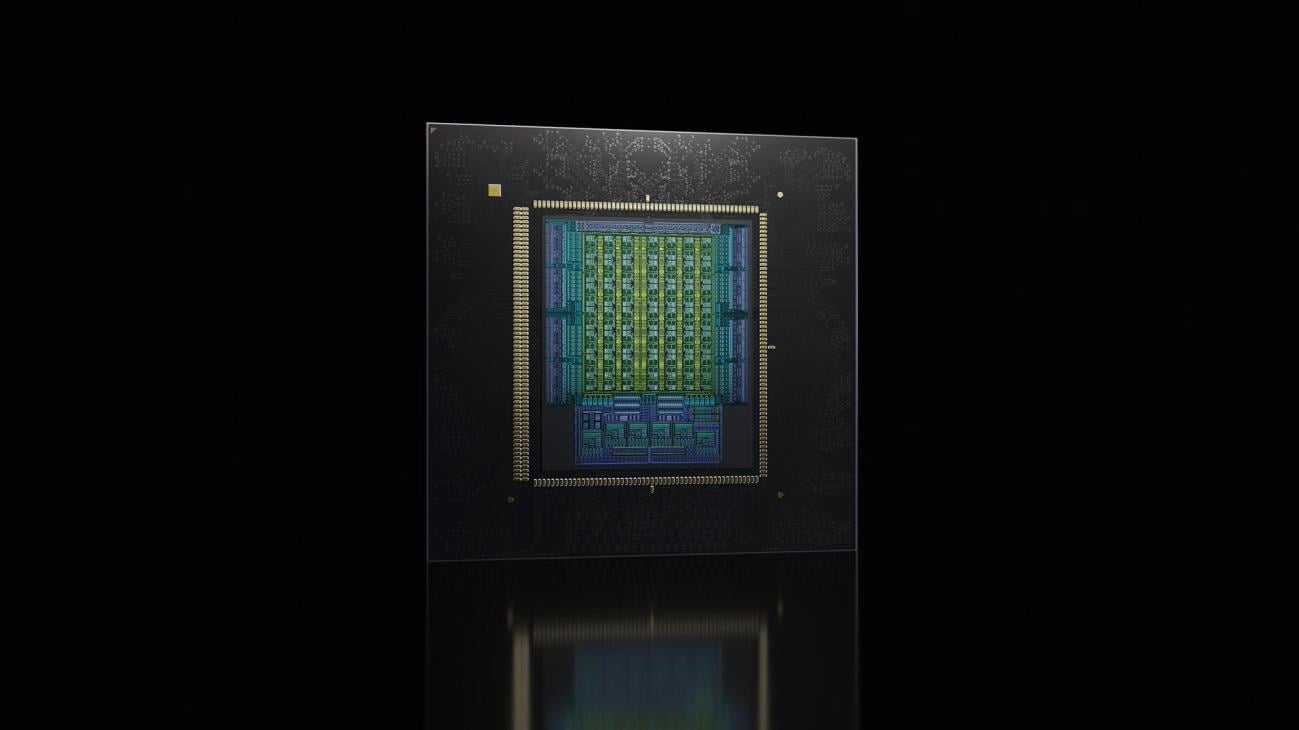

從實體系統架構的角度來看,機架級 Groq 3 LPX 部署包含多達 256 個 LP30 加速器,這些加速器透過高速、直接的晶片間互連連接。
雲端部署和系統生態系統
目前,專業雲端服務供應商已開始早期商業化採用該技術。 Nebius 已被指定為首家部署 Groq 3 LPX 的 AI 雲端合作夥伴,並計劃將該硬體整合到其 Nebius Token Factory 生產推理服務中。該架構旨在讓開發人員透過現有的 API 介面存取即時推理加速功能,而無需將程式碼庫遷移到新的框架抽象層。推理服務提供者 Groq 預計將成為該平台的首批採用者之一。


NVIDIA 為此次發布會同時更新了其所搭載機架的平台性能數據,聲稱在 140,000 萬個令牌的智能體編碼工作負載下,Vera Rubin NVL72 的每兆瓦令牌吞吐量比 GB300 NVL72 高達 30 倍,並且隨著用戶交互目標的提高,這一優勢還會進一步擴大。該硬體實現方案與 NVIDIA 的全端 Rubin AI 工廠基礎設施完美契合,該基礎設施包含七款獨立晶片,並採用五種專用機架配置。
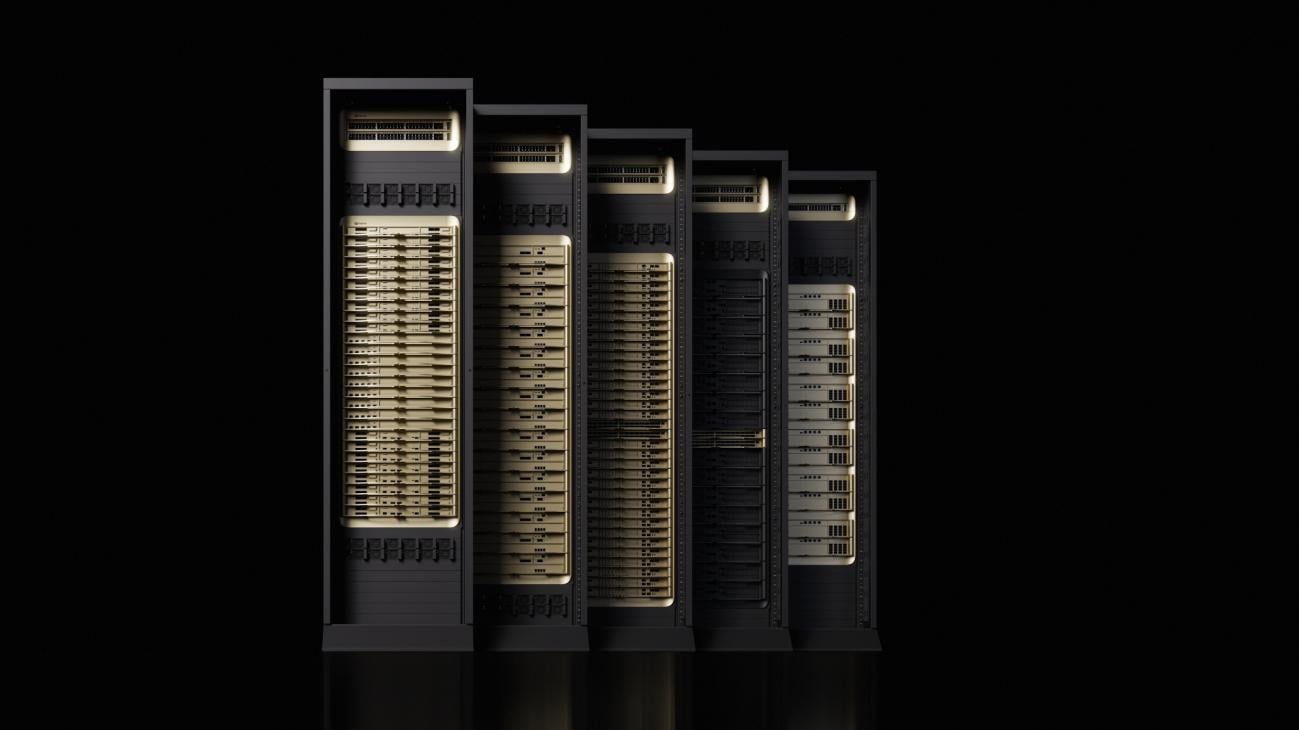
與 Rubin 和 LPX 運算叢集一起運作的系統元素包括 NVIDIA Vera CPU 機架、Vera BlueField-4 STX 儲存陣列和 NVIDIA Spectrum-6 SPX 網路架構。
NVIDIA 和 Nebius 的說法
「推理是人工智慧的成長引擎。NVIDIA 的 Grace Blackwell 和 NVL72 以前所未有的性能和效率飛躍,徹底革新了大型語言模型推理,」NVIDIA 創始人兼首席執行官黃仁勳表示。 “Vera Rubin 進一步拓展了這一願景,推出了專為智能體人工智能時代設計的、針對工作負載優化的 AI 工廠配置,並通過 LPX 技術實現了超快速的令牌生成,從而進一步提升了性能。”
Nebius 從使用者實際體驗的角度闡述了延遲的價值。 「生成階段決定了 AI 系統的反應速度,而 NVIDIA Groq 3 LPX 正是為此而生,旨在加速這一階段,」Nebius 首席技術長 Danila Shtan 表示。 “作為首個透過 Nebius Token Factory 將其投入生產環境的 AI 雲端平台,我們確保代理循環中的每一步都流暢無阻,而且開發者無需遷移到新的技術棧,即可使用他們已經在使用的同一 API。”
Spectrum-X 多平面和可擴展基礎設施
為了滿足這些推理工廠的海量網路需求,NVIDIA重點展示了其Spectrum-X多平面乙太網路架構。傳統的叢集擴展若要突破現代密度限制,通常需要增加第三層交換,這會帶來延遲增加、光纖成本上升以及功耗開銷。 Spectrum-X多平面架構透過將主機網路介面拆分為多個獨立的平面來規避這些問題,每個平面運行一個扁平的雙層網絡,可擴展至512,000個GPU。

NVIDIA ConnectX-9 SuperNIC 晶片負責處理流量管理和故障緩解,當與 102.4 Tb/s Spectrum-6 乙太網路 ASIC 配合使用時,每個 GPU 的網路速度最高可達 1,600 Gb/s。 Spectrum-XGS 乙太網路在不同設施間擴展了相同的協同設計,NVIDIA 表示,這可將多站點 NCCL 叢集的運行速度提升 1.9 倍。在八平面拓撲結構中,硬體故障轉移可立即繞過故障路徑重新路由流量,從而保持約 90% 的聚合網路頻寬。 NVIDIA 表示,硬體恢復速度比基於軟體的多平面負載平衡快 11 倍,這意味著 AI 工廠的產出可提高 1.6 倍。

同時,NVIDIA 推出了 Scale-In 網路架構,將 BlueField-4 資料處理單元與DOCA 軟體堆疊結合。 Scale-In 的目標是南北向基礎設施架構,將多租戶隔離、線速晶片內加密、遙測和高效能儲存資料路徑從主機處理器卸載。
用於客製化矽集成的 NVLink Fusion
NVIDIA 也推出了需要混合架構的超大規模營運商的 NVLink Fusion。該框架允許第三方客製化 XPU 和 CPU 直接與 NVIDIA 第六代 NVLink 和 NVLink-C2C 橫向擴展網路架構整合。透過利用模組化的 NVIDIA MGX 機箱藍圖和管理軟體,資料中心營運商可以標準化共享電源、散熱和網路機架設計,並根據工作負載的變化調整 GPU、LPU 和客製化晶片的具體比例。
NVIDIA 在 Hot Chips 大會上宣布了第二個 Vera Rubin 的消息:SpaceXAI 正在為 Grok 背後的代理工作負載採用 Vera CPU,併計劃將優化的 Vera Rubin NVL72 送入軌道,搭載在其第一代 Starmind 衛星上。


 Amazon