

在2025年台北國際電腦展上,NVIDIA發布了一系列令人興奮的公告。該公司推出了涵蓋半客製化人工智慧基礎設施、企業級人工智慧工廠、普及化的人工智慧開發工具以及用於人形機器人的先進平台等新技術,這標誌著人工智慧與運算和工業的各個方面融合的進程正在顯著加快。
NVLink Fusion:開啟半客製化 AI 基礎架構新時代
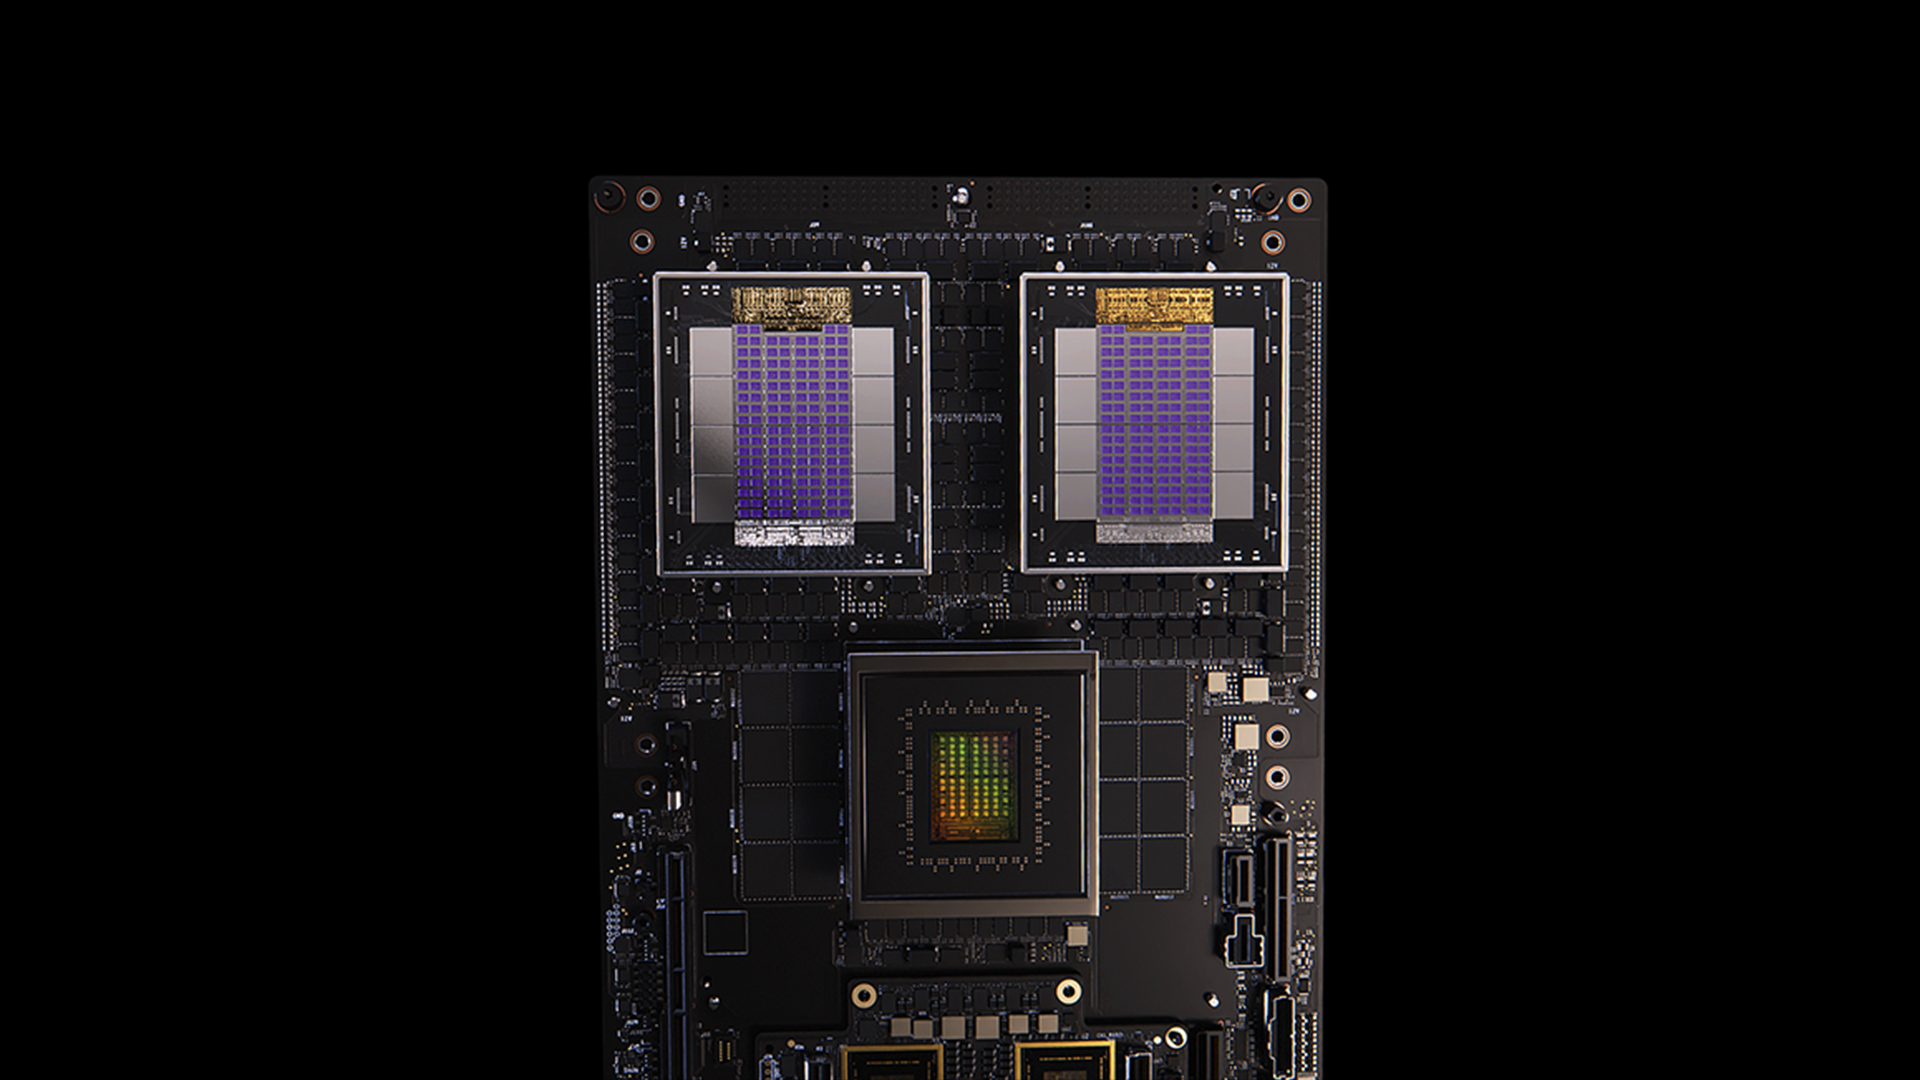
台北國際電腦展 (Computex) 上的一項重要公告是 NVIDIA 開放 NVLink 的大門。借助 NVIDIA NVLink Fusion,該公司提供 IP 和新的矽基礎,使各行各業能夠透過將其技術與其先進的互連相結合來建立半客製化的 AI 基礎設施。
客戶可以開發客製化的ASIC晶片,也可以將CPU直接連接到高效能的擴充架構。例如,企業可以使用C2C鏈路將客製化的CPU與NVIDIA GPU配對,或者反過來,將專用的AI ASIC晶片與NVIDIA的CPU(例如Grace或即將推出的Vera)集成,所有這些都透過NVLink互連。目前一代晶片間接口在CPU和GPU之間提供高達900GB/s的雙向頻寬。同時,更廣泛的第五代NVLink平台為每個GPU提供高達1.8TB/s的雙向頻寬。

這對業界來說是一個令人興奮的消息。建造 AI 加速器的公司現在有一個引人注目的選擇:他們可以選擇新興的開放標準,例如 UALink雖然其倡議開放,但目前仍落後於 NVIDIA 既定的互連速度,並且仍處於開發階段。或者,借助 NVLink Fusion,他們可以與目前最快的擴展互連集成,立即獲得尖端性能和 NVIDIA 全面而成熟的軟體套件。

許多產業合作夥伴已加入其中。採用 NVLink Fusion 創建客製化 AI 晶片和專用基礎設施的主要參與者包括 ASIC 和 IP 合作夥伴聯發科、Marvell、Alchip Technologies、Astera Labs、Synopsys 和 Cadence。此外,CPU 創新者富士通和高通技術公司也計劃建構與 NVIDIA GPU 和 NVLink 生態系統結合的客製化 CPU。
Blackwell Pro 6000 伺服器:輔助企業 AI 工廠

NVIDIA 在 Computex 上發布的另一項重要公告是關於利用 NVIDIA RTX PRO Blackwell 伺服器徹底改變企業 AI。雖然核心 GPU RTX PRO 6000 Blackwell 與工作站 GPU 共享強大的架構,但它與更標準伺服器設計的整合透過獨特的創新得到了顯著增強:NVIDIA ConnectX-8 (CX8),黃仁勳將其描述為「首先是交換機,其次是網路晶片」。

真正的突破在於CX8如何實現伺服器內部GPU之間以及跨伺服器的高速東西向通訊。正如黃仁勳所提到的,這項功能使RTX PRO 6000 GPU能夠高效通信,從而應對高要求的推理工作負載,其高頻寬互連能力堪比旗艦級Blackwell GB200和GB300 AI工廠系統上的NVLink技術。這種GPU之間的直接通訊繞過了速度較慢的傳統路徑,使RTX PRO Blackwell伺服器成為企業級推理應用的卓越之選。與NVIDIA Dynamo等軟體搭配使用時,這些伺服器能夠實現高效且可擴展的AI代理部署和運作。

我們還看了實際的主機板。它具有八個 PCIe 插槽,可容納 RTX PRO 6000 Blackwell GPU。除此之外,還有八個 PCIe 連接回主機板。並且,展會的明星是由 800 個 CX4 晶片驅動的八個 8Gbps 網路連接。這些高速連接埠實現了強大的伺服器間通信,使企業能夠透過將多台 RTX PRO Blackwell 伺服器聯網成強大的叢集來擴展其推理能力。
最後,黃仁勳強調了效能的飛躍,他展示了基準測試,表明新的 RTX PRO Blackwell 伺服器在 Lama 1.7B 推理方面提供的效能是 Hopper H100 HGX 系統的 70 倍。更令人印象深刻的是,對於 DeepSeek R1 型號,Blackwell 伺服器的效能比上一代最先進的 H100 提高了四倍。每秒令牌數和每秒每位使用者令牌數的顯著提升凸顯了伺服器處理高吞吐量和低延遲互動式人工智慧任務的能力。
人形機器人、Nvidia Jetson Thor 和 GR00T 專案:推進物理 AI 的前沿
NVIDIA 還重點介紹了其在新興人形機器人領域的計劃,並公佈了其 NVIDIA Isaac 平台的重大進展,旨在加速「實體 AI」的發展。黃仁勳表示,全新 Jetson Thor 機器人處理器是該計畫的核心,目前已開始生產。 Jetson Thor 被設計為新一代人形機器人和自主系統的強大、節能的大腦。

與硬體相輔相成的是 NVIDIA Isaac GR00T N1.5,這是 NVIDIA 用於人形機器人推理和技能的開放、通用基礎模型的更新版本。黃宣布 GR00T N1.5 現已開源,並且已引起人們的極大興趣,下載量達數千次。該模型旨在為機器人提供理解複雜指令並在動態人類環境中執行各種任務的智慧。
機器人領域的一項關鍵挑戰在於獲取龐大且多樣化的訓練資料集。 NVIDIA 推出的 Isaac GR00T-Dreams 解決了這個難題。 Isaac GR00T-Dreams 是突破性的藍圖,它是基於 NVIDIA Cosmos 實體 AI 世界基礎模型建構而成。黃仁勳將其詳細闡述為一種“真實到真實的數據工作流程”,巧妙地利用 AI 來增強人類演示的效果。開發者可以透過人類遠端操控的初始任務演示來微調 Cosmos 模型。然後,他們可以使用 GR00T-Dreams 向模型輸入新的場景或指令,從而產生大量「夢境」——即機器人執行新動作的合成影片序列。這些 2D 夢境影片會被轉換為 3D 動作軌跡,用於訓練 GR00T 機器人模型。 「因此,現在只需一小隊人類演示人員就能完成數千人的工作,」黃仁勳解釋道,並強調了這項技術如何顯著擴展數據生成規模。
整個生態系統包括現在在 GitHub 上開源的用於模擬的 Isaac Sim、用於機器人學習的 Isaac Lab、與 Google DeepMind 和迪士尼研究中心共同開發的先進牛頓物理引擎以及 Cosmos 世界模型,提供了一個全面的雲端到機器人平台。黃仁勳預計,“物理人工智慧和機器人技術將帶來下一場工業革命”,人形機器人特別適合“棕地”人類環境,有可能成為“下一個數萬億美元的產業”。
DGX Spark、Station 和 Cloud Lepton
NVIDIA 持續努力實現高效能運算,並對其 DGX 產品進行關鍵更新,從全球雲端市場到強大的個人 AI 超級電腦。
一項重要的新舉措是 NVIDIA DGX Cloud Lepton,這是一個具有運算市場的人工智慧平台,旨在將全球人工智慧開發人員與數以萬計的 GPU 連接起來。該平台旨在統一來自 NVIDIA 雲端合作夥伴全球網路(例如 CoreWeave、Crusoe、富士康和軟銀公司)的雲端 AI 服務和 GPU 容量存取。這些合作夥伴將在 DGX Cloud Lepton 市場上提供 NVIDIA Blackwell 和其他 NVIDIA 架構 GPU。開發人員可以利用特定區域的運算能力來滿足按需和長期需求,支援策略性和主權的人工智慧營運。 DGX Cloud Lepton 與 NVIDIA 的軟體堆疊(包括 NIM 和 NeMo 微服務)集成,以簡化 AI 應用程式的開發和部署,並與其 NCP 合作創建一個行星級的 AI 工廠。
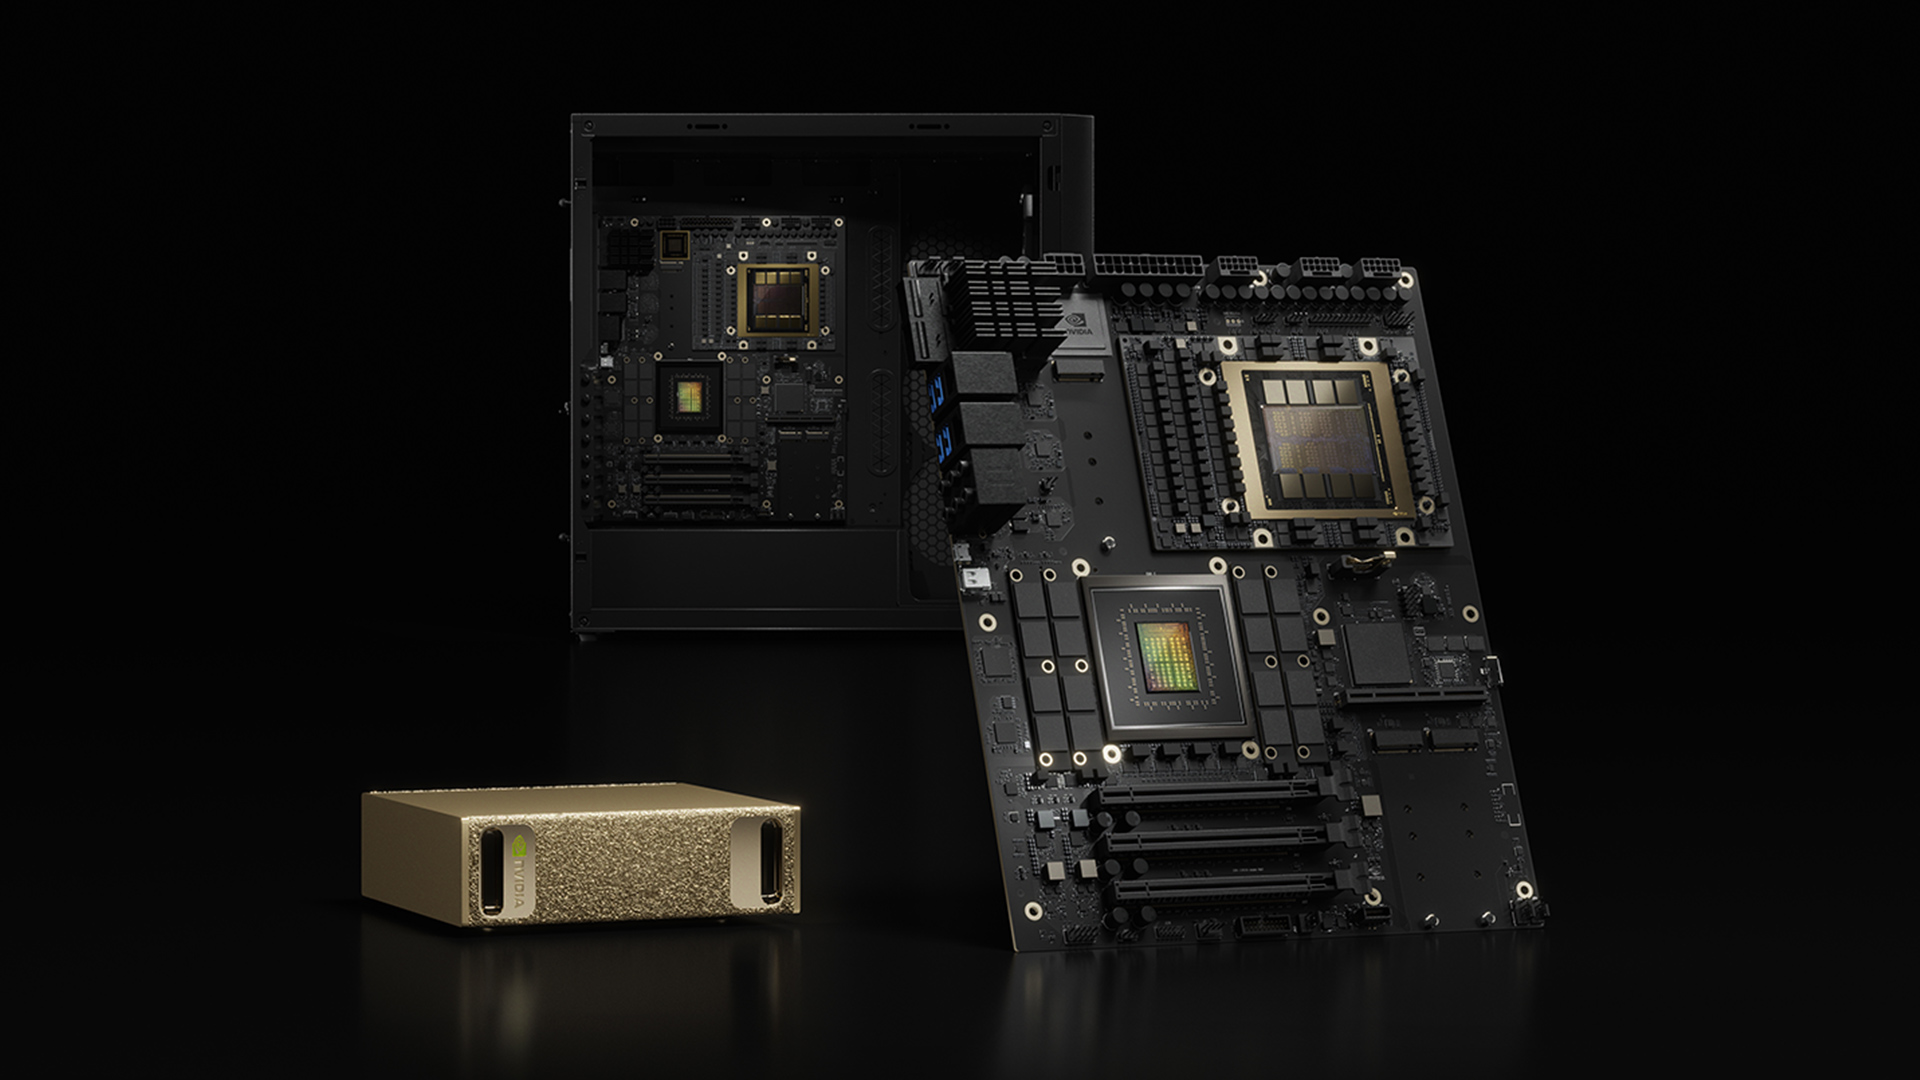
DGX Cloud Lepton 專注於廣泛的雲端訪問,而 NVIDIA 則強調了其個人 AI 超級電腦 NVIDIA DGX Spark 和 DGX Station 不斷擴展的生態系統。重點是透過更多的供應商發展合作夥伴關係並提高可用性。這些系統定位為人工智慧原生計算機,面向需要專用人工智慧雲端環境的開發人員、學生和研究人員。
- DGX Spark 由 NVIDIA GB10 Grace Blackwell 超級晶片提供支持,可提供高達 1 petaflop 的 AI 運算能力。目前,該產品已全面投入生產,並將很快透過更多合作夥伴推出,包括宏碁、華碩、戴爾科技、技嘉、惠普、聯想和微星。
- DGX Station 也得到了更廣泛的合作夥伴採用,其採用 NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip,可實現高達 20 petaflops 的 AI 性能。它將於今年稍後由華碩、戴爾科技、技嘉、惠普和微星推出,提供能夠運行萬億參數 AI 模型的桌面解決方案。
Nvidia RTX 5060 發布

NVIDIA 也在 Computex 上發布了 NVIDIA GeForce RTX 5060,作為其廣泛發布的成果。 RTX 5060 即日起以合作夥伴的附加卡形式和整合到新遊戲筆記型電腦中的形式發售,旨在為更廣泛的受眾提供引人注目的性能和功能。
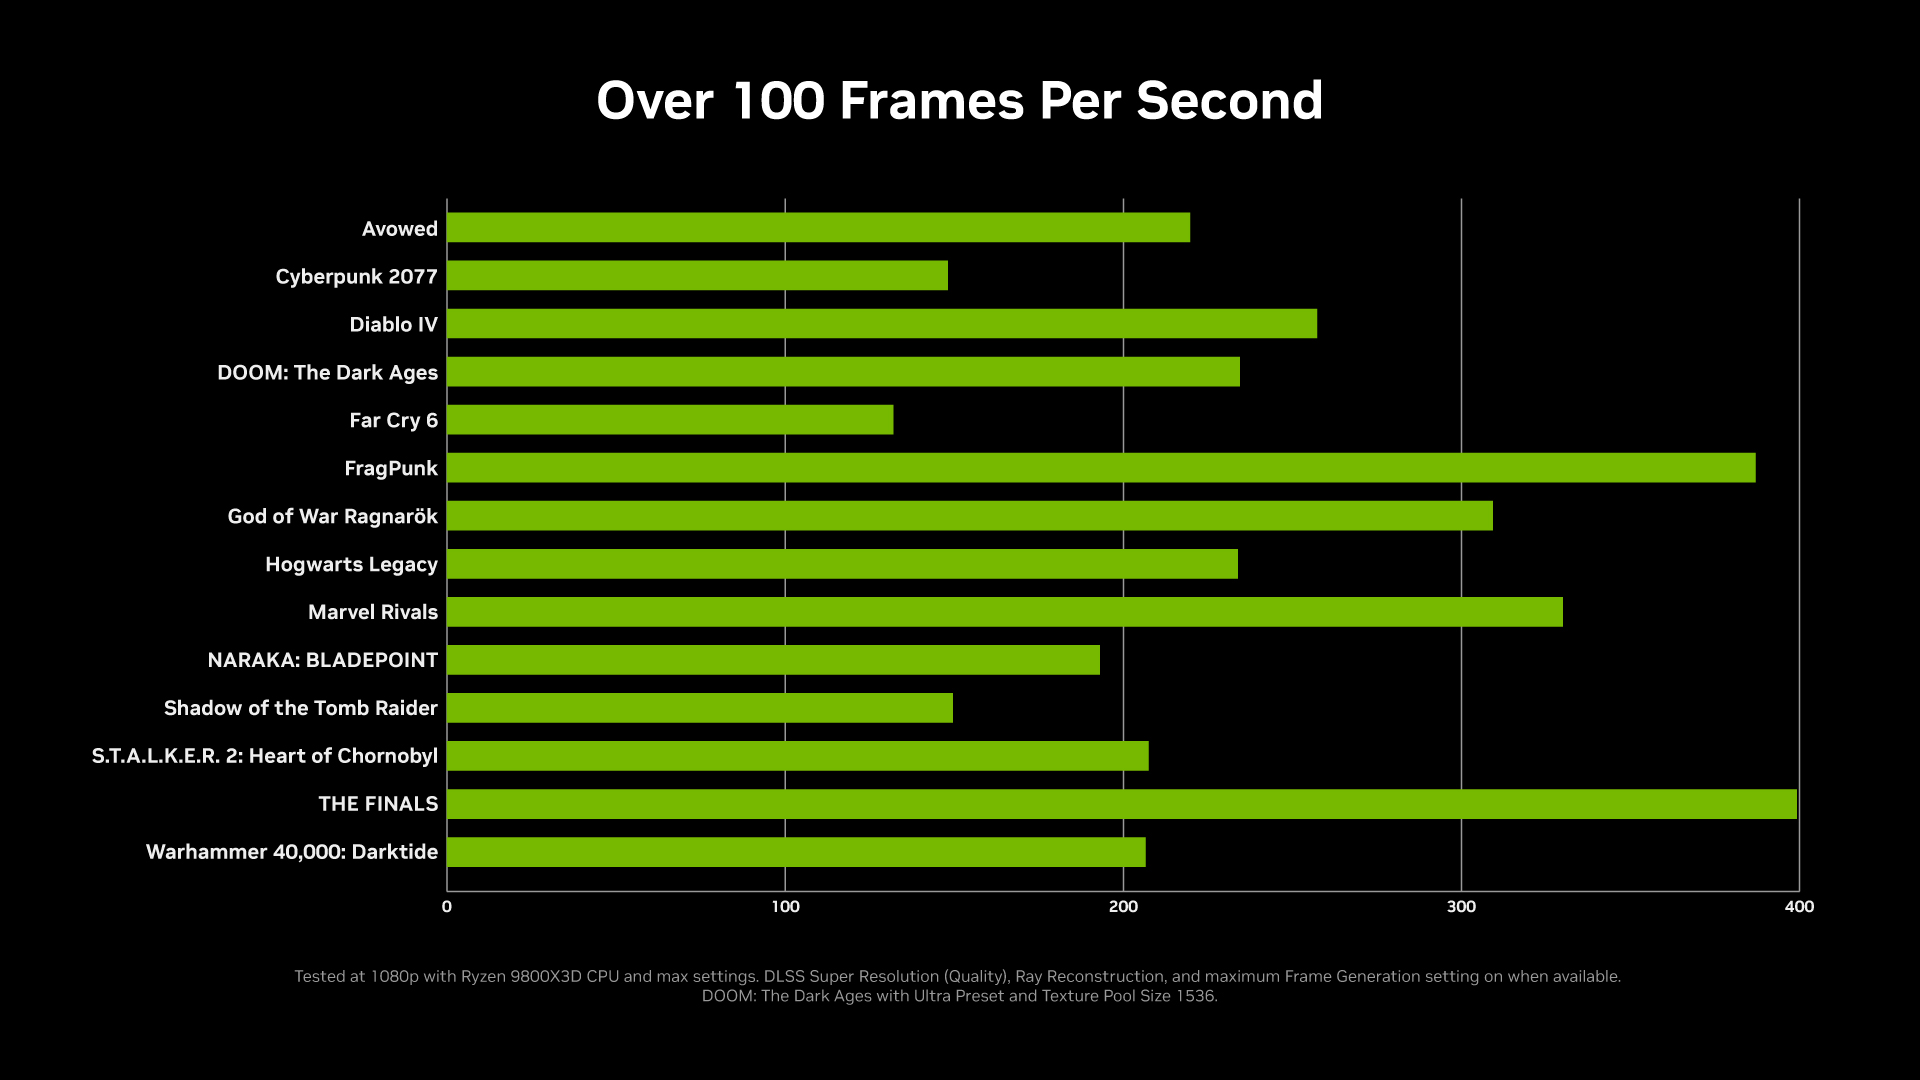
RTX 5060 基於 Blackwell 架構構建,支援 DLSS 4,利用 NVIDIA 最新的 AI 超解析度和幀生成技術。它擁有 614 AI TOPS(INT4),可增強 AI 處理能力。該卡具有第五代 Tensor 核心和第四代 RT 核心,可提高光線追蹤和 AI 性能。對於媒體處理,它包括一個第 5 代 NVIDIA 編碼器 (NVENC) 和一個第 4 代 NVIDIA 解碼器 (NVDEC)。 RTX 9 擁有 6GB GDDR5060 內存,提供 8 GB/秒的內存頻寬,確保現代遊戲和創意工作負載的流暢性能。
這些更新共同體現了 NVIDIA 的策略,即透過龐大的雲端網路或專用的高效能桌面系統,使強大的 AI 工具和運算資源更容易獲得,確保各種規模的開發人員都能參與 AI 革命。


 Amazon