

Pliops宣布與vLLM Production Stack建立策略夥伴關係。 vLLM Production Stack是一個開源的叢集級參考實現,旨在優化大型語言模型(LLM)推理工作負載。隨著人工智慧社群即將齊聚GTC 2025大會,此次合作意義重大。透過將Pliops先進的鍵值(KV)儲存後端與vLLM Production Stack強大的架構結合,此次合作將為人工智慧的效能、效率和可擴充性樹立新的標竿。
芝加哥大學 LMCache 實驗室主任蔣俊辰強調了此次合作的潛力,強調其能夠提高 LLM 推理效率和性能。聯合解決方案透過在高頻寬記憶體(HBM)下方引入新的 PB 級記憶體層,帶來了先進的向量搜尋和檢索功能。使用分解的智慧儲存可以有效地保留和檢索計算的 KV 緩存,從而加速 vLLM 推理。
想了解 Pliops 的入門知識,請查看我們的深度解析文章。
關於 KVCache
大多數大型語言模型使用轉換器架構,它依賴涉及查詢、鍵和值矩陣的注意機制。在順序產生 token 時,Transformer 會重複計算注意力,需要重新計算先前的鍵和值 (KV) 矩陣,從而增加計算成本。 KV 快取透過儲存先前計算的 KV 矩陣來解決這個問題,允許在後續的 token 預測中重複使用,從而顯著提高生成效率和吞吐量。
然而,這帶來了新的挑戰。 KV 快取可能會變得非常大,特別是在長時間生成或批次推理期間(典型批次大小為 32),最終會超出可用記憶體。為了解決這個限制,KV 快取儲存後端變得至關重要。
Pliops XDP LightningAI
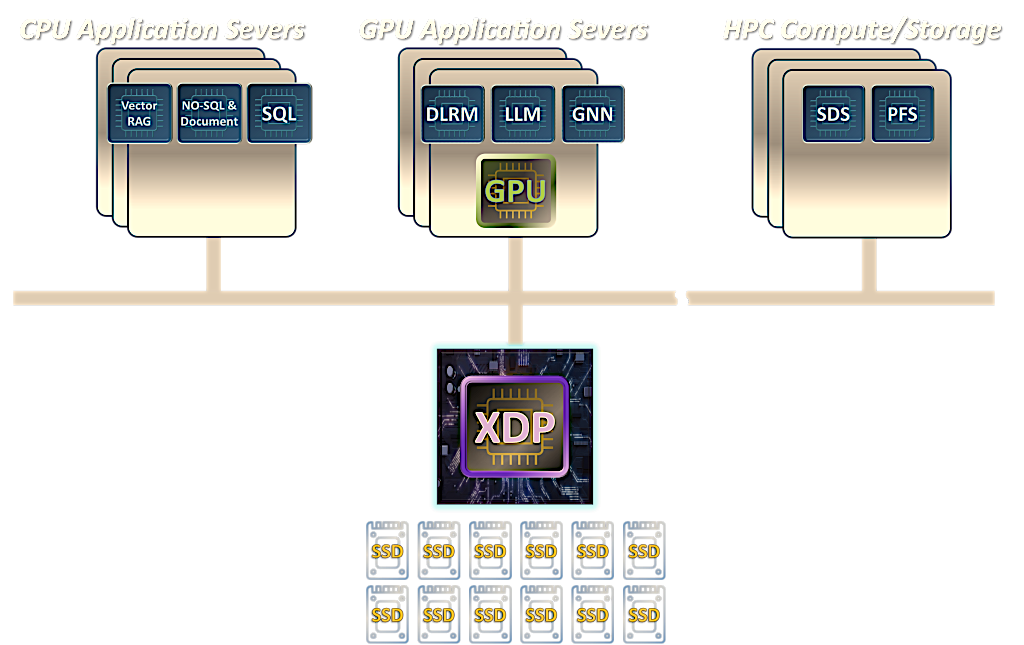
在資料中心部署 Pliops 的 XDP LightningAI 代表著成本效益的典範轉移,與傳統架構相比可節省大量成本。透過在現有基礎設施中添加專用的 XDP LightningAI 伺服器,組織可以實現顯著的節省,包括機架空間優化 67%、功耗降低 66%、年度營運支出節省 58% 以及初始投資成本降低 69%。
Pliops 繼續推進其極端資料處理器 (XDP) XDP-PRO ASIC,並輔以全面的 AI 軟體堆疊和分散式節點。該解決方案利用 GPU 發起的鍵值 I/O 接口,實現了前所未有的可擴展性和性能。 Pliops 的 XDP LightningAI 實現了顯著的端到端效能改進,使 vLLM 推理的效能提高了 8 倍,顯著加速了生成式人工智慧 (GenAI) 的工作負載。 Pliops 透過融合 DeepSeek 等前沿產業趨勢,確保了對未來 AI 發展強大的適應性。
Pliops 在 AI DevWorld 上展示了這些進步,重點介紹了 XDP LightningAI 如何透過顯著降低運算能力和成本來徹底改變 LLM 效能。此次演示體現了 Pliops 致力於實現企業級永續 AI 創新的決心。
持續合作
Pliops 使組織能夠最大限度地發揮人工智慧驅動洞察力的潛力,透過提供可操作資料的即時存取並確保無縫的整合路徑,在快速發展的技術環境中保持競爭優勢。
此次合作的未來發展路線圖包括將 Pliops 的 KV-IO 堆疊整合到生產堆疊中,並逐步實現進階功能,例如跨多輪對話的快速快取、可擴展的 KV 快取卸載和簡化的路由策略。


 Amazon