

華碩 ExpertCenter Pro ET900N G3 是我們測試的第二款 GB300 DGX 工作站,也是我們第一款在實驗室進行實際操作的同類產品;我們先前對 MSI XpertStation WS300 的測試是遠端進行的。它採用了與我們在 MSI XpertStation WS300 中測試的相同的 NVIDIA 晶片:Grace Blackwell Ultra Desktop Superchip,擁有 72 個 Grace 核心、B300 GPU、252GB HBM3e 顯存、496GB LPDDR5X 記憶體以及配備兩個 400Gb 埠的 SuperNIC-8 埠。華碩將這款核心平台封裝在一個簡潔的塔式機箱中,專為桌面 AI 而設計,並添加了一些 WS300 所沒有的亮點:頂部兩個提手、一個專門用於 ConnectX-8 光驅籠的風扇,以及一個 1,600W 的 80 PLUS 鈦金認證電源。
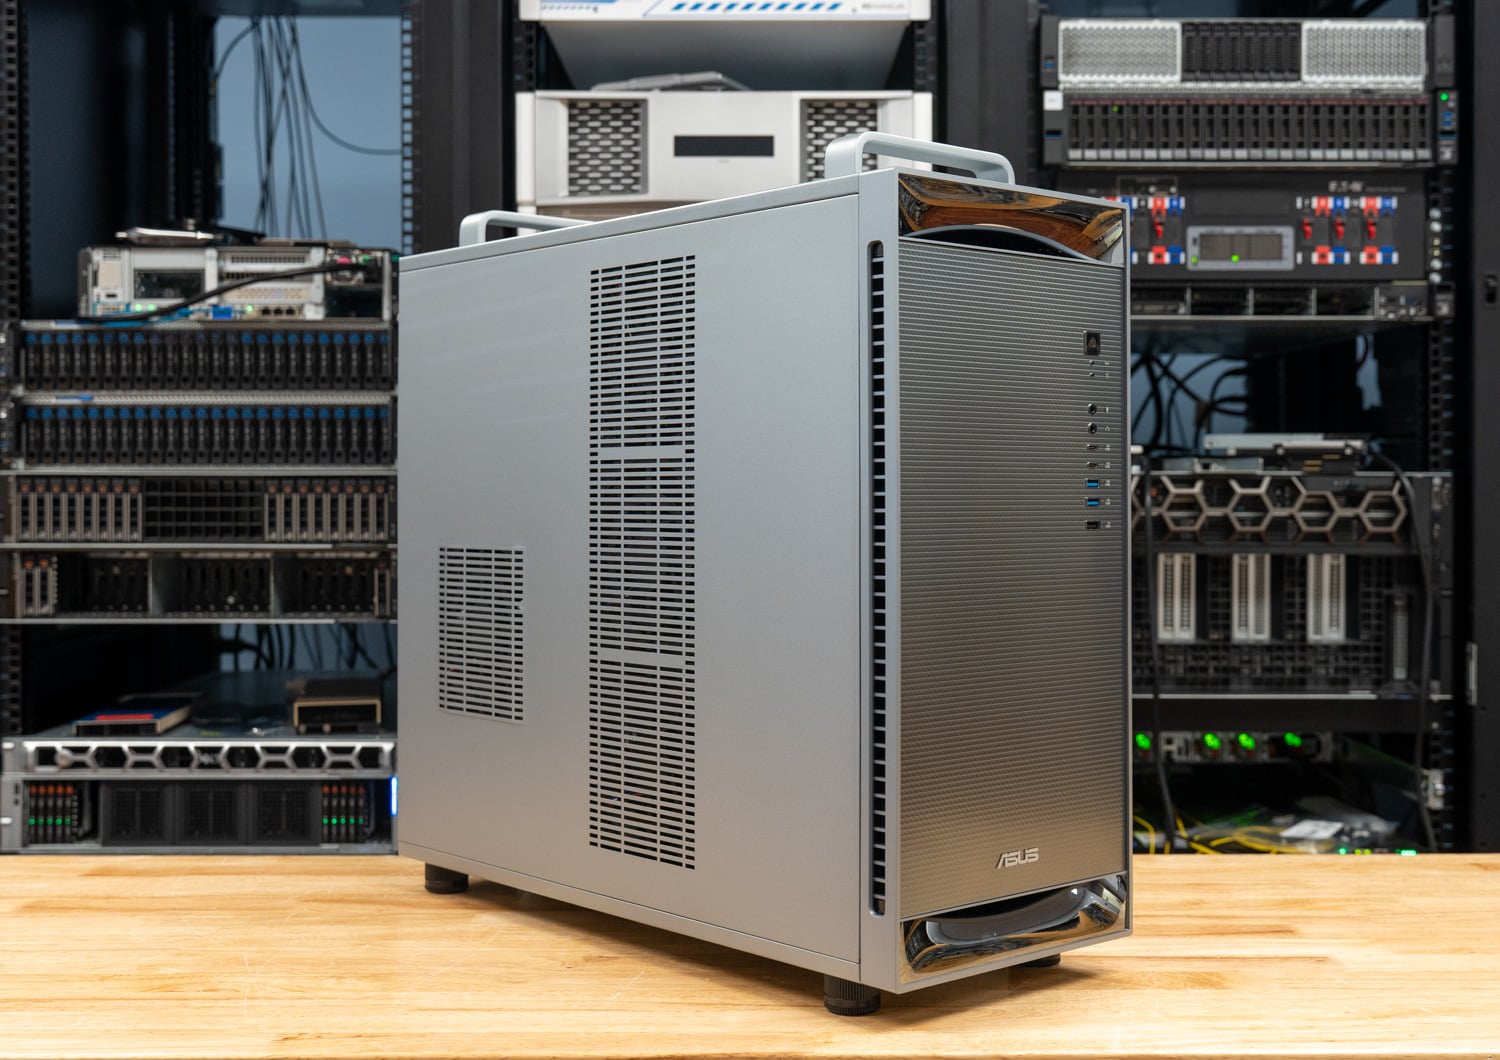
華碩將一台搭載 RTX PRO 2000 顯示卡的 ET900N G3 機殼寄到實驗室,進行了一週左右的基準測試、拍照和外觀檢查。關於該平臺本身、B300 晶片、Grace 晶片、NVLink-C2C 晶片、MIG 焊盤以及 DGX Station 工作站的用途,WS300 評測已經涵蓋了這些內容。本次評測的重點在於華碩圍繞 Superchip 晶片打造的產品,以及其性能是否能與我們先前測試過的第一款 GB300 塔式機殼相媲美。
華碩 ExpertCenter Pro ET900N G3 規格
| 規格 | 華碩 ExpertCenter Pro ET900N G3 |
|---|---|
| 平台概述 | |
| 超級晶片 | NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip |
| 中央處理器 | NVIDIA Grace,72 個 Arm Neoverse V2 內核 |
| GPU | NVIDIA Blackwell Ultra (B300),最高可達 20 PFLOPS NVFP4 稀疏性 |
| CPU-GPU互連 | NVLink-C2C,900GB/s 雙向 |
| 記憶體應用 | |
| 連貫記憶 | 748GB |
| GPU內存 | 252GB HBM3e,7.1TB/s |
| CPU內存 | 496GB LPDDR5X,396GB/s,4x SOCAMM |
| 儲存 | |
| 引導驅動器 | 2 個 M.2 2280 PCIe 5.0 x4 (M Key) 插槽,分別安裝了 2 塊 2TB NVMe 固態硬碟,組成 RAID 1 陣列。 |
| 擴張驅動 | 2 個 M.2 2280 (M Key) 插槽,華碩官方標稱 PCIe 6.0 x4,出廠時已開啟。 |
| 網路相關 | |
| 超級網卡 | NVIDIA ConnectX-8,2 個 QSFP112 400GbE 端口 |
| 乙太網路 - ENET | 1 個 Marvell 10GbE 端口 1 個 Realtek 1GbE (BMC) |
| 擴展 | |
| PCIe插槽 | 1個PCIe 5.0 x16 2 個 PCIe 5.0 x16 插槽(x8 訊號) |
| 外接顯示卡 | 最多可配備一張 NVIDIA RTX PRO Blackwell 顯示卡;評測機配備的是 RTX PRO 2000 Blackwell 顯示卡。 |
| 的I / O | |
| 前 | 2 個 USB 10Gbps Type-C 接口 2 個 USB 10Gbps Type-A 接口 1x的USB 2.0 耳機和麥克風插孔 |
| 後 | 4 個 USB 10Gbps Type-A 接口 1 個 Micro-USB COM(BMC 序列控制台) 1 個 Mini DisplayPort (BMC) 3個音訊插孔 |
| 管理與安全 | |
| BMC | ASPEED AST2600,配備 AMI MegaRAC 韌體、IPMI 和 Redfish |
| 安全性 | 車載TPM 2.0 |
| 電源和冷卻 | |
| 電源供應 | 1 個 1,600W ATX 電源,80 PLUS 鈦金認證 |
| 散熱 | 採用一體式水冷式冷卻系統(據華碩稱),GB300、SOCAMM 和 ConnectX-8 均配備冷板;前置和頂部散熱器,後置機殼風扇,QSFP112 插槽上方設有專用風扇。 |
| 工作溫度 | 10C到35C |
| 軟體和外形尺寸 | |
| 操作系統 | Ubuntu 將支援 NVIDIA AI 開發工具;華碩表示計劃推出基於 Windows 的 AI 開發支援。 |
| 尺寸 | 根據華碩官方數據,尺寸為 584 x 232 x 565 毫米(23.0 x 9.1 x 22.3 吋)。 |
| 重量 | 淨重27公斤,毛重32公斤 |
設計和建造
華碩將ET900N G3包裝成一款商務工作站,採用拉絲銀色機殼、深色網狀前面板、鍍鉻頂蓋和底座,以及位於前面板下方的華碩標誌。其尺寸符合平台要求:根據華碩官方數據,ET900N G3的尺寸為584 x 232 x 565毫米,比WS300(高529毫米、深570毫米、寬246毫米)略高略窄。 27公斤的重量意味著它並非一款可以隨意搬運的系統,而這正是華碩第一個獨特設計的意義所在。機殼頂部邊緣前後各有一個金屬把手,方便兩人無需觸碰面板即可將主機抬到桌面或推車上。在辦公設備上,這些把手看起來或許有些格格不入,但如果你曾經在實驗室裡搬運過GB300主機,就會明白它們的重要性了。
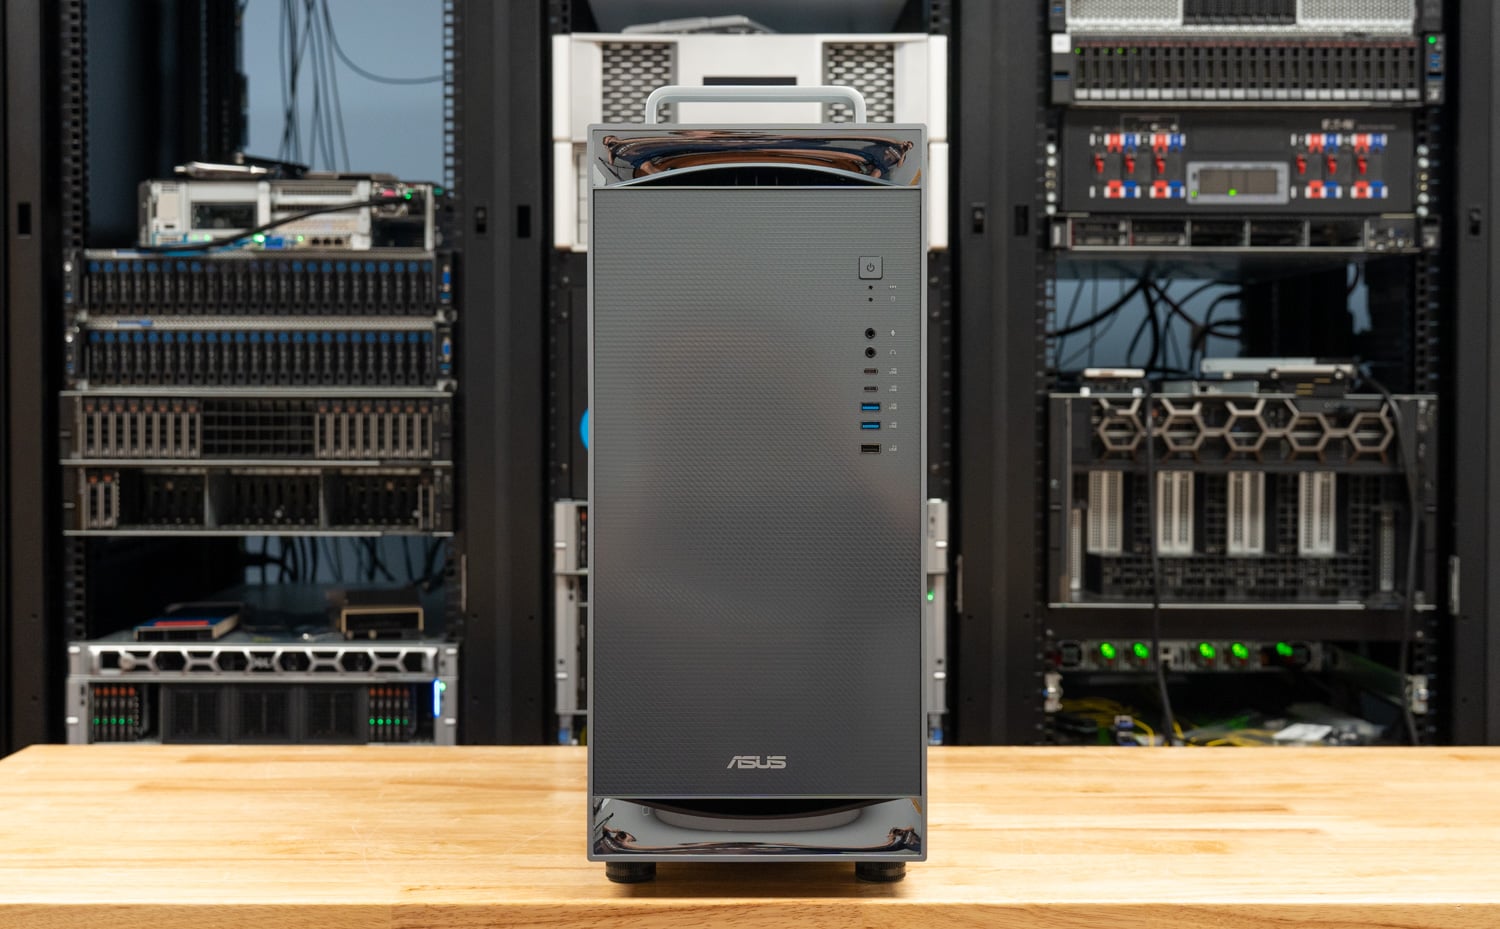
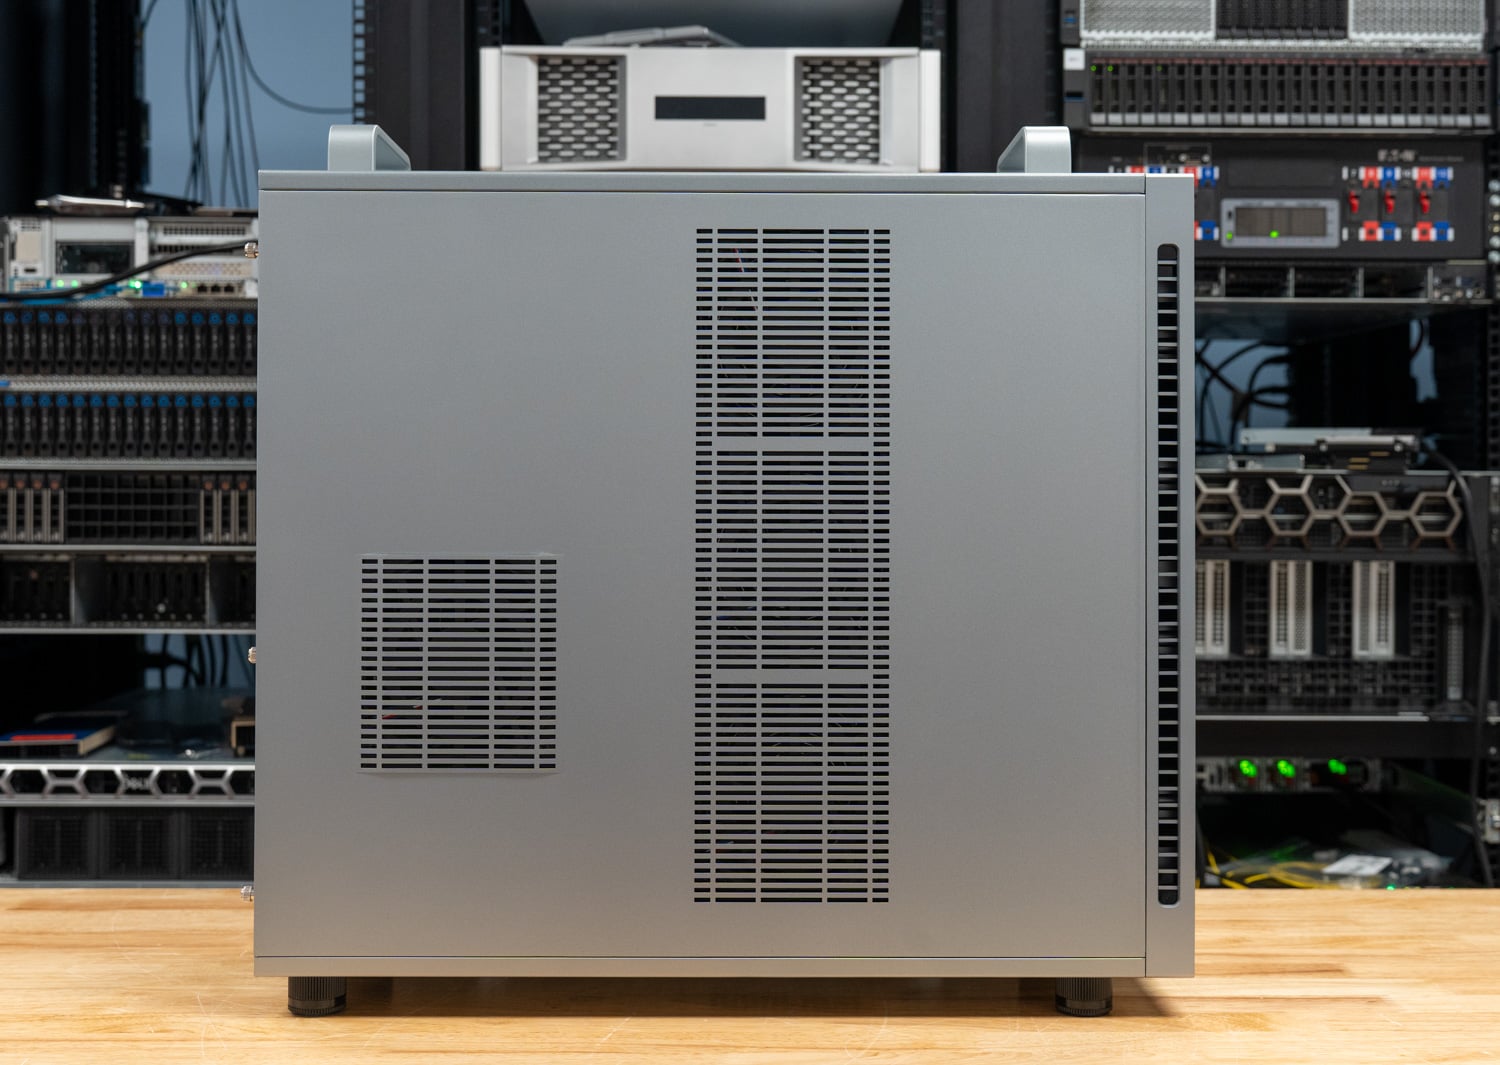
前面板配備電源按鈕、兩個 10Gbps USB Type-A 接口、兩個 10Gbps USB Type-C 接口、一個 USB 2.0 接口以及獨立的耳機和麥克風接口,所有接口均呈垂直排列在網狀面板的右上角。側面板是一塊大面積的通風面板,前端有一條長長的穿孔柱用於散熱器進氣,後端則是一個較小的方形格柵,與系統風扇對齊。機殼沒有側透面板,也沒有燈光,這符合目標使用者的喜好。
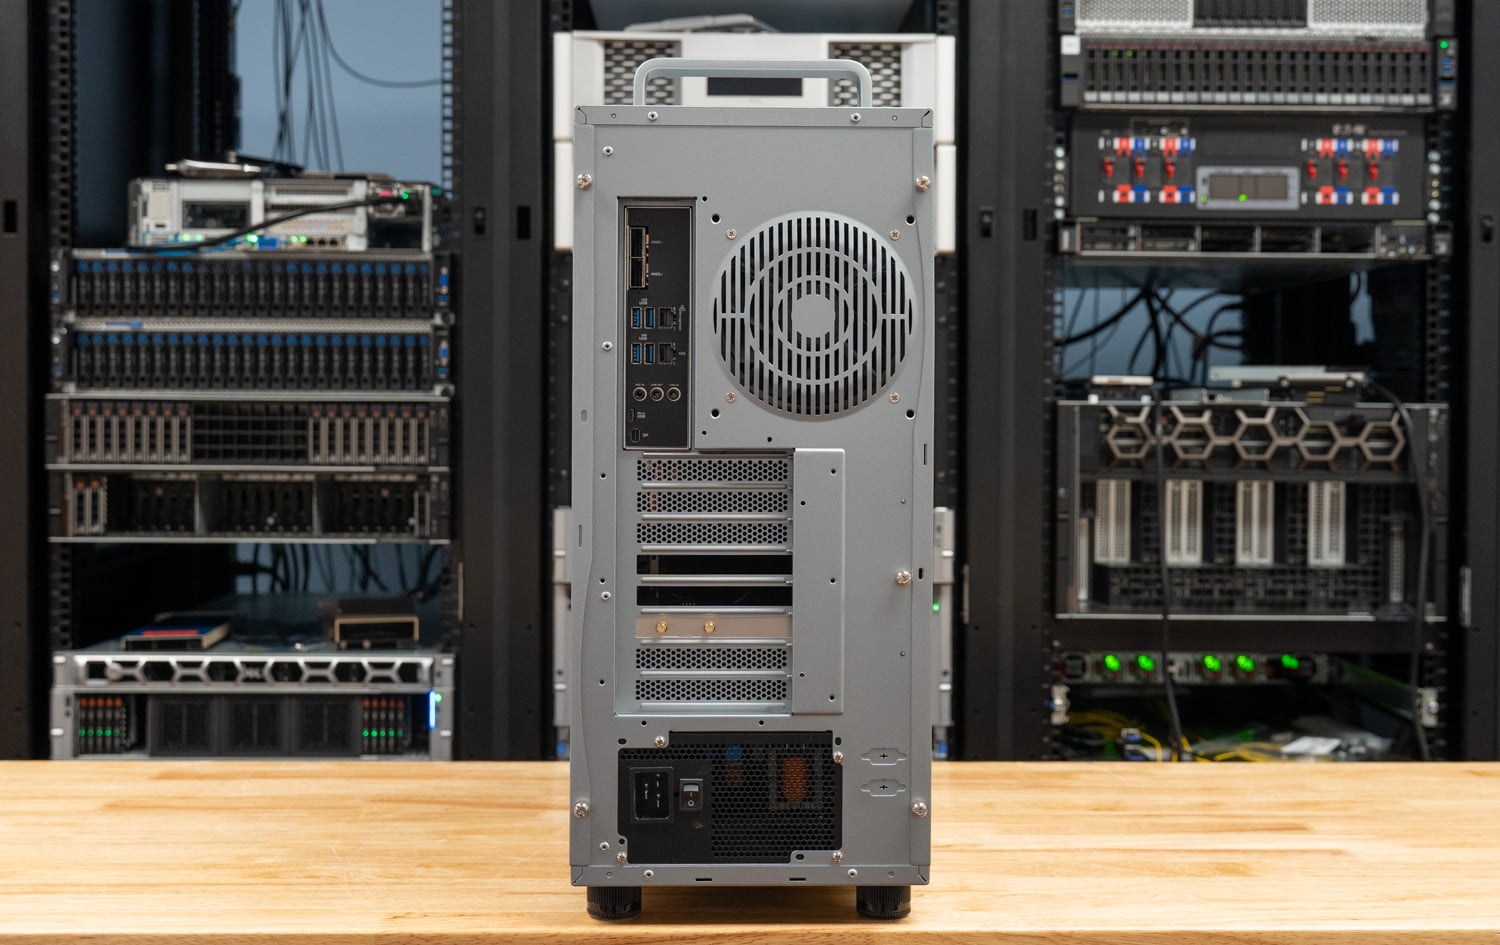
在背面,佈局將工作站 I/O 與下方的伺服器硬體分隔開來。上方的介面組包含四個 10Gbps USB Type-A 連接埠、10GbE 和 1GbE RJ45 網路介面、三個音訊介面、BMC 的 Micro-USB 控制台連接埠以及 BMC 用於設定的 Mini DisplayPort 介面。兩個用於 ConnectX-8 的 QSFP112 光碟機位於 I/O 擋板的頂部;旁邊是一個排氣風扇;三個擴充槽擋板位於中間;電源供應器及其 C19 電源介面位於底部。與 WS300 一樣,Mini DisplayPort 介面是 BMC 用於初始設定和故障排除的輸出介面;任何想要在這台機器上使用桌面功能的使用者都需要 RTX PRO 顯示卡。
ET900N G3 內部結構
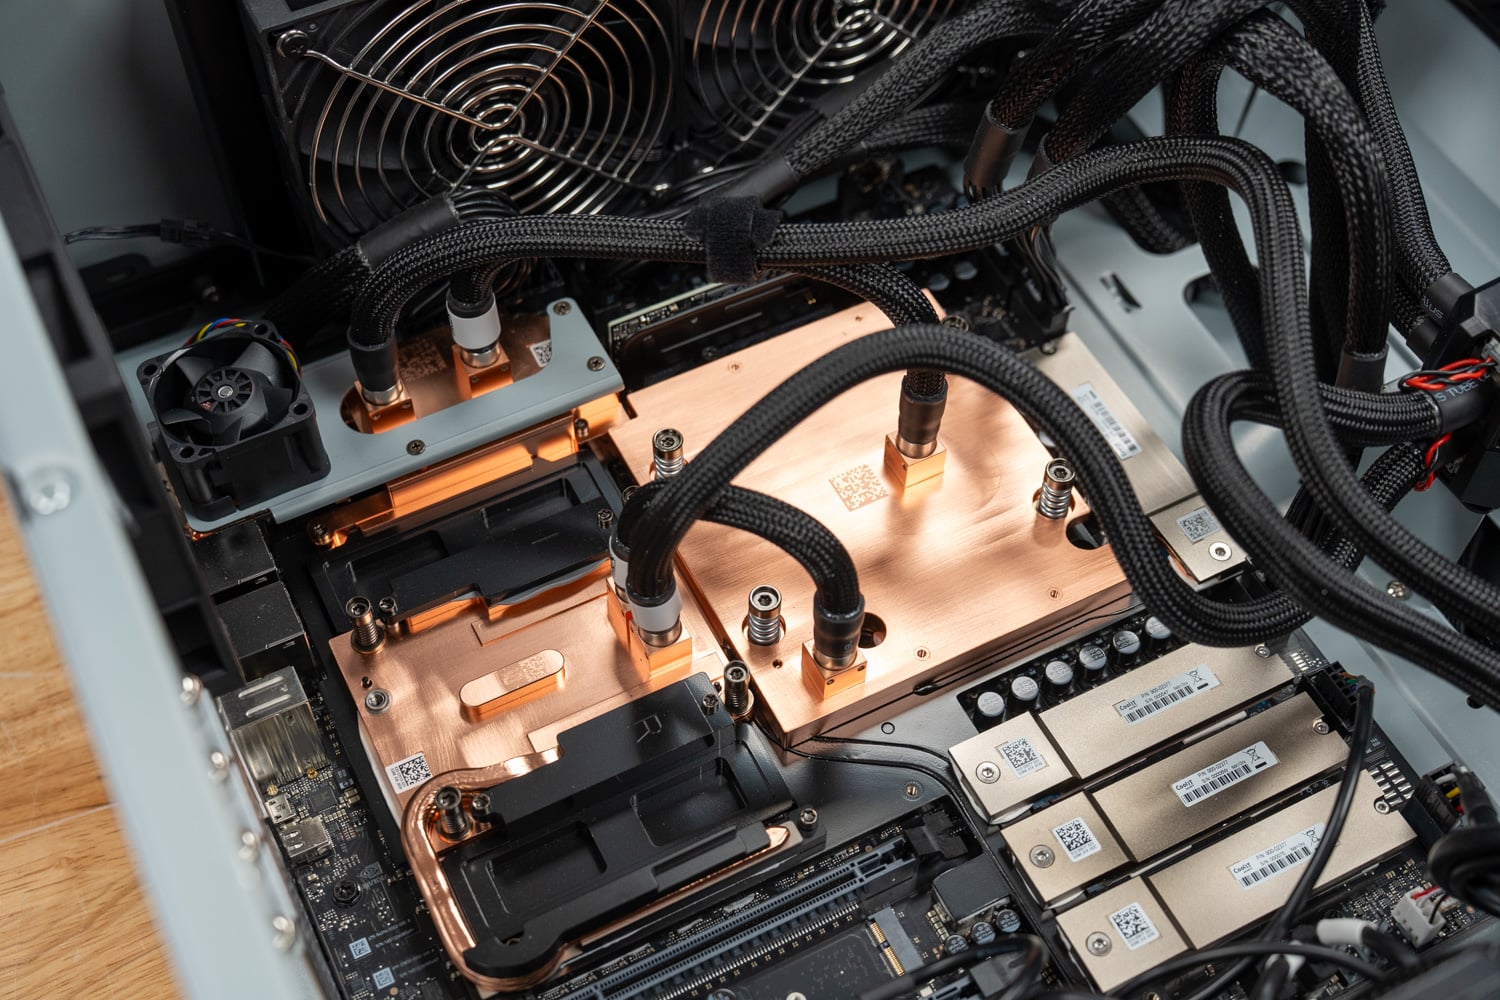
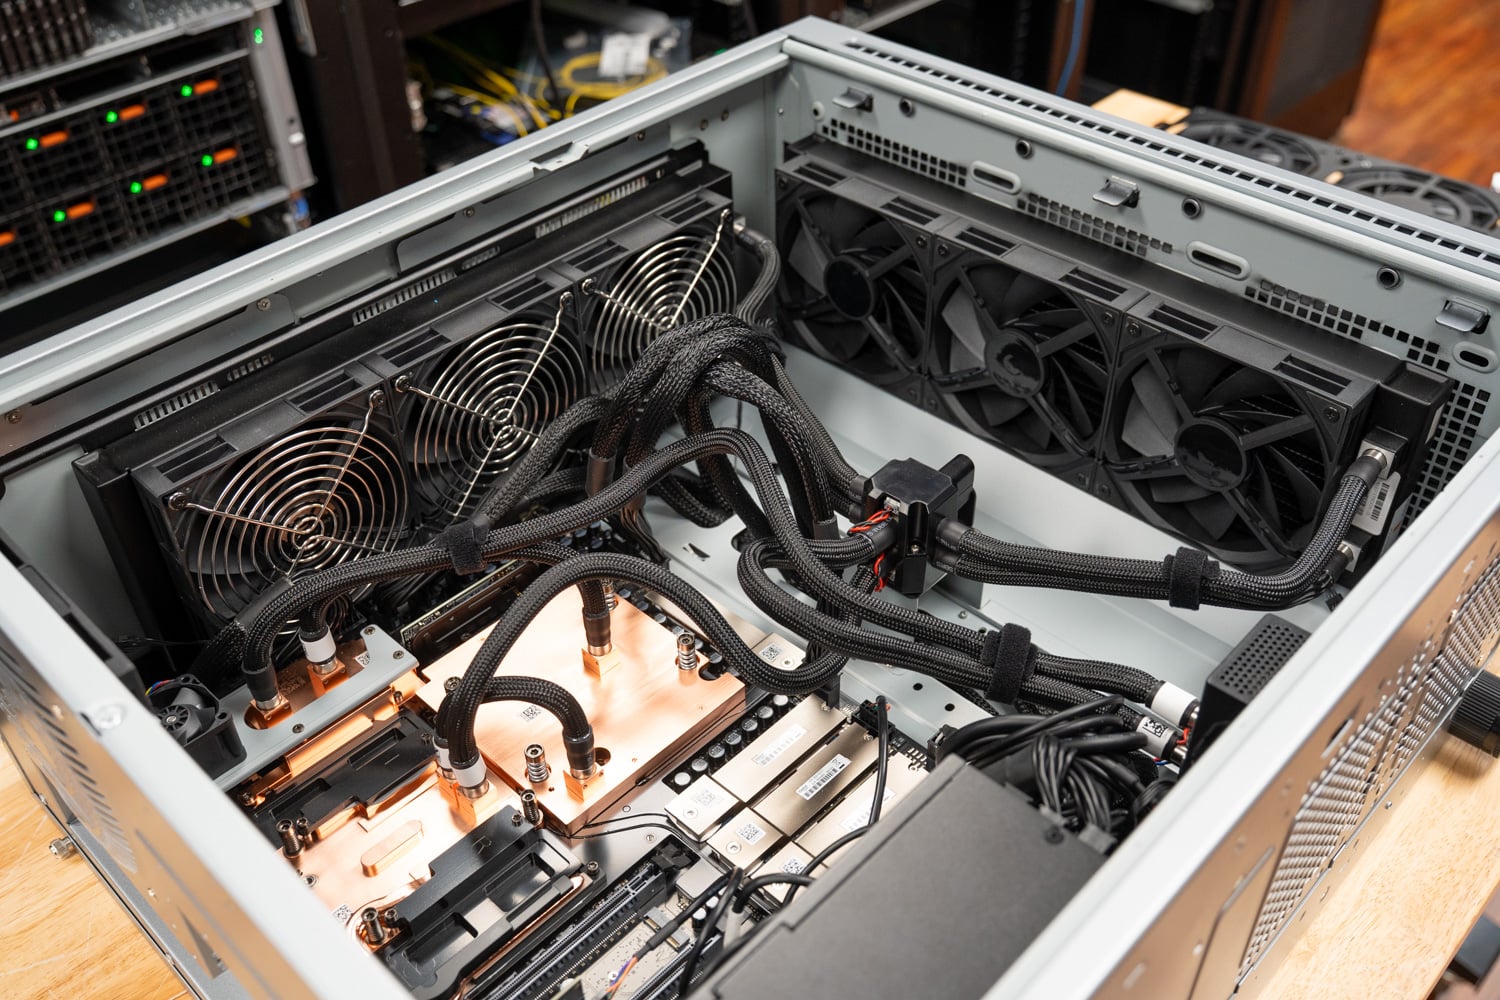
拆下側面板後,ET900N G3 看起來與 WS300 非常相似,這並不令人意外,因為它們都採用了相同的 NVIDIA 主機板。 GB300 Superchip 顯示卡位於機殼左側的銅冷板組件下方,SOCAMM 記憶體模組則位於其旁邊的銅冷板下方,而 ConnectX-8 記憶體模組則位於靠近後部 I/O 介面的第三個冷板下方。編織軟管從這些冷板連接到安裝在機殼橫樑上的分配歧管,然後連接到散熱器。三個全尺寸 PCIe 插槽位於 Superchip 顯示卡下方,電源位於機殼前下方角落,底部的線纜通道則由金屬罩遮蓋。
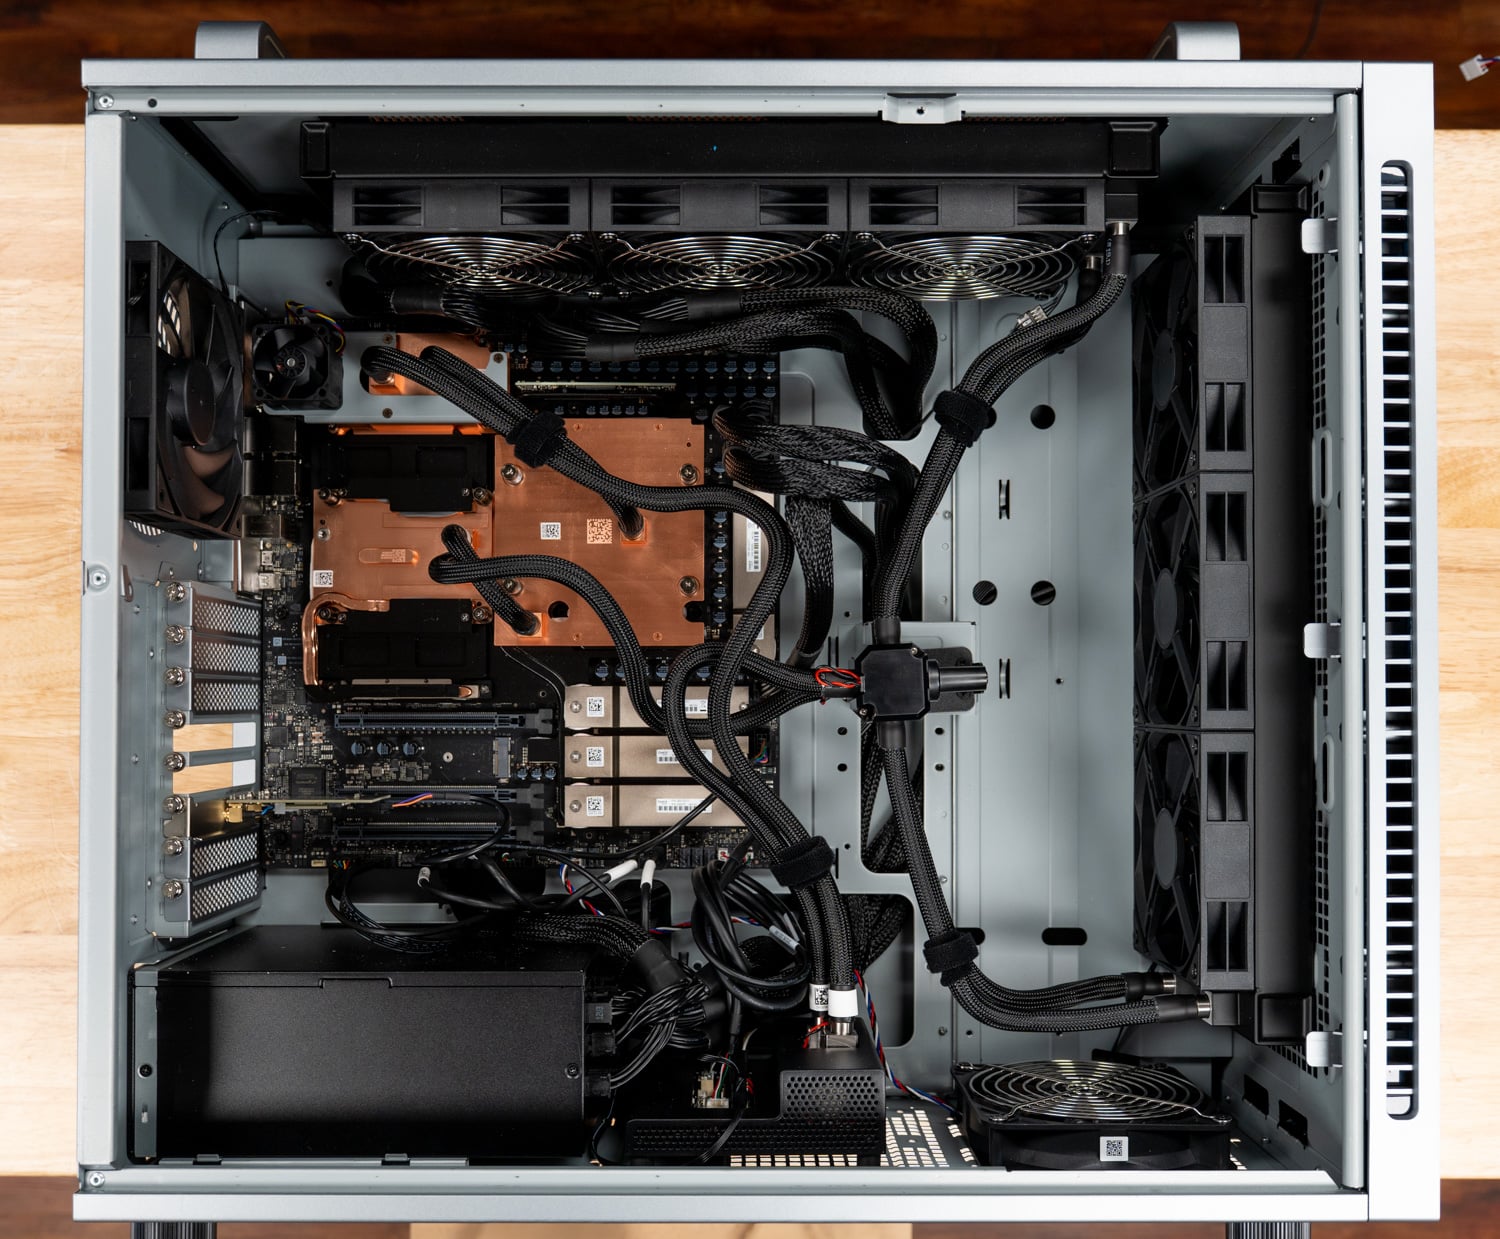
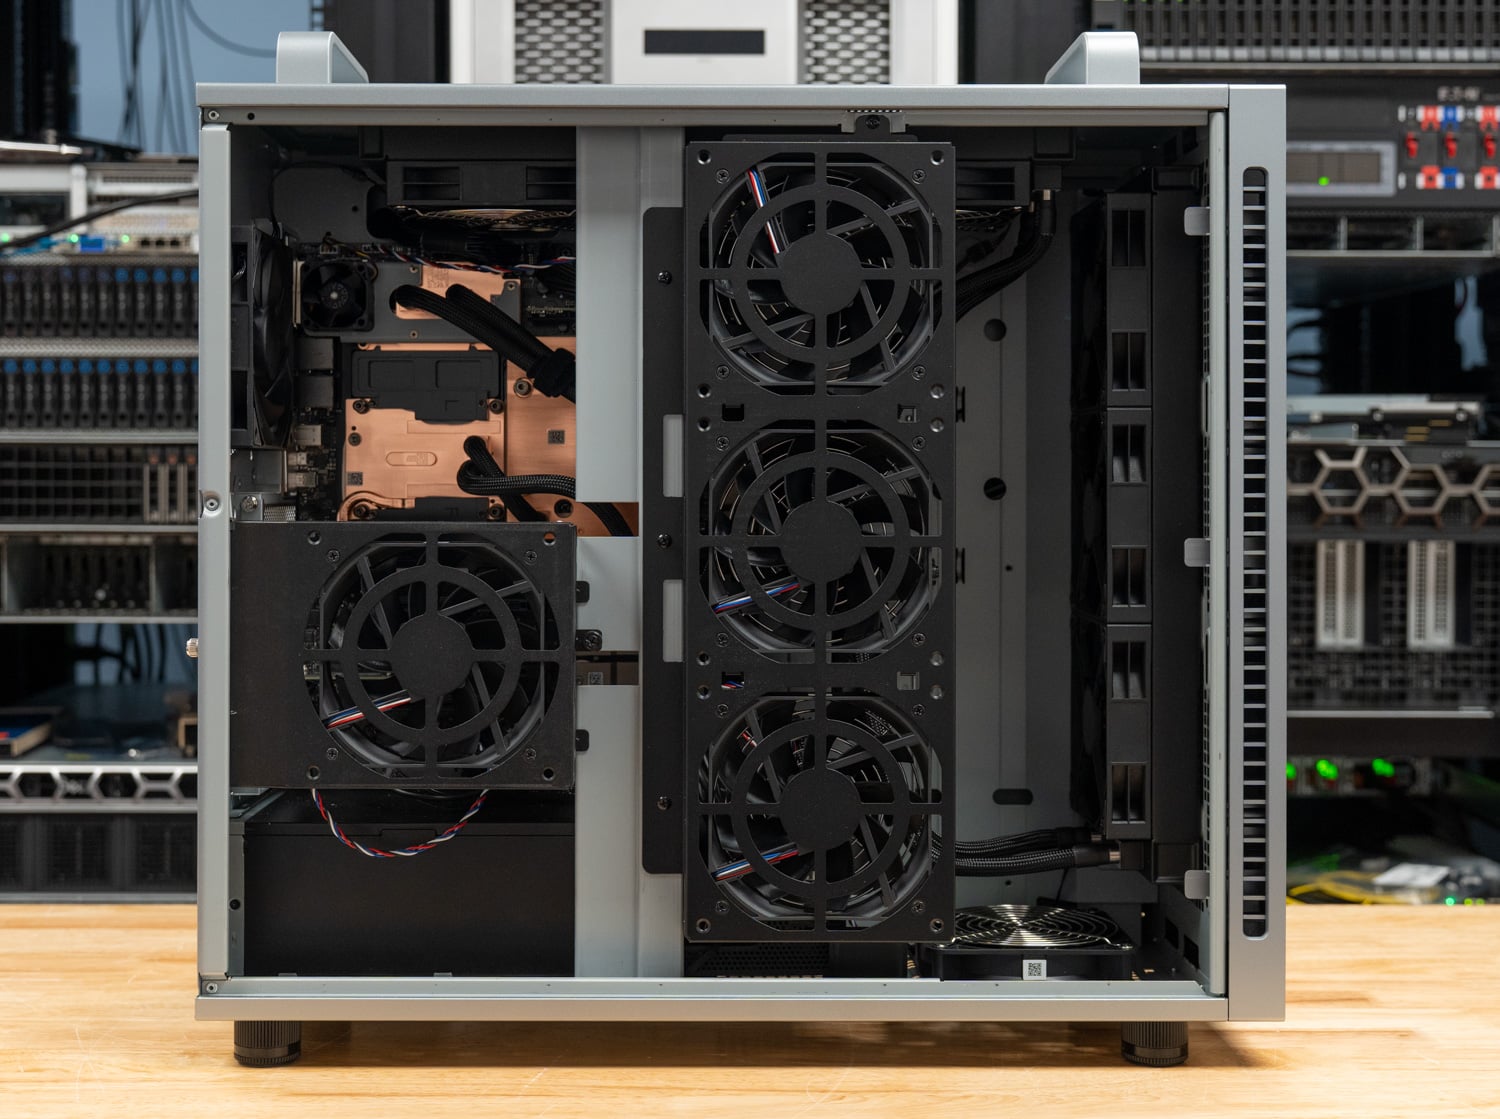
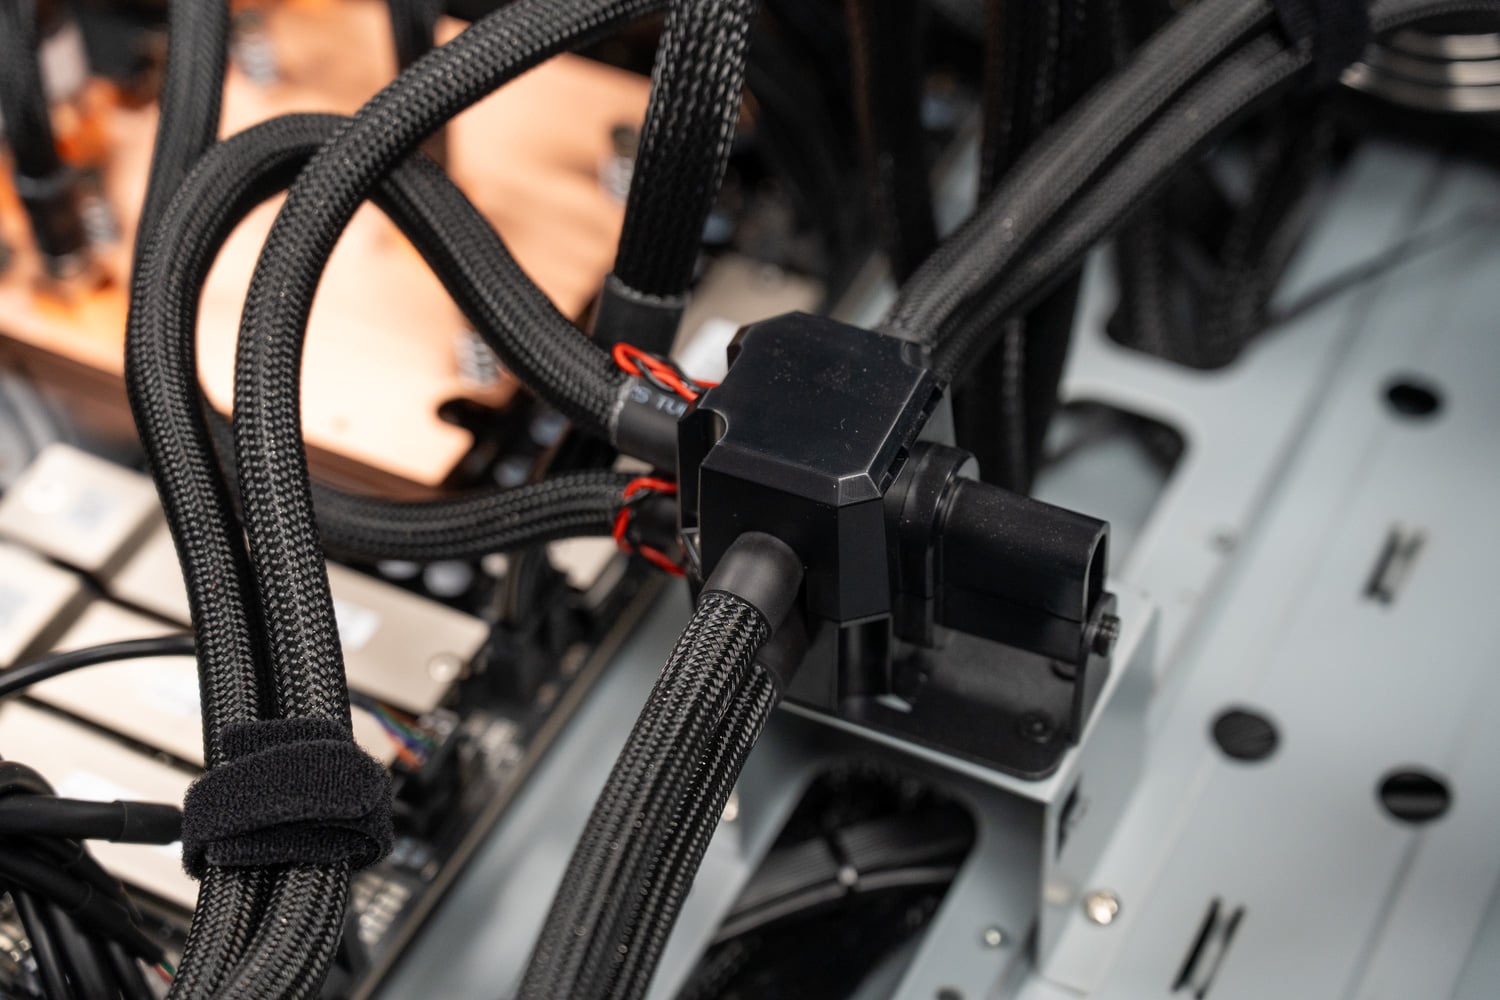
內部佈局與WS300相同:一個散熱器垂直安裝在前格柵後方,另一個散熱器位於頂部,每個散熱器都配有一排風扇,後部還有一個底盤風扇。冷卻液管路採用套管包裹,並用魔鬼氈固定在橫樑上。歧管將來自四個冷板的冷卻液管路集中起來,使得每個散熱器只需兩根管路即可連接。
光學愛好者
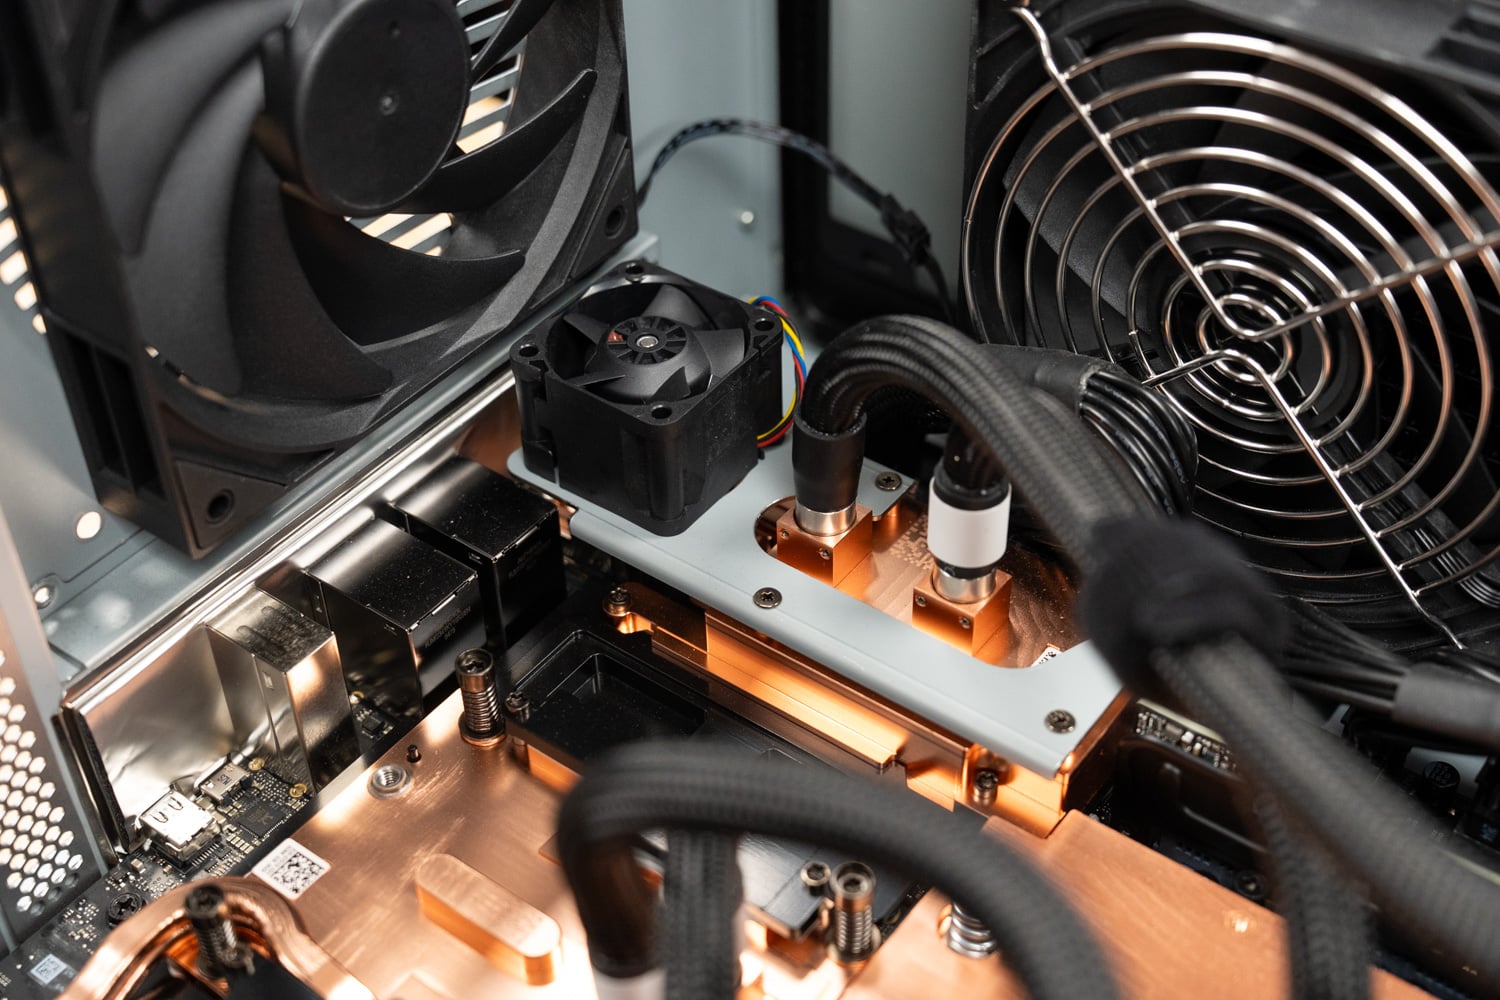
WS300 上沒有的散熱元件是安裝在 ConnectX-8 冷板上方支架上的小型風扇,它指向 QSFP112 光模組籠。液冷迴路負責 SuperNIC 晶片本身的散熱,但 400G 光收發器會產生自身熱量,並且位於金屬籠內,冷板只能透過傳導散熱。在其他測試中,我們注意到 ConnectX-8 在持續負載下會發熱,光模組本身也會過熱,因此,對於計劃長時間在光纖上運行 ET900N G3 的用戶來說,在光模組籠上設置專用氣流通道是一個非常實用的設計。而對於 DAC(我們正是透過這種方式將其連接到第二個 GB300 工作站,以進行仍在進行的集群推理深度測試),風扇的散熱需求則相對較低。
儲存、擴充和電源
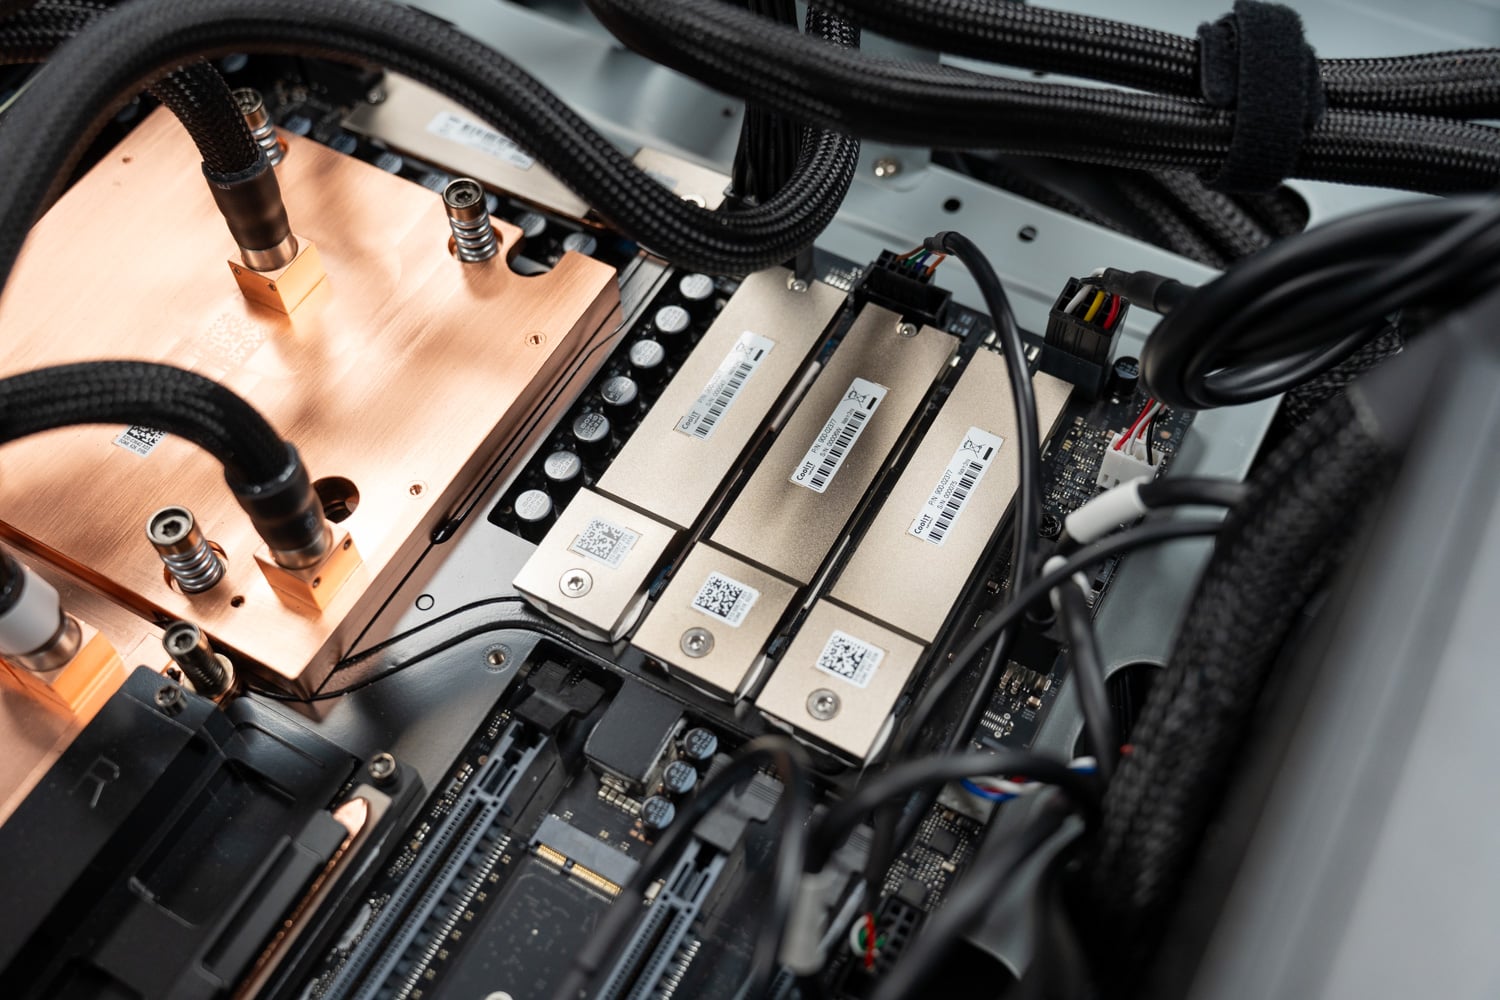
華碩 ET900N G3 出廠時配備了一塊 2TB NVMe 固態硬碟,用於安裝作業系統和 NVIDIA 軟體堆疊,該硬碟安裝在透過 PCIe 5.0 x4 連接到 Grace 的兩個 M.2 2280 插槽中。另外兩個插槽則懸掛在 ConnectX-8 的整合式 PCIe 交換器上,出廠時為空。
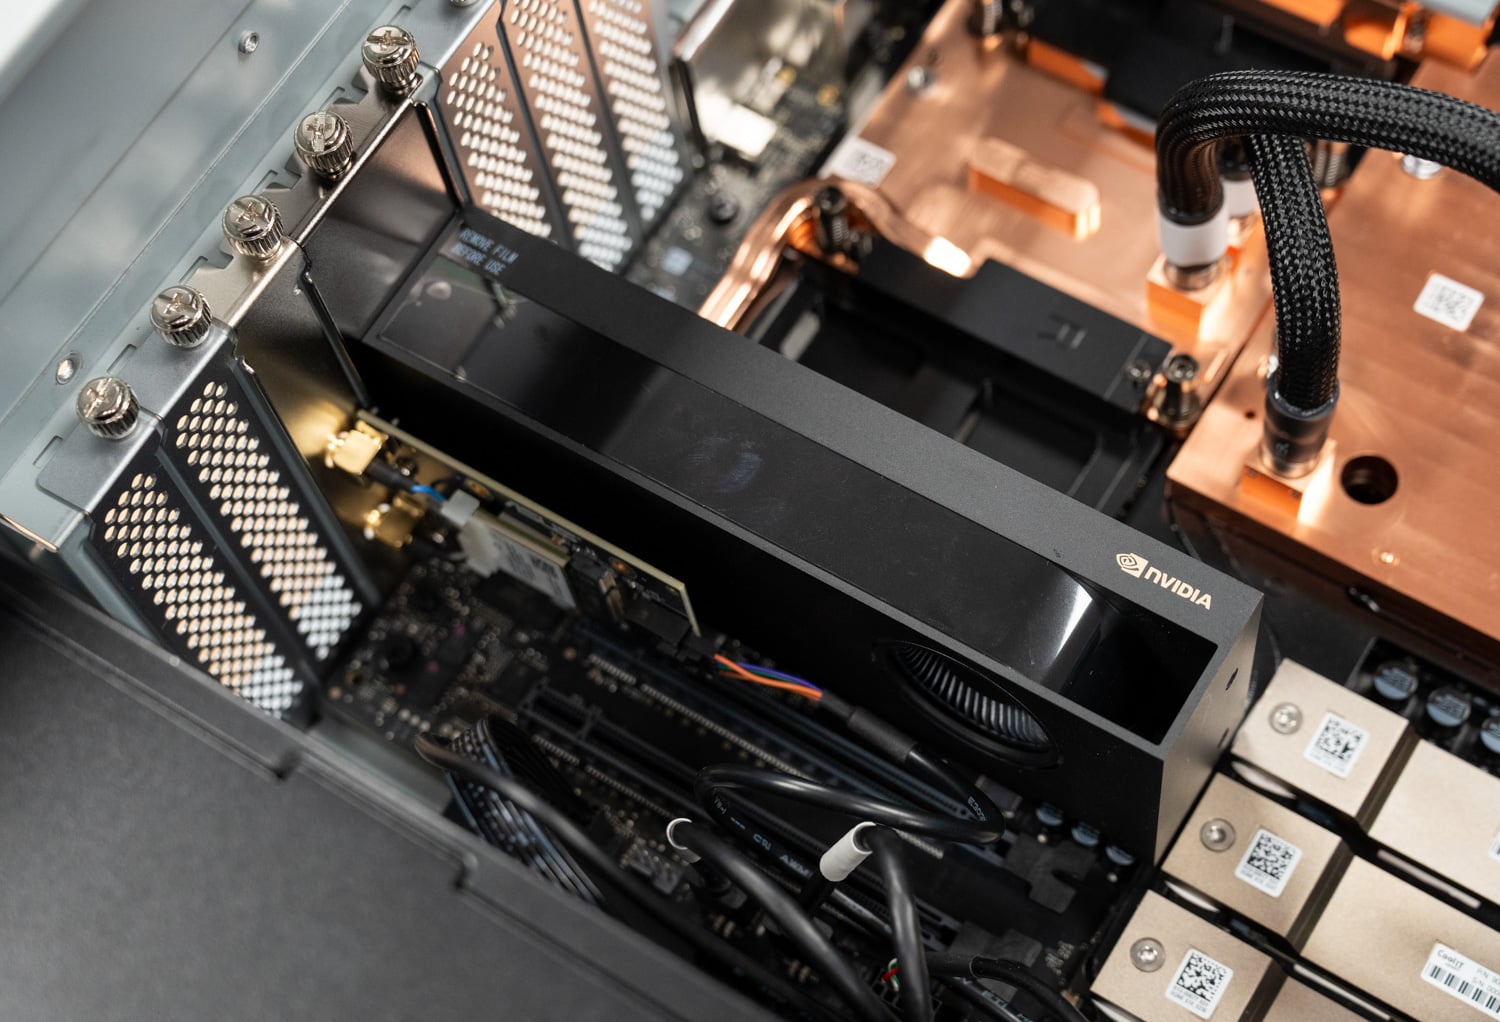
我們評測的樣機配備了一塊插在 PCIe 5.0 x16 插槽中的 NVIDIA RTX PRO 2000 Blackwell 顯示卡,這是華碩官方列出的配置之一。此顯示卡提供顯示輸出,且不會顯著消耗 GB300 的功耗預算。華碩表示,機殼最多可容納一塊 RTX PRO Blackwell 顯示卡。為了確保 Superchip 晶片擁有完整的加速預算,我們在進行基準測試前將其拔出,這與我們之前評測 WS300 時的情況相同。我們並未在該機殼中測試高功耗的 RTX PRO 顯示卡;關於高功耗 RTX PRO 顯示卡及其對共享功耗預算的影響,我們將在即將發布的 GB300 Station 評測中進行詳細介紹。
這款電源是華碩80 PLUS鈦金級認證的1,600W ATX電源,比WS300的白金級電源更高一級。鈦金級電源在115V輸入電壓下,50%負載時效率需達到94%,而白金級電源的效率為92%。鈦金級電源是唯一在10%負載下設定效率下限的電源級別,因此在GB300滿載運轉時,ET900N G3電源的功耗應該比白金級電源低幾十瓦。電源預算仍然是共享的:Grace處理器、B300主機板、水泵、風扇、儲存設備以及任何RTX PRO顯示卡都使用這1,600W電源。 NVIDIA的vsloshd服務會根據Superchip處理器和獨立顯示卡的功耗變化來分配電源,兩者的功耗都沒有固定上限。 WS300的評測文章詳細介紹了這個機制,而這款電源也採用了相同的機制。北美地區的安裝仍需要使用獨立的20A電路。
連線能力
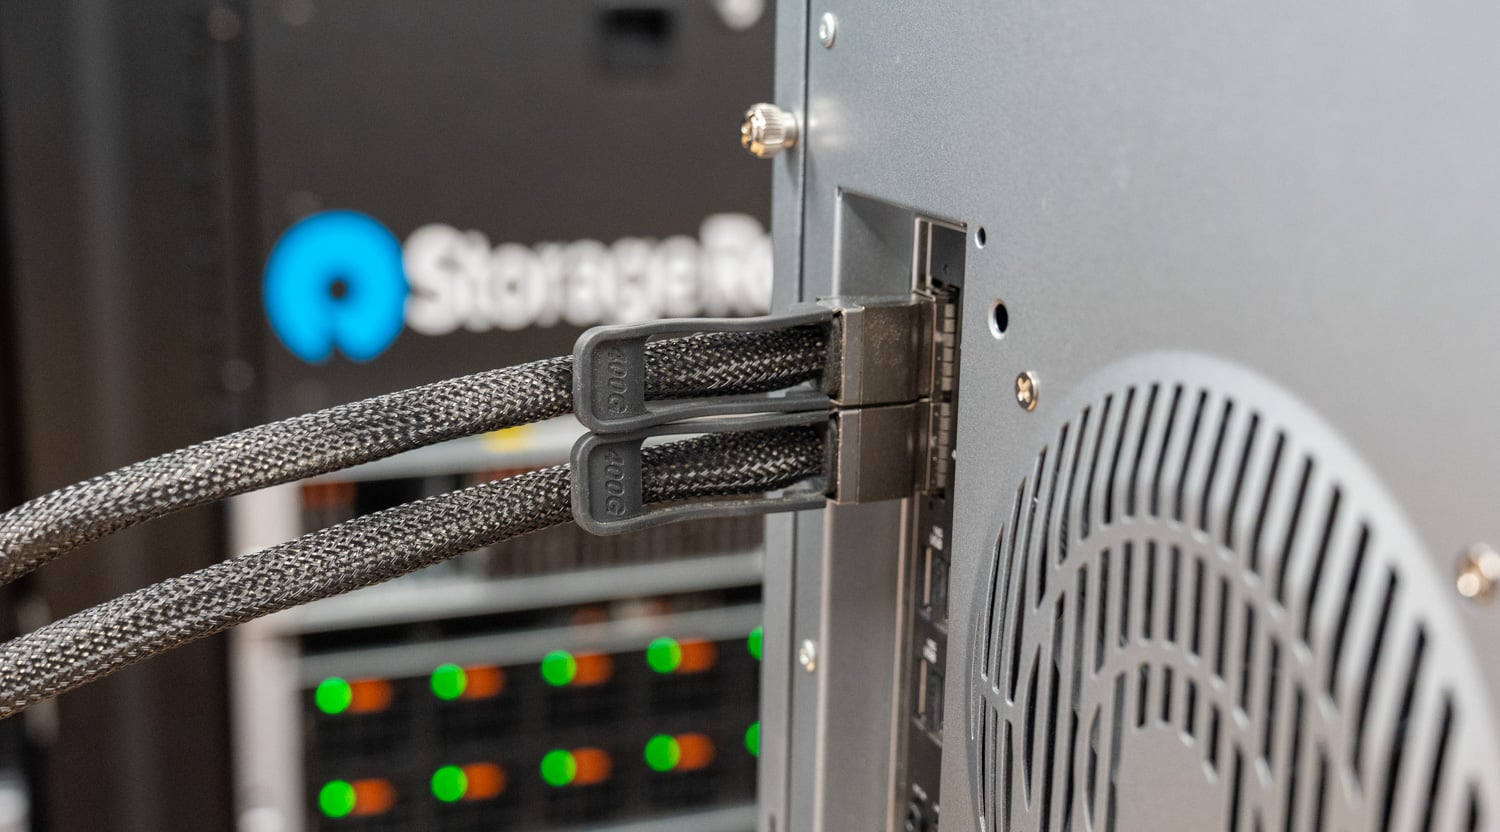
ConnectX-8 的兩個 QSFP112 連接埠是 ET900N G3 連接其他所有設備的接口,例如儲存設備、第二個 DGX Station 或叢集架構。這些連接埠已經在實驗室中使用,ET900N G3 透過 400G DAC 連接到第二個 GB300 Station,用於我們稍後將單獨發布的叢集推理深度分析。 10GbE Marvell 連接埠用於處理普通主機流量,而 Realtek 1GbE 連接埠則專用於 BMC。
測試筆記
本次評測中的所有結果均來自華碩寄送至我們實驗室的樣機,該樣機採用出廠標配的記憶體配置:252GB HBM3e 和 496GB LPDDR5X。系統未安裝 RTX PRO 顯示卡,因此 GB300 Superchip 顯示卡擁有完整的加速器功率預算,與我們 WS300 的測試條件相同。軟體堆疊、vLLM 配置、工作負載設定檔和並發掃描均與 WS300 的測試相同,因此兩款主機可以直接進行比較。本次評測僅關注效能,我們並未對此樣機進行功耗或溫度測試。
工作負載與我們在每個本地 AI 系統上運行的兩個 vLLM 實時推理配置文件相同:一個是輸入和輸出均為 512 個標記的等效工作負載,另一個是預填充密集型工作負載,輸入和輸出均為 8,192 個標記,並發流數量從 1 個到 128 個不等。對於前沿規模的模型,我們將其與配備兩張或四張RTX PRO 6000顯示卡的戴爾 PowerEdge XE7740 GPU 伺服器進行比較,這是這些檢查點最接近的單機替代方案。對於較小的模型,我們將其與同一台 XE7740 伺服器上的單張 RTX PRO 6000 顯示卡、戴爾 PowerEdge R770伺服器上的單張 H200 NVL 顯示卡以及由宏碁 Veriton GN100代表的GB10 DGX Spark 顯示卡以及由宏碁 Veriton GN100代表的GB10 DGX Spark進行比較,後者與我們在 300 評測中使用的相同版本。以下 ET900N G3 的資料是運行日誌中的確切值;對比系統資料取自我們的結果圖表。
推理性能
連貫記憶池的前沿模型
GB300 的存在意義在於服務於 B300 252GB HBM3e 記憶體容量邊界兩側的顯示卡型號,因此我們首先考察跨越該邊界的四個關鍵點:DeepSeek V4 閃存和 MiniMax M2.7 內存都能輕鬆裝入 HBM 顯存,MiniMax M3 閃存和 MiniMax M2.7 內存都能輕鬆裝入 HBM 顯存,MiniMax M3 內存存儲和 MiniMax M2.7 內存都能輕鬆裝入 HBM 顯存,MiniMax M3 存儲存儲和 MiniMax M2.7 內存都能輕鬆裝入 HBM 顯存,MiniMax M3 存儲存儲和 MiniMax M2.7 內存都能輕鬆裝入 HBM 顯存,MiniMax M3 存儲內存大約有一部分,內存負載了一半;在每張圖表的另一端,我們可以看到最接近的單機解決方案:PowerEdge XE7740 伺服器,其中整合了多張 RTX PRO 6000 系列顯示卡,並在需要時將效能負載轉移到主機記憶體。
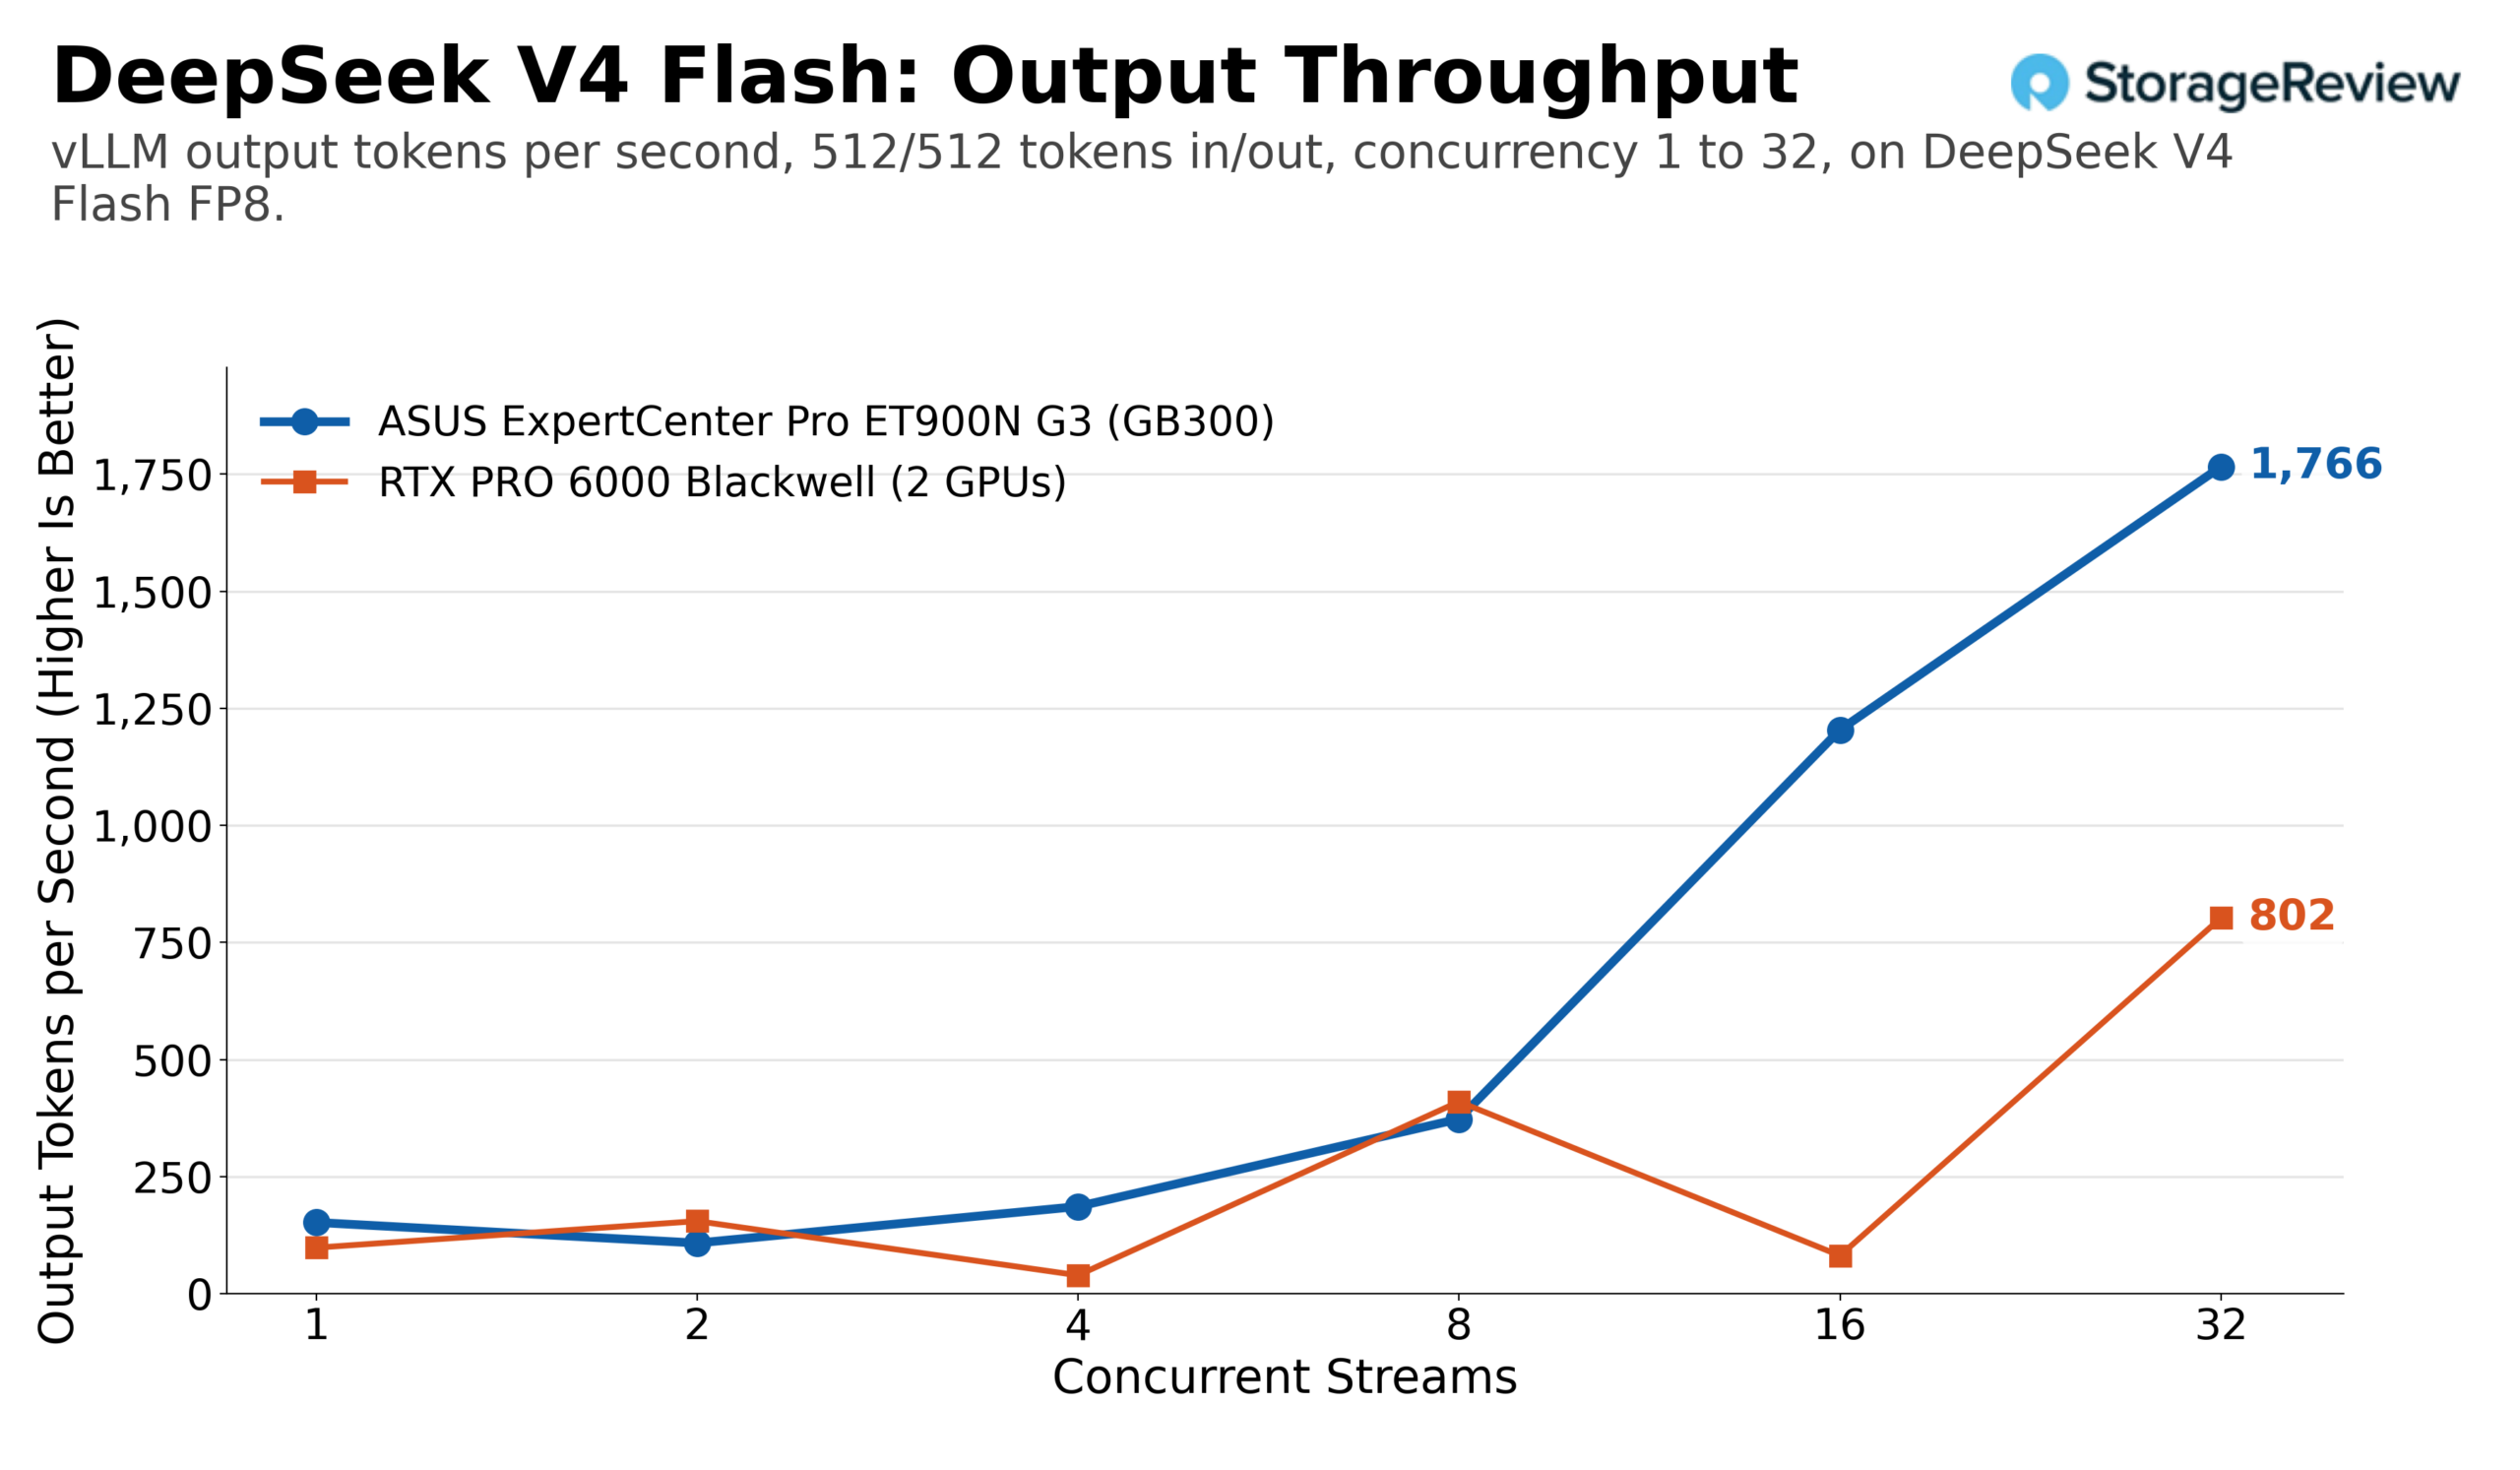
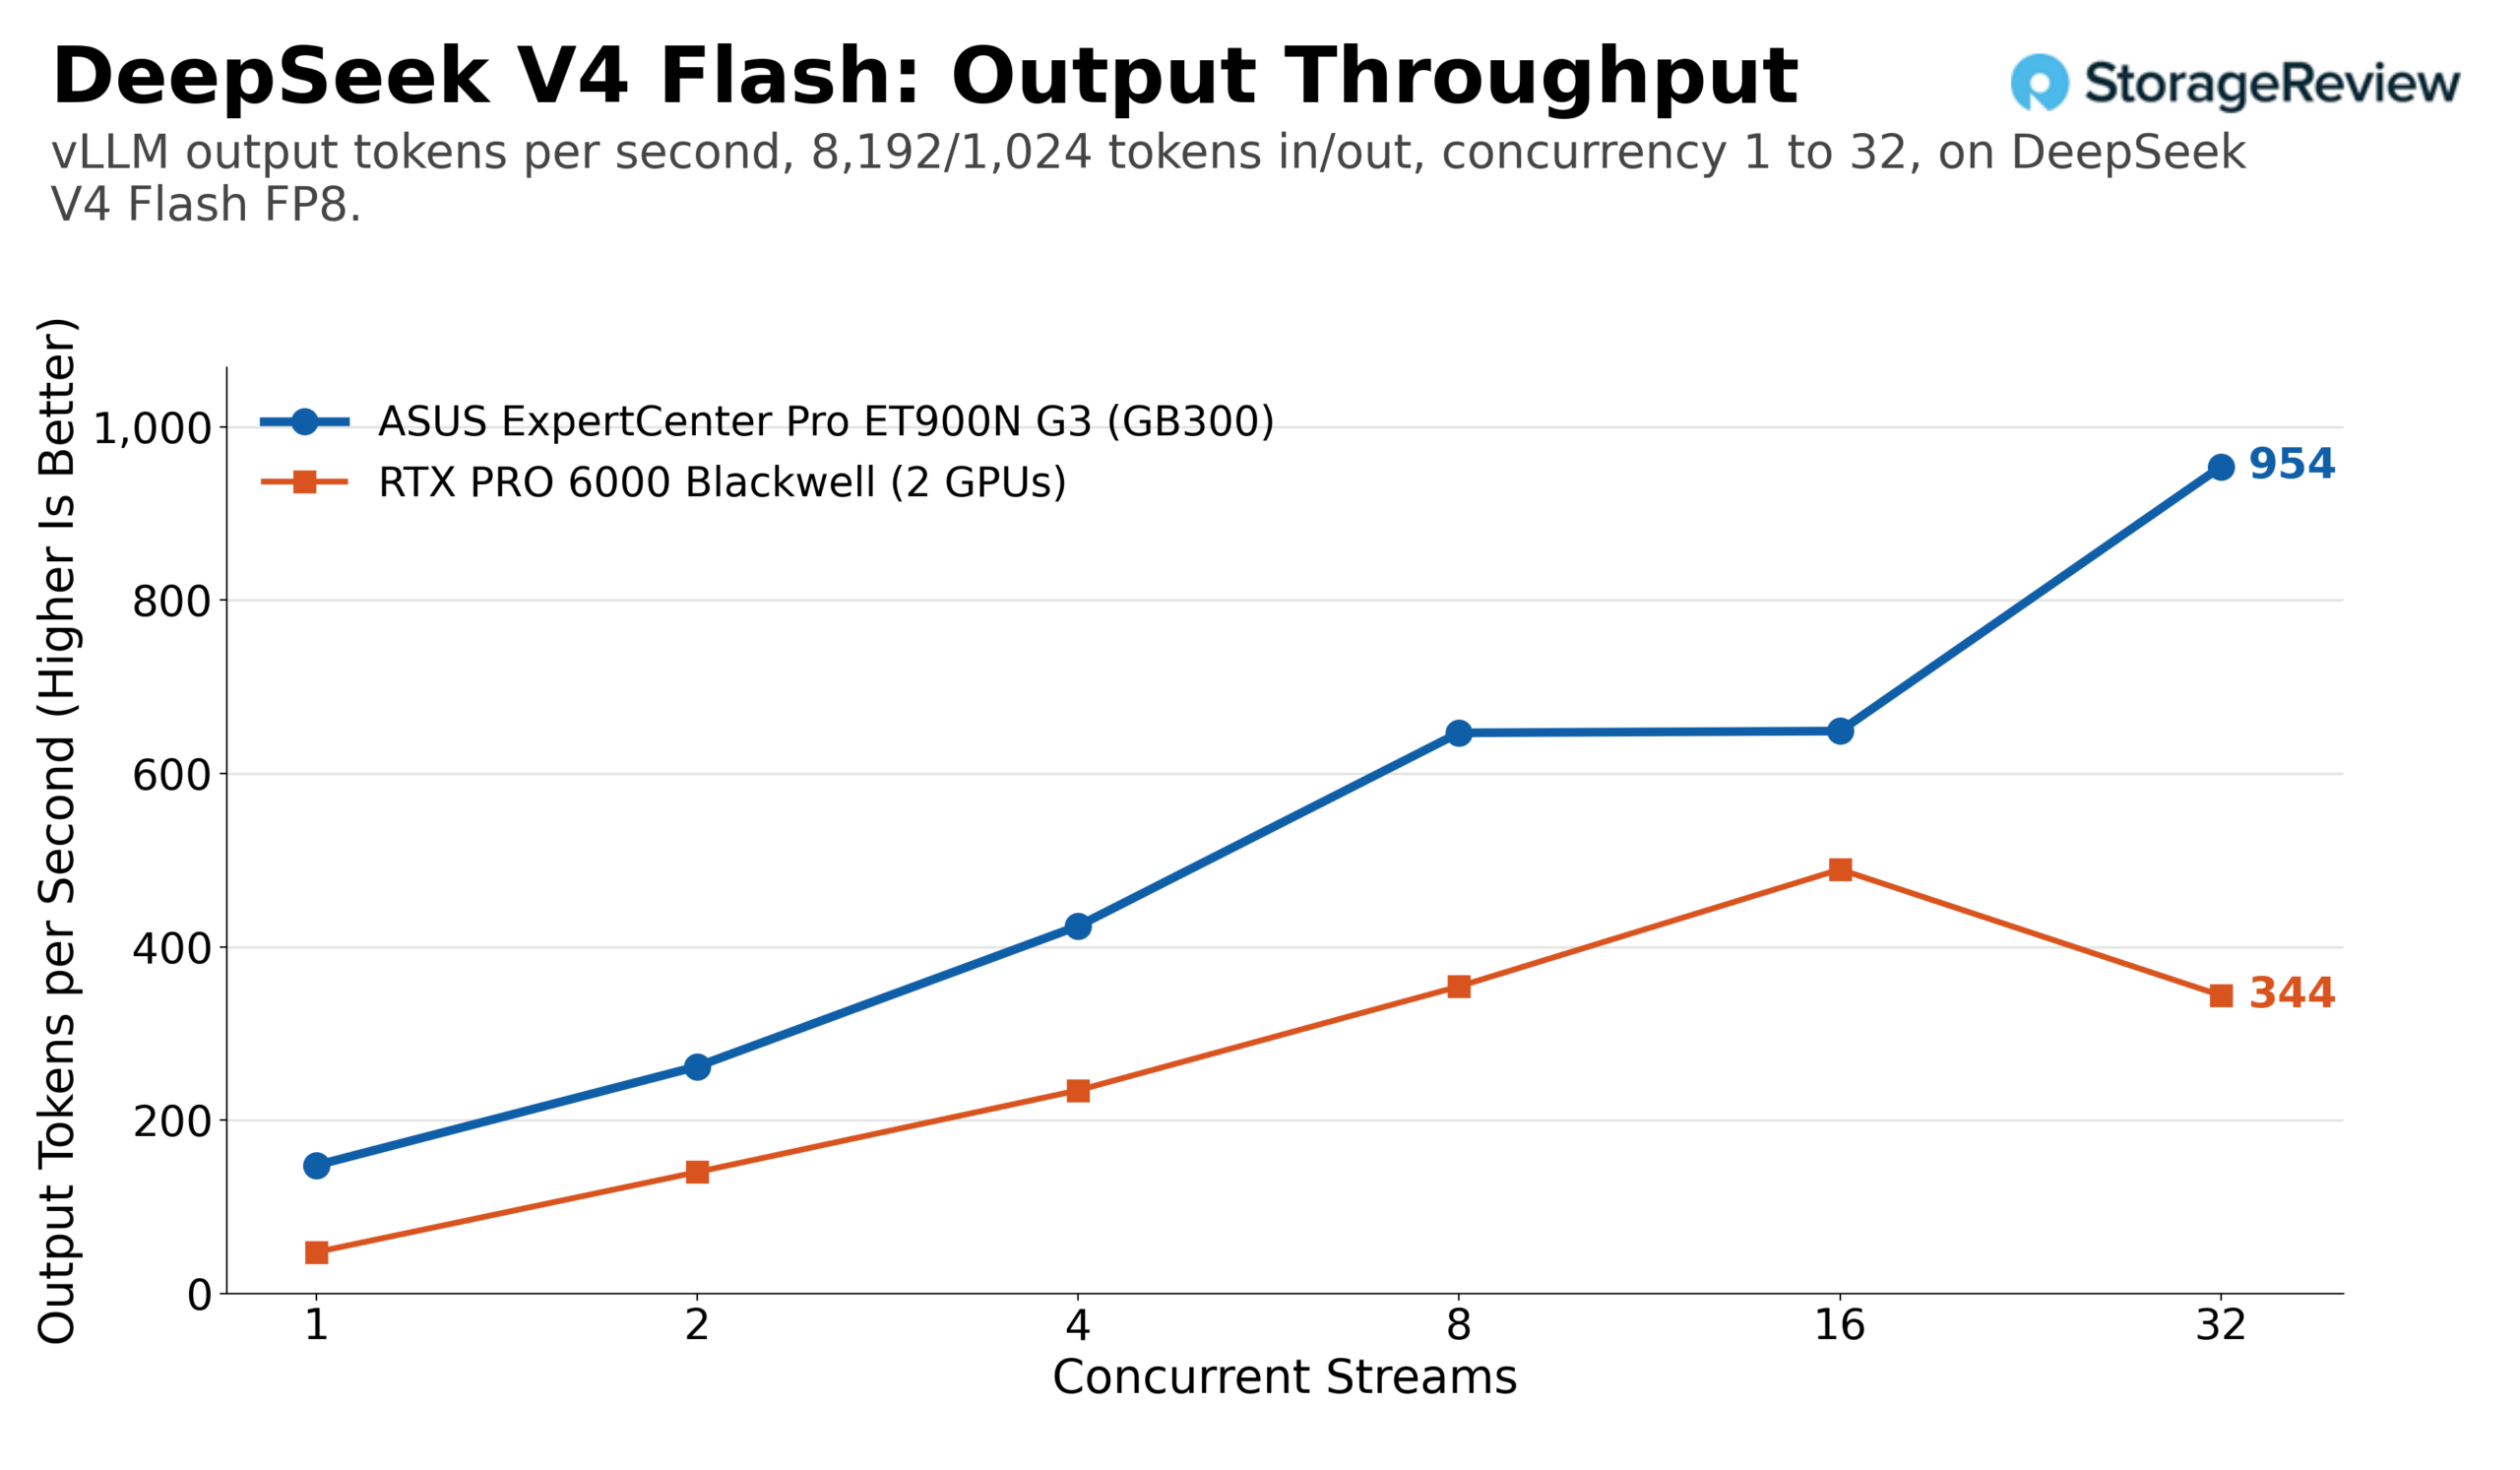
DeepSeek V4 Flash 的測試非常簡單:一個約 20GB 的原生 FP8 檢查點,B300 可以輕鬆處理。在相同的工作負載下,輸出吞吐量從單流時的每秒 152 個令牌提升至 32 流時的每秒 1,766 個令牌,總令牌吞吐量達到每秒 3,532 個令牌。在預先填充較多的場景下,ET900N G3 的輸出令牌數從每秒 148 個提升至每秒 954 個,總令牌數達到每秒 8,587 個。兩張 RTX PRO 6000 顯示卡在相同工作負載下峰值輸出令牌數接近每秒 800 個,在長提示符場景下約為每秒 490 個令牌,低並發情況下效能曲線波動較大。
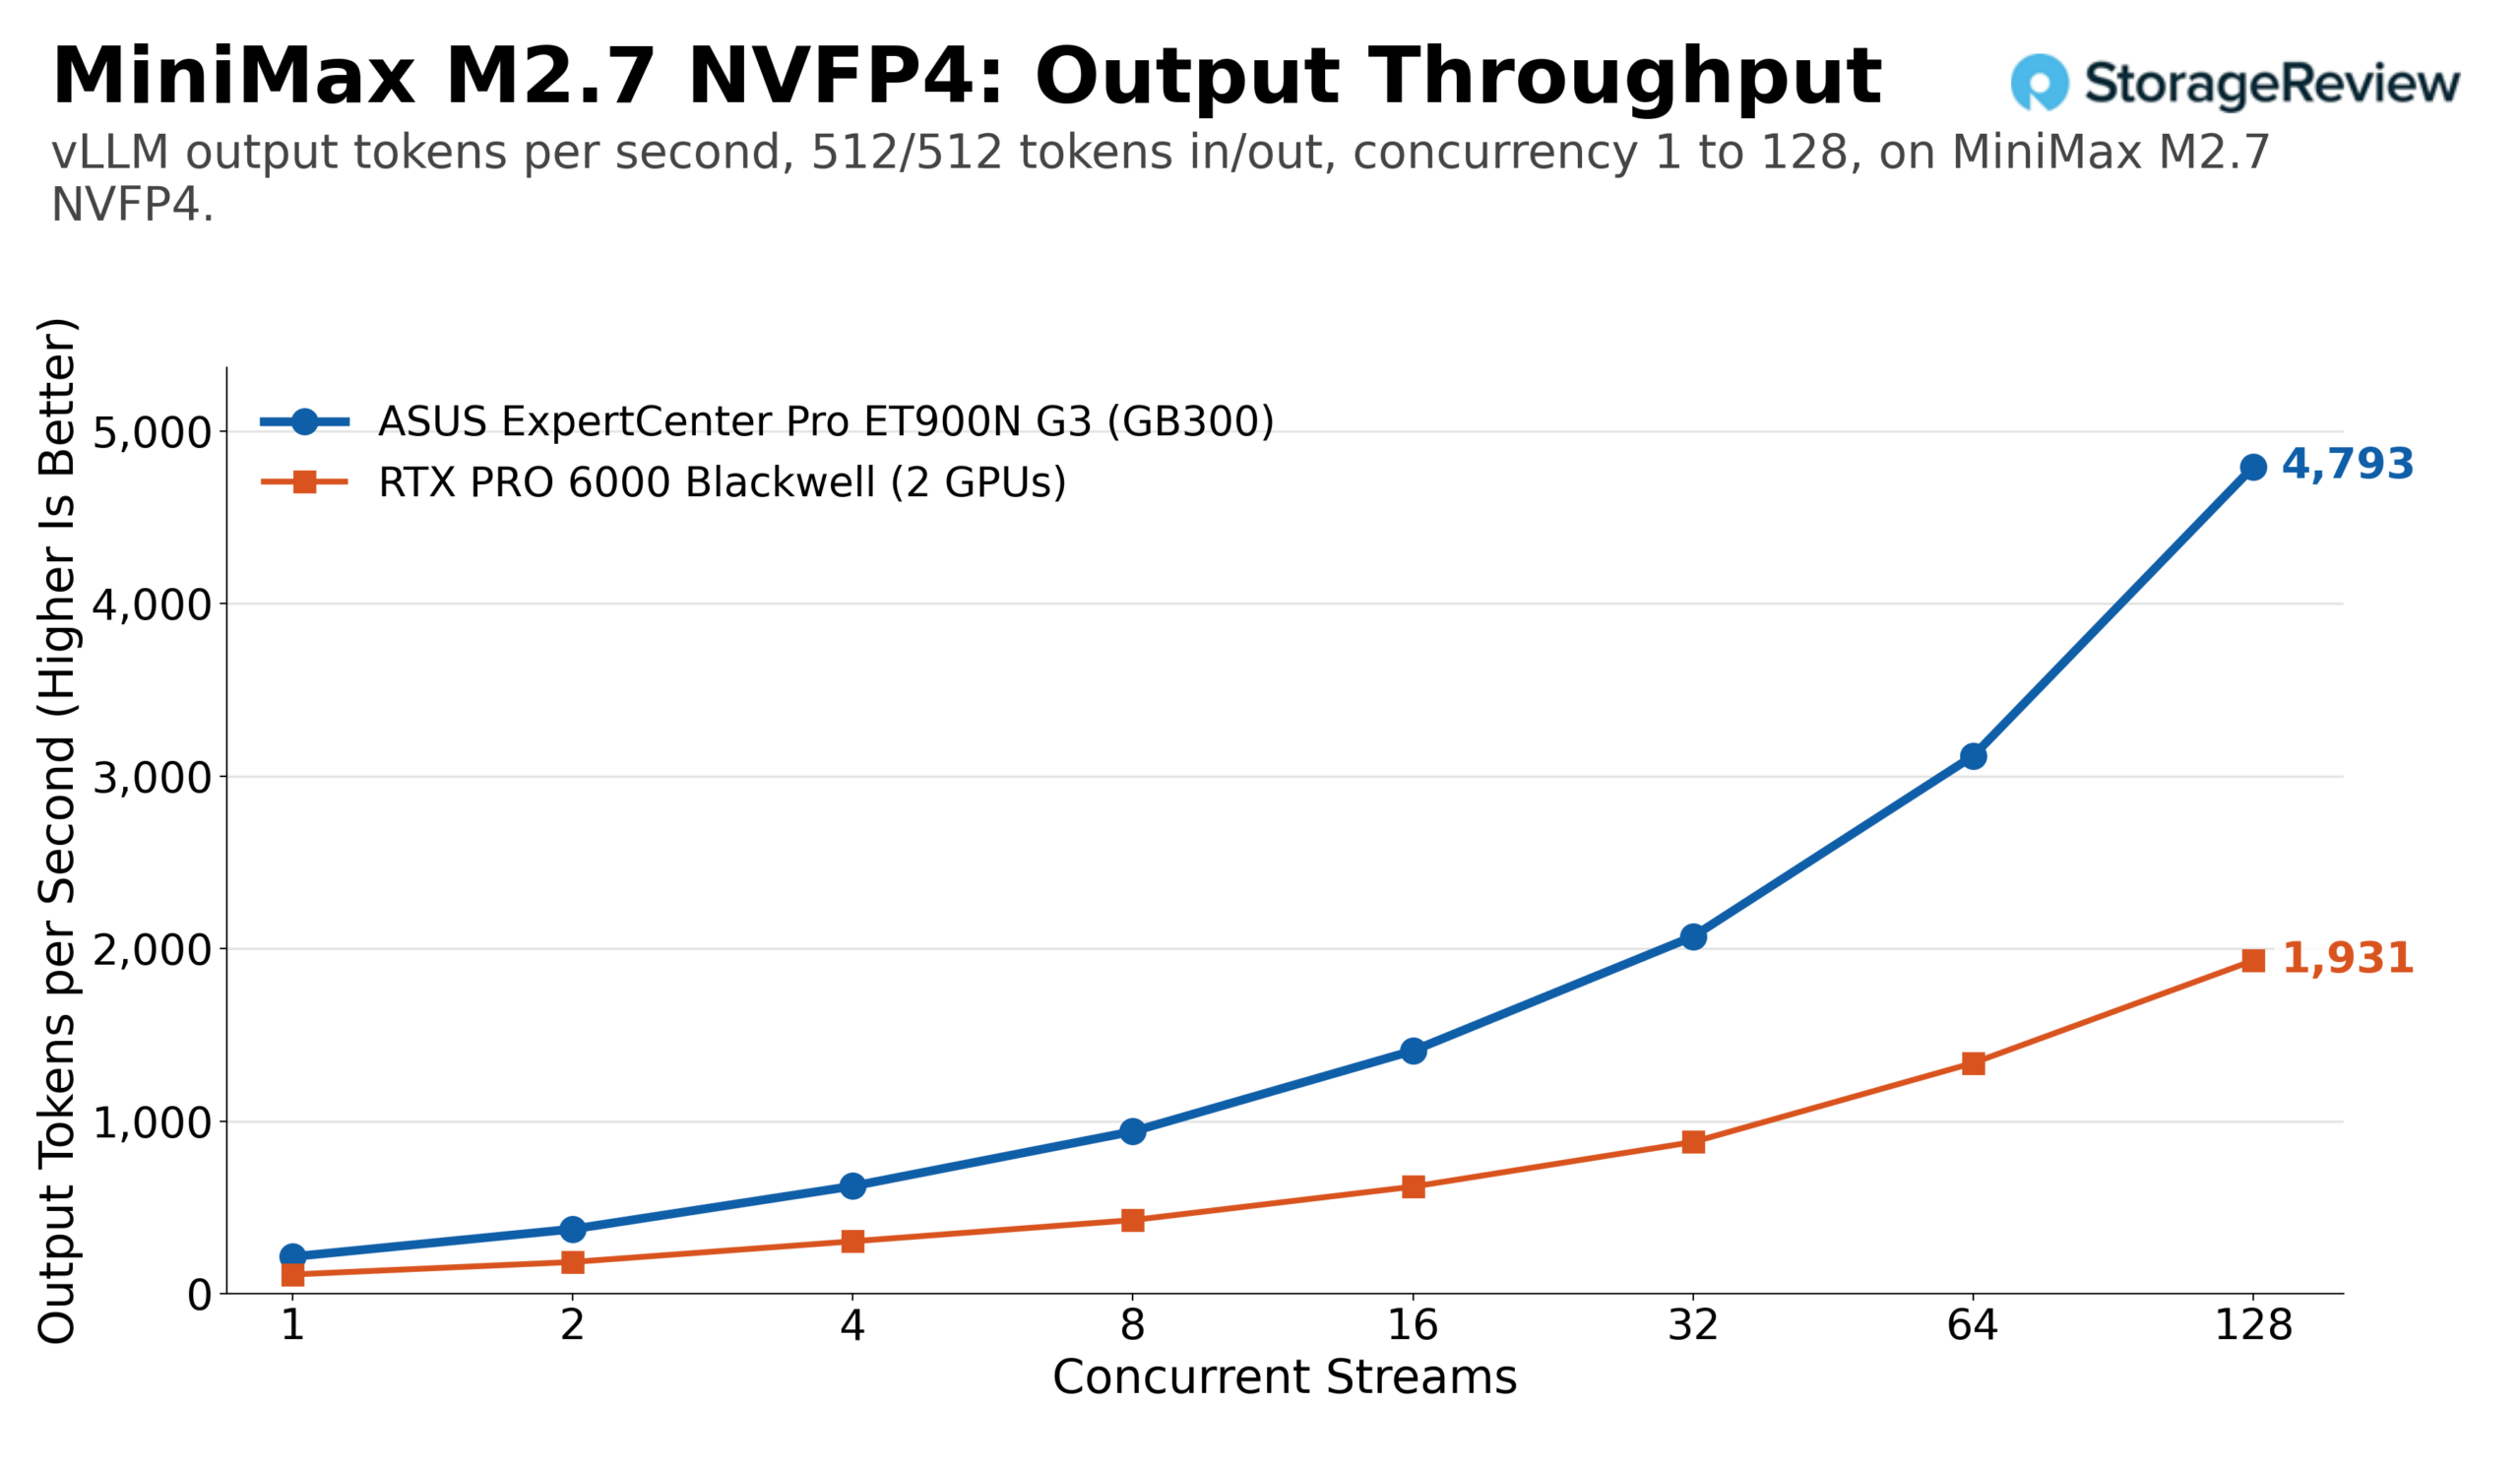
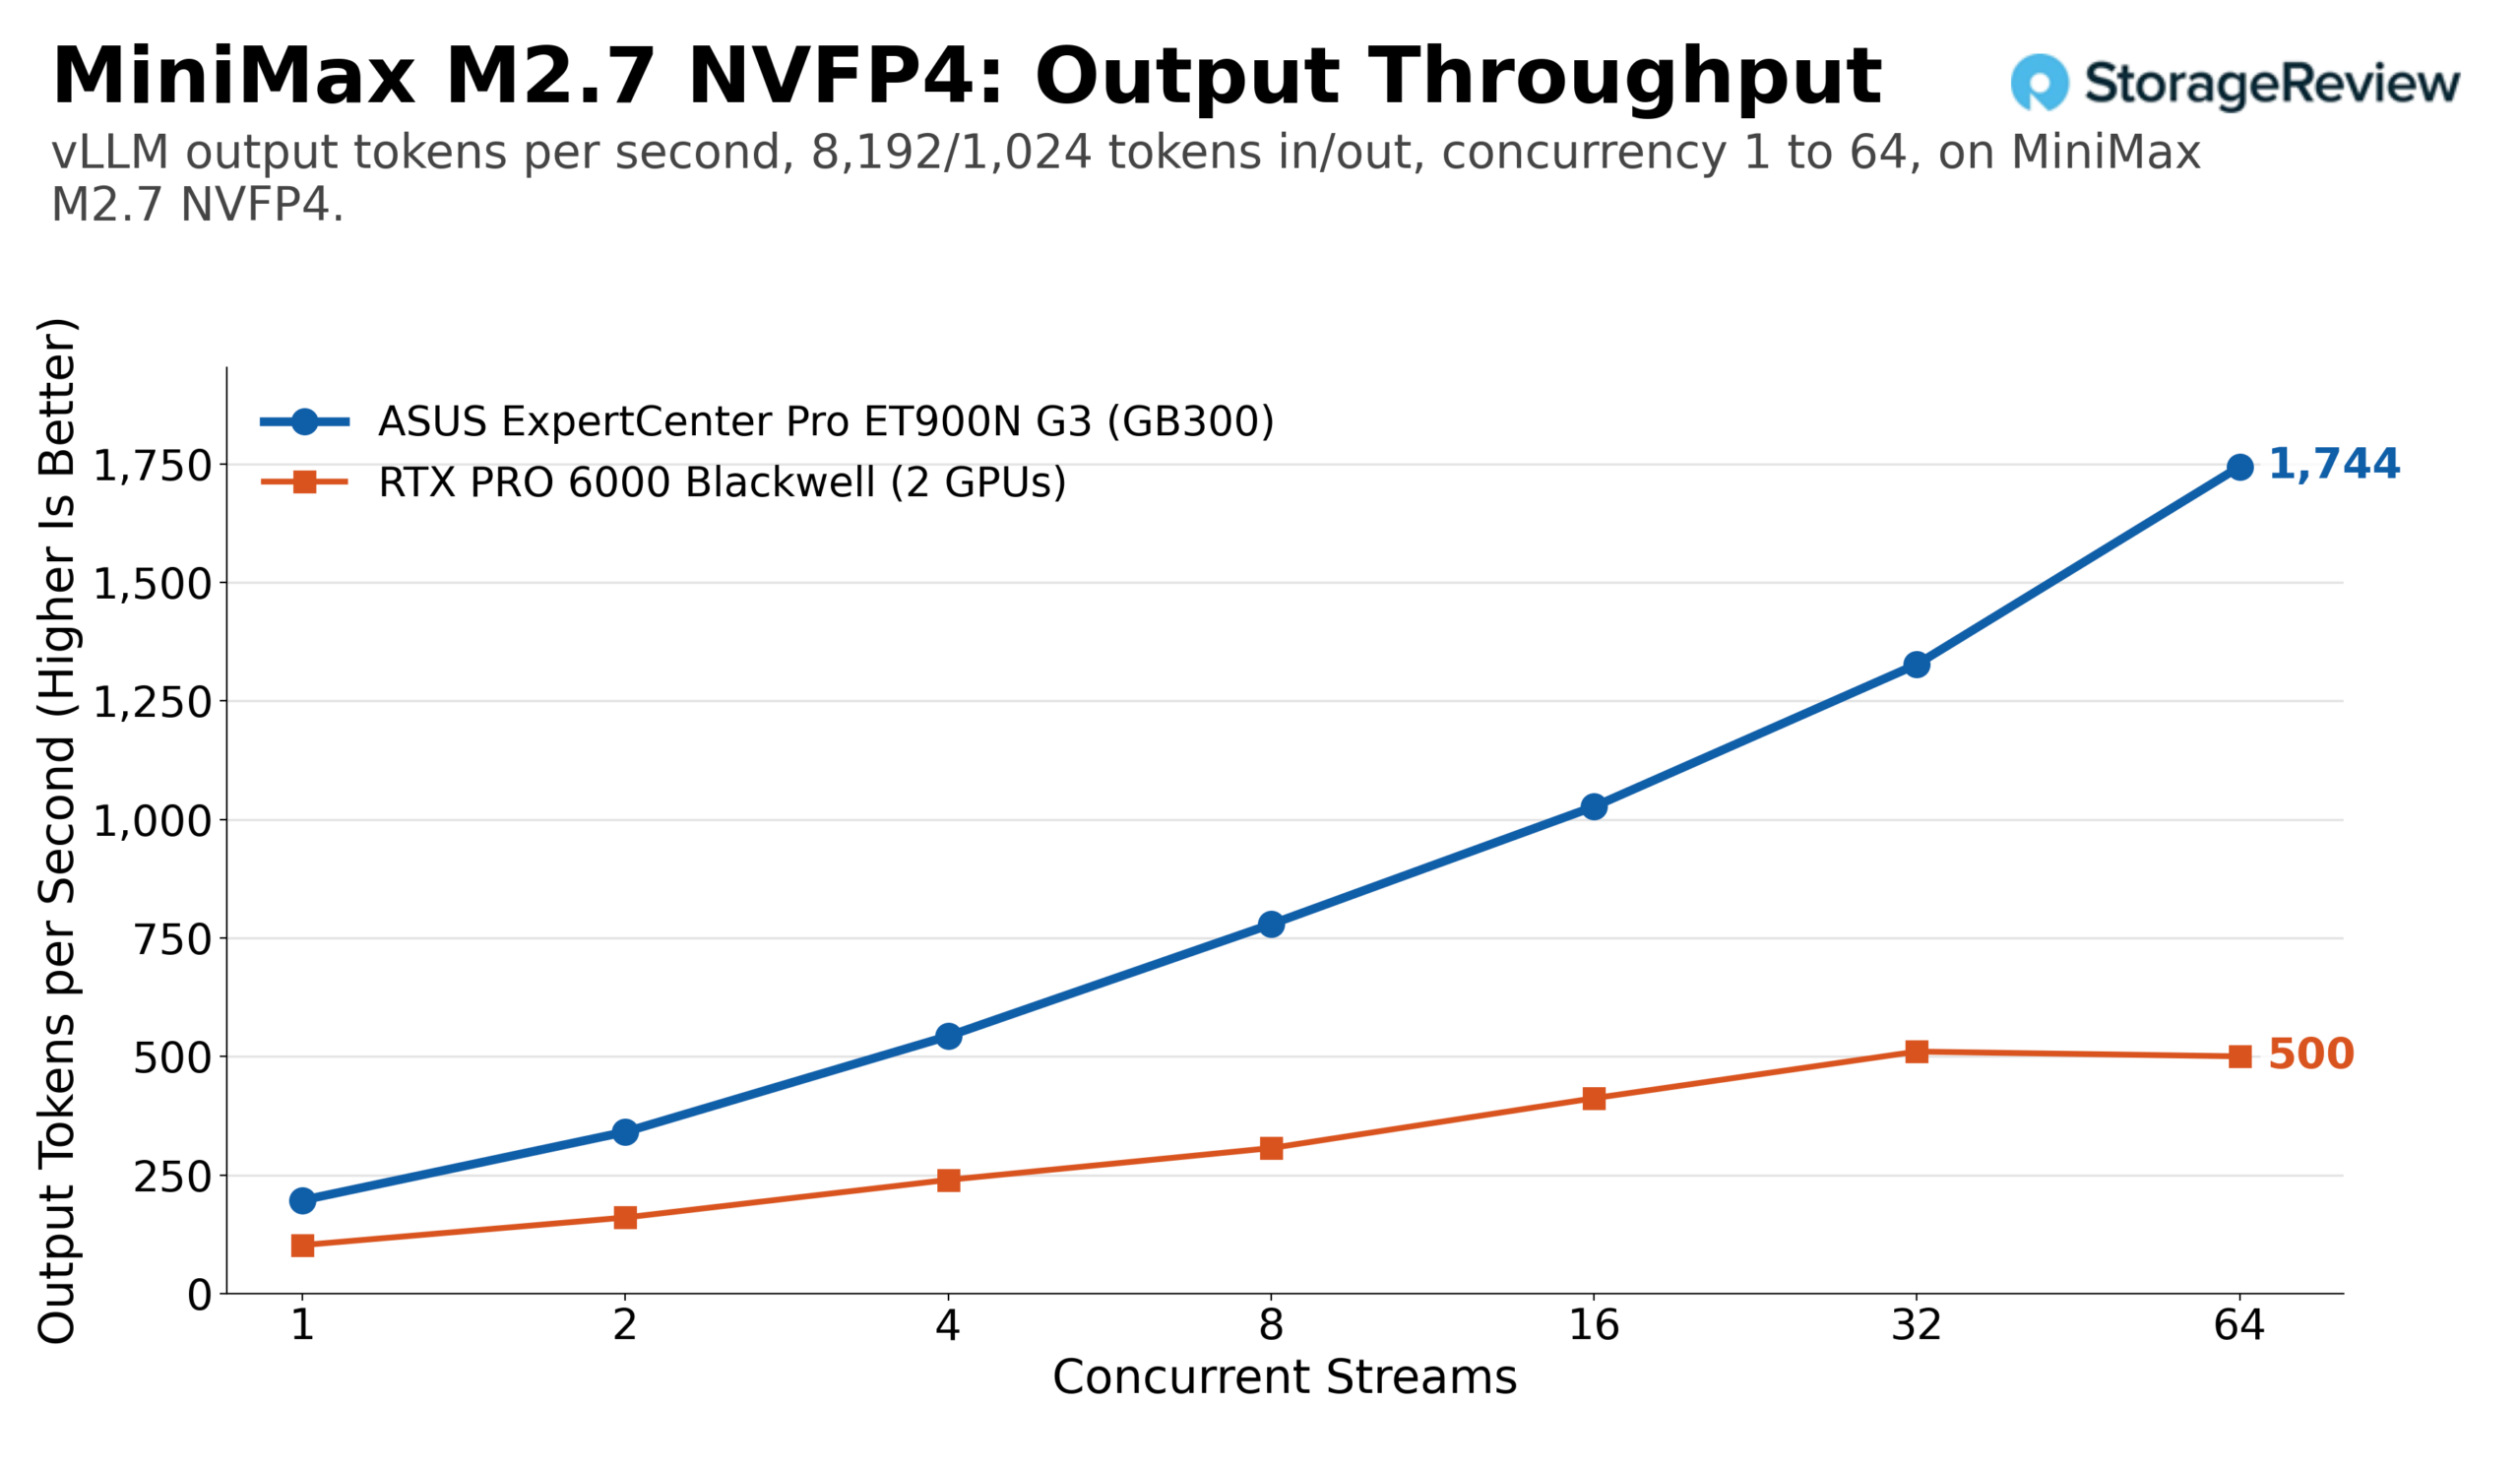
採用 NVIDIA NVFP4 量化技術的 MiniMax M2.7 佔用約 125GB HBM 記憶體,是四款顯示卡中效能擴充性最強的。在相同工作負載下,其輸出令牌數從單流每秒 214 個提升至 128 流每秒 4,793 個,總吞吐量達到 9,586 個。在預填充密集型運行中,其輸出令牌數擴展至每秒 1,744 個,總令牌數擴展至每秒 15,700 個(64 流)。兩張 RTX PRO 6000 系列顯示卡的效能曲線與 MiniMax M2.7 類似,但擴充性不到 MiniMax M2.7 的一半,在相同工作負載下最高輸出令牌數接近每秒 1,930 個,在長提示下約為每秒 510 個。
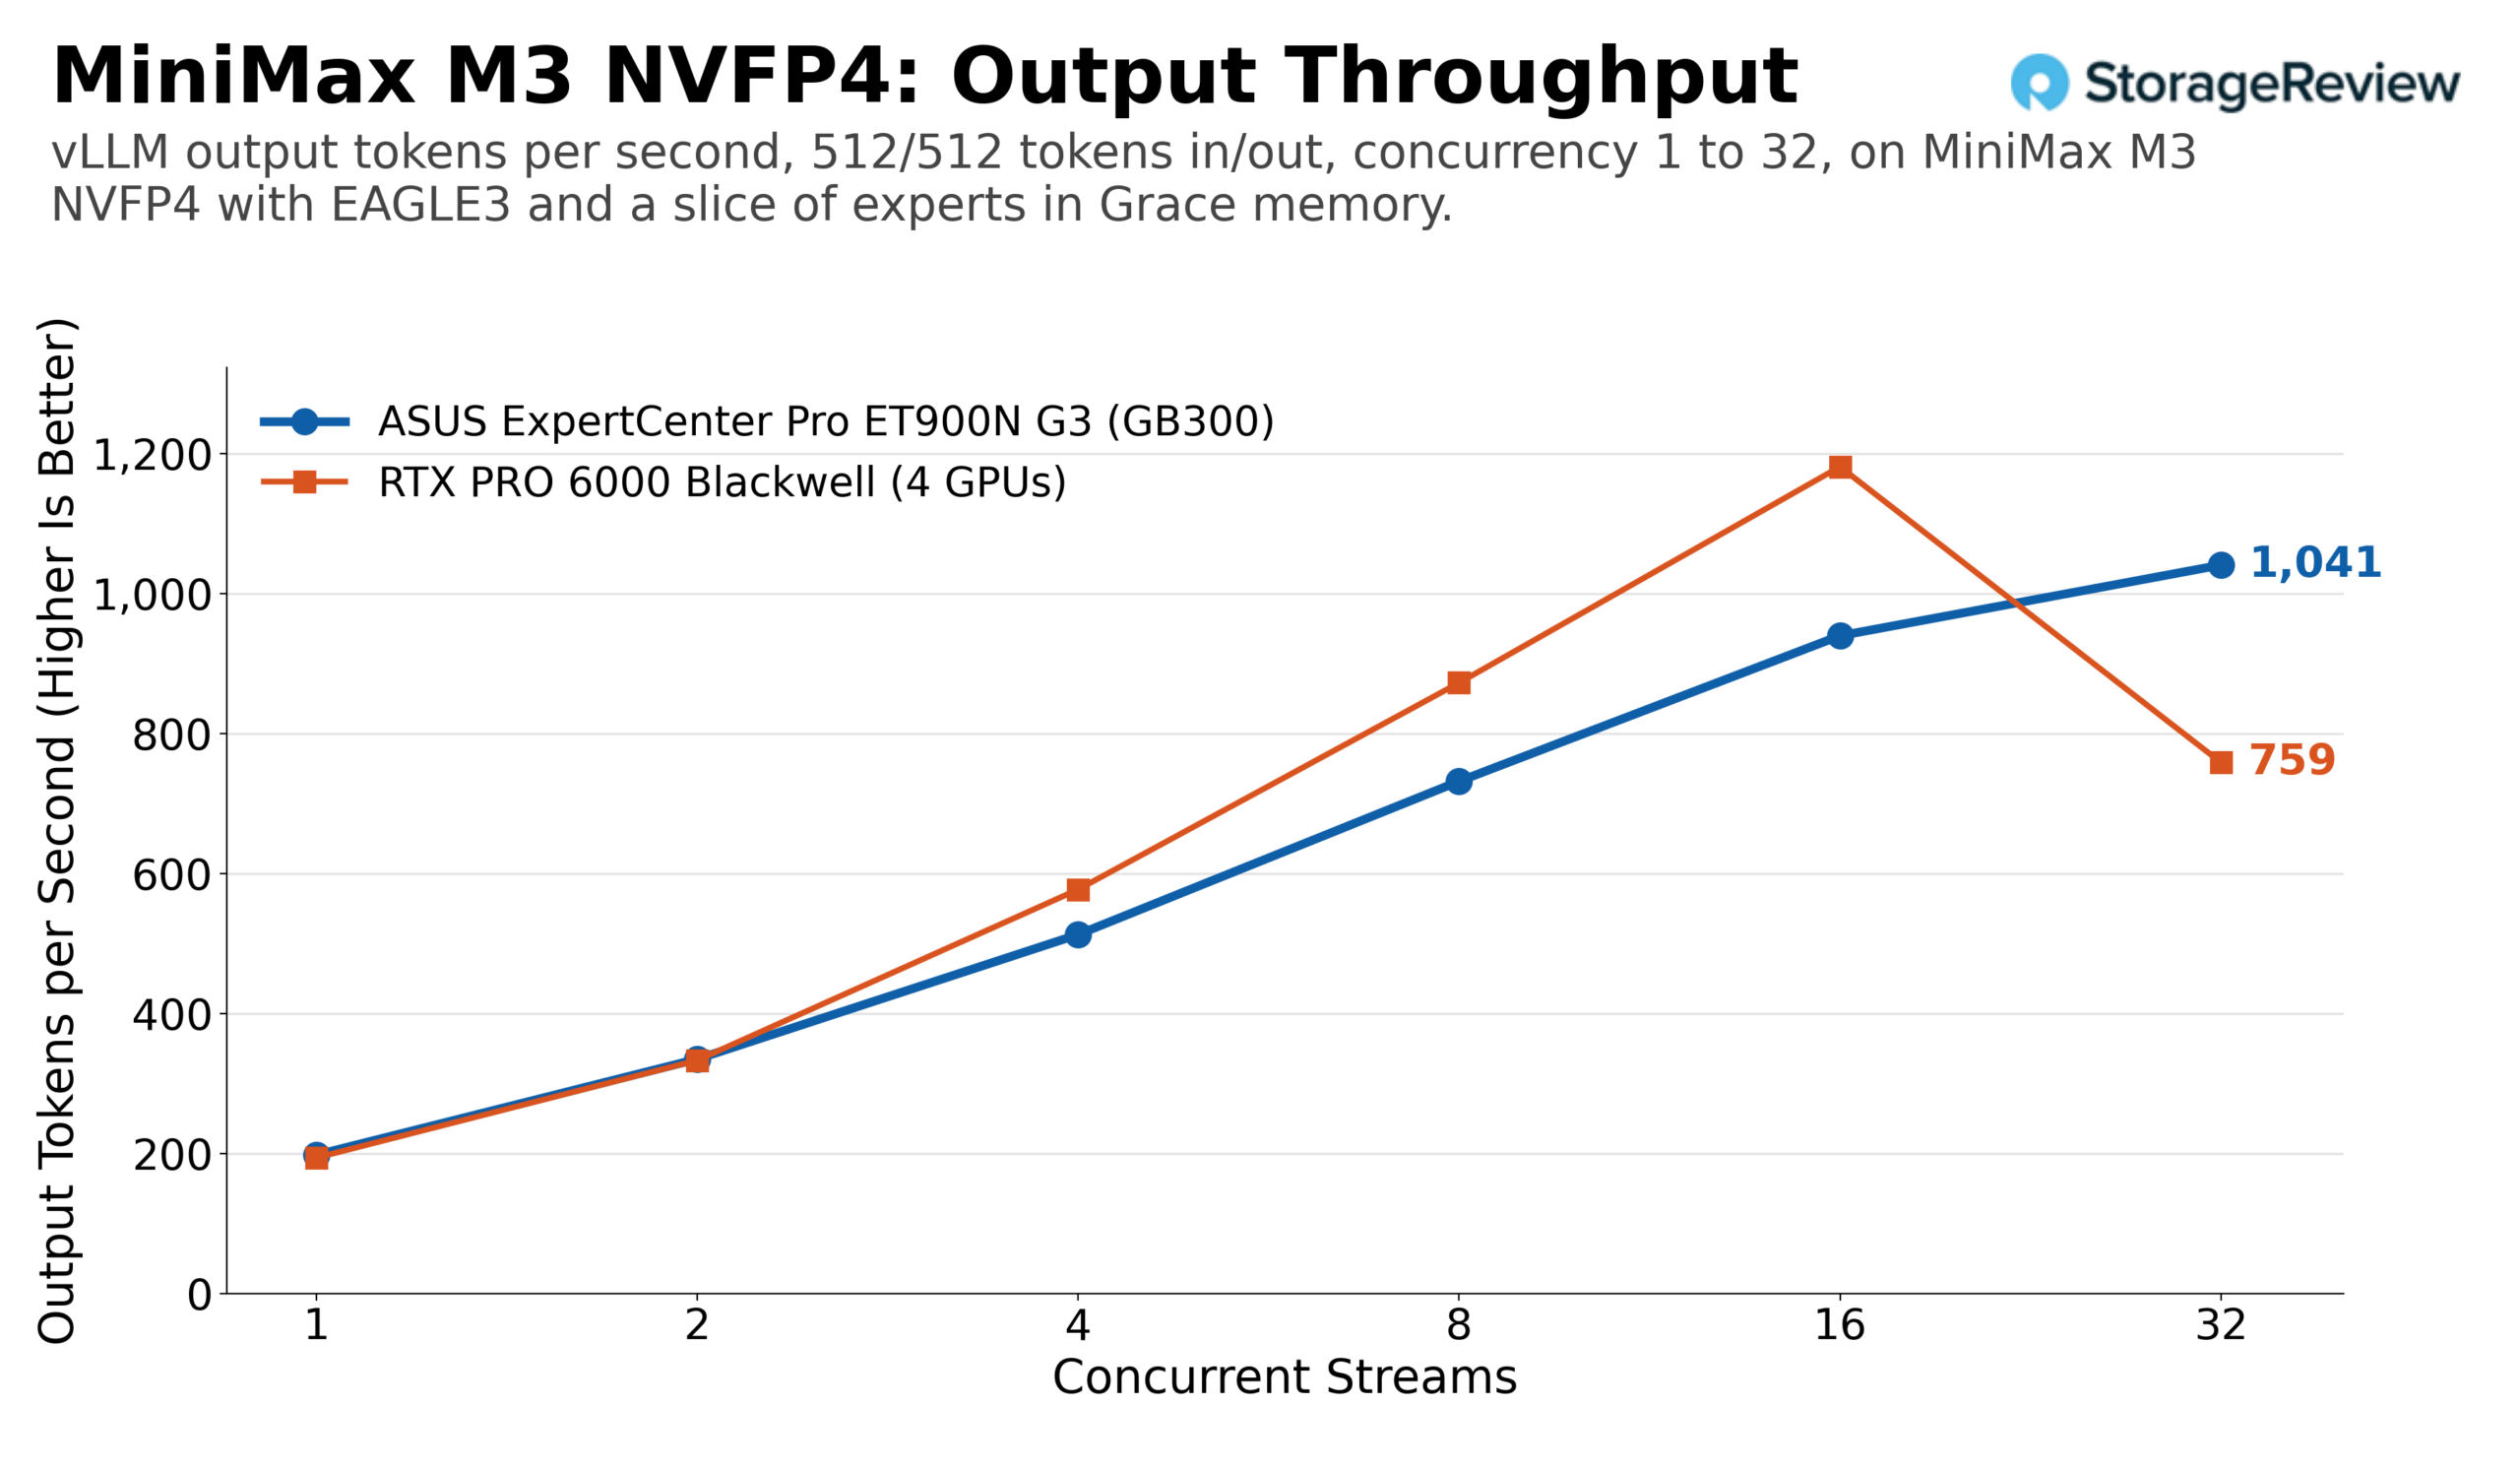
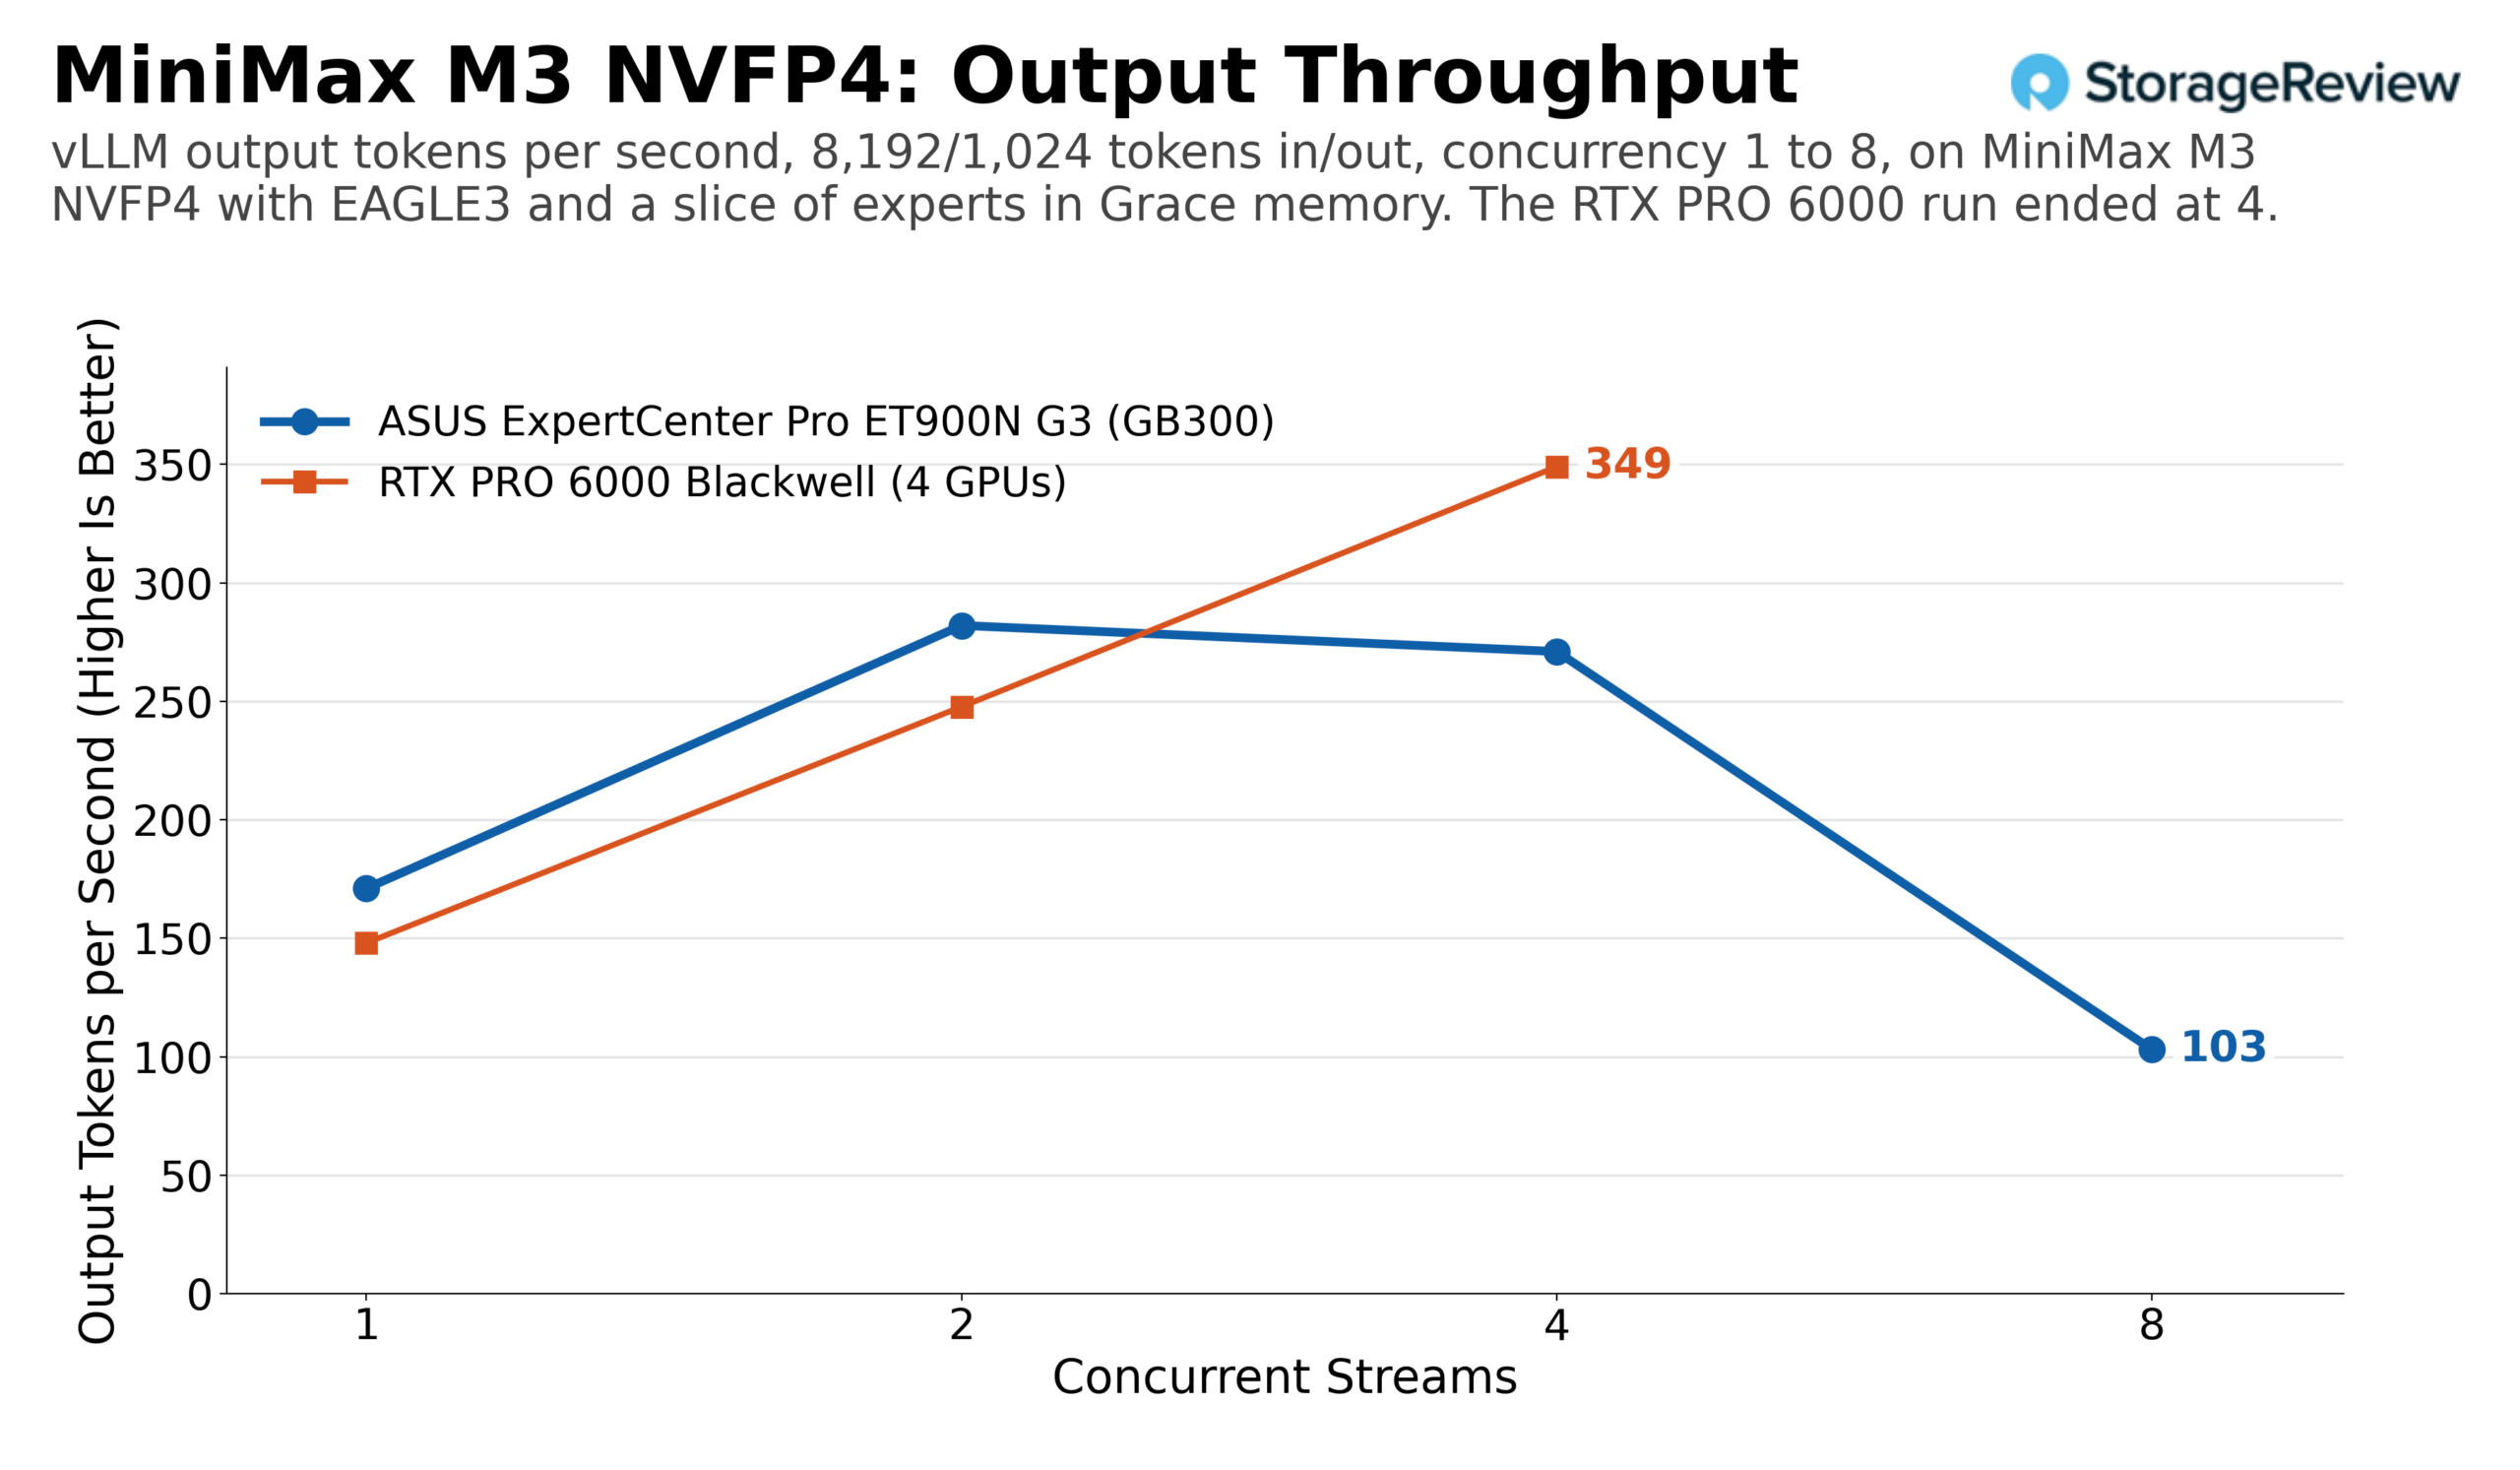
MiniMax M3 展示了記憶體容量捉襟見肘的現狀。 NVFP4 檢查點小於 252GB,但運行時和鍵值快取也需要空間,因此部分專家資訊駐留在 Grace 記憶體中,每個涉及這些專家資訊的解碼步驟都會經過 NVLink-C2C。在相同的負載下,使用 EAGLE3 推測解碼時,ET900N G3 在 32 個流下達到了每秒 1,041 個輸出標記;而預填充密集型配置在兩個流下達到了每秒 282 個輸出標記的峰值,四個流下保持在每秒 271 個,而八個流下則由於長提示消耗了剩餘緩存而降至 103 個每秒。四張配備相同推測解碼器的 RTX PRO 6000 顯示卡在八個流下保持了相同的速度,並在 16 個流下以每秒約 1,180 個輸出標記的速度領先,然後在 32 個流下回落至約每秒 760 個輸出標記。在預先填充較多的配置下,四卡盒每秒可處理約 349 個輸出令牌(四個流),而 Station 則為 271 個。該型號正好位於 HBM 邊界,是該系列中唯一一個四卡 384GB VRAM 與 252GB HBM 加上卸載功能相競爭的型號。
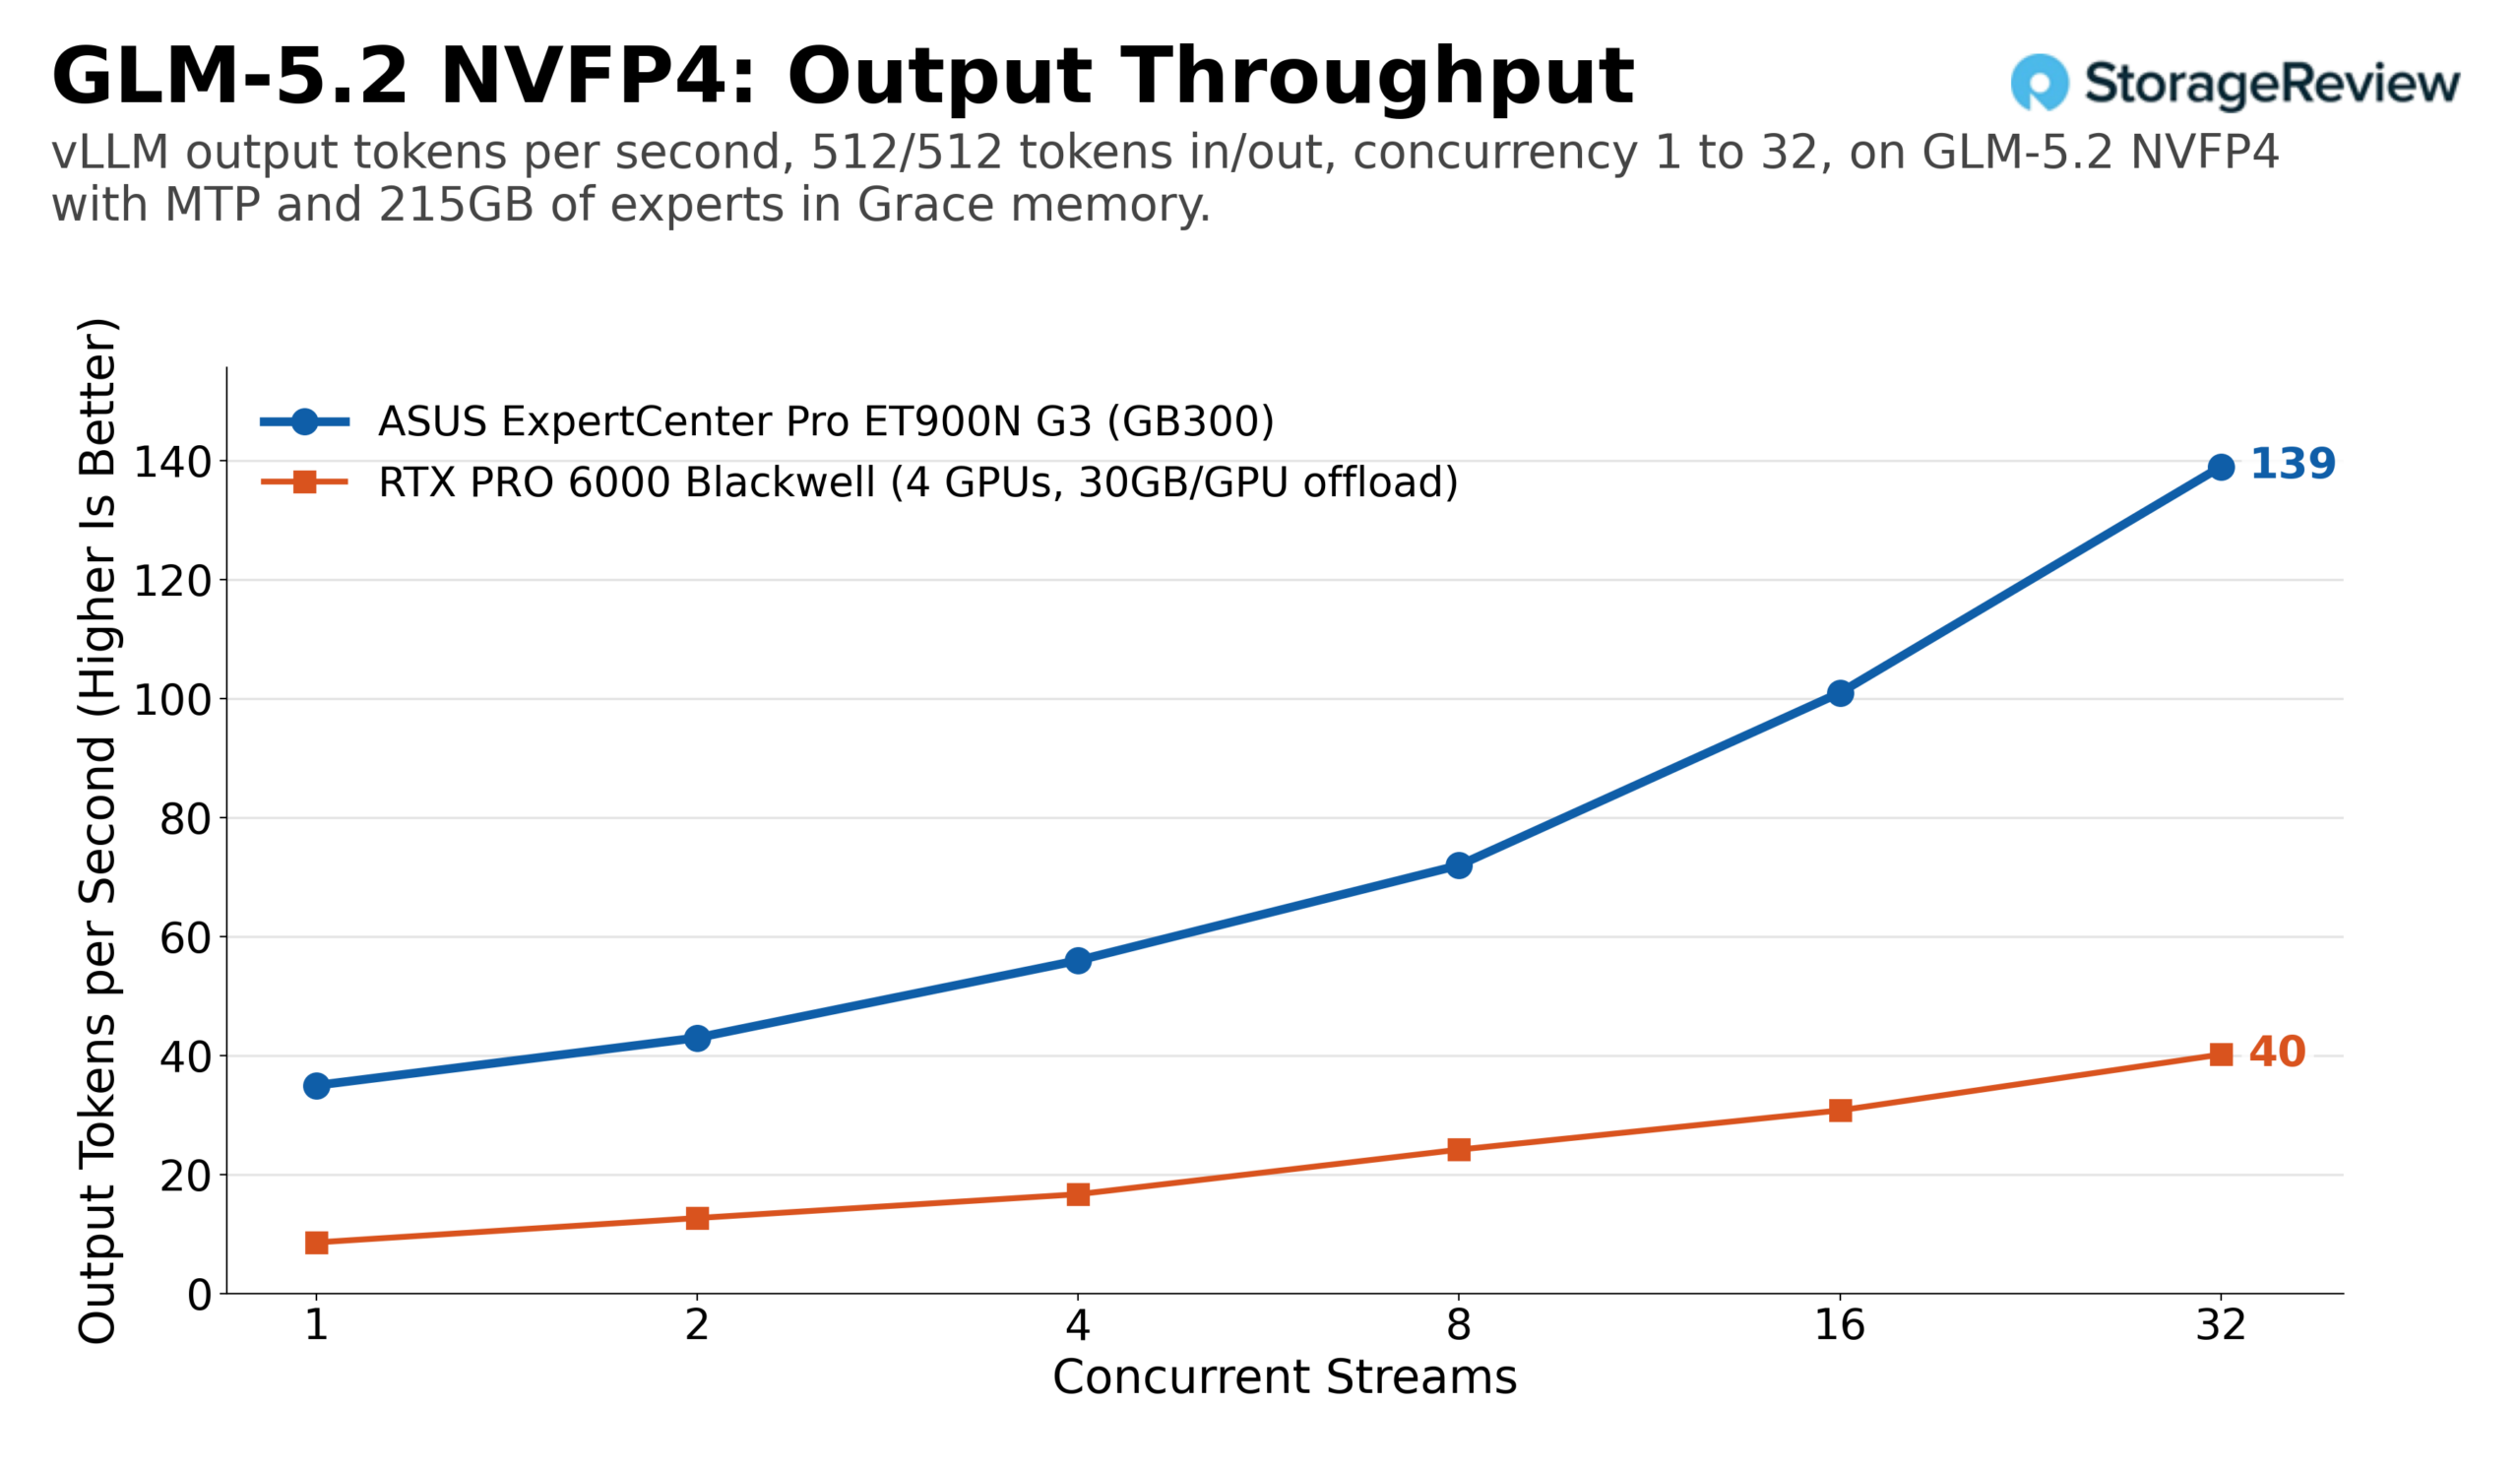
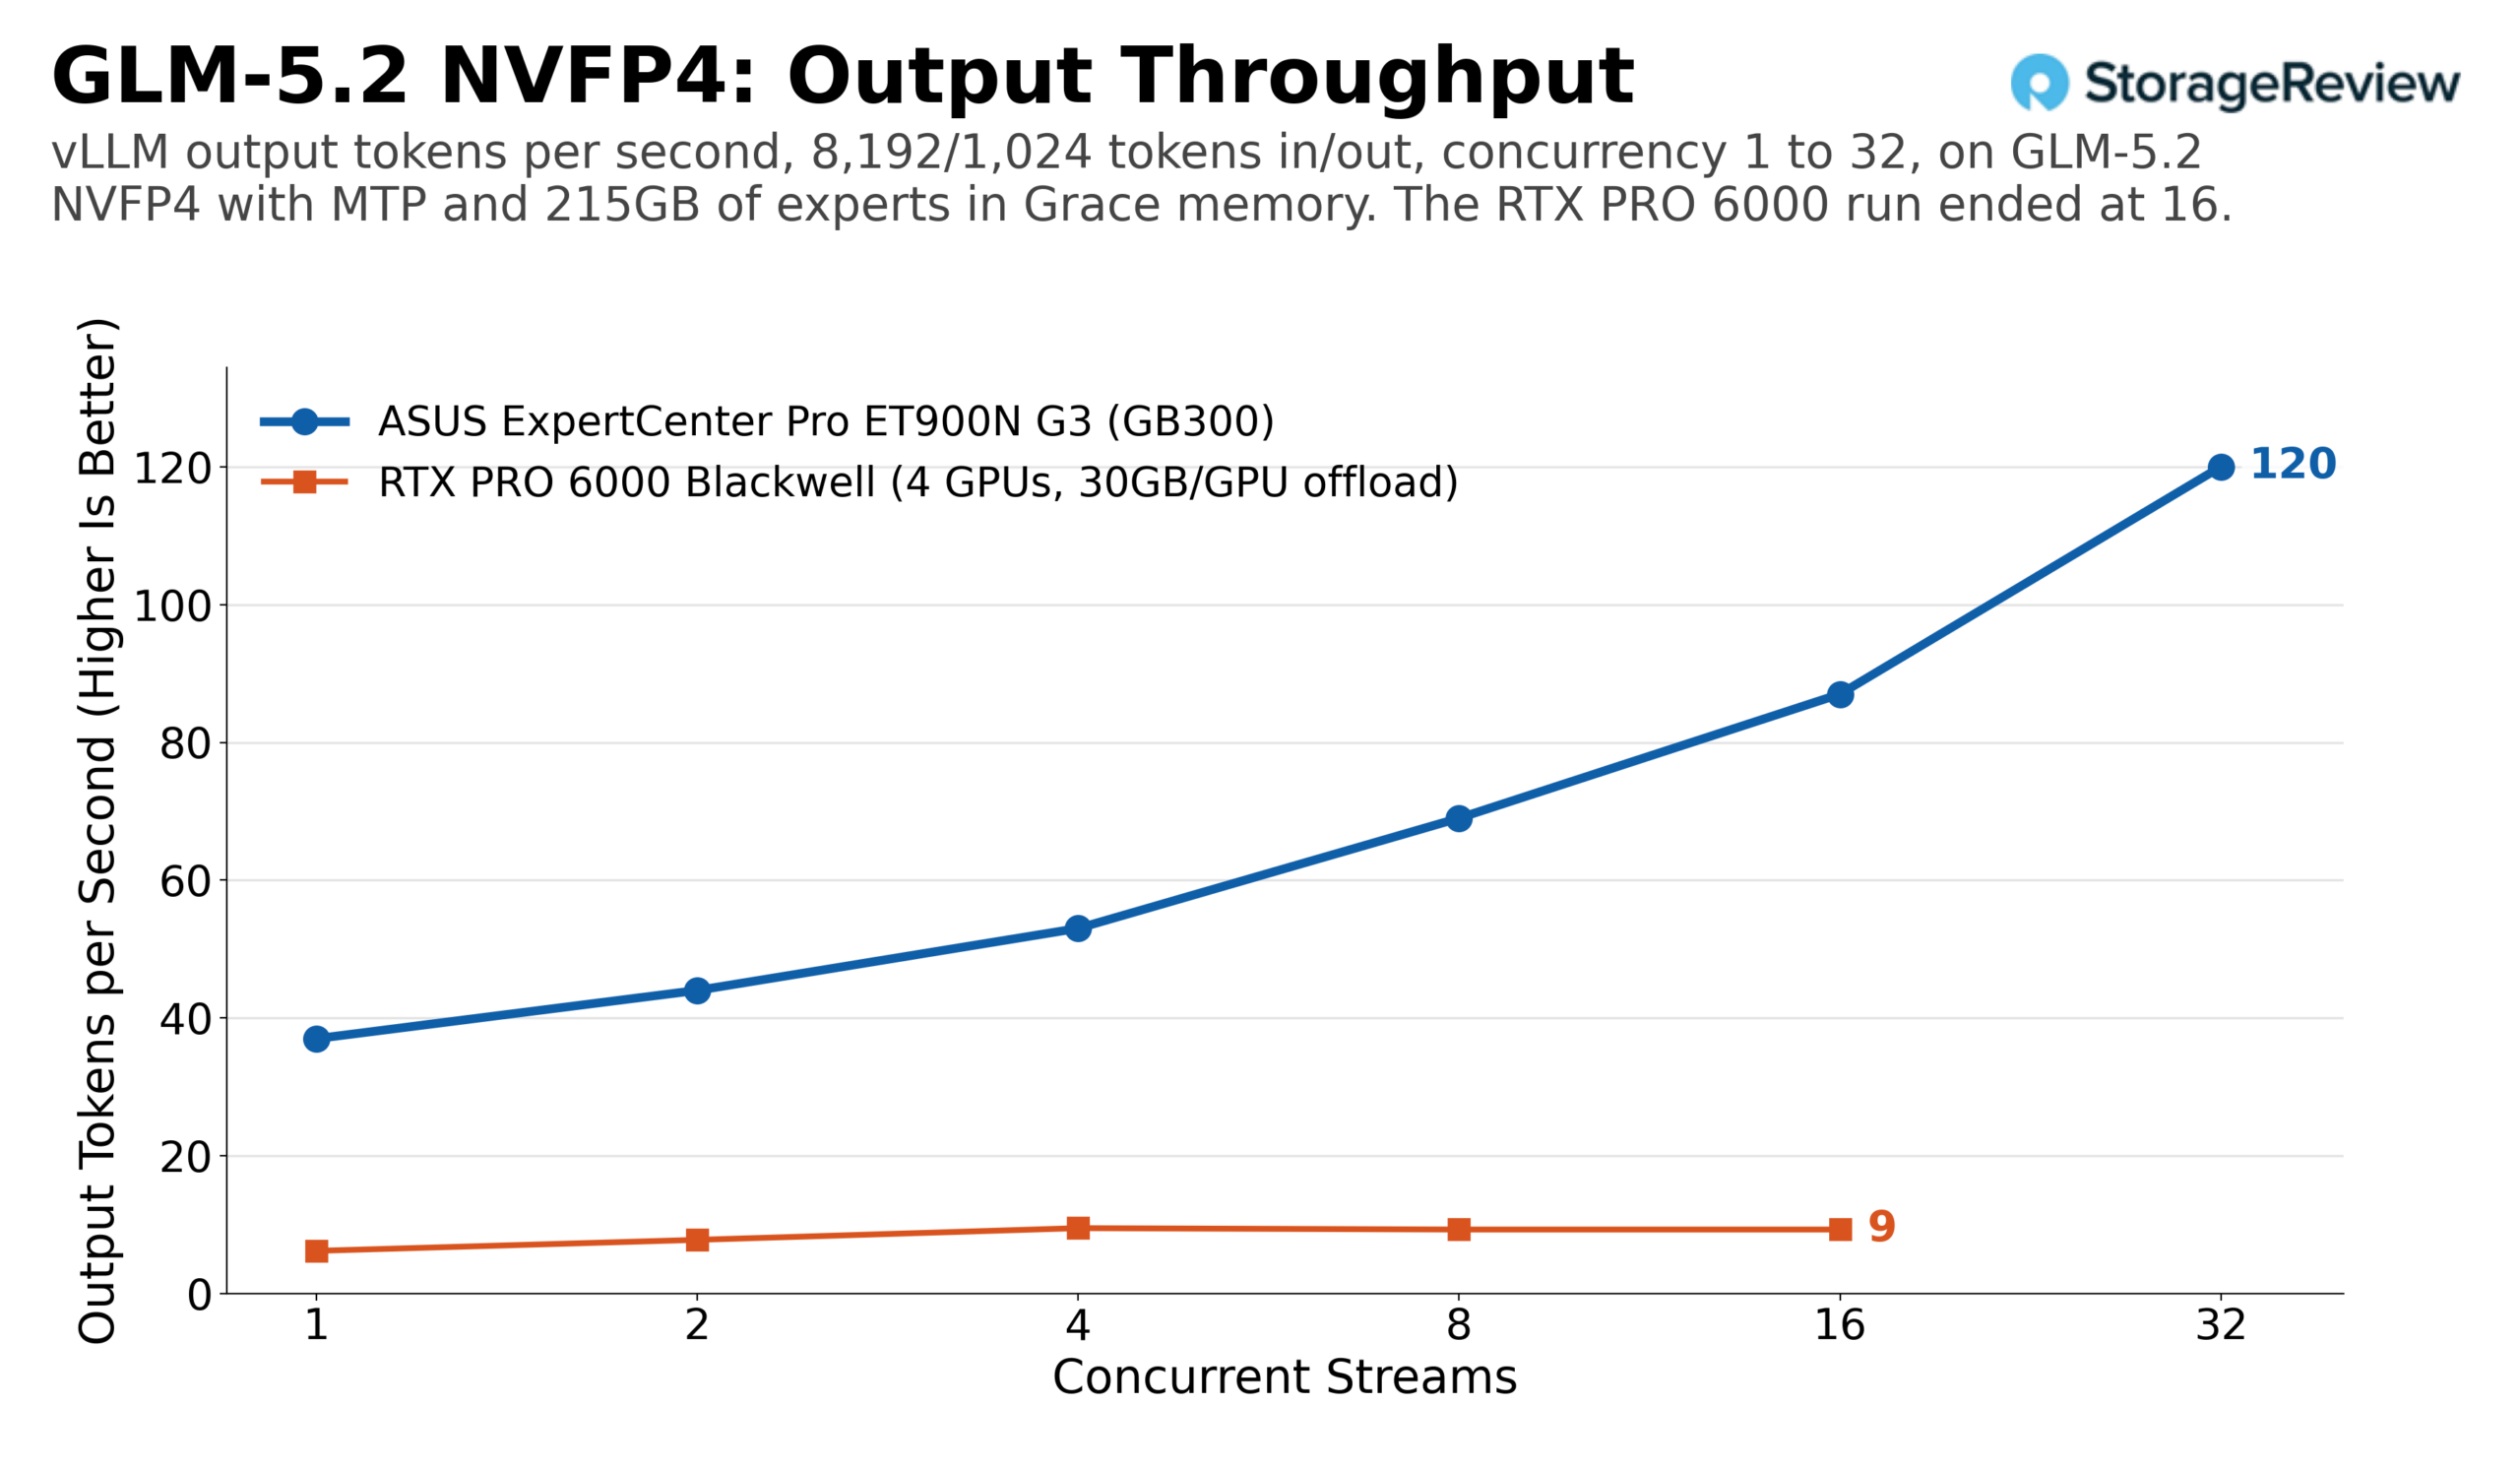
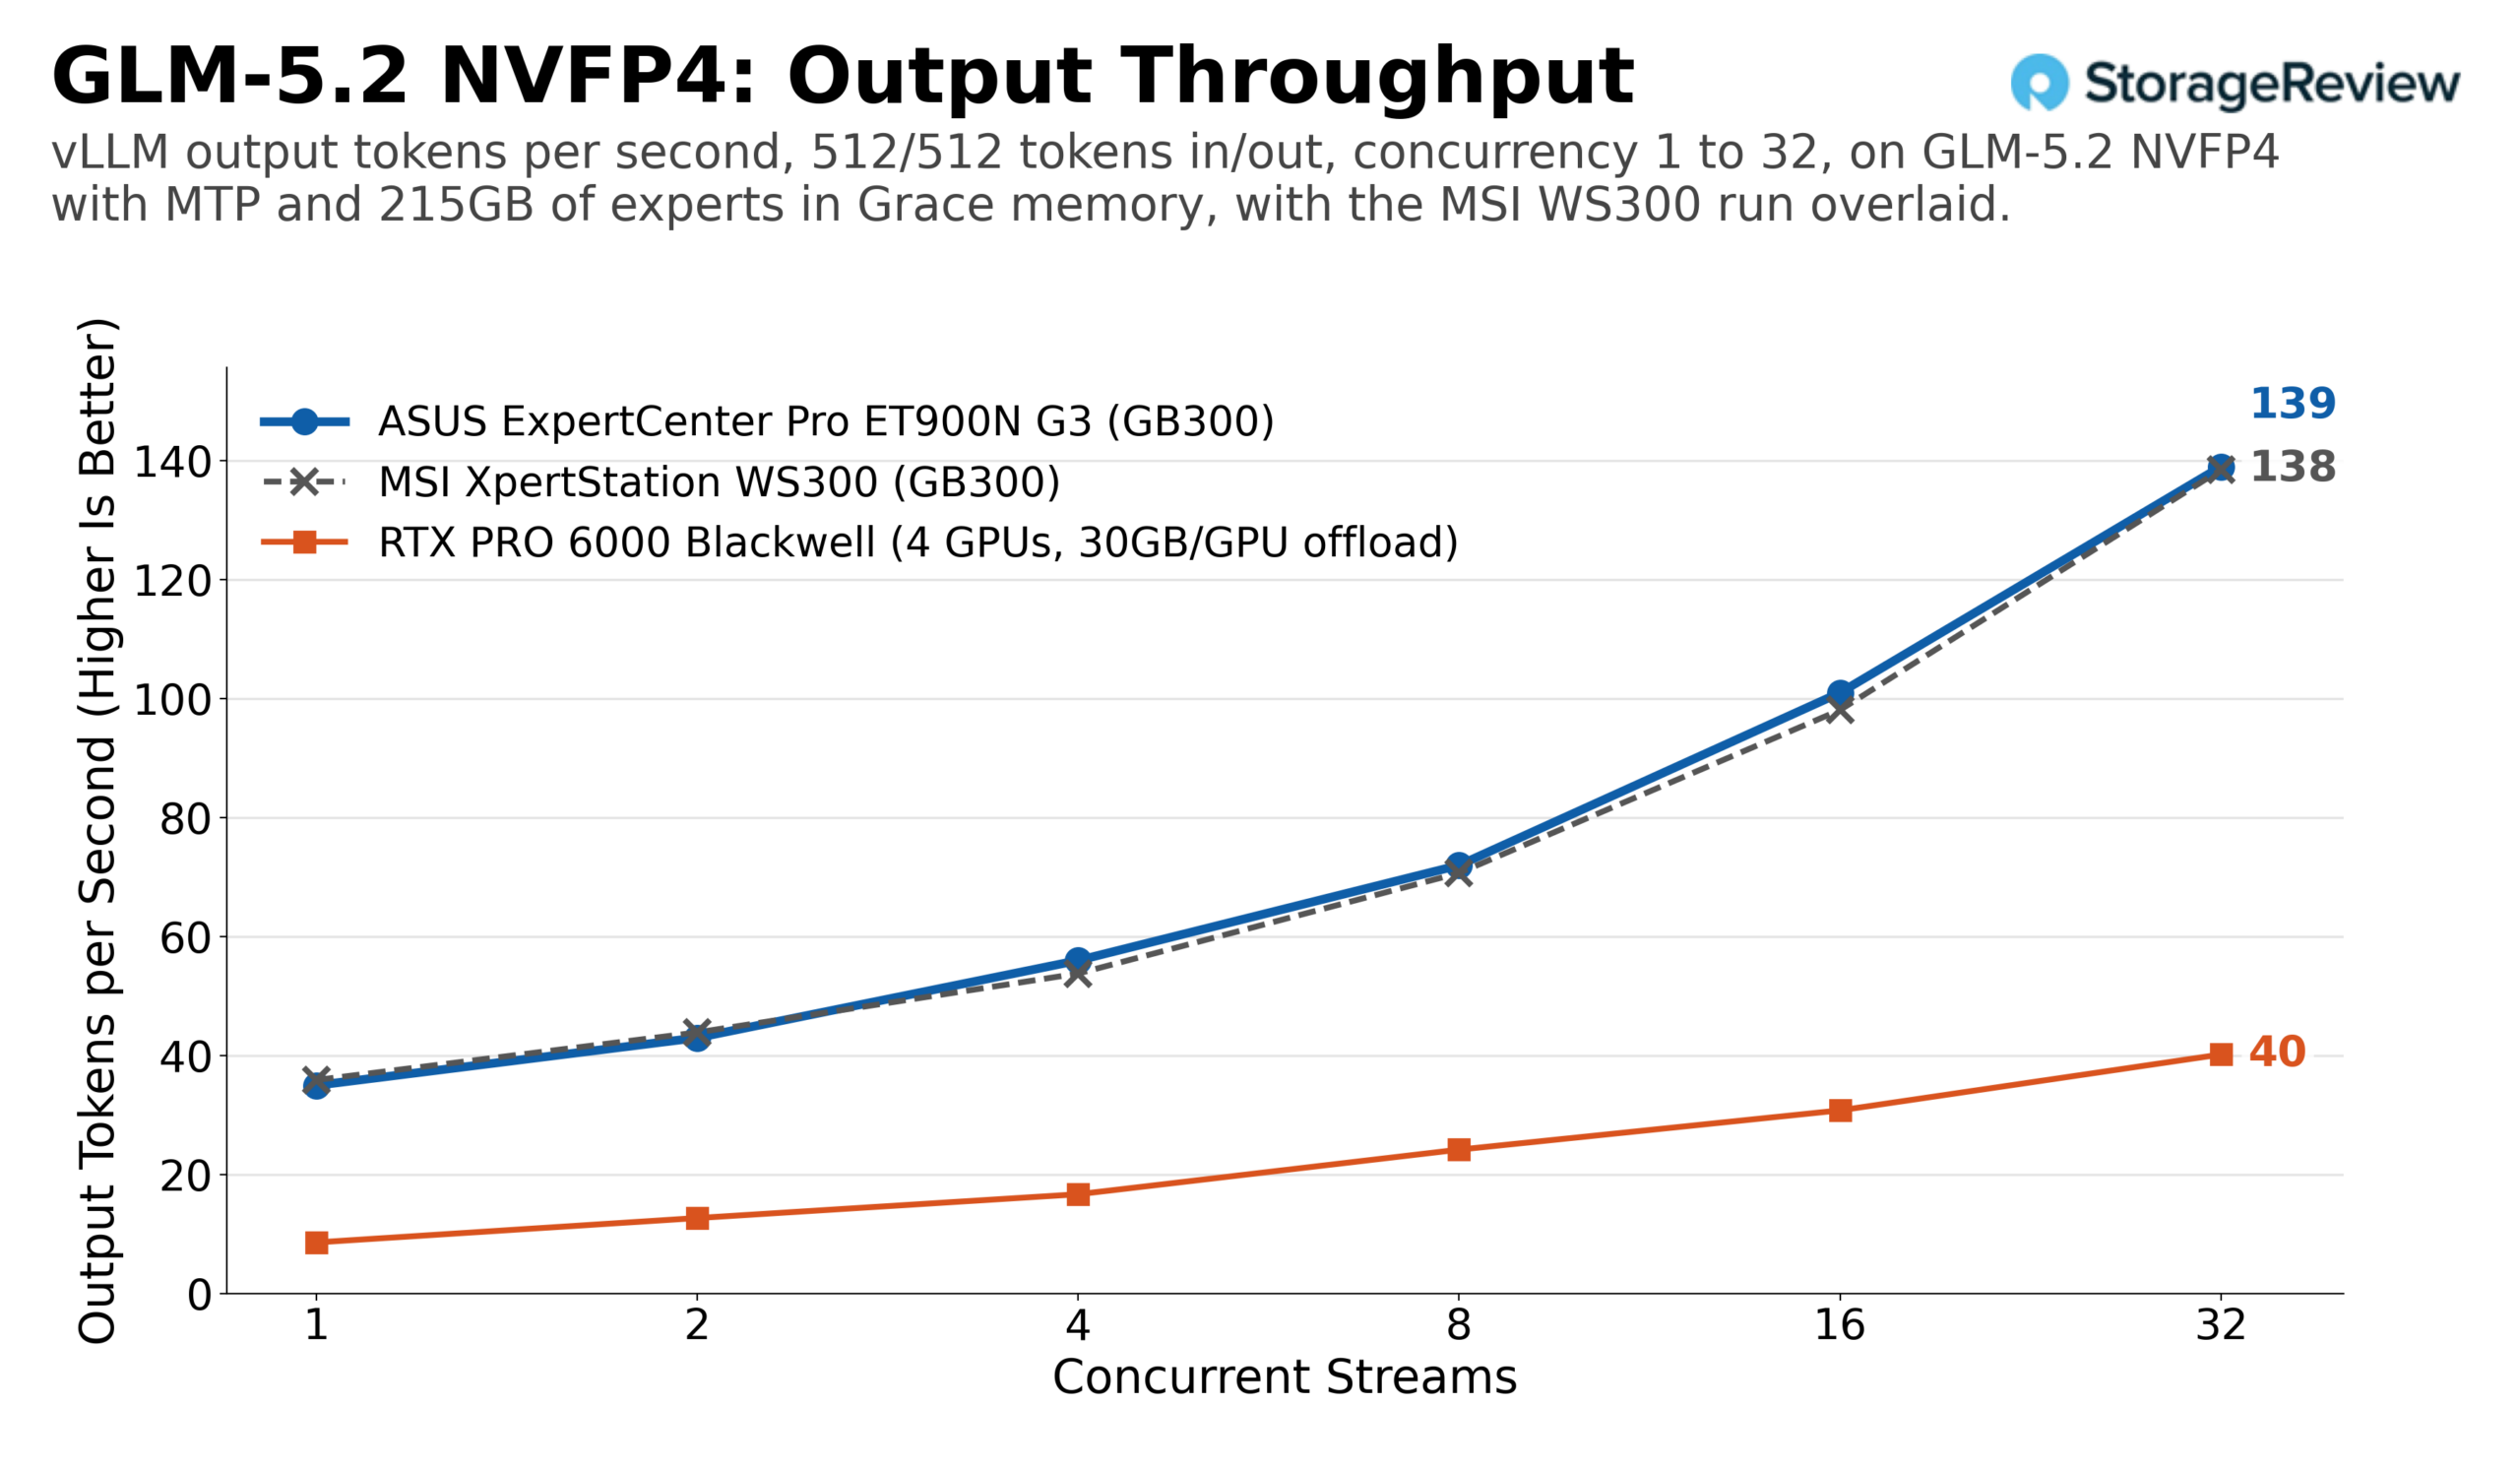
GLM-5.2 是只有相干池才能實現的用例。 NVFP4 檢查點在 Grace 記憶體中保存了約 215GB 的專家權重,並採用 MTP 推測解碼。在相同的工作負載下,ET900N G3 處理單流資料時每秒輸出 35 個標記,處理 32 流資料時每秒輸出 139 個標記,總吞吐量達到 277。在預填較多的場景下,掃描運行到 32 流,每秒輸出 120 個標記,總標記數達到 1,079 個。四張 RTX PRO 6000 顯示卡,每張顯示卡將約 30GB 的內存卸載到主機內存,在處理 32 流資料時每秒輸出約 40 個標記,而從四個流開始,在長提示符下每秒輸出約 9 到 10 個標記。這兩個系統都無法讓 433GB 型號感覺很快,但 GB300 的 396GB/s LPDDR5X 和 900GB/s NVLink-C2C 路徑,對於卸載專家來說,其擴展能力在 PCIe 連接的主機內存通過四張卡達到極限時仍然能夠繼續提升。
與 MSI WS300 相比,ET900N G3 的前沿模型結果在我們能夠比較的每個點上都相差不到 1%:在 DeepSeek V4 Flash 上,兩個塔式機在 32 流下每秒輸出 1,766 個令牌;在 MiniMax M2.7 上,128 流下每秒輸出 4,766 個令牌;在 MiniMax M2.7 上,128 流下每秒輸出 4,793 個令牌,在 M2.7 上,128 流下每秒輸出 4,793 個令牌; M3 上,兩台塔式機在 32 流下每秒輸出 1,041 個令牌;在 GLM-5.2 上,兩台塔式機在 32 流下每秒輸出 139 個令牌。
與 RTX PRO 6000、H200 NVL 和 DGX Spark 共享型號
基準測試的後半部使用了足夠小的模型,以便所有系統都能運作:原生 MXFP4 模式下的 GPT-OSS-20B 和 120B;BF16 和 FP8 模式下的 Llama 3.1 8B;BF16 和 FP8 模式下的 Mistral Small 24B;以及 BFB16 和 Q370 模式下的 3024B;自 WS300 評測以來,新增了一塊 H200 NVL,即 NVIDIA 的 141GB Hopper 顯示卡,這使得對比測試中出現了上一代資料中心加速器。
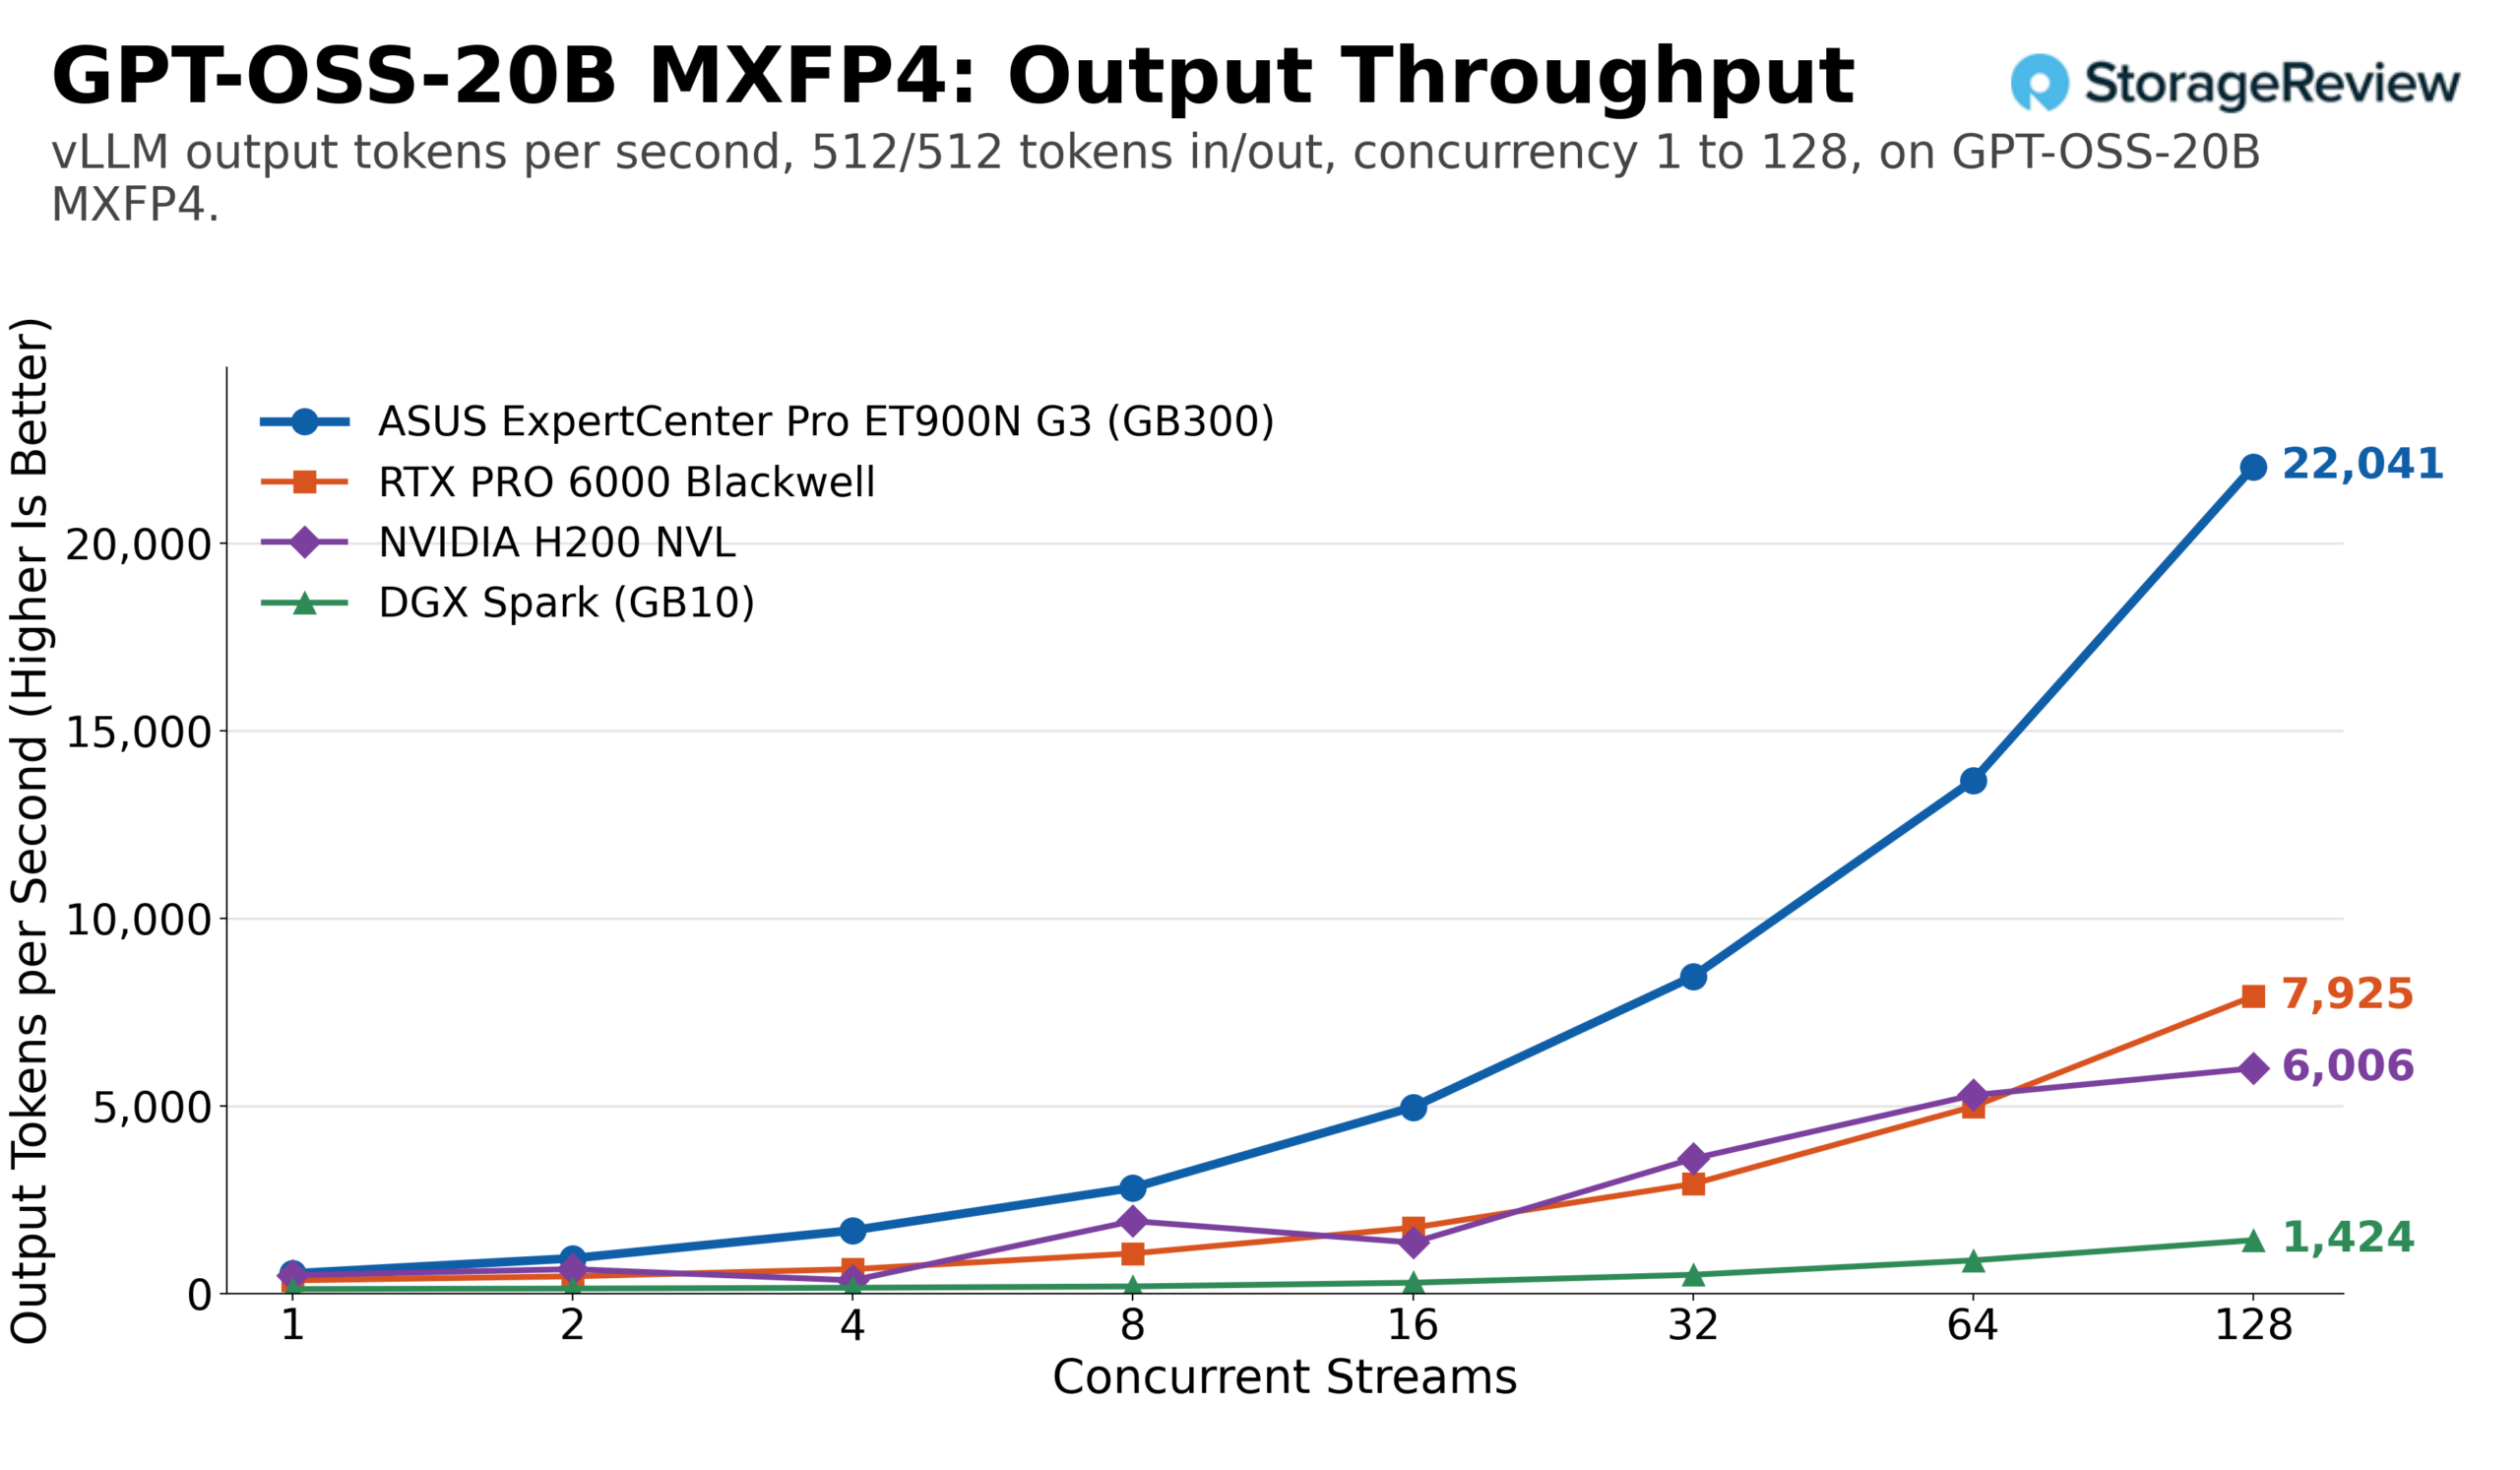
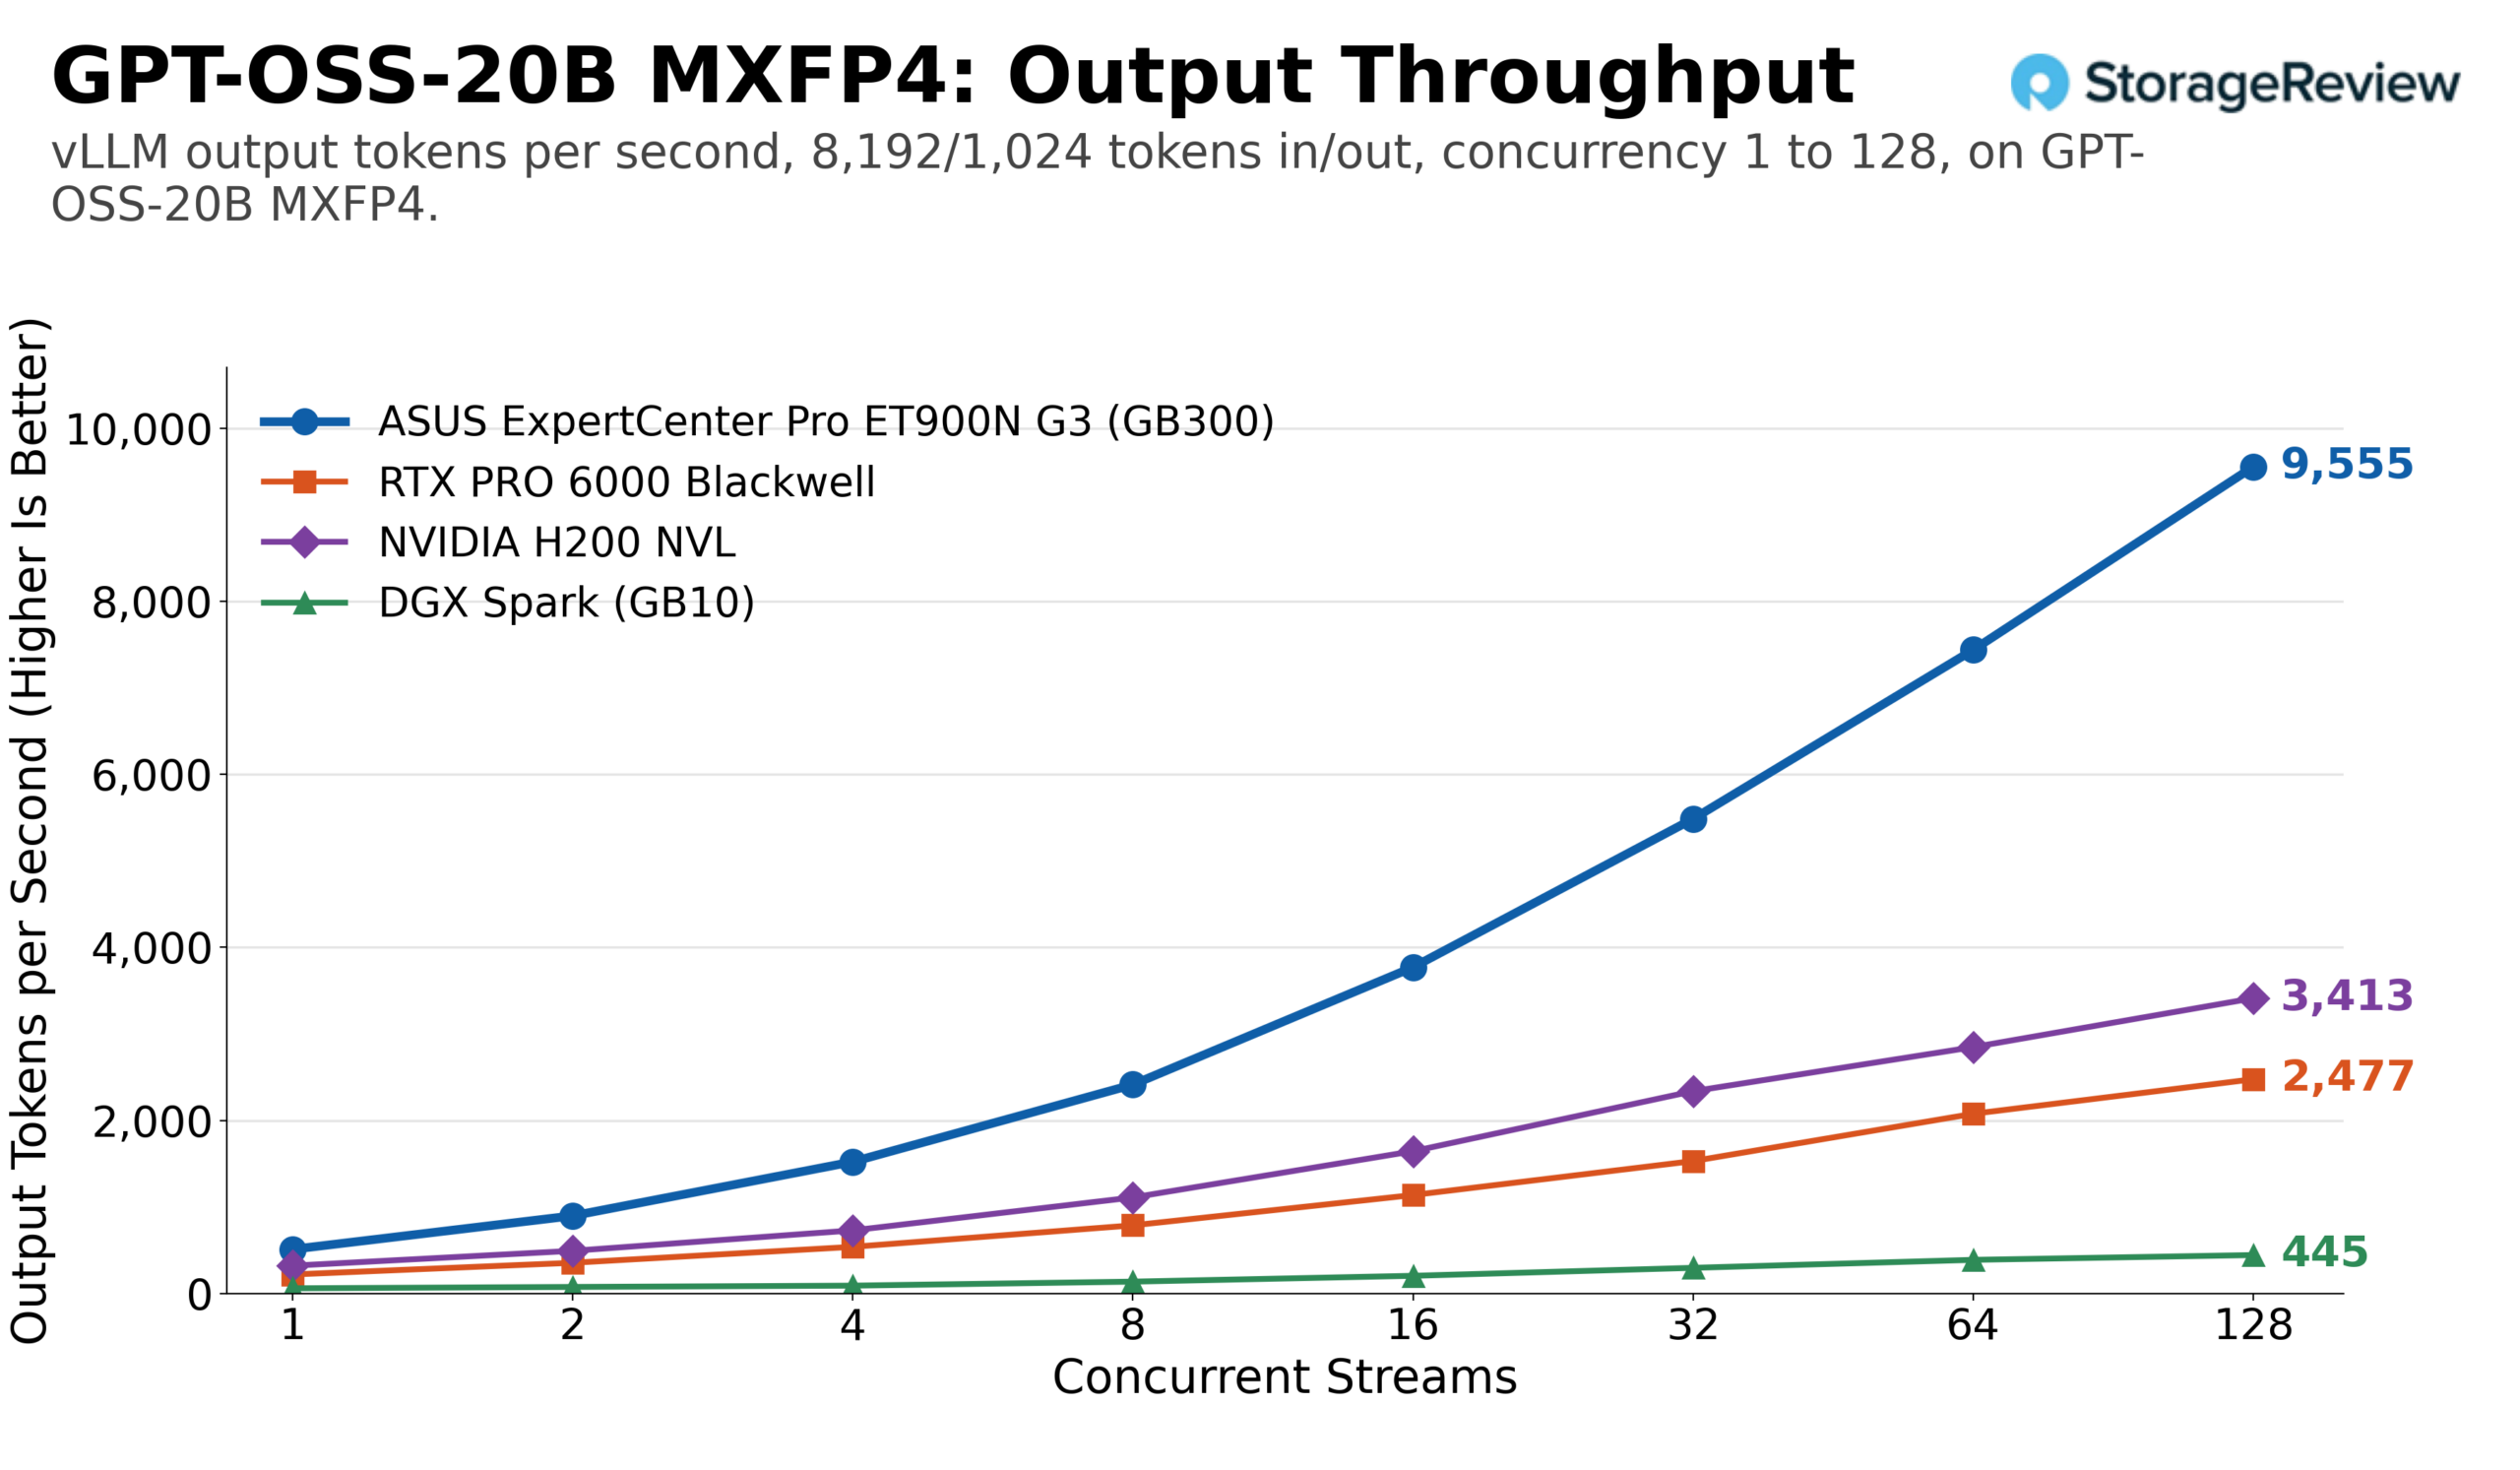
GPT-OSS-20B 是這組測試中最友善的,每個系統都能輕鬆通過。在相同的工作負載下,ET900N G3 在 128 個流下每秒輸出 22,041 個令牌,總共 44,082 個令牌,而 RTX PRO 6000 約為 7,920 個令牌,H200 NVL 約為 6,010 個令牌,DGX Spark 約為 1,420 個令牌。在單流模式下,Station 每秒可產生 536 個輸出令牌,而顯示卡為 354 個,H200 為 489 個,Spark 為 120 個。預填充密集型配置檔案進一步拉大了差距:Station 在 128 個流下每秒可產生 9,555 個輸出令牌,總共 85,994 個,而 RTX PRO 6000 約為 2,480 個,H200 NVL 為 3,410 個,Spark 為 445 個。
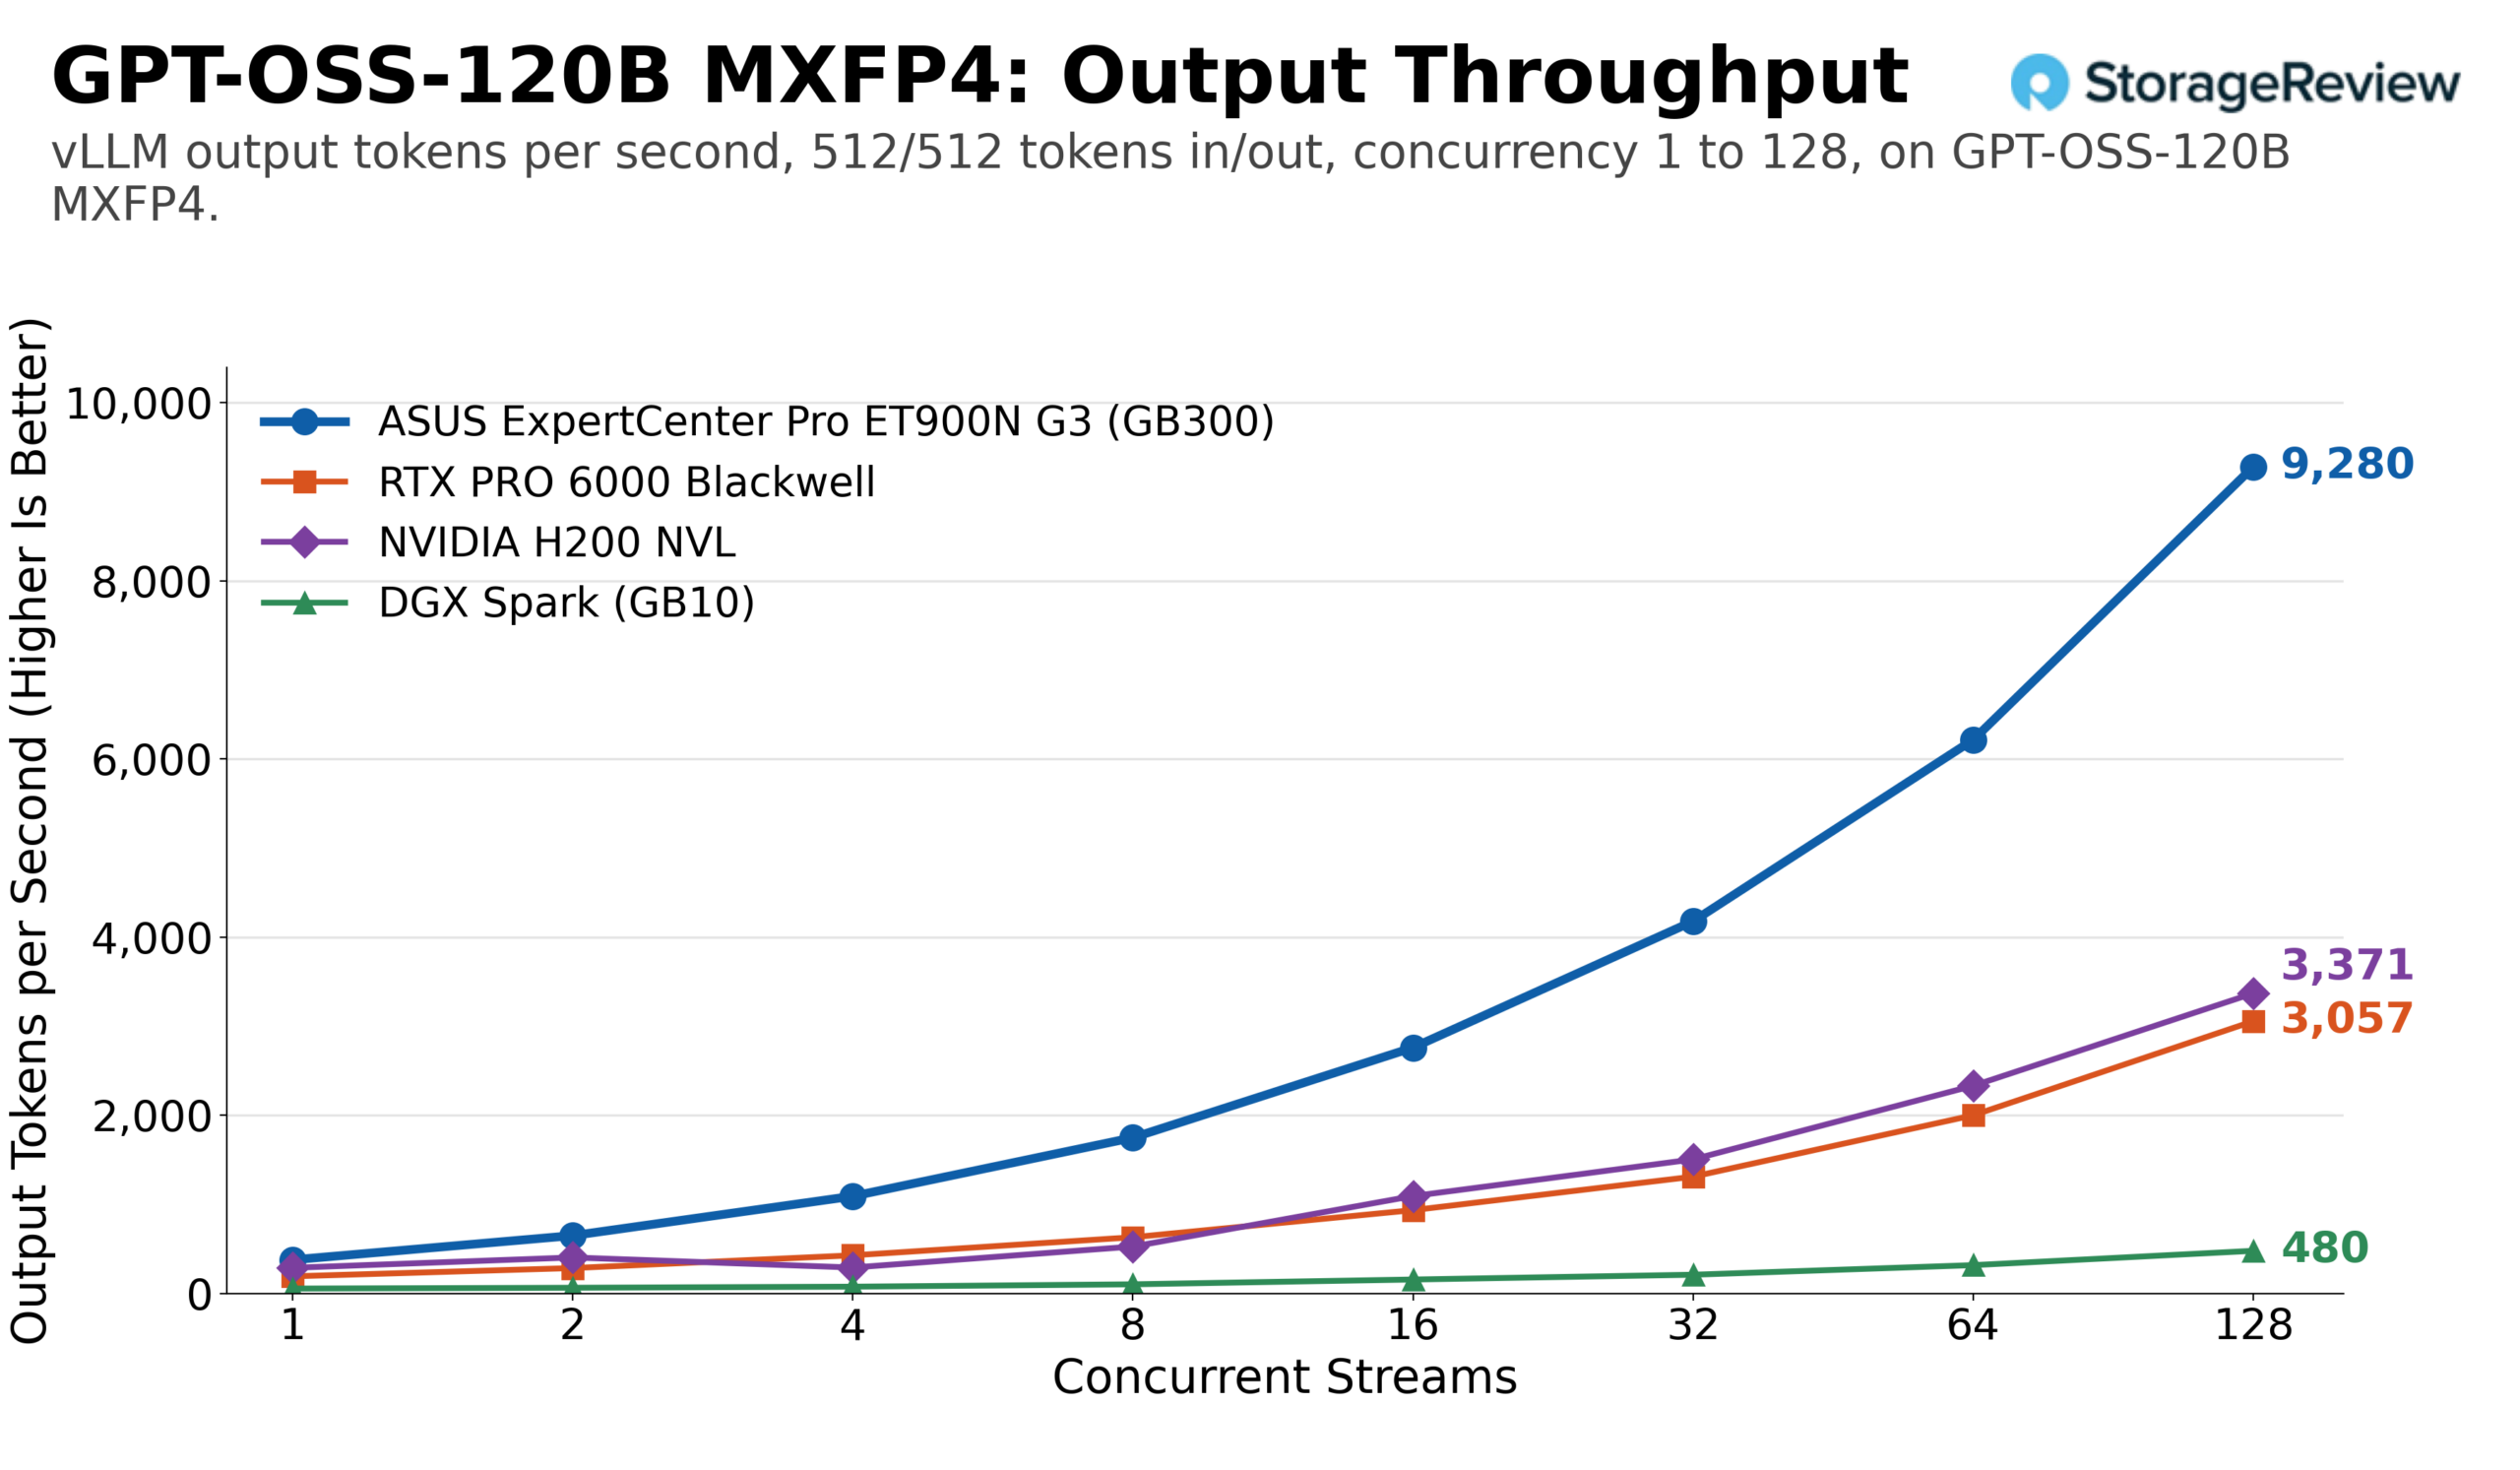
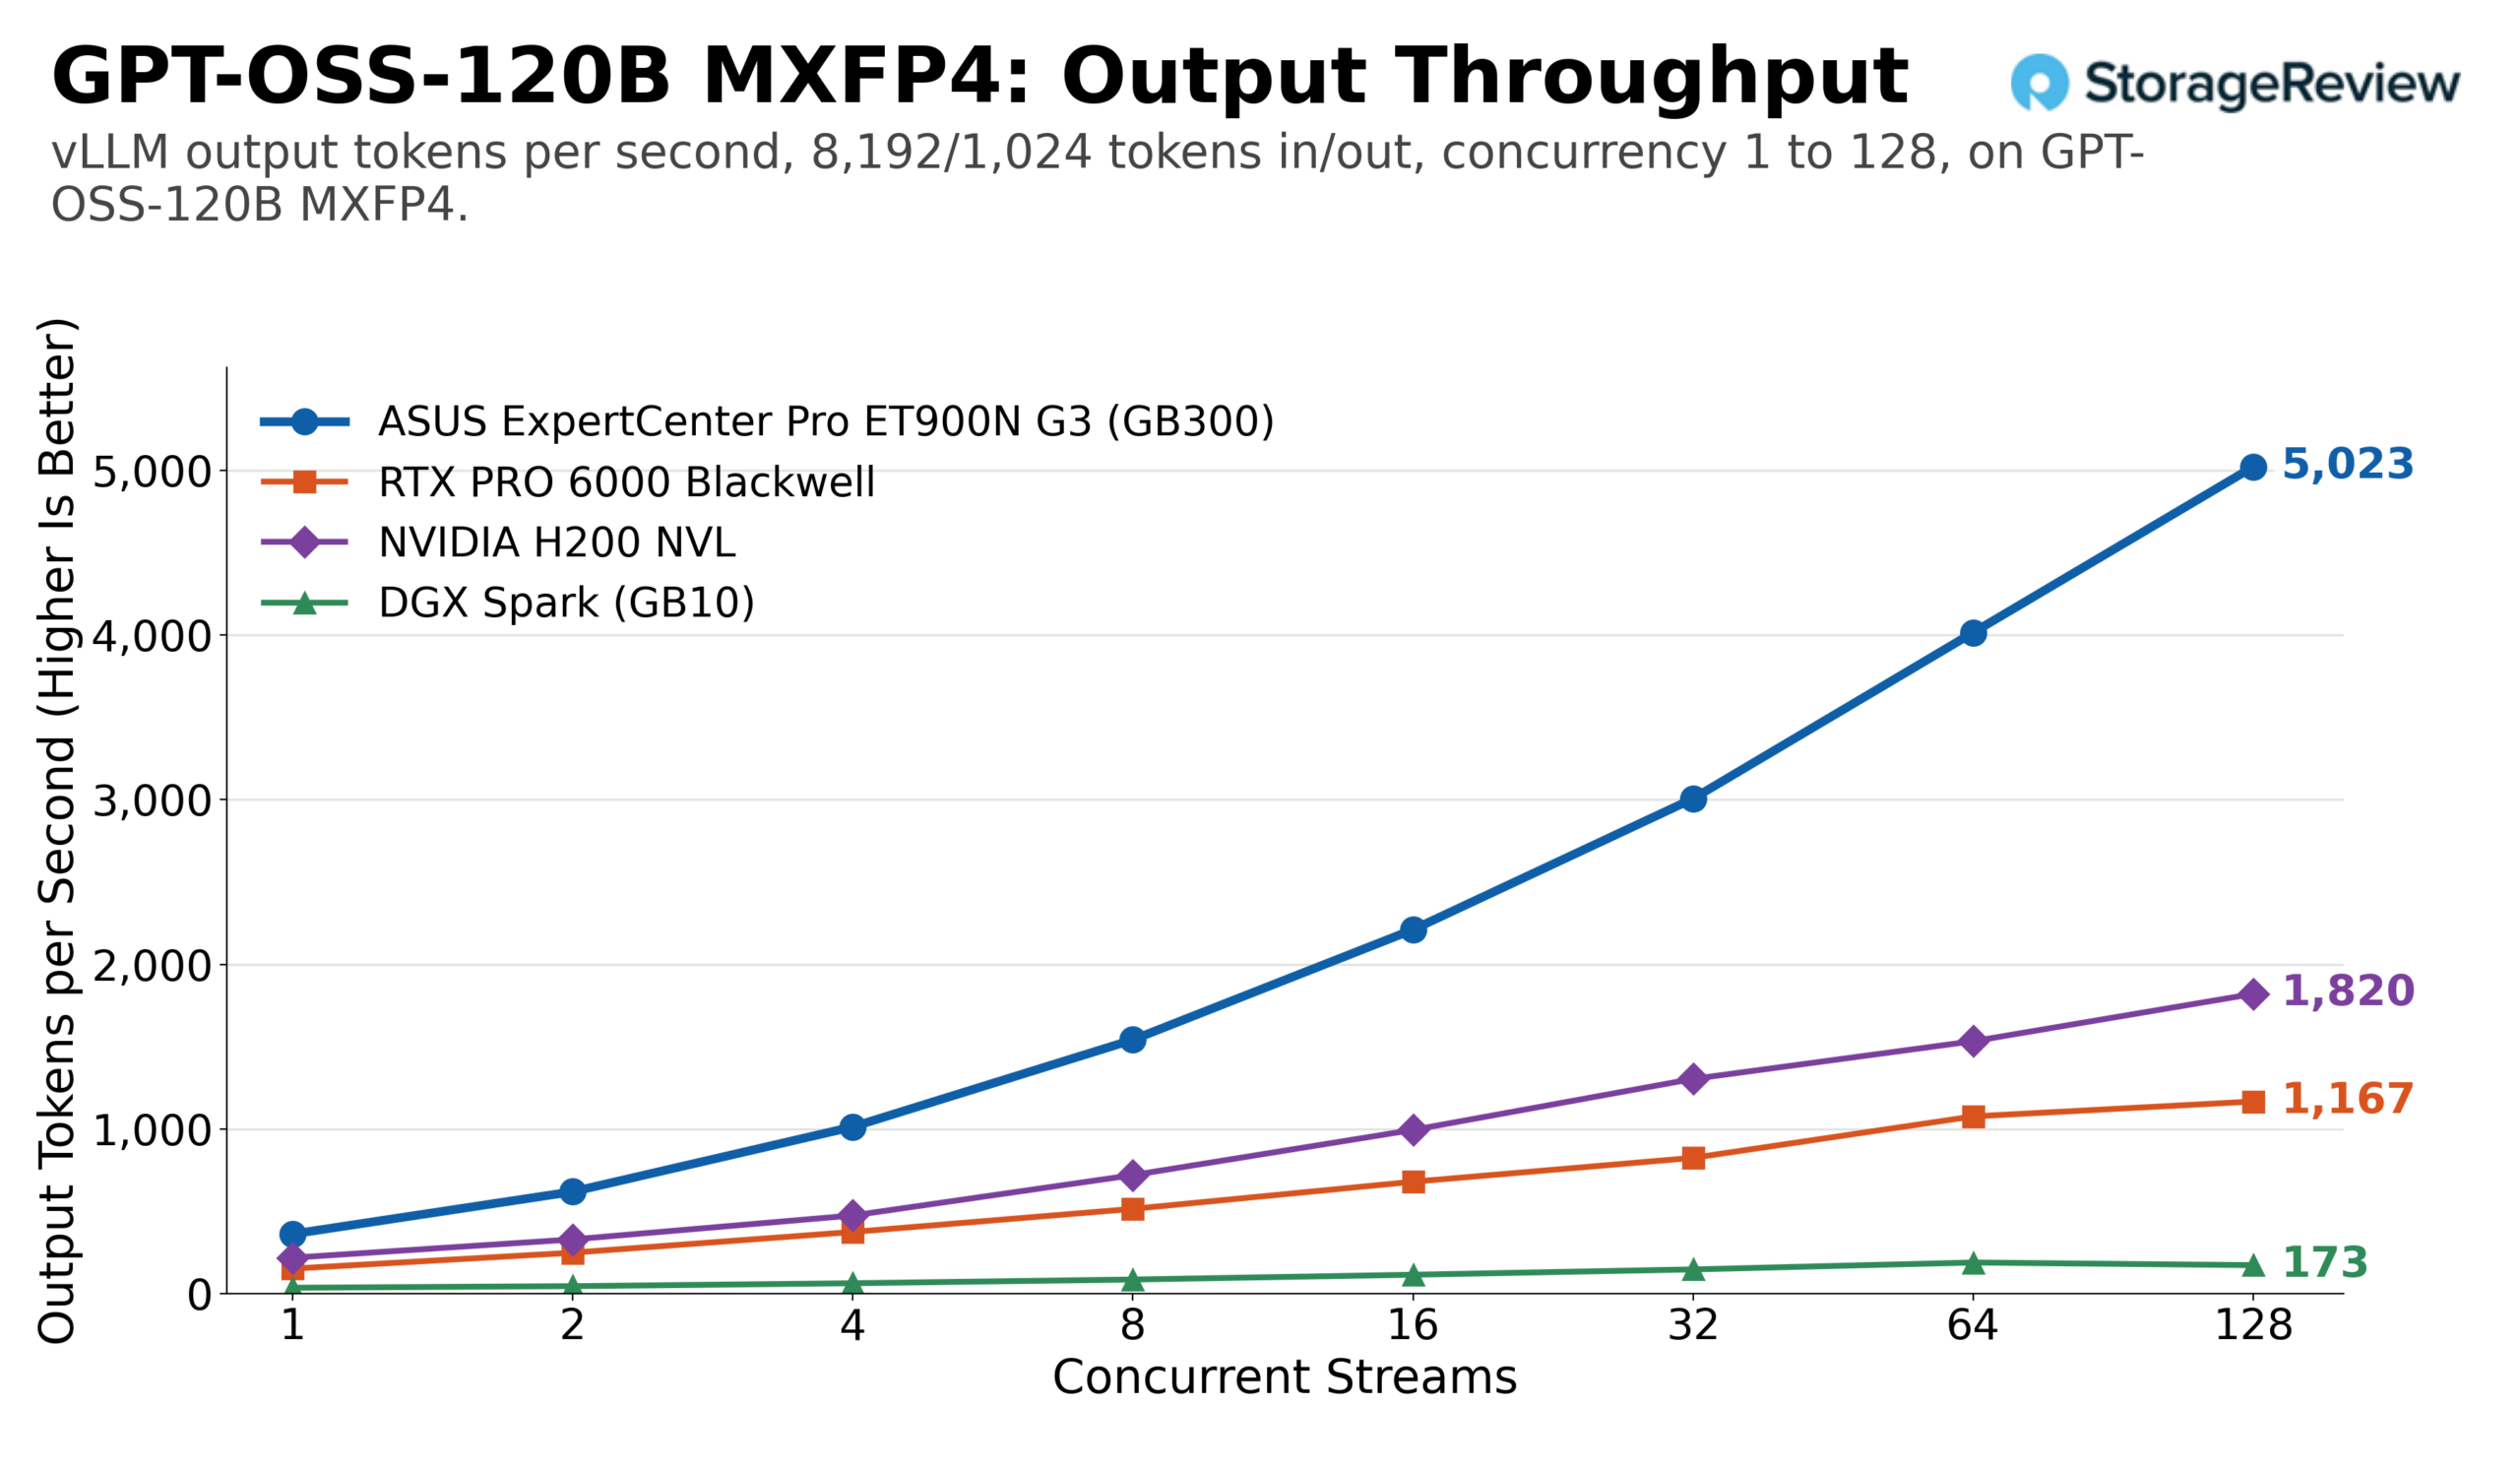
GPT-OSS-120B 是記憶體效能開始展現優勢的起點。在相同的工作負載下,ET900N G3 在 128 個串流的負載下達到了每秒 9,280 個輸出令牌,大約是 RTX PRO 6000(3,060 個)的三倍,H200 NVL(3,370 個)的 2.8 倍,以及 Spark(480 個)的 19 倍以上。在長時間提示的情況下,較小的系統很快就耗盡了鍵值快取空間:RTX PRO 6000 的輸出令牌最高約為每秒 1,170 個,H200 NVL 接近每秒 1,820 個,而 Station 在 128 個串流的負載下仍在持續提升,最終達到了每秒 5,023 個,總為 45,205 個令牌。
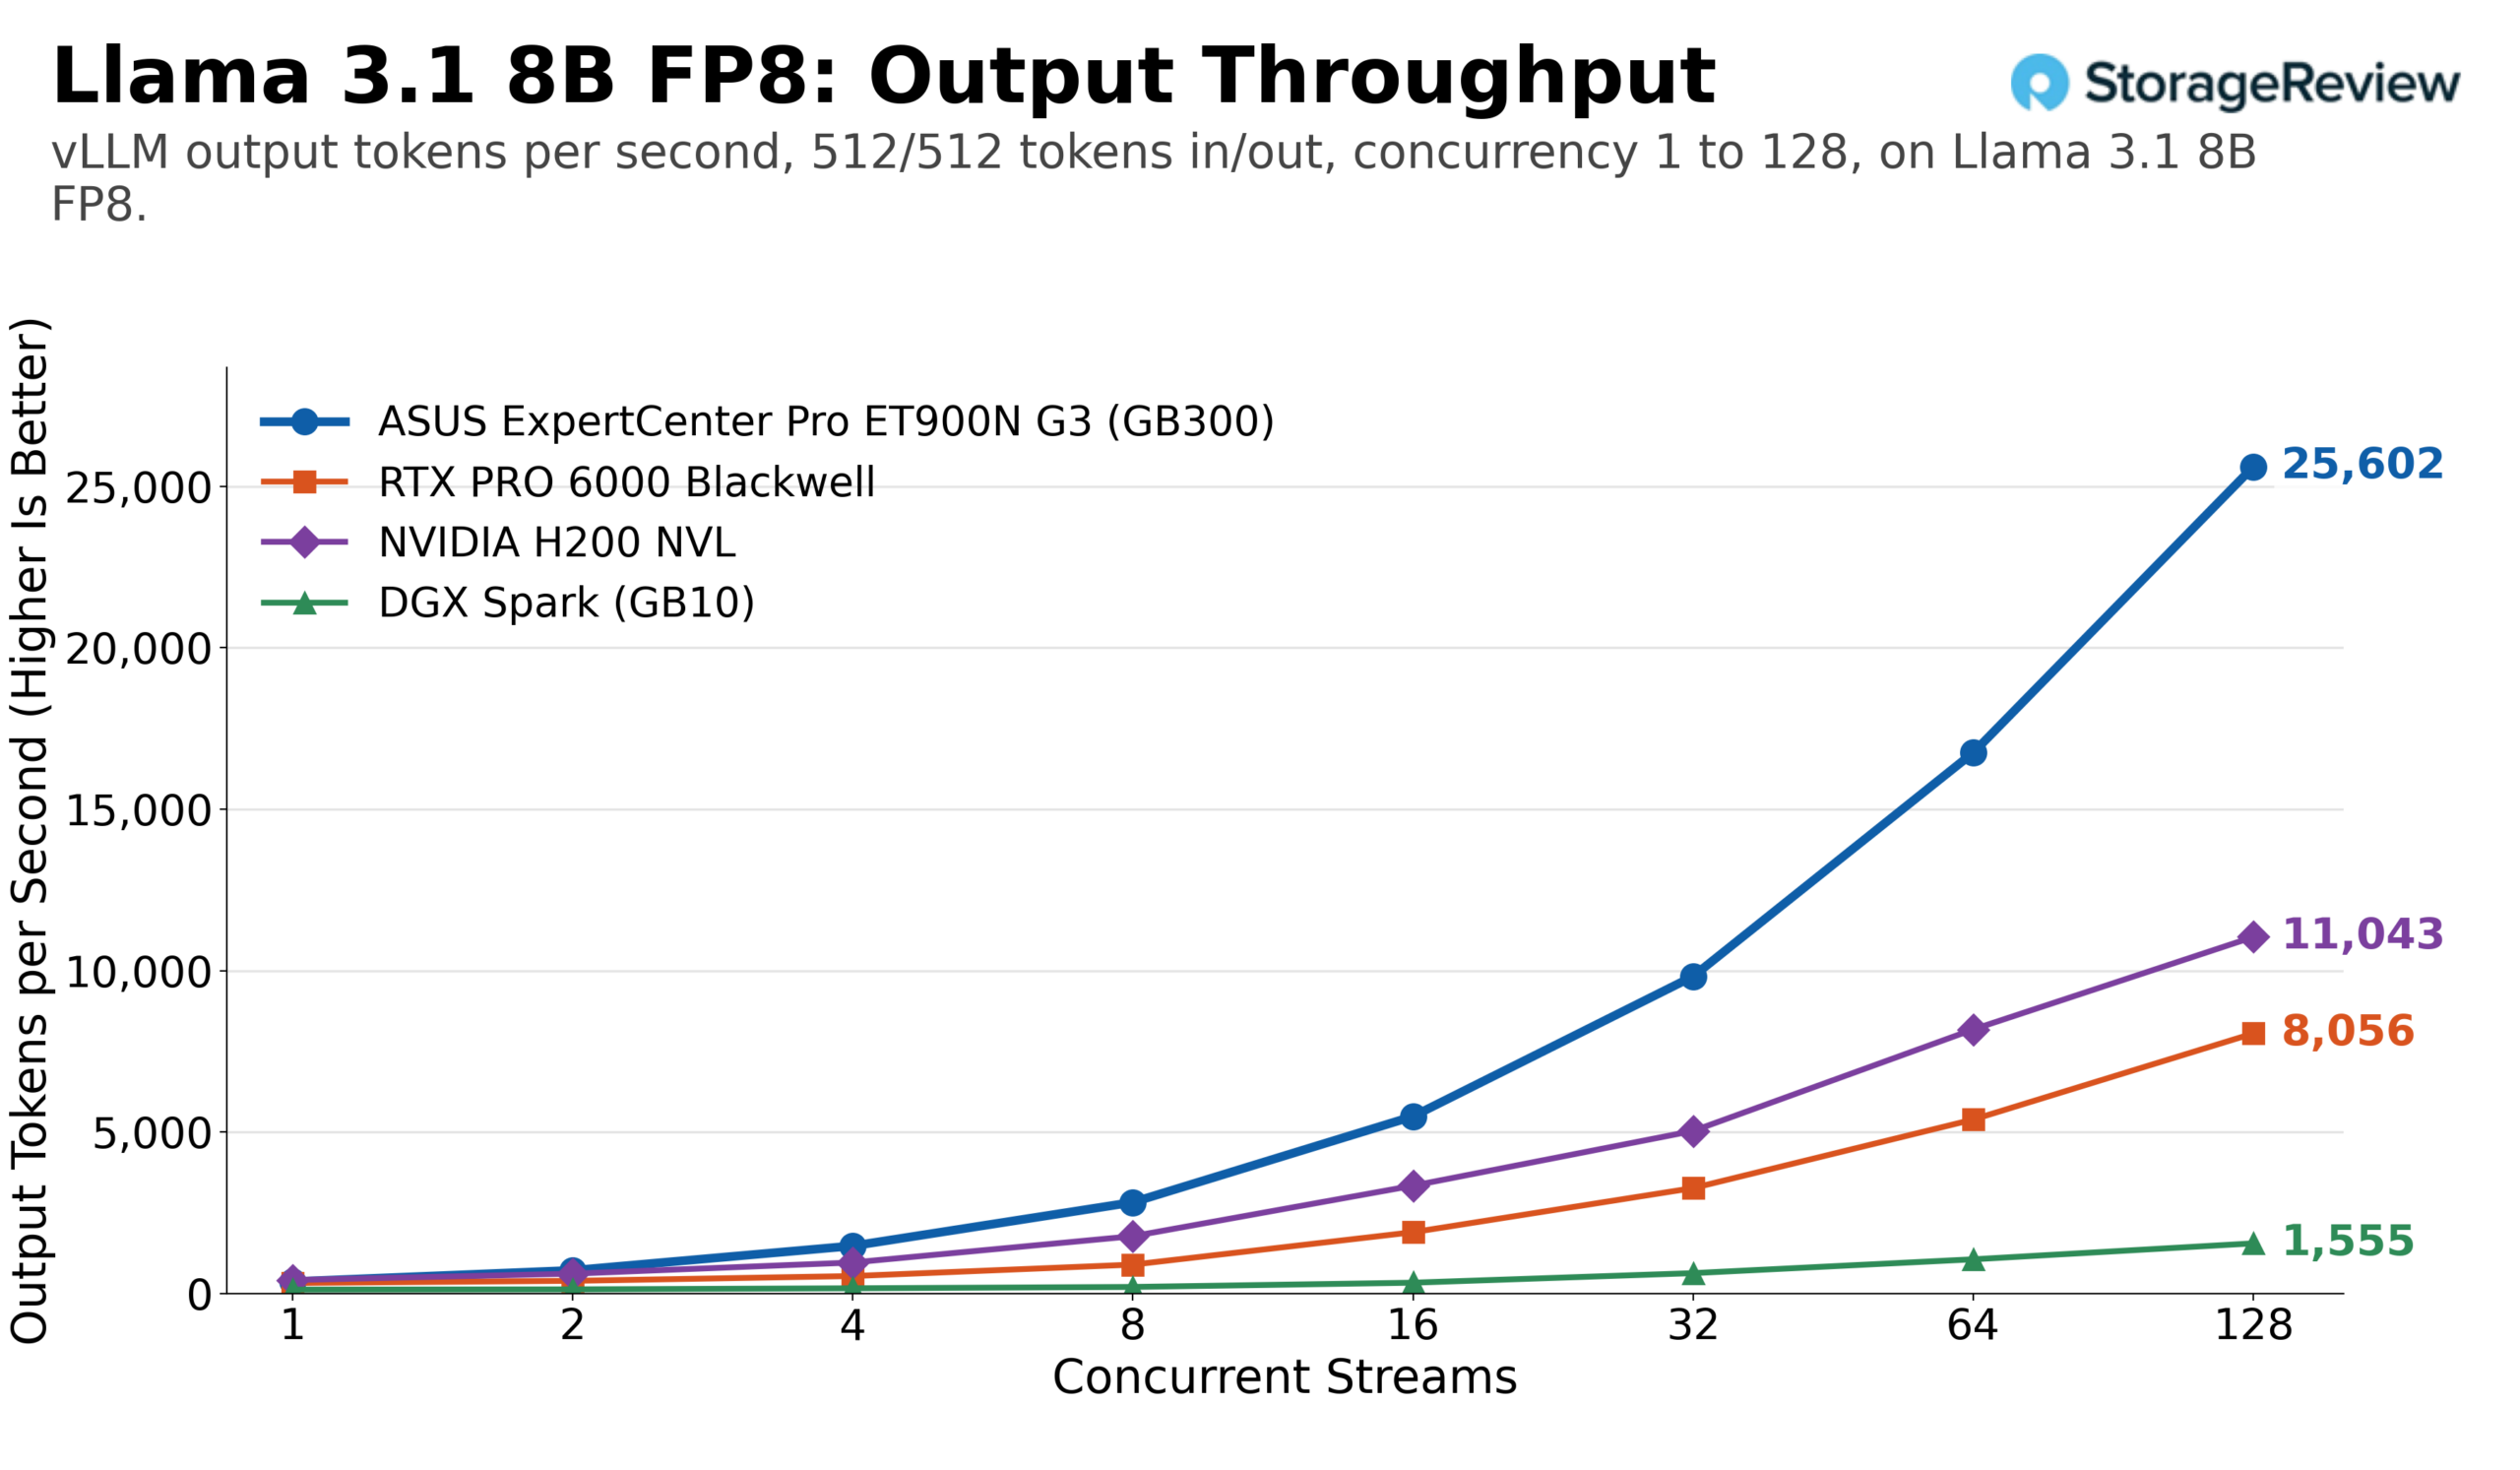
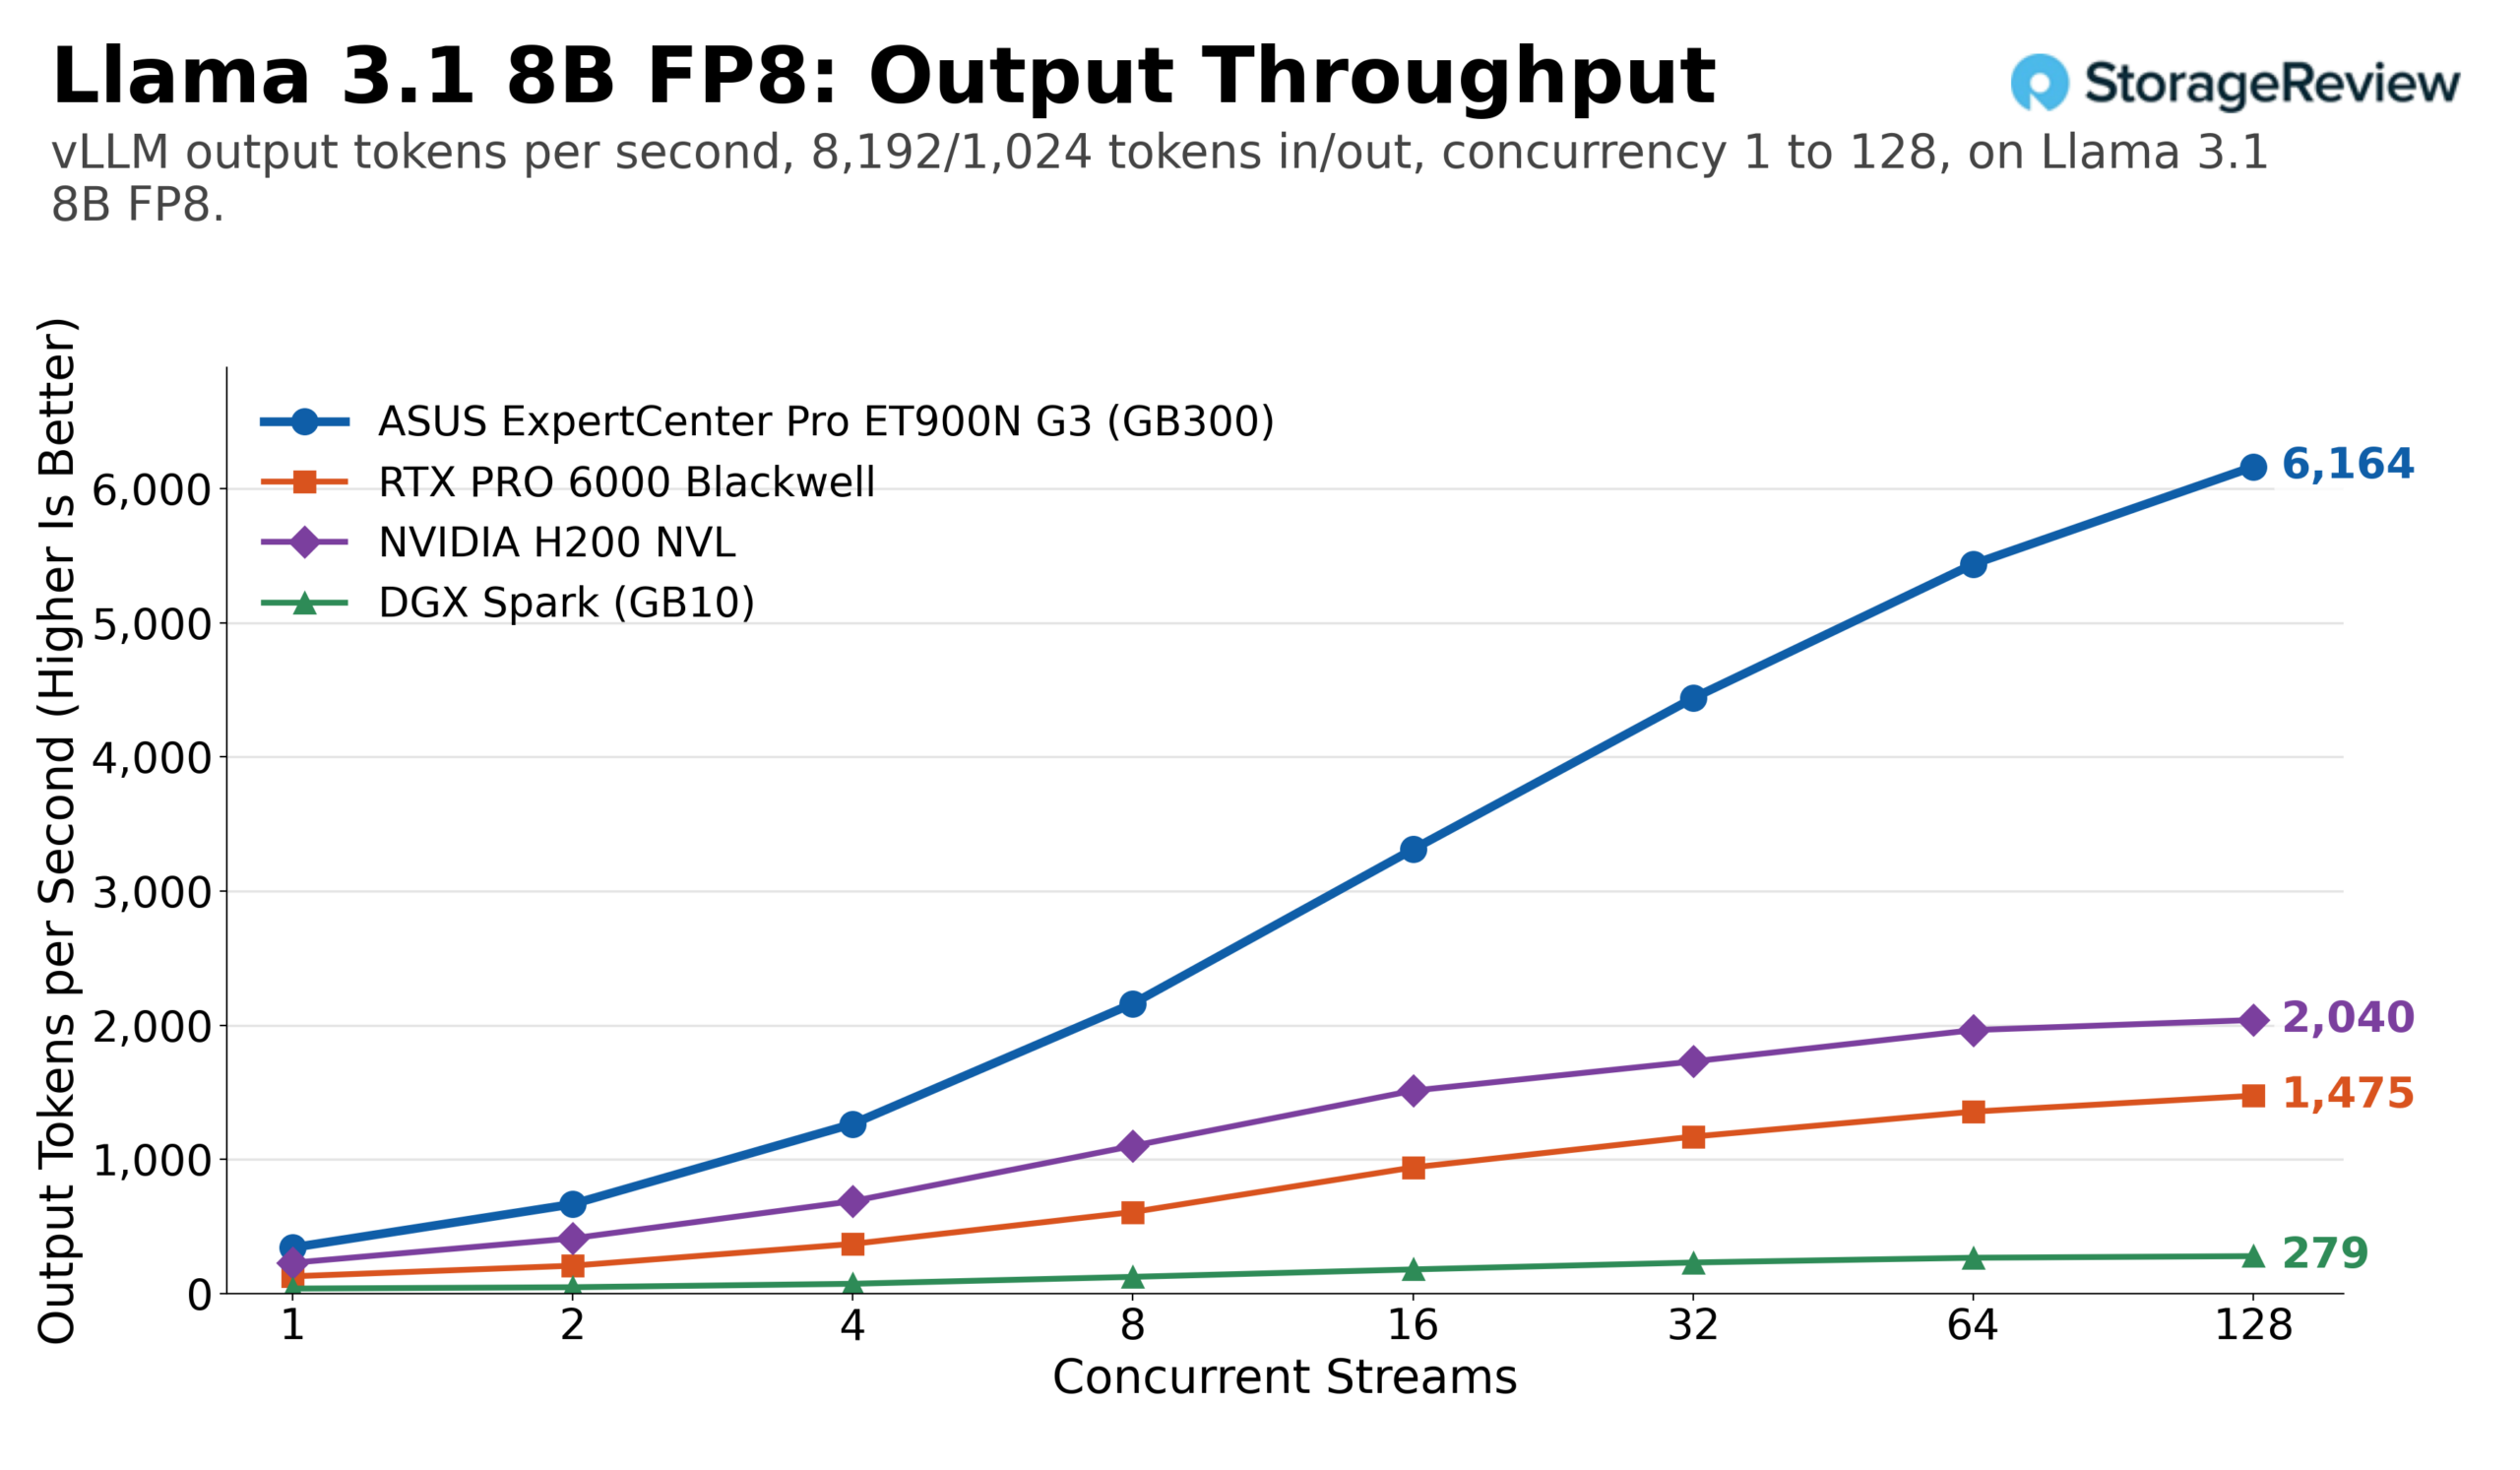
Llama 3.1 8B 在 FP8 模式下是該組測試中單項數值最高的。在相同工作負載下,ET900N G3 在 128 個流上每秒輸出 25,602 個令牌,總計 51,205 個令牌,而 RTX PRO 6000 和 H200 NVL 的輸出令牌數分別為約 8,060 個和 11,040 個。從 BF16 模式降至 FP8 模式後,Station 的效能提升了約 50%(從 17,074 個代幣提升至 25,602 個代幣),RTX PRO 6000 的效能提升了約 70%,H200 NVL 的效能提升了約 37%。預填充密集型設定檔壓縮了所有數據,Station 的輸出令牌數為每秒 6,164 個令牌,顯示卡為每秒 1,480 個令牌,H200 為每秒 2,040 個令牌。
Mistral Small 24B 在 FP8 模式下表現出最寬的效能比。在相同工作負載下,ET900N G3 的峰值輸出令牌數達到每秒 11,075 個,是 RTX PRO 6000(3,240 個)的 3.4 倍,是 H200 NVL(4,610 個)的 2.4 倍,幾乎是 Spark(559 個)的 20 倍。在長時間的提示符號處理下,RTX PRO 6000 的峰值輸出令牌數達到 32 個流,約為每秒 480 個;H200 NVL 的峰值輸出令牌數約為每秒 854 個;Station 的峰值輸出令牌數為每秒 2,302 個,流數為 128 個。


Qwen3 Coder 30B 是一款混合專家模型,其活動參數數量較少,在該模型中,單流表現差距縮小。在相同工作負載下,單流模式下,RTX PRO 6000 的輸出速度約為每秒 232 個輸出令牌,而 Station 為 319 個,H200 NVL 為 308 個。批次處理後,效能排名恢復正常:在 128 個串流的情況下,ET900N G3 在 FP8 模式下達到了每秒 12,439 個輸出令牌,是 Station(3,990 個)的 3.1 倍,是 H200 NVL(7,450 個)的 1.7 倍。在預先填充較多的場景下,Station 達到了每秒 3,837 個輸出令牌,而 RTX PRO 6000 在 64 個流下峰值約為每秒 880 個,H200 NVL 約為每秒 1,820 個。


在所有共享型號中,ET900N G3 的性能是單張 RTX PRO 6000 的 2.8 到 3.4 倍,是 H200 NVL 的 1.7 到 3.7 倍(滿並發運行),並且在長時間提示下,由於鍵值緩存空間耗盡,其性能優勢會進一步擴大。與 WS300 相比,這四款顯示卡的效能差距同樣在 1% 以內:在 GPT-OSS-20B 上分別為 22,041 和 22,161,在 GPT-OSS-120B 上分別為 9,280 和 9,294,在 GPT-OSS-120B 上分別為 9,280 和 9,294,在 GPT-OSS-120B 上分別為 9,280 和 9,294,在 GPT-OSS-120B 上分別為 18,7575,075,075 4,在 Mistral Small 1875757575 月,2075,07575 月,2075, Q FP8 上分別為 12,439 和 12,425。包含效能差距較大的三款顯示卡在內的完整 14 款顯示卡比較將在下一節中呈現。
雙塔機箱,同一底板:華碩 ET900N G3 對比 微星 WS300
ET900N G3 和 MSI XpertStation WS300 皆採用相同的 NVIDIA GB300 DGX Station 主機板,但機殼不同。兩款產品均在相同的 vLLM 版本上進行了相同的 14 種型號、相同的兩種工作負載以及相同的並發測試。下圖比較了 ET900N G3 在所有模型下的峰值輸出吞吐量與 WS300 的峰值輸出吞吐量。
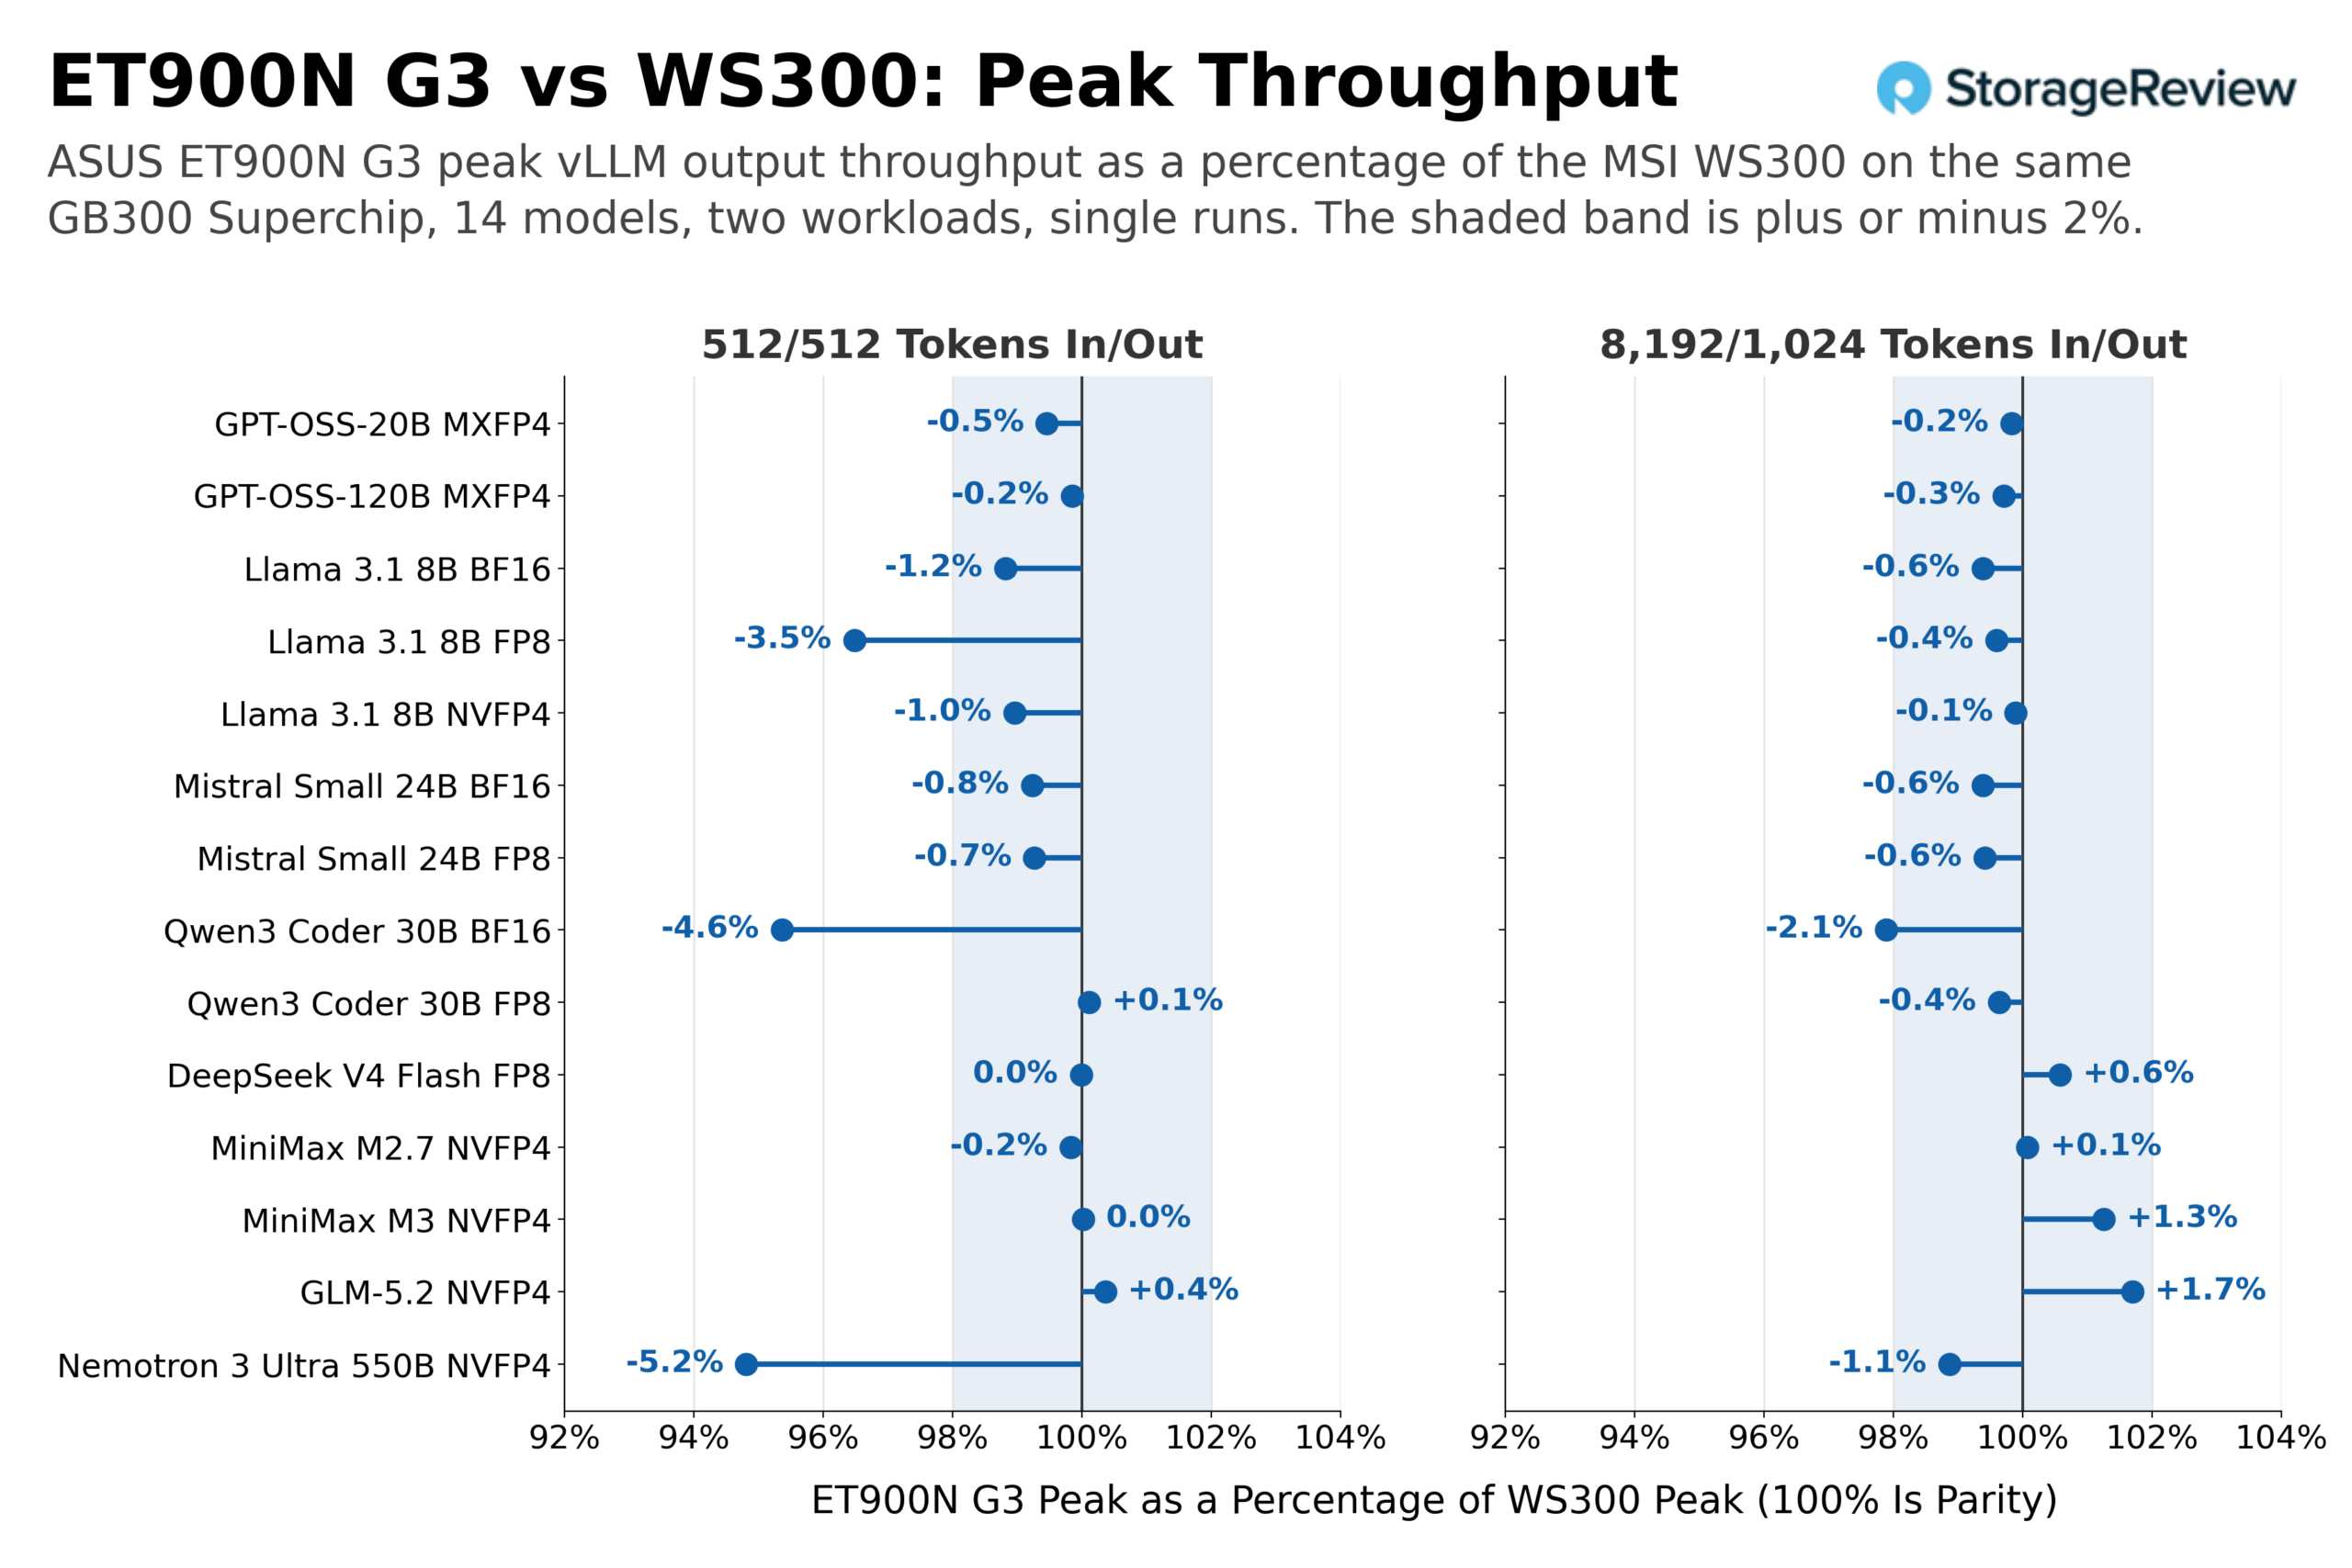
在28組模型-工作負載組合中,24組的效能差距在2%以內,其中大多數WS300的優勢僅為百分之幾。有4組的效能差距超出這個範圍,其中3組是在相同工作負載下進行的測試:Llama 3.1 8B FP8的效能比WS300低3.5%(每秒輸出令牌數分別為25,602和26,536),Qwen3 Coder 30B BF16的性能比WS300低4.6%(每秒輸出令牌數分別為10,000和10,486),Nemotron 3 Ultra 550B的性能比WS300低5.2%(每秒輸出令牌數分別為159和168),此外,Qwen3 Coder 30B BF1令牌數分別為159和168),此外,Qwen3 Coder 30B BF16%在長2016%。這裡的所有數據都是在每台塔式機上單次運行的結果,因此14個模型中有3個模型之間存在2%到5%的差距,我們不能將其歸咎於機箱本身。我們只是記錄數據以及兩者之間的差異。依賴一致性記憶體池的型號,例如 MiniMax M3 和 GLM-5.2,在兩種工作負載下都達到了相同或更高的效能;我們認為這對於平台而言是最重要的結果:Grace 卸載路徑在華碩機箱和微星機箱中的表現相同。
| 型號 | WS300 512/512 | ET900N G3 512/512 | 三角洲 | WS300 8,192/1,024 | ET900N G3 8,192/1,024 | 三角洲 |
|---|---|---|---|---|---|---|
| GPT-OSS-20B MXFP4 | 22,161 | 22,041 | -0.5% | 9,572 | 9,555 | -0.2% |
| GPT-OSS-120B MXFP4 | 9,294 | 9,280 | -0.2% | 5,038 | 5,023 | -0.3% |
| 羊駝 3.1 8B BF16 | 17,278 | 17,074 | -1.2% | 3,520 | 3,498 | -0.6% |
| Llama 3.1 8B FP8 | 26,536 | 25,602 | -3.5% | 6,189 | 6,164 | -0.4% |
| Llama 3.1 8B NVFP4 | 28,698 | 28,400 | -1.0% | 6,744 | 6,737 | -0.1% |
| 密斯特拉爾小型 24B BF16 | 7,922 | 7,861 | -0.8% | 1,643 | 1,633 | -0.6% |
| 密斯特拉爾小型 24B FP8 | 11,157 | 11,075 | -0.7% | 2,316 | 2,302 | -0.6% |
| Qwen3 程式設計師 30B BF16 | 10,486 | 10,000 | -4.6% | 3,830 | 3,749 | -2.1% |
| Qwen3 Coder 30B FP8 | 12,425 | 12,439 | + 0.1% | 3,851 | 3,837 | -0.4% |
| DeepSeek V4 快閃記憶體 FP8 | 1,766 | 1,766 | 948 | 954 | + 0.6% | |
| MiniMax M2.7 NVFP4 | 4,801 | 4,793 | -0.2% | 1,743 | 1,744 | + 0.1% |
| MiniMax M3 NVFP4 | 1,041 | 1,041 | 278 | 282 | + 1.3% | |
| GLM-5.2 NVFP4 | 138 | 139 | + 0.4% | 118 | 120 | + 1.7% |
| Nemotron 3 Ultra 550B NVFP4 | 168 | 159 | -5.2% | 142 | 140 | -1.1% |
GPT-OSS-20B 是此資料集中吞吐量最高的密集案例,而 GLM-5.2 是卸載型案例,兩者在沒有比率的情況下顯示出重疊:在這兩個案例中,WS300 的運行結果與 ET900N G3 的運行結果完全一致。
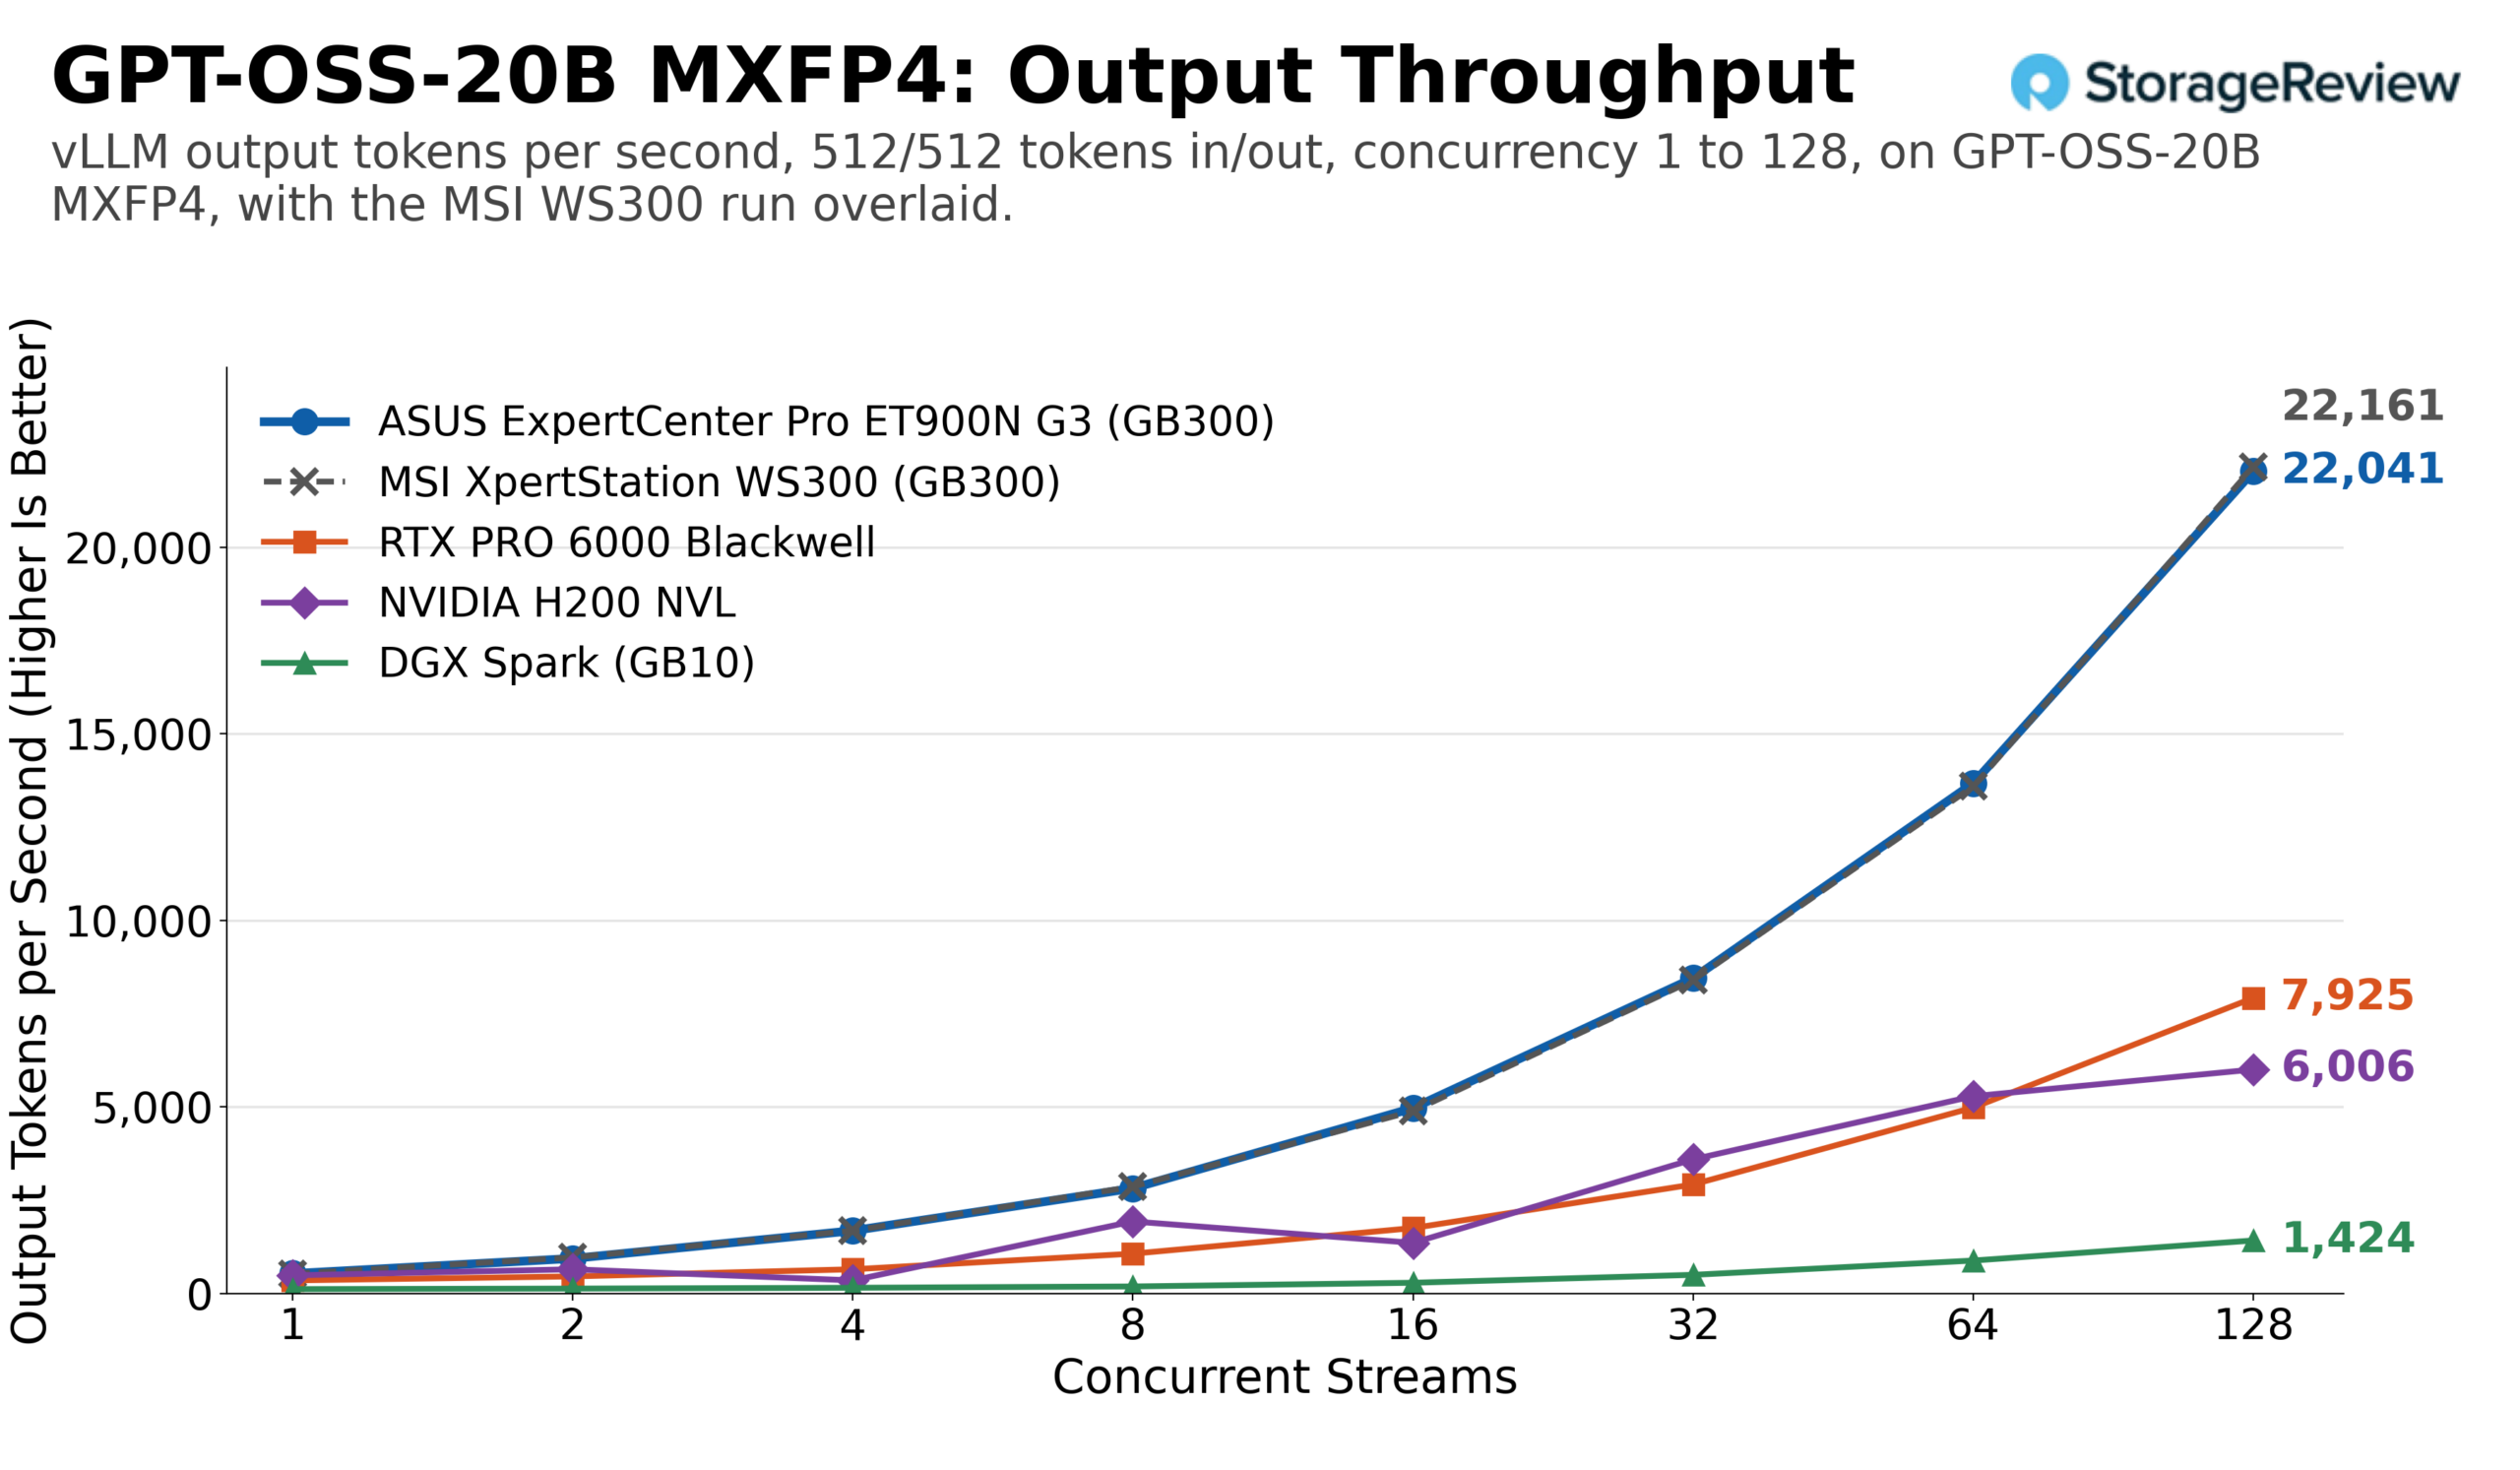
隨著更多GB300塔式機送至實驗室進行測試,我們將在此基礎上進行更深入的比較。接下來是惠普的ZGX,之後還會有更多機種。每台機器都運行相同的測試程序,因此不同OEM廠商實現方案之間的任何差異都會在此圖表中體現出來,每台塔式機對應一張圖表,而模型圖表則包含原始曲線。
結語
華碩 ExpertCenter Pro ET900N G3 作為參考平台的第二代產品,其表現與第一代產品相符。在 14 種模型和兩種工作負載下,其 vLLM 峰值吞吐量在 28 項對比測試中的 24 項中與 MSI XpertStation WS300 的差距在 2% 以內,從 DeepSeek V4 Flash 的每秒 1,766 個輸出令牌到 GPT-OSS-20B 的差距 204%,僅在 204% 上運行 4%到 5% 之間。此外,它還支援 GLM-5.2,並配備 215GB 的 Grace 內存,其處理速度甚至超過了四張 RTX PRO 6000 系列顯示卡。 GB300 Superchip 晶片設定了性能上限,而華碩在執行方面表現出色。
華碩的改進非常實用:把手讓27公斤重的機殼可以輕鬆搬運,無需握住面板;QSFP112接口上方的風扇解決了長時間運行400G光模組可能遇到的問題;鈦金電源則能降低牆插功耗。 Arm架構主機、20A電路、僅支援BMC的顯示輸出以及安裝大型顯示卡時共享的1,600W功率預算,這些都是平臺本身的特性,兩款機箱都適用。
GB300 DGX Station 仍然是我們放在桌面上功能最強大的設備,而華碩的版本也讓購買變得非常划算。
在我們的 最適合本地人工智慧的桌面電腦 leaderboard, the ET900N G3 now stands alongside the WS300 as a tested alternative in the Best GB300 System slot.



 Amazon