

Comino 最近寄送了最新 Comino Grando 供我們評測,該機配置了八張 NVIDIA RTX PRO 6000 Blackwell 顯示卡,每張顯示卡配備 96GB 顯存,總顯存容量達 768GB。我們曾在 2024 年評測Comino,當時配置了六張 RTX 4090 顯示卡,總記憶體容量為 144GB,此外我們也評測過一款搭載NVIDIA H100 顯示卡的版本。此次更新標誌著 Comino 在顯存容量和平台可處理的工作負載範圍方面都實現了顯著的世代飛躍。
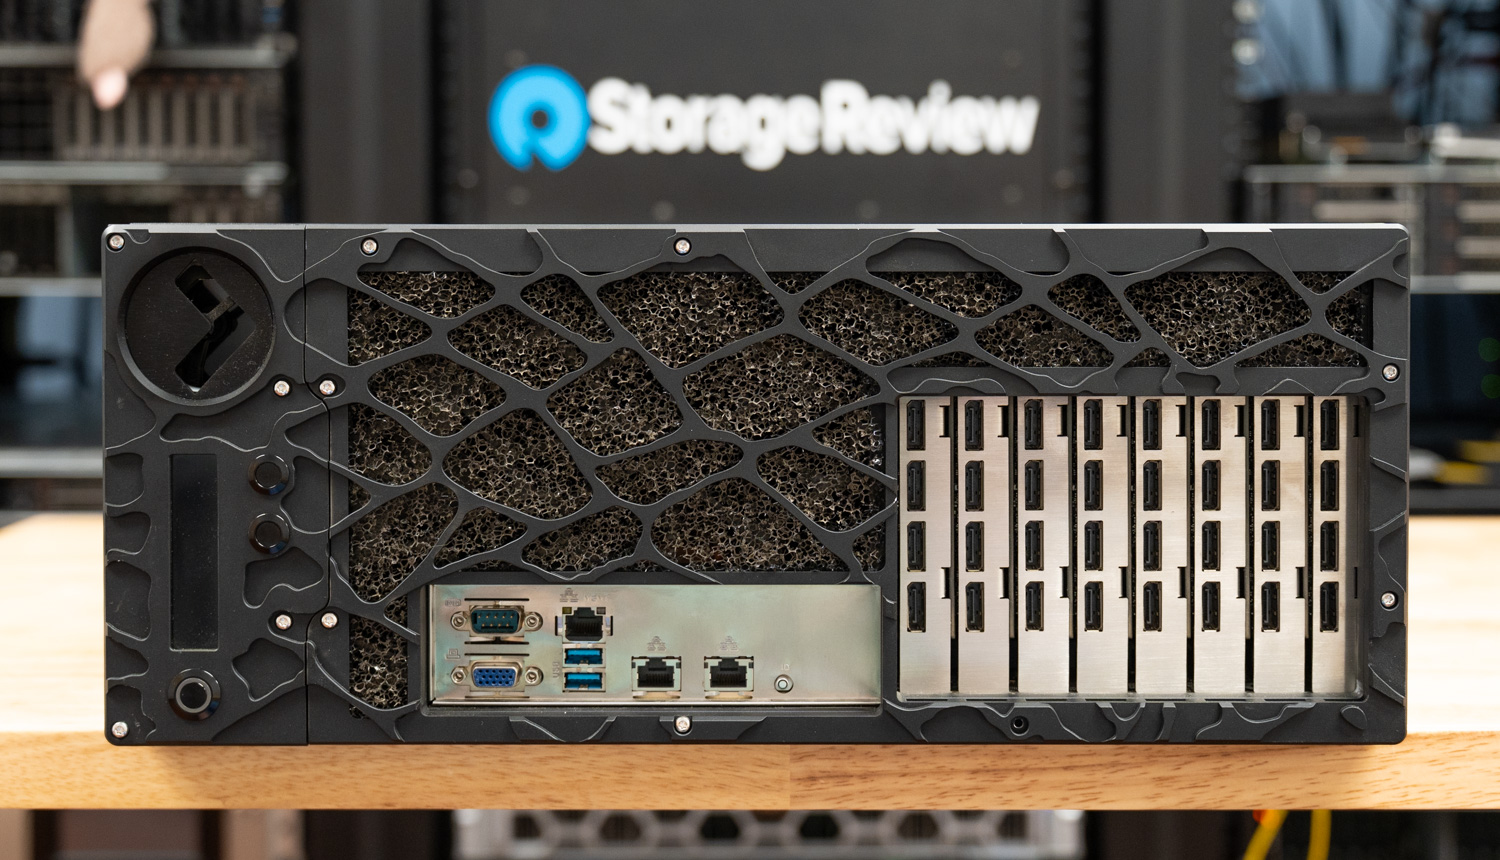
Grando 是一款專為解決高密度 GPU 運算與散熱管理之間的關鍵衝突而設計的 4U 平台。傳統的風冷機箱在現代專業顯示卡持續 600W 以上的 TDP 功耗下不堪重負,而 Grando 則採用了截然不同的方法,從零開始構建液冷架構,能夠散發高達 6.5kW 的持續熱量。這並非改造或事後補救;從倒置的主機板佈局到顏色編碼的快速斷開式歧管系統,整個機殼的設計都圍繞著冷卻迴路。
最終打造出的平台能夠在單一 4U 機殼內支援八顆全 TDP 專業級 GPU,在 3-38°C 的環境溫度下 24/7 全天候運行,不會出現過熱降頻、高轉速風冷帶來的噪音,且維護性絲毫不受影響。對於大規模部署 AI 推理、機器學習訓練或高效能模擬工作負載的企業而言,Grando 提供了一項真正難得的優勢:它是一款無需在密度、散熱和可靠性之間做出取捨的伺服器。
科米諾格蘭多規格
下表顯示了 Comino Grando 平台的實體規格和支援的硬體配置。
| 規格/特點 | 科米諾格蘭多 |
|---|---|
| Comino Grando 伺服器和機架式工作站 | |
| 製冷量 | 6.5kW(最大功率 6500W,進氣溫度 20°C) |
| 主板 | 最高可達EATX和EBB |
| GPU(伺服器) | 最多 8 個; NVIDIA:RTX A6000、RTX 6000 ADA、RTX PRO 6000、A40、L40、L40S、A100、H100、H200 |
| GPU(機架式工作站) | 最多 6 個; NVIDIA:3090、4090、5080、5090、RTX A6000、RTX 6000 ADA、RTX PRO 6000、A40、L40、L40S、A100、H100、H200; AMD:W7800、W7900 |
| CPU的 | 最多 2 個; 單路處理器:Intel Xeon W-2400/2500 和 3400/3500,Intel Xeon 可擴充處理器(第四代、第五代、第六代),AMD Threadripper PRO 5000WX、7000WX、9000WX,AMD EPYC 900/X、7000WX、9000WX,AMD EPYC 900 雙路處理器:Intel® 至強® 可擴充處理器第四代、第五代、至強® 6、AMD EPYC 9004/9005 |
| 內存 | 截至2TB |
| M2驅動器 | 最高 8 倍 NVMe |
| 儲存 | 背板熱插拔籠:最多可安裝 4 個熱插拔 SSD(4 個 7 毫米或 2 個 15 毫米),並且最多可安裝 4 個額外的 SSD(4 個 7 毫米或 2 個 15 毫米)來代替第 4 個電源; 內部 3.5 吋籠子最多可容納 4 個 3.5 吋或 4 個 2.5 吋 15 毫米或 12 個 2.5 吋 7 毫米; 內建 2.5 吋插槽:最多可安裝 4 個 2.5 吋 7 mm SSD。 |
| 電源及工作電壓 | 最多可支援 4 個 2000W 熱插拔 CRPS 電晶體,工作電壓範圍為 180-264V 最多可支援 4 個 1000W 熱插拔 CRPS 電晶體,工作電壓範圍為 90-140V 冗餘模式:4+0、3+1、2+2 |
| 噪音水平 | 39分貝-70分貝 |
| 區域網路 | 主機板上最高支援 2 x 10 Gbit/s,PCIe 插槽最高支援 400 Gbit/s。 |
| OS | Ubuntu / Windows 11(專業版/家用版)/ Windows Server |
| 物理和冷卻規格 | |
| 液體冷卻 | CPU 帶 VRM,GPU 帶 GDDR 和 VRM |
| 水庫 | Comino 定制 450ml,帶集成泵 |
| 風扇 | 3倍超高流量6200轉/分(高噪音)或 3倍高流量3000轉/分(低噪音) |
| 安裝 | 19吋機架式或獨立工作站 |
| 所需機架空間 | 4U |
| 尺寸 | 439 x 681 x 177毫米(不含把手和突出部分) |
| 重量 | 4 個 GPU:淨重 49 公斤,毛重 67 公斤 6 個 GPU:淨重 52 公斤,毛重 70 公斤 8 個 GPU:淨重 55 公斤,毛重 72 公斤 |
| 工作和儲存溫度範圍 | 儲存溫度:-5..50°C / 23..122°F 工作溫度:3..38°C / 38..100°F |
| 科米諾監測系統(CMS) | |
| 概述 | 具有感測器和即時監控軟體的控制器板 |
| 主要優勢 | 冷卻系統及CPU/GPU監控、Web介面、冷卻系統日誌、工作小組集中監控 |
| 感測器和連網設備 | 溫度(空氣和冷卻液)、濕度百分比、電壓、冷卻液流量、冷卻液儲液罐液位、風扇、水泵、主機板、顯示器和按鈕 |
| 整合的可能性 | 透過 REST API 建立監控,並將感測器資料推送至監控軟體(例如 Zabbix、Grafana)或資料庫(例如 InfluxDB)。 |
| CMS技術要求 | |
| OS | Windows 11 / 10 Ubuntu 22.04/20.4(Ubuntu 依賴項:目標系統必須安裝 nvidia-smi 和 sensors 工具) |
| Web瀏覽器 | Mozilla Firefox、Google Chrome、Chromium、Apple Safari、Microsoft Edge(注意:不支援 Internet Explorer 11) |
| 硬盤驅動器 | 300MB |
| 控制器韌體版本 | 1.0.6 或更高版本 |
| 控制器PCB版本 | 2.xx.xx |
設計、製造和GPU密度
機箱佈局和部署
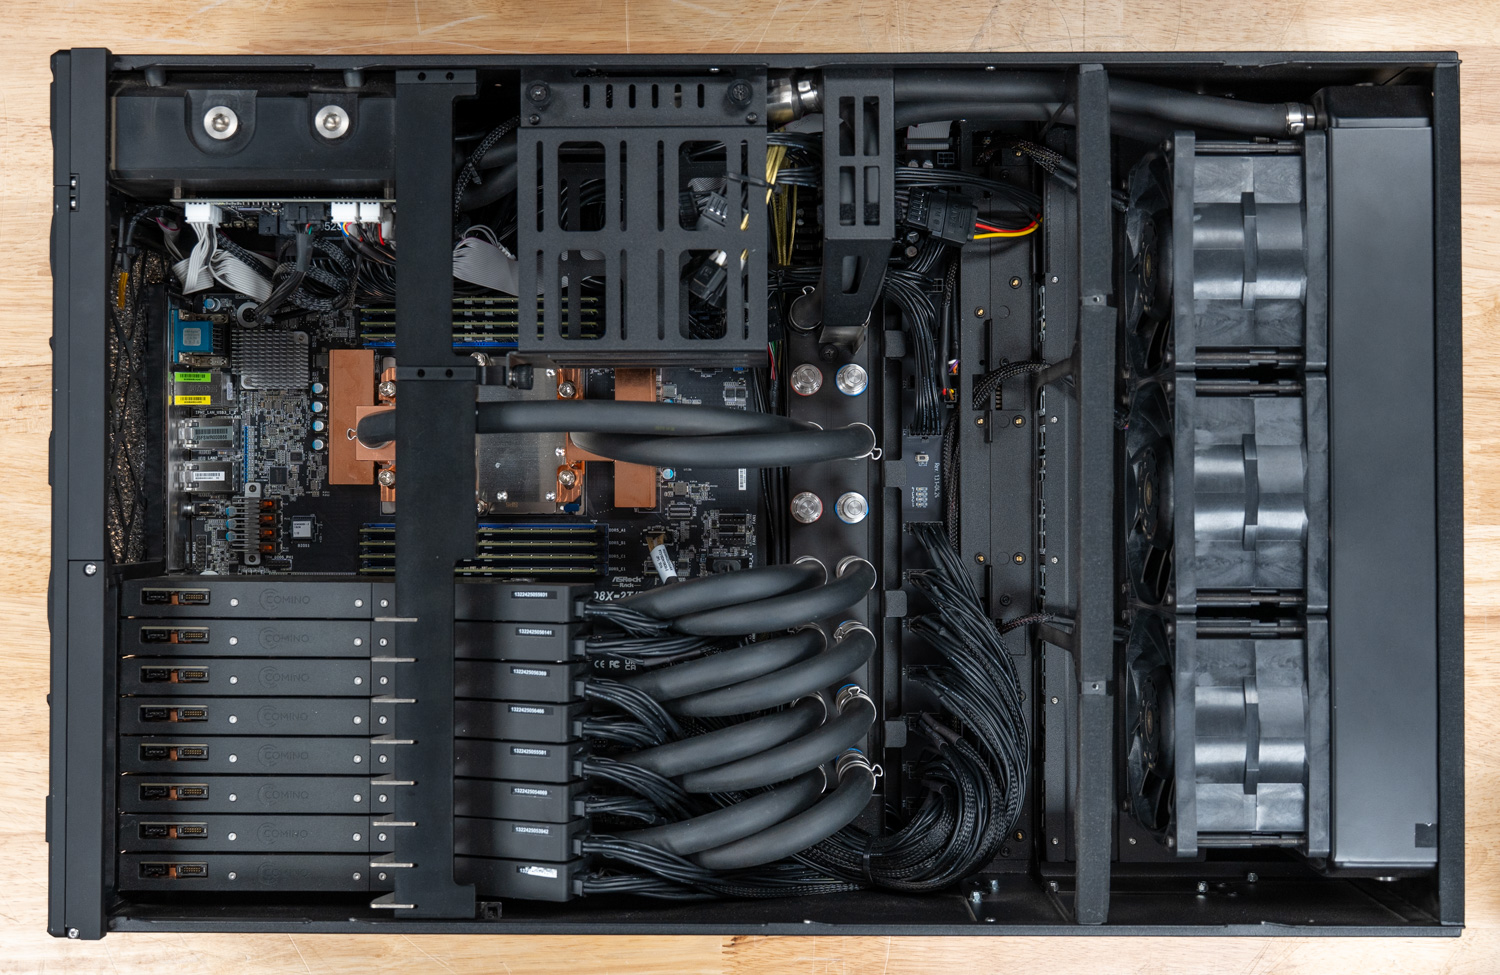
Grando 伺服器堪稱空間優化的典範,尺寸僅 17.3 x 26.8 x 6.97 吋(4U)。與傳統伺服器不同,它將主機板後部置於機箱前部,顛覆了傳統的內部佈局。這確保了諸如內存模組和 VRM 等風冷組件在進入後部的液冷散熱器之前,能夠吸入盡可能冷的空氣。
機殼本身也秉承了同樣的嚴苛標準,採用堅固的鋼材結構,內外均塗上霧面黑色粉末塗層。這種精心設計的工藝也延伸至管路、線材、散熱器和PCB焊錫層,體現了整體簡潔專業的美感概念。此外,該系統支援靈活的部署方式,既可作為19吋機架式設備使用,也可作為獨立的桌面設備使用。依配置不同,其重量在148至159磅之間。
GPU冷板與水冷頭
Grando 的核心在於其專有的銅質水冷頭,它不僅能冷卻 GPU 核心,還能冷卻顯存和電壓調節器等其他組件。每張 GPU 都是標準顯示卡,Comino 在其上安裝了客製化的冷板組件。這種超薄設計使得每張顯示卡僅佔用一個插槽,從而可以在一個 4U 機箱內並排安裝六張甚至八張專業級 GPU。我們評測的這台機器配備了八張 NVIDIA RTX PRO 6000 Blackwell 顯示卡,每張顯示卡的 TDP 為 600W,因此滿載時的總散熱需求高達 4,800W。
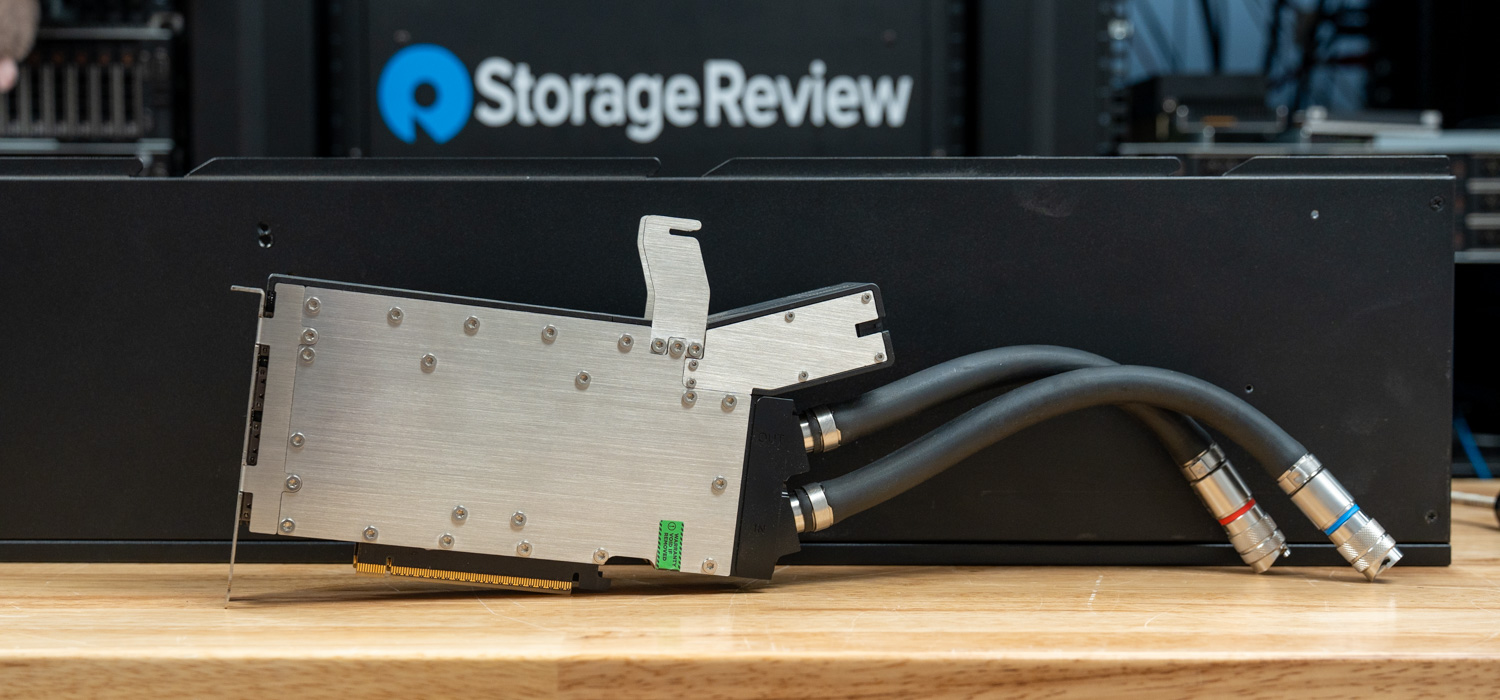
如果採用風冷散熱,幾乎不可能實現Comino主機板8張單槽GPU的密度,因為標準NVIDIA RTX PRO 6000系列顯示卡每張佔用兩個插槽,需要大量的風量。相比之下,這些客製化散熱的顯示卡每張僅佔用一個插槽。散熱板結構堅固,明顯增加了每張顯示卡的重量,但這重量也反映了此等級顯示卡所需的品質和散熱性能。
每對GPU都透過一個專用的子歧管連接,將兩個顯示卡的進出水口整合到主冷卻液歧管的單一介面中。這種成對連接的方式簡化了整體循環架構,減少了主歧管上的連接數量,並且允許技術人員斷開一對快速斷開接頭即可一次拆卸兩張顯卡,從而進一步簡化了維護工作。
供水分配和歧管
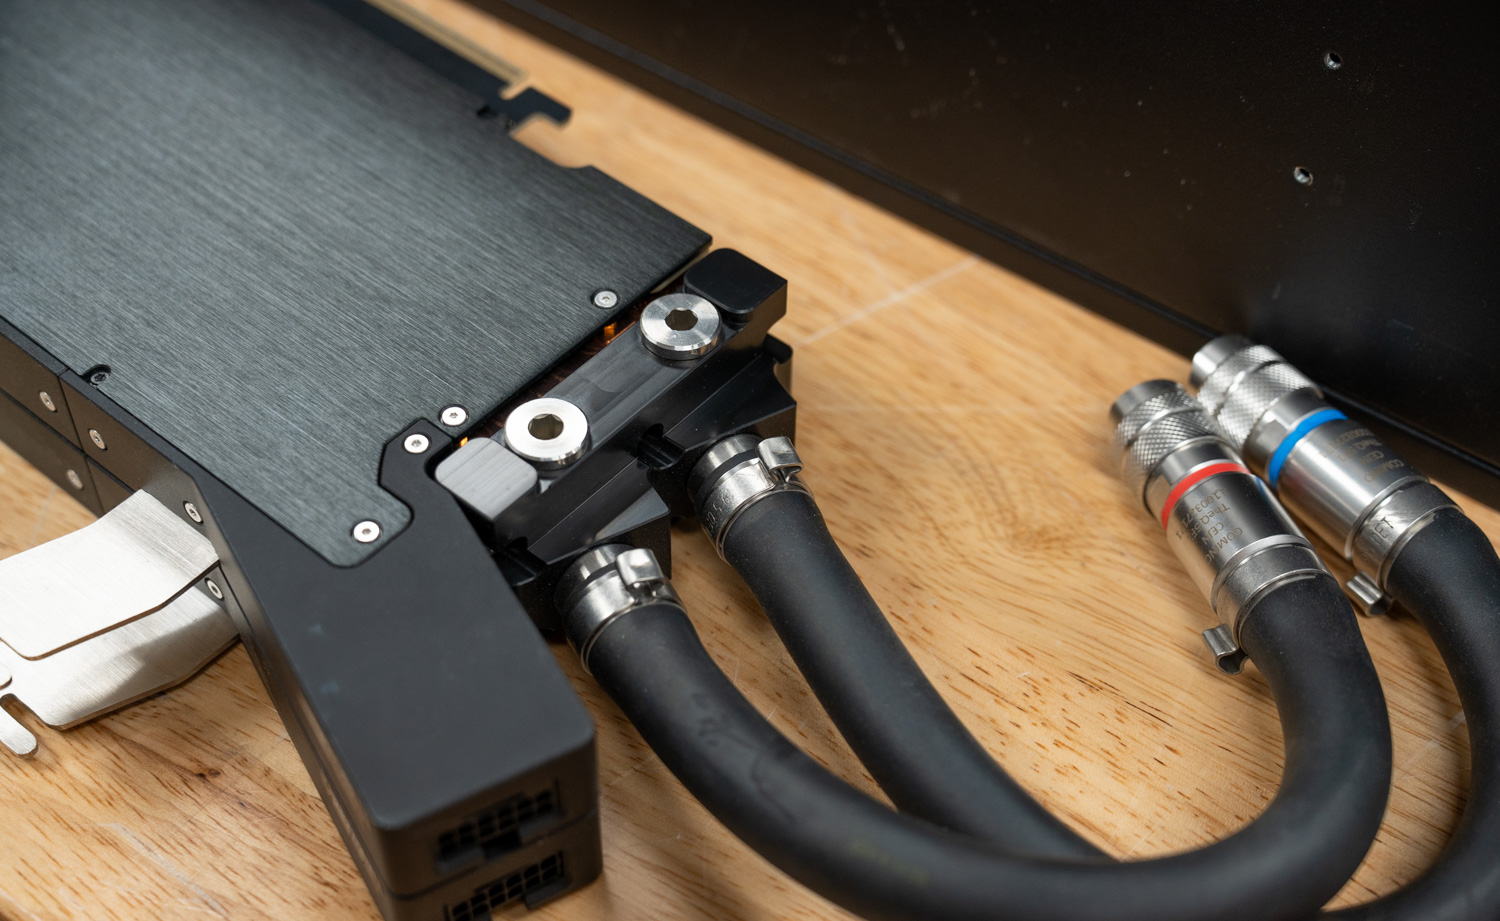
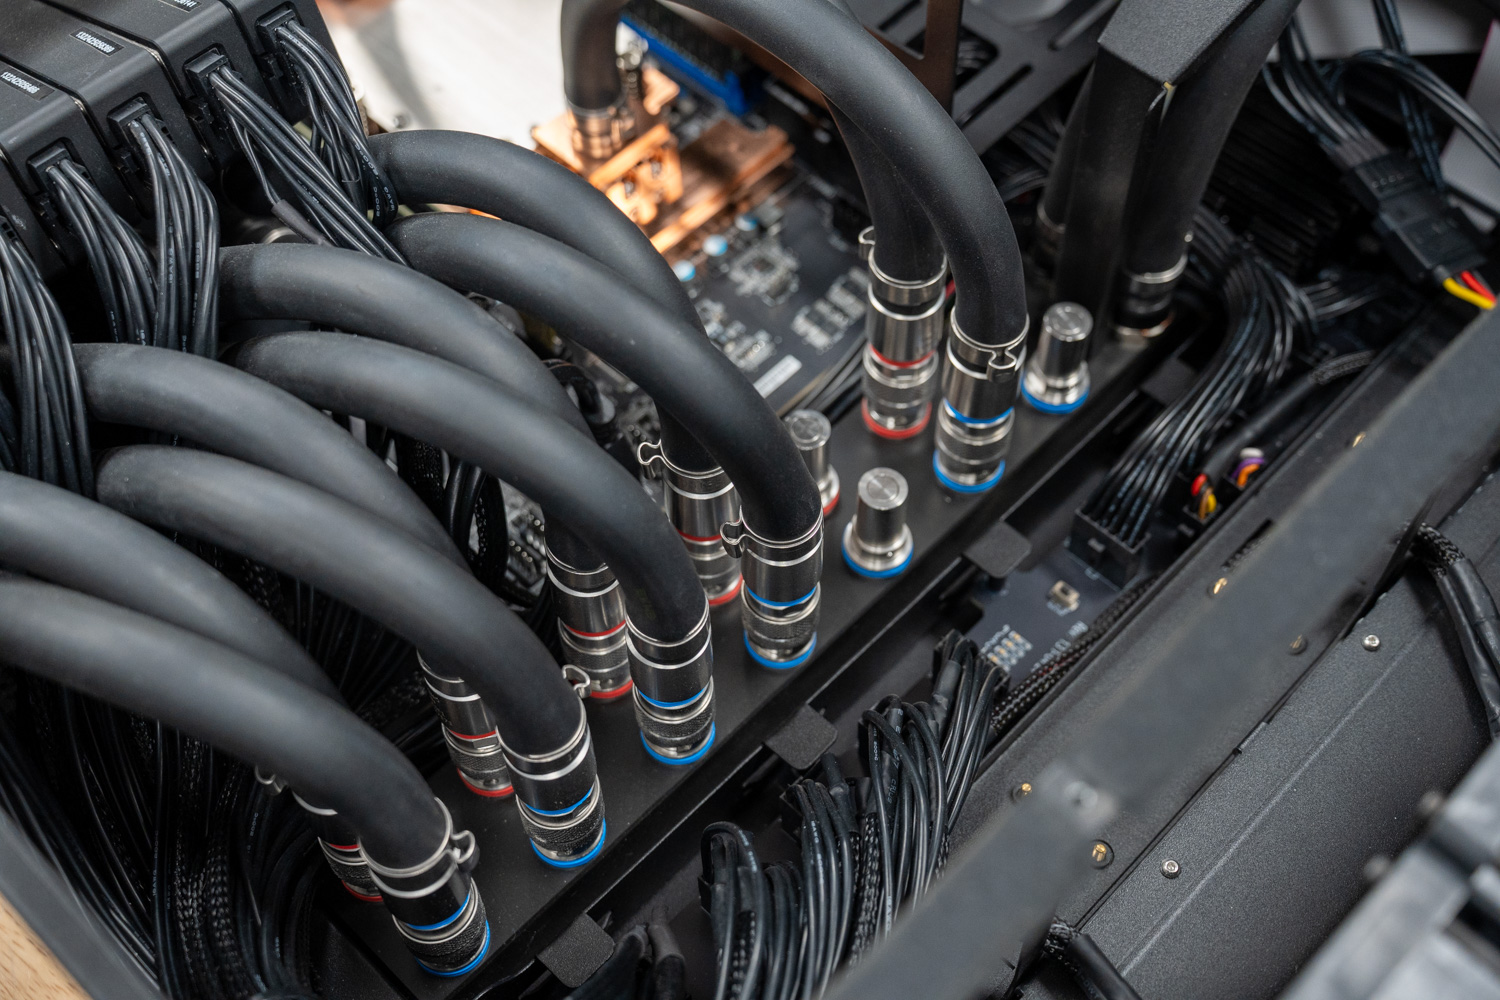
系統的核心是一個大型水分配歧管,它為每個GPU和CPU冷板提供冷卻液,並提供回流至散熱器的路徑。歧管與GPU和CPU之間的所有連接均採用Comino的「TheQ」快速斷開接頭。這些不銹鋼防滴漏接頭採用紅藍雙色環進行顏色編碼,清楚區分迴路的冷熱端,確保安裝和維護過程中不會出現任何混淆。
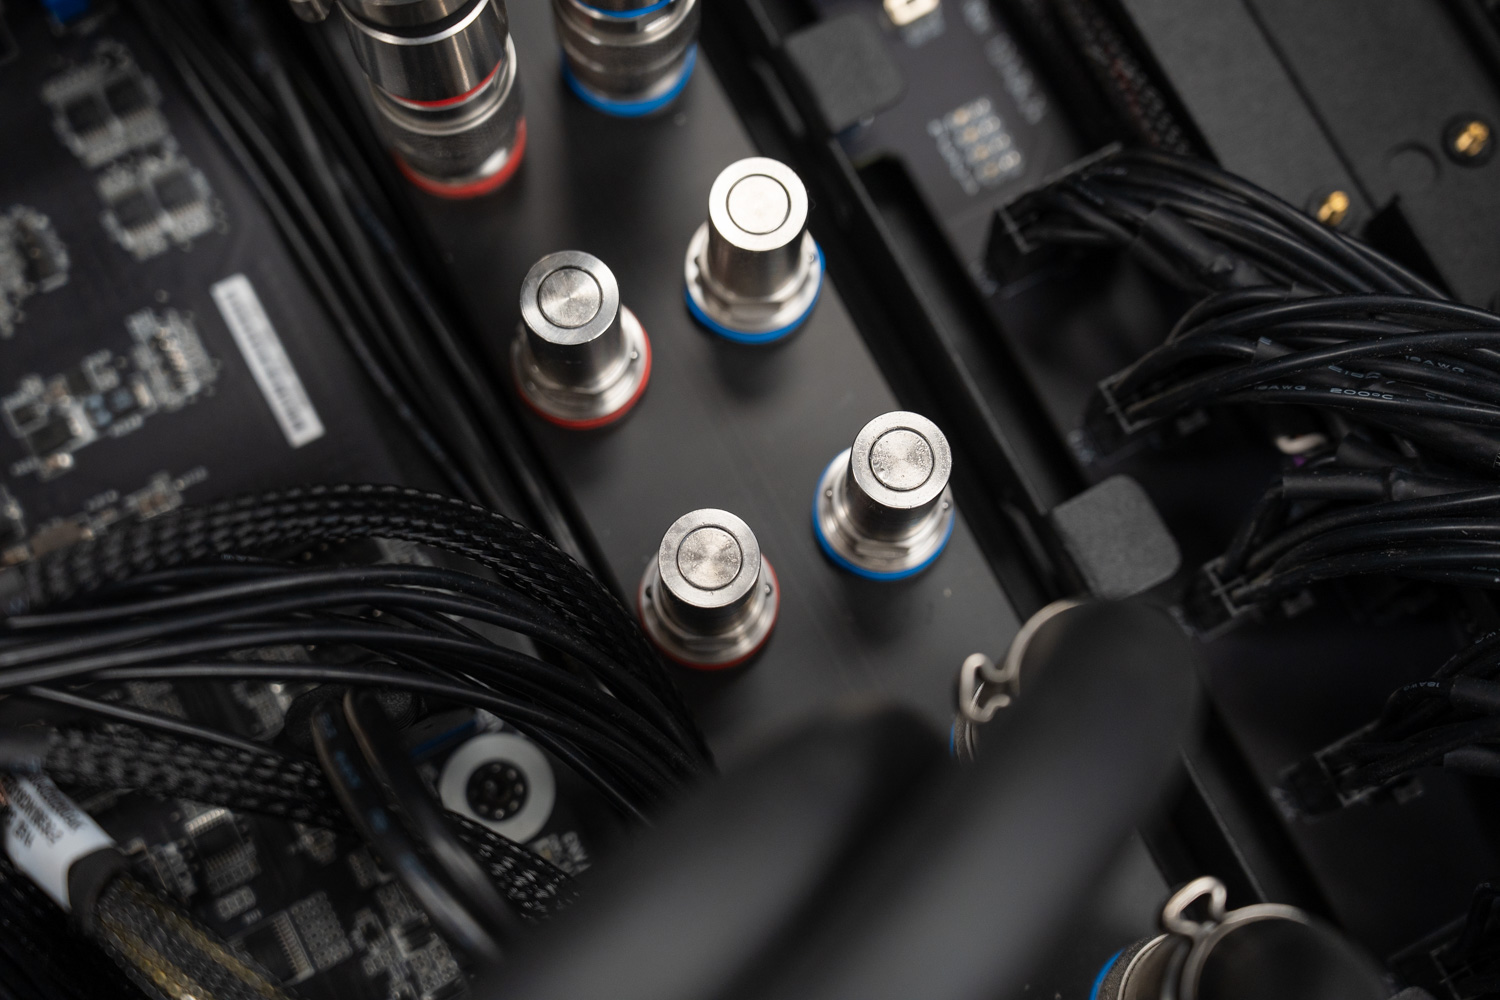
它們斷開連接時在接合面上留下的殘留物極少,因此技術人員無需排空 450ml 水箱或整個水冷迴路中的冷卻液,即可拆卸或更換單個 GPU 或 CPU。如此一來,Grando 將風冷系統的維護便利性帶到了高性能液冷平台。
CPU散熱和記憶體
CPU及其電壓調節器也受惠於直接連接到冷卻迴路的專用冷板,從而防止處理器在多GPU高負載運作時成為瓶頸。我們評測的原型機配備了一塊AMD Turin/Genoa主機板,搭載一顆AMD EPYC 9474F 48核心處理器。此冷板的品質與顯示卡冷板相得益彰,採用實心銅材精密加工而成,並用不銹鋼螺絲固定。
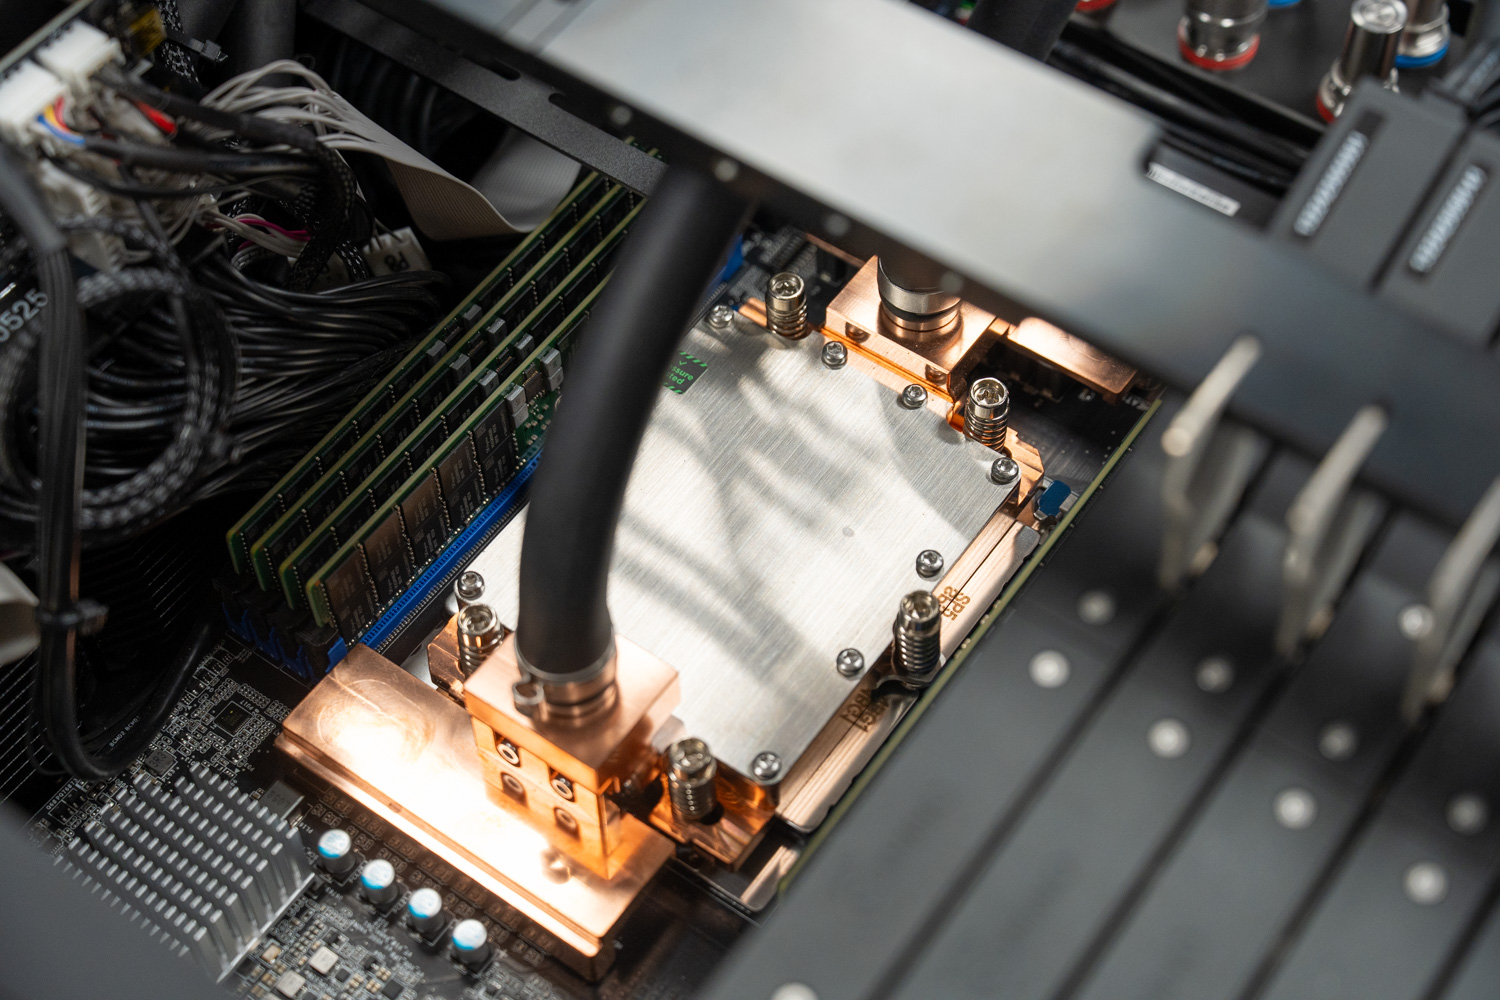
CPU兩側各有八個已插滿記憶體的DRAM插槽,支援最高2TB的記憶體配置。我們評測的這台機器配備了512GB的DDR5記憶體。機殼GPU和CPU區域上方有一根支撐桿,與它們垂直,用於固定GPU等敏感組件,並在運輸過程中保持機箱的剛性。
散熱器和風扇
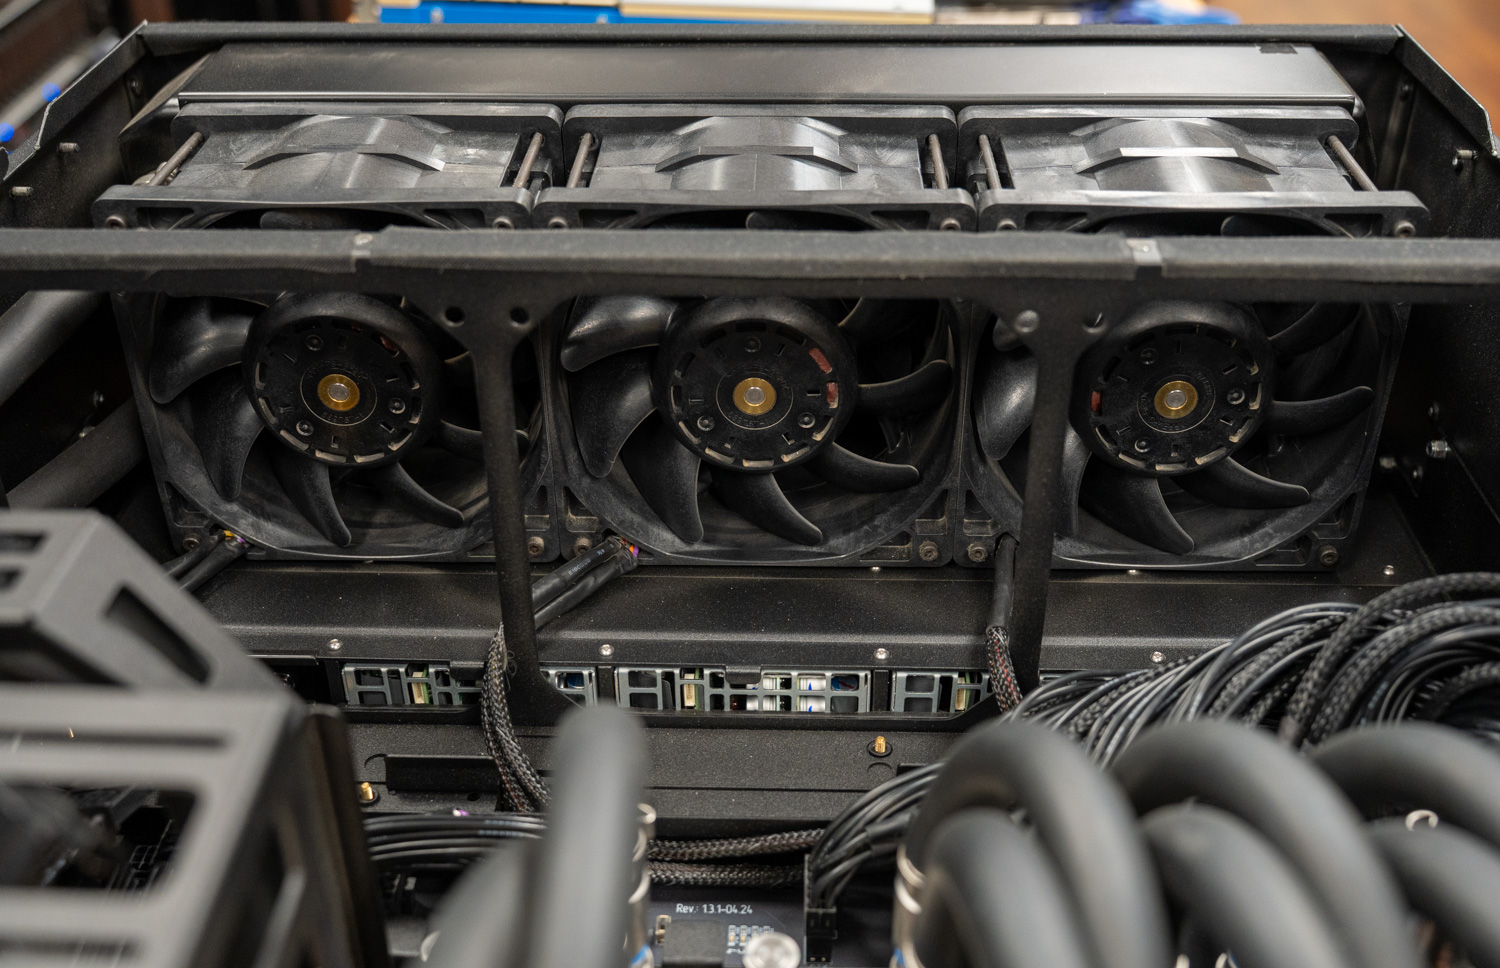
散熱方面,機殼後方安裝了一個大型三聯裝140mm冷排,搭配三個高速140mm風扇,最高轉速可達6,200 RPM,風量可達1,000 m³/h。厚實的冷排上密集的鰭片設計凸顯了平台的散熱潛力,在我們的配置下,該平台能夠持續散發高達6.5kW的熱量。
最令人驚訝的是,儘管負載如此之高,風扇轉速也如此之高,但這台機器的噪音水平卻控制在可接受的範圍內,即使在全速運轉時,噪音也僅為 70 分貝左右。對於工作站來說,這已經算是相當響亮了,但考慮到它要散發相當於小型電爐的熱量,這樣的噪音水平已經相當不錯了,這也充分說明了 Comino 的液冷散熱系統能夠多麼高效地將熱量從組件中散發出去。
前面板和遙測顯示屏
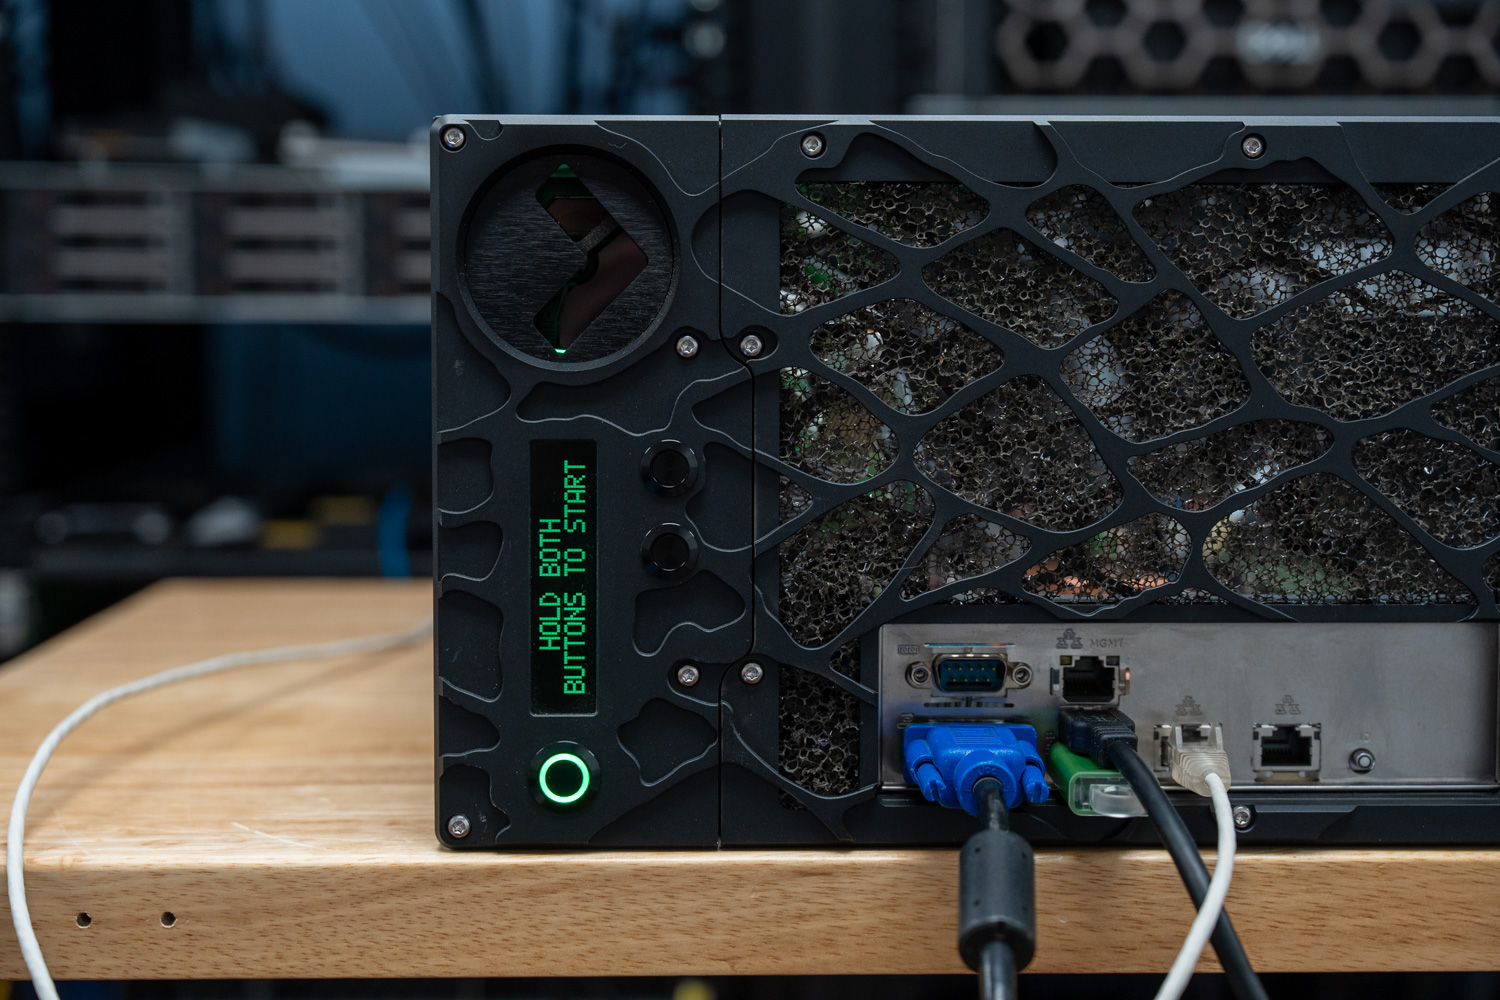
前面板上的 LED 顯示器可即時顯示關鍵遙測數據,包括水泵狀態、環境空氣溫度、冷卻液溫度和風扇轉速。使用者可透過冷卻模組上的背光按鈕瀏覽選單,短按按鈕可捲動查看可用資料。長按 PB2 按鈕可開啟其他選單分支,包括指令、服務設定和事件日誌。此外,前面板 I/O 介面還包括一個用於顯示輸出的 VGA 連接埠、一個串列埠、多個 USB 連接埠以及用於連接週邊設備和網路介面的連接埠。
電源和儲存架構
電力傳輸和冗餘
如此強大的運算能力需要同樣可靠的電源供應。 Grando 支援最多四個 1000W 或 2000W 熱插拔 CRPS 模組,採用冗餘配置,可在 180–264V 電壓範圍內提供高達 8.0kW 的功率。憑藉對 4+0、3+1 和 2+2 冗餘模式的支持,該系統能夠容忍電源故障,同時確保全天候 (24/7) 人工智慧和高效能運算工作負載的持續運作。
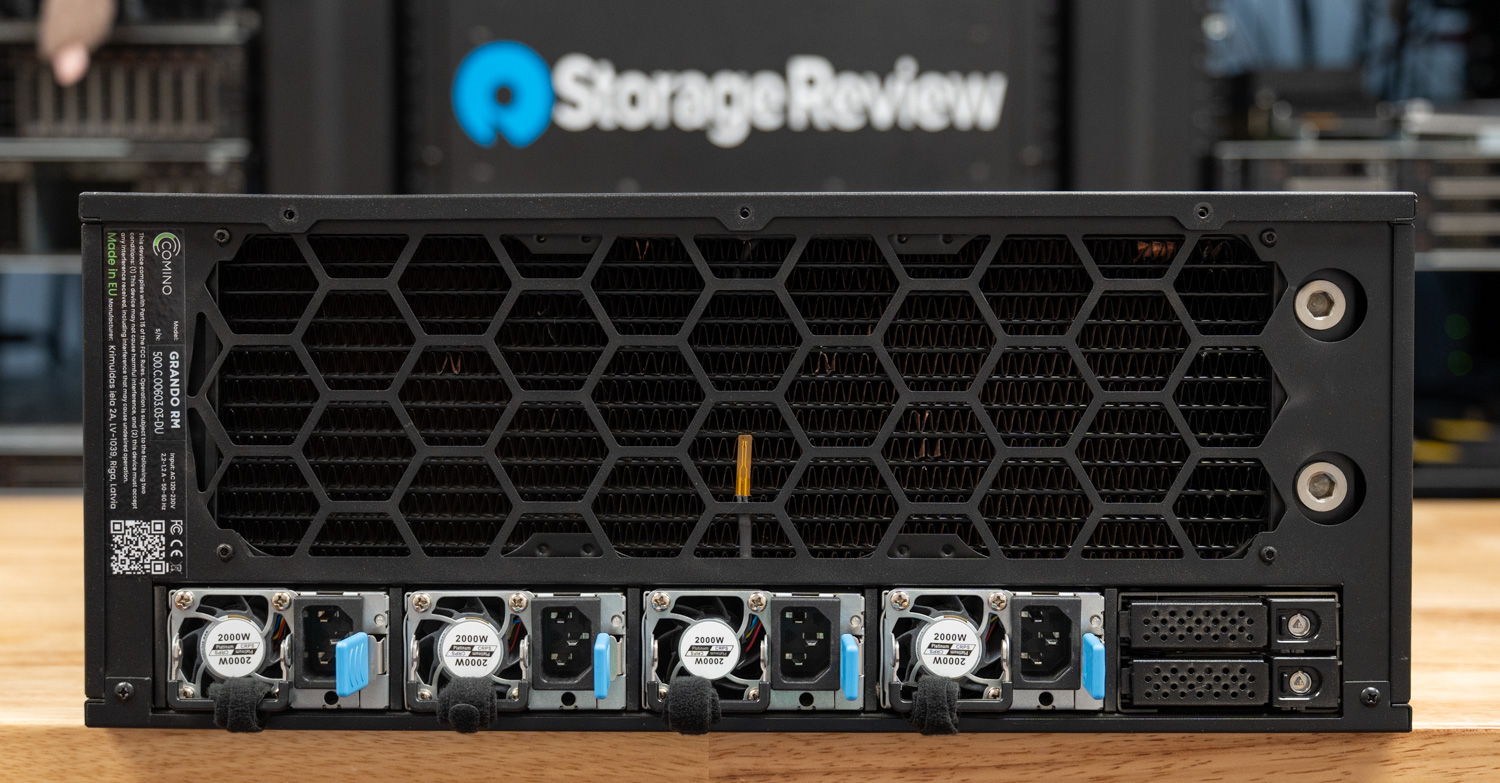
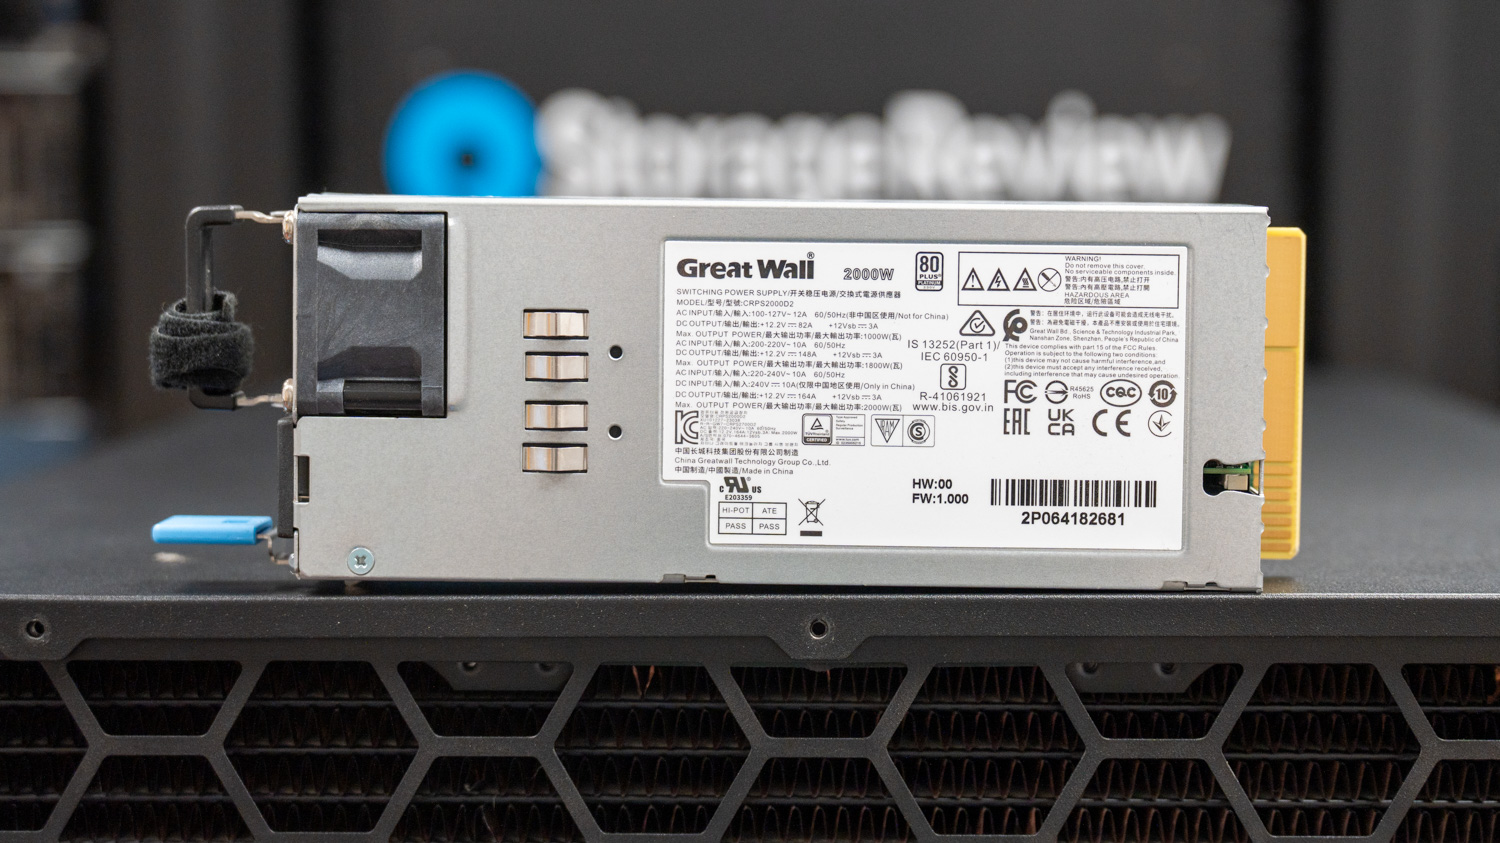
我們評測的樣機配備了四個長城 2000W 80 Plus 白金熱插拔電源,組成了完整的 8.0kW 配置。
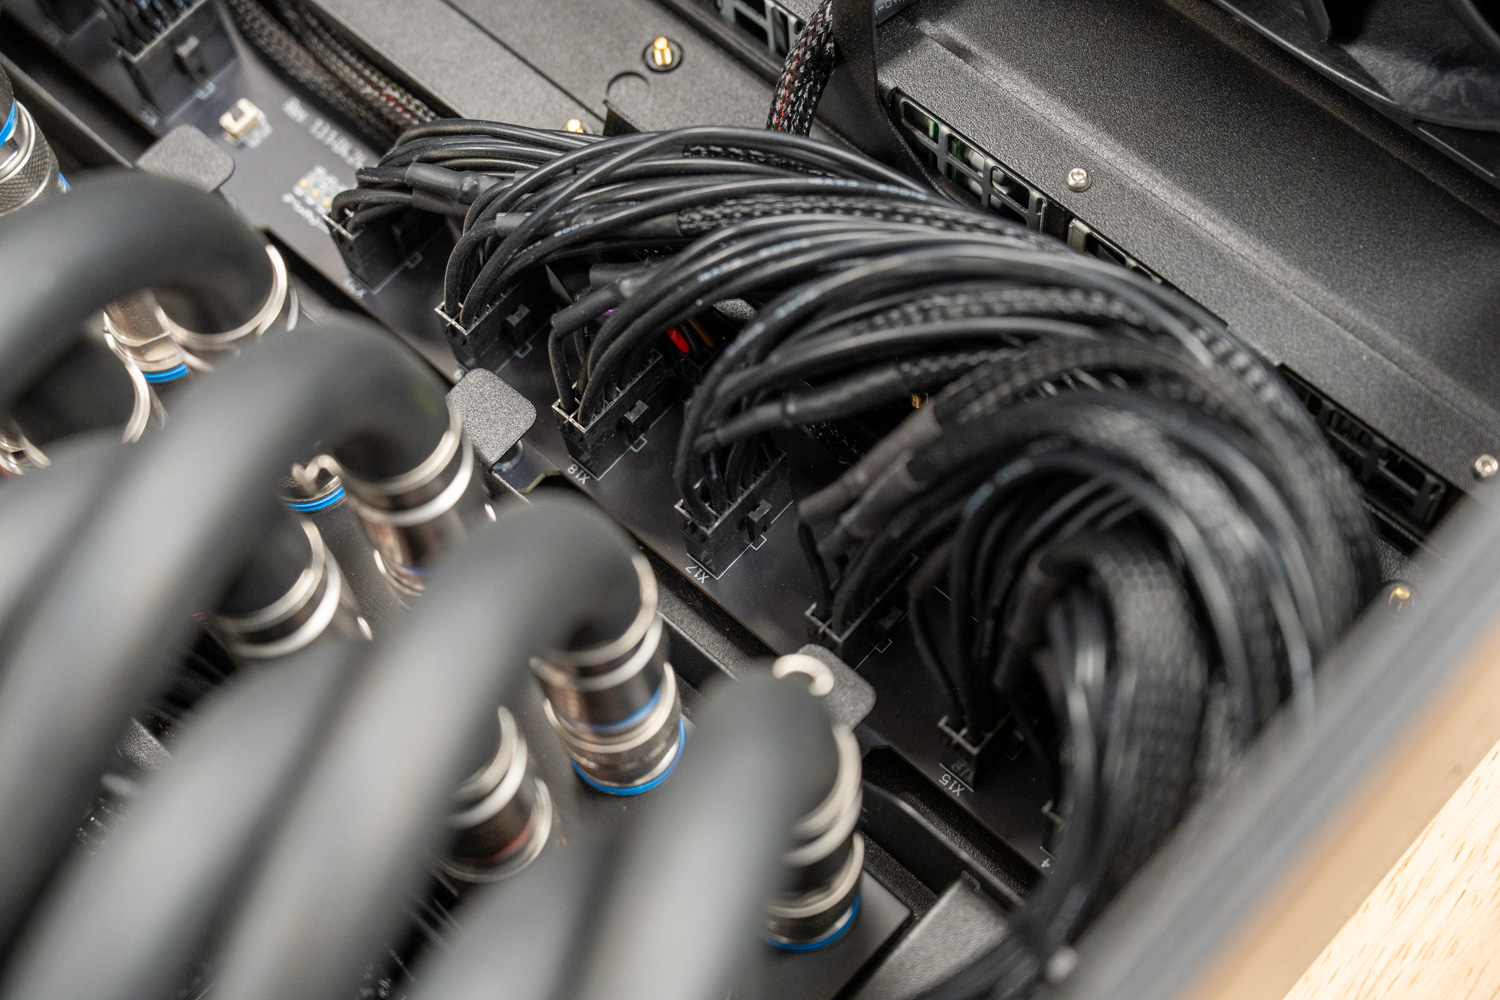
每個GPU的供電都透過一個集中式的12針電源分配板進行,該分配板安裝在GPU陣列和主線之間。 Grando利用這個分配板將輸入的電源集中起來,然後以有序且節省空間的方式將其分支到每個GPU。
PCIe、儲存和網路
Grando 機殼可輕鬆支援六張顯示卡,且不會影響插槽頻寬,其機殼可擴充至八張顯示卡配置,達到最大密度。 Comino 機殼採用 ASRock Rack GENOAD8X-2T/BCM 主機板,提供七個 x16 和一個 x8 PCIe Gen 5 插槽,這意味著八張顯示卡中有七張可以以 x16 頻寬全速運行,而第八張顯示卡則以 x8 頻寬運行。這是在單路 CPU 可支援的 PCIe 通道數量和 Comino 不願增加 PCIe 切換板的尺寸、成本和複雜性之間做出的權衡。如果採用雙路主機板,雖然可以提供更多 PCIe 頻道,但由於第二個 CPU 插槽會佔用原本用於 PCIe 插槽的空間,因此可用的插槽數量會更少。
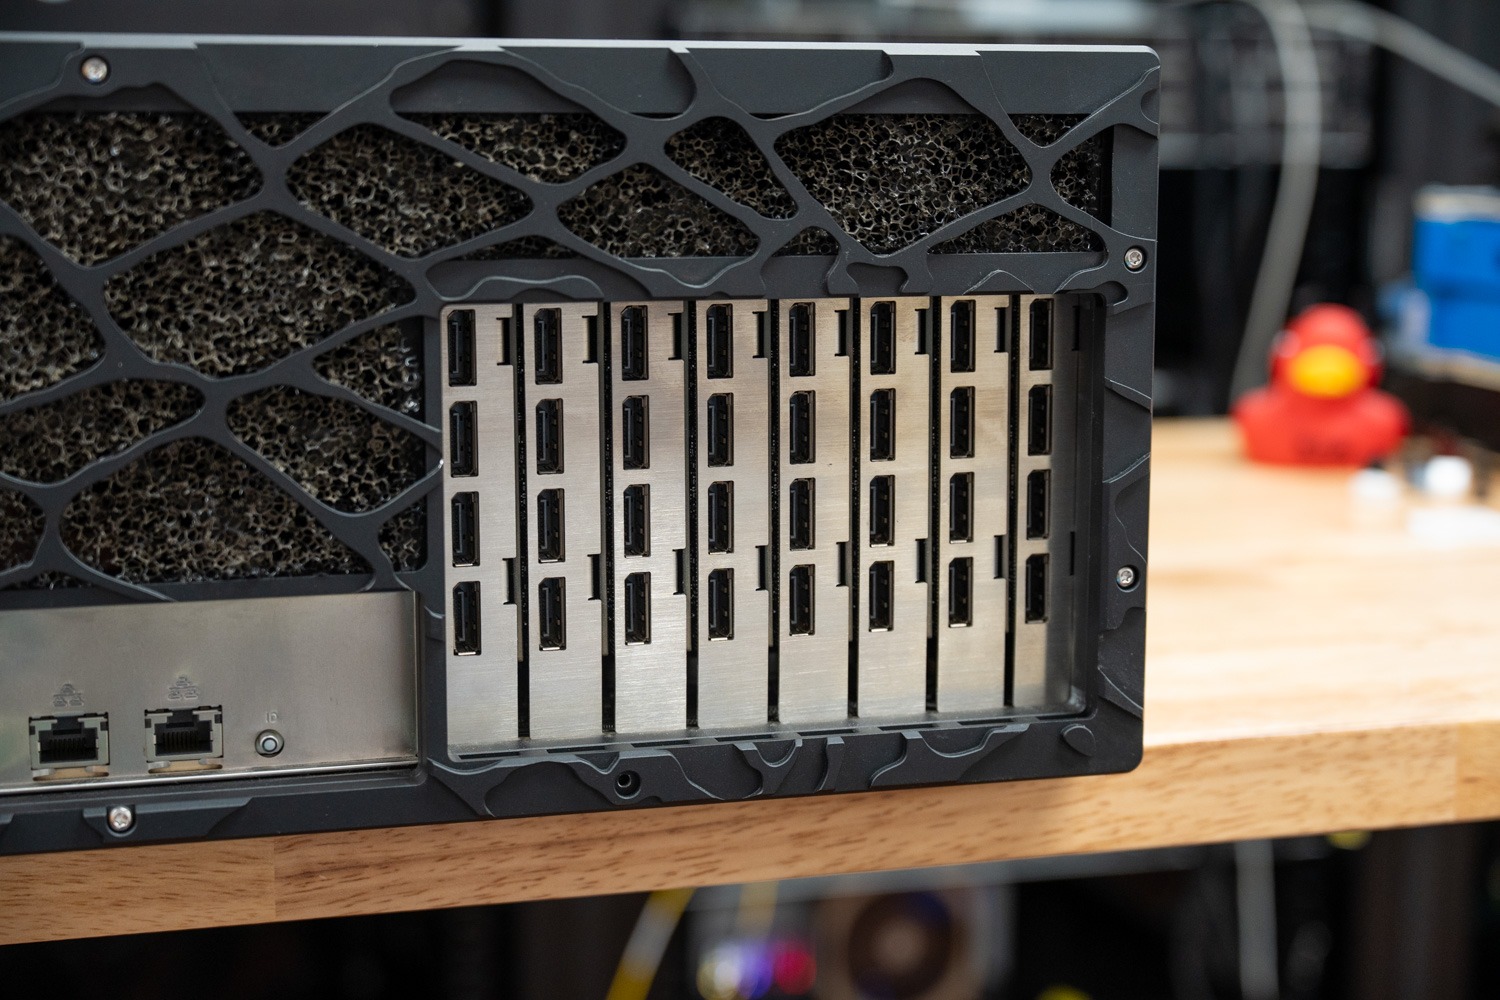
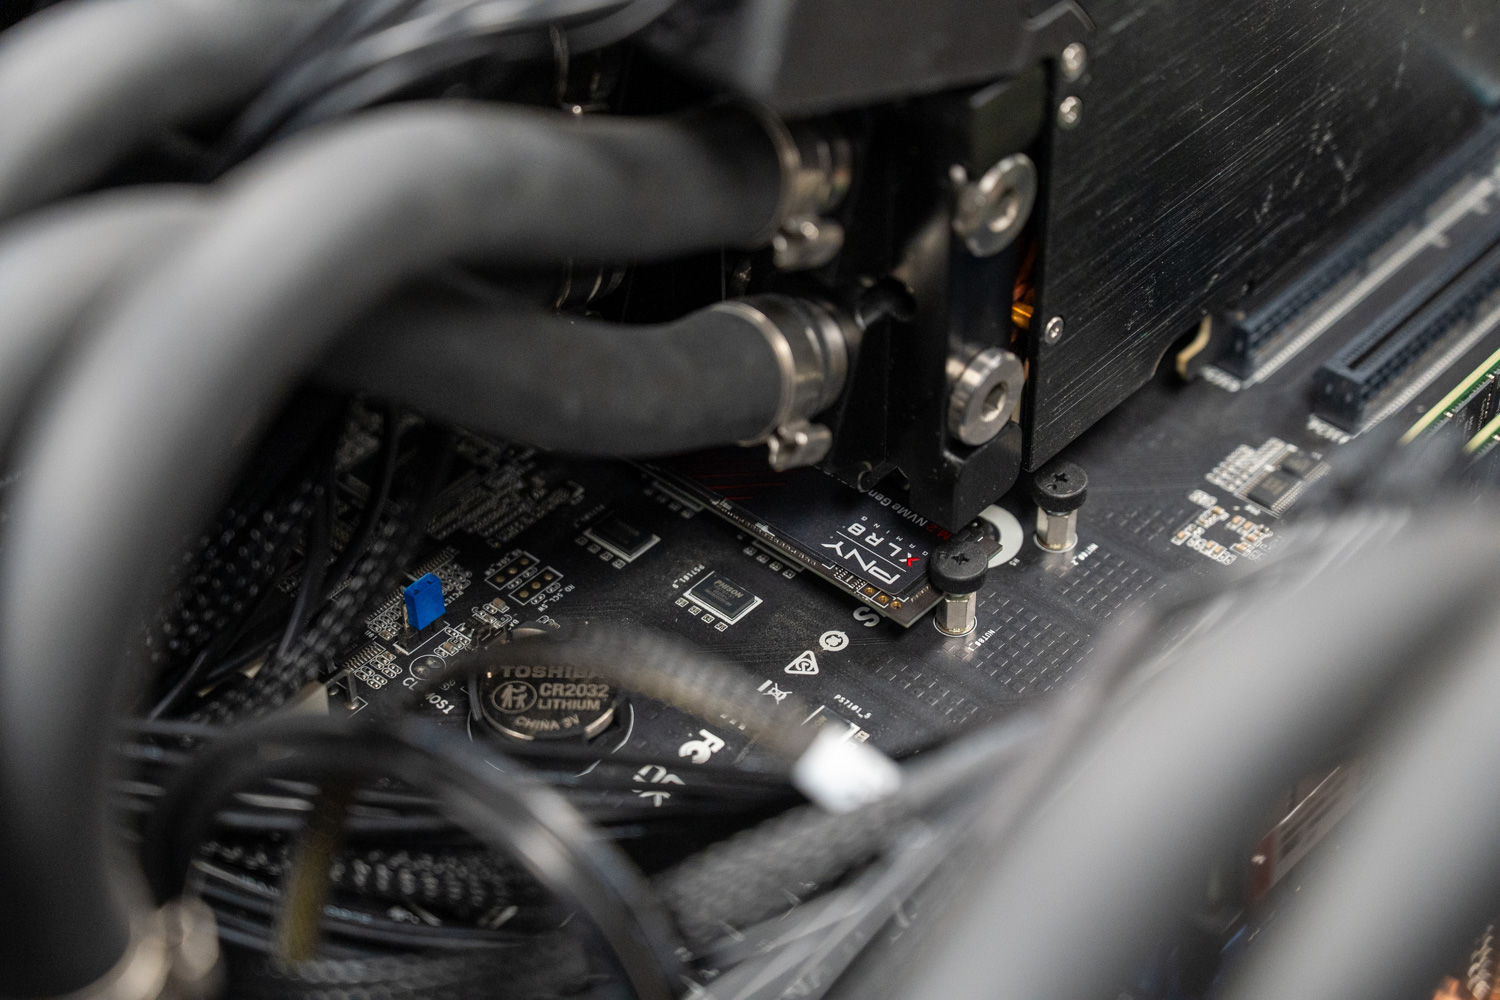
在單路系統中運行八塊顯示卡會佔用大部分可用的 PCIe 通道,這會帶來一些權衡。我們評測的這台基於 AMD Genoa 平台的機器總共有 128 條 PCIe Gen 5 頻道。八塊顯示卡佔用了其中的 120 個通道,剩餘的 8 個通道被四路分配給每個 M.2 SSD 插槽,因此無法同時運行八塊顯示卡和所有通過機箱後部兩個 MCIO 接口連接的 NVMe 固態硬碟。在我們配置八塊顯示卡的情況下,只有兩個 M.2 插槽可用於儲存。需要額外 NVMe 容量並同時追求最大顯示卡密度的管理員應該注意,透過背板硬碟籠添加後置熱插拔 NVMe 固態硬碟會佔用額外的 PCIe 通道,並限制系統中部分顯示卡的效能。
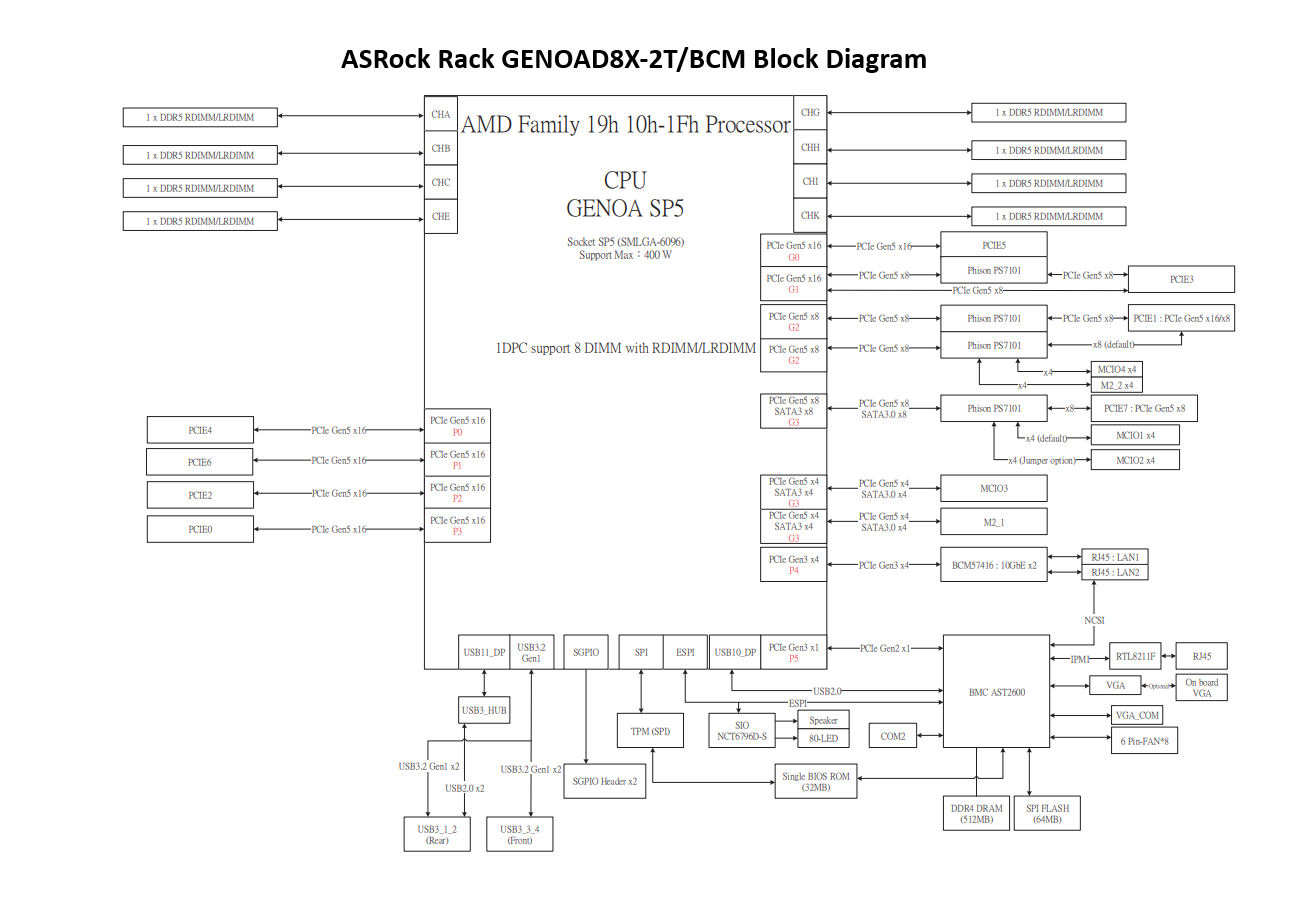
ASRock Rack GENOAD8X-2T/BCM 主機板框圖顯示了 CPU、PCIe Gen 5 插槽、DIMM 通道、M.2 插槽、BMC、USB、SATA 和網路連線。
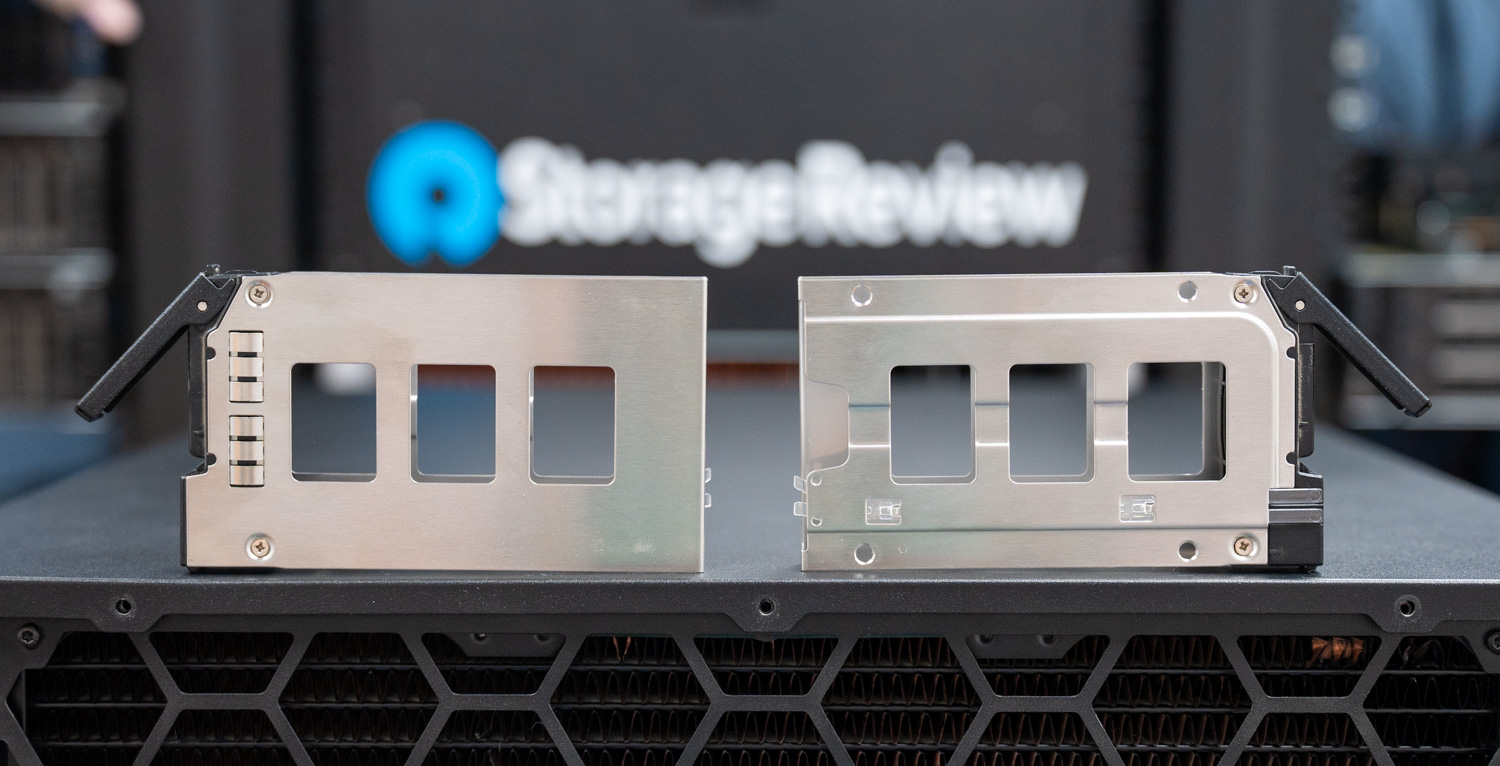
儘管如此,儲存方面同樣採用了模組化設計,且擴充性極佳,但其配置會影響GPU的PCIe通道預算,因此在規劃使用情境時需要格外注意。我們評測機的後面板配備了一個2.5吋硬碟籠,最多可支援四個2.5吋SSD,支援4個7mm或2個15mm兩種配置。此外,也可以選擇在第四個電源插槽的位置安裝第二組最多四個SSD。由於我們的評樣機需要佔用全部四個電源位元才能支援完整的8GPU配置,因此我們只能使用兩個熱插拔電源位中的第一個。機殼內部可安裝一個3.5吋硬碟籠,最多可容納四個3.5吋硬碟、四個2.5吋15mm硬碟或最多十二個2.5吋7mm硬碟,如果配置得當,還可以額外安裝四個內部2.5吋7mm SSD插槽。
網路方面,主機板標配兩個板載 RJ45 10 Gb/s 連接埠(由 Broadcom BCM57416 晶片驅動)以及一個專用的千兆乙太網路 IPMI 管理連接埠。管理員可以透過安裝支援高達 400 Gb/s 頻寬的 PCIe 網路卡來進一步提升頻寬,實現高頻寬網路連線。但要注意的是,額外的 PCIe 網路卡會佔用 GPU 插槽,減少系統可容納的 GPU 數量上限。
遠端管理和系統智能
為了保護硬體並優化效能,該系統配備了科米諾監控系統 (CMS)。 CMS 由一塊獨立的自主控制器板驅動,作為伺服器的“大腦”,獨立於主作業系統運作。實際上,該控制器讀取一系列感測器的數據,即時監測空氣和冷卻液溫度、濕度、冷卻液流量以及儲液罐液位。至關重要的是,這種自主設計使 CMS 能夠進行自我診斷,並在檢測到洩漏或泵浦故障時觸發緊急停機,從而保護昂貴的內部硬體免受損壞。
基於 Web 的圖形使用者介面 (GUI) 可處理日常管理,讓管理員能夠清楚了解 CPU 和 GPU 的散熱效能、正常運作時間和即時能耗。對於企業級部署,CMS 還可透過 REST API 連接到集中式監控工具,例如 Zabbix、Grafana 和 InfluxDB。這些功能共同幫助管理員維持 3 年的服務間隔期,並確保伺服器即使在高溫環境下也能以最佳效率運行,而不會出現過熱降頻。
超越人工智慧:創意和工程應用
雖然我們的測試專注於人工智慧推理工作負載,但 Grando 對於需要強大本地 GPU 運算能力的創意專業人士和工程師來說同樣實用。八張 RTX PRO 6000 顯示卡共 768GB 的顯存,使其擁有傳統工作站配置無法比擬的強大效能。
特效藝術家和動態圖形專業人士可以將包含海量紋理集的複雜場景完全渲染在顯存 (VRAM) 中,從而消除困擾 8K 素材或高多邊形環境製作的磁碟交換瓶頸。運行計算流體動力學或結構模擬的 CAD 工程師可以處理前所未有的複雜組件,而無需將模型分割成多個運行步驟。處理多流 8K RAW 時間軸的視訊剪輯師、應用全解析度機器學習降噪的調色師以及在本地渲染路徑追蹤最終效果而無需等待雲端資源的 3D 藝術家,都能從這種高密度的 GPU 記憶體和運算能力中受益。
Grando 平台並不需要完整的八 GPU 配置。 Comino 提供四 GPU、六 GPU 和八 GPU 三種配置方案,所有版本均可立即出貨。小型工作室、獨立創作者和工程團隊可以根據當前需求靈活選擇合適的配置,並在工作負載成長時擁有清晰的升級路徑。
平台權衡:密度與可擴展性
Grando 的緊湊設計在標準的 4U 空間內實現了卓越的 GPU 密度和散熱管理,但這種密度涉及架構上的權衡,在部署之前值得了解。
此機殼相容於EATX和EEB規格的主機板,但不相容於傳統雙路平台中常見的擴充型伺服器主機板。這限制了除GPU陣列之外可用於週邊裝置的PCIe通道總數。在我們採用的八GPU配置中,AMD EPYC處理器的128條PCIe Gen 5通道幾乎全部被GPU佔用,僅剩少量頻寬可用於板載10GbE連接埠以外的額外NVMe儲存或高速網路連線。
這與我們評測的戴爾、HPE 和 Supermicro 的八 GPU 平台形成鮮明對比。這些系統採用更大的機箱、雙路配置和 PCIe 交換器拓撲結構,以支援更豐富的外部連接。它們通常除了完整的 GPU 組件外,還能容納四到八個額外的網卡或 DPU,以及八個或更多熱插拔 NVMe 硬碟位,使其非常適合需要高頻寬互連的分散式推理工作負載。
然而,這種擴展能力的代價相當高昂。功耗超過 8kW。散熱需求需要專用的資料中心冷卻基礎設施。噪音水平限制了其在專用機房之外的部署。此外,由於企業級 GPU 平台持續面臨供應限制,交付週期通常長達六到十八個月。
Grando 的定位有所不同。對於那些優先考慮快速部署、易於管理的運作環境以及推理或創造性工作負載而非大規模分散式訓練的組織而言,其權衡取捨通常是有利的。對於那些需要立即獲得硬體並在實際可用的環境中工作的團隊來說,Grando 的高密度部署方案可能比排隊等待一個到貨後無法真正部署的平台更加實用。
科米諾格蘭多性能測試結果
系統配置
- 底盤: 科米諾格蘭多
- 主板: 華擎機架 GENOAD8X-2T/BCM
- 中央處理器: AMD EPYC 9474F 48℃
- 內存: 512GB DDR5
- GPU: 8 x NVIDIA RTX PRO 6000
- 貯存: M.2 SSD
Claude Code Serving – MiniMax M2.5
除了傳統的原始LLM推理基準測試之外,我們還想評估該硬體在智能體編碼工作流程中的效能,特別是透過使用本地託管模型支援多個並發的Claude Code會話。此用例直接關係到開發團隊的生產力:在體驗下降之前,有多少工程師可以同時使用由單一節點提供的AI編碼助理?
為了驗證這一點,我們建立了一個基準測試框架,該框架會產生一個中等難度的編碼問題資料集(例如實作 LRU 快取、建置 CLI 待辦事項應用程式、編寫 Markdown 轉換器以及建置 REST API),並在單獨的 Docker 容器中針對本機 vLLM 伺服器執行每個 Claude Code 會話。會話和推理端點之間有一個透明代理,用於捕獲每個 Claude Code 實例的請求指標。我們使用的模型是 MiniMax M2.5,透過 vLLM 在系統的八塊 NVIDIA RTX PRO 6000 GPU 上運作。雖然 M2.5 在公開排行榜上並非排名最高的編碼模型,但它是一個功能強大的模型,許多用戶(包括我們的開發者朋友)都在本地運行它。
作為基準參考點,我們使用 Anthropic 的 Claude Opus 4.6 透過 OpenRouter.ai(最受歡迎的生產 API 存取路由服務之一)測得的平均輸出吞吐量。該基準值約為每個 API 請求每秒 37 個令牌。
我們測量了兩個關鍵指標:每個 Claude Code 會話每秒平均輸出令牌數(每個開發人員的體驗)和所有會話每秒總輸出令牌數(伺服器產生的總工作量)。
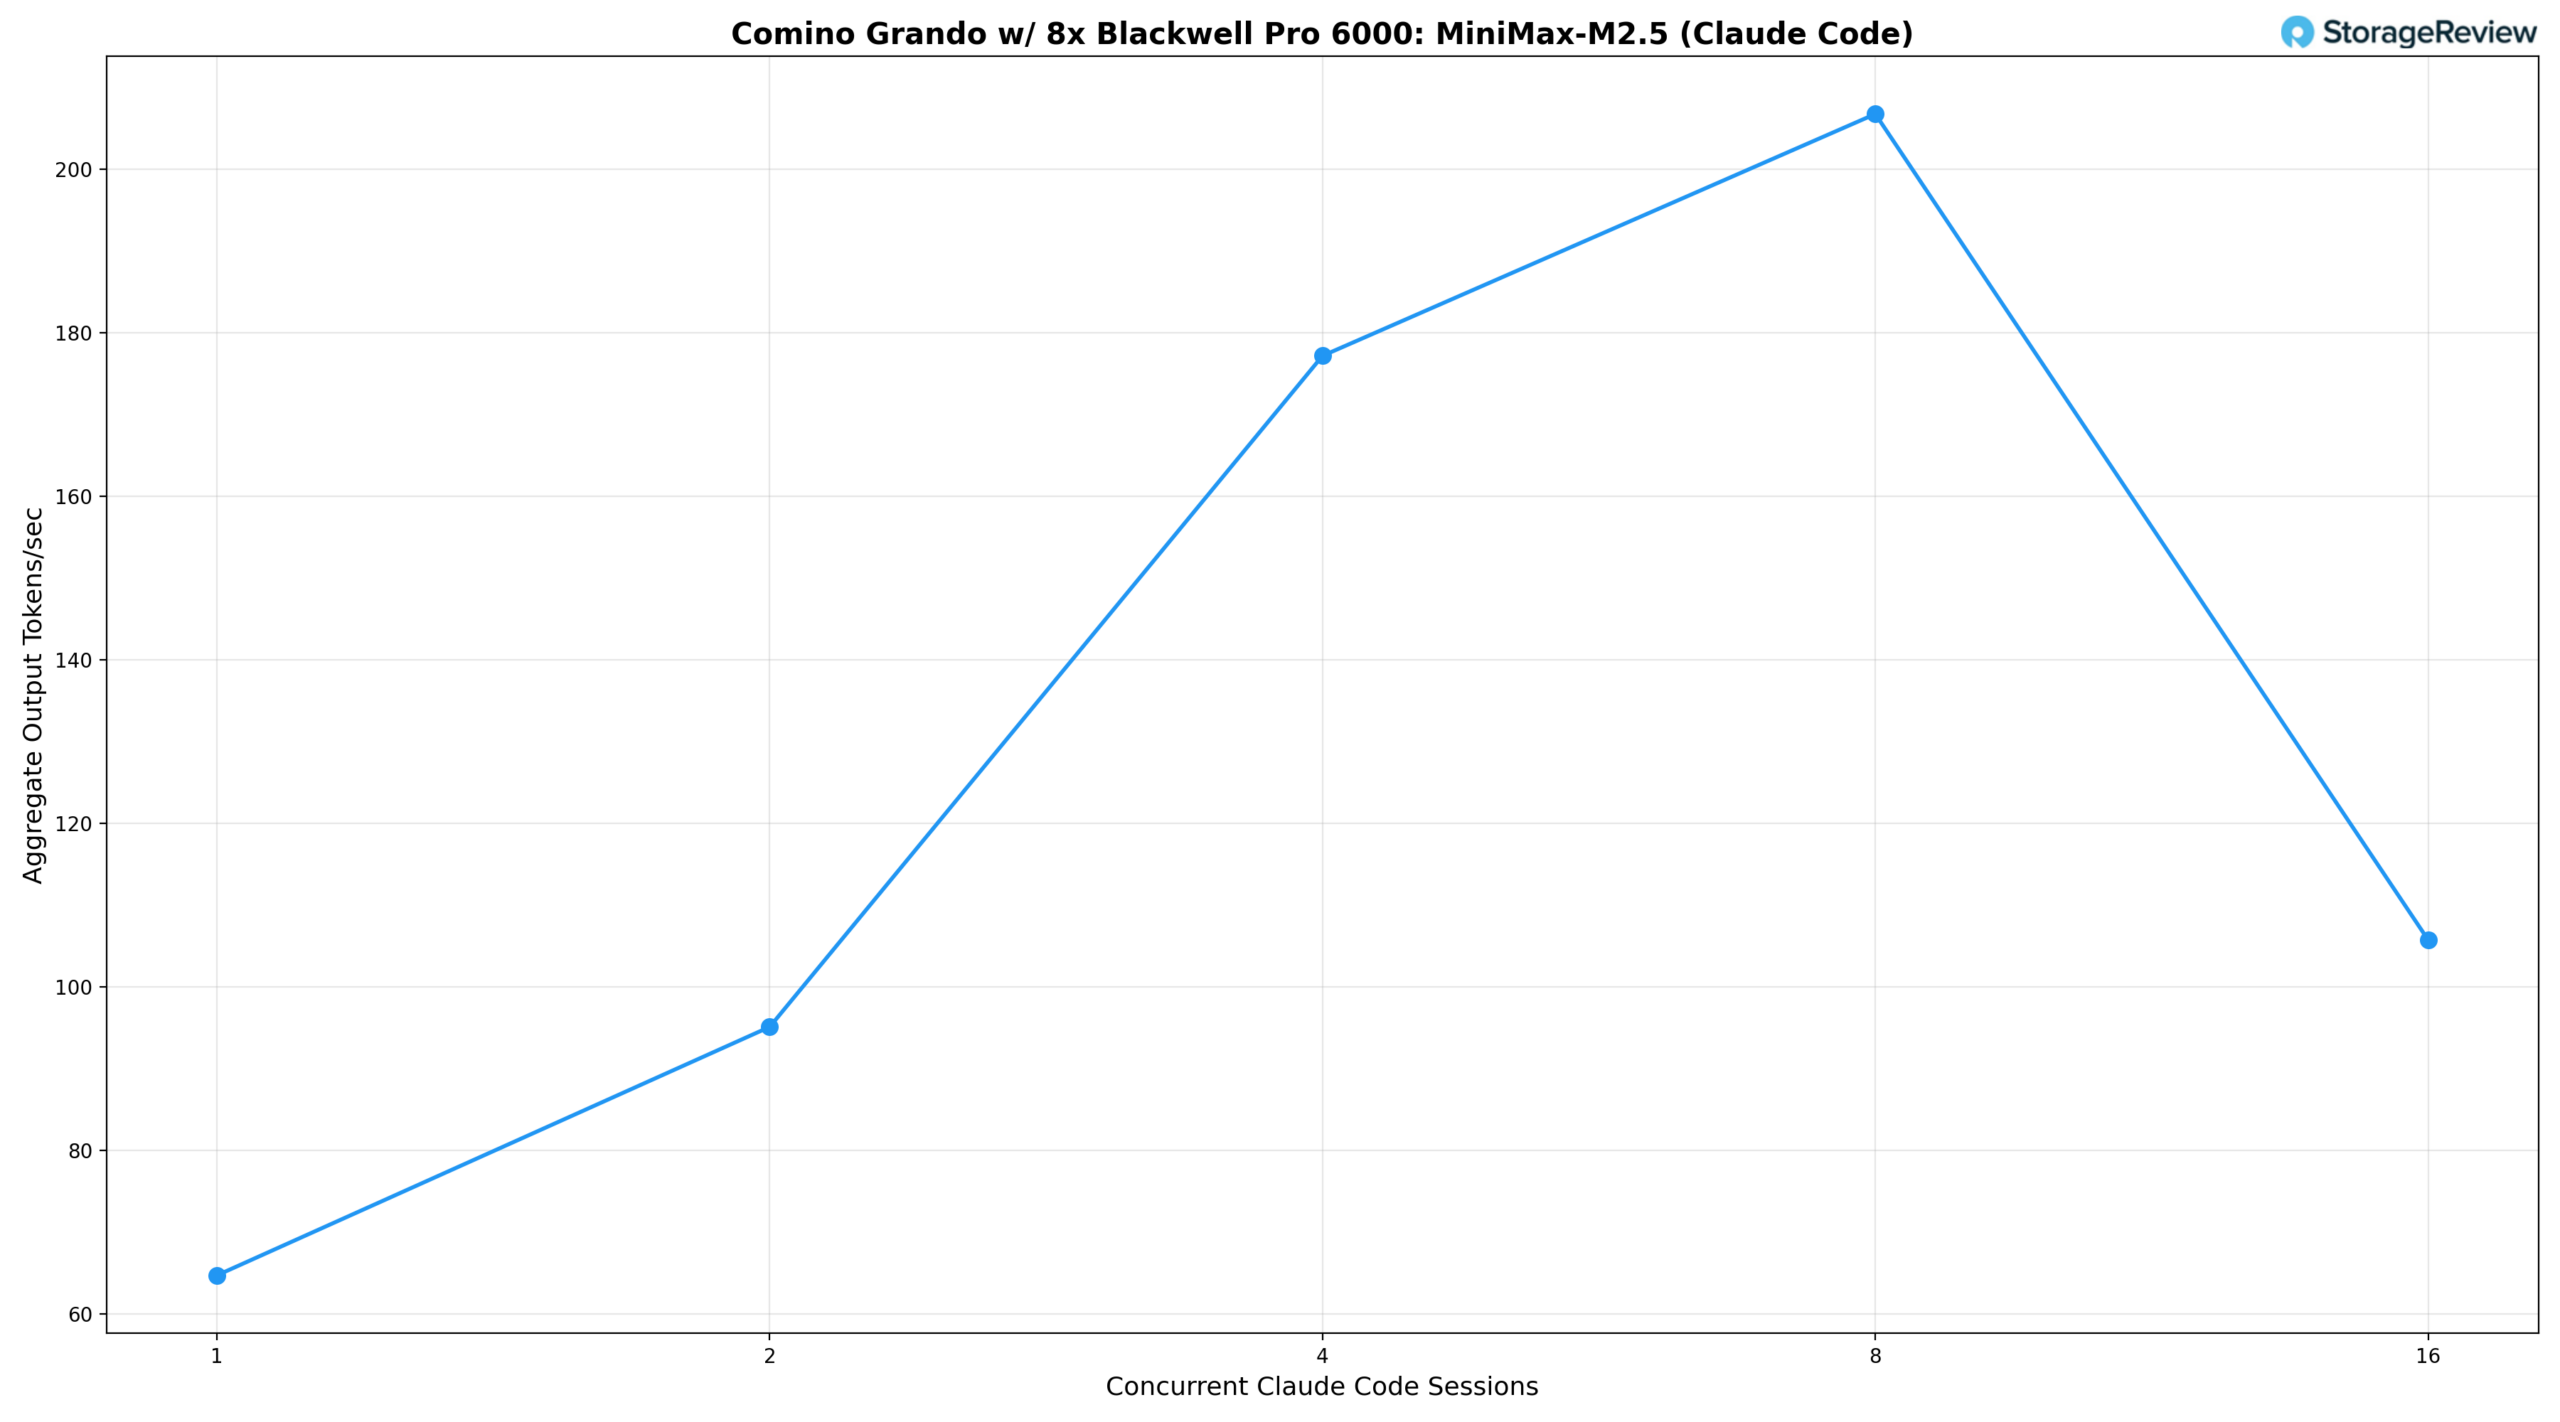
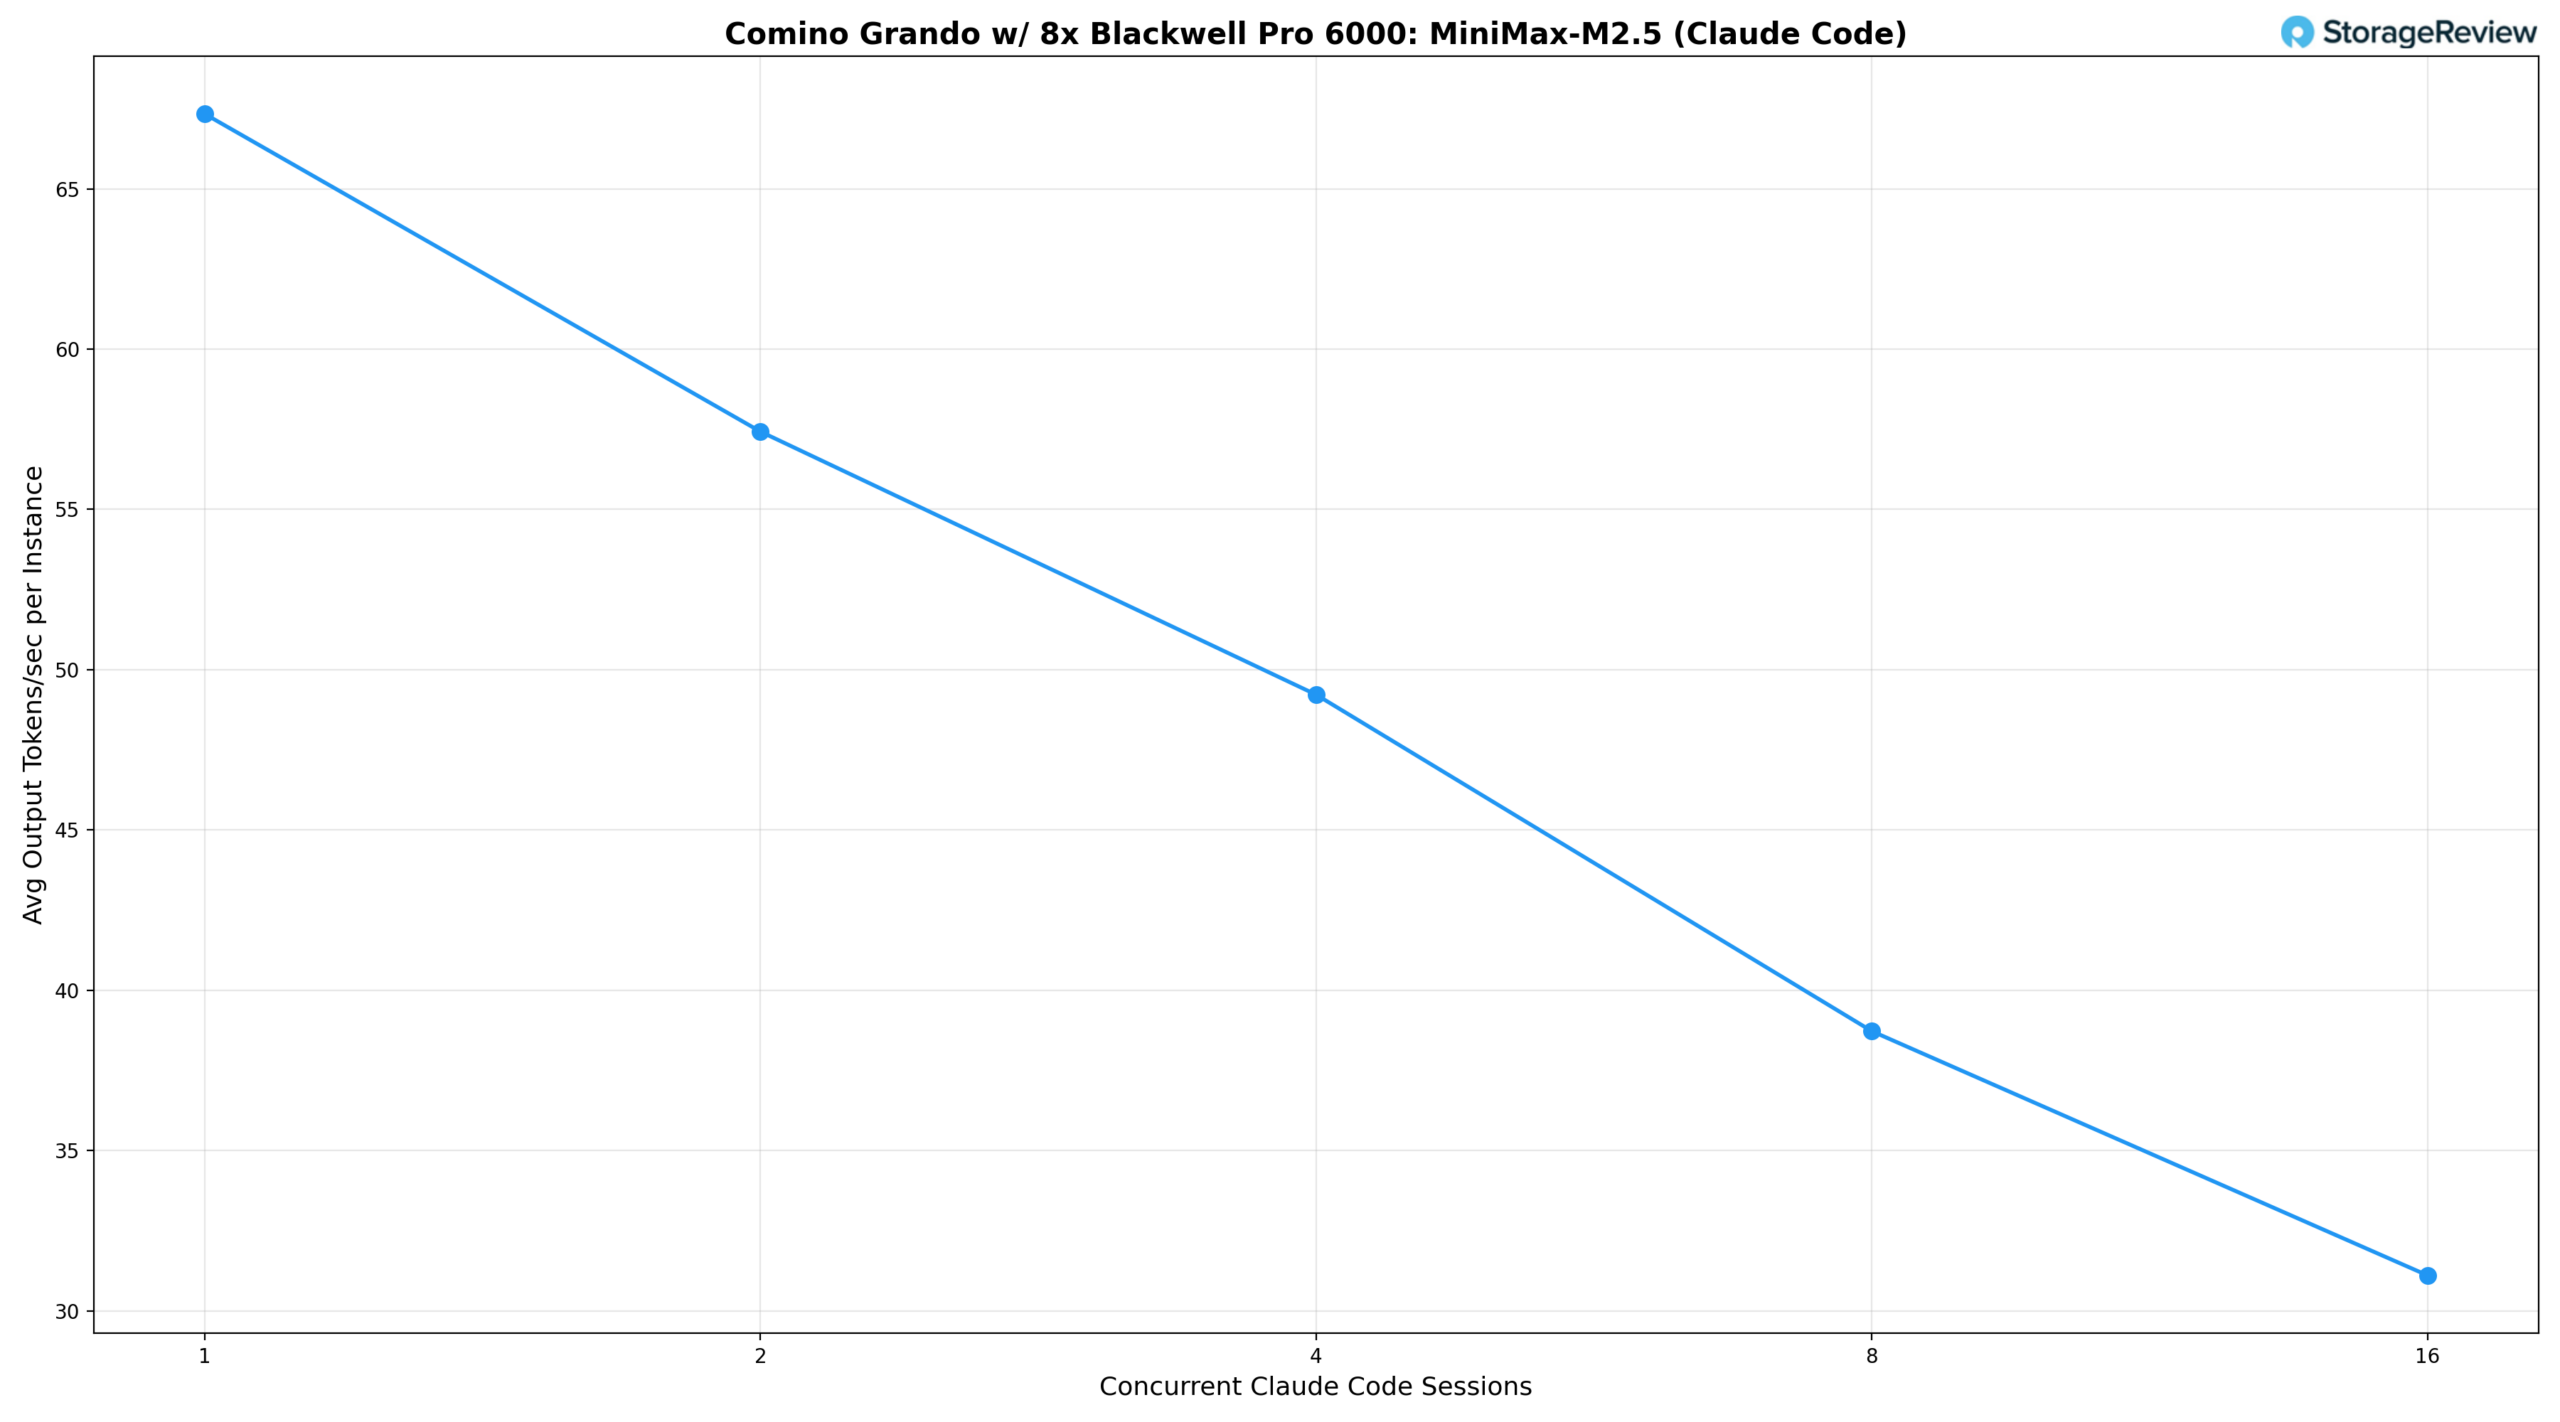
根據測試結果,單一同時 Claude Code 會話的單一使用者吞吐量為 67.3 tok/s,總吞吐量為 64.7 tok/s。當會話數為 2 時,單一使用者吞吐量略微下降至 57.4 tok/s,而總吞吐量則攀升至 95.1 tok/s,這是因為 vLLM 的批次機制開始分攤開銷。四個同時會話的單一使用者吞吐量保持在 49.2 tok/s,對於互動式編碼工作流程而言,這仍然提供了高度流暢的體驗,而總吞吐量則達到了 177.2 tok/s。八個並發會話是總吞吐量的最佳組合,峰值達到了 206.7 tok/s,而單用戶吞吐量則穩定在 38.7 tok/s,這一水平對於實時代碼生成和迭代來說仍然足夠流暢。
在 16 個並發會話的情況下,系統表現出經典的批次權衡:單一實例的吞吐量下降到 31.1 tok/s,總輸出下降到 105.8 tok/s。這表明,在這種並發級別下,230B MiniMax M2.5 模型已經接近八塊 GPU 所能承受的極限,否則會給每個用戶帶來明顯的延遲。從 8 個會話到 16 個會話的總吞吐量下降,反映的是大型 MoE 架構在高負載並發解碼情況下對記憶體頻寬的需求,而不是調度效率低下。
對於正在評估用於開發者工具的自託管 AI 基礎設施的組織而言,Grando 無疑是一個強有力的選擇。它運行著前沿的 230B 模型,能夠輕鬆支援多達八個並發的 Claude Code 會話,吞吐量水平之高令人感覺真正具有互動性,峰值總輸出時,每個用戶的速度超過 38 tok/s。由四到八名工程師組成的團隊可以以接近最佳吞吐量運行,而不會出現明顯的響應速度下降。
這種液冷架構使得這種等級的運算能力能夠在傳統GPU伺服器無法運作的環境中實際應用。該系統運作噪音極低,足以放置在新創公司辦公室、小型機房或開放式工作空間的專屬角落。而同等GPU密度的風冷系統噪音通常達到90分貝甚至更高,這足以需要專用的資料中心空間,或至少需要一個經過嚴格隔音處理的封閉式伺服器機房。 Grando可以與使用它的團隊和諧共存。憑藉完全的資料本地化、零API令牌費用以及對模型選擇的完全控制,它提供了一種自託管方案,可以隨著開發團隊的壯大而擴展,而無需資料中心基礎設施或同步增加成本。
vLLM 線上服務 – LLM 推理效能
vLLM 是 LLM 領域最受歡迎的高吞吐量推理和服務引擎之一。 vLLM 線上服務基準測試評估了該推理引擎在並發請求下的實際服務效能。它透過向運行中的 vLLM 伺服器發送請求來模擬生產環境的工作負載,並可配置請求速率、輸入輸出長度和並發客戶端數量等參數。此基準測試可測量關鍵指標,包括吞吐量(每秒令牌數)、首令牌時間 (TTF) 和單次輸出令牌時間 (TPOT),可協助使用者了解 vLLM 在不同負載條件下的效能。
我們測試了涵蓋各種架構、參數規模和量化策略的一系列模型的推理效能,以評估不同並發配置下的吞吐量。
結果總結
| 型號 | 精密 | 等於 (256/256) | 預填充-重(8k/1k) | 解碼密集型(1k/8k) |
|---|---|---|---|---|
| Comino Grando 配備 8 塊 RTX PRO 6000 Blackwell 顯示卡 — vLLM 推理結果(tok/s,峰值 BS=256) | ||||
| GPT-OSS 20B | ep_dp1 | 17,280 | 32,061 | 11,187 |
| GPT-OSS 120B | ep_dp1 | 11,726 | 21,636 | 7,570 |
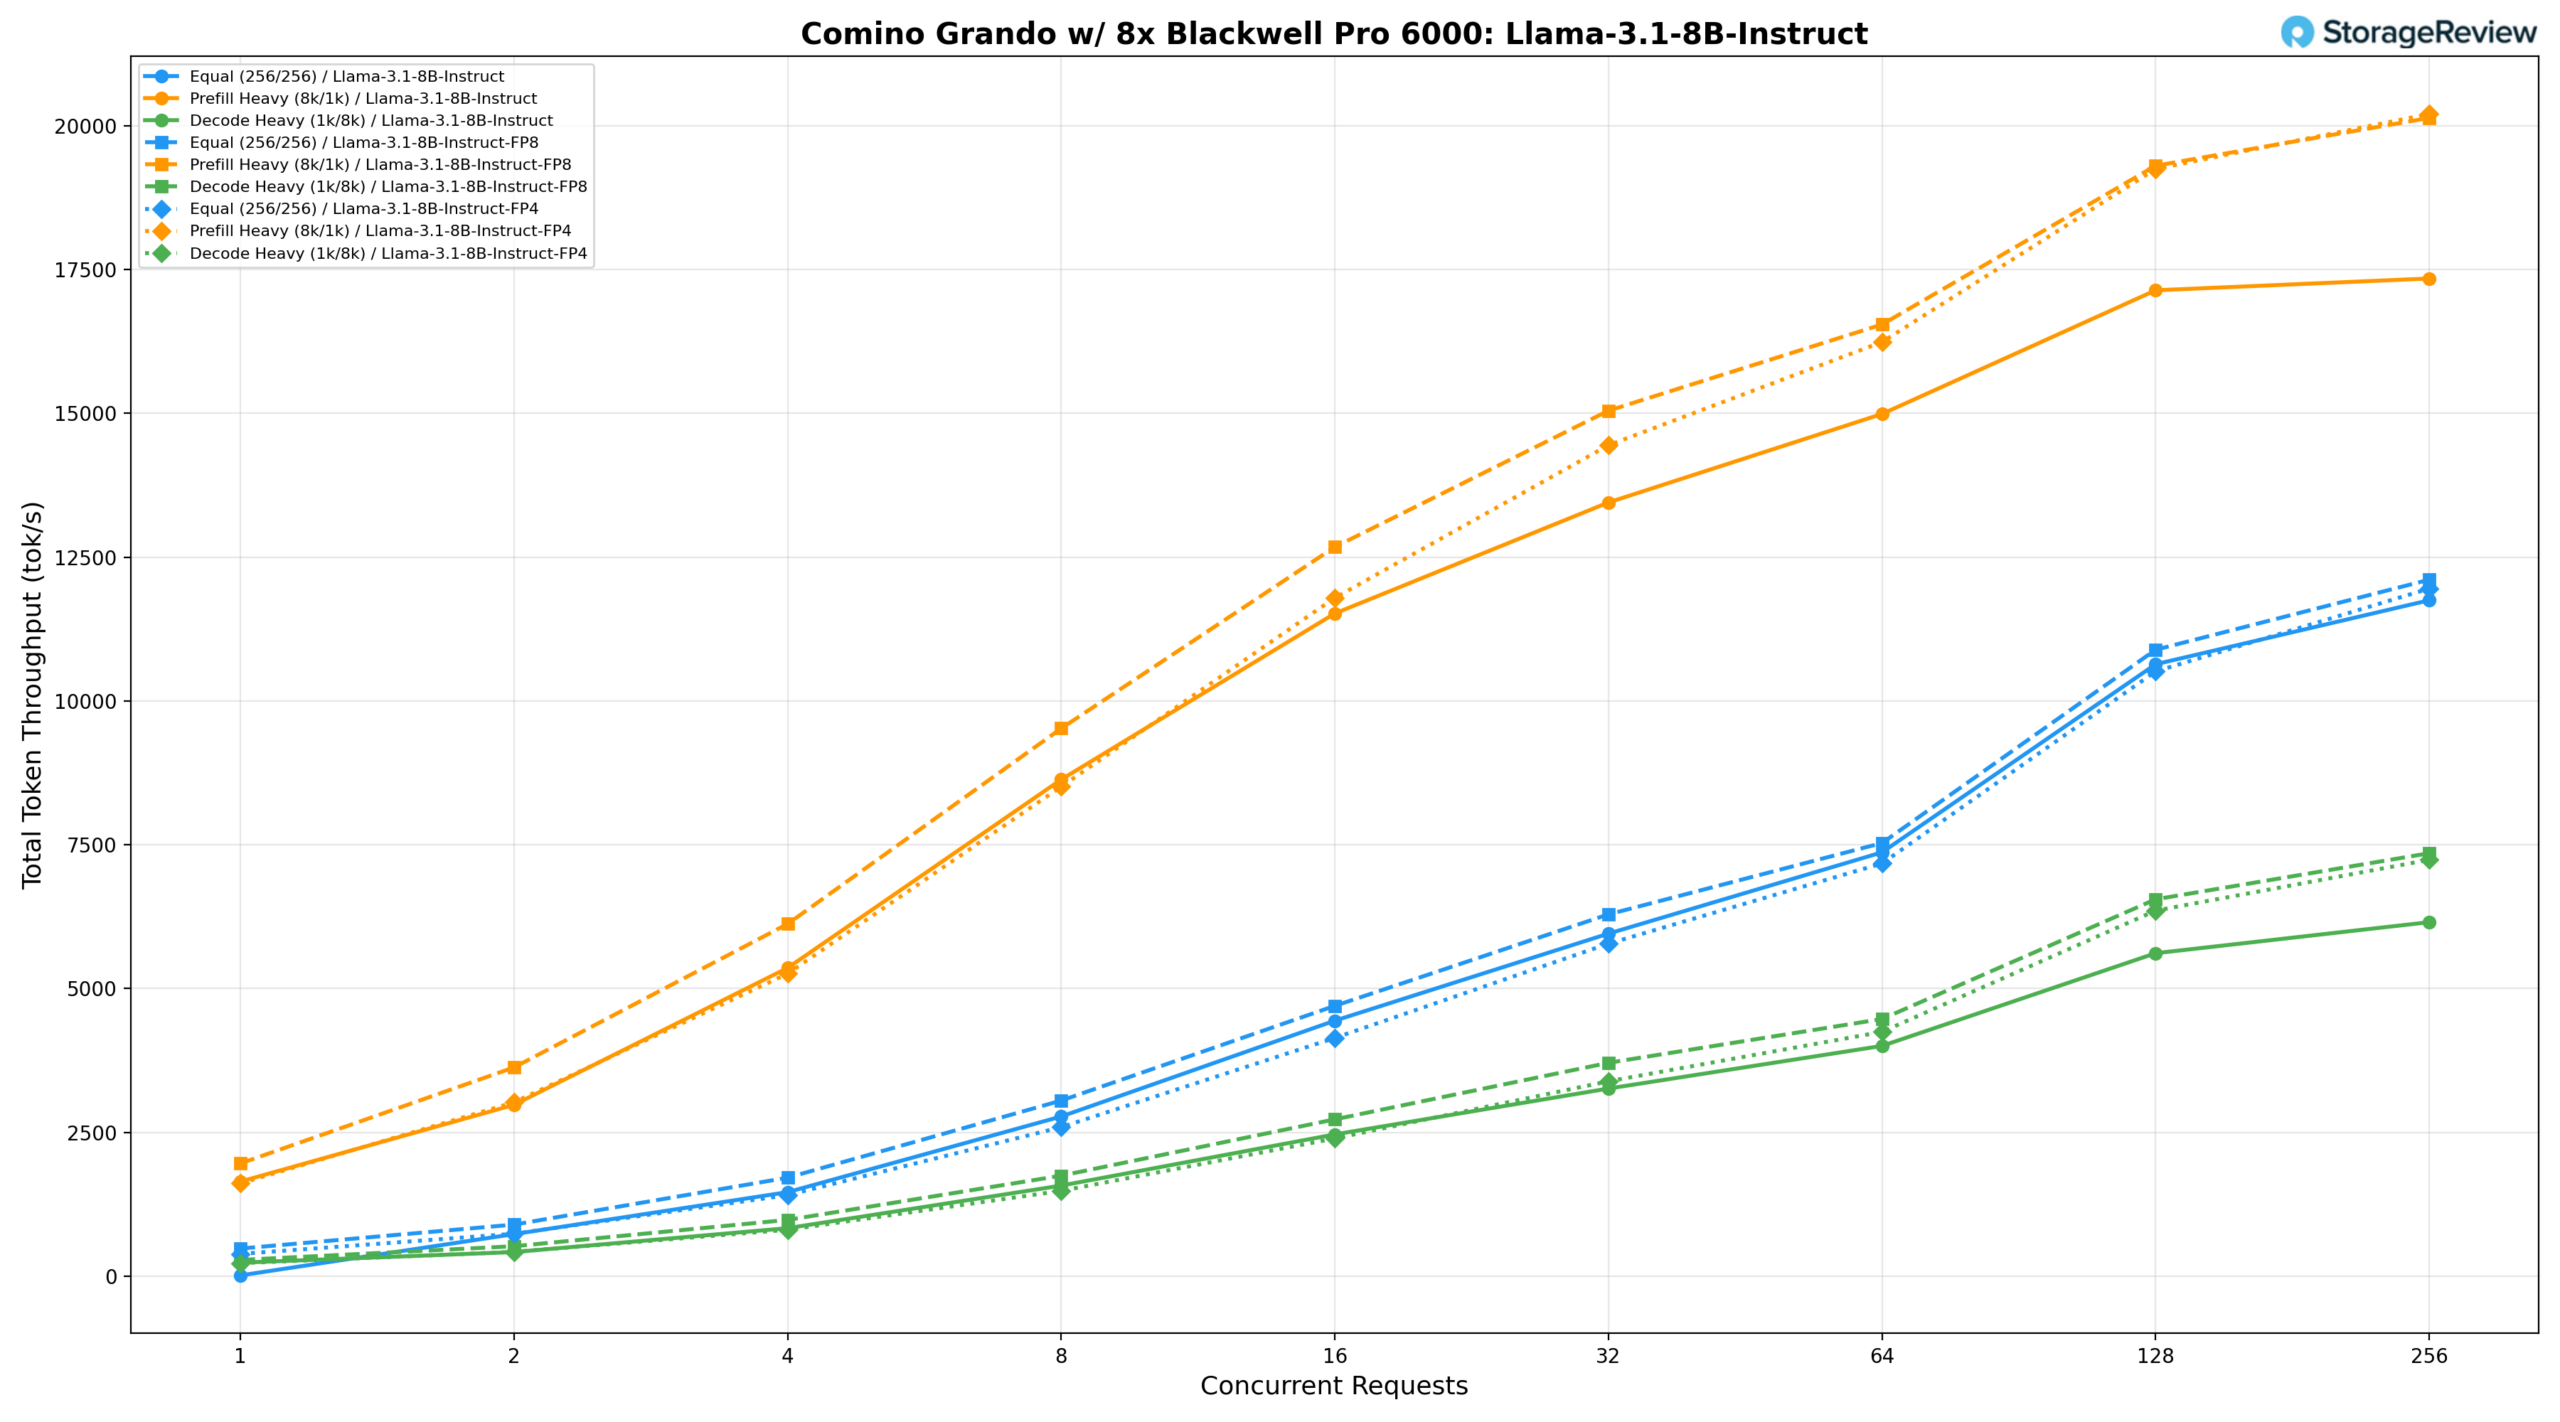
| 駱駝 3.1 8B 指導 | FP8 | 12,109 | 20,137 | 7,353 |
| 駱駝 3.1 8B 指導 | FP4 | 11,954 | 20,206 | 7,239 |
| 駱駝 3.1 8B 指導 | BF16 | 11,752 | 17,346 | 6,155 |
| Qwen3 Coder 30B A3B | FP8 | 10,985 | 16,659 | 4,907 |
| Qwen3 Coder 30B A3B | BF16 | 10,588 | 16,680 | 4,829 |
| 米斯特拉爾小型 3.1 24B | BF16 | 8,925 | 11,846 | 4,975 |
| MiniMax M2.5 (230B) | ep_dp1 | 5,753 | 7,357 * | 2,555 |
| 所有數值均以 tok/s 為單位,峰值吞吐量為 BS=256。 *MiniMax M2.5 預填充量較大的情況在 BS=128 時達到峰值(7,357 tok/s);BS=256 時為 7,141 tok/s。 | ||||
GPT-OSS 120位和20位
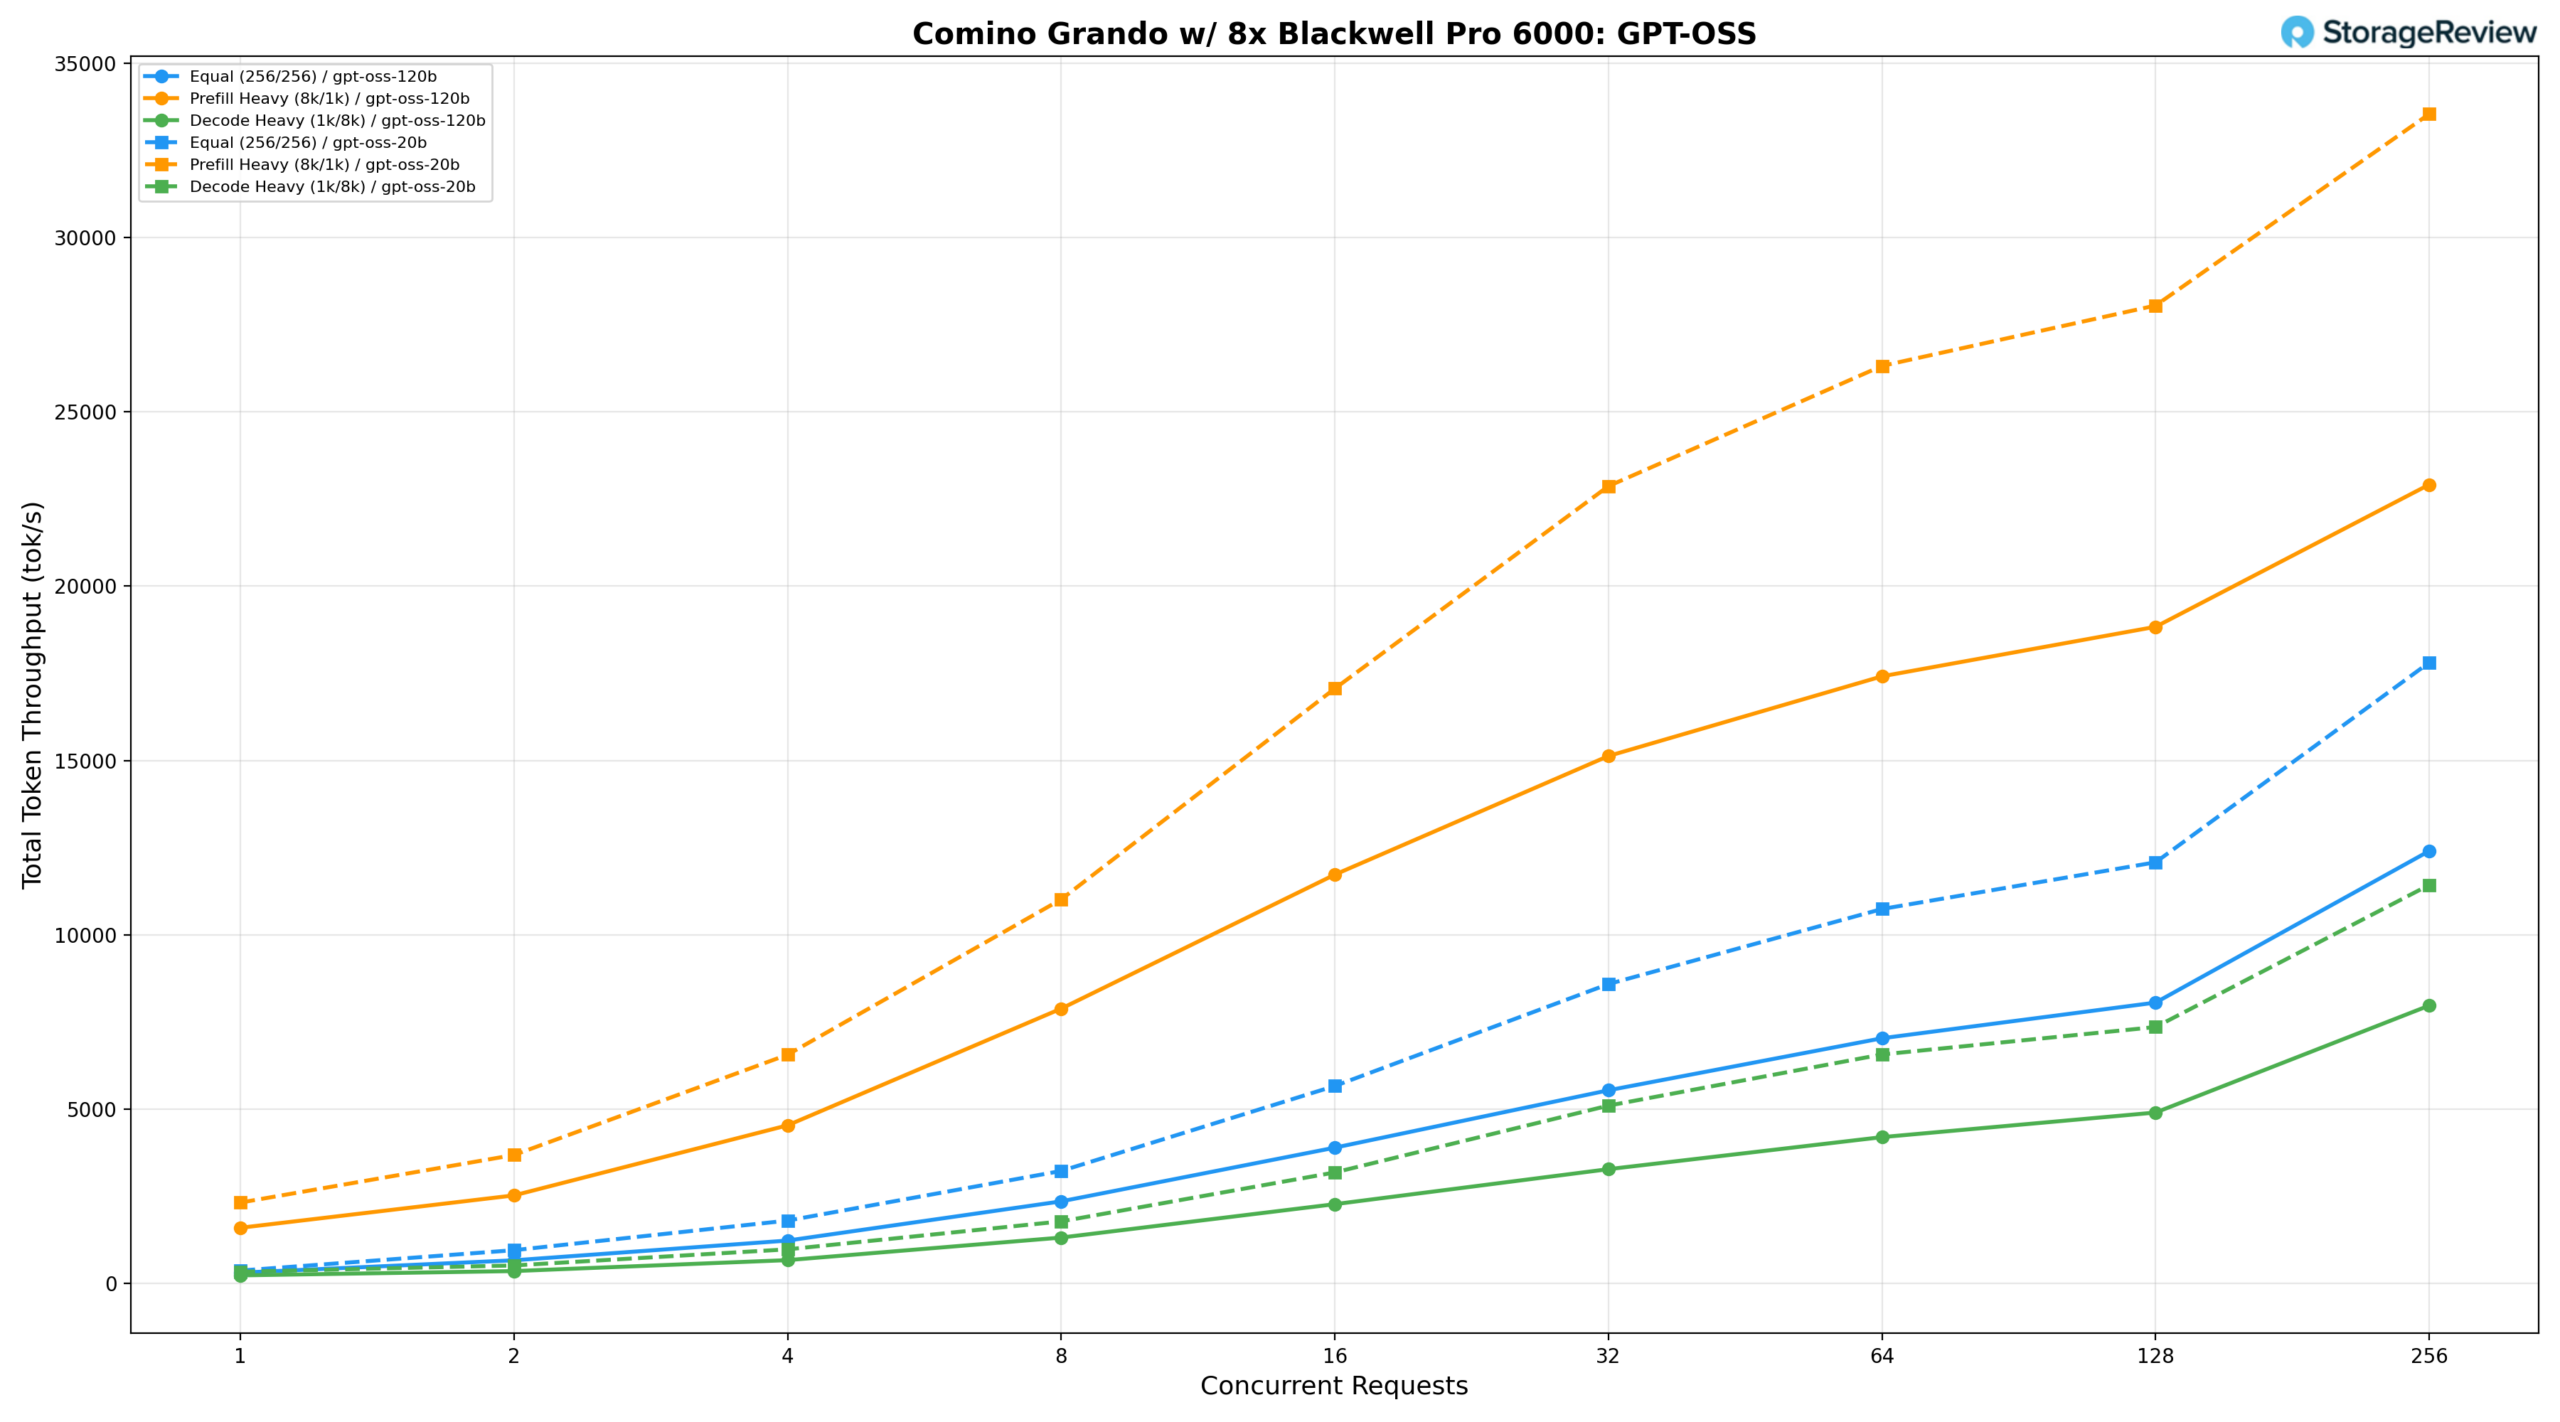
GPT-OSS 模型系列在 Comino Grando 上進行了 120B 和 20B 配置的測試。
GPT-OSS 120B
在相同工作負荷(256/256)下,120B 型號在 BS=1 時輸出速度為 268.85 tok/s,在 BS=64 時達到 6,666.23 tok/s,在 BS=256 時達到峰值 11,726.04 tok/s。預填充較重(8k/1k)時,初始速度為 1,375.69 tok/s,在 BS=64 時攀升至 16,374.19 tok/s,在 BS=128 時攀升至 17,944.55 tok/s,在 BS=21,636.41 時攀升至 256 時達到峰值。解碼密集型(1k/8k)從 BS=1 時的 196.28 tok/s 增長到 BS=256 時的 7,569.97 tok/s,在較低的並發等級下延遲得到了很好的控制。
GPT-OSS 20B
在相同工作負載下,20B 模型在 BS=1 時吞吐量為 334.80 tok/s,在 BS=64 時達到 10,303.56 tok/s,在 BS=256 時達到峰值 17,280.12 tok/s。預填密集型任務的吞吐量從 2,007.90 tok/s 開始,在 BS=64 時攀升至 24,990.46 tok/s,在 BS=128 時攀升至 26,866.25 tok/s,在 BS=256 時攀升至 32,060.72,060.72/k/s,在 BS=256 時達到峰值 32,060.72,060.解碼密集型運算速度從 BS=1 時的 286.08 tok/s 增長到 BS=256 時的 11,187.36 tok/s,在峰值並發時實現了 120B 解碼吞吐量的約 1.5 倍,同時保持了更緊湊的延遲。
Qwen3 Coder 30B A3B 指導與 FP8 指導
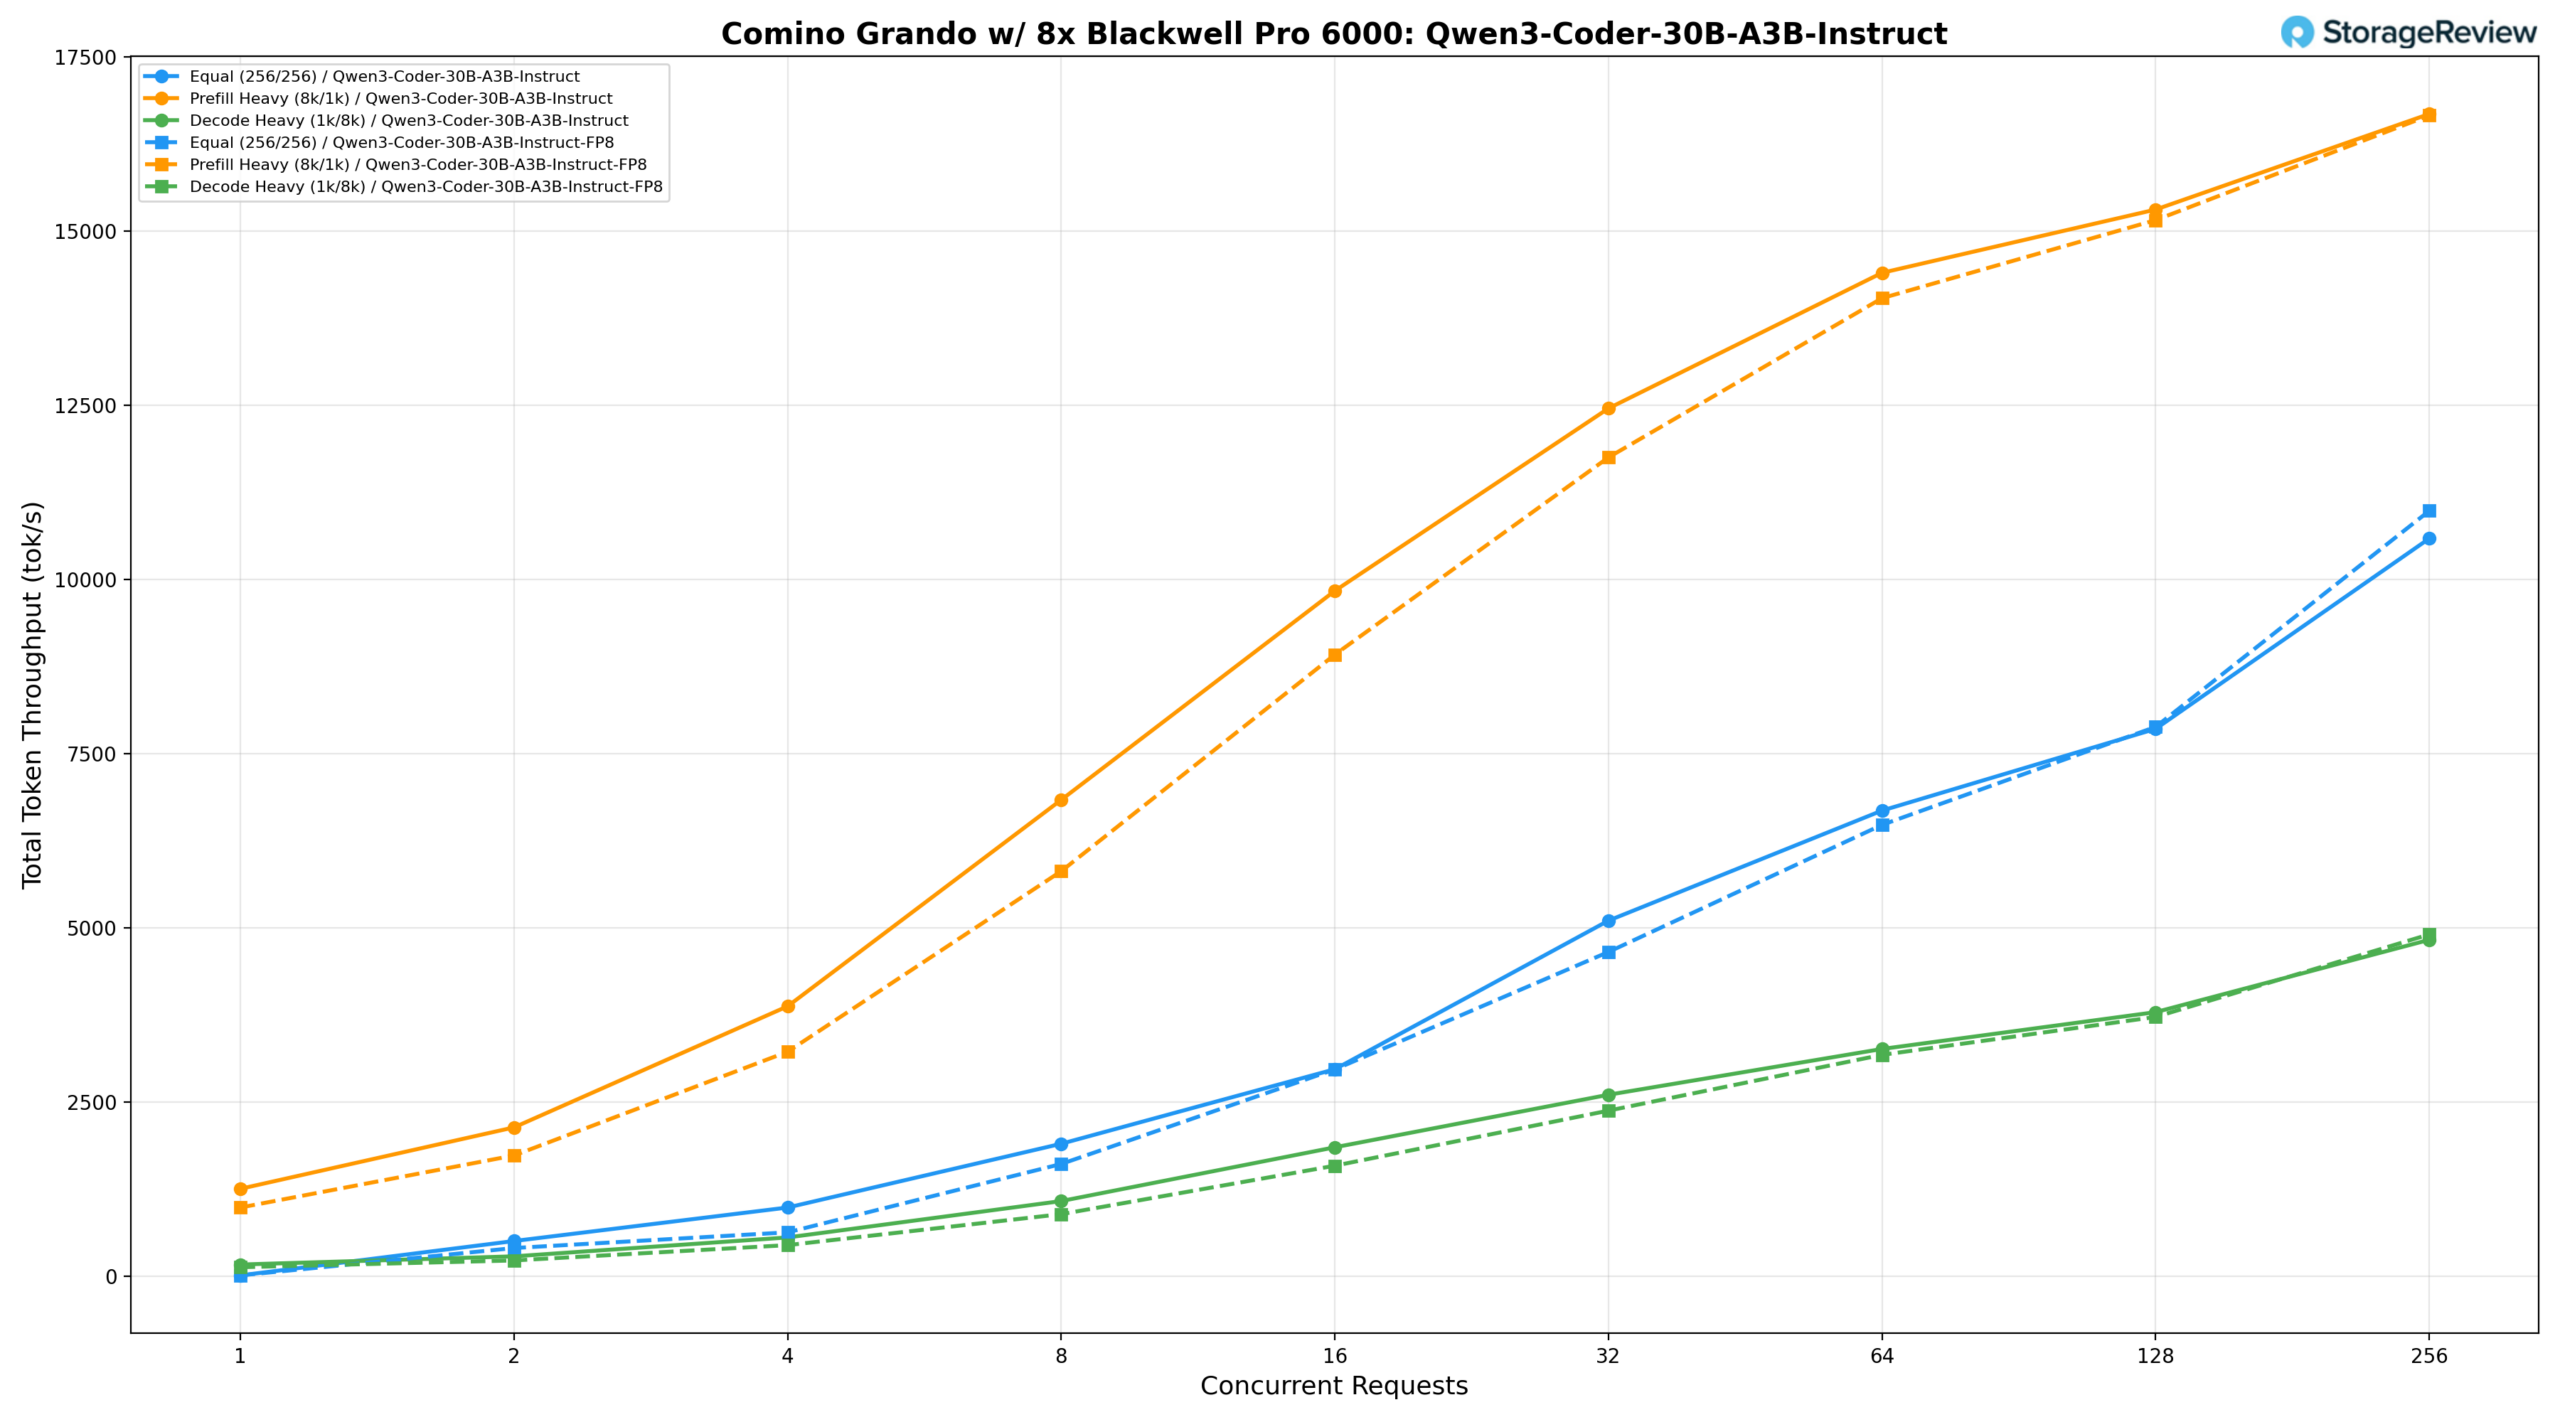
Qwen3-Coder-30B-A3B-Instruct 模型分別使用 BF16 和 FP8 精度進行了測試。
Qwen3-Coder-30B-A3B-Instruct (BF16)
在相同工作負載 (256/256) 下,BF16 模型在 BS=8 時輸出速度為 1,902.32 tok/s,在 BS=64 時達到 6,683.58 tok/s,在 BS=256 時達到峰值 10,587.56 tok/s。預填充較重 (8k/1k) 時,在 BS=1 時輸出速度為 1,256.03 tok/s,在 BS=64 時攀升至 14,400.57 tok/s,在 BS=128 時攀升至 15,308.35 tok/s,在 BS=128 時攀升至 15,308.35 tok/s,在 BS=25 時達到峰值。解碼密集型(1k/8k)從 BS=1 時的 169.19 tok/s 增長到 BS=256 時的 4,828.82 tok/s,在較低的並發級別下延遲得到了很好的控制。
Qwen3-Coder-30B-A3B-Instruct (FP8)
在大多數情況下,FP8 模型的吞吐量與 BF16 相當,在相同工作負載下,BS=64 時吞吐量達到 6,478.54 tok/s,BS=256 時峰值達到 10,984.61 tok/s,在峰值並發量下略優於 BF16。預填密集情境下,吞吐量在 BS=1 時為 987.48 tok/s,在 BS=64 時攀升至 14,036.46 tok/s,在 BS=128 時攀升至 15,156.69 tok/s,在 BS=256 時攀升至 15,156.69 tok/s,在 BS=256 時達到峰值達到 19.199.199.199。解碼密集型演算法的運算速度從 BS=1 時的 130.70 tok/s 增長到 BS=256 時的 4,906.51 tok/s,在峰值並發時略微超過 BF16,而這兩個配置在其餘並發範圍內保持緊密匹配。
Mistral Small 3.1 24B 指令 2503
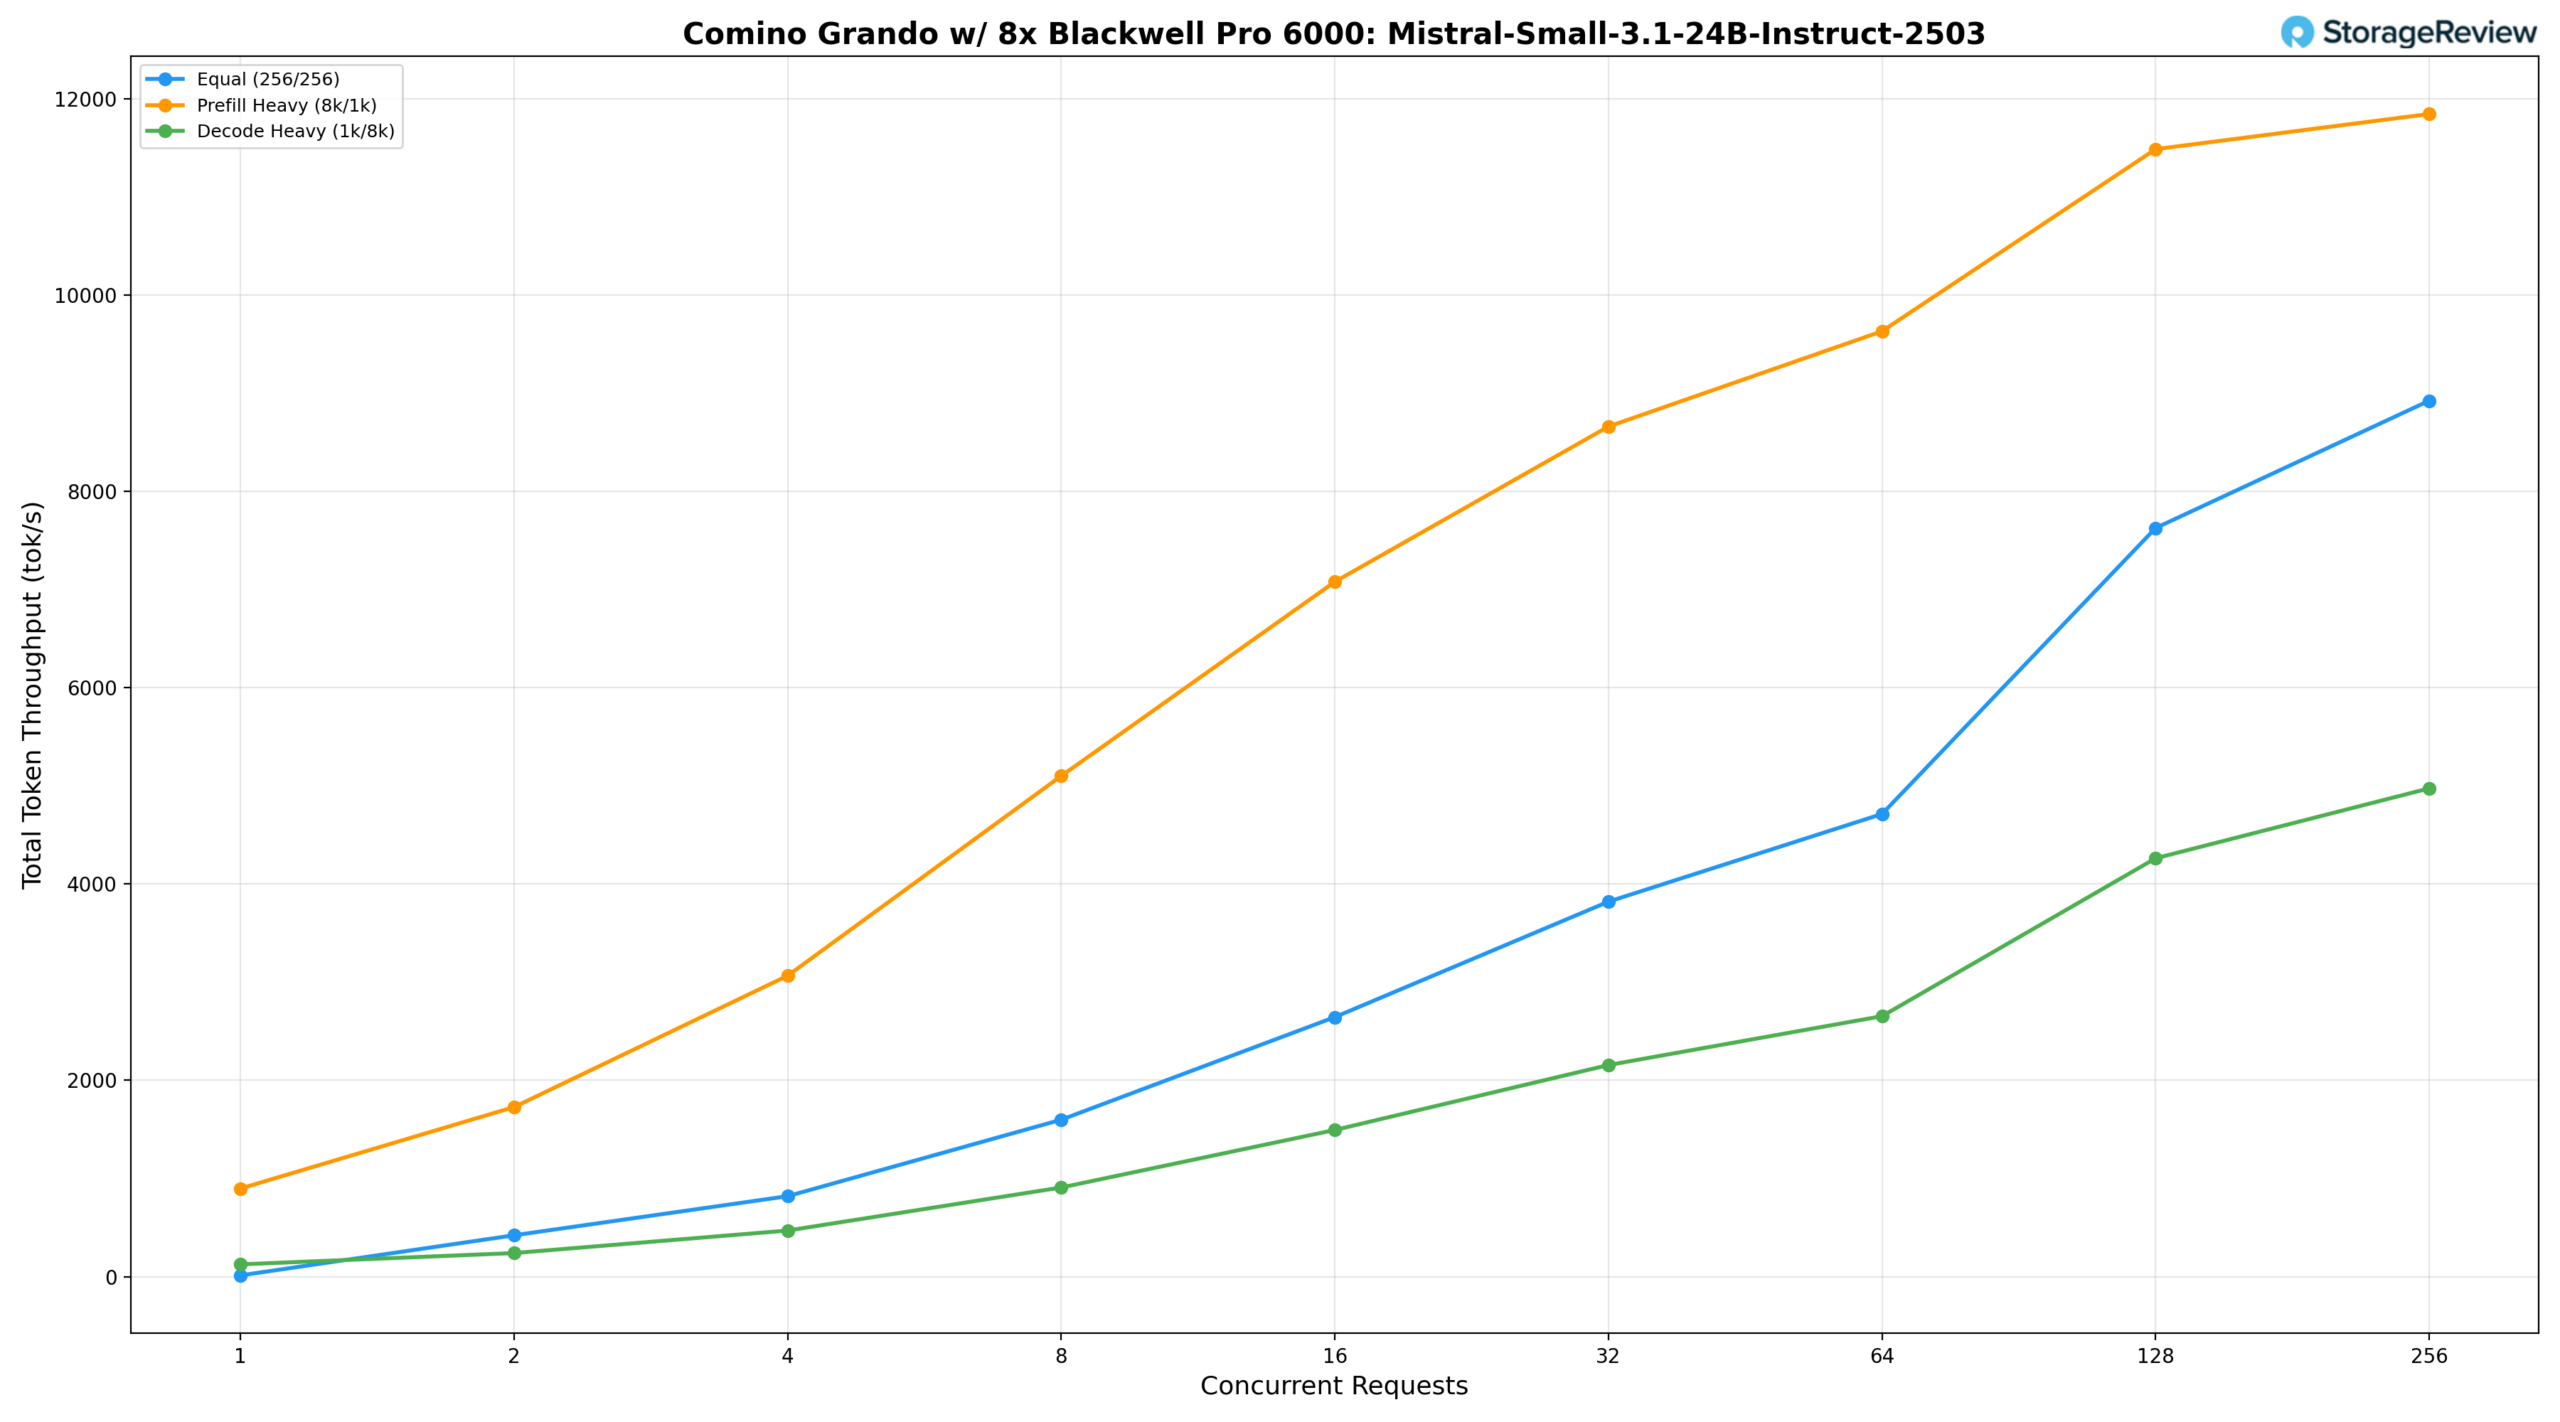
在相同工作負荷 (256/256) 下,模型在 BS=8 時達到 1,598.79 tok/s,在 BS=64 時達到 4,713.84 tok/s,並在 BS=256 時顯著提升至 8,925.12 tok/s。預先填充較多 (8k/1k) 的情況下,此模型在 BS=1 時從 897.84 tok/s 開始,在 BS=64 時攀升至 9,632.58 tok/s,在 BS=128 時達到 11,488.13 tok/s,在 BS=128 時達到 11,488.13 tok/s,並在 BS=156 時達到峰值。解碼密集型(1k/8k)從 BS=1 時的 124.98 tok/s 增長到 BS=64 時的 2,653.82 tok/s,然後在更高的並發水平下明顯加速,在 BS=128 時達到 4,262.53 tok/s,在峰值=256 時達到峰值= 45,062.53 tok5 時達到峰值= 950505,600 tok/s,這反映了該模型在並發規模擴大時保持強大解碼吞吐量的能力。
駱駝 3.1 8B 指導
在 Comino 上對 Llama-3.1-8B-Instruct 模型進行了三種精度配置的測試,從而清晰地展示了量化如何影響此模型大小的吞吐量。
羊駝 3.1 8B 指令 BF16
在相同工作負載 (256/256) 下,BF16 模型在 BS=8 時輸出速度為 2,776.42 tok/s,在 BS=64 時達到 7,369.01 tok/s,在 BS=256 時達到峰值 11,751.56 tok/s,在 BS=256 時達到峰值 11,751.56 tok/s。預填充較重 (8k/1k) 時,在 BS=1 時輸出速度為 1,645.29 tok/s,在 BS=64 時攀升至 14,990.47 tok/s,在 BS=128 時攀升至 17,140.71 tok/s,在 BS=128 時攀升至 17,140.71 tok/s,在 BS=25 時達到峰值。解碼密集(1k/8k)從 BS=1 時的 234.78 tok/s 成長到 BS=256 時的 6,154.73 tok/s。
Llama 3.1 8B 指令 FP8
FP8 量化在所有場景下均實現了顯著的效能提升。在相同工作負載下,BS=64 時效能達到 7,530.39 tok/s,在 BS=256 時達到 12,108.98 tok/s。預填充密集型場景下,BS=64 時效能提升至 16,546.53 tok/s,BS=128 時效能提升至 19,306.49 tok/s,在 BS=256 時達到峰值 20,137.35 tok/s,相較於 BF16 在並發時達到峰值 20,137.35 tok/s,相比 BF16 在並發時達到峰值 20,137.35 tok/s,相比 BF16 在並發時達到峰值 20,137.35 tok/s,相比 BF16 在並發時達到峰值並發的效能提升約 16%。解碼密集型場景下,BS=256 時效能峰值達到 7,353.40 tok/s,比 BF16 的效能提升約 19%。
Llama 3.1 8B 指令 FP4
在高併發水準下,FP4 的吞吐量與 FP8 非常接近,但在低批次大小下略遜一籌。在批次大小為 256 時,相同工作負載下的吞吐量峰值達到 11,954.40 tok/s;預填充密集型工作負載下的吞吐量峰值同樣為 20,205.57 tok/s,在峰值並發水平下略微領先於 FP8。解碼密集型工作負載下的吞吐量峰值為 7,239.29 tok/s,始終與 FP8 保持幾個百分點的差距。因此,當記憶體效率至關重要且吞吐量損失不大時,FP4 是一個極具吸引力的選擇。
MiniMax M2.5
在 Comino Grando 上測試的 MiniMax-M2.5 230B 是我們使用過的最大、要求最高的型號。
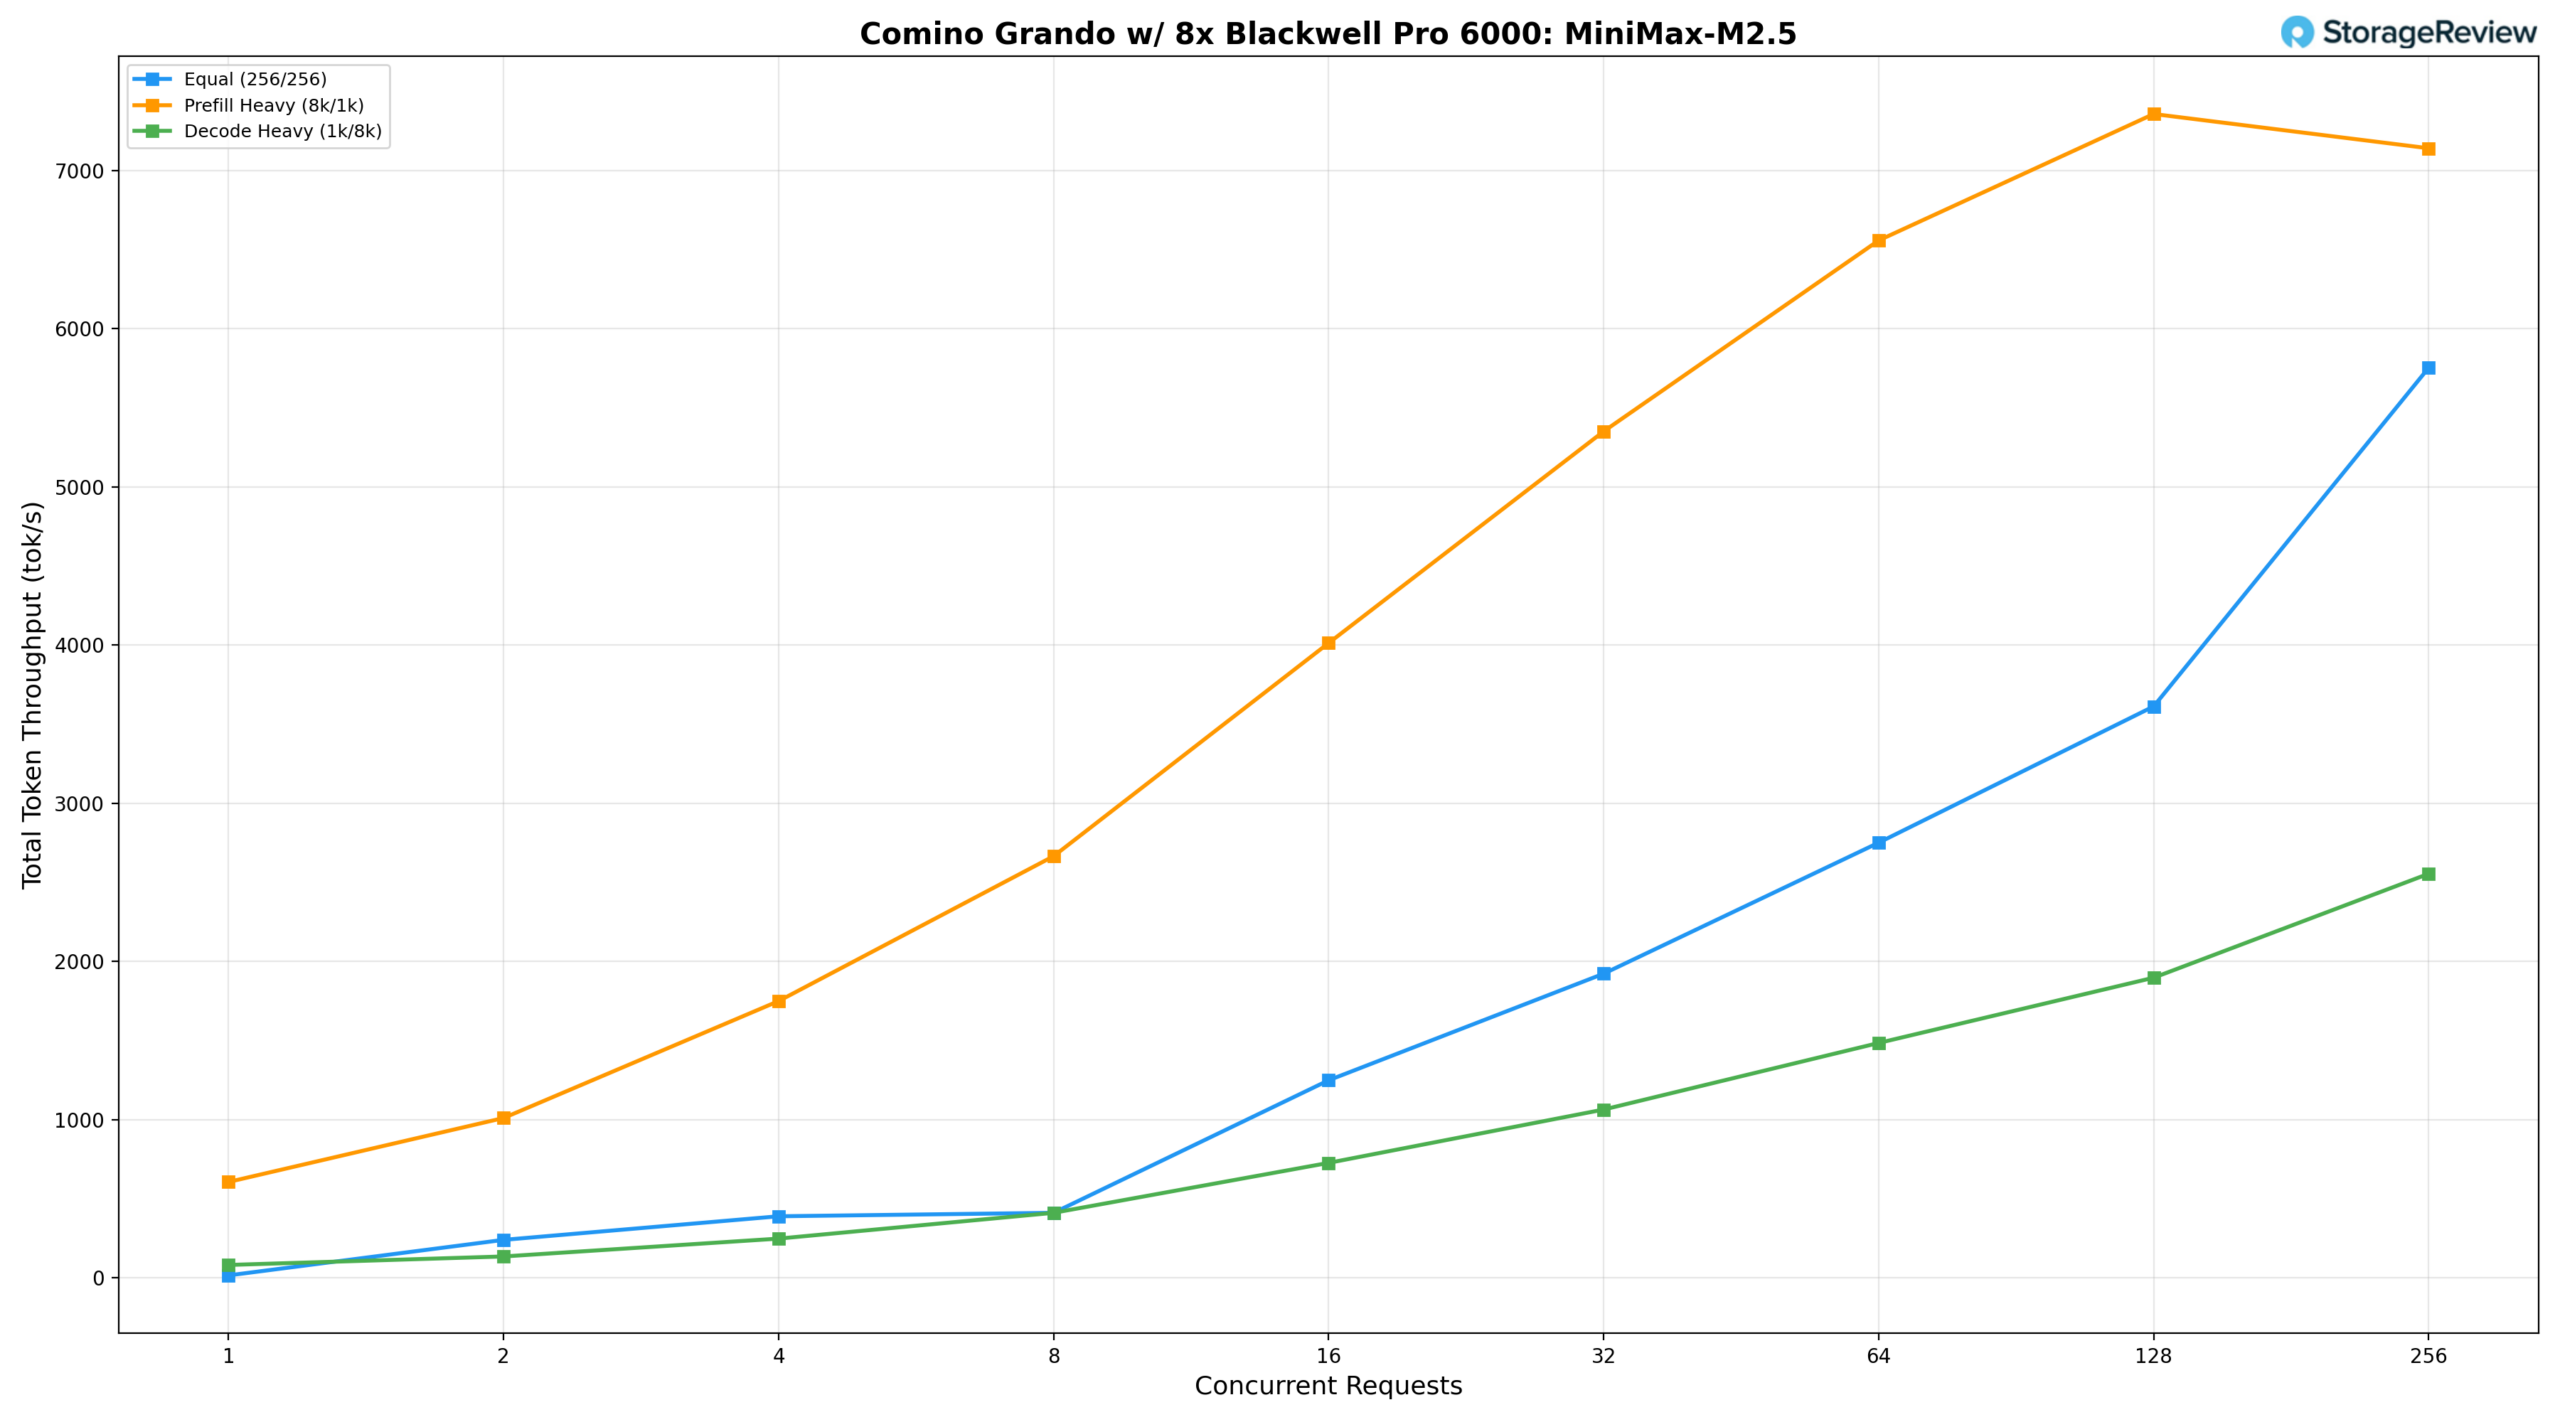
在相同工作負載 (256/256) 下,該模型在 BS=1 時初始吞吐量為 16.35 tok/s,在 BS=64 時達到 2,751.25 tok/s,並在更高的並發度下顯著提升,在 BS=256 時達到峰值 5,753.預填充密集型任務 (8k/1k) 在 BS=1 時初始吞吐量為 606.97 tok/s,穩步攀升至 BS=32 時的 5,351.02 tok/s 和 BS=64 時的 6,557.92 tok/s,在 BS=1285 時達到峰值 25.時的 7,140.74 tok/s,顯示模型在 BS=128 以上時預填充吞吐量接近飽和。解碼密集型(1k/8k)的速率從 BS=1 時的 82.21 tok/s 持續增長到 BS=64 時的 1,485.28 tok/s,在 BS=256 時達到峰值 2,554.87 tok/s,反映了 230B MoE 架構下的預期工作帶負載。
結語
Comino Grando 的最佳理解是,它是一個專為充分發揮八顆 NVIDIA RTX PRO 6000 GPU 全部潛能而打造的系統。從反向主機板佈局到散熱迴路和整合監控系統,每項重要的設計決策都旨在確保這些 GPU 能夠在 600W TDP 的滿載下持續運行,而不會受到散熱或功耗的限制。
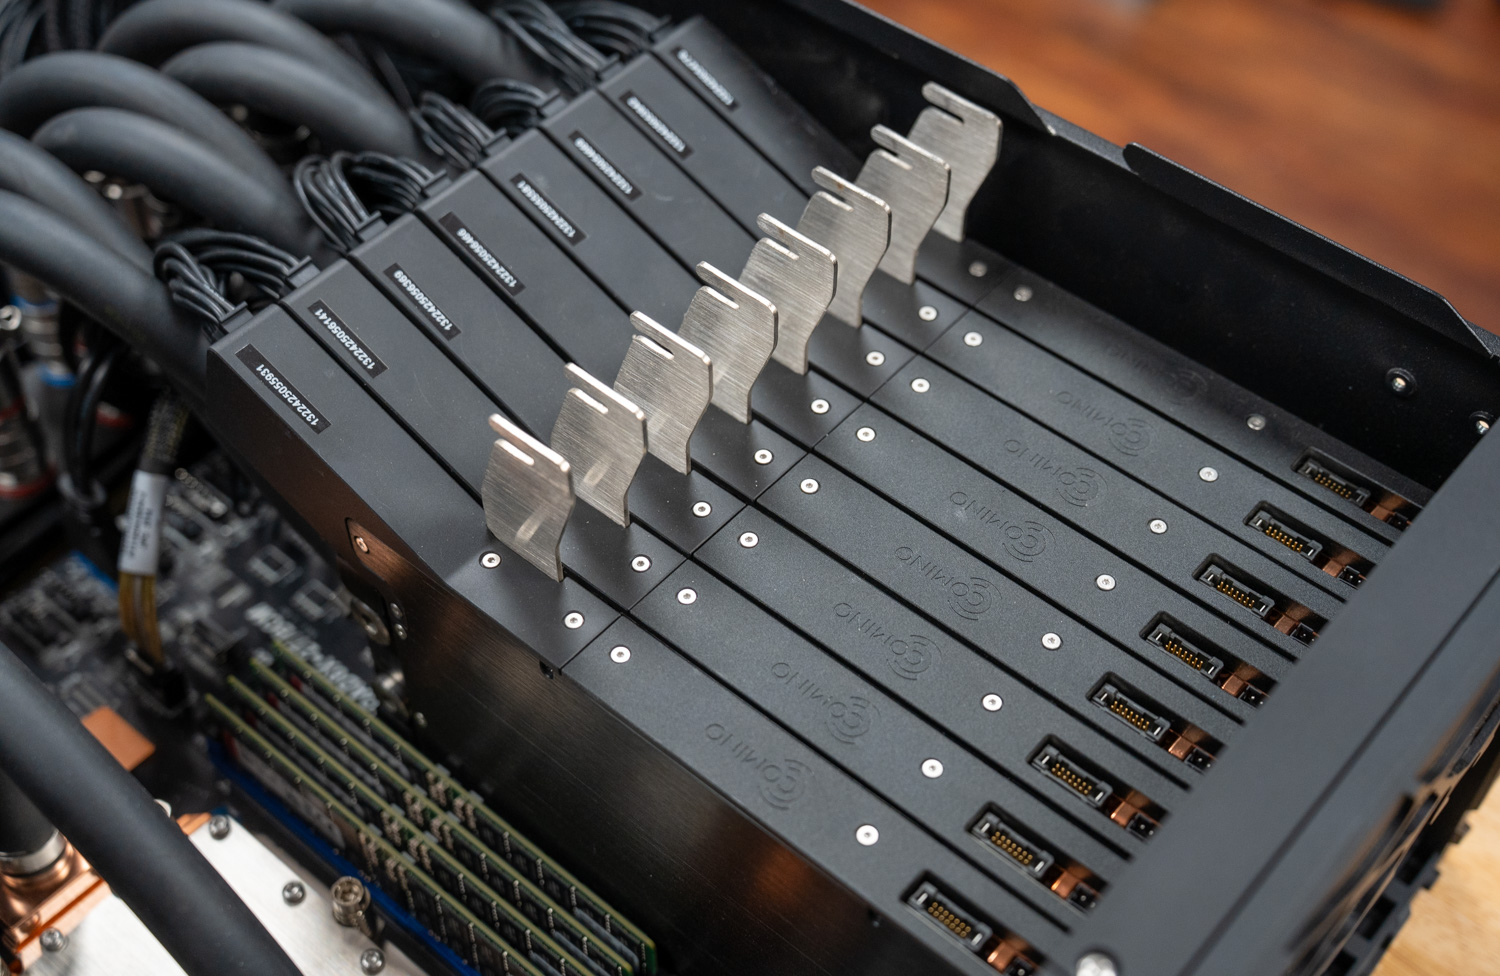
Grando 的魅力不在於任何單一功能,而是整個系統的協調統一。液冷並非後製加裝,而是架構的一部分。供電設計冗餘、支援熱插拔,並能輕鬆應付八張 600W 顯示卡 4,800W 的負載,仍有餘裕。監控系統不僅能報告溫度,還能在故障時自動保護硬體。這裡的一切都體現了精益求精的態度,而非事後補救。
性能數據進一步印證了這一點。從 Llama 3.1 8B 到 230B MiniMax M2.5,Grando 在各種車型上都展現了優異的吞吐量,對於自架平台而言實屬難得。 Claude Code 的同時測試更凸顯了其實際價值:八位工程師可以同時對本地託管的 230B 模型進行互動式編碼,在峰值聚合輸出下,每位用戶的吞吐量超過 38 tok/s。四到八人的團隊可以以接近最佳的吞吐量運行,且效能幾乎沒有下降。
這種配置的價值遠不止於人工智慧推理。憑藉每塊GPU 96GB的顯存和強大的多GPU擴展能力,該平台同樣適用於高階創意和工程工作負載,包括視覺特效渲染、大規模模擬和複雜的CAD流程。系統可擴展至四GPU和雙GPU配置,讓小型工作室和團隊也能獲得工作站等級的效能。
Grando 與我們評測的企業級八 GPU 平台最大的差別在於部署的實用性。那些系統提供更大的 PCIe 通道空間、更多的網路卡插槽和更強大的儲存連接,但它們也需要專用的資料中心基礎設施,功耗超過 8kW,而且交貨週期可能超過一年。 Grando 犧牲了一些週邊擴展性,換取了運行噪音低到可以與用戶共用一個房間、散熱量更少且現已上市的系統。對於那些優先考慮快速部署和易於管理的運作環境而非最大網路連接性的組織而言,這種權衡是有利的。
產品頁面 – Comino Grando
Comino 設定器 – 頁面
排行榜: Comino Grando RTX PRO 6000 在我們的「最佳本地 AI 桌上型電腦」排行榜上佔據了「極致之選」的位置。


 Amazon