

GeForce RTX 50 系列標誌著筆記型電腦 GPU 向前邁出了一大步,這要歸功於 NVIDIA 的全新 Blackwell 架構,它可增強 AI 處理、光線追蹤和電源效率。在這篇評測中,我們將重點放在 Razer Blade 5090 內的 GeForce RTX 16 行動 GPU,這是一款強大的 GPU,旨在以便攜形式提供一流的效能。雖然它的目標並不是與高階桌上型電腦相媲美,但其令人印象深刻的規格使其成為需要強大動力的專業人士和遊戲玩家的強大選擇。
GeForce RTX 50 系列引入了原生 FP4 支援、更先進的 Tensor Core 和改進的光線追蹤功能,同時提供了比前幾代更好的電池效率。透過 DLSS 4 實現 AI 驅動的渲染和幀生成,它已準備好為移動 GPU 的可能性設立新的基準。
GeForce RTX 5090 行動版與 5090 桌上型電腦:有何不同?
GeForce RTX 5090 行動版和桌面版雖然都採用了 Blackwell 2.0 架構和 5nm 過程,但它們的用途卻截然不同。不出所料,桌面版的尺寸要大得多,電晶體數量幾乎是行動版的兩倍(92.2 億 vs. 45.6 億),TDP 也高得多(575W vs. 150W)。這使得桌面版擁有更高的基礎頻率和加速頻率。
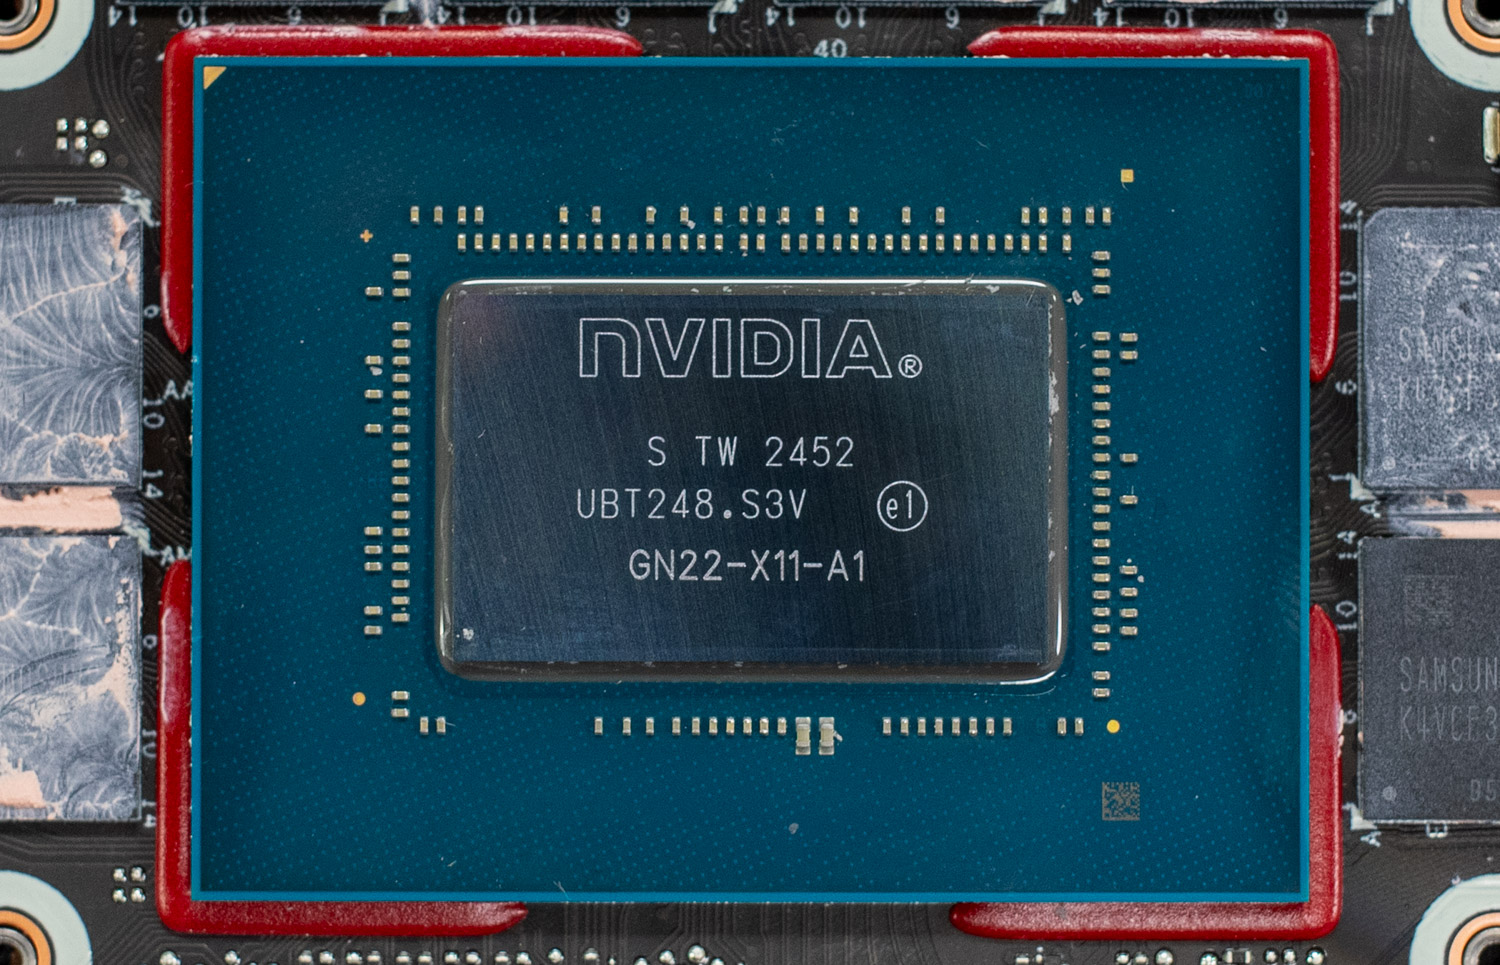
雖然行動版註重效率和便攜性,但桌面版提供了更強大的原始效能,其 CUDA 核心、記憶體頻寬和整體運算效能幾乎是行動版的兩倍,但代價是功耗更高、尺寸更大。最終,桌上版 GeForce RTX 5090 是一款性能野獸,而行動版則在功率和移動性之間取得了平衡。
平台概述:Razer Blade 16
雖然這裡的重點是 GeForce RTX 5090 行動 GPU,但值得討論一下它所運行的機器——Razer Blade 16。總的來說,這是一個令人印象深刻的平台,可以展示 5090 的功能,其高端規格讓 GPU 可以發揮其作用。
Razer Blade 16 是一款專為高效能運算而打造的高階工作站級筆記型電腦。它搭載 AMD Ryzen AI 9 HX 370,這是一款 12 核心(24 線程)處理器,最大加速時脈頻率為 5.18GHz,配備 32GB DDR5 內存,運行速度為 8000MT/s。
Razer Blade 16 規格
| 規格 | 信息 |
| 操作系統 | Windows 11專業版 |
| 處理器 | AMD Ryzen™ AI 9 HX 370(12 核心/24 線程,3.3 GHz 基本/5.1 GHz 最大加速) |
| 圖像 | NVIDIA GeForce RTX 5090(24 GB GDDR7 VRAM) |
| 顯示螢幕 | 16 吋 QHD+ OLED(2560 x 1600)240 Hz |
| 儲存 | 2 TB SSD(M.2 PCIe Gen 4 NVMe x4、x2) |
| 記憶體應用 | 32 GB LPDDR5X 8000 MHz(焊接) |
| 鍵盤 | 每鍵 RGB (Razer Chroma™) N 鍵翻轉 |
| 連線能力 | Wi-Fi 7、藍牙 5.4、三頻 2×2 WLAN |
| 連接埠數量 | 3 個 USB 3.2 Gen 2 型 A、2 個 USB4 型 C(PD 和 DisplayPort 1.4)、MicroSD(UHS-II)、HDMI 2.1 |
| 音訊 | 6 個立體聲揚聲器、THX 空間音訊、7.1 編解碼器(透過 HDMI)、雙陣列麥克風 |
| 電池 | 90 WHr 鋰離子電池(50 分鐘內充滿 30%,80 分鐘內充滿 48%),280 W 電源適配器 |
| 建造與完成 | CNC 銑削鋁,陽極氧化黑色,防指紋塗層 |
| 尺寸 | 14.9 毫米 ~ 17.4 毫米 x 250.5 毫米 x 355 毫米(0.59 英寸 ~ 0.69 英寸 x 9.86 英寸 x 13.98 英寸) |
| 重量 | 2.14公斤/ 4.71的磅 |
| 安全性 | Windows Hello IR FHD 網路攝影機、TPM 2.0、Kensington 安全插槽 |
| 保固 | 1 年筆記型電腦、2 年電池保固 |
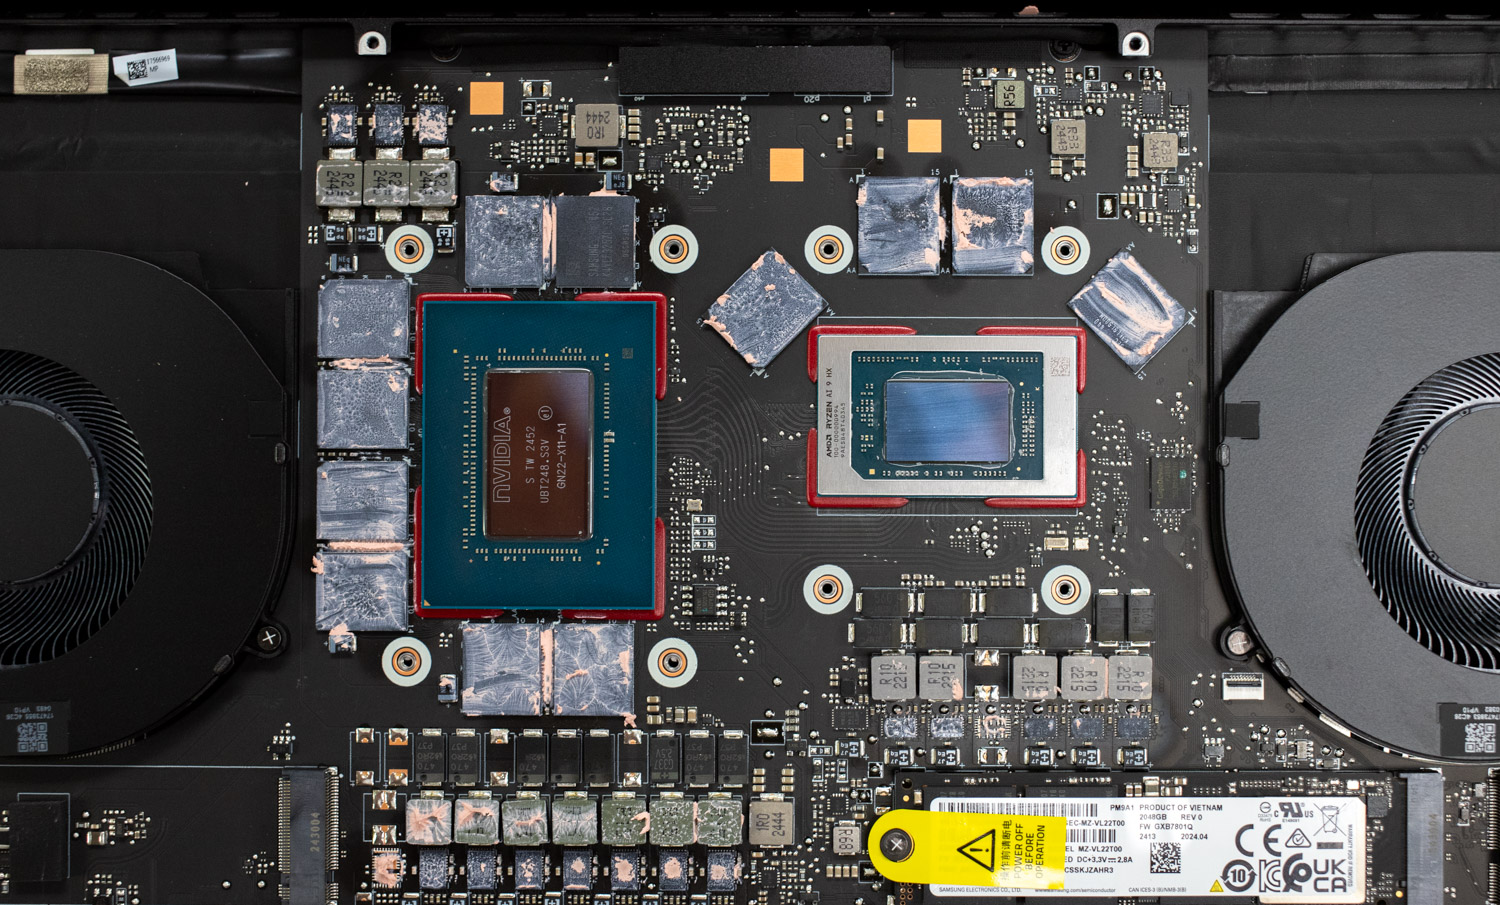
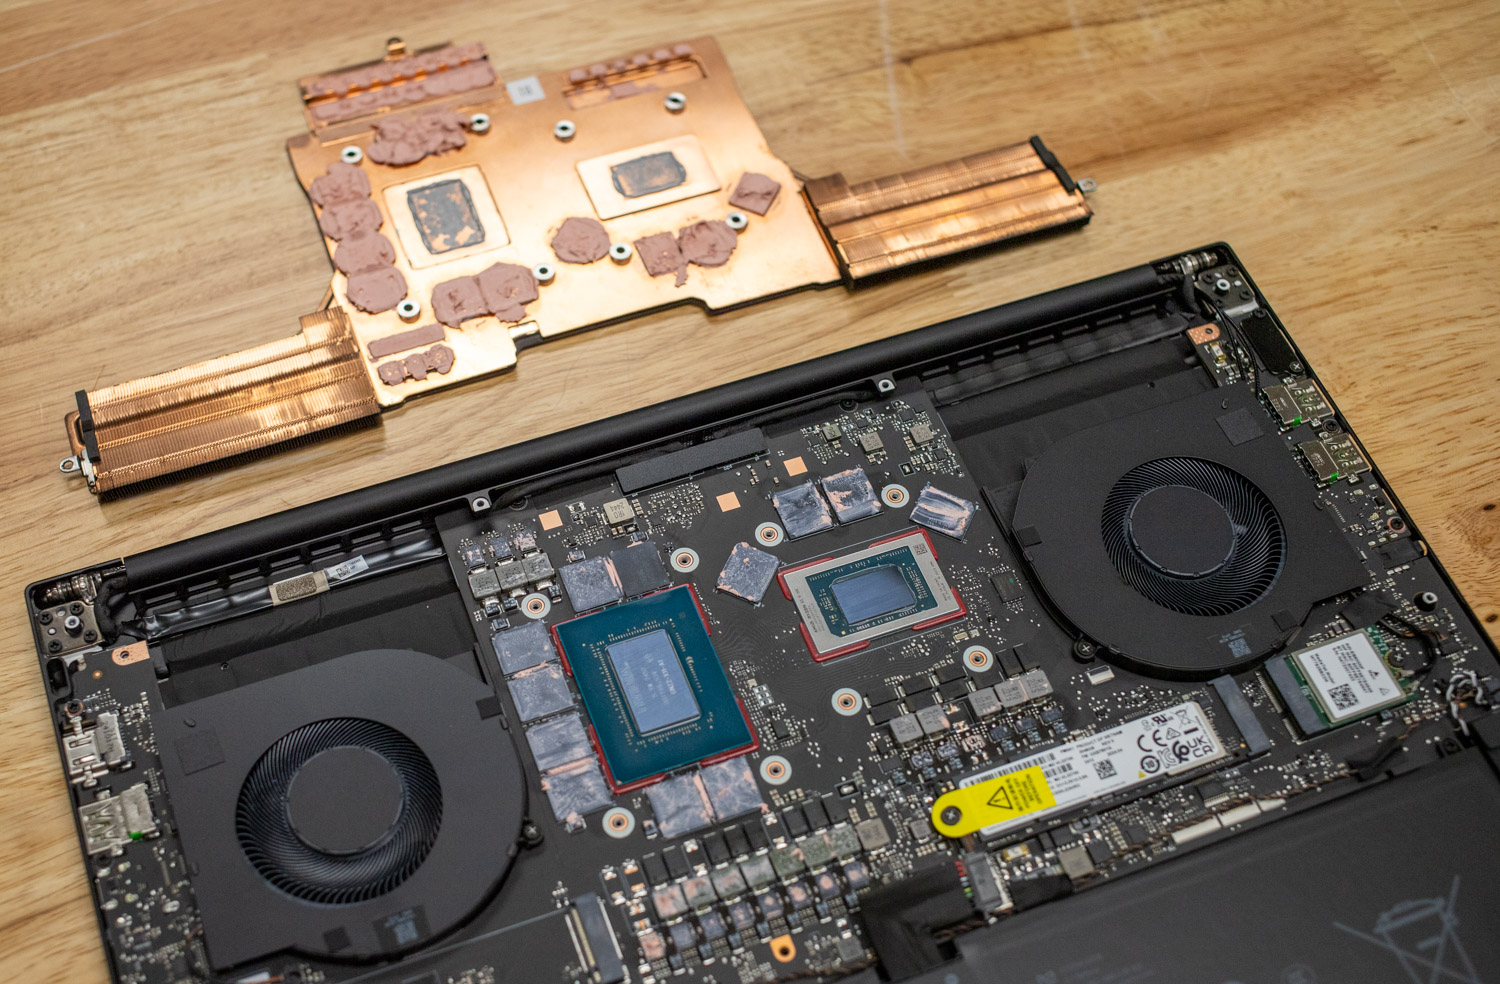
NVIDIA GeForce RTX 5090 Mobile 配備 24GB GDDR7 記憶體。在巨大的散熱器組件下,我們可以看到 3GB 三星模組焊接在 GPU 的周邊。
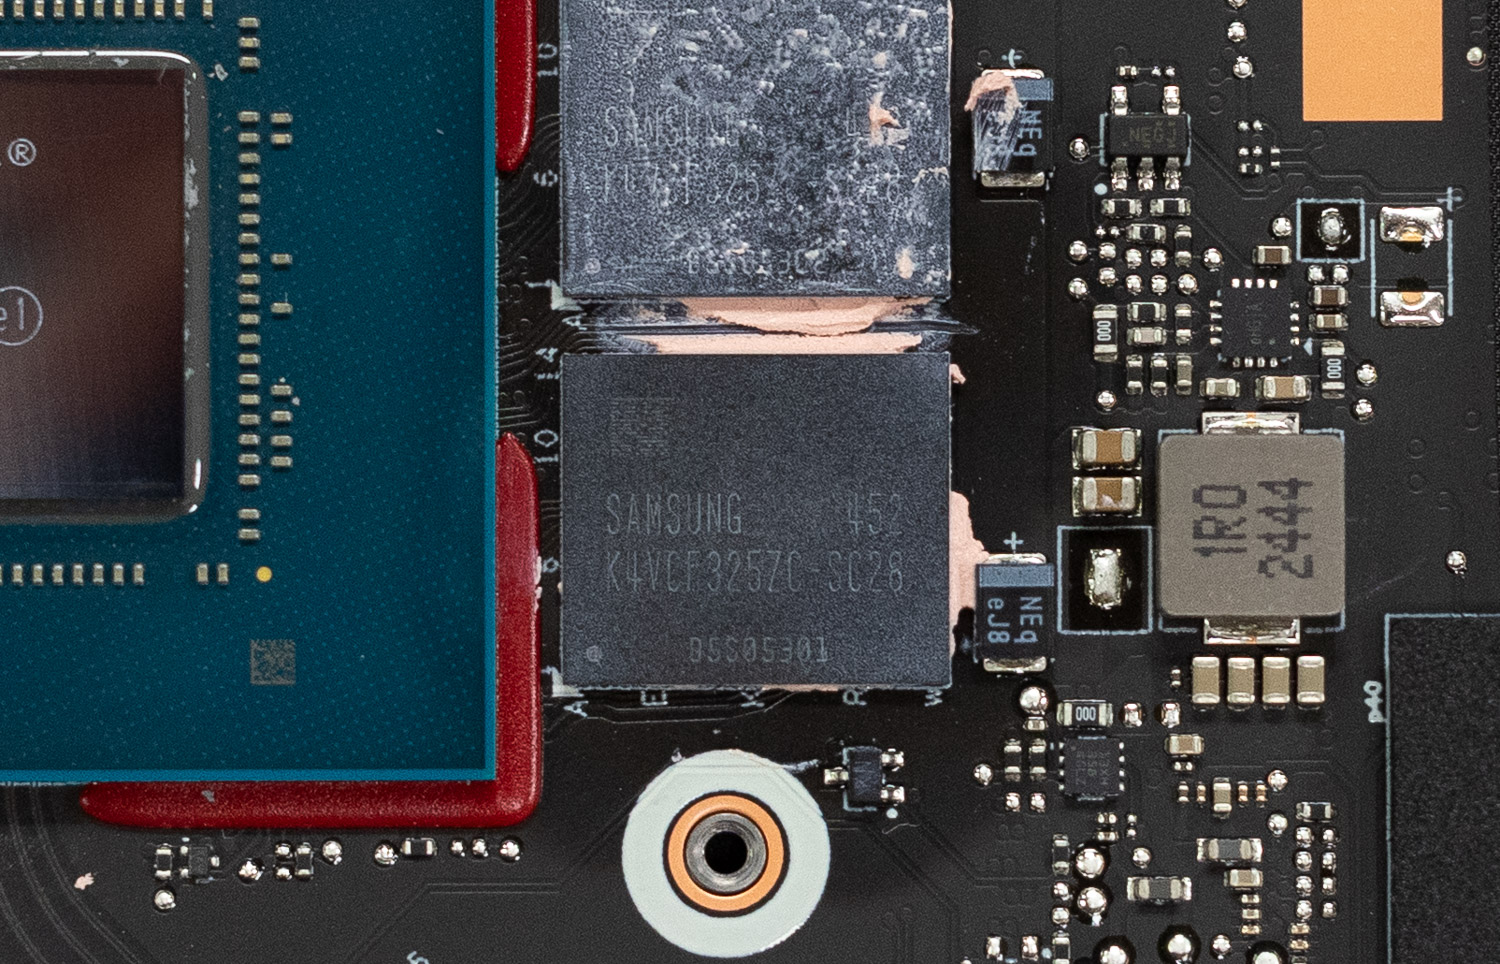
為了支援這種程度的效能,該系統配備了強大的工作站級 280W 電源,這對於提供 GPU 在插入電源時充分發揮其潛力所需的持續電力至關重要。 GeForce RTX 5090 行動 GPU 的最大 TGP 為 150W,而在 Razer Blade 16 中,在效能模式下運作時配置為 135W。
Blackwell 架構:更多核心,更強大的 AI 能力
Blackwell 架構是 GeForce RTX 50 行動 GPU 系列的核心,與上一代 Ada Lovelace 相比,它引入了幾項重要的升級。 GeForce RTX 5090 Mobile 具有 10,496 個 CUDA 核心和第五代 Tensor 核心,可大幅提升 AI 處理能力。 FP5 精度現已得到原生支持,透過減少記憶體負載和運算要求,GPU 能夠更有效地處理 AI 模型。
DLSS 4 和多幀生成:更多幀速率
在全新 Transformer 模型的支援下,DLSS 4 引入了多幀生成功能,可為每個傳統渲染的幀產生最多三個額外幀。這會在保持高影像品質的同時顯著提高幀速率。 Transformer 模型建立在 DLSS 早期版本中使用的捲積神經網路 (CNN) 之上,但它更進一步,可以分析整個幀及其隨時間的變化。這會產生更清晰的細節、更少的重影和更平滑的邊緣,在快速移動的場景中尤其明顯。
在《心靈殺手2》和《Cyberpunk2077:幻影自由》等遊戲中,NVIDIA 聲稱 DLSS 4 可以將幀率提升至原生渲染的 8 倍。當與 DLAA(深度學習抗鋸齒)和 DLSS 光線重建技術結合使用時,玩家可以在遊戲過程中獲得更高的幀率和更流暢、更穩定的視覺效果。變形模型還能提升紋理質量,使頭髮、鏈條和反射等細節看起來更自然一致,即使在快速移動的場景中也是如此。
進階射線追蹤與巨型幾何
新的第四代光線追蹤核心專為處理 NVIDIA 所謂的「超級幾何」而構建,本質上是現代遊戲環境中看到的更高三角形數量和複雜性。 GeForce RTX 4 系列可以處理比前幾代更多的體素,從而產生更詳細的角色模型、逼真的燈光和更豐富的環境細節。
RTX 神經光輝快取利用人工智慧技術更精確地估算間接光照,從而減少需要追蹤的光線數量,同時提升效能和視覺一致性。這項技術能夠實現更複雜的路徑追蹤方案,並維持高幀率。由於這些人工智慧驅動的優化,《心靈殺手2》和《傳送門RTX》等遊戲在光線追蹤場景中獲得了更高的穩定性和更少的重影。
效率與電源管理:電池效能更佳
隨著全新 GeForce RTX 50 行動系列的亮相,NVIDIA 做出了巨大努力,將高效能與更好的能源效率相結合。新的進階電源門控和加速頻率切換系統使 GPU 能夠轉換到低功耗狀態並立即適應不斷變化的工作負載。時鐘現在可以比前幾代調整快 1000 倍,這意味著在繁重任務期間具有更好的響應能力,並且在系統沒有負載時可以延長電池壽命。
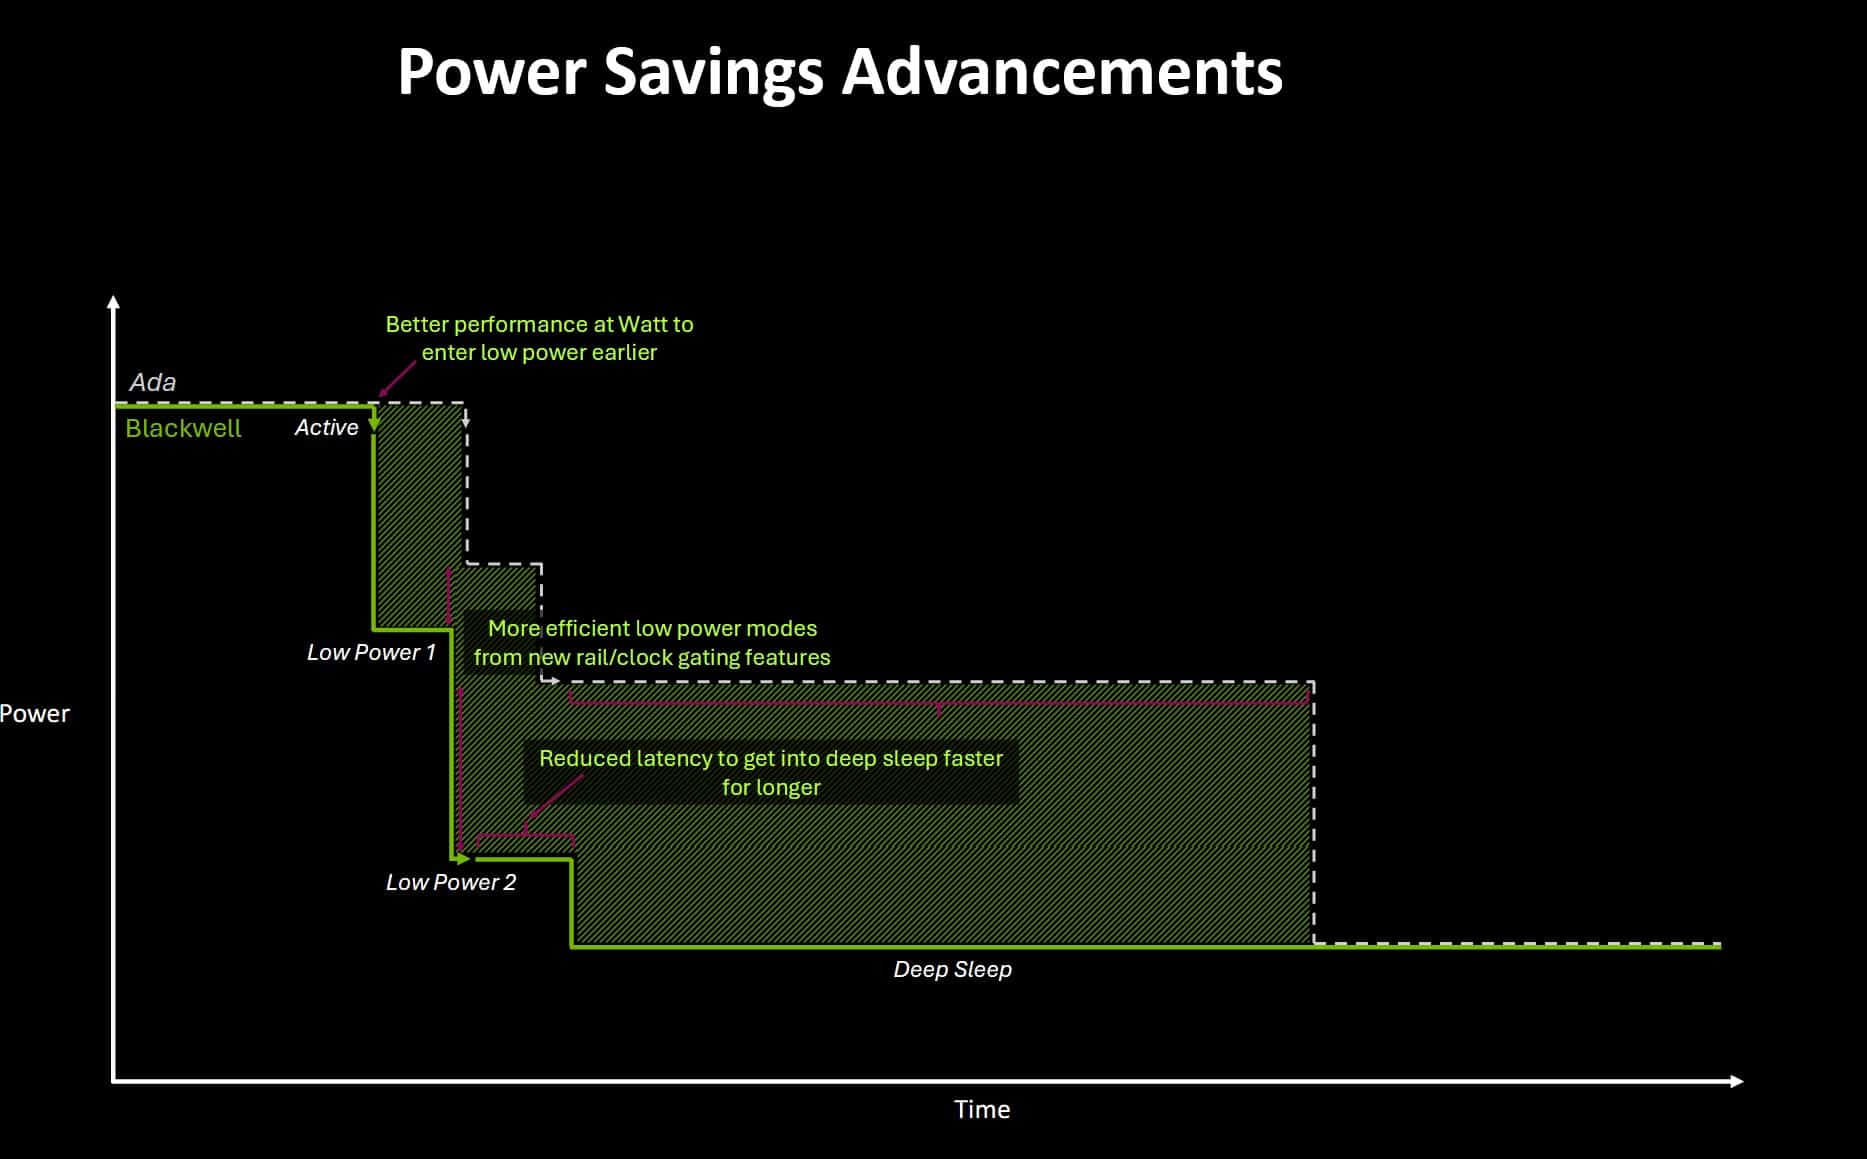
NVIDIA 增強了 Battery Boost 技術,可根據場景複雜度動態調整 GPU 和 CPU 的功耗,力求在支援的遊戲中保持穩定的 60 FPS,同時在對效能要求較低的場景下降低功耗。 NVIDIA 表示,這可使遊戲時的電池續航時間延長高達 40%,影片播放時間延長高達 30%。例如,我們的測試平台(Razer Blade 16)在運行《博德之門 3》和《賽博朋克 2077》等遊戲時,電池續航時間據稱幾乎是上一代產品的兩倍。
影片編碼與人工智慧輔助創作
對於使用筆記型電腦作為主系統的內容創作者來說,GeForce RTX 50 系列對視訊編碼和處理進行了重大升級。 GeForce RTX 5090 行動 GPU 有三個第 9 代 NVENC 編碼器和兩個第 6 代解碼器,支援 H.4 和 H.2 格式的 2:264:265 色度子取樣。這可以實現更高的色彩精度和更有效率的視訊壓縮。處理 HDR 內容或進行多輪色彩校正的創作者將受益於 4:2:2 編碼所帶來的更高的色彩保真度和更小的檔案大小。
FP4 支援也促進了 AI 輔助創意工作。與以前基於 Ada 的模型相比,穩定擴散等生成式 AI 模型在 GeForce RTX 2 系列 GPU 上的運行速度現在可提高 50 倍。 FP4 減少了記憶體使用量並提高了處理速度,同時又不影響輸出質量,使得在筆記型電腦上本地運行大型 AI 模型變得更加容易。
RTX 神經臉部和 AI 輔助渲染
GeForce RTX 50 行動系列中的 AI 不僅限於圖形渲染,它還改進了角色和紋理的處理方式。 GeForce RTX Neural Faces 使用生成式 AI 透過對數千種臉部表情和光照場景進行訓練來創造更逼真的臉部。它不依賴傳統的動畫方法,而是即時產生逼真的表情,使遊戲和模擬中的角色看起來和移動得更自然。
NVIDIA 還推出了 GeForce RTX 神經紋理壓縮功能,該功能利用 AI 將紋理尺寸縮小多達 7 倍,而不會犧牲細節。這減少了記憶體使用量並加快了載入時間——這對於大型開放世界遊戲來說是一個巨大的勝利。開發人員可以透過 GeForce RTX Neural Shaders SDK 利用這些功能,創造出更詳細、更身臨其境的環境,而不會造成 GPU 記憶體過載。
現在我們已經介紹了架構和主要特性,讓我們來看看 GeForce RTX 5090 Mobile 在實際使用中的表現。從遊戲到創意工作負載,我們都能看到 GPU 的功能。
NVIDIA GeForce RTX 5090 行動版規格
| GPU比較 | GeForce RTX 5090 行動版 | GeForce RTX 5090 | GeForce RTX 4090 行動版 | GeForce RTX 4090 |
| GPU名稱 | GB203 | GB202 | AD103 | AD102 |
| 卓越的建築 | 布萊克威爾2.0 | 布萊克威爾2.0 | 艾達洛夫萊斯 | 艾達洛夫萊斯 |
| 進程大小 | 5納米 | 5納米 | 5納米 | 5納米 |
| 晶體管 | 45,600百萬 | 92,200百萬 | 45,900百萬 | 76,300百萬 |
| 密度 | 120.6M/平方毫米 | 123.9M/平方毫米 | 121.1M/平方毫米 | 125.3M/平方毫米 |
| 模具尺寸 | 378平方毫米 | 744平方毫米 | 379平方毫米 | 609平方毫米 |
| 插槽寬度/形狀係數 | 移動IGP | 雙槽 | 移動IGP | 三槽 |
| 尺寸 | 電話 | 304 mm x 137 mm x 48 mm | 電話 | 304 mm x 137 mm x 61 mm |
| TDP | 150W¯¯ | 575W¯¯ | 120W¯¯ | 450W¯¯ |
| 視頻連接 | 依賴便攜設備 | 1 個 HDMI 2.1b,3 個 DisplayPort 2.1b | 依賴便攜設備 | 1個HDMI 2.1、3個DisplayPort 1.4a |
| 電源連接器 | 無 | 1x 16 針 | 無 | 1x 16 針 |
| 總線接口 | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 4.0 x16 | PCIe 4.0 x16 |
| 基地時鐘 | 990 MHz | 2017 MHz | 1335 MHz | 2235 MHz |
| 提升時鐘 | 1515 MHz | 2407 MHz | 1695 MHz | 2520 MHz |
| 記憶時鐘 | 1750 MHz 有效 28 Gbps |
2209 MHz(28 Gbps 有效) | 2250 MHz 有效 18 Gbps |
1313 MHz(21 Gbps 有效) |
| 內存大小 | GB 24 | GB 32 | GB 16 | GB 24 |
| 內存類型 | GDDR7 | GDDR7 | GDDR6 | GDDR6X |
| 內存總線 | 256位 | 512位 | 256位 | 384位 |
| 內存帶寬 | 896.0 GB / s | 1.79 TB / s | 576.0 GB / s | 1.01 TB / s |
| CUDA核心 | 10,496 | 21,760 | 9728 | 16,384 |
| TMU | 328 | 680 | 304 | 512 |
| 個ROPs | 112 | 192 | 112 | 176 |
| SM 計數 | 82 | 170 | 76 | 128 |
| 張量核心 | 328 | 680 | 304 | 512 |
| RT核心 | 82 | 170 | 76 | 128 |
| L1緩存 | 128 KB(每個 SM) | 128 KB(每個 SM) | 128 KB(每個 SM) | 128 KB(每個 SM) |
| L2緩存 | 64 MB | 88 MB | 64 MB | 72 MB |
| 像素率 | 169.7 G像素/秒 | 462.1 G像素/秒 | 189.8 G像素/秒 | 443.5 G像素/秒 |
| 紋理速率 | 496.9 GTexel/秒 | 1,637 GTexel/秒 | 515.3 GTexel/秒 | 1,290 GTexel/秒 |
| FP16(半) | 31.80 TFLOPS (1:1) | 104.8 兆次浮點運算 (1:1) | 32.98 TFLOPS (1:1) | 82.58 兆次浮點運算 (1:1) |
| FP32(浮點) | 31.80 TFLOPS | 104.8 TFLOPS | 32.98 TFLOPS | 82.58 TFLOPS |
| FP64(雙) | 496.9 GFLOPS (1:64) | 1.637 兆次浮點運算 (1:64) | 515.3 GFLOPS (1:64) | 1,290 GFLOPS (1:64) |
| 發行價(美元) | 取決於行動裝置規格 | $1,999 | 取決於行動裝置規格 | $1,599 |
NVIDIA GeForce RTX 5090 行動版效能
為了全面了解 GeForce RTX 5090 行動版顯示卡的效能,我們執行了一系列基準測試,涵蓋 AI 處理、渲染和遊戲效能。這些測試包括用於 AI 文字和圖像生成的UL Procyon 、用於整體運算能力的Geekbench 6 、用於光線追蹤渲染的V-Ray以及用於實際遊戲場景的3DMark。我們也測量了其能效,以評估 GPU 在效能和能耗之間的平衡。
測試系統規格
如上所述,我們測試了搭載 GeForce RTX 5090 Mobile 顯示卡的Razer Blade 16,這是一款高效能遊戲筆記型電腦,旨在充分利用最新硬體。以下是其主要硬體配置:
- 中央處理器: AMD Ryzen AI 9 HX 370(12 核心、24 線程、最高 5.1 GHz)
- GPU: NVIDIA GeForce RTX 5090 行動版 (24GB GDDR7)
- 隨機存取存儲器: 32GB DDR5-8000
- 貯存: 三星 PM9A1 2TB NVMe SSD
- 顯示: 16 吋 QHD+ 240Hz
- 電池: 95.2瓦
- 操作系統: 視窗11主頁
我們將使用電池和交流電測試 GeForce RTX 5090 Mobile,以顯示功率限制如何影響效能。許多高階 GPU 在使用電池供電時會節流以節省能源,這直接影響幀速率、AI 處理速度和渲染時間。比較這些結果可以真實地了解筆記型電腦在不同使用情境下的表現。將電源計劃設為“平衡”,以便在電池和插入測試中進行一致的基準測試。
雖然 GeForce RTX 5090 Mobile 專為便攜性能而設計,但將其與桌上型電腦 GeForce RTX 5090 進行比較可以為了解其功能提供有價值的背景資訊。桌上型電腦顯示卡的運轉功率預算和散熱空間要高得多,因此透過比較可以凸顯出在行動端顯示卡中保留了多少桌上型電腦等級的效能。
UL Procyon:人工智慧文字生成
首先,我們迎來了一系列測試,其中包括Procyon AI 文本生成基準測試。此基準測試提供了一種簡潔且一致的評估方法,簡化了 AI LLM 效能測試。它允許對多個 LLM 模型進行重複測試,同時最大限度地降低了大型模型規模和可變因素帶來的複雜性。此基準測試由 AI 硬體領域的領導企業共同開發,優化了本地 AI 加速器的使用,從而實現更可靠、更有效率的效能評估。以下測試結果均使用 TensorRT 進行測試。
GeForce RTX 5090 Mobile 提供了令人印象深刻的 AI 文字產生效能,但插入電源和電池操作之間存在明顯差距。插入電源後,行動 GPU 可實現每秒幾乎兩倍的輸出令牌,並且與使用電池相比,整體持續時間明顯更快 - 例如,使用 Phi,它從 98.5 令牌/秒躍升至 163.1 令牌/秒,並將總時間從 30.8 秒縮短至 18.6 秒。由於 TDP 和核心數量更高,桌面版 GeForce RTX 5090 的輸出率是行動版的兩倍多,持續時間縮短了一半。這些結果凸顯了行動版本在平衡電源效率和出色性能方面的優勢,不過,正如預期的那樣,桌面級模型的 AI 處理仍然處於自己的水平。
| UL Procyon:人工智慧文字生成 | GeForce RTX 5090 行動電池 | GeForce RTX 5090 行動版插件 | GeForce RTX 5090 |
| Phi 總分 | 2,256 | 3.842 | 5,749 |
| Phi 輸出到第一個代幣的時間 | 0.496小號 | 0.283小號 | 0.244小號 |
| Phi 每秒輸出令牌 | 98.551 令牌/秒 | 163.135 令牌/秒 | 314.435 令牌/秒 |
| Phi 總持續時間 | 30.863小號 | 18.624小號 | 10.280小號 |
| 米斯特拉爾總分 | 2,031 | 3,648 | 6,267 |
| 米斯特拉爾輸出第一個令牌的時間 | 0.740小號 | 0.430小號 | 0.297小號 |
| 米斯特拉爾每秒輸出令牌 | 66.990 令牌/秒 | 125.637 令牌/秒 | 255.945 令牌/秒 |
| 米斯特拉爾總持續時間 | 45.510小號 | 24.454小號 | 12.593小號 |
| Llama3 總分 | 1,798 | 3,398 | 6,104 |
| Llama3 輸出第一個令牌的時間 | 0.734小號 | 0.380小號 | 0.234小號 |
| Llama3 每秒輸出令牌 | 58.358 令牌/秒 | 107.906 令牌/秒 | 214.285 令牌/秒 |
| Llama3 整體持續時間 | 51.959小號 | 27.956小號 | 14.304小號 |
| Llama2 總分 | 1,815 | 3,660 | 6,591 |
| Llama2 輸出第一個令牌的時間 | 1.242小號 | 0.619小號 | 0.419小號 |
| Llama2 每秒輸出令牌 | 30.225 令牌/秒 | 61.258 令牌/秒 | 134.502 令牌/秒 |
| Llama2 整體持續時間 | 98.110小號 | 48.279小號 | 23.018小號 |
UL Procyon: 人工智能圖像生成
Procyon AI 影像產生基準測試能夠持續且準確地衡量各種硬體(從低功耗 NPU 到高階 GPU)上的 AI 推理效能。它包含三個測試:針對高階 GPU 的 Stable Diffusion XL (FP16) 測試、針對中型效能 GPU 的 Stable Diffusion 1.5 (FP16) 測試以及針對低功耗裝置的 Stable Diffusion 1.5 (INT8) 測試。此基準測試會針對每個系統使用最佳推理引擎,確保結果的公平性和可比較性。
在這裡,GeForce RTX 5090 Mobile 再次顯示插入電源和電池模式之間明顯的效能差距。在 Stable Diffusion XL (FP16) 中,插入後的得分是電池得分的兩倍多 (2,801 對 1,252),將生成時間從每個影像近 30 秒縮短到 13.4 秒。桌面版 GeForce RTX 5090 仍處於不同的級別,其插入分數是後者的兩倍多,每張影像的渲染速度極快,為 5.2 秒。同樣的趨勢也適用於 Stable Diffusion 1.5,其中桌上型卡具有更高的核心數量和功率餘裕,可以提供更快的結果。也就是說,行動版 GeForce RTX 5090 在負載下仍然表現良好。
| UL Procyon:AI 影像產生(總分:越高越好) | GeForce RTX 5090 行動電池 | GeForce RTX 5090 行動版插件 | GeForce NVIDIA RTX 5090 |
| 穩定擴散 1.5 (FP16) — 總體得分 | 1,592 | 3,231 | 8,193 |
| 穩定擴散 1.5 (FP16) — 總時間 | 62.775小號 | 30.946小號 | 12.204小號 |
| 穩定擴散 1.5 (FP16) — 影像產生速度 | 3.923 秒/影像 | 1.934 秒/影像 | 0.763 秒/影像 |
| 穩定擴散 1.5 (INT8) — 總體得分 | 21,261 | 36,342 | 79,272 |
| 穩定擴散 1.5 (INT8) — 總時間 | 11.758小號 | 6.879小號 | 3.154小號 |
| 穩定擴散 1.5 (INT8) — 影像生成速度 | 1.006 秒/影像 | 0.860 秒/影像 | 0.394 秒/影像 |
| 穩定擴散 XL (FP16) — 總體得分 | 1,252 | 2,801 | 7,179 |
| 穩定擴散 XL (FP16) — 總時間 | 478.861小號 | 214.206小號 | 83.573小號 |
| 穩定擴散 XL (FP16) — 影像產生速度 | 29.929 秒/影像 | 13.388 秒/影像 | 5.223 秒/影像 |
樂士馬克
Luxmark 是一個 GPU 基準測試,它使用開源光線追蹤渲染器 LuxRender 來評估系統在處理高度詳細的 3D 場景方面的效能。此基準測試適用於評估伺服器和工作站的圖形渲染能力,特別是對於視覺效果和建築視覺化應用程序,其中準確的光模擬至關重要。
在這裡,結果凸顯了 GeForce RTX 5090 Mobile 的穩定渲染能力,尤其是在插入電源時。 Hall Score 從使用電池時的 14,555 躍升至接通電源時的 28,547,效能幾乎翻了一番。然而,桌面版 GeForce RTX 5090 仍然遙遙領先,得分為 51,725,顯示出更高的熱量和功率限制的明顯優勢。雖然行動型號為筆記型電腦提供了具有競爭力的渲染能力,但處理複雜 3D 場景的專業人士仍將受益於桌上型電腦 GPU 的原始實力。
| Luxmark(越高越好) | GeForce RTX 5090 行動電池 | GeForce RTX 5090 行動版插件 | GeForce NVIDIA RTX 5090 |
| 食物評分 | 5,792 | 11,487 | 23,141 |
| 霍爾分數 | 14,555 | 28,547 | 51,725 |
Geekbench 6
Geekbench 6是一款跨平台基準測試軟體,用於衡量系統整體效能。 Geekbench 瀏覽器可讓您將任何系統與 Geekbench 6 進行比較。
GeForce RTX 5090 Mobile 在插入電源後,Geekbench 6 效能明顯提升,在 OpenCL 測試中從 174,725 躍升至 208,451。這表明 GPU 可以在更高的功耗下發揮其優勢,從而提供更好的運算效能。電池性能仍然穩定,但下降反映了不插電運行時電源效率的預期權衡。桌面版 GeForce RTX 5090 仍然以 374,807 的得分保持領先,但行動版在便攜式外形中也表現出色。
| Geekbench(越高越好) | GeForce RTX 5090 行動電池 | GeForce RTX 5090 行動版插件 | GeForce RTX 5090 |
| GPU OpenCL 分數 | 174,725 | 208,451 | 374,807 |
的V-Ray
V -Ray基準測試使用先進的 V-Ray 6 引擎,測量 CPU、NVIDIA GPU 或兩者的渲染效能。它採用快速測試和簡單的評分系統,使用戶能夠評估和比較系統的渲染能力。對於尋求高效性能洞察的專業人士而言,它是一款必不可少的工具。
在 V-Ray 基準測試中,GeForce RTX 5090 Mobile 在插入時表現出顯著的效能提升,其 vpaths 得分為 (4,076 對 6,877) — 提高了近 70%。這表明,當不受電池限制時,GPU 能夠更有效地處理要求苛刻的光線追蹤渲染。也就是說,即使在電池模式下,它仍然提供出色的渲染能力,使其成為忙碌的創意專業人士的可靠選擇。儘管桌上型電腦型號以 14,764 的得分超過了它,但考慮到其較低的功率範圍,行動 GPU 的性能仍然令人印象深刻。
| V-Ray(越高越好) | GeForce RTX 5090 行動電池 | GeForce RTX 5090 行動版插件 | GeForce RTX 5090 |
| 虛擬路徑 | 4,076 | 6,877 | 14,764 |
3D馬克
3DMark Port Royal、Speed Way 和 Steel Nomad 是測試不同場景下效能的 GPU 基準測試。 Port Royal 專注於光線追踪,Speed Way 評估賽車模擬中的性能,Steel Nomad 則以高強度、逼真的圖形挑戰 GPU。它們評估 GPU 在渲染、照明和動態場景方面的能力。
3DMark 的結果證實了插入電源後性能更強勁的持續趨勢,特別是在 Port Royal,其得分從 6,798 增加了一倍多至 15,380。 Speed Way 和 Steel Nomad 也顯示出顯著的提升,突顯了 GPU 如何從圖形密集型工作負載中的更高功率限制中受益。桌上版 GeForce RTX 5090 的全面得分更高,但行動版的性能足以滿足流暢的高端遊戲和旅途中的創意工作。
| 3DMark 測驗(分數越高越好) | GeForce RTX 5090 行動電池 | GeForce RTX 5090 行動版插件 | GeForce RTX 5090 |
| 皇家港口 | 6,798 | 15,380 | 19,290 |
| 速度之路 | 2,885 | 6,223 | 7,709 |
| 鋼鐵游牧者 | 2,731 | 5,655 | 6,458 |
耗電量:GeForce RTX 5090 行動版
功耗是任何運算平台的關鍵因素,但它直接影響行動環境中的電池壽命和熱管理。每一代新的 GPU 都傾向於進一步提升效能,但更高的功耗會導致熱量輸出增加,因此需要更有效率的冷卻解決方案。與依賴更大電源和主動冷卻的桌上型電腦不同,行動 GPU 必須在效能和電源效率之間取得平衡,以延長電池壽命,同時控制熱量。雖然更強大的 GPU 可以更快地完成任務,但持續的工作負載可能會引入熱限制,從而影響長期效能。
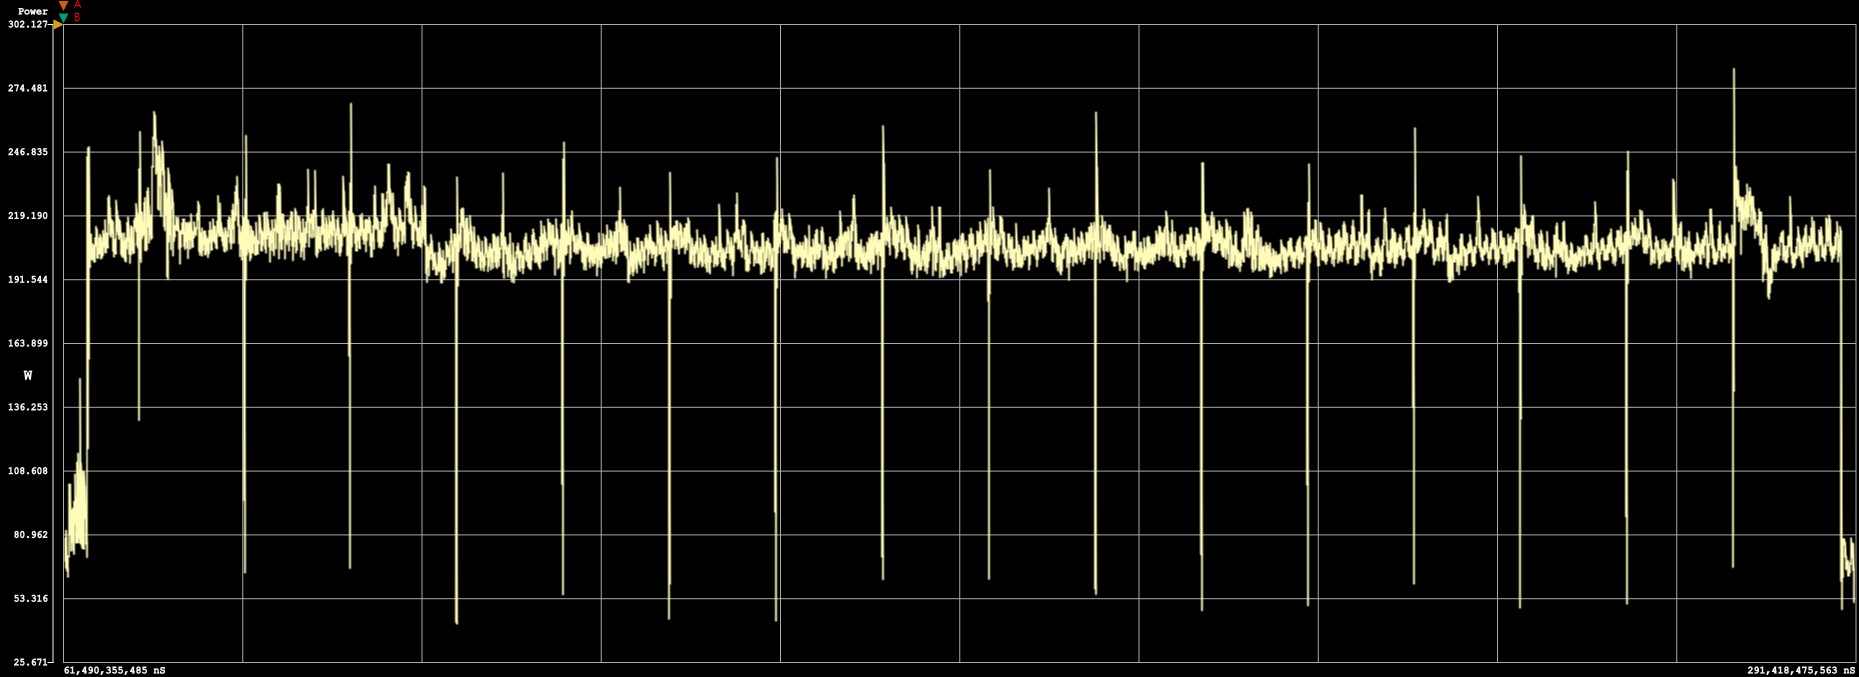
在 Procyon AI 影像產生測試期間,我們測試了 NVIDIA RTX 5090 Mobile 的功耗(插入電源,取出電池)。雖然行動 GPU 的運作功耗明顯低於其桌面 GPU,但係統在負載下峰值達到 239W,平均功耗高達 206W。
空閒功耗測得為 68.5W,這意味著 GPU 功耗達到約 137.5W。 Razer 16 將 GeForce RTX 5090 Mobile 的最大耗電量設定為 135W,與我們的測量值非常接近。整個測試僅用時 13.5 秒,期間僅消耗 0.76Wh 電量。這使得 GeForce RTX 5090 行動 GPU 成為 AI 影像生成測試中最節能的 GPU。
| 功率測試對比 | GeForce RTX 5090 行動版(已插入) | AMD 9070 XT | NVIDIA RTX 5070 | 華碩 Prime NVIDIA RTX 5070 Ti | NVIDIA RTX 5080 | NVIDIA RTX 5090 |
| 耗電量 | 0.76Wh | 3.41Wh | 2.46Wh | 1.66Wh | 1.39Wh | 1.16Wh |
| 測試時間 | 13.5小號 | 17.4小號 | 19.2小號 | 11.1小號 | 8.7小號 | 5.1小號 |
結語
NVIDIA GeForce RTX 5090 Mobile 為高效能筆記型電腦帶來了顯著的飛躍。這款 GPU 以 NVIDIA 的 Blackwell 架構為核心,融合了強大的 AI 動力、下一代光線追蹤和改進的電源效率,功率高達 150W。它並不是要取代桌上型電腦顯示卡,而是它提供了足夠的動力來毫不費力地運行密集的創意工作負載、AAA 遊戲和 AI 任務,尤其是在插入電源時。與 Razer Blade 9 筆記型電腦中的 AMD Ryzen AI 370 HX 16 等強大的 CPU 搭配使用,它展示了行動平台的發展程度。
在我們的測試中,電池和插入模式之間的性能差異是一致且明顯的 - 但這是意料之中的。在電池供電的情況下,GeForce RTX 5090 Mobile 仍然非常適合較輕的任務,但一旦連接到交流電源,GPU 就會發揮其全部潛力。無論是在 V-Ray 中渲染場景、使用 Stable Diffusion XL 生成圖像還是在 3DMark 中提高幀速率,插件結果始終提供類似桌面的響應能力,同時保持比以前的移動旗艦更好的效率。
雖然桌面版 GeForce RTX 5090 在原始性能方面仍然遙遙領先,但行動版已經縮小了差距,足以成為那些需要強大性能但又不想被主機和辦公桌束縛的用戶的理想選擇。其中最引人注目的測試是 Procyon AI 影像產生工作負載下的功耗。 NVIDIA GeForce RTX 5090 行動版打破了GeForce RTX 5090 FE所保持的記錄,功耗幾乎降低了一半。儘管行動版顯示卡的運行速度不如桌面版,但它在運行該工作負載時功耗極低,最終勝出。
如果您是 AI 愛好者、工程師或遊戲玩家,需要以便攜式形式獲得頂級 GPU 效能,GeForce RTX 5090 Mobile 可以滿足您的需求,但通常需要注意與筆記型電腦的散熱和功率限制相關的問題。雖然桌面版 GeForce RTX 5090 仍然是實現最高效能的首選,但行動版將這項功能的很大一部分帶給了筆記型電腦,而不會完全影響效率或行動性。


 Amazon