

對快速、高品質視訊內容的需求從未如此強烈。在當今的媒體格局中,小型新聞團隊、獨立內容創作者和活動製作團隊都需要即時捕捉、編輯和發布專業級素材,而且通常無需後製團隊或集中式基礎設施的支援。
正因如此,隨著素材數量的激增和重複使用需求的增加,透過邊緣製作系統提供的本地 AI 搜尋正成為必要。邊緣工作流程使團隊能夠在拍攝時直接處理素材,從而消除了瓶頸,使創作者能夠減少尋找和管理素材的時間,從而將更多時間投入到製作最佳內容上。
Axle AI是一款由人工智慧驅動的媒體資產管理和自動化平台,專為這種分散式、快節奏的工作流程而設計。它與業界領先的硬體(例如 HPE ProLiant DL145 Gen11 伺服器、NVIDIA L4 GPU 和 Solidigm PCIe Gen5 SSD)相結合,以創造出功能強大且便攜的製作環境。即使是最精簡的團隊,也能從中受益,獲得專業的 AI 輔助媒體處理能力。
系統架構概述
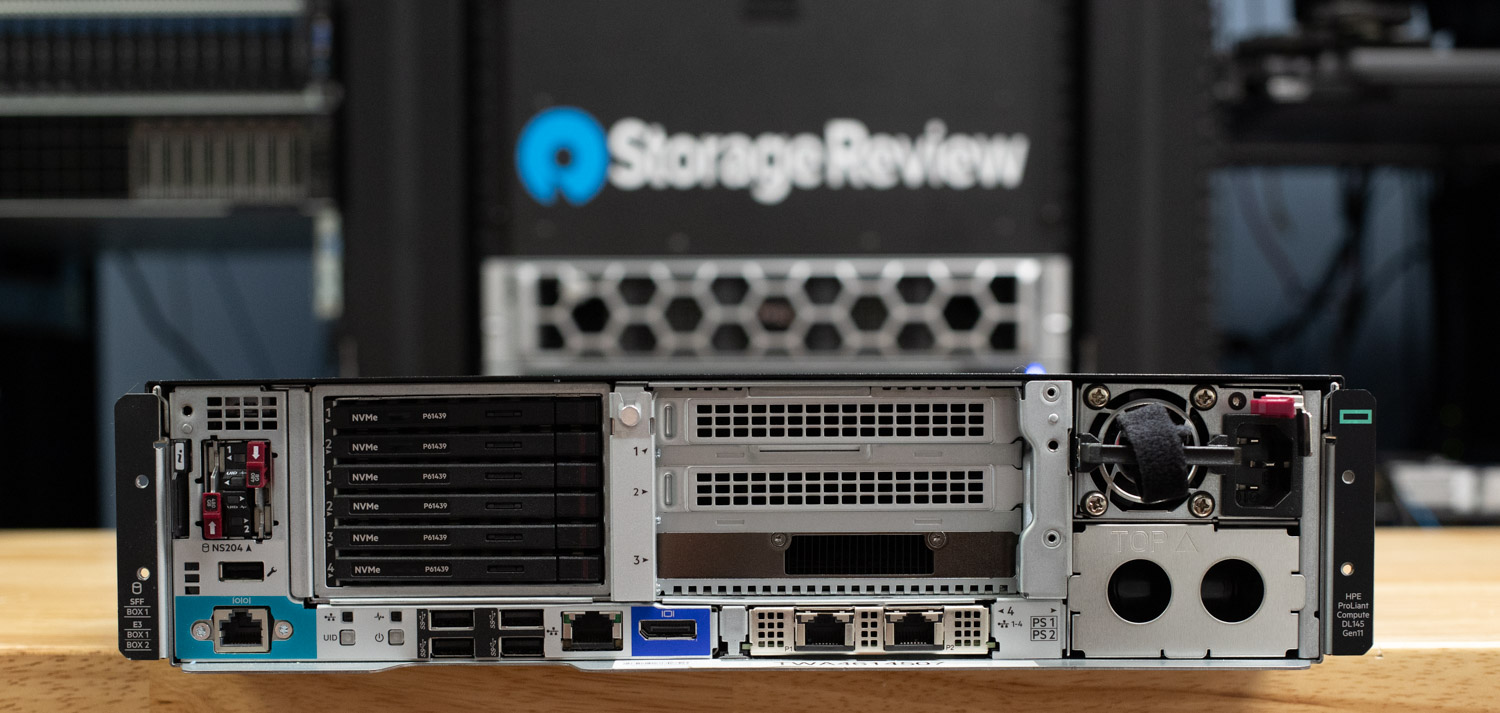
HPE ProLiant DL145 Gen11 邊緣伺服器是 Axle AI 在空間、電力和散熱受限的現場和活動環境中部署的理想選擇。這款伺服器採用 2U 短深度設計,深度僅為 16 英寸,專為便攜性和在狹小空間(例如移動機架和航空箱)中的安裝而設計。與傳統企業級設備不同,它支援 -5°C 至 55°C 的擴展工作溫度範圍,非常適合控制性較差的環境。儘管體積小巧,但它提供企業級功能,例如冗餘電源和啟動驅動器選項,使其成為需要強大、邊緣運算能力強的基礎設施且無需承擔全尺寸硬體開銷的團隊的理想之選。
在CPU方面,DL145支援AMD EPYC 8004(Siena)系列處理器,核心數從8個到64個不等。我們的測試系統配備了EPYC 8434P處理器,擁有48個核心和96個執行緒。其TDP為200W,在能源效率和運算能力之間取得了良好的平衡,使其成為高強度工作負載的理想選擇。該處理器支援96條PCIe 5.0通道,並提供6通道DDR5內存,最高速度可達4800 MT/s,擁有出色的內存頻寬。雖然Axle AI的最低配置要求是至少16個CPU核心和32GB內存,但我們的配置遠遠超過這些要求,擁有48個核心和256GB的DDR5內存。
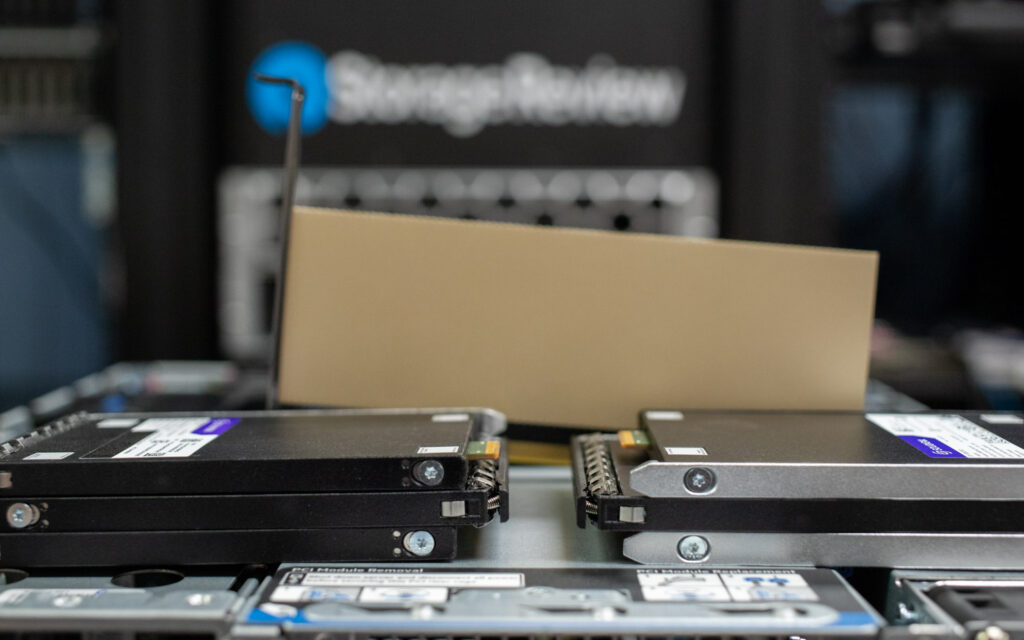
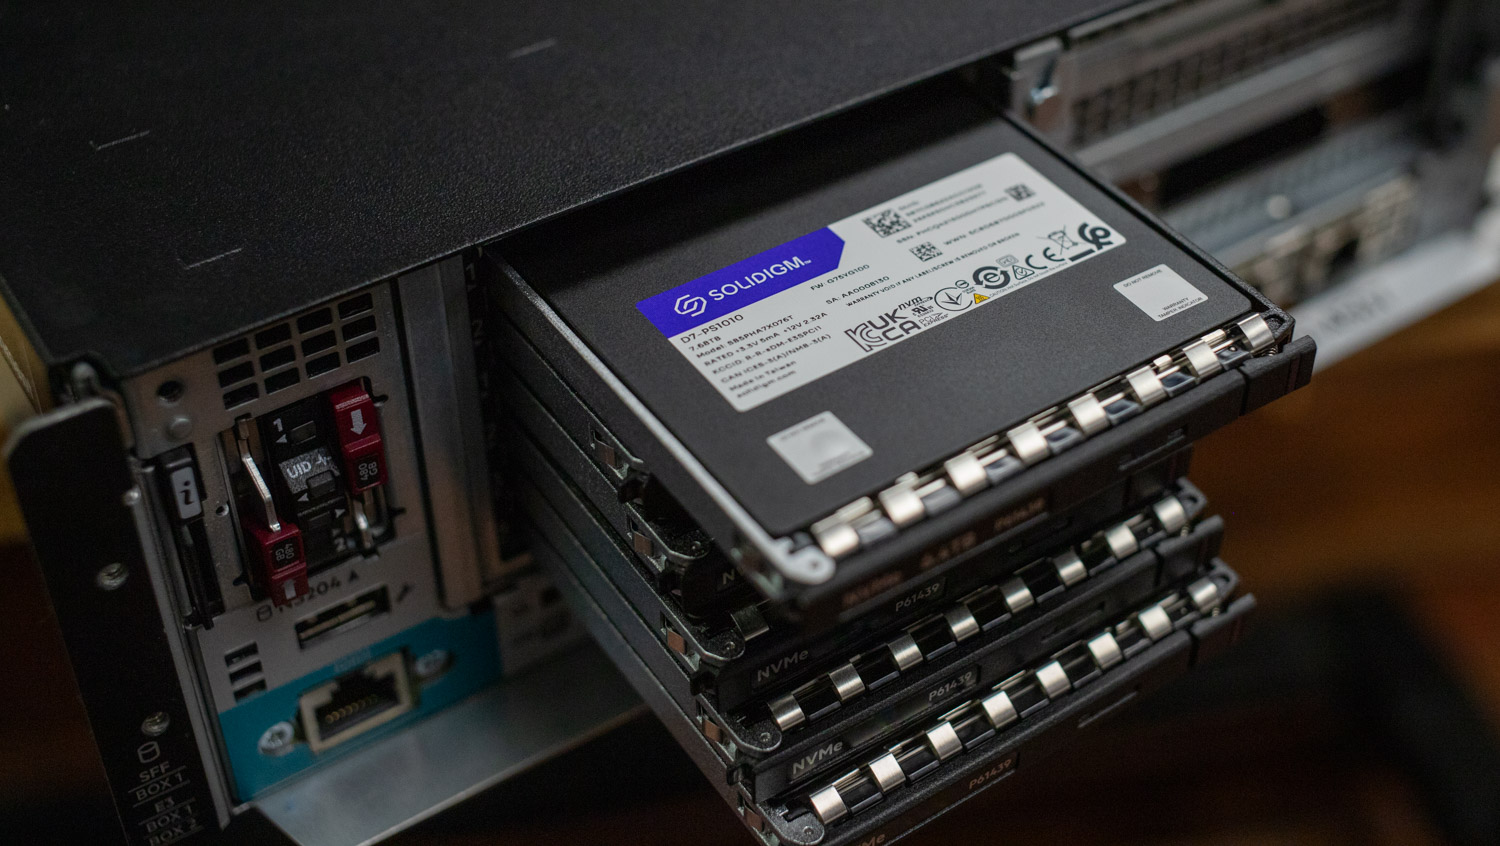
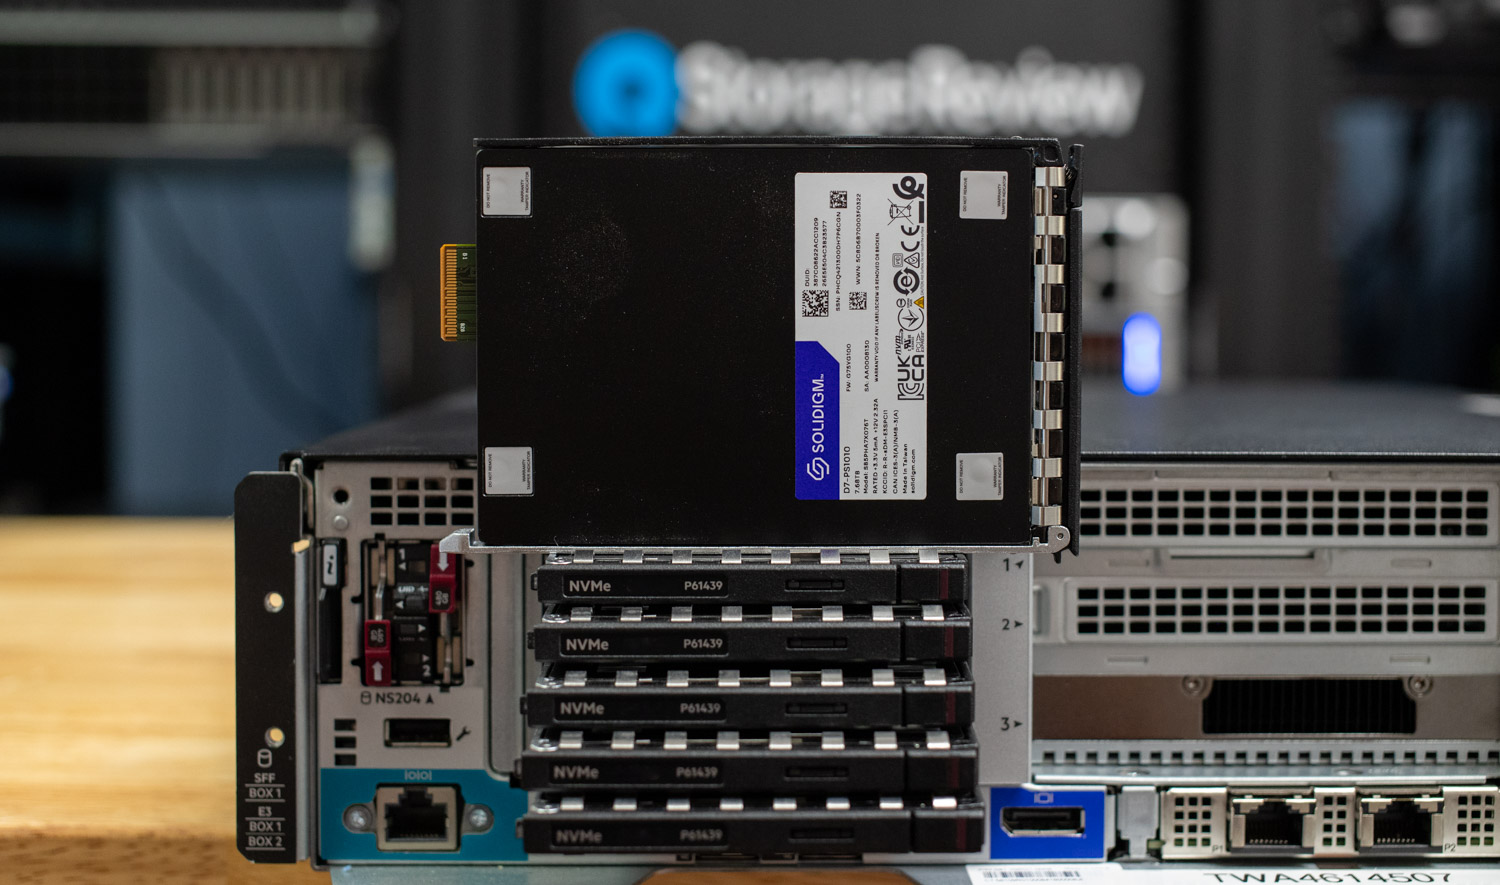
儲存效能在任何媒體流程中都至關重要,而 DL145 最多支援六個 EDSFF E3.S NVMe 硬碟,以滿足這些需求。在我們的配置中,我們使用了六個 Solidigm D7-PS1010 E3.S SSD,每個容量為 7.68 TB。這些 PCIe 5.0 x4 硬碟可提供高達 14,500 MB/s 的讀取速度和 10,000 MB/s 的寫入速度,總計可提供近 46 TB 的高速儲存。這些 SSD 專為 AI 和媒體工作流程而設計,具有出色的能源效率,與傳統 NVMe 硬碟相比,在特定流程階段可提供高達 50% 的吞吐量提升。對於需要額外容量的團隊,此配置可擴展至每個硬碟 15.36 TB,從而在緊湊的外形尺寸中提供總計 92 TB 的快速密集儲存。
DL145 最多支援三個單槽 GPU,在我們的配置中,我們部署了一塊 NVIDIA L4 加速器,這是一款基於 Ada Lovelace 架構的節能型加速器。 L4 專為視訊處理、AI 推理、視覺計算和虛擬化工作負載而設計,在僅消耗 72 瓦功耗的情況下,即可提供強大的效能。它配備 24 GB GDDR6 顯存,並透過 PCIe 4.0 x16 介面進行供電和資料傳輸。 Axle AI建議至少配備 16 GB 顯存,而 L4 額外配備了 8 GB 顯存,輕鬆滿足高解析度媒體任務和 AI 驅動操作的需求。
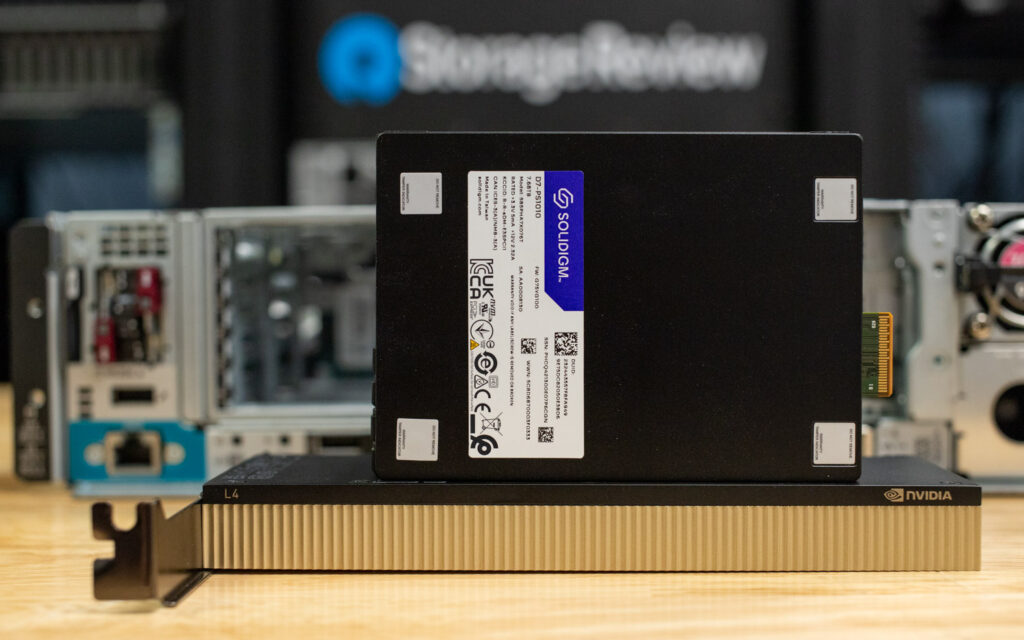
Nvidia L4 單槽 GPU
在應用層,我們使用 Proxmox 虛擬環境 (8.3.5) 部署了 Axle AI MAM 和 Axle AI 標籤。系統配置了兩個專用虛擬機器:一個運行 Axle AI MAM,另一個運行 Axle AI 標籤。這種結構將媒體管理和 AI 驅動的元資料處理清晰地分離,同時仍允許組件之間無縫通訊。
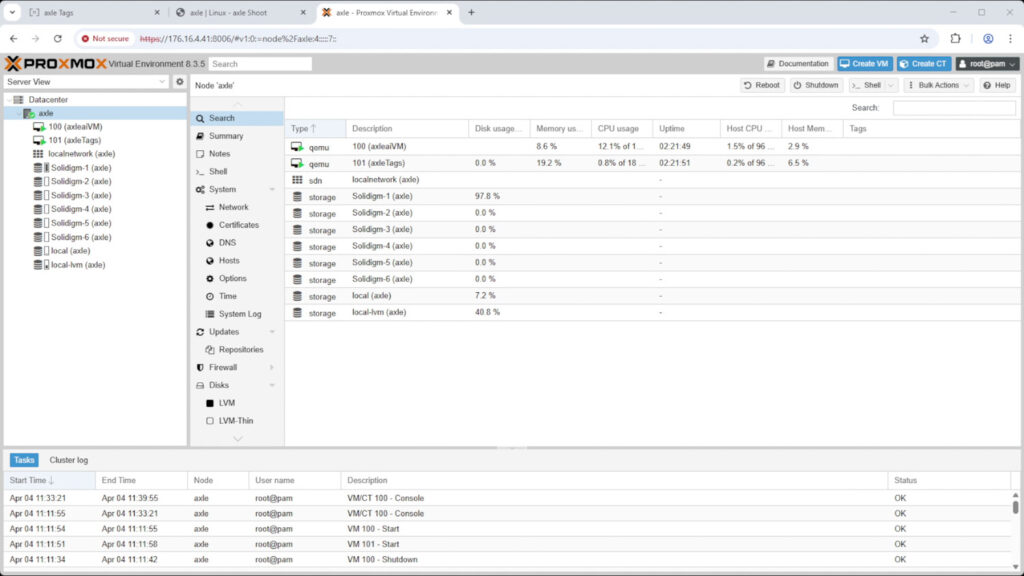
Proxmox環境與硬體總結
Axle AI Tags 與 MAM 協同運行,提供本地 AI 功能,包括語義向量搜尋、物件和徽標識別以及可訓練的人臉偵測。它部署在 Docker 容器中,並透過 PCIe 直通利用 NVIDIA L4 GPU 實現高效的即時推理。基於瀏覽器的訓練和管理介面支援靈活調整,其模組化設計支援 Intel/NVIDIA 或 AMD/NVIDIA 硬體配置。 Axle AI Tags 不僅在我們的設定中與 MAM 完全集成,還提供 REST API 相容性,以便與其他平台配合使用。
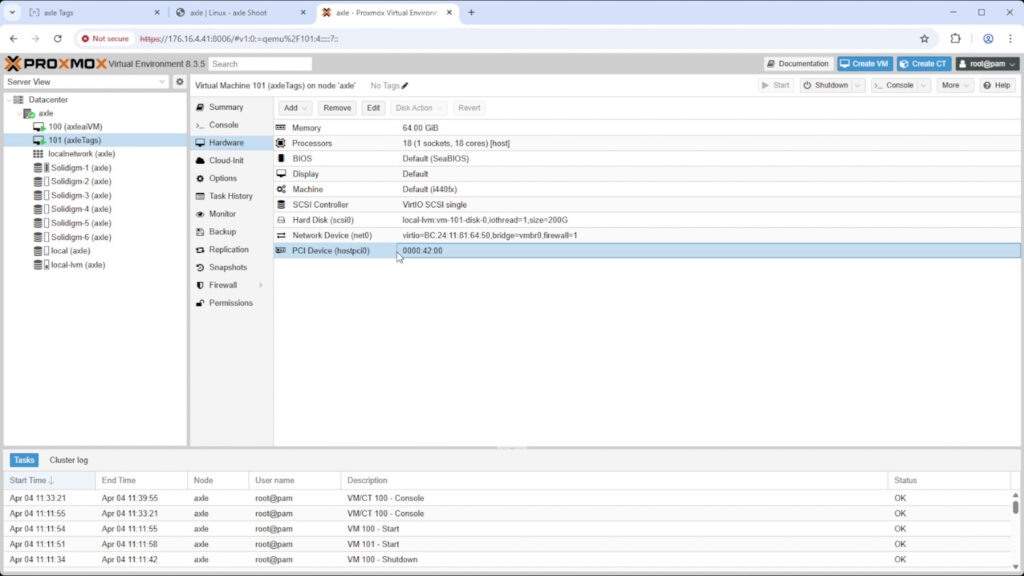
Axle AI Tags虛擬機器的硬體配置
Solidigm PS1010 硬碟安裝在 Axle AI MAM 虛擬機器中,確保高速、低延遲地存取素材。透過虛擬化整個堆疊並為每個元件分配專用運算資源,此設定可提供更高的正常運作時間、更佳的資源管理和多使用者支持,遠超過單一工作站所能提供的功能。這使其成為協作式、高容量製作環境的理想選擇。
這些元件共同構成了一個緊密整合的硬體解決方案,可實現快速、在地化、AI 驅動的媒體工作流程。對於需要在空間和電力有限的情況下,同時又需要 AI 處理能力的遠端團隊來說,這是一個高效的現場就緒平台。
HPE ProLiant DL145 Gen11 性能
在深入進行基準測試之前,下表概述了 HPE ProLiant DL145 Gen11 的系統配置。在執行 Proxmox 的虛擬化安裝上使用 Axle AI 進行測試時,系統已過渡到 Ubuntu Server 22.04.5,以測量 GDSIO 和 FIO 測試中的儲存效能。
| HPE ProLiant DL145 第 11 代 | 硬件總覽 |
|---|---|
| 中央處理器 | 單一 AMD EPYC 8434P |
| 內存 | 256GB 糾錯碼 DDR5 |
| 儲存 | 6塊 Solidigm D7-PS1010 E3s SSD,7.68TB |
| 引導存儲 | NS204 連接埠 2x 已填入(480GB Samsung PM9A3 M.2) |
| GPU | 單一 NVIDIA L4 |
| 操作系統 | Ubuntu服務器22.04.5 |
峰值合成性能
FIO 測試是一款靈活且強大的基準測試工具,用於測量儲存設備(包括 SSD 和 HDD)的效能。它評估各種工作負載(例如順序和隨機讀取/寫入操作)下的頻寬、IOPS(每秒輸入/輸出操作)和延遲等指標。此測試旨在捕捉峰值效能,並在多種工作負載下測試儲存系統,使其特別適用於比較不同的設備或配置。在本例中,我們執行了全表面測試,充分利用了驅動器的全部容量,以全面了解其持續的性能特性。
在使用128K塊的順序讀取測試中,該系統的頻寬達到56.4 GB/s,持續IOPS高達430,000,平均延遲為1.78毫秒。相同區塊大小下的順序寫入效能達到45.4 GB/s,IOPS高達346,000,平均延遲為2.22毫秒。在使用4K區塊的隨機讀取操作中,該系統的頻寬達到46.6 GB/s,IOPS高達11.4萬,平均延遲僅0.269毫秒,突顯了NVMe儲存陣列在密集存取模式下的高吞吐量潛力。 4K隨機寫入操作的頻寬達到29.1 GB/s,IOPS高達7.1萬,平均延遲為0.432毫秒,即使在碎片化訪問下也展現出強大的持續寫入能力。
| HPE DL145 Gen 11 FIO 基準測試摘要 | 頻寬 – GB/s | IOPS | 平均延遲 |
|---|---|---|---|
| 順序讀取(128K) | 56.4 GB / s | 430k | 1.78毫秒 |
| 順序寫入(128K) | 45.4 GB / s | 346k | 2.22毫秒 |
| 隨機讀取 (4KB) | 46.6 GB / s | 11.4M | 0.269毫秒 |
| 隨機寫入 (4K) | 29.1 GB / s | 7.1M | 0.432毫秒 |
GPU直接儲存
我們在這個測試台上進行的測試之一是 Magnum IO GPU 直接儲存 (GDS) 測試。 GDS 是 NVIDIA 開發的功能,可讓 GPU 在存取儲存在 NVMe 磁碟機或其他高速儲存裝置上的資料時繞過 CPU。 GDS 不再透過 CPU 和系統記憶體來路由數據,而是實現了 GPU 和儲存設備之間的直接通信,從而顯著減少了延遲並提高了數據吞吐量。
GPU 直接儲存的工作原理
傳統上,當 GPU 處理儲存在 NVMe 磁碟機上的資料時,資料必須先經過 CPU 和系統內存,然後才能到達 GPU。此過程會引入瓶頸,因為 CPU 成為中間人,增加延遲並消耗寶貴的系統資源。 GPU 直接儲存使 GPU 能夠透過 PCIe 總線直接從儲存裝置存取數據,從而消除了這種低效率。這種直接路徑減少了與資料移動相關的開銷,從而實現更快、更有效率的資料傳輸。
人工智慧工作負載,尤其是涉及深度學習的工作負載,是高度資料密集的。訓練大型神經網路需要處理 TB 級的數據,資料傳輸中的任何延遲都可能導致 GPU 利用率不足和訓練時間更長。 GPU 直接儲存透過確保資料盡快傳輸到 GPU、最大限度地減少空閒時間並最大限度地提高運算效率來解決這一挑戰。
此外,GDS 對於涉及串流大型資料集的工作負載特別有利,例如視訊處理、自然語言處理或即時推理。透過減少對 CPU 的依賴,GDS 可以加速資料移動並釋放 CPU 資源用於其他任務,從而進一步增強整體系統效能。
GDSIO 順序讀取
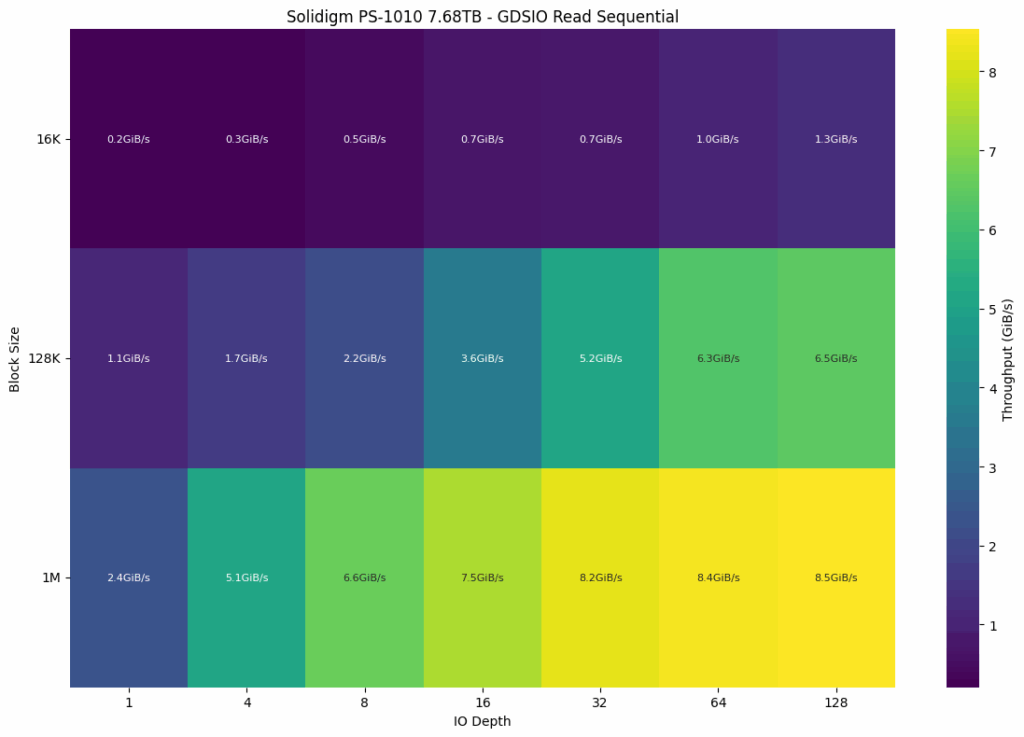
在 Solidigm PS1010 7.68TB 硬碟的 GDSIO 順序讀取測試中,效能隨區塊大小和 I/O 深度顯著變化。在最小的 16K 區塊大小下,吞吐量在佇列深度為 0.2 時僅為 1 GiB/s,並逐漸上升至 1.3 深度時的 128 GiB/s,顯示在該粒度下的可擴展性有限。當區塊大小增加到 128K 時,效能提升更為顯著,從 1.1 GiB/s 開始,在最高深度時攀升至 6.5 GiB/s。區塊大小為 1M 時獲得了最佳結果,吞吐量最初達到 2.4 GiB/s,在佇列深度為 8.5 時達到峰值 128 GiB/s,這表明硬碟的最佳效能配置是透過較大的順序讀取和更深的佇列實現的。
GDSIO 順序寫入
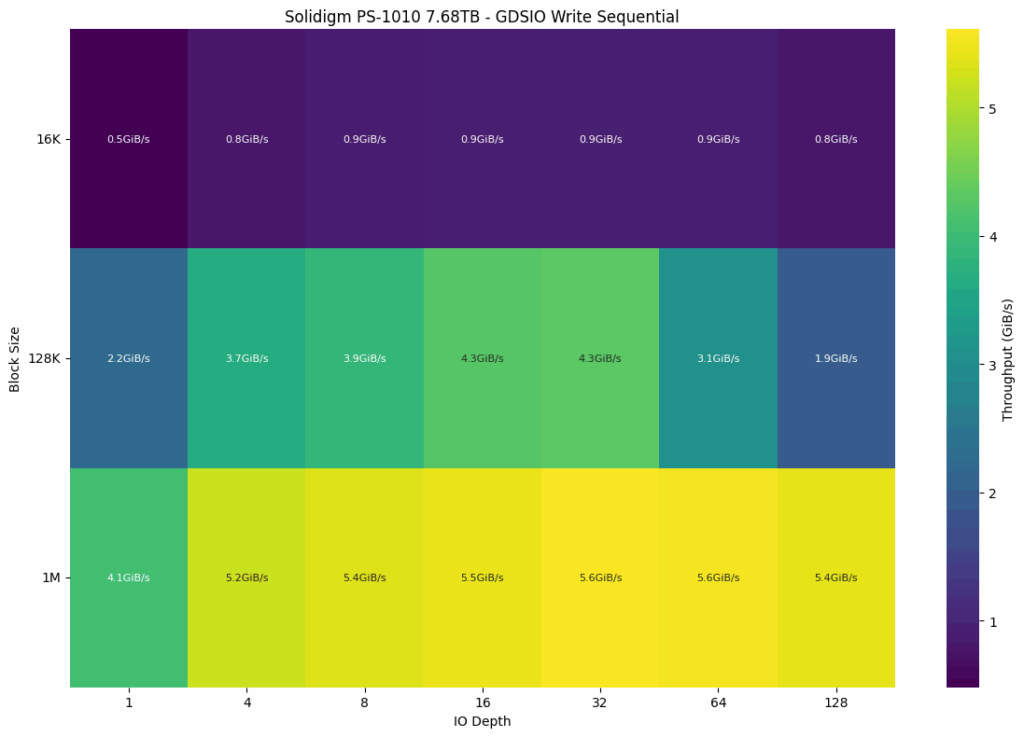
Solidigm PS1010 的順序寫入效能在較大的區塊大小下表現出良好的可擴展性,但在中等規模工作負載下,佇列深度較高時會下降。在最小的 16K 區塊大小下,寫入速度起始於 0.5 GiB/s,在佇列深度 0.9 到 8 之間達到 64 GiB/s 的峰值,然後在深度 0.8 時略微下降至 128 GiB/s。在 128K 區塊大小下,效能起始於 2.2 GiB/s,在深度 4.3 時提升至 32 GiB/s 的高點,然後在最深的隊列中下降至僅 1.9 GiB/s,這表明寫入可能已達到飽和或受到限制。在 1M 區塊大小下實現了最佳的持續效能,吞吐量從深度 4.1 時的 1 GiB/s 平穩擴展到深度 5.6 和 32 時的 64 GiB/s,並在深度 128 時保持穩定。
GDSIO 摘要
下表清楚地細分了 Solidigm D7-PS1010 SSD 上收集的 GDSIO 效能指標,包括延遲和 IOPS,測量資料分別以 16K、128K 和 1M 的區塊大小和 128 的 IOPS 進行測量。在佇列深度為 128 的情況下,延遲和 IOPS 會隨著區塊大小的變化而變化。 16K 區塊的平均讀取延遲為 1.549 毫秒,IOPS 為 82.3K,而寫入延遲為 2.429 毫秒,IOPS 為 52.6K。使用 128K 區塊時,讀取延遲增加到 2.414 毫秒(IOPS 為 52.9K),寫入延遲增加到 8.050 毫秒(IOPS 為 15.9K)。在 1M 的情況下,讀取延遲達到 14.643 毫秒(IOPS 為 8.7K),寫入延遲上升到 23.030 毫秒(IOPS 為 5.6K)。
| GDSIO 圖表(16K、128K、1M 區塊大小平均值) | HPE DL145 Gen 11(6 個 Solidigm D7-PS1010 E3s SSD 7.68TB) |
|---|---|
| (16K 區塊大小 128 IO 深度)平均讀取 | 1.3 GiB/秒(1.549毫秒)IOPS:82.3K |
| (16K 區塊大小 128 IO 深度)平均寫入 | 0.8GiB/秒(2.429毫秒)IOPS:52.6K |
| (128K 區塊大小 128 IO 深度)平均讀取 | 6.5 GiB/秒(2.414毫秒)IOPS:52.9K |
| (128K 區塊大小 128 IO 深度)平均寫入 | 1.9 GiB/秒(8.050毫秒)IOPS:15.9K |
| (1M 區塊大小 128 IO 深度)平均讀取 | 8.5 GiB/秒(14.643毫秒)IOPS:8.7K |
| (1M 區塊大小 128 IO 深度)平均寫入 | 5.4 GiB/秒(23.030毫秒)IOPS:5.6K |
邊緣媒體製作
Axle AI 是什麼?
Axle AI 是一個基於 AI 的本地媒體資產管理 (MAM) 平台,旨在簡化中小型媒體團隊的視訊工作流程。它可以自動執行關鍵任務,例如採集、標記和媒體搜索,而無需承擔傳統 MAM 系統的成本或複雜性。 Axle AI 專為速度和易用性而設計,讓團隊無論在辦公室還是遠距辦公,都能更有效率地管理和交付內容。
該平台支援整個製作流程。它自動採集素材、創建代理、使用物件識別、臉部偵測和語義搜尋等功能應用人工智慧驅動的元數據,並與 Adobe Premiere Pro 和 DaVinci Resolve 等行業標準編輯工具整合。這使得團隊能夠快速定位、編輯和發佈內容,避免瓶頸或延遲。
現實世界的用例
Axle AI 深受各類媒體團隊的信賴,包括廣播公司、紀錄片製作人、企業影片部門、行銷代理商以及現場活動製作人。這些團隊通常跨地域辦公,需要可靠地存取其媒體庫,而無需繁重的基礎設施。
透過 Axle AI,使用者可以透過基於瀏覽器的介面進行遠端協作,該介面可即時存取代理媒體。剪輯師可以在其首選的非線性編輯系統 (NLE) 中立即開始剪輯素材,而製片人和相關人員則可以即時審查、標記或批准剪輯片段(無需傳輸大文件或具備專業技術技能)。
無論您的團隊規模是五人還是五十人,Axle AI 都能實現更快、更有效率的工作流程。其簡潔的介面、快速的部署以及與現有儲存系統的兼容性,使其成為大批量分散式媒體製作的智慧解決方案。
對即時社交媒體的強烈需求大大加快了媒體製作的速度。這種心態非常普遍,「不爭第一,就是最後」的心態,尤其是在直播活動及其相關的內容創作方面。媒體公司需要一種有效率的方式來組織和快速審查大量素材。像 Axle AI 這樣的工具,能夠縮減到小規模操作,使這種工作流程在現場變得切實可行。如果與適當的工作流程(例如可以同時錄製代理檔案和原始素材的攝影機)搭配使用,效率將會大幅提升。
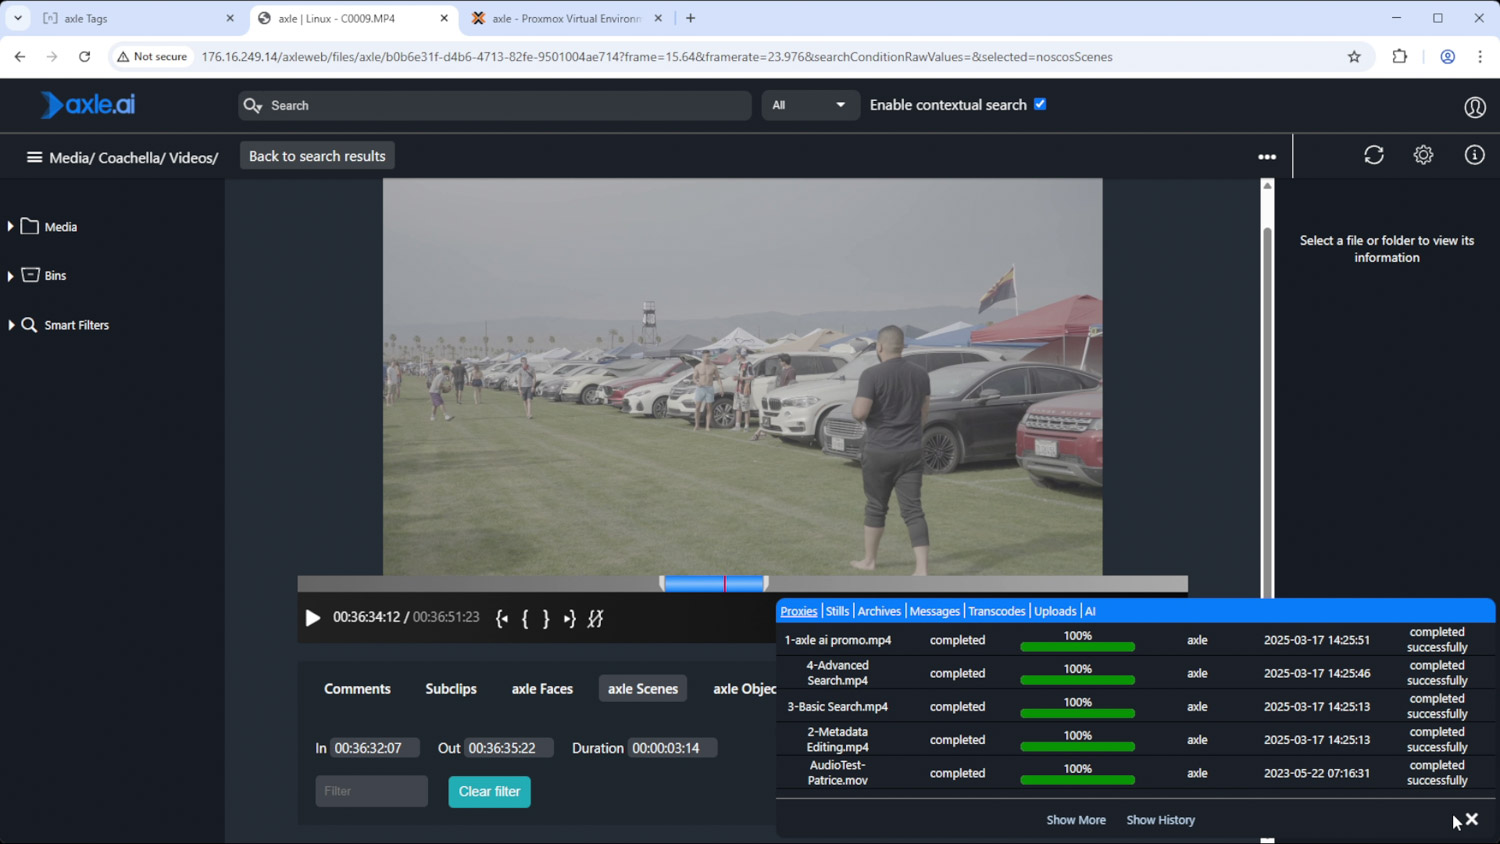
在採集時同時保存高解析度和低解析度代理媒體,並在 Axle AI 標籤中立即處理較小的代理文件,幾乎可以立即搜尋所有素材。 Axle AI 與大多數主流非線性編輯軟體(例如 Adobe Premiere Pro、DaVinci Resolve 和 Avid Media Composer)的集成,讓剪輯師可以立即開始工作。這也大大減輕了製作團隊的負擔,使他們能夠專注於其他任務或避免倦怠。
傳統上,記錄一直是媒體採集工作流程中最費力且最常被忽略的環節之一。 Axle AI 會使用 AI 產生的場景描述(而非傳統的元資料欄位)自動記錄媒體,讓剪輯師在仔細查看片段內容之前就能讀取其中的內容。它還提供語義搜尋工具,使剪輯師和製作人能夠使用概念和主題快速找到相關素材,而無需依賴特定的標籤。
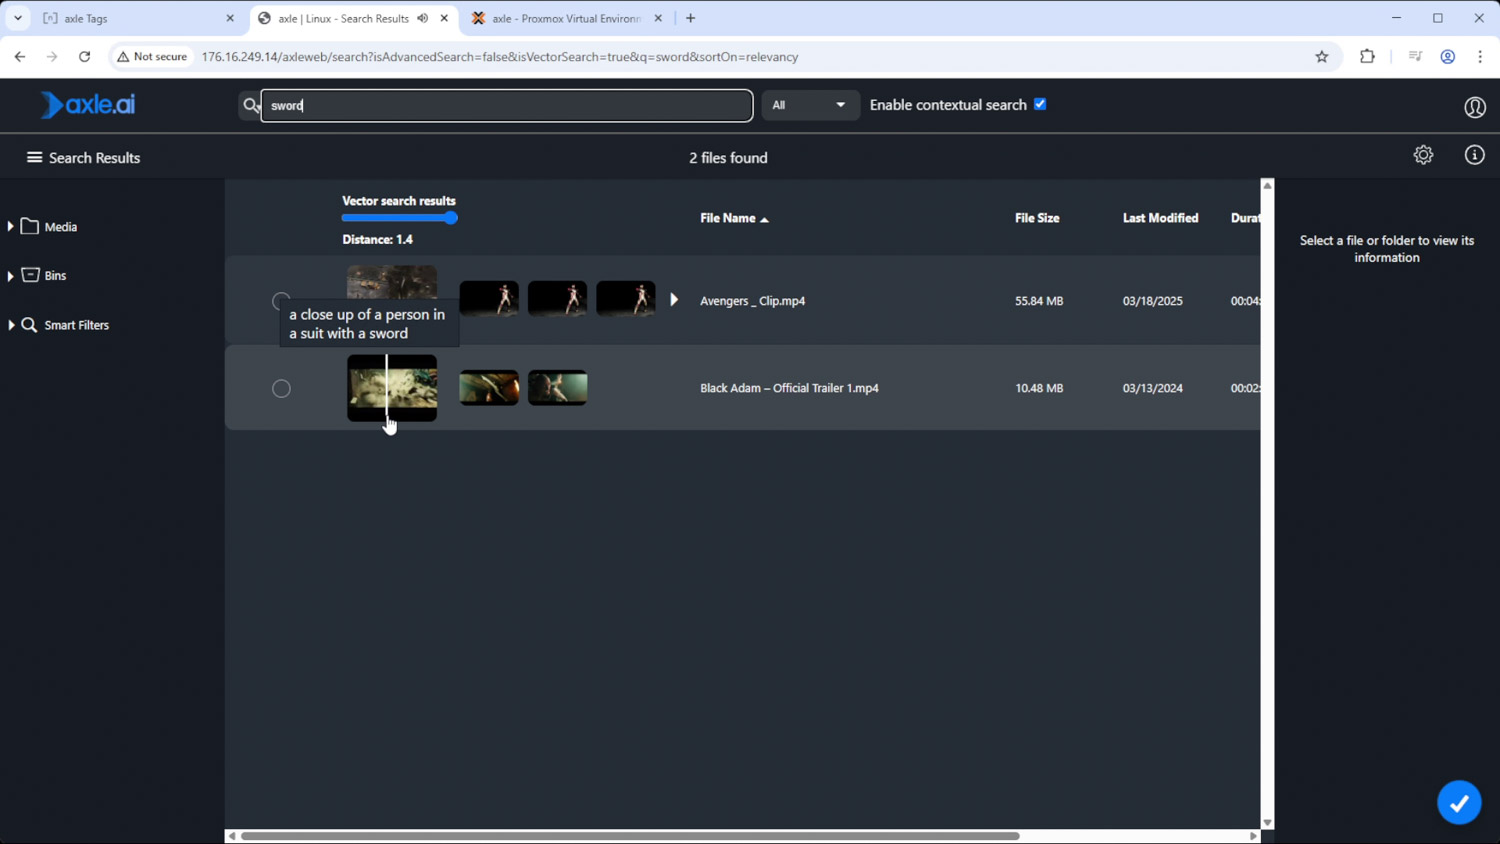
可擴展性也至關重要,因為並非所有工作都需要快節奏的現場媒體製作。 Axle AI 可以安裝在功能更強大的固定係統上,並透過網路共享存取媒體公司積壓的素材。這使得編輯和製作人能夠更快地找到相關媒體,甚至發現他們之前可能沒有考慮過的、在檔案庫中「遺失」的素材。內容創作者和廣播公司可以從這種積壓索引中受益匪淺,從原本閒置在伺服器上的媒體中創造更多價值。雖然它並非萬無一失,但它可以幫助媒體公司在媒體創作過程中一些最耗時的環節上搶佔先機。
HPE ProLiant DL145 Gen11 作為此邊緣 AI 部署的硬體基礎,在緊湊的空間內實現了運算密度、儲存吞吐量和 GPU 加速之間的完美平衡。該系統搭載 48 核心 AMD EPYC 8434P 處理器,該處理器屬於節能型 8004 系列,針對多執行緒工作負載進行了最佳化,同時保持了低功耗。此配置包括 256GB RAM 和單一 NVIDIA L4 GPU,這是一款高效的加速器,非常適合邊緣 AI 推理。儲存配置了六個 Solidigm D7-PS1010 E3.S SSD,每個 SSD 的容量為 7.68TB,為媒體資產和元資料密集型工作負載提供了充足的高效能快閃記憶體。 DL3 Gen145 支援最多三個單寬 GPU 和總共六個 E11.S 驅動器,能夠根據要求嚴苛的視訊和 AI 用例進行擴充。此設定強調了精心組裝現代硬體組件(包括 CPU、GPU 和 SSD)的重要性,以便為邊緣為中心的 AI 工作流程(例如由 Axle AI 提供支援的工作流程)提供卓越的效能。
結語
Axle AI 正在改變影片內容的製作方式,尤其適用於資源有限的即時工作團隊。透過將智慧媒體資產管理與強大的推理工具結合,Axle AI 實現了傳統媒體資產管理 (MAM) 系統無法比擬的自動化和回應速度。我們建置的裝置與 HPE ProLiant DL145 Gen11 邊緣伺服器、NVIDIA L4 GPU 和 Solidigm Gen5 SSD 搭配使用,可提供針對現代媒體工作流程最佳化的緊湊型高效能環境。無論是在現場使用還是作為混合編輯流程的一部分,此配置都提供了一種可擴展且高效的方式,可以比以往更快地提取、標記、搜尋和交付影片內容,同時不會影響品質或控制。對於那些需要在快節奏的內容環境中保持領先的團隊來說,邊緣基礎設施與 AI 輔助工作流程的結合將帶來顯著的競爭優勢。



 Amazon