

MSI XpertStation WS300 je postavený na najnovšej architektúre DGX Station od spoločnosti NVIDIA, ktorá je doteraz najvýkonnejšou generáciou a umiestňuje plnohodnotný uzol Grace Blackwell Ultra GB300 vedľa vášho stola. Hlavným číslom je 20 petaFLOPS výpočtového výkonu FP4, ktoré poskytuje jediná grafická karta Blackwell Ultra pripojená k 72-jadrovému procesoru Grace cez prepojenie NVLink-C2C s rýchlosťou 900 GB/s. Oba procesory čerpajú z jedného koherentného pamäťového fondu s kapacitou 748 GB; 252 GB HBM3e spárovaného so 496 GB LPDDR5X, čo stačí na uloženie modelu s biliónovými parametrami v lokálnej pamäti.
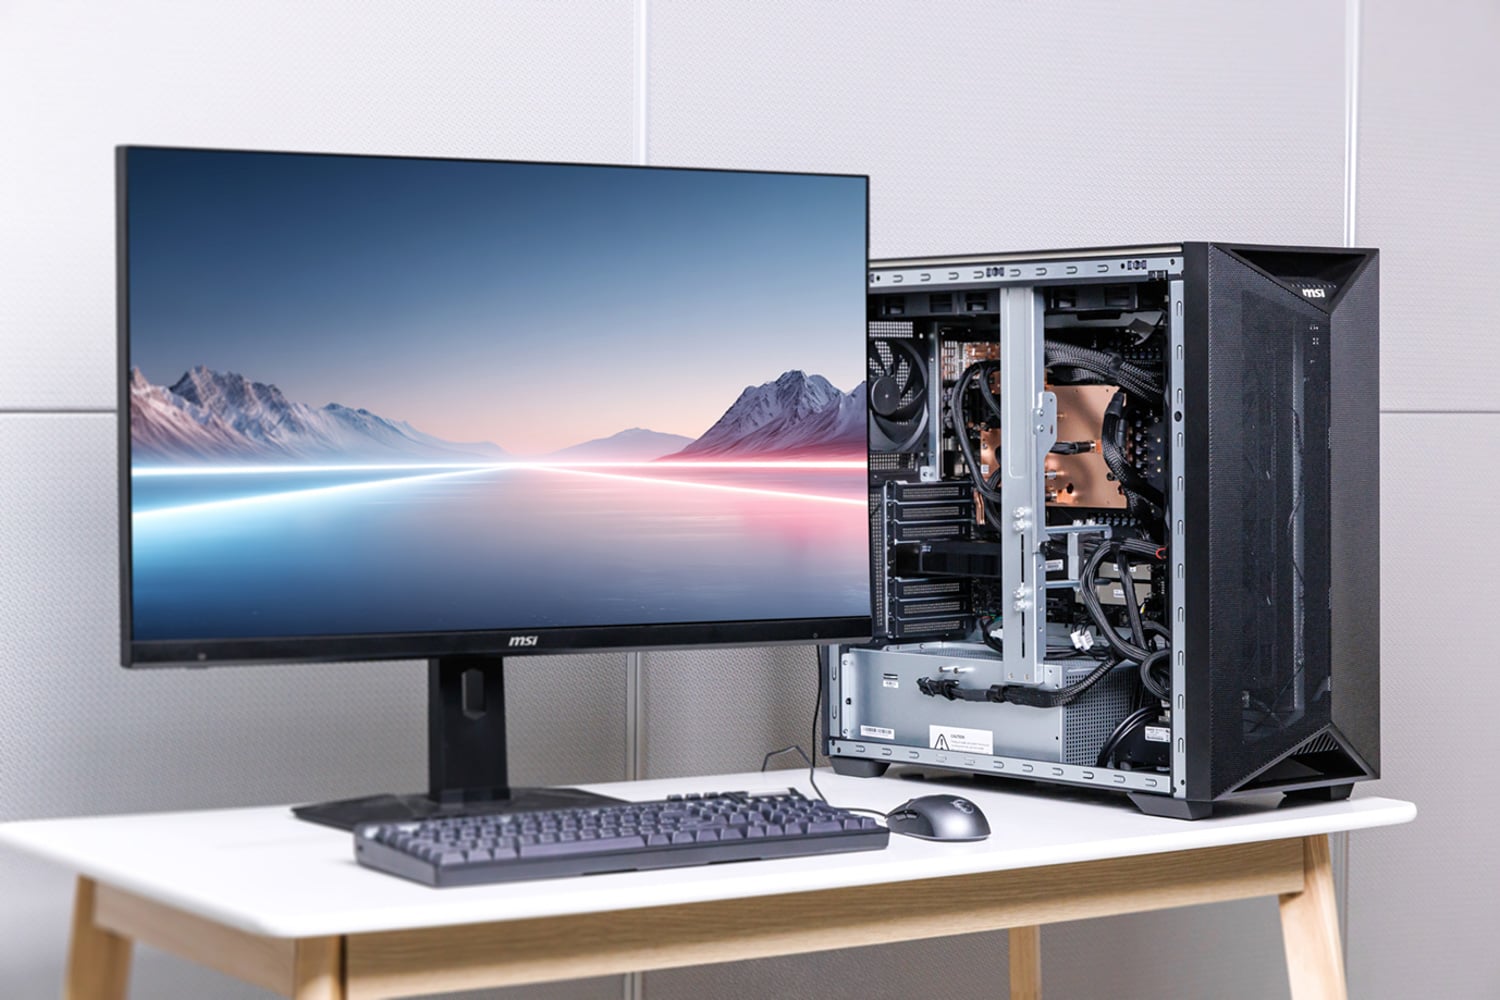
Stanica DGX tiež podporuje klastrovanie viacerých jednotiek pomocou svojho adaptéra ConnectX-8 SuperNIC, ktorý poskytuje dva 400GbE porty pre 800 Gb/s siete. Výsledkom je stroj dátovej triedy, ktorý môže bežať doma alebo v kancelárii, a nie v serverovni.
Technické špecifikácie stanice NVIDIA DGX
XpertStation WS300 je implementáciou platformy GB300 DGX Station od spoločnosti MSI. NVIDIA dodáva základnú dosku a softvérové prostredie Grace Blackwell Ultra, zatiaľ čo MSI dodáva šasi, kvapalinové chladenie, napájanie, rozloženie úložiska, externé I/O a servisný model, vďaka čomu sa platforma mení na kompletný systém pre stolný počítač. Keďže procesor Grace, grafický procesor Blackwell Ultra, prepojenie NVLink-C2C a sieť ConnectX-8 sú pevné, skutočný rozdiel medzi OEM výrobcami spočíva v tom, ako efektívne okolitý systém udržiava, spravuje a sprístupňuje tento hardvér. Spoločnosť MSI mala tento systém nakonfigurovaný so štyrmi 2TB Micron 4600 Gen5 M.2 SSD diskami na testovanie. Dva SSD disky boli nakonfigurované v RAID1 pre úložisko pre bootovanie, zatiaľ čo ďalšie dva boli samostatné SSD disky pre odkladací priestor alebo iné použitie.
| špecifikácia | podrobnosti |
|---|---|
| architektúra | |
| CPU | NVIDIA Grace, 72-jadrový Arm Neoverse V2 |
| GPU | NVIDIA Blackwell Ultra (B300) |
| Tenzorové jadrá | 5th Generation |
| Prepojenie CPU-GPU | NVLink-C2C, 900 GB/s obojsmerne |
| Memory Masážne stoly | |
| Koherentná pamäť | Až 748 GB |
| Pamäť GPU | Až 252 GB HBM3e |
| Šírka pásma pamäte GPU | 7.1 TB / s |
| Pamäť CPU | Až 496 GB LPDDR5X (4 x SOCAMM) |
| Šírka pásma pamäte CPU | 396 GB / s |
| Uskladnenie | |
| Spúšťacie jednotky | 2 x M.2 2280 PCIe 5.0 x4 NVMe (pripojené k CPU), osadené 2 x 2TB Micron 4600 Gen5 v RAID 1 |
| Rozširujúce disky | 2 x M.2 2280 PCIe 5.0 x4 NVMe (s pripojeným rozhraním ConnectX-8), osadené na testovanie s 2 x 2TB Micron 4600 Gen5 |
| networking | |
| NIC | NVIDIA ConnectX-8 SuperNIC, 2 x 400G QSFP112 (agregát 800 Gb/s) |
| Ethernet | 1 x 10GBase-T RJ45 (Marvell AQC113) |
| Port pre správu | 1 x 1000Base-T RJ45 (vyhradený mimo pásma) |
| Bezdrôtový | Slot M.2 2230 Key-E, PCIe 2.0 x1 (Wi-Fi 6E / Wi-Fi 7, Bluetooth) |
| expanzia | |
| PCIe sloty | 1 x PCIe 5.0 x16 FHFL s dvojitou šírkou; 2 x PCIe 5.0 x16 FHFL s jednou šírkou (x8 signály) |
| Podporované doplnkové grafické karty | NVIDIA RTX PRO 2000 Blackwell, RTX PRO 4000 Blackwell SFF, RTX PRO 6000 Blackwell Workstation / Max-Q |
| Predné/horné vstupy/výstupy | |
| USB | 2 x USB 3.2 Gen 2 typu A; 2 x USB 3.2 Gen 2 typu C (5V/3A) |
| Audio | 2 x jacky (linkový výstup / mikrofón) |
| Zadný vstup / výstup | |
| USB | 4 x USB 10 Gb/s typu A; 1 x Micro-USB COM (sériová konzola) |
| zobraziť | 1 x Mini DisplayPort (BMC video, max. 1024 x 768, bez DP++) |
| Audio | 3 x jacky (linkový vstup / linkový výstup / mikrofón) |
| Správa a bezpečnosť | |
| BMC | ASPEED AST2600 s firmvérom AMI MegaRAC, IPMI 2.0 a Redfish, lokálne úložisko eMMC |
| zabezpečenia | TPM 2.0, narušenie šasi, hardvérový koreň dôveryhodnosti Microchip CEC1736 (ERoT) |
| Chladenie | |
| Chladenie kvapalinou | Modul kvapalinového chladenia s výkonom 1400 W pre CPU + GPU s blokmi na GPU, CPU, pamäti a ConnectX-8 |
| Radiátory / Ventilátory | 2 x 360 mm radiátory; 1 x systémový ventilátor 12025 |
| Výkon | |
| Zdroj | 1 x 1600W ATX, 80 PLUS Platinum (150 x 86 x 210 mm) |
| Vstup AC | 100 – 114 V striedavého prúdu, 15 A, 47 – 63 Hz (max. výkon 1 300 W); 115 – 240 V striedavého prúdu, 15 – 8 A, 47 – 63 Hz (max. výkon 1 600 W) |
| Form Factor | |
| Rozmery | 245.7 x 529.0 x 570.4 mm (9.67 x 20.83 x 22.46 palca), Š x V x H |
Navrhujte a budujte
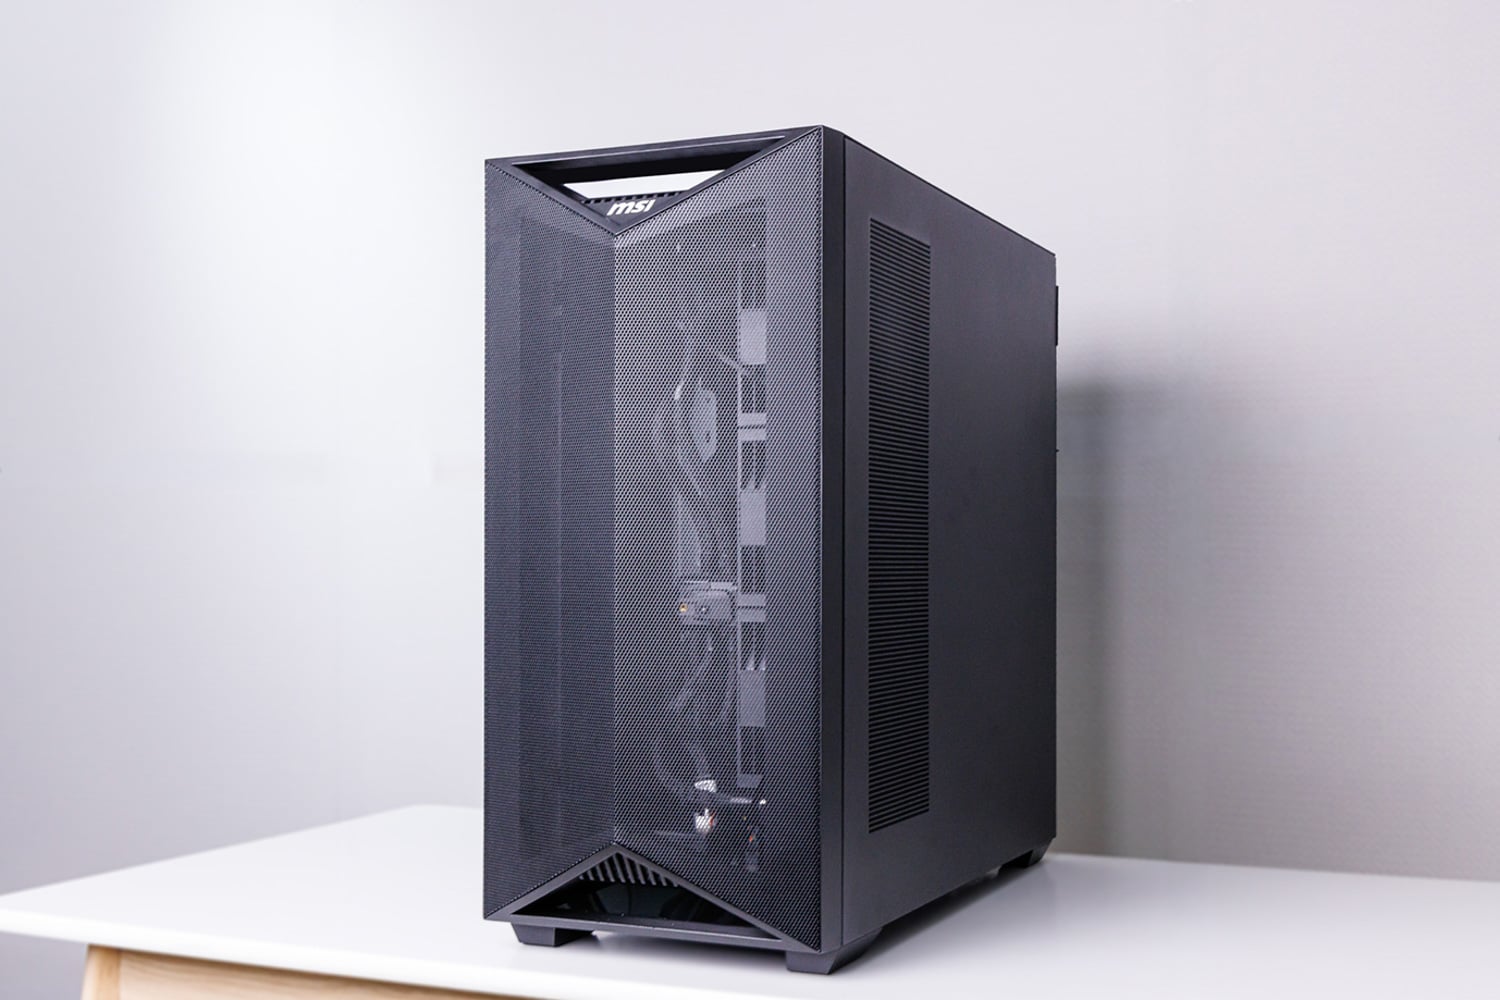
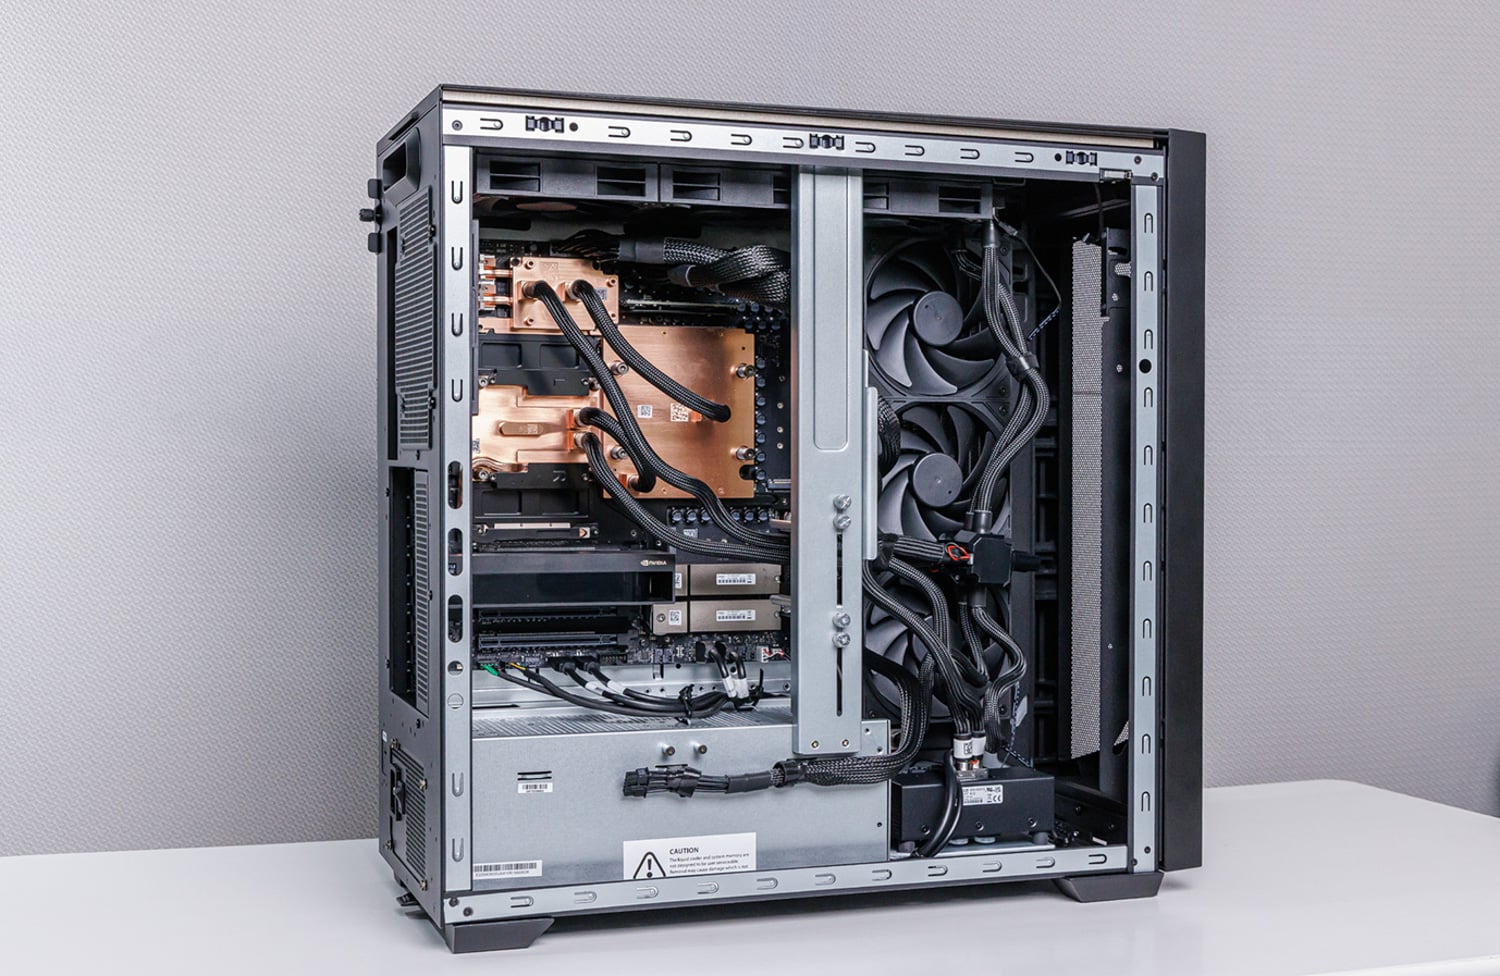
Na prvý pohľad vyzerá XpertStation ako štandardná moderná pracovná stanica s elegantným profesionálnym dizajnom. Po odmontovaní bočného panela sa podobnosť končí.
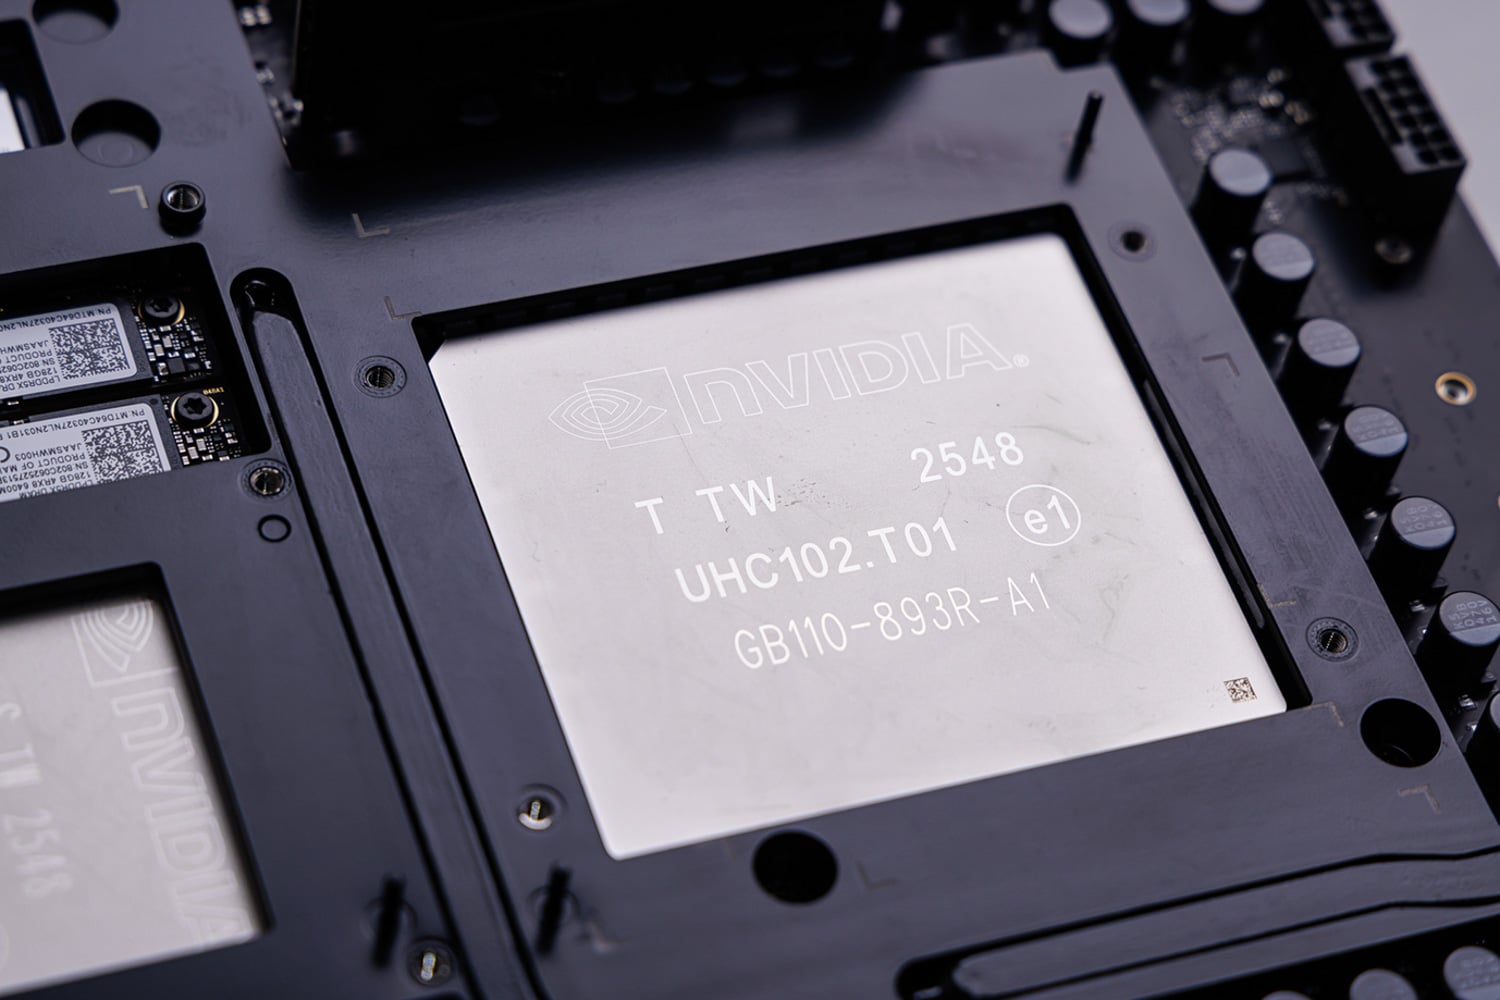
Superčip GB300 Grace Blackwell Ultra pre stolné počítače
V centre pozornosti WS300 je naša hviezda programu: grafický procesor NVIDIA B300, postavený na architektúre Blackwell Ultra.
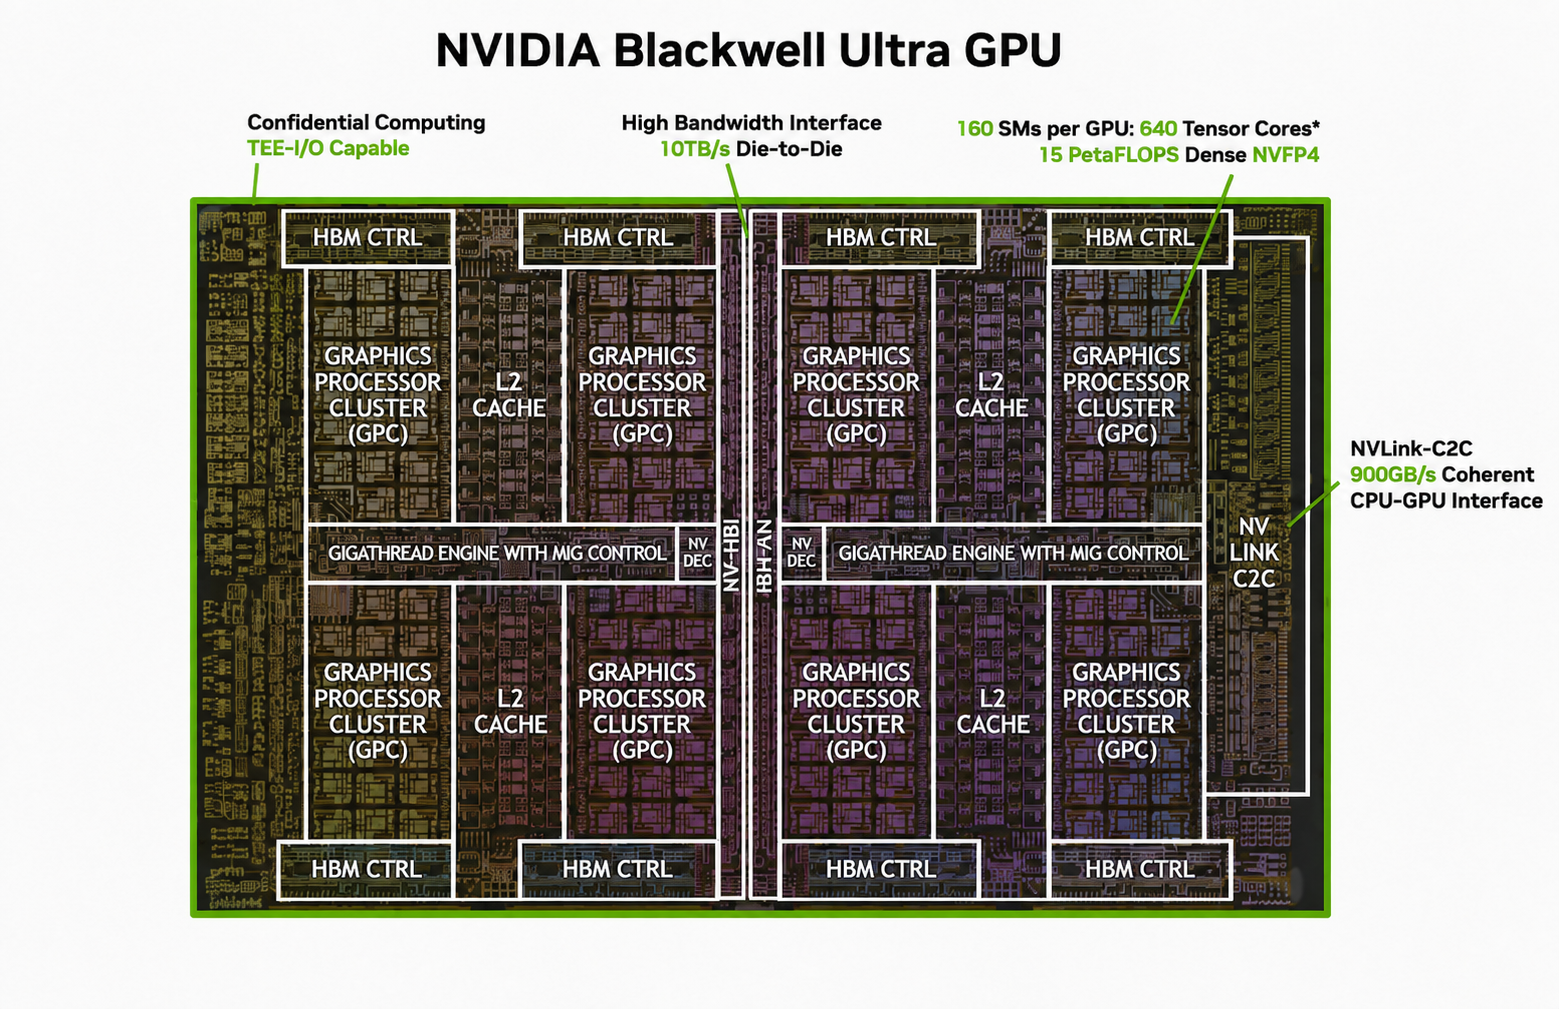
Zdroj: NVIDIA, anotované StorageReview
B300 je jednou z najpokročilejších GPU dostupných v súčasnosti, ktorá sa vyznačuje dizajnom s dvojitou reticle konštrukciou postavenou na procese 4NP od TSMC. Dva čipy sú spojené rozhraním NVIDIA NV-HBI 10TB/s chips-to-chips, čo umožňuje GPU fungovať ako jeden CUDA akcelerátor. B300 použitá v DGX Station je založená na dizajne Blackwell Ultra s 208 miliardami tranzistorov, s až 160 SM a 640 Tensor jadrami piatej generácie. Je tiež vybavená 252 GB HBM3e s pamäťovou šírkou pásma 7.1 TB/s. Ako súčasť dátového centra B300 nemá normálny zobrazovací výstup a hardvérové enkodéry NVENC. Obsahuje však sedem NVDEC enginov a sedem dekodérov nvJPEG. GPU tiež podporuje MIG, čo umožňuje jeho rozdelenie až do siedmich izolovaných inštancií. Z hľadiska výpočtovej kapacity B300 ponúka:
| Presnosť | Špičkový výkon |
|---|---|
| Výpočtový výkon B300 | |
| Tenzorové jadro NVFP4 | 20 PFLOPS riedke / 15 PFLOPS husté |
| Tenzorové jadro FP8 / FP6 | 10 PFLOPS |
| INT8 Tensor Core | 330 TOPS |
| Tenzorové jadro FP16 / BF16 | 5 PFLOPS |
| TF32 Tensor Core | 2.5 PFLOPS |
| FP32 | 80 TFLOPS |
| Tenzorové jadro FP64 / FP64 | 1.3 TFLOPS |
| Špičkové frekvencie sú založené na taktovaní grafického procesora. Špecifikácie Tensor Core používajú riedkosť, pokiaľ nie je uvedené inak. | |
S procesorom B300 je spárovaný Grace, prvý procesor od spoločnosti NVIDIA pre dátové centrá. Používa 72 jadier Arm Neoverse V2, ale okolitý procesor je vlastným návrhom spoločnosti NVIDIA, vrátane hierarchie vyrovnávacej pamäte, radičov pamäte, systémového I/O, škálovateľnej koherenčnej štruktúry a rozhrania NVLink-C2C. Grace sprístupňuje 72 jadier a 72 hardvérových vlákien, pričom každé jadro implementuje Armv9 s kryptografickými rozšíreniami a štyrmi 128-bitovými vektorovými jednotkami SVE2. Jadro má šesťcestný dekodér inštrukcií schopný odosielať až osem inštrukcií za hodinu, šesť skalárnych ALU, 64 KB vyrovnávacej pamäte L1 pre inštrukcie a dáta a 1 MB súkromnej L2. CPU zdieľa 114 MB vyrovnávacej pamäte L3 naprieč čipom.
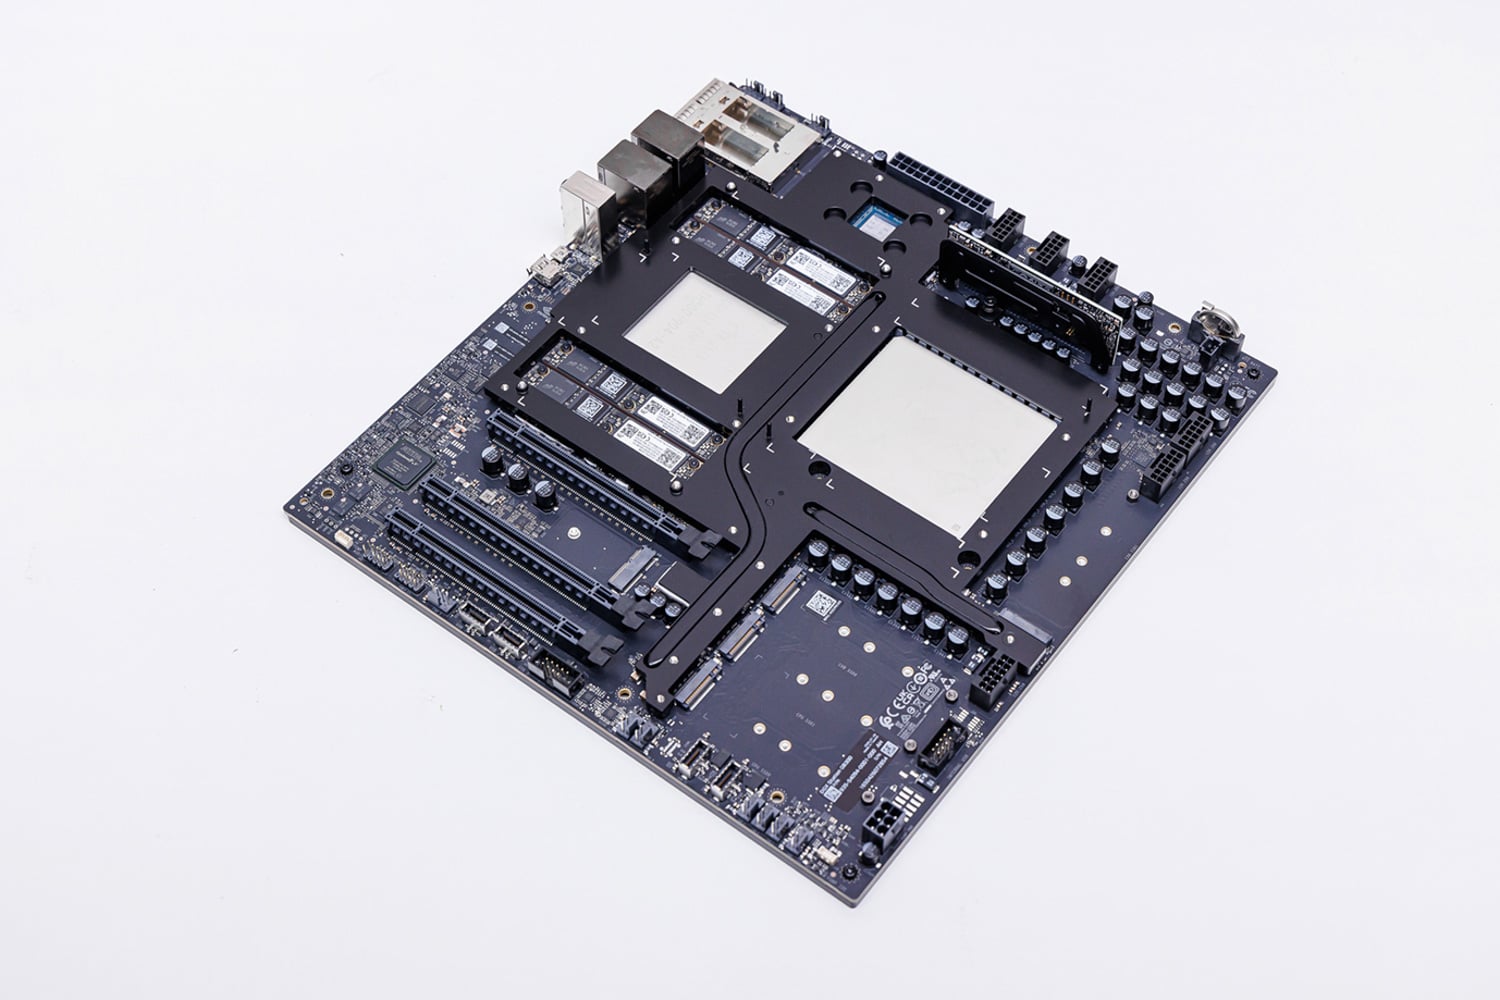
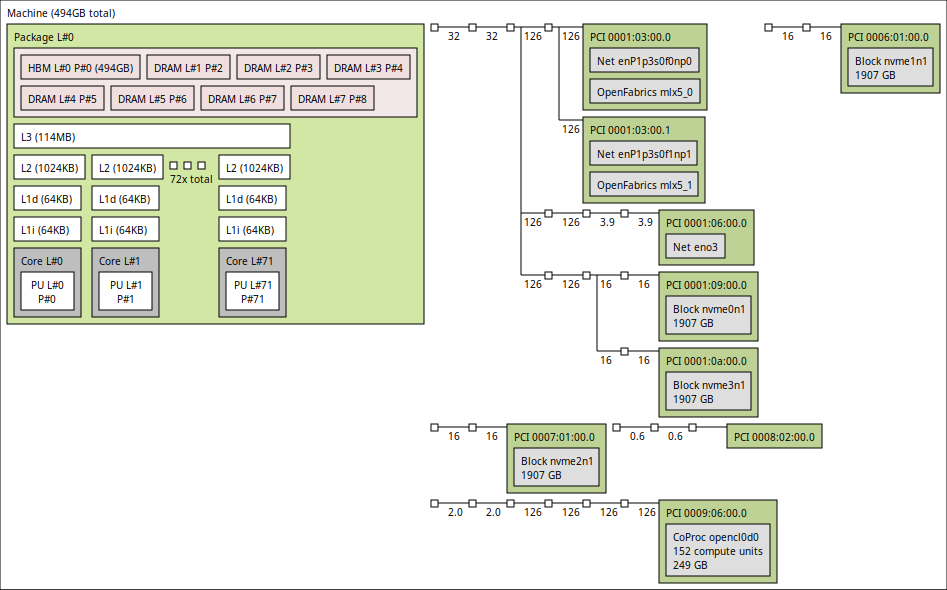
Jadrá a segmenty vyrovnávacej pamäte L3 sú prepojené prostredníctvom škálovateľnej koherenčnej štruktúry (Scalable Coherency Fabric) od spoločnosti NVIDIA, čo je sieťové prepojenie s bisekčnou šírkou pásma 3.2 TB/s. Táto štruktúra tiež spája jadrá CPU s pamäťou, systémovými I/O operáciami a rozhraním NVLink-C2C, čo poskytuje Grace šírku pásma pre pohyb dát potrebnú na udržanie napájania B300. Vo WS300 sa Grace stará o prácu na strane CPU, ktorá obklopuje akcelerátor: spúšťanie jadra GPU, načítavanie dát, predspracovanie, tokenizáciu a orchestráciu modelov. Nižšie uvedený topologický pohľad poskytuje jasný pohľad na jedno-socketový dizajn s jedným 72-jadrovým CPU Grace a zariadeniami platformy pripojenými okolo neho.
Grace je spárovaná so 496 GB pamäte LPDDR5X, ktorá poskytuje šírku pásma 396 GB/s. Namiesto priameho spájkovania pamäte k základnej doske používa DGX Station štyri moduly SOCAMM. SOCAMM alebo System-on-Chip Advanced Memory Module obsahuje LPDDR5X v kompaktnom, odnímateľnom prevedení. To umožňuje platforme zachovať výhody šírky pásma a energetickej účinnosti LPDDR5X a zároveň zabezpečiť prevádzkyschopnosť pamäte. Chybný modul je možné vymeniť bez výmeny celej základnej dosky.
Grace a B300 spája rozhranie NVIDIA NVLink-C2C, čo je prepojenie na úrovni balíka, ktoré poskytuje obojsmernú šírku pásma 900 GB/s, čo je zhruba sedemkrát viac ako pripojenie PCIe Gen5 x16. Dôležitejším rozdielom je koherencia pamäte. V konvenčnej pracovnej stanici si CPU a samostatná grafická karta udržiavajú oddelené pamäťové priestory, pričom dáta sa medzi nimi kopírujú cez PCIe. Vďaka NVLink-C2C zdieľajú Grace a B300 koherentný adresný priestor, čo umožňuje každému procesoru priamo pristupovať k pamäti pripojenej k druhému.
Výsledkom je 748 GB koherentný adresný priestor, nie 748 GB blok HBM. B300 má 252 GB HBM3e s rýchlosťou 7.1 TB/s, zatiaľ čo Grace prispieva 496 GB LPDDR5X s rýchlosťou 396 GB/s. Dáta uložené v pamäti Grace musia stále prechádzať cez prepojenie C2C, takže HBM zostáva najlepším umiestnením pre často používané váhy modelov, tenzory a vyrovnávacie pamäte. Pamäť Grace namiesto toho funguje ako veľkokapacitná vrstva, ktorá umožňuje, aby pracovné zaťaženia presahujúce 252 GB lokálnej pamäte B300 zostali na jednom systéme, a nie sú rozdelené medzi viacero GPU. Vplyv prechodu na túto druhú pamäťovú vrstvu na výkon zmeriame neskôr v testovacej časti.
Topológia systému
Bloková schéma od MSI, ktorá sa odvíja od balíka GB300, ukazuje, ako je zvyšok systému pripojený okolo Grace. CPU sa nachádza v strede topológie I/O a priamo k nemu sú pripojené dva sloty PCIe 5.0 x4 M.2. MSI ich osadzuje dvojicou 2TB SSD diskov Micron 4600 konfigurovaných v RAID 1 pre operačný systém a softvérový stack NVIDIA. Tri rozširujúce sloty plnej dĺžky tiež pochádzajú priamo z Grace, s jedným prepojením PCIe 5.0 x16 a dvoma prepojeniami PCIe 5.0 x8.
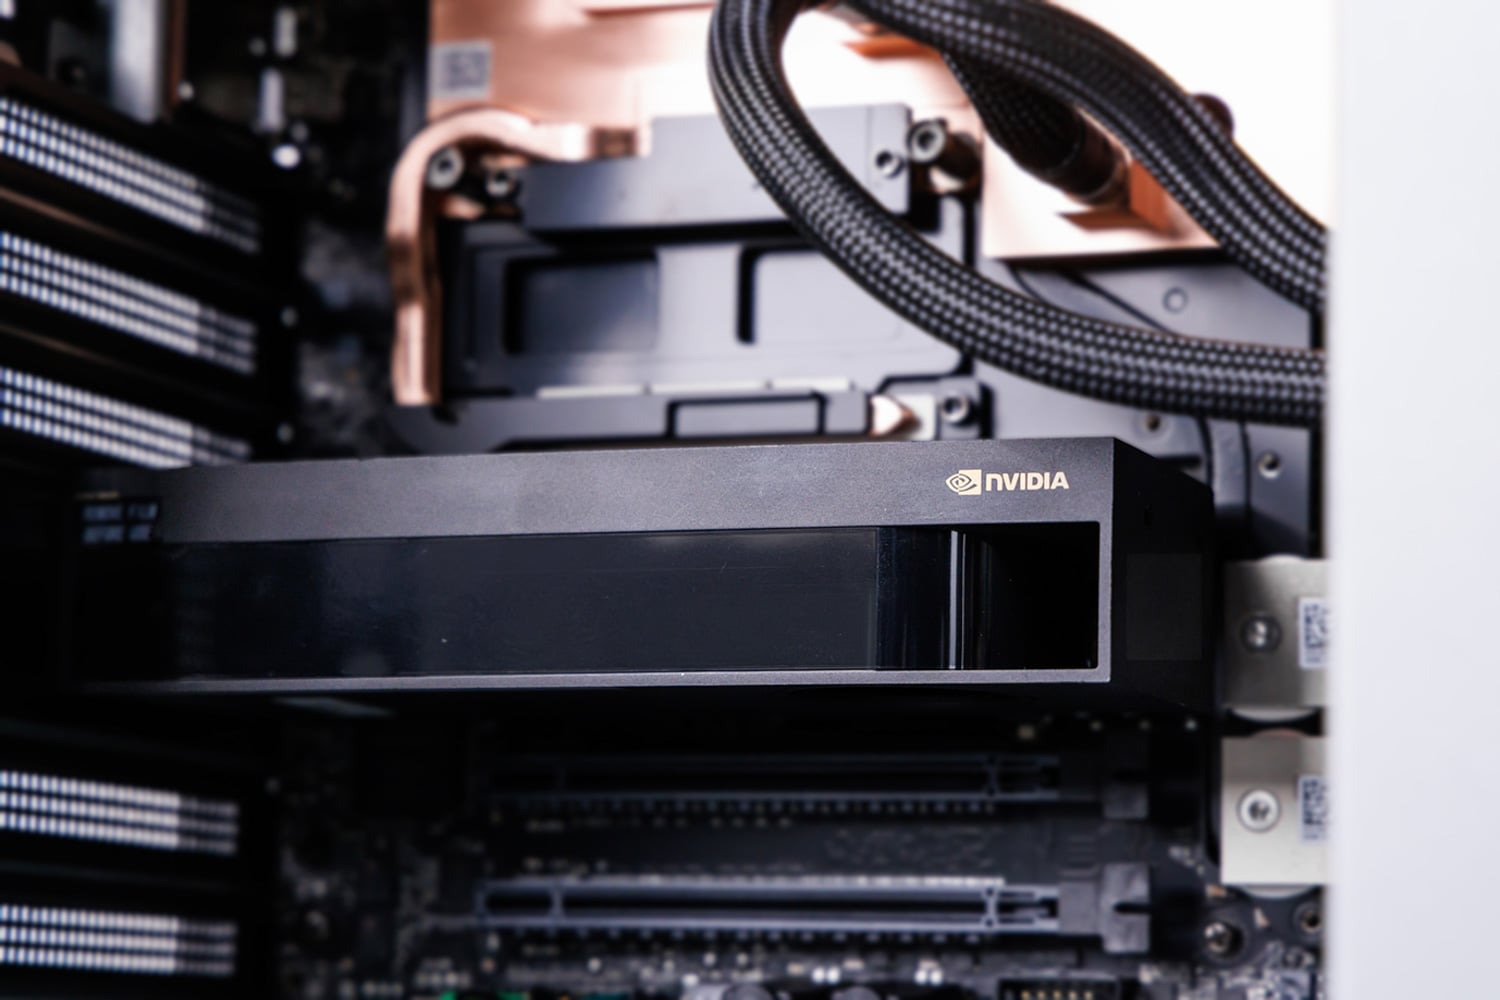
Spoločnosť MSI tiež pripravila šasi pre veľkú prídavnú grafickú kartu. Predpripravený napájací kábel 12VHPWR je ľahko dostupný na prednej strane šasi, takže nie je potrebné viesť ďalší kábel cez systém. Vertikálna kovová výstuha, ktorá spevňuje šasi, obsahuje aj konzolu proti prehýbaniu na podporu dlhých a ťažkých grafických kariet RTX PRO.
USB ovládač na strane Grace spravuje hlavné predné a zadné USB porty systému spolu so zvukovým kodekom. Grace sa tiež pripája k riadiacej jednotke ASPEED AST2600 BMC, ktorá poskytuje vyhradený 1GbE port pre správu, výstup Mini DisplayPort obmedzený na rozlíšenie 1024 x 768 a sériový port Micro-USB pre konzolu. Mini DisplayPort je určený na počiatočné nastavenie a riešenie problémov, nie ako primárny zobrazovací výstup systému. Každý, kto plánuje používať WS300 ako bežný stolný počítač, bude stále potrebovať jednu z voliteľných prídavných kariet RTX PRO.
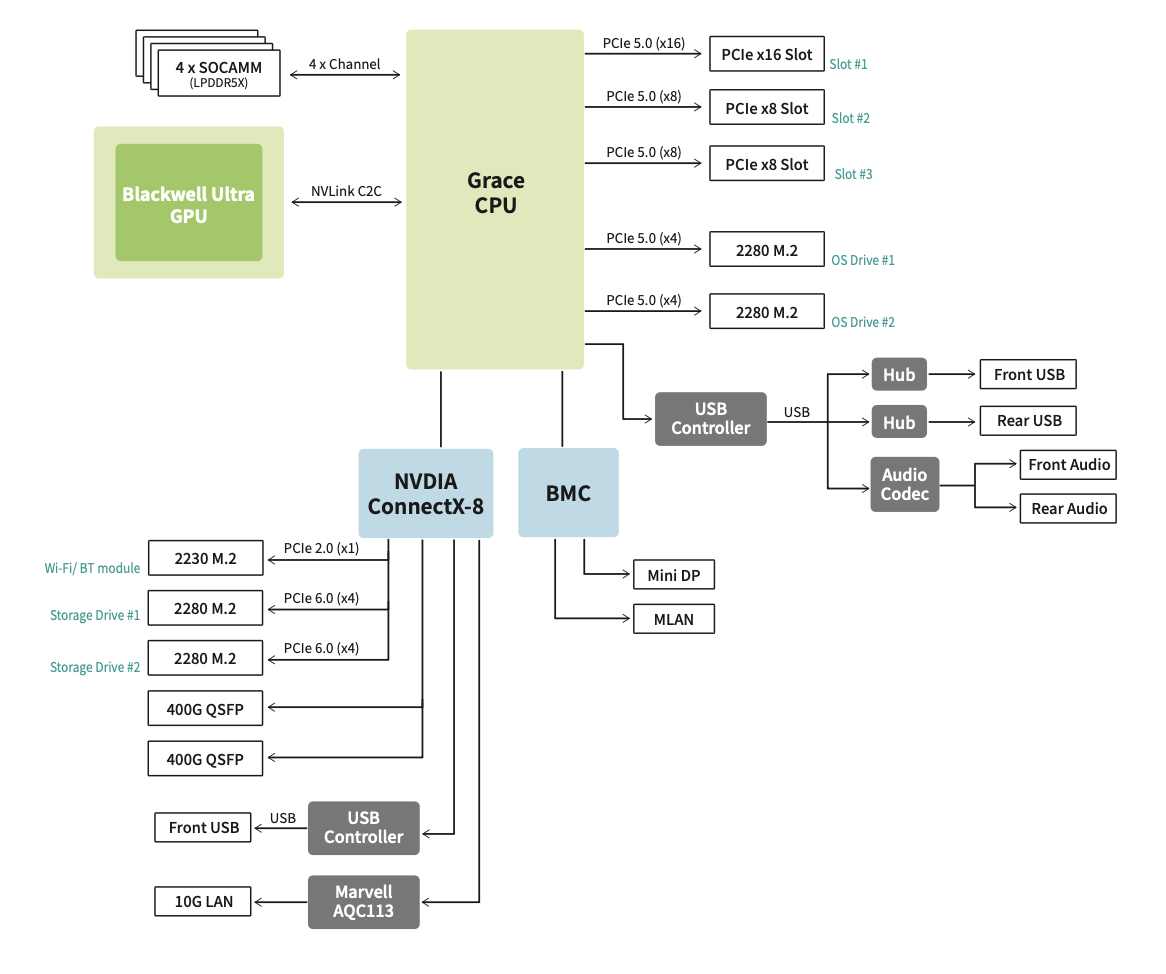
Ďalšou významnou vetvou je sieťová karta NVIDIA ConnectX-8 SuperNIC. Jej najviditeľnejším prvkom je dvojica 400GbE QSFP112 portov na zadnom paneli, ktoré poskytujú celkovú šírku pásma siete až 800 Gb/s. ConnectX-8 tiež obsahuje integrovaný prepínač PCIe so 48 linkami; jeho upstream port je kompatibilný s PCIe Gen6, ale downstream porty, ktoré sprístupňuje zariadeniam, fungujú na PCIe 5.0, čo umožňuje spoločnosti MSI používať ju ako sekundárny I/O rozbočovač a nie len ako sieťový adaptér.
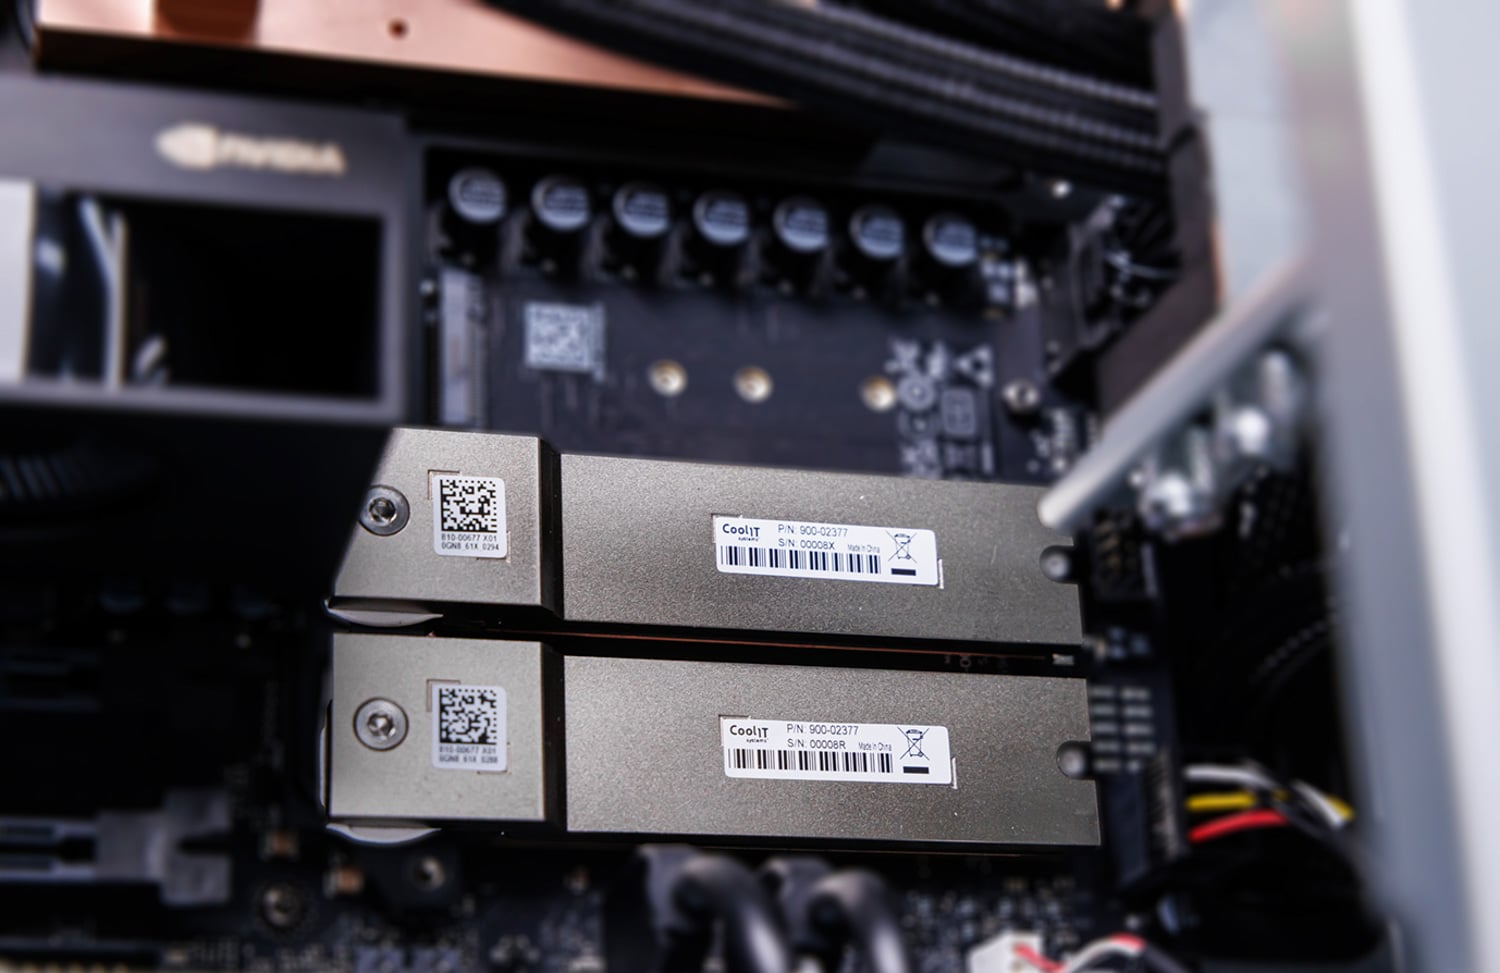
Dva porty PCIe 5.0 x4 z ConnectX-8 napájajú zostávajúce sloty M.2 2280, ktoré spoločnosť MSI ponecháva otvorené pre rozšírenie. Tá istá vetva tiež pripája slot M.2 2230 Wi-Fi a Bluetooth cez PCIe 2.0 x1, radič Marvell AQC113 pre port 10GBase-T a druhý radič USB, ktorý slúži ako dodatočná USB cesta na prednom paneli.
Napájanie a chladenie
WS300 je napájaný jedným 1 600 W zdrojom 80 PLUS Platinum ATX so vstupom C19. Pre inštalácie v Severnej Amerike vyžaduje stanica DGX vyhradený 20 A obvod, aby systém dosiahol plný výkon.
Menovitý výkon 1 600 W je stropom pre celý systém. Grace, B300, úložisko, čerpadlá, ventilátory a akákoľvek voliteľná karta RTX PRO sú napájané z rovnakého zdroja. Pridanie grafickej karty s vysokým výkonom rozširuje možnosti WS300, ale systém nečerpá z iného zdroja energie. Keď sú B300 aj karta RTX pod záťažou, musia zdieľať to, čo je už k dispozícii, čo môže znížiť výkon grafickej karty B300.
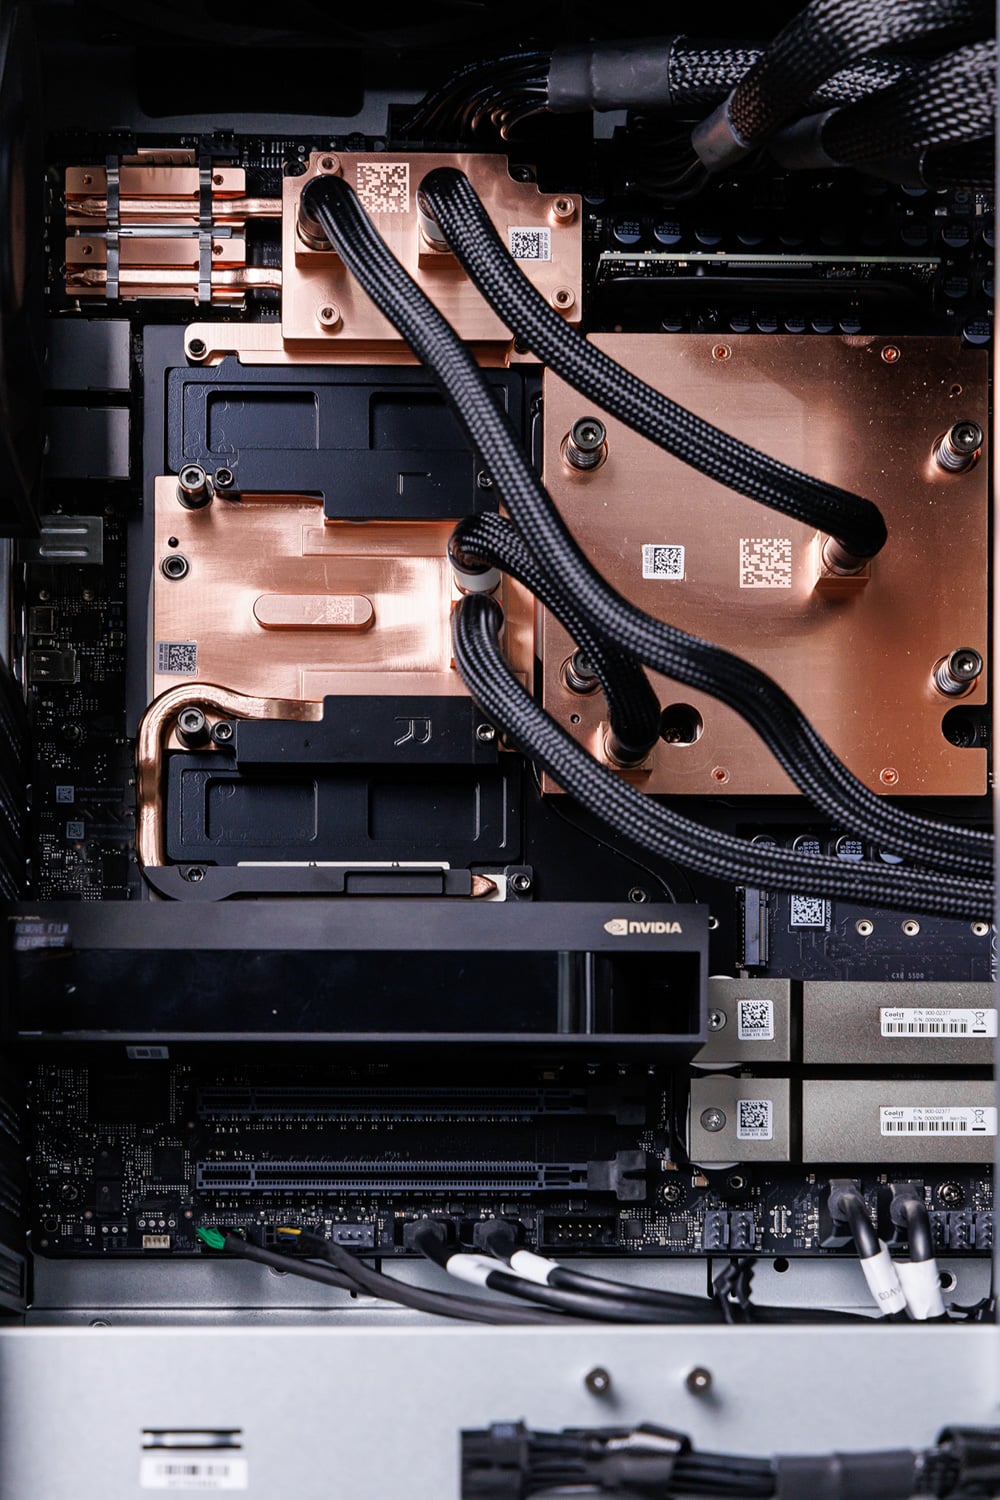
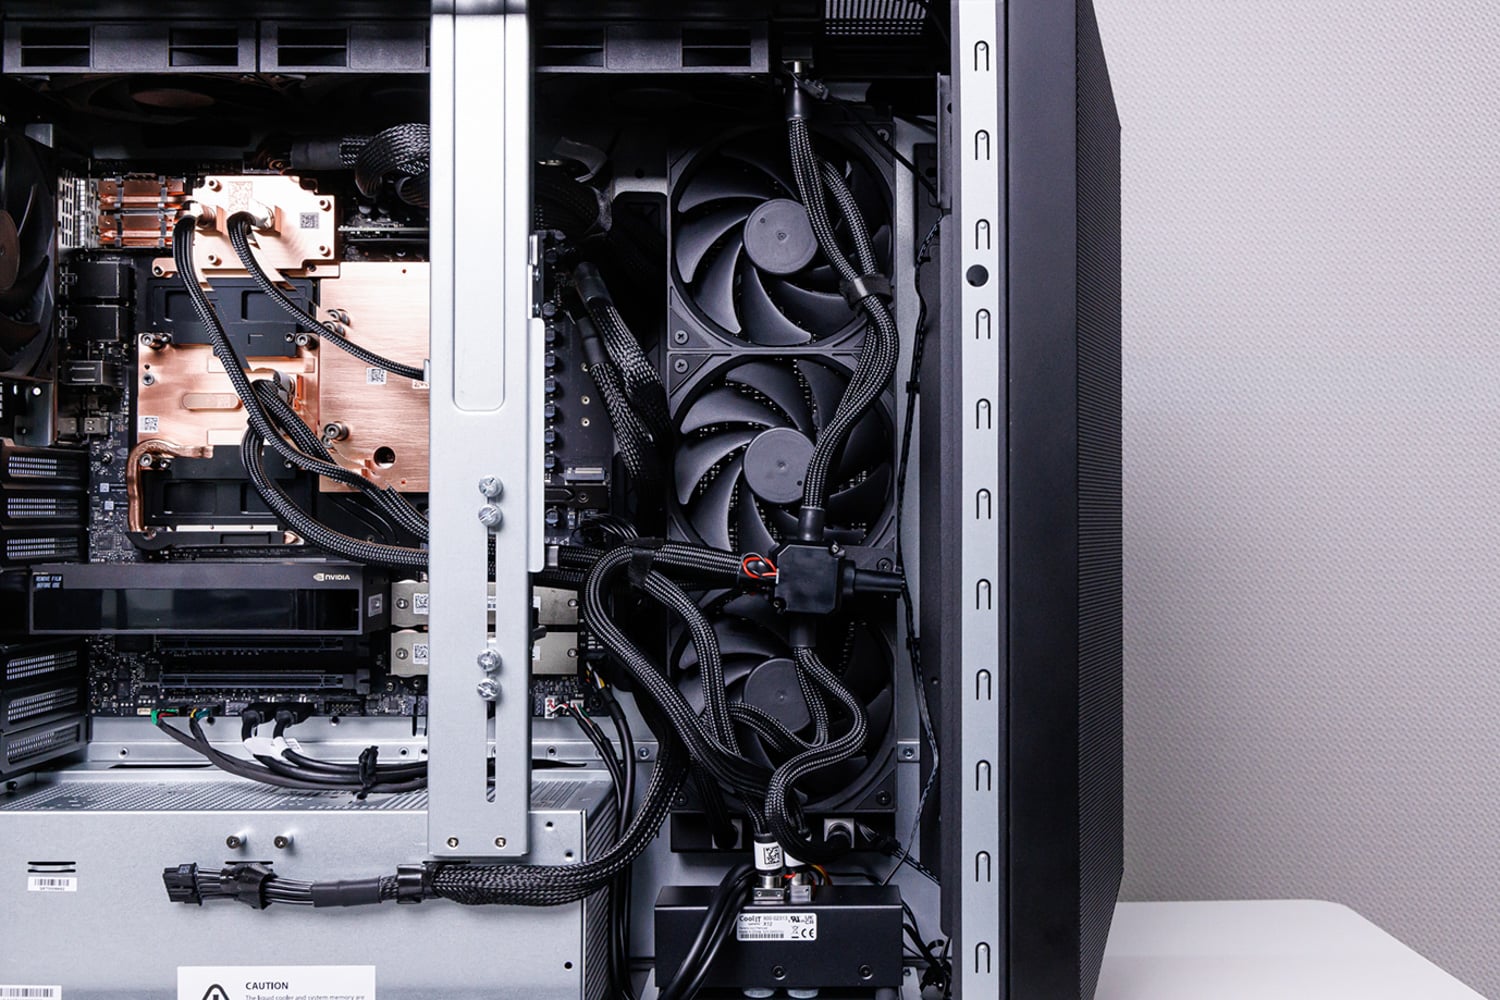
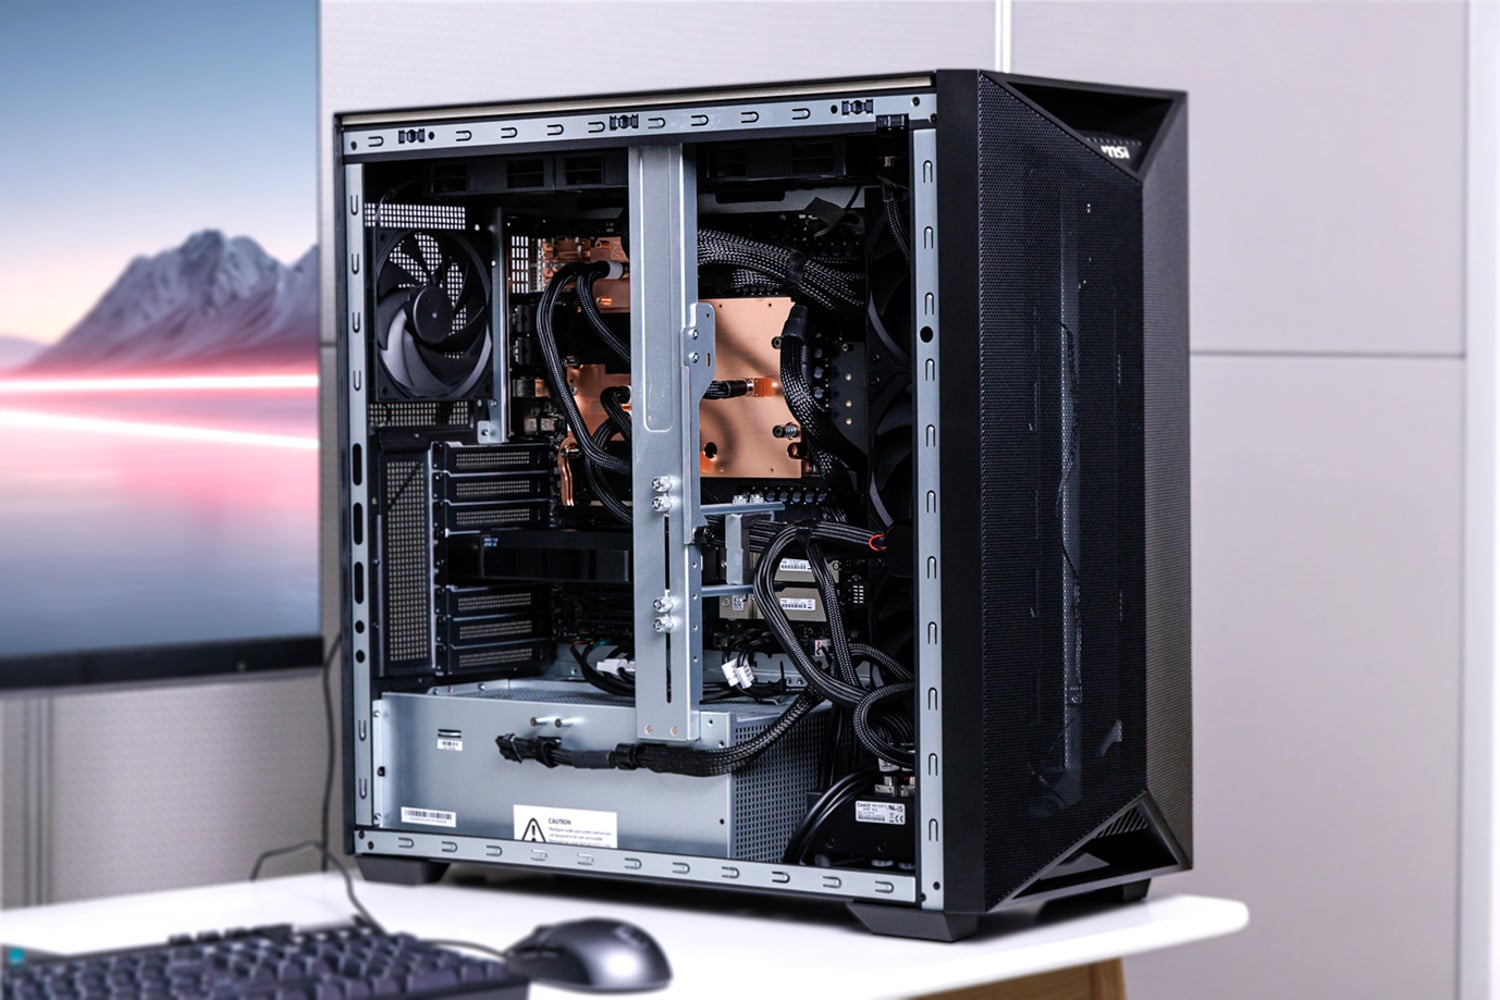
Spoločnosť MSI rieši výsledné tepelné zaťaženie pomocou vlastnej kvapalinovej slučky, ktorá pokrýva základnú dosku B300, procesor Grace, pamäť SOCAMM a ConnectX-8 vrátane optických klietok. Teplo je prenášané cez dva 360 mm radiátory, zatiaľ čo samostatný 120 mm ventilátor presúva vzduch cez zvyšok šasi. Spoločnosť MSI udáva výkon chladiacej zostavy až do 1 400 W pre procesor a grafickú kartu. Počas nášho testovania dosiahla teplota základnej dosky B300 maximum 71 °C, zatiaľ čo procesor sa nikdy nezahrial nad 65 °C pri spotrebe energie grafickej karty 1 292 W.
Špliechanie energie
NVIDIA spravuje tento zdieľaný rozpočet prostredníctvom služby vsloshd. V predvolenom dynamickom režime služba monitoruje odber energie modulu GB300 a voliteľnej karty RTX PRO v reálnom čase a presúva dostupnú rezervu medzi nimi, namiesto toho, aby každé zariadenie držala na pevnom limite. Podľa súčasnej politiky má karta RTX prioritu, takže keď potrebuje viac energie, systém najprv zníži strop výkonu GB300 a až potom zvýši strop RTX. Ak nie je nainštalovaná žiadna karta RTX, pre modul GB300 zostáva k dispozícii celý rozpočet politiky.
To znamená, že voliteľná RTX PRO 6000 nie je len dodatočným výkonom nad rámec B300. Keď sú obe GPU zaneprázdnené, výkon priradený karte RTX pochádza priamo z rozpočtu GB300 a môže znížiť frekvenciu a výkon B300.
Platforma tiež obsahuje hardvérovú brzdu napájania pre prípady, keď systém zistí znížený výkon. Videli sme to počas nášho praktického testu, keď uvoľnené napájacie konektory spôsobili, že WS300 znížil svoj limit napájania, namiesto toho, aby sa vypol alebo pokračoval v odberaní na plný výkon kvôli narušenému pripojeniu. Stroj zostal online v stave so zníženým výkonom, kým sa problém s pripojením nevyriešil.
pripojenie
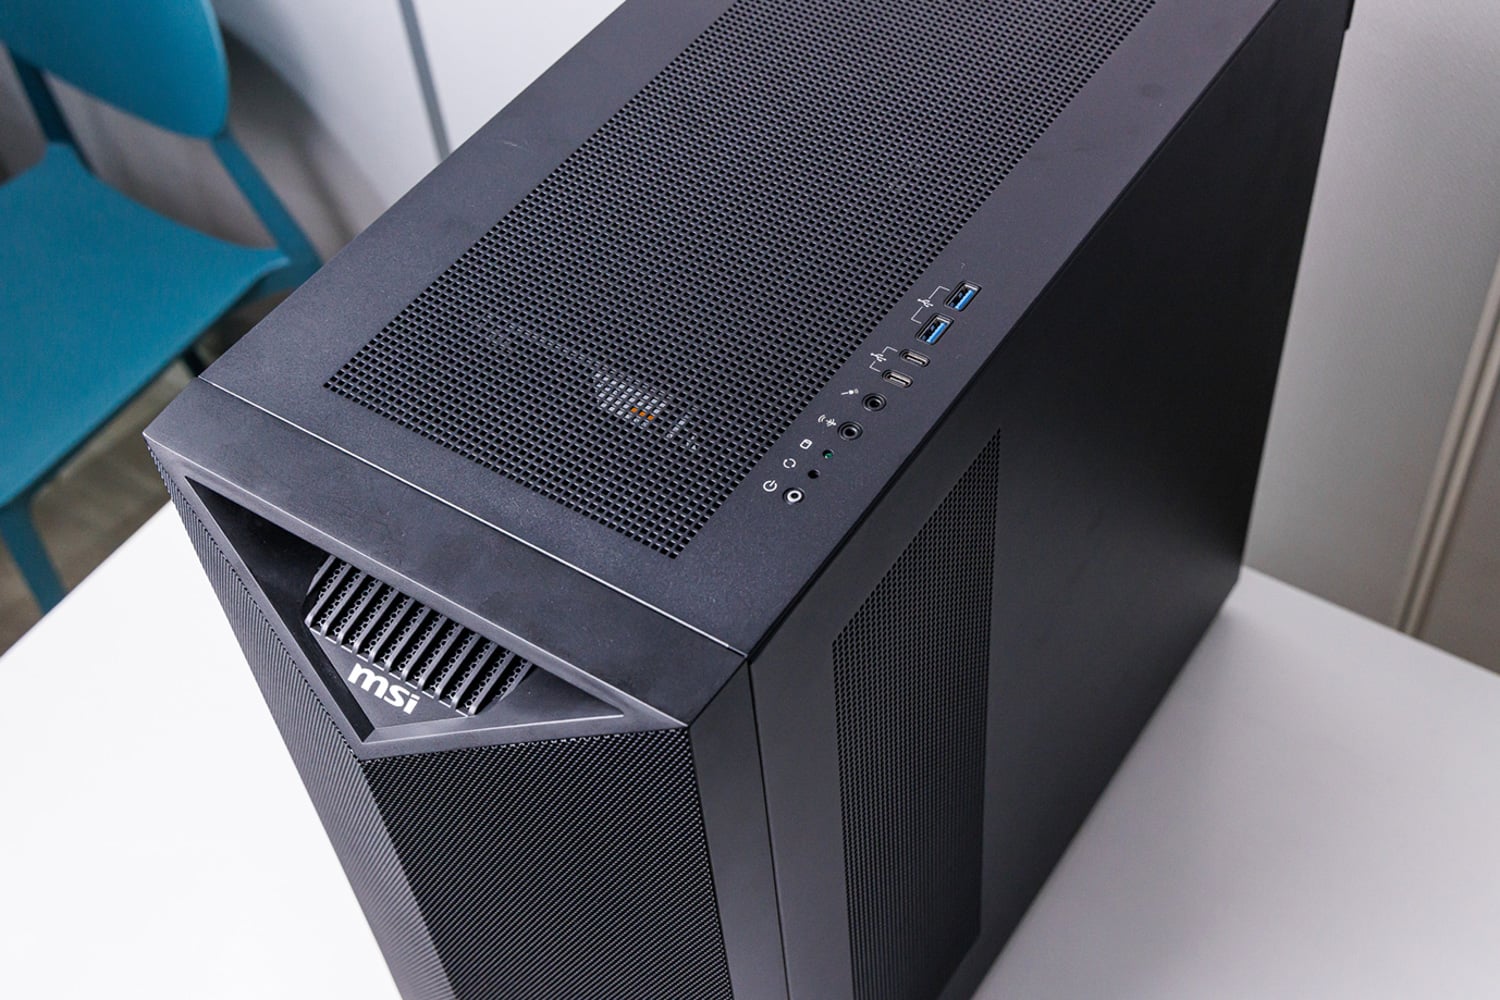
Predtým, ako prejdeme k samotnému šasi, stojí za to sa rýchlo pozrieť na predné a zadné vstupno-výstupné rozhrania. Predné vstupno-výstupné rozhranie pozostáva z dvoch portov USB 3.2 Gen 2 typu A, dvoch portov USB 3.2 Gen 2 typu C, samostatných konektorov pre linkový výstup a mikrofón a ovládacích prvkov napájania a resetovania.
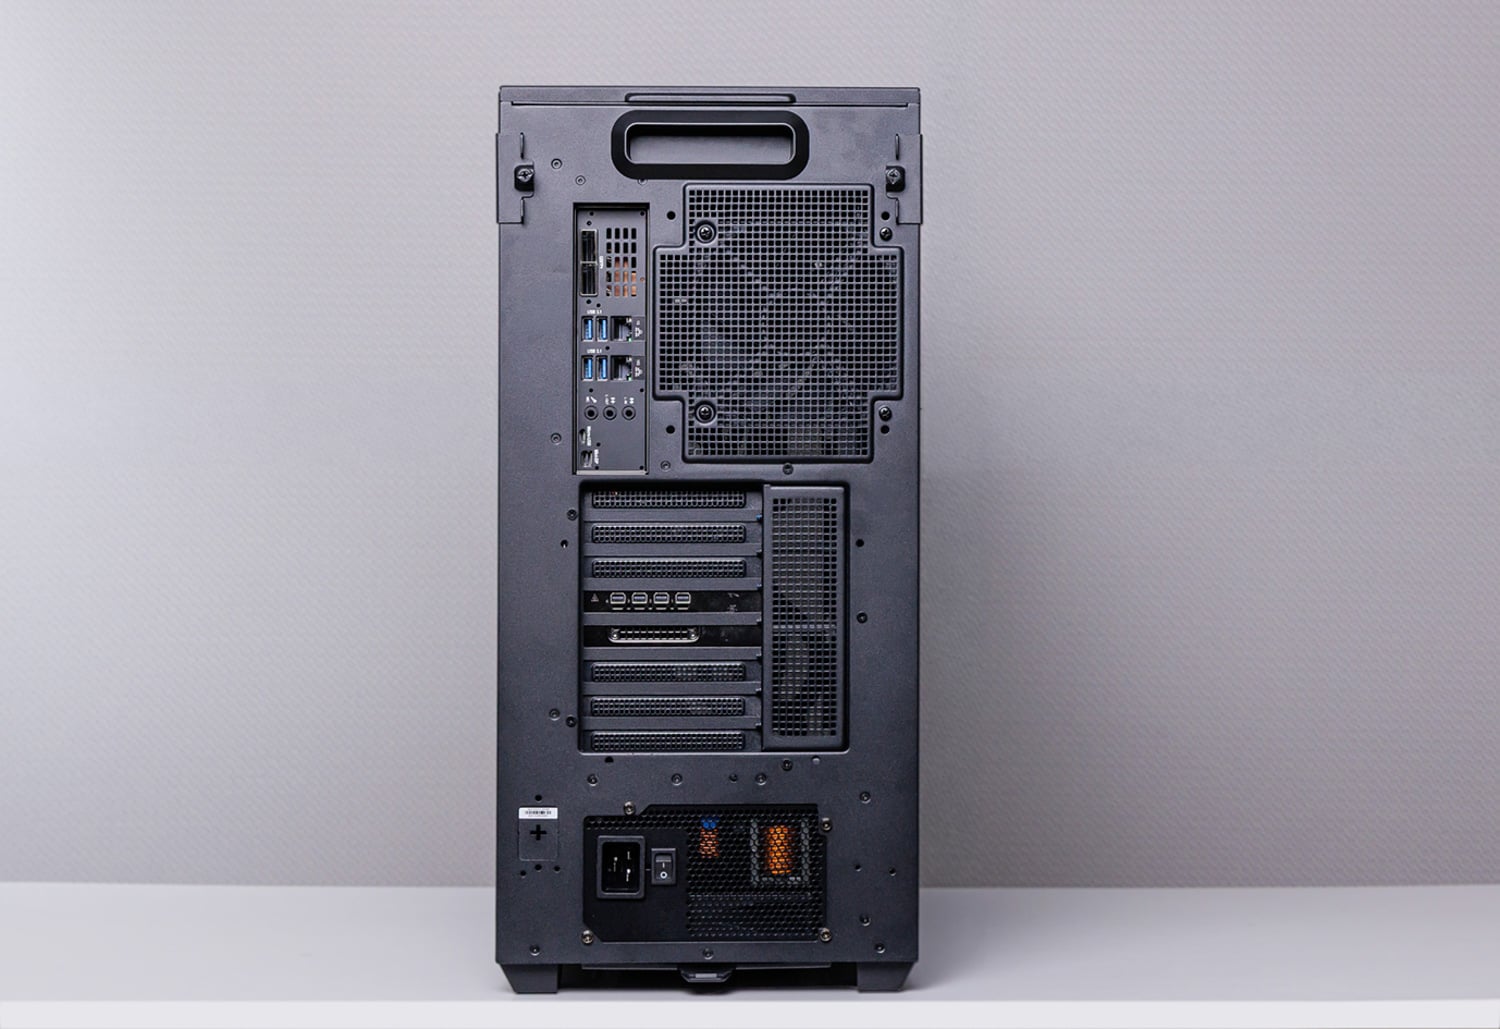
Zadný panel je rozdelený medzi pripojenie pracovnej stanice a serverový hardvér pod ním. ConnectX-8 poskytuje dva 400GbE QSFP112 porty, zatiaľ čo samostatný 10GBase-T port spracováva bežné hostiteľské siete a vyhradený 1GbE port sa pripája k riadiacej jednotke BMC. Štyri 10Gbps USB Type-A porty a tri zvukové konektory pokrývajú lokálne periférie. Riadiaca jednotka BMC tiež odhaľuje sériový port Micro-USB a Mini DisplayPort. Napájací vstup C19 sa nachádza v spodnej časti šasi a cez interný slot M.2 2230 Key-E je možné pridať Wi-Fi 6E alebo Wi-Fi 7 s Bluetooth.
Zaťaženie dátového centra na stole
Doteraz bolo všetko opísané v popise stanice DGX; užitočnejšou otázkou pre kupujúcich je, čo XpertStation umožňuje tímu robiť. Hodnota WS300 sa stáva jasnejšou, keď sa k nej správate ako k vývojovej platforme a nie len ako k vysokokapacitnému inferenčnému systému. Jej grafická karta B300, procesor Grace, podpora MIG, voliteľná grafika RTX PRO a softvérový balík pre dátové centrum prinášajú niekoľko pracovných postupov, ktoré by za normálnych okolností záviseli od zdieľaného hardvéru klastra, na jeden lokálny uzol.
MIG ako vývojový nástroj
Predstavte si, že na jednej GPU beží niekoľko úplne samostatných úloh súčasne, pričom každá je oddelená od ostatných. To robí Multi-Instance GPU (MIG): priestorovo segmentuje hardvér B300 až do siedmich rovnako veľkých segmentov alebo inštancií. Každá inštancia má svoj vlastný fixný podiel SM, HBM, vyrovnávacej pamäte a šírky pásma pamäte, nesie vlastnú identitu zariadenia a pre CUDA sa javí ako samostatná GPU.
To umožňuje vyvíjať, testovať a overovať pracovné zaťaženia s viacerými GPU; trénovať skripty a vyvíjať pre nástroje ako Dynamo, LLM-D atď.
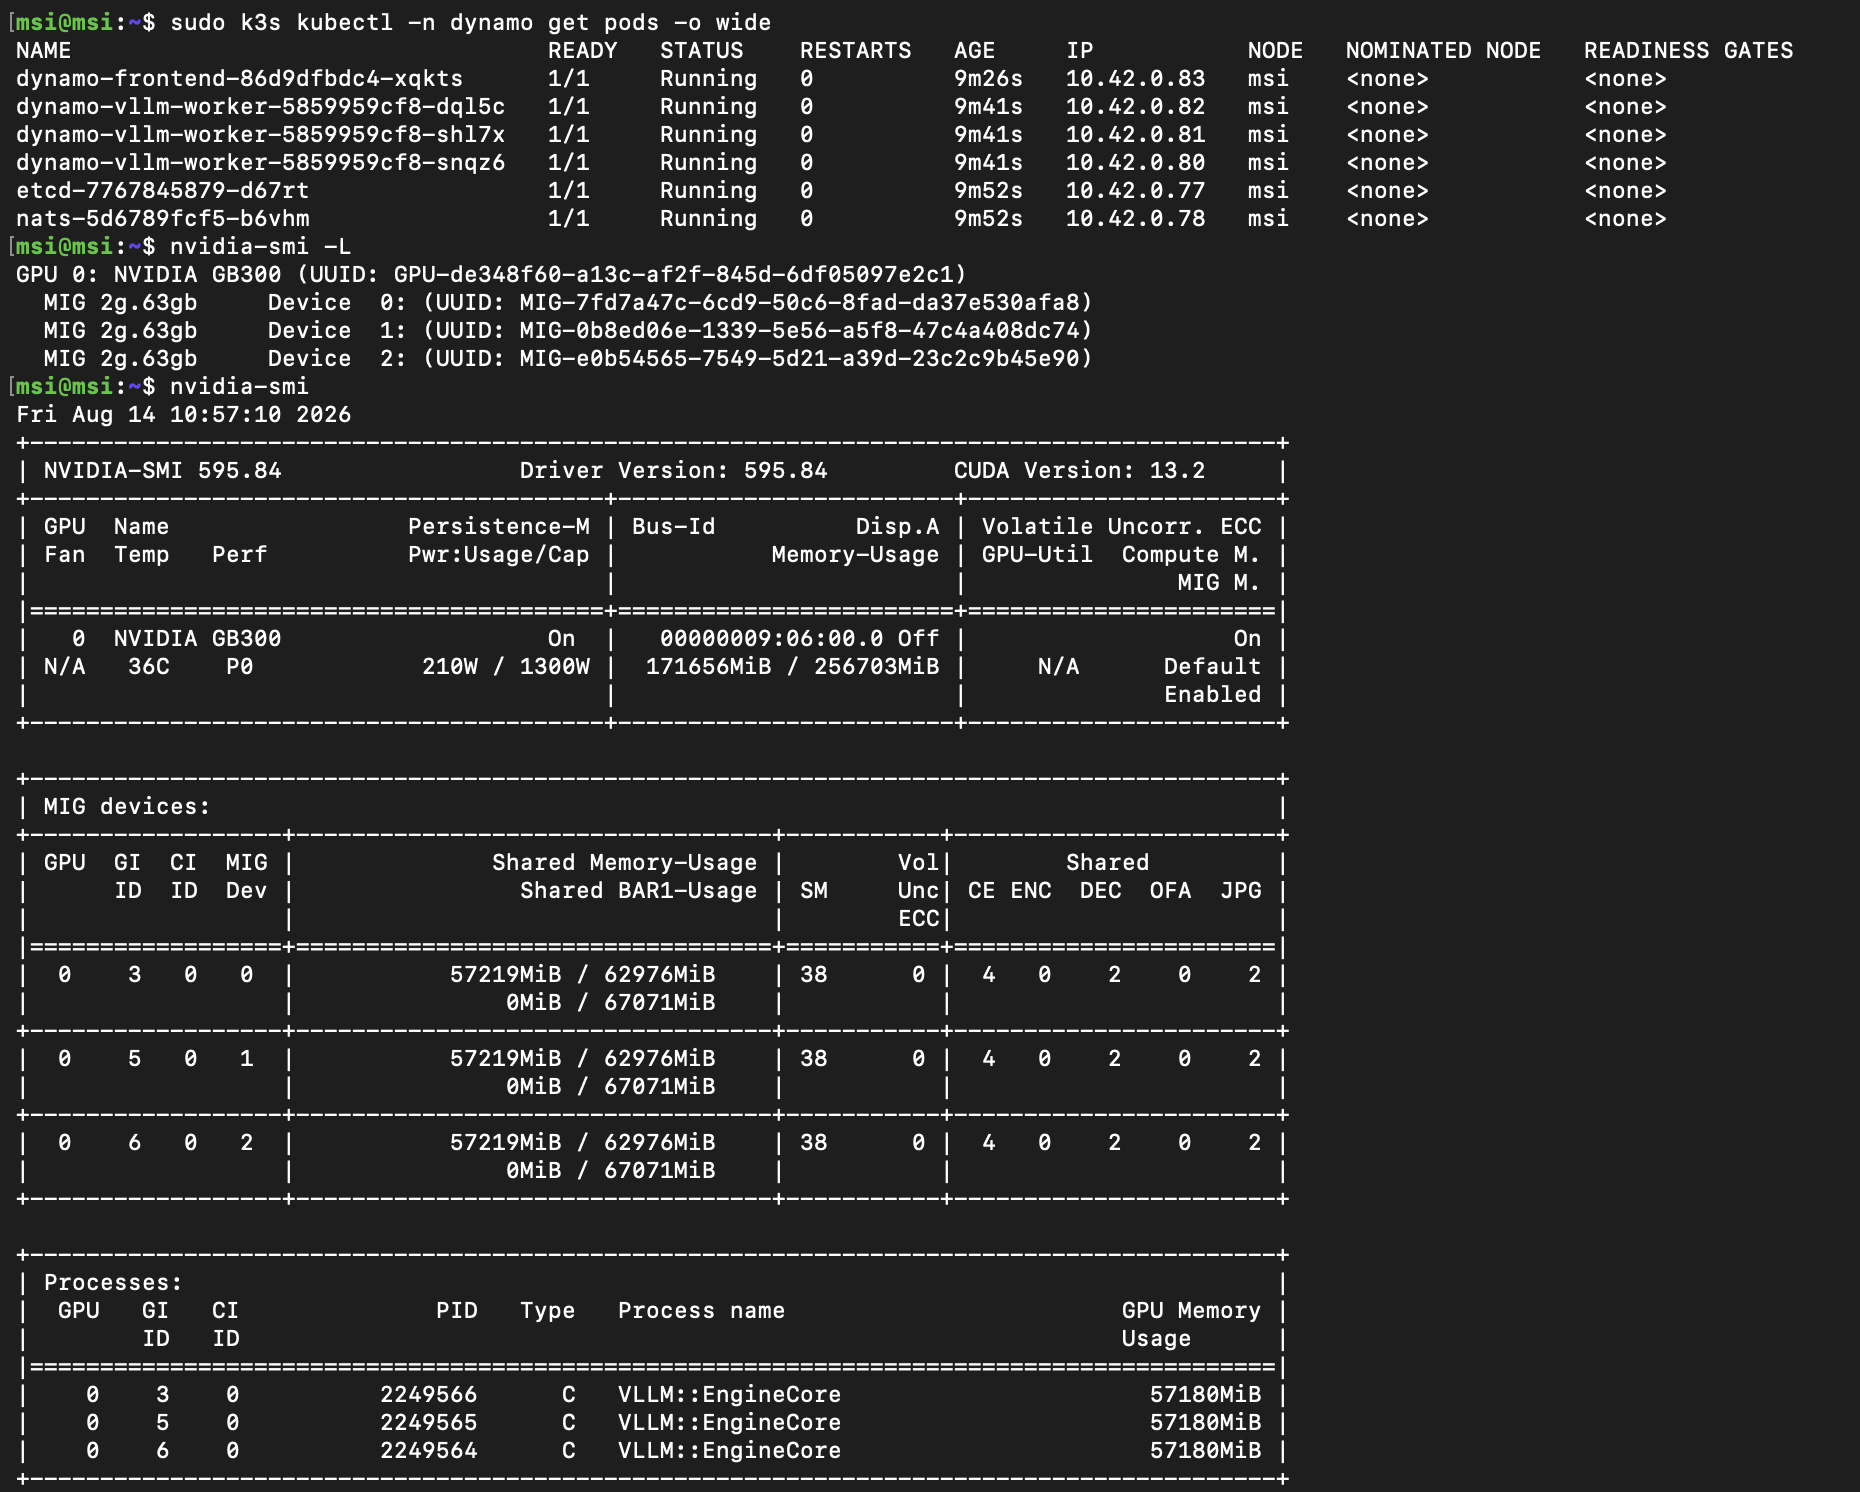
Pre naše testovanie sme nakonfigurovali B300 s 3 inštanciami MIG a použili sme ich na spustenie komponentov NVIDIA Dynamo na samostatných zariadeniach viditeľných pre CUDA. To odráža, koľko našich vlastných benchmarkových nástrojov sa vytvára: overenie, či sa správa presne tak, ako má, znamená opakované iterácie s reálnym hardvérom. S lokálnym B300 môžeme systém rozdeliť a prekonfigurovať bez plánovania času na zdieľanom serveri a bez spotreby energie, tepla a hluku racku v miestnosti, čo eliminuje prekvapivé množstvo réžie z tohto druhu iteračnej práce.
Isaac GR00T a fyzická slučka umelej inteligencie
Ďalším pracovným postupom, ktorý sa obzvlášť dobre hodí pre stanicu DGX, je fyzická umelá inteligencia.
Tento typ pracovného postupu sme už predtým testovali , ale vyžadoval si niekoľko systémov vybavených rôznymi triedami grafických procesorov. Stanica DGX spája tieto predtým oddelené fázy do jedného stolového počítača.
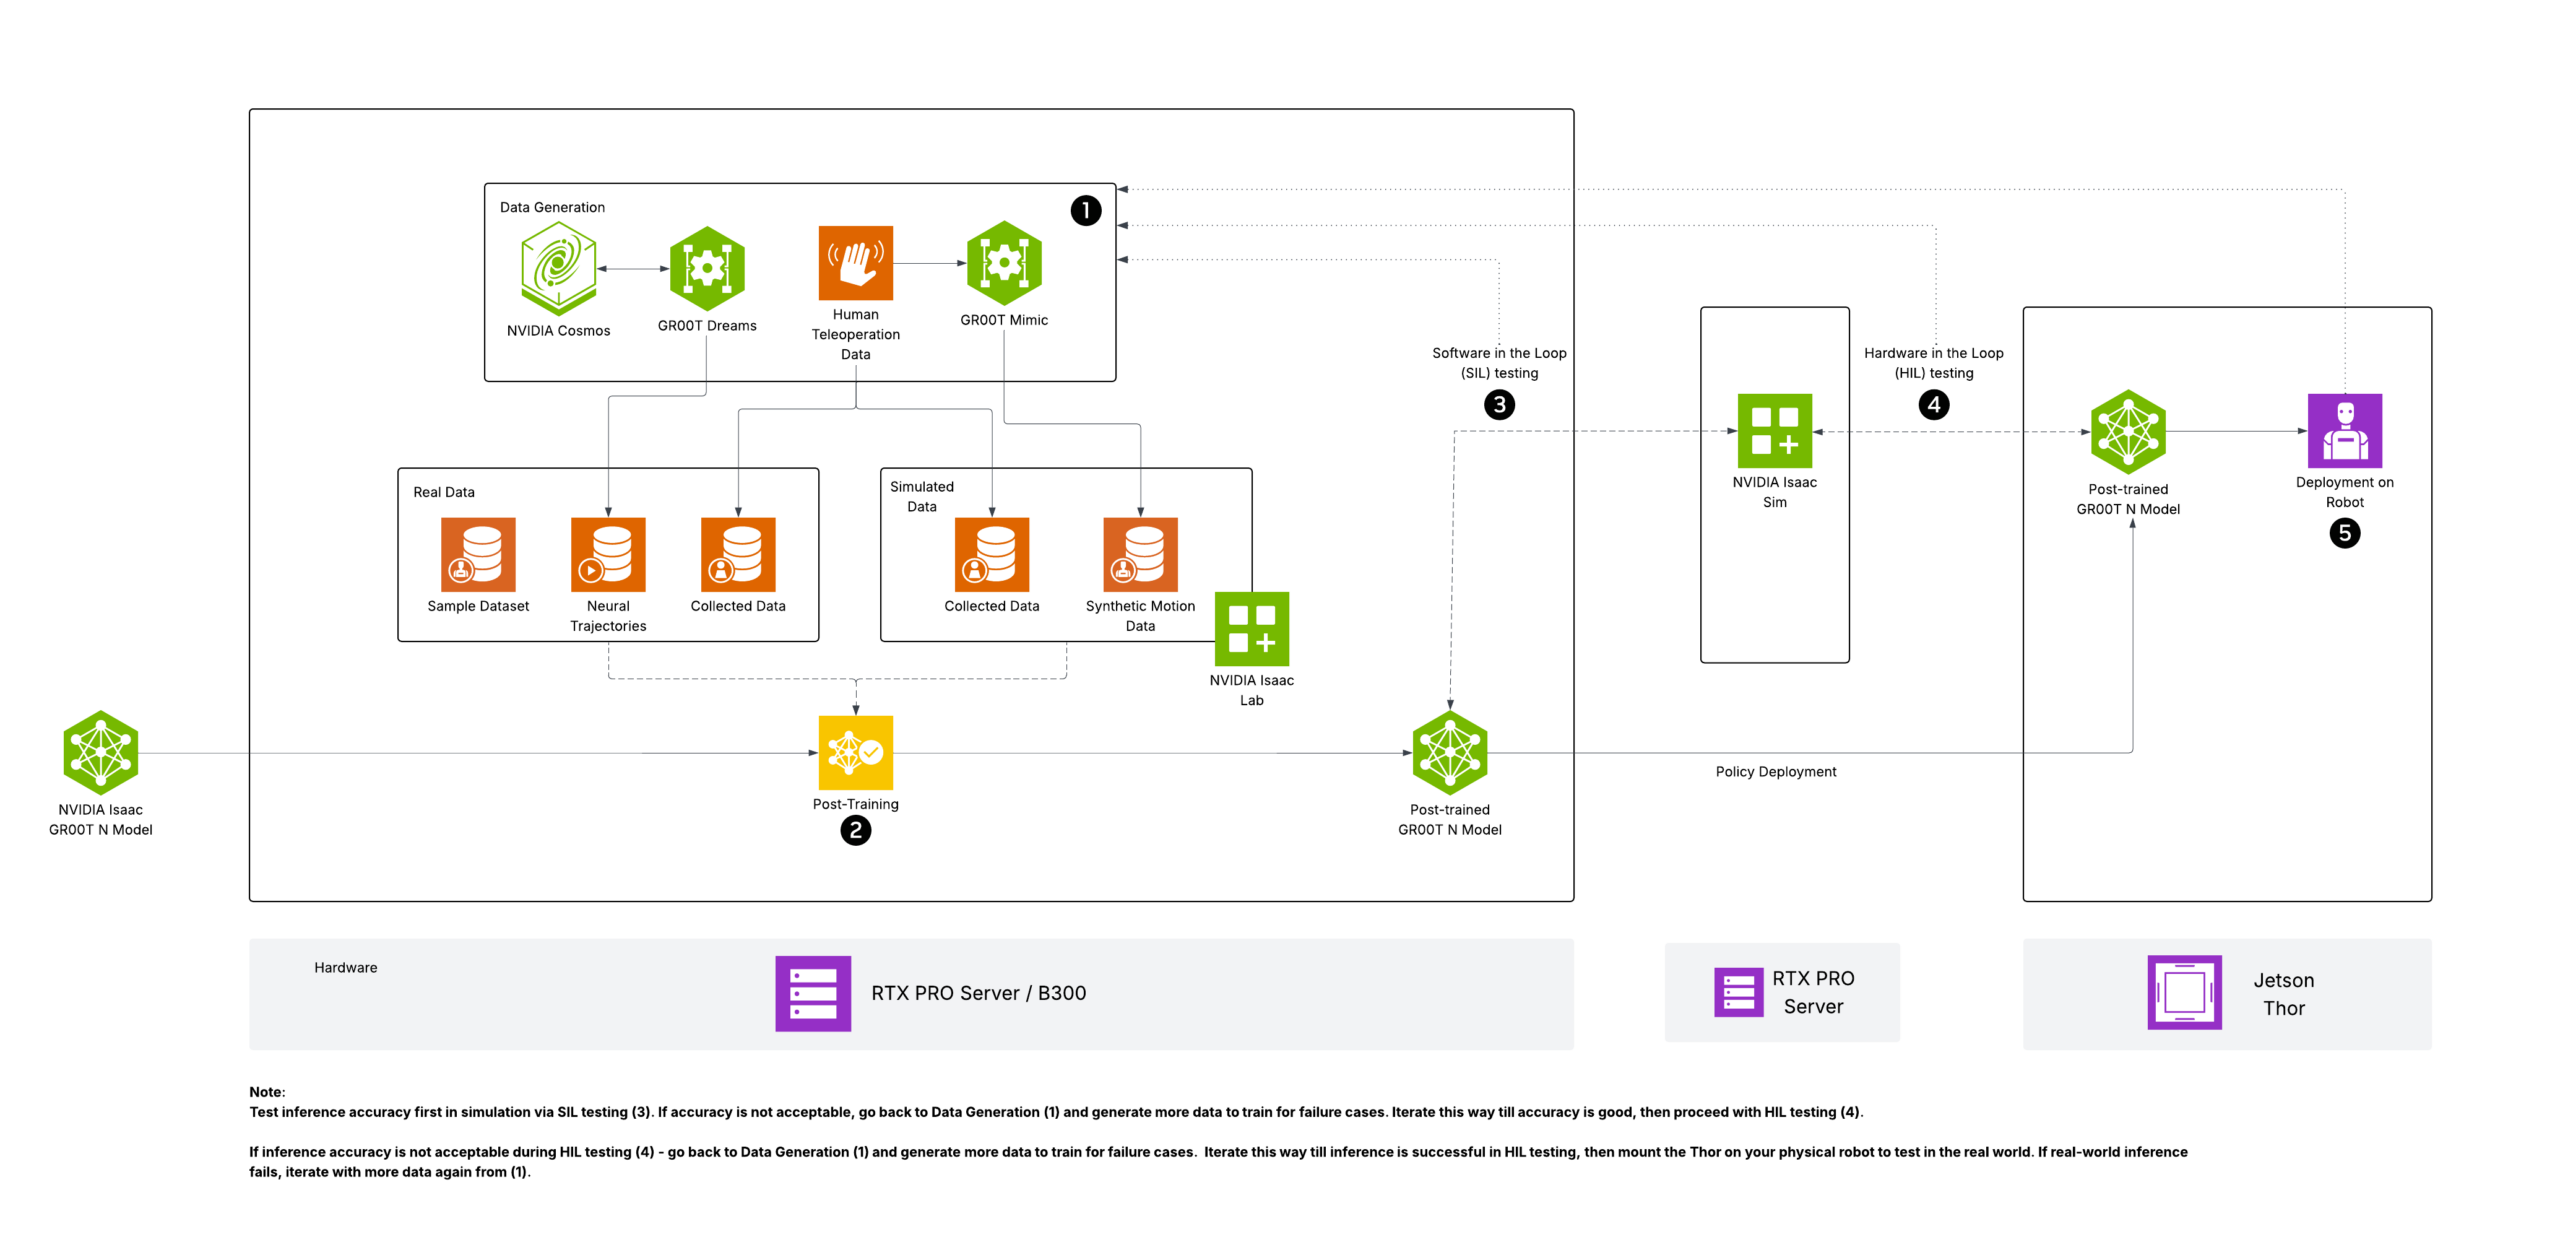
Proces začína teleoperáciou: operátor vedie robota úlohou zachytiť malú sadu reálnych ukážok. Tieto príklady potom vstupujú do pracovného postupu Isaac GR00T. Voliteľná grafická karta RTX PRO sa stará o grafické požiadavky a požiadavky na sledovanie lúčov robota Isaac Sim, zatiaľ čo Isaac Lab a GR00T-Mimic rozširujú pôvodné ukážky do oveľa väčšej kolekcie fyzikálne pravdepodobných syntetických trajektórií. Nakoniec B300 dolaďuje model GR00T pomocou kombinovanej reálnej a syntetickej sady údajov.
Zdroj: NVIDIA
Po doladení je možné výslednú politiku overiť v simulácii pred nasadením do robota na reálne vyhodnotenie. To vytvára úzky vývojový cyklus: zachytenie skutočnej demonštrácie, jej reprodukcia a úprava v simulácii, pretrénovanie modelu a testovanie aktualizovanej politiky na hardvéri. Pre tímy s obmedzeným prístupom k robotom, operátorom alebo oknám zberu údajov môže konsolidácia simulácie, generovania syntetických údajov a trénovania modelu v jednom systéme pri stole výrazne znížiť trenie každej iterácie.
Vývoj jadra Blackwell Ultra
Dá sa však povedať, že najlepším prípadom použitia pre DGX Station je optimalizácia jadra. Keď tím píše jadrá CUDA alebo Triton pre Blackwell Ultra, nič nenahradí spustenie na cieľovej architektúre. WS300 dáva vývojárovi po boku procesor B300 a 252 GB HBM3e, čo umožňuje profilovať skutočné pracovné zaťaženie, kontrolovať správanie pamäte, ladiť cesty Tensor Core, spájať operácie a iterovať bez rezervovania času na serveri s ôsmimi GPU alebo systéme v racku.
Väčšie systémy sú stále dôležité, ale môžu byť vyhradené pre prácu, ktorá ich vyžaduje: škálovanie NVLink, kolektívy NCCL, komunikačné jadrá, inferencia viacerých GPU a finálna validácia priepustnosti. WS300 spracováva prácu s jadrom jedného GPU lokálne, pričom tieto drahé zdieľané systémy zostávajú k dispozícii na škálovateľné testovanie. Pre tím zameraný na optimalizáciu Blackwell Ultra je to asi najpriamejší vývojový stroj, aký trh ponúka.
Ak by sa stanica DGX dodávala spolu s prvými systémami Blackwell Ultra, predpokladáme, že počiatočná dodávka by takmer okamžite zmizla v laboratóriách umelej inteligencie, kompilátorových tímoch, vývojároch inferenčných enginov a ďalších skupinách, ktoré sa predháňajú v ladení softvéru pre B300. Aj teraz môže byť priamy prístup k cieľovej grafickej karte najjasnejším dôvodom, prečo si ju organizácia kúpi.
výkon
Poznámka k testovaniu: Testovanie prebiehalo na diaľku na systéme hostovanom spoločnosťou MSI, pričom StorageReview riadil celé softvérové prostredie počas celého testovacieho obdobia. Systém bol testovaný bez nainštalovanej grafickej karty RTX PRO alebo akýchkoľvek iných prídavných kariet PCIe. Vďaka tomu mal superčip GB300 počas testovania k dispozícii plný dostupný výkon akcelerátora systému.
Maximálne dosiahnuteľné Matmul FLOPS (MAMF)
Najprv sme pre kontext výpočtov B300 spustili MAMF na troch systémoch generácie Blackwell. MAMF (Maximum Achievable Matmul FLOPS) je praktická metrika výkonu určená na meranie realistického maximálneho počtu operácií s pohyblivou rádovou čiarkou za sekundu, ktorý je možné dosiahnuť na akcelerátoroch strojového učenia počas operácií násobenia matíc, a ponúka presnejší benchmark ako teoretický maximálny počet FLOPS, ktorý sa často uvádza v hardvérových špecifikáciách.
V tomto teste sme v BF16, FP8 a NVFP4 analyzovali každý z 3 systémov a uvádzame najlepší trvalý (hustý) výsledok na presnosť.
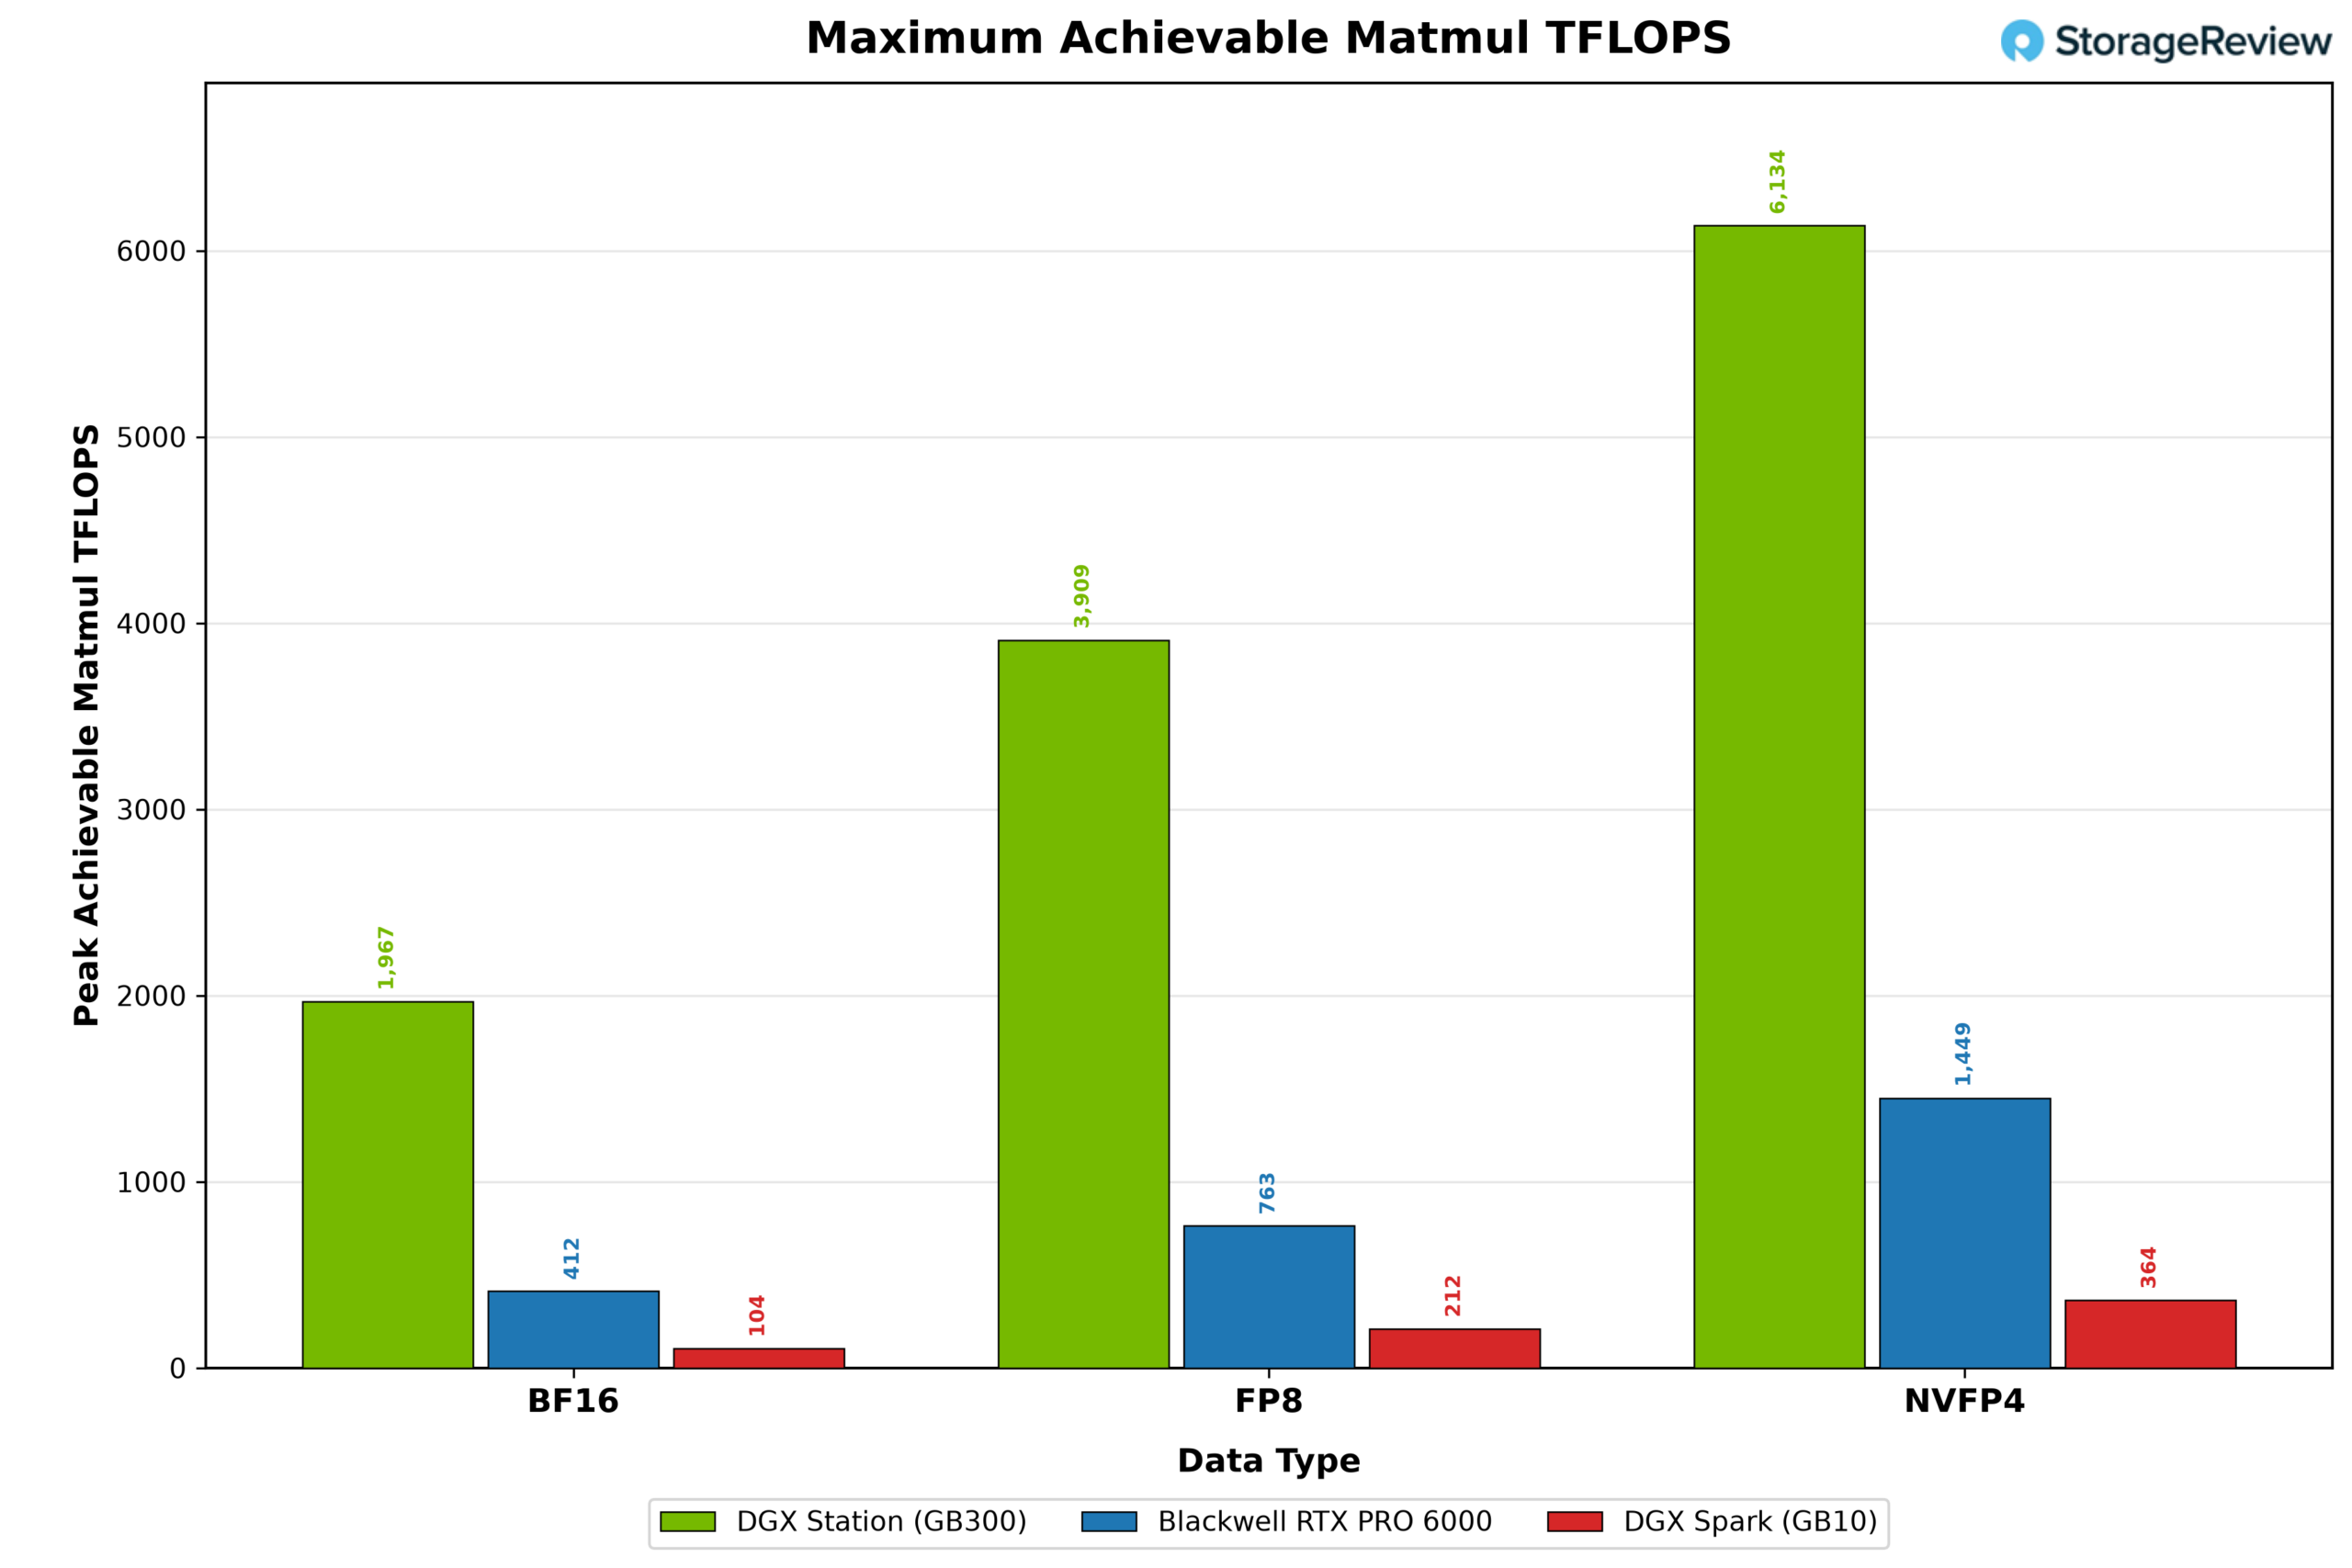
GB300 vedie v každej presnosti. V BF16 dosahuje 1 967 TFLOPS oproti 412 na RTX PRO 6000 a 104 na DGX Spark . FP8 sleduje rovnaký vzorec: 3 909, 763 a 211. NVFP4 zvyšuje GB300 na 6 134 TFLOPS, pričom RTX PRO 6000 má 1 449 a Spark 364. Pomery sú pozoruhodne stabilné vo všetkých troch presnostiach: GB300 má 4 až 5-násobnú výhodu oproti RTX PRO 6000 a 17 až 19-násobnú výhodu oproti Spark, zatiaľ čo RTX PRO 6000 si udržiava zhruba 4-násobnú výhodu oproti Spark.
Šírka pásma NV
Priepustnosť surových výpočtov je užitočná iba vtedy, ak akcelerátor dokáže udržiavať svoje vykonávacie jednotky zásobované dátami. Toto je obzvlášť dôležité pre inferenciu umelej inteligencie, kde je generovanie tokenov počas fázy dekódovania často obmedzené viac šírkou pásma pamäte ako dostupnými FLOPS.
Na superčipe GB300 táto hierarchia zahŕňa lokálny HBM3e čipu B300, pamäť LPDDR5X od Grace a prepojenie NVLink-C2C, ktoré ich spája. Nástroj NVBandwidth od spoločnosti NVIDIA analyzuje rôzne cesty kopírovania medzi týmito komponentmi a zobrazuje šírku pásma dostupnú v rámci GPU aj náklady na presun údajov medzi pamäťovými doménami GPU a CPU.
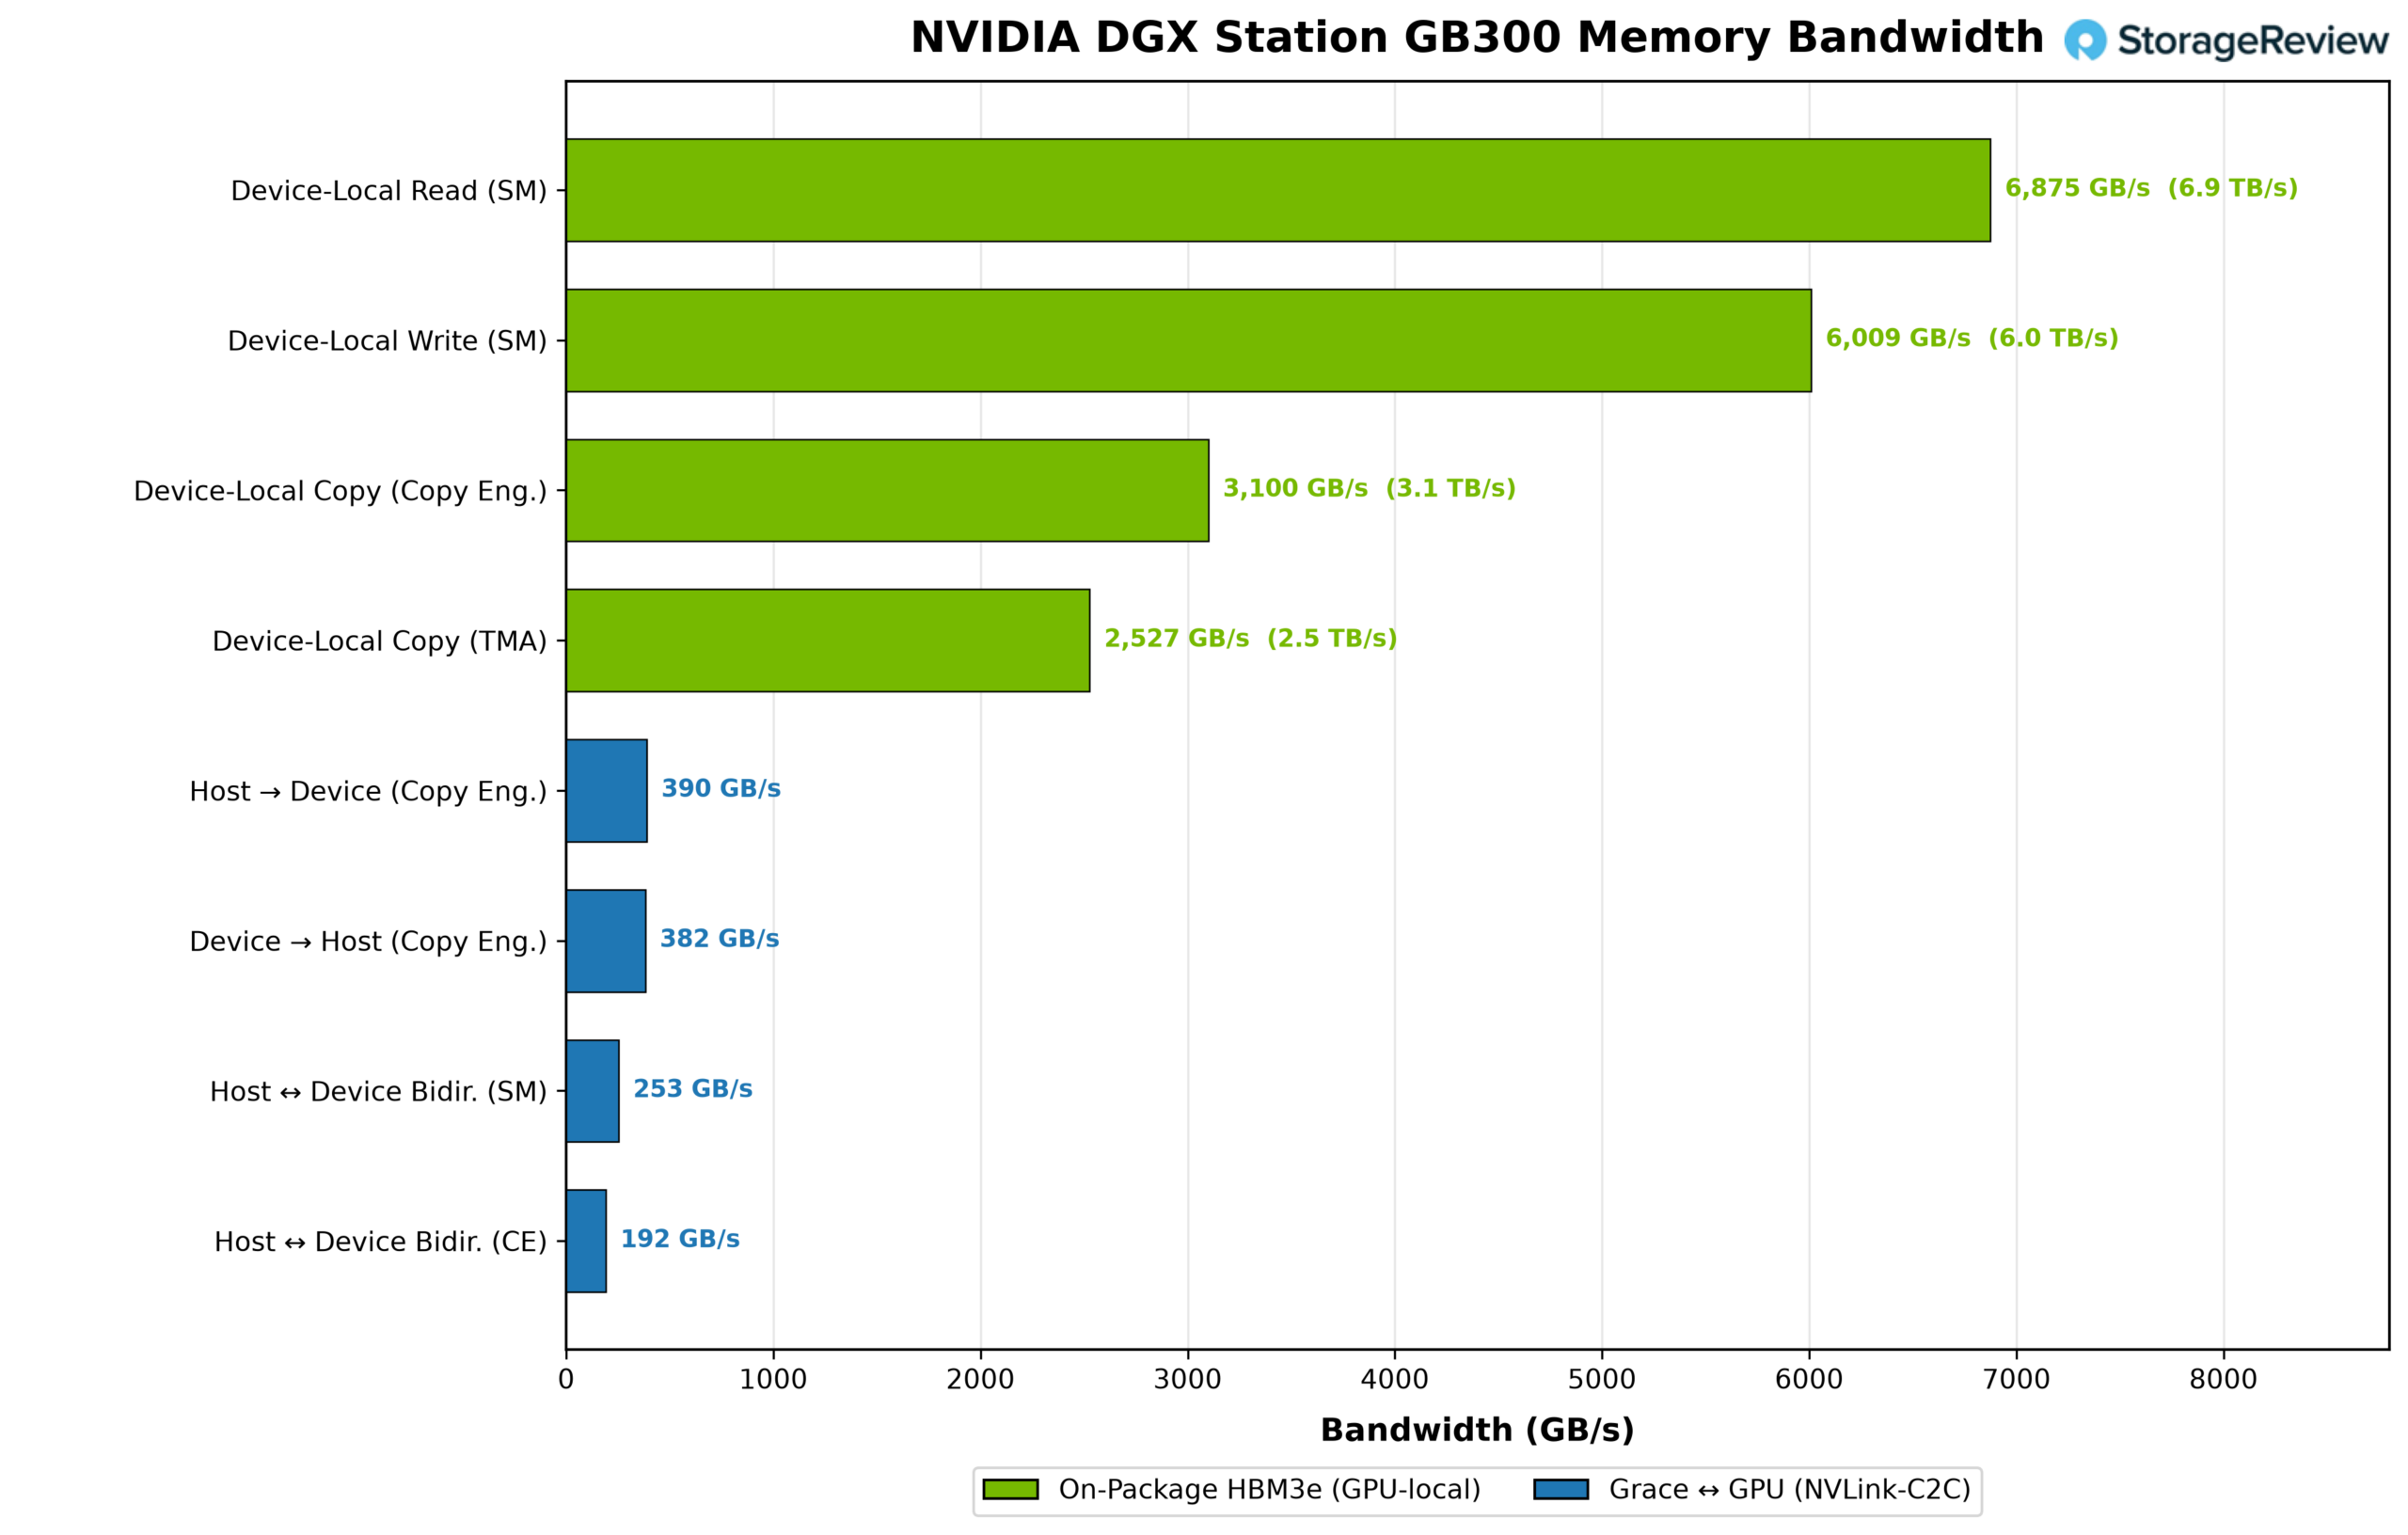
Prvé štyri testy merajú pohyb dát v rámci 252 GB pamäte HBM3e dosky B300. Rýchlosť čítania lokálneho zariadenia dosahuje 6 875 GB/s, čo je približne 6.9 TB/s, čo umiestňuje výsledok do niekoľkých percent od menovitej šírky pásma pamäte GPU 7.1 TB/s. Rýchlosť zápisu lokálneho zariadenia dosahuje 6 009 GB/s.
Kopírovacie operácie z HBM do HBM sú nižšie, pretože každá kópia spotrebuje šírku pásma dvakrát: raz na čítanie zdroja a znova na zápis do cieľa. Dedikované kopírovacie enginy dosahujú rýchlosť 3 100 GB/s, zatiaľ čo Tensor Memory Accelerator zaznamenáva 2 527 GB/s.
Zvyšné testy prechádzajú cez NVLink-C2C a využívajú 496 GB pamäte LPDDR5X od spoločnosti Grace. Prenosy z pamäte Grace do B300 HBM dosahujú rýchlosť 390 GB/s, zatiaľ čo prenosy v opačnom smere dosahujú rýchlosť 382 GB/s. Hoci NVLink-C2C poskytuje koherentnú šírku pásma medzi CPU a GPU až 900 GB/s, namerané prenosy sú obmedzené šírkou pásma pamäte LPDDR5X od spoločnosti Grace, ktorá dosahuje 396 GB/s. Obojsmerné prenosy toto obmedzenie ešte viac odhaľujú. Súčasná prevádzka dosahuje 253 GB/s pri použití kópií založených na SM a 192 GB/s cez kopírovacie enginy.
Záver
Po prebratí nízkoúrovňových testov prejdeme k inferencii LLM. Tu sa pozornosť presúva z maximálnych čísel na tokeny za sekundu, čas do prvého tokenu a latenciu pri zaťažení, čo nám poskytuje lepší prehľad o tom, ako sa WS300 správa ako obslužný systém.
Začnime s definujúcou schopnosťou superčipu GB300: obsluhovať modely na oboch stranách limitu kapacity 252 GB HBM3e od B300. Tu najviac záleží na jeho 748 GB koherentnej pamäťovej skupine. Päť kontrolných bodov postupuje od dvoch modelov, ktoré sa pohodlne zmestia do HBM, cez jeden, ktorý sa nominálne zmestí, ale ponecháva príliš málo miesta pre runtime a KV cache, a nakoniec k dvom, ktoré musia odľahčiť podstatnú časť svojej váhy pamäti Grace.
Poznámka: Kde je uvedené, modely boli spustené so špekulatívnym dekódovaním pre vyššiu priepustnosť dekódovania, pričom množstvo tokenov vynúteného prijatia bolo nastavené na množstvo špekulatívnych dekódovacích tokenov. Výsledky preto ukazujú najlepší výkon; v reálnom svete je priepustnosť dynamická a závisí od kvality špekulatívnych dekódovacích tokenov.
Modely, ktoré sa úplne hodia do HBM
DeepSeek v4 Flash (0731)
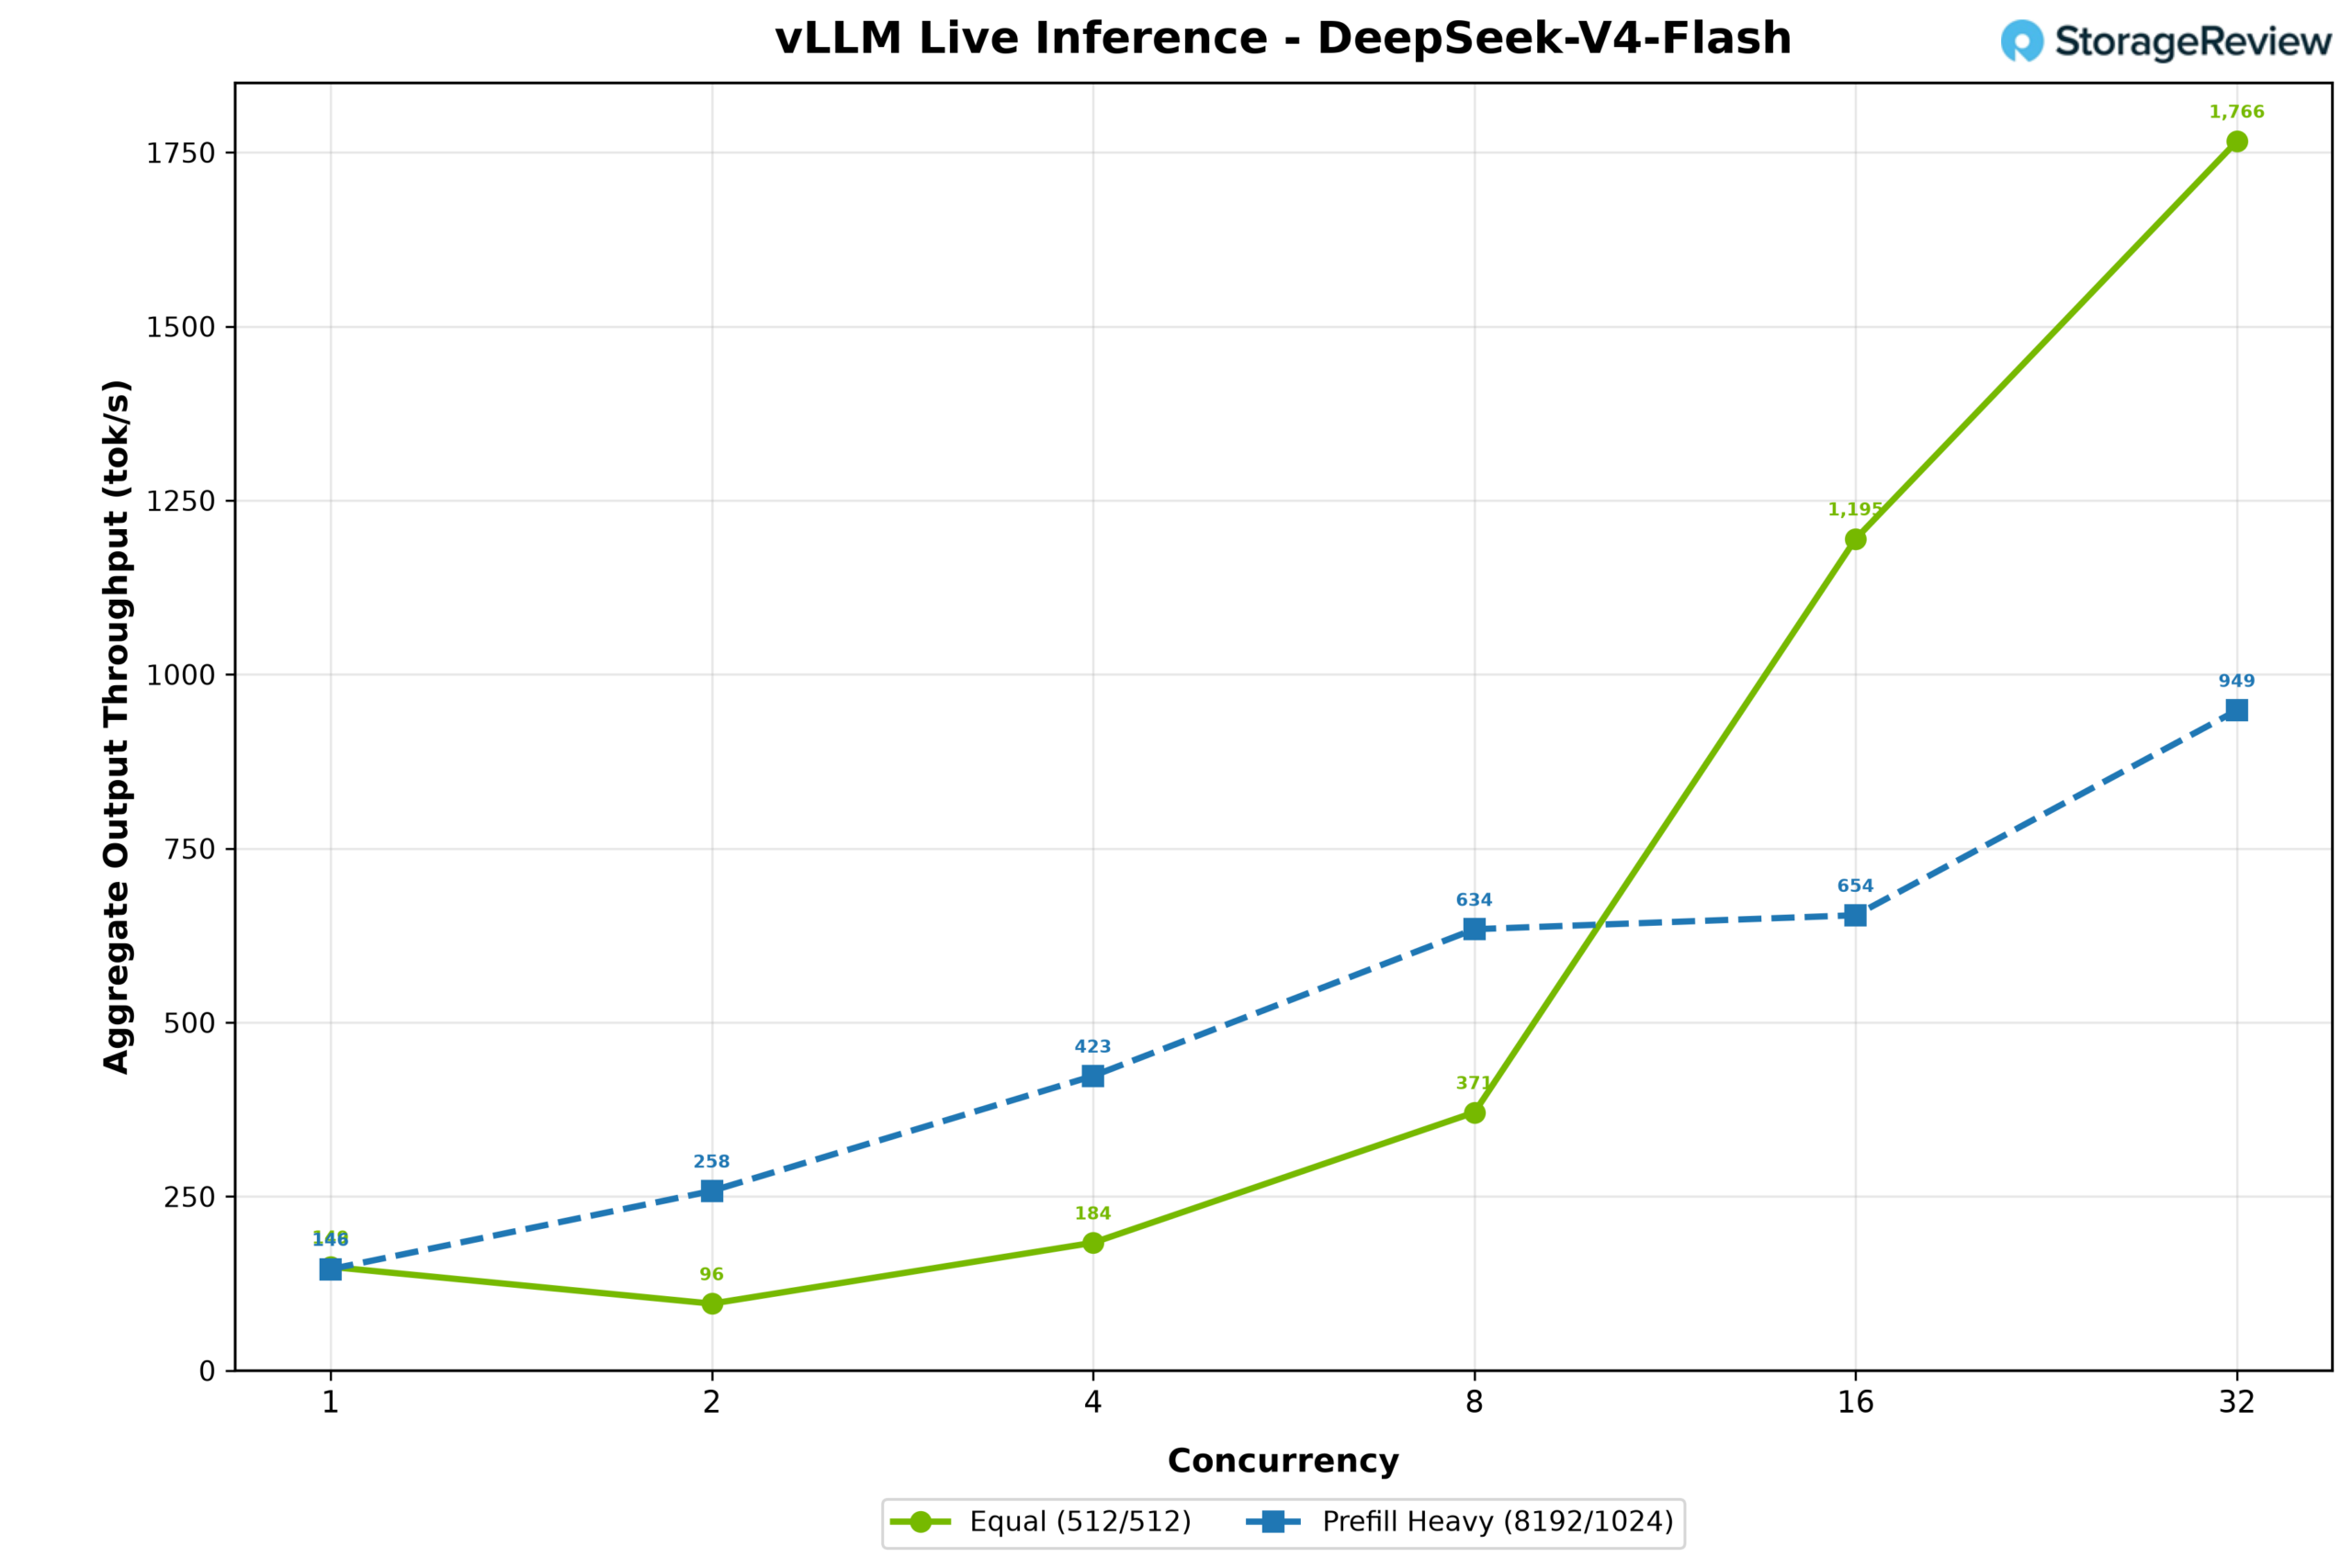
Prvým bol mimoriadne populárny DeepSeek v4 Flash (0731), ktorý spotrebúva 14+6 GB pamäte ako natívny kontrolný bod FP8. Tento model je známy svojou vysokou účinnosťou a ľahkou prevádzkou, čo sme zažili aj na stanici DGX. Pri pracovnom zaťažení 512/512 sa výstupná priepustnosť začala na 149 tokenoch za sekundu pri súbežnosti 1 a rýchlo stúpla na 1 766 pri súbežnosti 32. Pracovné zaťaženie s vysokým počtom predfillov sa zvýšilo zo 146 na 949 tokenov za sekundu.
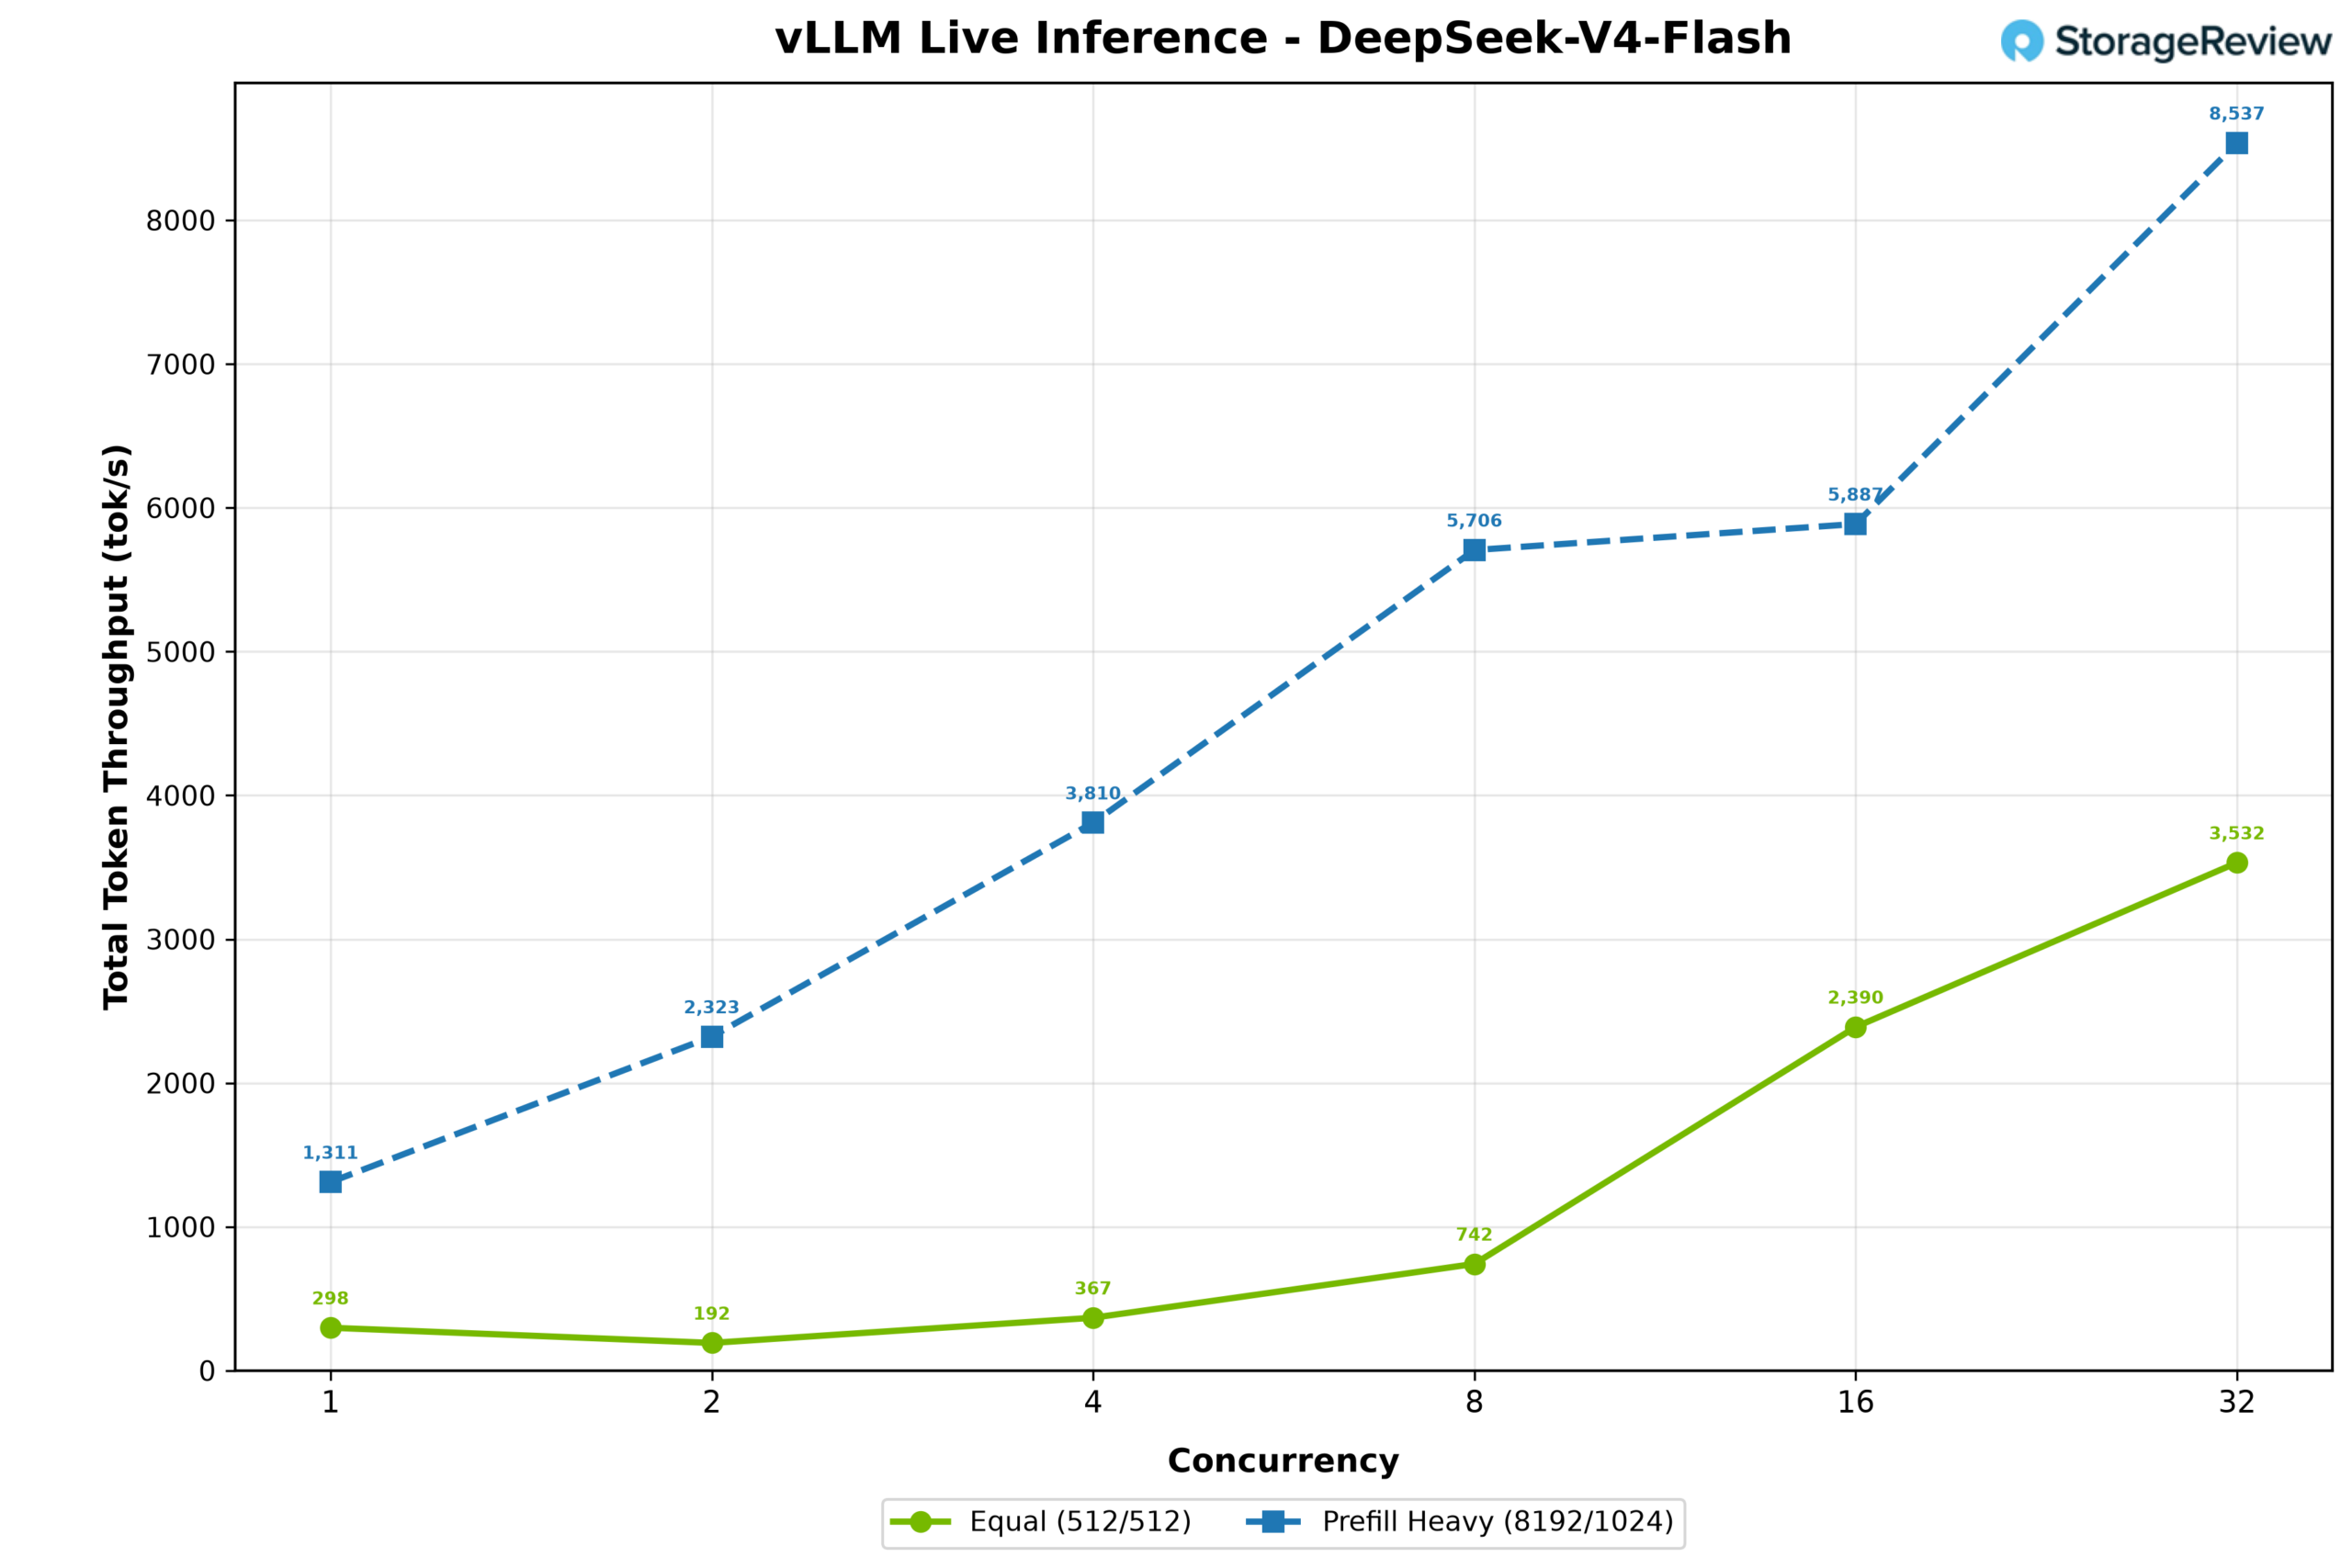
Celková priepustnosť tokenov sa škálovala v súlade s postupom, pričom pracovná záťaž 512/512 sa zvýšila z 298 na 3 532 tokenov za sekundu a pracovná záťaž s vysokým počtom predfillov sa zvýšila z 1 311 na 8 537.
MiniMax M2.7 (NVFP4)
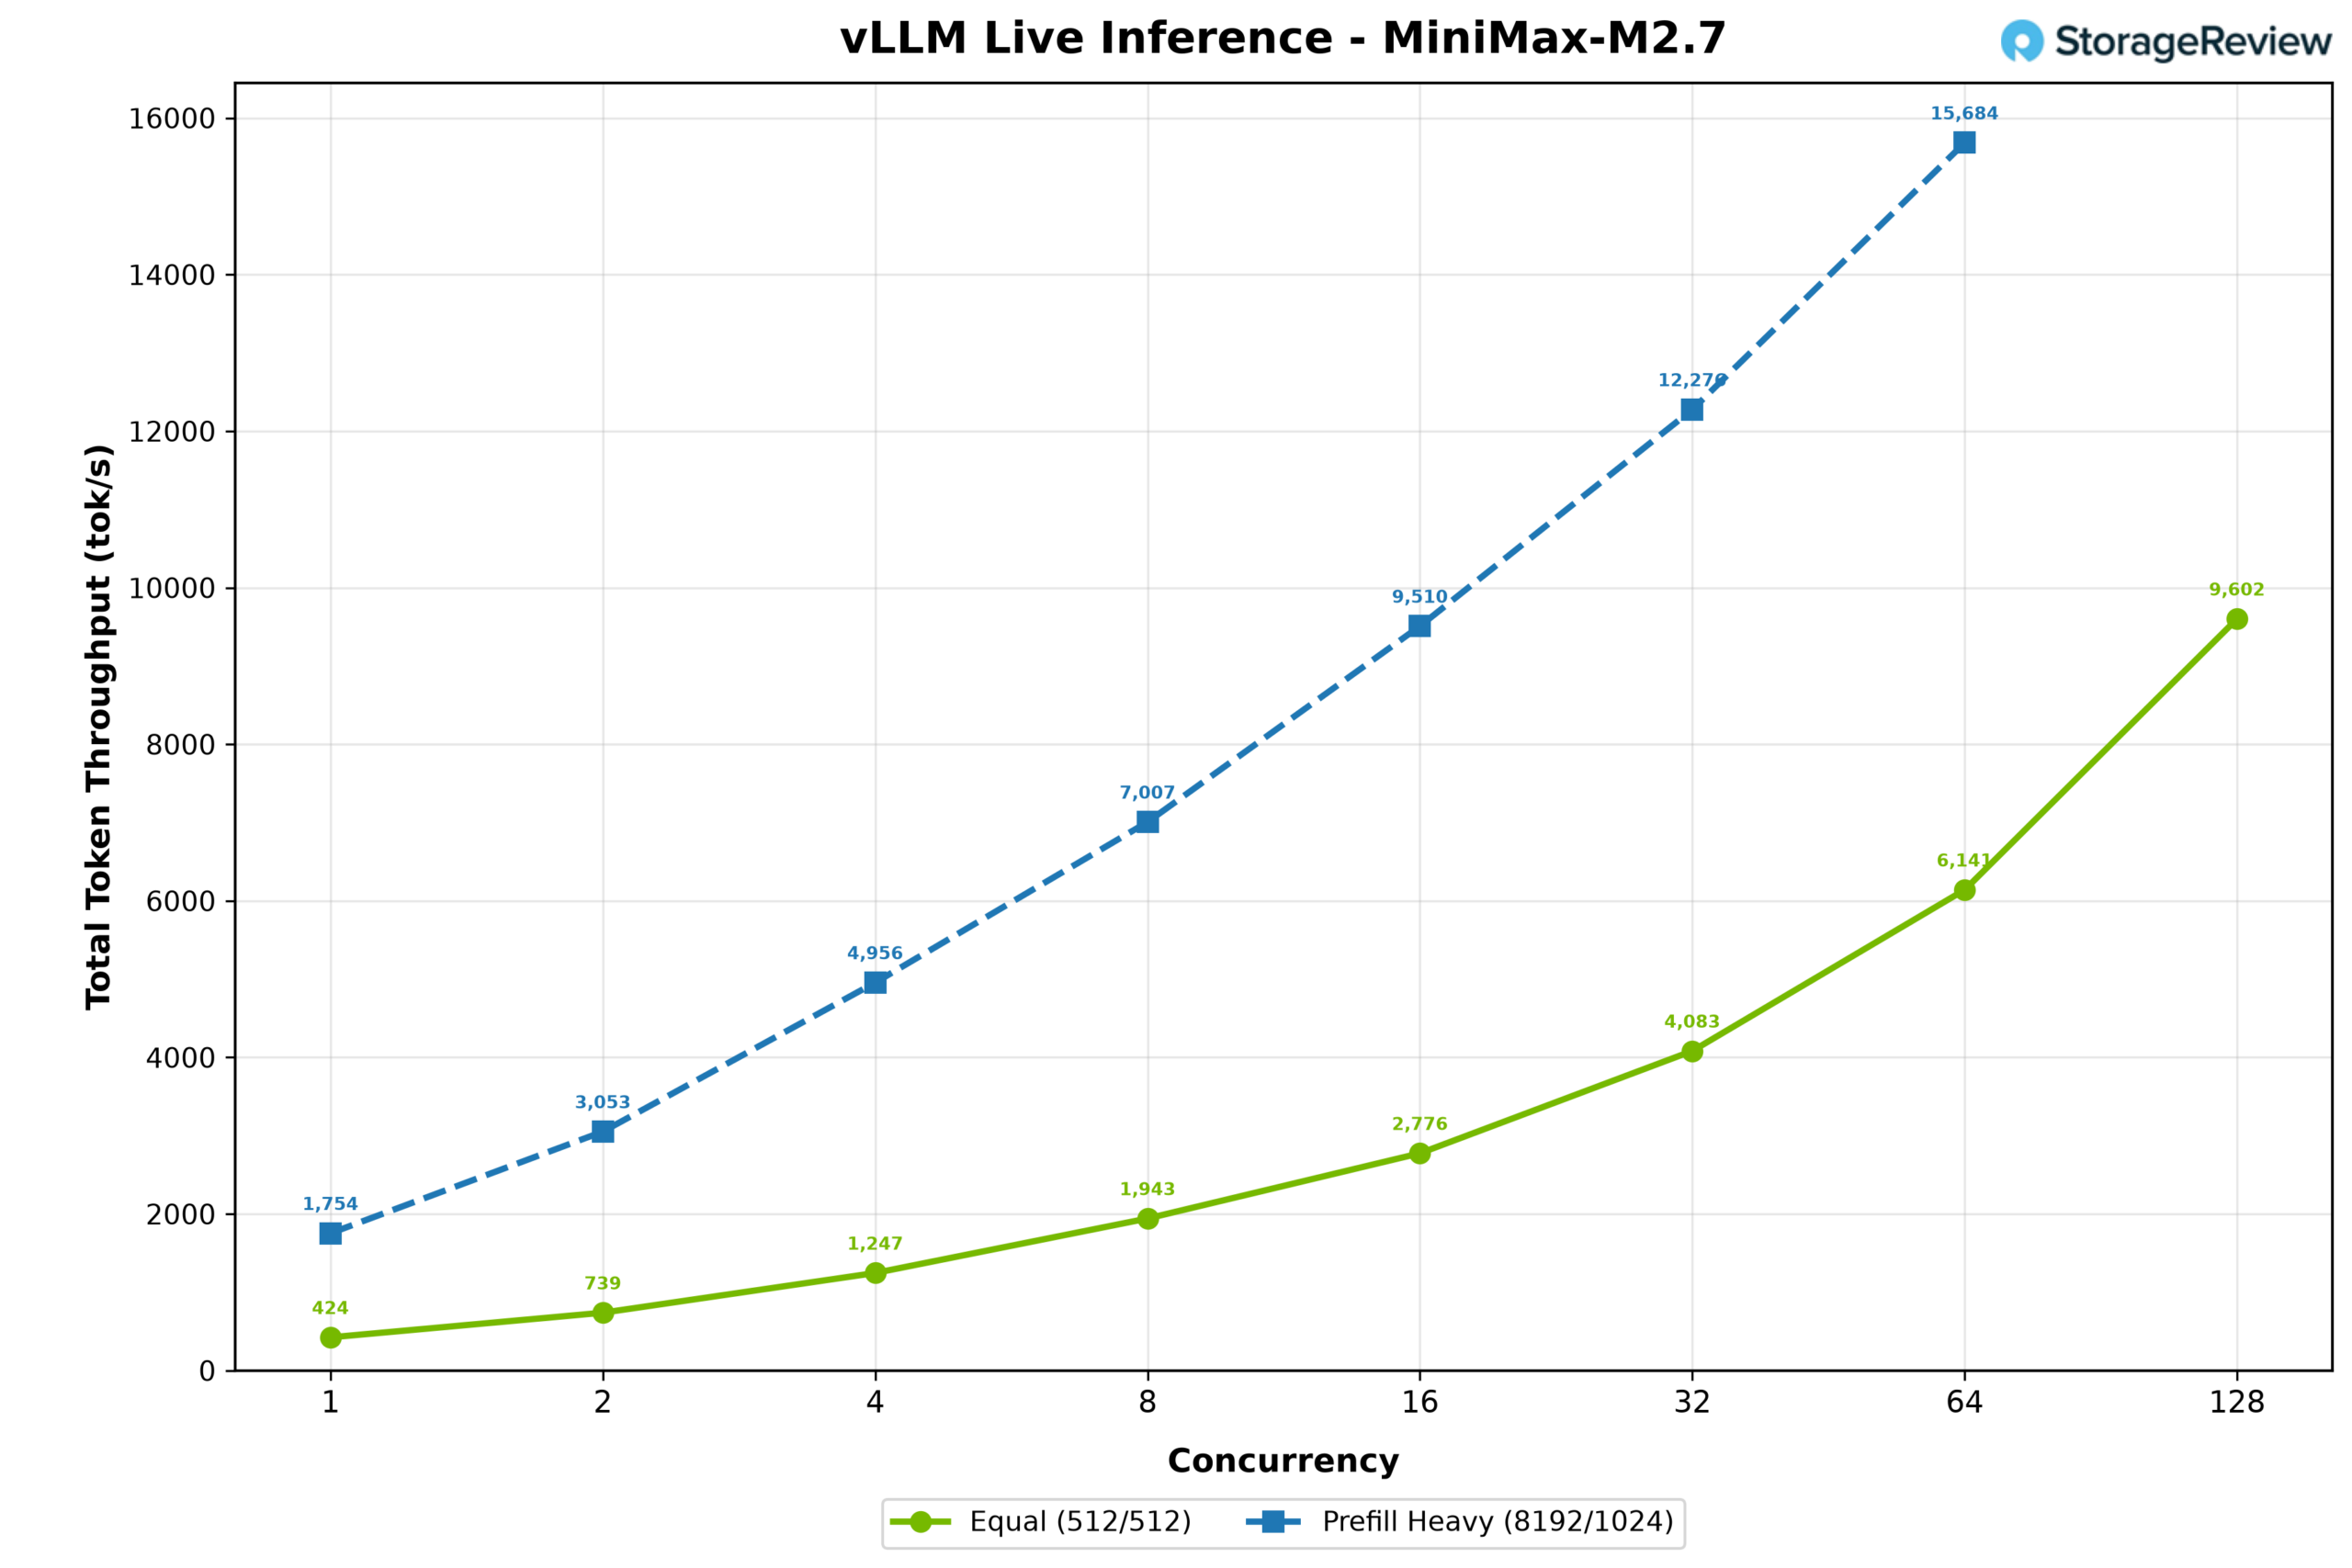
Ďalším v poradí je MiniMax M2.7, jeden z našich obľúbených modelov, testovaný s využitím NVIDIA NVFP4 quant, ktorý zaberá 125 GB VRAM. V pracovnom zaťažení 512/512 sa výstupná priepustnosť začala na 193 tokenoch za sekundu pri súbežnosti 1 a rýchlo sa zvýšila na 4 801 tokenov za sekundu pri súbežnosti 128. Pracovné zaťaženie s vysokou mierou predfillovania sa zvýšilo zo 195 tokenov za sekundu pri súbežnosti 1 na 1 743 tokenov za sekundu pri súbežnosti 64. Celková priepustnosť tokenov vykazovala opačný trend, pričom pracovné zaťaženie s vysokou mierou predfillovania sa zvýšilo z 1 754 na 15 684 tokenov za sekundu do súbežnosti 64, zatiaľ čo pracovné zaťaženie 512/512 sa zvýšilo zo 424 na 9 602 tokenov za sekundu pri súbežnosti 128.
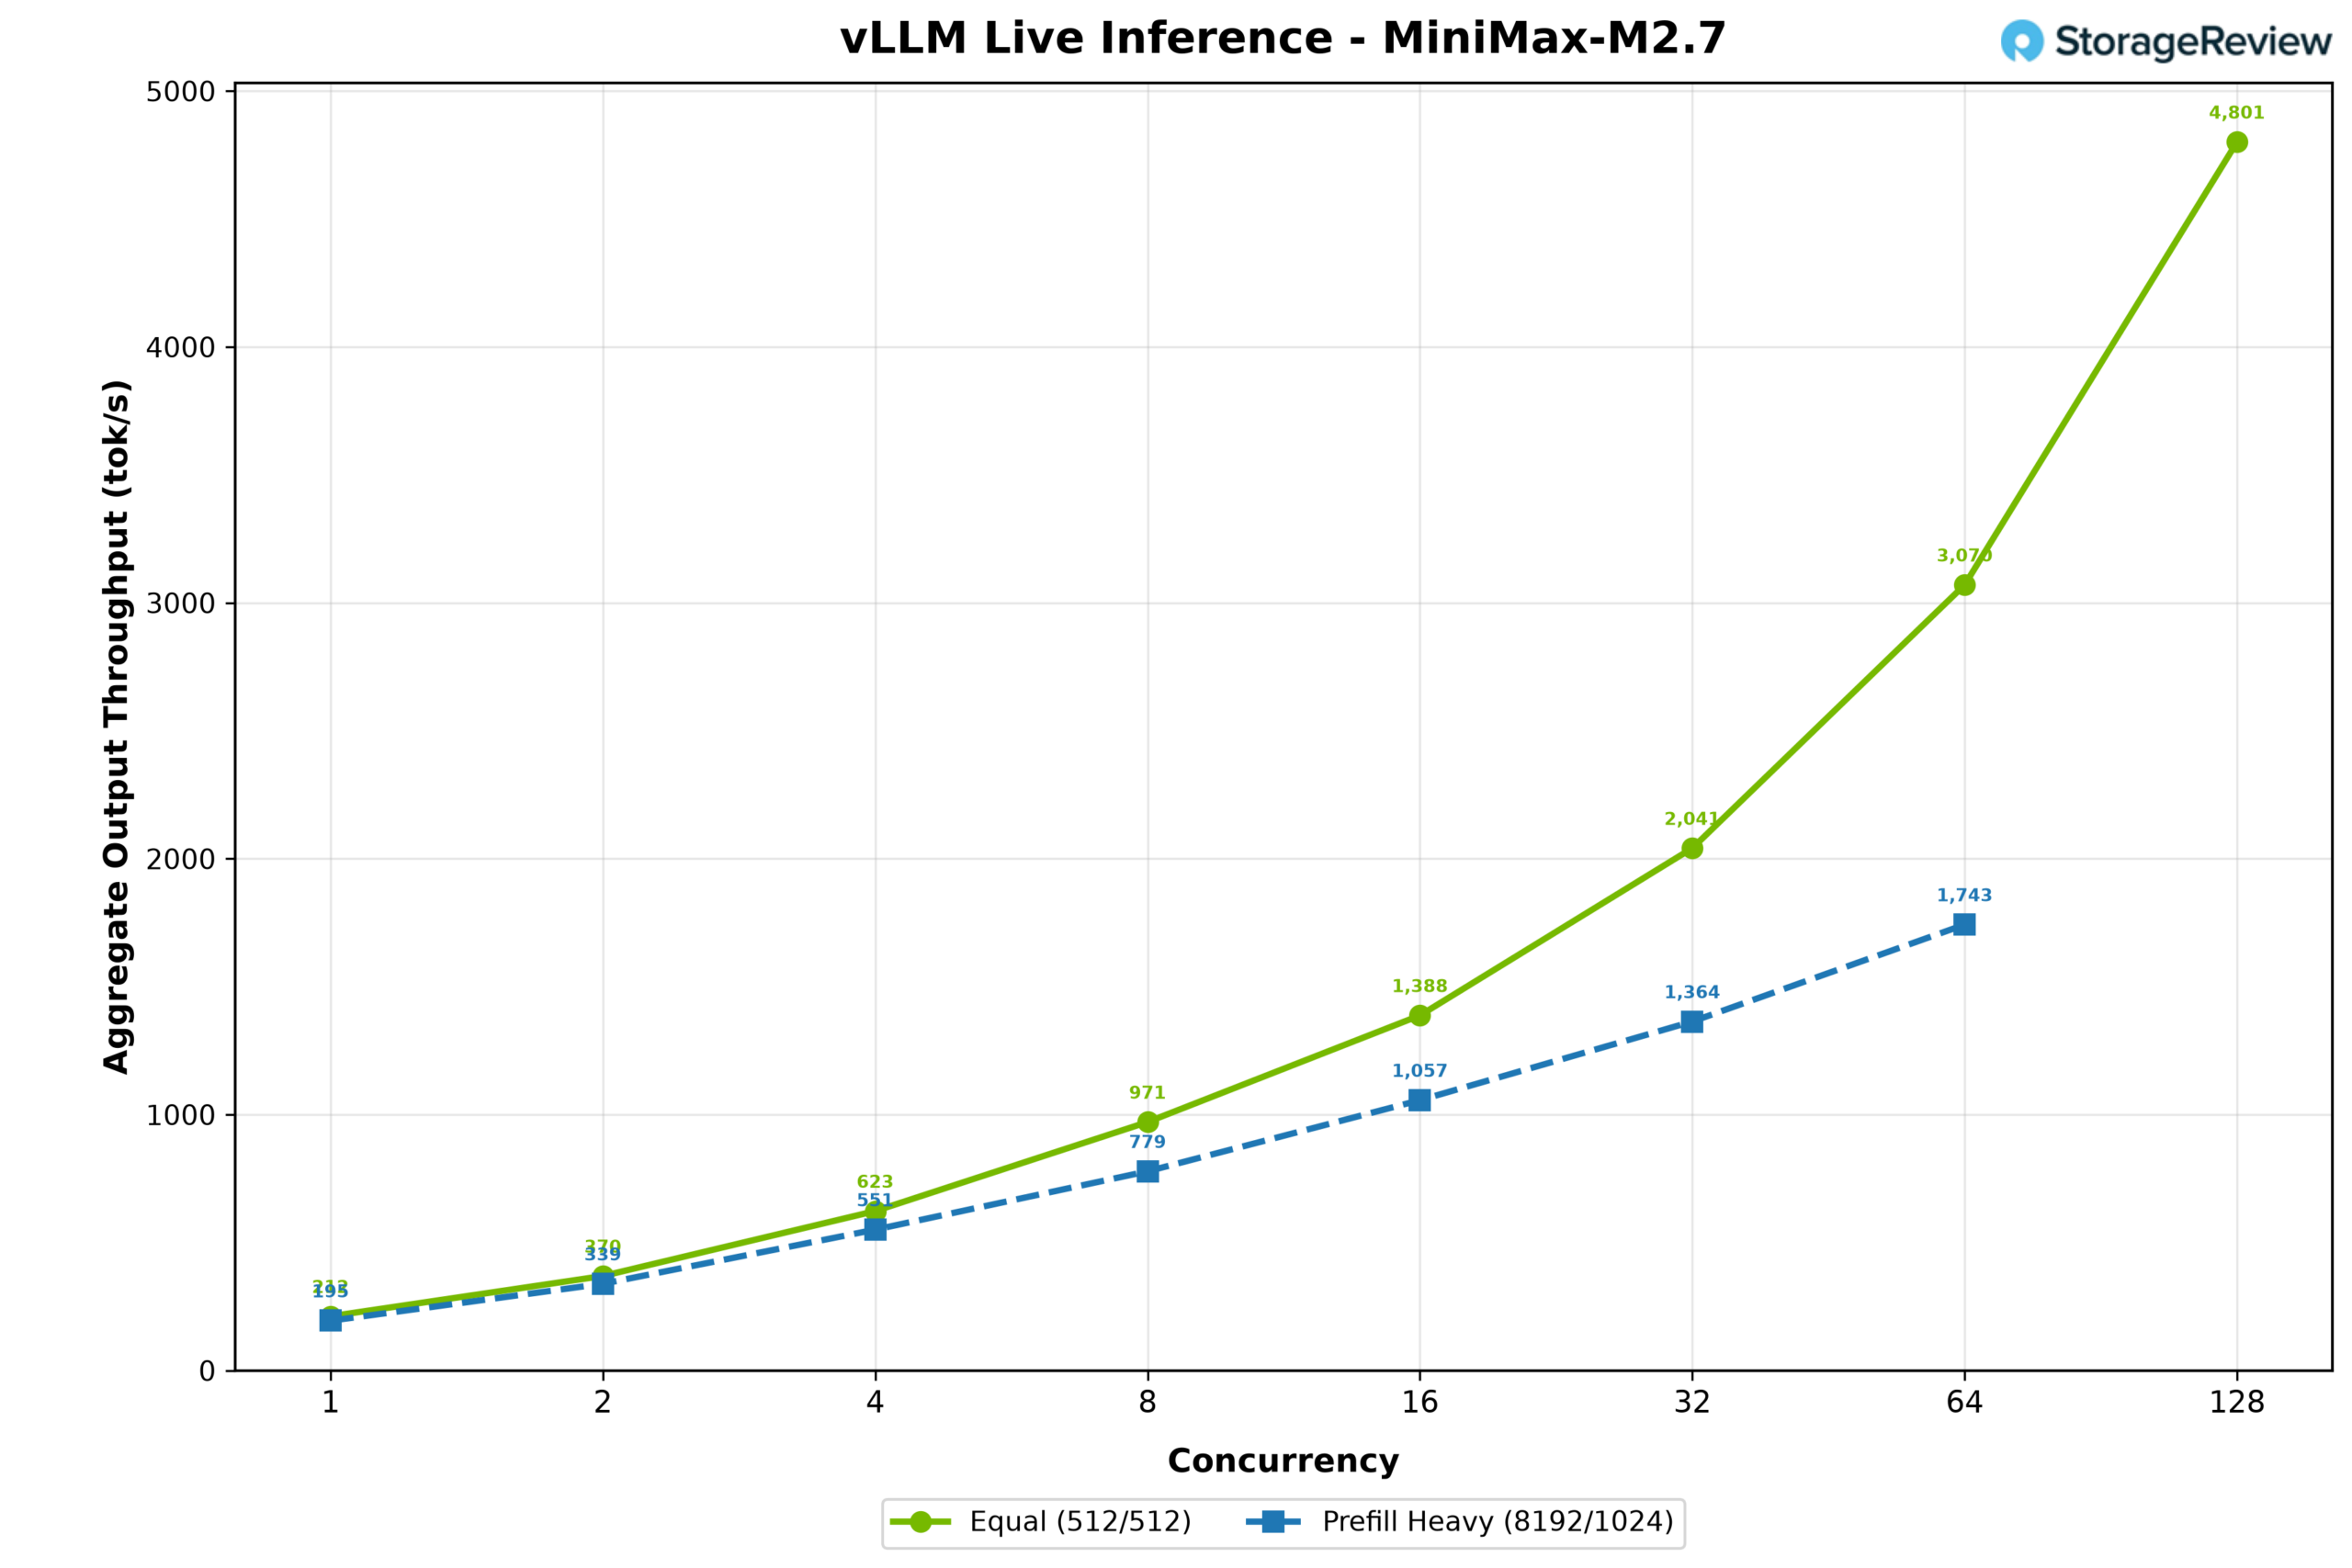
Celková priepustnosť tokenov vykazovala opačný trend, pričom pracovná záťaž s vysokým zameraním na predfill sa do úrovne súbežnosti 64 zvýšila z 1 754 na 15 684 tokenov za sekundu, zatiaľ čo pracovná záťaž 512/512 sa pri úrovni súbežnosti 128 zvýšila zo 424 na 9 602 tokenov za sekundu.
Modely, ktoré sa ledva zmestia do HBM
MiniMax M3 (NVFP4)
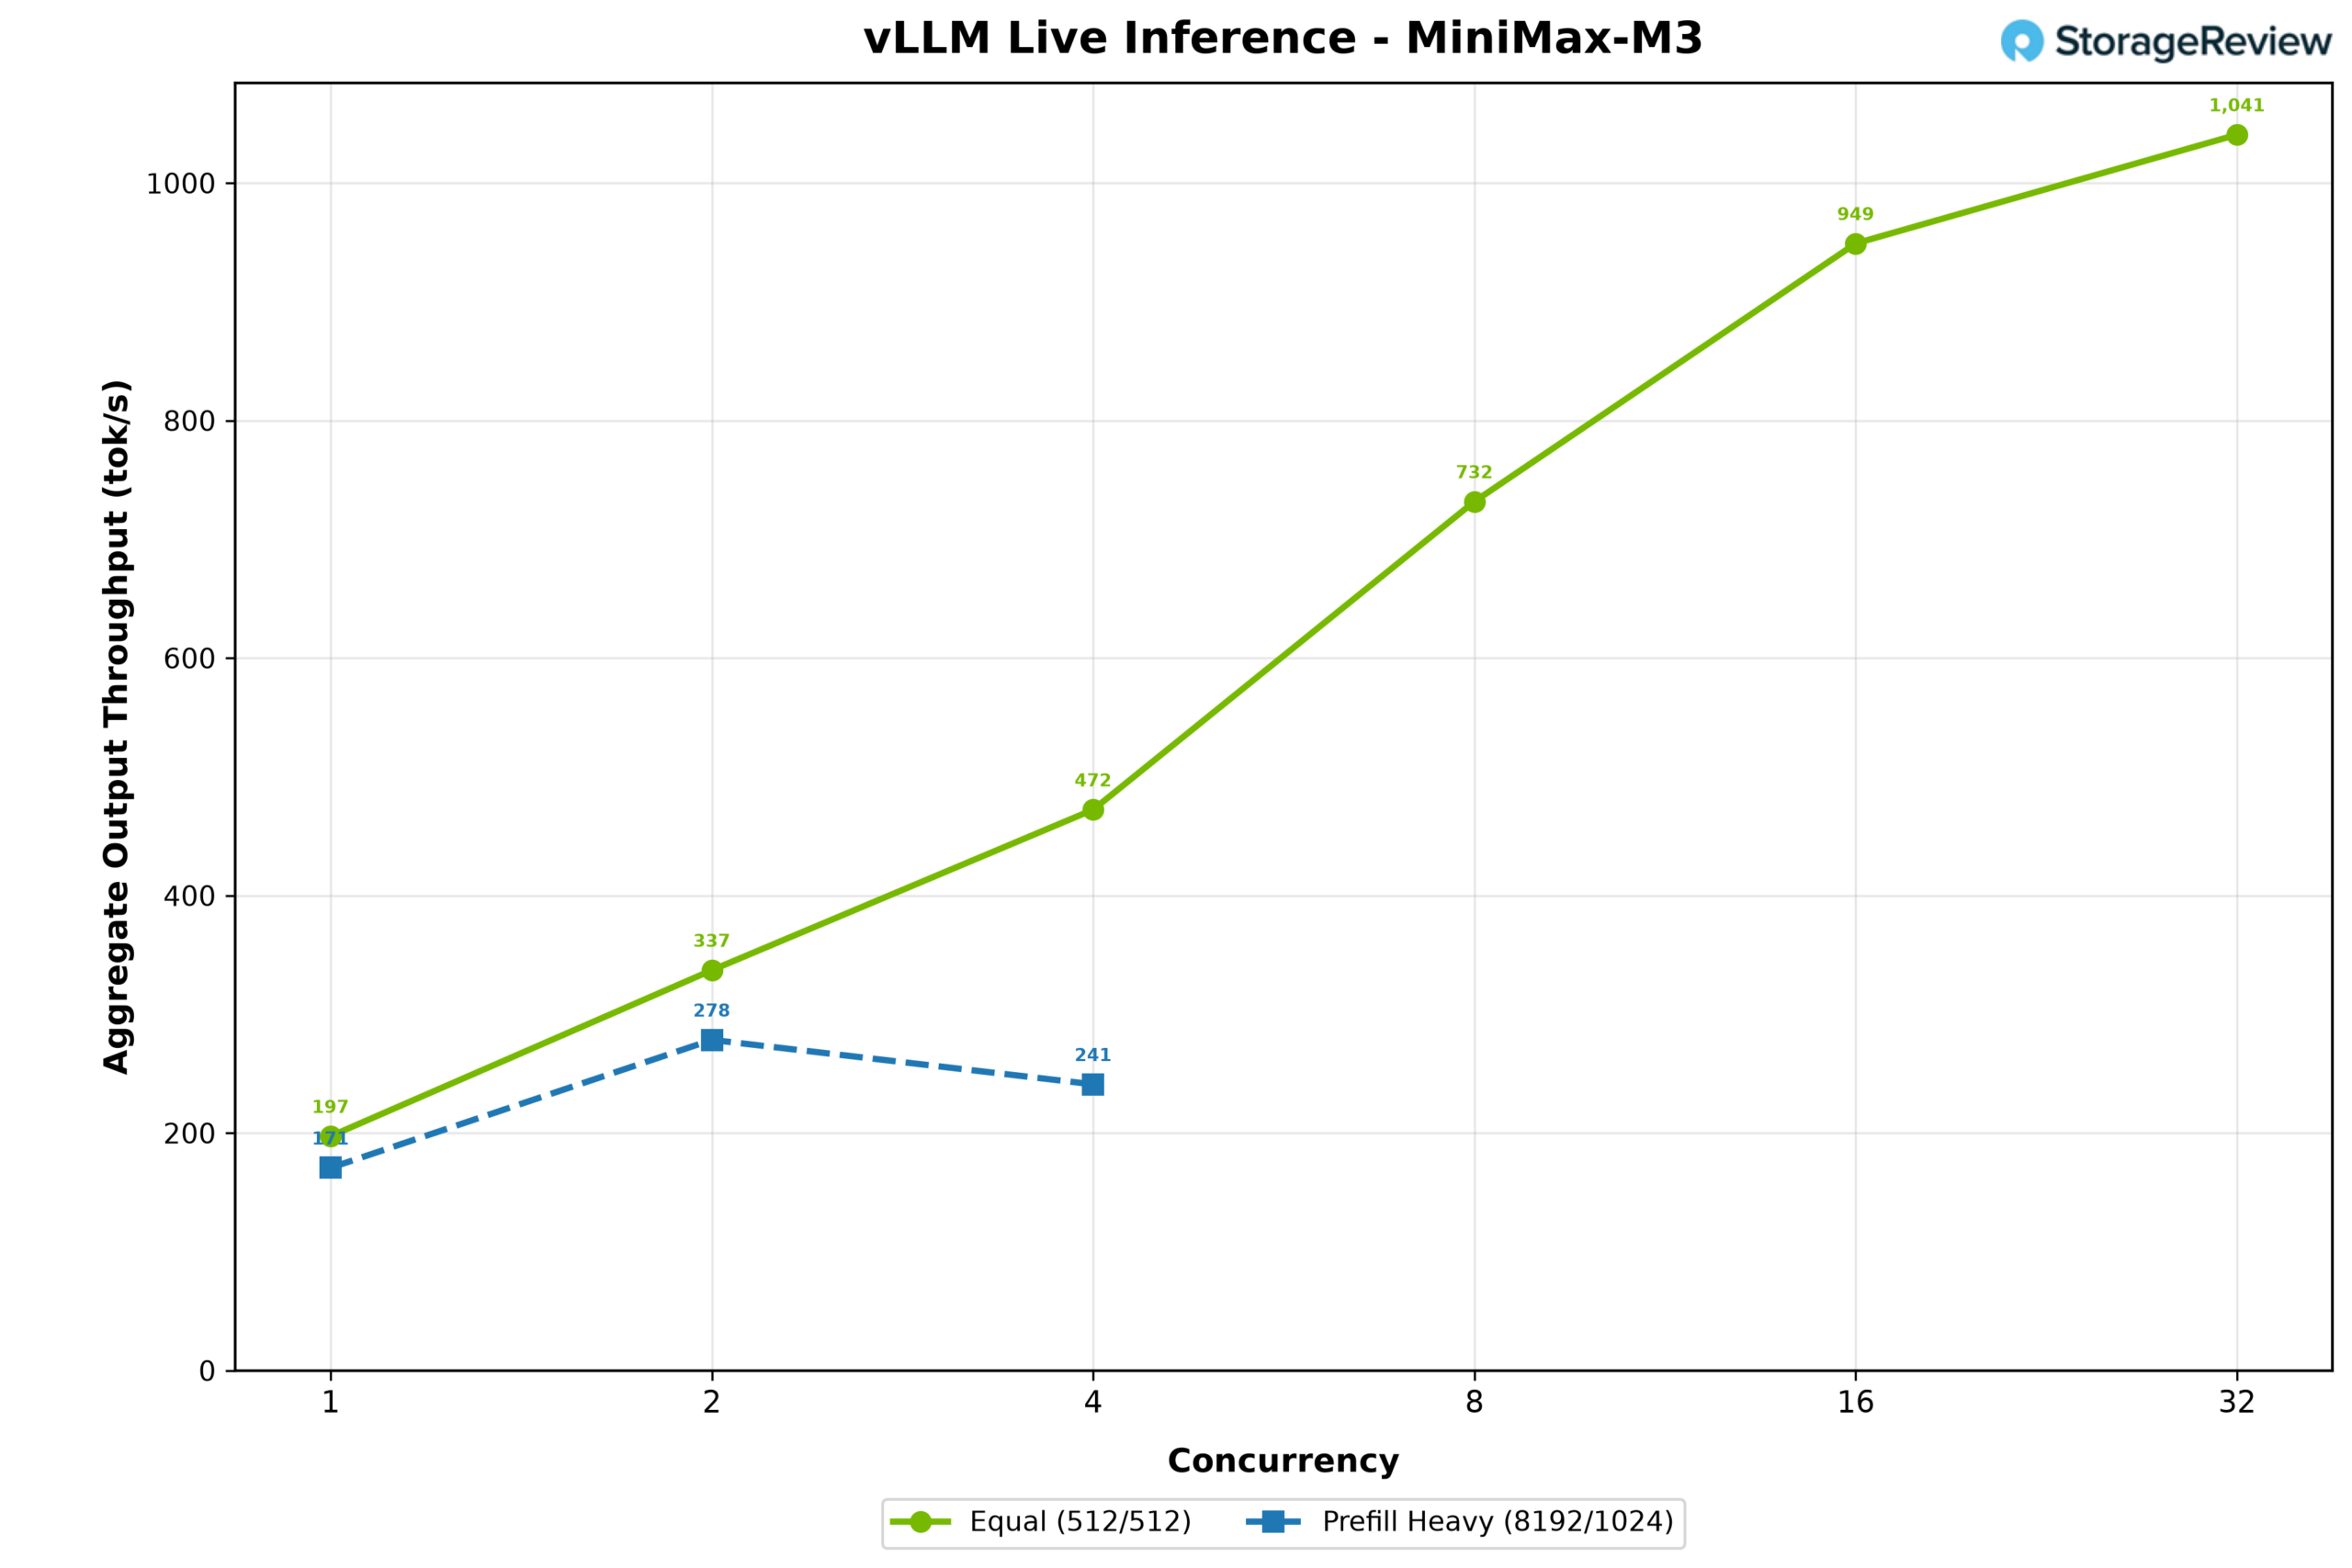
MiniMax M3 ukazuje, ako v praxi vyzerá situácia, keď sa sotva zmestí. Jeho 233GB kontrolný bod NVFP4 je menší ako 252GB HBM modelu B300, ale model stále potrebuje miesto pre runtime a KV vyrovnávaciu pamäť. Nakoniec obsadil 223GB HBM, pričom 21GB expertov bolo presunutých do Grace. Použilo sa špekulatívne dekódovanie EAGLE3-GQA so syntetickou akceptačnou dĺžkou 3 tokeny. V pracovnom zaťažení 512/512 sa výstupná priepustnosť začala na 197 tokenoch za sekundu pri súbežnosti 1 a postupne sa škálovala na 1 041 tokenov za sekundu pri súbežnosti 32. Pracovné zaťaženie s vysokým počtom predfillov sa zvýšilo zo 171 tokenov za sekundu pri súbežnosti 1 na vrchol 278 pri súbežnosti 2, než kleslo na 241 pri súbežnosti 4.
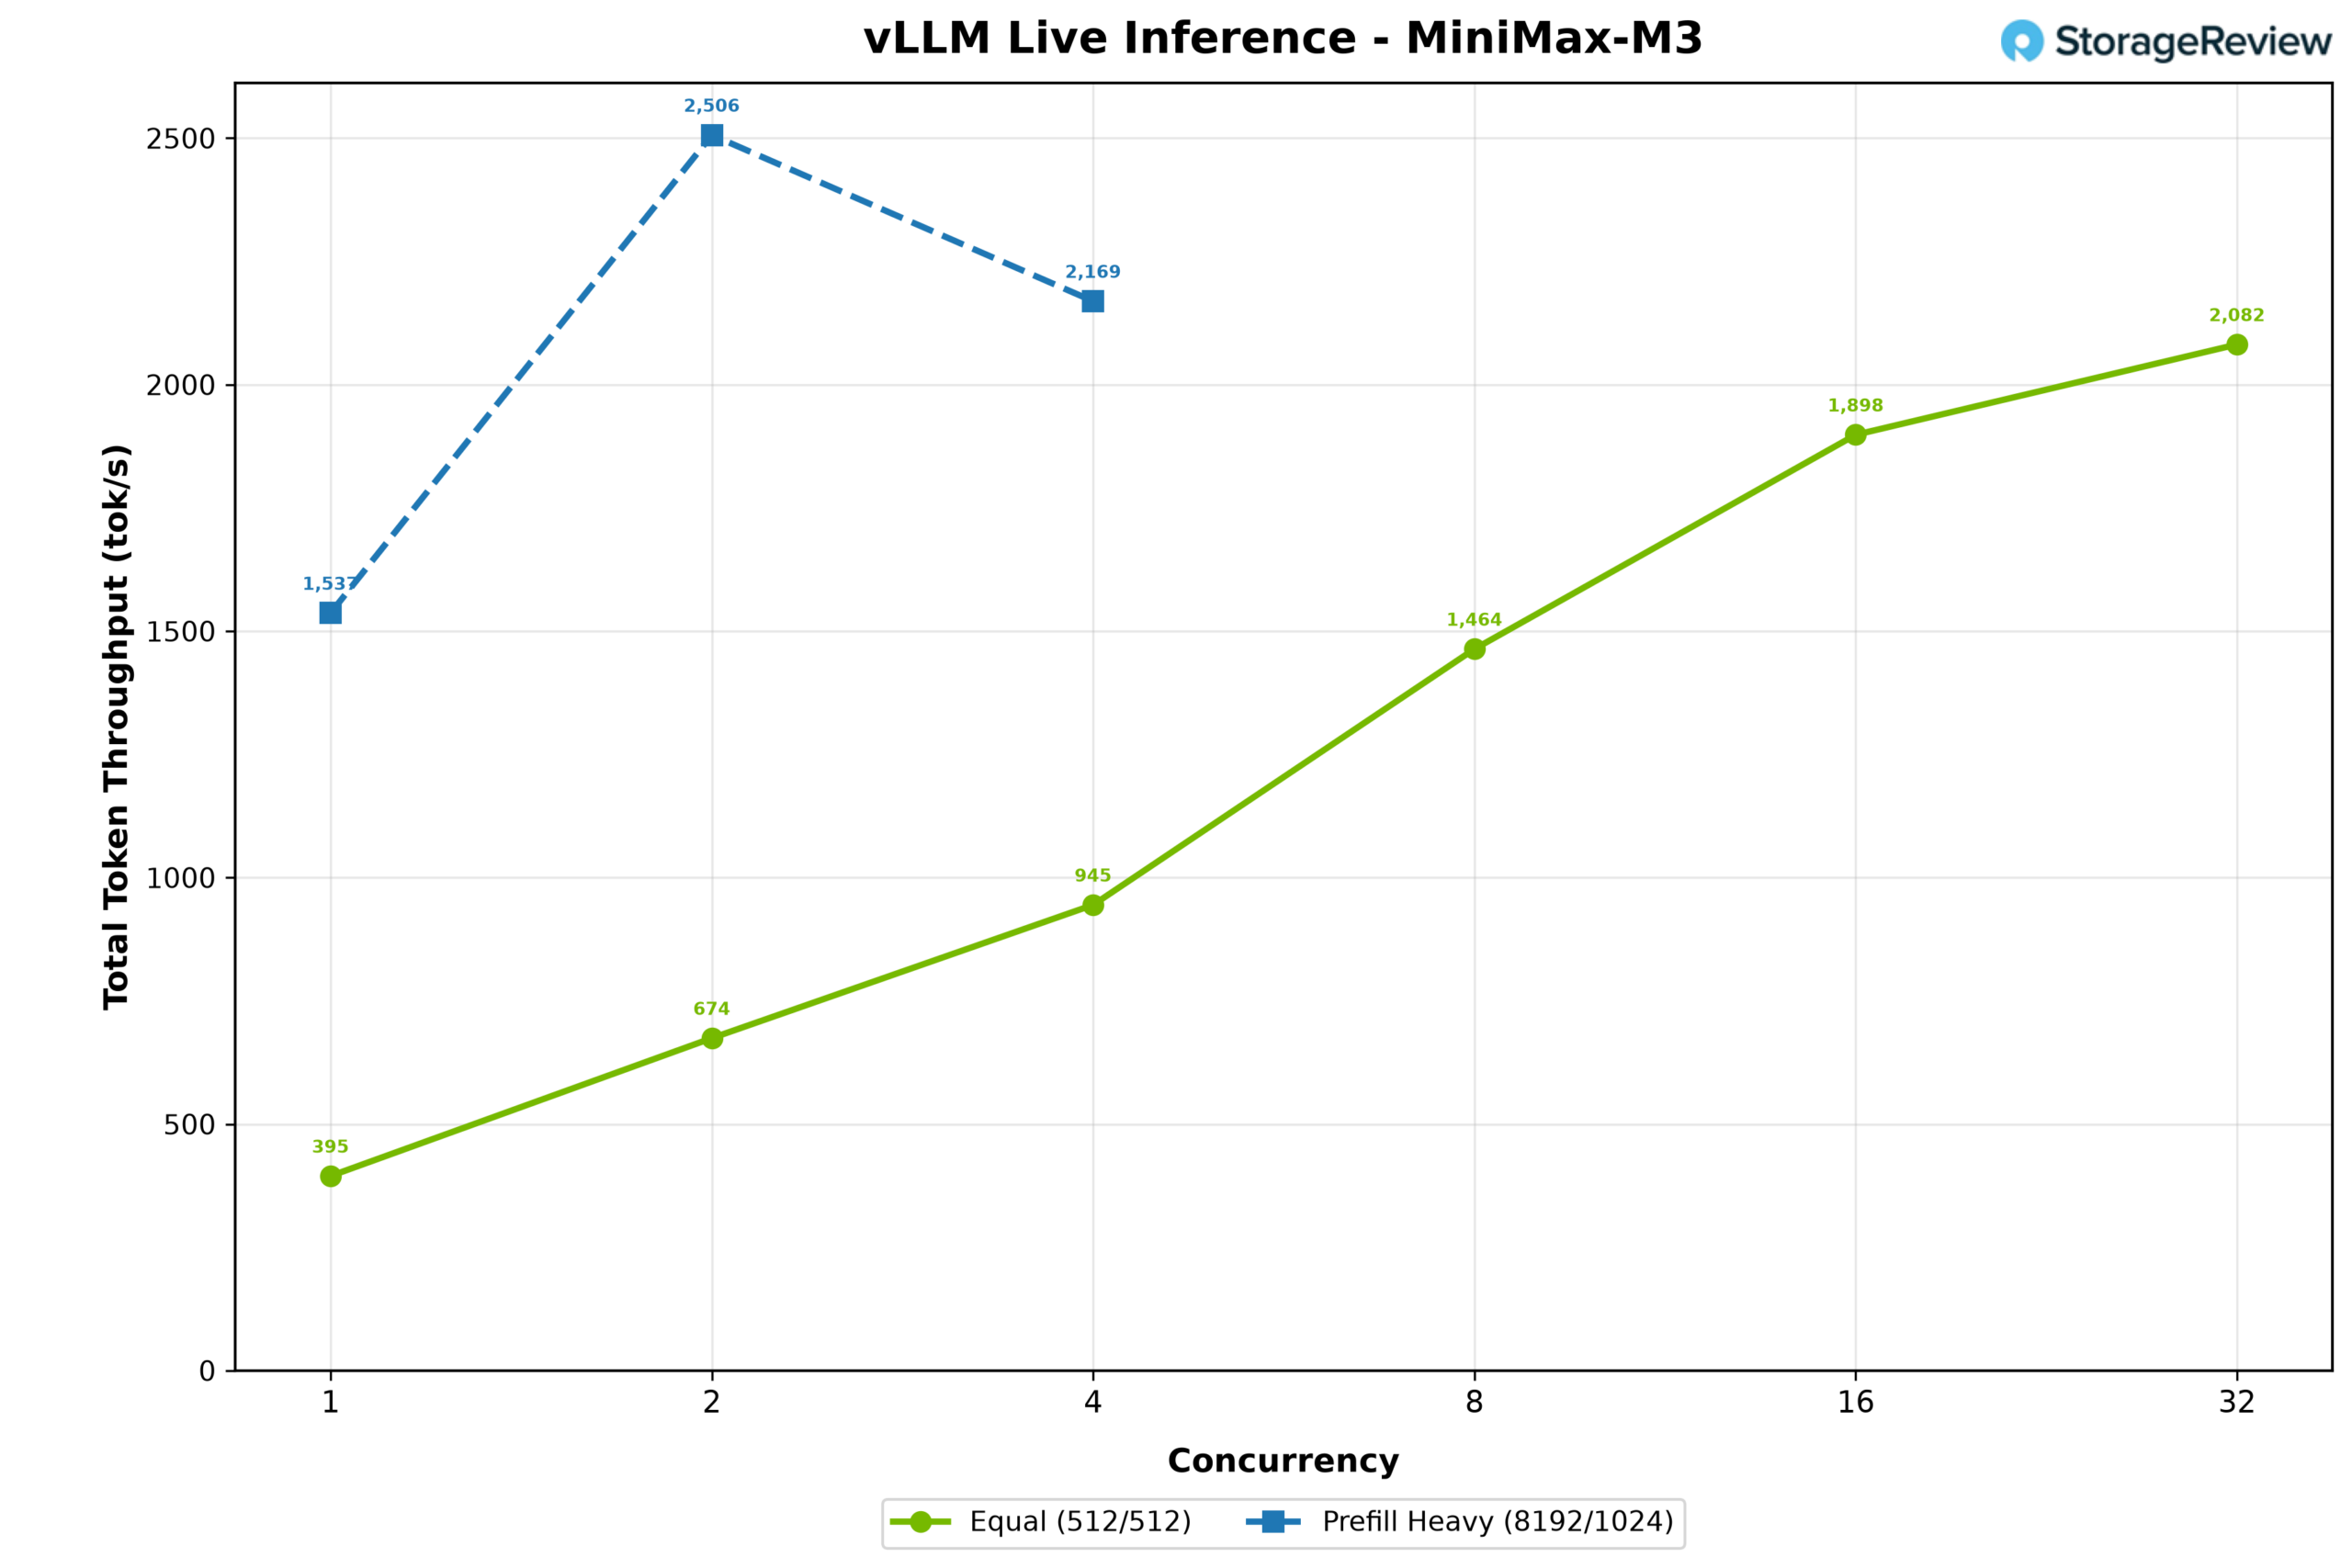
Celková priepustnosť tokenov sledovala podobný vzorec, pričom pracovná záťaž 512/512 vzrástla z 395 na 2 082 tokenov za sekundu, zatiaľ čo pracovná záťaž s vysokým počtom preddopĺňania dosiahla vrchol 2 506 tokenov za sekundu pri súbežnosti 2 a potom klesla na 2 169 pri súbežnosti 4.
Modely, ktoré sa nehodia do HBM
GLM-5.2 (NVFP4)
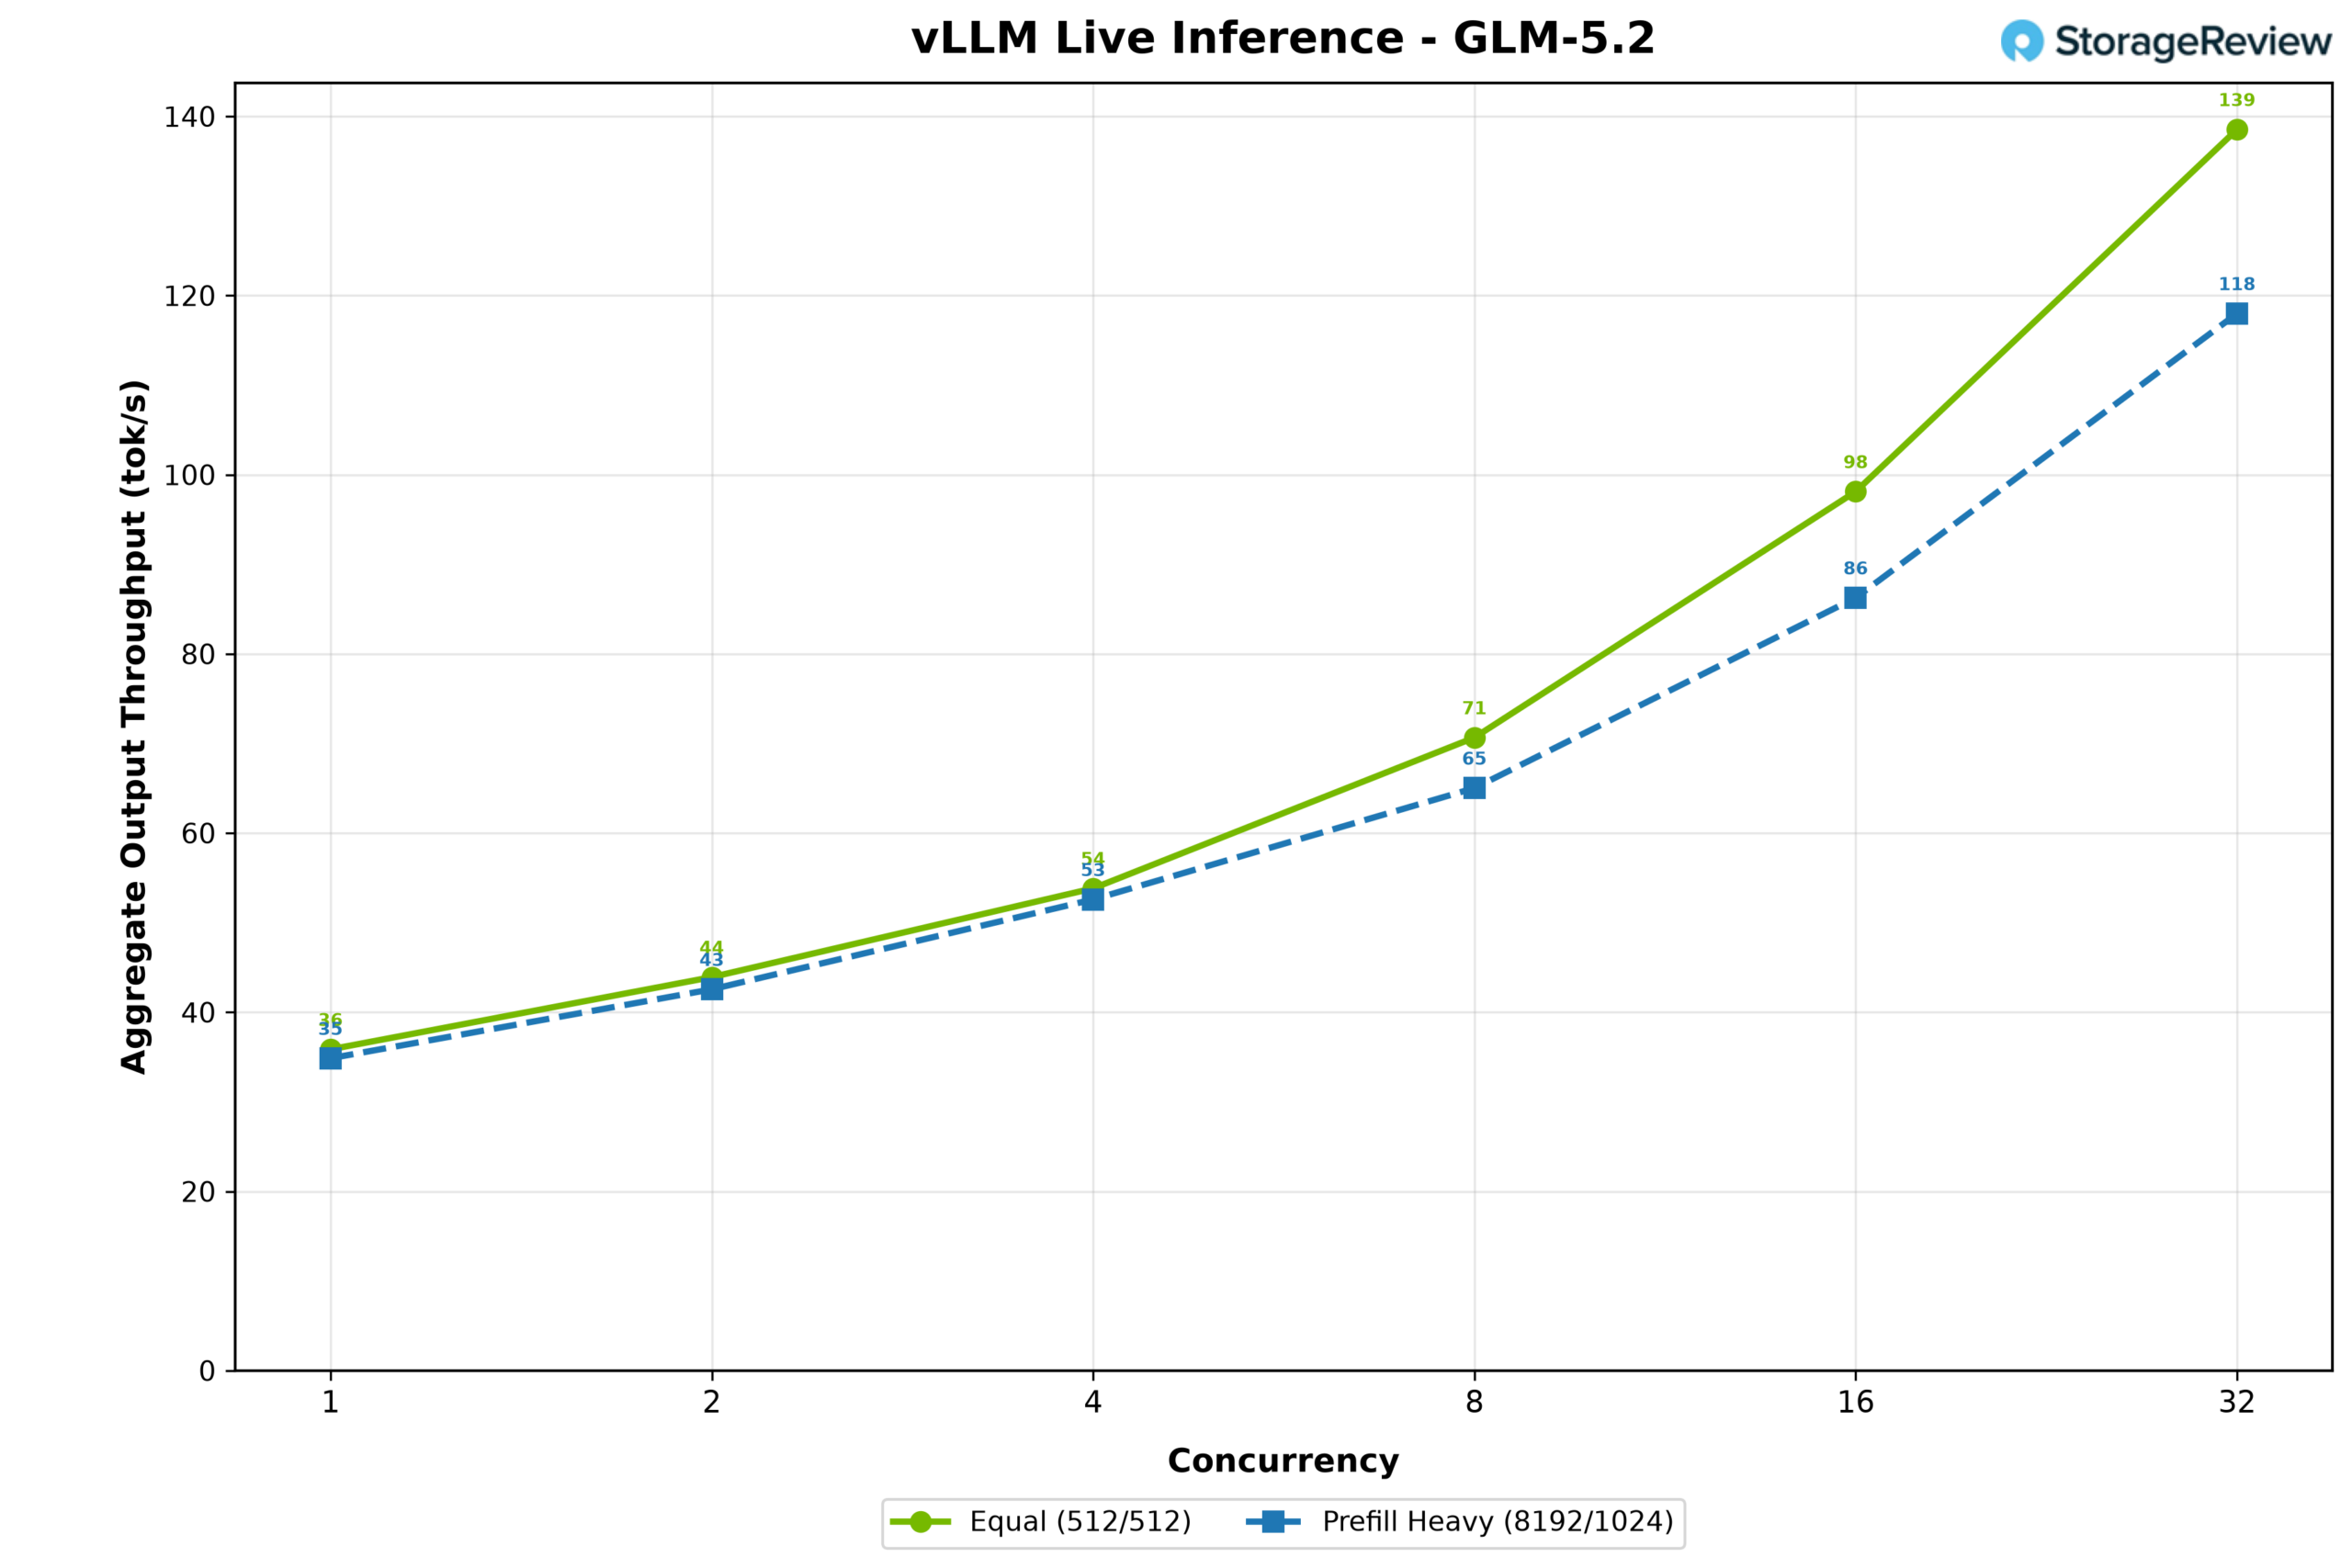
GLM-5.2 bol testovaný s použitím kvantifikátora NVFP4 od spoločnosti NVIDIA. Jeho kontrolný bod s kapacitou 433 GB využil 218 GB HBM, pričom 216 GB váh expertov bolo uvoľnených do pamäte Grace. Použilo sa špekulatívne dekódovanie MTP so syntetickou akceptačnou dĺžkou 3 tokeny. Výstupná priepustnosť v pracovnej záťaži 512/512 sa zvýšila z 36 tokenov za sekundu pri súbežnosti 1 na 139 pri súbežnosti 32. Pracovná záťaž 8 192/1 024 tesne nasledovala, pričom sa zvýšila z 35 na 118 tokenov za sekundu. Podobné výsledky medzi týmito dvoma profilmi ukazujú, že generovanie zostalo obmedzené predovšetkým presunom uvoľnených expertov medzi pamäťou Grace a GPU. Prehľad sa skončil pri súbežnosti 32, pretože nezostal dostatok HBM pre ďalší kontext.
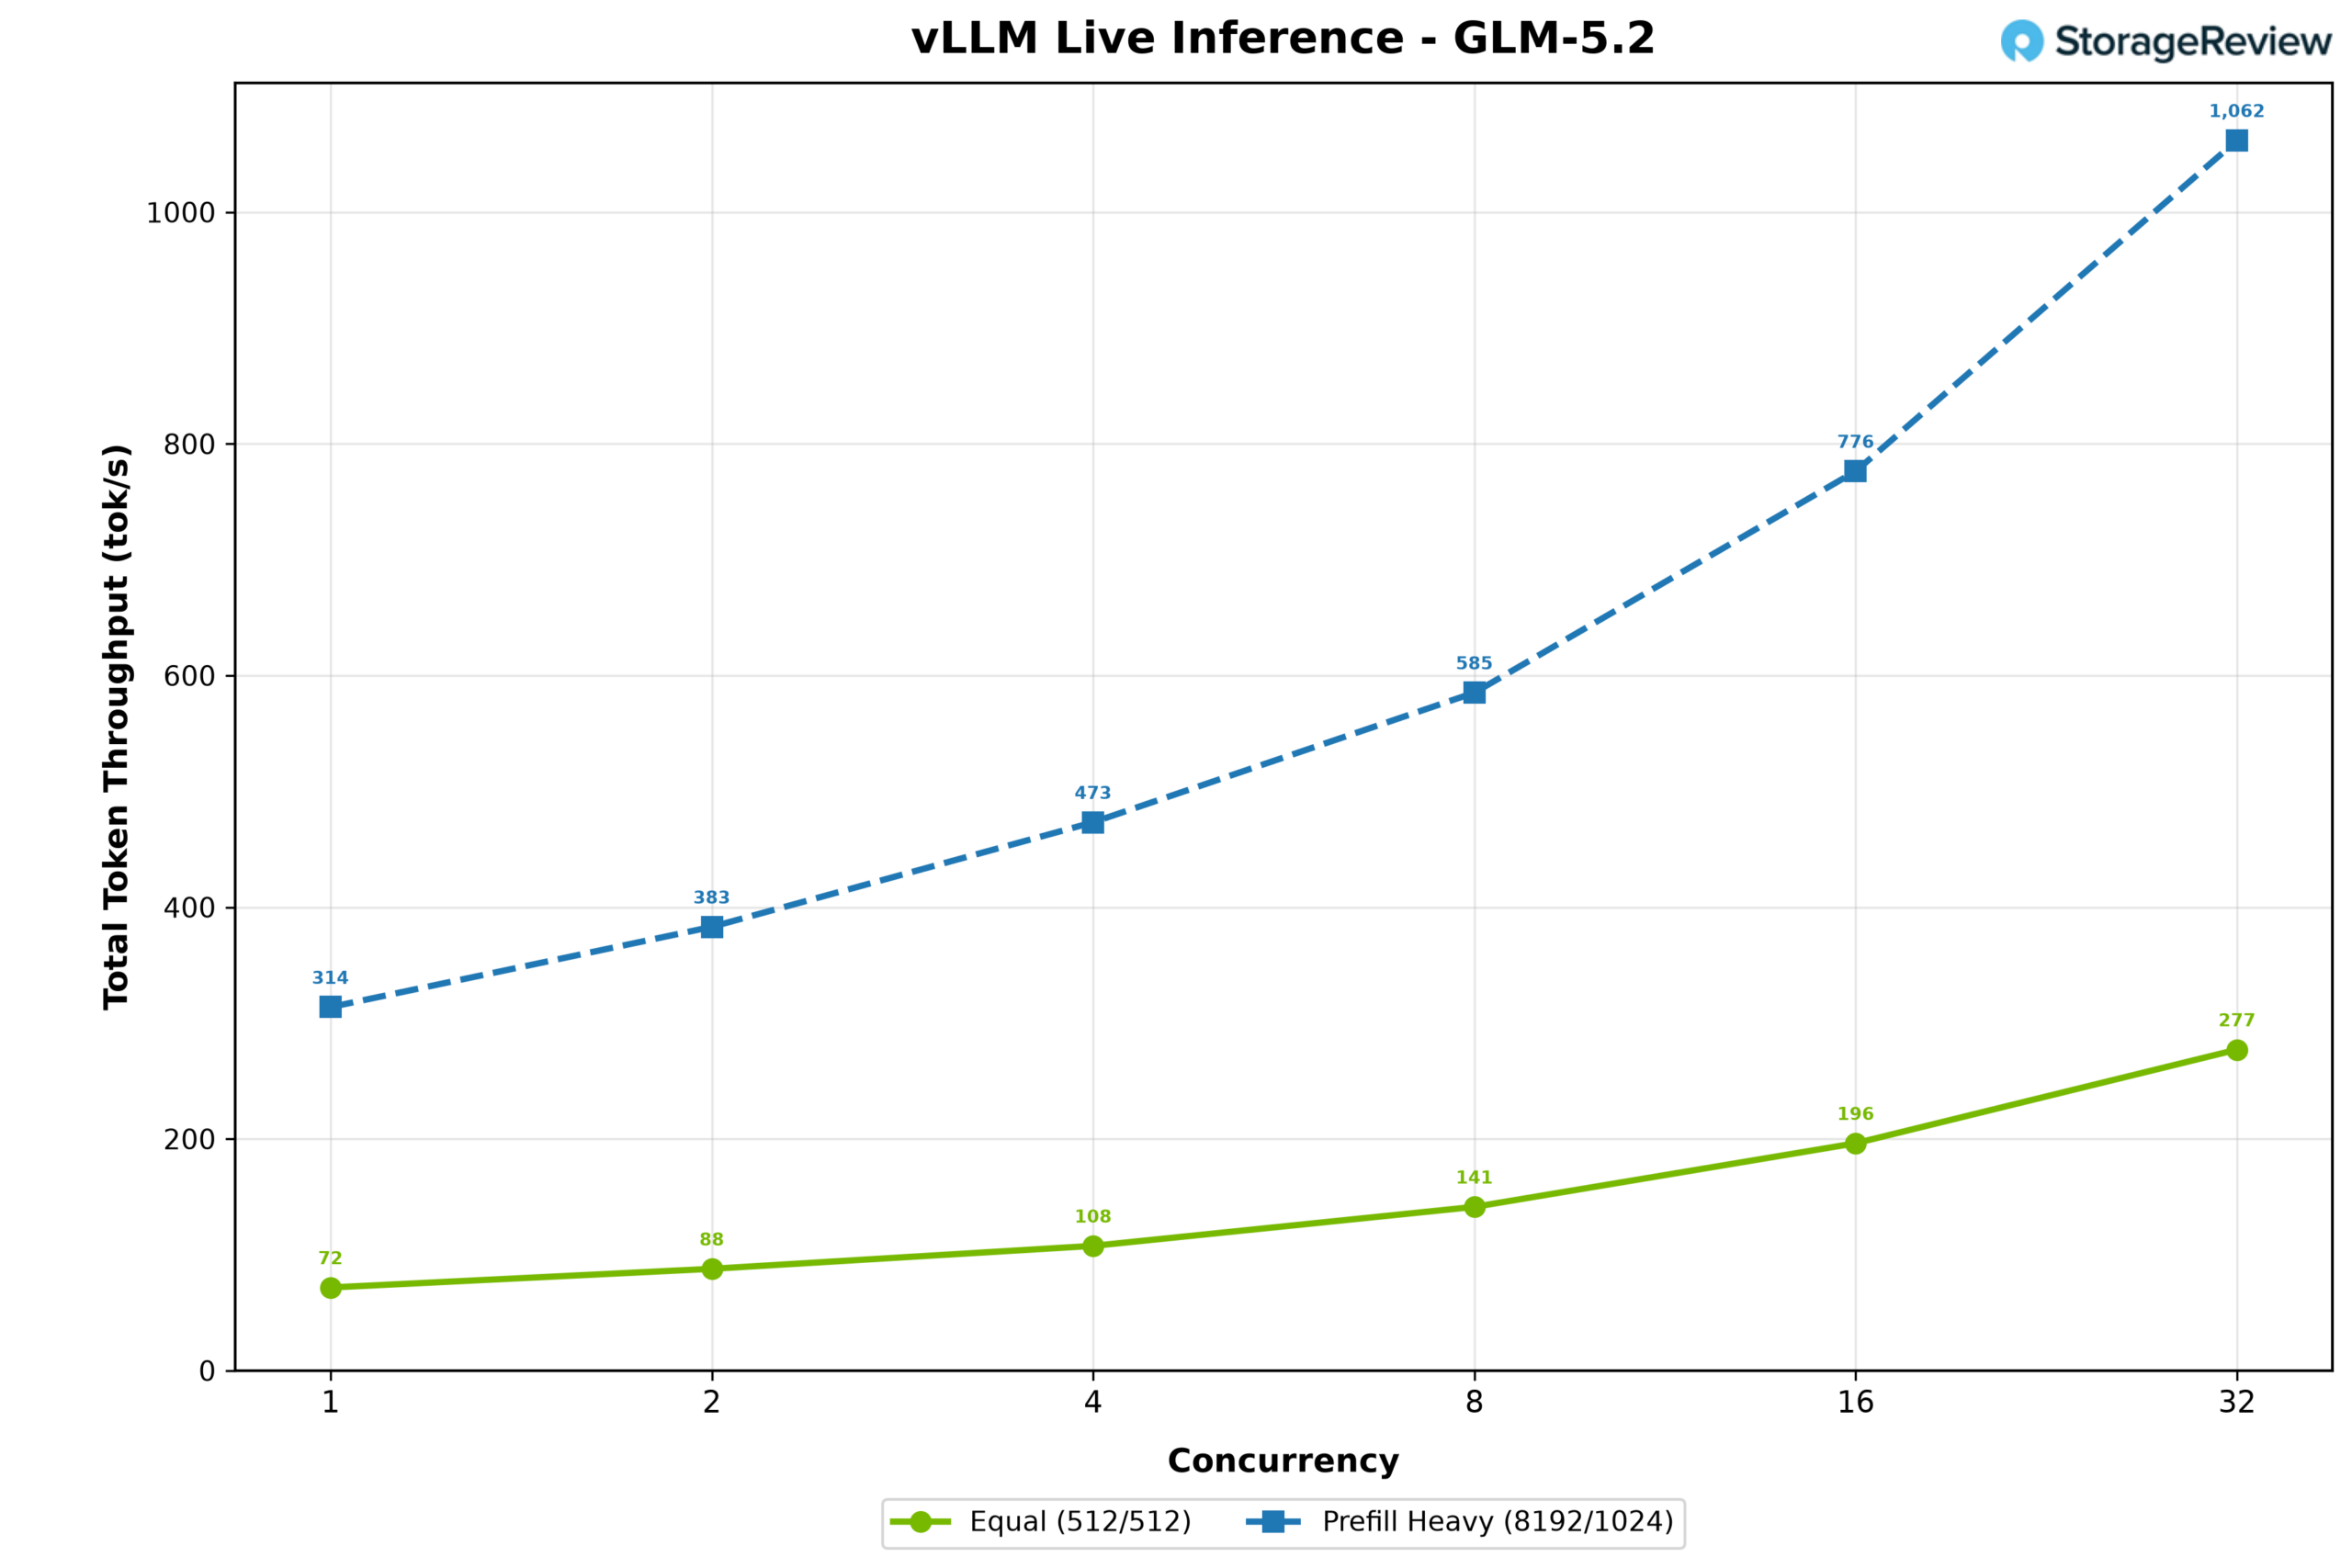
Celková priepustnosť tokenov sledovala rovnaký vzorec, pričom pracovná záťaž 512/512 vzrástla zo 72 na 277 tokenov za sekundu a pracovná záťaž s vysokým počtom predfillov vzrástla z 314 na 1 062; tu dlhšie výzvy konečne oddeľujú tieto dva profily, pretože samotné predfillové tokeny sa započítavajú do celkového počtu.
Nemotron-3-Ultra 550B (NVFP4)
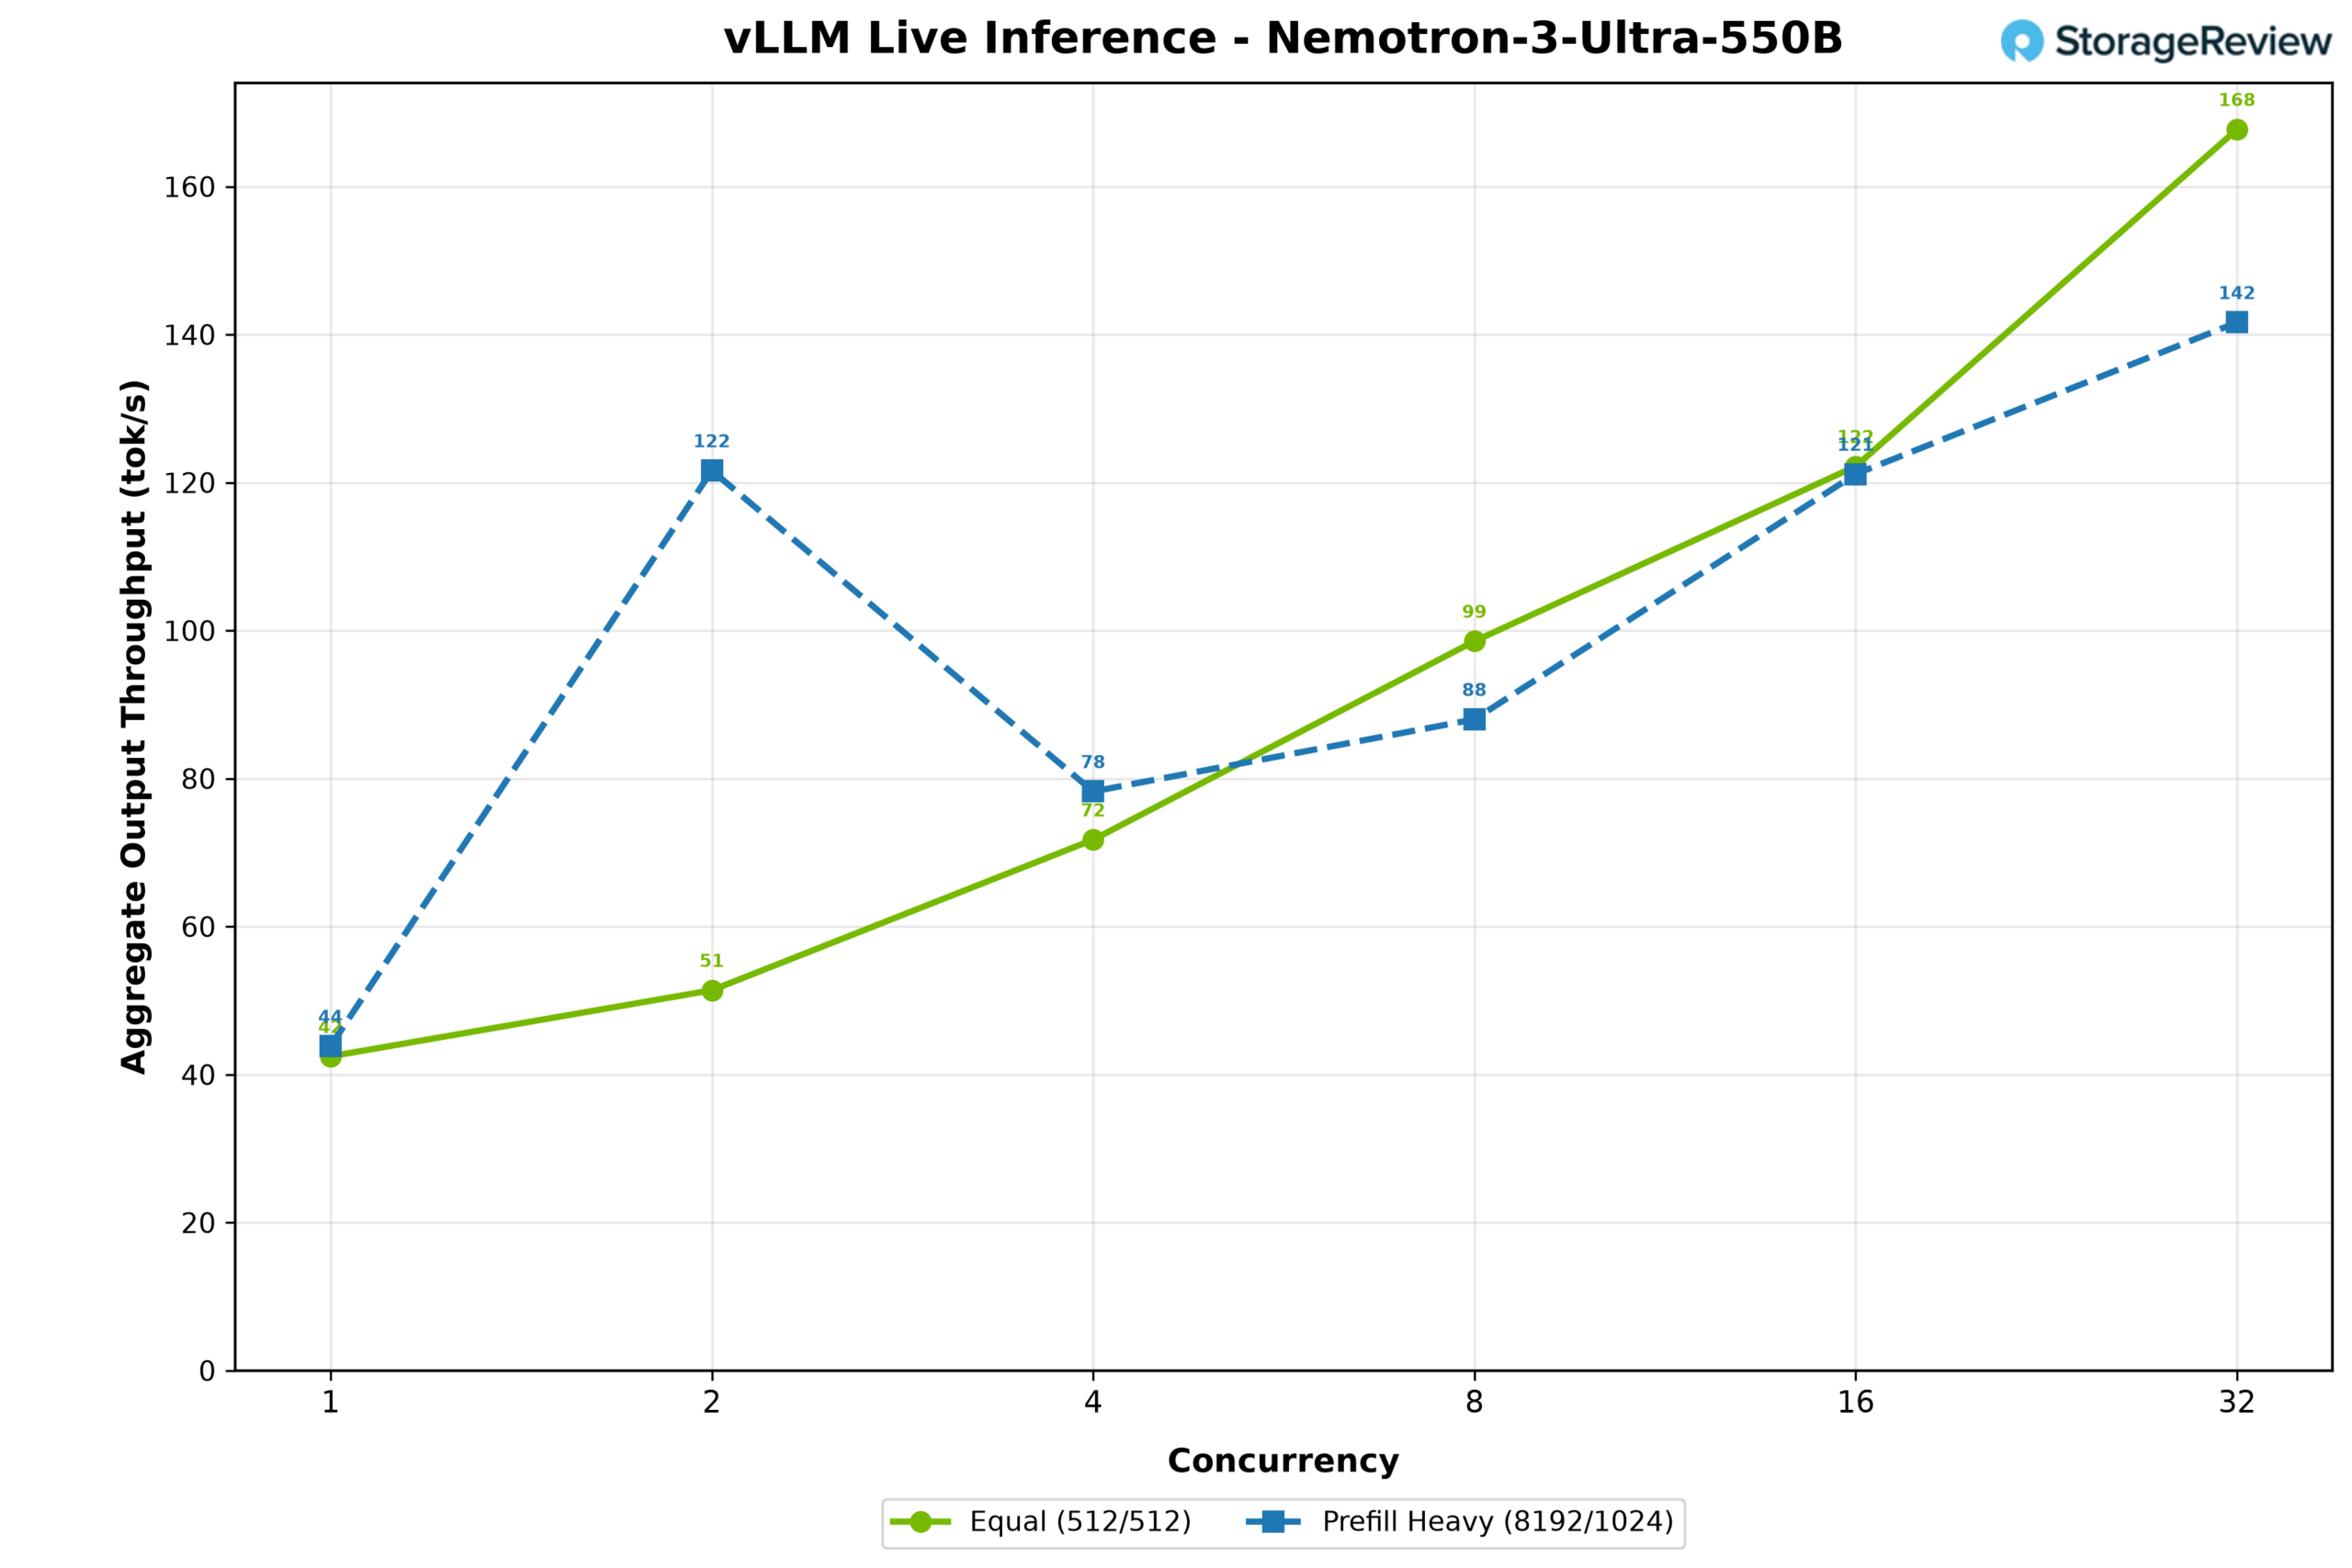
Nemotron-3-Ultra 550B je najväčší model, ktorý sme spustili, a ten, ktorý najpriamejšie využíva celý koherentný fond. Ide o 307GB hybridný model Transformer-Mamba s NVFP4, ktorý je príliš veľký len pre HBM, pričom 114 GB jeho váh bolo uložených do pamäte Grace. Použilo sa špekulatívne dekódovanie MTP so syntetickou akceptačnou dĺžkou 5 tokenov. Výstupná priepustnosť v pracovnej záťaži 512/512 začala na 43 tokenoch za sekundu pri súbežnosti 1 a stúpla na 168 pri súbežnosti 32. Pracovná záťaž s vysokým počtom predfillov vypovedala zaujímavejší príbeh: priepustnosť vzrástla zo 44 tokenov za sekundu pri súbežnosti 1 na vrchol 122 pri súbežnosti 2, ale potom klesla späť na 78 pri súbežnosti 4, pretože dlhé výzvy zaplnili obmedzenú vyrovnávaciu pamäť KV. Rovnako ako v prípade GLM-5.2, aj tu sa tieto dva profily úzko sledujú, čo opäť poukazuje na migráciu expertov medzi Grace a GPU ako limitujúci faktor, a nie na výpočtový výkon. Prehľadávanie sa skončilo na úrovni súbežnosti 32 z rovnakého dôvodu: nezostal dostatok HBM pre ďalší kontext.
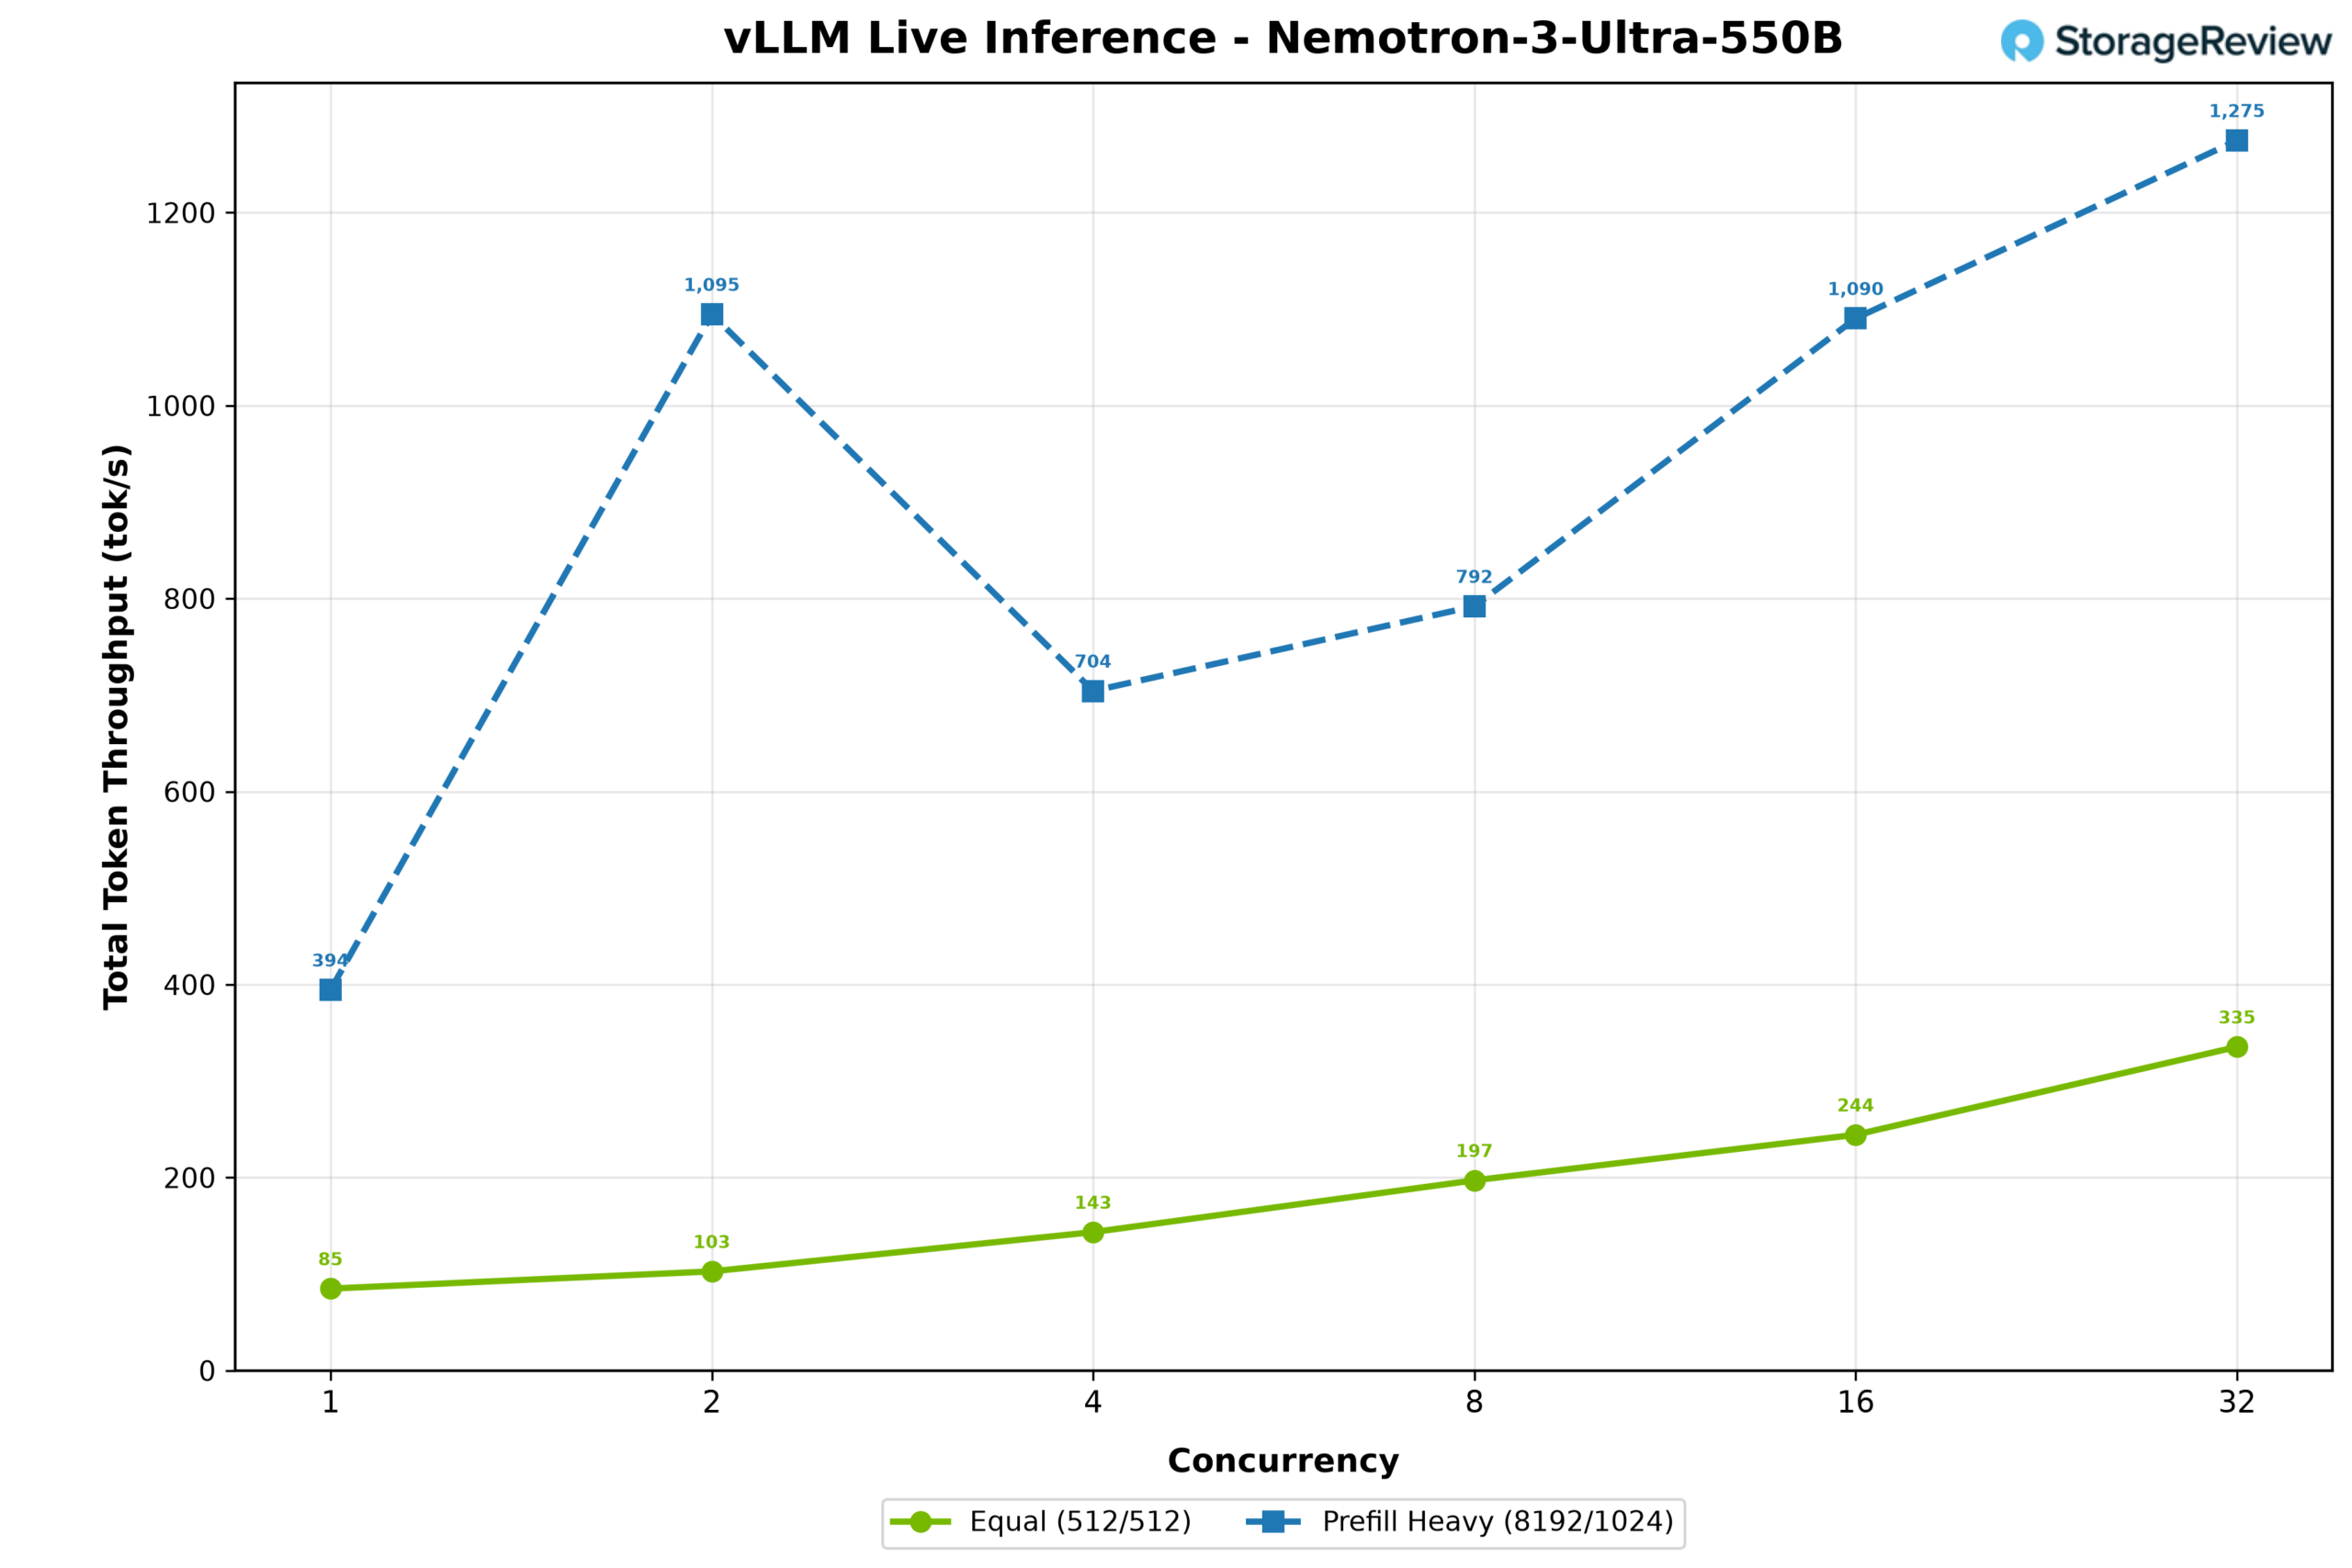
Nasledovala celková priepustnosť tokenov, pričom pracovná záťaž s vysokým zameraním na predfill dosiahla vrchol 2 506 tokenov za sekundu pri súbežnosti 2 a následne klesla na 2 169 pri súbežnosti 4, zatiaľ čo pracovná záťaž 512/512 sa zvýšila z 85 na 336 tokenov za sekundu.
WS300 vs. Blackwell RTX PRO 6000 vs. DGX Spark
Táto polovica nášho inferenčného testovania porovnáva WS300 s dvoma ďalšími spôsobmi, ako umiestniť Blackwell na stôl alebo do jeho blízkosti: Blackwell RTX PRO 6000, 600W grafická karta pre pracovnú stanicu od NVIDIA, ktorá je súčasťou Dell Pro Max Tower T2, ktorý sme recenzovali skôr, a DGX Spark s procesorom GB10, ktorý tu predstavuje Acer Veriton GN100 . Každý systém spúšťal rovnaké pracovné zaťaženia vLLM live inference v dvoch scenároch, rovnaké pracovné zaťaženie s 512 vstupnými a 512 výstupnými tokenmi a náročné pracovné zaťaženie predbežného dopĺňania s 8 192 vstupnými a 1 024 výstupnými tokenmi, na úrovniach súbežnosti od 1 do 128. Zaznamenali sme agregovaný výstup a celkovú priepustnosť pre každý model, ktorý môžu všetky tri systémy spoločne obsluhovať: GPT-OSS-20B a GPT-OSS-120B v ich natívnom MXFP4, Llama 3.1 8B v BF16, FP8 a NVFP4 a Mistral Small 24B a Qwen3 Coder 30B v BF16 a FP8.
GPT-OSS-20B
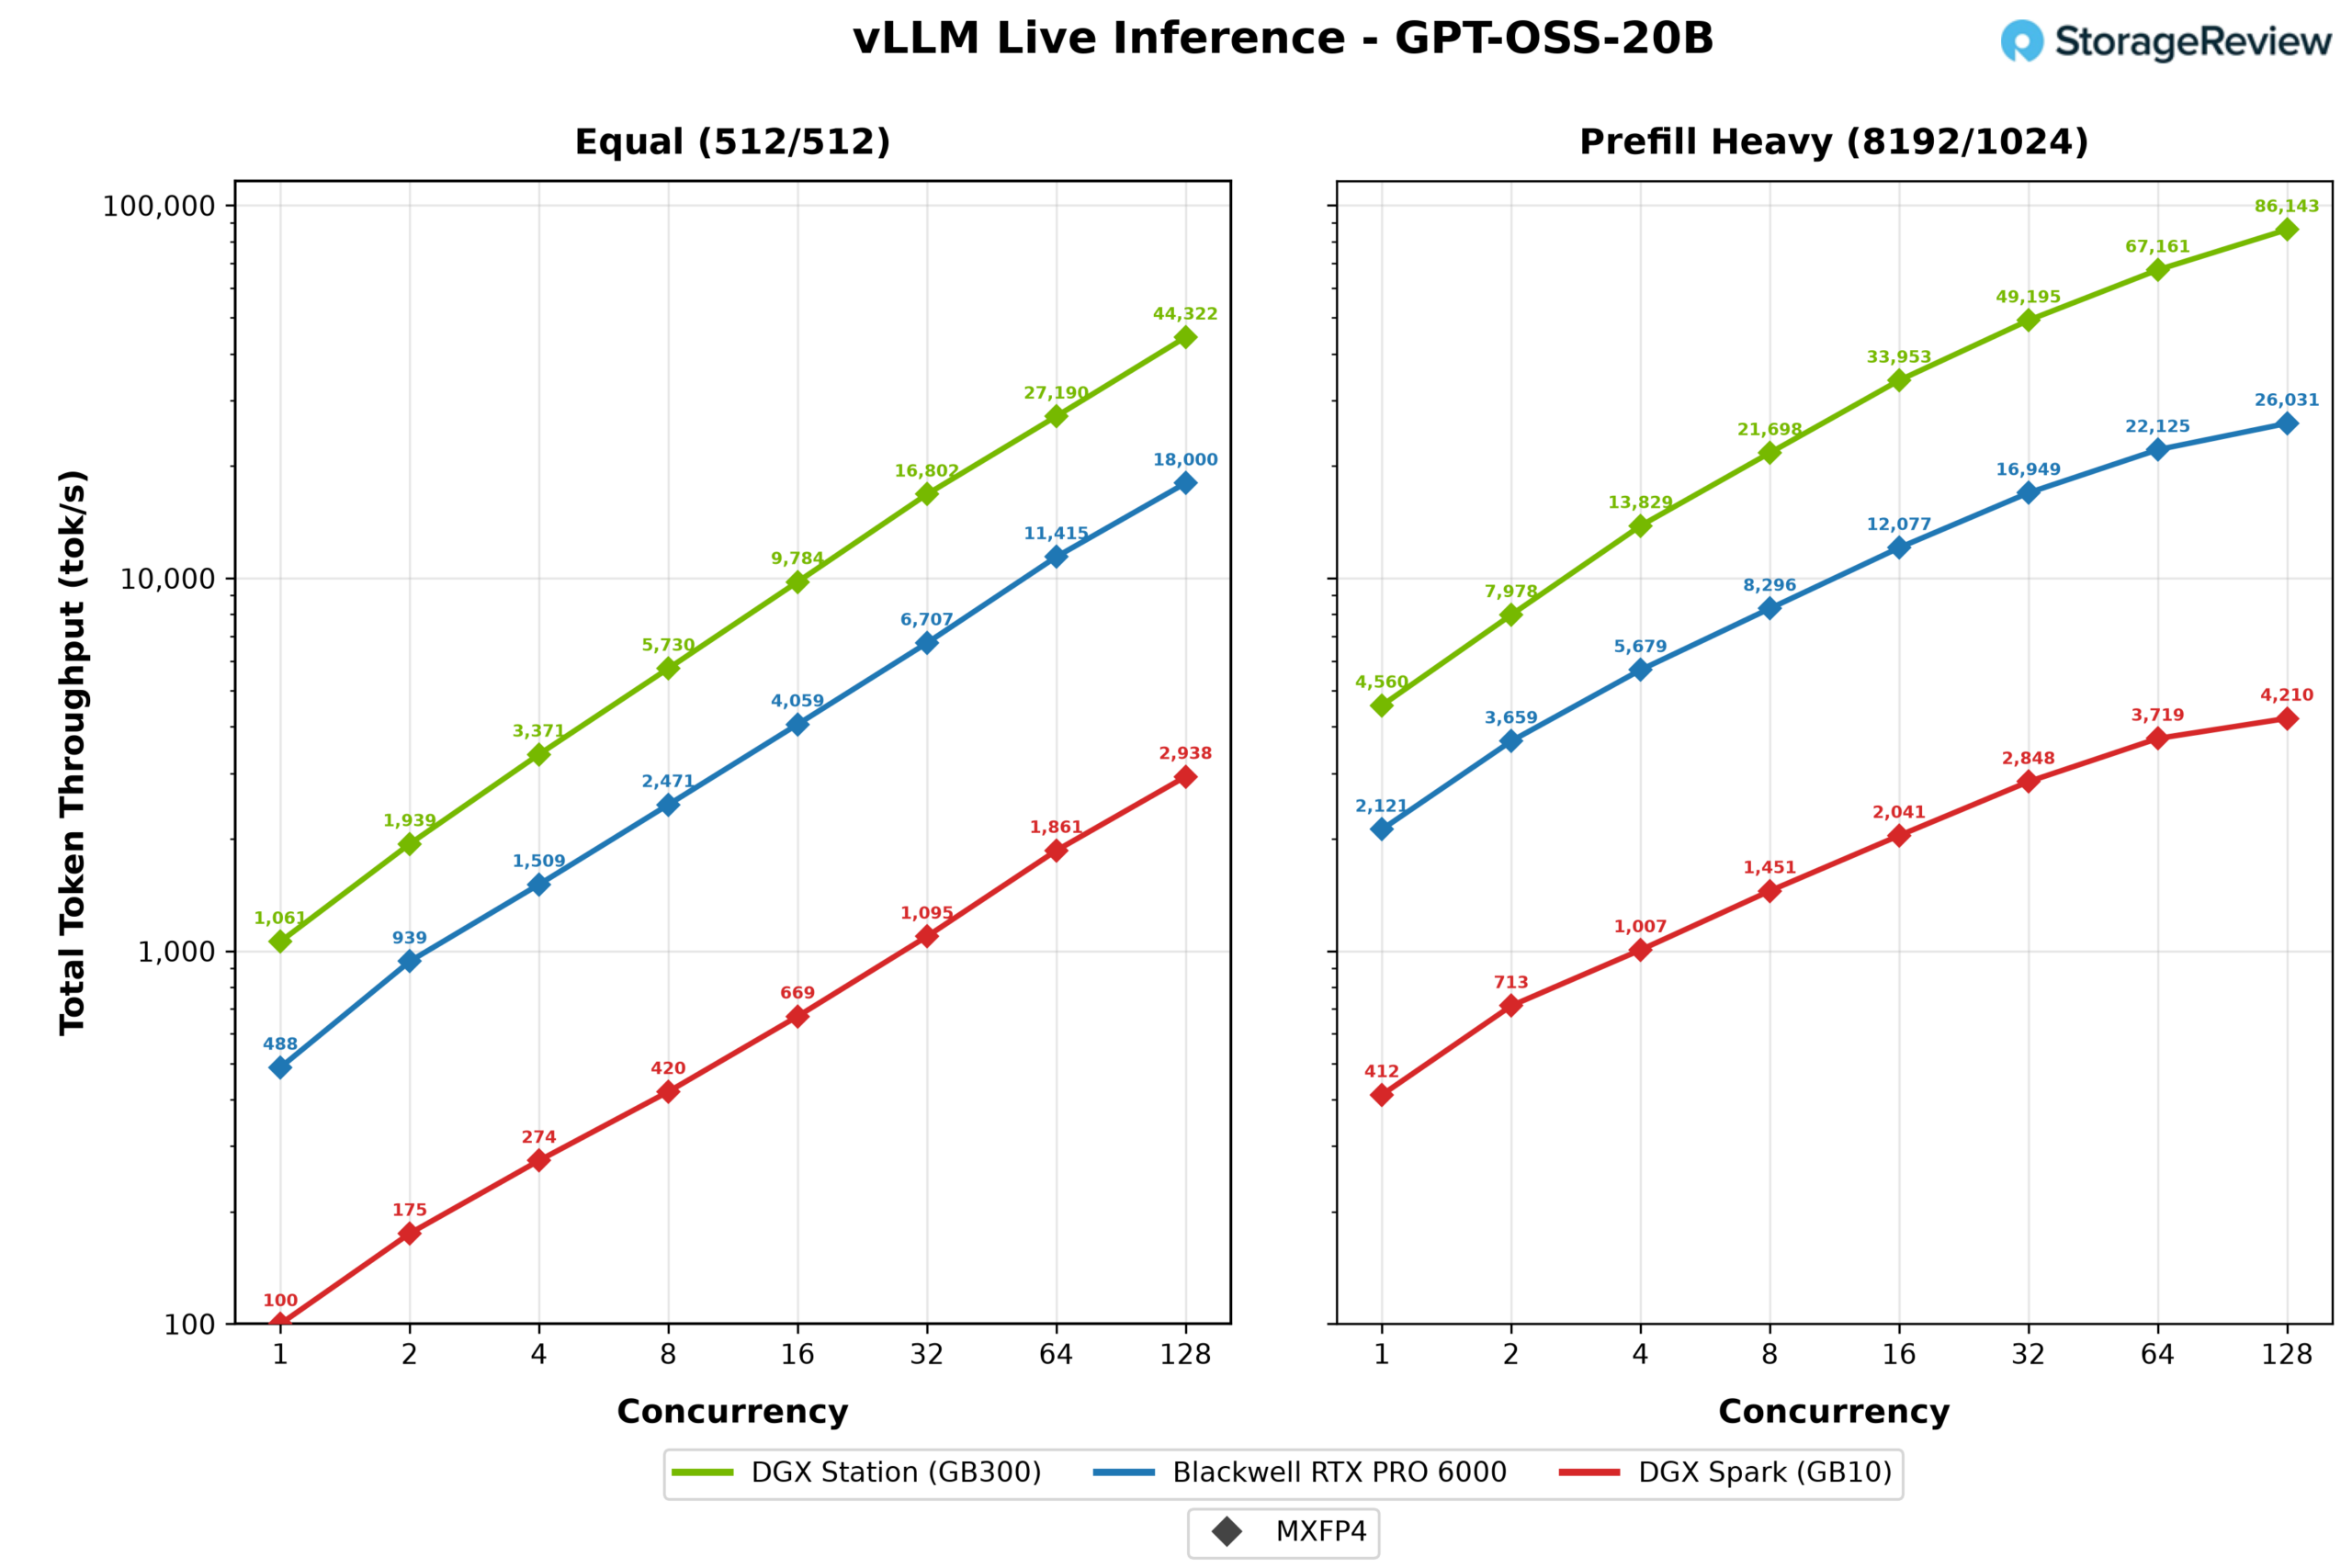
GPT-OSS-20B je najpriateľskejší test zo sady, kontrolný bod, ktorý sa ľahko zmestí na všetky tri systémy. Pri rovnakom zaťažení sa WS300 čisto škáloval na 22 161 výstupných tokenov za sekundu pri 128 súbežných streamoch, čo je zhruba 2.5-násobok RTX PRO 6000 s 9 000 a 15-násobok DGX Spark s 1 469. Výsledky s jedným streamom hovoria rovnaký príbeh v miniatúre: 530 tokenov za sekundu na Station, 244 na karte a 50 na Spark.
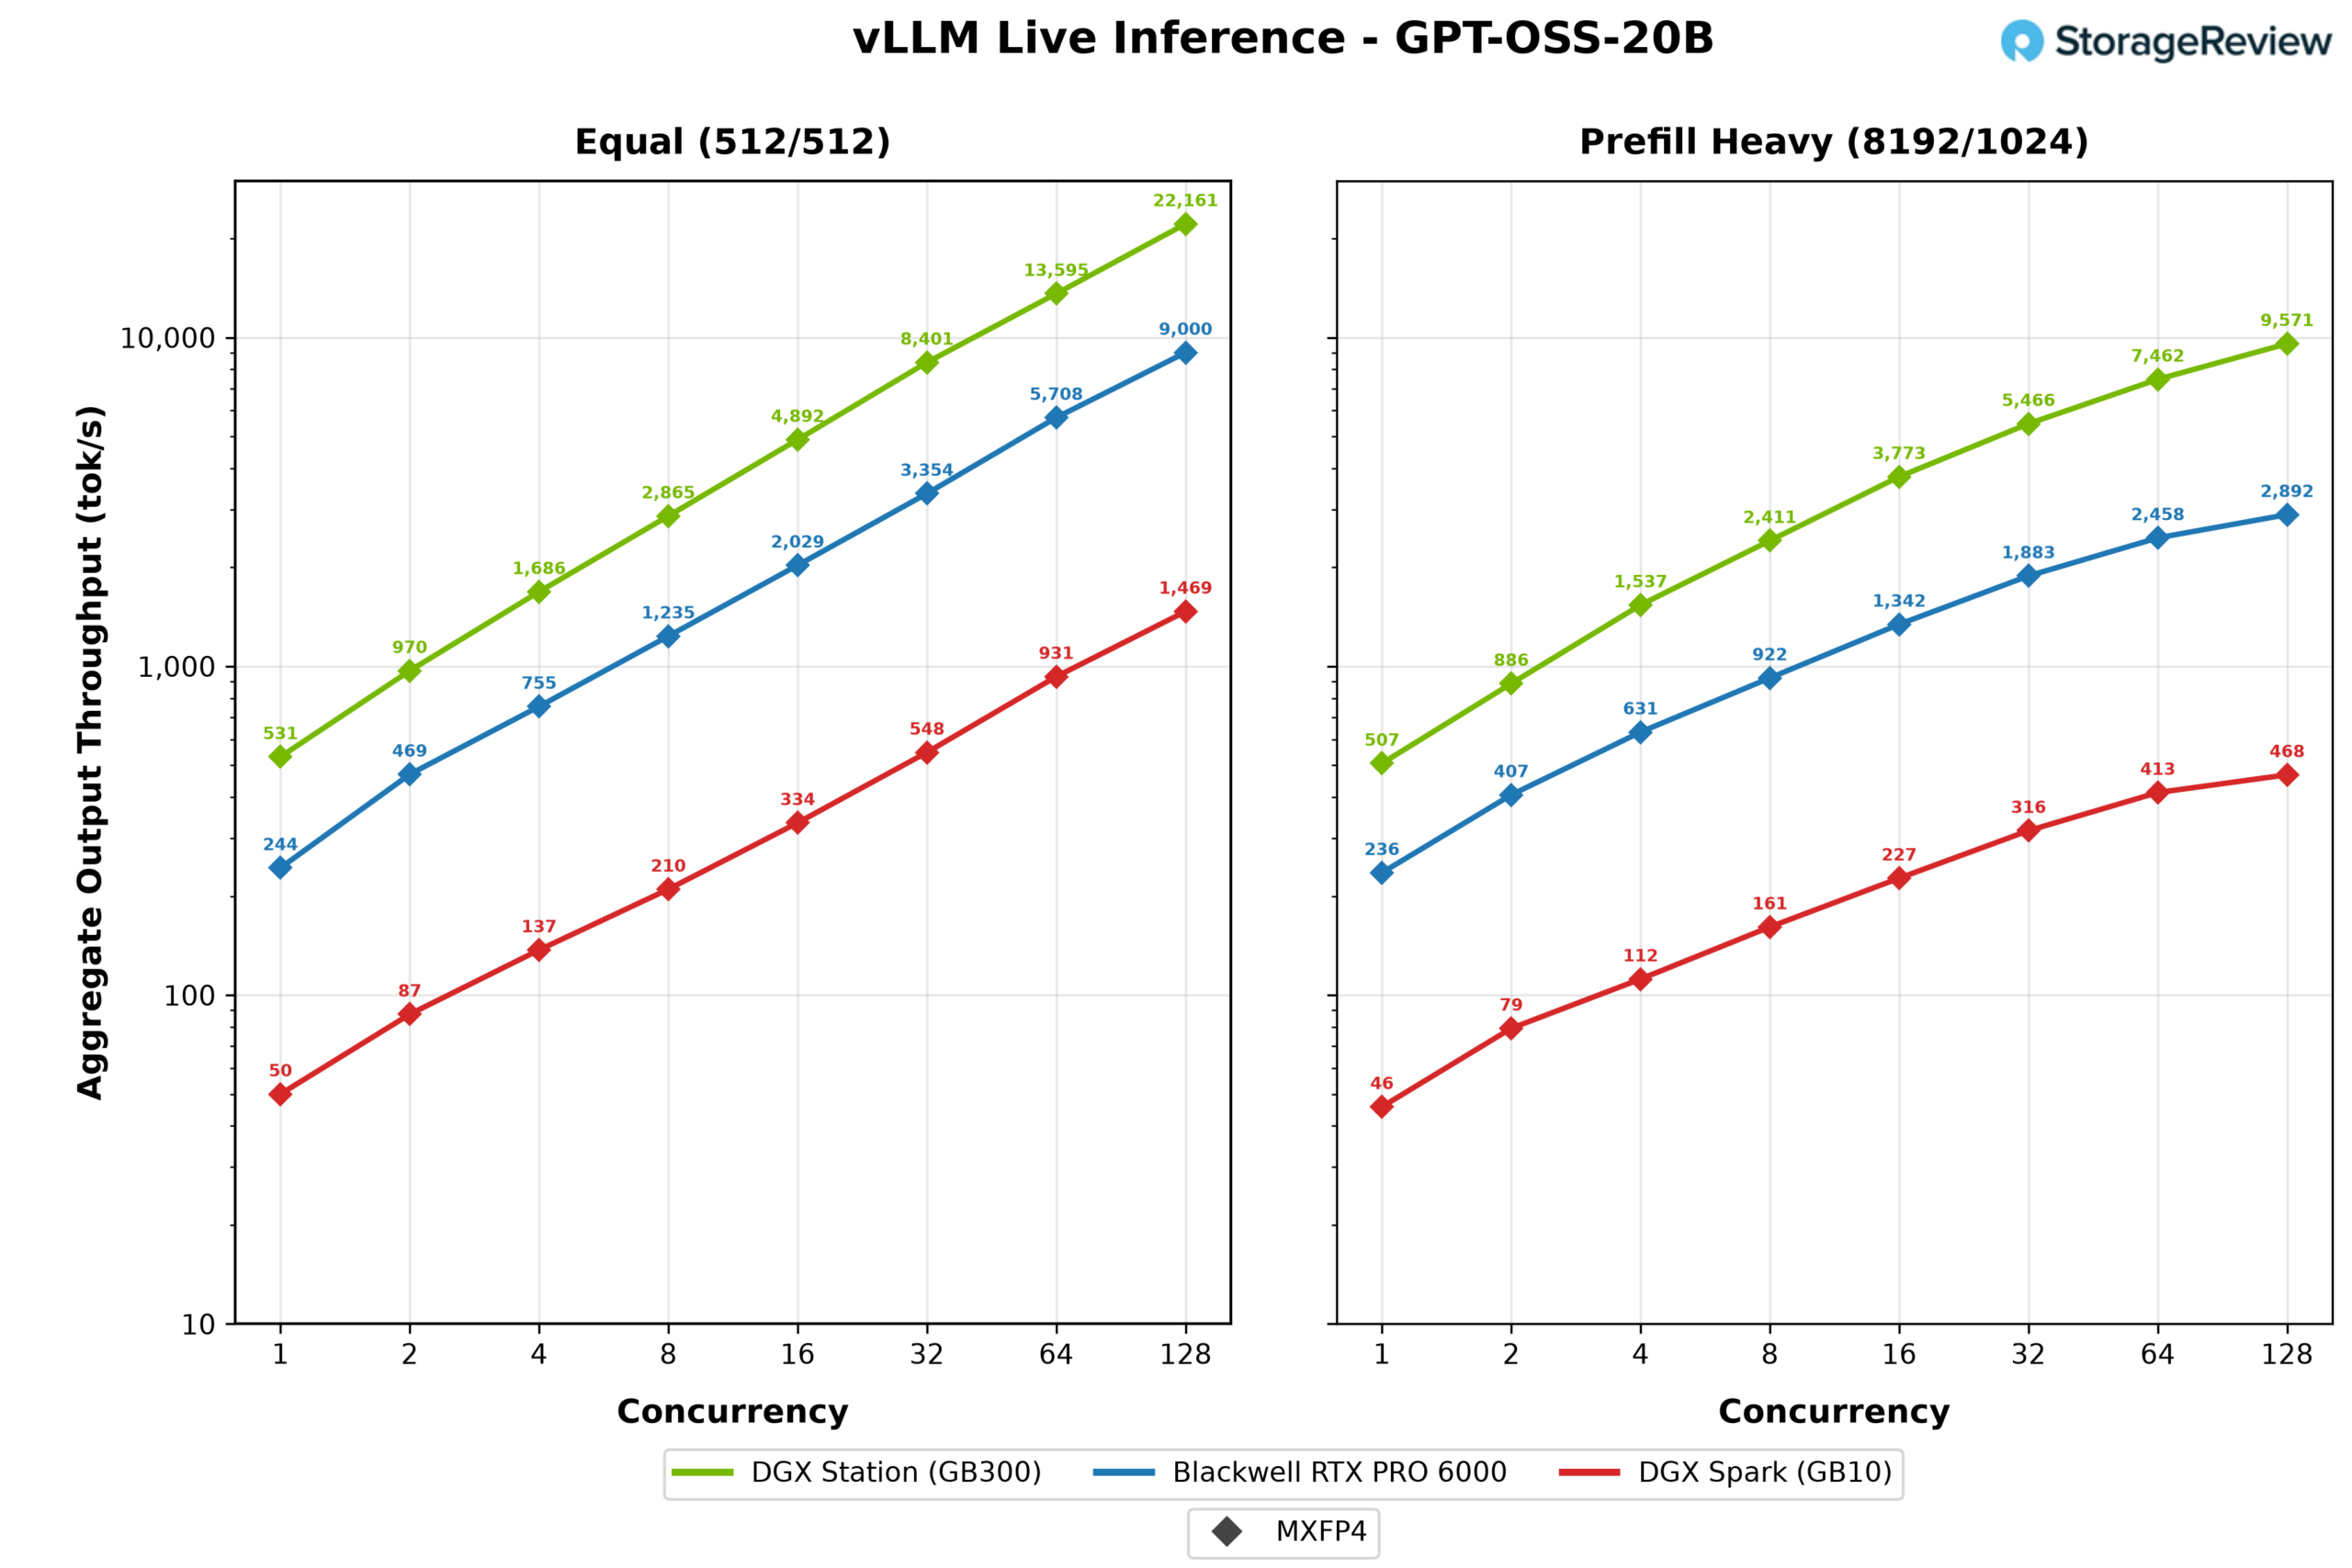
Scenár s vysokým počtom predfillov ešte viac oddeľuje pole. WS300 aj napriek 8 192 tokenovým výzvam stále poskytoval 9 572 výstupných tokenov za sekundu v špičke, čo po započítaní predfillov predstavuje viac ako 86 000 celkových tokenov za sekundu, zatiaľ čo RTX PRO 6000 dosiahol maximum 2 892 a Spark 468.
GPT-OSS-120B
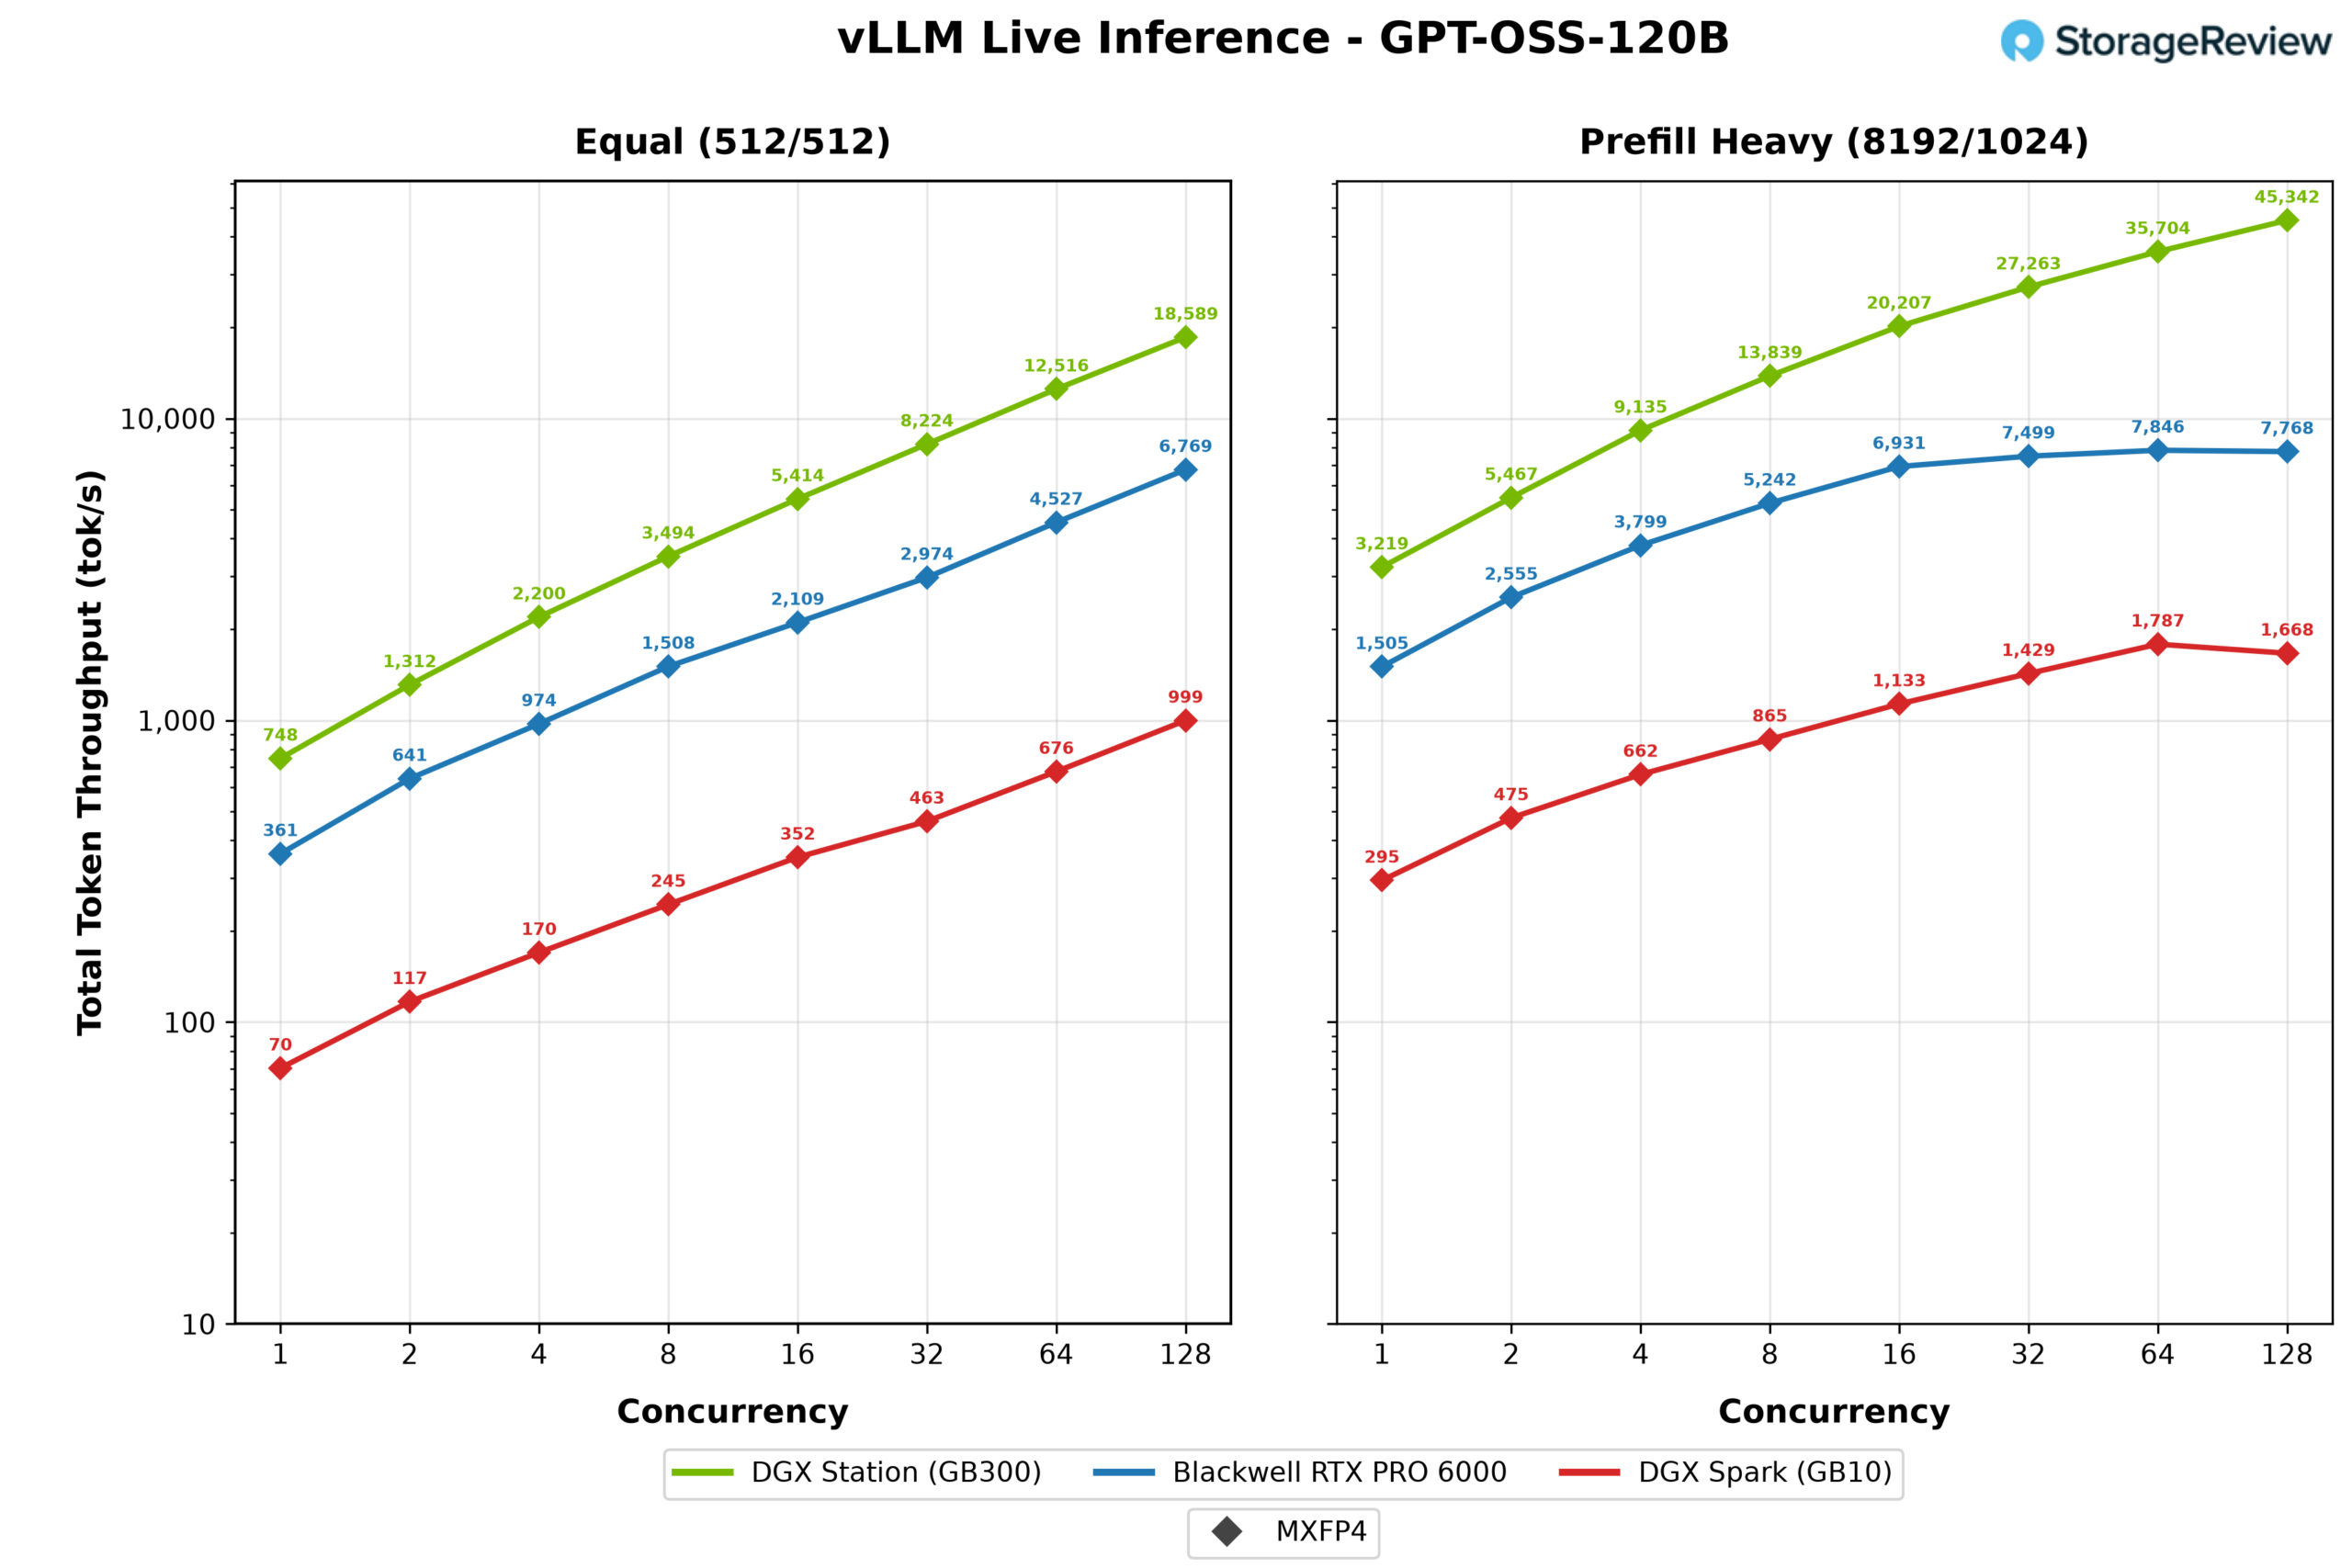
Po prechode na GPT-OSS-120B dokážu všetky tri systémy stále načítať model, ale hierarchia pamäte začína hrať rolu. WS300 dosiahol vrchol 9 294 výstupných tokenov za sekundu pri rovnakom zaťažení, čo je 2.7-krát viac ako RTX PRO 6000 s 3 384 a takmer 19-krát viac ako DGX Spark s 500.
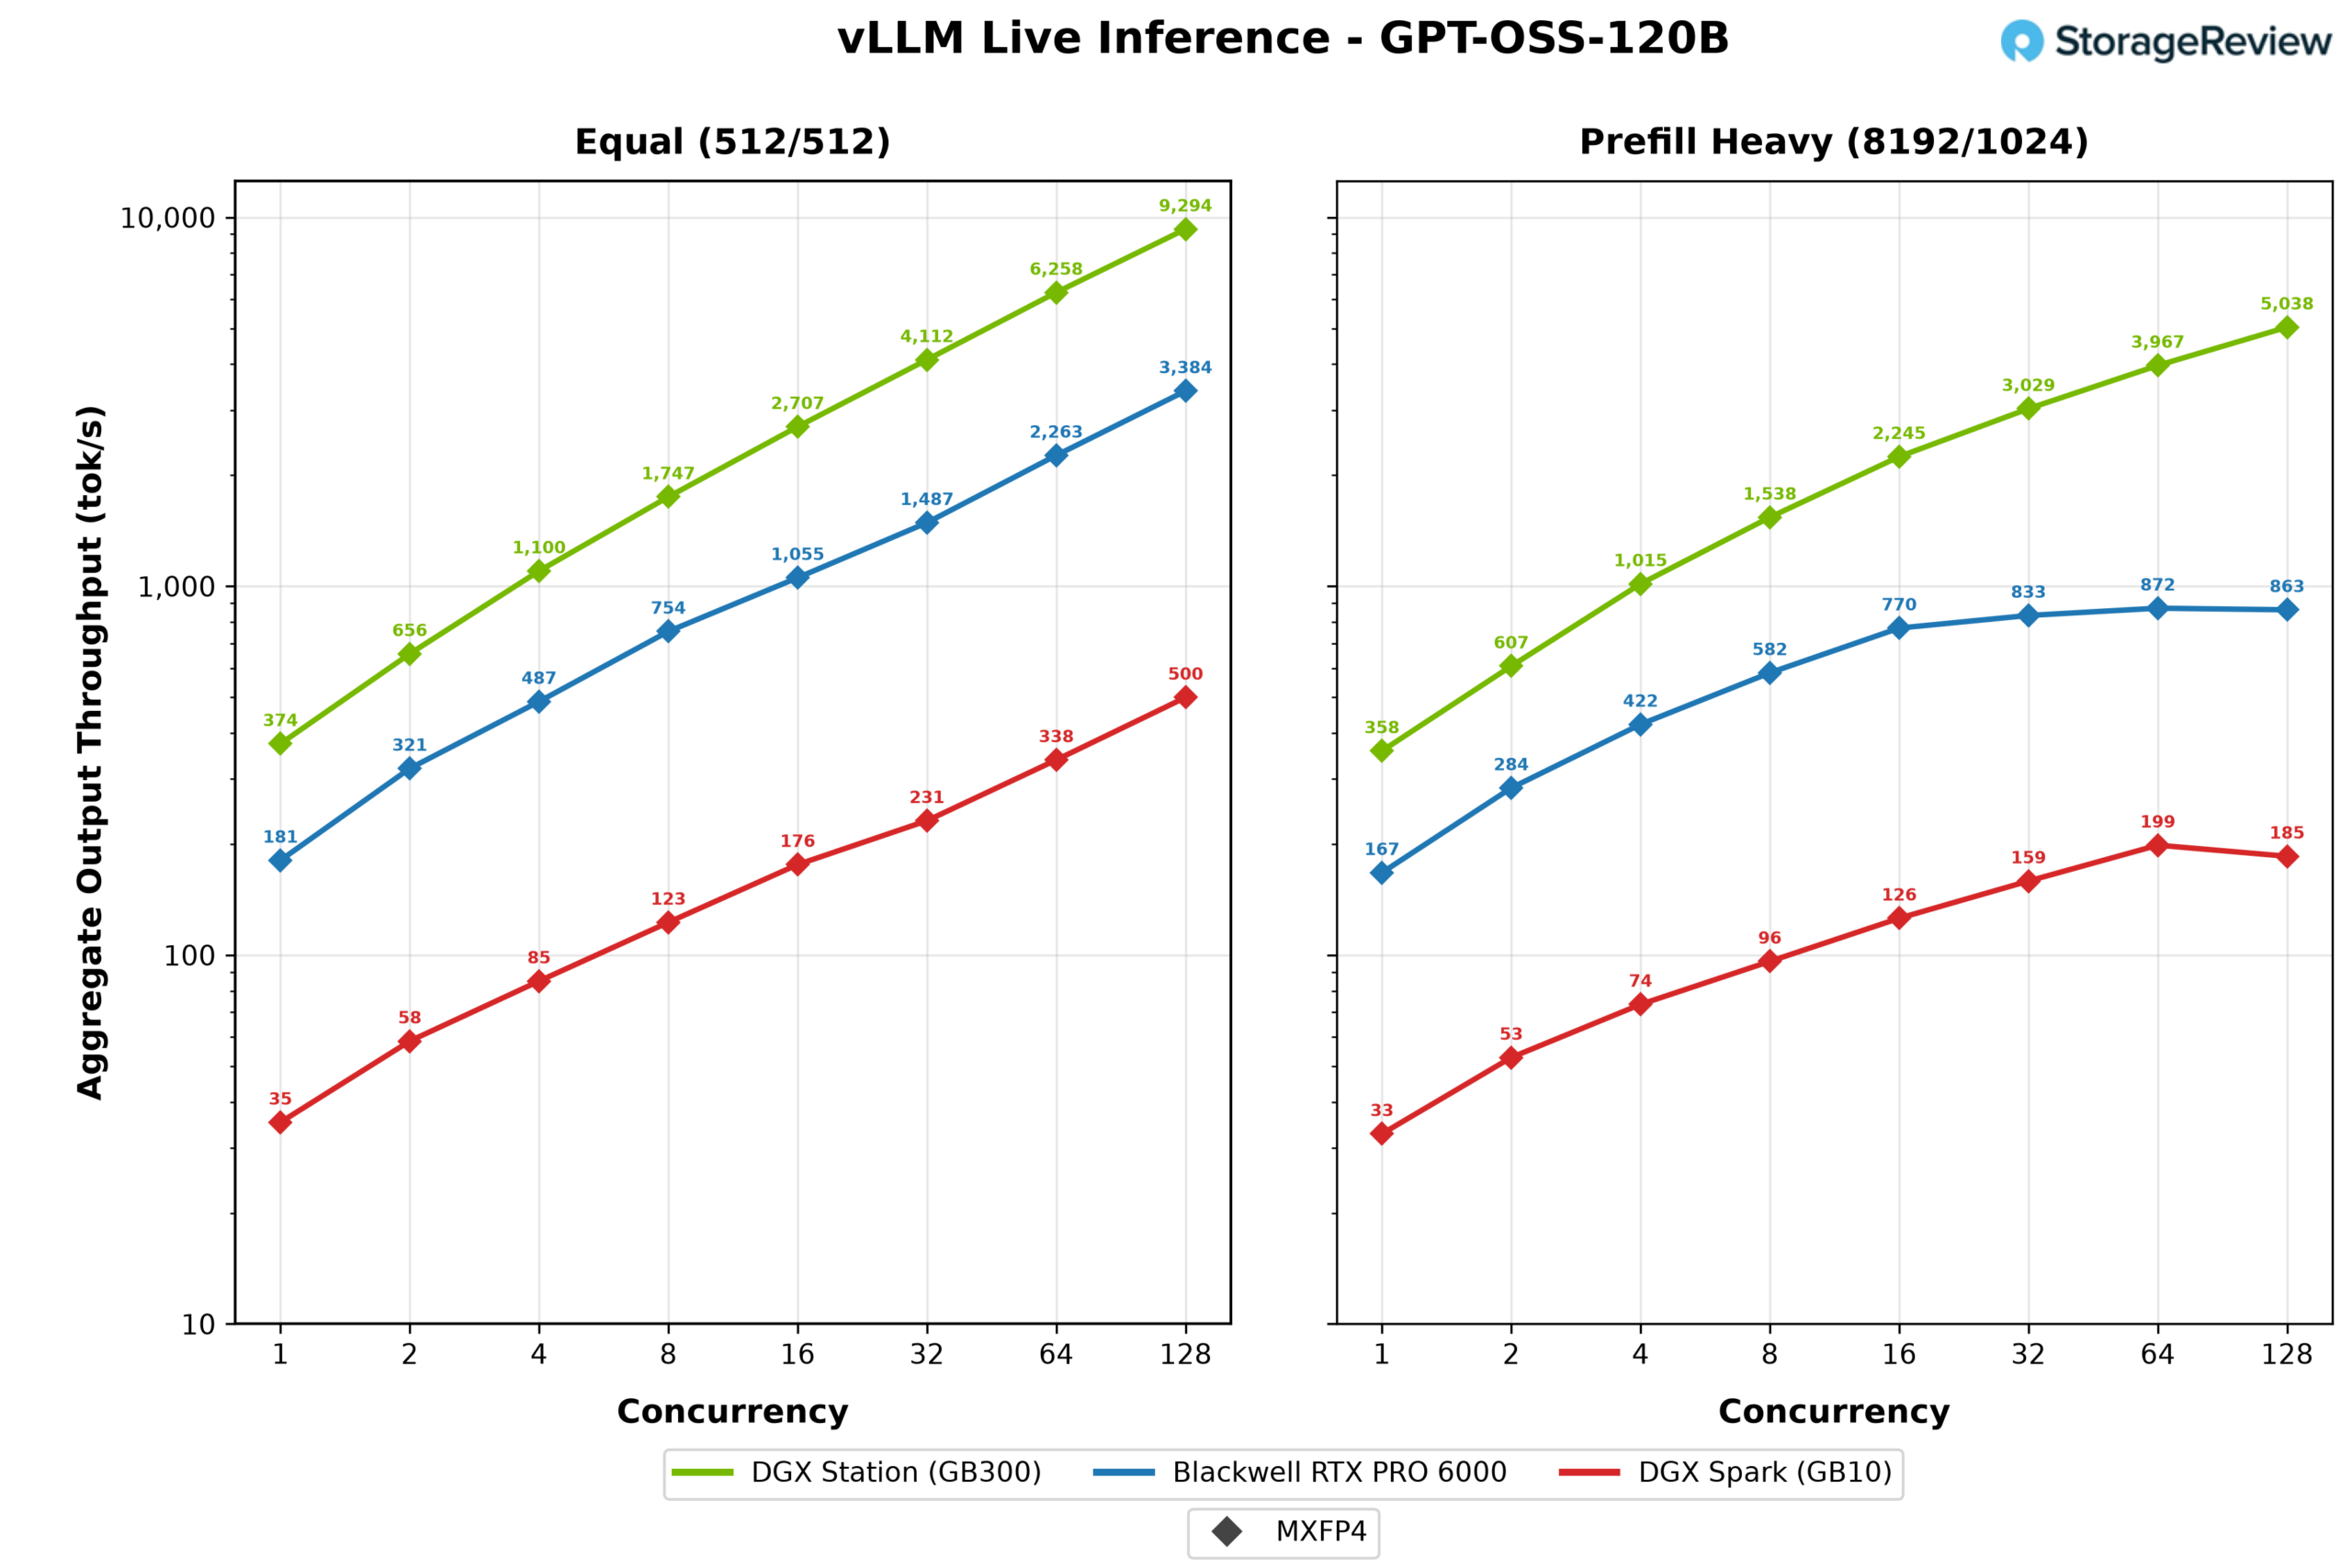
Práve pri silnom predfillovaní dosiahli menšie systémy svoje limity. RTX PRO 6000 dosiahla 872 výstupných tokenov za sekundu pri 64 súbežných streamoch a Spark 199, zatiaľ čo WS300 stále stúpala na 128 streamoch a skončila na 5 038, čo je takmer 6-násobný rozdiel oproti karte. Dlhé výzvy napĺňajú vyrovnávaciu pamäť KV a systémom s menšou pamäťovou rezervou dochádza miesto na dávkové spracovanie dávno predtým, ako to urobí Station.
Lama 3.1 8B
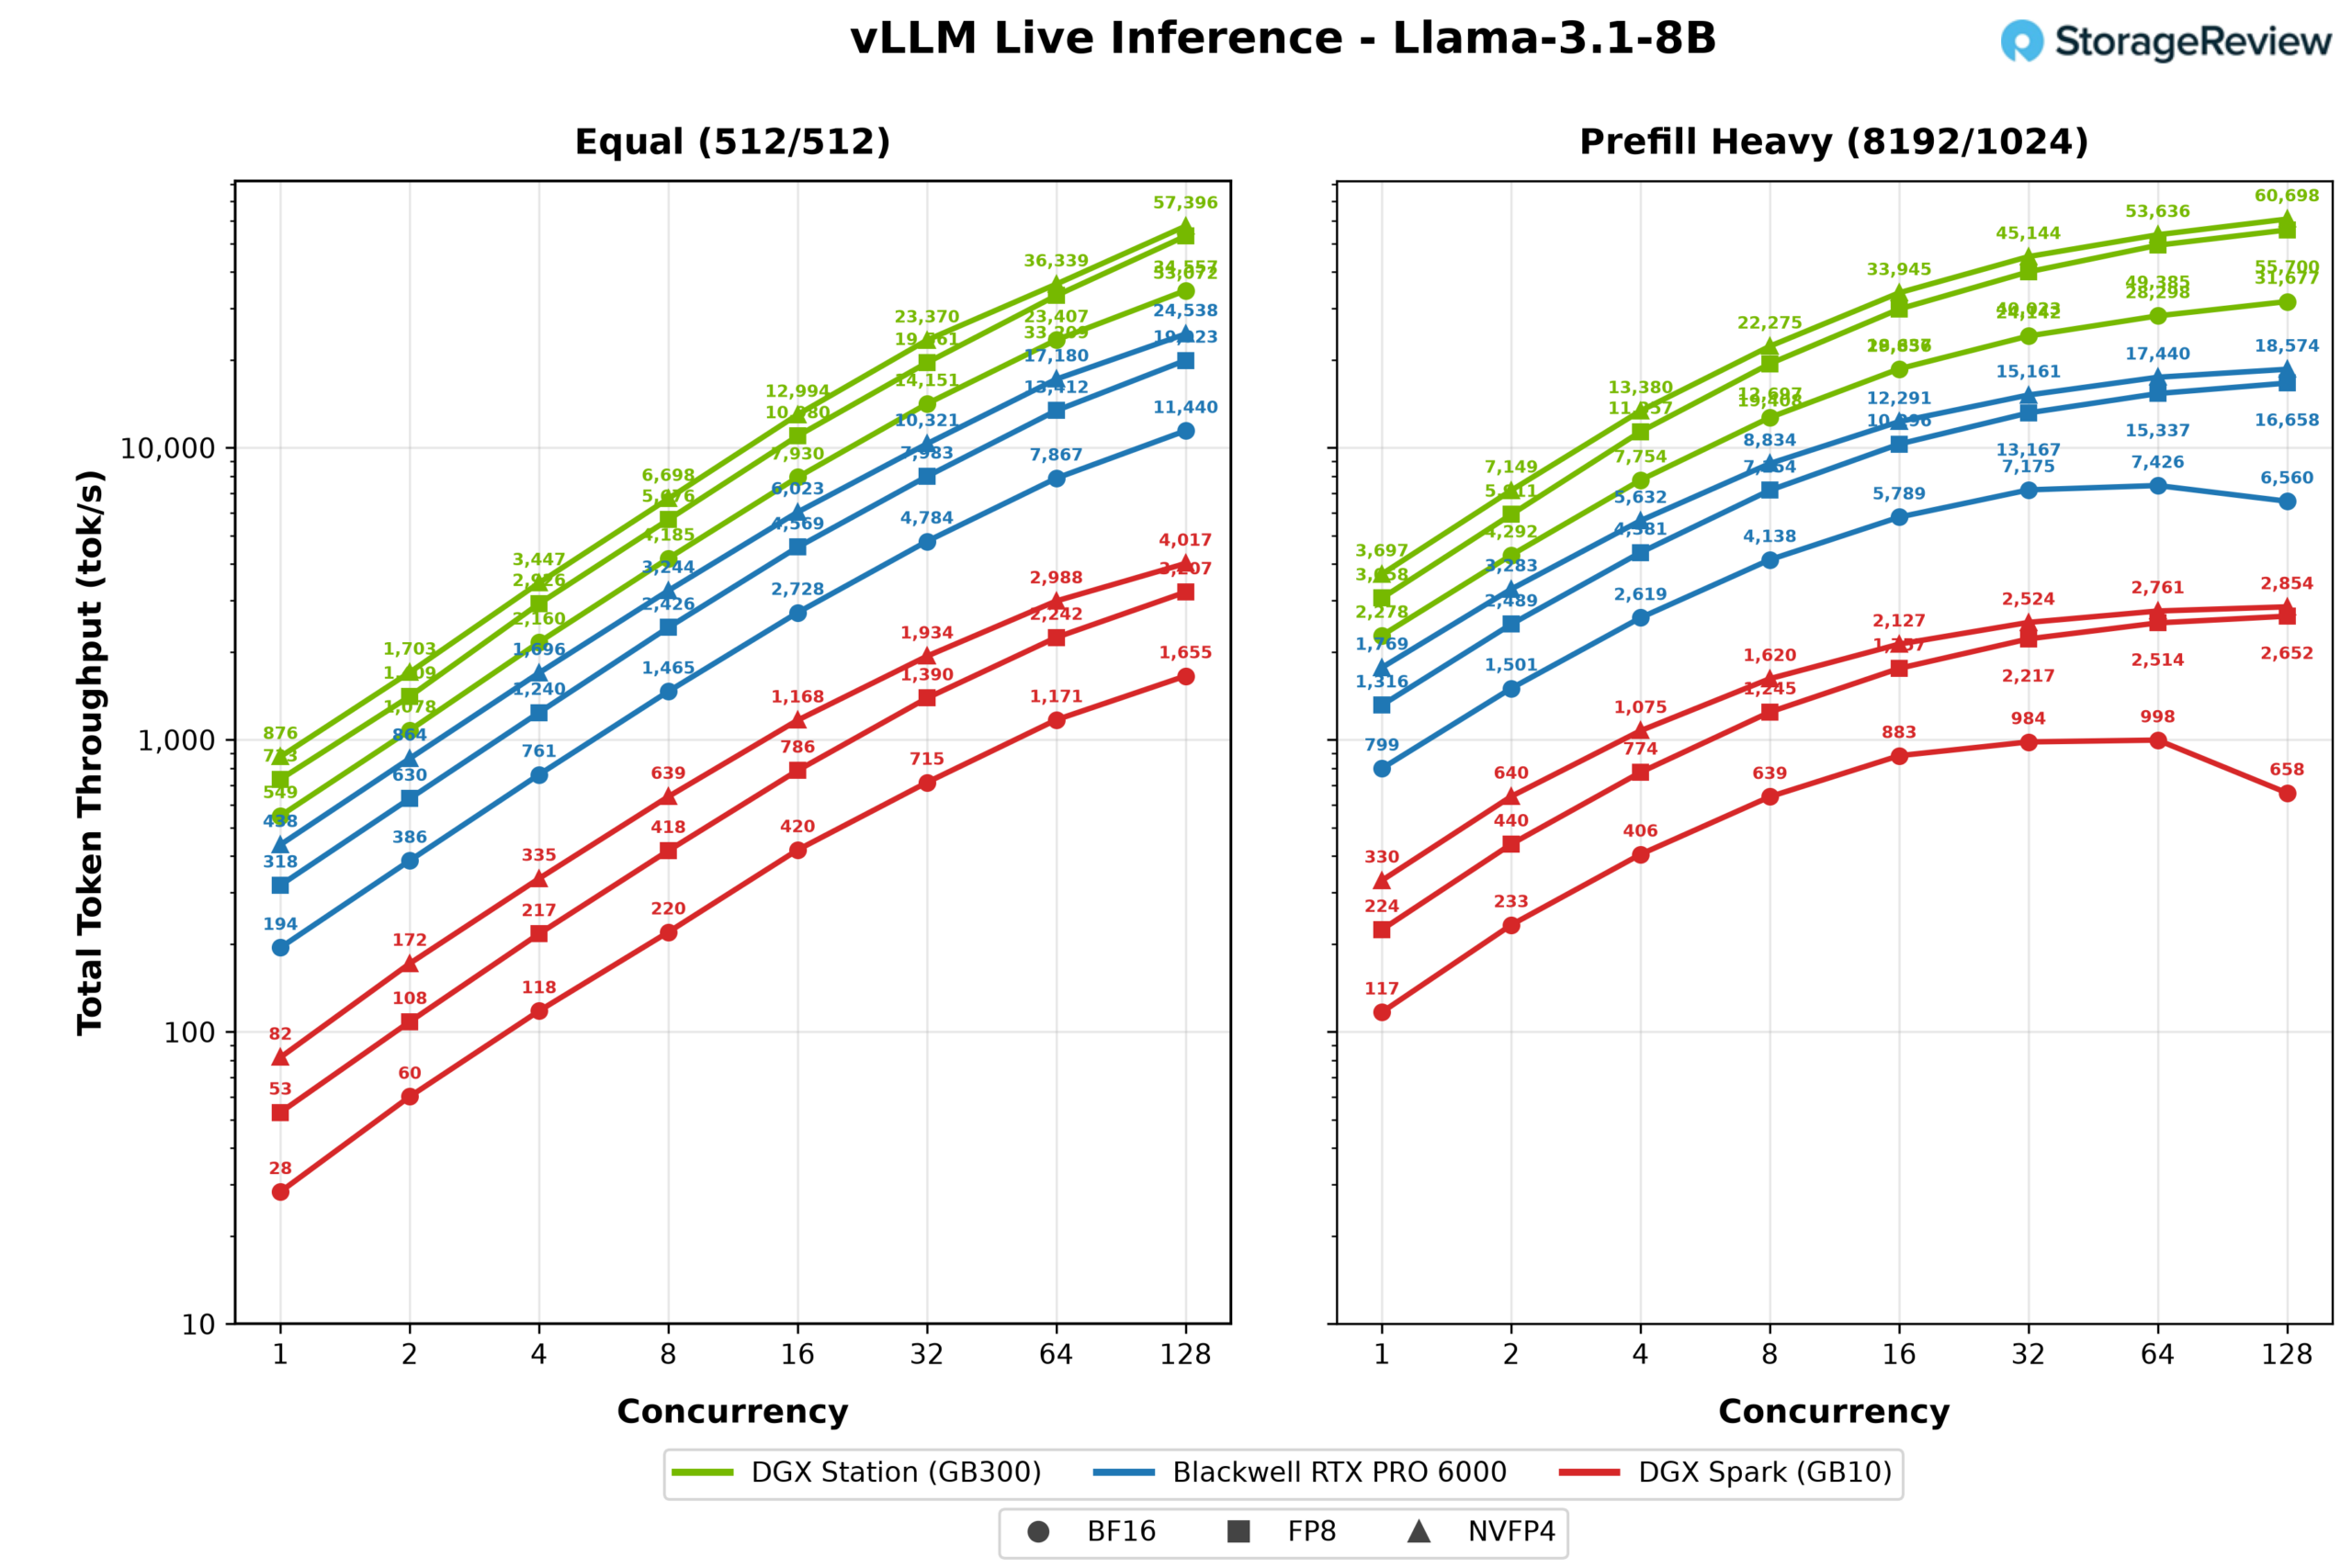
Llama 3.1 8B je dostatočne malá na to, aby sme ju mohli spustiť na BF16, FP8 a NVFP4 na každom systéme, čo z nej robí najčistejší pohľad na to, čo kvantizácia nakupuje na každom stroji. Pri 128 súbežných streamoch a rovnakom zaťažení sa WS300 posunul zo 17 278 výstupných tokenov za sekundu pri BF16 na 28 698 pri NVFP4, čo predstavuje 66-percentný nárast. RTX PRO 6000 získala z rovnakého pohybu 114 percent, z 5 720 na 12 269, a DGX Spark získal 143 percent, z 828 na 2 009. Stojí za to si zapamätať tento vzorec: čím menší stroj, tým viac sa kvantizácia vypláca.
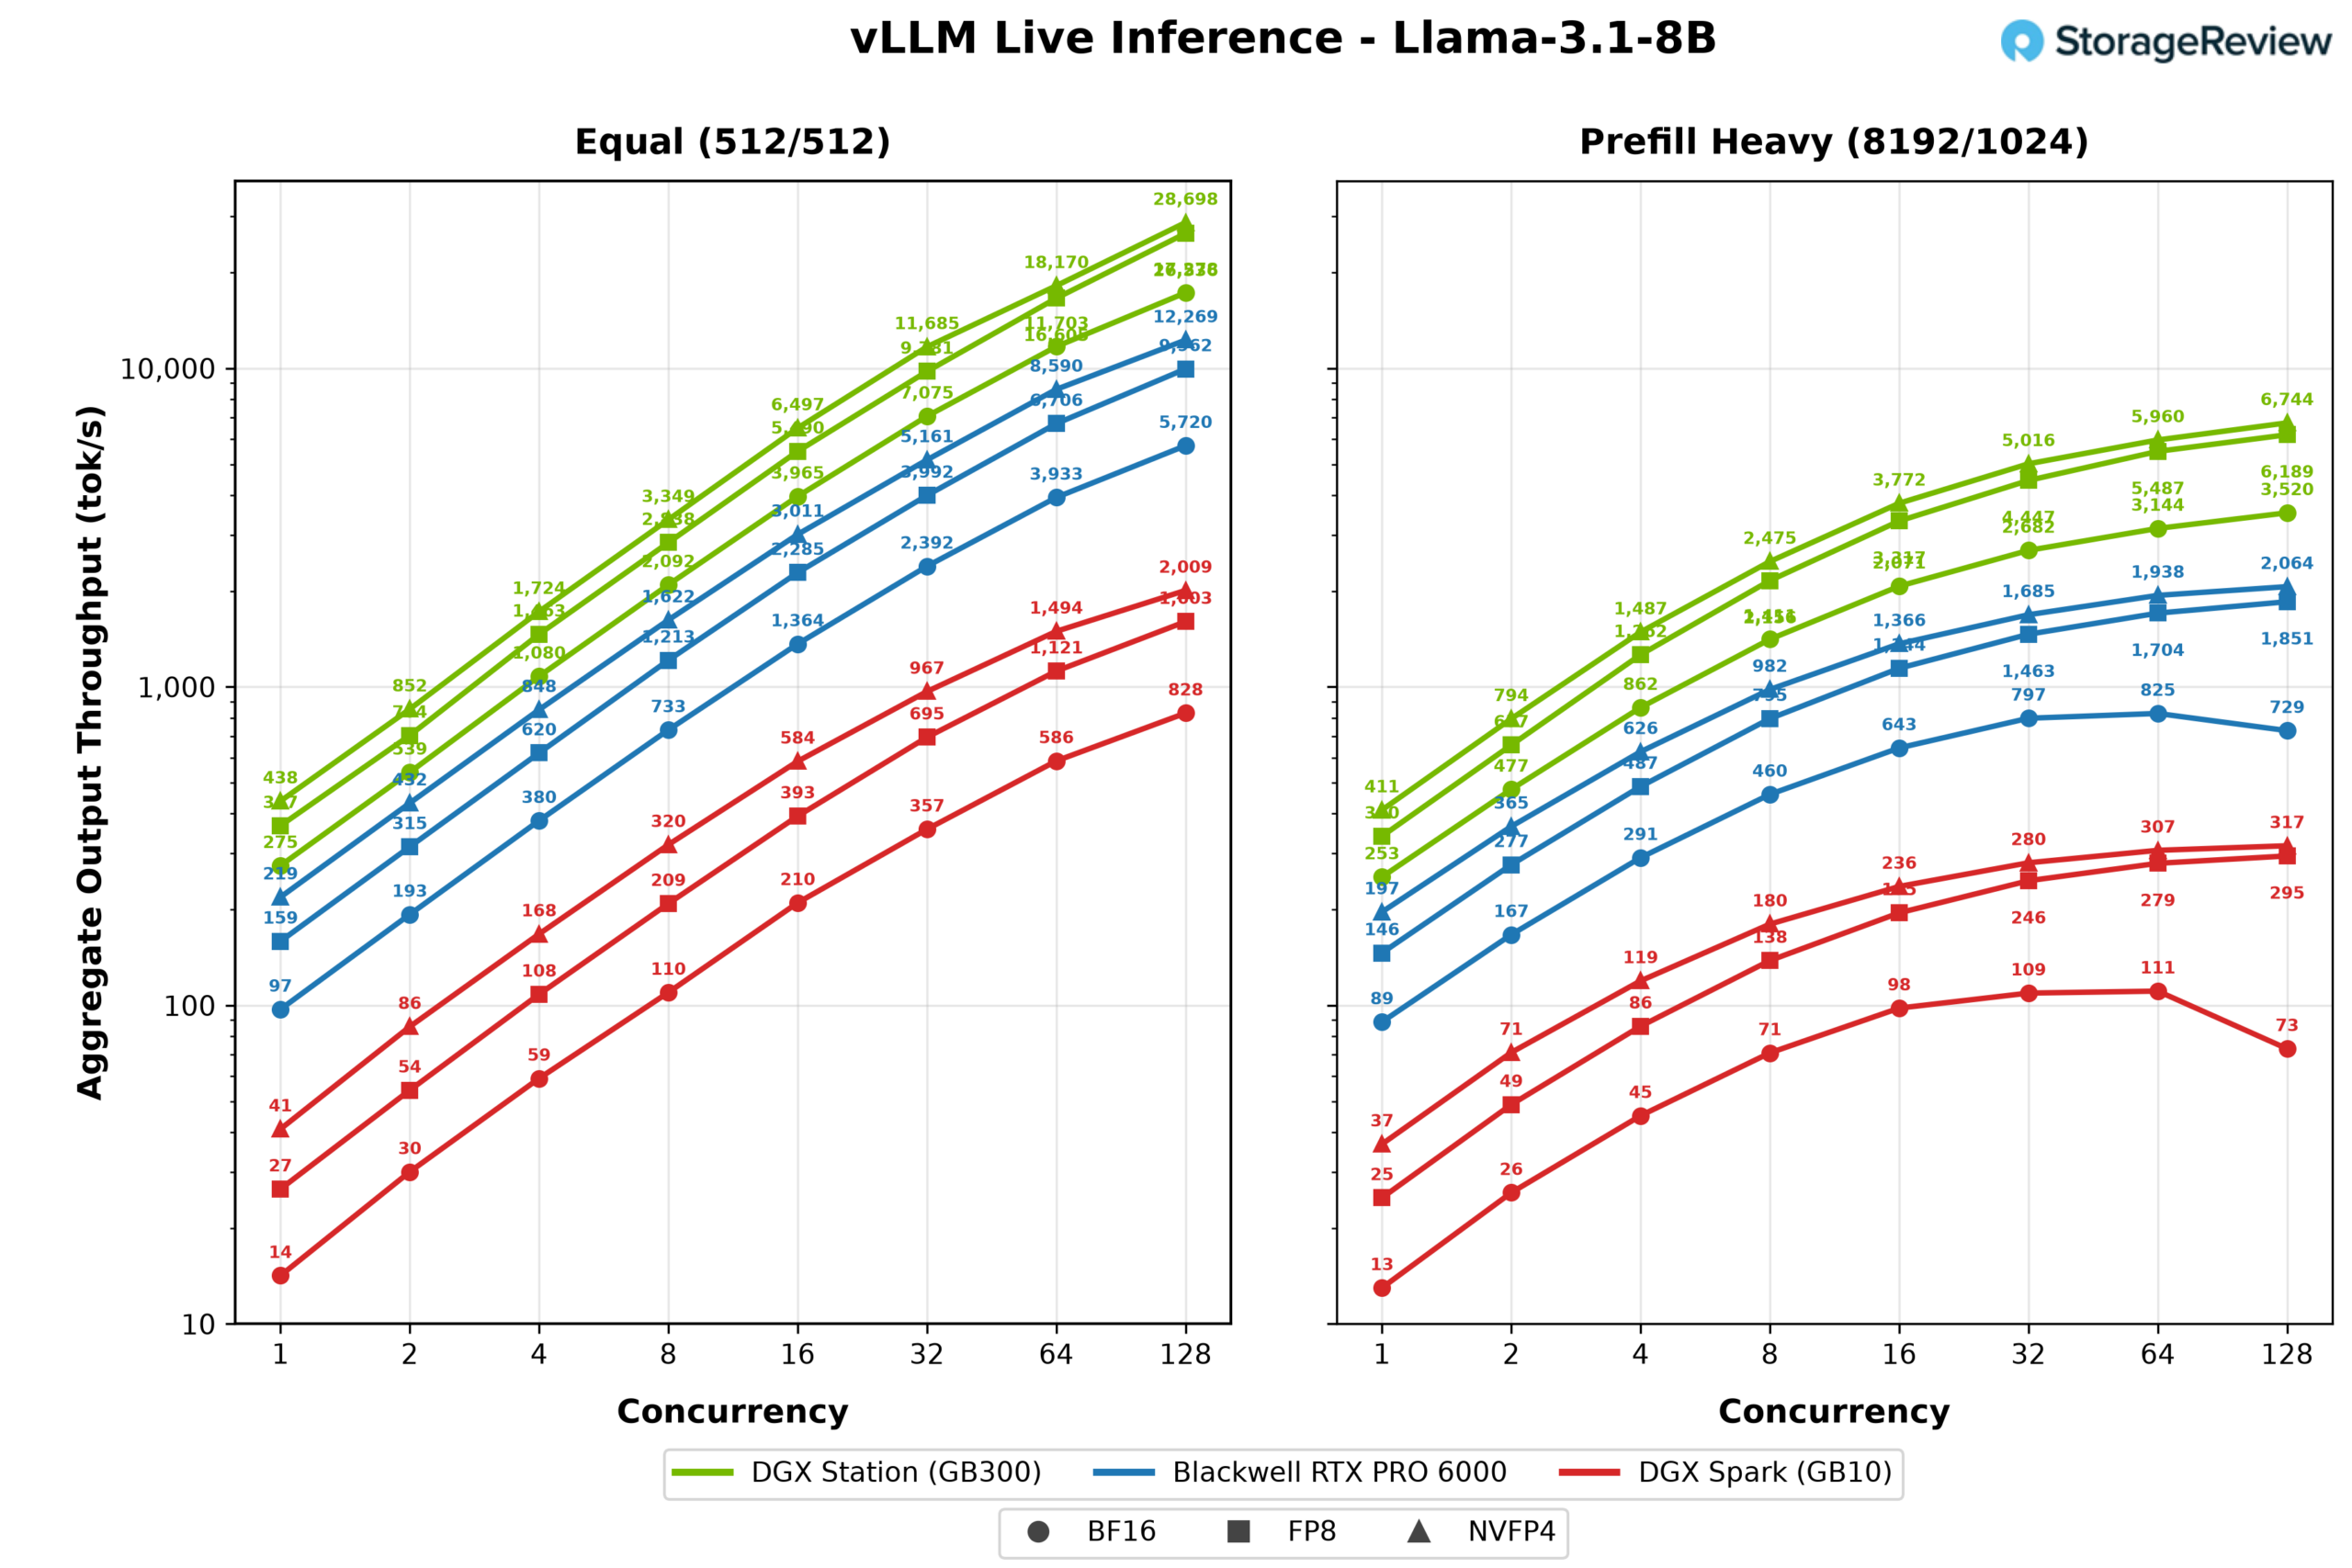
Výsledky s vysokým počtom predfillov komprimujú celé pole, pričom NVFP4 WS300 dosiahol vrchol 6 744 výstupných tokenov za sekundu oproti 2 064 pre kartu a 317 pre Spark.
Mistral Malý 24B
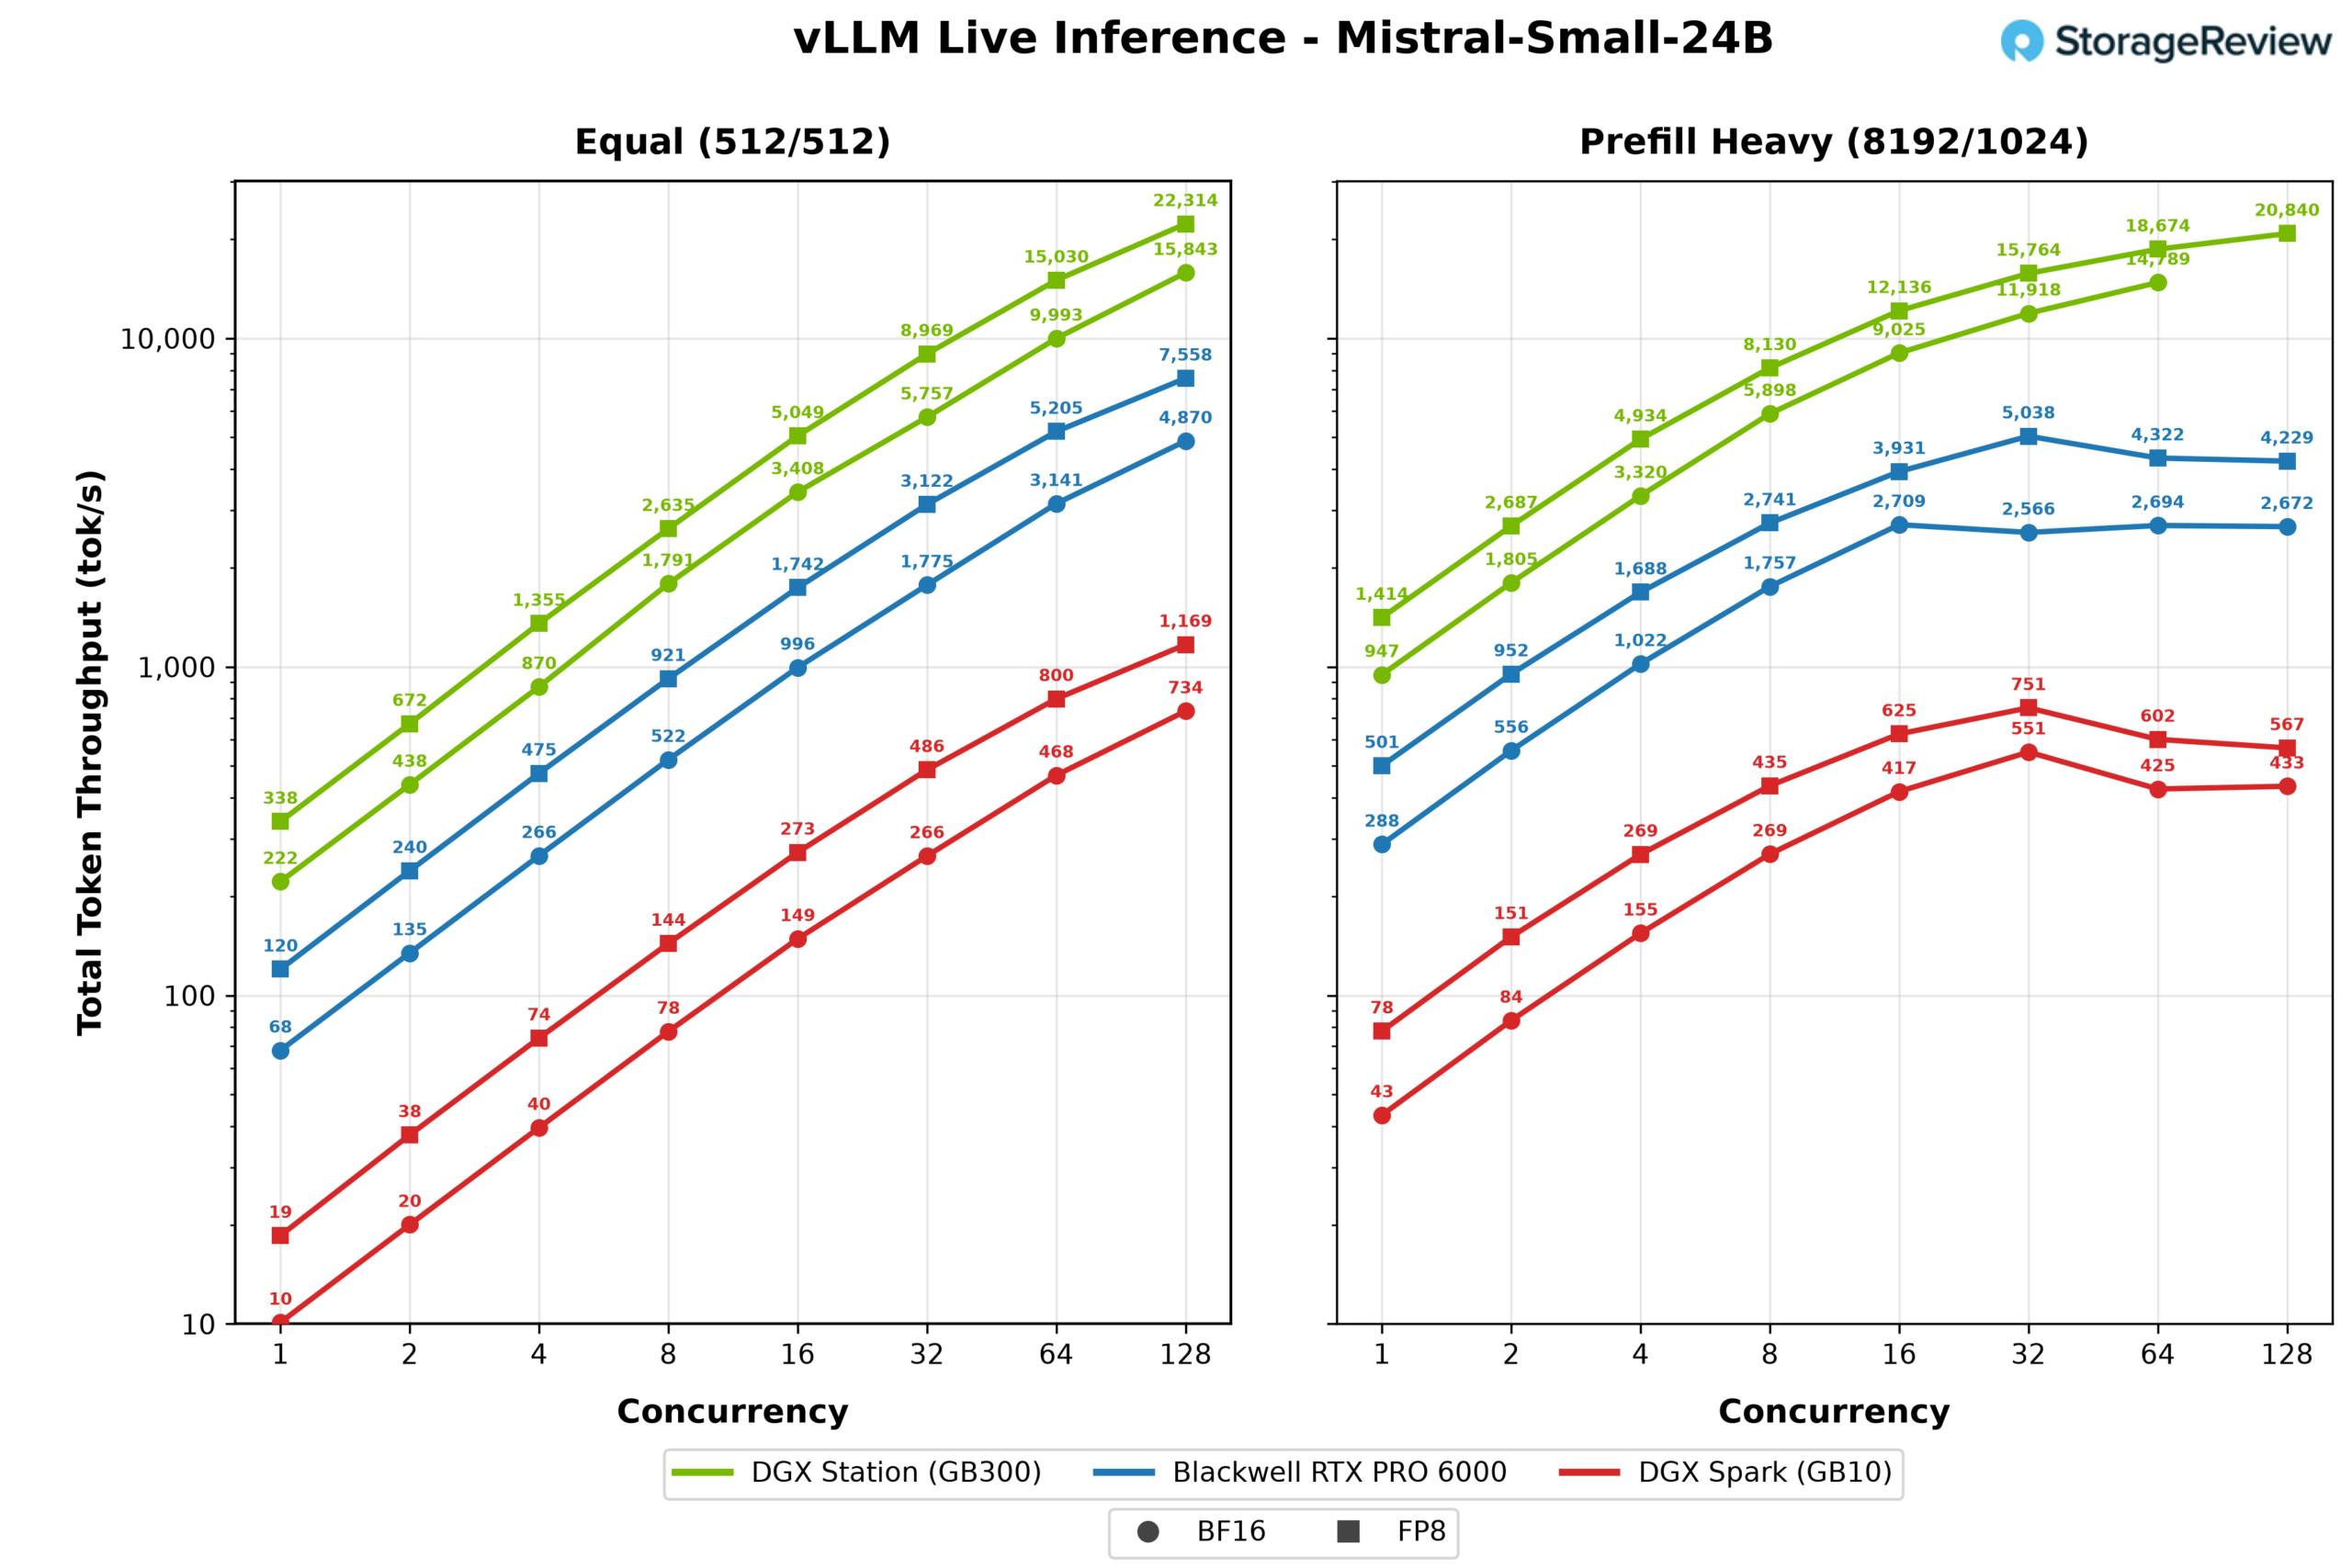
Mistral Small 24B vytvoril najväčšie medzery zo všetkých. V 8. FP pri rovnakom zaťažení dosiahol WS300 maximum 11 157 výstupných tokenov za sekundu, čo je trikrát viac ako RTX PRO 6000 s 3 779 a 19-krát viac ako DGX Spark s 585. V jednom streame je 169 tokenov za sekundu stanice oveľa bližšie k interaktívnemu pohodliu ako 9 tokenov Spark.
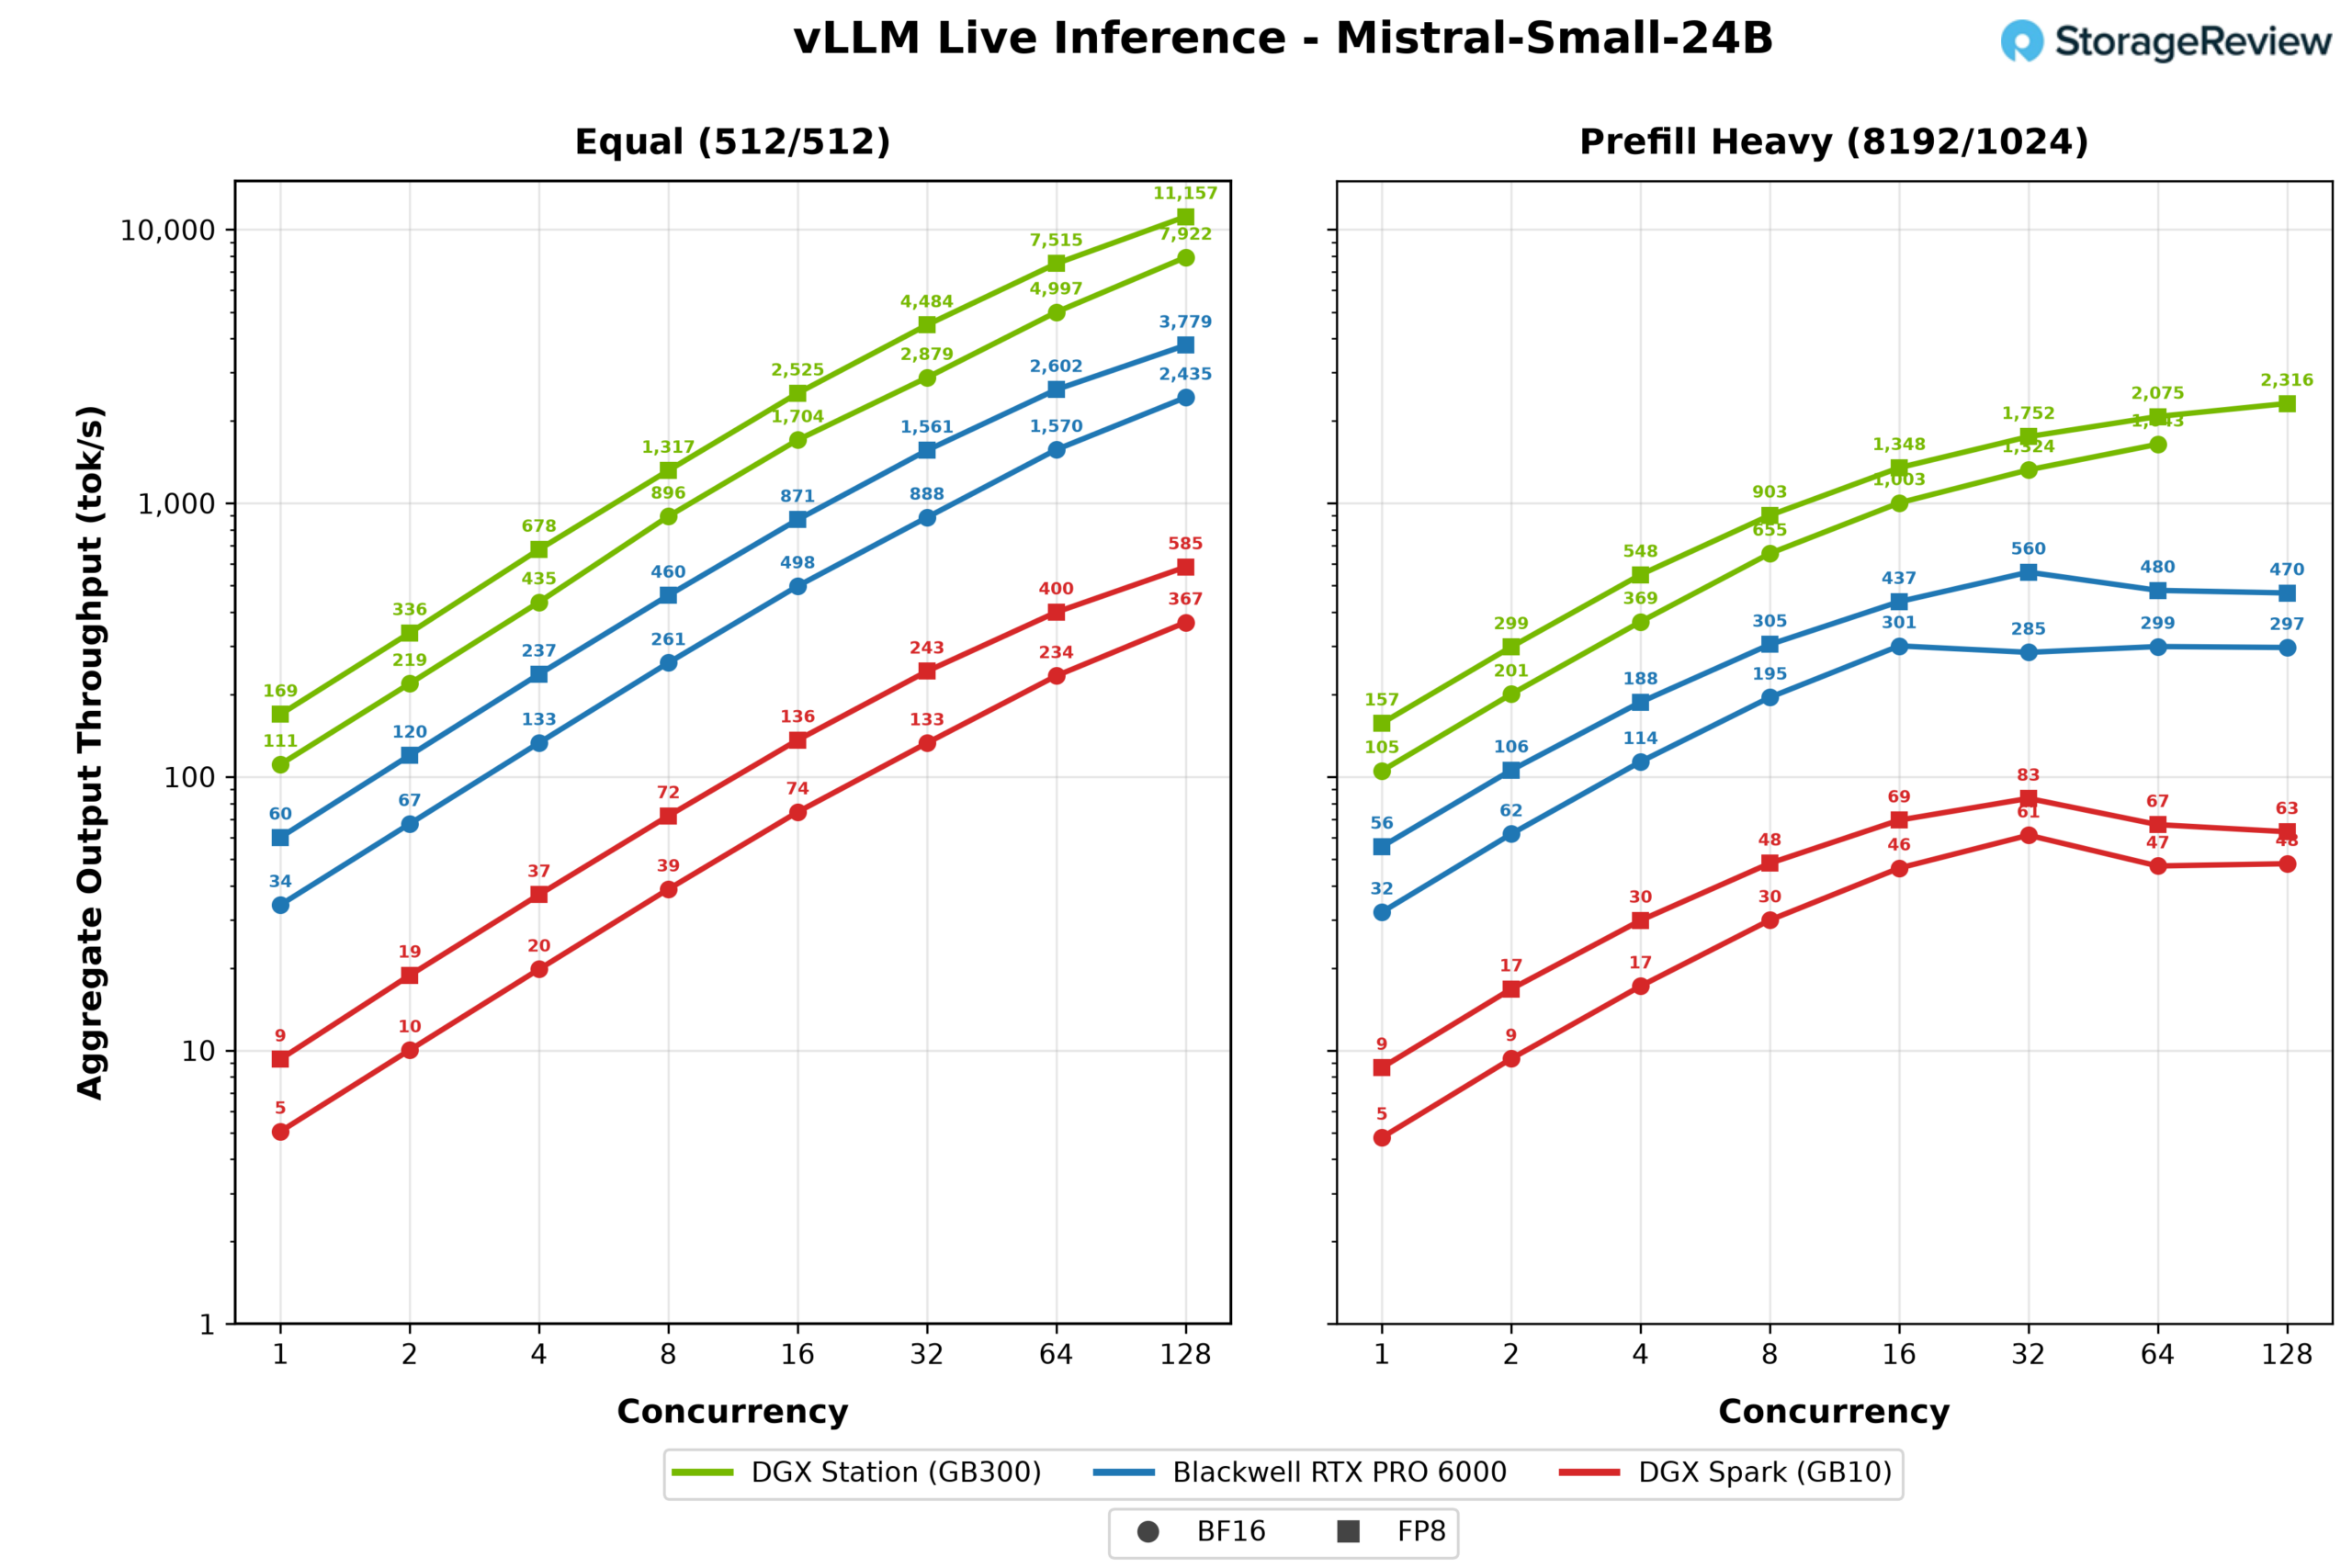
Pri vysokom zaťažení predfillom dosiahla RTX PRO 6000 maximum iba na 32 súbežných streamoch a 560 výstupných tokenov za sekundu, než klesla, zatiaľ čo WS300 pokračovala na 2 316 pri 128 streamoch.
Qwen3 kódovač 30B
Qwen3 Coder 30B, kombinácia expertného modelu s malým počtom aktívnych parametrov, je jediný test, v ktorom menšie systémy prekonali medzeru v jednom streame. Pri jednej súbežnej požiadavke a rovnakom zaťažení dodala RTX PRO 6000 208 výstupných tokenov za sekundu oproti 310 tokenom WS300, čo je najbližší výsledok v tomto porovnaní so stanicou, a dokonca aj Spark dosiahol použiteľných 55 tokenov. Dávkovanie obnovuje obvyklé poradie: pri 128 streamoch je 12 425 výstupných tokenov za sekundu stanice v FP8 2.4-krát viac ako karta a takmer 16-krát viac ako Spark.
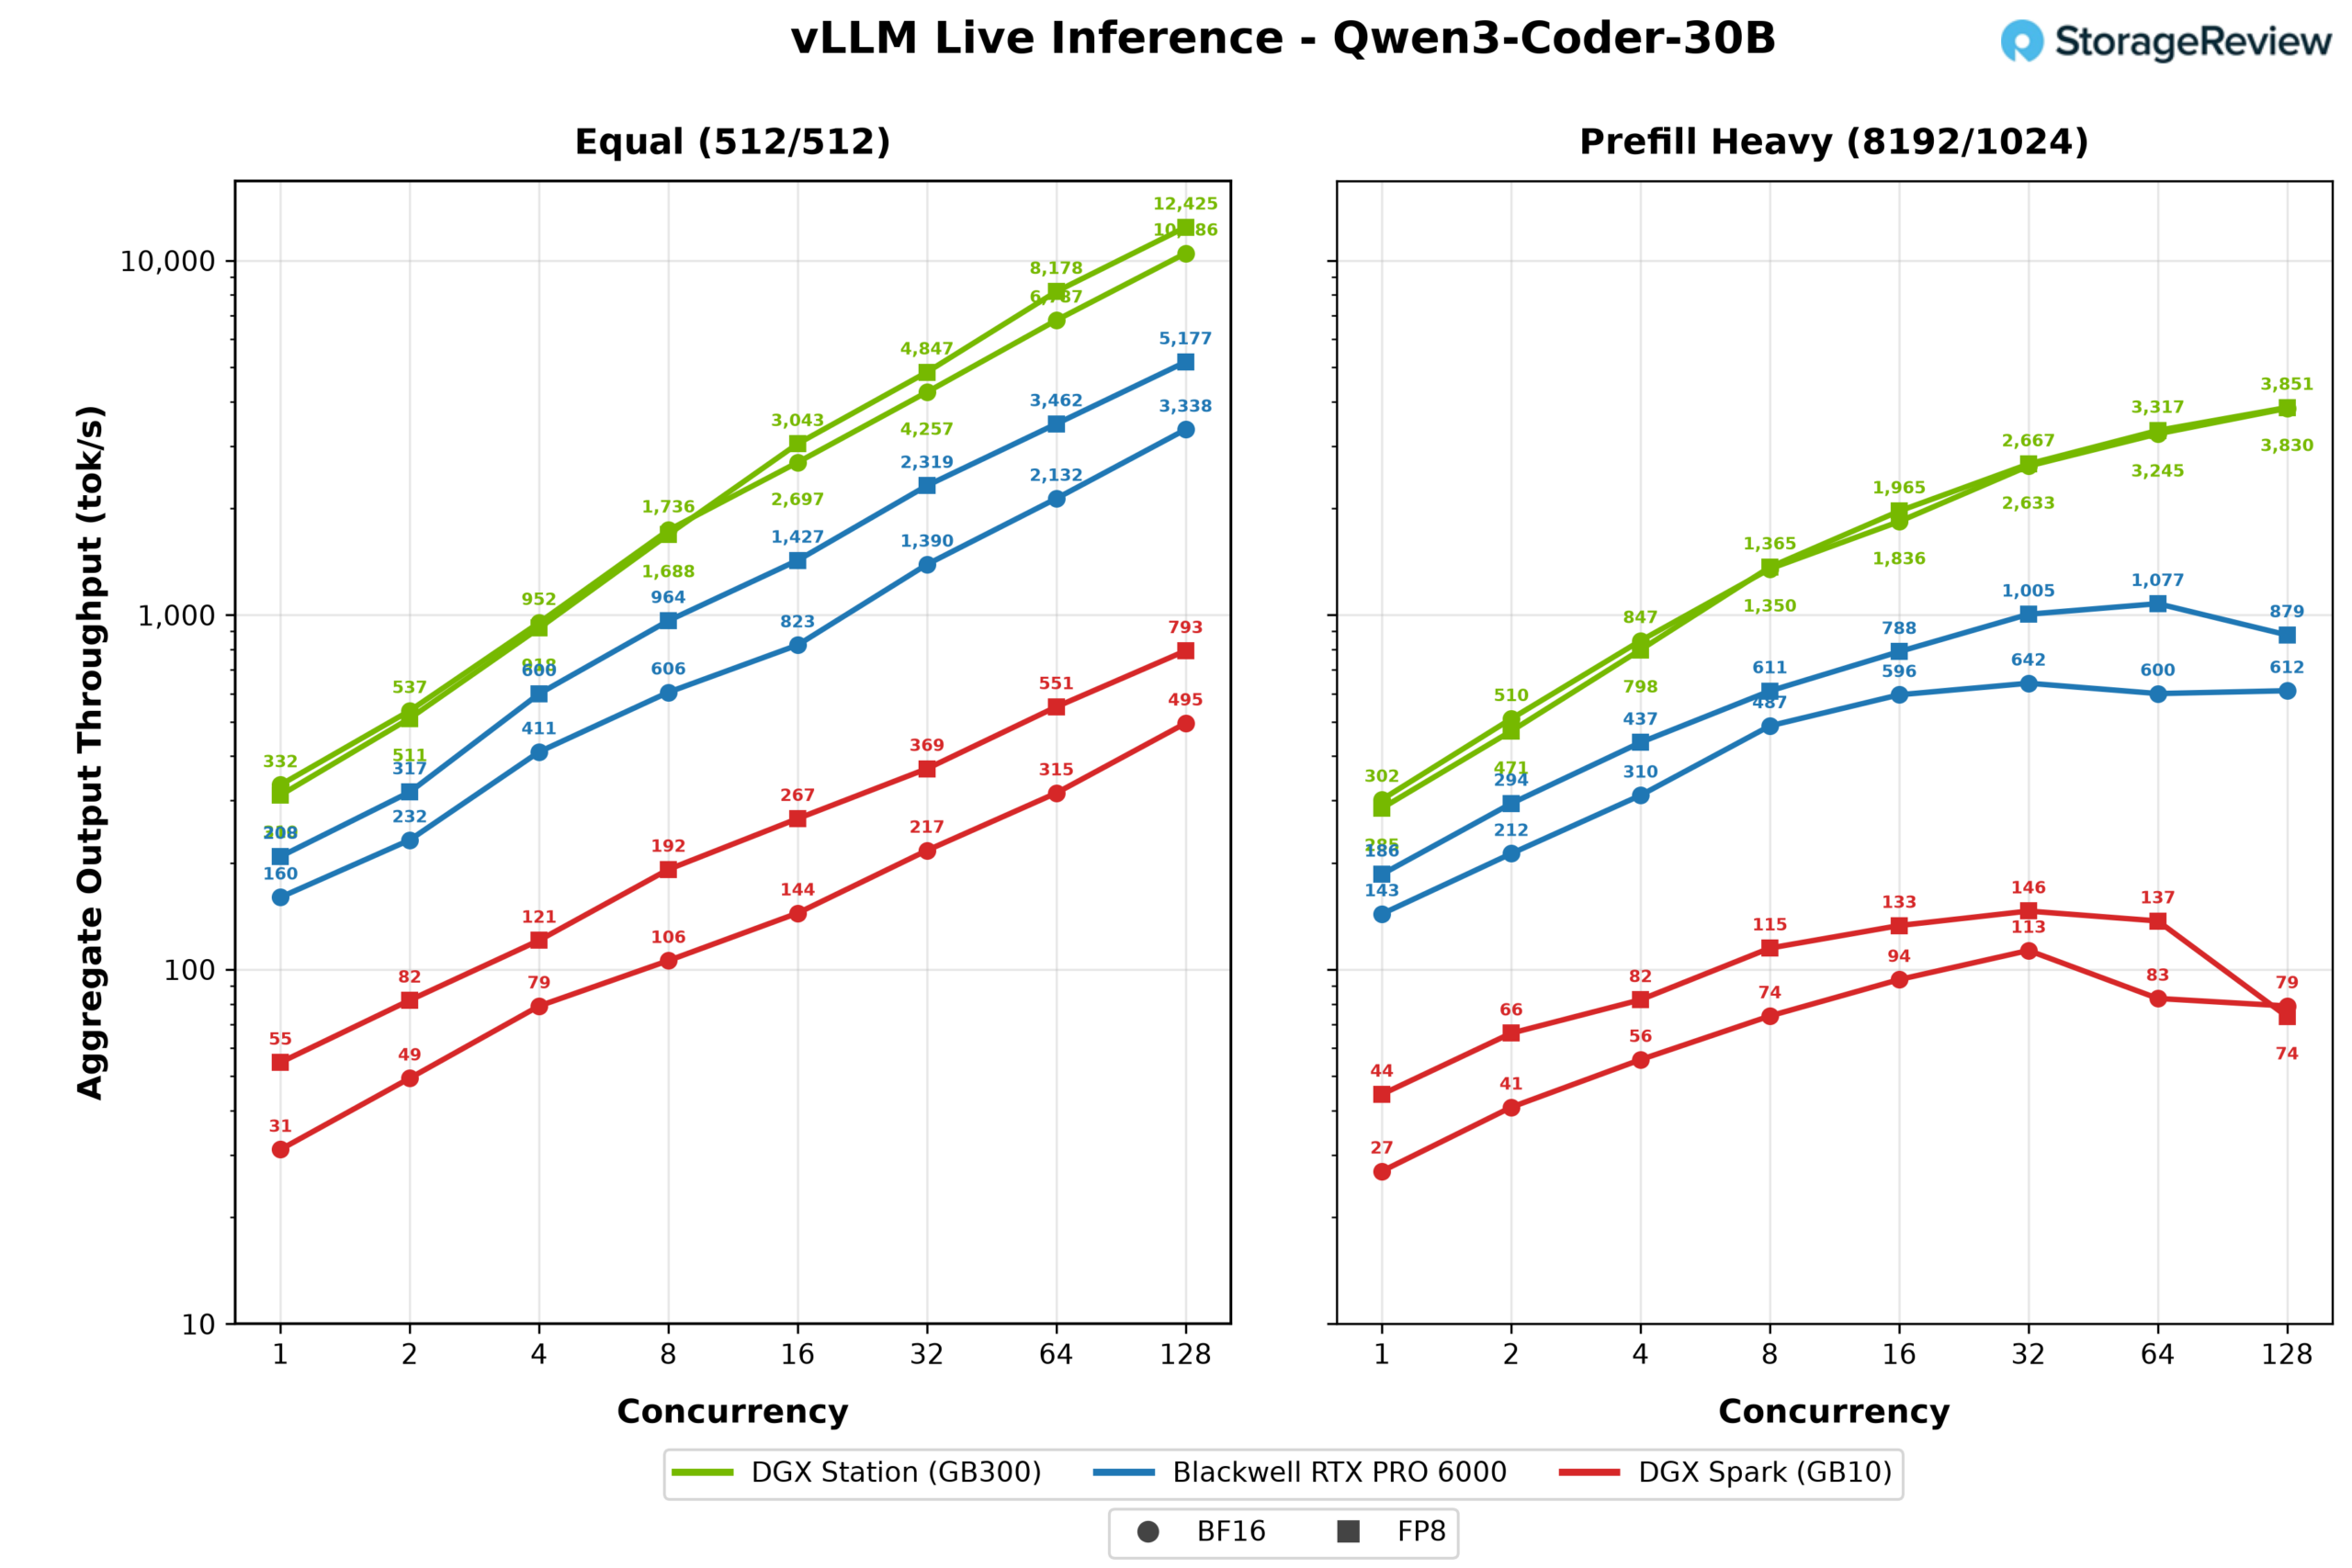
Výrazné predfillovanie nasledovalo zaužívaný vzorec, pričom WS300 dosiahol 3 851 výstupných tokenov za sekundu, zatiaľ čo karta dosiahla vrchol 1 077 a Spark 146.
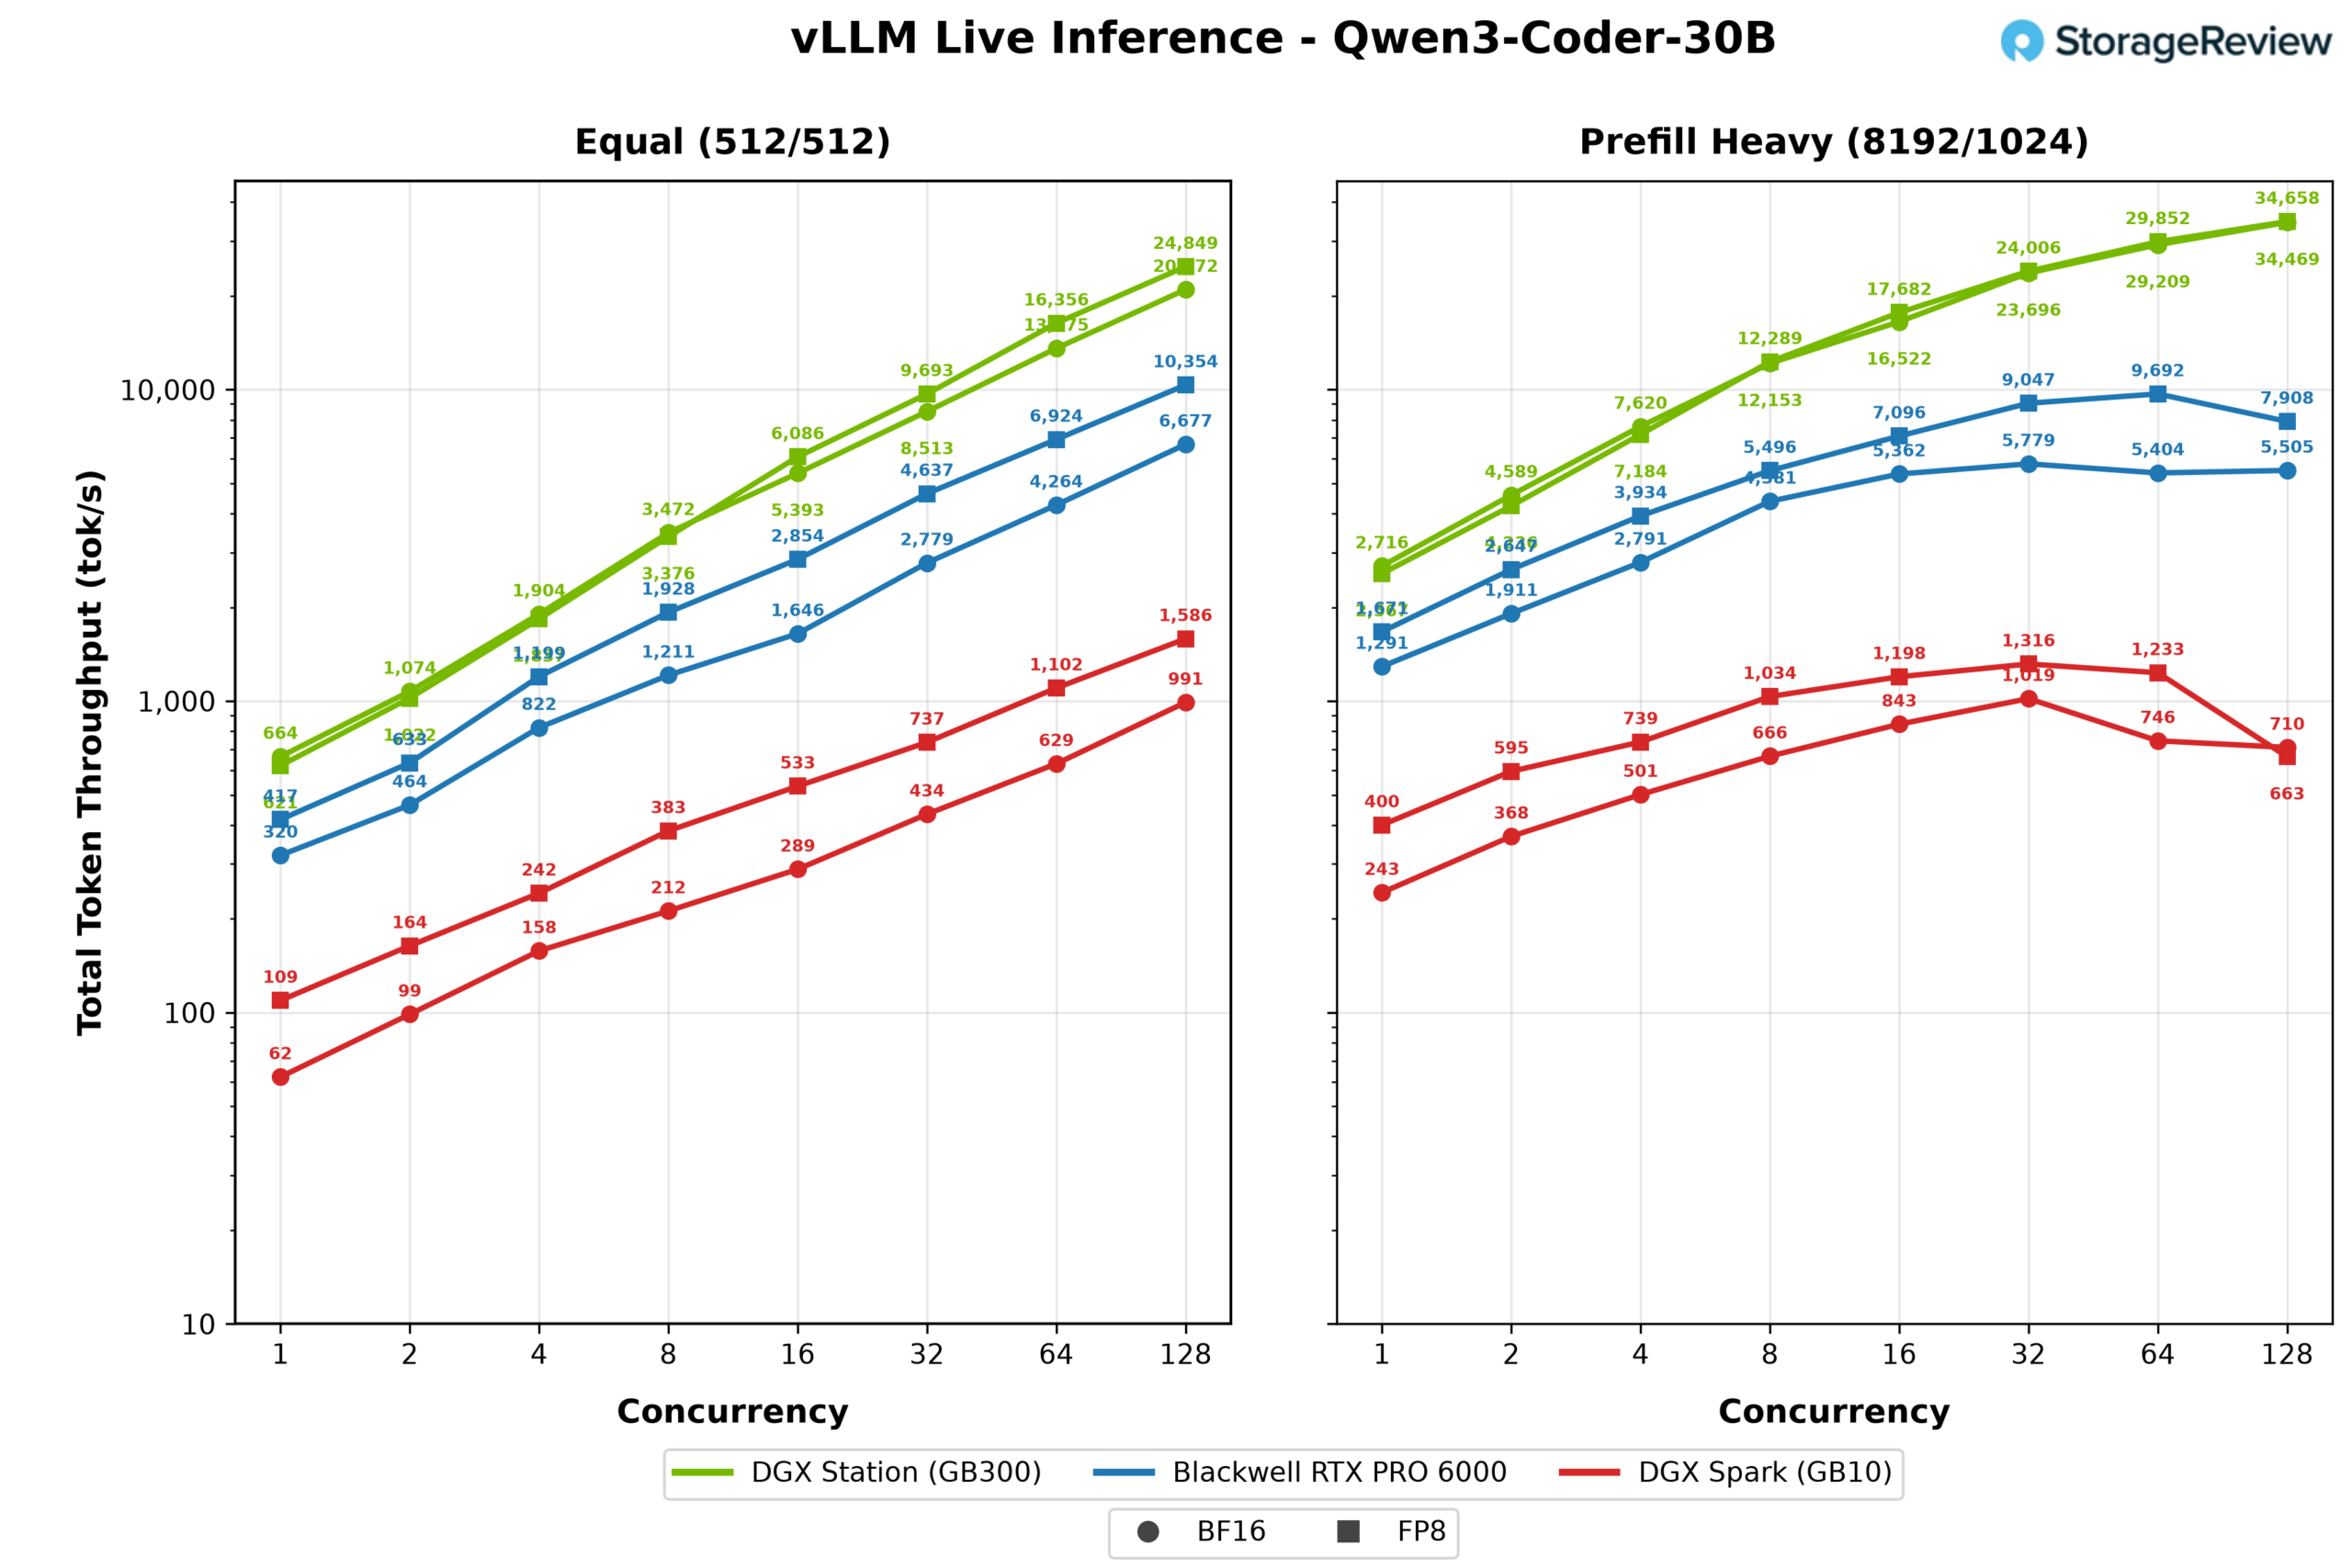
V rámci piatich zdieľaných modelov dosiahol WS300 pri plnej súbežnosti 2.3 až 3-násobok priepustnosti Blackwell RTX PRO 6000 a 14 až 19-násobok priepustnosti DGX Spark, pričom rozdiel sa rozširuje smerom k 6-násobku karty, keď dlhé výzvy zaťažujú vyrovnávaciu pamäť KV. Všetky tri počítače používajú rovnaký CUDA stack a rovnaké kvantizačné cesty; Station získava pamäťovú kapacitu a šírku pásma, ktoré sa tu zobrazujú ako priestor pre súbežnosť a tolerancia dlhého kontextu. Rovnako dôležité je to, čo tieto grafy nedokážu ukázať: žiadny z modelov v predchádzajúcich častiach sa ani nenačíta na ostatných dvoch systémoch.
GDSIO
Moderné pracovné zaťaženia umelej inteligencie závisia od presunu dávok údajov, váh modelov a kontrolných bodov z úložiska do pamäte GPU dostatočne rýchlo, aby sa akcelerátor udržal zaneprázdnený. Úložisko NVIDIA GPUDirect odstraňuje tradičnú cestu dvoch kópií, pri ktorej sa dáta najprv načítajú z SSD do systémovej pamäte a potom skopírujú do pamäte GPU.
Stanica GB300 DGX to implementuje inak ako konvenčný server PCIe GPU. Micron 4600 použitý v našom teste je pripojený k prepínaču PCIe integrovanému v ConnectX-8. ConnectX-8 sa pripája proti prúdu k procesoru Grace, zatiaľ čo grafický procesor B300 sa pripája k Grace cez NVLink-C2C. SSD a grafický procesor sa nenachádzajú pod tým istým prepínačom PCIe. Prevádzka úložiska namiesto toho prechádza cez prepínač ConnectX-8, vstupuje do koreňového komplexu PCIe Grace, prechádza koherenčnou štruktúrou Grace a prechádza cez NVLink-C2C, aby dosiahla HBM3e v B300.
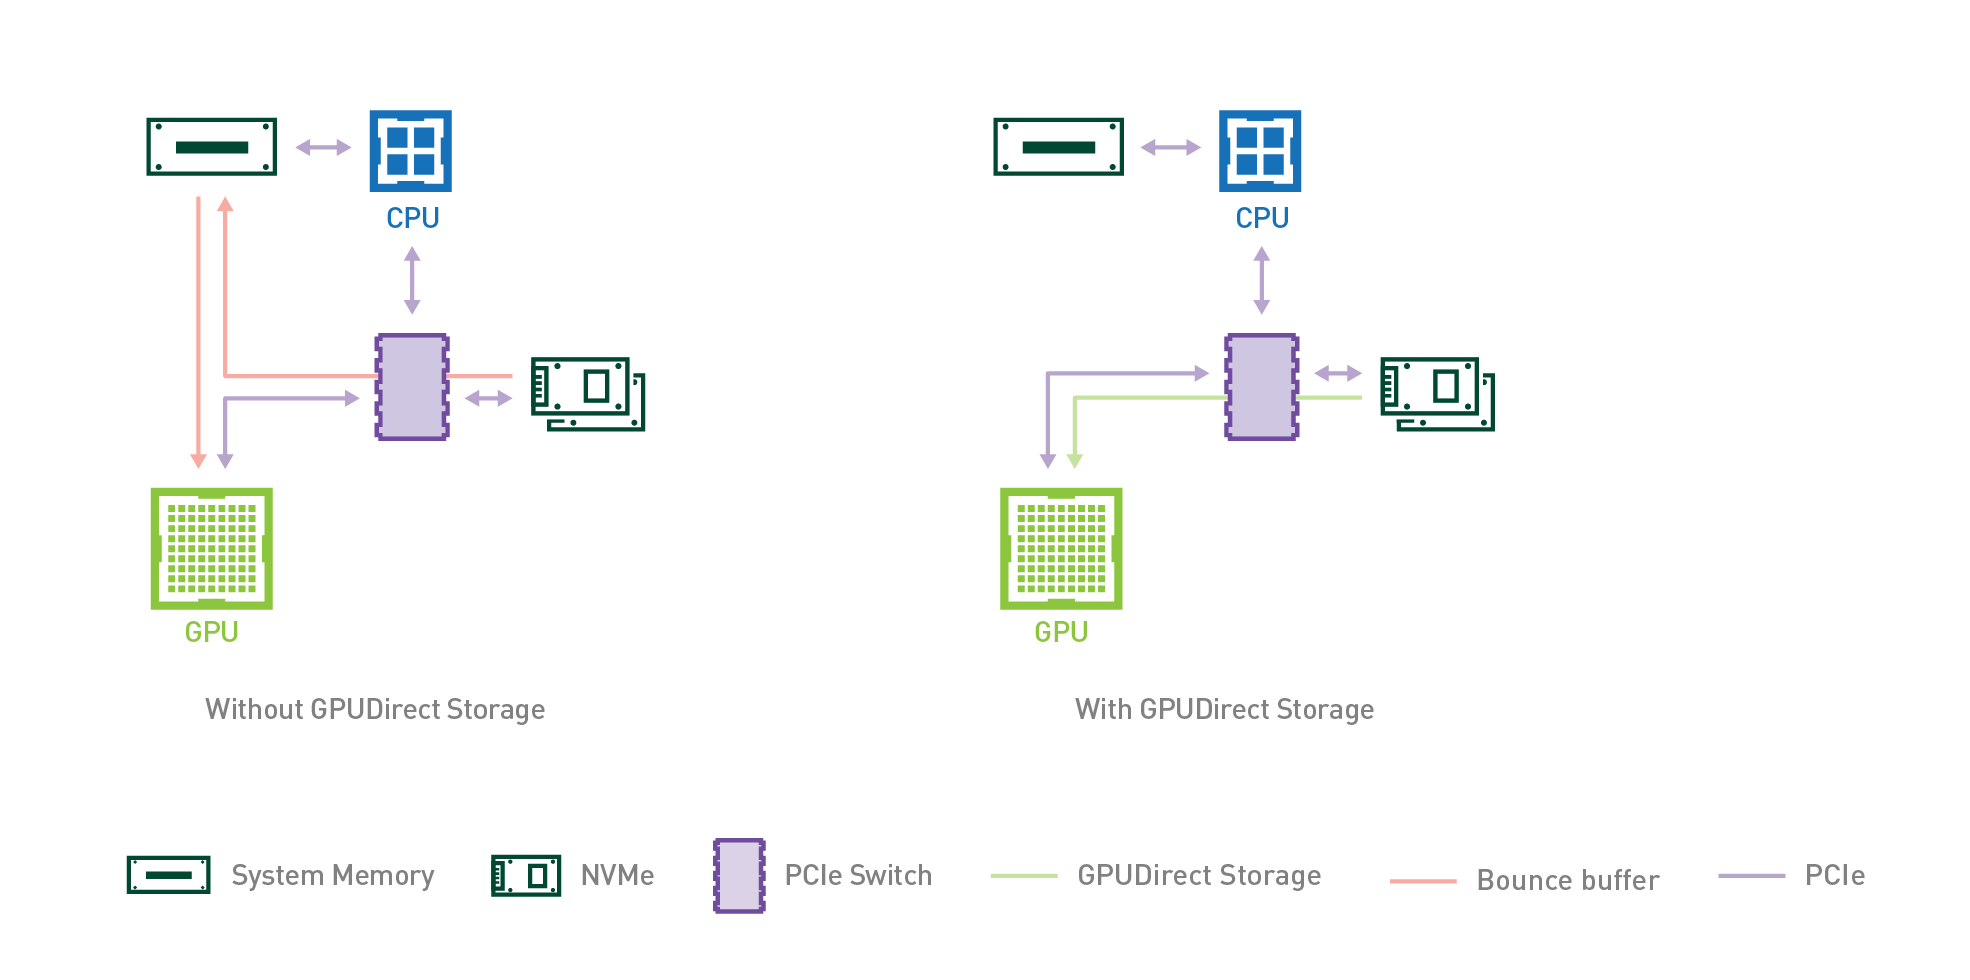
Pri použití GPUDirect Storage zaregistruje cuFile vyrovnávaciu pamäť alokovanú v B300 HBM3e ako zdroj alebo cieľ pre I/O úložiska. Pri čítaní používa radič Micron 4600 DMA na umiestnenie údajov do HBM3e; pri zápise načíta údaje z HBM3e. Obe operácie sledujú cestu Grace a NVLink-C2C opísanú vyššie bez umiestnenia užitočného zaťaženia do pamäte LPDDR5X od Grace. Grace stále spravuje súborový systém a riadiacu rovinu NVMe vrátane odosielania príkazov a prekladu adries, ale nekopíruje údaje. GPUDirect Storage preto odstraňuje krok umiestnenia systémovej pamäte, aj keď prevádzka stále prechádza cez Grace na ceste medzi SSD a pamäťou B300. Pri úlohách AI zodpovedajú sekvenčné čítania streamovaniu súborov údajov, načítavaniu modelov a obnove kontrolných bodov, zatiaľ čo sekvenčné zápisy zodpovedajú ukladaniu kontrolných bodov a iným prenosom späť do úložiska. Na testovanie výkonu GDSIO sme merali výkon úložiska s využitím jedného samostatného sekundárneho SSD.
Konfigurácia testovania GDSIO
- Bootovacie úložisko: 2 x Micron 4600 2TB v RAID1
- Sekundárne úložisko: 2 x Micron 4600 2TB
Pri pohľade na výkon sekvenčného čítania GDSIO sa jednotka konzistentne škáluje v závislosti od počtu vlákien aj veľkosti blokov. Pri 16K sa priepustnosť zvyšuje zo 16MiB/s pri 1 vlákne na 250MiB/s pri 16 vláknach, pričom pri 128 vláknach dosahuje 2.0GiB/s. Väčšie veľkosti blokov sa zvyšujú oveľa rýchlejšie, pričom 256K dosahuje 11.8GiB/s pri 64 vláknach a vrchol dosahuje pri 12.9GiB/s pri 128 vláknach. Najlepšie výsledky sa dosahujú pri 512K a 1M, kde priepustnosť dosahuje vrchol 13.1GiB/s, pričom pracovné zaťaženie 1M dosahuje túto úroveň iba pri 32 vláknach a udržiava ju počas 128 vláknach.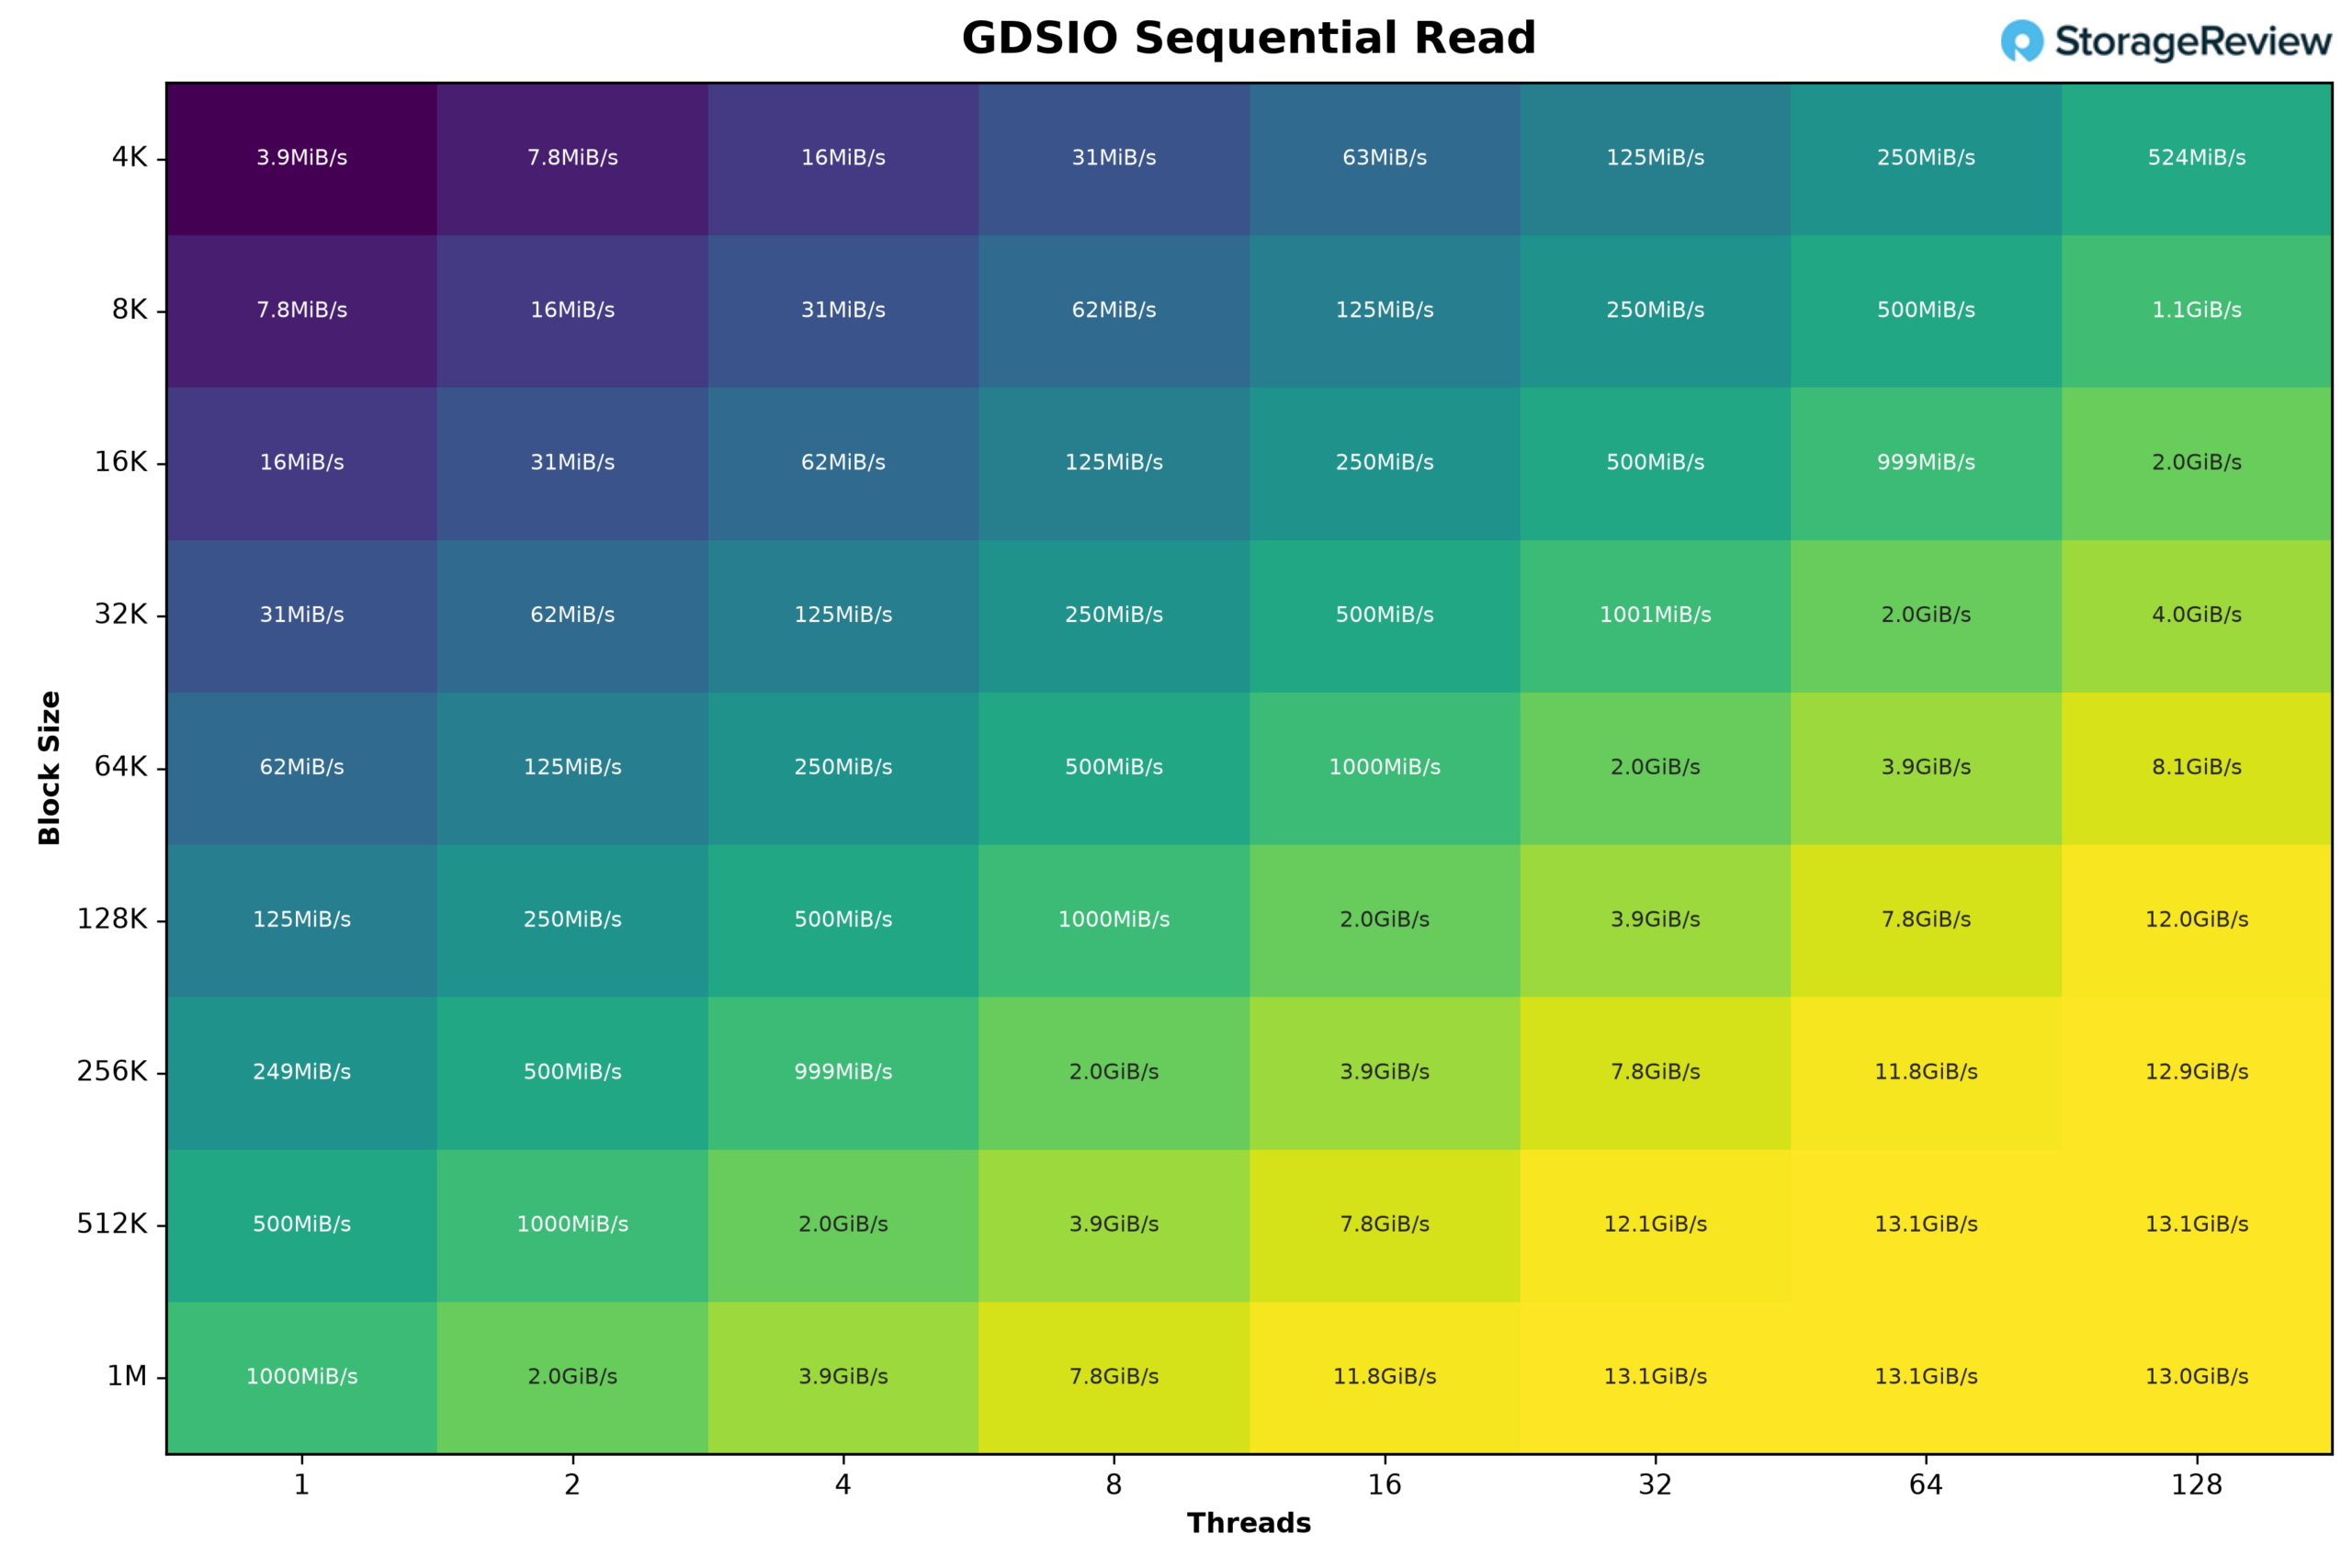
Pri prechode na výkon sekvenčného zápisu GDSIO sa jednotka konzistentne škáluje v závislosti od počtu vlákien aj veľkosti blokov. Pri 16K sa priepustnosť zvyšuje zo 16MiB/s pri 1 vlákne na 250MiB/s pri 16 vláknach, pričom pri 128 vláknach dosahuje 2.0GiB/s. Väčšie veľkosti blokov sa zvyšujú oveľa rýchlejšie, pričom 256K dosahuje 7.5GiB/s pri 32 vláknach a 12.0GiB/s pri 64 vláknach. Najsilnejší výsledok pochádza z pracovného zaťaženia 1M, ktoré dosahuje strop 12.0GiB/s len pri 16 vláknach a tento výkon si udržiava počas 128 vláknach. 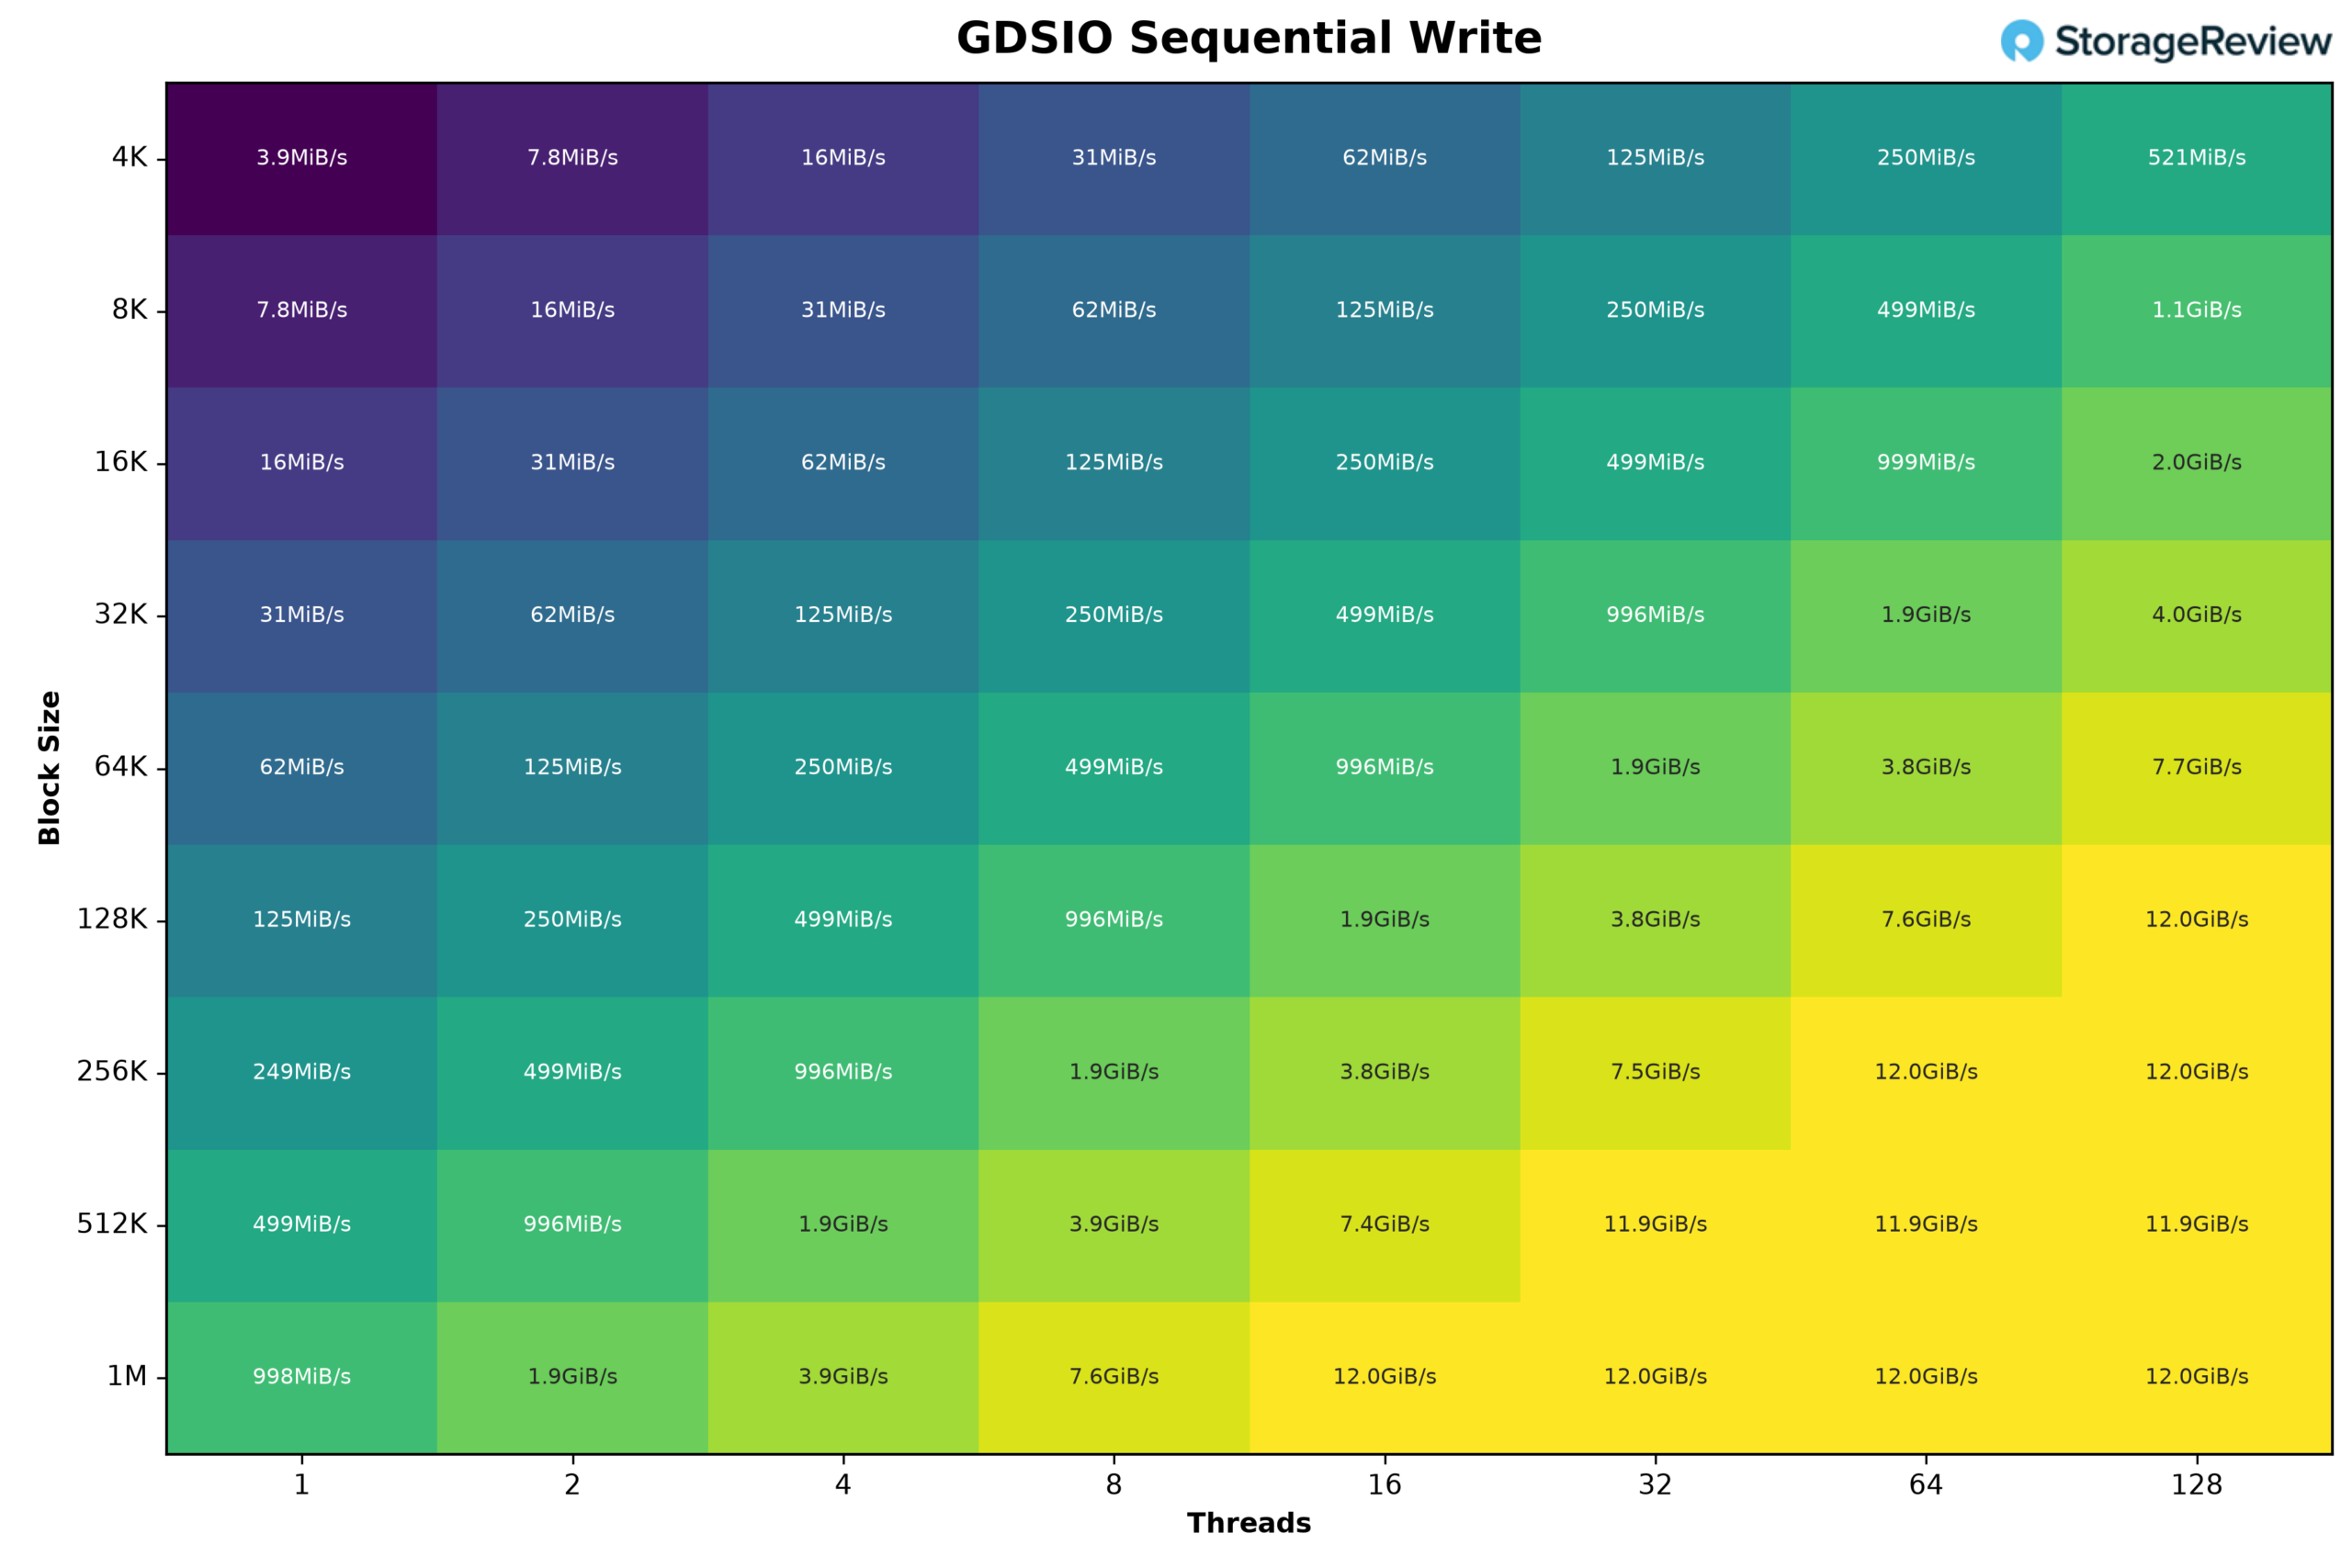
Pre koho je určený MSI XpertStation WS300?
WS300 je určený pre organizácie, ktoré potrebujú priamy prístup k Blackwell Ultra, ale nechcú, aby každý experiment začínal rezerváciou klastra alebo požiadavkou na cloud. Laboratóriá umelej inteligencie, vývojári inferenčných nástrojov, tímy frameworkov a kompilátorov, robotické skupiny a podnikové tímy umelej inteligencie ho môžu použiť ako lokálny vývojový uzol pre vyššie uvedené pracovné postupy. MIG umožňuje vývojárom testovať a vyvíjať pre nastavenie s viacerými GPU a BMC umožňuje vzdialenú správu systému.
Dáva to zmysel aj pre skúsených vývojárov umelej inteligencie, ktorí potrebujú systém pripravený na prácu. Hodnota nespočíva len v B300. Je to kompletná platforma okolo neho: 252 GB HBM3e, Grace a 496 GB LPDDR5X, ConnectX-8, zrkadlené úložisko pre bootovanie, kvapalinové chladenie, vzdialená správa a podpora od MSI v jednej veži. Praktickými obmedzeniami sú hostiteľ Arm, požiadavka na vyhradený 20A obvod a zdieľaný rozpočet 1 600 W pri nainštalovaní veľkej grafickej karty RTX PRO.
Maximálne využitie WS300 závisí aj od softvéru, ktorý ho obklopuje. NVIDIA poskytuje širokú škálu postupov a sprievodcov nasadením, ktoré majú pomôcť tímom rýchlo spustiť systém a uviesť jeho zdroje do prevádzky. V budúcnosti preskúmame niekoľko z týchto nástrojov vrátane Brevu, ktorý môže zjednodušiť zdieľaný prístup k pracovnej stanici a zlepšiť využitie, aby takýto drahý zdroj nezostal nečinný.
Čo sa týka ceny, MSI žiadnu nezverejnila a stroje v tejto triede majú len zriedka uvedenú cenu; ide o dôležitú konverzáciu s obchodným tímom, nie o tlačidlo na pridanie do košíka. Úprimné porovnanie nie je s inými pracovnými stanicami, ale s tým, za čo tím umelej inteligencie už platí: rezervovaný čas klastra, záväzky cloudovej GPU a náklady na plánovanie čakania na zdieľaný hardvér.
Záver
MSI XpertStation WS300 je najvýkonnejšia pracovná stanica, akú sme kedy recenzovali, a zároveň vzácny produkt, ktorý mení to, čo dokáže jeden odborník. Kontrolné body hraničného rozsahu, ktoré sa bežne nachádzajú za klastrovou rezerváciou, GLM-5.2 s kapacitou 433 GB a Nemotron-3-Ultra s 550 miliardami parametrov, sa načítavajú a obsluhujú na krabici vedľa stola, súkromne a vždy dostupné. To je zdroj nášho nadšenia pre tento systém.
Stanica DGX je určená pre vývojárov: vývojárov jadra zameraných na Blackwell Ultra, tímy zaoberajúce sa inferenčnými enginami a frameworkami, robotické skupiny prevádzkujúce kompletnú slučku Isaac a všeobecne používateľov frustrovaných z plánovania experimentov okolo zdieľaného hardvéru. Mimo tejto oblasti je argument pre kúpu týchto systémov dosť obmedzený. Hostiteľ Arm vylučuje niektoré reťazce nástrojov; 20A obvod je inštalačnou požiadavkou na 120V obvodoch; bez prídavnej karty nie je k dispozícii výstup na displej; a pracovná stanica RTX PRO 6000 stojí oveľa menej, čo pokrýva prácu jedného používateľa na modeloch, ktoré sa zmestia do jej 96GB pamäte.
Ekonomické aspekty tiež obmedzujú správnu veľkosť nasadenia. Jeden server WS300 sa dá ľahko zdôvodniť rezervovaným časom klastra a dva servery na tím stále áno. Ďalšie stohovanie v určitom bode stráca zmysel: v čase, keď organizácia kupuje napríklad štyri veže GB300, je za rovnaké peniaze na dosah osemprocesorový server B300 s väčšou pamäťou na GPU, hustejším rozdelením MIG a NVLink medzi jednotlivými GPU. Ideálna je jedna jednotka na stole, možno dve v laboratóriu, čo dopĺňa investíciu do dátového centra.
Základnú dosku dodáva spoločnosť NVIDIA, takže rozdiel medzi výrobcami originálneho vybavenia závisí od implementácie a prevedenie od MSI je v tomto smere solídne. B300, Grace, SOCAMM a ConnectX-8 chladí kvapalinový okruh s výkonom 1 400 W a platforma zostala počas testovania stabilná. Tento hlbší pohľad je teraz zverejnený: náš podrobný pohľad na teplotu WS300 porovnáva údaje o chladiacej doske a chladiči od MSI s 2.8-hodinovým prístrojovým testovaním, ktoré ukazuje, že čip sa udržiava na 60 °C a pri plnom zaťažení pracuje na rovnej frekvencii 2.07 GHz. Napájací rozpočet 1 600 W sa automaticky rozdeľuje medzi komponenty a keď sme testovali hardvérovú výkonovú brzdu s narušeným pripojením, skôr sa spomalila, než vypla. Predpripravený kábel 12VHPWR a držiak proti prehýbaniu podporujú rozširujúcu cestu RTX PRO. Po otestovaní prvej stanice GB300 DGX, ktorá sa k nám dostala, môžeme povedať, že XpertStation WS300 nastavuje pre platformu vysokú latku.
XpertStation WS300 teraz drží pozíciu Najlepší systém GB300 v našom rebríčku Najlepšie stolové počítače pre lokálnu AI a je súčasťou diskusie o pamäti v našom sprievodcovi RAM, GPU a úložisko pre Agentic AI.


 Amazonka