

Systémy umelej inteligencie pre stolové počítače postavené na čipsete NVIDIA GB10 majú jednu úlohu a robia ju dobre: umiestniť 128 GB unifikovanej pamäte a petaflop výpočtového výkonu na stôl dostatočne blízko osoby, ktorá ho používa, aby iterácia bola okamžitá. Čo však nemajú, je pripojenie k úložisku, ktoré už organizácia prevádzkuje. Každý variant DGX Spark a OEM sa dodáva s jedným krátkym slotom M.2, ktorý obmedzuje lokálnu kapacitu na približne 4 TB a umiestňuje každú množinu údajov, model a kontrolný bod na tomto počítači mimo riadenia, kontroly prístupu, zálohovania a auditu, ktoré sa nachádzajú v dátovom centre. Vynásobte to laboratóriom, oddelením alebo kampusom a výsledkom sú desiatky izolovaných 4TB ostrovov, z ktorých každý obsahuje vlastnú kópiu rovnakých modelov a množín údajov, pričom každý z nich je len taký bezpečný, ako je bezpečný stôl, na ktorom sa nachádza.
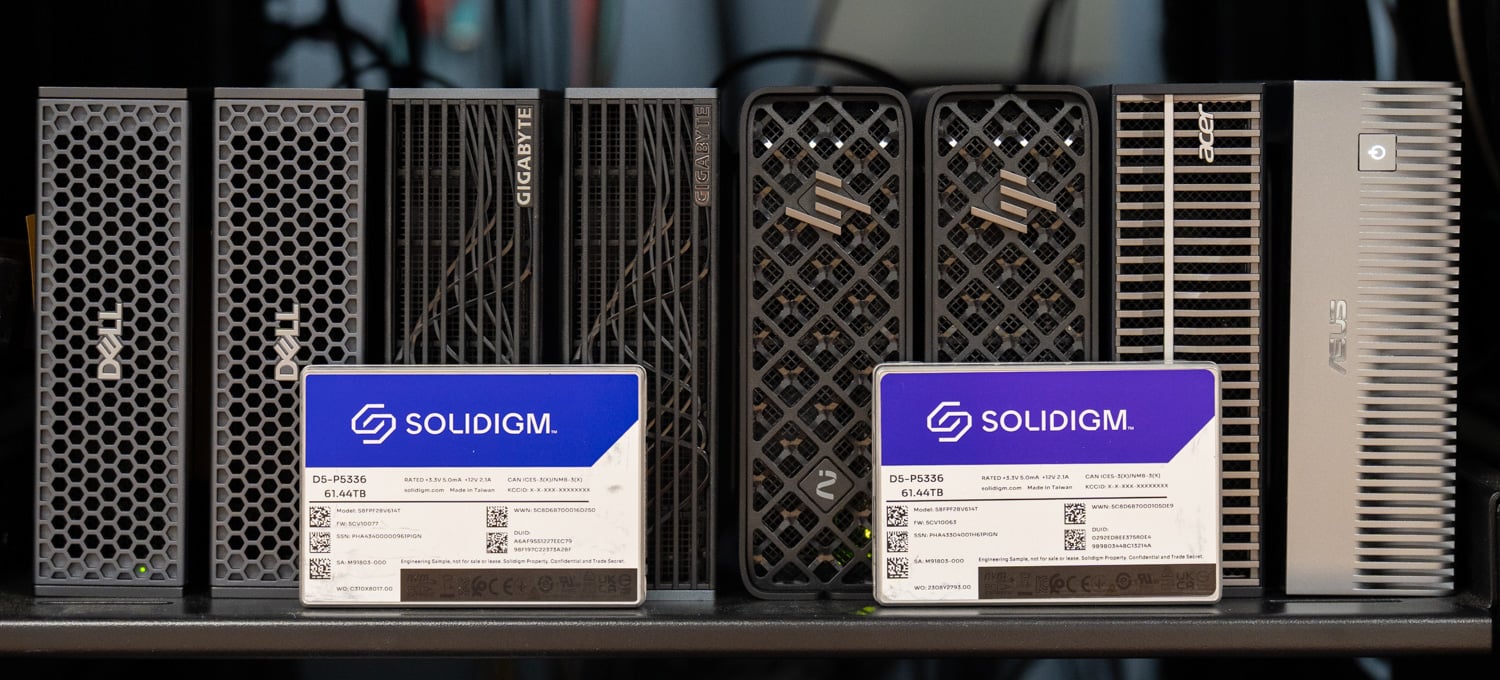
Tento projekt prenáša problém s úložiskom späť do dátového centra. Zostavili sme zdieľaný úložný hostiteľský systém DGX Spark z prístupového bodu Dell PowerEdge R770AP, ôsmich SSD diskov Solidigm D5-P5336 QLC v poli Graid SupremeRAID RAID 5, siete Broadcom 400GbE a zariadenia Tuxera Fusion, ktoré obsluhujú NFS cez RDMA. Potom sme k jeho 100GbE portom pripojili osem zariadení Spark. Každý Spark na sieti Fabric pripája rovnaký riadený, paritou chránený úložný fond s jednou linkou; jedna kópia každého modelu a súboru údajov obsluhuje všetky, žiadna pracovná stanica nepotrebuje viac úložiska, ako je dodávané, a samotné zariadenia Spark môžu byť umiestnené v racku vedľa poľa, kde sa ľahšie zabezpečujú, chladia a zdieľajú. Zmyslom tejto zostavy je miesto, kde sa uchovávajú dáta, a túto úlohu by mohol zohrať akýkoľvek server NVMe s rýchlymi sieťovými kartami. Oregonská štátna univerzita, ktorá skúma rozsiahle laboratórium Spark pre učenie sa umelej inteligencie a chce študentom poskytnúť prístup k výskumným súborom údajov meraným v desiatkach terabajtov, sa s nami podelila o svoje myšlienky počas navrhovania zostavy a pre dáta v tomto rozsahu bolo zdieľané úložisko prístupom, ktorý zodpovedal tomuto hodnoteniu.
Kľúčové poznatky
- Jedno pole, osem Sparkov, žiadny klientsky softvér: Osem DGX Sparks od piatich výrobcov originálneho vybavenia pripája zdieľané NFS/RDMA úložiská z jedného poľa Solidigm D5-P5336 QLC za Graid SupremeRAID a Tuxera Fusion cez 100GbE porty, ktoré už majú, s jednoriadkovým pripojením na štandardný Ubuntu.
- Hostované modely sa načítavajú ako lokálne: 78GB model Qwen3.5-122B-A10B-NVFP4 sa na jednom Sparku načítal zo zdieľaného poľa za 269.6 sekundy, čo je v rámci 13 % z 239.6 sekúnd, ktoré ten istý Spark potreboval zo svojho interného NVMe, a osem Sparkov, ktoré načítali tú istú kópiu naraz, dokončilo načítanie za 232.8 až 326.5 sekundy.
- Jedna kópia nahradí silo na každom stole: Modely a súbory údajov na riadenom, paritne chránenom úložisku dátového centra nahrádzajú kópie pre jednotlivé pracovné stanice na 4TB diskoch M.2, takže využitie sa zvyšuje, kopírované údaje sa znižujú a žiadny Spark nepotrebuje upgrade úložiska ani miesto na stole. Pre rozsiahle laboratórium pre učenie sa umelej inteligencie, ako je to, ktoré skúma Oregon State University, kde výskumné súbory údajov dosahujú desiatky terabajtov, je to prístup, ktorý zodpovedá prípadu použitia v našom hodnotení.
- Disky určujú strop a sieť má rezervu: Pri súčasnom čítaní všetkých ôsmich diskov Spark dosiahlo osemdiskové pole RAID 5 maximálnu rýchlosť blízko 25 GiB/s, čo je približne 214 Gb/s, čo využilo 27 % z 800 Gb/s, ktoré dokážu preniesť dve sieťové karty Broadcom BCM57608 v hostiteľskom zariadení. Jeden Spark nameraný výkon z poľa s rýchlosťou 10.8 GiB/s sa zhoduje s najrýchlejším interným M.2, aký sme namerali v systéme GB10.
- Riadenie je súčasťou protokolu: NFS s RDMA umiestňuje priečinky pre jednotlivých používateľov, zdieľané súbory údajov a hosťované modely do jedného menného priestoru s využitím služieb Active Directory, Kerberos a LDAP, čo umožňuje, aby dáta zostali pod kontrolou dátového centra, zatiaľ čo sa zariadenia Sparks presúvajú do racku.
Problém s ostrovčekom umelej inteligencie na každom stole
DGX Spark a jeho OEM varianty od spoločností Dell, GIGABYTE, HP, Acer a ASUS zdieľajú platformu GB10 a rovnaký úložný strop. V našej pôvodnej recenzii DGX Spark bolo úložisko najzreteľnejším obmedzením platformy. Interný slot podporuje krátke disky M.2, takže 8TB klientske SSD disky, ktoré sa dodávajú vo formáte 2280, sa doň fyzicky nezmestia. Luisuantech GP Spark, ktorý sme recenzovali v auguste, na to reaguje štvorpozicovým M.2 krytom visiacim z jedného 100GbE portu, čo je čisté riešenie pre jeden Spark na jednom stole a v laboratórnom meradle väčšie silo na každom stole.
Kapacita je polovica problému; druhá polovica je to, čo sa stane s dátami po ich umiestnení na stolnom počítači. Model s kapacitou 78 GB prenesený na Spark je kópia, ktorú nikto v IT nevidí. Výskumná dátová sada uložená na lokálnej flash pamäť je kópia mimo plánu zálohovania, mimo politiky prístupu a mimo inštitucionálnych auditov. Desať Sparkov v laboratóriu znamená desať kópií s rovnakou hmotnosťou, ktoré spotrebúvajú 780 GB flash pamäť a ktoré by sa dali použiť na niečo iné, a desať miest, kde môže dátová sada odísť s počítačom. Problém sa zhoršuje s rastúcimi číslami, či už ide o systémy GB10 alebo akúkoľvek infraštruktúru umelej inteligencie pre stolné počítače. Každá organizácia, ktorá spravovala flotilu notebookov, pozná tento vzorec a odpoveď bola vtedy rovnaká: dáta uchovávajte na zdieľanom úložisku v dátovom centre a koncový bod nechajte ako koncový bod.
Našťastie spoločnosť NVIDIA navrhla Spark s portami, ktoré to umožňujú. Každá jednotka nesie dve klietky QSFP56 na integrovanom rozhraní ConnectX-7 s maximálnou kapacitou platformy 200 GB použiteľnej šírky pásma za dvojicou liniek PCIe Gen5 x4. V našej recenzii klastra DGX Spark sme opísali konfiguráciu s rozdelenými rolami, v ktorej jedna klietka patrí k peer Sparku a druhá k úložisku. Tento projekt používa jednu klietku na Spark pre úložisko pri rýchlosti 100 GbE, pričom druhá zostáva voľná pre klastrovanie alebo dodatočnú šírku pásma. Pri rýchlosti 100 GbE má každý Spark teoretickú šírku pásma k úložnému hostiteľovi približne 12.5 GB/s, čo prevyšuje šírku pásma poskytovanú interným slotom M.2 vo väčšine týchto systémov.
Keď sa dáta dostanú na druhý koniec tohto pripojenia, úloha Sparku sa zmení. Stane sa výpočtovým koncovým bodom so zavádzacím diskom a lokálnym diskom vyrovnávacej pamäte a kapacita sa už nekupuje pre každú pracovnú stanicu. Model alebo súbor údajov sa zapíše raz a každý klient ho načíta, takže využitie úložiska sa zvýši a počet kópií sa zníži. Ochrana údajov sa presúva do poľa chráneného paritou v serverovom šasi a riadenie prístupu, šifrovanie v pokoji, zálohovanie a audit sa vykonávajú tam, kde už prebiehajú pre všetko ostatné. A pretože Spark teraz nepotrebuje nič iné ako napájanie a 100GbE pripojenie, nie je dôvod, aby musel vôbec stáť na stole. Umiestnený vedľa úložiska je chladnejší, tichší, fyzicky zabezpečený a dostupný pre každého, kto ho bude potrebovať nabudúce.
Hostiteľ úložiska
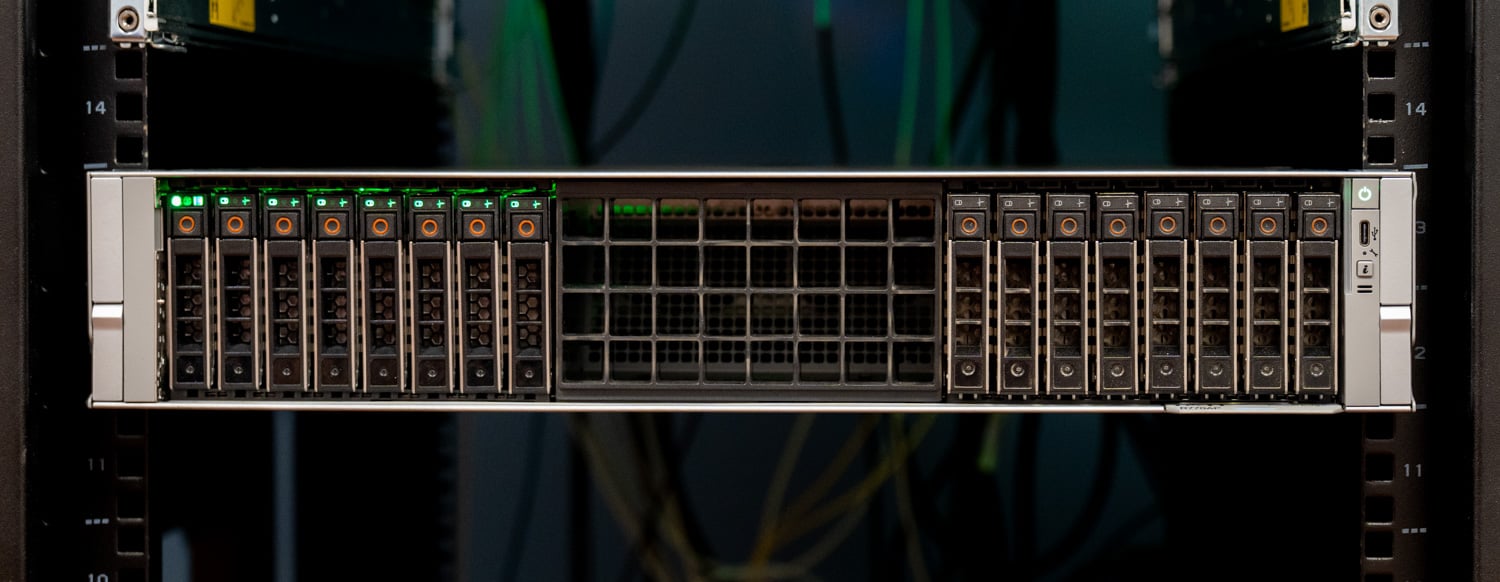
Úložisko je Dell PowerEdge R770AP , rovnaká platforma s 2U Xeon 6, ktorú sme recenzovali začiatkom tohto roka, a použili sme ju, pretože bola v laboratóriu voľná, keď sa projekt začal. Túto úlohu by mohol zaplniť akýkoľvek NVMe server s priestorom pre rýchle sieťové karty a malú grafickú kartu a R770AP je jedným zo spôsobov, ako ho zostaviť, aj keď je trochu prepracovaný. Náš server používa dva procesory Xeon 6 6978P s 1.5 TB DDR5 v 24 moduloch DIMM, používa jednu zo svojich dvoch bánk s ôsmimi pozíciami Gen5 NVMe a disky a grafickú kartu Graid sú umiestnené mimo CPU 0, pričom dva 400GbE adaptéry sú na CPU 1. Server beží na Ubuntu 24.04.
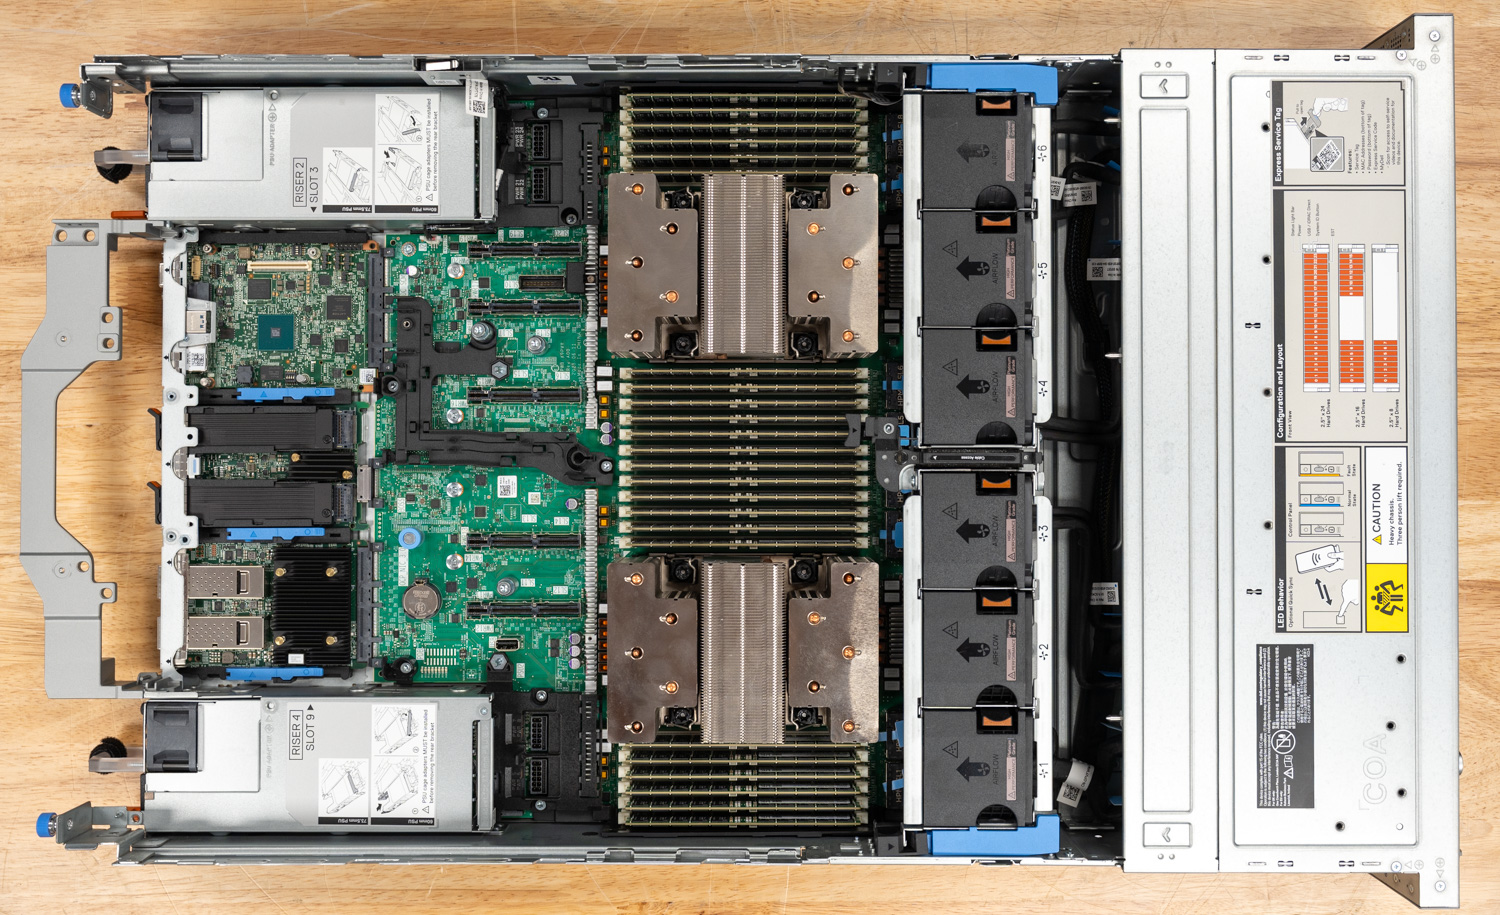
| Zložka | Konfigurácia hostiteľa úložiska |
|---|---|
| server | Dell PowerEdge R770AP, 2U, 16 2.5-palcových Gen5 NVMe pozícií |
| CPU | 2x Intel Xeon 6 6978P |
| Memory Masážne stoly | 1.5 TB DDR5 (24x 64 GB) |
| Uskladnenie | 8x Solidigm D5-P5336 61.44 TB U.2 PCIe 4.0 QLC (491.52 TB v surovom stave) |
| RAID | Graid SupremeRAID, RAID 5 na všetkých ôsmich diskoch, grafická karta NVIDIA RTX A2000 na procesore 0 |
| File System | XFS na virtuálnom disku SupremeRAID |
| Súborový server | Tuxera Fusion (Fusion NFS, súkromná ukážková verzia), NFS 4.1 cez RDMA (RPC-RDMA na porte 20049), používateľský režim |
| networking | 2x Broadcom BCM57608 (Thor 2) jednoportový 400GbE, PCIe Gen5 x16 na CPU 1, RoCEv2 |
| Prepínač | Dell PowerSwitch Z9864F-ON, 64x 800GbE OSFP112, Enterprise SONiC |
| Odkazy klientov | 800G optika rozdelená na 8x100GbE, jeden link na Spark, štyri Sparky na úložnú sieťovú kartu na samostatných VLAN |
| Klienti | 2x Dell Pro Max s GB10, 2x GIGABYTE AI TOP ATOM, 2x HP ZGX Nano G1n, Acer Veriton GN100, ASUS Ascent GX10 |
| OS | Ubuntu LTS 24.04 |
Prečo QLC a prečo D5-P5336
V našich rozhovoroch s Oregonskou štátnou univerzitou o koncepte laboratória Spark bola kapacita prvou požiadavkou, pretože výskumné súbory údajov sú rozsiahle. Úlohou tohto servera je uchovávať všetko, čo by miestnosť plná Sparks mohla potrebovať, a poskytovať to vo forme, ktorú si môže prečítať viacero klientov naraz. Ide o profil s vysokou kapacitou a intenzívnym čítaním, veľkými blokmi a práve pre tento profil bol QLC vytvorený. Rodina D5-P5336 má kapacitu od 7.68 TB do 122.88 TB; tu použité disky U.2 s kapacitou 61.44 TB sú spoločnosťou Solidigm hodnotené rýchlosťou sekvenčného čítania až 7 000 MB/s, sekvenčným zápisom 3 000 MB/s, rýchlosťou náhodného 4K IOPS pri čítaní 1.005 milióna a výdržou 65.2 PBW, čo predstavuje 0.58 zápisu na disk denne počas piatich rokov, na 192-vrstvovej QLC NAND s 16KB indirekcionálnou jednotkou.
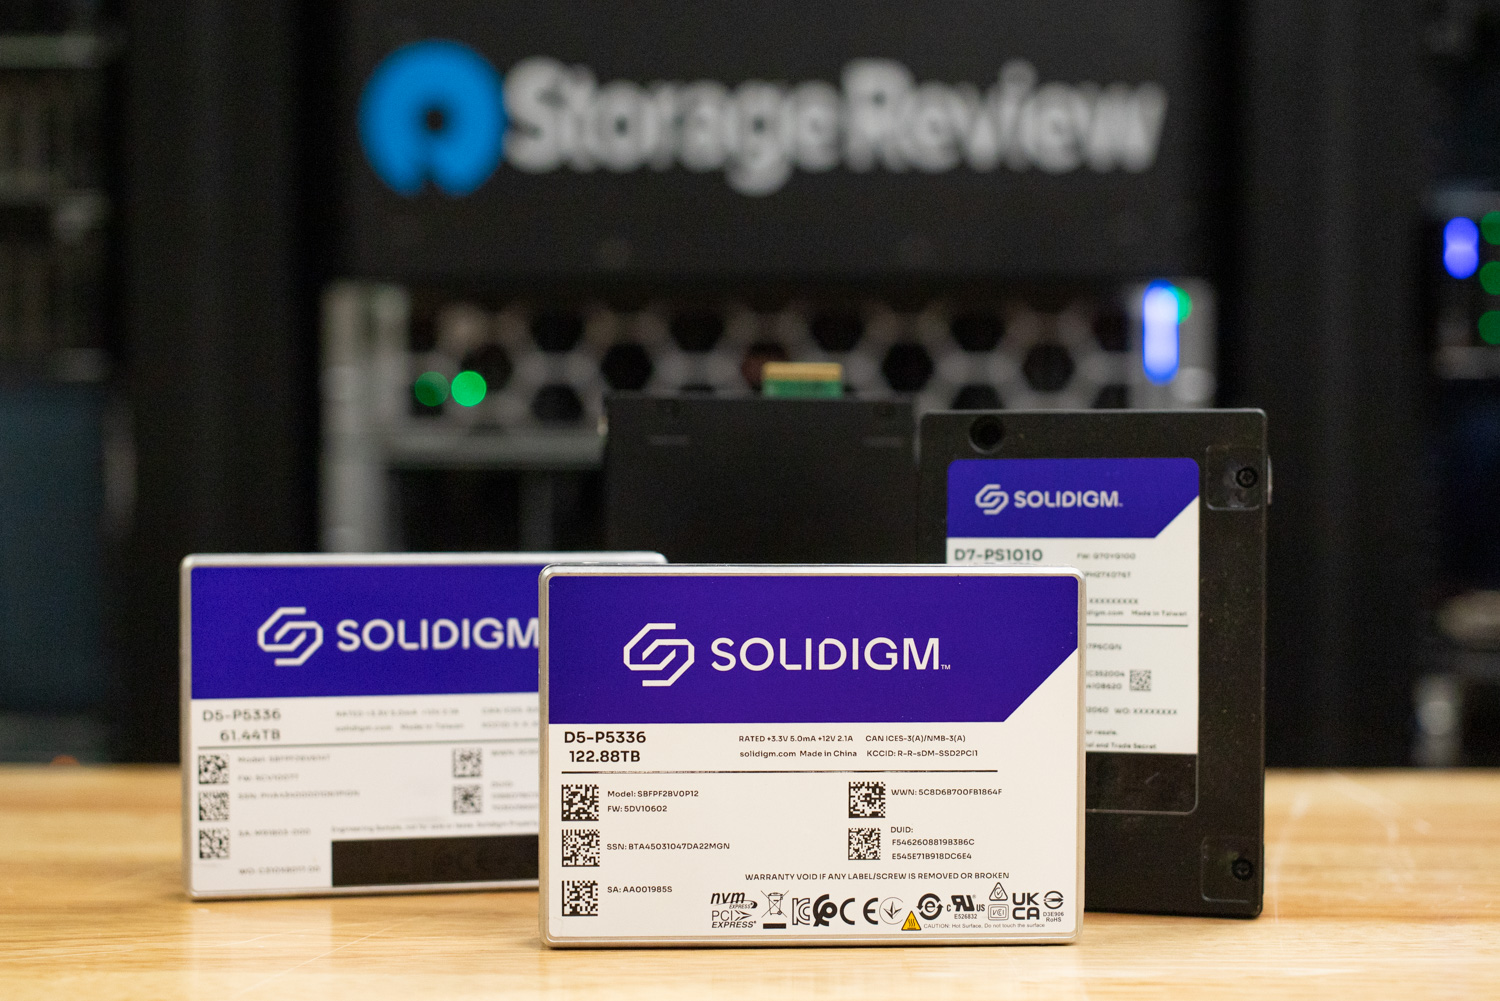
Osem diskov s kapacitou 61.44 TB zapĺňa polovicu predných pozícií R770AP a produkčná zostava by si mohla vybrať akýkoľvek kapacitný bod v rodine a ľubovoľný počet pozícií. Napriek tomu osem diskov v poli RAID 5 poskytuje približne 430 TB využiteľného priestoru s odolnosťou voči chybám jedného disku. To je viac ako 100-krát viac, ako má slot M.2 v Sparku, a dosť pre knižnicu modelov oddelenia, zdieľané súbory údajov, z ktorých študenti pracujú, a domovské adresáre jednotlivých používateľov. Zaplnenie ostatných ôsmich pozícií zdvojnásobí túto kapacitu bez toho, aby sa dotklo návrhu siete, a čísla o veľkostiach uvedené ďalej v tejto recenzii ukazujú, prečo sú disky tou súčasťou, ktorú treba rozšíriť.
16KB indirekcionálna jednotka je pre túto pracovnú záťaž dôležitá, pretože väčšia IU od Solidigmu vymieňa malú efektivitu náhodného zápisu za hustotu a náklady a pre zdieľanie, ktoré slúži modelom a súborom údajov, sú malé náhodné zápisy menšinovým prípadom. Načítavanie modelov je rozsiahle sekvenčné čítanie. Streamovanie súborov údajov je rozsiahle sekvenčné čítanie. Kontrolné body a študentské súbory sa zapisujú raz a čítajú sa často. Rozdelenie práce, ktoré z toho vyplýva, je pre laboratórium Spark správne: zdieľané pole QLC uchováva všetko, čo číta viacero používateľov, a vlastný M.2 Sparku spracováva prevádzku scratch a swap, ktorú zapisuje jeden používateľ.
RAID na GPU: Graid SupremeRAID
NVMe RAID na ôsmich diskoch Gen4, z ktorých každý dokáže čítať rýchlosťou 7 000 MB/s, je bod, v ktorom sa konvenčná hardvérová RAID karta stáva úzkym hrdlom, pretože každý bajt musí prejsť cez slot PCIe karty. Softvérový RAID čelí iným problémom s prístupom k zdrojom. Graid SupremeRAID prenáša výpočty parity na GPU a udržiava dátovú cestu na PCIe linkách hostiteľa, a preto sme v našom testovaní SupremeRAID AE so 16 diskami videli škálovateľnosť na viac ako 180 GB/s. Pre tohto hostiteľa sme spustili SupremeRAID na NVIDIA RTX A2000, malej GPU pre pracovnú stanicu.
Osem diskov D5-P5336 bolo pred odovzdaním spoločnosti Graid bezpečne vymazaných a postupne naplnených. Následne boli nakonfigurované ako jedno pole RAID 5. Výsledný virtuálny disk bol naformátovaný pomocou XFS a obsluhovaný systémom Tuxera. RAID 5 je pre takéto zdieľanie správna úroveň: zlyhanie disku udrží pole online, obnovenie systému prebieha bez toho, aby sa používateľské dáta preniesli offline, a strata kapacity je jeden disk z ôsmich. RAID 6 alebo RAID 10 by boli rozumnou voľbou pre produkčné nasadenie, ktoré uprednostňuje ochranu v okne obnovenia pred kapacitou, a SupremeRAID podporuje obe možnosti.
Sieť: Broadcom 400GbE a 800G jadro
Úložnú časť siete R770AP tvoria dva adaptéry Broadcom BCM57608 Thor 2, každý s jedným portom 400GbE sieťovej karty na rozhraní PCIe Gen5 x16. Broadcom umiestňuje BCM57608 ako sieťovú kartu 400G s najnižšou spotrebou energie v odvetví a jej sada funkcií ju robí vhodným doplnkom: RoCEv2 s vylepšenou kontrolou preťaženia DCQCN, adaptívnym smerovaním, bezpečným bootovaním so kremíkovým koreňom dôvery a inline šifrovaním kTLS. RoCEv2 v tomto dizajne prenáša NFS cez RDMA a kontrola preťaženia zabraňuje tomu, aby sa viacero klientov navzájom preťažovalo, keď všetci začnú naraz zaťažovať. Počas zostavovania ovládač bnxt_en hlásil, že optické moduly na portoch 400G dosahovali pri trvalom zaťažení prahovú hodnotu 70 °C. Tento problém sme vyriešili malým posunom profilu ventilátora na R770AP a sieťové karty potom bežali bez problémov.
Obe sieťové karty sú pripojené k Dell PowerSwitch Z9864F-ON , 800G jadrovému prepínaču z nášho laboratória s operačným systémom Enterprise SONiC. Z9864F-ON má 64 portov OSFP112 s rýchlosťou 800 GbE a ktorýkoľvek z nich rozdeľuje na 2x400 G, 4x200 G alebo 8x100 G. Jedna 800G optika rozdelená na 8x100 G pripája osem Sparkov, každý s jedným prepojením, k tomu istému prepínaču, ktorý ukončuje dve 400G úložné linky. Každá 400G sieťová karta je umiestnená na vlastnej VLAN a obsluhuje štyri Sparky, takže hostiteľské úložisko predstavuje dva ciele RDMA a záťaž je medzi ne rovnomerne rozdelená. V praxi ide o topológiu s plnou rýchlosťou: 8x100 G šírky pásma klienta na jednej strane, 2x400 G šírky pásma úložiska na druhej strane a prepínač s kapacitou 102.4 Tb/s v strede.
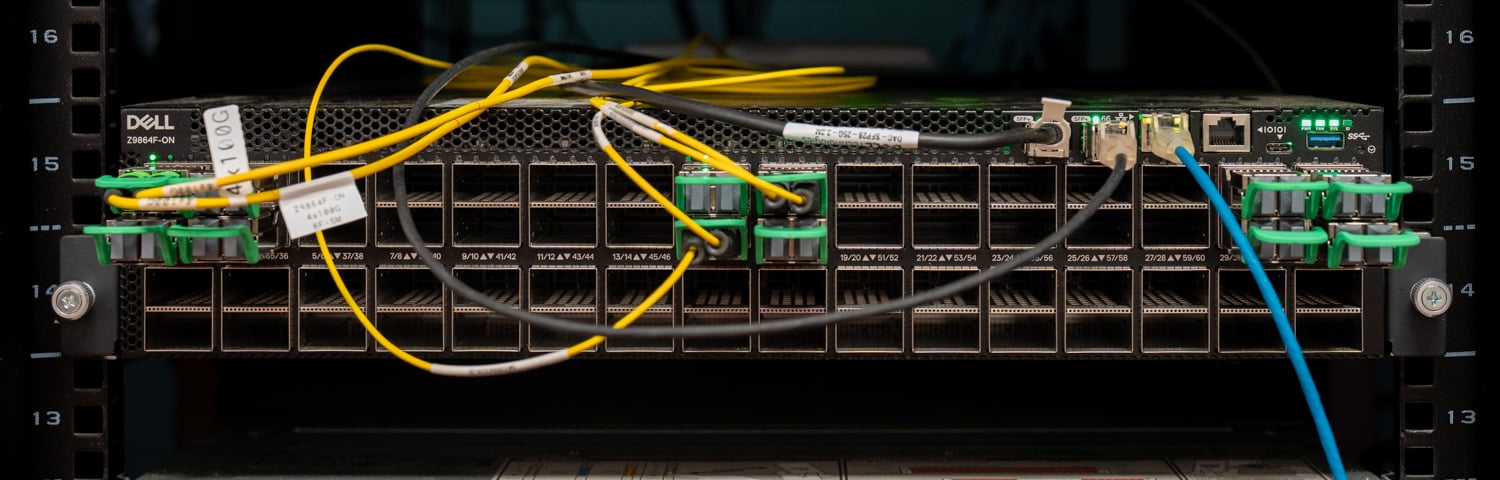
Overili sme štruktúru dát ešte predtým, ako sa jej dotkol akýkoľvek úložný softvér. Testy server-to-server medzi R770AP a druhým hostiteľom cez 400G linky prebiehali linkovou rýchlosťou v oboch smeroch a prevádzka RDMA zo Sparkov potvrdila, že 100G breakout porty fungovali plnou rýchlosťou. Keď inžinieri spoločnosti Tuxera spustili zdieľania NFS, iperf3 zo Sparkov do ich príslušných sieťových kariet vykazoval čistú rýchlosť 99 Gb/s so štyrmi paralelnými streammi a nulovými opakovanými prenosmi.
Prečo NFS a prečo Tuxera
Keďže Graid predstavuje rýchle blokové zariadenie, úložný hostiteľ by mohol slúžiť serverom Sparks buď ako blokové ciele NVMe-oF, alebo ako zdieľané súbory. Cestu k bloku sme testovali v recenzii GP Spark a pre jedného klienta funguje dobre. Pre laboratórium mnohých Sparkov sme chceli niečo iné. Blokové zväzky sú jeden k jednému; každý používateľ by potreboval LUN a v momente, keď dvaja používatelia chcú rovnakú množinu údajov, kopírujú ju, čo je problém, ktorý má celý tento návrh odstrániť. NFS je stredom Vennovho diagramu: jeden menný priestor obsahuje zdieľané množiny údajov, hostované modely a priečinky pre jednotlivých používateľov. Každé pripojenie Spark používa klienta NFS, ktorý je už v Ubuntu, a nástroje Kubernetes a Slurm, ktoré by univerzita nainštalovala na laboratórium Spark, všetky hovoria o NFS.
Fusion NFS je NFS polovica Tuxera Fusion, multiprotokolového súborového servera, ktorý pokrýva SMB a NFS na jednom používateľskom režime s viacvláknovým jadrom; na Fusion SMB sme sa prvýkrát pozreli v roku 2024 v projekte mediálneho pracovného postupu spoločností Solidigm a Tuxera. Tuxera tvrdí, že dosahuje rýchlosť až 22.7 GB/s cez jedno 200GbE pripojenie s RDMA, nad jadrom NFSD a Ganesha vo vlastnom testovaní spoločnosti, a produkt podporuje NFS 4.1, aktívne škálovateľné klastrovanie, transparentné prepnutie pri zlyhaní a integráciu Active Directory, Kerberos a LDAP. Táto posledná sada je governance hook: ten istý adresár, ktorý riadi, kto sa môže prihlásiť do Sparku, riadi aj to, čo môžu vidieť v zdieľanom priečinku. Jedna výhrada platí pre každé číslo Tuxera v tomto článku: zostavenie, ktoré sme spustili, je súkromná ukážka Fusion NFS, o ktorej Tuxera tvrdí, že nebola úplne optimalizovaná pre výkon a softvér ešte nie je dostupný na komerčný predaj. Všeobecná dostupnosť je plánovaná na november, po SC'26.
Tuxera nainštaloval Fusion na R770AP, naformátoval zväzok Graid pomocou XFS a nakonfiguroval server s NFS na štandardnom porte a RPC-RDMA na porte 20049, pričom vynechal listenery SMB, pretože tento projekt je iba NFS. Počiatočná konfigurácia vlákien bola štyri protokolové vlákna, každé s ôsmimi vláknami pre transport, odosielanie a prijímanie, dáta VFS a metadáta VFS, čo Tuxera opisuje ako východiskový bod pre ladenie. Adresárové služby boli zámerne vynechané z laboratórnej zostavy; univerzitné nasadenie by naň navrstvilo vlastné identifikačné služby. Na strane Spark je pripojenie zdieľania jedným príkazom:
sudo mount -t nfs -o proto=rdma,port=20049 :/mnt/shares/smbnfs1/ /localnfs
Ten jeden riadok predstavuje celú integráciu klienta bez ovládača, konfigurácie iniciátora a softvéru od dodávateľa na Sparku. Používateľ, ktorý sa zajtra prihlási do iného Sparka, spustí ten istý riadok a uvidí tie isté súbory.
Dôkaz konfigurácie: Osem iskier na jednej sade údajov
Pred akoukoľvek modelovou prácou sme spustili kontrolu správnosti každého Sparku jednotlivo: 1 milión sekvenčných čítaní vlákien so 16 úlohami a hĺbkou frontu 16 oproti jeho vlastnému priečinku v poli. Osem jednotiek vrátilo medzi 10.0 a 11.2 GiB/s, čím sa na každej z nich nasýtilo 100GbE prepojenie. Potom sme spustili testovanie, aby sme dokázali, že všetkých osem dokáže uniesť svoj podiel záťaže. Každé spustenie udržiava fixných 16 vlákien s hĺbkou frontu 16 celkovo a rozdeľuje ich na jeden, dva, štyri a osem Sparkov, cez 1 milión sekvenčných, 64K náhodných, 16K sekvenčných a 4K náhodných pracovných zaťažení, s čítaním a zápisom, priamym I/O, 60 sekúnd na test. Každý Spark zapisuje do svojho vlastného priečinka v poli, štyri na sieťovú kartu úložiska, a nikde v zásobníku nie je žiadna QoS. Pri súčasnom načítaní všetkých ôsmich úložiská sa sekvenčné čítania 1 milióna úložiska na jednotku pohybovali od 3.09 do 3.13 GiB/s, náhodné čítania 64 000 úložiska od 6 648 do 6 779 IOPS a náhodné zápisy 4 000 úložiska od 2 136 do 2 155 IOPS, a to naprieč piatimi výrobcami originálnych zariadení (OEM) na dvoch VLAN bez vynucovania spravodlivosti. Každý Spark sa dostal k poľu, každý Spark dostal rovnomerný podiel a konfigurácia bola pripravená na dôležitú pracovnú záťaž.
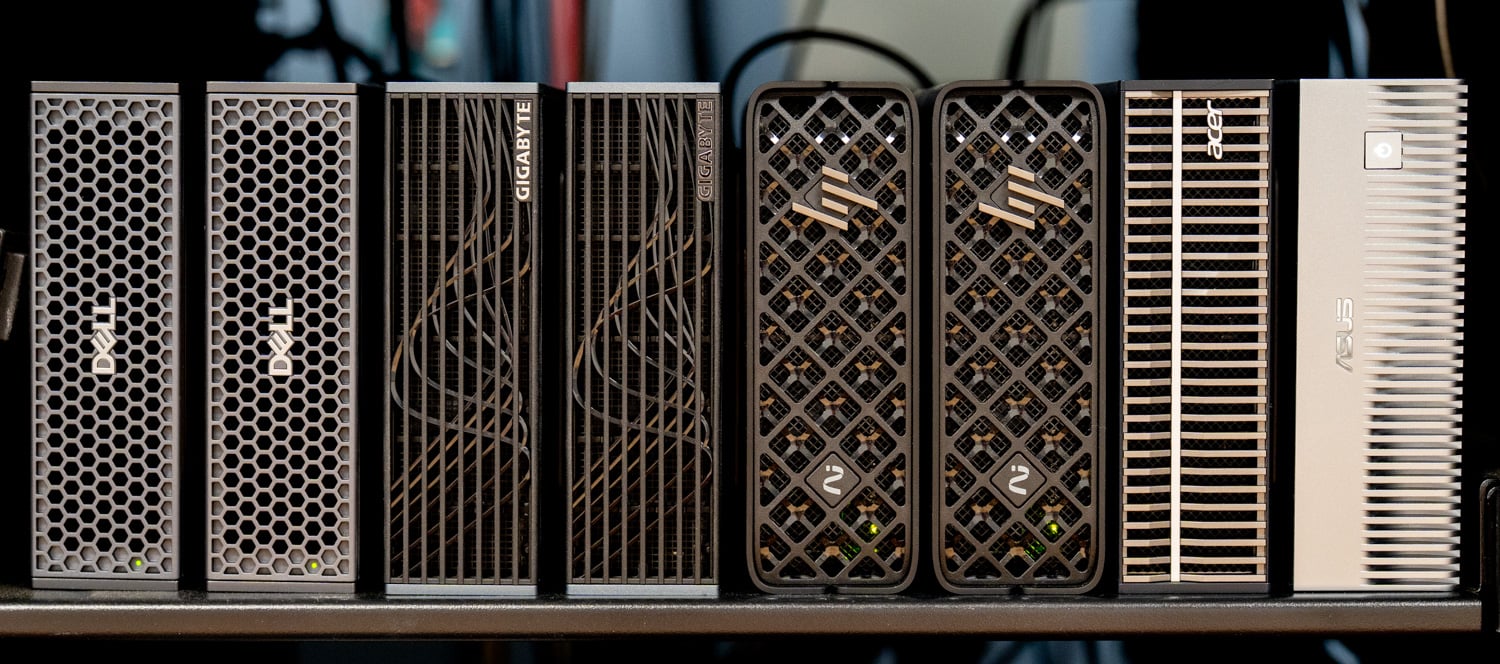
| Spark (osem klientov, 2 vlákna x QD16 každé) | Úložná sieťová karta | 1M sekvenčné čítanie | 64K náhodných IOPS pri čítaní | 4K náhodných IOPS pri čítaní | 4K náhodných IOPS zápisu |
|---|---|---|---|---|---|
| Dell Pro Max s GB10 (1) | 1 | 3,176 MiB/s | 6,648 | 10,000 | 2,150 |
| GIGABYTE AI TOP ATOM (1) | 1 | 3,195 MiB/s | 6,779 | 10,300 | 2,142 |
| HP ZGX Nano G1n (1) | 1 | 3,201 MiB/s | 6,696 | 10,100 | 2,136 |
| Acer Veriton GN100 | 1 | 3,194 MiB/s | 6,670 | 10,100 | 2,149 |
| Dell Pro Max s GB10 (2) | 2 | 3,184 MiB/s | 6,694 | 10,200 | 2,155 |
| GIGABYTE AI TOP ATOM (2) | 2 | 3,187 MiB/s | 6,667 | 10,100 | 2,141 |
| HP ZGX Nano G1n (2) | 2 | 3,189 MiB/s | 6,678 | 10,100 | 2,151 |
| ASUS Ascent GX10 | 2 | 3,163 MiB/s | 6,734 | 10,300 | 2,145 |
Dimenzovanie hostiteľa: Dve sieťové karty a dostatok priestoru
Rovnaký prehľad odpovedá na otázku, ktorú si musí laboratórium alebo podnik položiť pred kúpou: kde je maximálna povolená hodnota a ktorá časť hostiteľa ju nastavuje? Štyri panely nižšie zobrazujú priepustnosť čítania vo všetkých štyroch pracovných zaťaženiach, pričom fixné zaťaženie sa škáluje od jedného Sparku do ôsmich; strana zápisu je popísaná v texte a tabuľke nižšie.
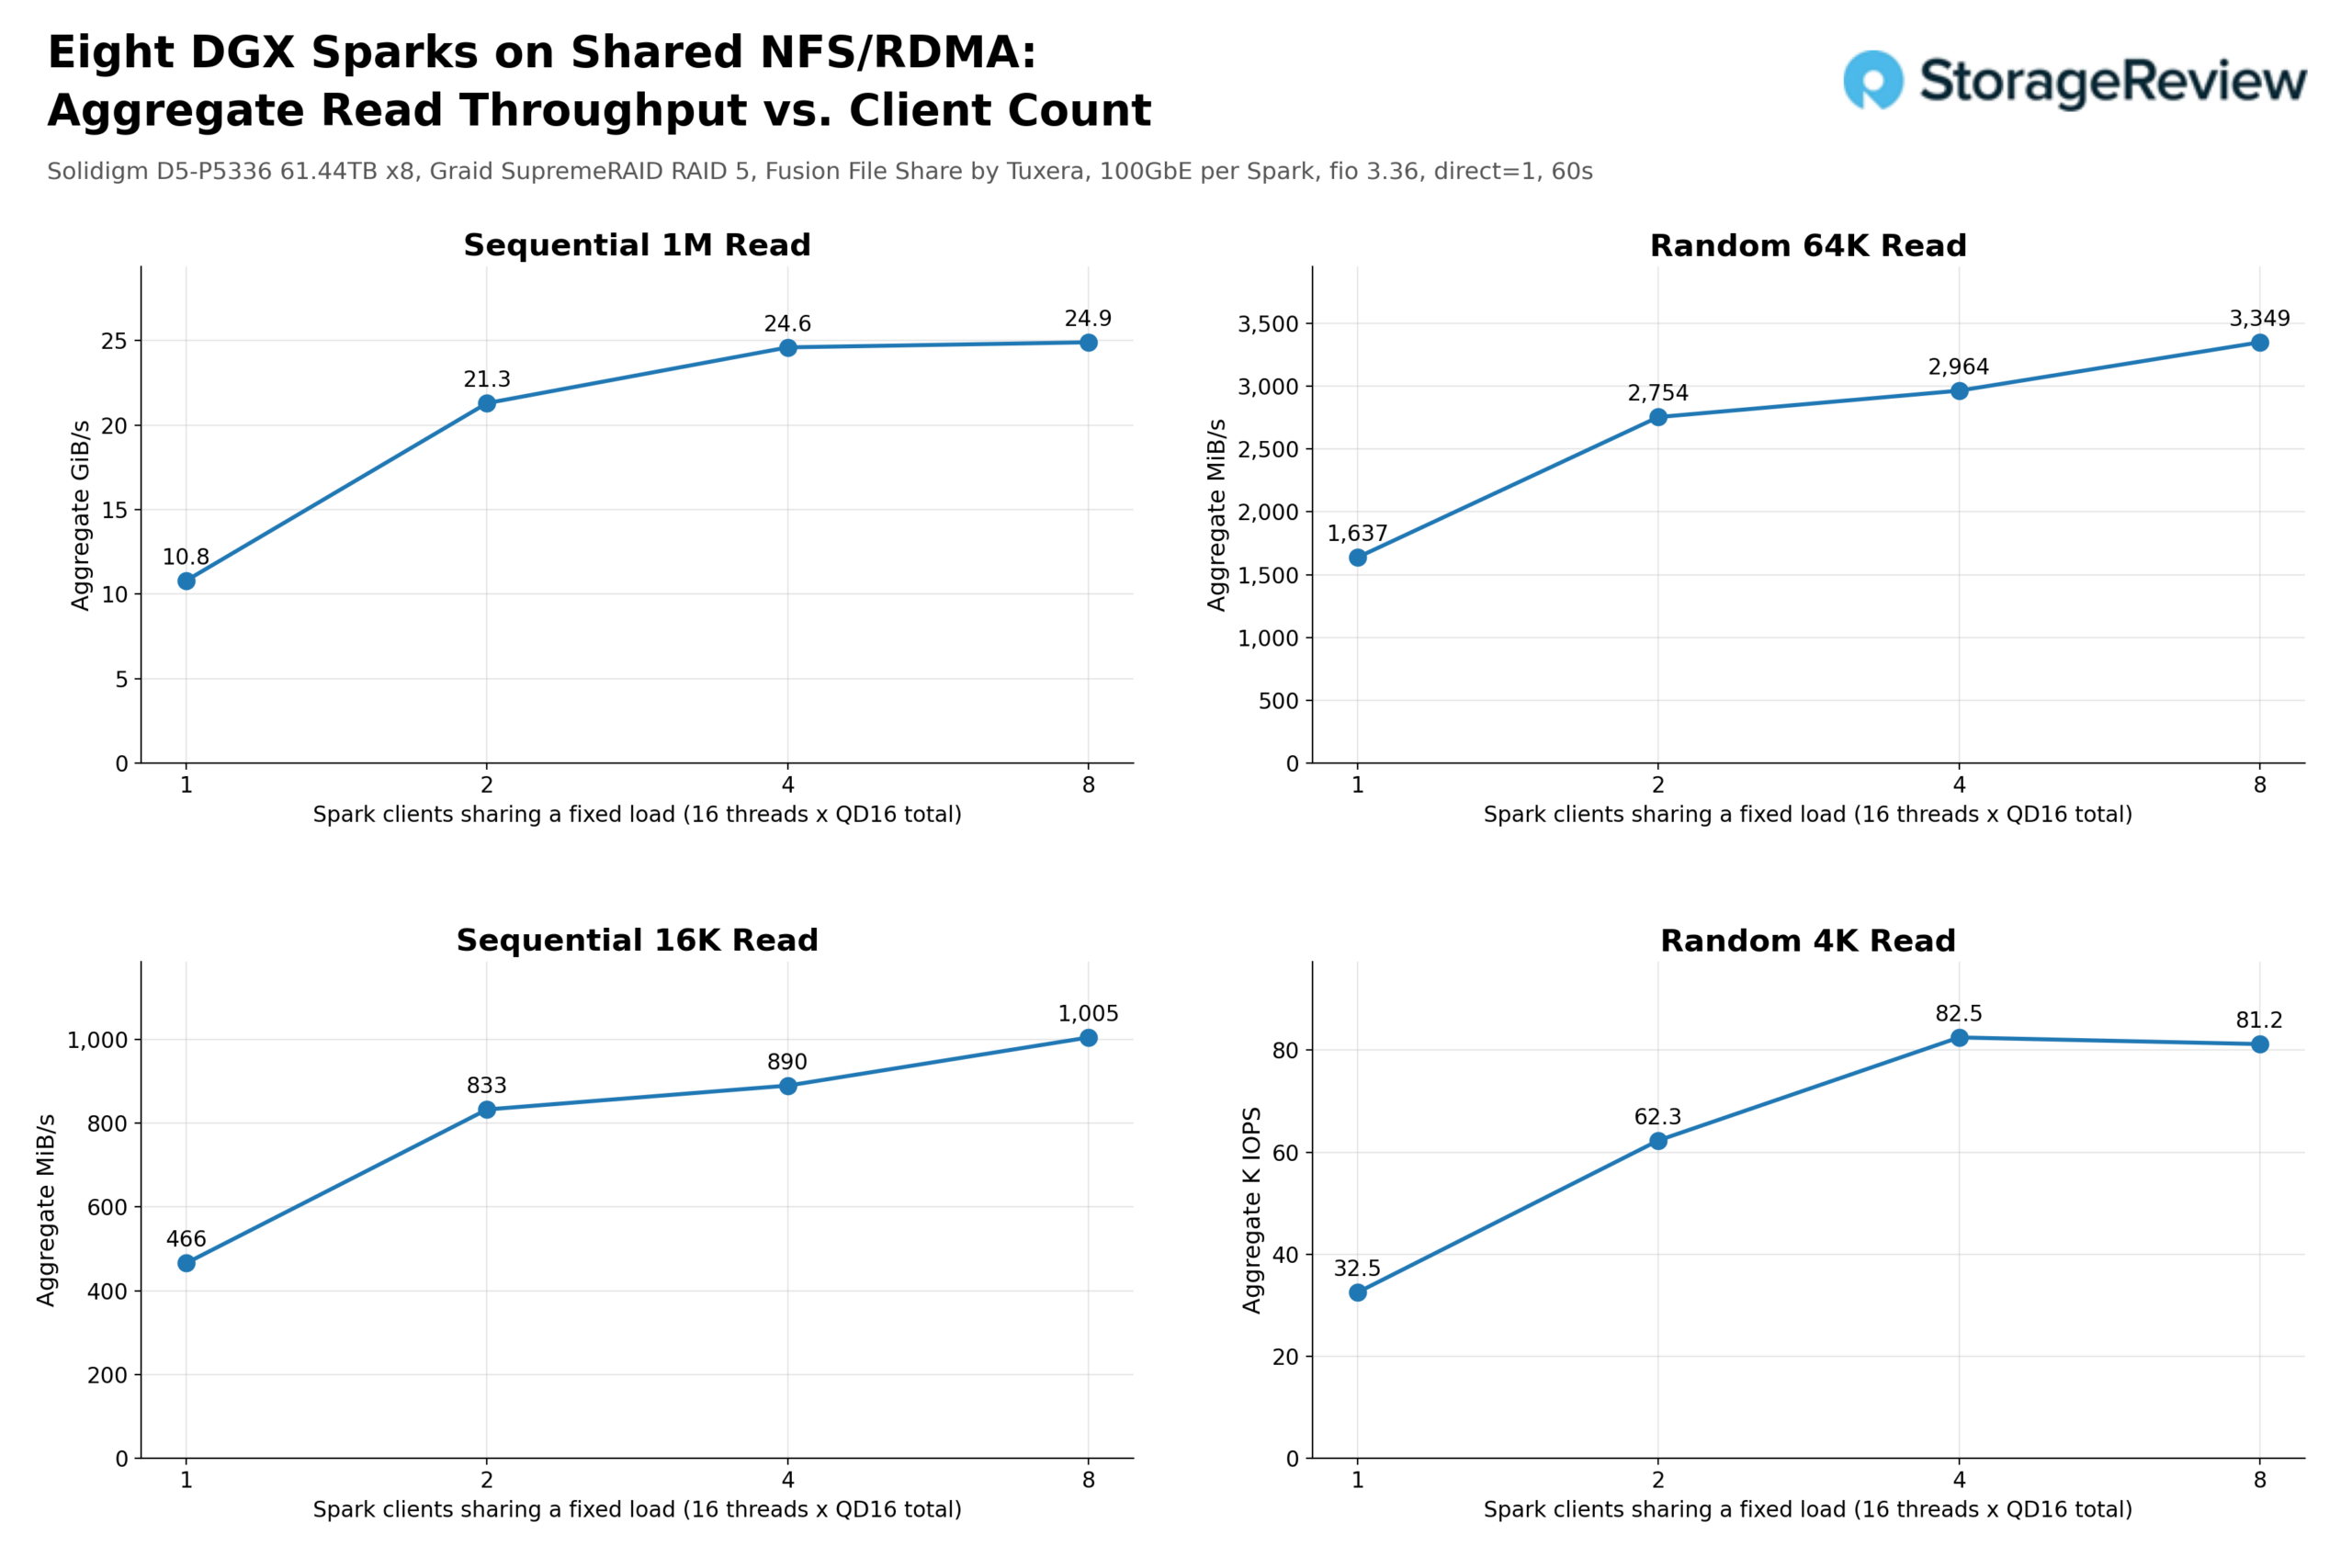
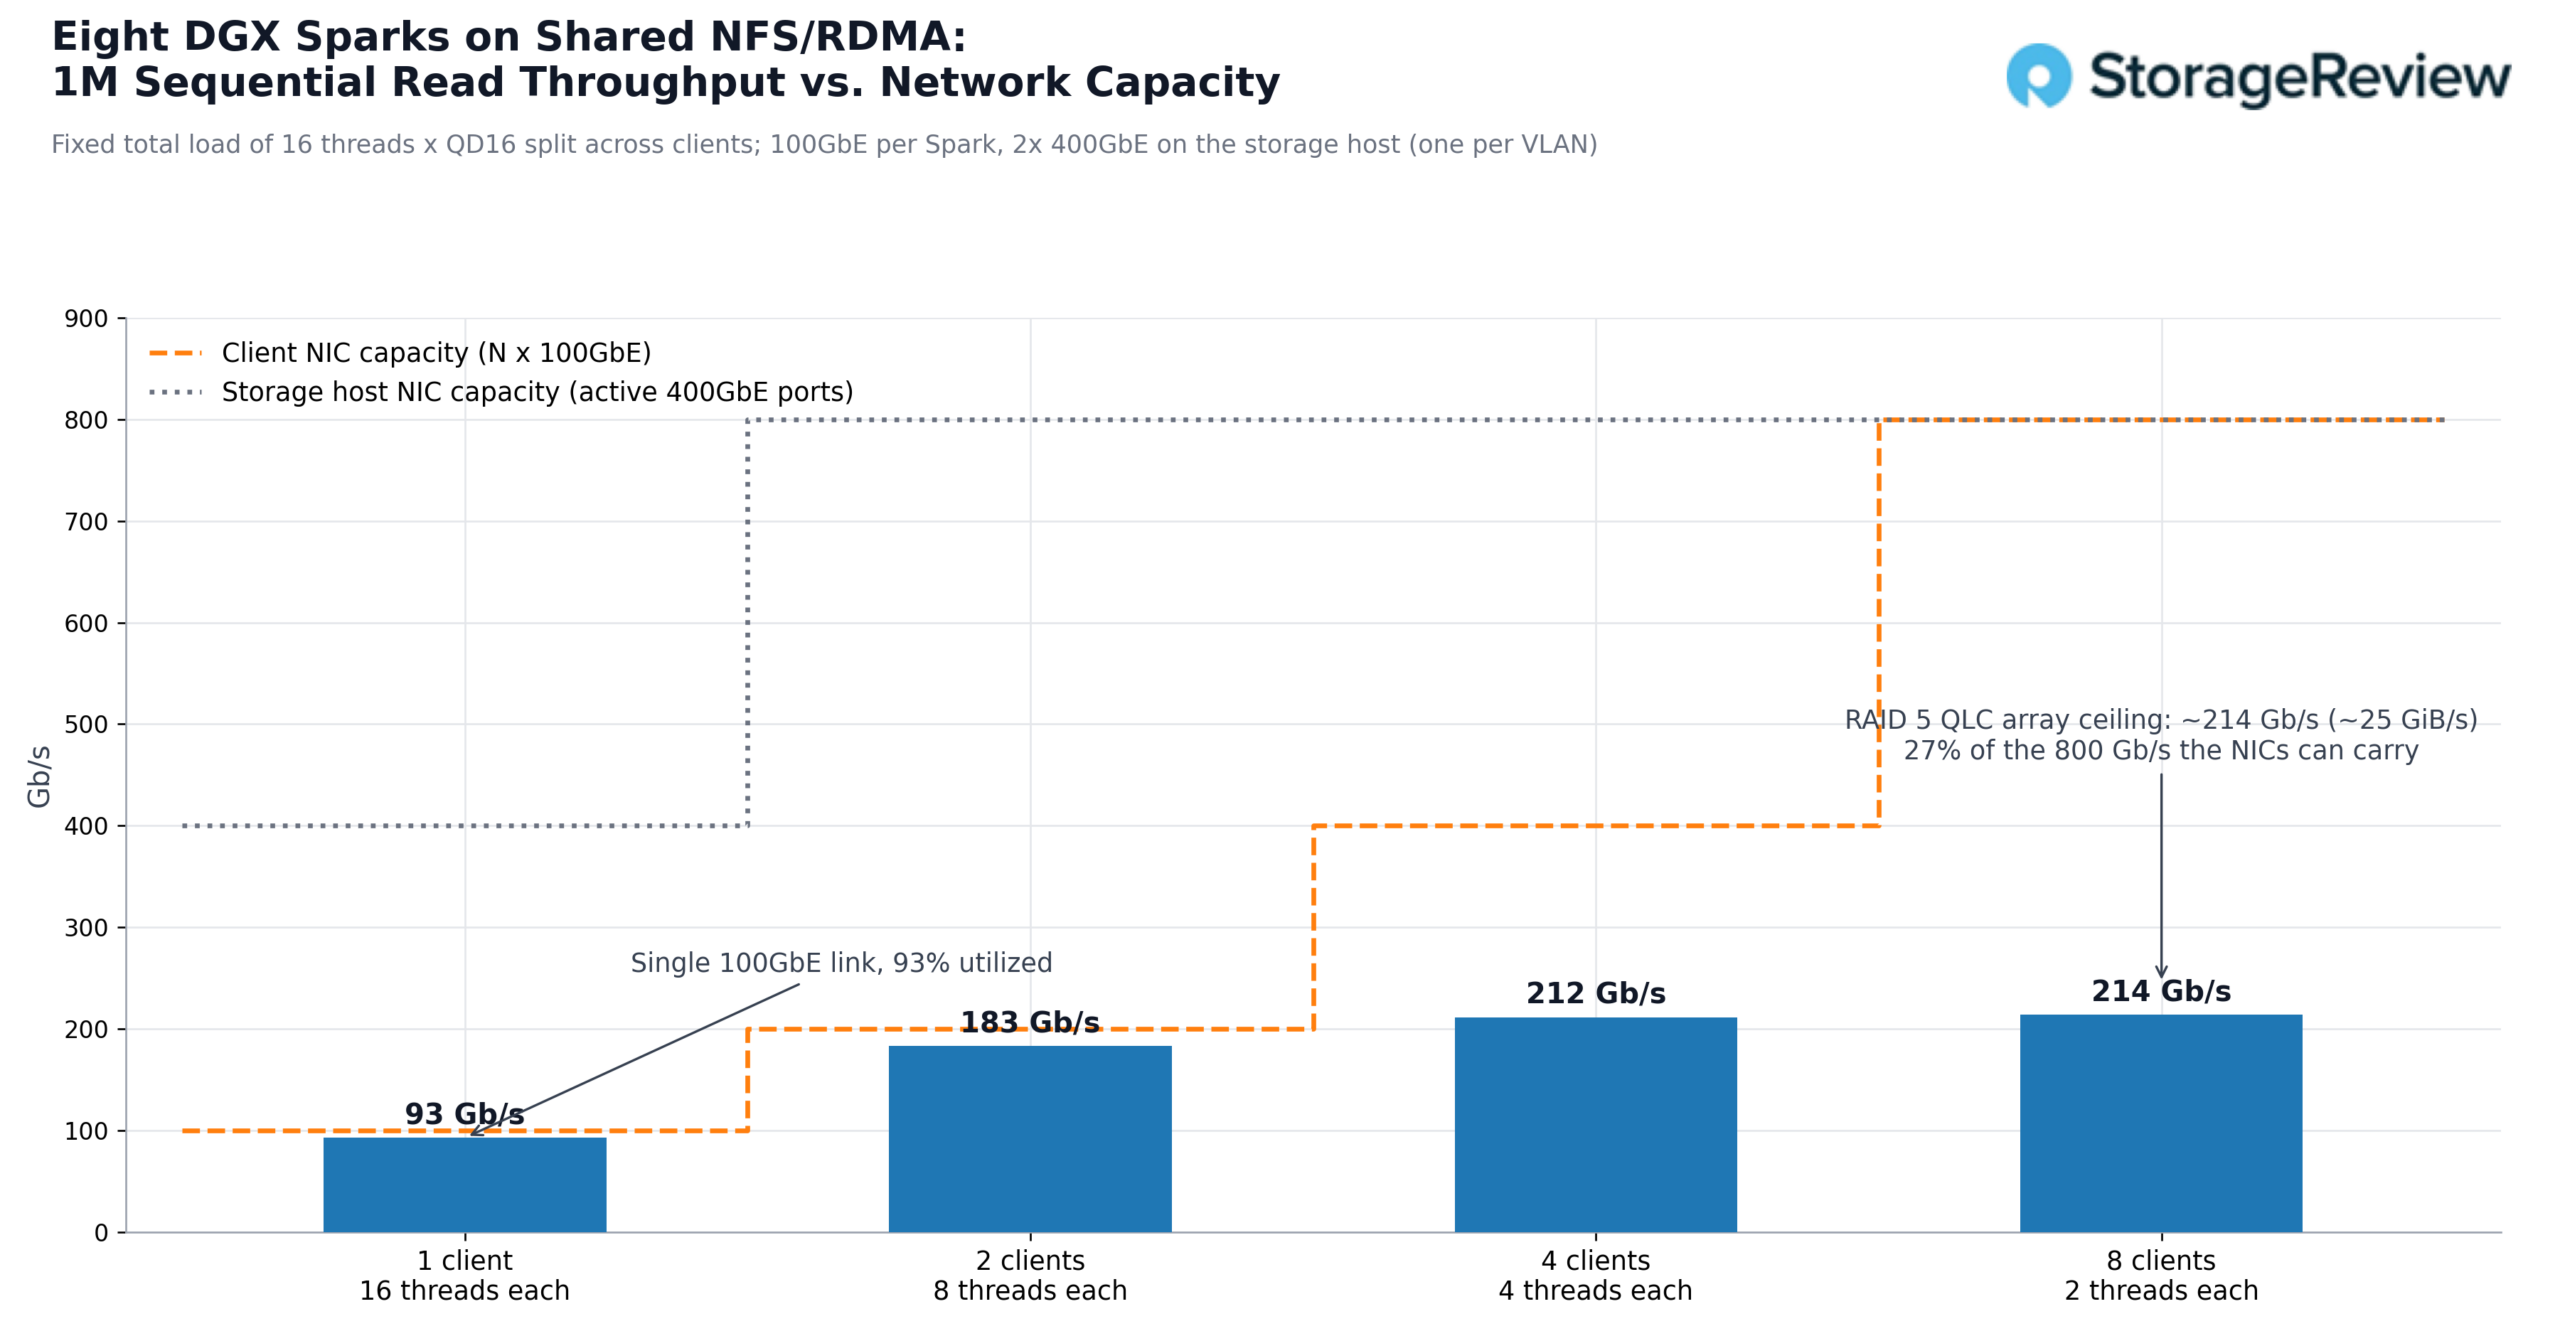
Celkové sekvenčné čítanie 1 milióna dát vzrástlo z 10.8 GiB/s na jednom Sparku na 21.3 GiB/s na dvoch, 24.6 GiB/s na štyroch a 24.9 GiB/s na ôsmich. Z hľadiska siete je to 93 Gb/s, 183 Gb/s, 212 Gb/s a 214 Gb/s v porovnaní s 800 Gb/s, ktoré dokážu preniesť dve 400GbE sieťové karty Broadcom, takže pri plnom zaťažení ôsmimi klientmi pole využívalo 27 % sieťovej kapacity hostiteľa. Plató blízko 25 GiB/s patrí poľu RAID 5 QLC s ôsmimi diskami; sieťové karty, prepínač a vlastné 100GbE linky Sparku sa nikdy nestali limitom.
Dve sieťové karty na strane servera už pokrývajú osem Sparkov pri rýchlosti linky a pokryli by aj ostatných osem pozícií v R770AP: zdvojnásobenie počtu diskov, či už ako druhé pole alebo širšia sada RAID, poskytuje väčšiu šírku pásma čítania za tými istými dvoma portami a zároveň zostáva priestor nazvyš. To isté platí pre I/O. Náhodné čítania pri 4K operáciách sa znížili z 32.5K IOPS na jednom klientovi na približne 81K IOPS na štyroch klientoch a ďalej, pričom latencia na I/O klesla zo 7.9 ms na 3.1 ms, keďže front každého klienta sa zmenšil, a náhodné čítania pri 64K operáciách sa znížili z 1 637 na 3 349 MiB/s, pričom sieť v oboch prípadoch výrazne prekročila svoj limit.
Druhým dôležitým porovnaním je porovnanie s úložiskom, ktoré Spark už má. V našich individuálnych recenziách GB10 dosiahla GDSIO 1M čítanie z interného M.2 maximálnu rýchlosť blízko 11.2 GiB/s na Acer Veriton GN100 a GIGABYTE AI TOP ATOM. Dell Pro Max s GB10 a HP ZGX Nano G1n dosiahol približne 5.5 GiB/s, zatiaľ čo ASUS Ascent GX10 sa priblížil k 5 GiB/s. Pre porovnanie, externý NVMe-oF box od Luisuantech GP Spark poskytol 9.5 GB/s cez rovnaký 100GbE port. Jediné čítanie zo zdieľaného QLC poľa s rýchlosťou 10.8 GiB/s sa vyrovná najrýchlejším interným diskom v tejto skupine a zhruba zdvojnásobí najpomalšie čítanie cez jeden kábel z dát, ktoré dokáže čítať aj každý iný Spark. Nástroje sa líšia: GDSIO na interných diskoch a fio cez NFS, takže ide o porovnanie rozsahu.
Úplný prehľad je uvedený nižšie so súhrnnými údajmi pre všetky štyri pracovné zaťaženia pri každom počte klientov. Každý riadok čítania stúpa s počtom klientov, až kým pole nevyčerpá kapacitu, a každý riadok zápisu zostáva nezmenený od jedného Sparku po osem, pretože paritná cesta RAID 5 udržiava pole na pevnom strope zápisu bez ohľadu na to, koľko klientov ho zdieľa. Pre zdieľanú zložku vytvorenú tak, aby ju čítalo viacero ľudí a zapisovalo sa raz pri príjme, je to profil, pre ktorý je dizajn vytvorený.
| Agregát (celkom 16 vlákien) | 1 Spark | 2 iskier | 4 iskier | 8 iskier |
|---|---|---|---|---|
| 1M sekvenčné čítanie | 10.8 GiB/s | 21.3 GiB/s | 24.6 GiB/s | 24.9 GiB/s |
| 1M sekvenčný zápis | 2.4 GiB/s | 2.4 GiB/s | 2.4 GiB/s | 2.4 GiB/s |
| Náhodné čítanie 64K | 1,637 MiB/s | 2,754 MiB/s | 2,964 MiB/s | 3,349 MiB/s |
| 64K náhodný zápis | 722 MiB/s | 719 MiB/s | 723 MiB/s | 703 MiB/s |
| 16K sekvenčné čítanie | 466 MiB/s | 833 MiB/s | 890 MiB/s | 1,005 MiB/s |
| 16K sekvenčný zápis | 57 MiB/s | 60 MiB/s | 62 MiB/s | 28 MiB/s |
| Náhodné čítanie 4K | 32.5K IOPS | 62.3K IOPS | 82.5K IOPS | 81.2K IOPS |
| 4K náhodný zápis | 17.8K IOPS | 17.7K IOPS | 17.5K IOPS | 17.2K IOPS |
Modely hostingu na zdieľanom úložisku
Test fio dokazuje, že pole a sieť sú viac než schopné. Ďalším testom, ktorý je dôležitý pre prípad použitia, je, či sa model nachádzajúci sa na zdieľanom poli načíta rovnako dobre ako model nachádzajúci sa na vlastnom NVMe disku Spark, pretože to je pracovný postup, od ktorého závisí celý návrh: jedna kópia, hostovaná centrálne, načítaná kýmkoľvek. V NVFP4 sme vybrali Qwen3.5-122B-A10B, model so zmesou expertov a 122 miliardami parametrov, ktorý zaberá 78 GB na disku a zmestí sa do 128 GB unifikovanej pamäte jedného Sparku. Merali sme čas od spustenia inferenčného servera do hlásenia stavu servera spolu s priemernou šírkou pásma úložiska počas tohto okna v troch scenároch: jeden Spark načítavajúci zo svojho interného NVMe, rovnaký Spark načítavajúci cez NFS/RDMA zo zdieľaného poľa a všetkých osem Sparkov načítavajúcich tú istú kópiu z poľa súčasne.
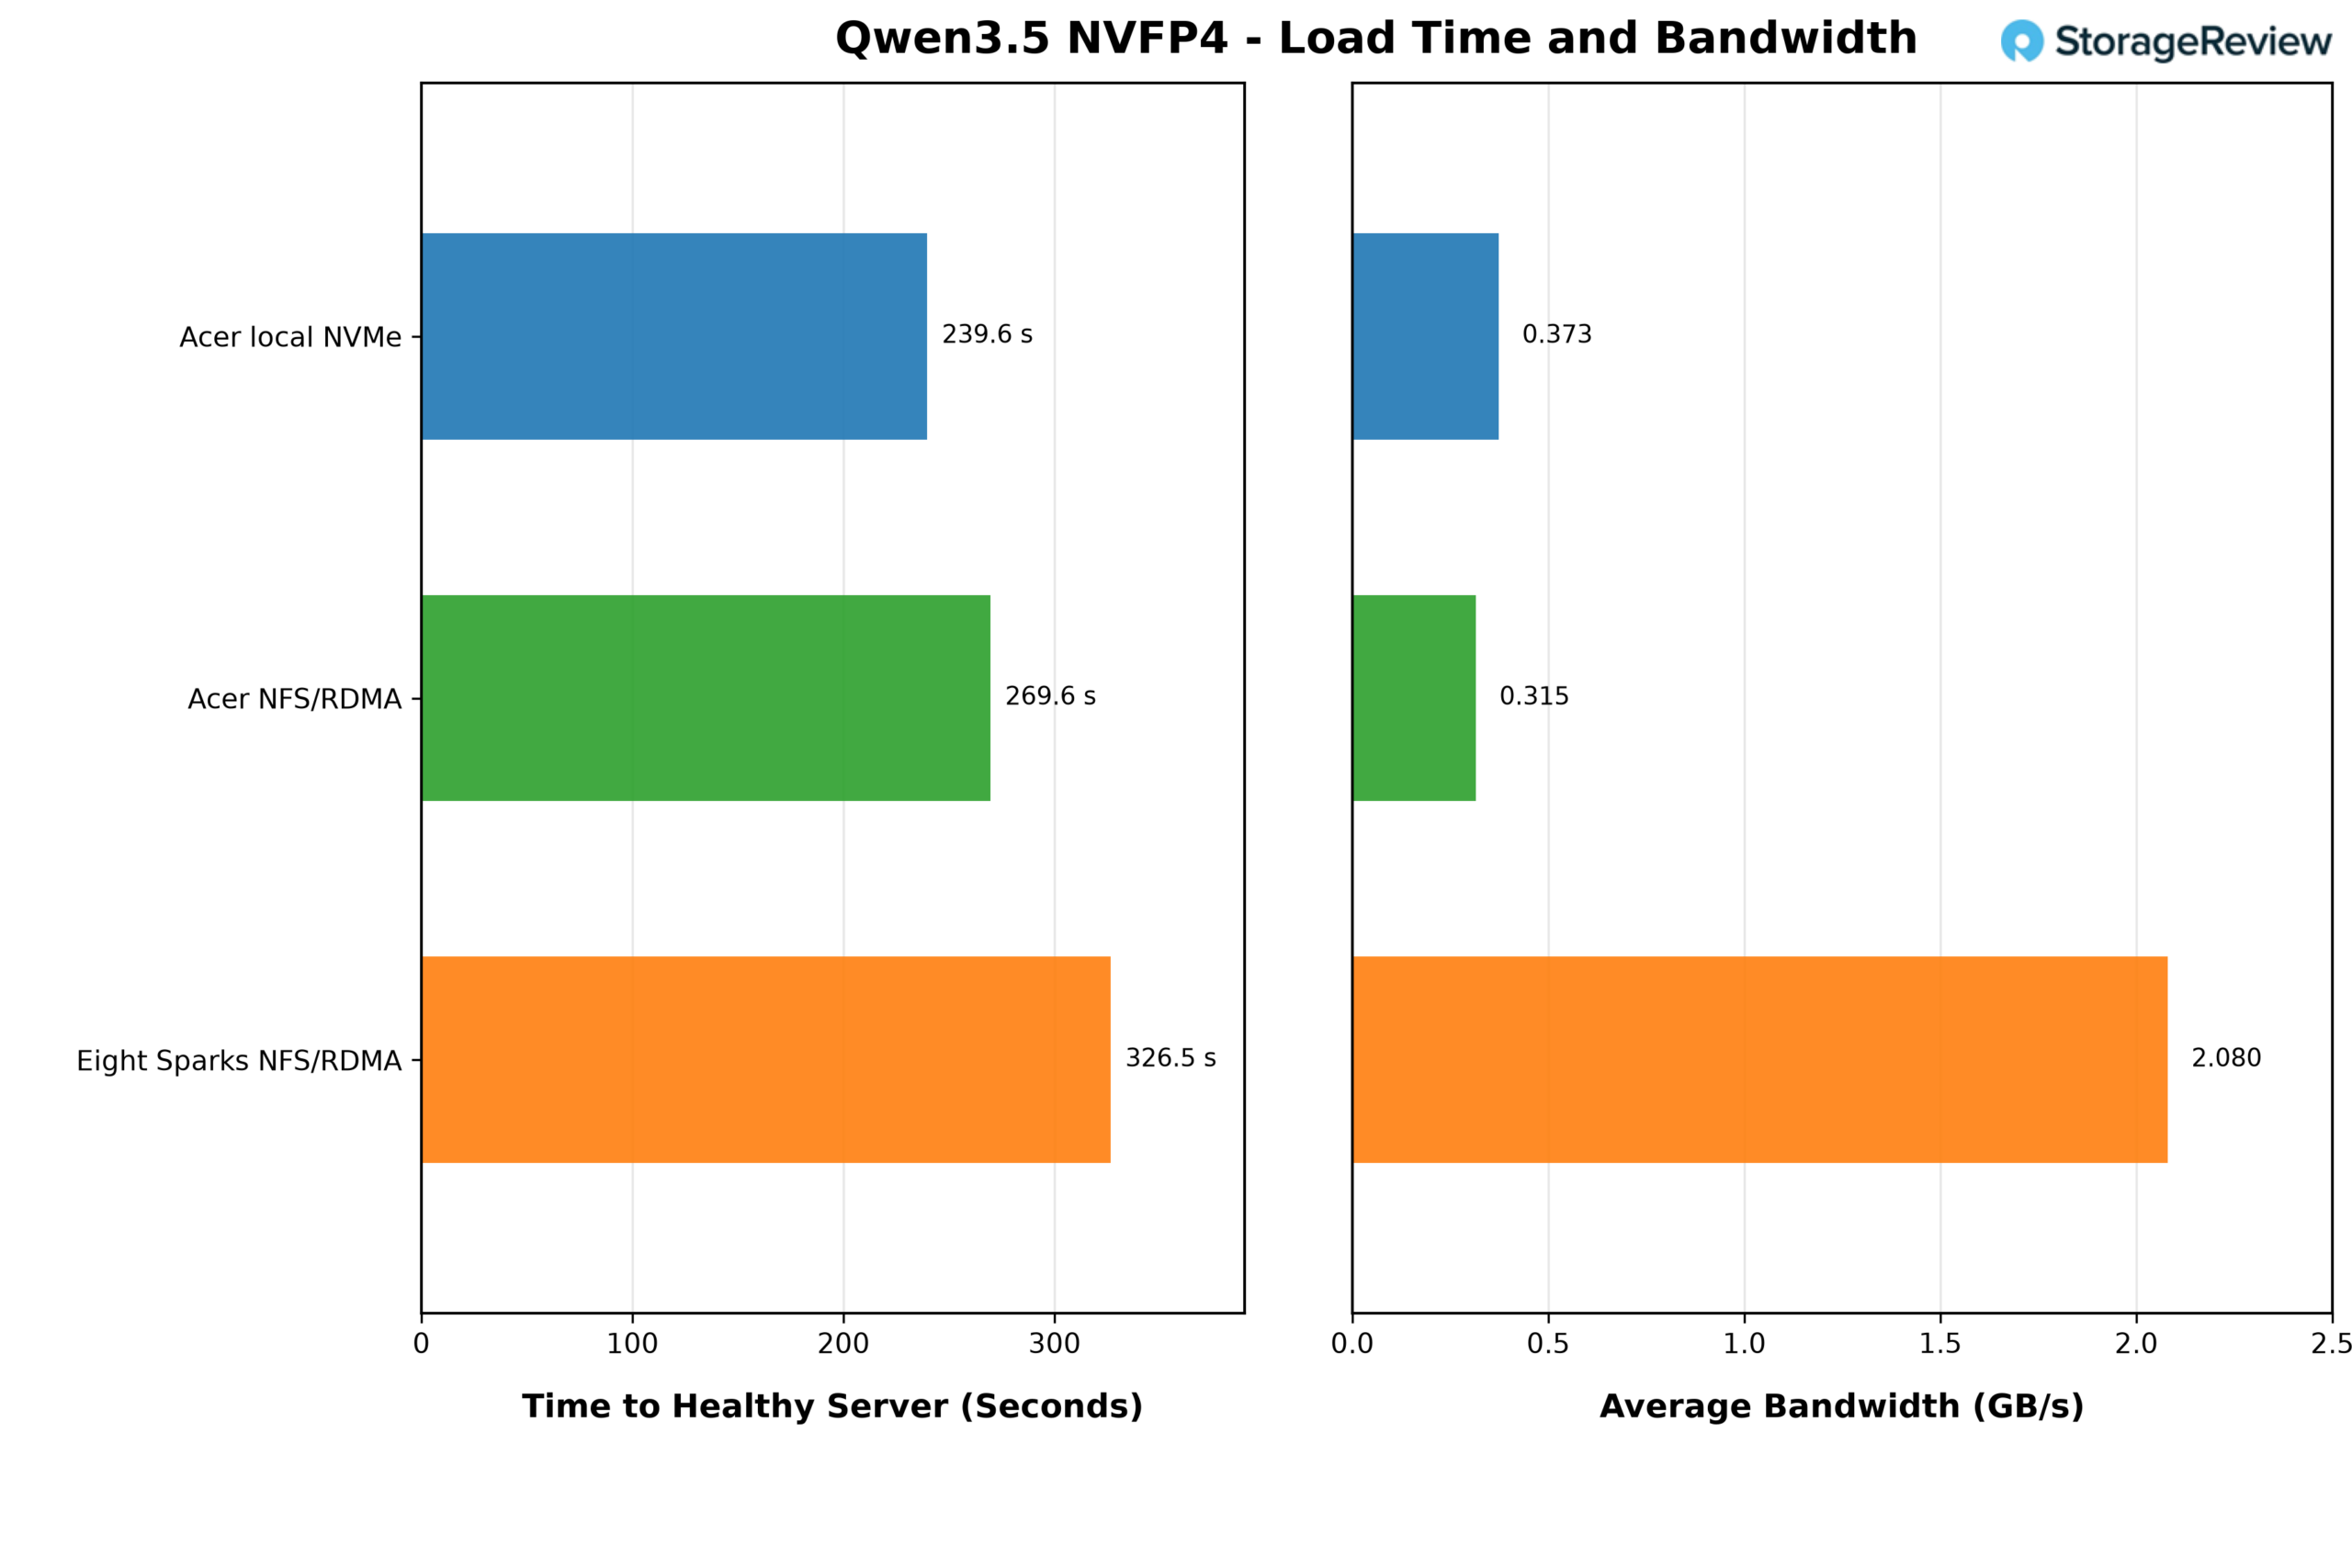
Z interného NVMe sa Acer Veriton GN100 dostal na server s funkčným rozhraniom za 239.6 sekundy s priemernou rýchlosťou 0.373 GB/s. Zo zdieľaného poľa cez NFS/RDMA trvalo rovnakému Sparku 269.6 sekundy s rýchlosťou 0.315 GB/s, čo je približne o 30 sekúnd alebo 13 % dlhšie. Priemery ukazujú, že pri 78 GB za štyri minúty nie je načítanie modelu na Sparku v žiadnom prípade viazané na úložisko. Tempo udáva vlastné spracovanie váh GB10 a úložisko trávi väčšinu času čakaním.
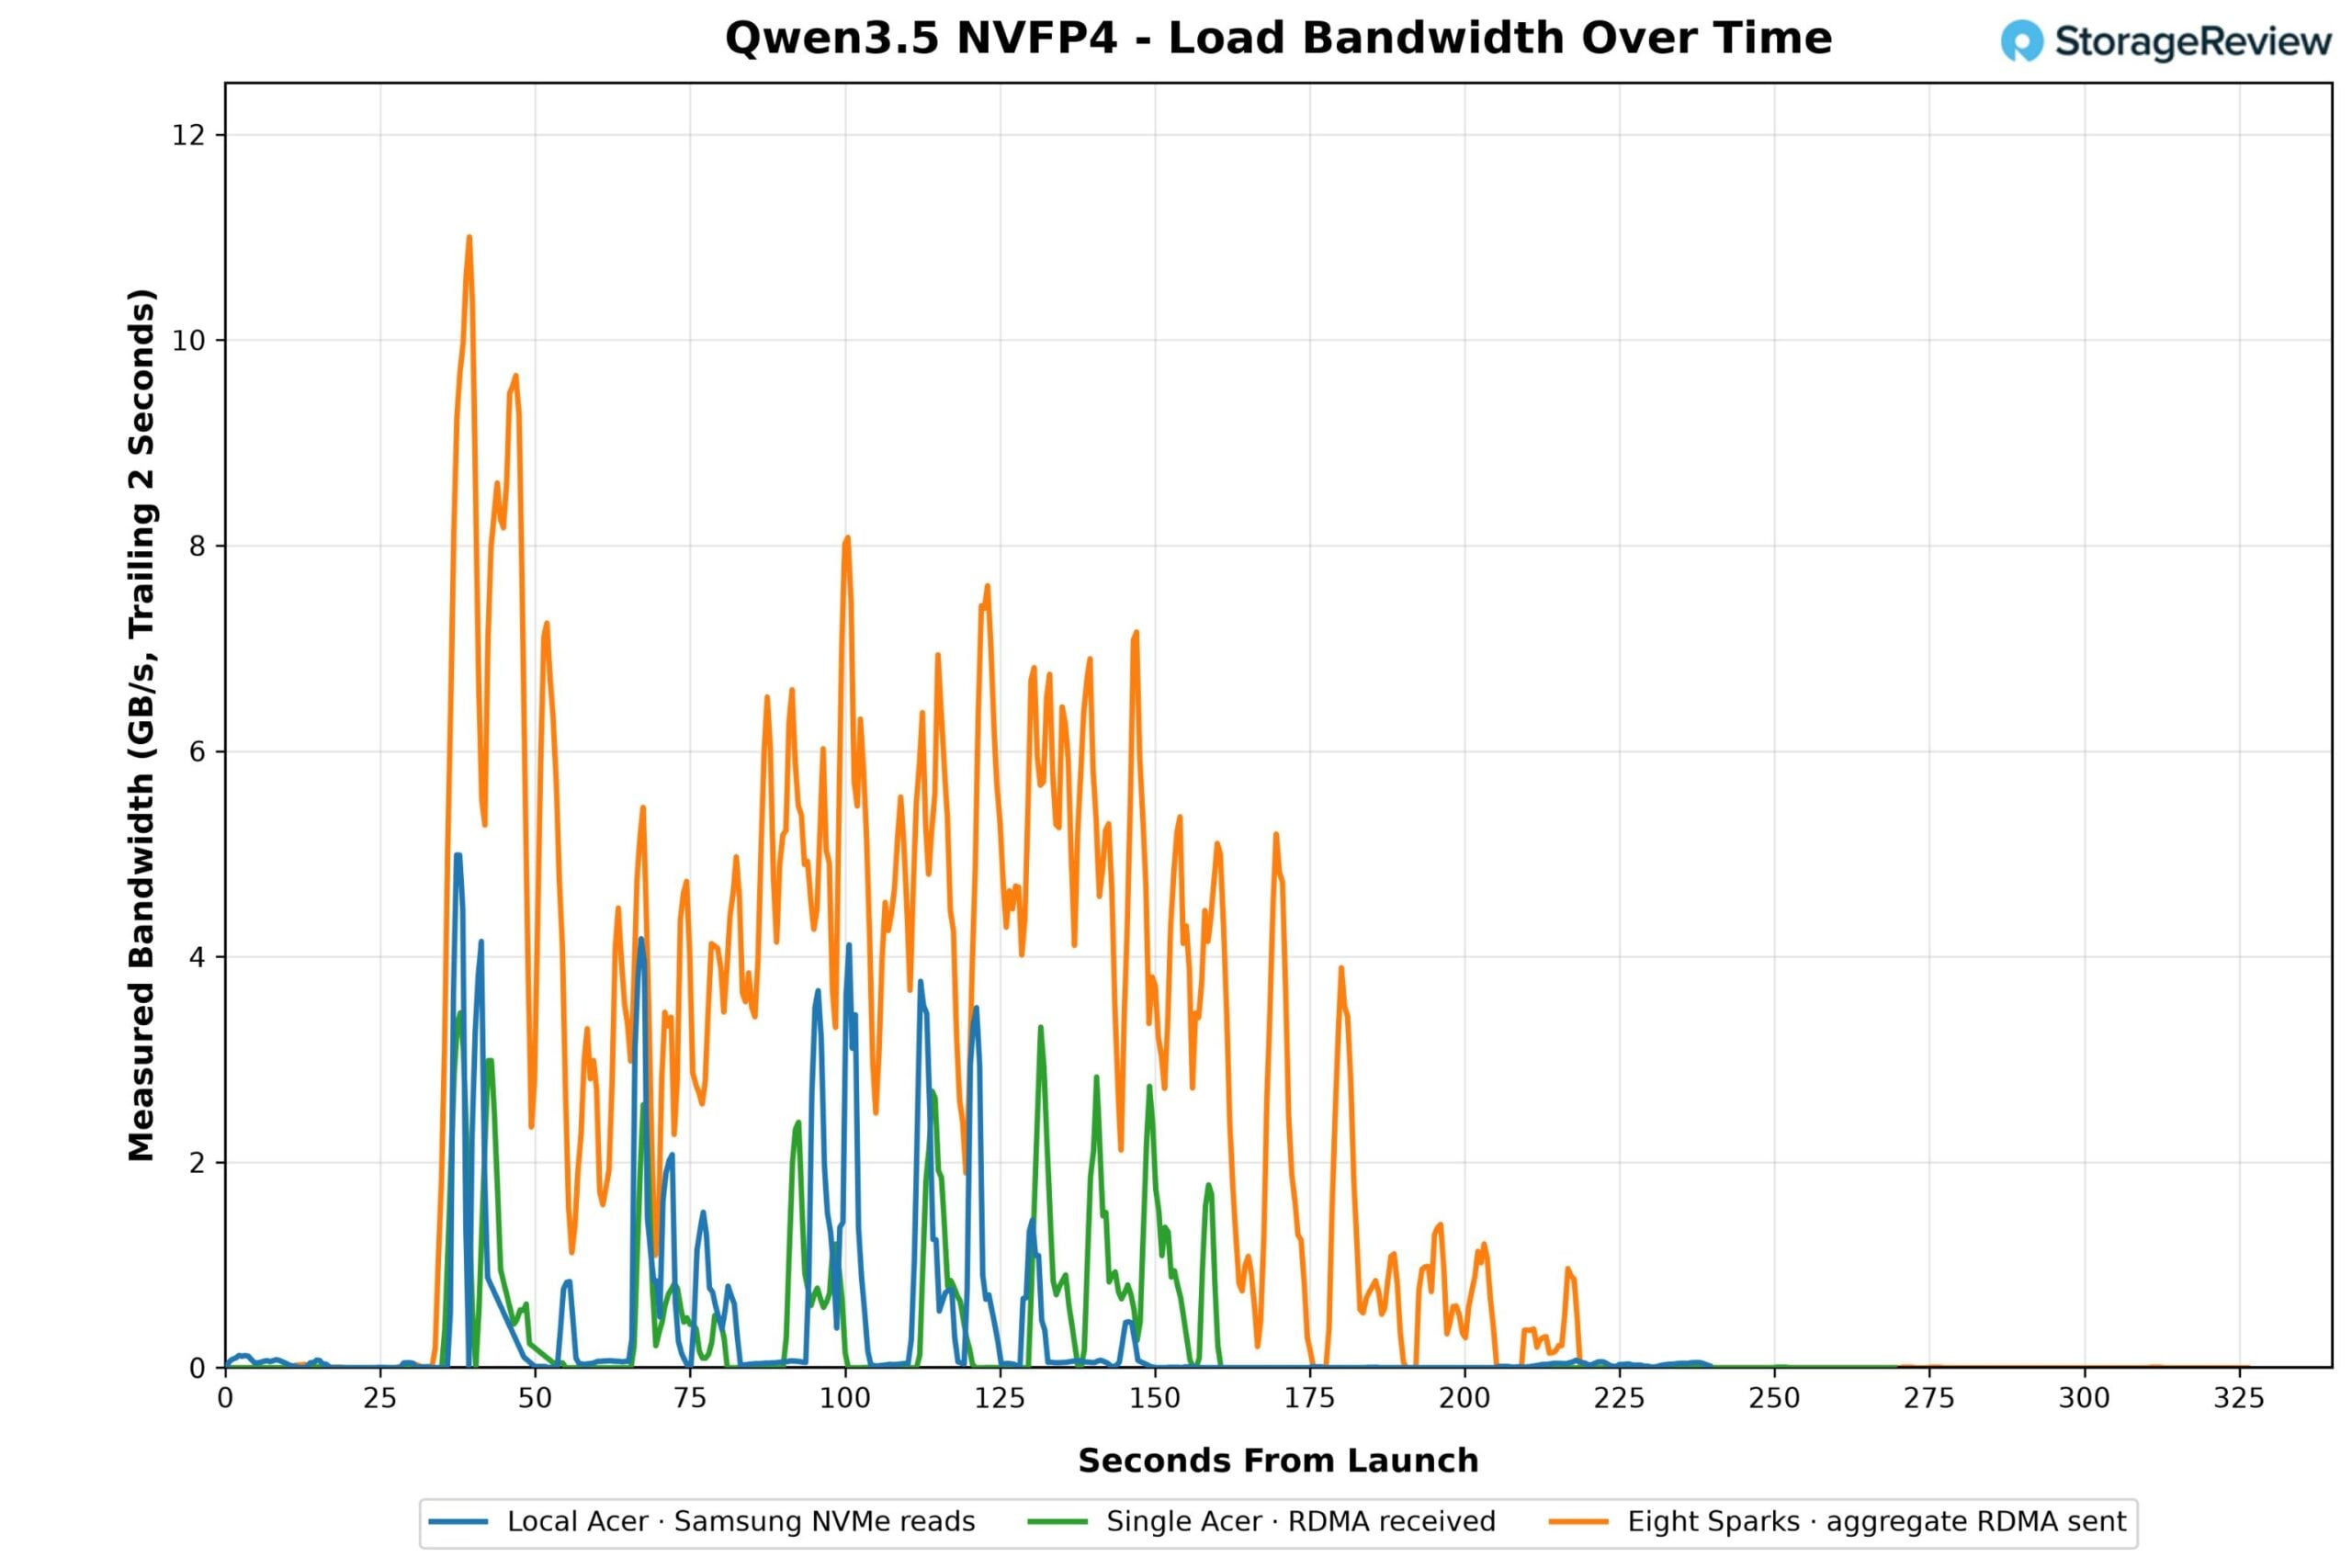
Trasa šírky pásma ukazuje tento vzorec: lokálne čítania NVMe prichádzajú v dávkach, ktoré dosahujú vrchol okolo 5 GB/s s dlhými medzerami medzi nimi; jeden NFS klient vykazuje rovnaký tvar dávky s mierne nižšími špičkami. Agregovaná čiara ôsmich Sparkov zobrazuje pole so súbežným dopytom. Keďže všetkých osem Sparkov naraz ťahalo rovnakých 78 GB, pole dosiahlo v prvej minúte celkový vrchol 11 GB/s, potom sa počas nasledujúcich dvoch minút ustálilo medzi približne 4 a 8 GB/s, zatiaľ čo Sparky pracovali so svojimi váhami, s priemerom 2.08 GB/s v celom okne. Oproti 25 GiB/s, ktoré ukázalo zaťaženie fio, pole dokáže poskytnúť, osem Sparkov, ktoré načítali model naraz, spotrebovalo zlomok toho, čo je k dispozícii.
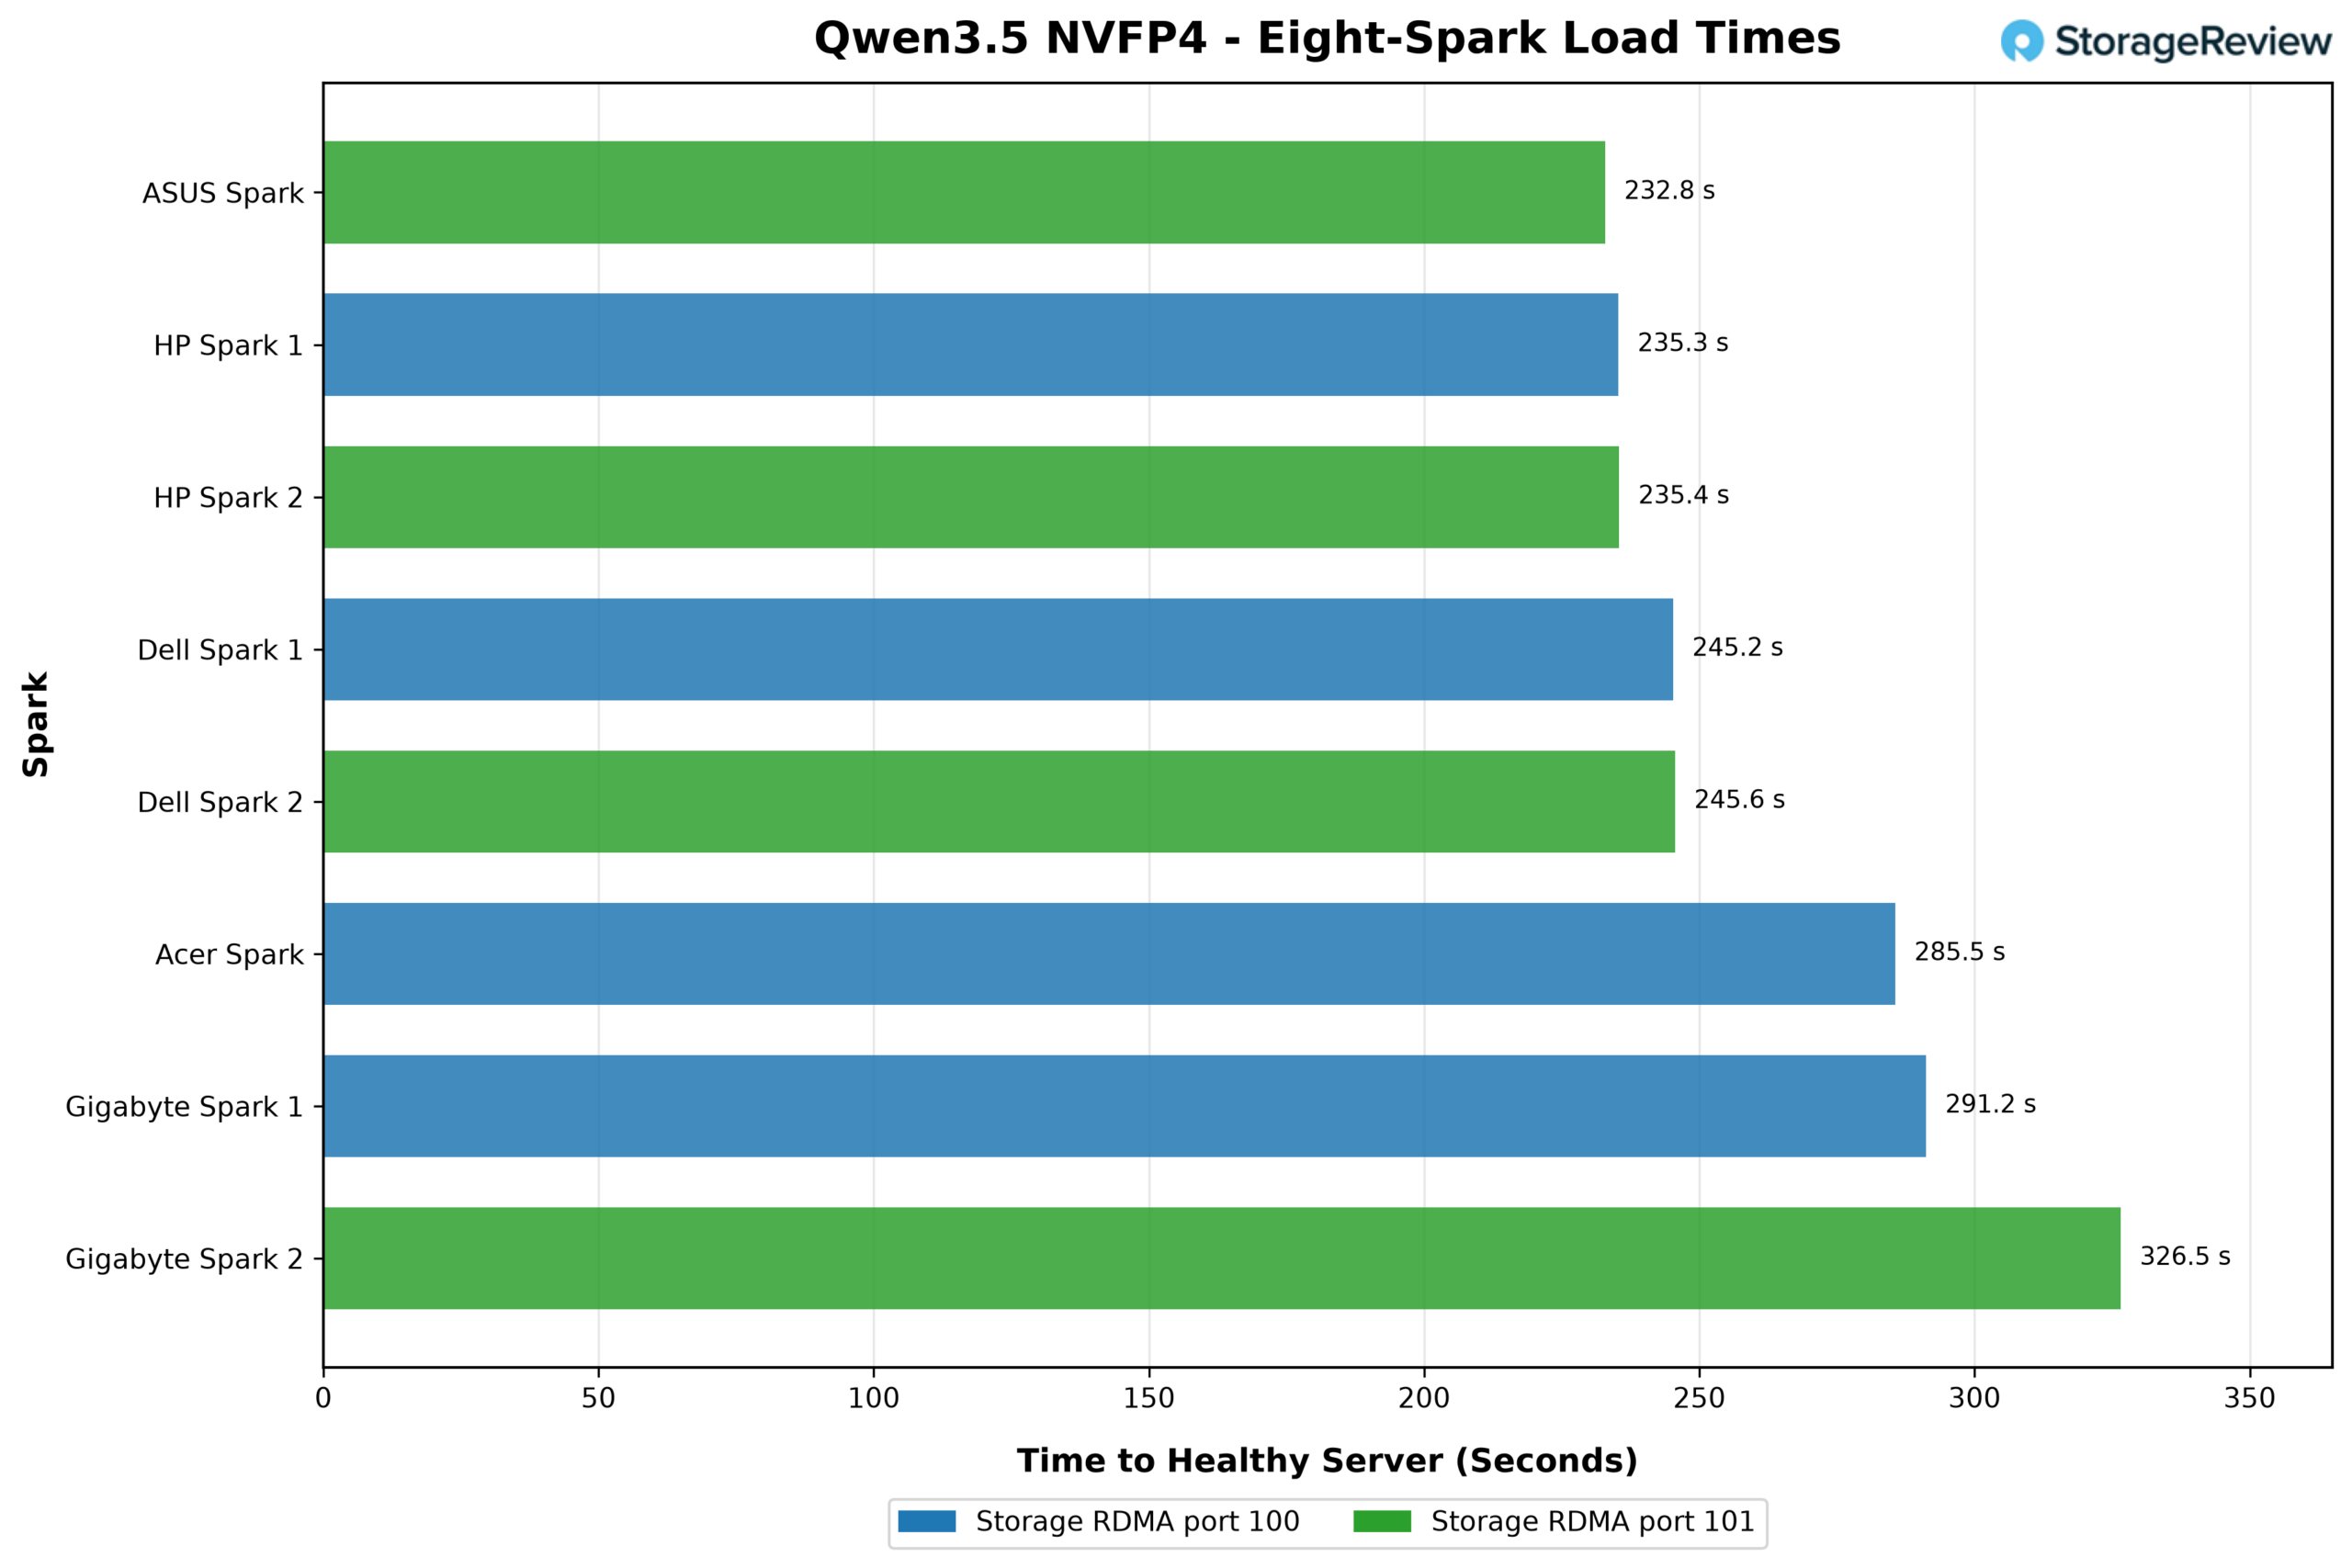
Časy načítania na jednotku v osemcestnom teste sa pohybovali od 232.8 sekundy na ASUS Ascent GX10 do 326.5 sekundy na jednej z jednotiek GIGABYTE AI TOP ATOM, pričom dva systémy HP ZGX Nano G1n dosiahli 235.3 a 235.4 sekundy a dva systémy Dell Pro Max s GB10 245.2 a 245.6 sekundy. Päť z ôsmich Sparkov, ktoré sa súčasne načítavali zo zdieľaného poľa, prekonalo jeden Spark, ktorý sa načítaval samostatne cez NFS/RDMA, a tri z nich prekonali lokálny NVMe beh. Rozpätie nie je otázkou dodávateľa; bez QoS v zásobníku sa jednotka, ktorá čaká na pole, kedykoľvek prepne z jedného behu na druhý, a dve jednotky na každej úložnej sieťovej karte sa rovnomerne rozdelili medzi rýchly a pomalý koniec grafu.
Pre laboratórium je výsledkom to, že si môže uchovať jednu kópiu každého modelu na poli a ktorýkoľvek Spark alebo každý Spark ju načíta približne za čas, ktorý by trval načítanie lokálnej kópie, bez kroku sťahovania, bez spotrebovania lokálnej kapacity a bez kópie váh uloženej na stole.
Prípadová štúdia štátu Oregon
Vysoká škola pre vedu o Zemi, oceáne a atmosfére na Oregonskej štátnej univerzite (Oregon State College of Earth, Ocean, and Atmospheric Sciences) sa opakovane podieľa na našej práci v oblasti infraštruktúry umelej inteligencie, od výskumu oceánov v reálnom čase na palube výskumnej lode až po akademické hodnotenie s pomocou umelej inteligencie s platformou Metrum AI . Chris Sullivan, riaditeľ pre výskum a akademické výpočty na Oregonskej štátnej univerzite (OSU), a jeho architekt Thomas Olson skúmajú rozsiahle laboratórium Spark pre učenie sa pomocou umelej inteligencie, ktoré by sa dalo škálovať až na 100 jednotiek, a ich úvahy o úložisku ovplyvnili náš návrh dvoma konkrétnymi spôsobmi.
Po prvé, úložisko musí byť nezávislé od Sparkov. OSU zvažovala súborový systém roztiahnutý cez samotné Sparky a zamietla ho pre učebňu, pretože pridanie alebo odstránenie jediného uzla by narušilo úložnú službu pre všetkých. Centrálne pole, ktoré pripojí akýkoľvek Spark, znamená, že Spark je možné pridať, odstrániť, preformátovať alebo odovzdať inému študentovi bez ovplyvnenia údajov kohokoľvek iného. Po druhé, úložisko musí nasledovať používateľa. Požiadavku OSU opisujeme ako vylepšenú verziu zdieľaných súborov pre účely umelej inteligencie, kde študenti ukladajú trvalé informácie pri presúvaní medzi systémami. Pri NFS je to priečinok na študenta; prihláste sa do ľubovoľného Sparku, pripojíte zdieľaný priečinok a vaša práca je tam.
Práve súbory údajov sú dôvodom, prečo je to pre OSU dôležitejšie ako pre server s domovským adresárom. Vysoká škola pre vedy o Zemi, oceáne a atmosfére chce sprístupniť svoje výskumné údaje, oceánografické a atmosférické zbierky merané v desiatkach terabajtov študentom na ich vlastný výskum. Na úložisku pri stole neexistuje žiadna verzia tejto možnosti: 4TB slot M.2 nedokáže pojať ani jednu z týchto zbierok a dokonca aj laboratórium plné externých boxov by znamenalo kúpu a naplnenie kópie pre každý stôl a následné udržiavanie každej kópie aktuálnej, čo si žiadne oddelenie nemôže dovoliť. Jednotlivé umiestnenie údajov na poli a ich pripojenie cez 100 GbE je prístup, ktorý v našom hodnotení spĺňal túto požiadavku. To isté pole hostí knižnicu modelov, takže študenti trávia svoje stretnutie spúšťaním Qwen, Llama alebo akéhokoľvek iného modelu bez kroku sťahovania. Rovnaký princíp platí aj pre podnik, ktorý nasadzuje stolové systémy umelej inteligencie ako vývojárske pracovné stanice: pripojte produkčnú sadu údajov cez rýchlu sieť a nechajte systém na nej pracovať na mieste, čo eliminuje potrebu vytvárať druhé dátové jazero, aby stolové počítače mali čo čítať. Dáta zostávajú v dátovom centre s už existujúcimi kontrolami prístupu, šifrovaním a zálohovaním a Spark po odovzdaní neobsahuje nič dôležité.
Záver
Hardvér s umelou inteligenciou pre stolné počítače je dobrý v mnohých veciach, ale nie je skvelý na to, aby bol súčasťou dátového majetku organizácie, a jediný slot M.2 v každom systéme GB10 to zabezpečuje: čokoľvek používateľ potrebuje, skončí skopírované na lokálny flash disk, neviditeľné pre IT, nechránené a duplikované na každom inom stole, ktorý potrebuje to isté. Pre jeden Spark je externý lokálny úložný box rozumným riešením. Pre laboratórium, oddelenie alebo podnik, ktorý ich nasadzuje po desiatkach, je každý stôl s vlastnými dátami silo a riešenie je rovnaké ako v dátovom centre pred rokmi: umiestniť kapacitu do rýchlej siete, spravovať ju raz a zdieľať. Sparky už majú vysokorýchlostné siete; tento projekt ukazuje, čo sa stane, keď ich niekam dáte, a argumentuje, že samotné Sparky patria do racku vedľa nich.
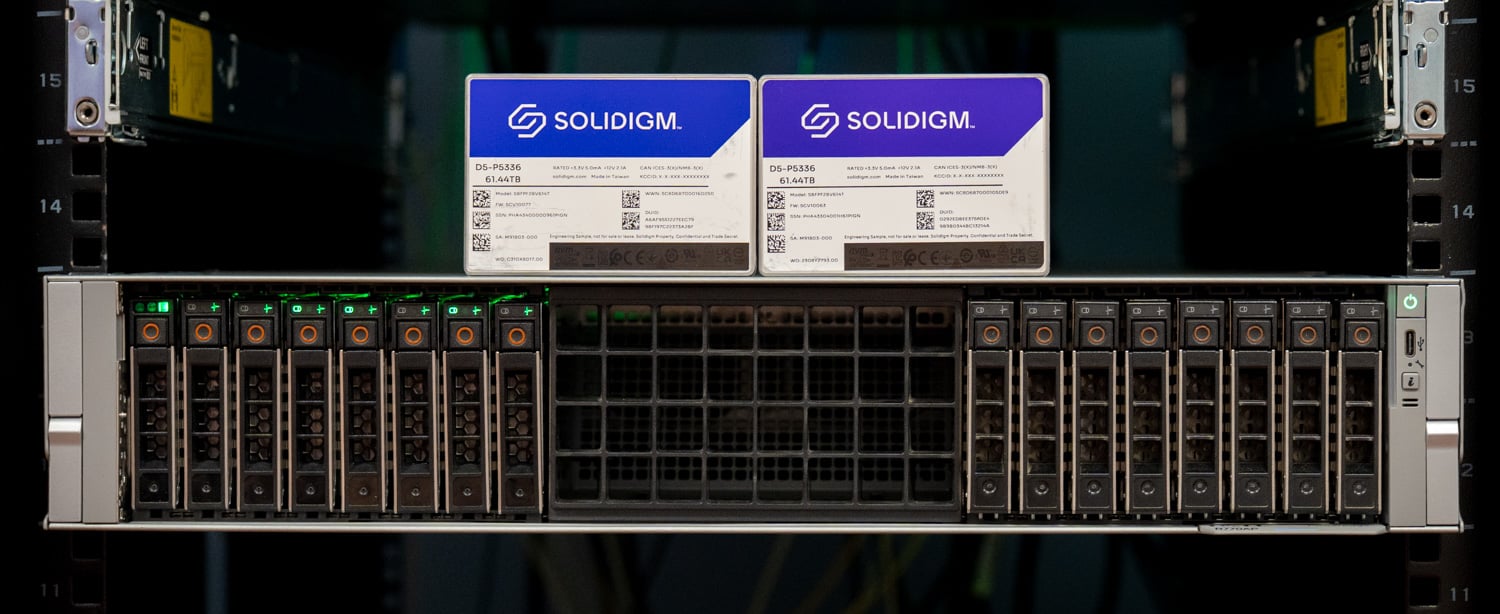
Osem diskov Solidigm D5-P5336 QLC v poli Graid RAID 5 na serveri Dell poskytlo ôsmim diskom Sparks jednu paritne chránenú sadu údajov. Dve sieťové karty Broadcom 400GbE a jedna Dell Z9864F-ON s 800G breakout poskytli osem diskov Sparks 100GbE každému. Tuxera Fusion NFS over RDMA umožnil túto kapacitu pripojiť na jeden linkový server na štandardnom Ubuntu s hookmi adresárových služieb pre riadenie prístupu. Pri pevnom zaťažení rozloženom na všetkých osem diskov pole poskytovalo 24.9 GiB/s agregovaného sekvenčného čítania, rovnomerne rozdeleného bez QoS, a jeden Spark sám saturoval svoje spojenie rýchlosťou 10.8 GiB/s, čo je rovnako rýchlo ako najlepší interný disk v akomkoľvek systéme GB10, ktorý sme testovali; tento limit spotreboval 27 % toho, čo dokážu preniesť dve sieťové karty na strane servera, takže sieť je dimenzovaná na plnší server ako tento. Test modelu potvrdil pracovný postup: 78GB model, ktorý bol raz hostovaný na zdieľanom poli, sa načítal na jednom Sparku s rýchlosťou do 13 % lokálneho NVMe a na ôsmich Sparkoch naraz, pričom päť z ôsmich dokončilo prácu rýchlejšie ako samostatný NFS.
Vďaka QLC flash pamäti tieto ekonomické faktory fungujú, pretože pracovná záťaž je vysoká z hľadiska kapacity a čítania, čo je silná stránka D5-P5336, a jeden server dokáže uniesť to, čo by sto Sparkov nikdy nedokázalo uniesť lokálne, s jednou kópiou všetkého a každou kópiou pod kontrolou dátového centra. Oregon State University má úložisko pre výskum v oblasti produkcie pre prácu, ktorá nemôže čakať. Koncept, ktorý Chris Sullivan a Thomas Olson skúmajú, je vzdelávacia úroveň, ktorú dnes vysoká škola nemá: riadený, zdieľaný fond s veľkosťou pre jeden alebo viac Sparkov, vybudovaný zo servera a niekoľkých vysokokapacitných diskov, ktorý by mohol umiestniť desiatky terabajtov skutočných oceánografických a atmosférických údajov pred rozsiahle laboratórium pre vzdelávanie s umelou inteligenciou na rovnakej infraštruktúre, akú používajú jeho Sparky.
Túto správu sponzoruje spoločnosť Solidigm. Všetky názory a stanoviská vyjadrené v tejto správe vychádzajú z nášho nestranného pohľadu na posudzovaný(e) produkt(y).
Odkazy na komerčné produkty v tomto článku slúžia na informačné účely a nepredstavujú schválenie zo strany Oregonskej štátnej univerzity.


 Amazonka