

IBM 已將 Meta 最新的開源 AI 模型——Llama 4 Scout 和 Llama 4 Maverick——整合到其 watsonx.ai 平台中。這些新一代專家混合模型 (MoE) 旨在提供高效能的多模態能力,並顯著提高成本效益、可擴展性和處理能力。隨著 Llama 4 的加入,IBM 現在在 watsonx.ai 上支援 13 個元模型,這進一步鞏固了其對開放式多模型生成式 AI 方法的承諾。
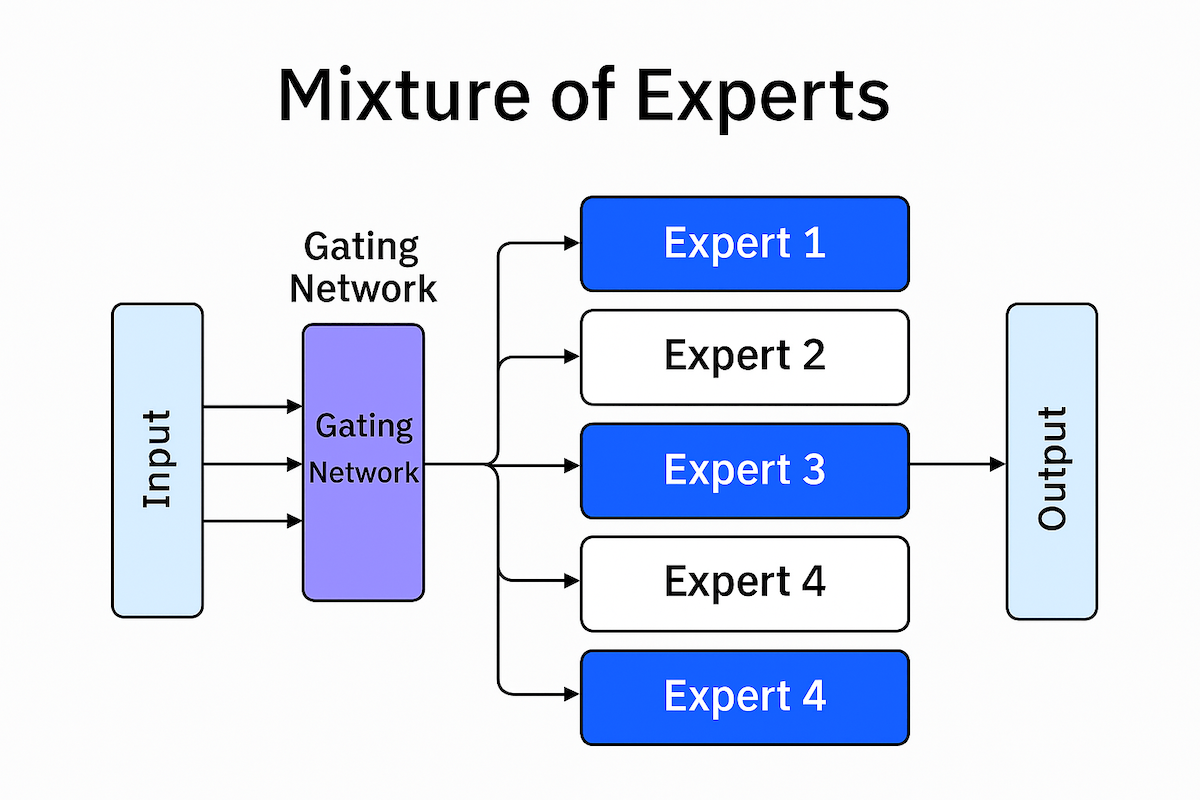
專家混合架構:高效不妥協
Meta 的新款 Llama 4 模型標誌著 AI 架構的重大進步。兩種模型都採用了 MoE,它可以聰明地為每個代幣激活一部分模型“專家”,而不是讓整個網路參與其中。這種有針對性的推理策略可以在不影響品質的情況下提高吞吐量並降低營運費用。
Llama 4 Scout擁有 109 億個參數,分佈在 16 位元專家節點上,但在推理過程中僅啟動 17 億個參數。這種高效的配置實現了更高的並發性和更快的反應速度,同時在編碼、長上下文推理和圖像理解任務上表現出色。儘管 Scout 體積小巧,但它使用 40 兆個 token 進行訓練,性能超越了那些激活參數集更大的模型。
Llama 4 Maverick更進一步,有 400 億個參數和 128 位專家,但每次推理僅需 17 億個活躍參數。 Meta 報告顯示,Maverick 在多模態基準測試中全面超越了 OpenAI 的 GPT-4o 和 Google 的 Gemini 2.0 Flash,並且在推理和編碼工作負載方面與 DeepSeek-V3 的性能相當,儘管其效率更高。
| 型號 | 總參數 | 活動參數 | 專家人數 | 上下文視窗 |
|---|---|---|---|---|
| 駱駝 4 偵察兵 | 109B | 17B | 16 | 10M 代幣 |
| 駱駝 4 特立獨行 | 400B | 17B | 128 | 10M 代幣 |
引領長遠人工智慧
Llama 4 Scout 引入了突破性的上下文窗口,其容量高達 10 萬個令牌,是目前業界最長的上下文窗口。這項進步使得多文件摘要、深入的程式碼庫分析和長期用戶個人化成為可能。 Meta 將此里程碑歸功於兩項架構創新:交錯注意力層(無位置嵌入)和推理時間注意力擴展技術。這些增強功能統稱為“iRope”,使 Meta 更接近其無限上下文長度 AI 的願景。
適用於實際用例的原生多模態
傳統的 LLM 僅針對文字進行訓練,然後針對其他資料類型進行改造。相較之下,Llama 4 模型被認為是“原生多模式”,這意味著它們是從頭開始使用文字、圖像和視訊資料的組合進行訓練的。這使它們能夠自然地處理各種輸入類型並提供更整合、上下文感知的結果。
 在訓練過程中,模型在早期處理階段融合視覺和語言數據,有效地教會系統同時跨模態進行解釋和推理。結果是在基於圖像的推理方面表現出色,包括能夠處理每個提示中的多個圖像並將特定的視覺元素與文字回應關聯起來。
IBM WatsonX 上的企業部署
透過 watsonx.ai,開發人員和企業可以存取 Llama 4 Scout 或 Maverick,並在雲端、本地或邊緣環境中對其進行微調、提煉和部署。 IBM 的企業級平台支援整個 AI 生命週期,為各個技能水平的開發人員提供工具——從程式碼到低程式碼和無程式碼環境。
watsonx.ai 包括與向量資料庫、代理框架和高級基礎設施的預先建立的集成,可以輕鬆大規模地實施 AI。強大的治理工具確保企業級的合規性、安全性和可審計性,幫助團隊負責任地建置和更快部署。
人工智慧轉型策略聯盟
IBM 與 Meta 的合作將開放式創新與實用的企業準備融為一體。隨著 Meta 擴展模型架構的限制,IBM 提供了當代企業快速發展所需的基礎設施、治理和部署靈活性,而不會犧牲控製或成本效益。
Llama 4 登陸 watsonx.ai 為 IBM 客戶提供了一套新的高效能工具,可在廣泛的用例中釋放價值——無需供應商鎖定,並保證在為企業設計的平台上運行。


 Amazon