
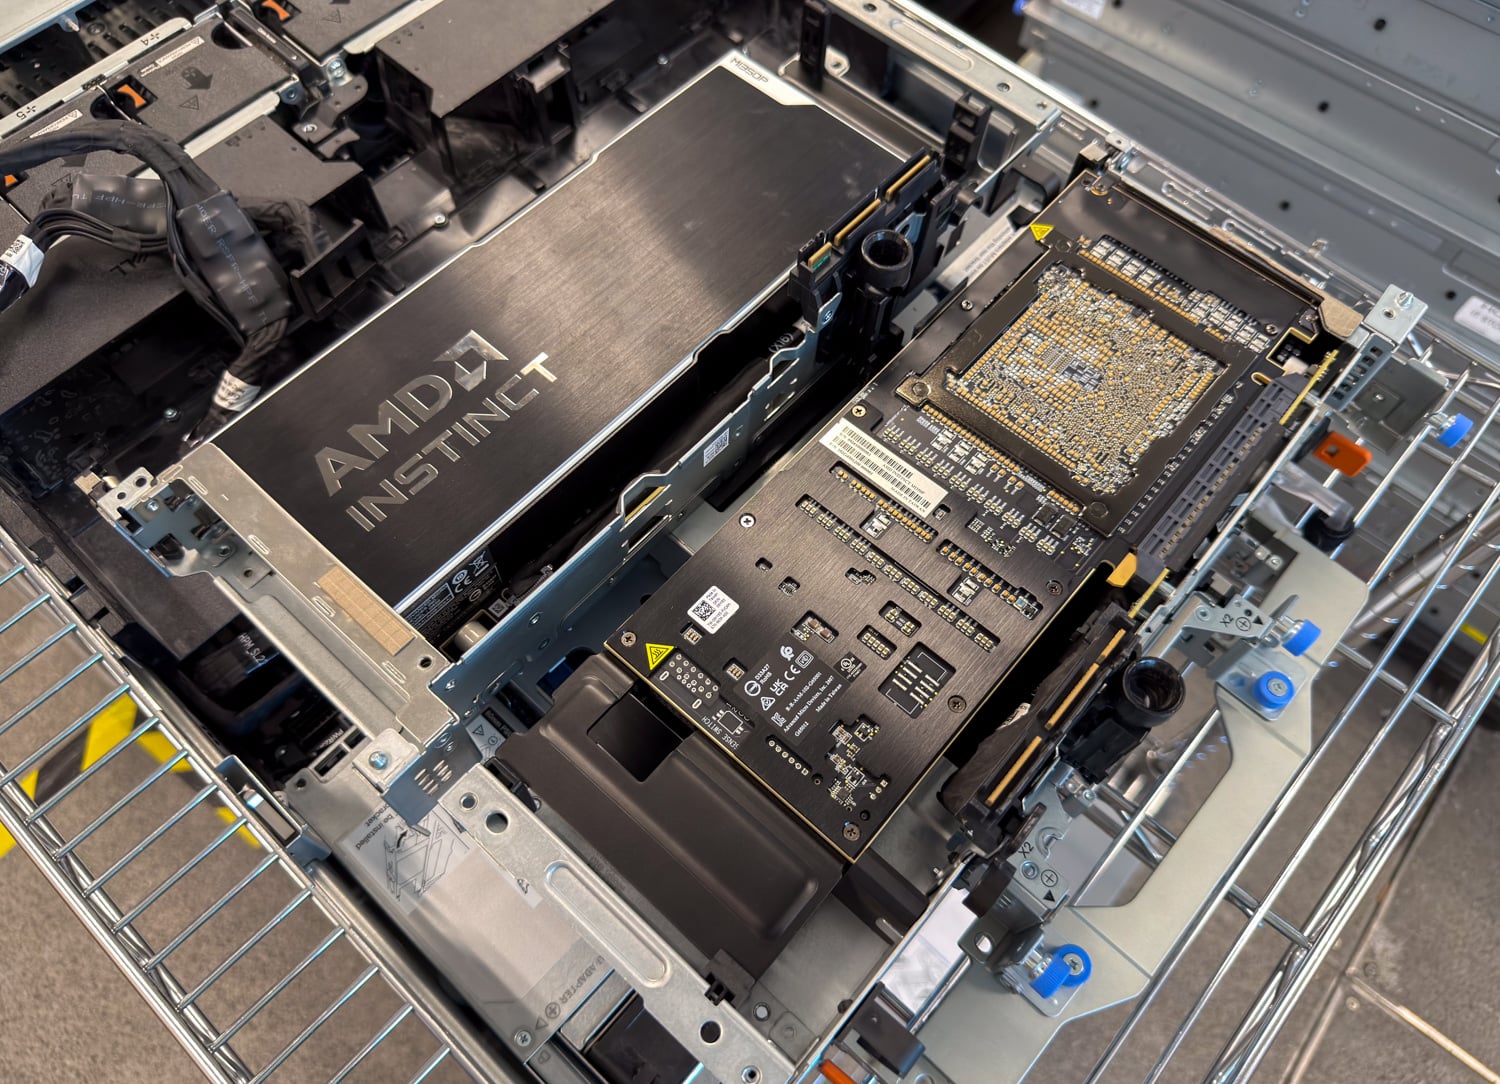
AMD Instinct MI350P 是 AMD 繼 2022 年的 MI210 之後,四年來推出的首款全新 PCIe Instinct GPU。它將 AMD 的 CDNA 4 架構應用於傳統的獨立顯示卡,擁有高達 4.6 PFLOPS 的 MXFP4 效能、144GB 的 HBM3E 記憶體以及 4TB/s 的顯存頻寬。所有這些強大的性能都整合在一個雙插槽、600W 的顯示卡中。

我們目前的AI系統評測主要集中在實驗室環境下的推理服務,使用來自Llama、Qwen、DeepSeek和gpt-oss系列的開放權重模型,透過vLLM或SGLang運行,並測量其輸出吞吐量和首令牌延遲。評測範圍涵蓋從邊緣到完整GPU節點:NVIDIA RTX PRO 4500伺服器版在HPE ProLiant DL145 Gen11伺服器中,其輸出令牌/秒的中位數是其所替代的L4緩存的2.7倍,功耗僅高出約105W;戴爾、技嘉和惠普的DGXb網路版本在200W; JumpStart計畫讓我們有機會親身體驗NVIDIA HGX B200和AMD Instinct MI350X系統。儲存也受到同樣的對待,因為資料路徑決定了這些 GPU 的繁忙程度,所以我們使用 GDSIO 測量 GPUDirect Storage 吞吐量,並測試KV 快取卸載到快閃記憶體以處理長上下文和代理工作負載。
如果您正在為 AI 規劃硬體規模,「最佳伺服器」頁面列出了我們根據這些評論資料挑選的當前 AI 推理和邊緣伺服器,「最佳企業級 SSD」頁面涵蓋了為 GPU 提供資料的驅動器,「最佳儲存陣列」頁面涵蓋了訓練叢集和新雲端背後的 AI 儲存平台。
AMD Instinct MI350P 是 AMD 繼 2022 年的 MI210 之後,四年來推出的首款全新 PCIe Instinct GPU。它將 AMD 的 CDNA 4 架構應用於傳統的獨立顯示卡,擁有高達 4.6 PFLOPS 的 MXFP4 效能、144GB 的 HBM3E 記憶體以及 4TB/s 的顯存頻寬。所有這些強大的性能都整合在一個雙插槽、600W 的顯示卡中。
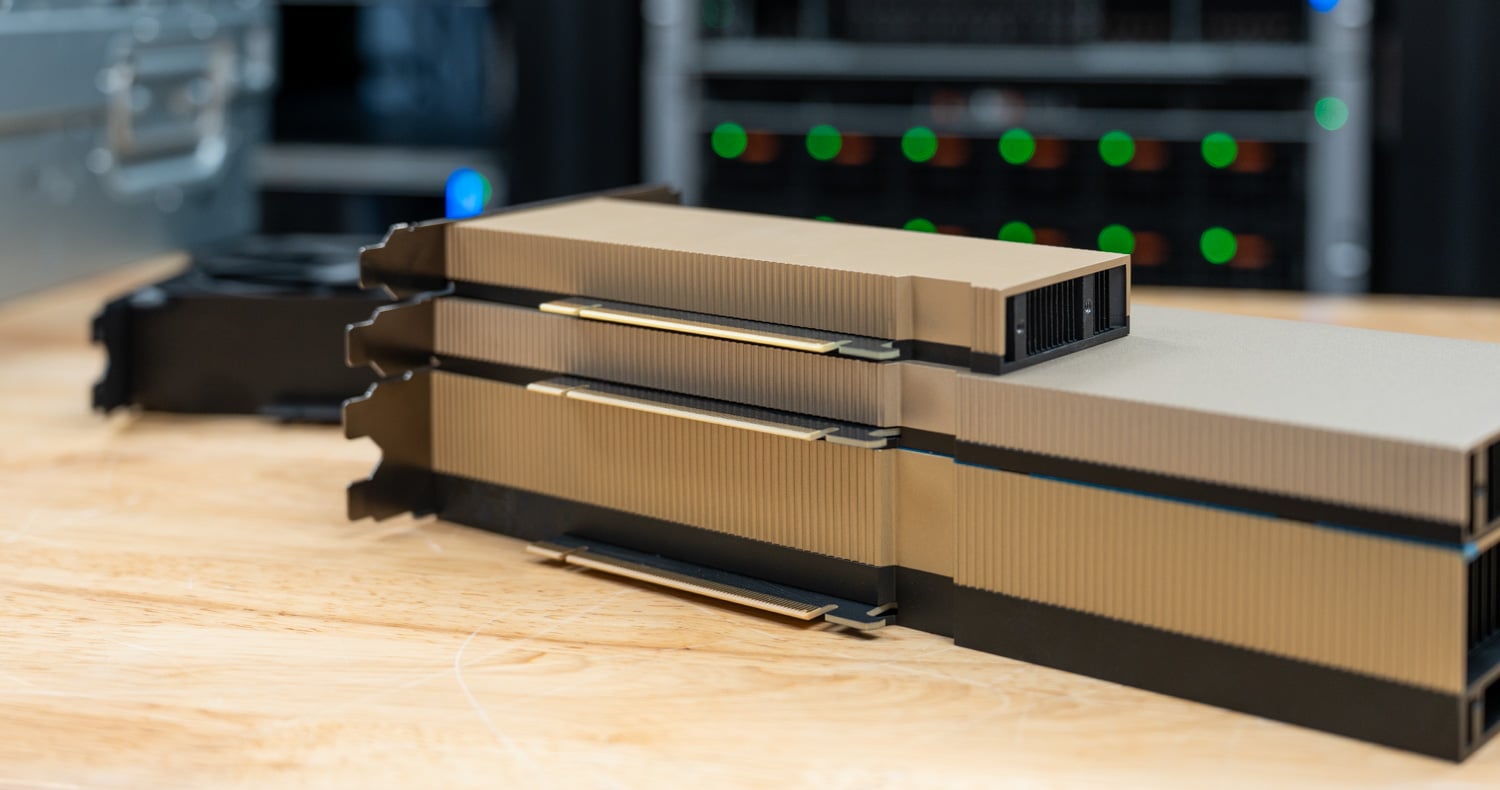
NVIDIA RTX PRO 4500 Blackwell 伺服器版是 NVIDIA 專為大多數企業現有伺服器打造的顯示卡。它是一款單槽被動散熱的 165W 顯示卡,配備 32GB GDDR7 顯存,並擁有完整的 Blackwell 功能集:第五代 Tensor Core(支援 FP4)、第四代 RT Core、三個編碼器和三個解碼器,以及多實例 GPU 支援。
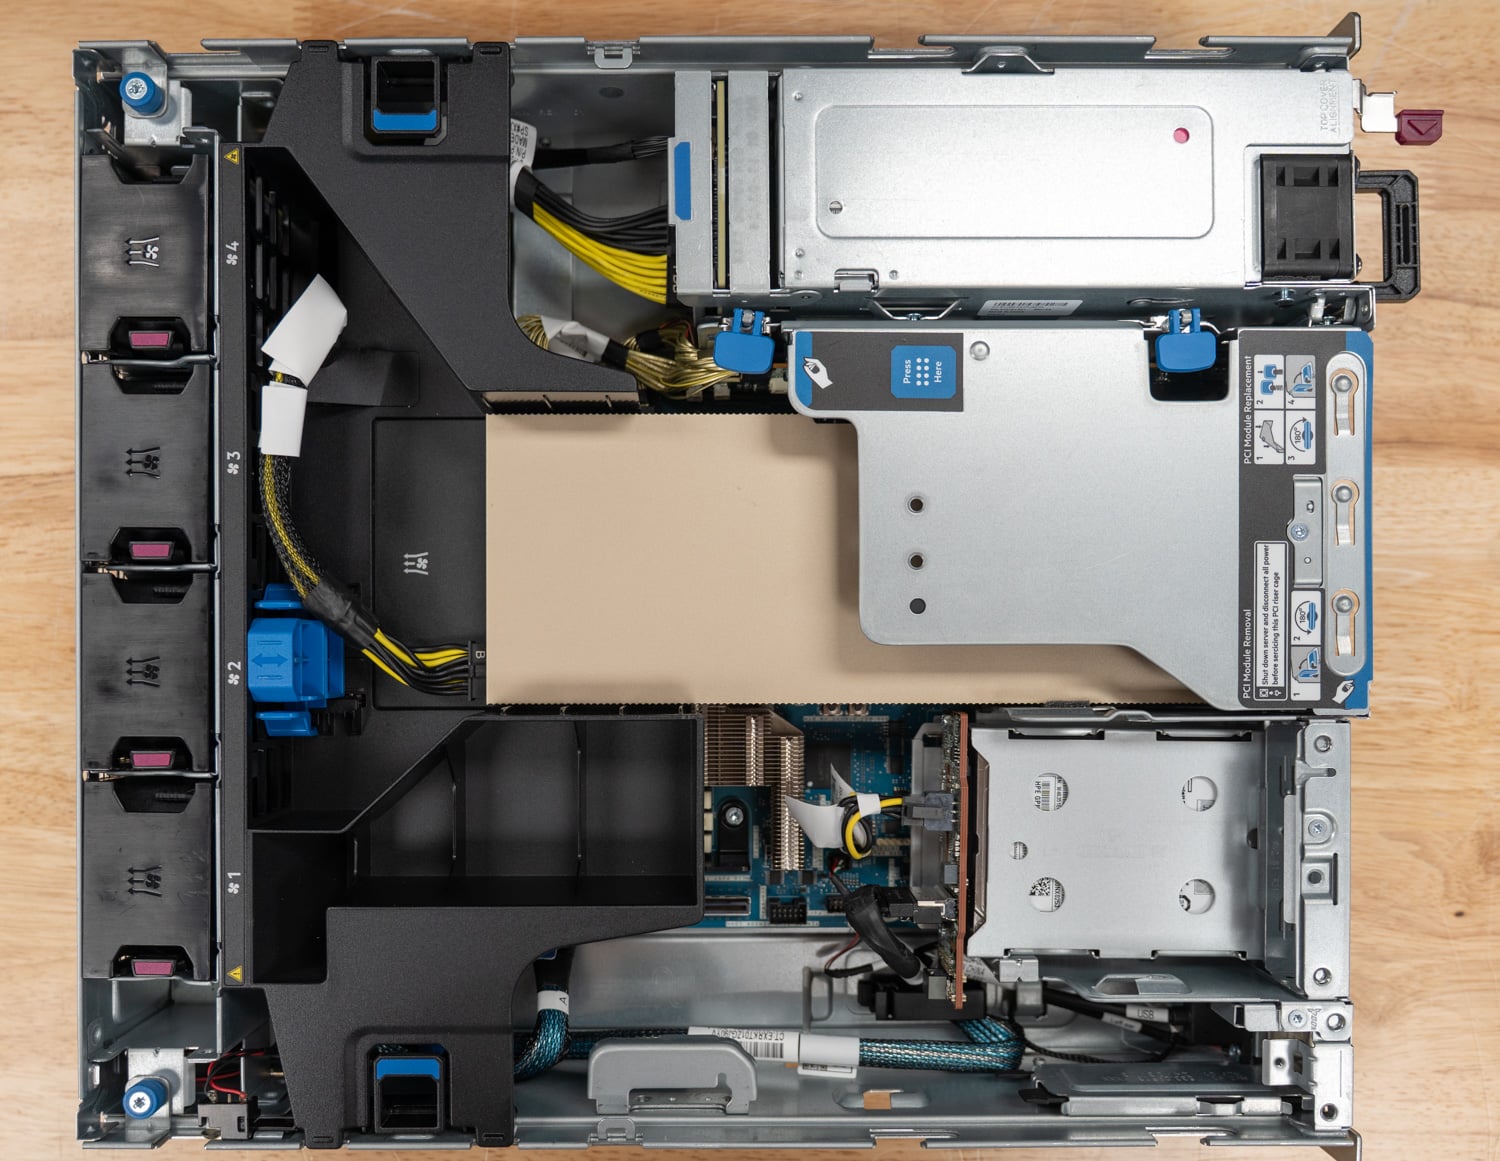
NVIDIA RTX PRO 4500 Blackwell 伺服器版是 NVIDIA 專為替代資料中心外伺服器中的 L4 快取而設計的顯示卡:單槽設計,支援 PCIe Gen5,採用被動散熱,功耗 165W,配備 32GB GDDR7 顯存,並擁有完整的 BlackFP 執行個體功能集,包括 TenFP4 HPE 寄送了一台 ProLiant DL145 伺服器給我們。
企業級人工智慧基礎設施已從優化訓練模型轉向服務這些模型,這改變了其經濟模式。訓練是一項有終點的資本項目。推理則是一項生產工作負載,只要服務在線上就會運行,其輸出以代幣衡量。這就是人工智慧營運商目前面臨的代幣經濟學問題:一旦
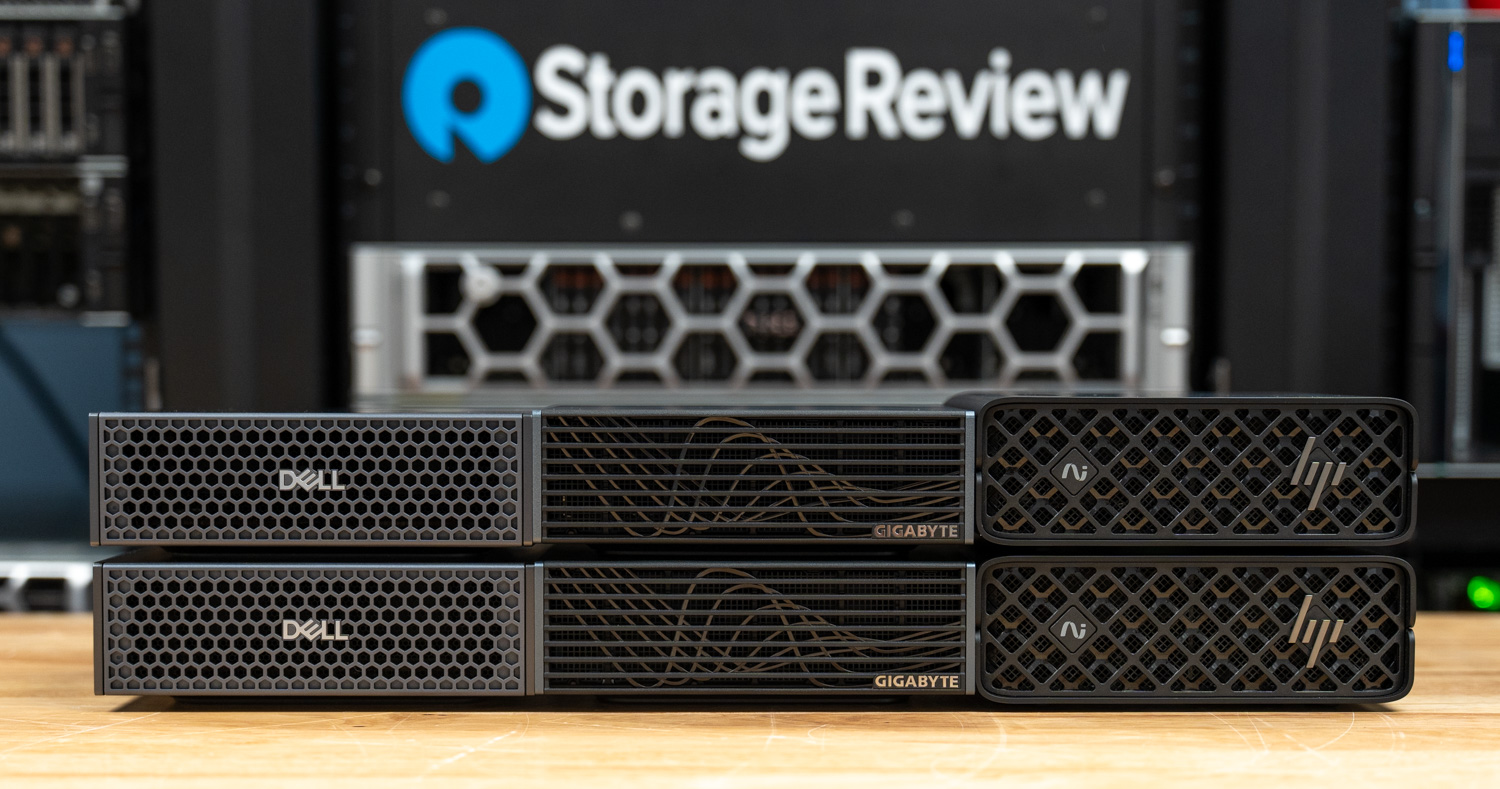
每當人們談起NVIDIA DGX Spark顯示卡,首先想到的往往是兩件事。第一個是它最引人注目的規格:128GB統一內存,裝在一台售價約4,000美元的台式機裡,這個數字在兩年前還很難想像會出現在工程師的辦公桌上。第二是200
去年11月,我們發表了關於俄勒岡州立大學浮游生物成像研究的報道,標題聚焦於科學本身:研究船上搭載的人工智慧加速基礎設施,在船隻抵達港口之前,就能近乎即時地處理數TB的海洋數據。但在接下來的幾周里,一些其他的事情悄悄發生。校園裡開始流傳著這樣一個消息:
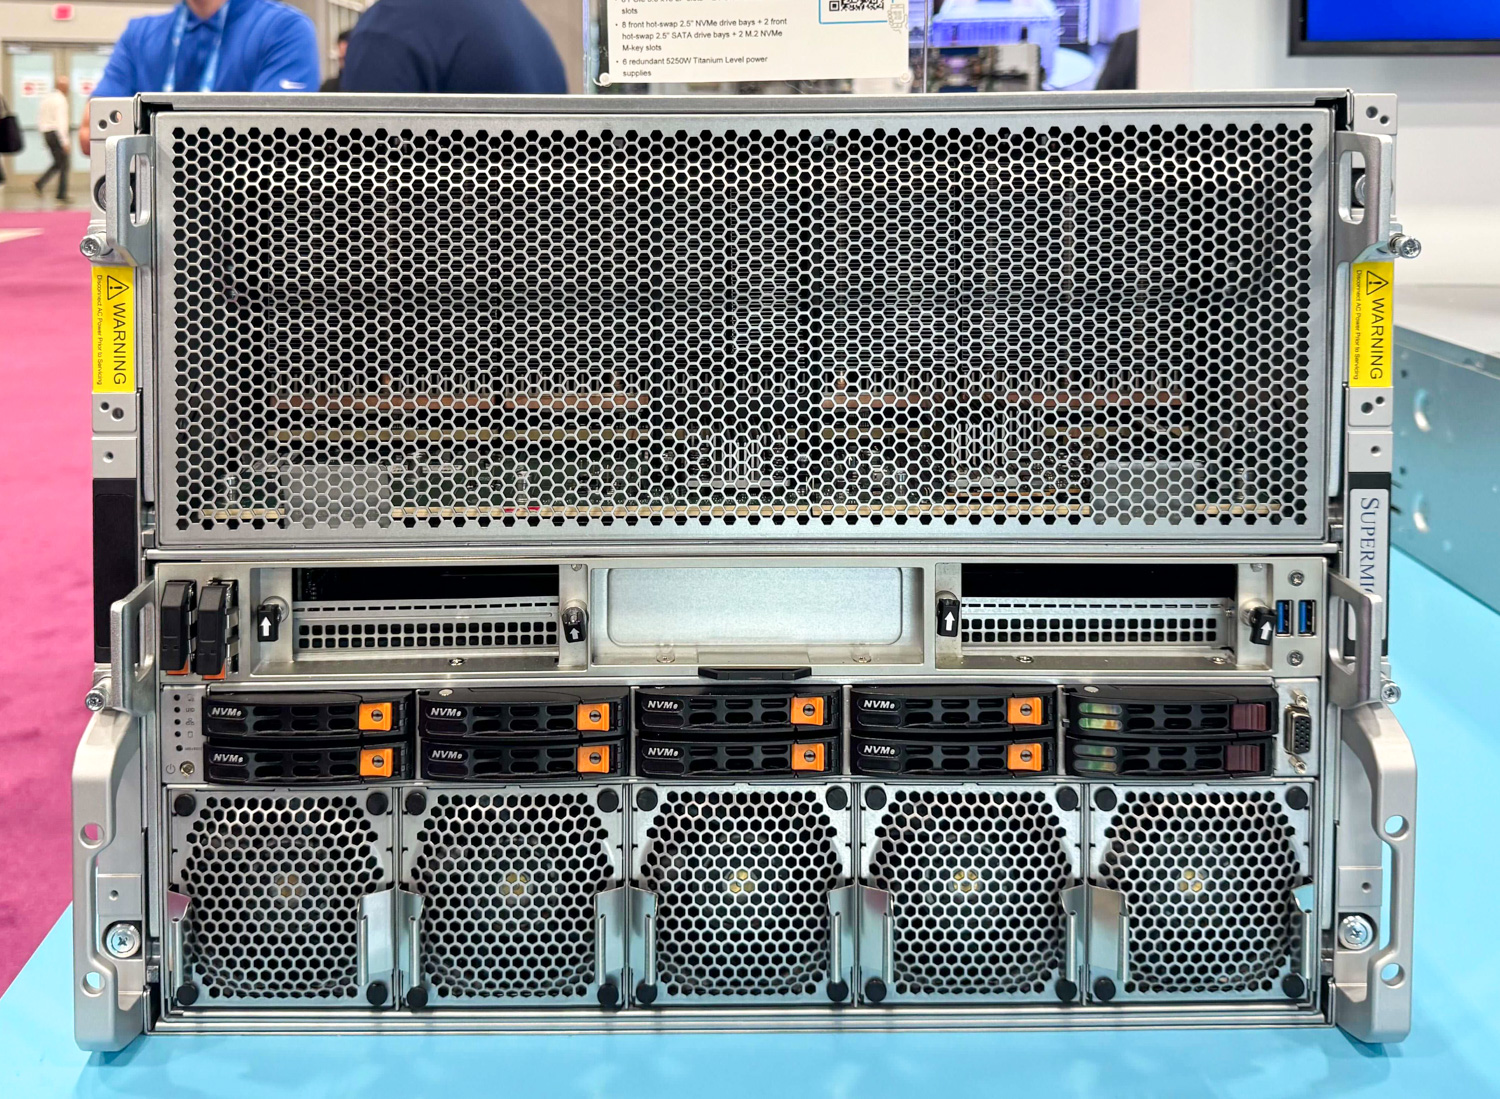
Supermicro 的 JumpStart 專案已成為 AI 基礎架構採購前評估工具包中最實用的工具之一。與在共享環境中進行腳本演示不同,JumpStart 為符合條件的用戶提供免費、限時、裸機訪問權限,用戶可以透過 SSH、IPMI 和 VNC 連接到真實的生產伺服器,從而在實際硬體上運行工作負載。
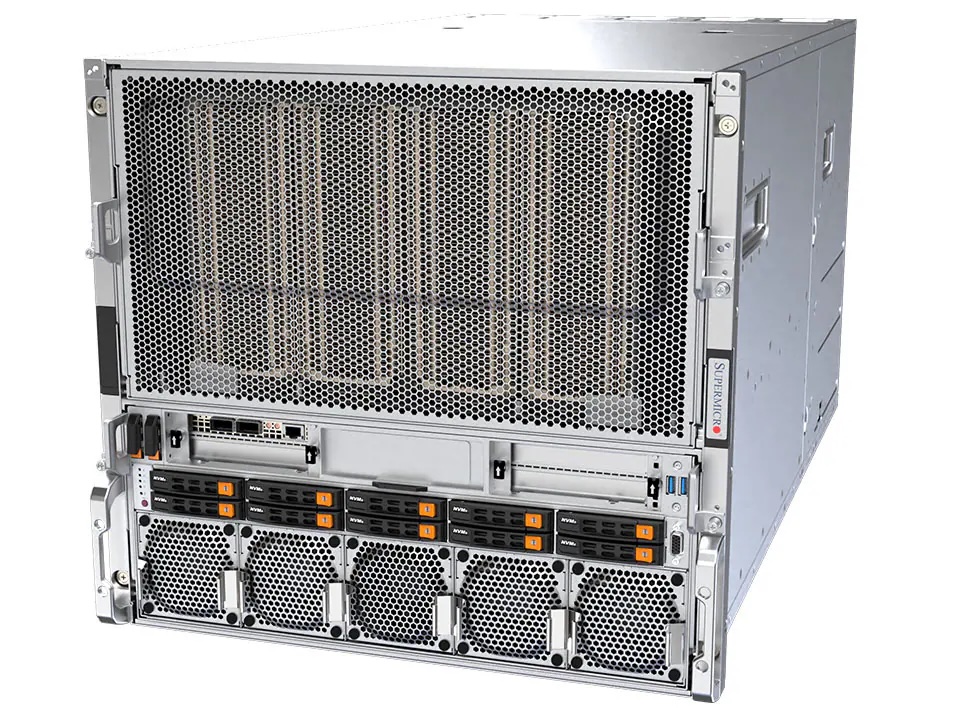
我們花了一周時間透過 Supermicro JumpStart 對 HGX B200 進行測試,以了解遠端裸機存取如何加快 AI 平台決策速度。
L40S 對於需要計算和圖形效能的合成資料生成、多模式 AI 開發和 Omniverse 應用程式尤其有價值。
我們的附屬合作夥伴提供的產品和解決方案:


 Amazon