

NVIDIA GTC 2023 以推出新產品、合作夥伴、創新和軟件拉開序幕。 為了讓您了解公告的範圍,主題演講持續了 78 分鐘。 宣布了四個新平台,每個平台都針對特定的生成式 AI 推理工作負載和專用軟件進行了優化。
這些平台將 NVIDIA 的全套推理軟件與最新的 NVIDIA Ada、Hopper 和 Grace Hopper 處理器相結合。 今天推出了兩款新的 GPU,即 NVIDIA L4 Tensor Core GPU 和 H100 NVL GPU。
NVIDIA L4 AI 視訊加速器在 AI視訊處理方面比 CPU 的效能提升 120 倍,同時能源效率提升 99%。 L4 可作為通用 GPU,幾乎適用於任何工作負載,提供增強的視訊解碼和轉碼能力、視訊串流播放、擴增實境、生成式 AI 視訊等功能。
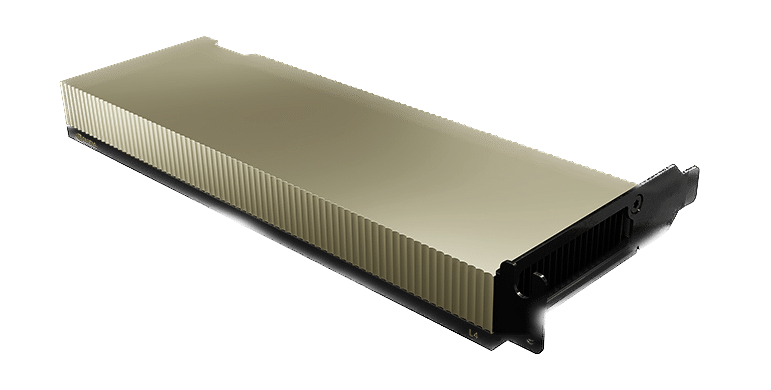
NVIDIA Ada Lovelace L4 Tensor Core GPU 為企業、雲端和邊緣的視頻、人工智能、虛擬化桌面和圖形應用程序提供通用加速和能效。 借助NVIDIA的AI平台和全棧
方法,L4 針對廣泛的 AI 應用程序進行大規模推理進行了優化,包括推薦、基於語音的 AI 化身助手、生成 AI、視覺搜索和聯絡中心自動化。
L4 是最高效的主流 NVIDIA 加速器,配備 L4 的服務器比 CPU 解決方案高出 120 倍的 AI 視頻性能和 2.7 倍的生成 AI 性能,以及比上一代 GPU 高出 4 倍的圖形性能。 NVIDIA L4 是一種多功能、高能效、單插槽、薄型外形,非常適合大型部署和邊緣位置。
NVIDIA L40 影像生成平台針對圖形和 AI 賦能的 2D、視訊和 3D 影像生成進行了最佳化。 L40 平台是 NVIDIA Omniverse 的引擎,Omniverse 是一個用於在資料中心建置和運行元宇宙應用程式的平台,其穩定擴散推理效能比上一代產品提升了 7 倍,Omniverse 效能提升了 12 倍。
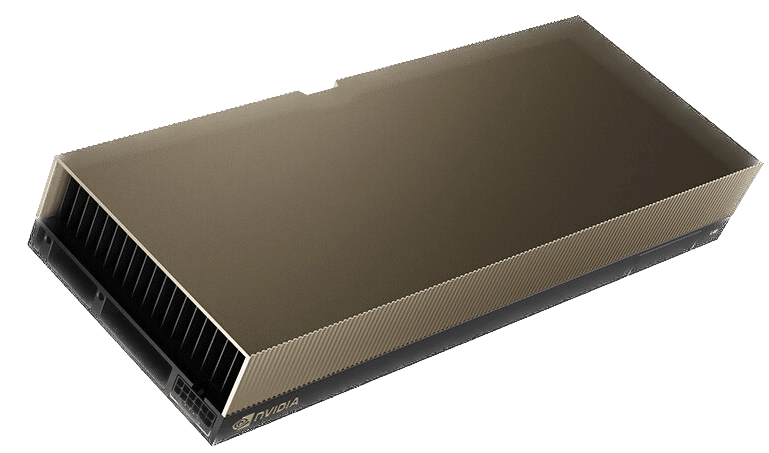
NVIDIA L40 GPU 為數據中心提供高性能視覺計算,具有下一代圖形、計算和人工智能功能。 L40 基於 NVIDIA Ada Lovelace 架構構建,利用最新一代 RT、Tensor 和 CUDA 內核的強大功能,為要求苛刻的數據中心工作負載提供可視化和計算性能。
L40 提供增強的吞吐量和並發光線追踪和著色功能,可提高光線追踪性能並加速產品設計和架構、工程和施工工作流程的渲染。 L40 GPU 為結構稀疏性和優化的 TF32 格式提供硬件支持,以實現開箱即用的性能提升,從而實現更快的 AI 和數據科學模型訓練。 加速的 AI 增強型圖形功能(包括 DLSS)可在特定應用程序中提供更高的分辨率和更好的性能。
L40 的大型 GPU 內存可處理內存密集型應用程序和工作負載,例如數據科學、模擬、3D 建模和渲染,以及 48GB 的超快 GDDR6 內存。 使用 vGPU 軟件將內存分配給多個用戶,以在創意、數據科學和設計團隊之間分配大量工作負載。
NVIDIA L24 專為具有節能硬件和組件的 7×40 企業數據中心運營而設計,經過優化可大規模部署並為各種數據中心工作負載提供最大性能。 L40 包括採用信任根技術的安全啟動,提供額外的安全層,並且符合 NEBS Level 3 標準以滿足數據中心標準。
NVIDIA H100 NVL 專為大規模部署大型語言模型而設計,是部署 ChatGPT 等大型語言模型的理想選擇。新款 H100 NVL 配備 94GB 顯存,並搭載 Transformer Engine 加速技術,在資料中心規模下,其 GPT-3 推理效能比上一代 A100 提升高達 12 倍。
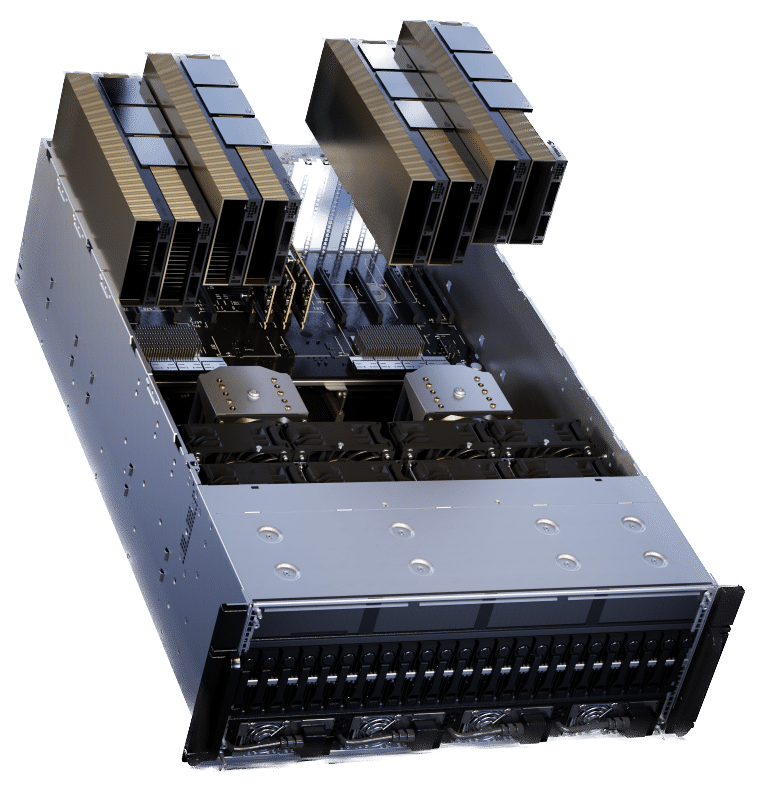
基於 PCIe 的 H100 NVL 和 NVLink 橋利用 Transformer Engine、NVLink 和 188GB HBM3 內存來提供最佳性能和跨數據中心的擴展。 H100 NVL 支持多達 175 億個參數的大型語言模型。 配備 H100 NVL GPU 的服務器可將 GPT-175B 模型性能提高至 NVIDIA DGX A12 系統的 100 倍,同時在功率受限的數據中心環境中保持低延遲。
NVIDIA Grace Hopper for Recommendation Models是圖推薦模型、向量資料庫和圖神經網路的理想選擇。憑藉 CPU 和 GPU 之間 900 GB/s 的 NVLink-C2C 連接,Grace Hopper 的資料傳輸和查詢速度比 PCIe Gen 5 快 7 倍。
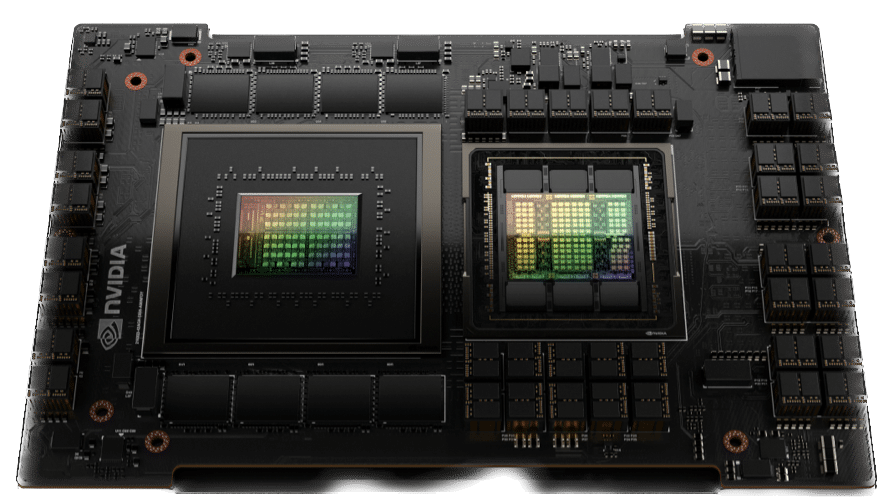
NVIDIA Grace Hopper Superchip 是一款突破性的加速 CPU,專為大規模人工智能和高性能計算 (HPC) 應用而設計。 該超級芯片將為運行 TB 級數據的應用程序提供高達 10 倍的性能提升,使科學家和研究人員能夠為世界上最複雜的問題找到前所未有的解決方案。
NVIDIA Grace Hopper Superchip 結合使用 NVIDIA NVLink-C2C 的 Grace 和 Hopper 架構,為加速 AI 和 HPC 應用程序提供 CPU+GPU 一致性內存模型。 與 NVIDIA DGX A900 相比,Grace Hopper 包括每秒 7 GB (GB/s) 的一致接口,速度比 PCIe Gen5 快 30 倍,並為 GPU 提供高 100 倍的聚合系統內存帶寬。 最重要的是,它運行所有 NVIDIA 軟件堆棧和平台,包括 NVIDIA HPC SDK、NVIDIA AI 和 NVIDIA Omniverse。
現代推薦系統模型需要大量內存來存儲嵌入表。 嵌入表包含項目和用戶特徵的語義表示,有助於向消費者提供更好的推薦。
通常,這些嵌入遵循使用頻率的冪律分佈,因為某些嵌入向量的訪問頻率高於其他向量。 NVIDIA Grace Hopper 支持高吞吐量推薦系統管道
將最常用的嵌入向量存儲在 HBM3 內存中,將剩餘的嵌入向量存儲在更高容量的 LPDDR5X 內存中。 NVLink C2C 互連為 Hopper GPU 提供了對其本地 LPDDR5X 內存的高帶寬訪問。 同時,NVLink Switch System 擴展了這一點,為 Hopper GPU 提供了對 NVLink 網絡中所有 Grace Hopper Superchip 的所有 LPDDR5X 內存的高帶寬訪問。


 Amazon