

Comino社は先日、レビュー用に最新バージョンのComino Grandoを送ってくれました。このバージョンは、それぞれ96GBのVRAMを搭載したNVIDIA RTX PRO 6000 Blackwellカードを8枚搭載し、合計768GBのGPUメモリを備えています。弊社は2024年に、合計144GBのGPUメモリを提供するRTX 4090を6枚搭載したCominoと、 NVIDIA H100を搭載したバージョンをレビューしました。今回の最新アップデートは、生のメモリ容量とプラットフォームが対応できるワークロードの範囲の両方において、世代を超えた大きな飛躍を示しています。
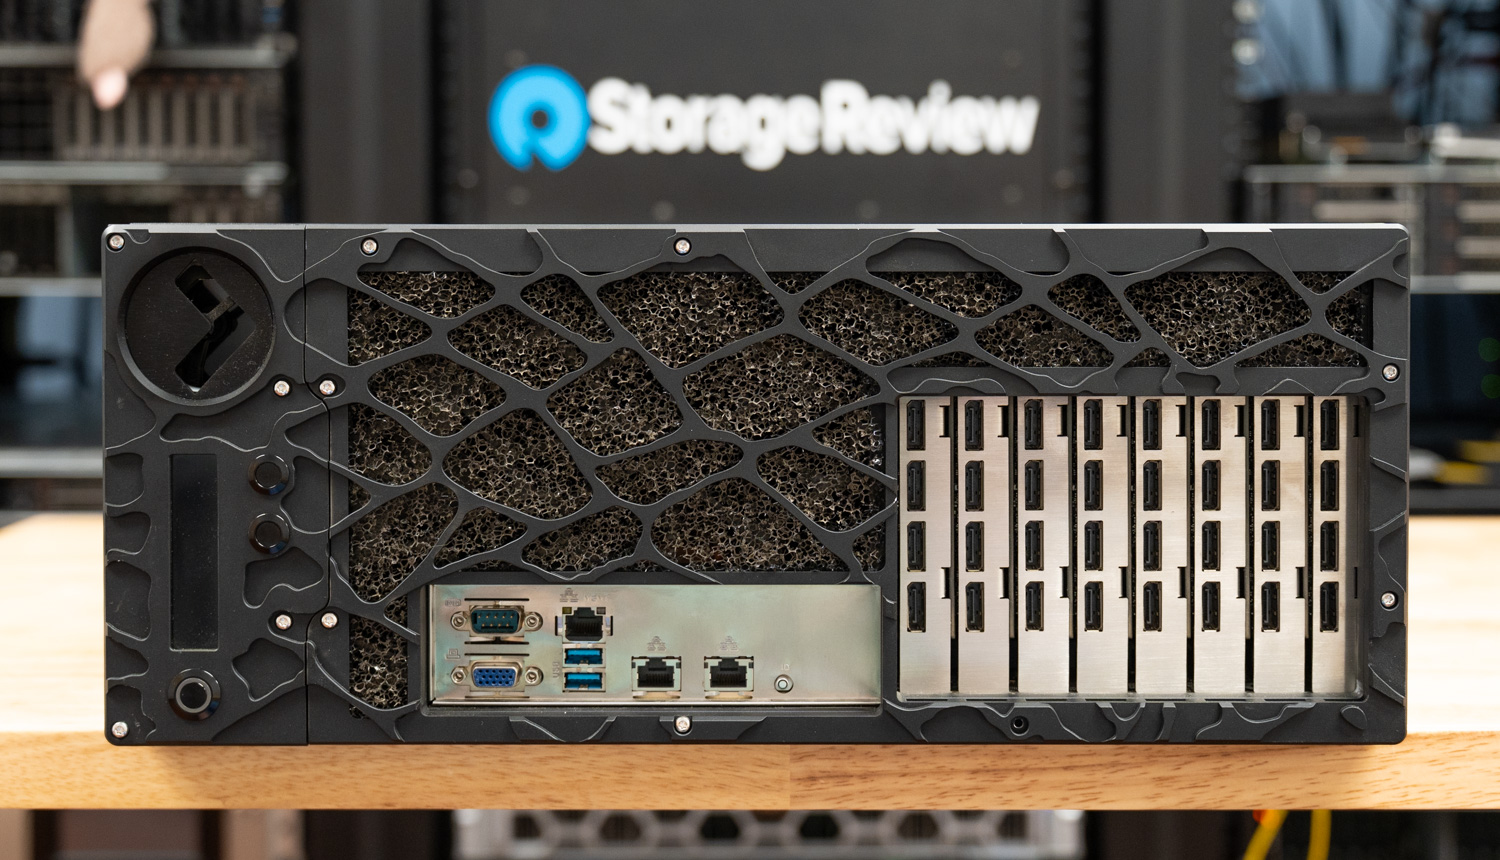
Grandoは、高密度GPU演算と熱管理という重要な課題を解決するために設計された、専用設計の4Uプラットフォームです。標準的な空冷シャーシは、現代のプロフェッショナル向けカードの600W以上のTDP要求に耐えきれず崩壊してしまいますが、Grandoは根本的に異なるアプローチを採用し、6.5kWもの連続的な熱を放散できる液冷アーキテクチャを中心にゼロから構築されています。これは後付けや付け足しではなく、マザーボードの反転レイアウトから色分けされたクイックディスコネクトマニホールドシステムに至るまで、シャーシ全体が冷却ループを中心に設計されています。
その結果、8基のフルTDPプロフェッショナルGPUを1台の4Uシャーシに搭載し、周囲温度3~38℃の環境で24時間365日稼働させることが可能になりました。しかも、サーマルスロットリングも発生せず、高回転空冷による騒音も発生せず、保守性も損なうことなく動作します。AI推論、機械学習トレーニング、高性能シミュレーションワークロードを大規模に展開する組織にとって、Grandoはまさに稀有な存在です。密度、熱効率、信頼性のどれかを選択する必要のないサーバーなのです。
コミノ・グランドの仕様
下の表は、Comino Grandoプラットフォームの物理仕様とサポートされるハードウェア構成を示しています。
| 仕様/機能 | コミノ・グランド |
|---|---|
| コミノ・グランドサーバー&ラックマウント型ワークステーション | |
| 冷却能力 | 6.5kW(最大出力6,500W、吸気温度20℃時) |
| マザーボード | EATXとEBBまで |
| GPU(サーバー) | 最大8個まで。 NVIDIA: RTX A6000、RTX 6000 ADA、RTX PRO 6000、A40、L40、L40S、A100、H100、H200 |
| GPU(ラックマウント型ワークステーション) | 最大6個まで。 NVIDIA: 3090、4090、5080、5090、RTX A6000、RTX 6000 ADA、RTX PRO 6000、A40、L40、L40S、A100、H100、H200; AMD: W7800、W7900 |
| CPU | 最大2個まで。 シングルソケット:Intel Xeon W-2400/2500 & 3400/3500、Intel Xeon Scalable 第4世代、第5世代、XEON 6、AMD Threadripper PRO 5000WX、7000WX、9000WX、AMD EPYC 9004/9005 デュアルソケット:Intel Xeon Scalable 第4世代および第5世代、XEON 6、AMD EPYC 9004/9005 |
| RAM | 2TBまで |
| M.2ドライブ | 最大8台のNVMe |
| Storage | 背面パネルのホットスワップケージ:最大4台のホットスワップ対応SSD(7mm厚4台または15mm厚2台)と、4台目の電源ユニットの代わりにさらに最大4台(7mm厚4台または15mm厚2台)を搭載可能。 内部3.5インチケージ、最大4x 3.5インチまたは4x 2.5インチ 15mmまたは12x 2.5インチ 7mm。 内部2.5インチスロット:最大4台の2.5インチSSD(7mm厚) |
| 電源および動作電圧 | 最大4台の2000Wホットスワップ対応CRPS(180~264V) 最大4台の1000Wホットスワップ対応CRPS(90~140V) 冗長モード:4+0、3+1、2+2 |
| 騒音レベル | 39dB-70dB |
| LAN | マザーボード上で最大2x 10 Gbit/s、PCIeで最大400Gbit/s |
| OS | Ubuntu / Windows 11 (Pro/Home) / Windows Server |
| 物理的および冷却に関する仕様 | |
| 液体冷却 | CPUとVRM、GDDRとVRMを搭載したGPU |
| 貯水池 | Cominoカスタム450ml(ポンプ内蔵型) |
| 扇 | 3x 超高流量 6200RPM (高騒音レベル) または 高流量3000RPM(低騒音レベル)×3 |
| 設置 | 19インチラックマウント可能、またはワークステーションとしてスタンドアロンで使用可能 |
| 必要なラックスペース | 4U |
| サイズ | 439 x 681 x 177mm(取っ手および突起部を除く) |
| 重量 | GPU 4個:正味重量49kg、総重量67kg GPU 6個:正味重量52kg、総重量70kg GPU 8個:正味重量55kg、総重量72kg |
| 動作温度および保管温度範囲 | 保管温度:-5~50℃ / 23~122°F 動作温度範囲:3~38℃ / 38~100°F |
| コミノ監視システム(CMS) | |
| 概要 | センサーとリアルタイム監視用ソフトウェアを搭載したコントローラーボード |
| 主な利点 | 冷却システムおよびCPU/GPUの監視、Webインターフェース、冷却システムログ、ワークグループ向け集中監視 |
| センサーおよび接続機器 | 温度(空気と冷却液)、湿度(%)、電圧、冷却液流量、リザーバー冷却液レベル、ファン、ポンプ、マザーボード、ディスプレイ、およびボタン |
| 統合の可能性 | REST API を介して監視を確立し、センサーデータを監視ソフトウェア (Zabbix、Grafana など) またはデータベース (InfluxDB など) に送信します。 |
| CMSの技術要件 | |
| OS | Windows 11/10 Ubuntu 22.04/20.4 (Ubuntuの依存関係: 対象システムにnvidia-smiおよびsensorsユーティリティがインストールされている必要があります) |
| Webブラウザ | Mozilla Firefox、Google Chrome、Chromium、Apple Safari、Microsoft Edge(注意:Internet Explorer 11はサポートされていません) |
| ハードディスクドライブ | 300MB |
| コントローラーファームウェアバージョン | 1.0.6以降 |
| コントローラー基板バージョン | 2.xx.xx |
設計、構築、およびGPU密度
シャーシのレイアウトと展開
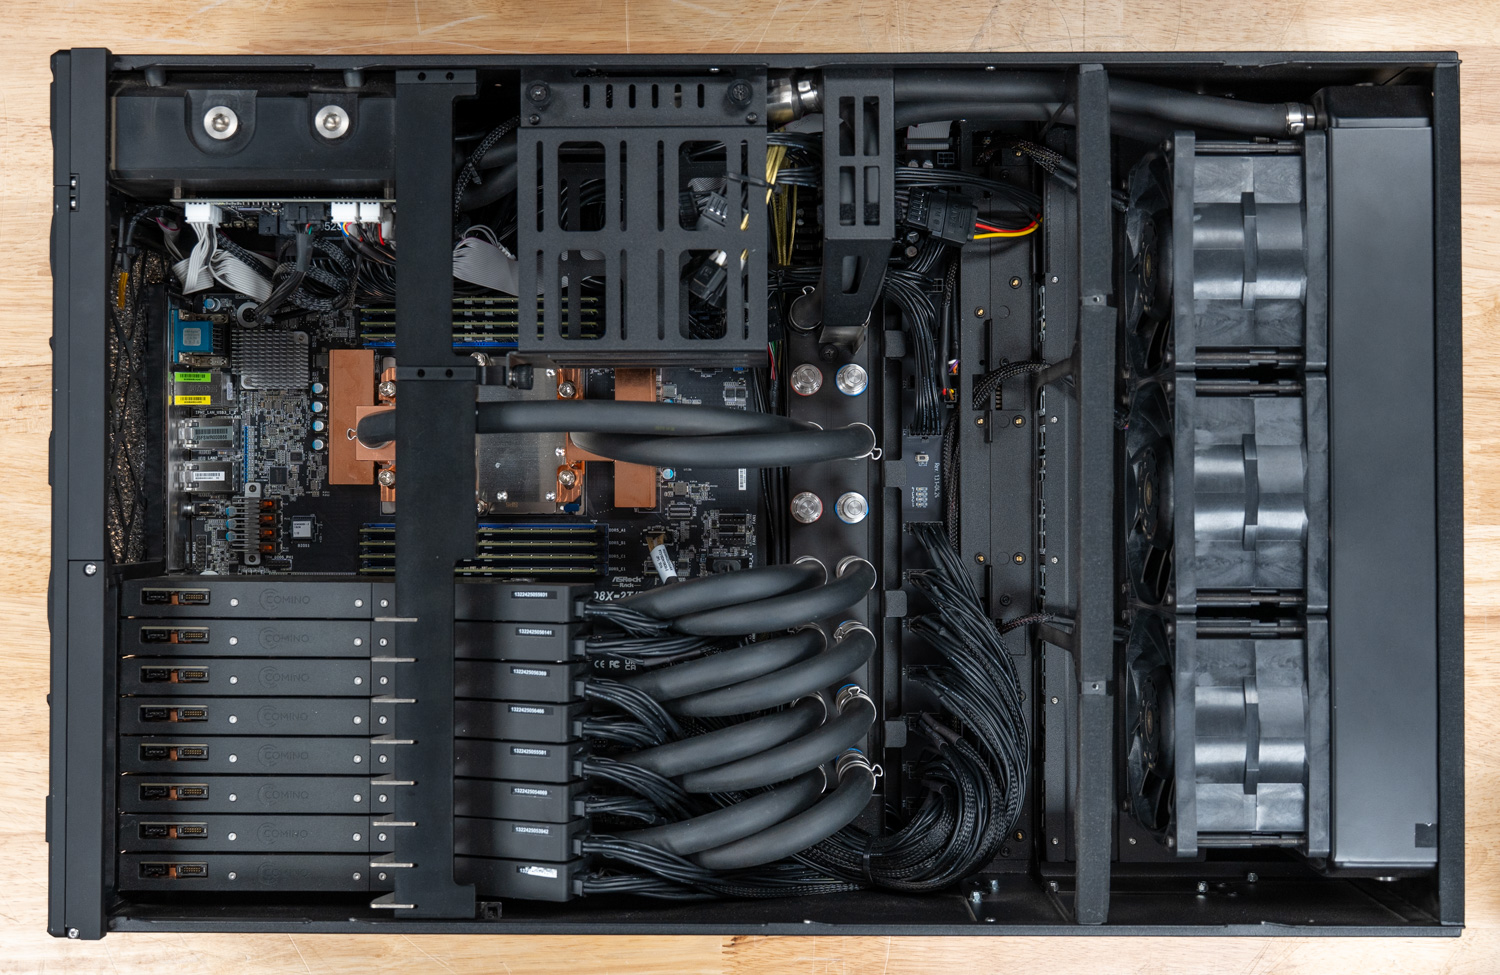
Grandoサーバーは、17.3 x 26.8 x 6.97インチ(4U)というコンパクトなサイズながら、スペース最適化の極みと言えるでしょう。従来のサーバーとは異なり、マザーボードの背面をシャーシの前面に配置することで、従来の内部レイアウトを逆転させています。これにより、RAMモジュールやVRMなどの空冷コンポーネントは、背面にある液冷ラジエーターに到達する前に、可能な限り冷たい吸気を受けることができます。
シャーシ自体も同様に厳格な基準に基づいて製造されており、頑丈なスチール構造にマットブラックのパウダーコート仕上げが施されています。このこだわりは、チューブ、ケーブル、ラジエーター、PCBのはんだマスクにも及び、全体を通してクリーンでプロフェッショナルな美観を追求した明確な意図が反映されています。さらに、このシステムは多様な展開に対応しており、19インチラックマウントユニットとしても、スタンドアロンのデスクトップユニットとしてもシームレスに機能します。構成によって重量は148~159ポンドです。
GPU冷却プレートとウォーターブロック
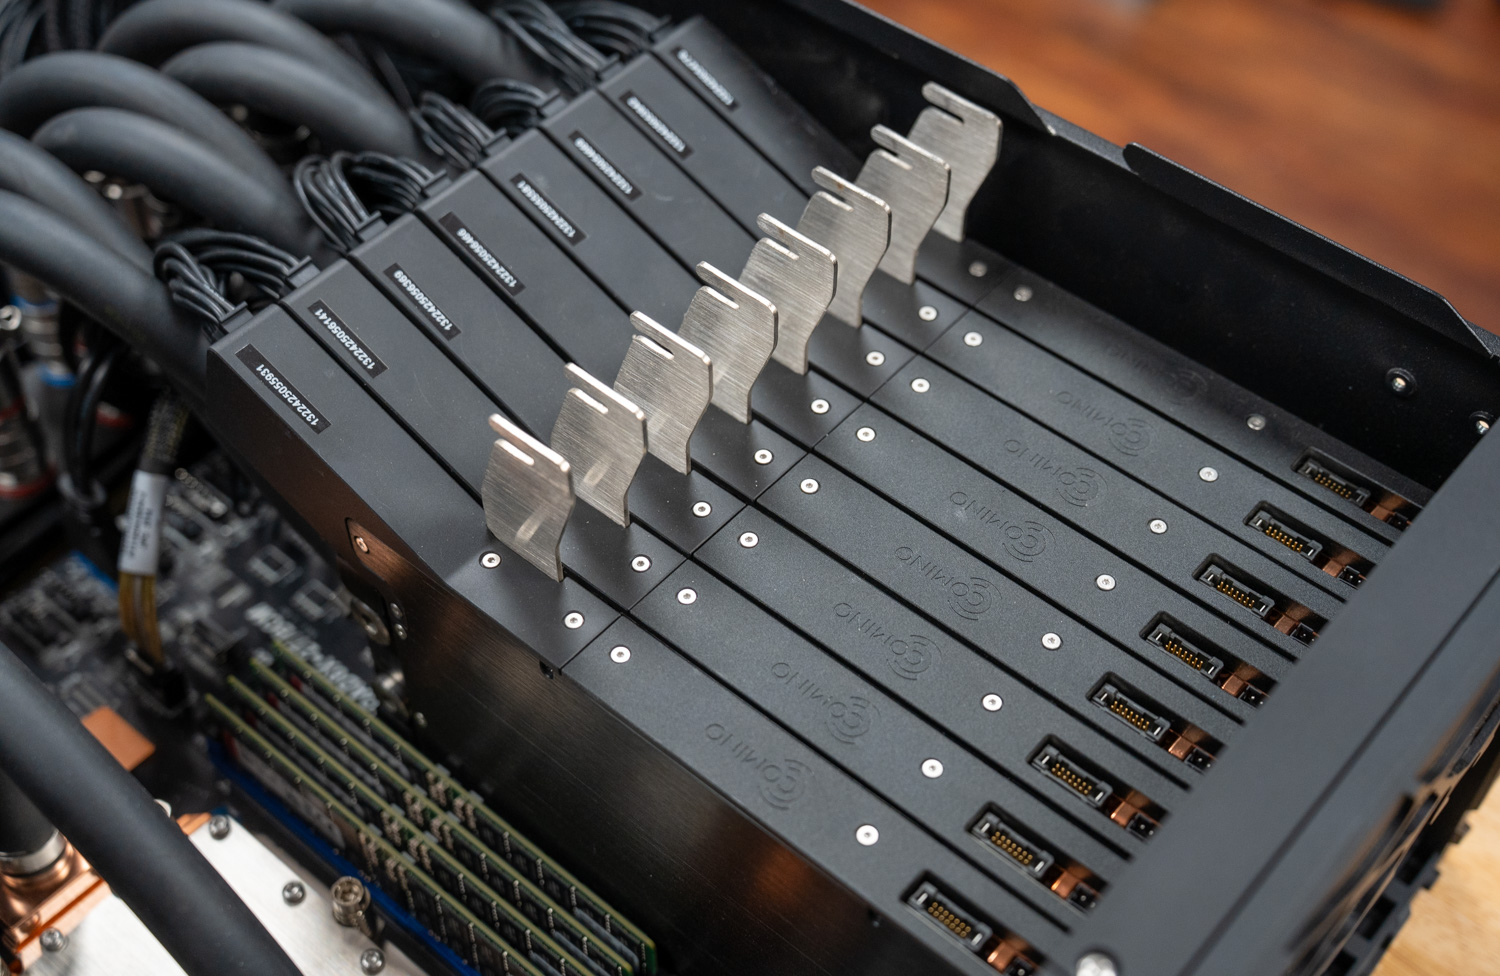
Grandoの高密度冷却の中核を成すのは、独自の銅製ウォーターブロックで、GPUダイだけでなく、メモリや電圧レギュレータなどの他のコンポーネントも冷却します。各GPUは市販のカードとして出荷され、Cominoがカスタムのコールドプレートアセンブリを取り付けます。実際には、この薄型設計により各カードの設置面積が1スロットに縮小され、1つの4Uシャーシ内に6枚または8枚のプロフェッショナルGPUを並べて配置できます。レビューユニットには、TDPが600WのNVIDIA RTX PRO 6000 Blackwellカードが8枚搭載されており、フルロード時の冷却要件は合計4,800Wでした。
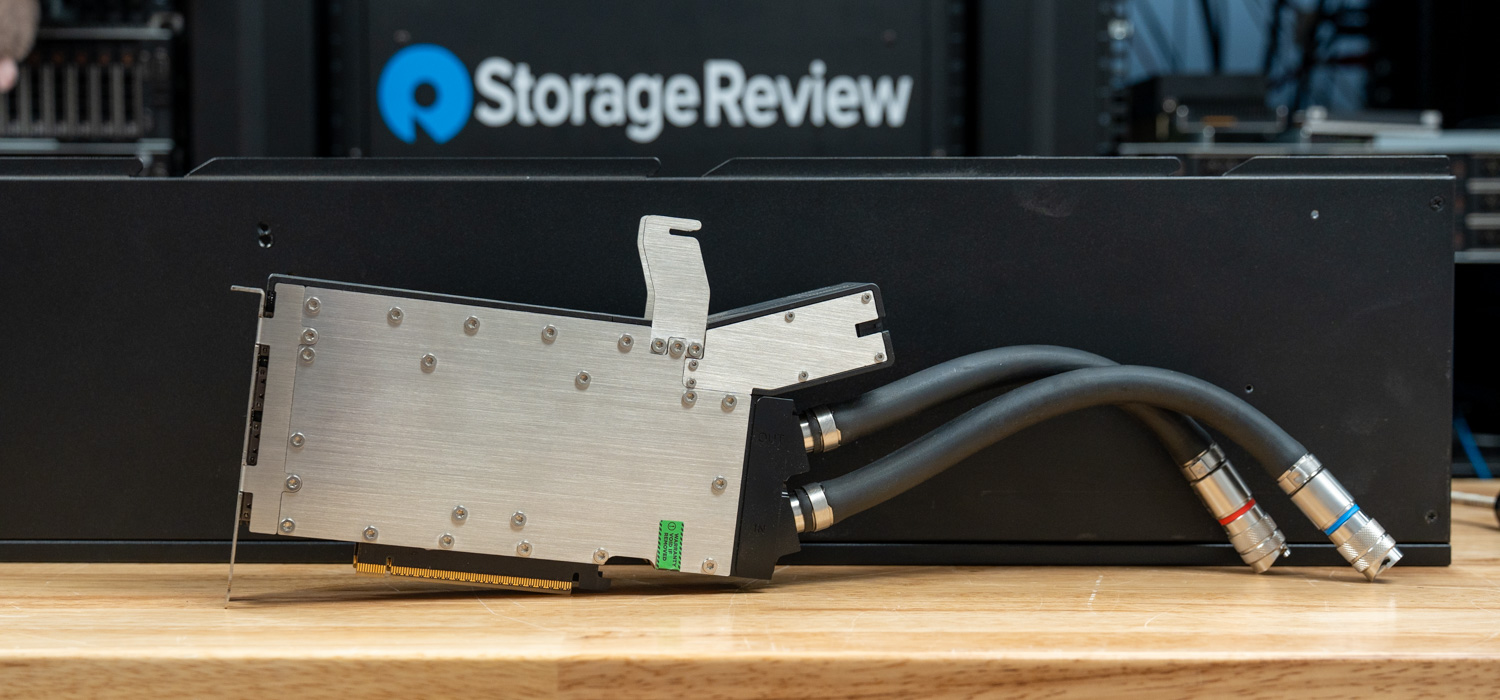
Cominoの8枚のシングルスロットGPU密度を実現するには、空冷ではほぼ不可能でしょう。なぜなら、標準のNVIDIA RTX PRO 6000カードはそれぞれ2スロットを占有し、相当なエアフローを必要とするからです。それに対し、このカスタム冷却カードはそれぞれ1スロットしか占有しません。冷却プレートは頑丈に作られており、各カードにかなりの重量が加わりますが、その重量はこのレベルで求められる品質と冷却性能を反映しています。
各GPUペアは専用のサブマニホールドを通して配管され、両方のカードがメイン冷却マニホールドへの単一の入口および出口接続に統合されます。このペア方式により、ループ全体の構造が簡素化され、メインマニホールドの接続数が削減されるとともに、技術者はクイックディスコネクトカップリングのペアを1組外すだけで2枚のカードを一度に取り外すことができ、メンテナンスがさらに効率化されます。
水の分配と分配
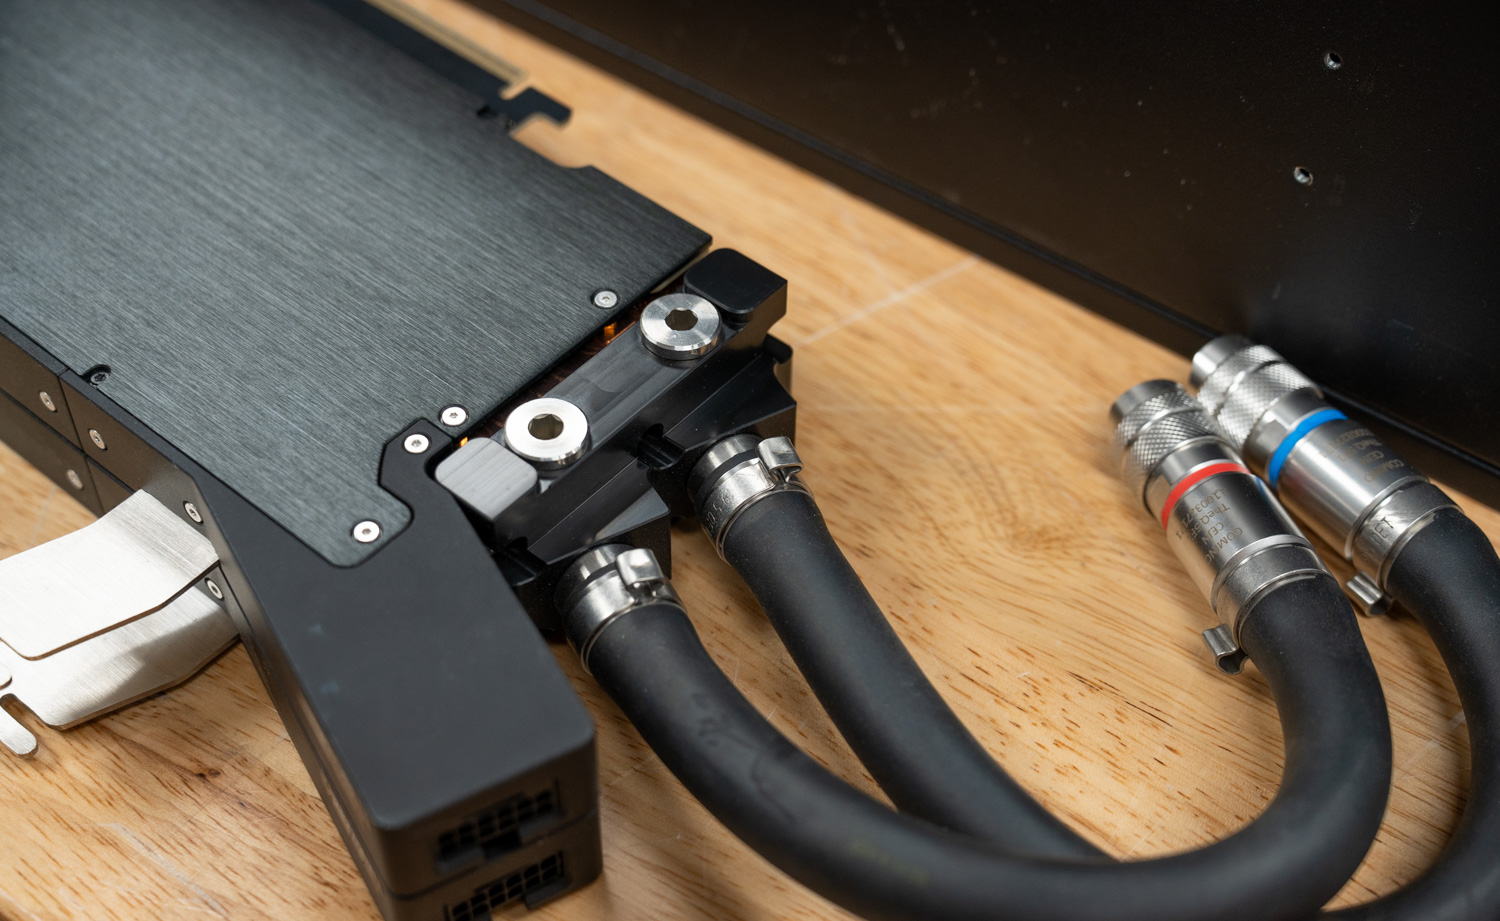
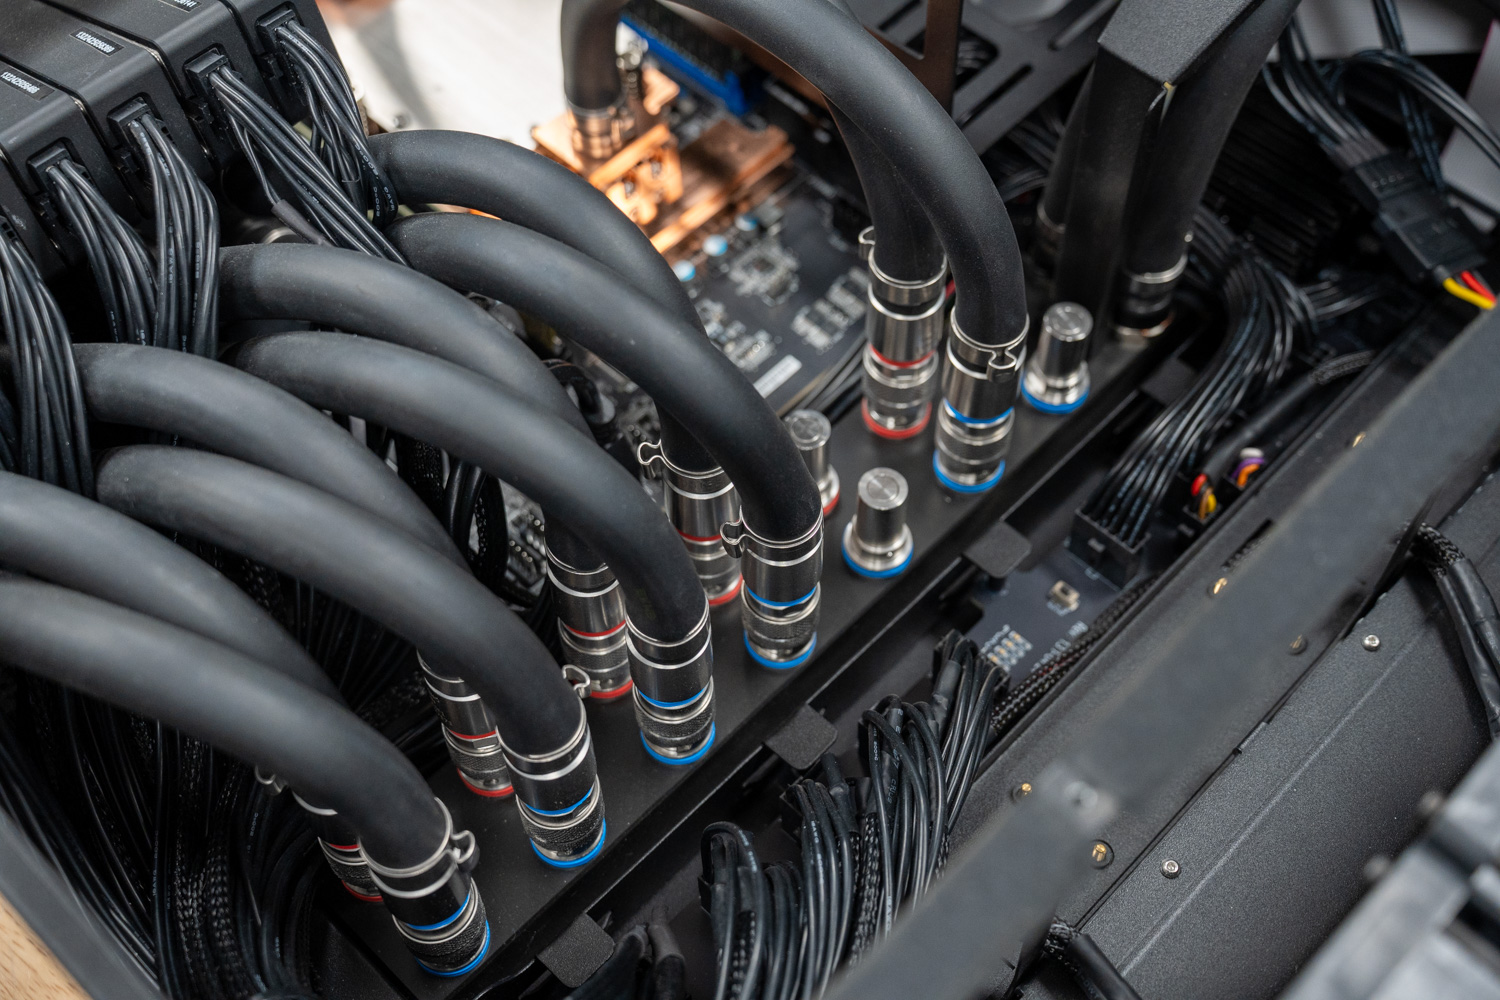
システムの中心には、各GPUとCPUの冷却プレートに冷却液を供給し、ラジエーターへの戻り経路を提供する大型の給水マニホールドが配置されています。マニホールドとGPUおよびCPU間の接続には、Comino社の「TheQ」クイックディスコネクトカップリングが使用されています。これらのステンレス製液だれ防止継手は、ループの高温側と低温側を明確に識別できるよう、赤と青のリングで色分けされており、設置時やメンテナンス時の混乱を解消します。
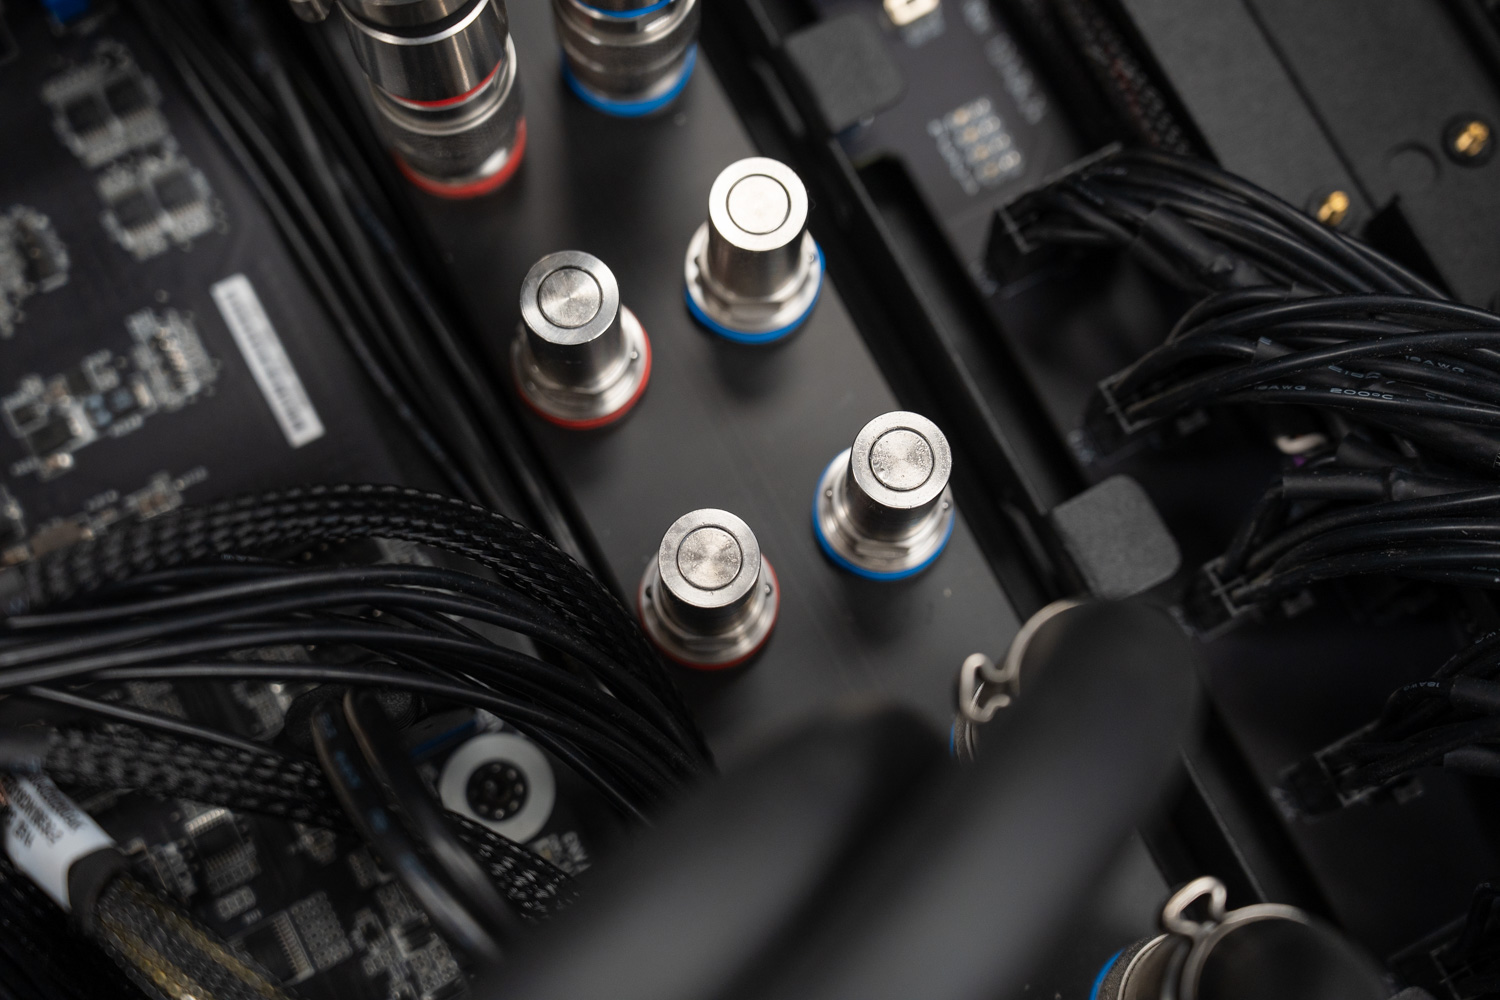
取り外し時に接合面に残る残留物は最小限に抑えられるため、技術者は450mlのリザーバーやループ内の残りの冷却液を抜くことなく、個々のGPUやCPUを取り外したり交換したりできます。このように、Grandoは空冷システムのメンテナンスの容易さを、高性能な液冷プラットフォームにもたらします。
CPU冷却とメモリ
CPUとその電圧レギュレータも、冷却ループに直接接続された専用のコールドプレートの恩恵を受けており、負荷の高いマルチGPUワークロード時にプロセッサがボトルネックになるのを防いでいます。レビューに使用したユニットには、AMD EPYC 9474F 48コアプロセッサを1基搭載したAMD Turin/Genoaボードが付属していました。コールドプレートは、カードのコールドプレートと同様に、純銅から削り出され、ステンレス鋼製の金具で固定されています。
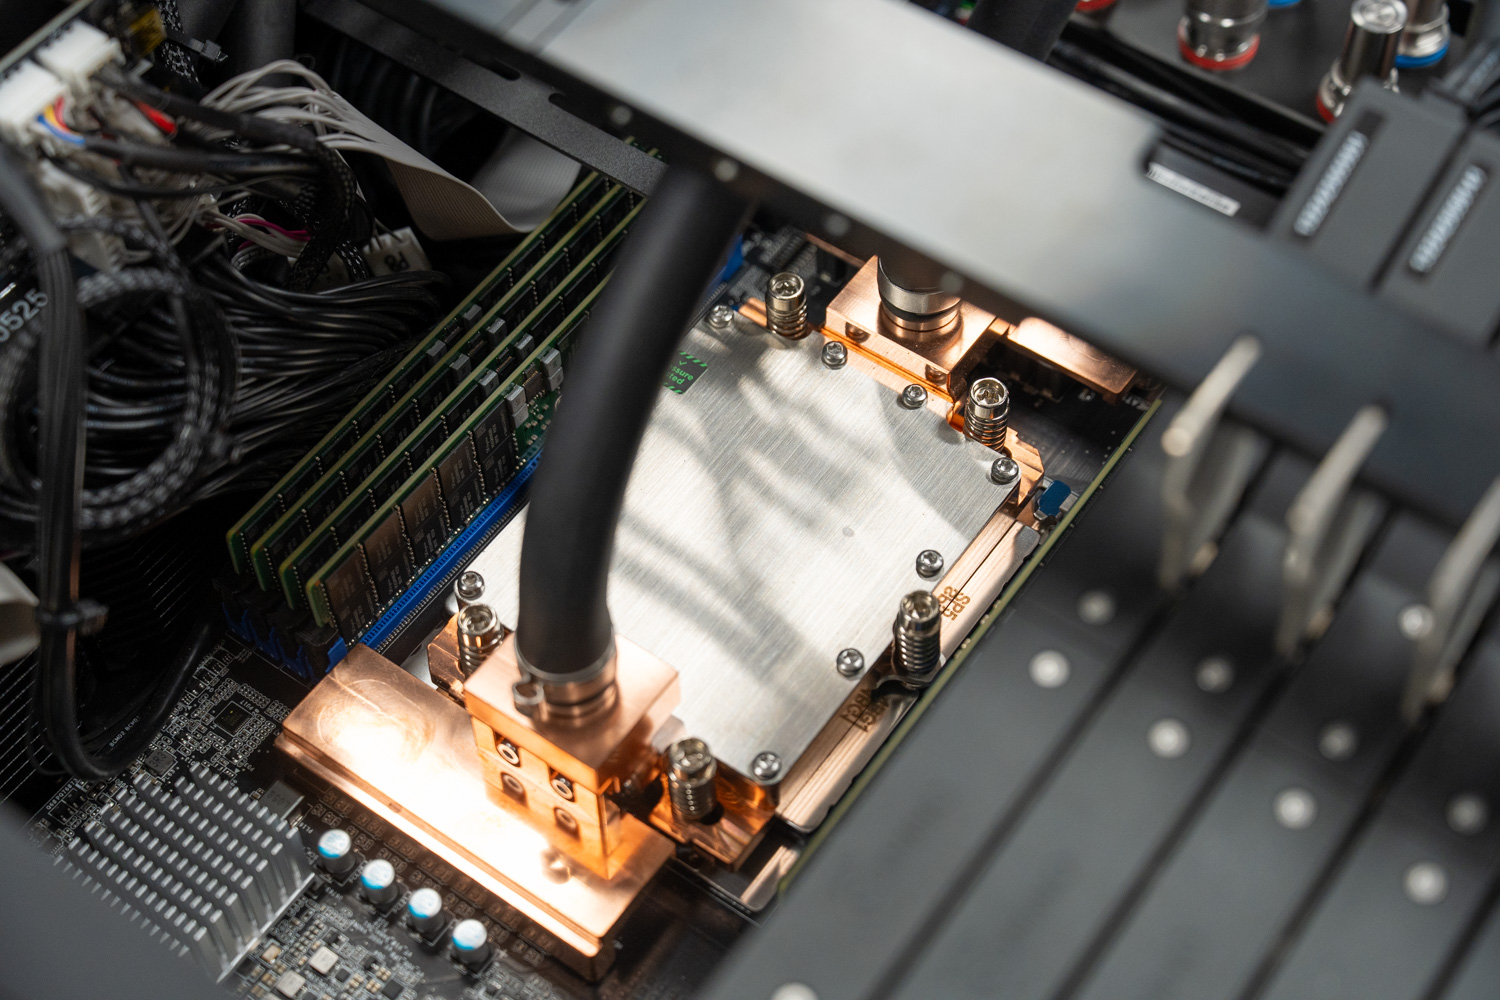
CPUの両側には、最大2TBのRAM構成に対応する8つのDRAMスロットが配置されています。レビュー機には512GBのDDR5 RAMが搭載されていました。シャーシのGPUとCPUエリアの上部には、それらに垂直に渡ってサポートバーが配置されており、GPUなどの繊細なコンポーネントを固定し、輸送中のシャーシの剛性を維持します。
ラジエーターとファン
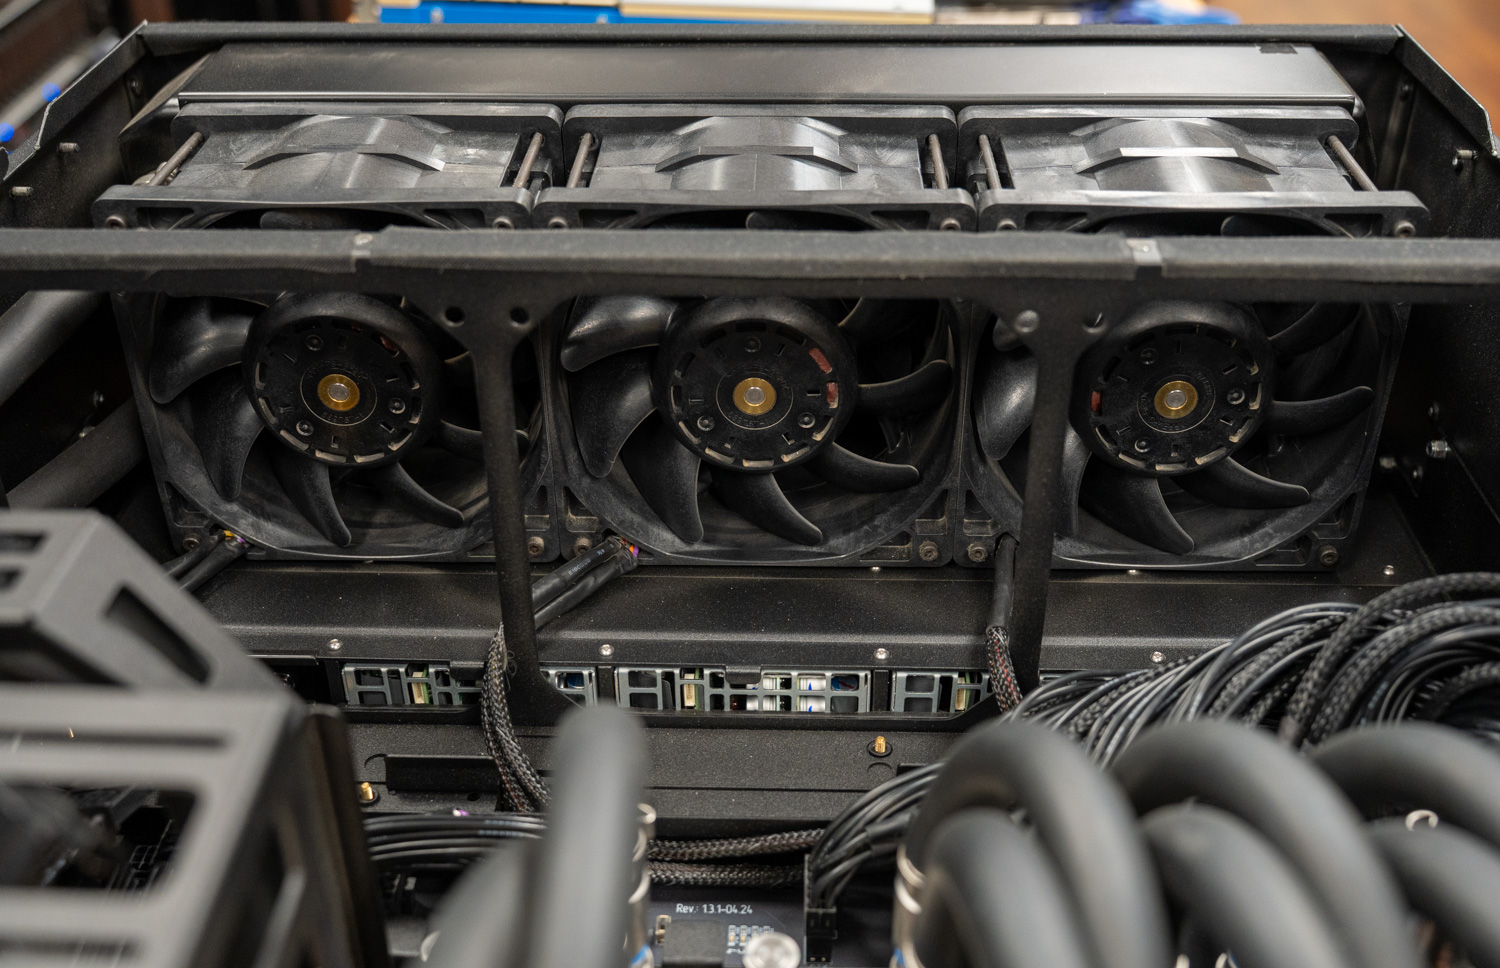
冷却は、シャーシ背面に搭載された大型の140mmラジエーター3基と、最大6,200RPMの回転速度と最大1,000m³/hの風量を実現する3基の高速140mmファンによって行われます。厚みのあるラジエーターによって実現された高密度フィンスタックは、プラットフォームに設計された熱的余裕を強調しており、今回の構成では最大6.5kWの持続的な熱を放散するように設計されています。
おそらく最も驚くべき点は、その負荷とファンの回転速度にもかかわらず、このユニットは許容範囲内の騒音レベルを維持していることであり、最大回転時でも騒音レベルは70dB強にとどまっている。これはワークステーションの基準ではうるさい方だが、小型電気炉並みの熱出力を放散するシステムとしては驚くほど抑えられており、Cominoの液冷ループがいかに効率的にコンポーネントから熱を逃がしているかを示している。
フロントパネルとテレメトリディスプレイ
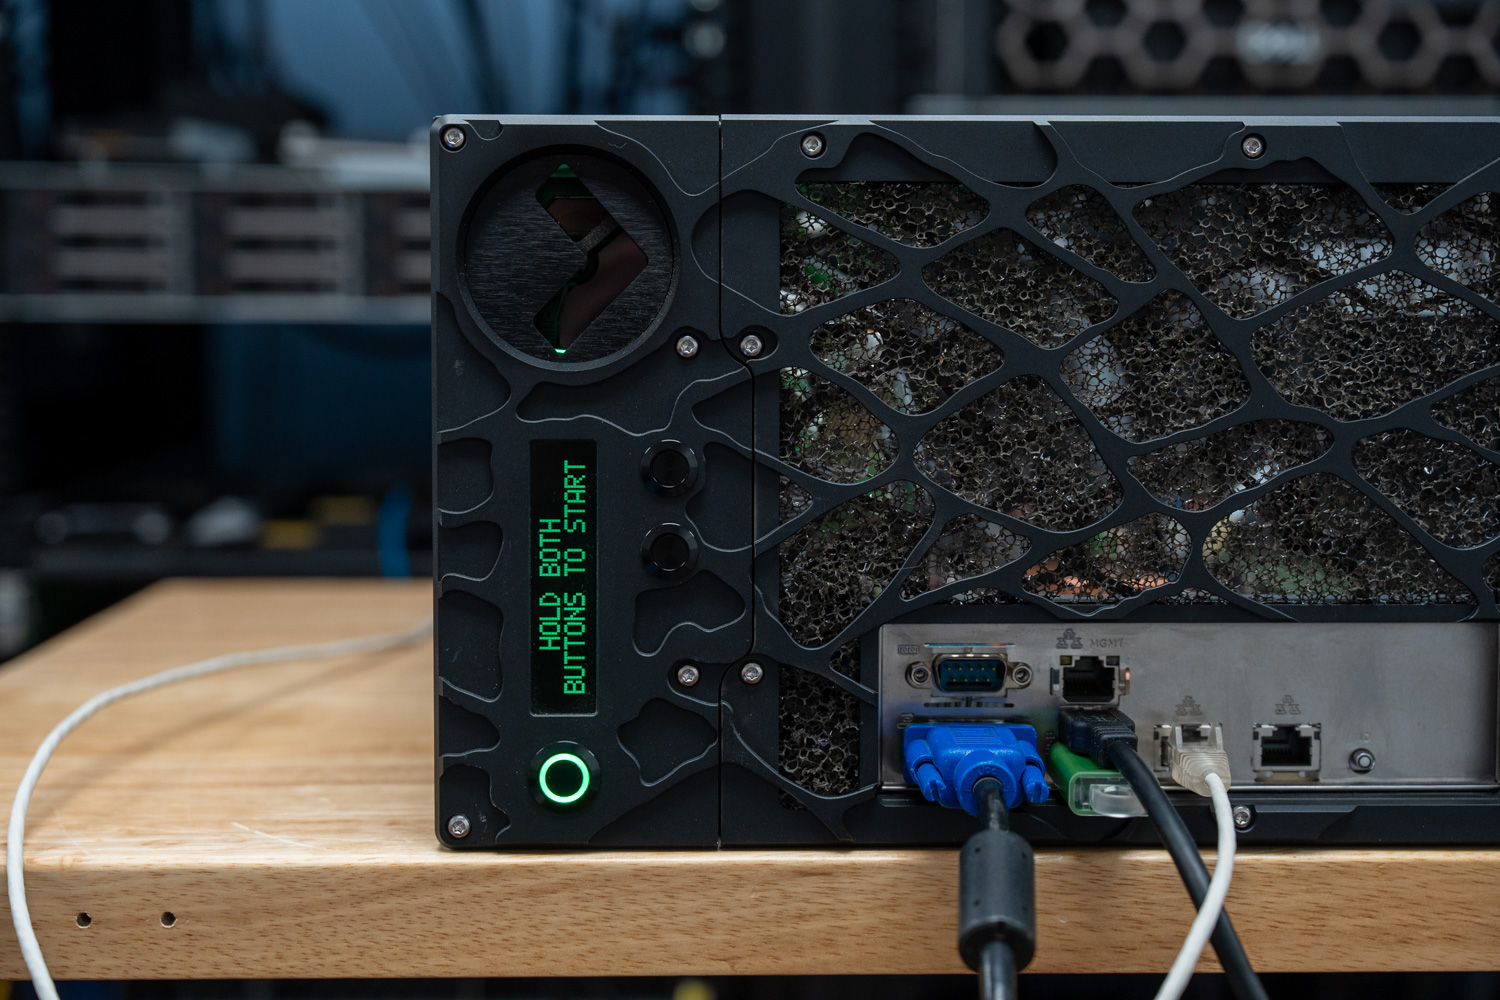
前面パネルにはLEDディスプレイが搭載されており、ポンプの状態、周囲温度、冷却液温度、ファン速度など、主要なテレメトリデータをリアルタイムで表示します。ユーザーは冷却モジュール上の点灯式ボタンを使ってメニューを操作し、短く押すと利用可能なデータをスクロールできます。PB2ボタンを長押しすると、コマンド、サービス設定、イベントログなどの追加メニューが表示されます。さらに、前面I/Oパネルには、ディスプレイ出力用のVGAポートに加え、シリアルポート、複数のUSBポート、周辺機器やデバイス接続用のネットワーク接続端子が備わっています。
電力およびストレージアーキテクチャ
電力供給と冗長性
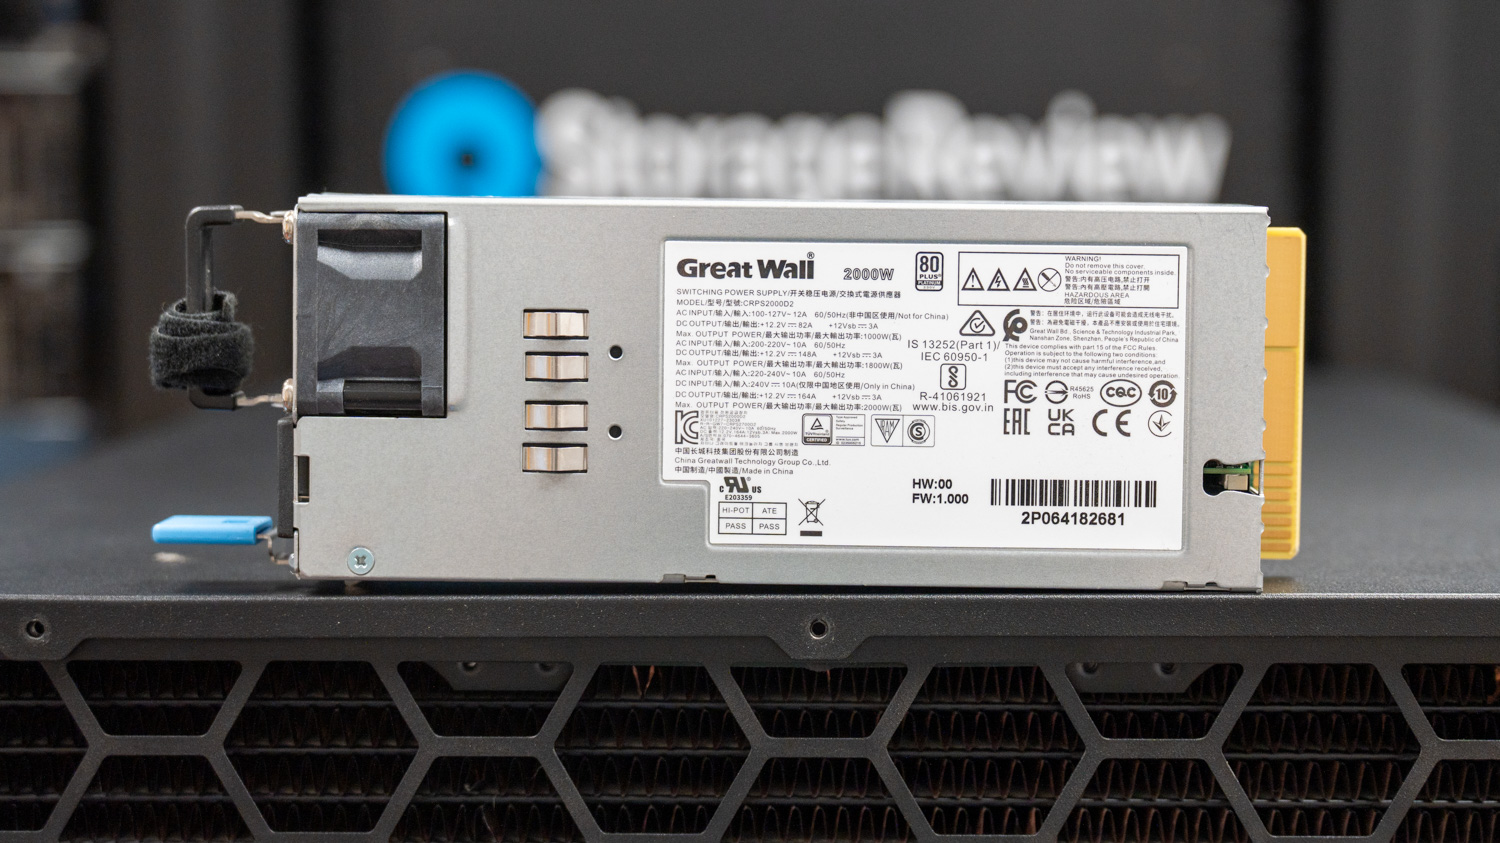
このレベルのコンピューティングを支えるには、同様に堅牢な電力供給が必要です。Grandoは、冗長構成で最大4つのホットスワップ対応1000Wまたは2000W CRPSモジュールをサポートし、180~264Vで最大8.0kWの電力を供給します。4+0、3+1、および2+2の冗長モードをサポートしているため、電源ユニットの障害にも耐え、24時間365日のAIおよびHPCワークロードに対して継続的な動作を維持できます。
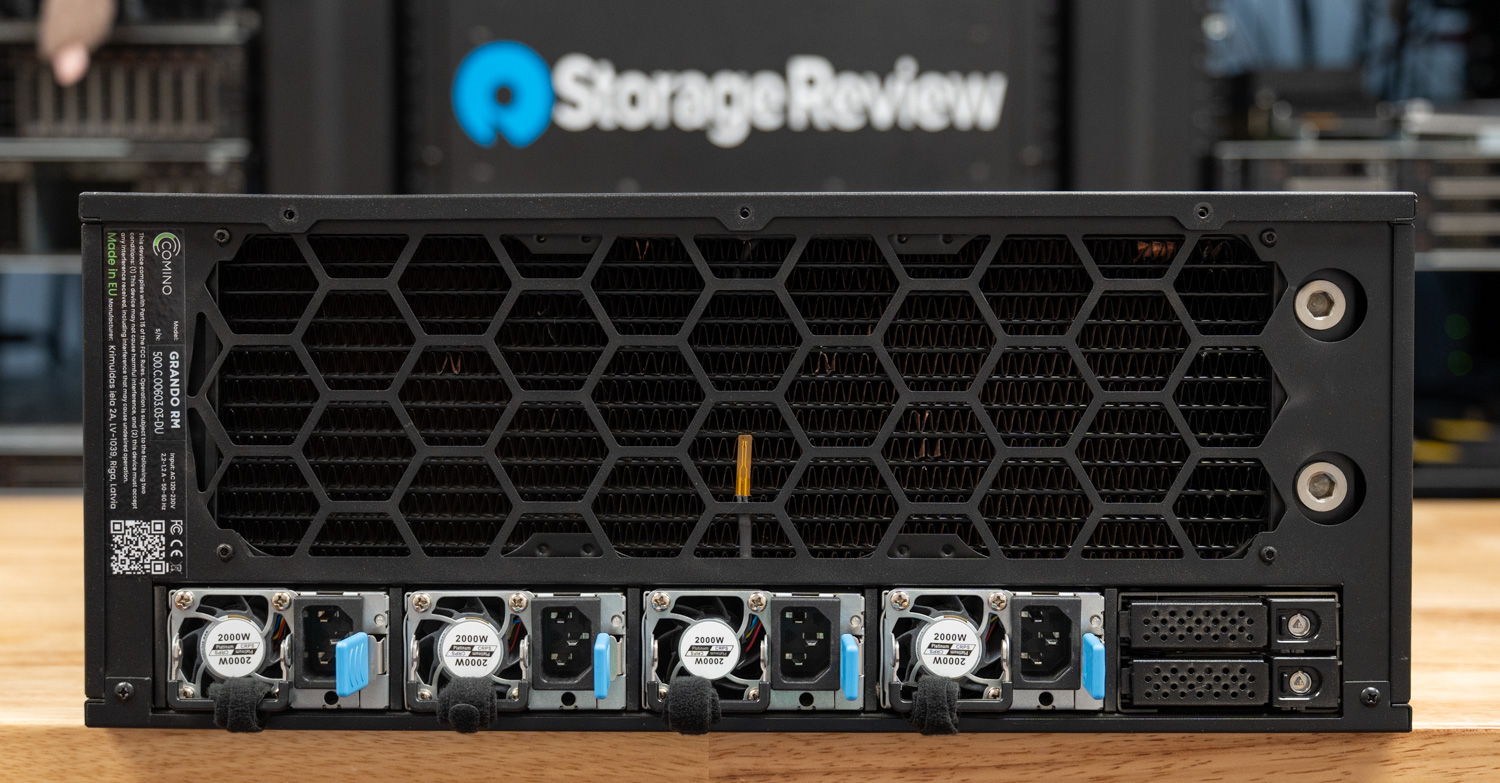
今回レビューしたユニットには、Great Wall製の2000W 80 Plus Platinumホットスワップ対応電源が4台付属しており、合計8.0kWの構成となっていました。
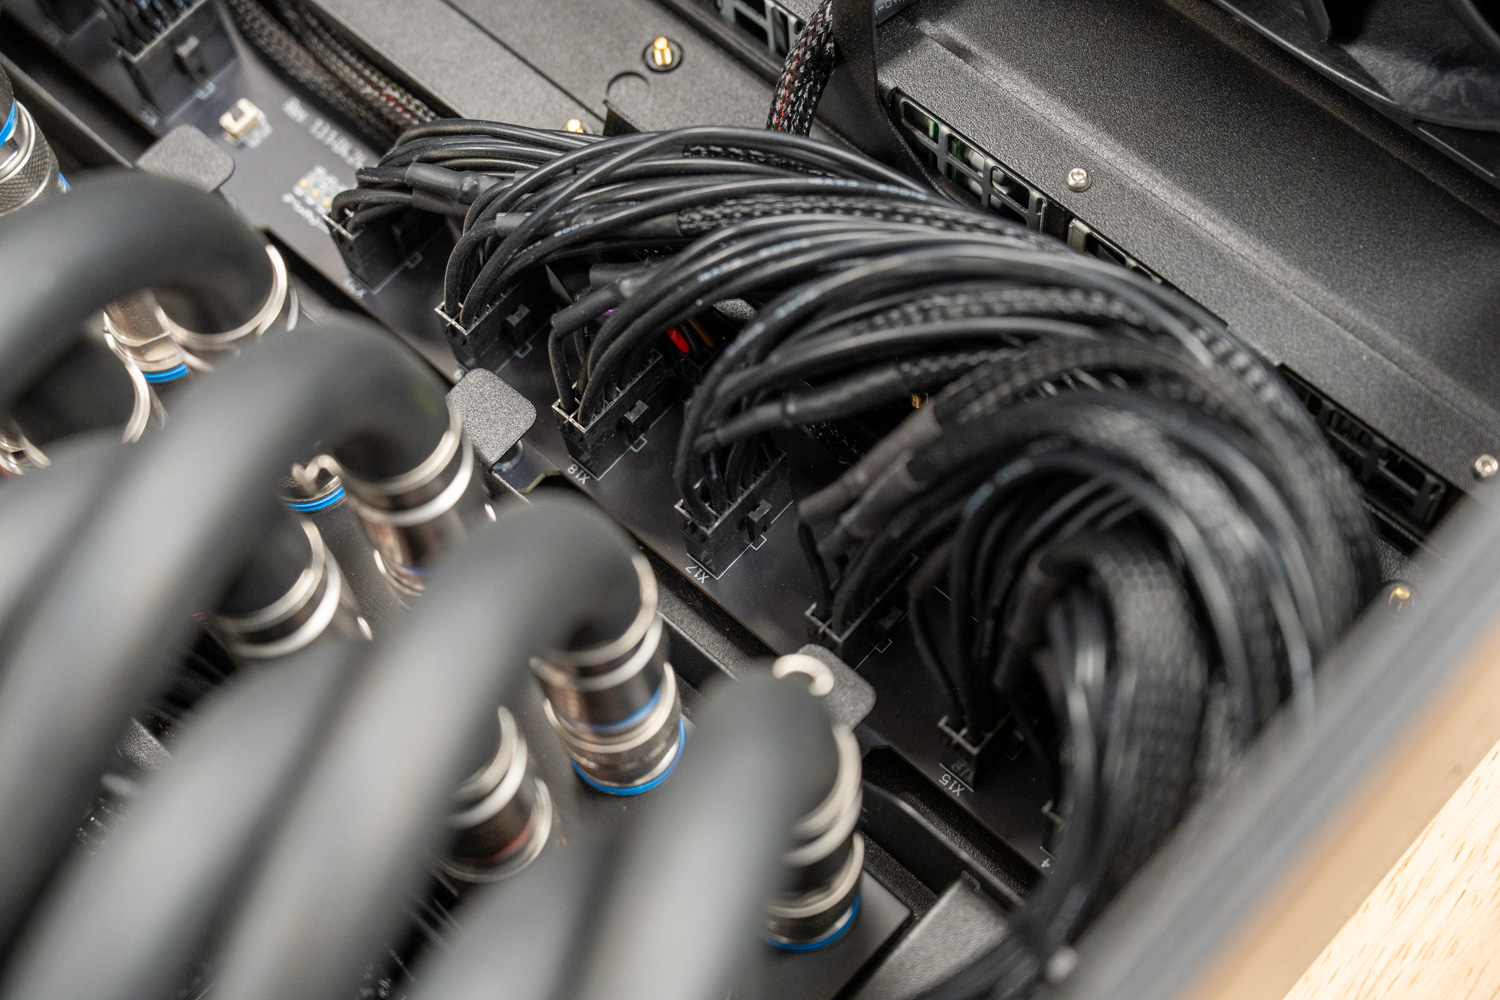
各GPUへの電力供給は、GPUアレイとメインケーブルの間に設置された中央集中型の12ピン電源分配基板を介して行われます。Grandoはこの分配基板を使用して、入力される電源を集約し、整理された省スペースな方法で各GPUに分岐させます。
PCIe、ストレージ、およびネットワーク
Grandoはスロット帯域幅を損なうことなく6つのGPUを快適にサポートし、シャーシは最大密度を実現するために8枚のカード構成まで拡張できます。CominoのASRock Rack GENOAD8X-2T/BCMマザーボードは、7つのx16および1つのx8 PCIe Gen 5スロットを備えているため、8つのGPUのうち7つはフルx16帯域幅で動作し、8枚目のカードはx8で動作します。これは、シングルソケットCPUがサポートできるPCIeレーンの数と、PCIeスイッチプレートのサイズ、コスト、複雑さを追加することに対するCominoの消極的な姿勢との間のトレードオフです。デュアルソケットマザーボードに移行すると、より多くのPCIeレーンが提供されますが、スペースが限られたフォームファクタでは2番目のソケットがPCIeスロットで使用されるスペースを占有するため、スロット数はさらに少なくなります。
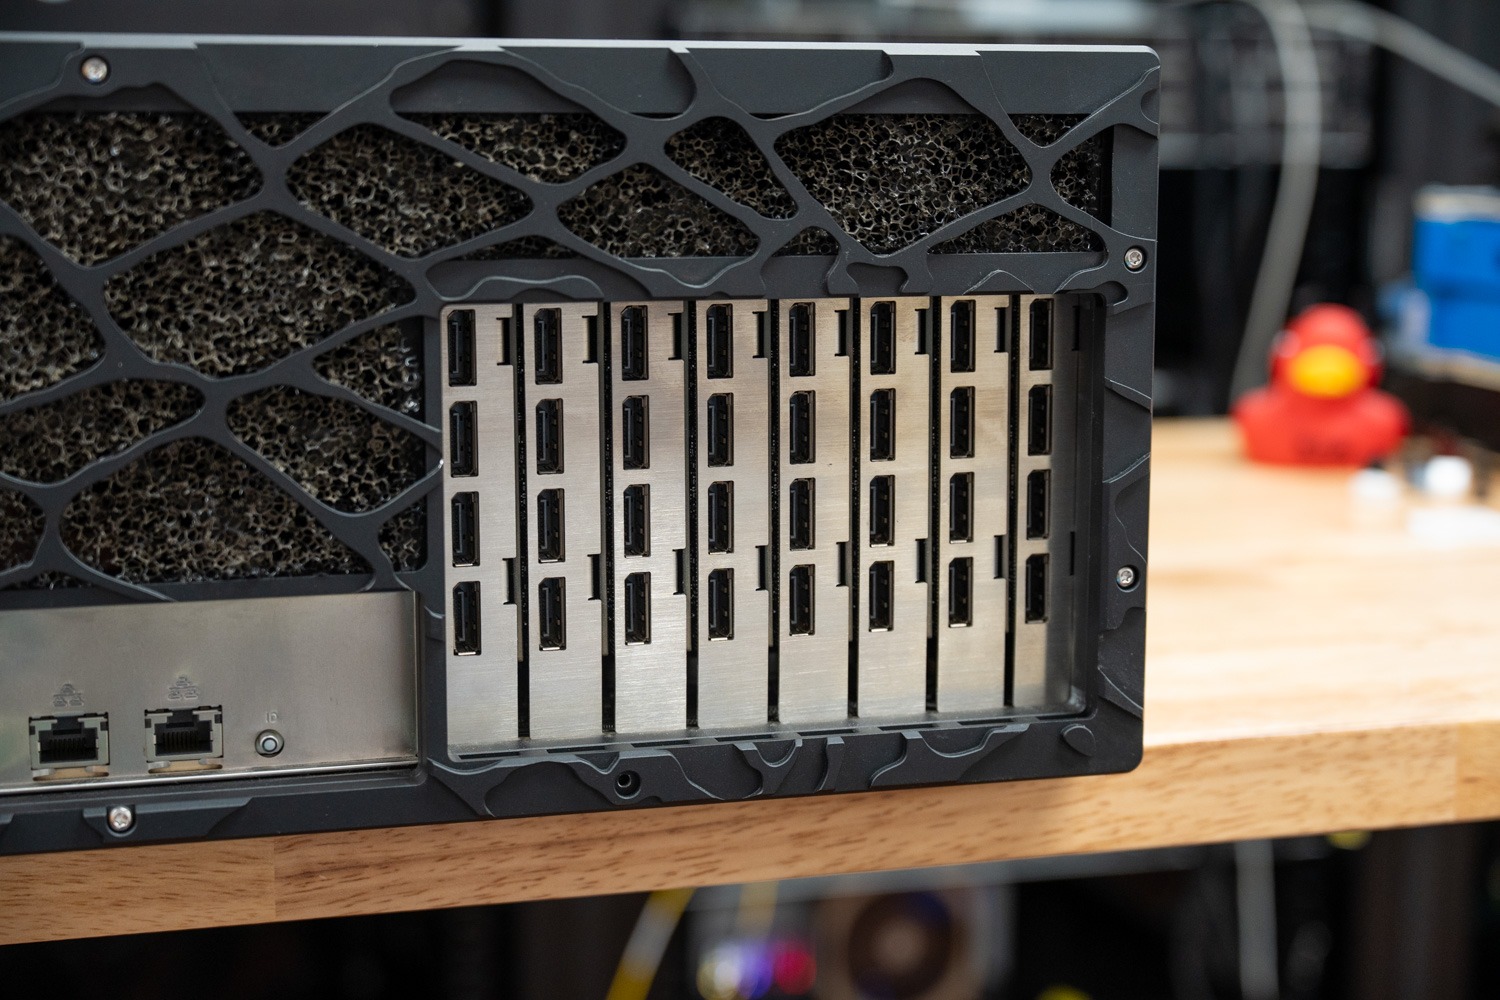
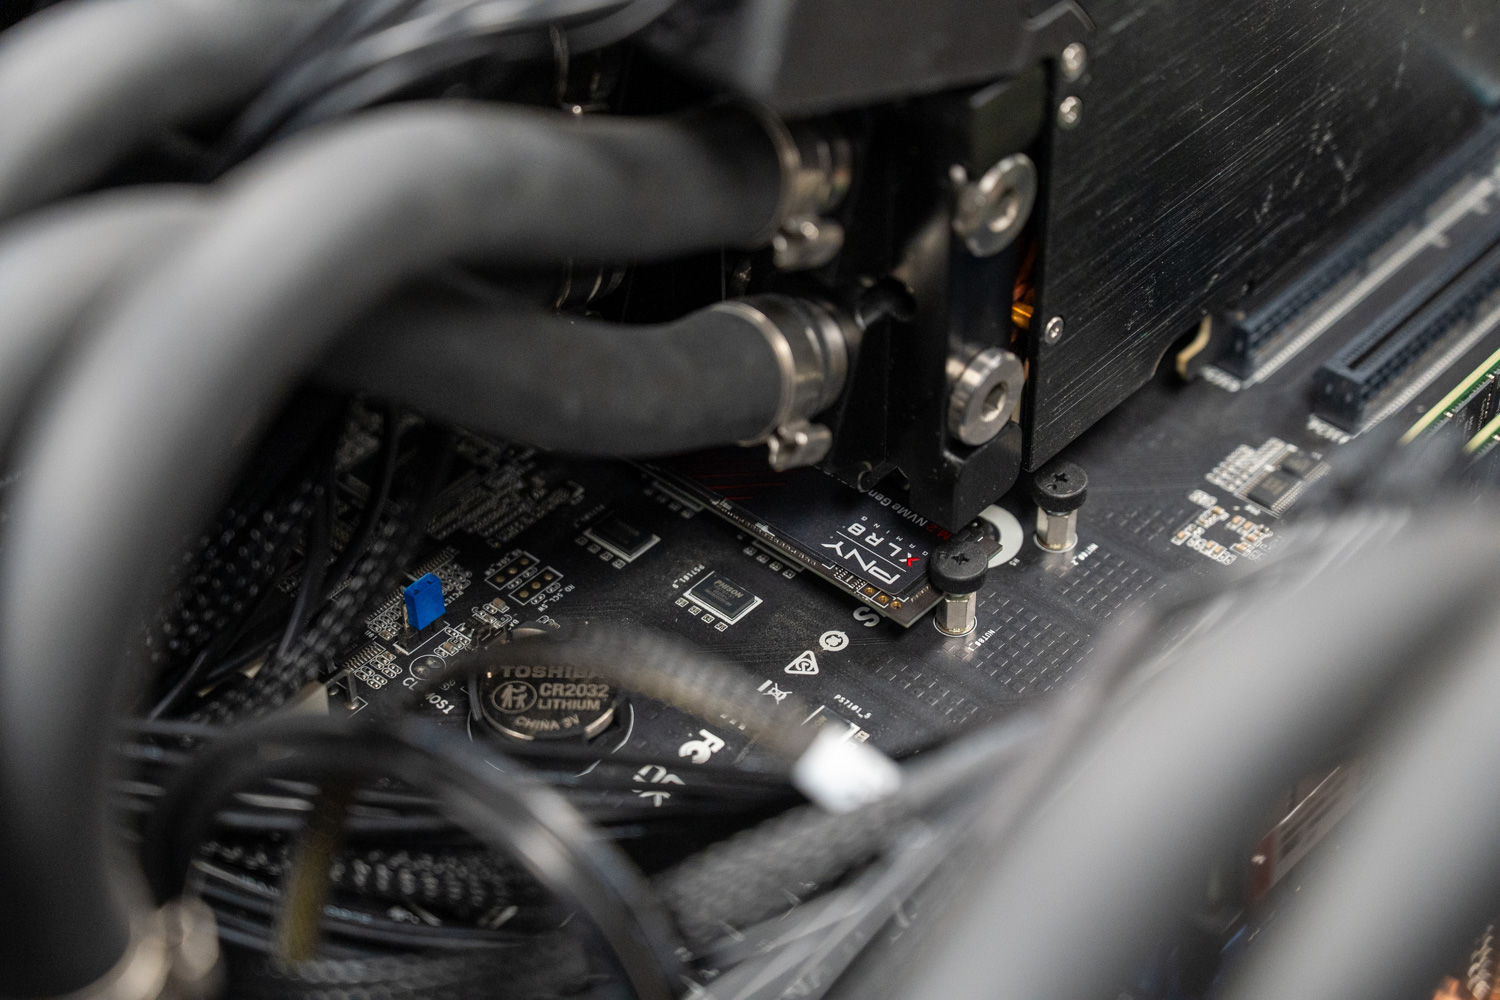
シングルソケットシステムで 8 基の GPU を実行すると、利用可能な PCIe レーンの大部分が消費され、トレードオフが生じます。レビュー対象の AMD Genoa ベースのユニットには、合計 128 レーンの PCIe Gen 5 が利用可能です。8 基の GPU がそのうち 120 レーンを消費するため、残りの 8 レーンは M.2 SSD スロットごとに x4 で分割されます。そのため、8 基の GPU と、シャーシ背面の 2 つの MCIO コネクタを介して接続された NVMe ドライブのフルセットを同時に実行することはできません。8 基の GPU をフル構成にした場合、ストレージに使用できる M.2 スロットは 2 つだけでした。最大 GPU 密度に加えて追加の NVMe 容量が必要な管理者は、背面パネルのケージを介して背面ホットスワップ NVMe ストレージを追加すると、追加の PCIe レーンが消費され、システム内の GPU 容量の一部が無効になることに注意してください。
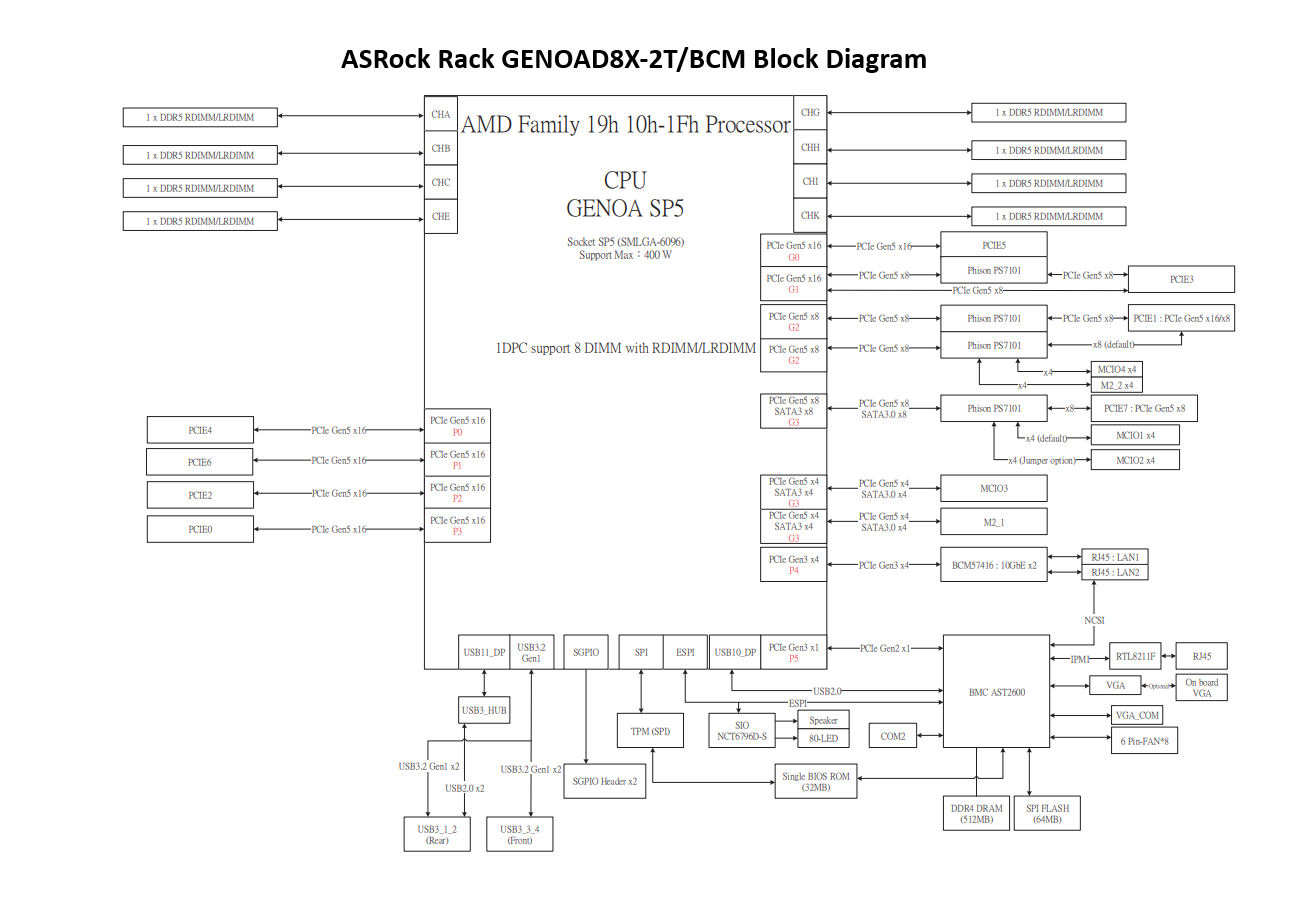
ASRock Rack GENOAD8X-2T/BCMマザーボードのブロック図。CPU、PCIe Gen 5スロット、DIMMチャネル、M.2スロット、BMC、USB、SATA、およびネットワーク接続を示しています。
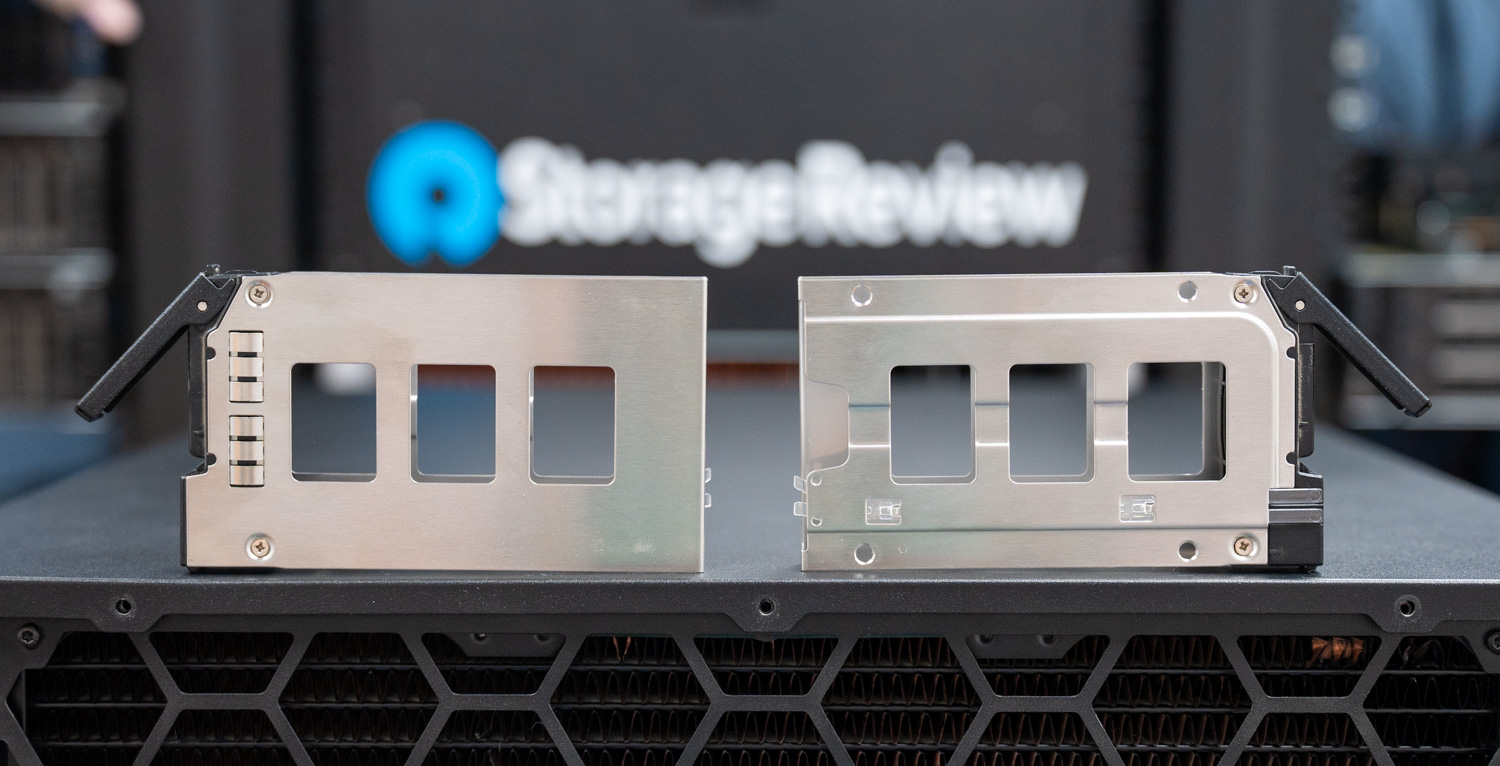
とはいえ、ストレージも同様にモジュール式で拡張性がありますが、構成によって GPU の PCIe レーンの予算に影響するため、想定される使用ケースに合わせて計画しておく価値があります。レビューユニットの背面パネルには、4 x 7mm または 2 x 15mm の構成で最大 4 台の 2.5 インチ SSD をサポートする 2.5 インチ ドライブ ケージがあり、オプションで 4 番目の PSU スロットの代わりに最大 4 台の 2 番目のセットを使用できます。レビューユニットでは、8 枚の GPU 構成をサポートするために 4 つの電源ベイすべてが必要だったため、2 つのホットスワップ ベイのうち最初のベイしか使用できませんでした。シャーシ内部では、最大 4 台の 3.5 インチ ドライブ、4 台の 2.5 インチ 15mm ドライブ、または最大 12 台の 2.5 インチ 7mm ドライブを収容できる 3.5 インチ ケージをサポートでき、構成によっては 4 つの追加の内部 2.5 インチ 7mm SSD スロットも使用できます。
ネットワーク接続に関しては、マザーボード上にBroadcom BCM57416を搭載したオンボードRJ45 10Gb/sポートが2つ標準装備されており、専用のギガビットイーサネットIPMI管理ポートも備えています。管理者は、最大400Gb/sの高速ファブリック接続をサポートするPCIe NICをインストールすることで帯域幅をさらに拡張できますが、追加のPCIe NICはGPUスロットを占有するため、システムがホストできるGPUの最大数が減少することに注意してください。
リモート管理とシステムインテリジェンス
ハードウェアを保護し、パフォーマンスを最適化するために、本システムにはCominoモニタリングシステム(CMS)が搭載されています。独立した自律型コントローラボードがCMSを制御し、メインのオペレーティングシステムとは独立してサーバーの「頭脳」として機能します。実際には、このコントローラは、空気と冷却液の温度、湿度、冷却液流量、リザーバーレベルをリアルタイムで追跡する包括的なセンサー群を読み取ります。重要なのは、この自律型設計により、CMSが自己診断を実行し、漏れやポンプの故障を検知すると緊急シャットダウンをトリガーできるため、高価な内部ハードウェアを損傷から保護できることです。
ウェブベースのGUIにより日常的な管理が可能になり、管理者はCPUとGPUの冷却性能、稼働時間、リアルタイムのエネルギー消費量を明確に把握できます。エンタープライズ規模の導入においては、CMSはZabbix、Grafana、InfluxDBなどの集中監視ツールとREST APIを介して接続することも可能です。これらの機能により、管理者は3年間のサービス間隔を維持し、高温環境下でもサーマルスロットリングを起こすことなくサーバーを最高の効率で稼働させることができます。
AIのその先へ:創造的かつ工学的な応用
今回のテストはAI推論ワークロードに焦点を当てたものですが、Grandoは、ローカルGPUコンピューティング能力を大量に必要とするクリエイティブプロフェッショナルやエンジニアにとっても同様に実用的な製品です。8枚のRTX PRO 6000カードに搭載された合計768GBのVRAMは、従来のワークステーション構成では実現できない性能を発揮します。
FXアーティストやモーショングラフィックスのプロフェッショナルは、膨大なテクスチャセットを持つ複雑なシーンをVRAM内で完全にレンダリングできるため、8K映像や高ポリゴン環境を使用する制作現場で問題となっていたディスクスワッピングのボトルネックを解消できます。計算流体力学や構造シミュレーションを実行するCADエンジニアは、モデルを複数の実行に分割することなく、これまでにない複雑なアセンブリを扱うことができます。マルチストリーム8K RAWタイムラインを扱うビデオエディター、フル解像度で機械学習ベースのノイズリダクションを適用するカラーリスト、クラウドファームの可用性を待つことなくローカルでパストレーシングによる最終レンダリングを行う3Dアーティストなど、すべてのユーザーがこの高密度なGPUメモリと演算能力の恩恵を受けています。
Grandoは、8基のGPU構成を必須としていません。Cominoは、4基、6基、8基のGPU構成でプラットフォームを提供しており、すべてのバリエーションが即時出荷可能です。小規模スタジオ、独立系クリエイター、エンジニアリングチームは、現在のニーズに合わせて投資規模を調整しながら、ワークロードの増加に合わせて明確なアップグレードパスを確保できます。
プラットフォームのトレードオフ:密度と拡張性
Grandoのコンパクトな設計は、標準的な4Uサイズの筐体内で優れたGPU密度と熱管理性能を実現していますが、その密度には、導入前に理解しておくべきアーキテクチャ上のトレードオフが伴います。
このシャーシはEATXおよびEEBフォームファクタのマザーボードに対応していますが、従来のデュアルソケットプラットフォームに見られるような拡張サーバーボードには対応していません。そのため、GPUアレイ以外の周辺機器に使用できるPCIeレーンの総数が制限されます。8基のGPU構成では、AMD EPYCプロセッサの128レーンのPCIe Gen 5レーンがほぼすべてGPUによって消費され、オンボードの10GbEポート以外に、追加のNVMeストレージや高速ネットワーク接続に利用できる帯域幅はほとんど残っていません。
これは、これまでレビューしてきたDell、HPE、Supermicroの8GPUプラットフォームとは対照的です。これらのシステムは、より大型のシャーシ、デュアルソケット構成、PCIeスイッチトポロジーを採用することで、はるかに多くの周辺機器接続をサポートしています。通常、フルGPU構成に加えて4~8個のNICまたはDPU、さらに8個以上のホットスワップ対応NVMeベイを搭載できるため、高帯域幅のファブリックインターコネクトを必要とする分散推論ワークロードに最適です。
しかしながら、こうした機能拡張には相当なコストがかかる。消費電力は8kWを超え、熱負荷に対応するためには専用のデータセンター冷却設備が必要となる。騒音レベルが高いため、専用のマシンルーム以外への設置は不可能である。さらに、エンタープライズ向けGPUプラットフォームの供給制約が続くため、納期は6ヶ月から18ヶ月に及ぶことも少なくない。
Grandoは、従来とは異なる位置づけにある。迅速な導入、管理しやすい運用環境、そして大規模な分散トレーニングよりも推論やクリエイティブなワークロードを優先する組織にとって、Grandoのトレードオフは多くの場合有利に働く。実際に作業できる環境でハードウェアをすぐに必要とするチームにとって、Grandoの高密度化へのアプローチは、到着しても現実的に導入できないプラットフォームを待つよりも実用的であると言えるだろう。
コミノ・グランドの性能テスト結果
システム構成
- シャーシ: コミノ・グランド
- マザーボード: ASRock ラック GENOAD8X-2T/BCM
- CPU: AMD EPYC 9474F 48C
- メモリ: 512GB DDR5
- GPU: NVIDIA RTX PRO 6000 x 8
- ストレージ: M.2 SSD
クロード・コード・サービング – ミニマックスM2.5
従来の生のLLM推論ベンチマークにとどまらず、ローカルでホストされたモデルを使用して複数のClaude Codeセッションを同時に処理する、エージェント型コーディングワークフローにおいて、このハードウェアがどの程度優れたパフォーマンスを発揮するかを評価したいと考えました。このユースケースは、開発チームの生産性に直接関係します。つまり、単一ノードから提供されるAIコーディングアシスタントを、何人のエンジニアが同時に使用しても、エクスペリエンスが低下する前にどれだけの人数が利用できるかということです。
これをテストするために、中程度の難易度のコーディング問題(LRUキャッシュの実装、CLI todoアプリケーションの構築、マークダウンコンバータの作成、REST APIの構築など)のデータセットを生成し、ローカルのvLLMサーバーに対して各Claude Codeセッションを個別のDockerコンテナで実行するベンチマークハーネスを構築しました。セッションと推論エンドポイントの間には透過プロキシが配置され、各Claude Codeインスタンスのリクエストごとのメトリクスをキャプチャします。使用したモデルはMiniMax M2.5で、システムの8つのNVIDIA RTX PRO 6000 GPU上でvLLMを介して提供されます。M2.5は公開リーダーボードでトップランクのコーディングモデルではありませんが、開発者仲間を含む多くのユーザーがローカルで実行できる高性能モデルです。
基準値として、本番環境のAPIアクセスで最も人気のあるルーティングサービスの1つであるOpenRouter.aiを介したAnthropic社のClaude Opus 4.6の平均出力スループットを使用します。この基準値は、APIリクエスト1件あたり約37トークン/秒です。
私たちは2つの重要な指標を測定しました。1つはClaude Codeセッションごとの1秒あたりの平均出力トークン数(各開発者が経験する数値)、もう1つはすべてのセッションにおける1秒あたりの合計出力トークン数(サーバーが生成する総作業量)です。
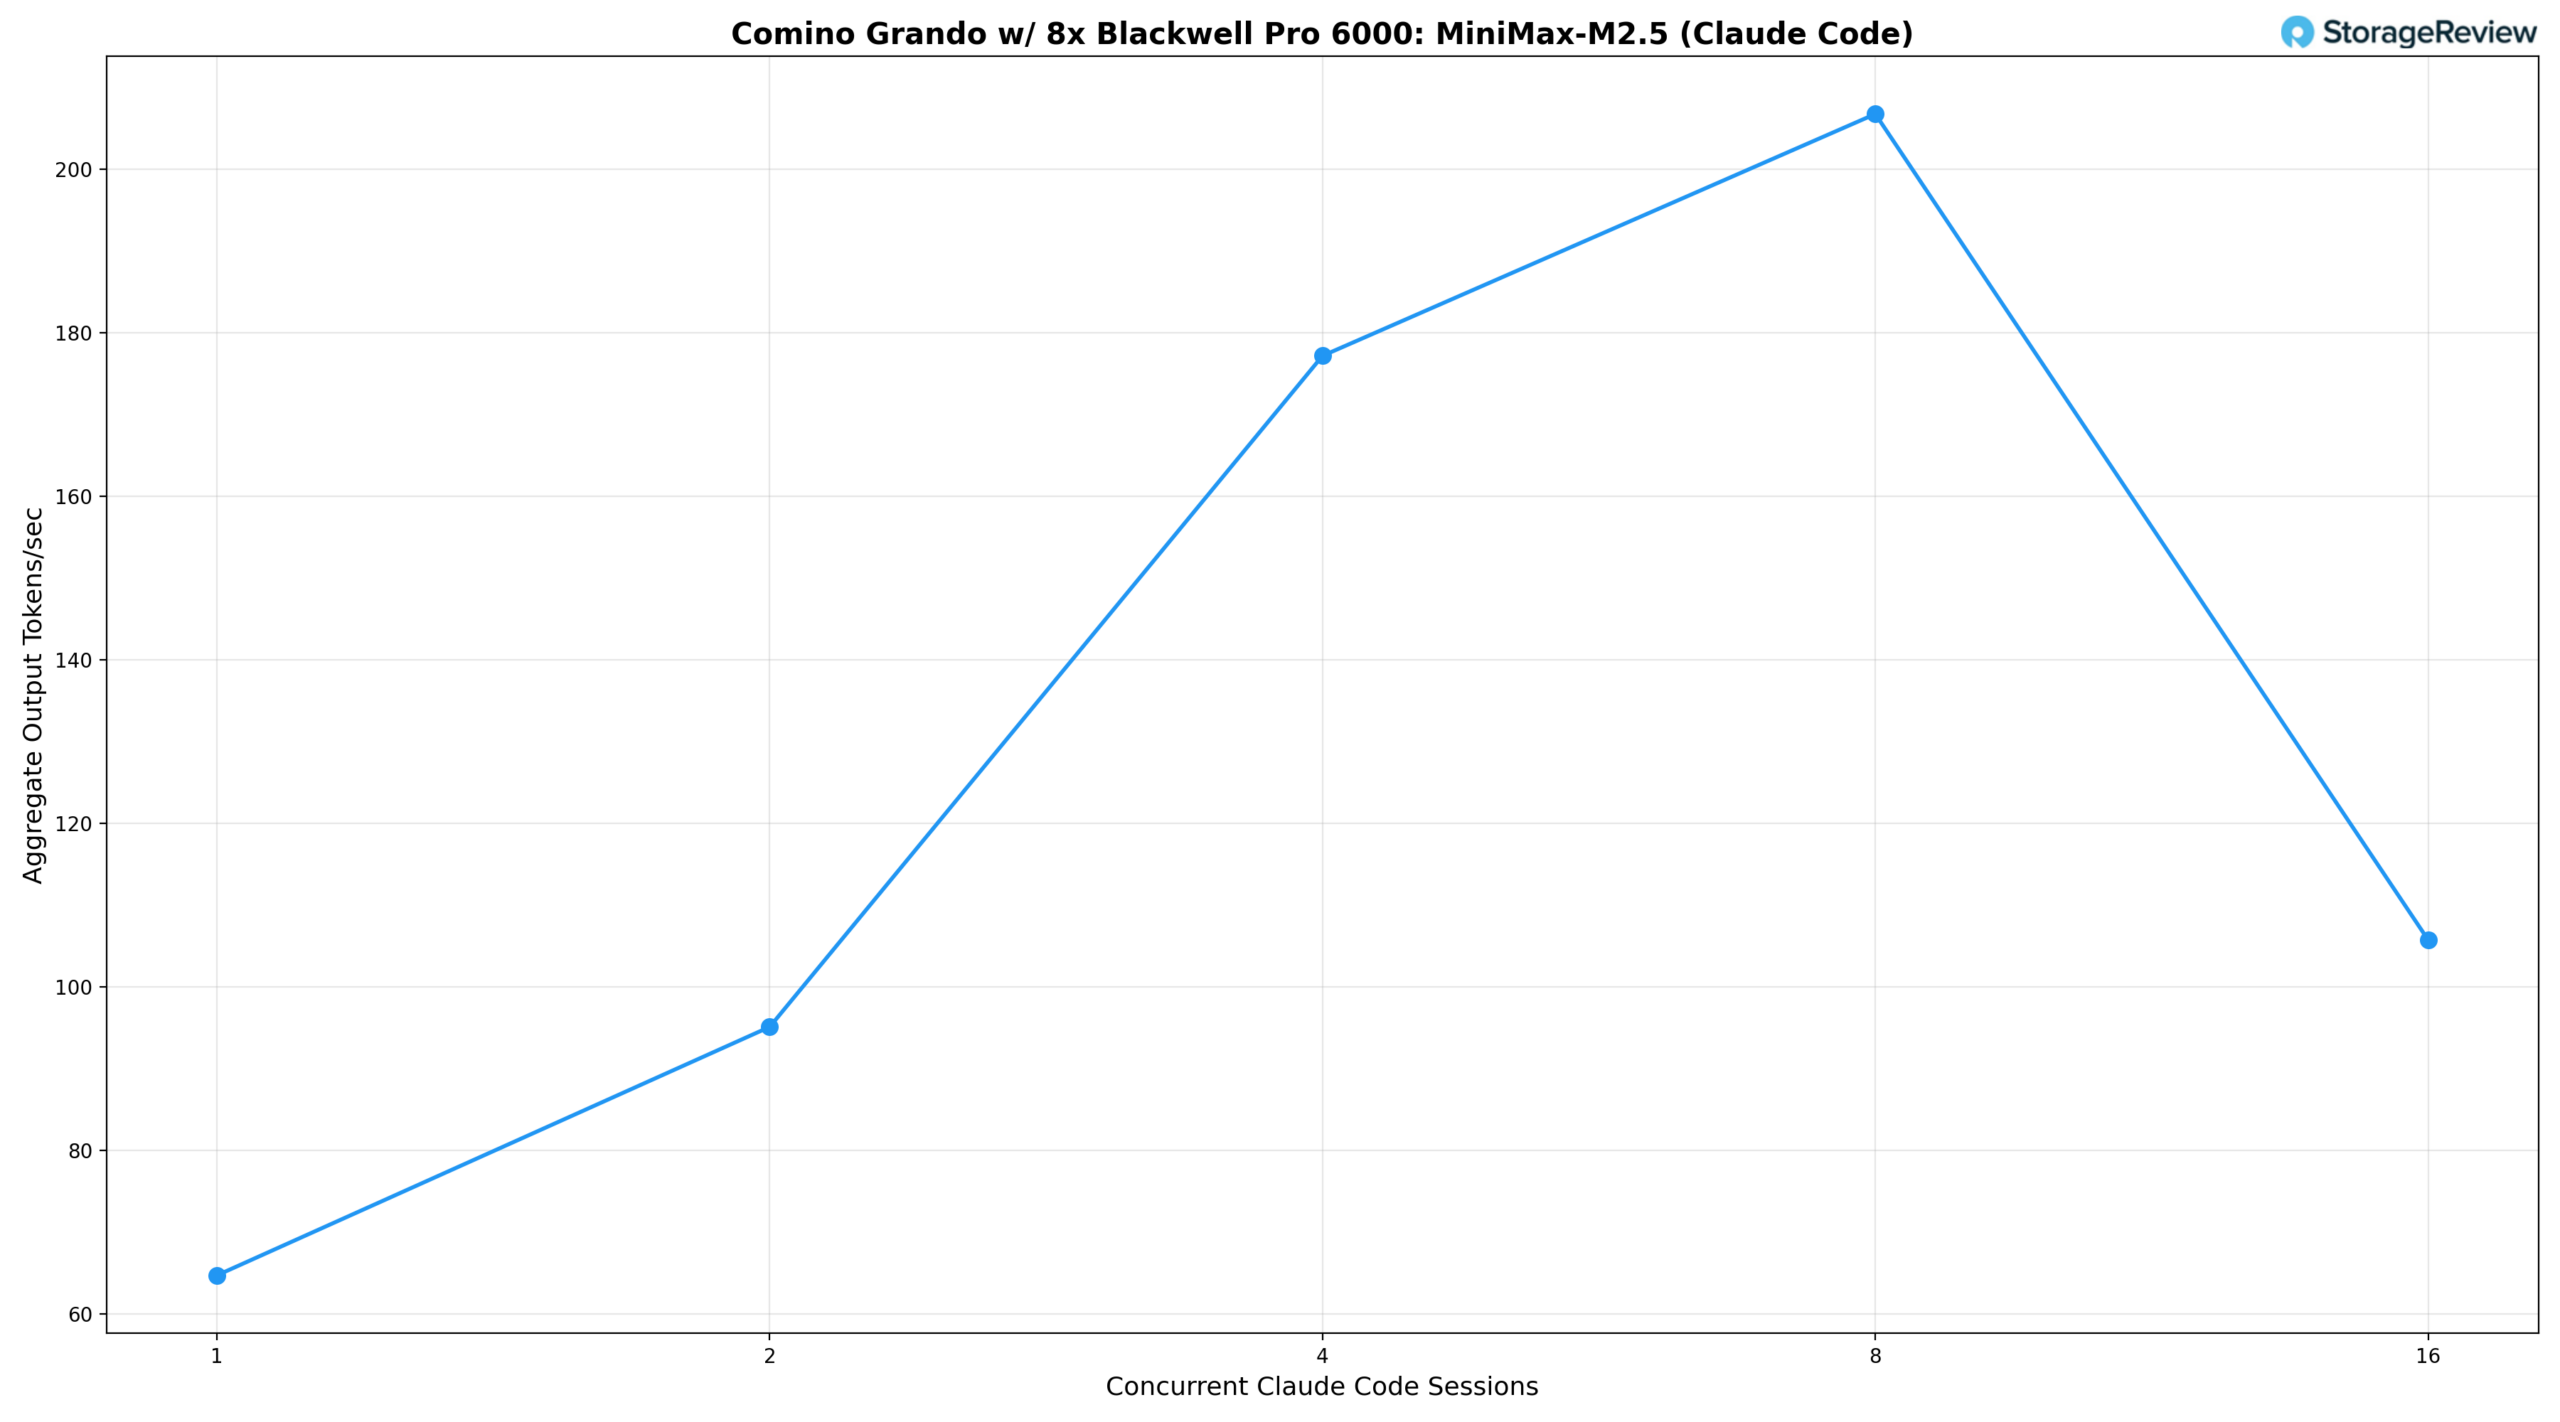
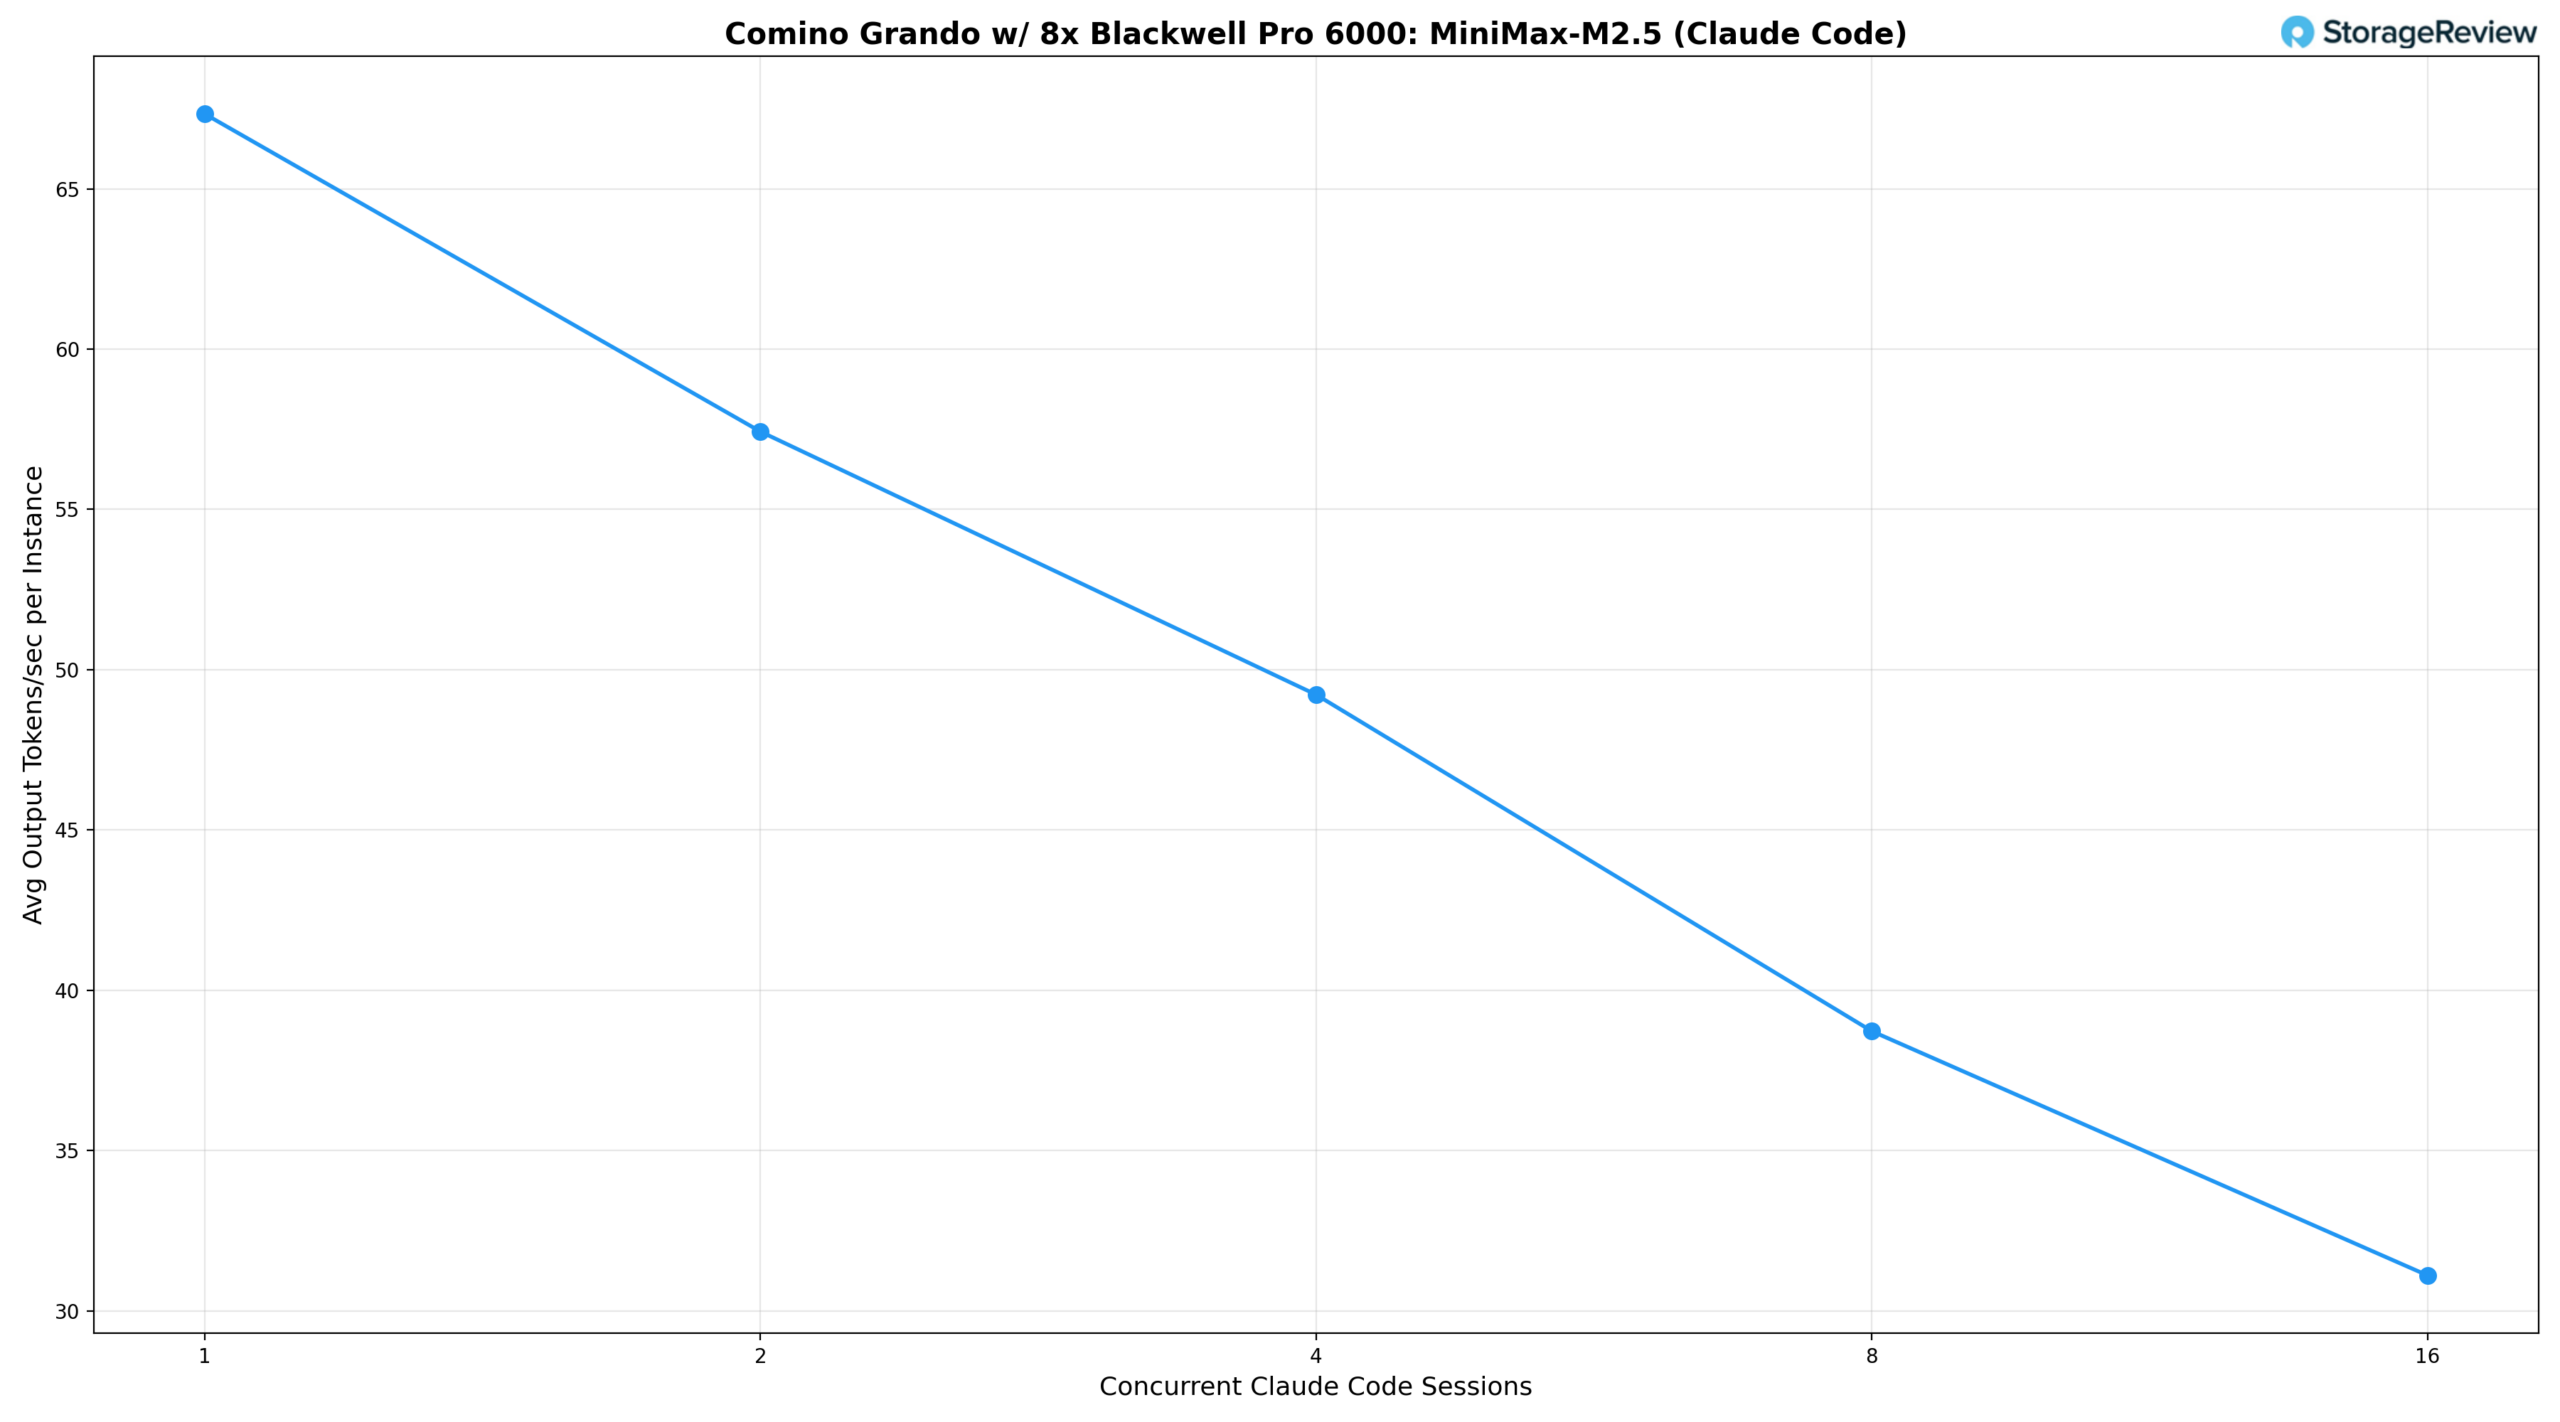
結果に基づくと、同時実行の Claude Code セッションは、ユーザーあたり 67.3 tok/s、合計出力は 64.7 tok/s となります。セッションが 2 つになると、インスタンスあたりのスループットは 57.4 tok/s にわずかに低下しますが、vLLM のバッチ処理がオーバーヘッドを償却し始めると、合計出力は 95.1 tok/s に上昇します。同時実行のセッションが 4 つになると、ユーザーあたり 49.2 tok/s が維持され、対話型コーディング ワークフローに対して非常に応答性の高いエクスペリエンスが実現し、合計スループットは 177.2 tok/s に達します。セッションが 8 つになると、合計出力が 206.7 tok/s でピークに達し、インスタンスあたりのスループットは 38.7 tok/s に落ち着き、リアルタイムのコード生成と反復処理に快適なレベルを維持します。
同時セッション数が16の場合、システムは典型的なバッチ処理のトレードオフを示します。インスタンスあたりのスループットは31.1 tok/sに低下し、総出力は105.8 tok/sに低下します。これは、この同時実行レベルでは、230B MiniMax M2.5モデルが、各ユーザーに意味のある遅延を発生させることなく8つのGPUが維持できる限界に挑戦していることを示唆しています。セッション数が8から16に増加するにつれて総出力が低下するのは、スケジューリングの非効率性ではなく、同時デコード負荷が高い大規模なMoEアーキテクチャのメモリ帯域幅の要求を反映しています。
開発者ツール向けに自社ホスト型AIインフラストラクチャを検討している組織にとって、Grandoは有力な選択肢となるでしょう。最先端の230Bモデルを搭載したGrandoは、最大8つのClaude Codeセッションを同時に快適に処理でき、ピーク時の集計出力ではユーザーあたりの速度が38トークン/秒を超え、真にインタラクティブな操作感を実現します。4~8人のエンジニアからなるチームであれば、応答性の低下をほとんど感じることなく、ほぼ最適なスループットで運用できます。
液冷式アーキテクチャにより、従来のGPUサーバーが動作しない環境でも、このレベルのコンピューティングを実用的に利用できます。システムは静かに動作するため、スタートアップ企業のオフィス、小規模なマシンルーム、オープンスペースの専用コーナーなどにも設置可能です。同様のGPU密度を持つ空冷式システムは通常90dB以上の騒音を発するため、専用のデータセンタースペース、あるいは少なくとも本格的な防音処理を施した密閉型サーバー室が必要になります。Grandoは、それを使用するチームと共存できます。完全なデータローカリティ、トークンごとのAPIコストなし、モデル選択の完全な制御と組み合わせることで、データセンターインフラストラクチャや段階的なコスト増加を必要とせずに、成長する開発チームに合わせて拡張できるセルフホスト型のパスを提供します。
vLLMオンラインサービング – LLM推論パフォーマンス
vLLMは、LLM(論理論理モデル)向けの高スループット推論およびサービスエンジンとして最も人気のあるものの1つです。vLLMオンラインサービスベンチマークは、同時リクエスト下におけるこの推論エンジンの実際のサービスパフォーマンスを評価します。実行中のvLLMサーバーにリクエストを送信することで、本番環境のワークロードをシミュレートします。リクエストレート、入力および出力の長さ、同時クライアント数などのパラメータは設定可能です。このベンチマークでは、スループット(1秒あたりのトークン数)、最初のトークン取得までの時間、出力トークンあたりの時間(TPOT)などの主要な指標を測定し、さまざまな負荷条件下でのvLLMのパフォーマンスをユーザーが理解するのに役立ちます。
さまざまなアーキテクチャ、パラメータスケール、量子化戦略にわたる包括的なモデルスイート全体で推論パフォーマンスをテストし、さまざまな同時実行プロファイルでのスループットを評価しました。
結果の概要
| モデル | 精度 | 等しい(256/256) | プレフィルド - ヘビー (8k/1k) | デコード負荷が高い(1k/8k) |
|---|---|---|---|---|
| Comino Grando(8× RTX PRO 6000 Blackwell搭載)— vLLM推論結果(tok/秒、BS=256でのピーク値) | ||||
| GPT-OSS 20B | ep_dp1 | 17,280 | 32,061 | 11,187 |
| GPT-OSS 120B | ep_dp1 | 11,726 | 21,636 | 7,570 |
| ラマ3.1 8B 指示 | FP8 | 12,109 | 20,137 | 7,353 |
| ラマ3.1 8B 指示 | FP4 | 11,954 | 20,206 | 7,239 |
| ラマ3.1 8B 指示 | BF16 | 11,752 | 17,346 | 6,155 |
| Qwen3 コーダー 30B A3B | FP8 | 10,985 | 16,659 | 4,907 |
| Qwen3 コーダー 30B A3B | BF16 | 10,588 | 16,680 | 4,829 |
| ミストラル スモール 3.1 24V | BF16 | 8,925 | 11,846 | 4,975 |
| ミニマックスM2.5(230B) | ep_dp1 | 5,753 | 7,357 * | 2,555 |
| すべての値はtok/sで、ピークスループットはBS=256です。*MiniMax M2.5のプレフィルヘビーはBS=128でピーク(7,357 tok/s)に達し、BS=256では7,141 tok/sでした。 | ||||
GPT-OSS 120Bおよび20B
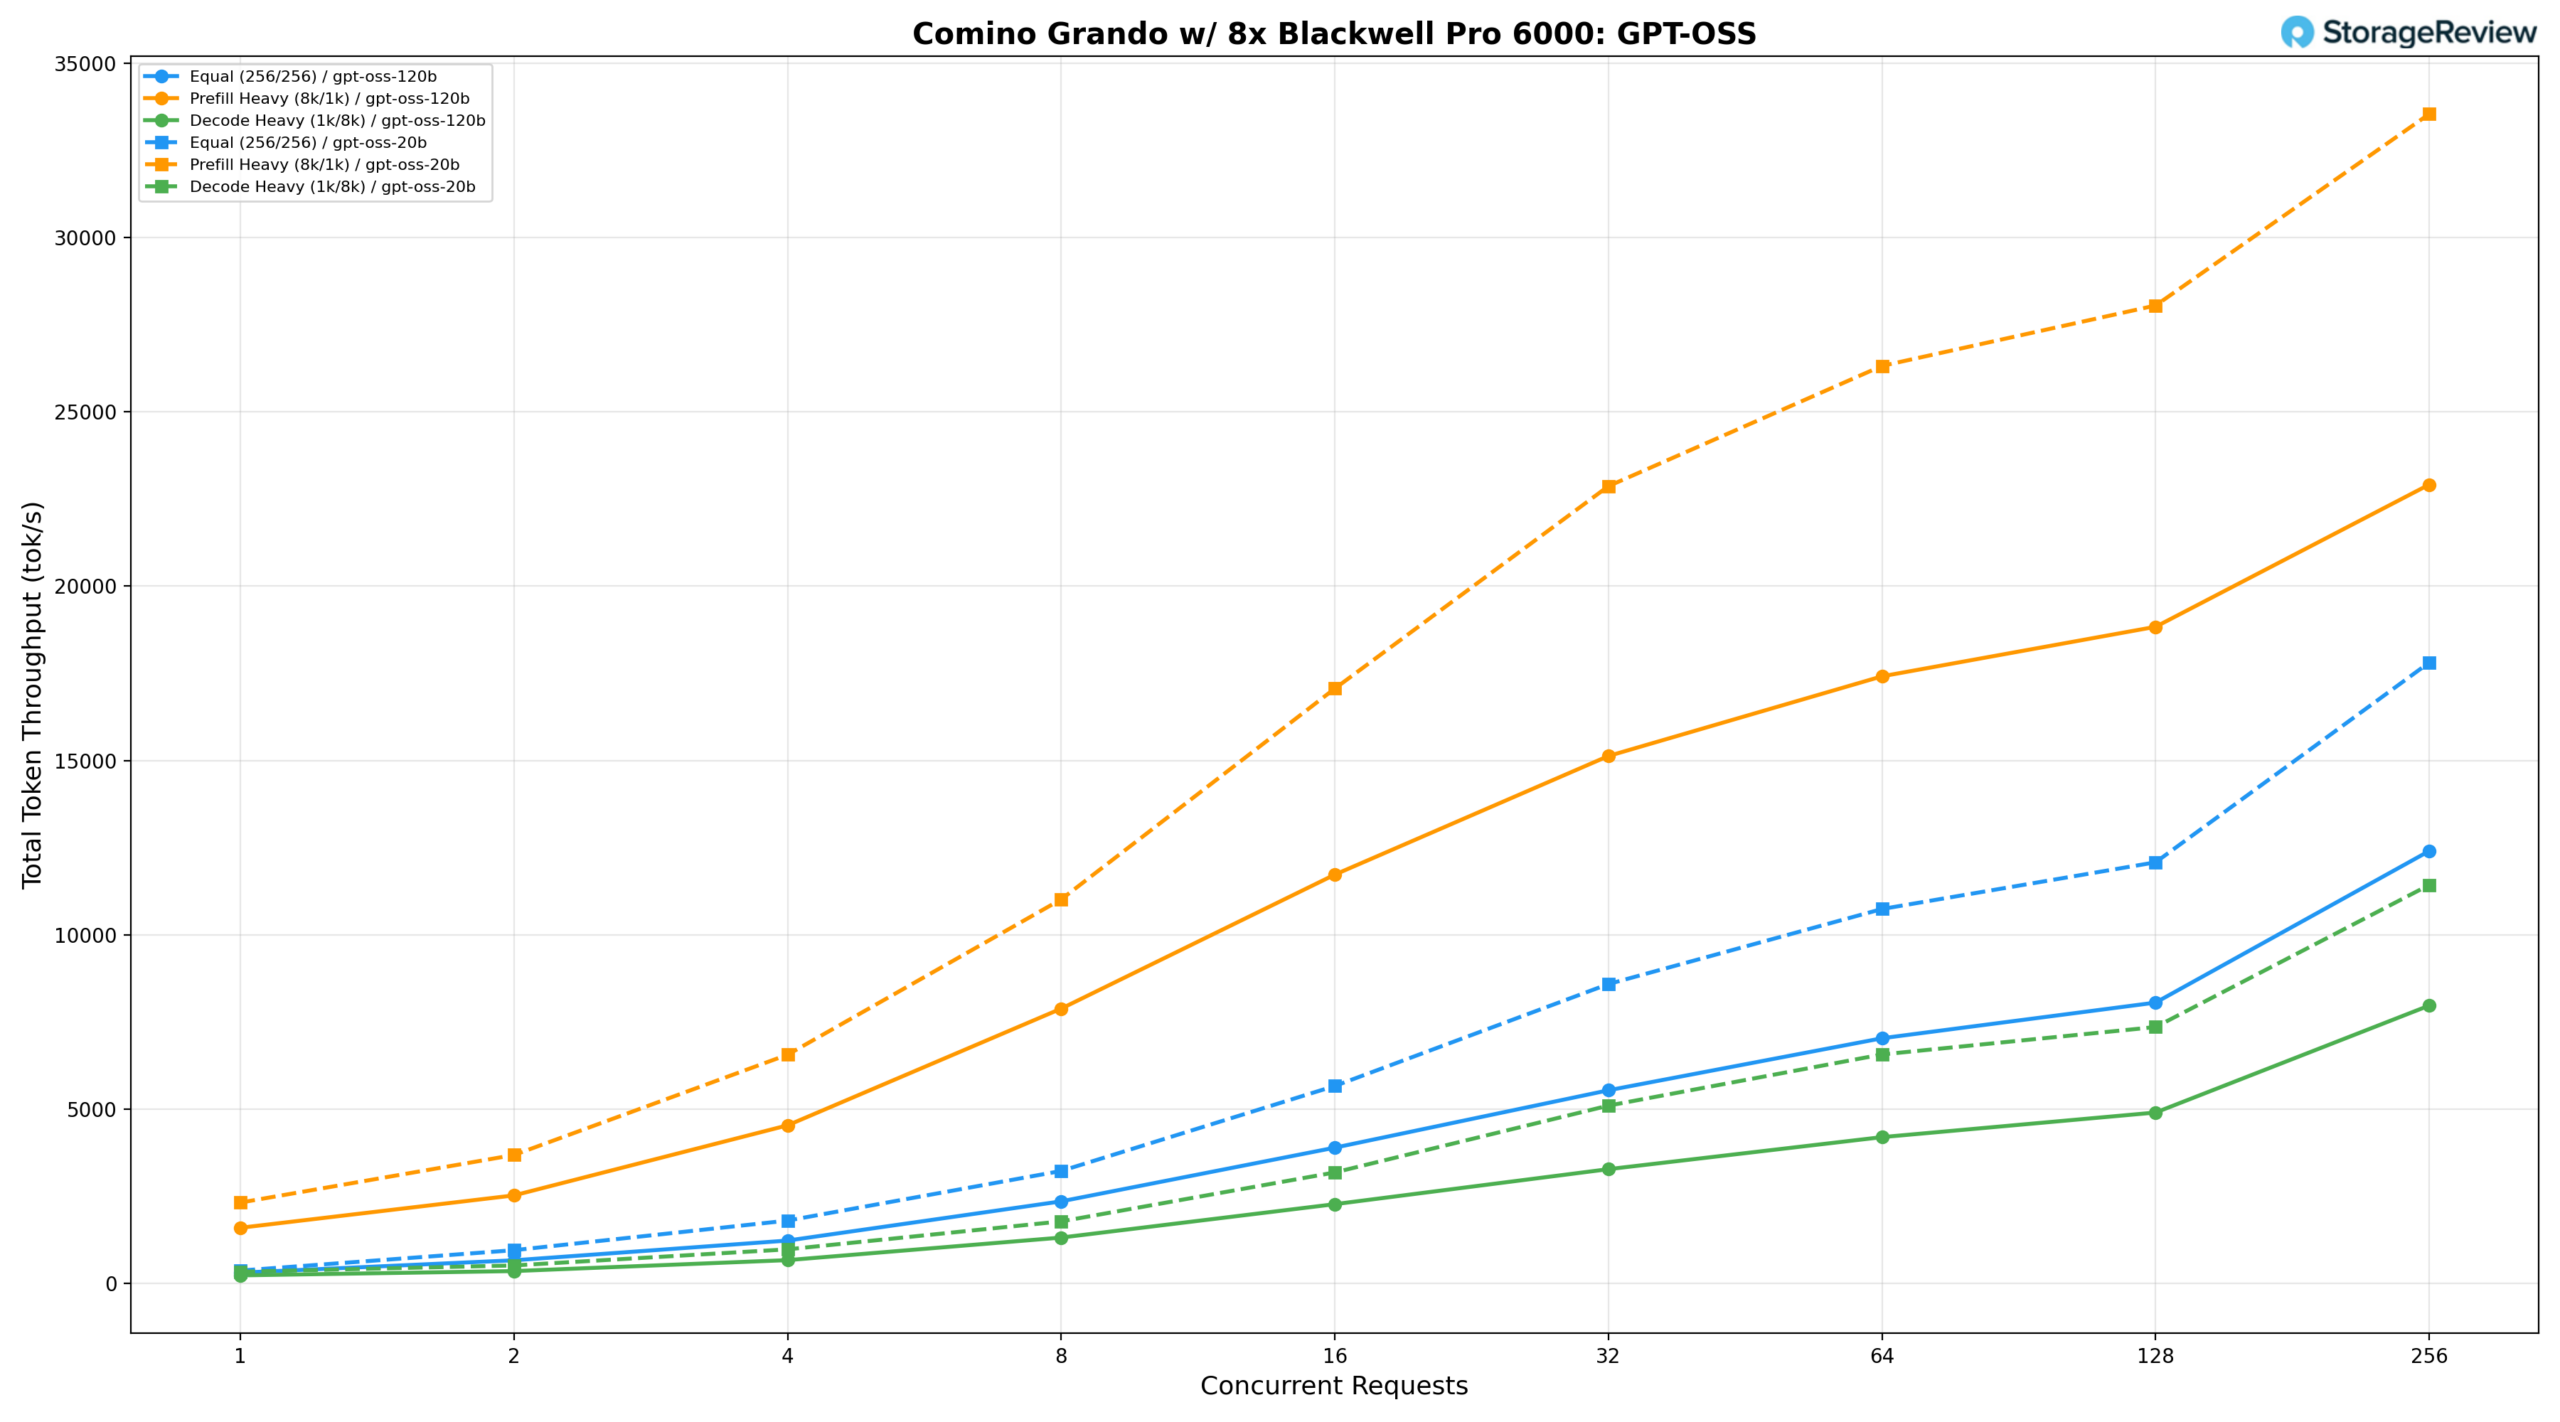
GPT-OSSモデルファミリーは、Comino Grando上で120B構成と20B構成の両方でテストされた。
GPT-OSS 120B
同等のワークロード (256/256) では、120B モデルは BS=1 で 268.85 tok/s を実現し、BS=64 で 6,666.23 tok/s に達し、BS=256 で 11,726.04 tok/s のピークに達します。プリフィル負荷が高い (8k/1k) では、1,375.69 tok/s から始まり、BS=64 で 16,374.19 tok/s、BS=128 で 17,944.55 tok/s まで上昇し、BS=256 で 21,636.41 tok/s のピークに達します。デコード負荷の高い処理(1k/8k)は、BS=1 のときの 196.28 tok/s から BS=256 のときの 7,569.97 tok/s まで増加し、低い同時実行レベルではレイテンシが適切に制御されます。
GPT-OSS 20B
20B モデルは、同等のワークロードで BS=1 で 334.80 tok/s を実現し、BS=64 で 10,303.56 tok/s に達し、BS=256 で 17,280.12 tok/s のピークに達します。プリフィル負荷が高い場合、2,007.90 tok/s から始まり、BS=64 で 24,990.46 tok/s、BS=128 で 26,866.25 tok/s まで上昇し、BS=256 で 32,060.72 tok/s のピークに達します。これは、両方のモデルサイズで記録された最高の絶対プリフィル処理量です。デコード処理負荷が高い場合、BS=1 での 286.08 tok/s から BS=256 での 11,187.36 tok/s まで増加し、ピーク時の同時接続数で 120B の約 1.5 倍のデコードスループットを実現しながら、全体を通してより低いレイテンシを維持します。
Qwen3 Coder 30B A3B命令およびFP8命令
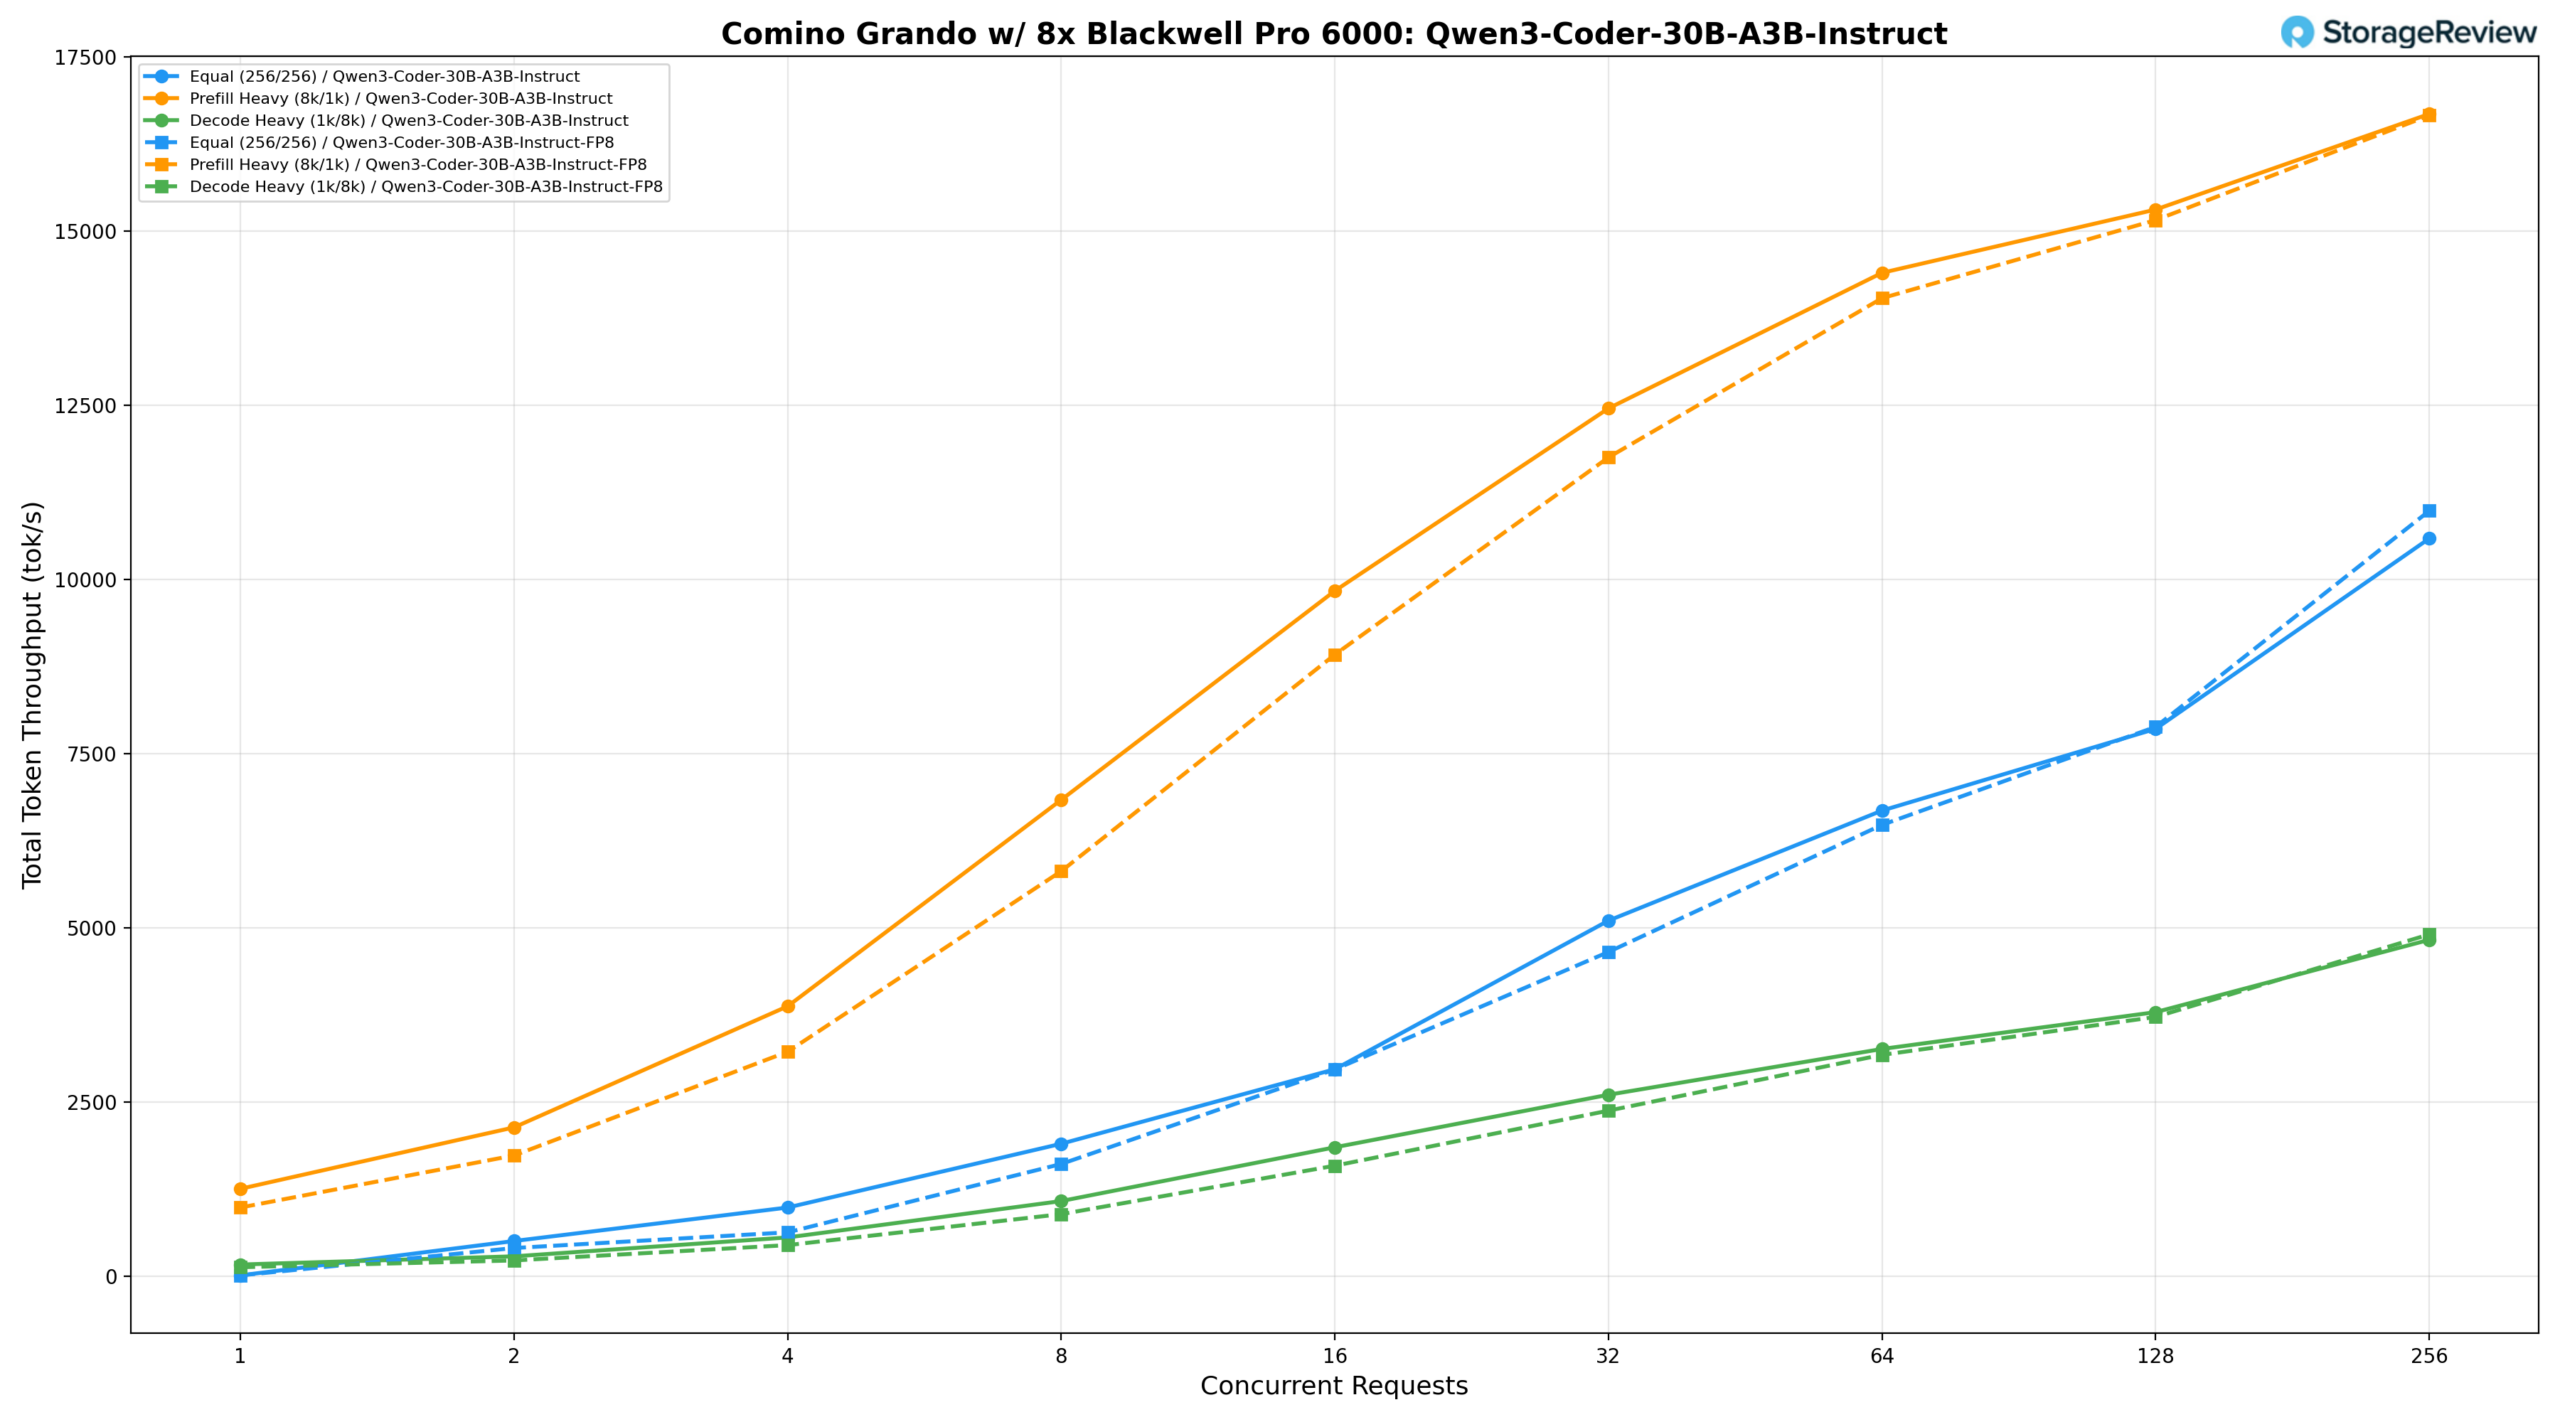
Qwen3-Coder-30B-A3B-Instructモデルは、BF16精度とFP8精度の両方でテストされました。
Qwen3-Coder-30B-A3B-Instruct (BF16)
同じワークロード (256/256) の場合、BF16 モデルは BS=8 で 1,902.32 tok/s の出力を出し、BS=64 で 6,683.58 tok/s に達し、BS=256 で 10,587.56 tok/s のピークに達します。プリフィル負荷が高い (8k/1k) 場合、BS=1 で 1,256.03 tok/s から始まり、BS=64 で 14,400.57 tok/s、BS=128 で 15,308.35 tok/s まで上昇し、BS=256 で 16,679.52 tok/s のピークに達します。デコード負荷の高い処理(1k/8k)は、BS=1 のときの 169.19 tok/s から BS=256 のときの 4,828.82 tok/s まで増加し、低い同時実行レベルではレイテンシが適切に制御されます。
Qwen3-Coder-30B-A3B-Instruct (FP8)
FP8 モデルは、ほとんどのシナリオで BF16 と同等のスループットを実現し、同等のワークロードでは BS=64 で 6,478.54 tok/s に達し、BS=256 でピーク時には 10,984.61 tok/s に達し、ピーク時の同時実行数では BF16 をわずかに上回ります。プリフィル負荷が高い場合、BS=1 で 987.48 tok/s から始まり、BS=64 で 14,036.46 tok/s、BS=128 で 15,156.69 tok/s まで上昇し、BS=256 でピーク時には 16,658.98 tok/s に達します。デコード負荷が高い場合、BS=1 での 130.70 tok/s から BS=256 での 4,906.51 tok/s まで増加し、ピーク時の同時実行数では BF16 をわずかに上回りますが、その他の同時実行数範囲では 2 つの構成はほぼ同等になります。
ミストラル・スモール3.1 24B 指示書2503
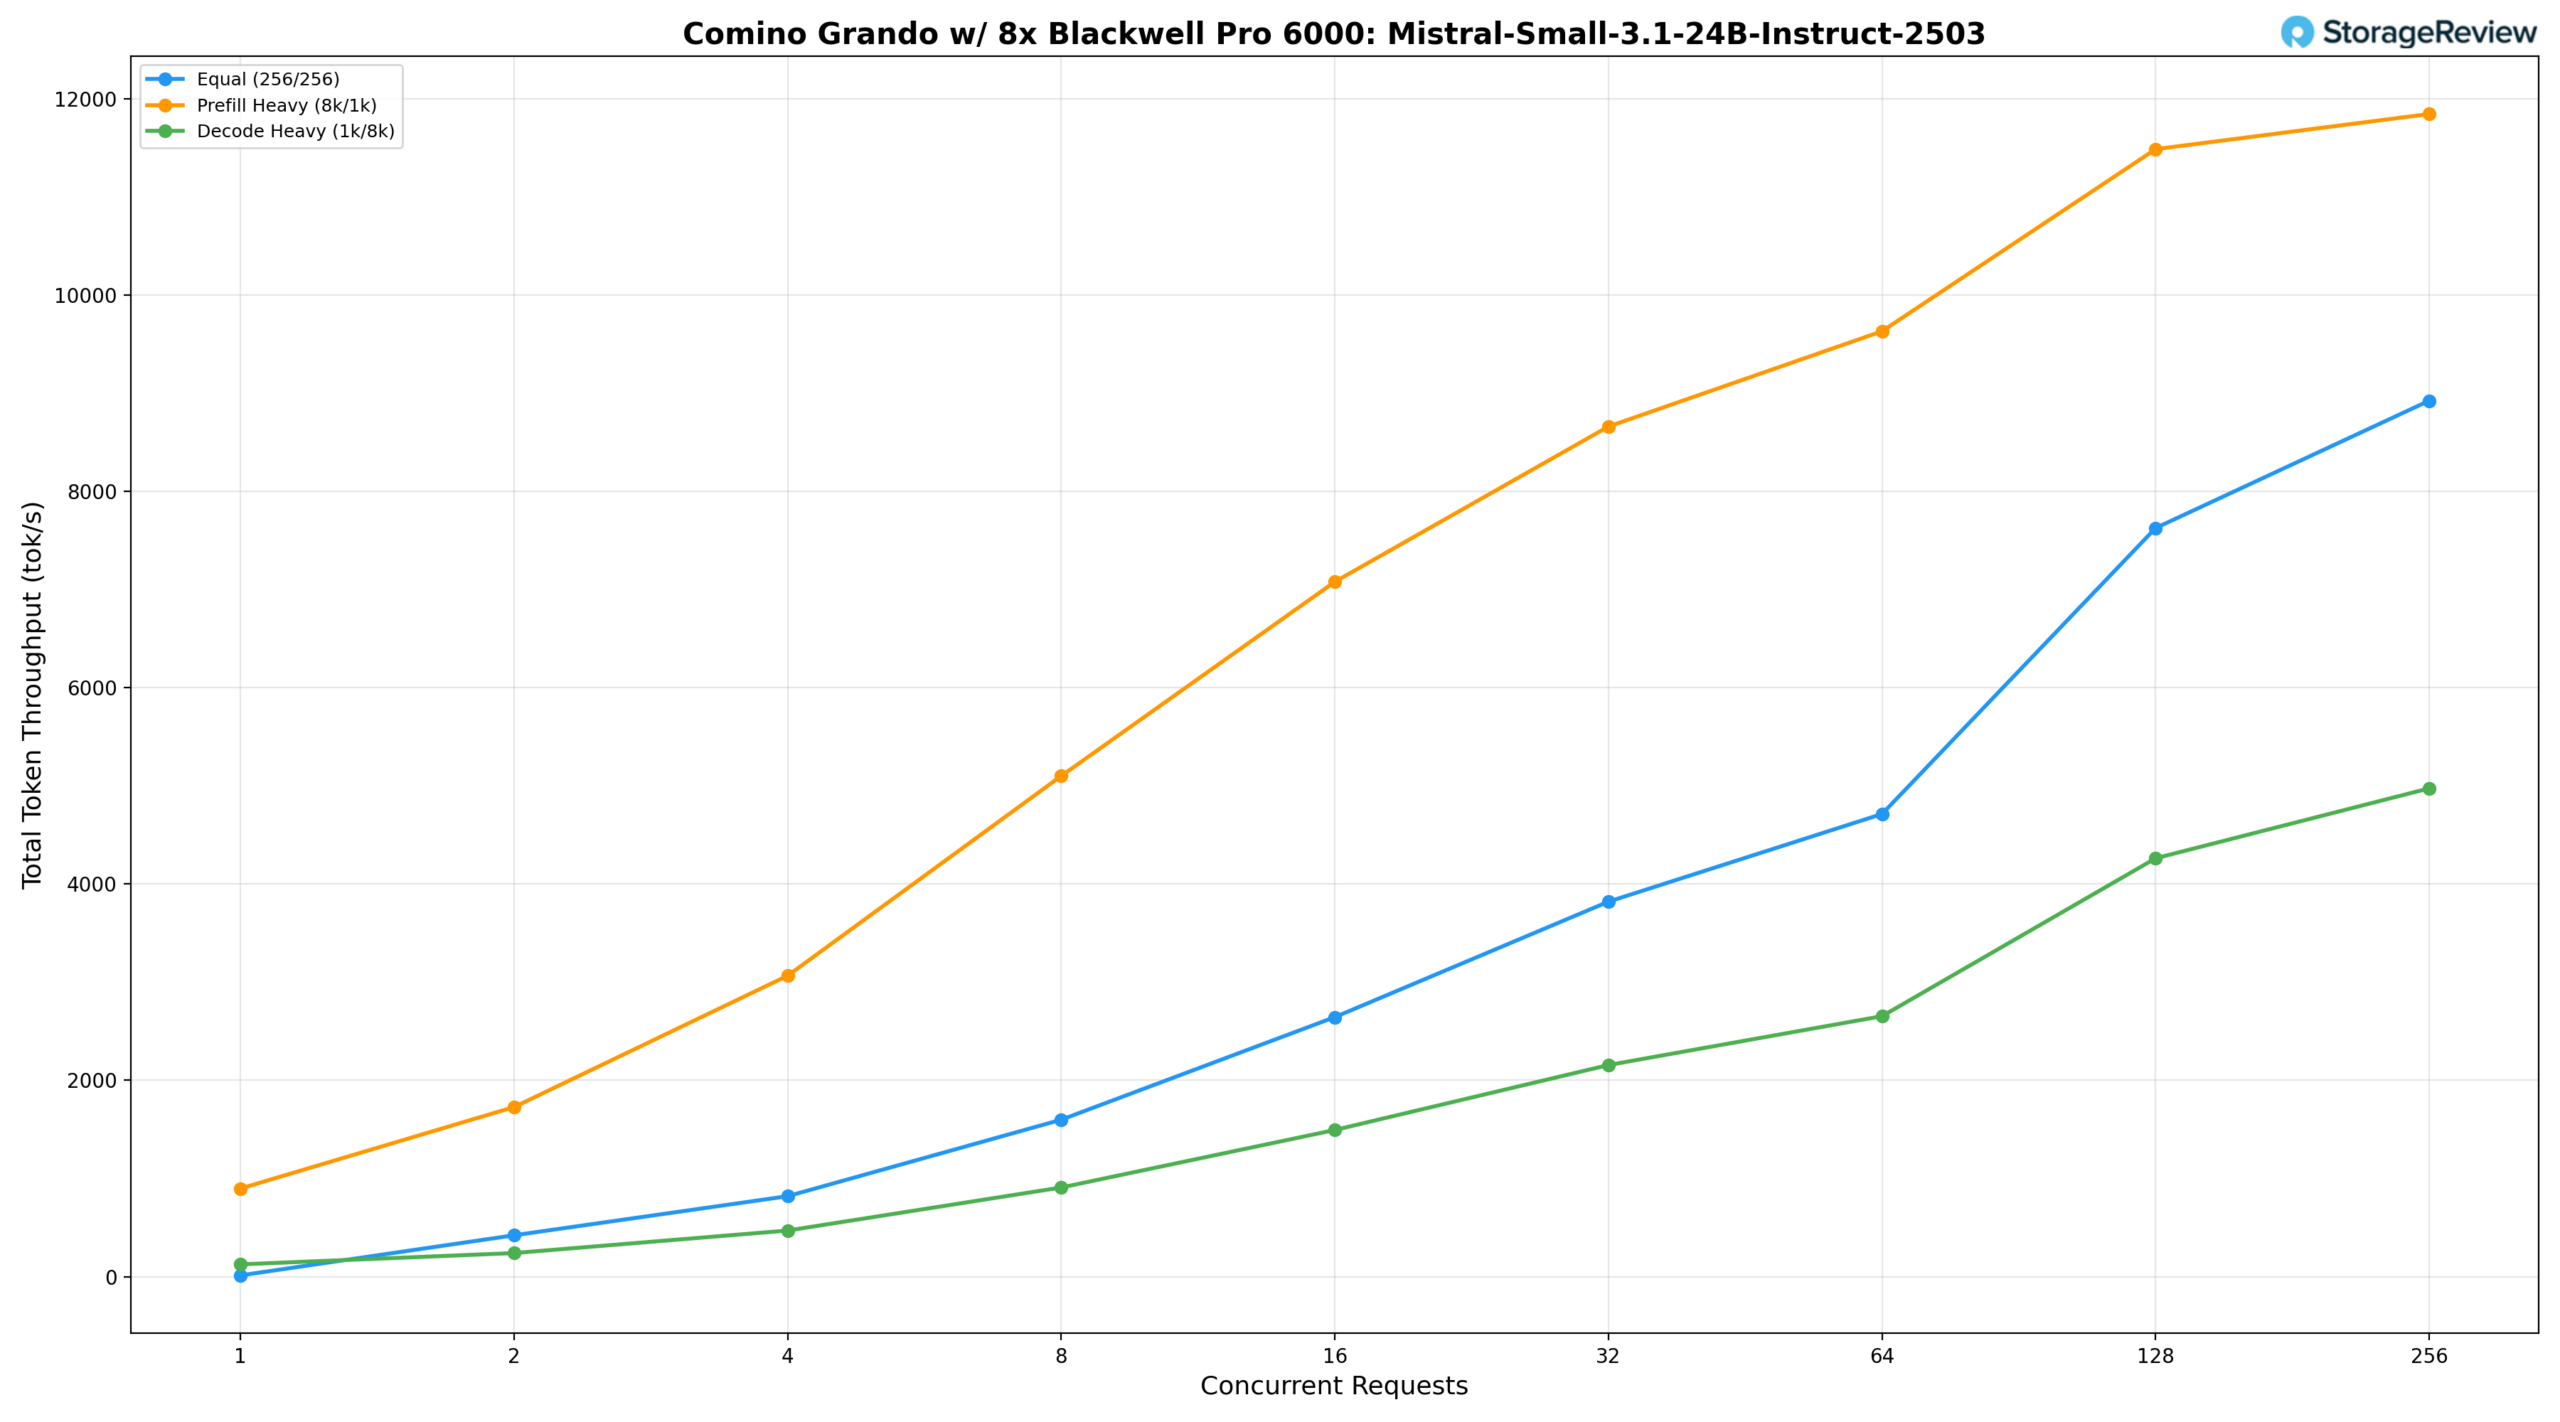
ワークロードが均等な場合(256/256)、このモデルはBS=8で1,598.79 tok/s、BS=64で4,713.84 tok/sに達し、BS=256で8,925.12 tok/sまで大幅にスケールします。プリフィル負荷が高い場合(8k/1k)は、BS=1で897.84 tok/sから始まり、BS=64で9,632.58 tok/s、BS=128で11,488.13 tok/sまで上昇し、BS=256で11,846.15 tok/sでピークに達します。デコード負荷の高い (1k/8k) 処理は、BS=1 で 124.98 tok/s から BS=64 で 2,653.82 tok/s まで増加し、その後、より高い同時実行レベルで顕著に加速し、BS=128 で 4,262.53 tok/s に達し、BS=256 で 4,975.06 tok/s のピークに達します。これは、同時実行が拡大してもモデルが強力なデコードスループットを維持できることを示しています。
ラマ3.1 8B 指示
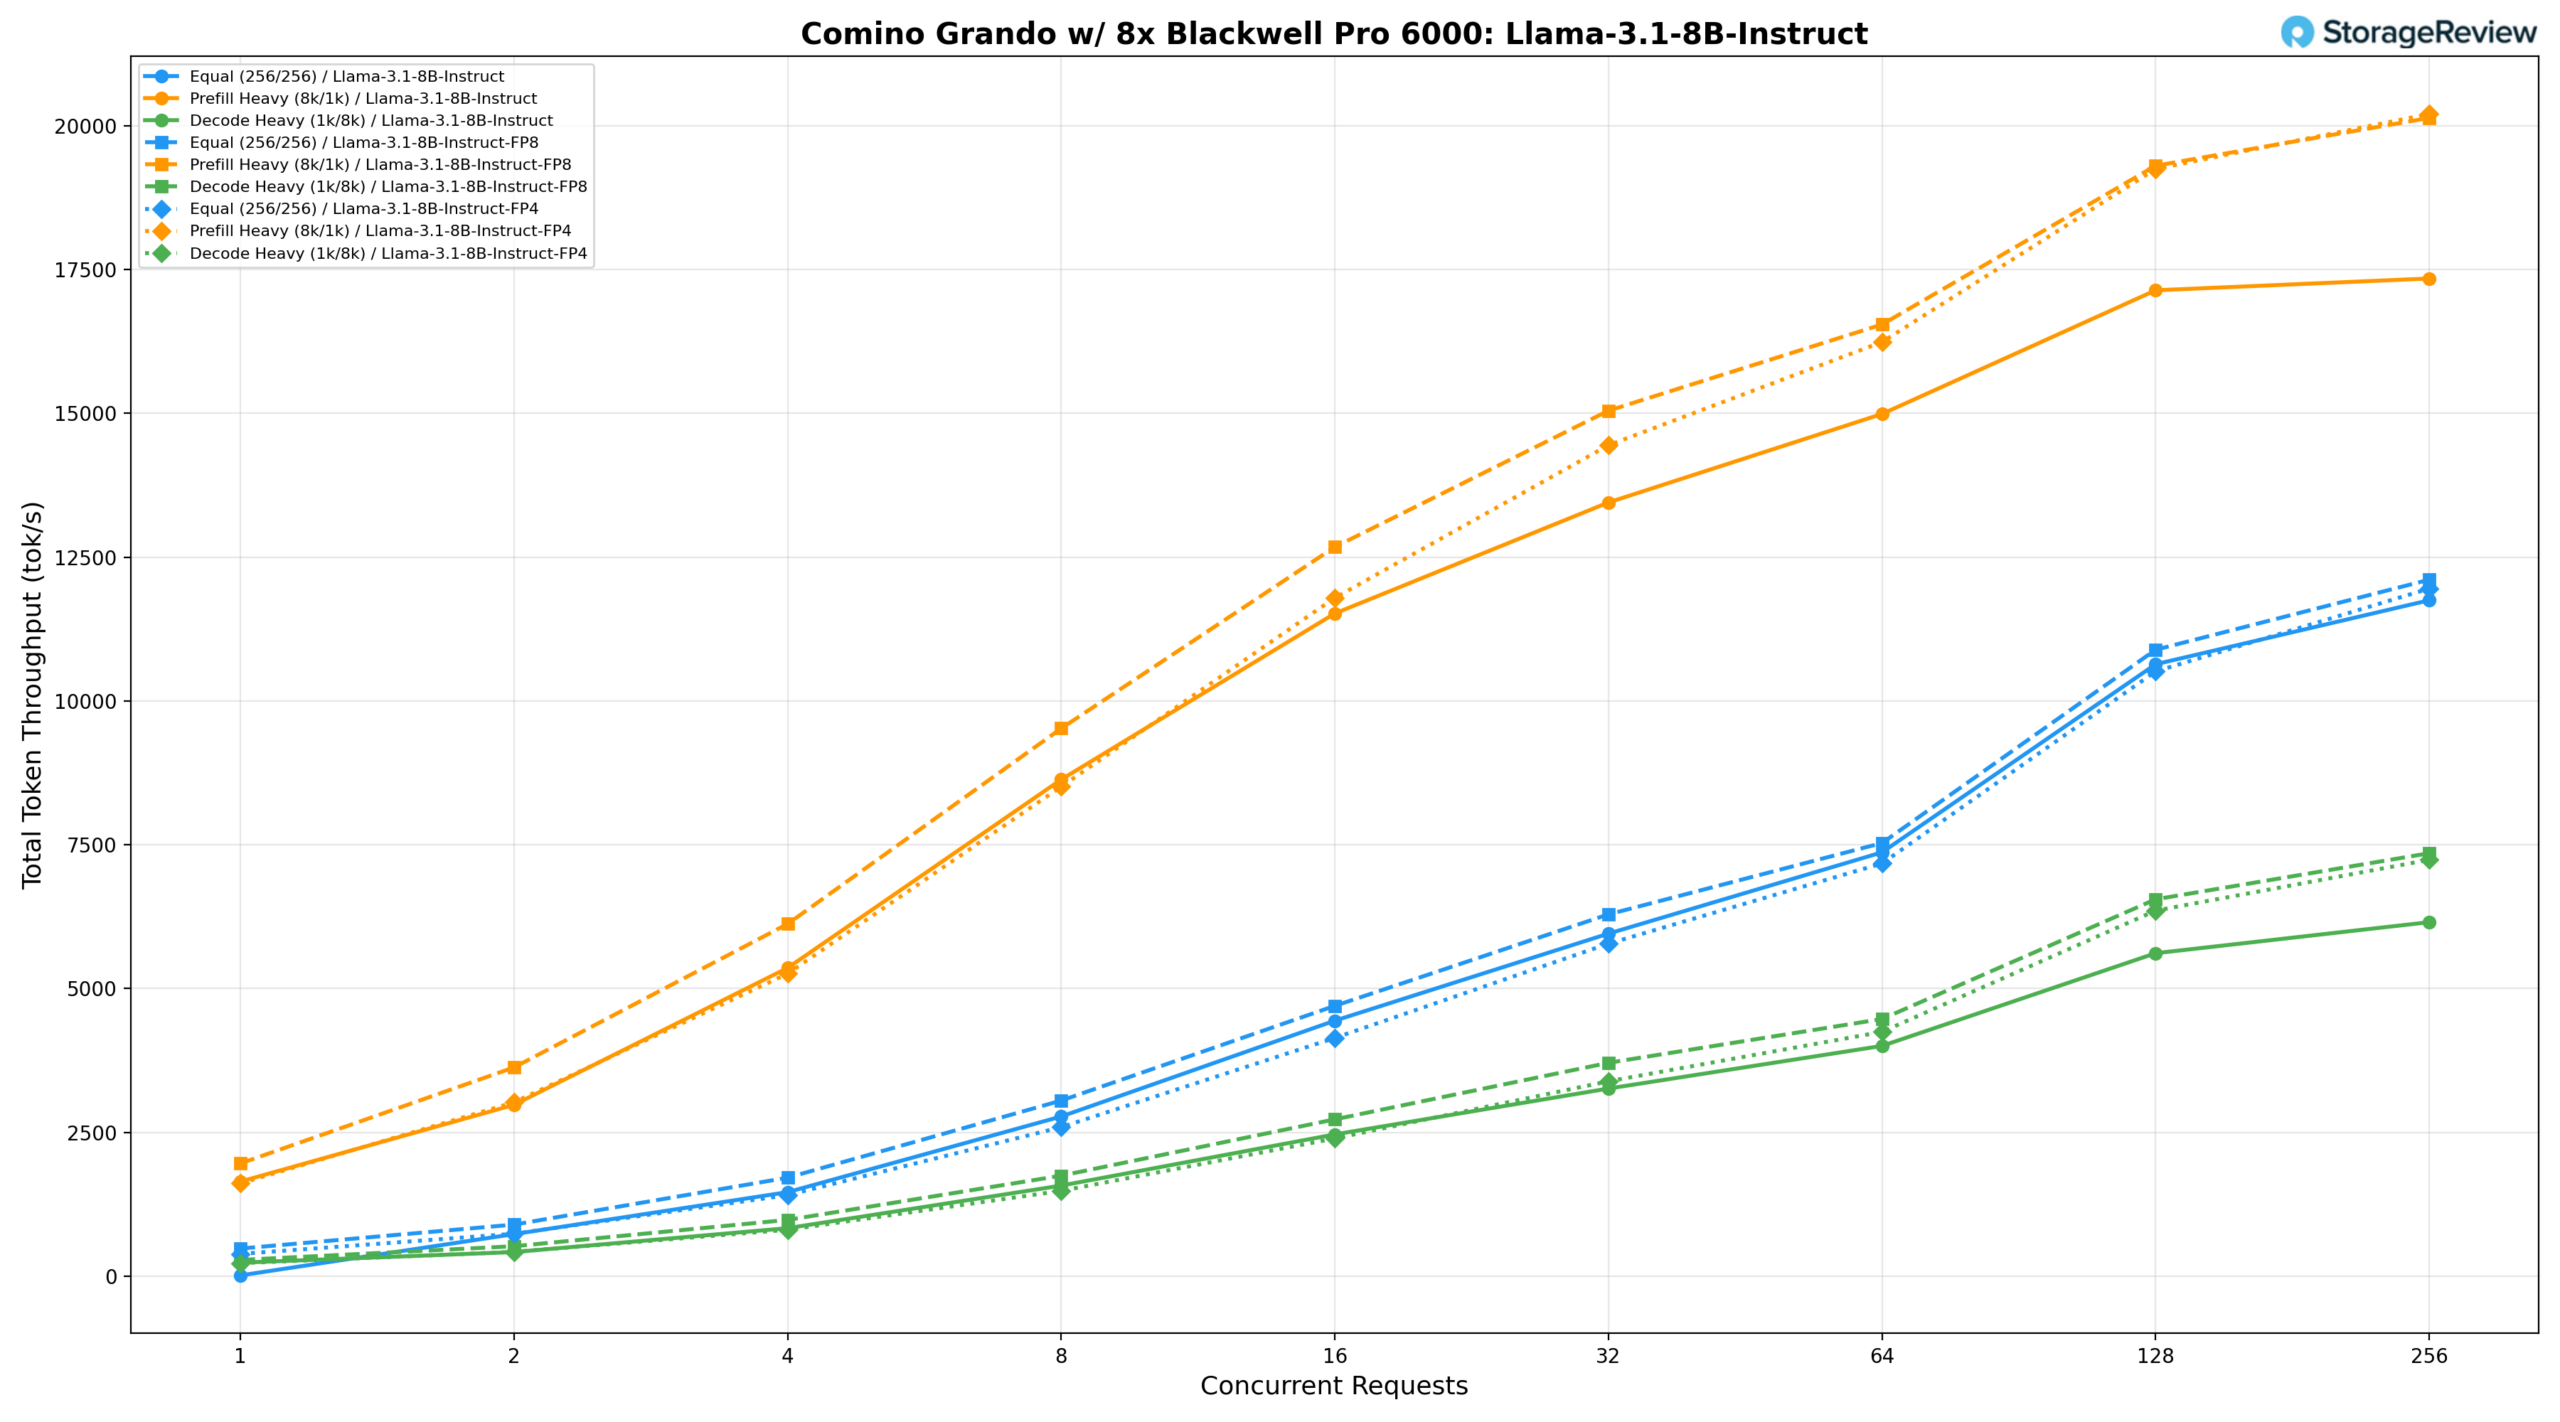
Llama-3.1-8B-Instructモデルは、Comino上で3つの精度構成にわたってテストされ、このモデルサイズにおける量子化がスループットにどのように影響するかを明確に示しました。
ラマ3.1 8B 指示BF16
同じワークロード (256/256) の場合、BF16 モデルは BS=8 で 2,776.42 tok/s の出力を出し、BS=64 で 7,369.01 tok/s に達し、BS=256 で 11,751.56 tok/s のピークに達します。プリフィル負荷が高い (8k/1k) 場合、BS=1 で 1,645.29 tok/s から始まり、BS=64 で 14,990.47 tok/s、BS=128 で 17,140.71 tok/s まで上昇し、BS=256 で 17,345.80 tok/s のピークに達します。デコード負荷の高い (1k/8k) は、BS=1 での 234.78 tok/s から BS=256 での 6,154.73 tok/s に増加します。
ラマ3.1 8B命令FP8
FP8 量子化は、あらゆるシナリオで大幅なパフォーマンス向上を実現します。均等ワークロードでは、BS=64 で 7,530.39 tok/s に達し、BS=256 で 12,108.98 tok/s のピークに達します。プリフィル負荷が高い場合、BS=64 で 16,546.53 tok/s、BS=128 で 19,306.49 tok/s に達し、BS=256 で 20,137.35 tok/s のピークに達します。これは、同時実行ピーク時で BF16 と比較して約 16% 向上しています。デコード負荷が高い場合、BS=256 で 7,353.40 tok/s のピークに達し、BF16 を約 19% 上回ります。
ラマ3.1 8B命令FP4
FP4 は、並列度が高いレベルでは FP8 とほぼ同等のスループットを実現しますが、バッチサイズが低いレベルでは若干劣ります。同等のワークロードでは、BS=256 で 11,954.40 tok/s のピークに達し、プリフィル負荷の高いワークロードでは、BS=256 で 20,205.57 tok/s の最高値に達し、並列度がピークのときに FP8 をわずかに上回ります。デコード負荷の高いワークロードでは、BS=256 で 7,239.29 tok/s のピークに達し、全体を通して FP8 との数パーセント以内の差に収まるため、スループットを大きく犠牲にすることなくメモリ効率を優先する場合に FP4 は魅力的な選択肢となります。
ミニマックスM2.5
コミノ・グランド号でテストしたMiniMax-M2.5 230Bは、私たちが使用したモデルの中で最大かつ最も要求の厳しいモデルでした。
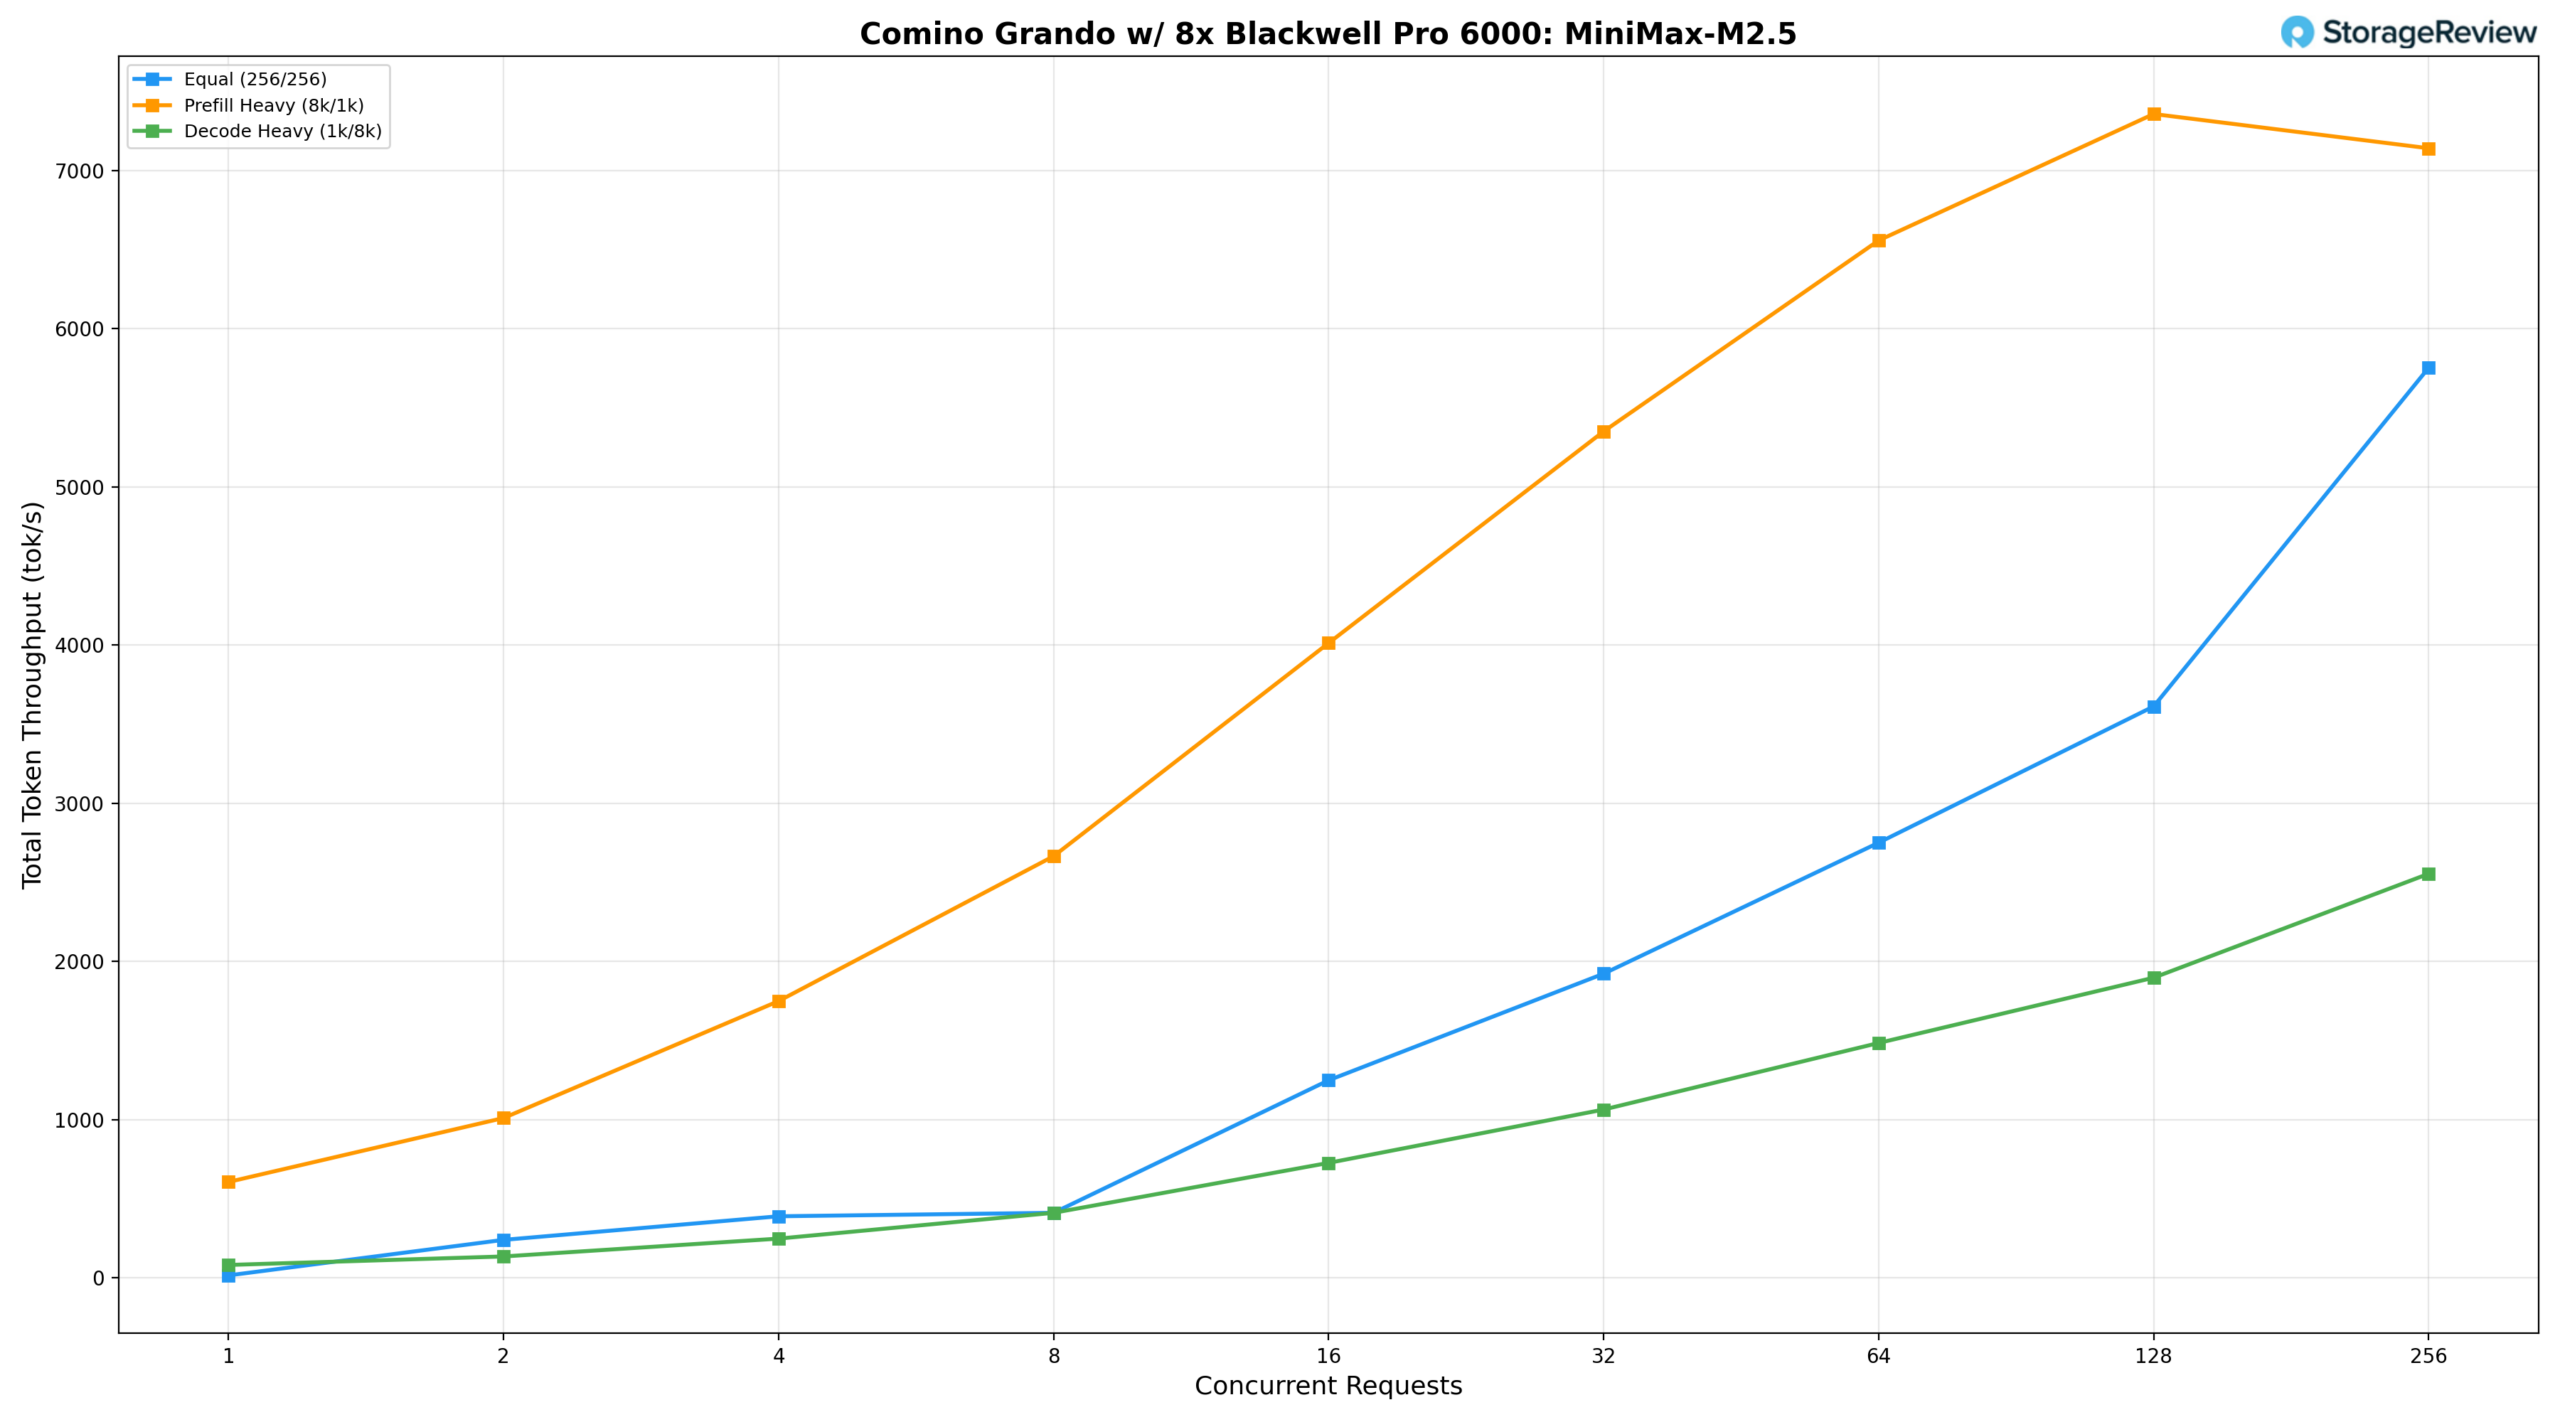
ワークロードが均等な場合 (256/256)、モデルは BS=1 で 16.35 tok/s から始まり、BS=64 で 2,751.25 tok/s に達し、並列度が高くなるにつれて大きくスケールし、BS=256 で 5,753.24 tok/s のピークに達します。プリフィルが多い場合 (8k/1k) は、BS=1 で 606.97 tok/s から始まり、BS=32 で 5,351.02 tok/s、BS=64 で 6,557.92 tok/s まで着実に上昇し、BS=128 で 7,357.26 tok/s のピークに達した後、BS=256 で 7,140.74 tok/s までわずかに低下し、BS=128 を超えるとプリフィル スループットが飽和に近づくことを示唆しています。デコード負荷の高い (1k/8k) は、BS=1 での 82.21 tok/s から BS=64 での 1,485.28 tok/s まで一貫して増加し、BS=256 で 2,554.87 tok/s のピークに達します。これは、持続的なデコードワークロードの下での 230B MoE アーキテクチャの予想されるメモリ帯域幅の要求を反映しています。
結論
Comino Grandoは、8基のNVIDIA RTX PRO 6000 GPUの潜在能力を最大限に引き出すために特別に設計されたシステムと理解するのが最も適切でしょう。反転したマザーボードレイアウトから冷却ループ、統合されたモニタリングスタックに至るまで、主要な設計上の決定はすべて、これらのGPUが熱や電力の制約を受けることなく、600WのTDPで継続的に動作することを保証することを目的としています。
Grandoの魅力は、個々の機能だけではなく、システム全体の調和にあります。液冷システムは後付けではなく、アーキテクチャそのものに組み込まれています。電源供給は冗長構成でホットスワップに対応し、600Wのグラフィックカード8枚による4,800Wの負荷にも余裕を持って対応します。モニタリングシステムは温度表示にとどまらず、異常発生時にはハードウェアを自動的に保護します。ここには、後付け感を感じさせる要素は一切ありません。
パフォーマンス数値は、その連携の強さを裏付けています。Llama 3.1 8Bから230B MiniMax M2.5まで、多様なモデルにおいて、Grandoはセルフホスト型プラットフォームとしては十分なスループットを実現しました。Claude Codeの同時実行テストでは、その実用性がさらに明確になりました。ローカルホスト型の230Bモデルに対して、8人のエンジニアが同時にエージェントコーディングセッションをインタラクティブな速度で実行でき、ピーク時の集計出力ではユーザーあたりのスループットが38 tok/sを超えます。4人から8人のチームであれば、目立った性能低下なく、ほぼ最適なスループットで運用できます。
この構成の価値は、AI推論にとどまりません。GPUあたり96GBのVRAMと高密度マルチGPUスケーリングにより、このプラットフォームは、VFXレンダリング、大規模シミュレーション、複雑なCADパイプラインなど、ハイエンドのクリエイティブおよびエンジニアリングワークロードにも最適です。システムは4GPU構成や2GPU構成にも縮小できるため、ワークステーションクラスの密度を必要とする小規模スタジオやチームでも、このレベルのパフォーマンスを利用できます。
Grandoが、これまでレビューしてきたエンタープライズ向け8GPUプラットフォームと最も異なる点は、導入の容易さです。これらのプラットフォームは、より多くのPCIeレーン、より多くのNICスロット、そしてより深いストレージ接続性を提供しますが、専用のデータセンターインフラストラクチャが必要で、消費電力は8kWをはるかに超え、納期は1年以上かかる場合もあります。Grandoは、周辺機器の拡張性を多少犠牲にする代わりに、ユーザーと同じ部屋で使用できるほど静かに動作し、周囲環境への放熱量が少なく、すぐに出荷できるシステムとなっています。最大限のファブリック接続性よりも迅速な導入と管理しやすい運用環境を優先する組織にとって、このトレードオフは好ましいものです。
製品ページ – Comino Grando
コミノコンフィギュレーター – ページ
リーダーボード: Comino Grando RTX PRO 6000は、ローカルAI向けベストデスクトップのリーダーボードで「エクストリームピック」の座を獲得しました。


 Amazon