

2026年10月19日更新:Open WebUIは、測定ガイド結果(RTX 5000 Adaベンチマークで1秒あたり115.32トークンと75.06トークン、1月は123トークンと82トークン)により2番目に選ばれました。また、Windowsデスクトップアプリとサーバーv0.12.2に関する記事が追加され、ガイド欄にはOpen WebUIのハンズオン記事へのリンクが掲載されています。初版公開日:2026年8月19日。
独自のハードウェア上で言語モデルを実行する理由は4つあり、そのうちイデオロギー的な理由は1つだけです。プライバシー:ローカルモデルに渡すドキュメントはマシンから決して外に出ません。これは、クライアントコード、契約書、患者データ、未公開製品に関するすべてのやり取りに当てはまります。
コスト構造:クラウドAIは従量課金制で、エージェントワークロードによってトークン数が急速に増加するため、高性能ワークステーションであれば費用を回収できます。所有するハードウェアは電気代のみで稼働します。可用性:レート制限、停止、火曜日にワークフローを変更する廃止通知メールなどは一切ありません。そして制御:検証済みのモデルは、変更を決定するまでそのまま使用できます。
一方で、最先端のクラウドモデルは依然として高い能力を備えており、長期的なエージェント業務においてはその差は顕著です。ローカルモデルが同等の能力を発揮できるのは、チャット、要約、単一ファイルのコード、ドキュメントの質疑応答といった限定的な作業に限られます。これは、ほとんどの人が1日を通して行っている業務の大部分を占めています。もし、あらゆるコストで最大限の能力を求めるのであれば、クラウドを利用するのが良いでしょう。しかし、プライバシー、コスト、あるいは制御性を重視するのであれば、ローカル環境は現状でも十分に実用的であり、このページはそのための道しるべとなるでしょう。
その枠組みに基づいてハードウェア予算を決定してください。ローカルAIの予算は、何よりもまずメモリ容量の決定が重要になります。16GBのVRAMまたは32GBの統合メモリで、上記の制限された処理を処理できる7~8Bクラスに対応できます。24~32GBのVRAM、または48GBの統合メモリで、エージェントコーディングがデモではなくなる30Bクラスに到達します。96~128GBの統合メモリで、最先端の品質に迫る100B以上のモデルを実行できます。過剰購入は気づかないうちに速度を向上させますが、不足すると、目的のモデルクラスがまったくロードされないことになります。
ローカルAIに最適なノートパソコンとデスクトップパソコンのランキングでは、マシンをティア別にランク付けしています。このページでは、それらのマシンで実行できるアプリケーションについて説明します。
ソフトウェア面はハードウェアほどスムーズに成熟していません。現在検索結果で推奨されているツールの約3分の1は既に使われなくなっており、それらを推奨しているページのほとんどはそれに気づいていません。
このページでは、2026 年 10 月時点で動作するツールとハードウェアを追跡しています。現時点では、中立的で検証可能な指標である GitHub のスター数でランキングしています。ツールがクローズド ソースでスター数がない場合はその旨を記載しています。表中のツール名はすべて、公式のダウンロードページへのリンクになっています。各ツールがラボでテストされるにつれて、ガイド列には、1 月以降に開始されるハンズオン セットアップの手順と独自の数値が表示されます。
このページは3つのルールに基づいて作成されています。まず、ローカルモデルとローカルエージェントの区別から始めます。いくつかの製品はユーザーのマシン上で動作しますが、推論呼び出しはすべてベンダーのクラウドに送信されます。これはプライバシー保護のための措置であり、オフライン機能ではありません。これらのツールは区別が明確になるよう、ページ下部に別途記載されています。次に、すべての項目に現実的なハードウェア最小要件を記載しています。「ノートパソコンで動作する」というだけでは、メモリ容量の数値が示されていないため意味がありません。最後に、FAQでは、削除された項目とその日付を記録しています。
おすすめ商品
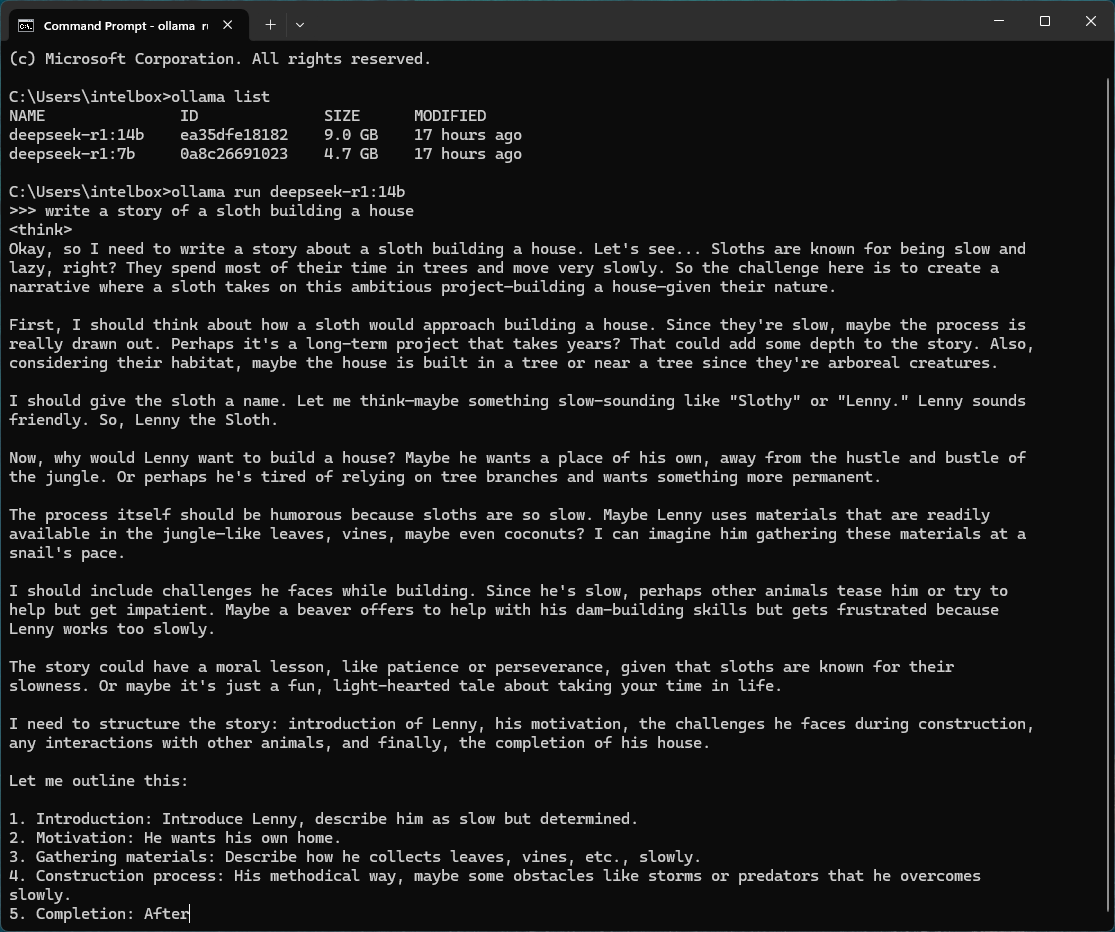
最優秀ローカルLLMランタイム:オラマ
Ollama はデフォルトの回答であり、他のほとんどのツールが通信する相手です。MIT ライセンスで、GitHub のスターは約 179,000 個あり、現在は CLI に加えてデスクトップ GUI も提供されています。1 つのコマンドでモデルを取得し、localhost 上に OpenAI 互換のエンドポイントを公開し、2026 年 1 月に Anthropic Messages API との互換性を追加しました。これにより、Claude Code をローカル モデルに向けられるようになりました。最小要件: 3B モデルの場合は 8GB システム RAM、7-8B の場合は 16GB、30B クラスの場合は 24GB VRAM。
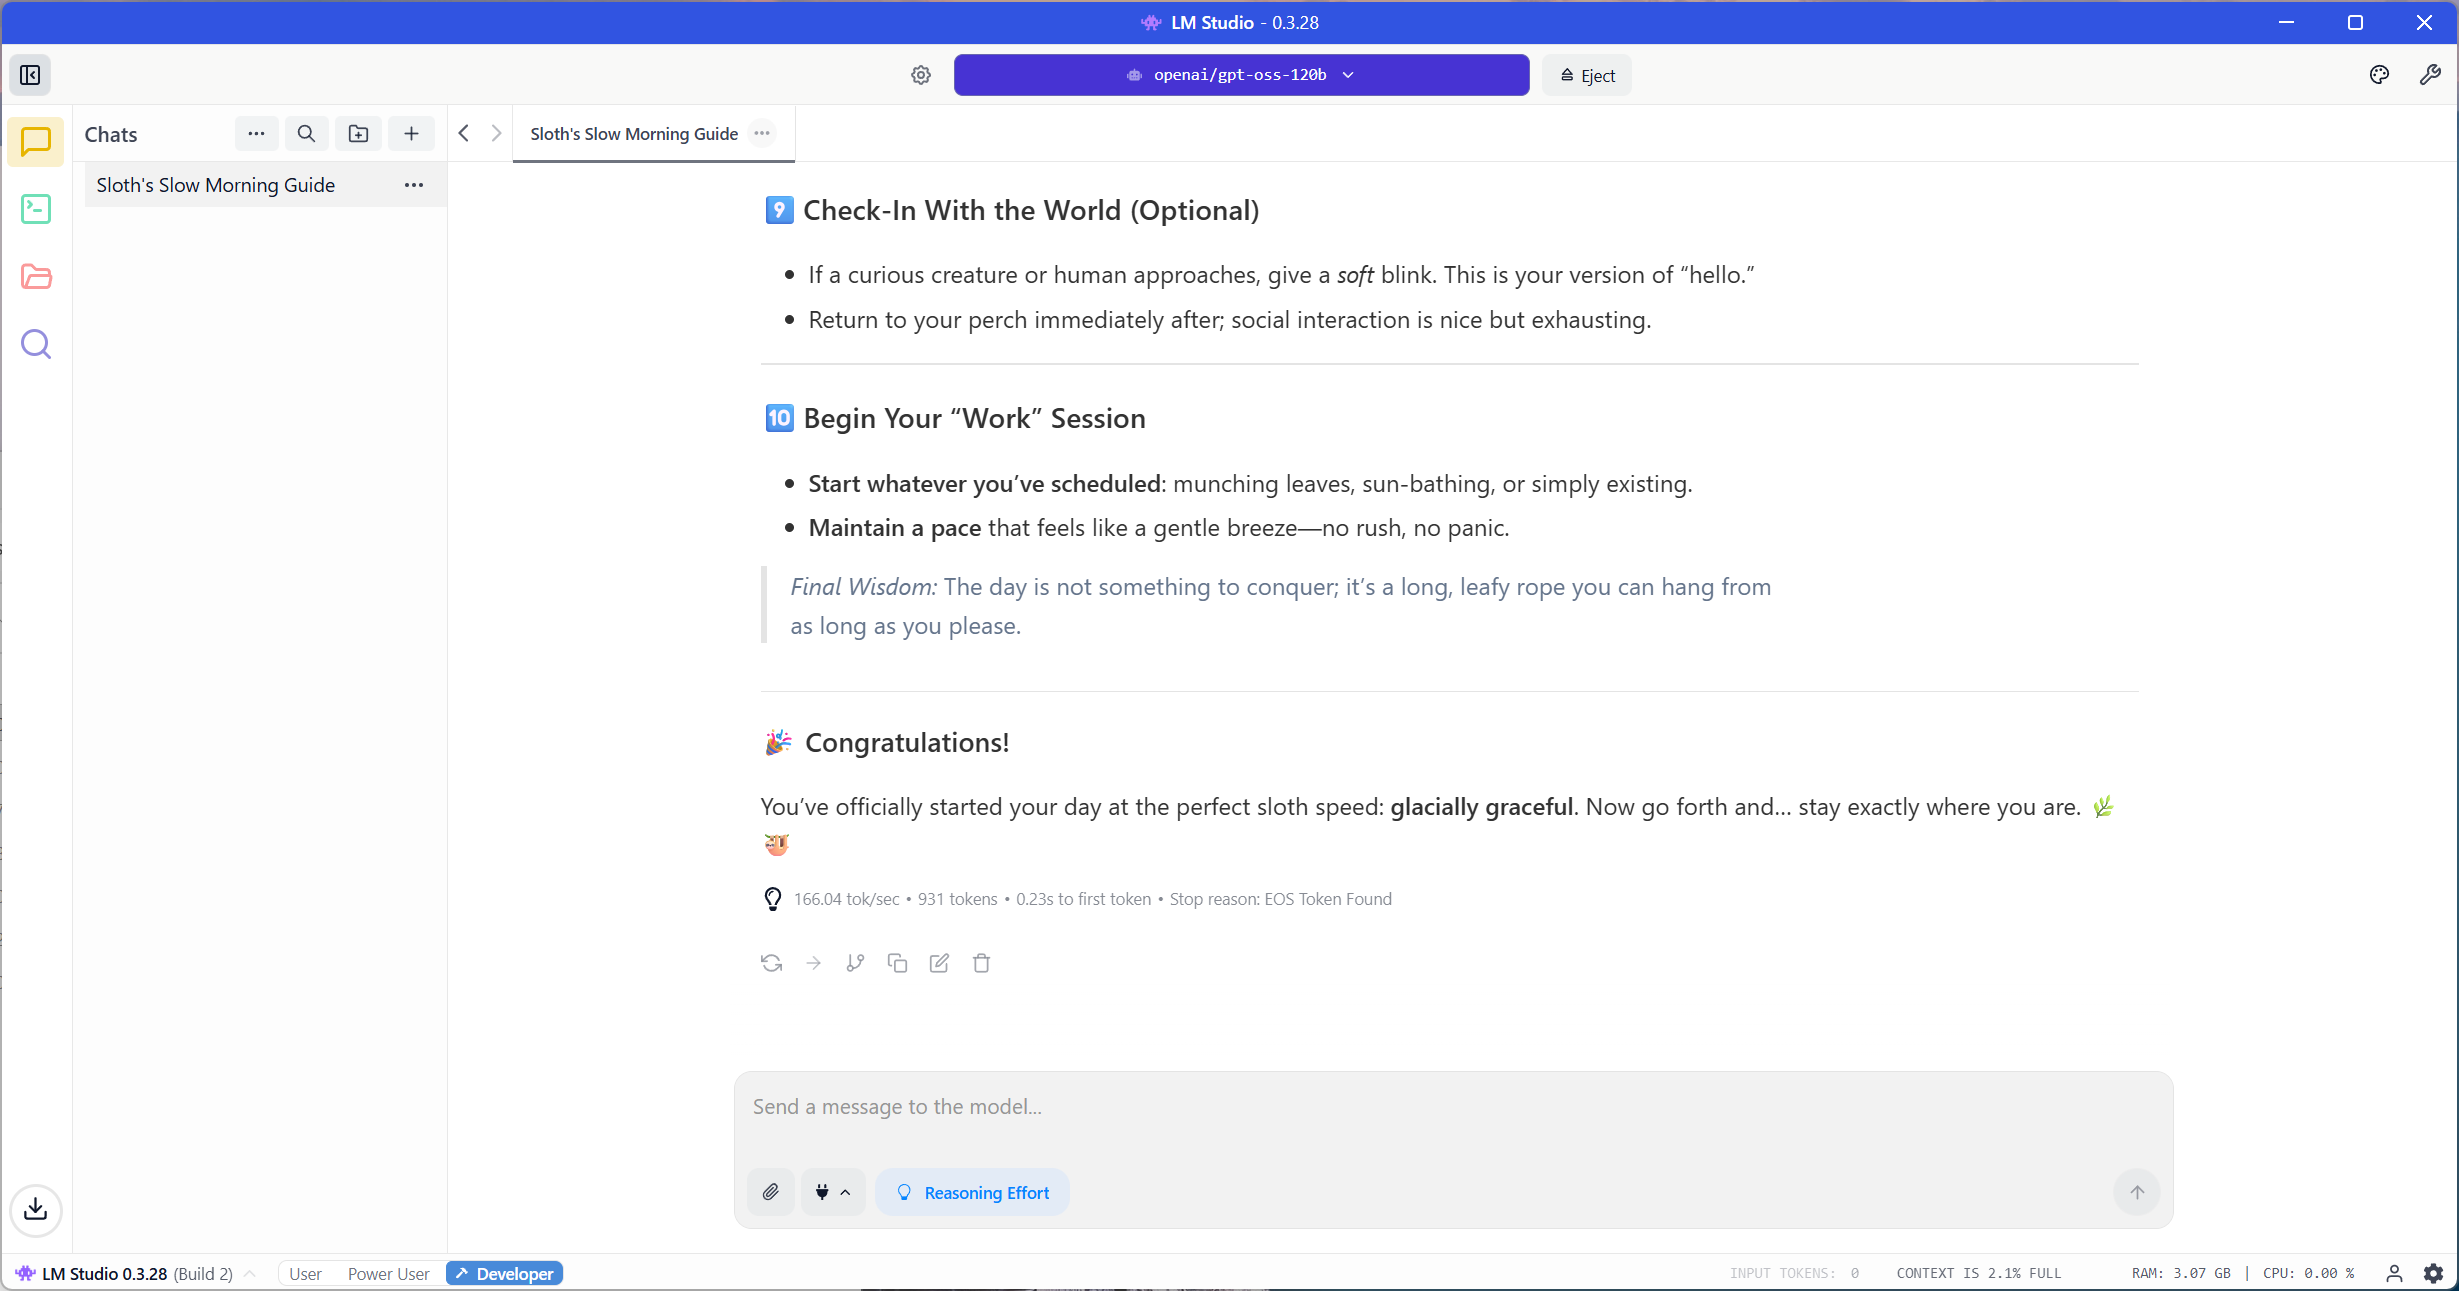
ハードウェアのベンチマークに最適:LM Studio
クローズドソースなのでスター数は表示されませんが、それでもその価値はあります。LM Studio は llama.cpp と MLX の両方をバンドルし、マシンを使用するのではなく測定する場合に重要なコントロール、つまり GPU オフロード レイヤー、量子化の選択、コンテキストの長さ、マルチ GPU 動作を公開します。2025 年 7 月以降、商用利用は無料です。これは、ワークステーションとラップトップのボードにあるトークン/秒の数値のほとんどの背後にあるツールです。最小要件: 16GB RAM、興味深い動作をするには 24GB VRAM または 32GB 統合メモリ。
最適な基盤エンジン: llama.cpp
このページにある他のほとんどすべては llama.cpp の下流にあります。 MIT ライセンスで、約 124,700 のスターがあり、1 日に複数のタグ付きビルドが公開されています。ハードウェアのユーザーにとって重要なのは、特定の理由からです。バックエンドのリストは膨大で、CUDA、ROCm、Metal、Vulkan、SYCL、CANN、OpenCL をカバーしており、ベンダーのエンジニアが最適化を直接貢献しています。ビルド 8688 の Intel Arc のプリフィル改善は、約 5 倍の価値があり、すべての Ollama および LM Studio ユーザーは何もインストールせずにそれを利用できました。最小要件: CPU のみで動作し、8GB の RAM が使用可能です。
最高のローカルファーストデスクトップアプリ:1月
Apache 2.0、約44,100スター、2026年10月時点でv0.8.6。Janはllama.cppをバンドルしているので、他にインストールする必要はなく、ネットワークケーブルが抜かれていても動作します。このカテゴリのアプリのうち、Ollamaフィールドを持つクラウドクライアントがいくつあるかを確認するまでは、これは低いハードルのように聞こえます。これは、ターミナルを決して開かない同僚に渡すのに最適なものです。
また、このページで初めて、弊社独自の数値データに基づいたプラットフォームでもあります。弊社のRTX 5000 Adaベンチマークでは、Jan V3.5 4Bは平均123トークン/秒、Jan V2 VL Highは82トークン/秒でデコードされました。これは、GPUメモリを4.8GBと8.2GB使用し、初回起動時にGPUアクセラレーションを有効にし、CUDA設定を行わなかった結果です。インストールからOpenAI互換APIまでの完全な手順は、弊社のJanハンズオンガイドに記載されています。ドキュメントRAGは、このガイドでカバーされていないアプリの唯一の部分です。最小要件: 8GB RAM。
最高のローカルドキュメントRAG: AnythingLLM
MIT の評価は約 64,800 スターです。ベクター データベースをバンドルし、設定なしでチャンキングと埋め込みを処理するため、デスクトップ クラスで最もすぐに使えるドキュメント チャットとなっています。隠すつもりのない 2 つの点があります。2026 年 3 月に CVSS 9.6 と評価された脆弱性があり、モデル自身のストリーム レスポンスによってリモート コード実行がトリガーされる可能性がありましたが、バージョン 1.11.2 で修正されているため、使用する前にアップデートしてください。また、ローカル ファーストとして宣伝されているアプリでは、テレメトリがデフォルトで有効になっていますが、設定で無効にできます。最小要件:ドキュメント作業には 16GB RAM。
最適なセルフホスト型マルチユーザー:Open WebUI
約149,000個のスターと、最も深い取得構成可能性を備え、サーバーv0.12.2をテストしました。これは、Dockerをエントリポイントとする自己ホスト型サーバーとして始まり、現在は、バンドルされたPython環境と独自のllama.cppランタイムとともにWindowsデスクトップアプリでインストールされます。これをベースに構築する前に知っておくべきことが1つあります。ライセンスは2025年4月にBSD-3からOSI承認されていないカスタムライセンスに変更され、Open WebUIブランドを削除することを禁止する条項が追加され、30日間の期間で50ユーザー未満の場合は例外となります。小規模で変更せずに実行すれば、何も変わりません。
これは、このページで独自の数値を掲載している 2 番目のプラットフォームです。Jan のベンチマークとモデル ファイルでは、Open WebUI Desktop は Jan V3.5 4B を平均 115.32 トークン/秒、Jan V2 VL High を 75.06 でデコードし、異なる llama.cpp ビルドの Jan より 6.2 および 8.5 パーセント遅れています。セットアップで両者が異なります。llama.cpp ビルド b11612 を固定し、CUDA ランタイム DLL を手動で追加し、再インストール後に 8,192 トークンのコンテキストを復元して、スロットごとに最大 169,984 トークンを割り当てられるようにしました。プリセット、画像入力、DDGS ウェブ検索、ローカル API はすべて、Open WebUI のハンズオン ガイドで詳しく説明されているように動作しました。最小要件:コンテナ用に 4GB を加えた別のランタイム、またはバンドルされた llama.cpp を含むデスクトップ アプリ。
最高のローカルコーディングエージェント:クライン
Apache 2.0、約63,900スター。Clineは、OllamaとLM Studio専用に構築されたコンパクトなシステムプロンプトや、モデルファミリーごとのネイティブツール呼び出しなど、競合他社よりもローカルパスで多くの実際のエンジニアリングを行ってきました。クラウドが依然として優位に立っている点について、Cline自身のドキュメントは異例なほど率直です。最小要件: 24GBのVRAMまたは36GBの統合メモリ、コンテキストを32K以上に設定してください。
最高のオフラインターミナルコーディング:Aider
Apache 2.0、約48,300スター、そしてアーキテクチャ的に最も信頼性の高いローカルオプションであるのには、理解する価値のある理由があります。AiderはJSONツール呼び出しを一切使用しません。プレーンテキストからdiffと全ファイル編集フォーマットを解析することで、ローカルモデル上のほとんどのエージェントを壊すまさにその障害モードを回避します。注意点はメンテナンスです。コミットの96%は1人の作者によって書かれており、リリースサイクルは2026年に1回の安定版リリースにまで縮小しています。最小要件: 24GB VRAMまたは36GB統合メモリ。
最高のセルフホスト型エージェントプラットフォーム:OpenHands
MIT、約84,500スター。OpenHandsはローカルモデルを適切に文書化し、さらに便利なことに、問題がセットアップにあるのではないことを教えてくれます。ドキュメントには、エージェントがチャットボットのように動作したり、ツールが常に失敗したりする場合は、モデルが制限であると記載されています。22Kのコンテキストを最小として要求し、32Kを推奨します。最小要件:量子化モデルの場合は24GBのVRAM、または64GBの統合メモリ。
最高の無料オフラインサプライズ:GitHub Copilot CLI
2026 年 4 月以降、Copilot CLI は Ollama、vLLM、および Foundry Local に対して実行されます。GitHub 認証はオプションであり、Copilot サブスクリプションは不要です。COPILOT_OFFLINE を設定すると、すべてのテレメトリとネットワーク接続が停止し、サブエージェントはローカル プロバイダーを継承します。ほとんどの比較記事では、依然としてクラウド専用として記載されています。分割に注意してください。IDE 拡張機能は、独自のキーを使用する場合でも、インライン補完をクラウドに送信します。最小要件:コンテキスト ウィンドウが 128K のモデル、つまり 32GB VRAM または 64GB 統合メモリ。
ベンダー支援型サーバー最優秀賞:Lemonade
Apache 2.0ライセンス、約5,400個のスターを獲得しており、ベンダー関連ツールの中で唯一、その性能だけでおすすめできるツールです。AMDのエンジニアがメンテナンスを担当しており、NVIDIA CUDA、Apple Metal、Vulkan、通常のCPUに加え、RadeonおよびRyzen AI NPUでも動作します。約2週間ごとにリリースされ、2026年4月にはデスクトップアプリをElectronからTauriに移行しました。最小要件: 16GB RAM、NPUパスの場合はRyzen AI 300シリーズ以降。
ファイルシステム全体を対象とした最高のローカルRAG:Nexa AI ハイパーリンク
Nexa AI Hyperlinkはクローズドソースで無料であり、デバイス上のファイルシステム全体をインデックス化し、インライン引用で回答します。このツールがリストに掲載されている理由は、コンシューマー向けハードウェアでの高速化数値を公開している唯一の新しいローカルRAGツールであるためです。RTX 5090では、インデックス作成が約3倍、推論が約2倍高速化され、1GBのフォルダの処理時間が約15分から4~5分に短縮されます。最小要件:最新のRTX GPU、16GB RAM。
ランタイム:モデルを実行するもの
これら5つはエンジンであり、次の2つの表にあるものはすべて、それらのいずれかと通信するフロントエンドです。そのため、この表はページの他の部分と同様にGitHubのスター数順に並んでいます。
ここでのガイド列はアプリと重複するため、それに応じて範囲が定められています。Ollamaは、他のほとんどのツールが参照する主要なツールでありバックエンドであるため、独自のガイドが用意されています。LM Studioは両方の表に表示され、1つのガイドが用意されています。llama.cppは、1月に公開されたハンズオンから始まる、それをバンドルするアプリを通じて解説されています。MLXは、Apple Silicon上のLM Studioを通じて解説されています。vLLMはサービングエンジンであり、そのテストは既に2タワーGB300クラスタのレビューに含まれています。
| ランタイム | 星 | ライセンス | 最小ハードウェア | 加速 | ガイド |
|---|---|---|---|---|---|
| オラマ | 〜179,000 | マサチューセッツ工科大学(MIT) | 8GB RAM(3B)、16GB(7~8B)、24GB VRAM(30Bクラス) | CUDA、ROCm、Metal、Vulkan | 近日発表 |
| ラマ.cpp | 〜124,700 | マサチューセッツ工科大学(MIT) | 8GB RAM、CPUのみで動作します | CUDA、ROCm、Metal、Vulkan、SYCL、CANN、OpenCL | カバーされる XNUMX月 (NAIST) と WebUIを開く 実践的な体験 |
| MLX / mlx-lm | 〜27,500 | マサチューセッツ工科大学(MIT) | Apple Silicon、16GB統合メモリ | Metal; CUDAバックエンドは2026年に追加予定 | LM Studioガイド(近日公開予定)より |
| LMスタジオ | クローズドソース | 独自開発、商用利用無料 | 16GB RAM、24GB VRAMまたは32GB統合 | llama.cppとMLXをバンドルします | 近日発表 |
| vLLM | 生産サービス | Apacheの2.0 | 24GB VRAM リアルな床 | CUDA、ROCm | 弊社でテスト済み GB300クラスターのレビュー |
デスクトップアプリとローカルRAG
これらは読者がインストールするアプリであり、「ローカル優先」列を注意深く読む必要があります。この列は、あなたのマシン上でモデルを実行するソフトウェアと、Ollama URL用のフィールドを追加するソフトウェアを区別しています。
| アプリ | 星 | ライセンス | 地元優先 | 最小ハードウェア | ガイド |
|---|---|---|---|---|---|
| WebUIを開く | 〜149,000 | カスタム品であり、OSI承認品ではありません。 | 機能:サーバーに加え、llama.cppを同梱したWindowsデスクトップアプリ | コンテナ用に別のランタイム + 4GB、またはデスクトップアプリ | Open WebUI ハンズオンガイド |
| なんでもLLM | 〜64,800 | マサチューセッツ工科大学(MIT) | 対応可能。テレメトリはデフォルトで有効。 | RAM 16GB | 近日発表 |
| XNUMX月 | 〜44,100 | Apacheの2.0 | はい、llama.cpp をバンドルします | RAM 8GB | Janの実践ガイド |
| LMスタジオ | クローズドソース | プロプライエタリ | はい | 16GB RAM、24GB VRAMは興味深い | 近日発表 |
| ムスティ | クローズドソース | 独自規格、無料プラン | はい、Ollama、MLX、llama.cpp をバンドルします | RAM 8GB | 近日発表 |
| Nexa AI ハイパーリンク | クローズドソース | 独自開発、無料 | はい、デバイス上でのインデックス作成 | 最新のRTX GPU、16GB RAM | 近日発表 |
コーディングとエージェントツール
これらは、ページ上で最もハードウェア負荷の高い項目です。なぜなら、エージェントによる処理には大きなコンテキストウィンドウと長時間のセッションが必要となるからです。32GBのVRAMまたは64GBの統合メモリが、これがデモではなくなる限界点だと考えてください。
| ツール | 星 | ライセンス | ローカル パス | 最小ハードウェア | ガイド |
|---|---|---|---|---|---|
| オープンハンズ | 〜84,500 | マサチューセッツ工科大学(MIT) | LM Studio、Ollama、vLLM、SGLang | 24GB VRAMまたは64GB統合メモリ、32Kコンテキスト | 近日発表 |
| クライン | 〜63,900 | Apacheの2.0 | Ollama、LM Studio、OpenAI互換 | 24GB VRAMまたは36GB統合 | 近日発表 |
| グース | 〜52,900 | Apacheの2.0 | Ollama一流企業。現在はLinux Foundation。 | 24GB VRAMまたは36GB統合 | 近日発表 |
| 助けます | 〜48,300 | Apacheの2.0 | Ollama、OpenAI互換。ツール呼び出しなし | 24GB VRAMまたは36GB統合 | 近日発表 |
| ゼッド | バージョン1.0、2026年4月 | Apacheの2.0 | LM Studio、Ollama、llama.cpp | 24GB VRAMまたは36GB統合 | 近日発表 |
| GitHub コパイロット CLI | クローズドソース | 独自開発のため、購読は不要です。 | オラマ、vLLM、ファウンドリー・ローカル | 32GB VRAMまたは64GB統合メモリ、128Kコンテキスト | 近日発表 |
ベンダーの取り組み
すべてのシリコンおよびOSベンダーがローカルAI向けの製品を出荷しており、その名称が紛らわしく、廃れ率も高いため、このカテゴリは独自の項目として扱うべきである。2026年を通してのパターンは一貫している。ベンダーはサードパーティスタックとの競争をやめ、サードパーティスタックに製品を提供し始めた。NVIDIAは自社のローカルAI製品を両方とも廃止し、現在はOllama、llama.cpp、およびComfyUIの最適化を公開している。AMDはLM Studioと共同ブランドを展開している。Qualcommは他社のアプリを移植することでNPU機能を出荷した。
OllamaやLM Studioではできない、ベンダーツールが実現できる唯一のことは、NPUへのアクセスです。llama.cppにはNPUバックエンドがないため、SnapdragonやRyzen搭載のAIマシンでは、これらのツールはニューラルエンジンを0%しか利用しません。40~60 TOPSの性能を期待していたとしても、それを利用するのはベンダーのパスだけです。NPUは現在70億モデル程度が上限であり、常に稼働している小規模モデルの処理では、スループットではなくバッテリー寿命がメリットとなるため、その点を考慮して期待値を調整してください。ディスクリートGPUは、速度の面では常にNPUを凌駕します。
| ベンダー | それは何ですか | タイプ | 必要なハードウェア | ステータス | ガイド |
|---|---|---|---|---|---|
| AMDレモネード | サーバー、GUI、SDK。スター数約5,400、Apache 2.0ライセンス。 | アプリ+サーバー | 16GB RAM、NPUにはRyzen AI 300+を使用。NVIDIA、Apple、CPUでも動作します。 | 活動中、約2週間ごとに発送 | 近日発表 |
| Intel OpenVINO GenAI | ランタイムとSDK;約10,700スター | SDK | Core Ultra、Arc A/Bシリーズ、16GB RAM | アクティブ、2026年8月時点で2026.3 | 追跡可能、ガイドの予定なし |
| Apple Foundationモデル | OSによって公開されるデバイス上のモデル | OSフレームワーク | Apple Silicon; 既にインストール済み | 有効。WWDC 2026で全てのプロバイダーに開放。 | 追跡可能、ガイドの予定なし |
| マイクロソフト・ファウンドリー・ローカル | ローカル推論SDKおよびCLI。スター数約2,400。 | SDK | Windows、macOS、Linux、NPU/GPU/CPU | 一般公開予定:2026年4月;厳選モデルカタログ | 追跡可能、ガイドの予定なし |
| AMD ガイア | Ryzen AI向けローカルLLMアプリ。約1,400スター、MIT | アプリ+SDK | Ryzen AI 300シリーズ以上(最小要件)、RAM 16GB(推奨64GB) | アクティブ、v0.20.0 2026年6月 | 追跡可能、ガイドの予定なし |
| インテル AI プレイグラウンド | デスクトップアプリ;約900個の星 | アプリ | Arc Aシリーズ 8GB+、Arc Bシリーズ、Core Ultra | 2年経ってもまだベータ版のままだが、活発に活動している。 | 追跡可能、ガイドの予定なし |
| クアルコム GenieX | Snapdragon NPU向けオンデバイスGGUFランタイム | ランタイム | Snapdragon X / X Elite、8 Elite | 開発者向けプレビュー版、2026年7月 | 追跡可能、ガイドの予定なし |
| NVIDIA プロジェクト G-Assist | システム制御用のデバイス内8Bアシスタント | アプリ | RTX 20シリーズ以降、6GB VRAM | アクティブだが、まだプレリリース版と表示されている | 追跡可能、ガイドの予定なし |
ネーミングも混乱を招いている。NVIDIAの「RTX AI Garage」は製品名のように聞こえるが、実際はブログシリーズだ。Microsoftのスタックも何度も名前が変更されている。Copilot Runtime APIはWindows AI APIに、Azure AI FoundryはMicrosoft Foundryに、そしてDirectMLは現在、セキュリティ修正のみを行うメンテナンスモードになっている。Qualcomm AI Hubは、物理デバイスをリモートでプロビジョニングするクラウドサービスであり、ローカルで実行するものではない。
よく壊れるもの
ローカルモデルが「動作しない」という報告のほとんどは、モデルの問題ではなく、設定の問題です。特に以下の4つの問題が大きな割合を占めており、ハードウェアに関心のある人であれば、シリコンのせいにする前にこれら4つの問題を知っておくべきです。
1. Ollama はデフォルトで 4,096 トークンのコンテキストを使用します。この制限を超えてもエラーは発生せず、静かに切り捨てられ、エージェント ループは静かに終了します。本格的なハーネスでは、より多くのトークンが必要です。OpenHands は最低 22K、推奨は 32K、Codex は 32K、Copilot CLI は 128K、Cline は 262,144 に設定しています。この設定は、おそらくオンラインで見かける障害報告の最も一般的な原因です。
2. KVキャッシュの量子化は、特にツール呼び出しの性能を低下させます。これは、一般的な出力品質が目に見えて低下する前に発生します。llama.cppのドキュメントには、この点について直接警告が記載されています。エージェントを実行している場合は、これを無効にしてください。
3. ツールの数は、緩やかな傾斜ではなく、急激な変化をもたらします。スコープ内のツールがおよそ 5 個または 6 個を超えると、一部のモデルは有効な JSON ツール呼び出しを静かに停止し、代わりにレスポンスボディに XML を埋め込むようになります。ハーネスはこれを「ツールが使用されていません」と読み取ります。ある人気エージェントはデフォルトで 11 個のツールを出荷し、2026 年初頭まで推奨モデルを壊しました。Open WebUI テストで、組み込みのツール指示によって短いベンチマーク要求が 8,192 トークンのコンテキストを超えてプッシュされたという、これと似た現象が発生しました。実際の結果は直感に反します。多くの MCP サーバーをロードすると、フロンティア モデルとは異なり、ローカル モデルでは積極的に悪影響を及ぼします。
4. Q4_K_Mは実用的な最低値です。これ以下では、ツール呼び出しの信頼性が全体的な品質よりも急速に低下するため、モデルは音は正常に聞こえるものの、実際には何も機能していません。
メモリが制約となる
このページに掲載されているすべてのツールにおいて、実行できる内容を決定するのは、アクセラレータが認識できるメモリ容量です。これらは、エージェント関連の作業で最もよく挙げられる組み合わせであり、私たちがラボで検証しようとしている組み合わせでもあります。
| Hardware | モデル | フットプリント | 報告されたスループット |
|---|---|---|---|
| RTX 5090、32GB | Qwen3.6-35B-A3B Q4_K_M | 〜21GB | 160~180トーク/秒、262Kコンテキスト |
| RTX 5090、32GB | Qwen3-Coder-30B-A3B Q4_K_M | 〜19GB | 24GBクラスで50~90トークン/秒 |
| RTX 5090、32GB | デブストラル・スモール 24B Q4_K_M | 〜14GB | ツール呼び出し専用に設計されています |
| RTX PRO 6000、96GB | GPT-OSS 120B MXFP4 | 〜63GB | ワークステーション用カード1枚に搭載された100BクラスのGPU。当ラボのレビュー対象製品です。 |
| RTX PRO 5000搭載ノートパソコン、24GB GDDR7 | Qwen3-Coder-30B-A3B Q4_K_M | 〜19GB | これまでテストした中で最大のノートパソコン用GPU(ThinkPad P16 Gen 3);30Bクラスは余裕をもって収まる |
| 96~128GB統合型、Mシリーズ | gpt-oss-120b Q6_K | 〜93GB | 14~20トークン/秒。オープンウェイトモデルの中で最もクリーンなツール呼び出しJSON。 |
マーケティングでは触れられていないので、あえて言っておきますが、最も負荷の高いオープンウェイトモデルはワークステーションモデルではありません。GLM-5.2はパラメータ数が約744Bで、FP8では744GB程度のメモリを必要とします。これは8基のGPUを搭載したデータセンターノードに相当します。Kimi K2とDeepSeek V4も同じカテゴリーに属します。これらのモデルをデスクトップPCで実行するように指示するガイドは誤りです。
上記のスループット数値は、公開されている第三者機関のテスト結果およびベンダー資料から引用したものであり、StorageReviewのラボテスト結果ではありません。ただし、上記の製品選択におけるJanおよびOpen WebUIのデコード数値は例外です。各製品選択がガイド作成プロセスを経ていくにつれて、これらの数値はStorageReview独自の数値に置き換えられます。
クラウドファーストツール、そしてそれらがここにランクインしていない理由
ローカルエージェントはローカルモデルとは異なります。以下のツールはその違いを示しています。それぞれがユーザーのマシン上で動作しながら、推論呼び出しはすべてベンダーのクラウドに送信します。
| ツール | ローカルモデルのサポート | お願い |
|---|---|---|
| カーソル | いいえ | 公式ドキュメントによると、すべてのリクエストはCursorサーバーを経由してルーティングされ、カスタムキーは主要なクラウドプロバイダーでのみ機能し、タブ補完は常にCursorモデルを使用する。2026年にSpaceXに買収された。 |
| デビン・デスクトップ(旧姓ウィンドサーフ) | いいえ | 2026年6月に名称変更。すべてのモデルはクラウド上でホストされています。 |
| Google 反重力 | いいえ | ドキュメントには、Ollama、LM Studio、またはカスタムエンドポイントを使用できないことが明記されています。 |
| ジェミニ CLI | いいえ | 地域的なサポートはコミュニティフォークでのみ存在する |
| コド | いいえ | 「オンプレミス」とは、クラウドモデルと呼ばれる自己ホスト型インフラストラクチャを指します。 |
| IDE 内の GitHub Copilot | 一部 | チャットはローカルモデルを使用できます。インライン補完は、独自のキーを使用する場合でもクラウドベースのままです。 |
| AI言語モデルを活用してコードのデバッグからデータの異常検出まで、 | いいえ | デスクトップアプリとモバイルアプリは、OpenAIのクラウドモデルのクライアントです。OpenAIのオープンウェイトgpt-ossモデルはローカルでも実行されますが、ChatGPTアプリではなく、上記のランタイムを介して実行されます。 |
| クロード | いいえ | ClaudeアプリとCoworkはAnthropicのクラウドモデル上で動作します。Claude CodeはOllamaのAnthropic互換APIを介してローカルモデルを参照できますが、これは機能するものの、サポート対象外の構成です。 |
| 一般的なエージェントアシスタント | いいえ | このクラスのツールはあなたのマシン上で動作しますが、推論にはクラウドモデルに依存します。 |
「CursorをOllamaに接続する」というガイドはよく見かけますが、Cursorの公式ドキュメントはそれらと矛盾しています。オフラインでの操作が必須条件であれば、この点が決定的な違いとなります。
画像や動画の生成についてはどうでしょうか?
ローカル画像生成は、ローカルAI分野における最大規模のコミュニティの一つです。ComfyUIだけでも、GitHubのスター数で上記に挙げたツールのほとんどを凌駕しており、ローカル動画生成は、最もVRAMを消費するコンシューマー向けワークロードとして台頭しています。独自のランキングが設けられるに値し、実際に設けられる予定です。このページに4つ目のカテゴリを追加すると、この分野が埋もれてしまうでしょう。それまでは、このページのハードウェアロジックはそのまま適用されます。画像や動画の処理は、言語モデルよりもさらにメモリを多く消費するため、同じ階層構造が適用されます。
このページの使い方
ランキングは3つのルールに基づいており、1つ目は、今のところGitHubのスター数で順位付けすることです。これは理想的ではありませんが、中立的で検証可能であり、テストしていないものをテストしたふりをする必要もありません。クローズドソースのツールにはその旨が明記され、架空のスコアは付けられません。独自のテストで明確なお気に入りが見つかれば、測定結果を反映するように順位付けが変更され、その旨を明記します。JanとOpen WebUIにはラボの数値が付与されたので、その変更は既に始まっています。2つ目は、すべての項目に最小メモリ量が付けられていることです。これは、モデルがロードされるかどうかを決定する数値だからです。
第三に、「ガイド」欄は、選定製品に特化した取り組みです。ランキング上位の製品には、当社のハードウェア上での具体的な設定手順と数値データが記載された実践的なガイドが用意され、アプリに組み込まれているランタイムについては、そのアプリのガイドで解説されています。また、ベンダーの取り組みについては、ガイドがなくてもそれぞれの表で追跡されています。各ガイドが公開されると、ここにリンクが表示されます。
ローカルLLMツールに関するよくある質問
どのローカルLLMツールから始めるべきでしょうか?
ターミナル操作に慣れているならOllama、コントロール付きのウィンドウ操作を好むならLM Studio、そしてすぐに使えて追加インストールが不要なものが欲しいならJanがおすすめです。3つとも無料で、完全にオフラインで動作し、内部的にはllama.cppを使用しているため、モデルの動作は同じです。違いはインターフェースだけで、速度に差はありません。
NVIDIA ChatRTX、GPT4All、Continue.devはどうなったのですか?
それらは、驚くほど多くの同業他社とともに姿を消しました。古い推奨事項に従う前に知っておくべき最も重要なことはこれです。NVIDIA ChatRTXは 2026 年 1 月 21 日に非推奨となり、リポジトリはアーカイブされ、サポート フォーラムはロックされました。後継となるものはまだ発表されていません。
GPT4Allは最も厄介なケースです。過去12か月間コミットがなく、最後のリリースは2025年2月ですが、リポジトリはアーカイブされておらず、依然として多くのスターが表示されているため、活動しているように見えます。サポートしている量子化フォーマットは限られており、最新のモデルリリースのほとんどを読み込むことができません。
Continue.dev は、2 年間にわたりローカルモデルコーディングの標準推奨ツールでしたが、Cursor に買収され、2026 年 6 月にサービスを終了しました。Roo Code は2026 年 5 月にサービスを停止し、Voidは2026 年 6 月にアーカイブされ、Twinny は2025 年 11 月に、Reor は2026 年 3 月にサービスを終了しました。Khojは2026 年 4 月にホスト型サービスを終了しましたが、セルフホスト型は存続しています。ベンダー側では、Intel IPEX-LLMは 2026 年 1 月にアーカイブされ、既知のセキュリティ問題があり、移行パスが公開されていないため、フラグが立てられました。NVIDIA RTX AI Toolkit は2025 年 11 月に非推奨となりました。
ローカルLLMを実行するには、どれくらいのVRAMが必要ですか?
チャットの場合、システムRAMが8GBあれば3Bモデルが動作し、16GBあればCPU単体で7~8Bモデルが許容範囲内で動作します。実用的な速度を求めるなら、VRAMまたは統合メモリにモデルを配置する必要があります。16GBで7~14Bクラス、24GBでQ4の30Bクラス、32GB以上でエージェントコーディング作業がストレスなく行えるようになります。それ以上になると、帯域幅よりも容量が重要になるため、96~128GBの統合メモリを搭載したマシンでは、市販のグラフィックカードでは処理できないモデルが動作します。
ローカルのLLMツールは私のNPUを使用しますか?
通常はそうではありません。llama.cppにはNPUバックエンドがないため、OllamaとLM StudioはSnapdragonまたはRyzen AIマシン上でニューラルエンジンを0%のままにして、代わりにCPUまたはGPUで実行します。現在NPUにアクセスするには、ベンダーパスが必要です。Qualcomm GenieX、NPUランタイムを備えたAMD Lemonade、Intel OpenVINO、またはOSフレームワークを介したAppleのNeural Engineです。NPUも現在70億モデル程度が上限であり、ディスクリートGPUは常にスループットでNPUを上回るため、バッテリー寿命と低消費電力の常時稼働がメリットとなります。
ローカルAIはWindowsとLinuxのどちらで実行すべきでしょうか?
このページに掲載されているデスクトップアプリに関しては、WindowsとmacOSが最もスムーズな動作環境を提供します。LM Studio、Jan、AnythingLLM、Ollamaはすべてネイティブにインストールでき、GPUドライバは通常の場所から入手でき、ターミナルは不要です。Linuxは、その一段階下で独自の地位を確立しています。本番環境向けサービスエンジンであるvLLMとSGLangはLinuxファーストであり、マルチGPUサービスも事実上Linuxを前提としています。また、AMDのRyzen AI NPUサポートなど、最新のアクセラレーションパスの一部は、他のどの環境よりも早くLinuxに実装されており、Ryzen AI NPUサポートはLinuxに登場し、非常に新しいカーネルを必要とします。
その差は以前よりも縮まっています。AMDは2026年にROCmのリリースをWindowsとLinuxで統一し、残りの大部分はWSL2でカバーされているため、Open WebUIのようなDockerベースのツールはWindowsマシンでも問題なく動作します。実用的なルールとしては、デスクトップアプリのテーブルからインストールする場合は、現在使用しているOSのままにしておくこと、専用のサーバーボックスを構築したり、あらゆるアクセラレーションパスを追求したりする場合は、Linux上で構築することです。
ローカルモデルは、コーディングにおいてクラウドモデルを置き換えるのに十分な性能を備えているだろうか?
それは完全にタスク次第であり、その差は多くの報道で認められているよりも明確です。限定された作業、単一ファイルの生成、単体テスト、定型コード、コードの説明といった作業においては、高性能ワークステーション上の現在のオープンウェイトモデルは、最先端のクラウドモデルとほぼ同等の性能を発揮します。しかし、長期的なエージェント型作業、大規模リポジトリ全体にわたる複数ファイルのリファクタリングといった作業においては、明らかに劣勢となり、その失敗は、何も実行されないまま処理が停止したり、実際には行われていない作業が自信満々に報告されたりするなど、好ましくない形で現れます。ローカル環境への移行理由がプライバシー、エアギャップ要件、またはコストであれば、現時点では実現可能です。しかし、その理由が機能性であれば、まだ実現可能とは言えません。
モデルをローカルで実行する方が、クラウドサービスを利用するよりも安全でしょうか?
データ所在地の要件を満たすのであれば、答えはイエスです。これが、ほとんどの人がローカル環境を選択する理由です。ソフトウェアのセキュリティに関しては、デフォルトではノーです。2026年3月にCVSS 9.6と評価されたローカルAIアプリは、デスクトップアプリが安全でないデフォルト設定でパッケージ化されているため、モデル自身のストリーム出力によってホスト上でコードを実行するように制御される可能性があります。ローカル環境とは、データがその場所に留まることを意味しますが、ソフトウェアが強化されていることを意味するわけではありません。このカテゴリでは、頻繁に更新されるコードが多数含まれているためです。
AIエージェントサンドボックスとは何ですか?また、ローカルAIには必要ですか?
サンドボックスとは、通常はコンテナまたは軽量仮想マシンといった隔離された環境であり、AIエージェントが生成したコマンドやコードを実行する場所です。そのため、ミスや悪意のある命令がホストシステムに影響を与えることはありません。エージェントは質問に答えるだけでなく、シェルコマンドの実行、ファイルの編集、ブラウジングなども行います。そして、これらの動作はすべて、操作可能なモデルの出力によって制御されています。モデルをローカルで実行しても、この計算式は全く変わりません。
サンドボックスとは、エージェントの動作を隔離するものであり、モデルがどこに存在するかを隔離するものではありません。前述のコード実行の脆弱性は、まさにローカル環境を優先するアプリケーションにおいて、この点を浮き彫りにしました。このページで紹介するツールの中には、サンドボックス機能を内蔵しているものもあります。また、ホストへのアクセス権を制限せずにエージェントを実行するツールは、重要なマシンで使用する前に、より慎重に検討する必要があります。エージェントの導入がビジネス環境に広がるにつれ、サンドボックス機能は主要な機能となり、当社もこれらのツールを評価する際に、サンドボックス機能を考慮に入れるようになるでしょう。
ローカルハードウェアは、数十個のサブエージェントを持つエージェントワークロードを実行できますか?
これは最先端技術であり、簡単に言えば、単一のワークステーションではすぐにメモリが不足してしまうということです。マルチエージェントワークロードでは、それぞれ独自のコンテキストを持つサブエージェントが生成され、推論側では、アクティブなコンテキストごとにメモリ内に独自のKVキャッシュが生成されるため、フットプリントは並列処理とモデルサイズの両方に応じて増加します。メモリ容量を超えたキャッシュをどこに移動させるかは、それ自体がエンジニアリング上の課題です。DellとSolidigmのハードウェアをベースにした、 KVキャッシュをフラッシュメモリにオフロードする詳細な解説は、このテーマに関する当社のこれまでの最良の解説です。
30Bクラスのエージェントセッションを快適に処理できるマシンであれば、通常、レイテンシが悪化する前にバッチ処理サーバーを介して数個の並列セッションを処理できます。数十個の同時サブエージェントはサーバー領域であり、多数のライブコンテキストを保持できる十分なメモリと、継続的なバッチ処理用に構築されたvLLMのようなサービスエンジンが必要です。また、ローカルモデルはツール数の増加に伴って信頼性が低下し、オーケストレーションによってツールとハンドオフが増加するため、品質にも限界があります。
我々の見解では、単一エージェントまたは少数エージェントによる処理は、今日では正当なワークステーション業務であり、大規模なサブエージェント群による処理はインフラストラクチャ業務である。この境界線、そしてその境界線を越えるために必要なハードウェアについては、今後さらに深く探求していく予定だ。


 Amazon