

2026年10月13日更新:社内スタイルに合わせてコピー処理を行いました。ベンダープロファイル、クレームトラッカー、およびデータは変更されていません。
主要なストレージベンダーはどこも最高のストレージアレイを販売していると主張しており、長年にわたり最速が最高の指標とされてきたが、独立したテストを実施しているベンダーはほとんどない。Dell、Everpure(旧Pure Storage)、VAST、Weka、IBM、NetApp、Huaweiはいずれもパフォーマンスの優位性を謳っているが、これらの主張の根拠となる数値はほぼすべてベンダー自身の内部テストによるもので、「実際のパフォーマンスは異なる場合があります」という注釈が付いている。
このページはそうした問題を整理するために作成されており、ストレージ性能に関するエビデンスを3つのクラスに分類し、このページ上のすべての数値に適切なラベルを付けています。具体的には、監査済みのベンチマーク提出データ(MLPerf Storage、IO500、SPC-1など、ベンダーが公開ルールに基づいて結果を提出するもの)、ベンダーの主張(独立した検証のない仕様書や発売時の数値)、そしてStorageReviewラボの結果(弊社が独自に測定したシステム)です。ベンダーが自社製アレイのテストを許可しない場合は、その旨を明記します。検証可能なデータがないことも、問題の一部です。
AIストレージのリーダー
これらは、AIトレーニングクラスターやネオクラウドを構築する際に必ず候補となるベンダーです。統一された評価基準がないため、ランキングは作成していません。しかし、各ベンダーに対して、プラットフォームの種類、顧客名義での導入状況、NVIDIAによる検証の有無、監査済みのベンチマーク結果の有無、そして未検証のパフォーマンスに関する主張など、共通の情報を提供することは可能です。ベンダーがこれらの情報に関して何らかのニュースを発表した場合は、プロファイルを更新します。
最初の4社はAIネイティブなストレージ専門企業であり、残りはAI製品ラインを持つ既存のエンタープライズストレージベンダーである。両グループとも実際の導入実績を獲得しているが、それぞれが持つ実績の量は大きく異なる。
VASTデータ
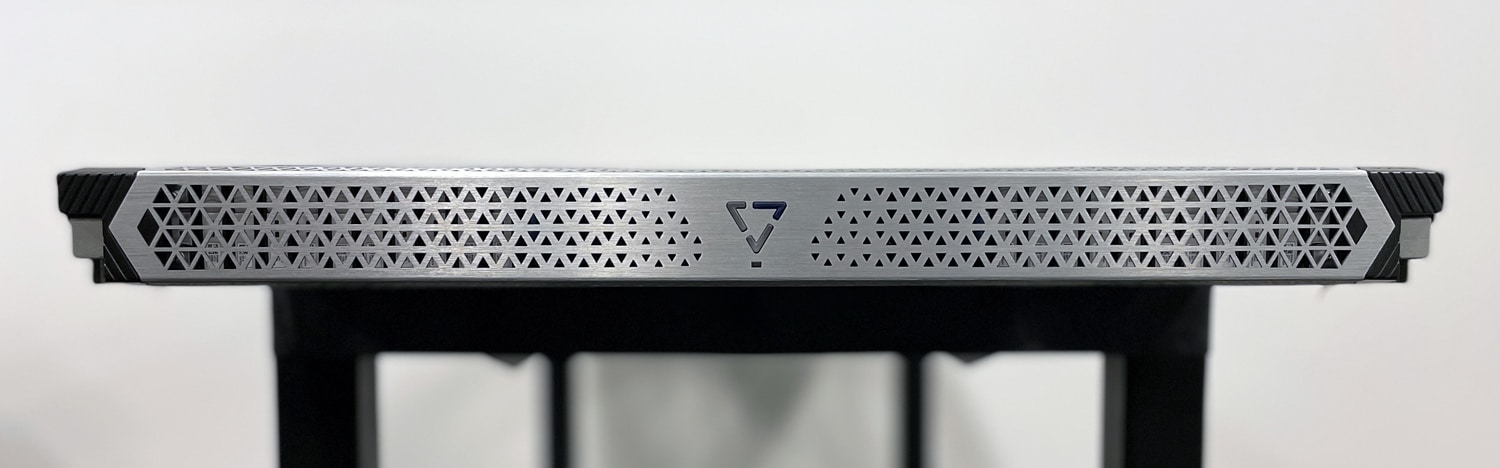
プラットフォーム: DASE(Disaggregated, Shared-Everything)アーキテクチャに基づいて構築されたVAST AIオペレーティングシステム。ステートレスなコンピューティングコンテナがNVMe-oF上のNVMeエンクロージャのプールを前面に置き、ストレージクラスメモリ書き込みバッファを備えたオールQLCメディア上で、ファイル、オブジェクト、データベースアクセス全体にわたって単一のネームスペースを提供します。
具体的な導入事例としては、 2025年11月に発表された11億7000万ドルの複数年契約に基づくCoreWeaveがあり、VASTはCoreWeaveを最大の顧客と位置付けている。VASTはxAI Colossus Frontier AI Factoryの拡張にも追加され、NVIDIA GB300 NVL72上で稼働するMistral Compute AIファクトリーにも搭載されている。
NVIDIA認証: NVIDIA認定ストレージローンチパートナーであり、DGX SuperPOD向けに認証済みです。
監査結果:なし。VASTはMLPerf Storageにデータを提出したことがありません。
公表されている主張: VASTとAMDは、ベンダーテストの結果、InstinctのKVキャッシュオフロードにより、最初のトークン取得までの時間が9倍高速になったと共同で主張している。2026年4月のシリーズFは300億ドルの評価額で期待値を高めているが、これはパフォーマンスの数値ではない。
過去1年間の報道内容:
- VASTとAMDは、KVキャッシュのオフロードにより最初のトークン取得までの時間が9倍速くなると主張している。 (7月2026)
- ClouderaとVASTがGPU不足の解消を目指す (7月2026)
- VASTがGB300 NVL72上でMistral ComputeのAIファクトリーを稼働させる (5月2026)
- VASTがエージェント型AI OSを発表 (2月2026)
- VAST Amplifyは、既存のSSDを6倍の容量に感じさせることを目指しています。 (Jan 2026)
- VASTはDPUネイティブ推論アーキテクチャを導入する (Jan 2026)
ウェカ
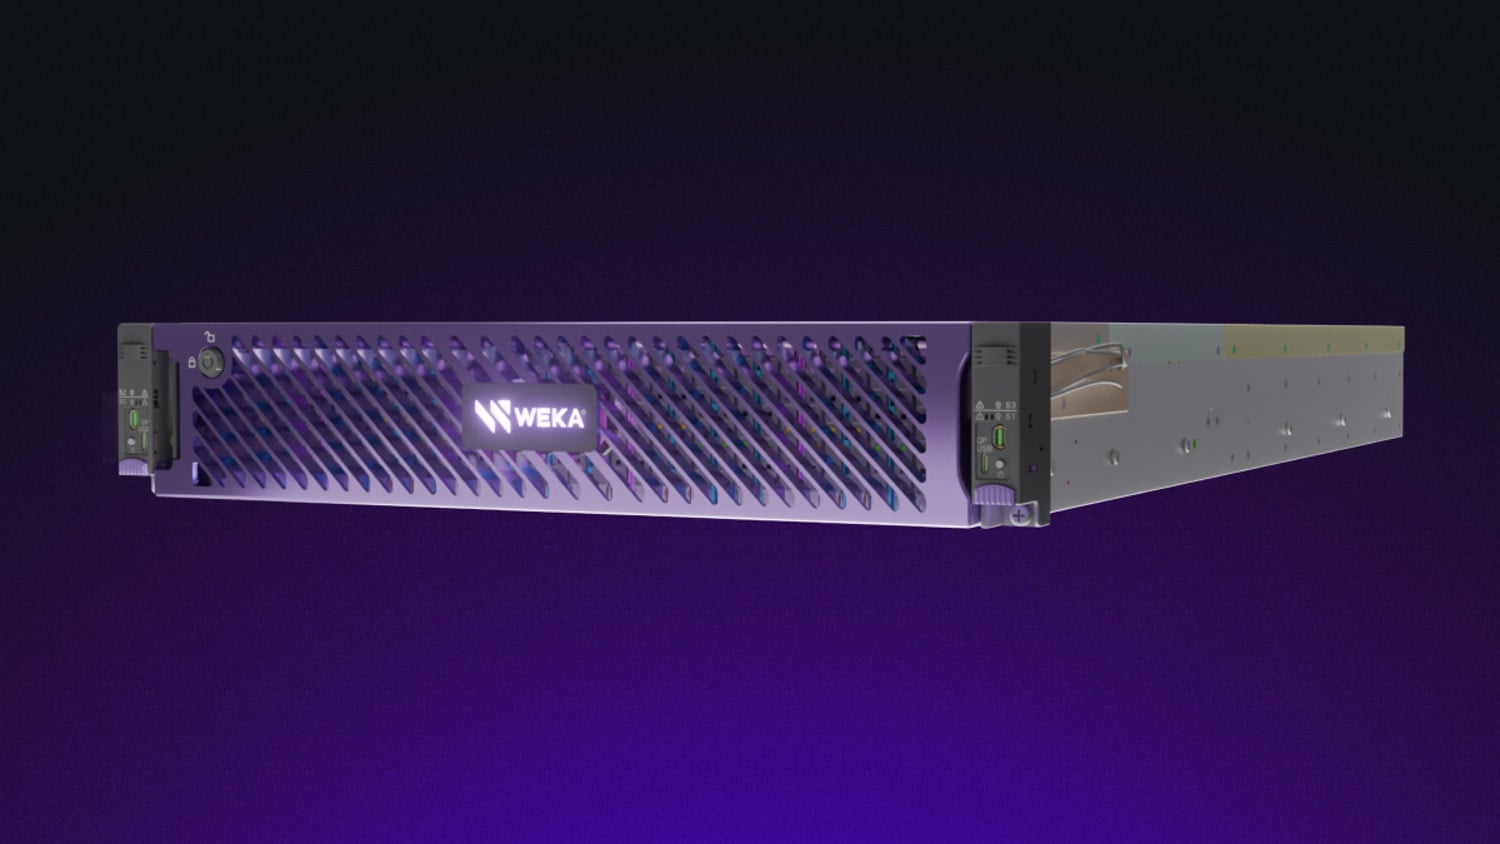
プラットフォーム: NeuralMeshは、以前はWekaFSとして知られていたソフトウェア定義の並列ファイルシステムで、ソフトウェアおよびWEKApodアプライアンスとして販売されています。NeuralMesh Axonは、GPUサーバー内に同じデータプレーンを組み込むことで、ローカルNVMeがクラスタに参加し、アイドル状態になることを防ぎます。
具体的な導入事例: Nebiusは、AIクラウドのプレミアムティアとしてNeuralMeshを採用しています。Andromedaは、2026年7月に約50社のGPUプロバイダー全体でNeuralMeshを標準採用しました。WEKAもCoreWeaveのマルチベンダースタックの一部です。
NVIDIA認証: NVIDIA認定ストレージローンチパートナーであり、DGX SuperPODおよびBasePODの認証を取得済み。
監査結果: WEKAは2024年9月にMLPerf Storage v1.0にデータを提出しましたが、2025年8月のv2.0には提出していません。そのため、最新の監査データは1世代前のものです。
未公表の主張: WEKApod 3(NeuralMesh 6搭載)は、シングルラックで1.1 EBの容量と10.2 TB/sの速度を実現していると主張されている。これはベンダーが公表した数値であり、監査済みの提出資料はない。
知っておくべき点: HPEは2025年11月にWEKA、Qumulo、Scalityとのパートナーシップを終了したため、WEKAはHPEの販売チャネルを通じて顧客に届けられなくなりました。
過去1年間の報道内容:
- Andromedaは50以上のGPUプロバイダーでNeuralMeshを標準化 (7月2026)
- WEKApod 3がシングルラックのエクサバイトの壁を突破 (7月2026)
- NeuralMesh AIDPが一般提供開始 (Mar 2026)
- NeuralMeshは、推論メモリとしてNVIDIA STXと統合されています。 (Mar 2026)
- WEKApod PrimeおよびNitro次世代プラットフォーム (Nov 2025)
DDN
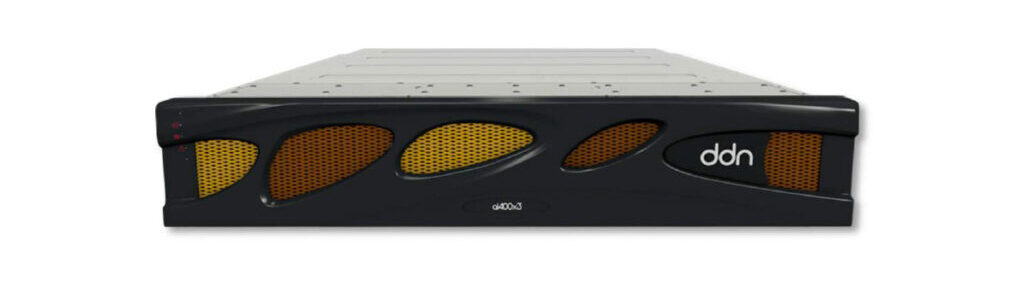
プラットフォーム: 2つの製品ラインがあり、1つはAI400X3およびAI400X3Mアプライアンスの基盤となるLustre由来の並列ファイルシステムであるEXAScalerで、トレーニングを処理します。もう1つは、2.4でマルチテナンシーとPOSIXサポートが追加されたキーバリューオブジェクトプラットフォームであるInfiniaで、推論およびAIファクトリーワークロードを対象としています。
具体的な導入事例としては、 2024年11月に発表された、EXAScalerとInfinia上で稼働する20万個のGPUを搭載したxAI Colossusが挙げられる。DDNは、AIサイクル以前から存在する国立研究所やHPCへの導入実績も多数抱えている。
NVIDIA認証: NVIDIA認定ストレージローンチパートナーであり、DGX SuperPOD認証を取得済み。
監査結果:はい、最新です。MLPerf Storage v2.0において、AI400X3は複数のノードにわたる3D U-Netで120.68 GB/sの速度を維持し、2RUアプライアンスからLlama3-8bチェックポイントを30.6 GB/sの読み取り速度と15.3 GB/sの書き込み速度で処理しました。この結果から、DDNはこのリストの中で最も優れた製品であることがわかります。
未公表の主張: NVIDIA DynamoによるKVキャッシュの高速化は、独立機関ではなくNebulとの共同検証によって実現された。
過去1年間の報道内容:
- DDNがISC 2026でAI400X3Mを発表 (2026年XNUMX月)
- Infinia 2.4では、マルチテナンシーとPOSIXサポートが追加されました。 (7月2026)
- DDNとNebulがKVキャッシュアクセラレーションを検証 (7月2026)
DDNはMLPerf Storage v2.0のパフォーマンス密度でトップだったが、v3.0ラウンドには参加しなかった。
ハンマースペース
プラットフォーム: Hammerspaceグローバルデータプラットフォームとティア0は、GPUサーバーに既に搭載されているローカルNVMeを共有型のチェックポイント対応容量に変換します。標準規格、並列NFS(FlexFiles対応NFS 4.2)に基づいて構築されており、独自の専用機器を使用せず、通常のサーバー上で動作するため、Hammerspaceの専用機器を撮影する必要はありません。
具体的な導入事例: Meta社は、自社のエンジニアリングブログで、24,576個のGPUを搭載した2つのH100クラスターにわたるHammerspaceの導入事例を公開しました。これは、ベンダーではなく運用者が執筆したものであるため、このページに掲載されているベンダーによる大規模AIストレージ導入事例の中で、最も具体的な事例と言えるでしょう。
NVIDIAによる検証:なし。Hammerspaceは、DGX SuperPOD、DGX BasePOD、NCPリファレンスアーキテクチャ、またはNVIDIA認定ストレージのいずれの認証も取得していません。
監査結果:はい、MLPerf Storage v1.0とv2.0の両方で。v2.0では、Tier 0が5つのノードで3D U-Net上で420.8 GB/sの速度を達成し、アクセラレータ利用率は96.4%で、140個のシミュレートされたH100にデータを供給しました。Hammerspaceはこのリストの中で最も監査済みの参加実績があり、NVIDIAの検証結果は最も弱く、ここに挙げた他のほとんどの企業とは正反対です。
当社の報道内容: HammerspaceはStorageReviewのラボテストを受けておらず、最近の記事も限られています。これはプラットフォームの欠点ではなく、当サイト側の不備です。
v2.0の提出者であるHammerspaceも、v3.0のラウンドには参加しなかった。
Dellテクノロジ
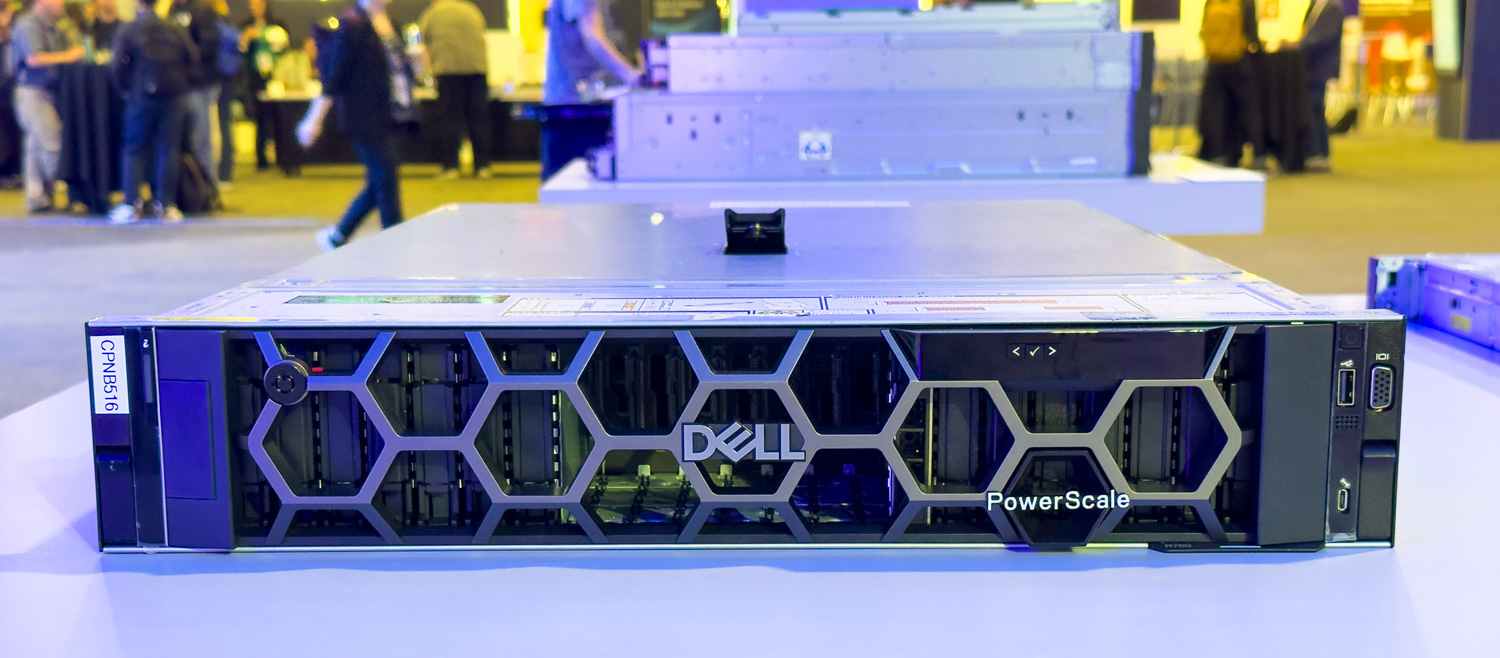
プラットフォーム:パイプラインの異なる部分を対象とした3つの製品群。PowerScaleは、オールフラッシュのFシリーズノードを備えたスケールアウトNAS製品ライン。ObjectScaleはS3レイヤーで、2026年にS3 over RDMAとKVキャッシュオフロードに対応。Lightning File Systemは、2026年4月に一般提供開始された新しい並列ファイルシステムで、DellがDDN、VAST、WEKAに対抗する製品として位置付けている。
具体的な導入事例:デルのストレージ上で大規模なAIトレーニングが具体的に導入されている事例は確認できませんでした。最も具体的な事例としては、PowerScale上で運転安全AIラボを運用しているスバルが挙げられます。この規模のベンダーとしては、AIネイティブベンダーが宣伝するネオクラウドの優位性に比べると、これは大きなギャップと言えるでしょう。
NVIDIAによる認証: NVIDIA認定ストレージのローンチパートナーであり、PowerScaleは2025年7月にNVIDIAクラウドパートナープログラムの認定を取得しました。
監査結果:なし。デルはMLPerf Storageにデータを提出したことがありません。
公開されている主張:デルは、社内分析に基づき、Lightningを世界最速の並列ファイルシステムと称し、Exascale Storageをラックあたり数TB/sの容量と見積もっています。どちらも下記の主張トラッカーに記載されています。購入者への注意点:Lightningは一般提供開始(GA)済みですが、AIファクトリー構築向けに限定されており、ほとんどの読者は標準的な見積もりでLightningを目にすることはないでしょう。
過去1年間の報道内容:
- デルは、2026年のガートナーのエンタープライズストレージ分野のマジック・クアドラントでリーダーの地位を維持しました。 (Aug 2026)
- ObjectScaleは、245TBのKioxia製SSDとRDMA経由のS3を搭載し、2Uサイズで9.83PBの容量を達成した。 (Aug 2026)
- デルは第1四半期の外部ストレージ販売台数で、IDCが選ぶ上位5社の合計を上回った。 (7月2026)
- PowerStore Gen 3 内部のリセット (5月2026)
- PowerStoreOS 5.0の詳細解説、第3世代リセットのソフトウェア面 (Sep 2026)
- GTC 2026におけるLightningファイルシステムとエクサスケールストレージ (Mar 2026)
- PowerEdge R5715のレビュー:実際にテストしたストレージ重視の2U (Mar 2026)
HPE
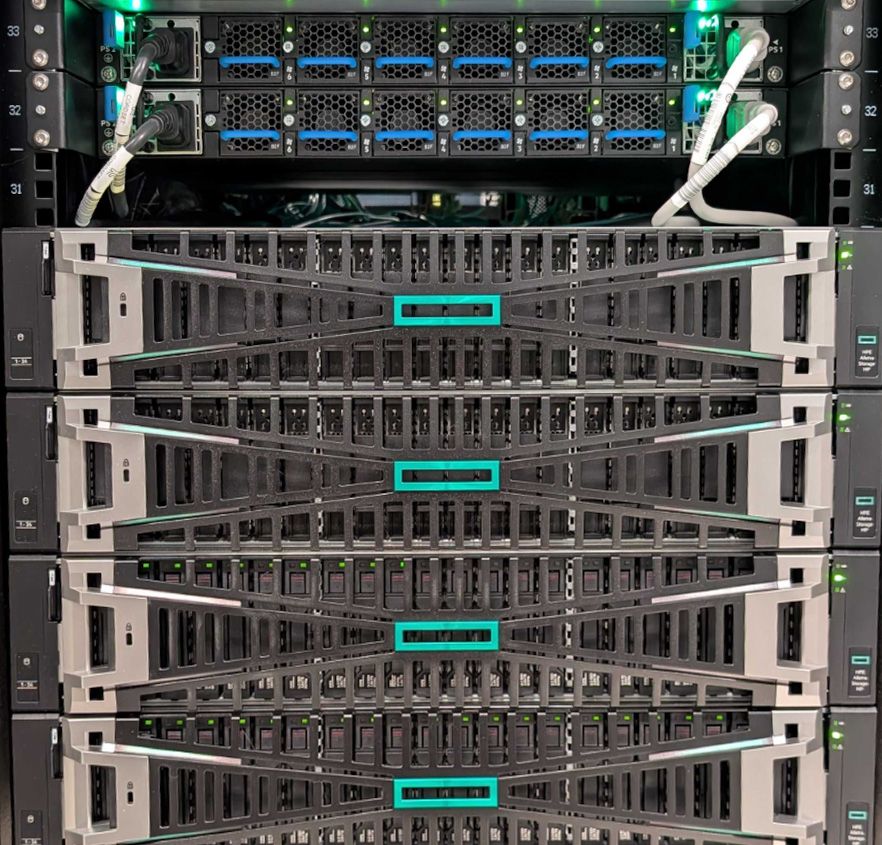
プラットフォーム: Alletra Storage MP。ブロックストレージ用のB10000とオブジェクトストレージ用のX10000に分かれており、さらにファイルストレージ用のGreenLakeも備えている。HPEは、これらの周辺機器であるコンピューティングおよびネットワーク機器も販売しており、同社のAIストレージ製品のほとんどはこの構成で出荷されている。
具体的な導入事例: HPEがフルスタックを提供する、ソブリンAIおよびAIファクトリー構築。上記のVAST、WEKA、DDNの例に匹敵するような、具体的な名称が付けられたネオクラウドの成功事例はない。
NVIDIA認証: NVIDIA認定ストレージローンチパートナーであり、DGX BasePODおよびSuperPODの認証を取得しています。
監査結果: HPEはMLPerf Storageのすべてのラウンド(v1.0からv3.0まで)に参加しており、参加回数ではDellとNetAppを上回っています。ただし、ファイル側のエントリには注意が必要です。HPEのAIファイルにおける最も優れた結果はWEKAとの共同提出によるものでしたが、HPEはQumuloおよびScalityとともに、2025年11月にWEKAとのパートナーシップを終了しました。これらの結果は、HPEが現在販売できる製品を説明するものではありません。
過去1年間の当社の報道:当社はAlletraプラットフォームを実際にテストしました。
- HPEは、2026年のGartnerエンタープライズストレージ分野のマジック・クアドラントでリーダーの地位を維持しました。 (Aug 2026)
- Alletra Storage MP B10000とNIST CSF 2.0、当社の実地テスト (2026年XNUMX月)
- Alletra Storage MP X10000とデータ保護アクセラレータノード (2月2026)
- CloudCasaがB10000向けにKubernetes DR機能を追加 (2026年XNUMX月)
- MLPerf Storage v3.0: K3000を使用した3D U-Netで345.8 GiB/s。このページに掲載されているベンダーのうち、今回のテスト結果を提出したのはわずか2社のみ。
IBM
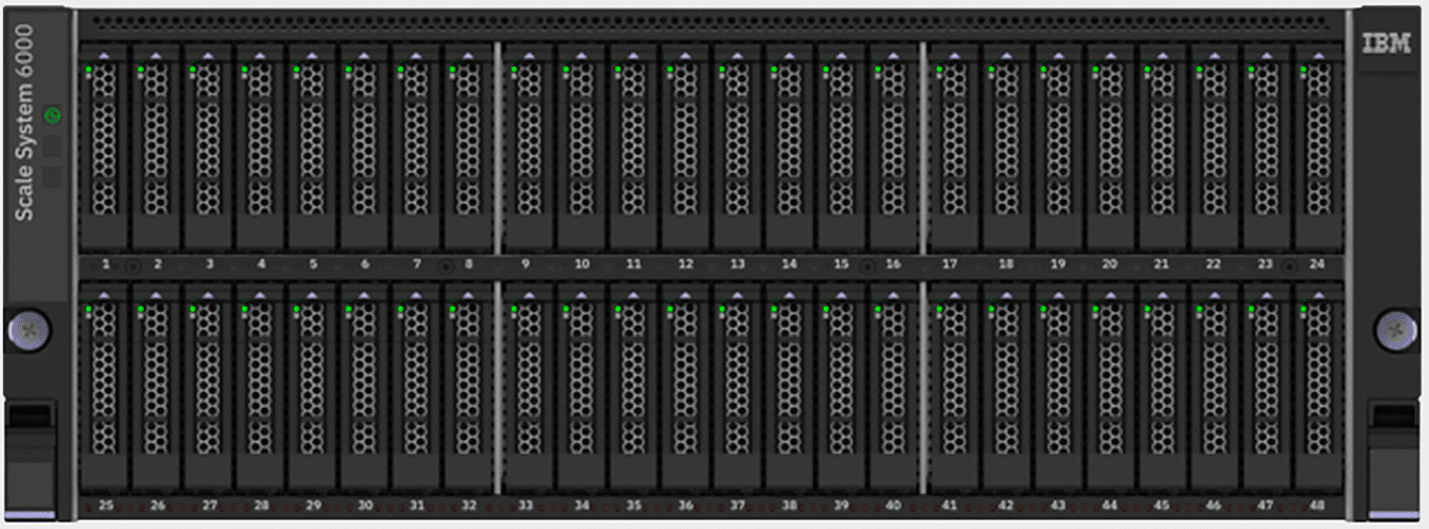
プラットフォーム: IBM Storage Scaleは、GPFSの流れを汲む並列ファイルシステムであり、ソフトウェアおよびStorage Scale Systemアプライアンスとして販売され、FusionによってKubernetesおよびAIパイプライン向けにパッケージ化されています。
名称付きデプロイメント: CoreWeaveのマルチベンダースタックの一部。IBM Cloudは、Together AIと連携した2億4000万ドル規模の専用HGX B300推論クラスタも構築しており、2026年8月に発表されたが、ストレージレイヤーについては明らかにされていない。
NVIDIA認定: NVIDIA認定ストレージローンチパートナー。
監査結果:はい、MLPerf Storage v2.0(チェックポイントワークロードを含む)では、Storage ScaleがLlama 3.1 1Tモデルで656.7 GiB/sの読み取りを記録しました。チェックポイント復元は、フロンティアトレーニング実行中に障害によってどれだけのデータが失われるかを決定する指標であり、監査済みの数値を公開しているベンダーはごくわずかです。
未発表の主張:最速アレイのカテゴリーにおいて、特筆すべき点はない。IBMは、ストレージスケールを、トップレベルのスループット記録よりも、拡張性と統合性を重視して販売している。
過去1年間の報道内容:
- IBMは、2026年のGartnerエンタープライズストレージ分野のマジック・クアドラントでリーダーの地位を維持しました。 (Aug 2026)
- IBMとTogether AIは、HGX B300推論専用クラスターに2億4000万ドルを投資した。 (Aug 2026)
- IBMがRAGワークロード向けコンテンツ認識ストレージを発表 (Apr 2026)
- エージェント型AIを搭載した次世代FlashSystem (2月2026)
- ストレージスケールシステム6000、AIおよびHPC向け統合ストレージ (Nov 2025)
- IBM FlashSystem 5300のレビュー、IBMのコンパクトアレイの実機操作、そしてより大規模なシステムがどのように動作するかを知るための役立つ情報。 (Sep 2024)
エバーピュア(旧ピュアストレージ)
プラットフォーム: FlashBlade//EXAはAI対応のエントリーモデルで、メタデータとデータパスを分離することでデータプレーンを独立して拡張します。FlashBlade//SとFlashArrayは残りの部分をカバーします。Everpureは完成品のSSDを購入するのではなく、独自のDirectFlashモジュールを製造しているため、その密度と耐久性の数値は市場の他の製品とは一致しません。同社は2026年2月23日に正式にEverpureとなりました。
名前付きデプロイメント: CoreWeaveのマルチベンダースタックの一部です。FlashBlade//EXA上での名前付きAIトレーニングデプロイメントについては、確認できませんでした。
NVIDIA認定: NVIDIA認定ストレージローンチパートナー。
監査結果: MLPerf Storage v3.0 (2026 年 9 月)、Everpure の最初の提出: 30 台の FlashBlade//EXA データ ノードで、チェックポイント書き込み速度 877.5 GiB/s、読み取り速度 833.0 GiB/s を記録し、このラウンドで最大のチェックポイント数値を達成。さらに、このラウンドで最大の KV キャッシュ結果である 1,623.4 GiB/s も記録。また、2026 年 2 月 17 日に公開された SPECstorage Solution 2020_ai_image の記録である 6,300 AI ジョブも保持。ベンチマークもワークロード モデルも異なるが、公開されたルール セットとレビュー プロセスに基づく実際の提出であり、評価対象となる。
明示的な主張: FlashBlade//EXAは、業界最高性能のデータストレージプラットフォームとして販売されており、単一のネームスペースで10TB/秒を超えるスループットが予測されています。これは予測値であり、実測値ではありません。
過去1年間の報道内容:
- Everpureは、2026年のGartner MQにおいて、2年連続で両軸のトップに立った。 (Aug 2026)
- EverpureがエンタープライズAIパイプライン向けデータストリームを発表 (2026年XNUMX月)
- データインテリジェンスとエンタープライズデータクラウドの機能強化 (2026年XNUMX月)
- Emulex SecureHBAとEverpure XL130 R5の組み合わせは、AIベンチマークではなく、Everpureハードウェアを実際に操作する機会を提供するものです。 (Mar 2026)
- MLPerf Storage v3.0 (2026年9月): 初回提出、FlashBlade//EXA 上でのチェックポイント書き込み速度 877.5 GiB/s、読み取り速度 833 GiB/s、さらに KV キャッシュ読み取り速度 1,623 GiB/s を記録し、今回のラウンドで最大のチェックポイントおよび推論速度を達成しました。 v3.0の全範囲を網羅.
ネットアップ
プラットフォーム: 2025年10月に発表されたAFXは、AIデータパイプライン向けに構築された分離型オールフラッシュONTAPで、その上にAIデータエンジンがレイヤー化されています。AIPodはNVIDIAが検証したリファレンスデザインです。INSIGHT 2026で発表され、現在注文可能なNovusは、AIファクトリー向けにAFXの上位に位置します。pNFSメタデータは、認定済みのSupermicroサーバー上で動作するData Directorノードに移動し、AFF A90 HAペアがデータを転送します。クライアントは標準のLinux pNFSで、GPUサーバー上に独自のエージェントはありません。
具体的な導入事例: AIトレーニング規模での導入事例は確認できていません。最も有力な公開成果物は、顧客名ではなく、検証済みのアーキテクチャであり、2026年6月からのシスコとのFlexPod AI設計などが含まれます。
NVIDIA認証: NVIDIA認定ストレージローンチパートナーであり、DGX SuperPOD認証を取得しています。
監査結果: MLPerf Storageでは該当なし。NetAppはこれまでこの分野に参入したことがない。Novusの背後にあるNetAppは、ONTAPクラスタが1つのネームスペースに統合された際にほぼ線形スケーリングを示すOmdia監査済みテストを引用している。100 TB/sという見出しは、そのテストに基づくOmdiaのモデリング結果であり、実測値ではない。
過去1年間の報道内容:
- Novusは、100 TB/sを目標に、AFF A90データノードからpNFSメタデータを分離する。 (10月2026)
- NetAppは、2026年のGartnerエンタープライズストレージ分野のマジック・クアドラントでリーダーの地位を維持しました。 (Aug 2026)
- HCLTechは、消費ベースのAIストレージを実現するためにKeystoneとU4Xを組み合わせました。 (Aug 2026)
- NetAppがGPUデータ処理のためにDataPelagoを買収 (7月2026)
- StorageGRID 12.1では、フェデレーションネームスペースと最大12 TB/sが追加されました。 (2026年XNUMX月)
- FlexPodはCiscoと共同でAIアーキテクチャを検証した。 (2026年XNUMX月)
- AFXの発売 (10月2025)
ファーウェイに関する注記
ファーウェイは、MLPerf Storage v2.0で最高の絶対スループットを記録しました。8UデュアルノードOceanStor A800が255台のシミュレートされたH100に給電し、3D U-Netで698 GiB/sを達成しました。これは以下の監査済み表に記載されています。米国、ヨーロッパ、またはこのページが対象とするほとんどの市場の購入者にとって実用的な購入ではないため、リーダープロファイルからは除外しています。数値は実在しますが、入手可能性はそうではありません。2026年のガートナーマジッククアドラントは、反対方向から同じバランスを実現しており、北米以外のOceanStorの強みにより、ファーウェイをリーダークアドラントに留めています。
アナリストの意見
アナリストによる評価は、それ自体が証拠となるものです。監査済みのベンチマークではなく、実行力とビジョンに関する独立した評価であり、これらのシステムが実際に購入される方法に近いものです。2026年のガートナー・マジック・クアドラント(エンタープライズ・ストレージ・プラットフォーム向け)では、昨年と同じ6社のベンダー(Everpure、Huawei、HPE、NetApp、Dell、IBM)がリーダー・クアドラントに名を連ねており、Everpureは2年連続で実行力とビジョンの完成度において最高位を獲得しています。
このページでは、2つの重要な点に留意する必要があります。ガートナーはプライマリストレージ市場を評価し、高性能ファイルおよびオブジェクトストレージ市場は別の調査で追跡しています。上記のAIネイティブのスペシャリストは後者の分野に属しているため、クアドラントにこれらのベンダーが含まれていないのはカテゴリーの境界を示すものであり、評価ではありません。評価対象となった8社のうち6社がリーダーのラベルを獲得したとしても、ラベル自体は購入者にとってあまり意味を持ちません。重要なのは、相対的な順位です。
このリストを変更するにはどうすればよいでしょうか?
重要度の高い順に、以下の4つの項目を検討します。ベンダーが、自社でホストできるハードウェアであれ、より大規模なデプロイメントへのアクセスであれ、当社の方法論に基づいてプラットフォームをテストするためのアクセス権を当社に提供する。ベンダーが、MLPerf StorageまたはSPECstorageといった最新の監査ラウンドに提出する。ベンダーではなくオペレーターが、MetaがHammerspaceで行ったように、デプロイメントを文書化する。あるいは、ベンダーが、現在のポジショニングに依存している指定やパートナーシップを失う(WEKAとHPEの分裂が、両社がAIバイヤーにアプローチする方法を変えたように)。これらの事象が発生するたびに、プロファイルを更新します。
監査済みベンチマークが示すもの
2026年にストレージ性能競争が繰り広げられるのは、AIトレーニングとそれを支えるネオクラウドプロバイダーの分野であり、健全な監査済みベンチマークであるMLCommons MLPerf Storageが存在する唯一のセグメントです。現在公開されているバージョンはv3.0(2026年9月)で、19の組織が提出し、143の結果が寄せられています。このベンチマークは初めて、トレーニングスループット、チェックポイント、2つの新しい推論テスト(ベクトルデータベースとKVキャッシュ)を含むAIパイプライン全体を網羅しており、提出されたベンチマークの約6分の1がS3オブジェクトストレージのサポートを利用しています。
v3.0ではシミュレーション対象のアクセラレータがH100からB200に変更されたため、以前のラウンドの結果とは比較できません。MLPerf Storageは単一の勝者を決定するものではなく、異なるシステムが異なるワークロードと指標で優れた結果を示します。
| システム | 監査結果(MLPerf Storage v3.0) | CLASS |
|---|---|---|
| エバーピュア・フラッシュブレード//EXA | 30のデータノードで、チェックポイント書き込み速度は877.5 GiB/s、読み取り速度は833 GiB/s。KVキャッシュの読み取り速度は1,623 GiB/s。 | チェックポイントおよび推論リーダー |
| YanRongTech F9000X | 99個のシミュレートされたB200アクセラレータにデータを供給する3D U-Net上で543.9 GiB/sの速度を達成 | 提出されたトレーニングスループットの最高値 |
| チューリングデータ F9200 | 3つのストレージノードからの3D U-Netでは541.5 GiB/s、Checkpoint-70Bでは読み取り539.9 GiB/s、書き込み307.1 GiB/sを記録した。 | パフォーマンス密度の新人 |
| Azure で管理される Lustre | 4,096TiBのマネージドクラウドデプロイメントからの642.2 GiB/sのチェックポイント書き込み | 最初のハイパースケールクラウドサービスが提出されました |
| NVIDIA AIストア | OCI、AWS、GCPにまたがるS3オブジェクトストレージへの20件の送信 | 並列ファイルシステム領域におけるオブジェクトストレージ |
HPC 側では、IO500 リスト (ISC 2026 版) は、SCNet の Sugon ParaStor が 500 のクライアント ノード全体で 26,888 GiB/s の測定帯域幅でトップとなり、Intel DAOS システム (Argonne Aurora、LRZ) が複数のトップ スロットを占め、Weka は Samsung SSC-24 経由で登場しています。v3.0 の入れ替わりは、数値と同様に注目に値します。v2.0 のスループット リーダーであった DDN、Huawei、Hammerspace、Lightbits はすべて今回のラウンドには参加せず、Azure や NVIDIA を含む 11 社の新規提出者が登場しました。詳細な分析は、MLPerf Storage v3.0 の報道をご覧ください。
ネオクラウドの動力源は誰か
導入成功事例はベンチマークではありませんが、パフォーマンスを重視する事業者がどのような製品やサービスを購入するのかを示す確かな証拠となります。なお、最大規模のAIファクトリーは複数のベンダーの製品で構成されており、これらのサイトを単一のストレージ企業が完全に所有しているわけではありません。
| AIクラウド | Storage | Details |
|---|---|---|
| コアウィーブ | VAST Data(スタックにはWEKA、DDN、IBM Storage Scale、Everpureも含まれる) | 11億7000万ドルの複数年契約、2025年11月、VASTの最大顧客 |
| xAIコロッサス | Frontier AI Factory拡張パックで追加されたVAST Dataを搭載したDDN EXAScalerとInfinia | DDNは2024年11月にGPU10万台を供給開始すると発表。2025年後半にはマルチベンダー体制となる予定。 |
| ネビウス | WEKAニューラルメッシュ | Nebius AI Cloudのプレミアムティアは、2025年6月に発表されました。 |
| 一緒にAI | IBMクラウド(HGX B300システム) | 2億4000万ドルの契約が2026年8月に発表された。ストレージ層の詳細はまだ明らかにされていない。 |
クレームトラッカー
これらは、AIストレージ分野における現在の「最速」という主張です。いずれも、主張されている規模での独立した検証は行われていません。ほとんどのベンダーは、社内テストとして脚注で言及しており、表の中で最も信頼性の高い情報源は、予測される見出しの背後にあるアナリスト監査済みのテストです。
| ベンダークレーム | 数 | ステータス |
|---|---|---|
| Everpure FlashBlade//EXA、「業界最高性能のデータストレージプラットフォーム」(2025年3月発売予定) | 単一のネームスペースで10TB/秒以上の読み取り速度が見込まれる | ベンダー予測;監査済み提出書類なし |
| Dell Lightning File System、「世界最速の並列ファイルシステム」(一般提供開始:2026年4月) | Dellの社内分析によると、ラックユニットあたり最大150GB/秒。 | ベンダーの主張。監査済みの提出書類なし。 |
| Dellエクサスケールストレージ(GTC 2026) | ラックあたり最大6TB/秒 | ベンダーの主張。監査済みの提出書類なし。 |
| ファーウェイ新世代オーシャンストレージ・ドラド(2024年9月発売予定) | 0.03msのレイテンシで100億IOPSのスペックシート上限 | ベンダー仕様書。ファーウェイが委託したOmdiaのテストでは、実際のOracle RACワークロードにおいて、70マイクロ秒で2.58万IOPSの持続性能が測定された。これは、仕様書上の最大値に対する有用な実測値となる。 |
| WEKA、NeuralMesh 6搭載WEKApod 3、シングルラックでエクサバイトの処理能力を実現(2026年7月) | 1ラックで1.1EBと10.2TB/sを実現 | ベンダーの主張:WEKAはv1.0でMLPerf Storageに最後に送信され、v2.0はスキップされました。 |
| VAST DataとAMD、InstinctにおけるKVキャッシュのオフロードを実現(2026年7月) | 最初のトークン取得までの時間が9倍速くなりました | 共同ベンダーテスト。VASTはMLPerf Storageにデータを提出したことがない。 |
| DDNとNebul、NVIDIA DynamoによるKVキャッシュの高速化(2026年7月) | ベンダーが公表した推論ワークロードの高速化 | パートナーによる検証であり、独立した監査ではありません。DDNは最新のMLPerf Storage v2.0の結果を公開しています。 |
| NetApp Novus、「世界最速のストレージ」(2026年10月発売予定) | 単一のpNFSネームスペース全体で、100 TB/秒のシーケンシャル読み取りが予測される。 | Omdiaによる監査済みの小規模クラスターにおけるほぼ線形スケーリング。100 TB/sという数値は、そのテスト結果に基づくOmdiaの予測値であり、測定値ではありません。 |
SPC-1はどうなったのか?
SPC-1は業界のブロックストレージベンチマークとして記録されていましたが、現在は半ば休止状態です。米国のベンダーは2018年頃に事実上これを放棄し、リーダーボードは中国のベンダーが独占しています。現在認められている記録は、広く引用されているHuaweiの結果ではありません。ExponTech WDS V3は2720万SPC-1 IOPS(2023年11月承認)でトップの承認スコアを保持しており、Inspurの2300万を上回っています。Huaweiの有名な2100万は2020年に記録され、現在は4位です。FlashNexusの3000万IOPSというより高いスコアは2025年2月から審査中で承認されておらず、ストレージパフォーマンス評議会が承認するまでは記録として扱いません。
このページの使い方
このページには3つのルールが適用されます。1つ目は、すべての数値に証拠の種類(監査済み提出データ、ベンダーの主張、StorageReviewの測定値)を明記することです。2つ目は、最新のデータに基づかない最上級表現は繰り返しません。このページに掲載されている有名な「最速」の主張のいくつかは数年前のものであり、その旨を明記しています。3つ目は、このページの検証済みページへのアクセスはどのベンダーにも開かれています。MLPerf StorageまたはIO500にデータを提出するか、当社の標準的な方法論に基づいてテストを行うためのアクセス権を当社に提供してください。
このページでは、AIとネオクラウドストレージのみを取り上げています。主流のエンタープライズ向けブロックストレージ、ファイルストレージ、およびSMBストレージについては、それぞれ専用のページを用意しており、ここでは取り上げていません。これは、各分野で入手可能なデータが異なるためです。リーダーのプロフィールは、新しい情報が入り次第更新し、監査済みの新しいレポートが公開された際には、全面的に見直しを行います。
最速ストレージに関するよくある質問
世界最速のストレージアレイは何ですか?
検証済みの回答は一つもなく、回答を提示する人はベンダーの情報を引用しているに過ぎません。2026年9月時点の監査済みデータによると、EverpureのFlashBlade//EXAはMLPerf Storage v3.0で最大のチェックポイント値となる877.5 GiB/sの書き込みを記録し、YanRongTechのF9000Xはトレーニングスループットで543.9 GiB/sを記録し、Sugon ParaStorはIO500帯域幅リストでトップに立ち、ExponTechはSPC-1 IOPSの記録を保持しています。Dellのラックあたりのエクサスケールストレージ予測など、主張されている最大の数値は、独自に検証されていません。
AIトレーニングに最適な最速のストレージは何ですか?
唯一の監査済みAIストレージベンチマークであるMLPerf Storage v3.0で評価すると、トレーニングスループットのリーダーはYanRongTech、TuringData、UBIXであり、チェックポイントとKVキャッシュ推論ではEverpureが、クラウドサービスではAzureがトップです。最大規模のAIオペレーターが展開しているものに基づいて評価すると、VAST、DDN、WEKAがネオクラウドの勝利を独占していますが、これら3つはいずれもv3.0に提出しておらず、両方の種類の証拠がラベル付きで上に示されています。
エンタープライズ向けアレイの独立したベンチマークがなぜこれほど少ないのか?
ほとんどのエンタープライズストレージベンダーはベンチマーク結果の公開を契約で禁止しており、主流のアレイメーカーはかつて使用していたSPC-1などの公開ベンチマークを2018年頃に廃止しました。AI向けベンダーは、MLPerf Storageへの参加が販売要件となったため、この傾向を部分的に逆転させています。新しい監査済み結果が公開され次第、このページを更新します。
量子耐性暗号化は、アレイ購入の際に考慮すべき要素でしょうか?
規制対象業界にとっては、確かにその通りで、期限は見た目よりもずっと近い。NSAのCNSA 2.0ガイドラインでは、新規の国家安全保障システム(NSS)の設置は2027年1月までに準拠する必要があり、準拠していないシステムは2030年末までに廃止する必要がある。また、EUのNIS2およびDORAフレームワークにも独自の暗号化要件が定められている。
FC-SP-3規格が完成したことで、これはもはやプロジェクトではなく調達の詳細事項となりました。FC-SP-3対応HBAは、ポスト量子アルゴリズムを用いて回線速度でSANトラフィックをリアルタイムで暗号化します。暗号化はトランスポート層で行われるため、アレイは圧縮、重複排除、ランサムウェアの異常スキャンが可能なデータを受信できます。これらのサービスは、アプリケーションレベルの暗号化では対応できません。通常の3~5年ごとの更新購入でFC-SP-3接続を指定することで、2030年までに完全に暗号化されたSANが実現します。
ハードウェア面では、すでにミッドレンジ製品に搭載されています。Dell PowerStore Gen 3 はすべて、OCP スロットに EDIF 対応のファイバーチャネル カードを搭載しており、Dell はワイヤ暗号化自体を PowerStoreOS 5.1 ソフトウェアアップデートで提供する予定です。PowerStoreOS 5.0 の詳細解説では、このアップデートについて説明しています。FC -SP-3 の詳細解説では、規格、期限、および導入モデルについて説明しています。


 Amazon