

2026年10月20日更新:エントリーバーの表示が「Linux上のvLLMで2つ以上のGPU、または96GB以上の共有メモリプールを備えたモデル」に変更され、シングルGPUタワーは「ベストデスクトップワークステーション」にランクインしました。HP Z8 Fury G6iとDell Precision 7875は、このページのみにランクインし、選定内容は変更ありません。
このページに掲載されているすべてのシステムは、StorageReviewラボによるテストを受けています。GPT -OSS-120B、Llama 3.1 8B、Mistral Small 3.1 24B、Qwen3 Coder 30BなどのモデルにおけるvLLMオンラインサービングスループット、初回トークン取得時間、出力トークンあたりの時間、さらにMAMFコンピューティング効率とGDSIOストレージテストなど、ローカルAIのパフォーマンスを直接ベンチマークしています。スペックシートに基づいてランク付けされたシステムはありません。
2026年のローカルAIデスクトップにおける決定的な課題は、統合メモリとディスクリートVRAMのどちらを採用するかという点です。NVIDIAのGB10ベースのDGX SparkやAMDのRyzen AI Max(Strix Halo)システムといったデスクトップ向けアプライアンスは、1つのチップに128GBの統合メモリを搭載し、アプライアンス価格で、従来であれば複数のディスクリートGPUが必要だったモデルを実現しています。
ワークステーションタワーは、圧倒的なスループットで応えます。RTX PRO 6000 Blackwellカードは、数倍のコストと消費電力で、はるかに高いトークン/秒を実現します。このページでは、一貫したテストスイートに基づいて、両者を別々のティアでランク付けしています。なぜなら、最適な答えは、実行しようとしている最大規模のモデルと、必要な応答速度によって異なるからです。
一目でわかる
| カテゴリー | システム | メモリ | GPU(テスト済み/最大) | レビューの全文 |
|---|---|---|---|---|
| 総合的に見て最高のデスクトップAIシステム | NVIDIA DGX スパーク | 128GB統合LPDDR5X | GB10一体型(固定) | DGX Spark レビュー |
| 最高のGB10実装 | エイサー ベリトン GN100 | 128GB統合LPDDR5X | GB10一体型(固定) | Veriton GN100 レビュー |
| 最高のx86代替案 | AMD Ryzen AI Halo (Strix Halo) | 最大128GBの統合LPDDR5X | Radeon 8060S内蔵(固定) | Ryzen AI Halo レビュー |
| ディスクリートGPUなしで最適 | HP Z2 ミニ G1a | 統合型LPDDR5X(GPT-OSS 120Bを実行) | 統合型、dGPUなし(固定) | Z2 Mini G1a レビュー |
| 最高のGB300システム | MSI XpertStation WS300(代替品:ASUS ET900N G3) | 748GBのコヒーレントメモリ(252GB HBM3e + 496GB LPDDR5X) | GB300一体型(固定) | XpertStation WS300 レビュー |
| ローカルAIに最適なタワー | Dell Precision 7875 | 192GB GDDR7 (2×96GB) | 2× RTX PRO 6000 / 最大2 | Precision 7875 レビュー |
| 最高のマルチGPUプラットフォーム | HP Z8 Fury G6i | テスト時の192GB GDDR7 / 最大384GB | RTX PRO 6000 2枚テスト済み / 最大4枚 | Z8 Fury G6i レビュー |
| 究極の選択 | コミノ・グランド RTX PRO 6000 | 768GB GDDR7 (8×96GB) | 8× RTX PRO 6000 / 最大8 | コミノグランドレビュー |
デスクトップAIアプライアンス
アプライアンス層(デルは「デスクサイドAI」、NVIDIAは「パーソナルAIスーパーコンピュータ」と呼ぶ)は、ピークスループットよりもモデル容量、電力効率、価格を重視している。128GBの統合メモリを搭載したこれらのシステムは、高量子化の70Bクラスのモデルを余裕で処理でき、120Bクラスまで拡張可能だ。これは、タワー型システムでは複数のディスクリートGPUが必要となるようなワークロードに対応する。
このティアの必須ラボ資料:当社のDGX Spark熱テストでは、下記のGB10システムにおけるOEM冷却設計を比較しており、これらのプラットフォームが改訂されるまで、このクラスのすべてのユニットに適用されます。
総合的に見て最高のデスクトップAIシステム:NVIDIA DGX Spark
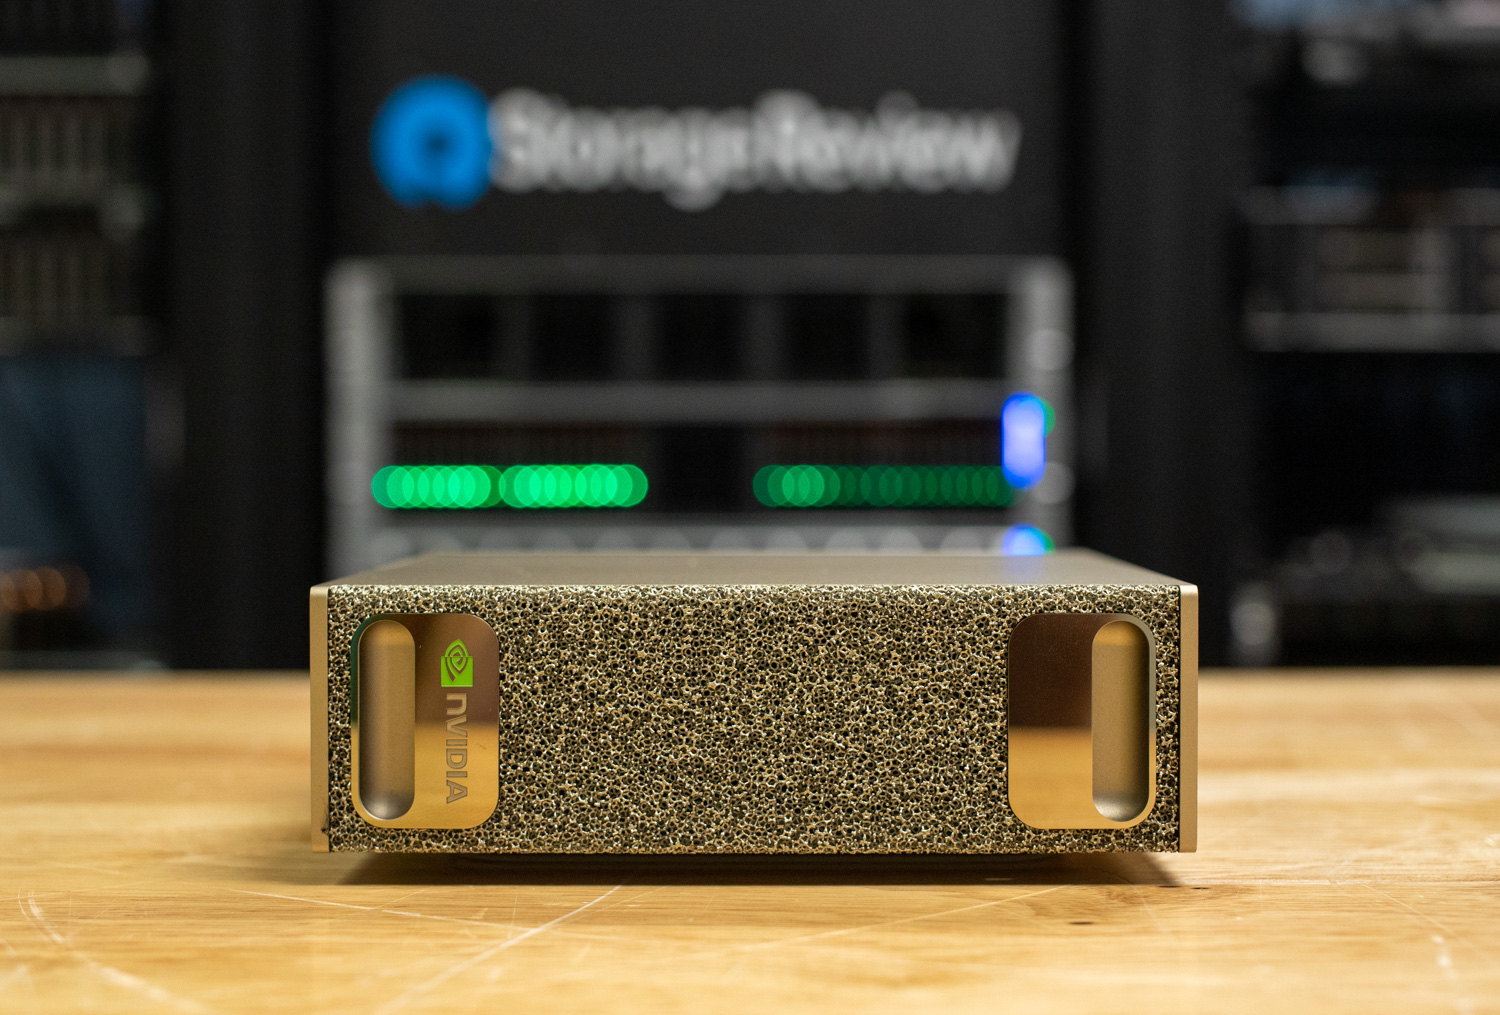
DGX Sparkは、他のすべてのデスクトップAIボックスの基準点となっています。GB10 Grace Blackwellスーパーチップは、20コアのArm CPUと128GBの統合LPDDR5Xメモリを組み合わせ、デュアルConnectX-7 200GbEポートを備えているため、テストしたアプライアンスクラスの中で、箱から出してすぐにクラスタリングできる唯一の製品です。2ノード分散推論テストでは、Dell、GIGABYTE、HPの各ノードで200GbEを介してパイプライン並列ワークロードを実行しました。
このクラスタリングの話には、より安価な導入方法が登場しました。NVIDIAは10月23日に64GBのDGX Spark SKUを4,999ドルで追加し、同じ6つのOEMを通じて販売します。2つのSKUが1本の200GbEケーブルでペアリングされ、128GBのプールを形成します。NVIDIAは、クラスタリングされたペアがQwen3.8 27B上の単一の128GBユニットの最大1.7倍になるとしていますが、この主張はまだテストしていません。CUDAソフトウェアスタックは、このセグメントで最も充実しています。
このプラットフォームの唯一の大きな制約はストレージ容量です。GB10 システムはすべて、単一の短い M.2 スロットで最大 4TB 程度までしか対応できません。8つの Spark で構成された共有ストレージ構成が、このフリート向けの解決策です。各 Spark が既に搭載している 100GbE ポートを介して提供される単一の制御された QLC アレイでは、1 つのクライアントが 10.8GiB/s で読み取り、GB10 システムで測定した最速の内部 M.2 と同等の速度を実現し、中央でホストされた 78GB モデルはローカル NVMe の 13% 以内の容量でロードされました。
最高のGB10実装例:Acer Veriton GN100
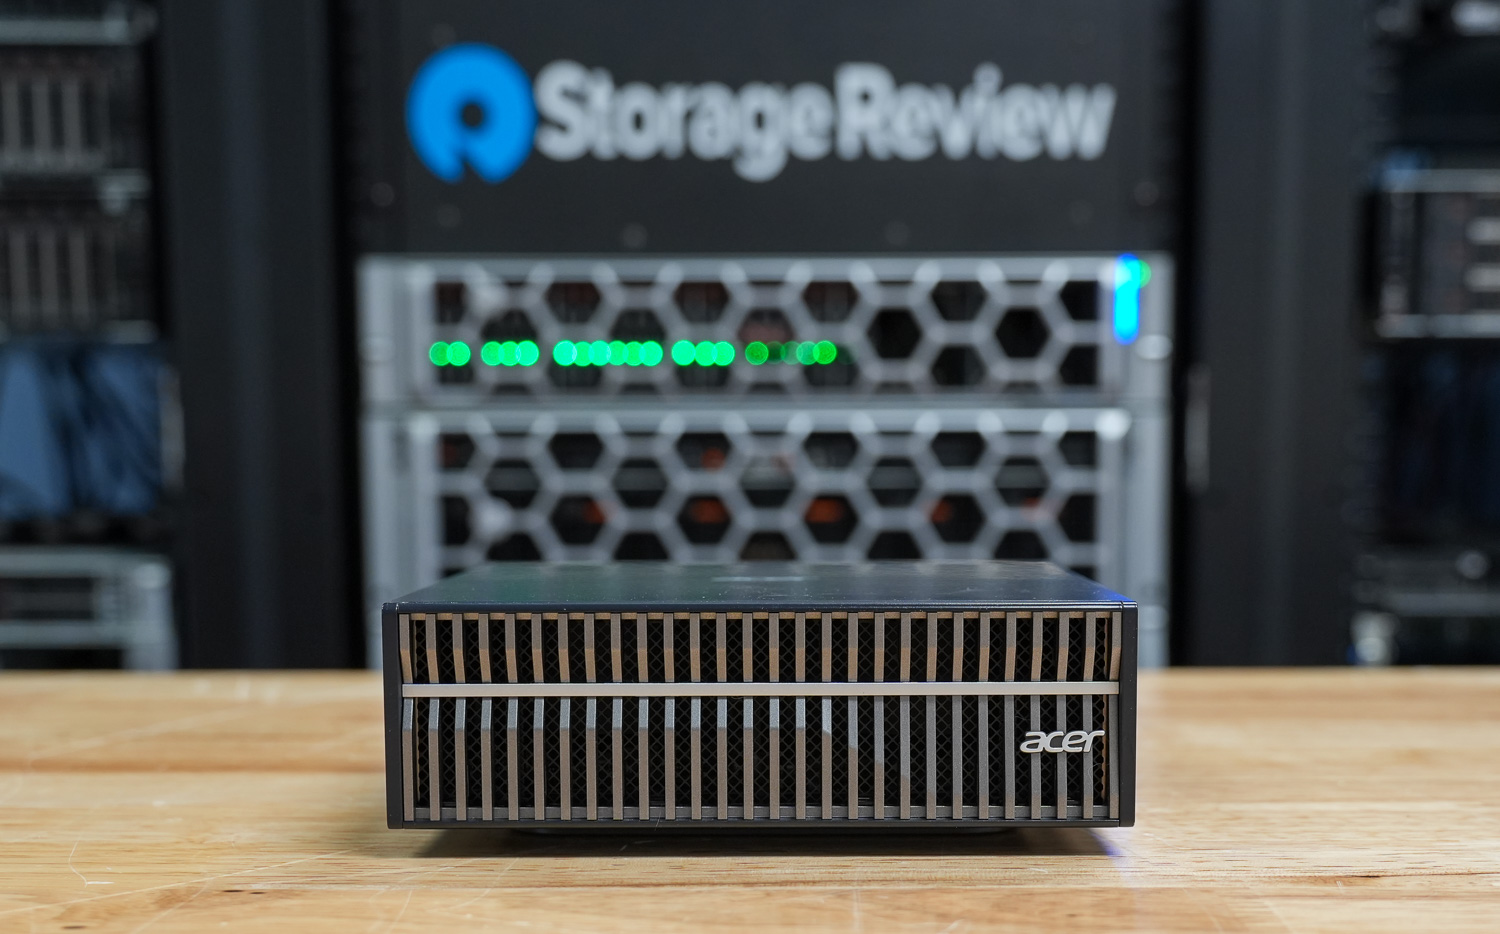
GB10 OEMシステムの中で、真の差別化要因となるのは熱設計であり、今回のテストではVeriton GN100が際立っていました。GB10搭載機はすべて同じシリコンとメモリ構成を採用しているため、持続的なパフォーマンスは冷却性能に左右されます。複数のOEM製品を比較した今回の熱設計比較は、私たちが知る限り、他に類を見ないものです。
最高のx86代替品:AMD Ryzen AI Halo
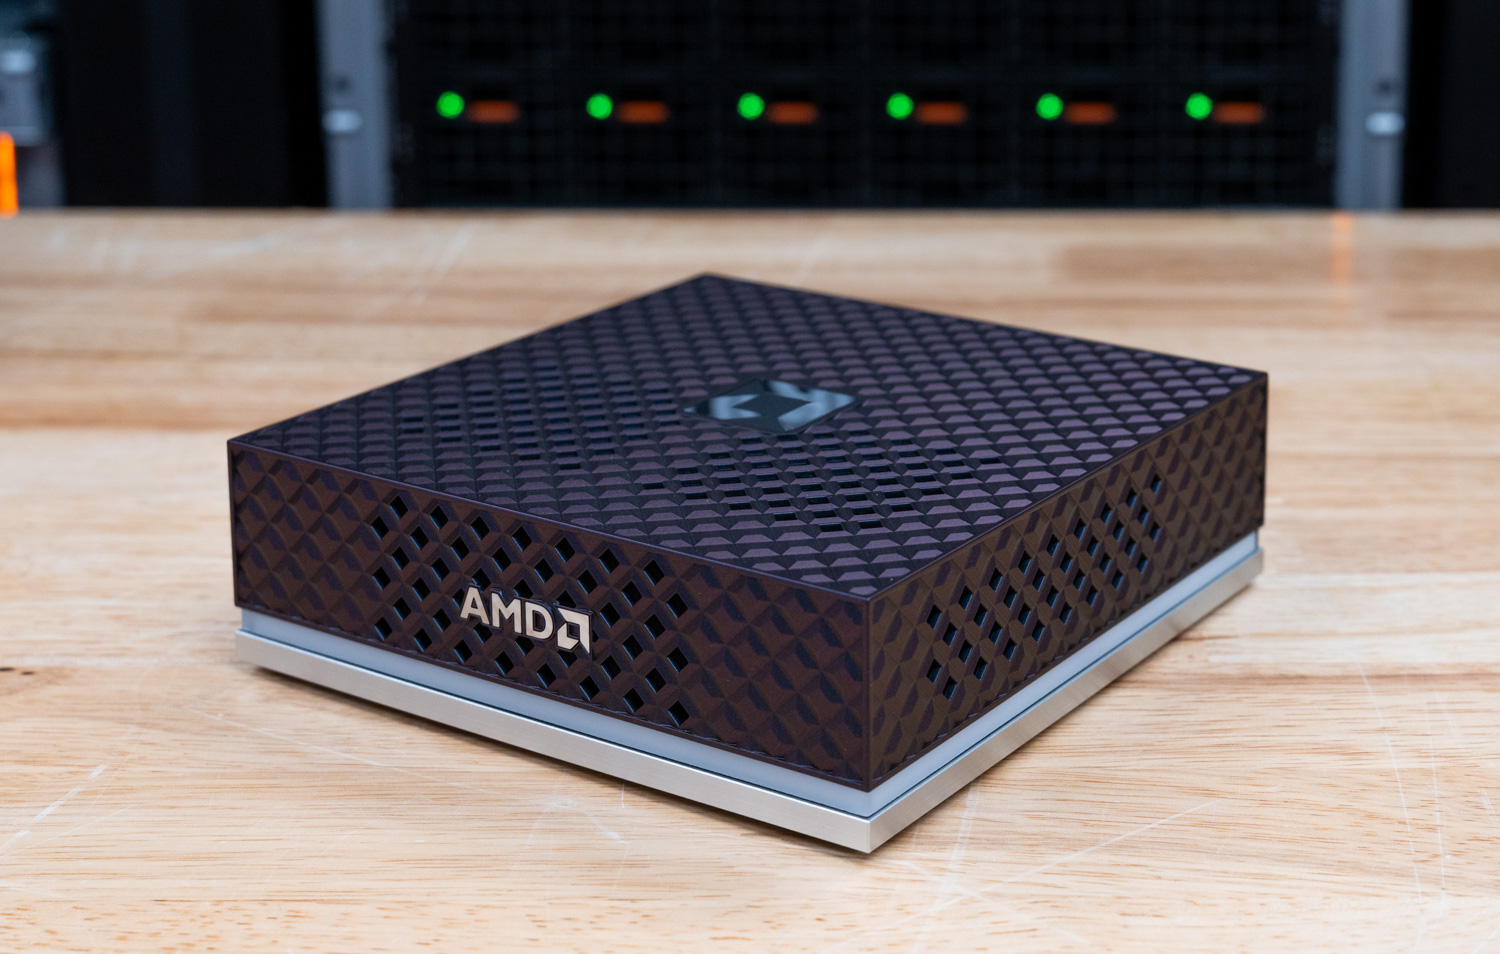
Windowsや標準的なx86ソフトウェアスタックが必要な場合は、Strix Haloがデスクトップ向けのソリューションです。AMDのRyzen AI Max+ 395プラットフォームは、128GBの統合メモリとデュアルOS構成を組み合わせており、テストでは200Bパラメータクラスのモデルを処理しました。これは、Arm/DGX OSへのコミットメントなしにDGX Sparkを直接的に狙ったものです。
ディスクリートGPUなしで最適な機種:HP Z2 Mini G1a
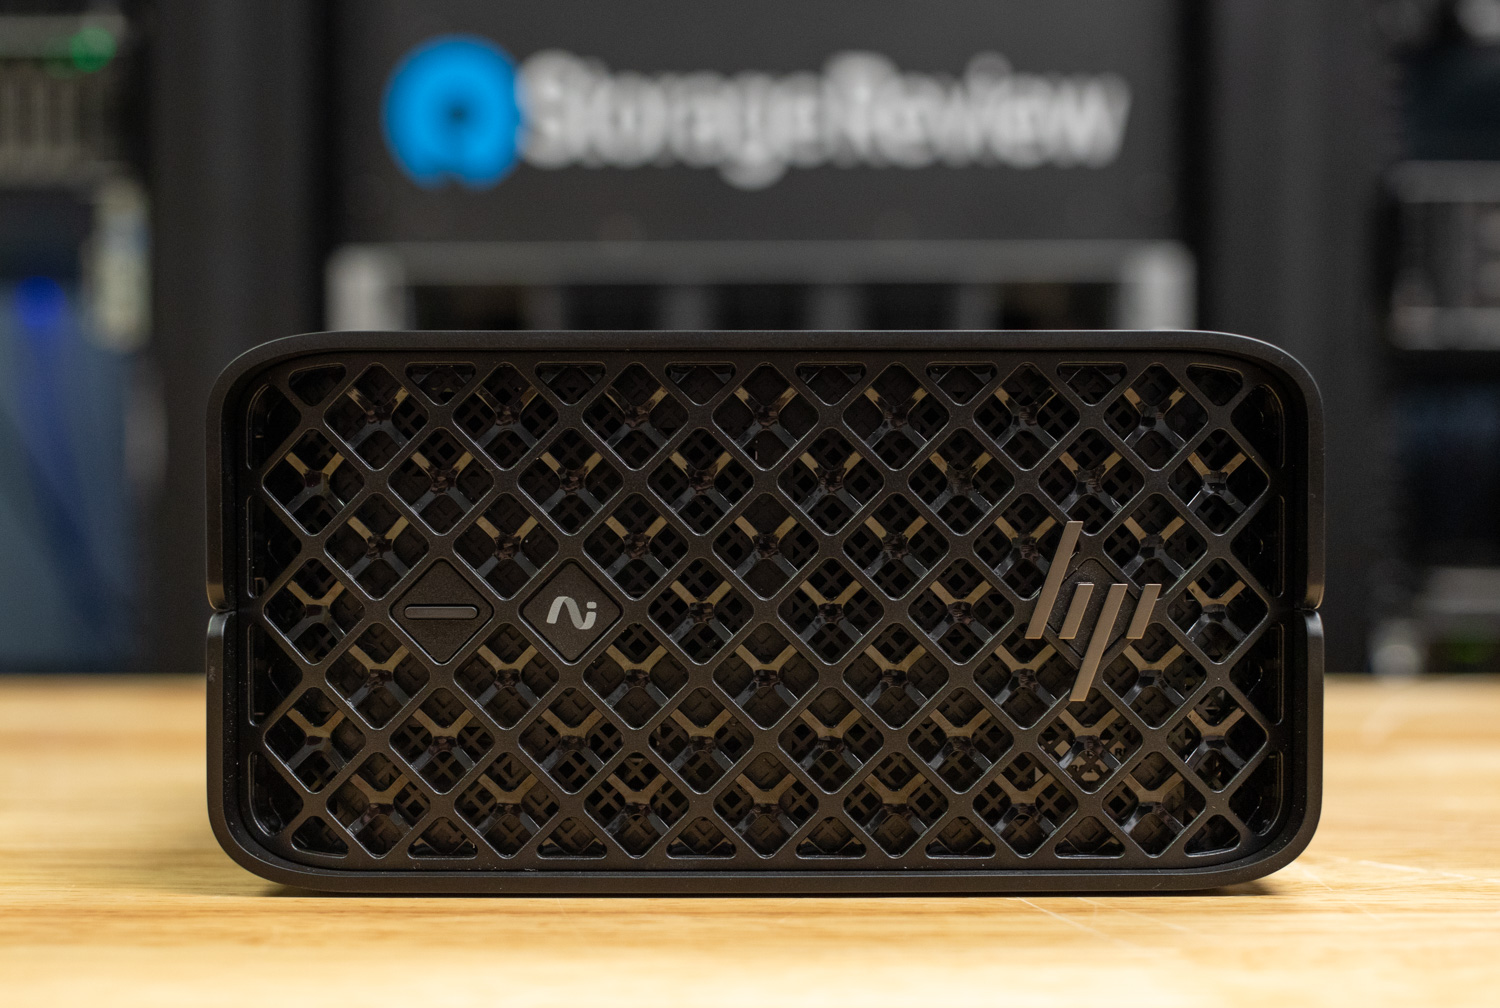
Z2 Mini G1aは、ディスクリートGPUを一切搭載せずにGPT-OSS 120Bを実行しました。HPのミニワークステーションは、AMDのRyzen AI Max+ PROシリコンをコンパクトで静音性に優れたITフレンドリーな筐体に搭載しており、統合メモリx86システムが小型オフィスボックスで大型モデルと同等の性能を発揮できるようになったことを最も明確に示した製品です。
最高のGB300システム:MSI XpertStation WS300
WS300は、当ラボでテストした最初のGB300 DGXステーションであり、アプライアンスレベルの性能の限界を塗り替えるものです。Grace Blackwell Ultraスーパーチップは、748GBのコヒーレントメモリ(252GBのHBM3eと496GBのLPDDR5X)をプールし、20ペタFLOPSのFP4演算能力を備えています。テストでは、Graceメモリに216GBのエキスパートウェイトを保持した433GBのGLM-5.2チェックポイントを実行しましたが、机の横で稼働させるには不向きなモデルです。他のDGXクラスのシステムと同様に、WindowsではなくDGX OSで動作します。これだけのメモリ容量を実現するには、DGX OSへの対応が不可欠です。
価格と電力の面では、上位のGB10ボックスよりもタワー型PCの極端な部類に近くなりますが、アプライアンスクラスでこれほど大型のモデルは他にありません。1,300Wのタワー型PCで部分スロットリングが発生するかどうかという当然の疑問には、測定結果による答えがあります。WS300の熱特性を詳細に調査した結果、Blackwell Ultraダイの温度が60℃に保たれた状態で2.8時間連続動作し、クロック周波数は2.07GHzで低下がなく、フルロード時でも約20℃の熱マージンが残っていることが記録されました。
GB300の代替品: ASUS ExpertCenter Pro ET900N G3は、テスト済みの2番目のGB300 DGXステーションであり、プラットフォームの性能を裏付けています。14モデルと2つのワークロードで、28のピークスループット比較のうち24がWS300の2%以内に収まり、コヒーレントプールモデルは同等以上の性能を発揮しました。ASUSは、27kgのタワーに持ち運び用ハンドル、400G光学ケージの上に専用ファン、そして80 PLUS Titanium電源を追加しました。どちらのタワーもプラットフォームの性能を備えています。2つのタワーの比較については、 ET900N G3のレビューをご覧ください。
クラスタのスケーリング:これらのタワー 2 台を独自の 400G ポートでケーブル接続すると、測定結果が保証されるのではなく、測定されます。GB300クラスタ テストでは、ASUS および HP Station を 2 つの DAC とペアにし、NCCL コレクティブでライン レートの 98% に達し、単一の Station で処理できる 433GB モデルである GLM-5.2 を、32 ストリームで毎秒 139 個の出力トークンから 1,525 個に、そして 256 ストリームで 3,141 個にまで増加させました。
1つのステーションに適合するモデルは、それぞれ異なるスケーリングを示します。プリフィル/デコード分解により、GLM-5.3 Flashのショートプロンプトのスループットは3倍になり、DeepSeek V4.1 Flashは毎秒5,248トークンを記録し、このセットの中で最高の出力となりました。
ラボにて:HP ZGX Fury AI Station
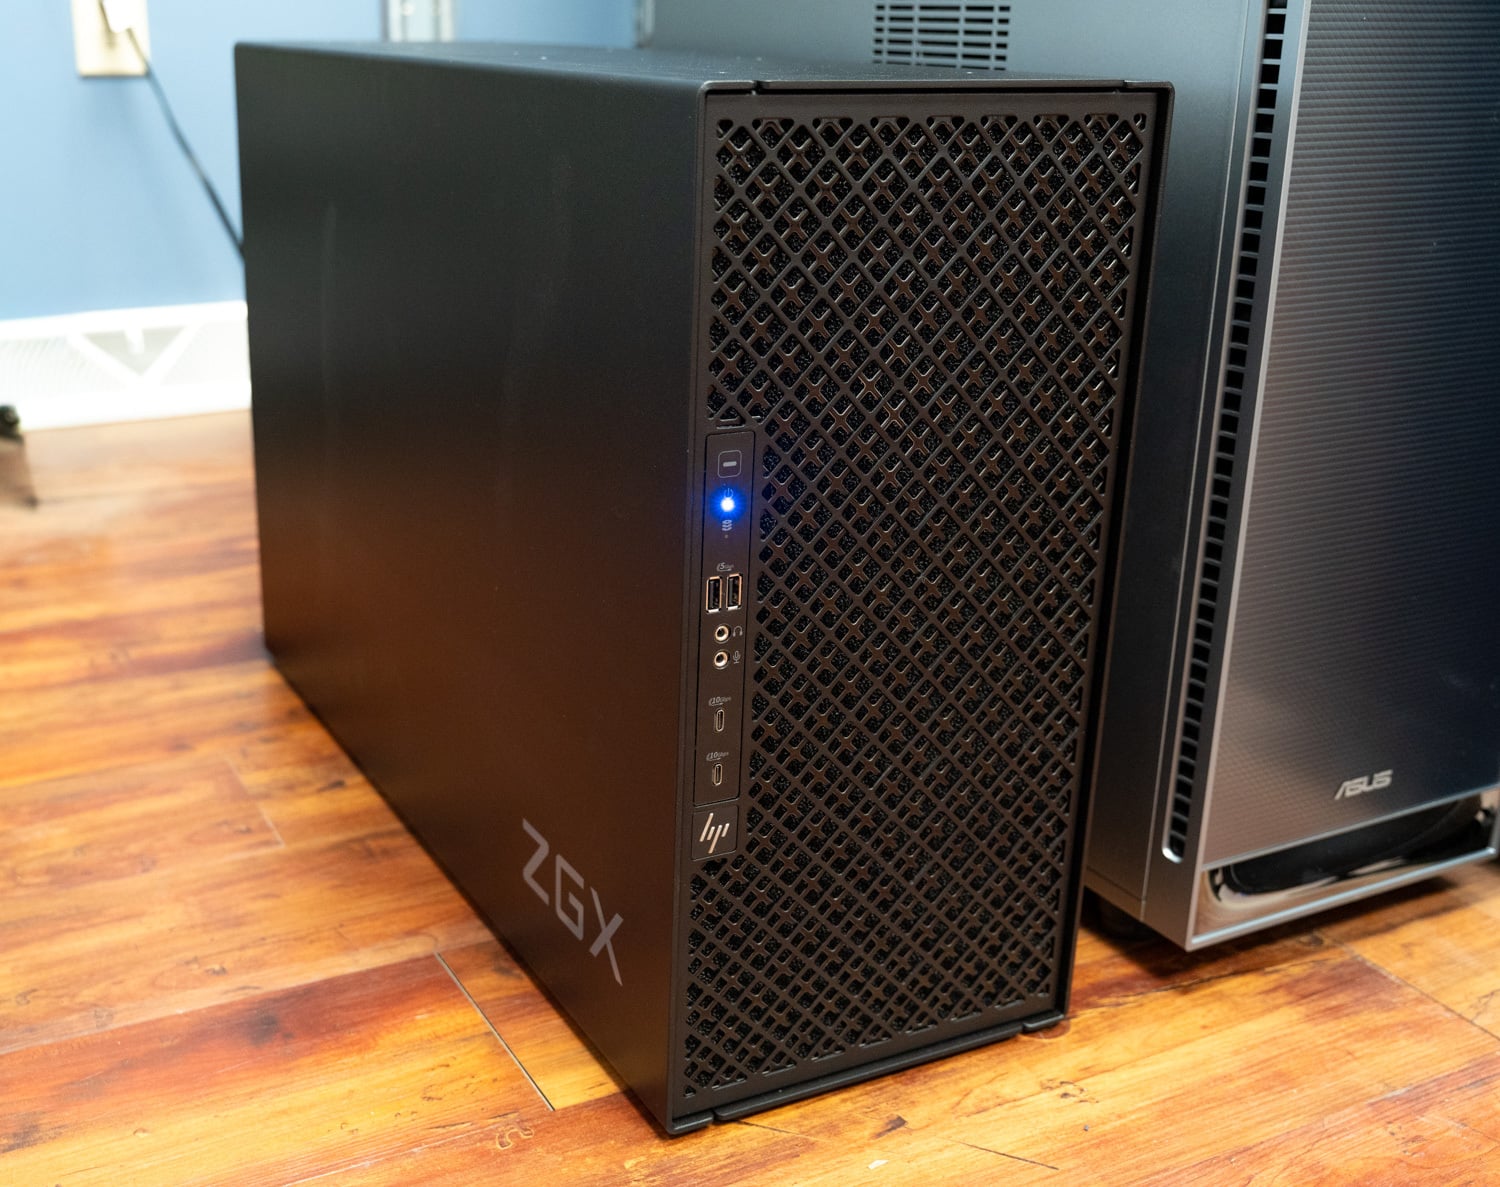
HP ZGX Fury AI Stationは、MSI WS300とASUS ET900N G3に続いて当ラボに届いた3番目のGB300クラスのシステムで、この2つのタワーのテスト結果は2%以内の差でした。
HPのZGX Fury AI Stationが現在、当社のラボに導入されています。これは、前述のMSI XpertStation WS300と同じNVIDIA GB300 Grace Blackwell Ultraプラットフォームをベースに構築されているため、2つのベンダーによるDGX Stationアーキテクチャの実装を同じベンチマーク上で比較できる初めての機会となります。具体的には、熱特性、音響特性、持続クロック、そして実際に使用した場合の使い勝手などを比較します。
ZGX Furyの最初の公開数値は既に発表されています。2つのステーションで構成されるGB300クラスタテストにおいて、ZGX Furyは2番目のタワーとして機能し、分散型GLM-5.3 Flash構成のデコード処理と、各テンソル並列処理の半分を実行しました。単体でのレビューは現在進行中であり、ZGX Furyのベンチマーク数値が確定次第、ランキングに登場します。
ZGX Furyは、Dell Pro Precision with GB300と並んで、MicrosoftがDGX Station for Windows向けに発表した最初の2つのシステムの1つでもあり、NVIDIAはWindows版を第4四半期に発売予定としている。ハードウェアは、UbuntuでテストしたGB300タワーと一致しており、このバージョンでは、サーバースタックがWindows上でネイティブに動作するのか、WSL上で動作するのかが未解決の問題となっている。
近日登場:AMD Threadripper Halo Station
IFA 2026で発表され、まだどのラボにも導入されていないAMDのThreadripper Halo Stationは、GB300クラス以上の製品に対する初の直接的な回答となる。そのコンセプトはNVIDIAの戦略とは正反対で、1つの大きなコヒーレントメモリプールではなく、最大2TBの8チャネルDDR5と128レーンのPCIe 5.0を搭載したプラットフォーム上の96コアThreadripper PROと、それぞれ144GBのHBM3Eを搭載した2つの600W Instinct MI350Pアクセラレータを組み合わせ、さらに4枚のカードと576GBのHBMへの拡張パスも提示している。システム全体は液冷式で、x86ホストはWS300のレビューで指摘したArmツールチェーンの摩擦を回避している。
未解決の疑問は、これらのモデルがPCIe接続カードとNVLink-C2Cコヒーレンスをどの程度うまく両立できるかという点であり、AMDはベンチマーク、価格、入手可能性に関する情報を一切公開していないため、これは注目に値する製品であり、推奨製品ではありません。詳細は発表記事をご覧ください。ハードウェアがラボに届き次第、ランキングに反映されます。
さらにテストした製品:デスクトップ型AI機器
これらのシステムは同じラボプロセスを経ており、カテゴリー枠を占有しない堅実な選択肢です。Dell Pro Max with GB10、ASUS Ascent GX10、GIGABYTE AI TOP ATOM、HP ZGX Nano G1n、およびHP EliteDesk 8 Mini G1a。
ローカルAI向けワークステーションタワー
応答時間が取得コストよりも重要な場合 (対話型コーディングアシスタント、マルチユーザーサービス、長いツール呼び出しチェーンを持つエージェントパイプライン)、ディスクリート VRAM が依然として優位です。これらのタワーは、推論スループットとメモリ上限に基づいてここでランク付けされており、シャーシに最終的に搭載できるものと同じくらい、テストした GPU 構成とシャーシの最大容量がそれぞれリストされています。このセクションでランク付けされるには、タワーには 2 つ以上の GPU が必要です。96GB RTX PRO 6000 を搭載したものを含むシングル GPU タワーは、別の質問に答えるため、Windows クライアント スイートのベスト デスクトップ ワークステーションページでランク付けされています。
ローカルAIに最適なタワー型PC:Dell Precision 7875
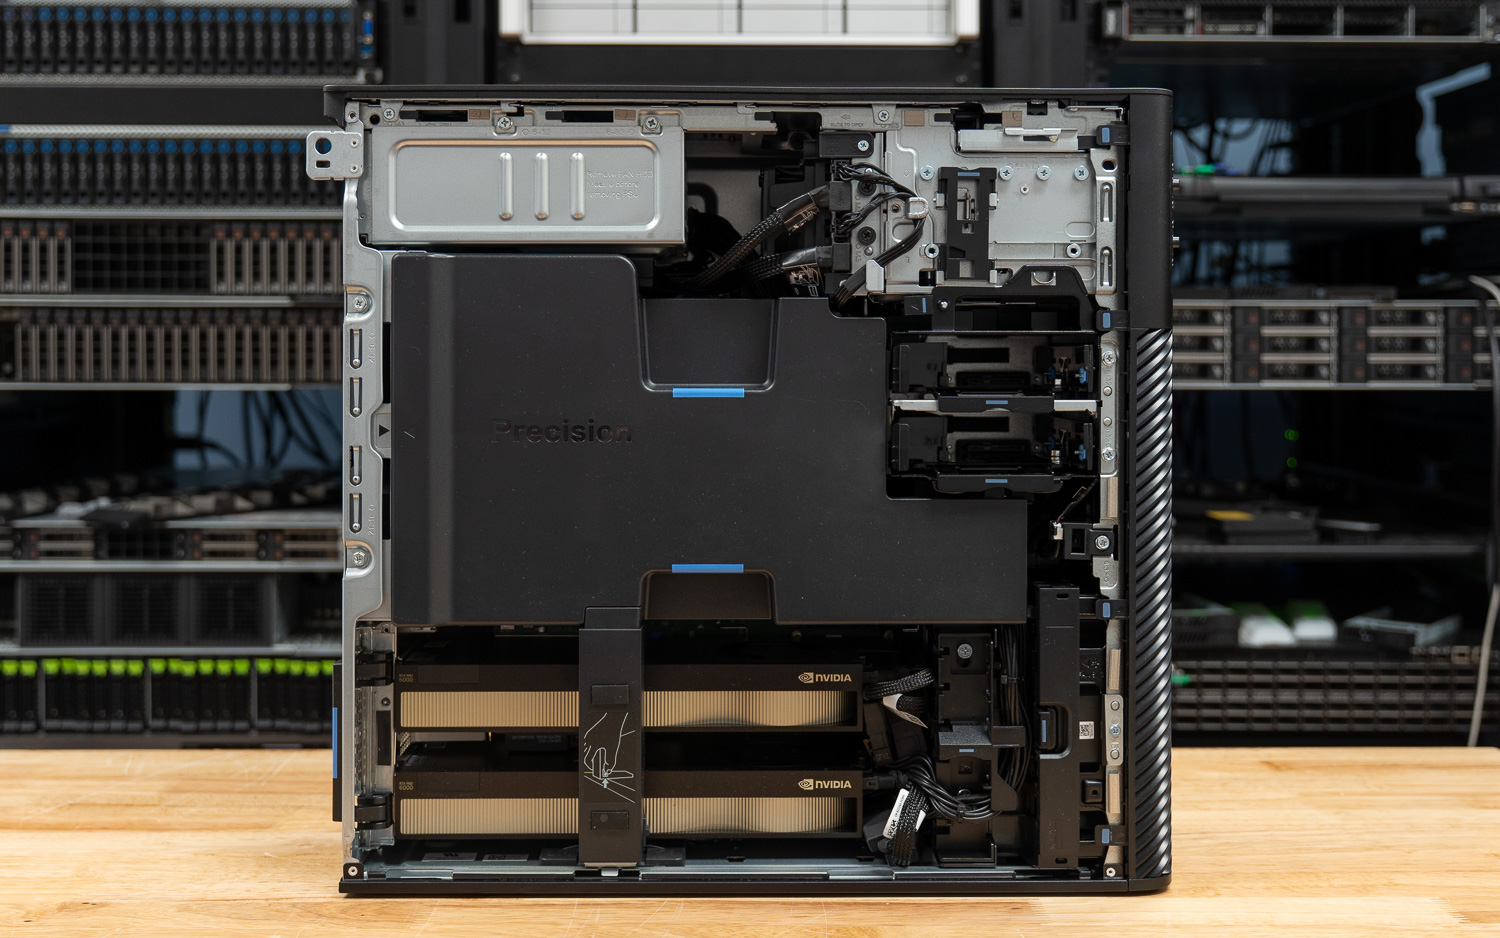
デュアルRTX PRO 6000 Blackwell GPUを搭載したPrecision 7875は、ローカル推論において、当社がテストした中で最速の標準フォームファクタシステムです。Threadripper PRO 9995WXプロセッサと2枚のカードに合計192GBのVRAMを搭載し、100BクラスのモデルをGPUメモリに完全に保持しながら、統合メモリアプライアンスでは到底及ばないインタラクティブグレードの初回トークン取得時間を実現しています。ただし、上限には注意が必要です。7875シャーシは最大2枚のデュアル幅カードしかサポートしていないため、当社のデュアルGPU構成は最大構成であり、後から3枚目を追加することはできません。
最高のマルチGPUプラットフォーム:HP Z8 Fury G6i
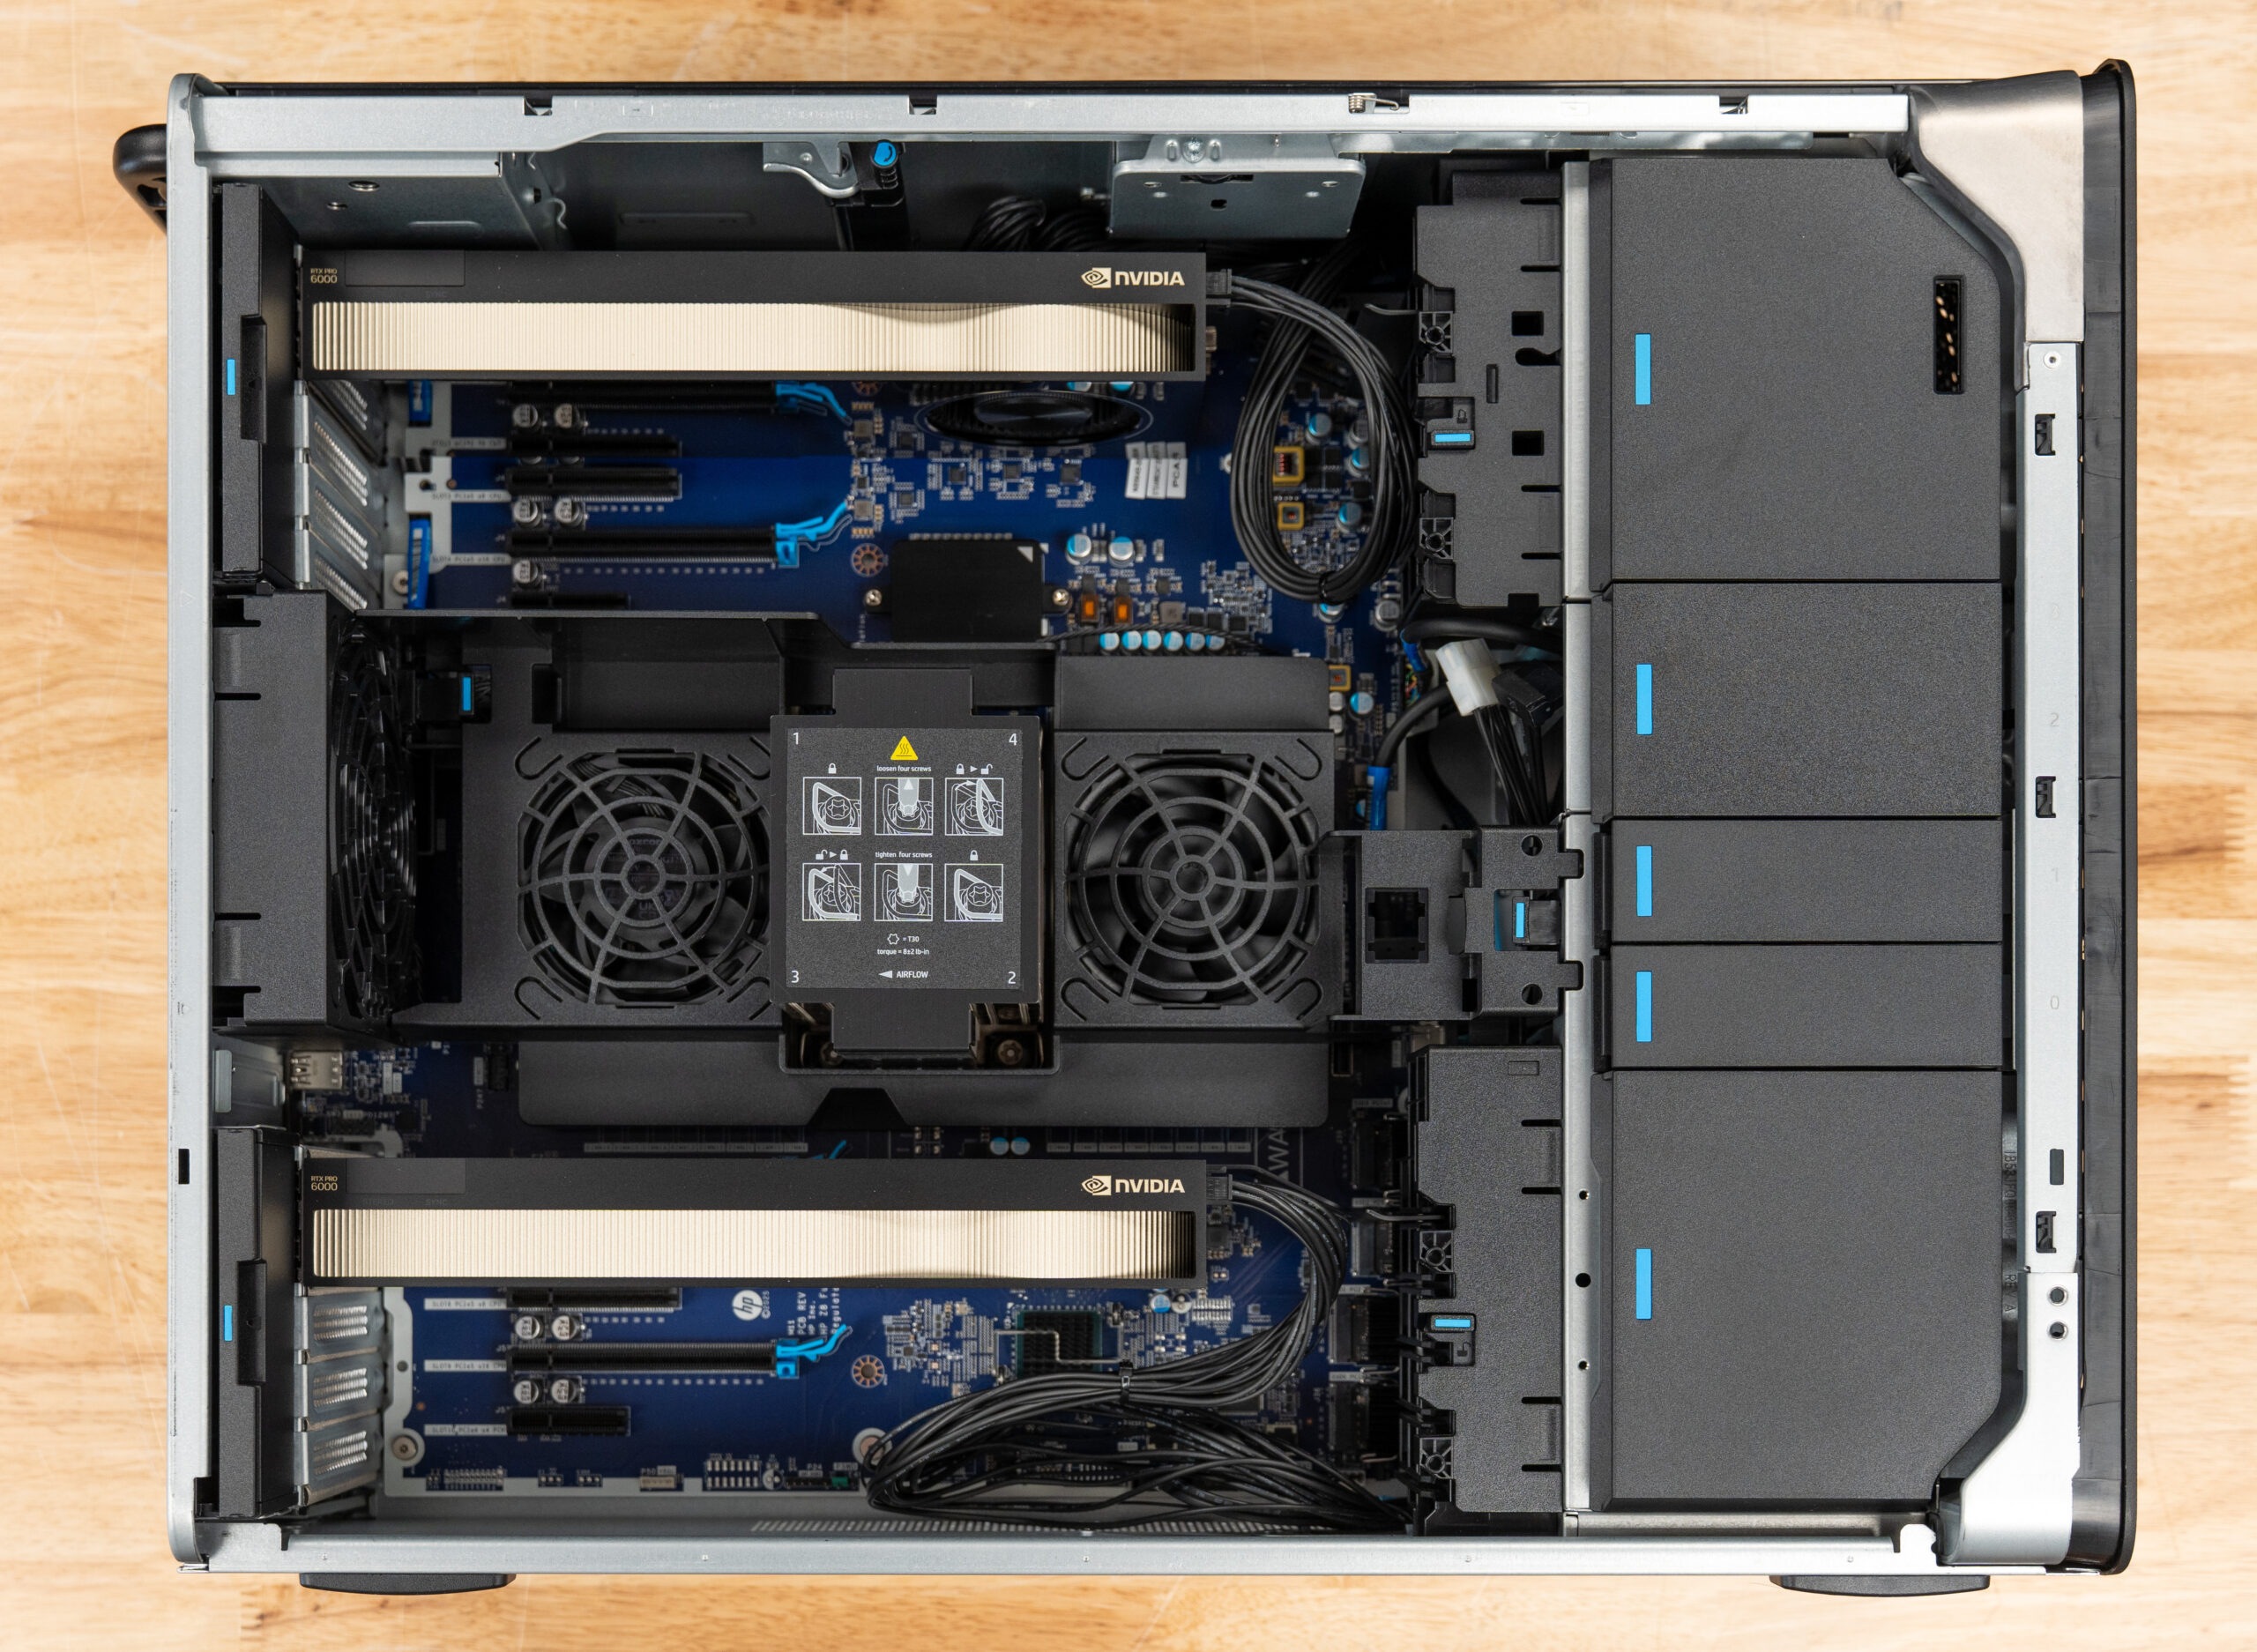
Z8 Fury G6iは、将来的にGPUを増設する予定がある場合に最適なタワーケースです。今回のレビューでは、RTX PRO 6000 Max-Qカードを2枚搭載し、合計192GBのVRAMを使用しましたが、最大2700Wのデュアル電源を備えたこのケースは、最大4枚のBlackwellカードと384GBのVRAMをサポートします。テスト時の仕様と最大構成の差こそが重要なポイントです。これまでテストした標準的なOEMタワーケースで、これ以上のGPU搭載容量を持つものはなく、2枚から4枚への増設もケースの変更なしで行えます。
究極の選択: Comino Grando RTX PRO 6000
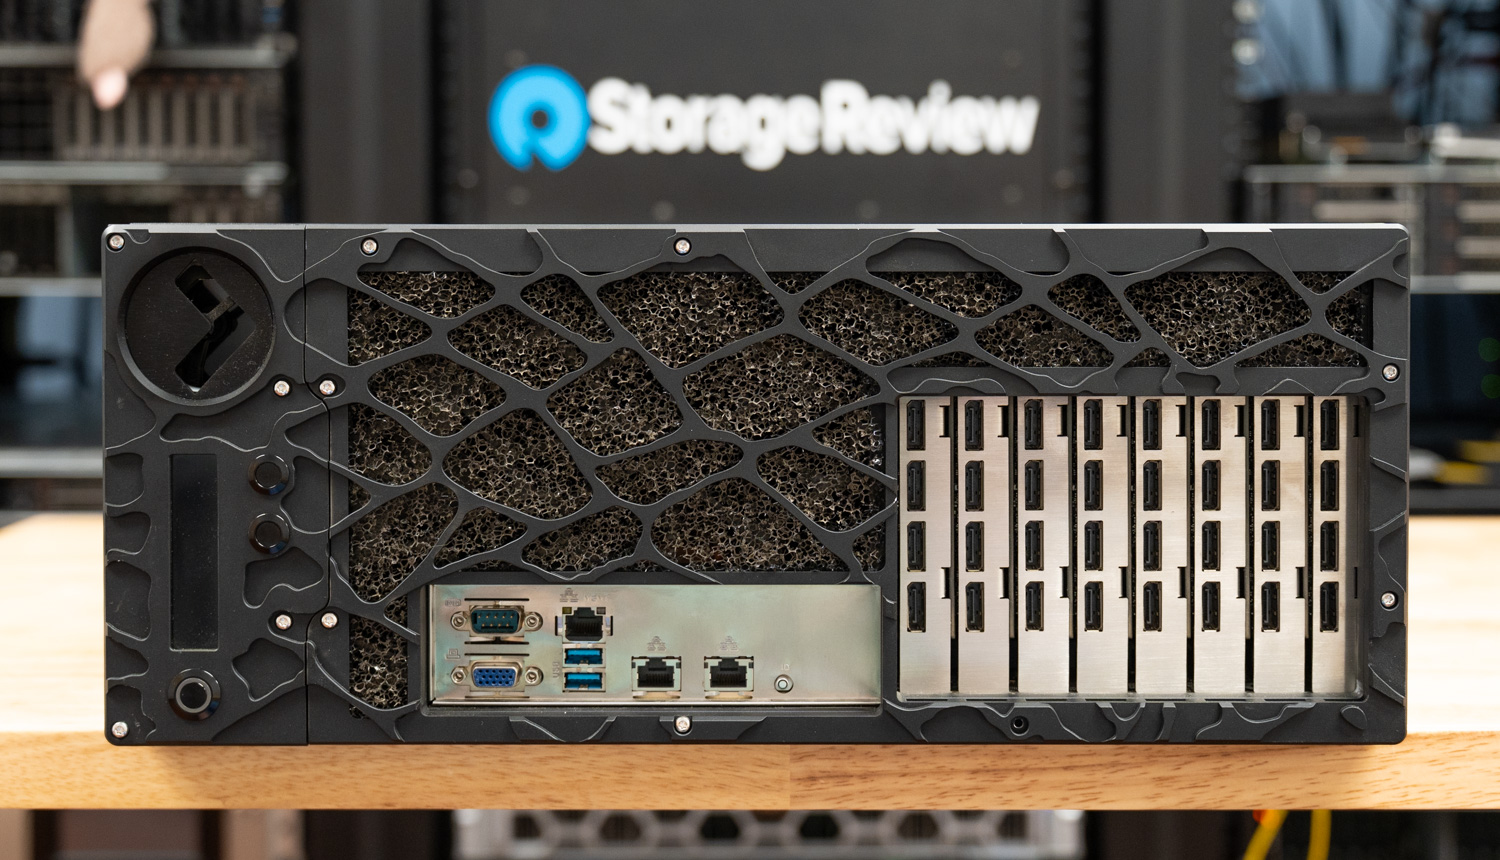
液冷式4Uシャーシに768GBのVRAMを搭載したGrandoは、他のどの製品にも収まらないユーザーのために存在します。レビュー機には、シャーシの最大容量である96GBのRTX PRO 6000 Blackwellカードが8枚搭載されていましたが、Cominoの液冷システムは8枚すべてをフルTDPで常時稼働させ、スロットリングも発生しません。これは、多くのラックサーバーよりも多くのGPUメモリを搭載しながら、デスクの横に置けるサイズです。価格は高額ですが、静音性は抜群で、このリストの中では意図的に異彩を放っています。デスクサイドの限界を示す証拠と言えるでしょう。
ランキング
StorageReview のリーダーボードには 3 つのルールがあり、1 つ目は、ラボでテストされたシステムのみがランク付けされるということです。ベンチマークテストを行っていない場合は言及されることはありますが、カテゴリを持つことはできません。2つ目は、測定基準ごとにシステムが一度だけランク付けされるということです。上記のタワーは、2026 年 10 月にそのページがシングル GPU システムに移行したまで、SPECworkstation とレンダリング パフォーマンスによるデスクトップ ワークステーション リーダーボードにもランク付けされていました。その際の結果はレビューに残っており、ここでは推論スループットとメモリ上限でランク付けされています。3つ目は、エントリー バーです。システムには、Linux 上で vLLM をサービスしてテストされた 2 つ以上の GPU、またはモデルに少なくとも 96GB が利用可能な共有メモリ プールが必要です。シングル GPU タワーは、96GB カードを搭載していても、 Windows クライアント スイートのベスト デスクトップ ワークステーションのページでランク付けされています。
ランキングは、vLLMのオンラインサービス処理能力、初回トークン取得時間、出力トークンあたりの処理時間、MAMFの計算効率、GDSIOのストレージ性能、および市場価格を総合的に評価して算出されます。同点の場合は、編集部の判断により順位を決定します。ベンダーは公開前にランキングを閲覧することはできず、このページへの掲載は有料ではありません。
ローカルAIデスクトップに関するよくある質問
エージェント型AIに最適なデスクトップ環境は何ですか?
エージェントのコーディング、ツール呼び出しパイプライン、複数ステップの自律タスクなどのエージェントワークロードは、エージェントが多数のモデル呼び出しを大規模なコンテキストで連鎖させるため、単一チャットの使用とは異なり、スループットとレイテンシに敏感です。そのため、タワー型アプライアンスが有利です。Dell Precision 7875のディスクリートVRAMは、長いエージェントチェーンの応答性を維持するために必要な、持続的な最初のトークン取得までの時間を提供します。予算を重視するエージェント実験には、GB10クラスのアプライアンスで同じスタックを低速で実行できます。サイジングに関する詳細なガイダンスは、「エージェントAIのためのRAM、GPU、ストレージ」をご覧ください。
70Bモデルをローカルで実行するには、どれくらいのメモリが必要ですか?
作業上の目安として、4ビット量子化の70Bモデルでは、コンテキスト処理前に約40~48GBのモデルアクセス可能なメモリが必要です。長いコンテキストで快適にインタラクティブに使用するには、さらに多くのメモリが必要となります。そのため、128GBの統合メモリ搭載アプライアンスは70Bクラスのモデルをうまく処理でき、また、シングルGPUタワー型PCが「最高のデスクトップワークステーション」ページで上位にランクインしているのです。
これらのシステムを稼働させるには特別な電力が必要ですか?
アプライアンス層に関しては、答えはノーです。GB10クラスのボックスやStrix Haloシステムは、標準的なオフィス用コンセントで問題なく動作します。タワー型システムについては、建物の所有者と真剣に話し合う必要があります。フル構成のHP Z8 Fury G6iは、合計2700Wのデュアル電源を搭載でき、これは標準的な15アンペア、120Vの回路が供給できる電力よりも多く、Comino Grandoは180~264Vの入力が必要な2000Wのホットスワップ電源を指定しており、110Vサービスでは1000Wユニットに低下します。
このページ上部から購入する前に、壁のコンセントがどれだけの電力を供給できるかを確認してください。専用回路や208/240Vの電源が必要になる場合があり、それがGPUをフル装備する際の真のコストの一部となる可能性があります。発熱量も同様で、消費される電力はすべて室内に放出されます。
Mac Studioはどうでしょうか?
現時点では、まだ実機テストを実施していないという理由だけでなく、Appleが大容量メモリ搭載のMac Studioの販売を終了したことも理由の一つです。大容量メモリ搭載モデルは、ローカルAIにおけるMac Studioの唯一の大きな利点、つまり非常に大きなモデルを格納できる十分な統合メモリを備えていました。これらの構成がなくなったことで、現在のラインナップは本ページに掲載するに値する製品とは言えなくなりました。Appleは今年中にMac Studioを刷新すると予想されています。大容量メモリ搭載モデルが復活すれば、テストを実施して再検討する予定です。


 Amazon