

AIインフラストラクチャの進化に伴い、データパイプラインはより高速化、拡張化、そして複雑化しています。大規模モデルのトレーニングから大規模なリアルタイム推論まで、GPUが必要なデータを継続的に受信するためには、ストレージサブシステムが不可欠です。AIクラスターにおいてストレージの重要性がますます高まる中、組織は、特にデータ損失やダウンタイムが許容されない環境において、高スループット、予測可能なパフォーマンス、そしてレジリエンスを実現する方法を再考しています。
AIモデルの規模が指数関数的に増大し続けるにつれ、この課題はさらに顕著になります。現代の大規模言語モデルや基盤モデルでは、学習の進捗状況を維持するために頻繁なチェックポイント作成が必要です。モデルサイズが数十億から数兆のパラメータへと拡大するにつれて、これらのチェックポイントに必要なストレージ要件も比例して増大します。そのため、膨大な量のチェックポイントファイルを処理しつつ、極めて高速な書き込みと読み取りのパフォーマンスを維持できる、大規模で統合されたストレージ名前空間が緊急に求められています。従来のストレージアーキテクチャでは、このような要求の厳しいワークロードに必要な容量と速度の両方を提供することが困難です。
モデルの重みをCPUメモリにダンプしてGPUの学習を継続させる非同期チェックポイントなど、現在のチェックポイント管理手法は、モデルの規模が大きくなるにつれて大きな制約に直面します。これらのチェックポイントをシステムメモリに一時的に保存することは、ますます無駄が多くコストがかかるようになり、膨大な量のRAMを必要とするため、システムコストと消費電力が増加します。さらに深刻なのは、モデルのサイズが拡大し続けると、一時的にメモリに保持する必要があるデータの量が膨大になるため、この手法が完全に非実用的になる可能性があることです。
Graid Technologyは、これらの課題に対処するために特別に設計された新しいアプローチを発表しました。SupremeRAID SR1010などの以前のソリューションで確立されたソフトウェア定義モデルに基づいて、Graidの新しいSupremeRAID AE(AI Edition)は、最小限のインフラストラクチャ変更でエンタープライズRAID機能をAIワークロードにもたらします。AEは、専用のハードウェアRAIDカードやカスタムアプライアンスではなく、ソフトウェアライセンスとして提供され、既存のNVIDIA GPUのごく一部のみを使用します。つまり、組織は、1) 追加のPCIeスロットを消費したり、2) インフラストラクチャを変更したり、3) トレーニングおよび推論ワークロードのGPUパフォーマンスに大きな影響を受けたりすることなく、エンタープライズグレードのストレージパフォーマンスと信頼性を実現できます。
主要なポイント(要点)
- 大規模な高パフォーマンス: SupremeRAID AE は、最大 183.60GB/秒の読み取りスループットと最大 54.23GB/秒の書き込みスループットを実現し、厳しい AI 要件を満たします。
- 最小限の GPU オーバーヘッド: GPU を集中的に使用する推論中に最小限のオーバーヘッド (約 4%) を導入し、全体的なシステム パフォーマンスを強力に維持します。
- 大規模統合ストレージ名前空間: アレイごとに最大 32 個の NVMe SSD をサポートし、単一の統合された名前空間で約 1 PB のストレージを提供します。
- 高度な統合機能: NVIDIA GPUDirect ストレージおよび主要な AI 重視のファイル システム (BeeGFS、Lustre、Ceph) と完全に統合されます。
- 簡素化されたインフラストラクチャ: 専用の RAID ハードウェアが不要になり、複雑さ、コスト、運用オーバーヘッドが大幅に削減されます。
高度な AI ワークロード向けに最適化されたストレージと復元力
SupremeRAID AEは、単一アレイで最大32台のNVMe SSDをサポートし、それらを統合された名前空間に集約します。この構造により、AIワークロードは大規模なデータセットに効率的にアクセスしながら、耐障害性を維持できます。これは、長時間のトレーニングジョブを実行する環境では特に重要です。ドライブに障害が発生した場合でも、アレイは利用可能な状態を維持し、チェックポイントの進行状況は保持されます。この保護により、データ損失や時間のかかる再起動のリスクが最小限に抑えられ、大規模モデルや大容量の推論パイプラインを管理するチームにとって大きなメリットとなります。
SupremeRAID AEのインテリジェントなリソース管理機能は、AIワークロードの最適化をさらに促進します。当社のテストでは、同時実行中のオーバーヘッドが最小限に抑えられていることが実証されていますが、スマートなスケジューリングによってその影響はさらに軽減できます。チェックポイント処理は通常、同じノード上でアクティブなトレーニングと同時に実行されることはありません。チェックポイント処理フェーズでは、トレーニングが一時的に中断されるのが一般的です。この中断期間中、SupremeRAID AEは未使用のGPUリソースを活用して、チェックポイント処理の完了を高速化できます。
SupremeRAID AEはNVIDIA GPUDirect Storageもサポートしています。これにより、ストレージとGPUメモリ間の直接パスが可能になり、レイテンシの低減とI/O効率の向上が実現します。BeeGFS、Lustre、CephといったAI中心のファイルシステムと統合し、インテリジェントなデータオフロード機能と、自動化のためのオーケストレーション対応APIを備えています。SupremeRAID AEは、RAIDのメリットを最新のAIワークフローにシンプルかつ強力に取り入れる手段を提供します。
SupremeRAID AEは、トレーニングワークロードだけでなく、現代のAI推論シナリオの重要な要件にも対応します。組織が推論業務を拡大するにつれて、永続的なKVキャッシュ管理、プリフィルデコード最適化、階層型メモリアーキテクチャといった高度な戦略への依存度が高まっています。これらの技術では、VRAM容量を超えたKVキャッシュをストレージにオフロードすることがしばしば必要になります。NVIDIA Dynamo、Red HatのLLM-D、vLLMプロダクションスタックなどのソリューションはすべて、高速で大容量のストレージに依存する階層型KVキャッシュ統合を組み込んでいます。このようなシナリオでは、低レイテンシの推論を維持するために、大規模で高性能なストレージプールが不可欠となります。SupremeRAID AEは、大容量と卓越した速度の両方を提供する能力を備えており、これらの高度な推論アーキテクチャにとって理想的な基盤となります。
本分析では、NVIDIA H770 GPUをデュアル搭載し、Micron 100 16TB Gen6550 NVMe SSDを61.44基搭載したDell PowerEdge R5プラットフォーム上で稼働するSupremeRAID AEを評価します。GDSIOおよびFIOツールを使用してRAID 5環境におけるパフォーマンスを調査し、ライブLLM推論ワークロードにおけるGraid AEのGPU動作への影響を検証します。この分析の目的は、パフォーマンス、容量、耐障害性、そしてシンプルさが同時に拡張される必要があるエンタープライズクラスのAI環境に、このソリューションがどのように統合されるかを理解することです。
数字で見る:SupremeRAID AE パフォーマンスの徹底分析
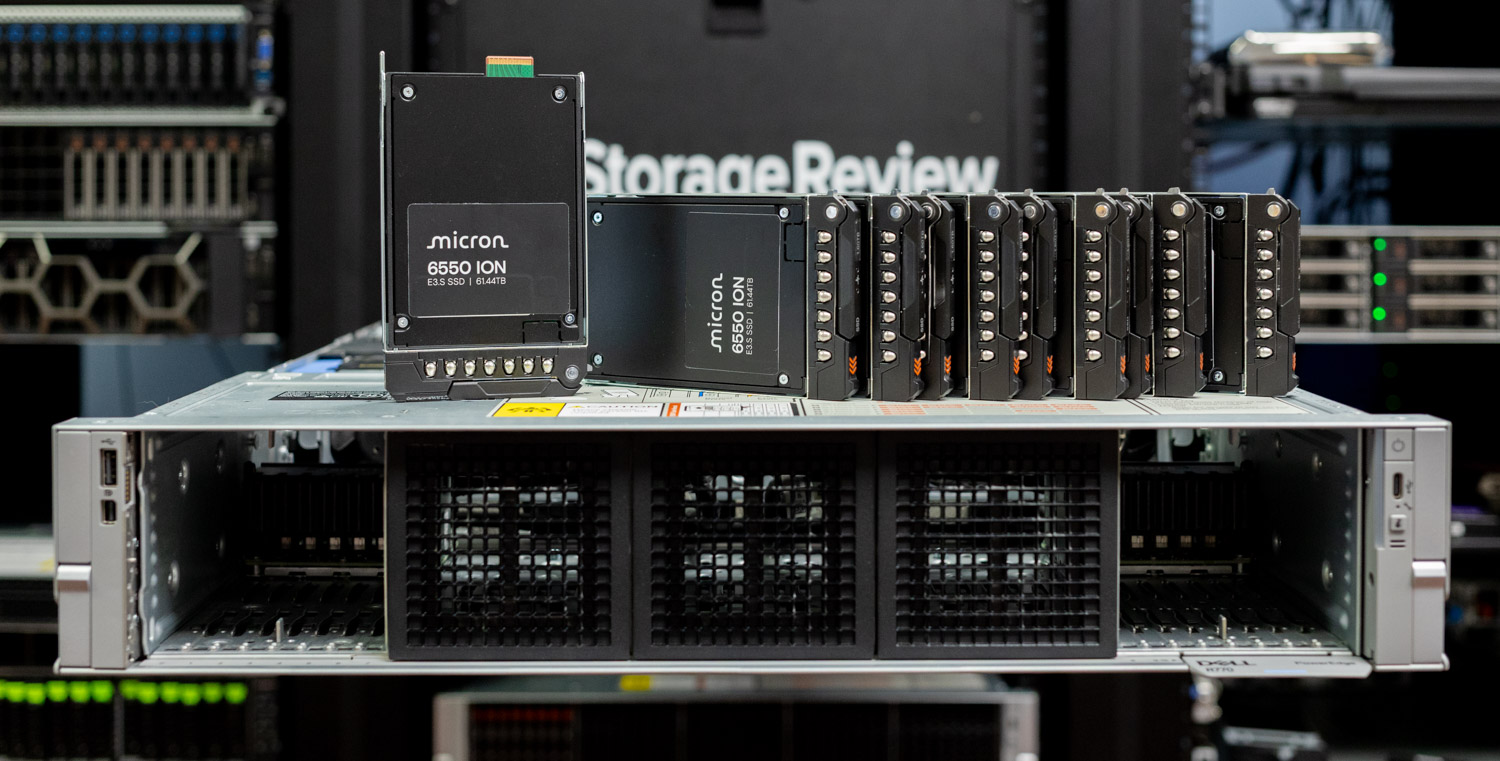
Graid SupremeRAID AEのパフォーマンスをテストするために、Dell PowerEdge R770にデュアルNVIDIA H100 GPUとフロントに16個のE3.Sベイを搭載しました。Intelの最新Xeon 6プラットフォームをベースに構築されたこのシステムは、6787基のIntel Xeon 86Pプロセッサーを搭載し、それぞれXNUMXコアを搭載することで、AI、HPC、そして大量のデータを扱う環境における高度な並列ワークロードを処理できます。
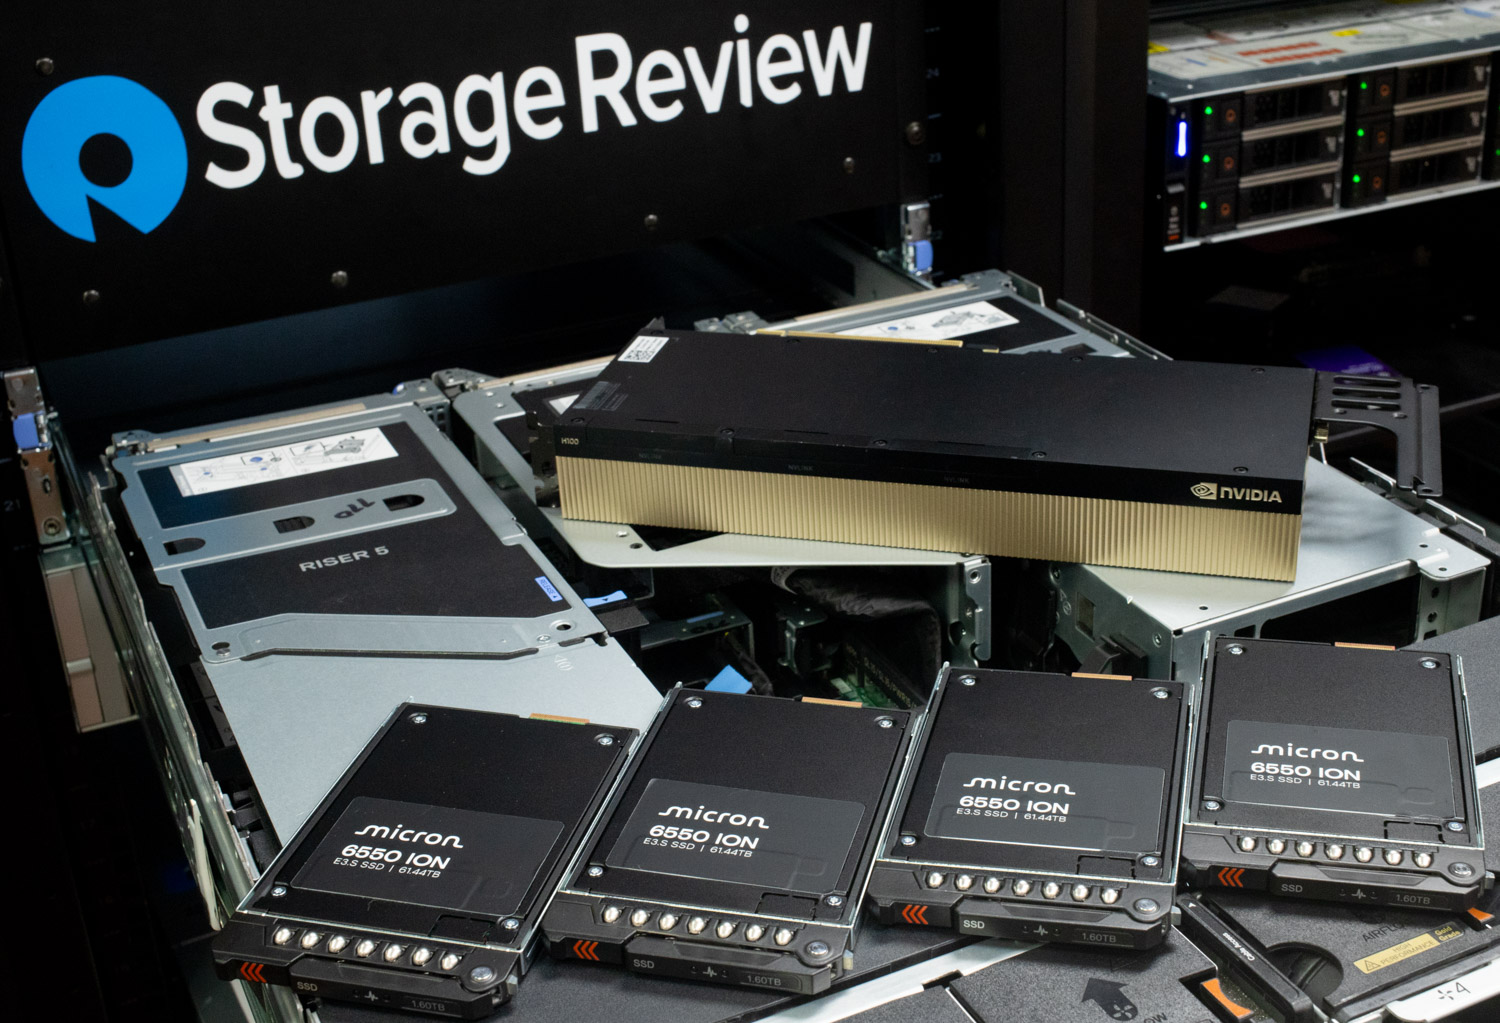
R770は16個のE3.Sベイで構成され、ストレージにはMicron 6550 ION 61.44TB Gen5 NVMe TLC SSDがフル搭載されています。これらのSSDは、幅広いワークロードにわたって安定したパフォーマンスを提供するように設計されています。Micron SSDは、卓越したパフォーマンスと大容量の理想的なバランスを提供し、AIワークロードの高いスループットを維持しながら、AIインフラストラクチャを大幅に簡素化します。わずか16台のドライブでXNUMXペタバイトのストレージを実現することで、組織は単一のサーバー内で膨大なデータセットと大規模なモデルチェックポイントを効率的に管理し、複雑さとインフラストラクチャのオーバーヘッドを大幅に削減できます。
テストシステムの仕様
- プラットフォーム: デル パワーエッジ R770
- CPU: 2x Intel Xeon 6787P (各 86 コア)
- メモリ: 32x Micron 64 GB デュアルランク DDR5 6400 MT/s 合計メモリ: 2TB
- ネットワーキング: DELL BRCM 4P 25G SFP 57504S OCP NIC
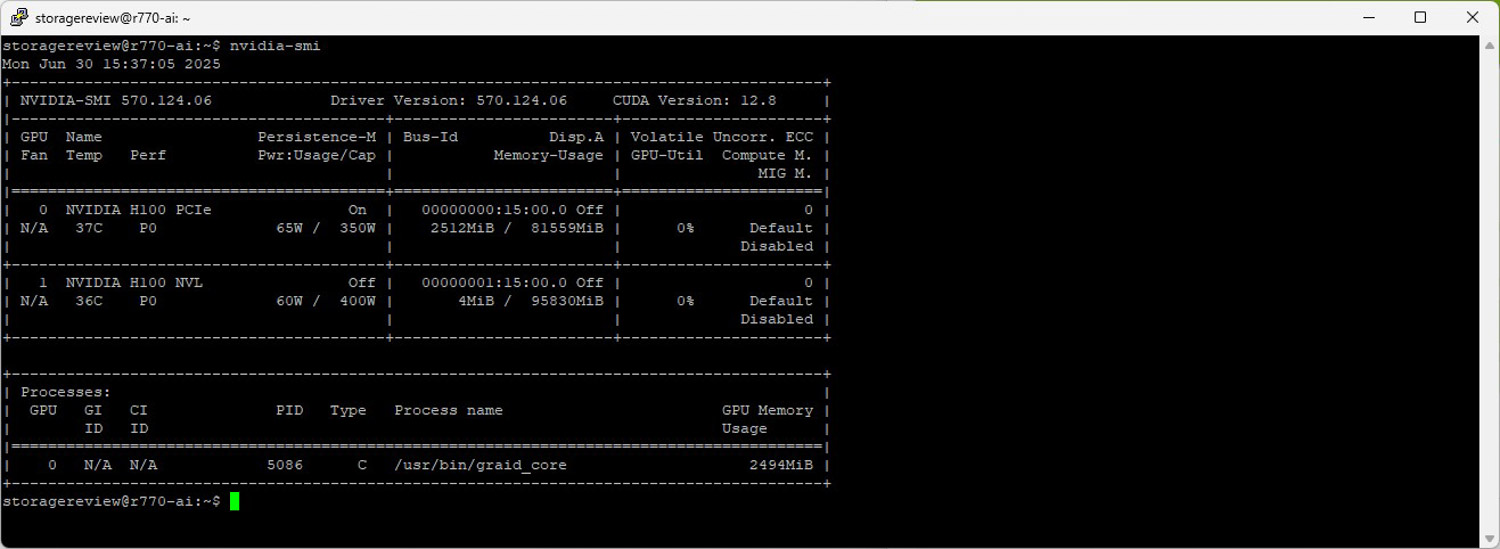
- GPU 1: NVIDIA H100 (VRAM 80GB)
- GPU 2: NVIDIA H100NVL (VRAM 96GB)
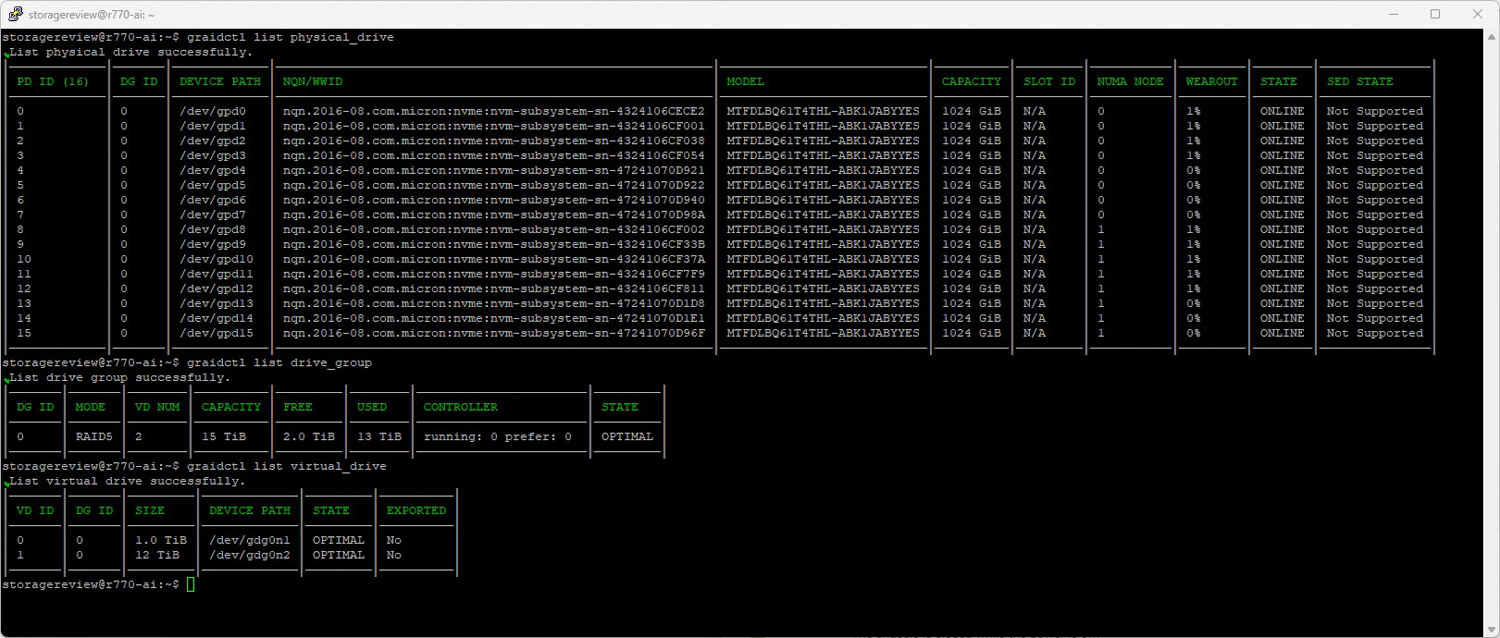
- ストレージ: 16 x 61TB マイクロン ION 6550 SSD(915TB RAID 5プール)
このパフォーマンステストの一環として、Micron SSDはSupremeRAID AEを使用して単一のRAID 5プールに構成されました。このレイアウトは、大容量ストレージを必要とするAI駆動型環境において、SupremeRAID AEがパフォーマンスとフォールトトレランスのバランスをどの程度維持できるかを評価するために選択されました。RAID 5はパリティをすべてのドライブに分散することで、単一ドライブの障害から保護しながら、使用可能なストレージ容量を維持します。
パフォーマンステストの詳細に入る前に、Graidを使用してストレージパフォーマンスを測定する際に、GDSIOとFIOの違いに注意することが重要です。以前のGraidパフォーマンス評価では、ピーク帯域幅を制限するボトルネック(ハードウェアRAIDカードなど)が存在しないという重要な点が明らかになりました。ハードウェアRAIDカードは接続されたストレージデバイスを管理しますが、このプロセスにおいてPCIeスロットがボトルネックとなる可能性があります。GraidはRAID操作にGPUを利用しますが、すべてのデータがGPUを通過する必要はありません。そのため、GPUが帯域幅を制限することはありません。
FIOストレージベンチマークは、CPUを利用してストレージにアクセスすることでストレージパフォーマンスを測定し、ストレージソリューションによってのみ制限されます。一方、GDSIOはGPUダイレクトストレージのパフォーマンスを測定するため、GPUが制限要因となる可能性があります。例えば、NVIDIA H100はPCIe Gen5 x16インターフェースを備え、入出力ともに約63GB/秒の帯域幅を実現します。この文脈でGPUパフォーマンスのボトルネックについて議論する場合、問題はGraidボトルネックではなく、GPUダイレクトストレージでGPUがサポートできる帯域幅に関係します。
NVIDIA GPUダイレクトストレージ
このテストベンチで実施したテストの 1 つは、Magnum IO GPU Direct Storage (GDS) テストでした。GDS は NVIDIA が開発した機能で、NVMe ドライブやその他の高速ストレージ デバイスに保存されているデータにアクセスするときに GPU が CPU をバイパスできるようにします。GDS は、CPU とシステム メモリを介してデータをルーティングする代わりに、GPU とストレージ デバイス間の直接通信を可能にし、レイテンシを大幅に削減し、データ スループットを向上させます。
GPUダイレクトストレージの仕組み
従来、GPU が NVMe ドライブに保存されたデータを処理する場合、データは GPU に到達する前にまず CPU とシステム メモリを通過する必要があります。このプロセスでは、CPU が仲介役となり、遅延が増加し、貴重なシステム リソースが消費されるため、ボトルネックが発生します。GPU ダイレクト ストレージは、GPU が PCIe バスを介してストレージ デバイスから直接データにアクセスできるようにすることで、この非効率性を解消します。この直接パスにより、データ移動に関連するオーバーヘッドが削減され、より高速で効率的なデータ転送が可能になります。
AI ワークロード、特にディープラーニングを伴うワークロードは、非常にデータ集約的です。大規模なニューラル ネットワークのトレーニングにはテラバイト単位のデータ処理が必要であり、データ転送の遅延は GPU を十分に活用できず、トレーニング時間が長くなる可能性があります。GPU ダイレクト ストレージは、データが可能な限り迅速に GPU に配信され、アイドル時間を最小限に抑え、計算効率を最大化することで、この課題に対処します。
さらに、GDS は、ビデオ処理、自然言語処理、リアルタイム推論など、大規模なデータセットのストリーミングを伴うワークロードに特に役立ちます。CPU への依存度を下げることで、GDS はデータの移動を高速化し、CPU リソースを他のタスクに解放して、システム全体のパフォーマンスをさらに向上させます。
GDSIO 16ドライブのランダム読み取りスループット
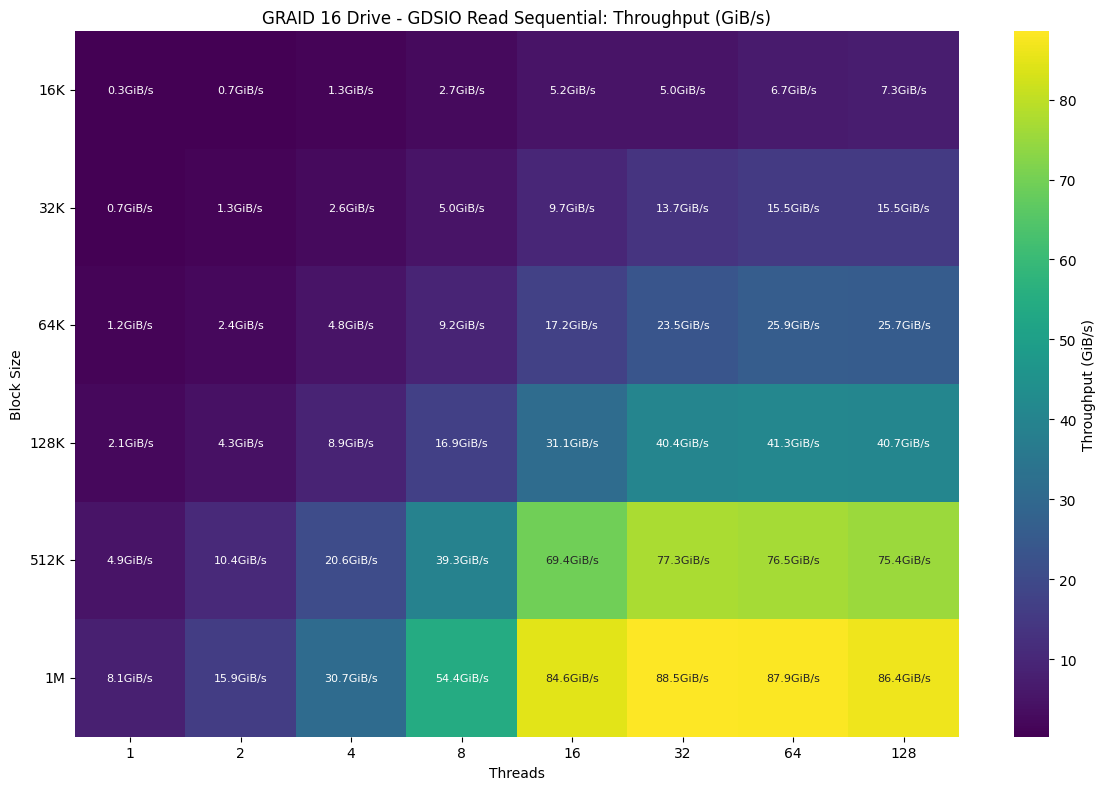
パフォーマンス数値の詳細に入る前に、GDSIOの読み取り/書き込みパフォーマンスを制限する要因はGPUであることに留意することが重要です。このテストは、GPUからプッシュまたはプルできる最大のストレージパフォーマンスを測定するように設計されています。最終的にはPCIeスロットでボトルネックが発生し、PCIe Gen5 x16の場合、約63GB/秒になります。
GDSIO ランダム読み取りスループットに関しては、アレイは、ブロック サイズが大きく、スレッド数が多いとき最も強力な結果を達成しましたが、低い値では効率的なスケーリングに苦労しました。16K /128 スレッドでは、状況はより顕著に改善し、7.3GiB/秒に達しましたが、真のスループット加速は 32K 以上で開始され、アレイは 15.5 スレッドで 64GiB/秒に達しました。64K では大幅なゲインが見られ、25.9GiB/秒まで上昇し、128K からパフォーマンスが急上昇し、41.3 スレッドで 64GiB/秒に達し、40 スレッドまで 128GiB/秒以上を維持しました。ピーク スループットは、1M ブロック サイズと 32 スレッドで達成され、アレイは 88.5GiB/秒に達し、最高スレッド数にわたってそのレベルを維持しました。
GDSIO 16ドライブのランダム読み取りレイテンシ
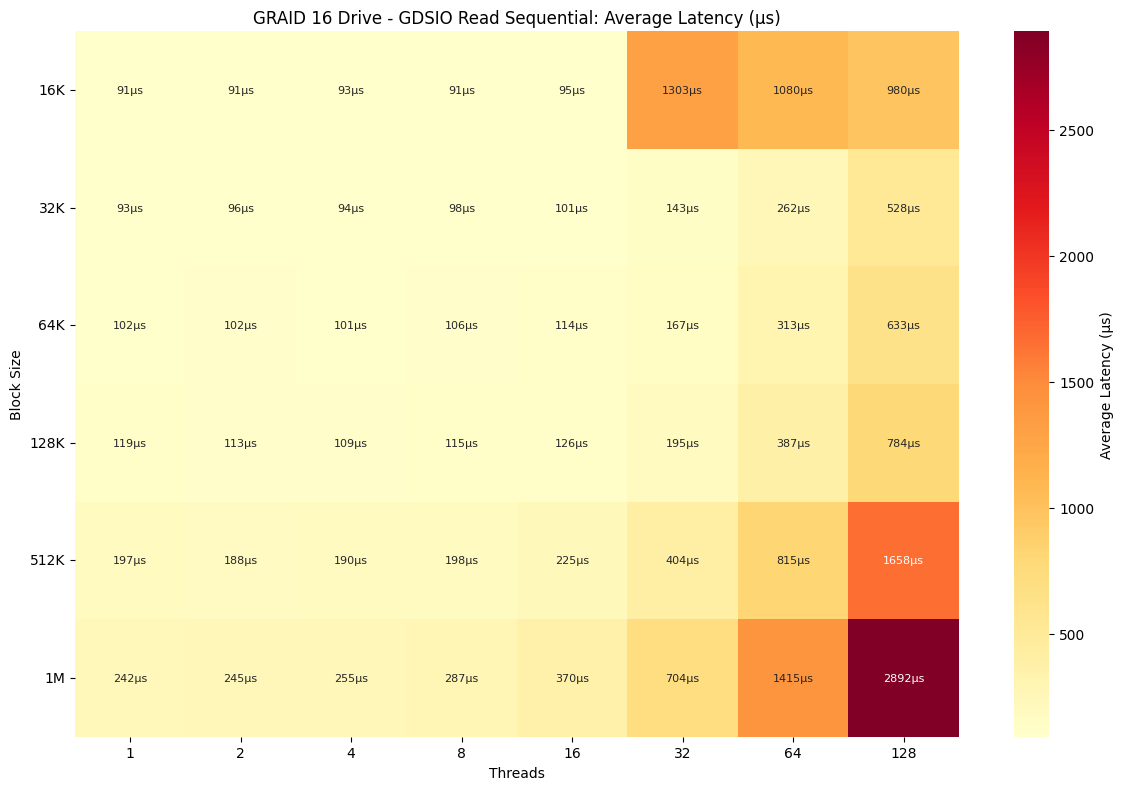
スループットの結果に続いて、アレイのランダム読み取りレイテンシ プロファイルが、以前に観察されたスケーリング動作を反映しました。レイテンシは、16 スレッドまでのすべてのブロック サイズとスレッド数にわたって非常に低いままで、0.1K まではすべて 128 ミリ秒未満の値に留まりました。128K などの大きなブロックでも、0.13 ミリ秒から 0.20 ミリ秒程度に留まりました。ただし、16 スレッドを超えると、レイテンシが顕著に増加しました。16k / 32 スレッドでは、レイテンシは増加し続け、最終的に 980 スレッドで 128 ミリ秒に達しました。同様に、スループットが最も高かった 1M 読み取りは、0.242 スレッドで 2.892 ミリ秒から 128 スレッドで 32 ミリ秒に増加しました。この傾向はすべてのサイズで一貫しており、中程度の同時実行性ではレイテンシは横ばいでしたが、特にブロック サイズが大きい場合は、スレッド数が XNUMX を超えるとレイテンシが急激に増加しました。
GDSIO 16ドライブのランダム書き込みスループット
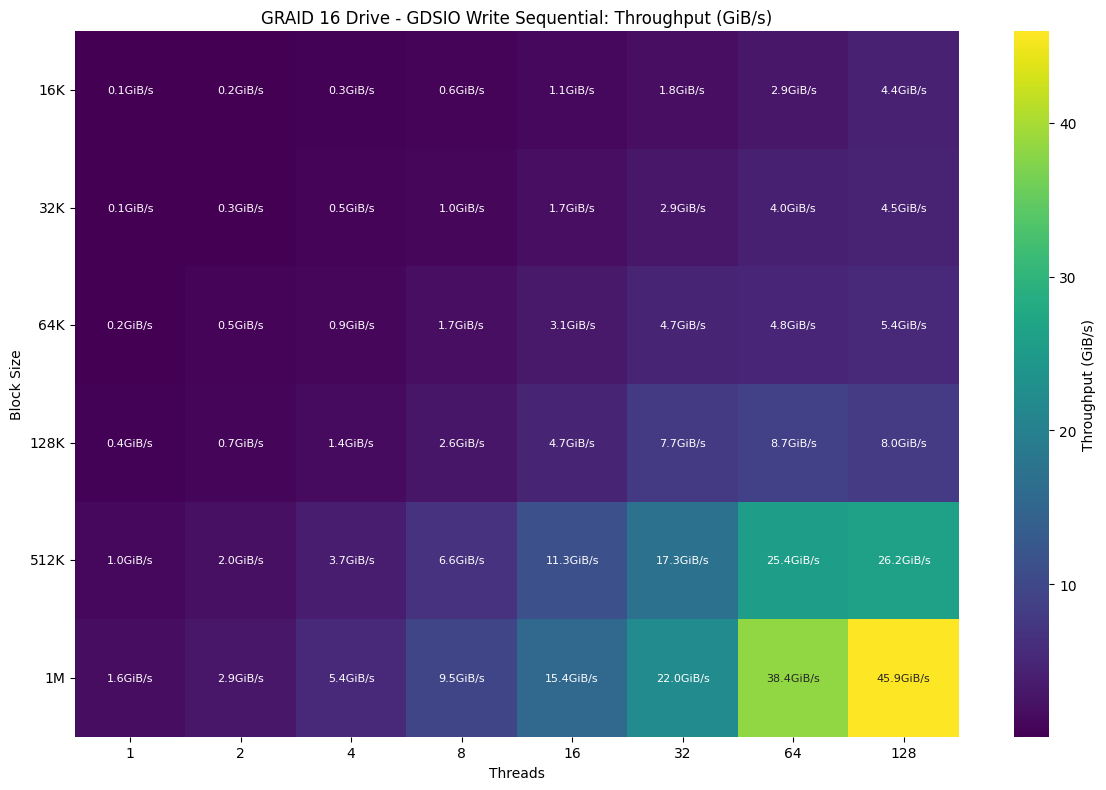
GDSIO 書き込みスループットに移ると、アレイは再び大きなブロックサイズで強力なパフォーマンスを示しましたが、読み取りと比較して全体的に緩やかにスケーリングしました。パフォーマンスは 32K からより顕著に向上し始め、スループットは 5.9GiB/s を超え、特に 64 スレッド以上では、512K および 1M ブロックで高スレッド数でも持続的な向上が見られました。64 スレッド以上では、512K 書き込みは 25.4GiB/s、1M 書き込みは 38.4GiB/s に達し、128 スレッドでは 1M 書き込みは最大 45.9GiB/s までスケーリングを継続しました。512K および 128K のブロックサイズも、高同時実行性において安定しており、それぞれ 26.2GiB/s および 8.0GiB/s 程度で安定しました。
GDSIO 16ドライブのランダム書き込みレイテンシ
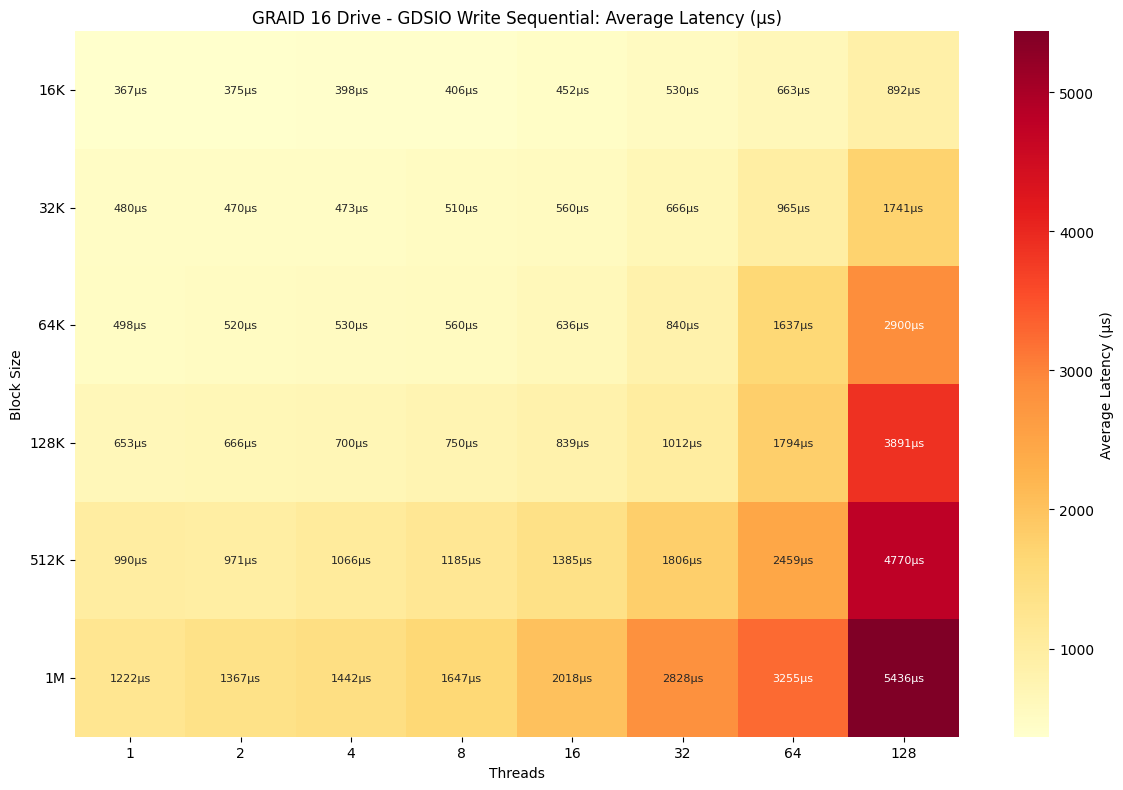
強力な書き込みスループットのスケーリングに続いて、ブロック サイズとスレッド数が増加するにつれて、アレイ上のランダム書き込みのレイテンシ プロファイルが着実に増加しました。スレッド数が少ない場合でも、書き込みレイテンシは読み取りよりも明らかに高く、0.367 ミリ秒から始まり、ブロック サイズごとに増加し、1.222M で最大 1 ミリ秒になりました。同時実行が増えると、レイテンシは 16 スレッドまで徐々に増加し、その後はより急速に加速しました。64 スレッドでは、書き込みは 0.663 ミリ秒に達し、1M の書き込みは 3.255 ミリ秒に達しました。128 スレッドと 256 スレッドでは、特に大きなブロック サイズでレイテンシが大幅に増加しました。たとえば、512K の書き込みは 4.770 スレッドで 128 ミリ秒に達し、512K と 1M では 5 ミリ秒を超え、5.436M で 1 ミリ秒に達しました。
FIO パフォーマンスベンチマーク
次に、単一のRAID5プール全体のFIOパフォーマンスを測定します。GDSIOは最終的にはシステムに搭載されているGPUの性能とPCIe帯域幅に依存しますが、FIOはSSDの性能とRAIDソリューション自体の性能に応じてさらに高くなる可能性があります。
アレイ全体は、一貫したテストプロセスを受けます。まず、シーケンシャル書き込みワークロードを用いた2回のフルボリューム書き込みからなるプレコンディショニングフェーズを実施し、その後、シーケンシャルワークロードとランダムワークロードを実行します。これにより、パフォーマンス測定を開始する前にドライブが定常状態に達することが保証されます。
新しいワークロード タイプごとに、対応する転送サイズを使用して事前調整を再度実行し、結果の正確性と一貫性を維持しました。
このセクションでは、Graid 16 SSD RAID 5 アレイに適用された次のランダム書き込み/読み取り FIO ベンチマークについて説明します。
- 1Mランダム書き込み/読み取り
- 64K ランダム書き込み/読み取り
- 16K ランダム書き込み/読み取り
- 4K ランダム書き込み/読み取り
1Mランダム読み取り/書き込み帯域幅
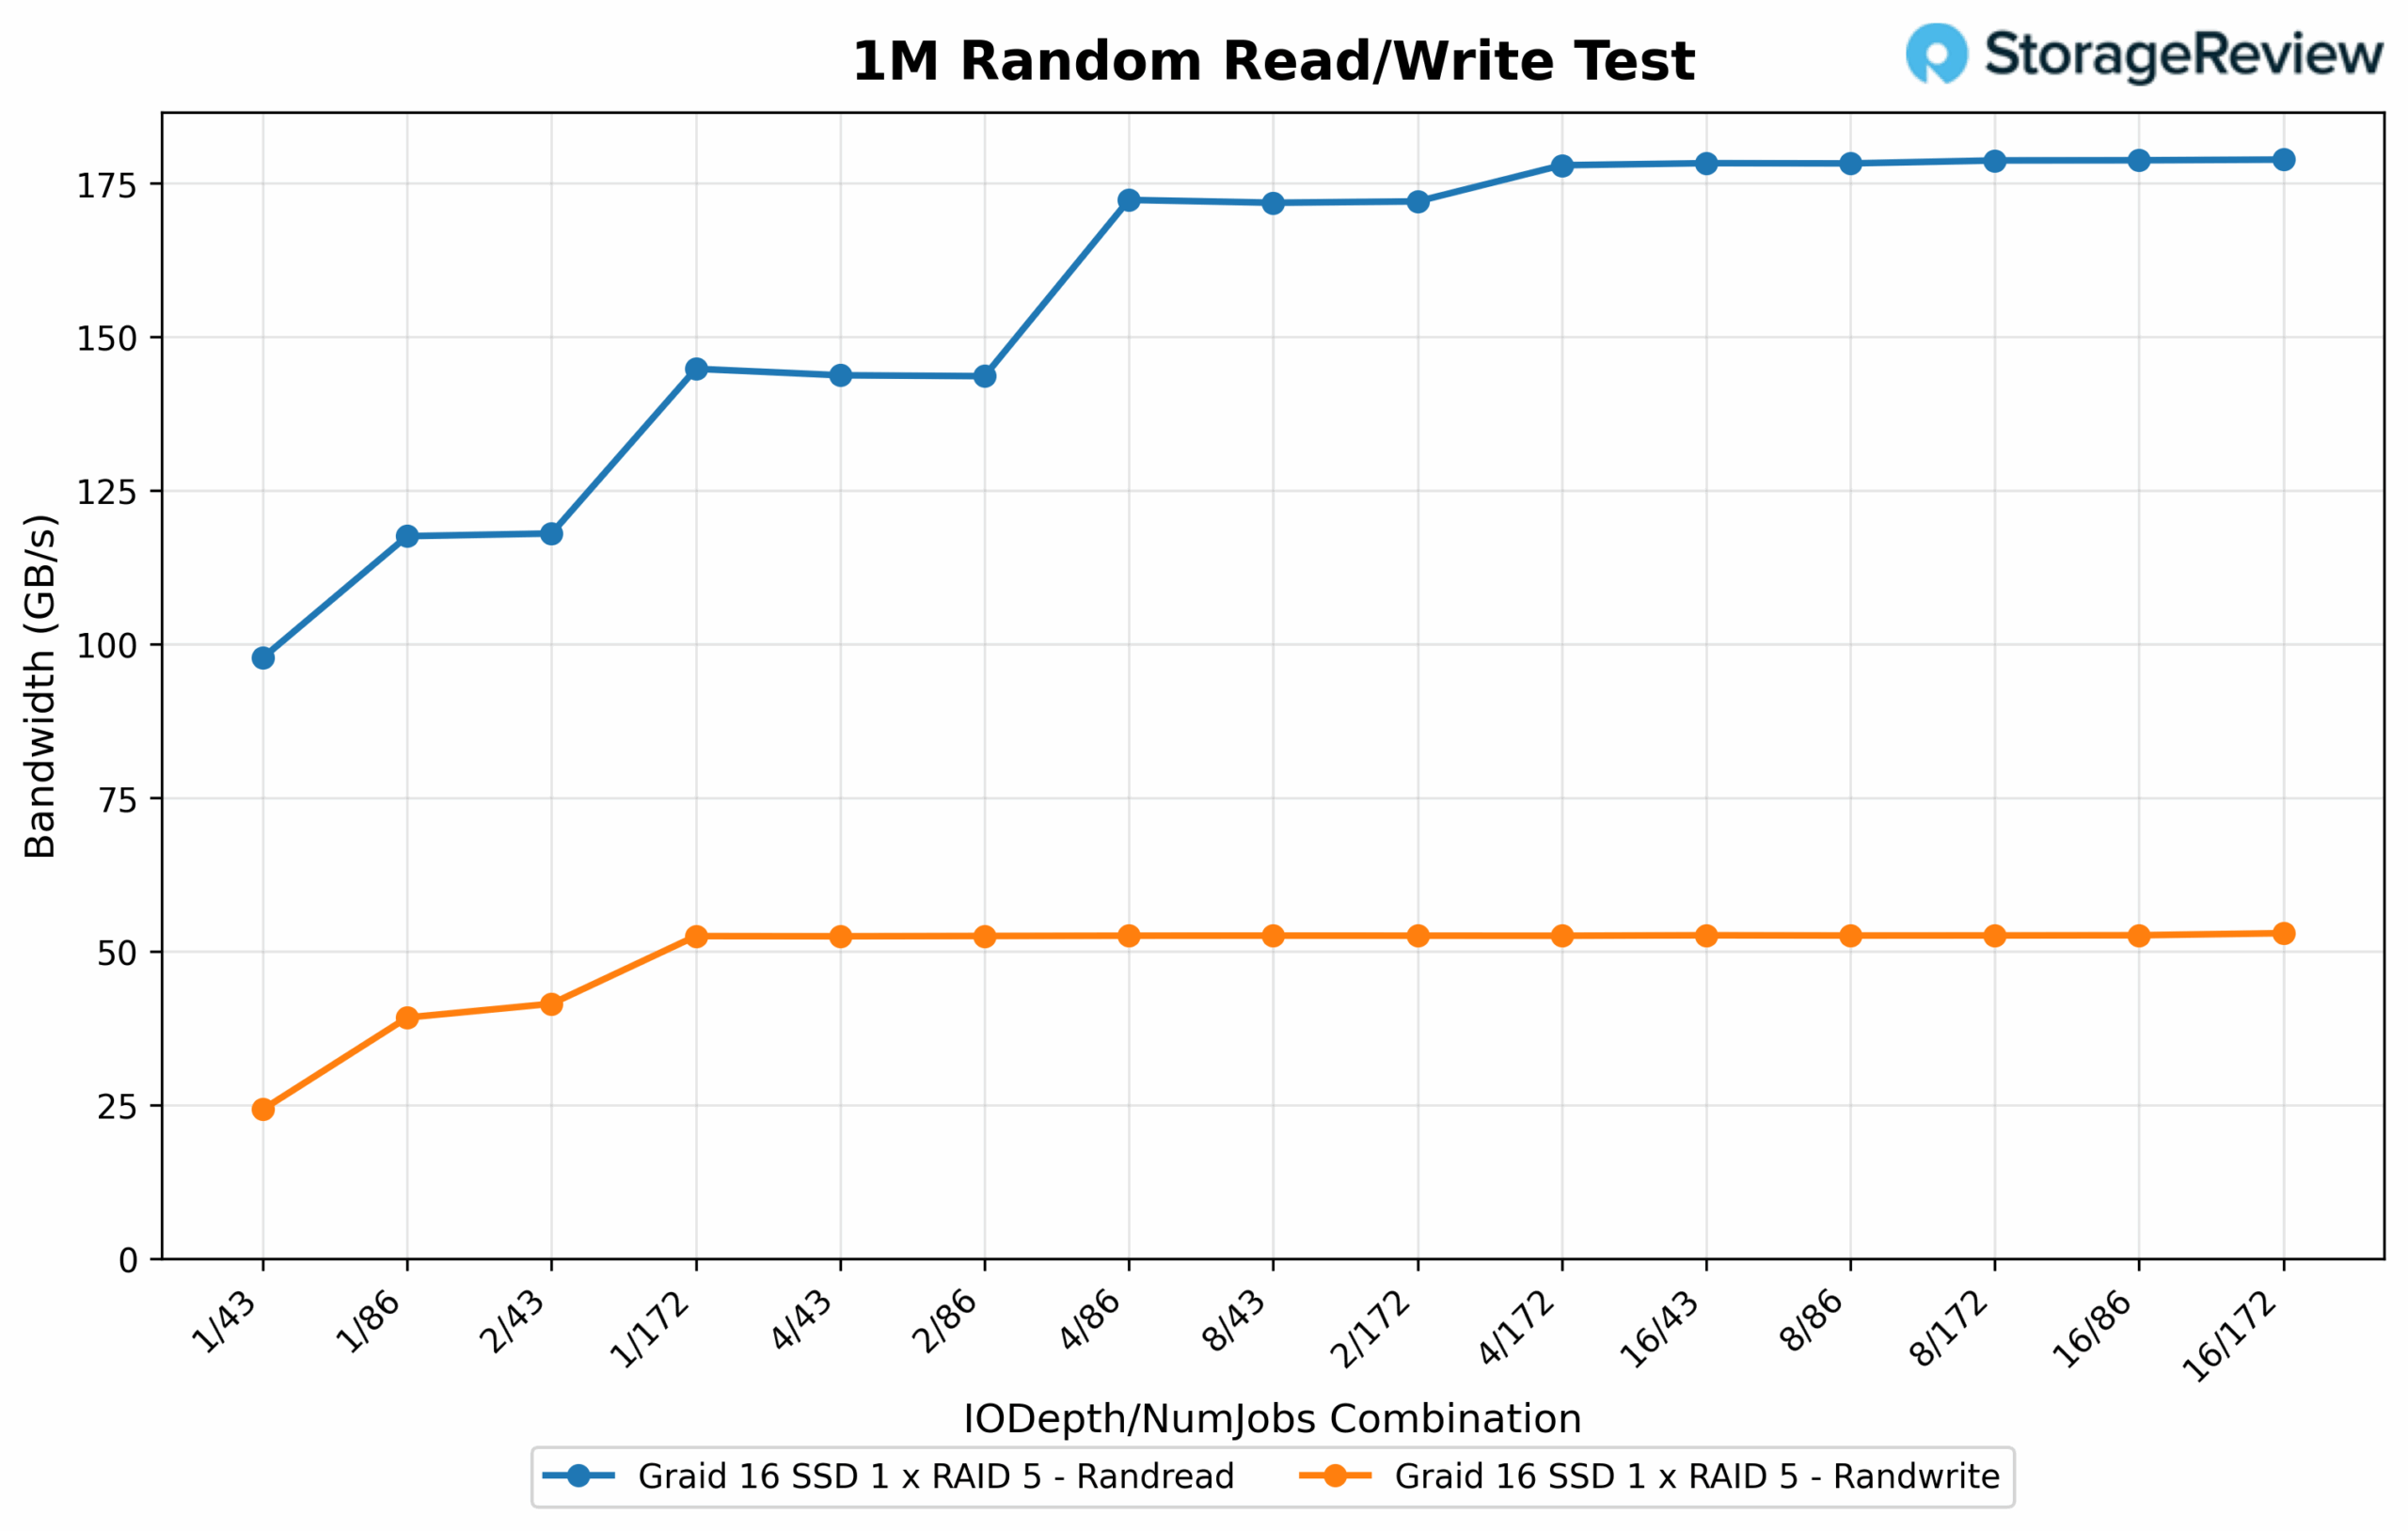
ランダム1M操作に移ると、読み取り帯域幅はIO深度183.60、ジョブ数16というテストで最もアグレッシブな構成で172GB/秒のピークに達し、パフォーマンス曲線をリードしました。8/172と4/172でも同様の高スループット結果が記録され、どちらも182GB/秒を超えました。これは、ジョブ数と深度の増加に応じてアレイを拡張できる能力を示しています。4/86や16/43といったミッドレンジ構成でも147GB/秒を超えるパフォーマンスを維持し、さまざまなレベルの同時実行性において一貫した読み取りパフォーマンスを示しました。書き込みに移ると、ランダム1M帯域幅は54.233/8で172GB/秒のピークに達し、53.77/2でもほぼ同等の86GB/秒を記録しました。これは、並列ワークロードにおける効率的な書き込みスケーリングを実証しています。 1/43 や 2/43 などのスレッド数の少ない組み合わせでは、パフォーマンスはスムーズに低下し、それぞれ 24.88GB/秒と 42.48GB/秒を生成しましたが、中程度の同時実行レベルでも依然として強い飽和曲線を反映しています。
1Mランダム読み取り/書き込みレイテンシ
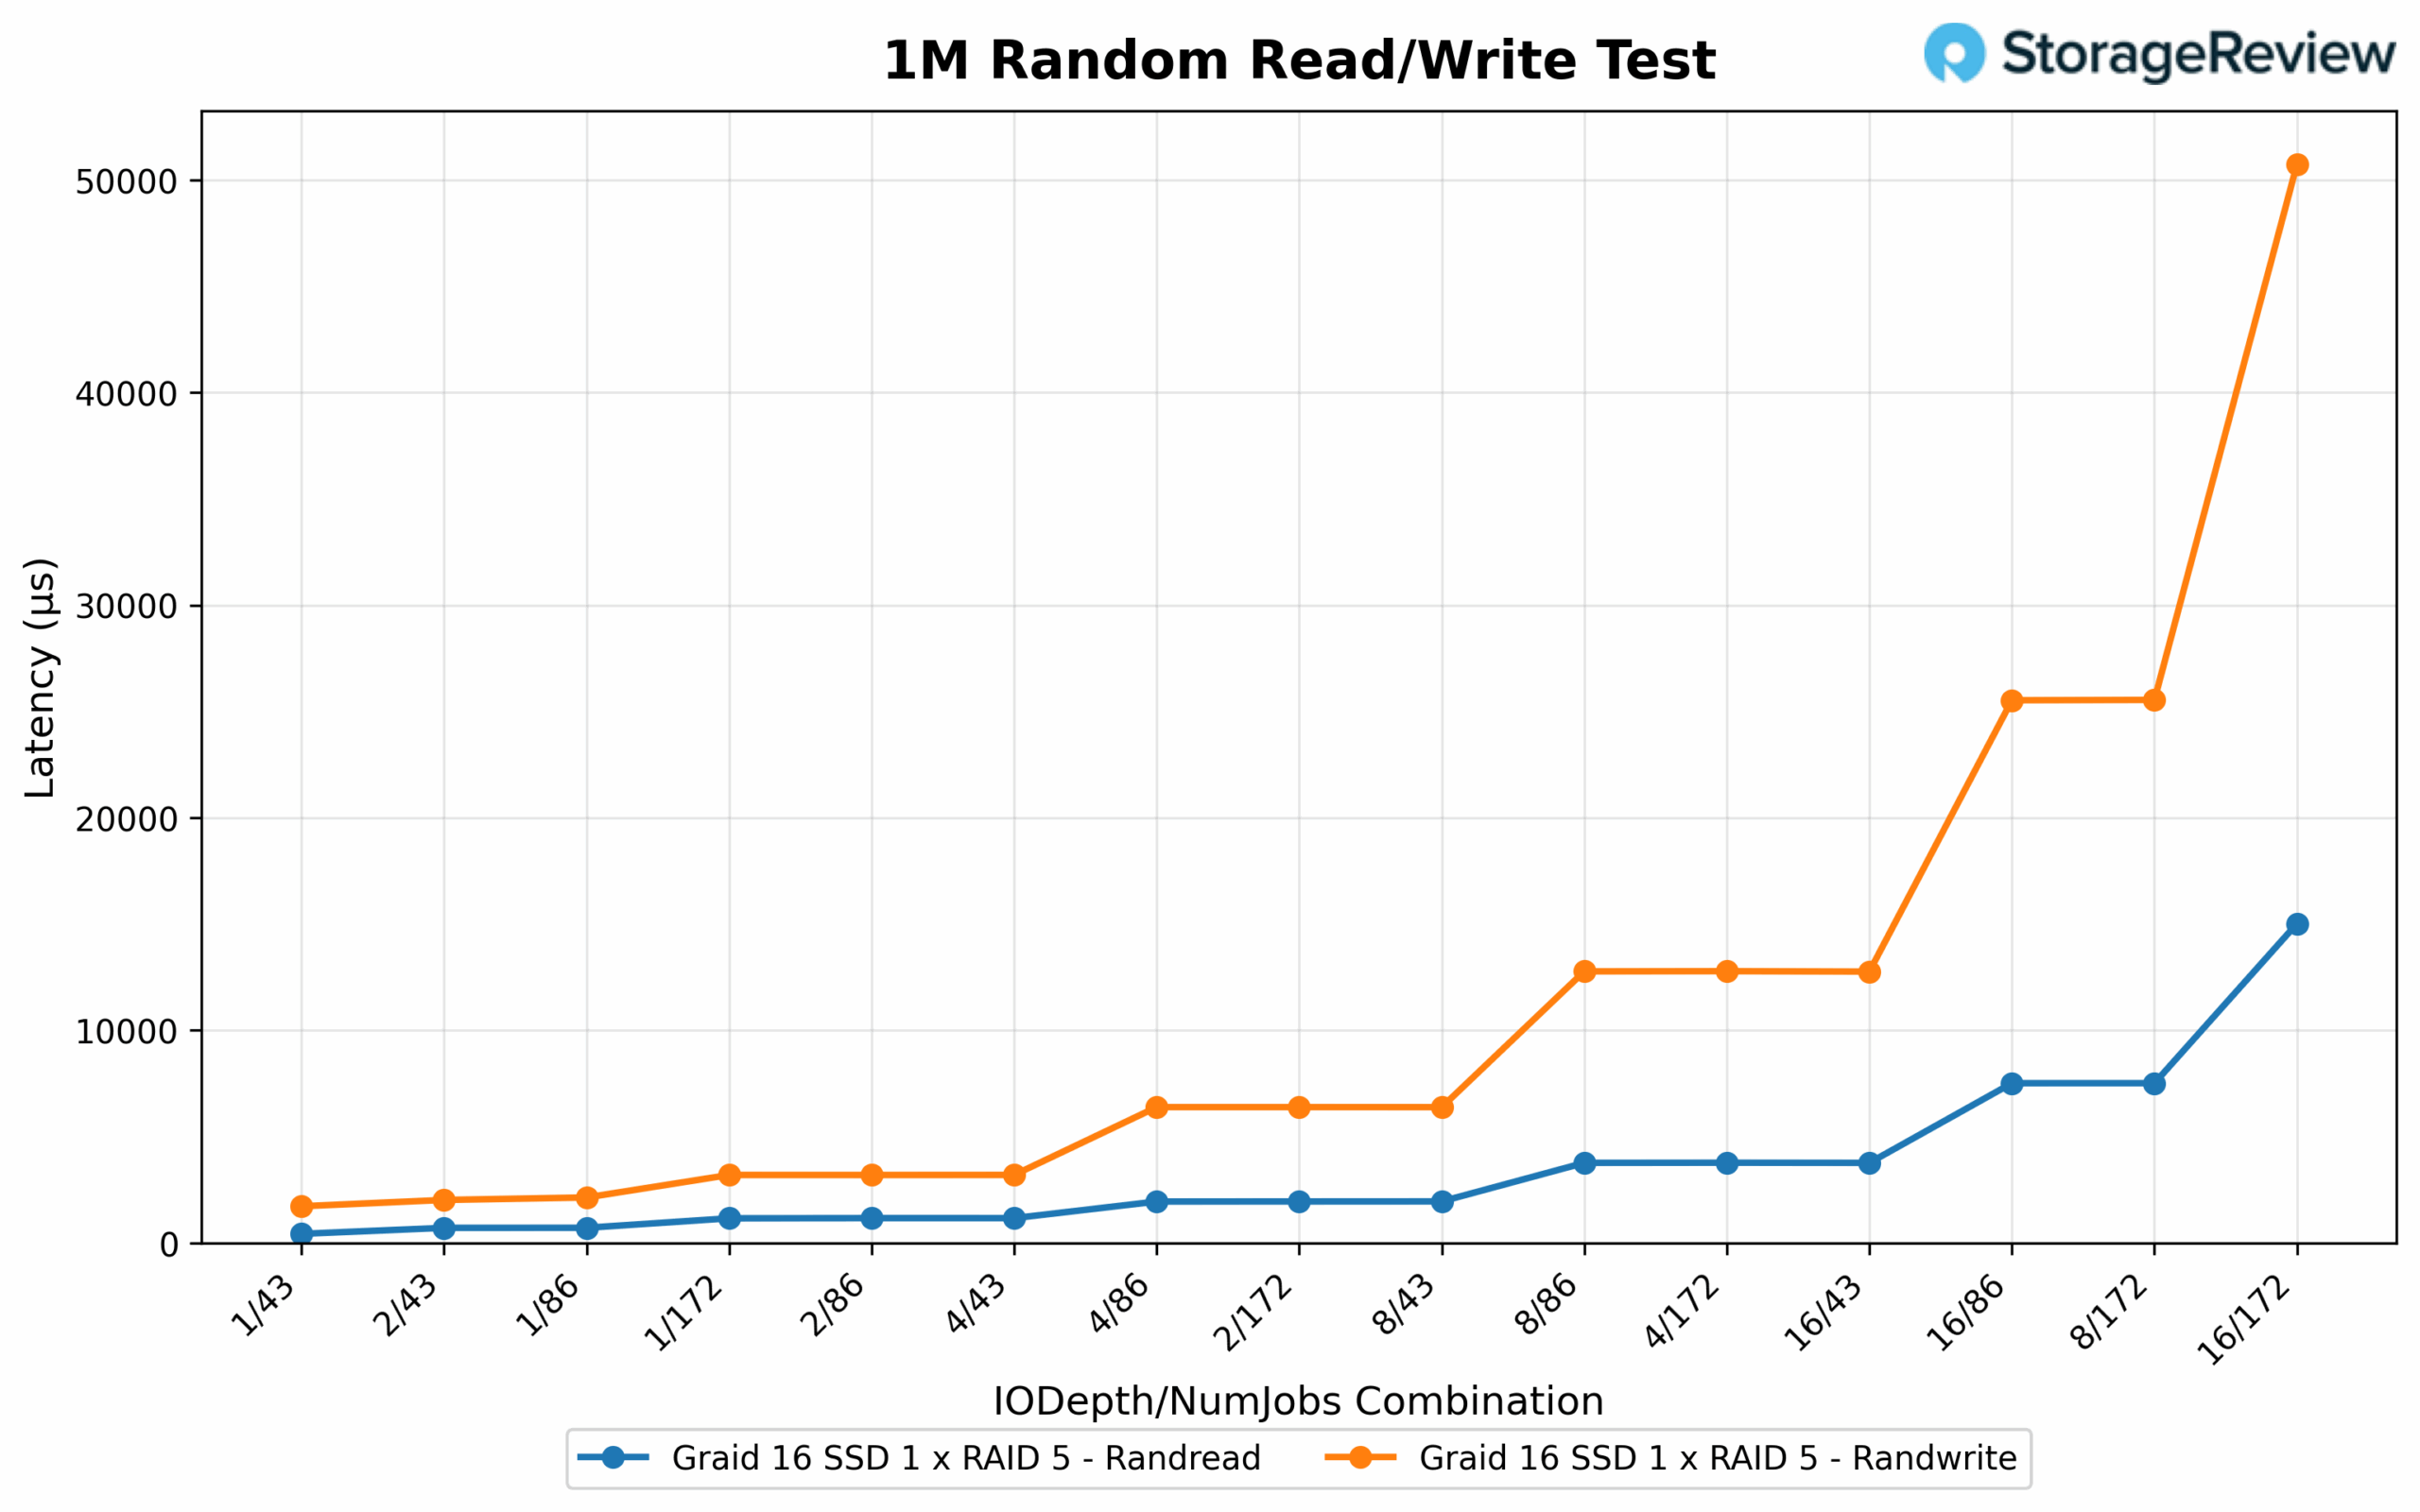
読み取りレイテンシは、テスト範囲全体にわたって制御されていました。観測された最低レイテンシは、0.714/2 と 86/4 の両方で 86 ミリ秒でしたが、8/172 や 4/172 などのより深い深度の負荷では 2 ミリ秒未満に留まりました。最高の読み取りスループットを生成した構成である 16/172 は、7.516 ミリ秒の最高のレイテンシとなりました。これは、キューが深くなると応答時間が長くなるため、明らかなトレードオフです。書き込み側では、レイテンシは同様のパターンを示しました。最低の書き込みレイテンシは 1.727/1 で 43 ミリ秒でした。スループットとレイテンシの強力なバランスは、2/86 で 3.197 ミリ秒でした。8/43 などのより高い同時実行オプションでは 6.389 ミリ秒を記録し、16/172 構成では、最高の書き込みパフォーマンスを実現しながら 50.741 ミリ秒の最高のレイテンシを記録しました。これは、極度の深度でのスループットと応答性の間のよく知られた逆相関関係を強調しています。
64K ランダム読み取り/書き込み帯域幅
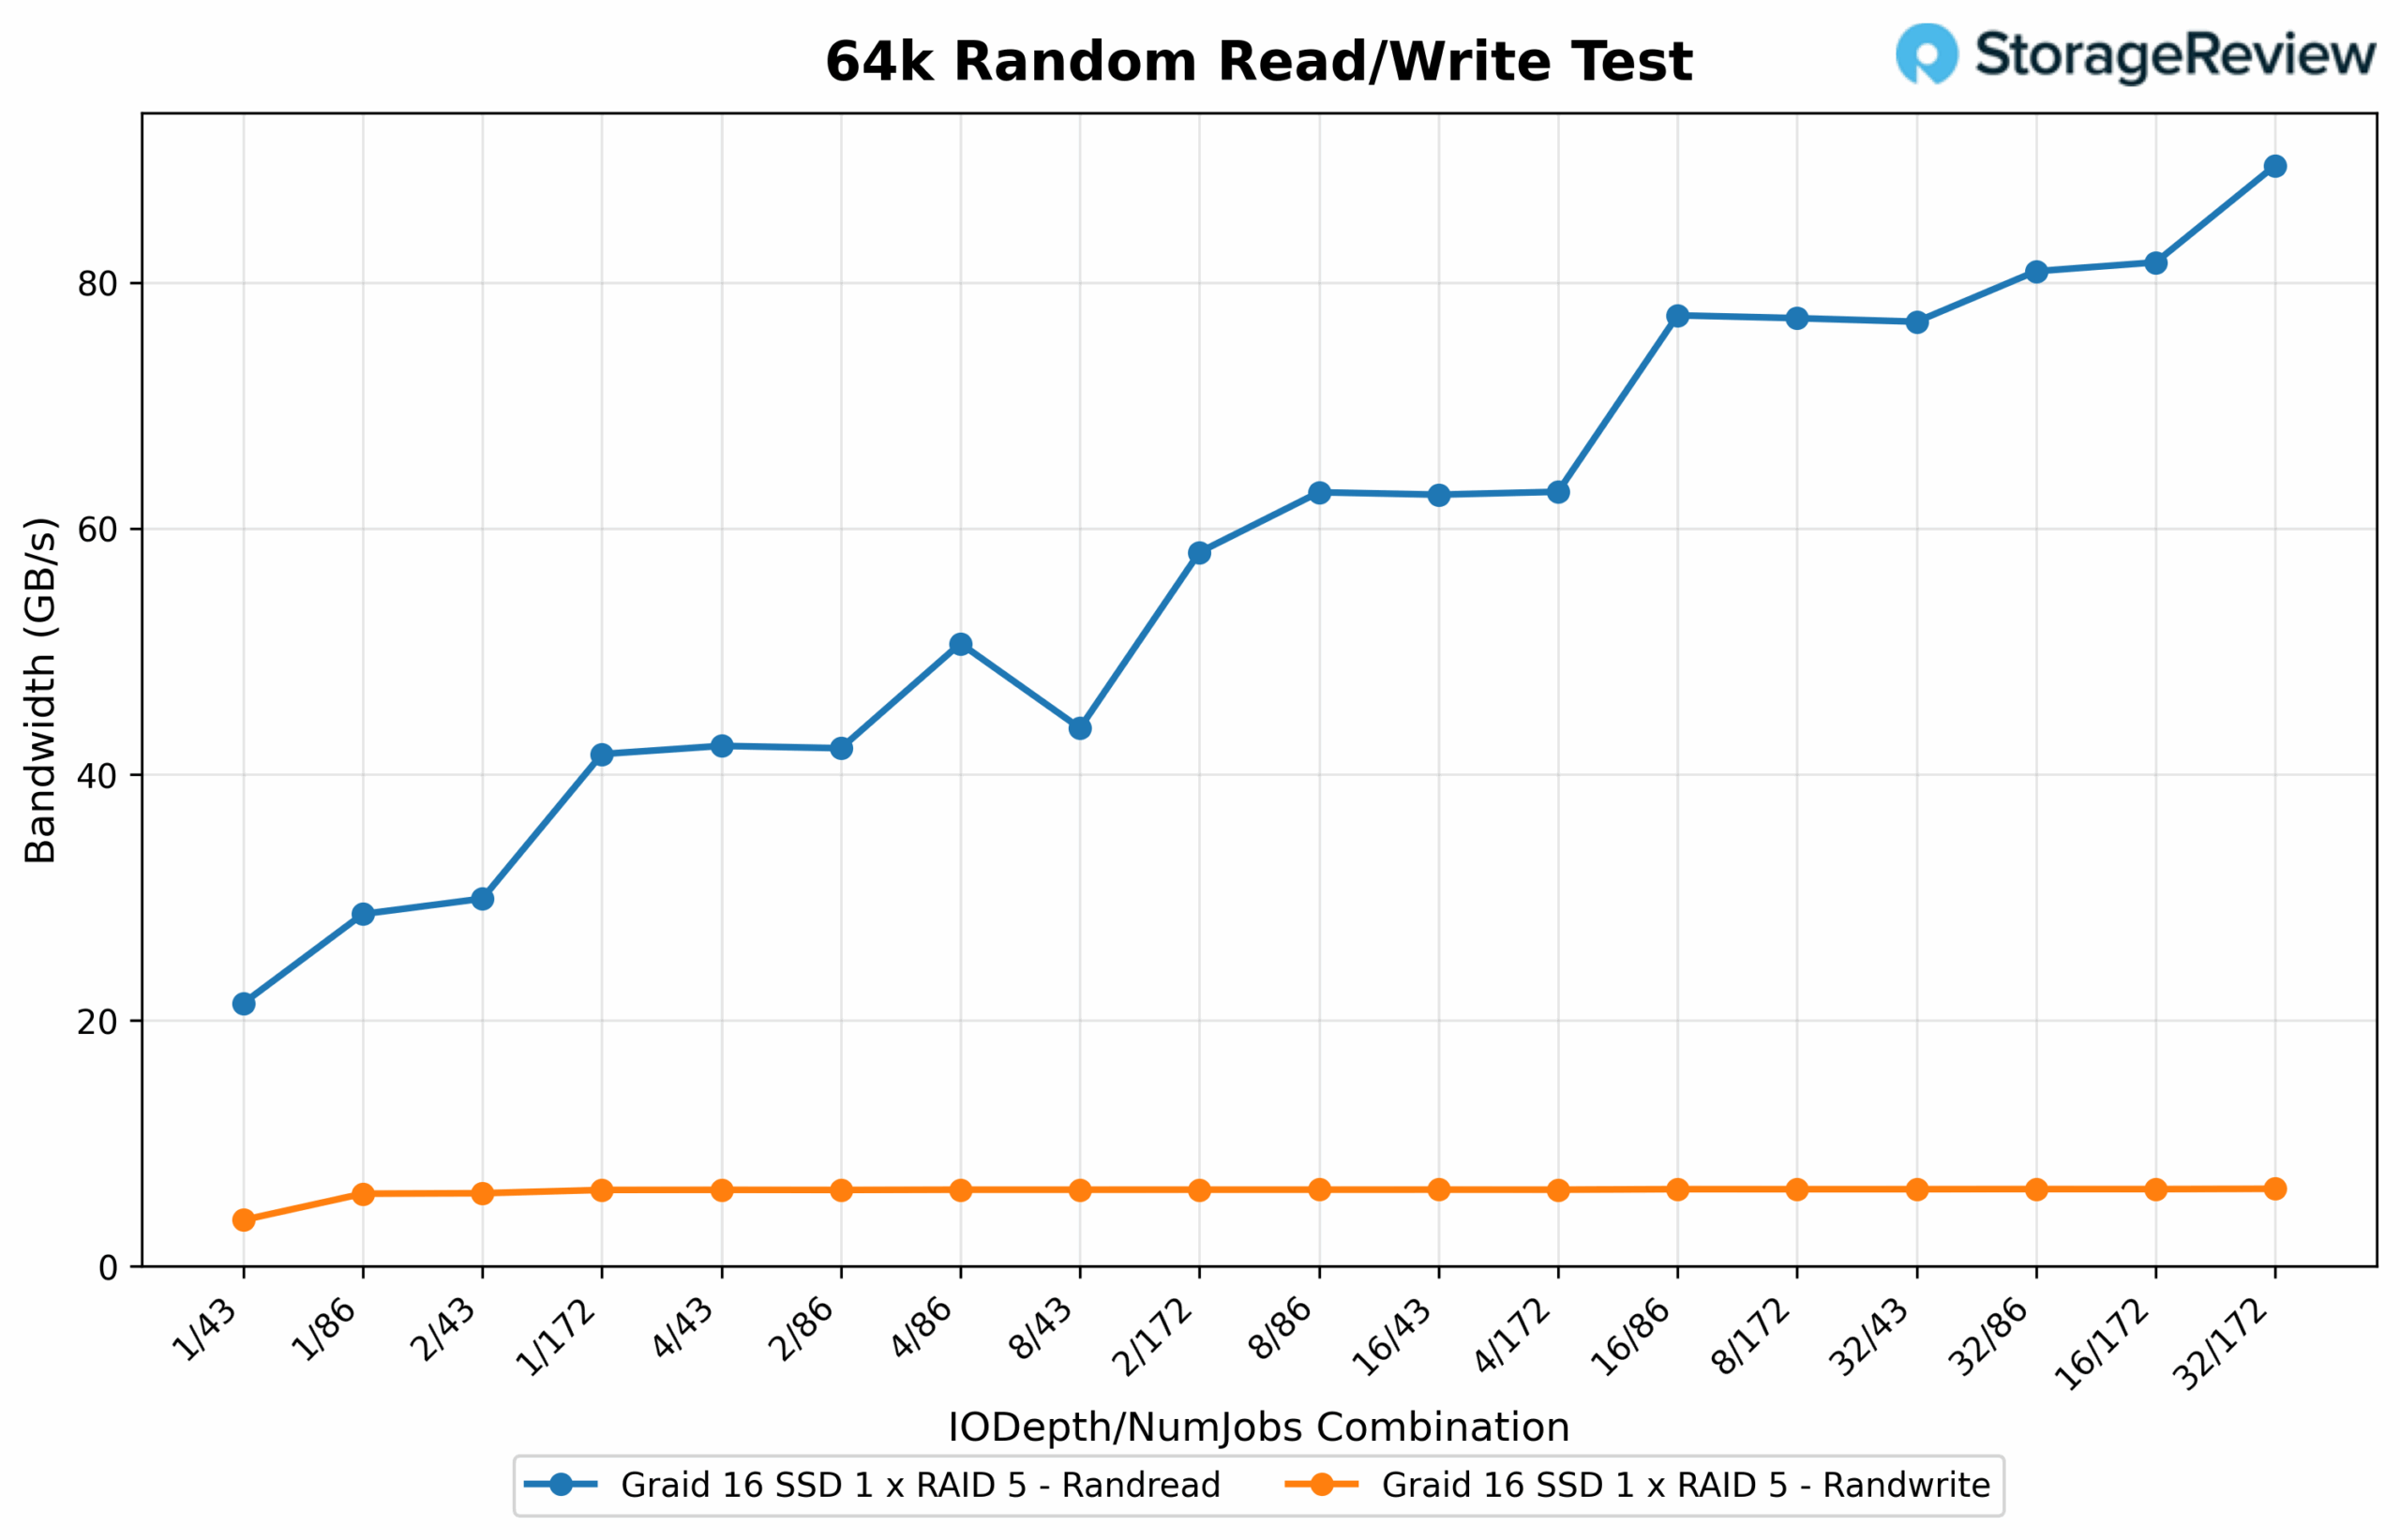
ランダム 64K 操作に移行すると、キュー深度とジョブ数の増加に伴い読み取り帯域幅が大幅に向上し、91.65 ジョブで 32 IO 深度で 172GB/秒のピークに達しました。16/172 で 83.59GB/秒、32/86 で 82.85GB/秒など、他の構成もこれに続き、ワークロードのスケールに応じて着実にパフォーマンスが向上していることがわかります。8/172 や 16/86 などのミッドレンジのセットアップでは、78GB/秒から 79GB/秒の間で強力な結果が維持されました。対照的に、1/43 や 1/172 などの同時実行性の低い組み合わせでは、スループット レベルが 21.89GB/秒から 42.63GB/秒まで低下し、ピーク時のパフォーマンスを実現するためにアレイが並列処理に依存していることを示しています。書き込み側では、64K ランダム帯域幅は 6.44/32 で 86GB/秒のピークに達しました。 32/172や16/86といった他のトップパフォーマンス構成もほぼ同等のパフォーマンスを示し、それぞれ6.41GB/秒と6.36GB/秒を記録しました。ほとんどのテストポイントは6.3GB/秒から6.4GB/秒の間に集中しており、キュー深度の変化にかかわらず安定したパフォーマンスを示しました。1/43などの低速構成では書き込みパフォーマンスが3.83GB/秒と最も低くなりましたが、それでも高負荷環境下では徐々にパフォーマンスが向上するという傾向が裏付けられました。
64K ランダム読み取り/書き込みレイテンシ
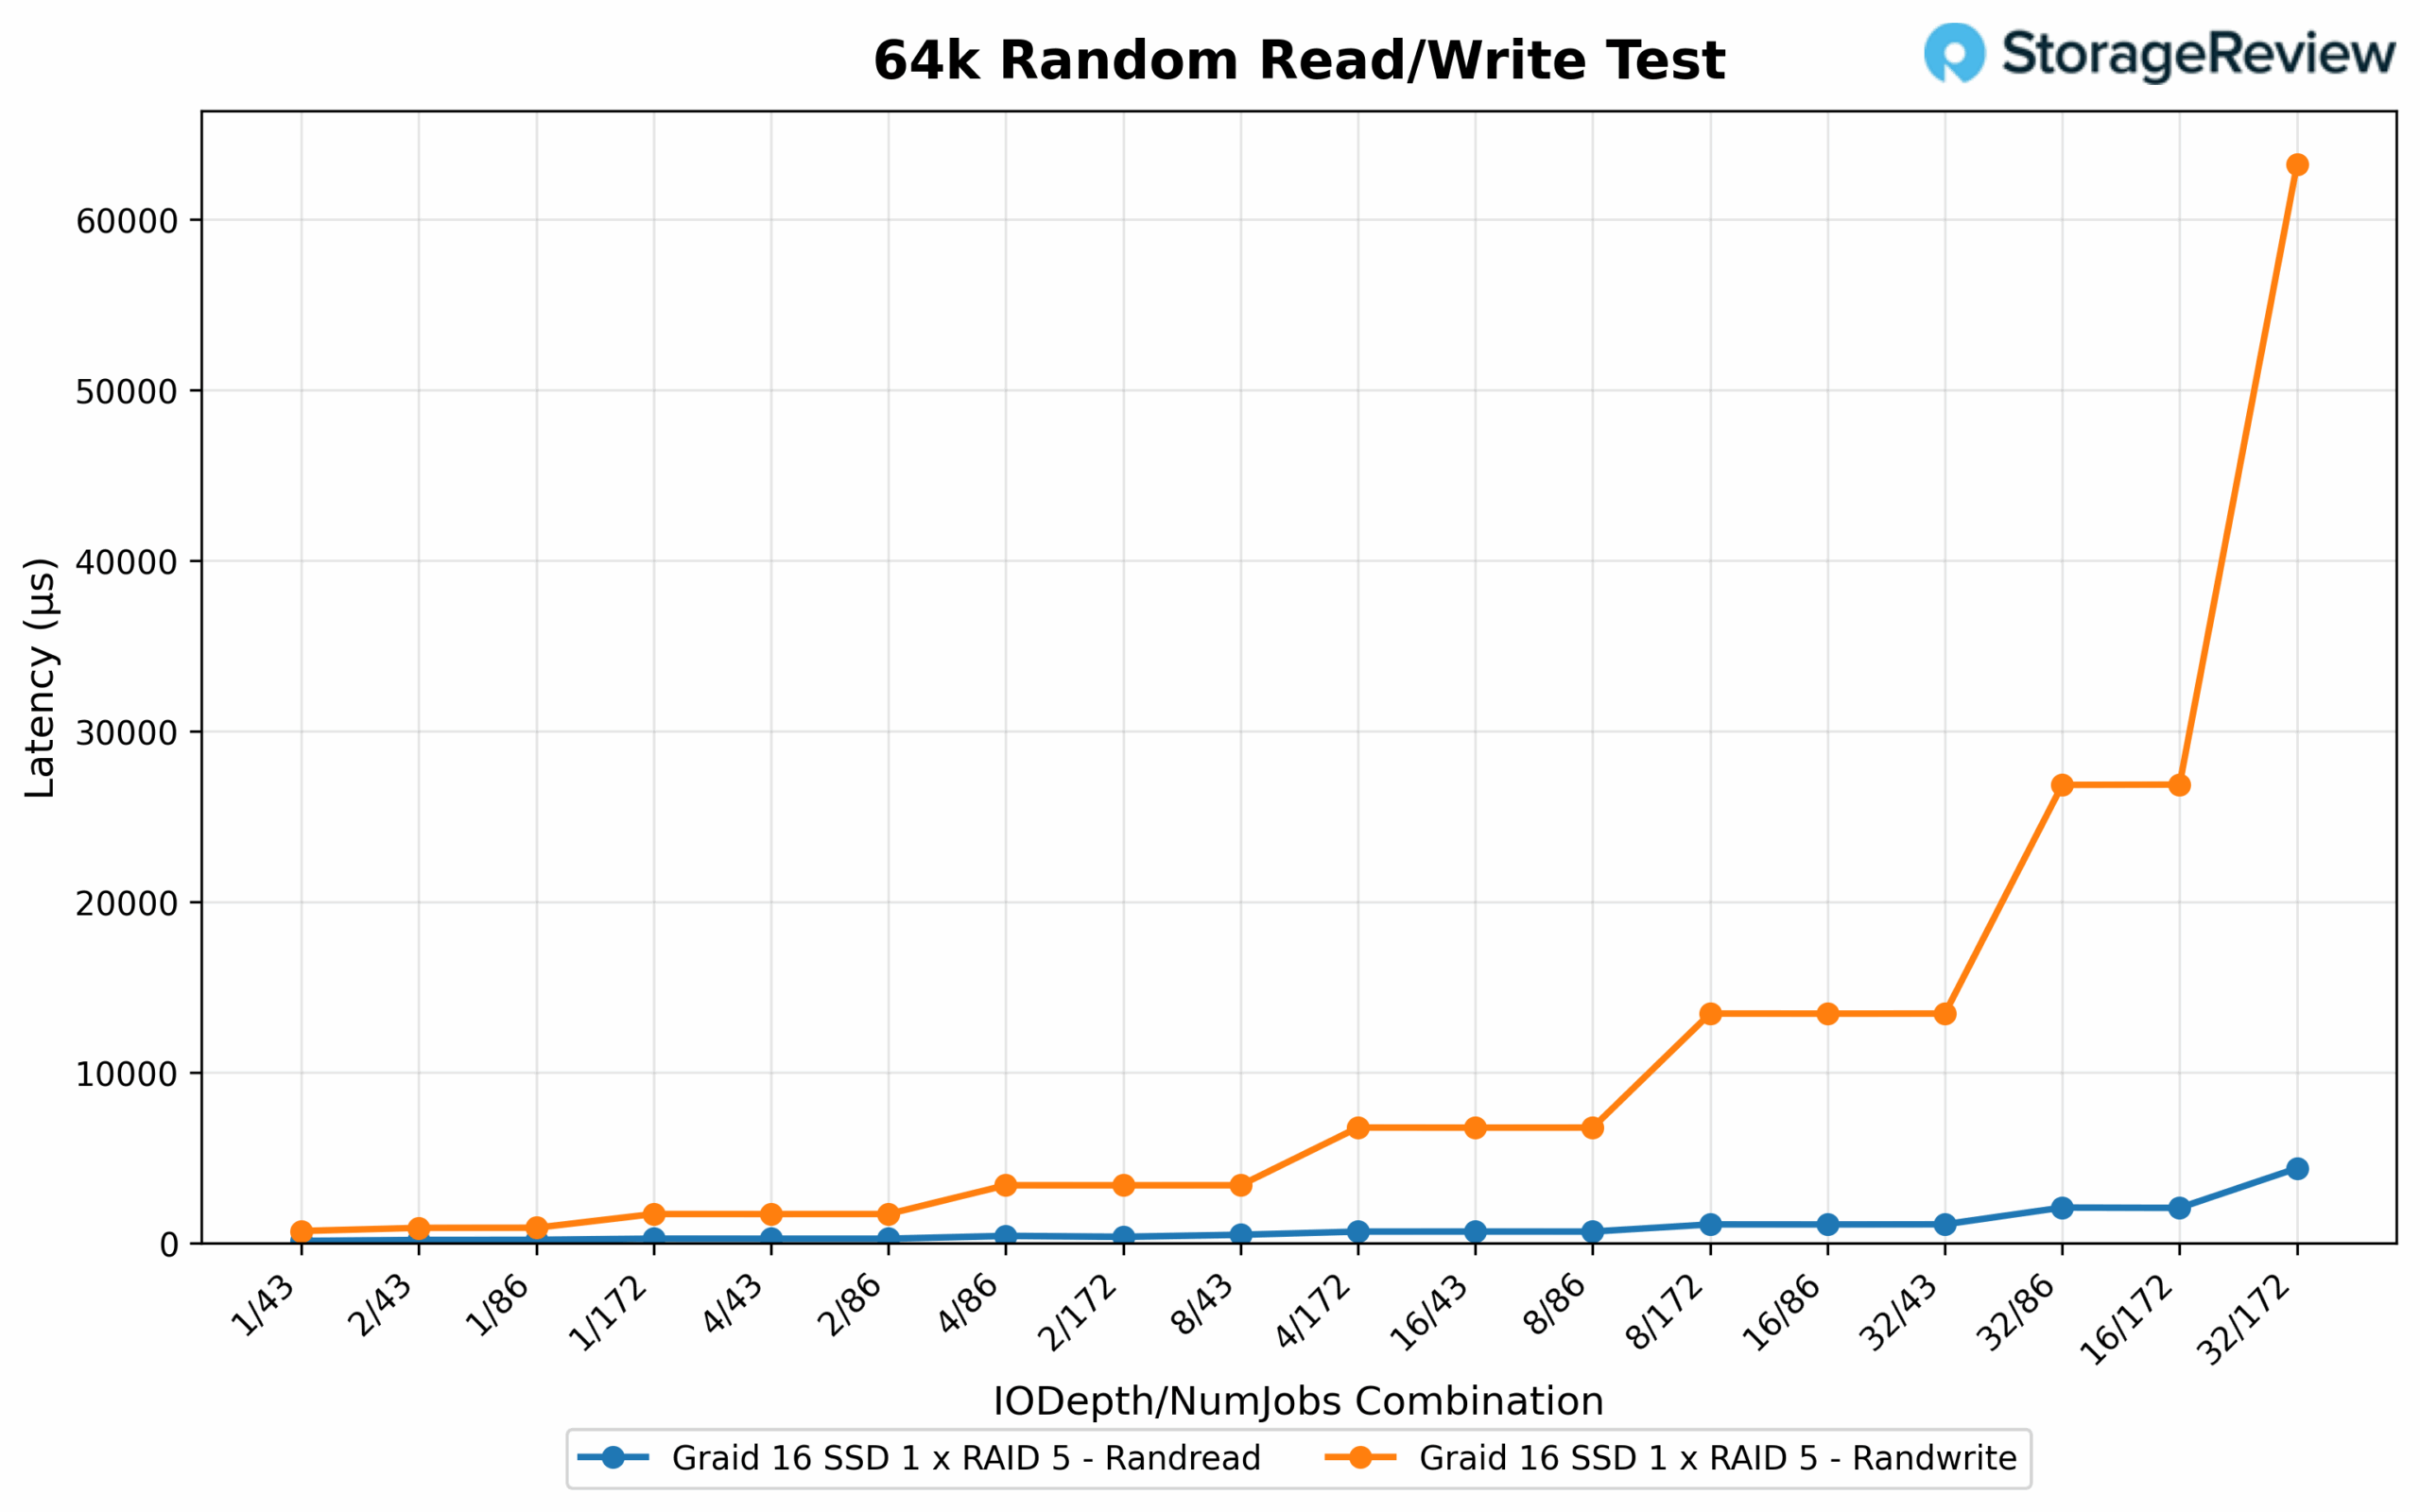
ランダム64K読み取りレイテンシは、ほとんどのテストケースで一貫して低い値を維持しました。最も低いレイテンシは0.123/1で43ms、次いで0.175/1で86msでした。スループットが上昇してもレイテンシは制御範囲内に留まり、4/172では0.666ms、16/172では2.057msを記録しました。高負荷環境下でも応答性は良好で、32/86は2.076msという結果でしたが、帯域幅はトップクラスでした。書き込み側では、レイテンシは深度とジョブ数に応じてより急激に変化しました。最も低いレイテンシは2/43で0.887ms、4/43と2/86はそれぞれ1.694msと1.697msで僅差でした。より重い構成では、応答時間のトレードオフの明確な兆候が見られました。8/172 では 13.445 ミリ秒、16/172 では 26.862 ミリ秒まで上昇し、32/172 では 63.201 ミリ秒でピークに達し、ワークロードが増加するにつれてキューのオーバーヘッドが増加することが強調されました。
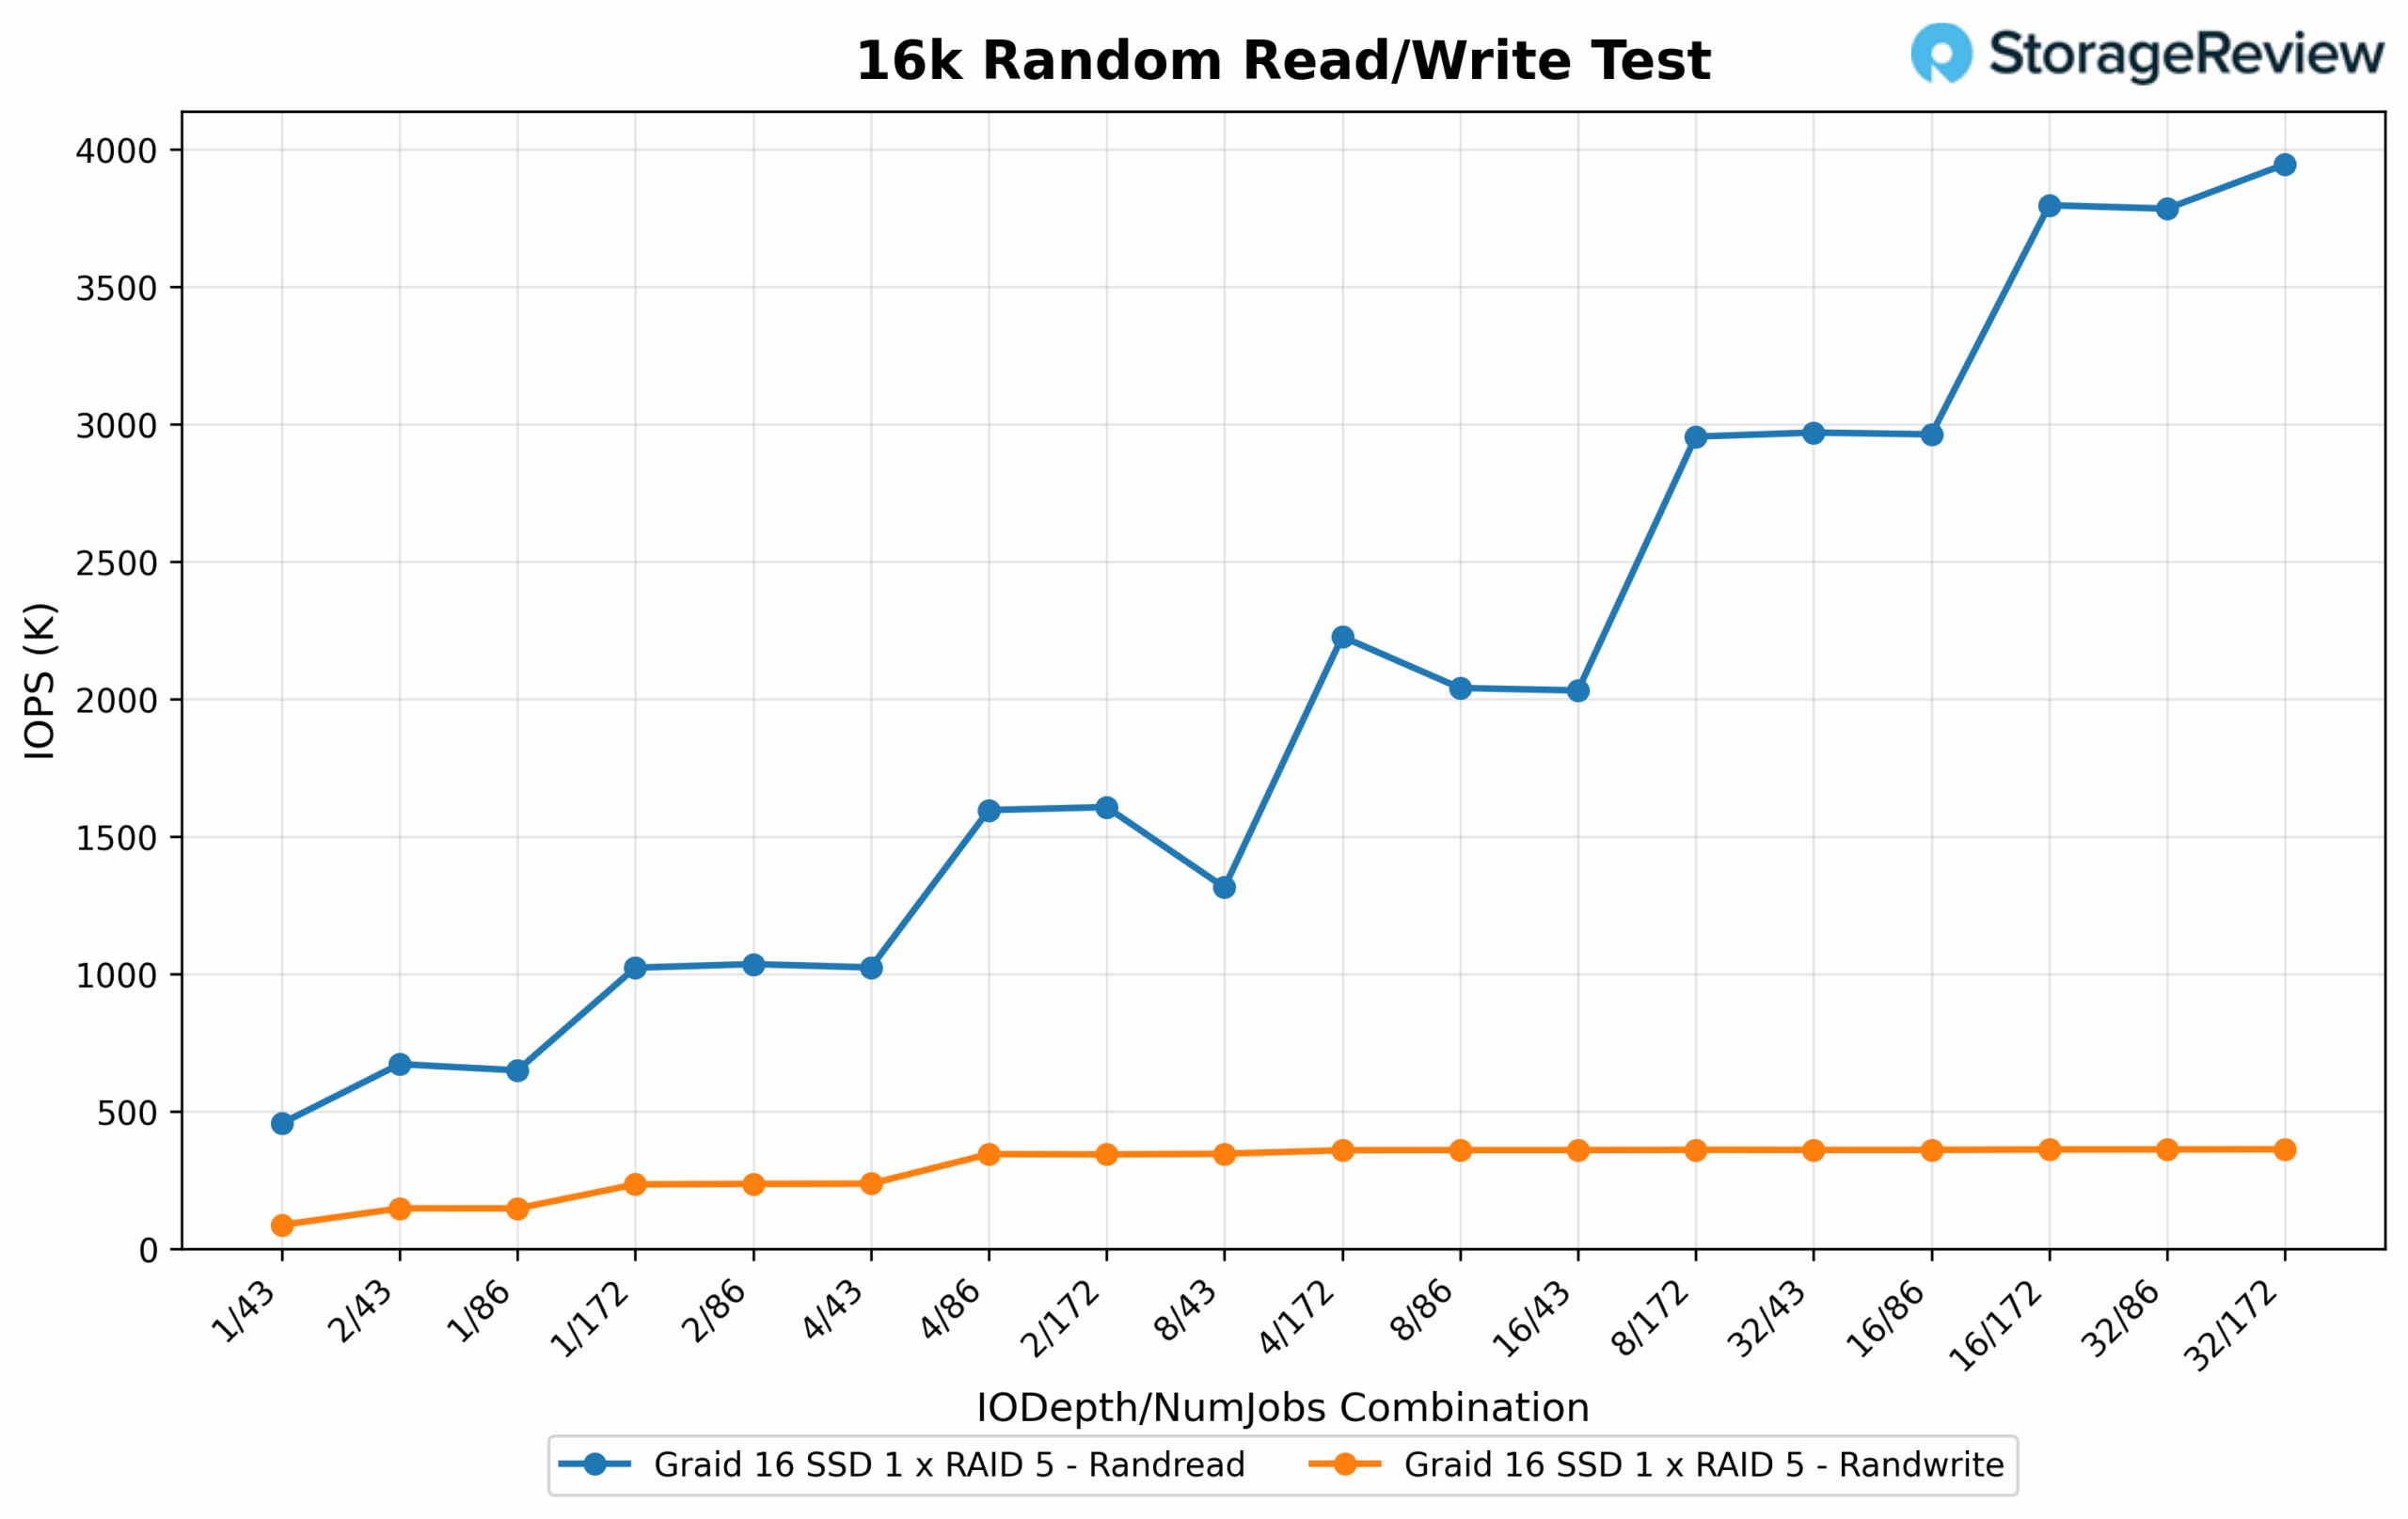
16K ランダム読み取り/書き込み IOPS
16Kランダム読み取りレイテンシは、ピークIOPS時でも低い値を維持しました。最も応答性が高いのは、比較的負荷の低い構成で、1/43ではわずか0.087ミリ秒、1/86では0.114ミリ秒でした。4/86や8/86といった高同時実行構成では、それぞれ0.236ミリ秒と0.420ミリ秒でした。最高性能の構成でもレイテンシは妥当な水準に抑えられており、16/172では1.143ミリ秒、32/172では2.372ミリ秒を記録し、応答時間への影響を抑えつつ効率的なスケーリングを実現しています。16Kランダム書き込みでは、レイテンシが最も低く、2/43で0.848ミリ秒でした。次いで1.253/4で43ミリ秒、1.415/1で43ミリ秒となりました。深度とジョブ数が増加するにつれて、レイテンシは徐々に増加しました。8/172 は 5.574 ミリ秒に達し、16/172 と 32/172 はそれぞれ 10.455 ミリ秒と 22.958 ミリ秒に上昇し、キューの飽和が増加するにつれて予想されるトレードオフが強調されました。
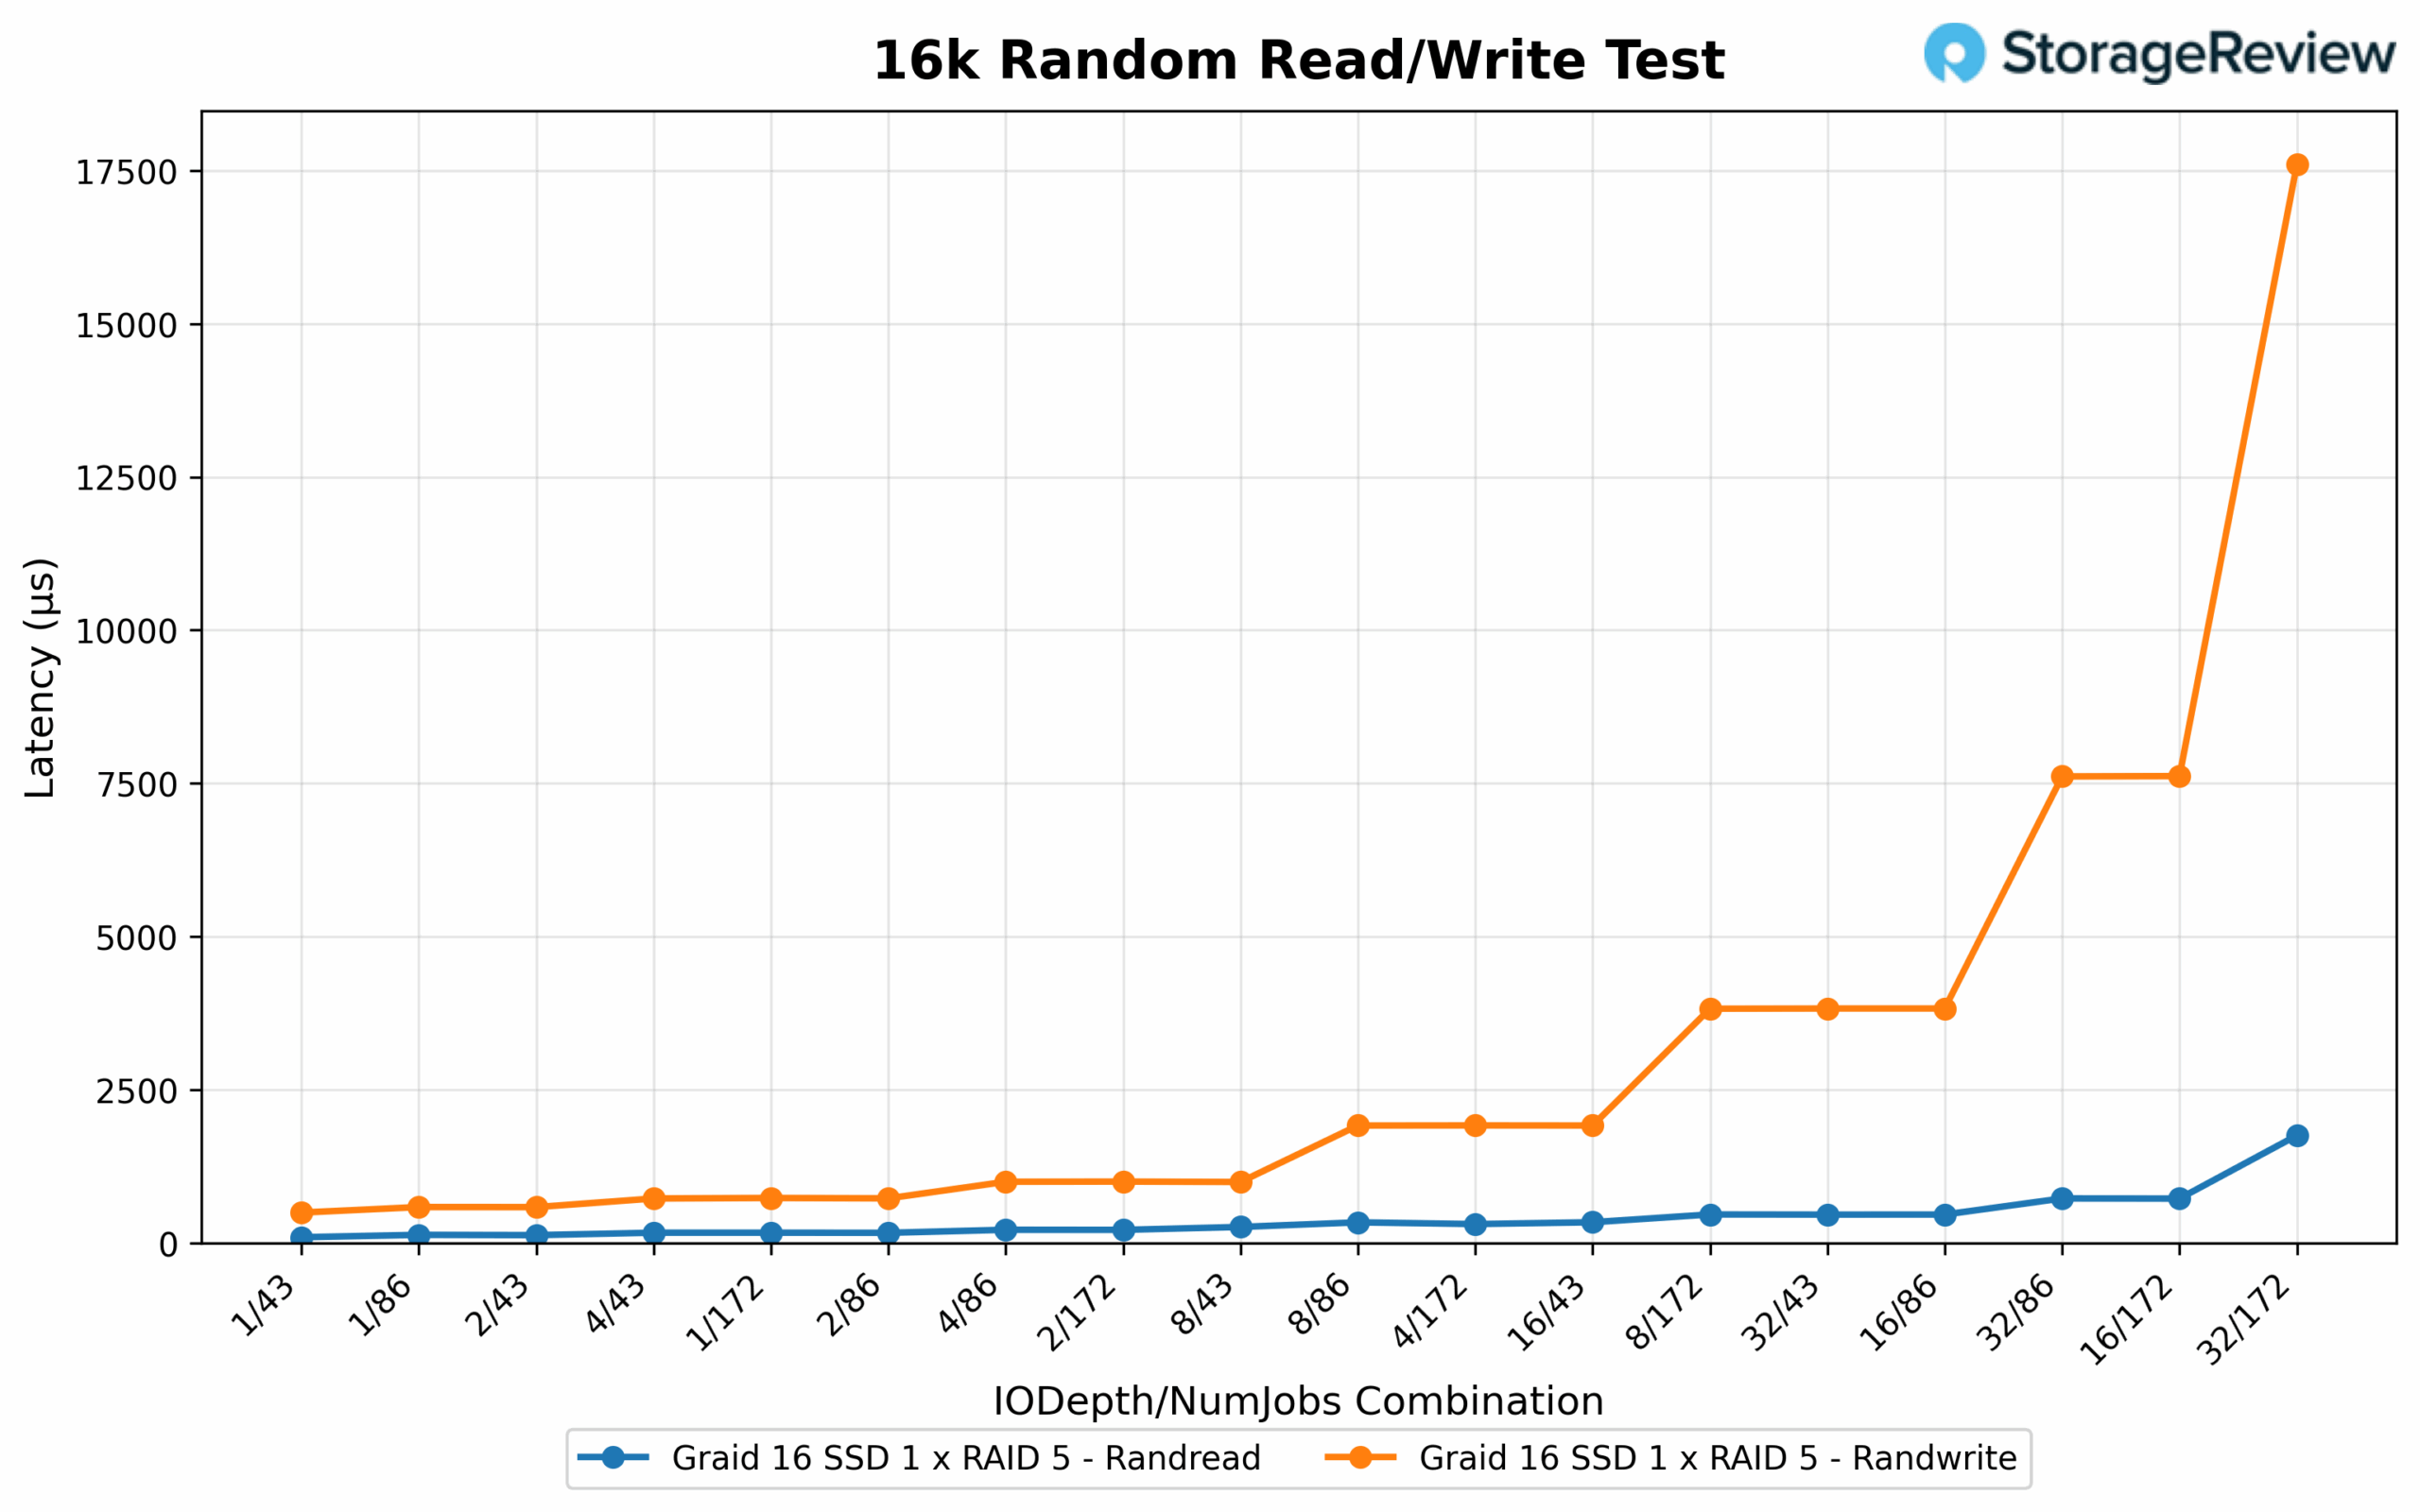
16K ランダム読み取り/書き込みレイテンシ
ランダム16K読み取りレイテンシは、全体的に一貫して低い値を維持しました。最も応答性に優れた構成は1/43で0.123ms、次いで1/86で0.175msと僅差でした。最大負荷時でも、32/172や16/172といった構成ではレイテンシが2.1ms未満に抑えられ、アレイは高いIOPSを処理できる一方で応答時間も高速であることが示されました。一方、ランダム16K書き込みレイテンシは、より広いばらつきを示しました。最も低いレイテンシは0.496/1で43msで、2/86や4/43といった効率的な実行では1ms未満を維持しました。同時実行性と深度が増すにつれて、レイテンシもそれに応じて増加しました。16/172では7.017ms、32/172では17.246msとなり、最大飽和時のピークスループットと応答性の間のトレードオフが予想通りであることが裏付けられました。
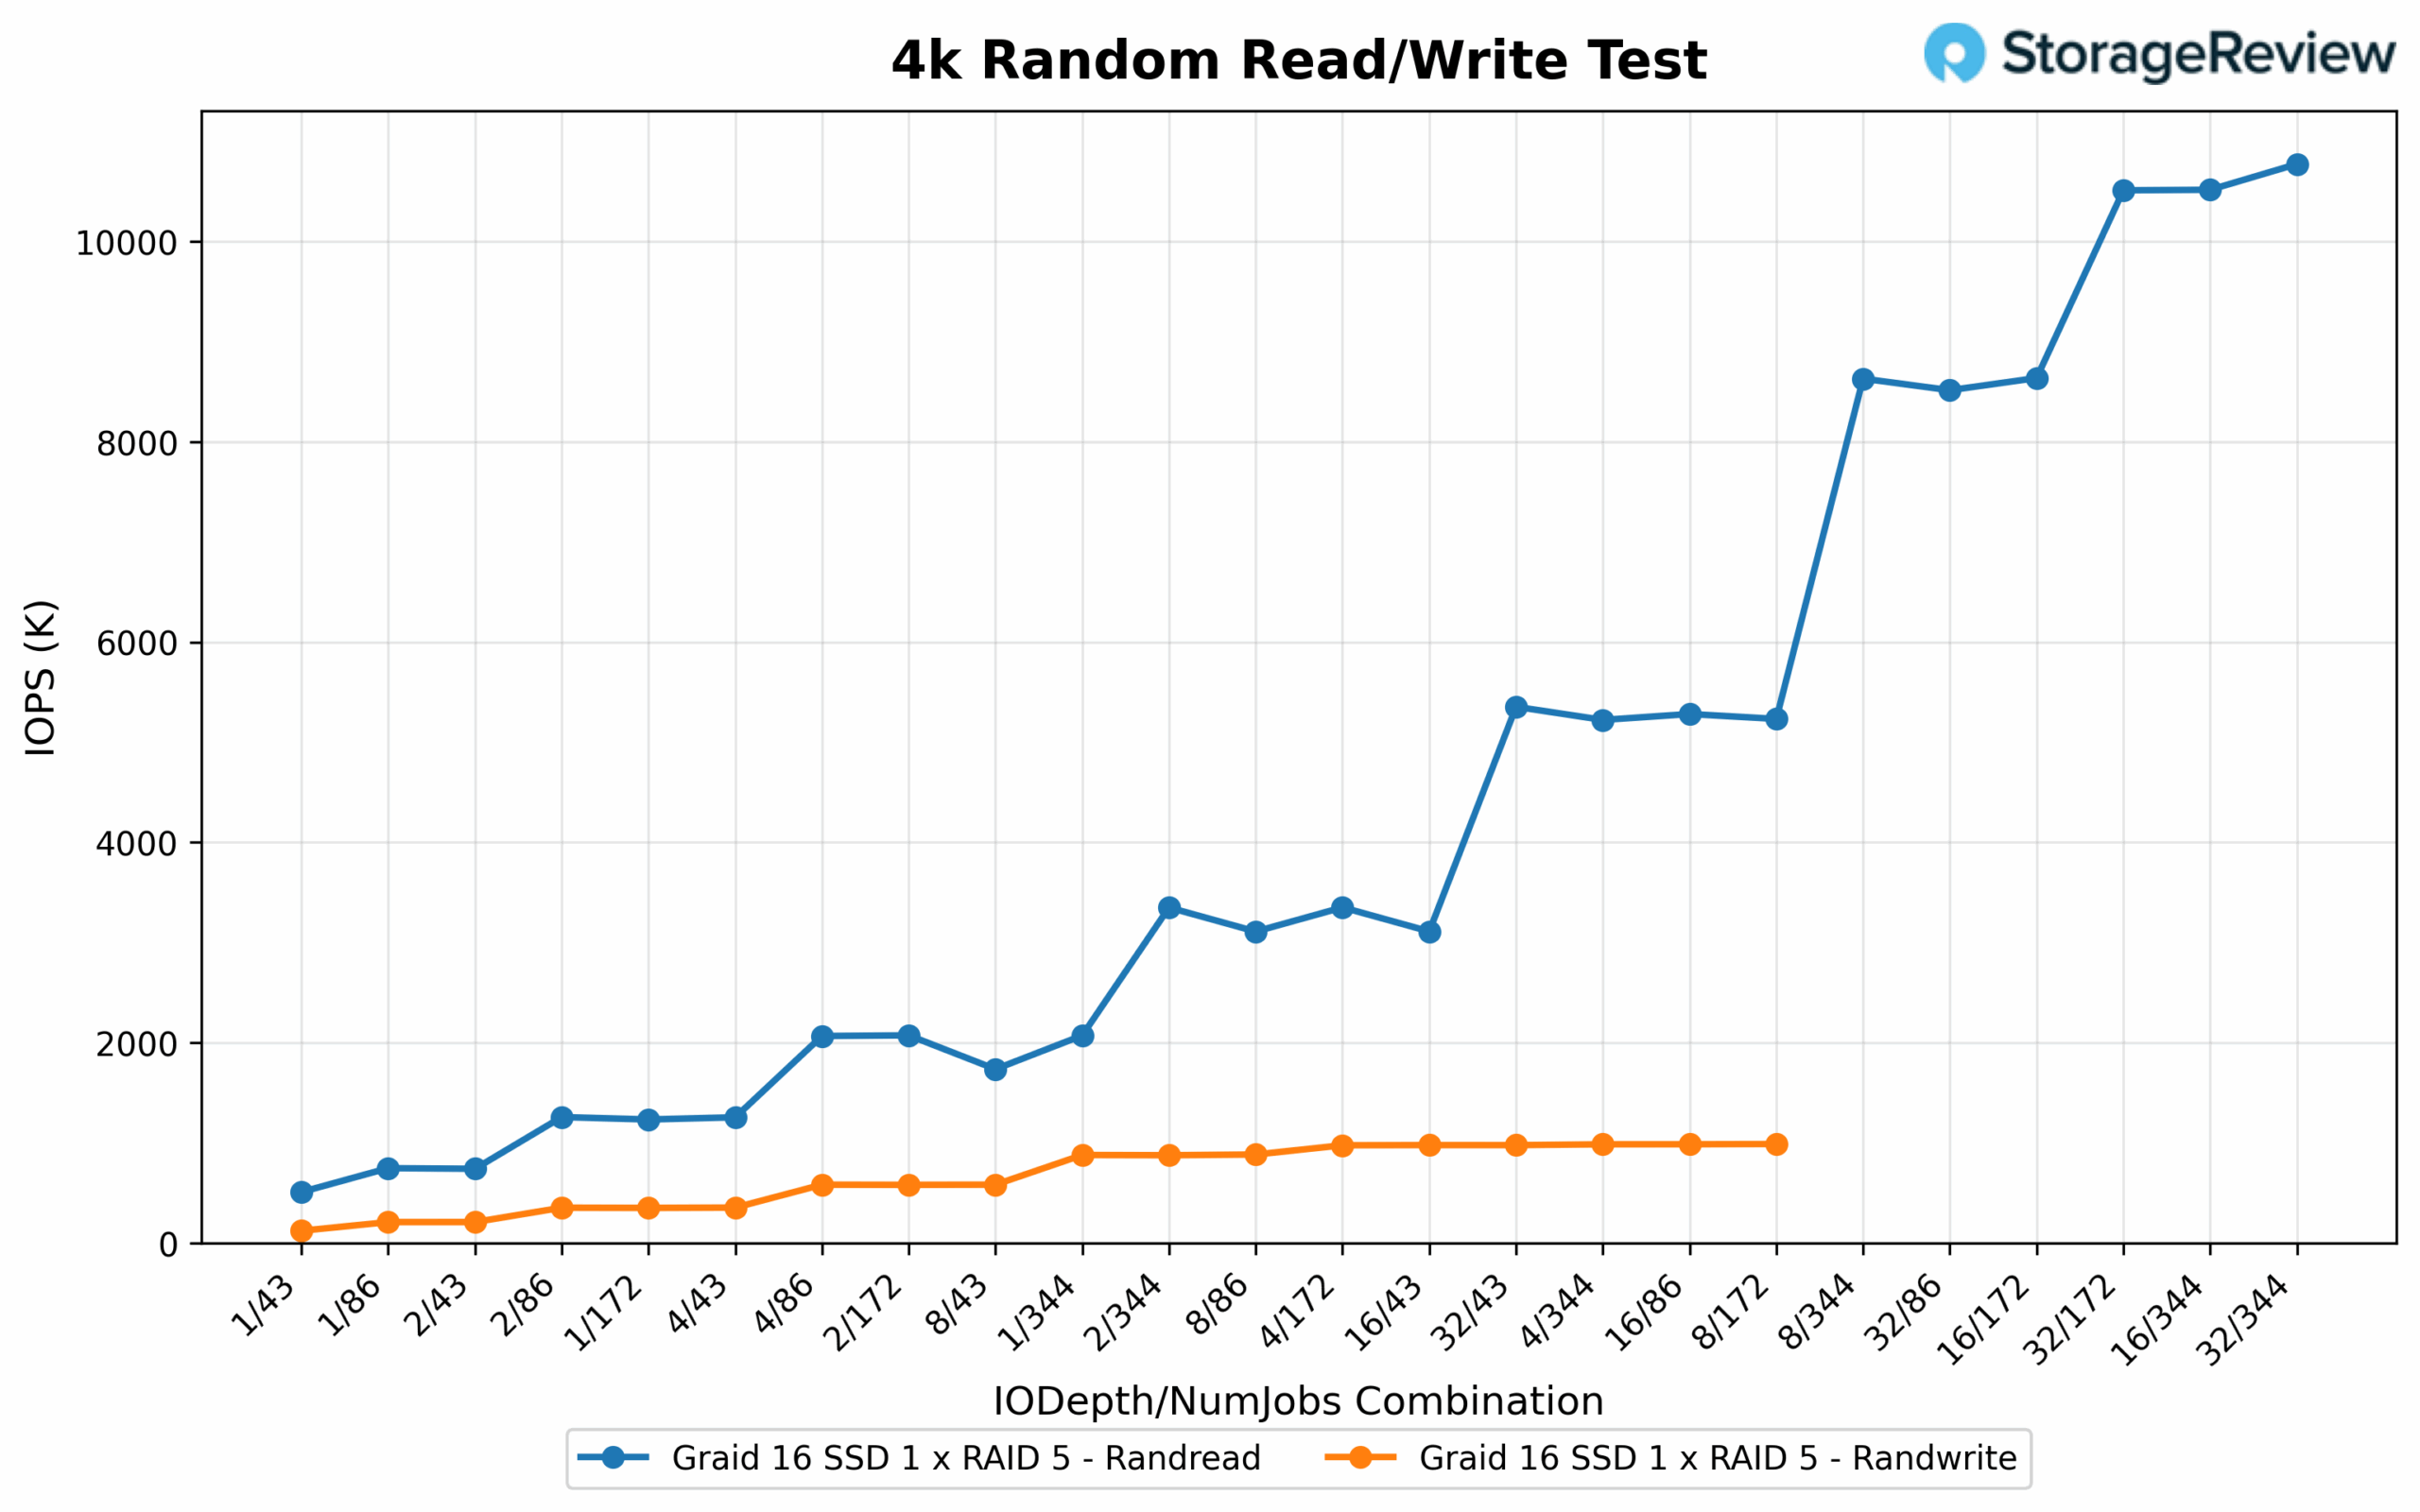
4K ランダム読み取り/書き込み IOPS
同時実行負荷が高い状況では、ランダム4K読み取りIOPSは、IO深度10.77、ジョブ数32で344万IOPSという驚異的なピークに達しました。16/344で10.52万IOPS、4/344で10.51万IOPS、8/344で10.42万IOPSと、他の構成も僅差で続き、いずれもキューとジョブ深度を積極的に組み合わせることで、卓越したスケーリング性能を示しました。8/172や16/172といった深度を下げた構成でも、5.23万IOPSから5.35万IOPSという高いスループットを維持し、要求の厳しい並列ワークロード処理能力をさらに際立たせました。書き込みでは、4K IOPSはIO深度987.9/32で172KIOPSのピークに達しました。同様の高効率構成としては、32Kで86/985.1、16Kで172/985.6、8Kで172/976.9が挙げられます。さらに、8/86から16/86までの組み合わせでも、875Kから977Kの範囲でパフォーマンスが維持され、同時書き込み操作による完全な飽和状態においてもアレイの一貫性と信頼性が強化されました。
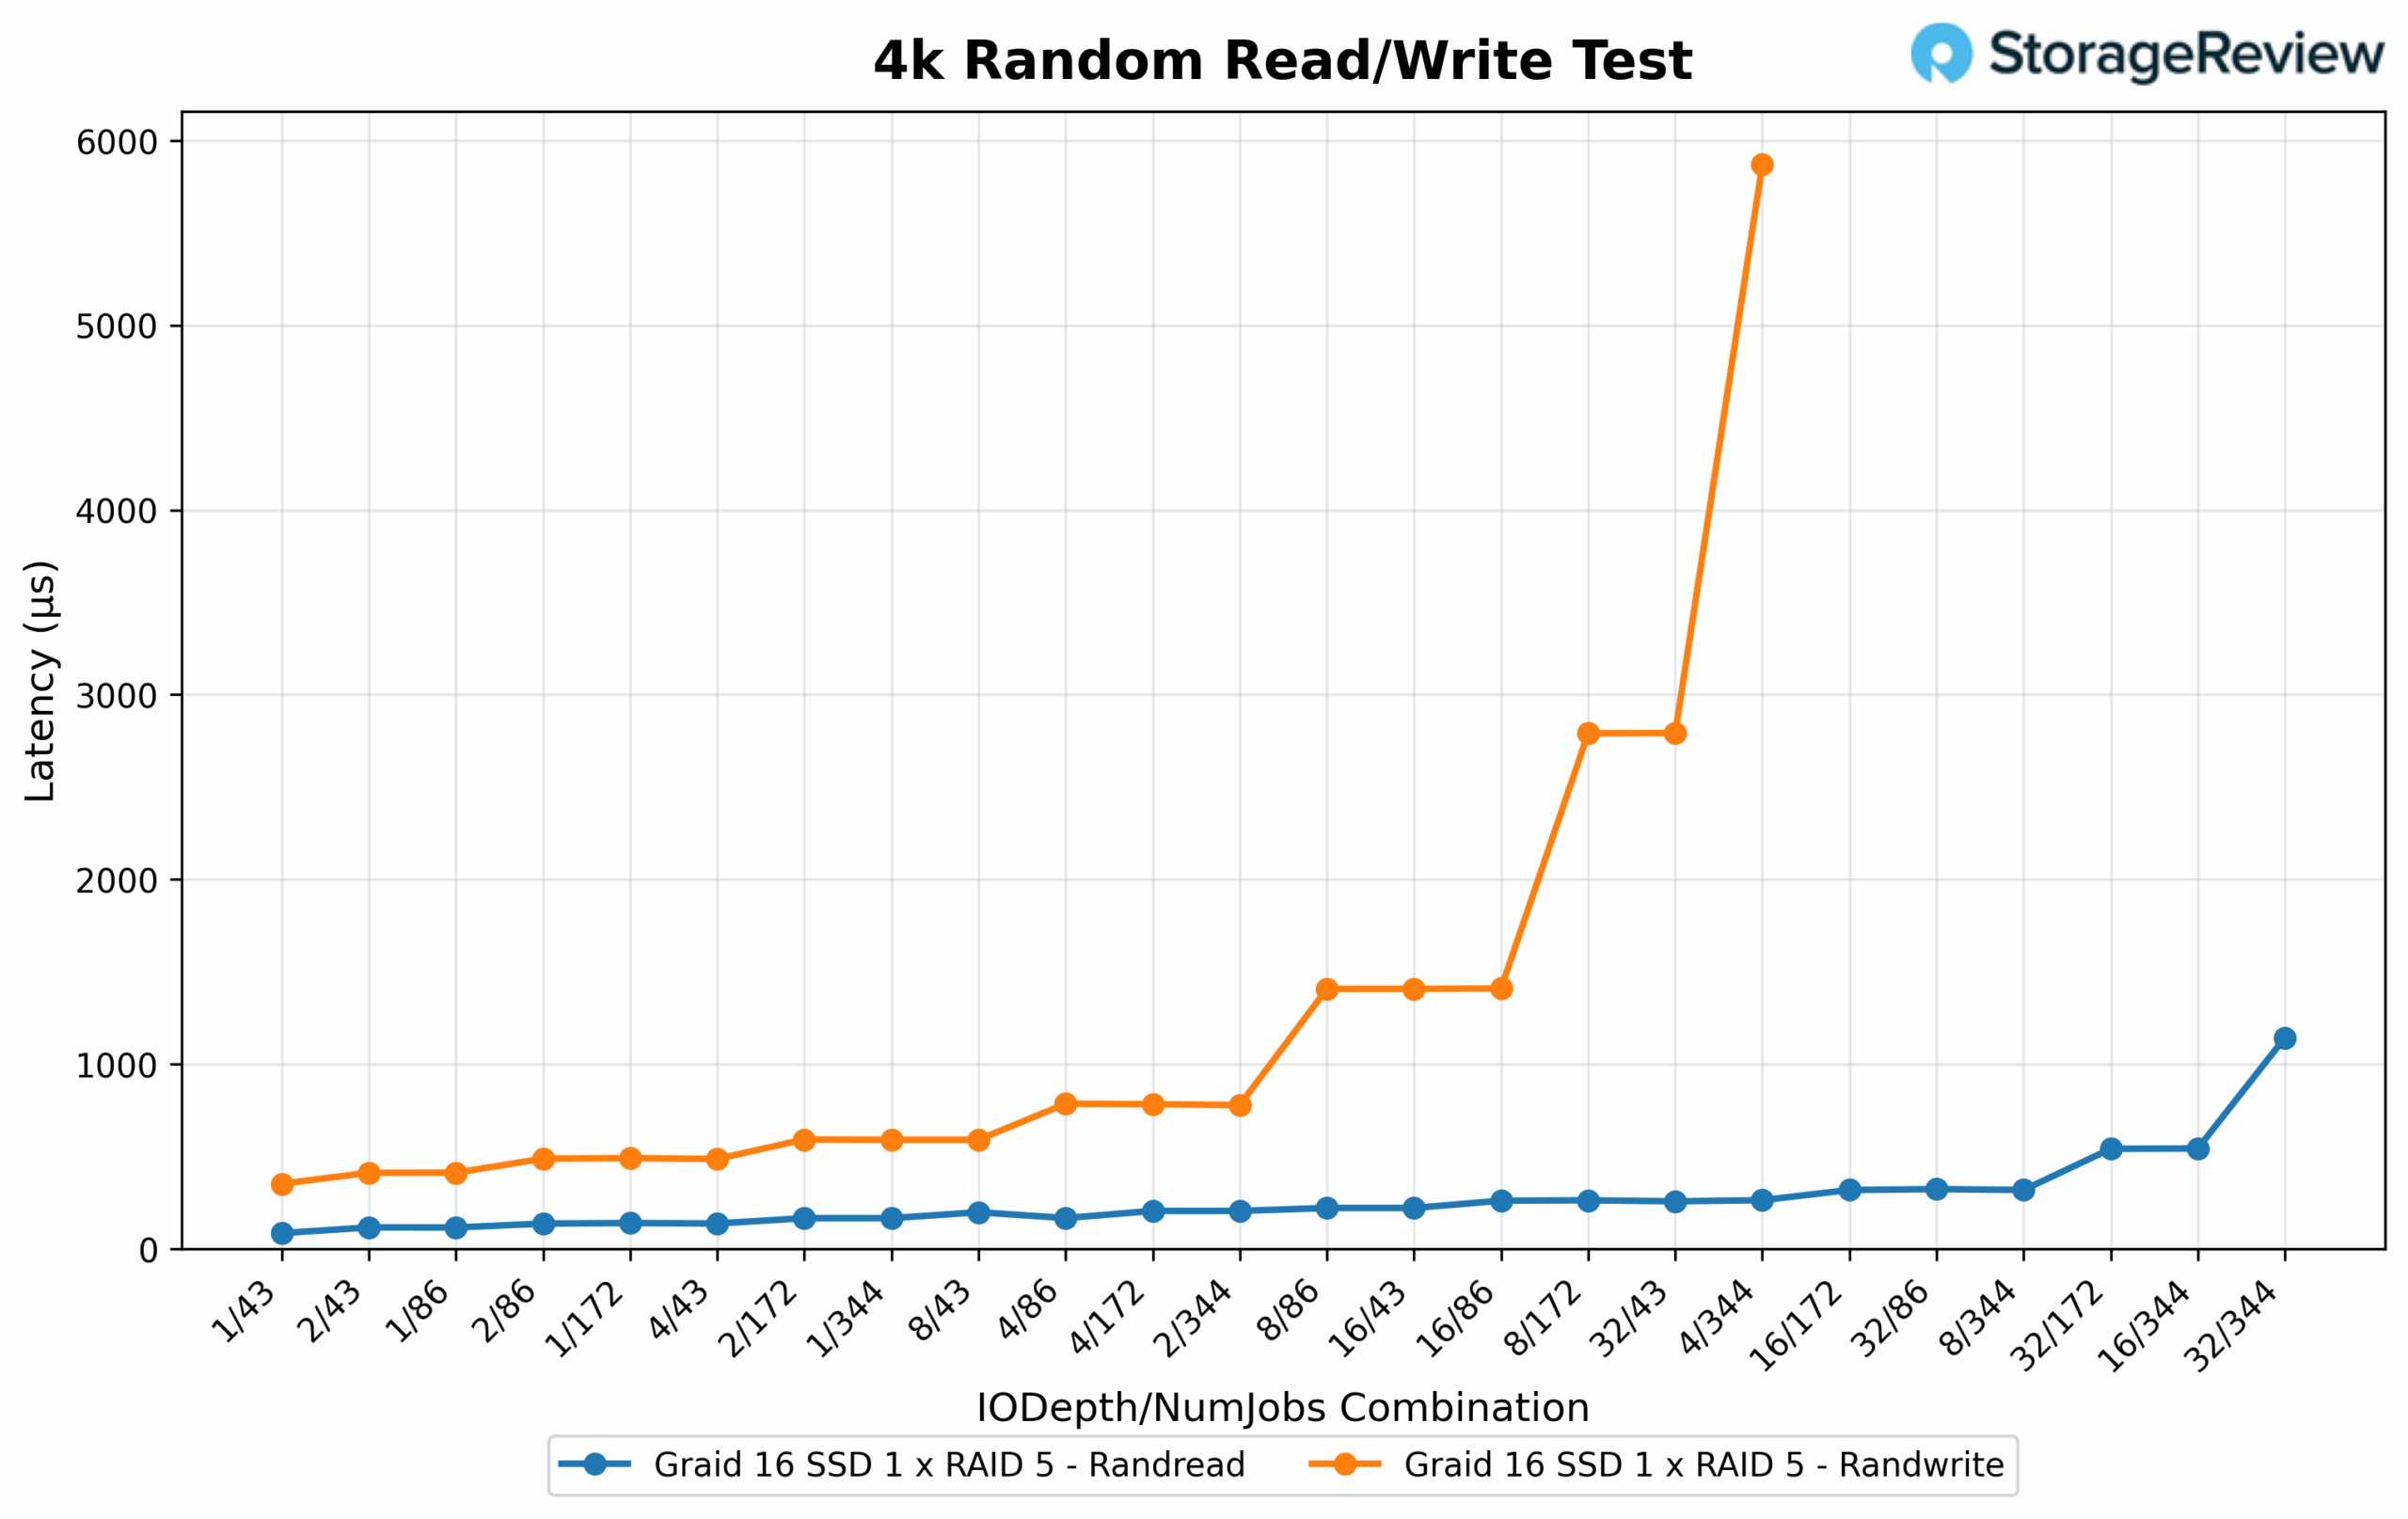
4K ランダム読み取り/書き込みレイテンシ
ランダム4K読み取りレイテンシは、全体的に非常に低い値を維持しました。最速の応答時間は0.084/1で86ミリ秒でしたが、1/43、2/43、4/43を含む他の構成でも、すべて0.12ミリ秒を下回りました。ピークIOPS時でもレイテンシは良好に制御されており、最高性能の32/344構成でもわずか1.142ミリ秒に抑えられています。これは、アレイが最大スループットのポテンシャルに達しているにもかかわらず、優れた応答性を維持していることを示しています。書き込み側では、ランダム4Kレイテンシも良好に管理されています。記録された最低値は0.352/1で43ミリ秒でしたが、1/86、2/43、4/43などの他の高効率構成でもすべて0.6ミリ秒未満でした。 32/172 や 32/86 などの高スループット構成では、レイテンシが 2.79 ミリ秒から 5.87 ミリ秒にわずかに上昇しましたが、持続的な書き込み飽和レベルを考慮すると許容範囲内にとどまりました。
Graid SupremeRAID AE GPU オーバーヘッドの測定
Graid の SupremeRAID AE ストレージ パフォーマンス メトリクスを調査する際には、GPU リソースを共有する SupremeRAID が、同じ GPU を利用するワークロードにどのような影響を与えるかを考慮することが重要です。これまでの SupremeRAID の導入では、システム内の GPU は Graid 専用でした。このソリューションでは、Graid がリソースを活用して共有できる GPU がすでに含まれているプラットフォームに導入します。オーバーヘッドの影響を測定するために、vLLM を使用して LLM 推論シナリオを構築しました。Graid がアイドル状態のワークロードのベースライン パフォーマンスを測定し、次に Graid が RAID 172 プール全体で 5 GB を読み取る状態で再度測定しました。これは推論ワークロードをシミュレートし、100 つのワークロードの実行中に次のワークロードを事前に割り当てます。vLLM によって GPU の使用率が XNUMX% に達すると、Graid の操作はトークン レートとレイテンシに影響します。
AIワークロードでは、Llama 3.3 70Bモデルをフル精度(BF16)、16K KVキャッシュサイズでvLLMによる推論を実行しました。これにより、両カードのVRAM(78Gカードでは80G、86Gカードでは94G)がほぼ完全に使用されました。次に、vLLMのベンチマークスクリプトを最大出力長256トークンで実行しました。各テストでは、現実的なリクエストパターンをシミュレートするために、連続バッチ処理を利用して、最大256リクエストの同時実行で32クエリを実行しました。収集したメトリクスは、Tok/s、最初のトークンまでの時間(TTFT)、出力トークンあたりの時間(TPOT)、およびトークン間レイテンシ(ITL)です。推論テスト中に開始したFIOワークロードは、それぞれ172GBを読み取る16の1Kランダム読み取りジョブで構成されていました。
スループットは全体的にわずかに低下しました。リクエストスループットは1.86秒あたり1.78リクエストから4.3リクエストに低下し、225.44%の減少となりました。出力トークンスループットは215.94秒あたり4.2トークンから2029.77トークンに低下し、1944.30%の減少となりました。総トークンスループットは4.2秒あたりXNUMXトークンからXNUMXトークンに低下し、同様にXNUMX%の減少となりました。これは、転送によってオーバーヘッドが発生し、パフォーマンスに若干の影響が及んだことを示しています。
レイテンシ指標では、さまざまな結果が示されました。平均 TTFT は 3.6 ミリ秒から 6,704 ミリ秒へと 6,945% 増加しましたが、中央値の TTFT は 1.5% 増加しました。興味深いことに、P99 TTFT は改善し、2.8 ミリ秒から 14,199 ミリ秒へと 13,803% 減少しました。これは、この指標でのテールエンドのパフォーマンスが向上したことを示しています。TPOT については、平均値が 5.3% 増加しましたが、中央値は 0.65% の増加で比較的横ばいでした。ただし、P99 TPOT は 24.6 ミリ秒から 127.69 ミリ秒へと 159.15% も急上昇し、最悪の場合のトークン生成時間が大幅に影響を受けたことを示しています。トークン間レイテンシ (ITL) も同様の傾向を示し、平均値は 5.1% 増加し、中央値はほぼ変化せず、P99 は 2.2% 増加しました。
GraidのSupremeRAID AEをvLLMワークロードと並行して実行したところ、スループットがわずかに(約4%)低下し、平均レイテンシが中程度に増加し、トークン生成におけるP99パフォーマンスが顕著に低下しました。これらの影響にもかかわらず、システムは完全に安定し、応答性も良好でした。これは、Llama 3.3 70Bなどの大規模モデルを用いた高並列推論が、Graid SupremeRAID AEと並行して信頼性の高いパフォーマンスを発揮できることを実証しています。
| メトリック(持続時間が短い / トーク/秒数が高いほど良い) | ベースライン | 172GB FIO読み取り操作 |
| 成功したリクエスト | 256 | 256 |
| ベンチマーク期間(秒) | 137.68 | 143.73 |
| 入力トークンの合計 | 248,414 | 248,414 |
| 生成されたトークンの合計 | 31,037 | 31,037 |
| リクエストスループット(リクエスト/秒) | 1.86 | 1.78 |
| 出力トークンスループット(tok/s) | 225.44 | 215.94 |
| 総トークンスループット(tok/s) | 2029.77 | 1944.30 |
| 最初のトークン発行までの時間 (TTFT) (レイテンシが低いほど良い) | ||
| 平均TTFT(ミリ秒) | 6,704.43 | 6,945.72 |
| TTFTの中央値(ミリ秒) | 6,469.88 | 6,569.80 |
| P99 TTFT(ミリ秒) | 14,199.21 | 13,803.62 |
| 出力トークンあたりの時間(TPOT、最初のトークンを除く)(レイテンシが低いほど良い) | ||
| 平均TPOT(ミリ秒) | 81.44 | 85.72 |
| TPOTの中央値(ミリ秒) | 80.38 | 80.90 |
| P99 TPOT(ミリ秒) | 127.69 | 159.15 |
| トークン間レイテンシ(ITL)(レイテンシが低いほど良い) | ||
| 平均ITL(ミリ秒) | 79.94 | 83.99 |
| 中央値ITL(ミリ秒) | 49.75 | 49.78 |
| P99 ITL(ミリ秒) | 539.07 | 550.73 |
閉じた思考
Graid SupremeRAID AEは、AIインフラストラクチャを構築または拡張する組織に、実用的で効果の高いソリューションを提供します。従来のハードウェアRAIDをGPU駆動型のソフトウェア定義アプローチに置き換えることで、SupremeRAID AEは導入を簡素化するとともに、現代のAIワークフローを停滞させる一般的なボトルネックを解消します。
当社のテストでは、最大32台のNVMe SSDを単一の耐障害性名前空間に統合し、1台のサーバーで約183PBの容量を卓越したパフォーマンスで実現できることが実証されました。54GB/秒の読み取りスループットとXNUMXGB/秒の書き込みスループットというピーク時の結果は、ライブ推論中の最小限のGPUオーバーヘッドと相まって、大規模なモデルチェックポイントと低レイテンシ推論というXNUMXつの要求を大規模に満たす能力を実証しています。
SupremeRAID AEは、専用RAIDハードウェアのコストと複雑さを排除し、NVIDIA GPUDirect StorageやAIに特化したファイルシステムなどのテクノロジーとシームレスに統合することで、将来を見据えたストレージ基盤を構築します。推論の効率化と運用リスクの軽減に重点を置く組織にとって、SupremeRAID AEは、実稼働AI環境に必要なパフォーマンス、シンプルさ、そして耐障害性を提供します。


 Amazon