

L40S заполняет критически важный пробел в экосистеме графических процессоров для центров обработки данных. В то время как ориентированные на вычисления графические процессоры для обучения ИИ, такие как Nvidia H100, отдают приоритет высокой производительности, полностью игнорируя графическое ускорение, традиционным профессиональным картам визуализации, как правило, не хватает вычислительных возможностей ИИ, необходимых для современных задач вывода и новых графических приложений, основанных на ИИ. Это делает его особенно ценным для генерации синтетических данных, разработки многомодального ИИ и приложений Omniverse, где важны как вычислительная, так и графическая производительность.
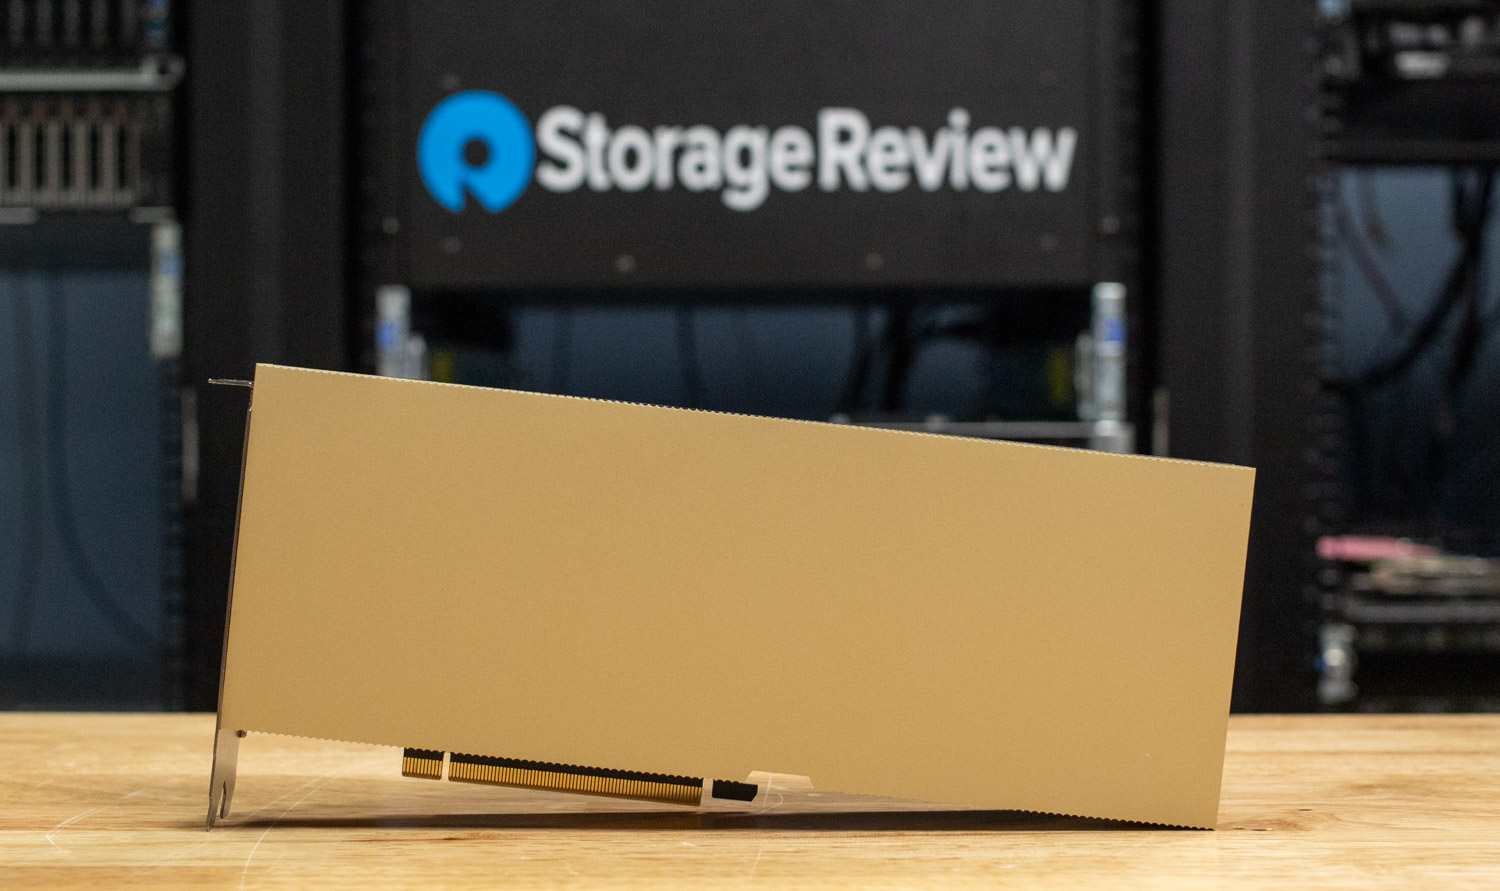
Технические характеристики NVIDIA L40S
| Параметр | L40 | L40S | H100 80G PCIe |
| Архитектура графического процессора | Ада Лавлейс | Ада Лавлейс | хоппер |
| Графический процессор Die | AD102 | AD102 | GH100 |
| CUDA Cores | 18,176 | 18,176 | 14,592 |
| Тензорные сердечники | 568 (4-е поколение) | 568 (4-е поколение) | 456 |
| RT Cores | 142 (3-е поколение) | 142 (3-е поколение) | – |
| Память графического процессора | 48 ГБ GDDR6 с ECC | 48 ГБ GDDR6 с ECC | 80 ГБ HBM2e |
| Пропускная способность памяти | 864 Гб / с | 864 Гб / с | 2 TB / s |
| Интерфейс памяти | 384-бит | 384-бит | 5120-бит |
| Максимальная потребляемая мощность | 300 Вт | 350 Вт | 350 Вт |
| Форм-фактор | 4.4″ В x 10.5″ Д: Двойной слот | 4.4″ В x 10.5″ Д: Двойной слот | 4.4″ В x 10.5″ Д: Двойной слот |
| Тепловое решение | Пассивный | Пассивный | Пассивный |
| Разъемы дисплея | 4 порта DisplayPort 1.4a | 4 порта DisplayPort 1.4a | – |
| Интерфейс PCIe | Ген4 x16 | Ген4 x16 | Ген5 x16 |
| разъем питания | 16-контактный | 16-контактный | 16-контактный |
| Поддержка виртуальных графических процессоров | Да | Да | Нет |
| Многоэкземплярный графический процессор (MiG) | Нет | Нет | Да |
| Поддержка NVLink | Нет | Нет | Нет |
Эксплуатационные характеристики
| Метрика | Производительность L40 | L40S Performance | H100 Производительность |
| FP32 Производительность | 90.5 TFLOPS | 91.6 TFLOPS | 51.2 TFLOPS |
| Тензорное ядро TF32 | 362.1 TFLOPS | 366 TFLOPS | 756 TFLOPS |
| Тензорное ядро FP16 | 724 TFLOPS | 733 TFLOPS | 1513 TFLOPS |
| Тензорное ядро FP8 | 1,448 TFLOPS | 1,466 TFLOPS | 3026 TFLOPS |
| Peak INT8 Tensor TOPS | 1,448 TFLOPS | 1,466 TFLOPS | 3026 TOPS |
| RT Core Производительность | 209 TFLOPS | 212 TFLOPS | – |
(Данные о производительности приводятся с учетом разреженности данных)
NVIDIA L40S против H100
Детальный анализ технических характеристик раскрывает различные концепции проектирования NVIDIA L40S и H100. L40S построена на архитектуре Ады Лавлейс, используя тот же кристалл AD102, что и в высокопроизводительных графических картах NVIDIA для рабочих станций. Это наследие обеспечивает ей огромное количество ядер CUDA — 18 176, что приводит к высокой производительности в вычислениях с одинарной точностью (FP32), являющихся краеугольным камнем традиционного графического рендеринга и научных вычислений. В отличие от этого, архитектура Hopper и кристалл GH100 в H100 разработаны в первую очередь для задач искусственного интеллекта и высокопроизводительных вычислений.
Наиболее показательным отличием является конфигурация ядра. L40S включает 142 ядра RT третьего поколения и 568 ядер Tensor четвертого поколения. Ядра RT — это специализированное оборудование для ускорения трассировки лучей, функция, полностью отсутствующая в H100, что делает L40S уникально способным к фотореалистичному рендерингу. Хотя H100 имеет меньше ядер Tensor, они быстрее и совершеннее, оптимизированы для новых форматов данных ИИ, таких как FP8, что обеспечивает ему значительное преимущество в производительности ИИ.
Этот компромисс также очевиден в подсистемах памяти. H100 использует 80 ГБ дорогостоящей памяти HBM2e, обеспечивая впечатляющую пропускную способность в 2 ТБ/с. Это необходимо для обеспечения работы SM-ов во время обучения и вывода крупномасштабных моделей ИИ. L40S использует более традиционную 48 ГБ памяти GDDR6, обеспечивая пропускную способность 864 ГБ/с. Хотя это менее половины объема памяти H100, этого все еще достаточно для загрузки больших 3D-сцен, текстур высокого разрешения и крупных моделей ИИ для вывода.
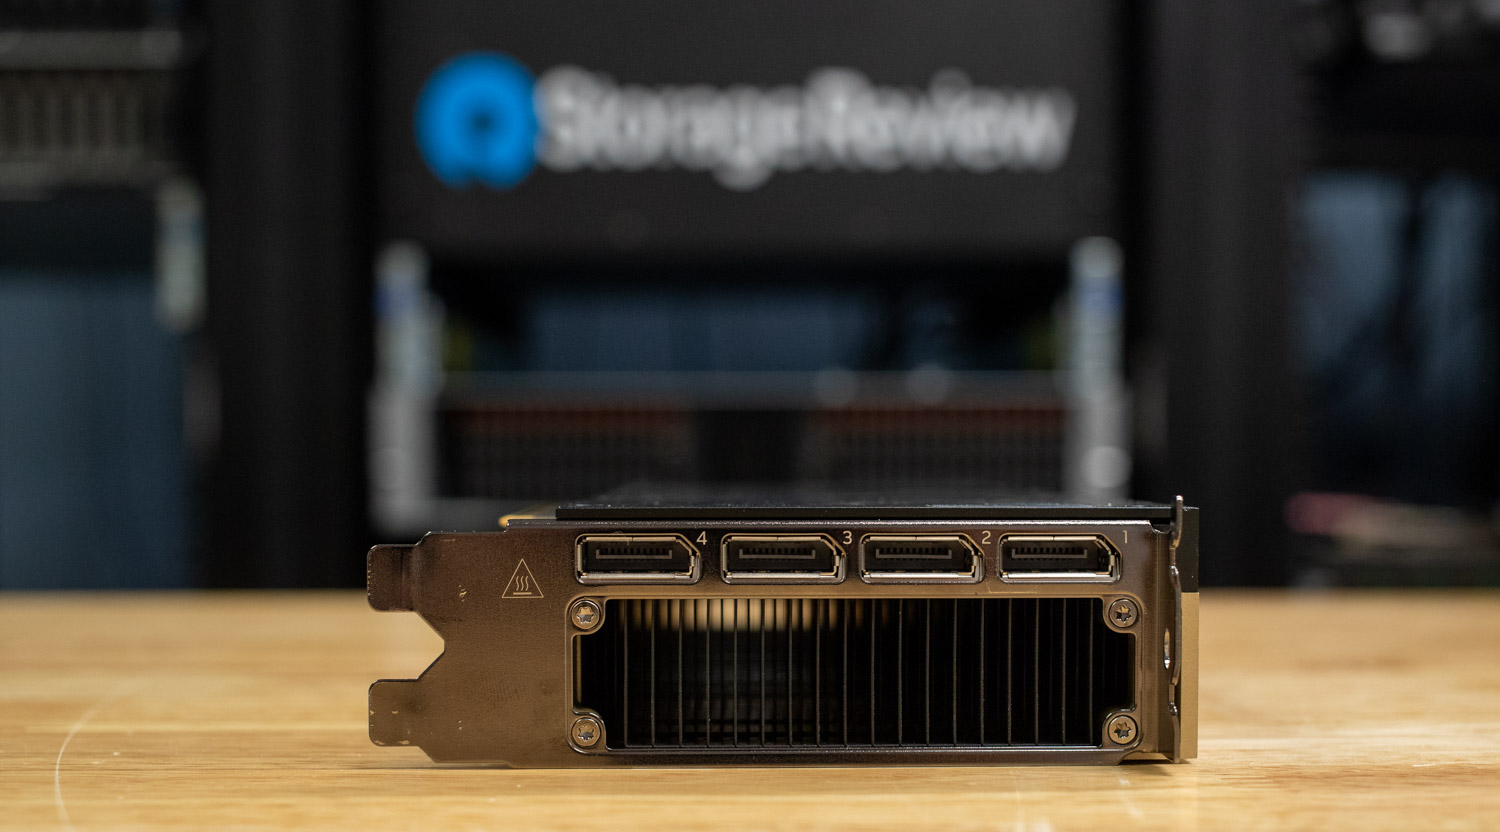
Наконец, в описании функций указаны их предполагаемые роли. L40S включает четыре выхода DisplayPort 1.4a и мощную поддержку vGPU, что делает его идеальным для виртуализированных рабочих станций, рендер-ферм и развертывания облачных игр. H100, не имеющий видеовыходов или возможностей vGPU, вместо этого предлагает технологию Multi-Instance GPU (MiG), которая позволяет разделить его на несколько меньших, изолированных экземпляров GPU для одновременного выполнения нескольких ресурсоемких вычислительных задач. Общая двухслотовая пассивная система охлаждения и потребляемая мощность 350 Вт L40S и PCIe H100 обеспечивают гибкость развертывания в широком диапазоне стандартных серверов.
При сравнении L40S с флагманской видеокартой NVIDIA H100 становятся очевидны различия в их предназначении. H100 является бесспорным лидером по производительности обучения ИИ среди видеокарт этого поколения, но это сравнение отражает лишь часть картины. Стоит отметить, что L40 также входит в линейку NVIDIA, имея более низкое значение TDP — 300 Вт по сравнению с 350 Вт у L40S, предлагая аналогичные возможности при сниженном энергопотреблении.
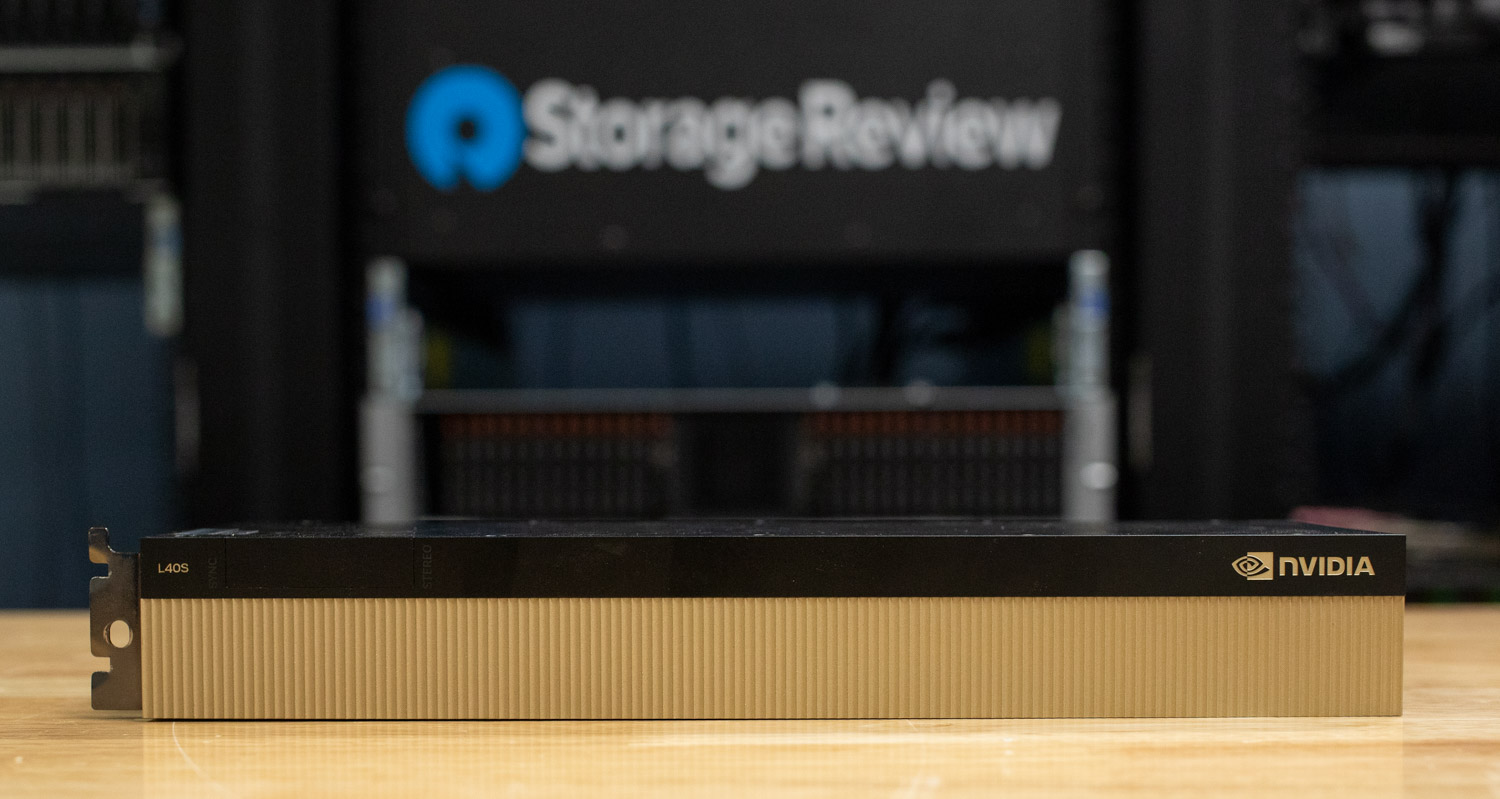
Рассматриваемая нами модель H100 — это оригинальная версия с 80 ГБ памяти PCIe и HBM2e. С тех пор NVIDIA расширила эту линейку вариантами, такими как H100 NVL, которая заменяет оригинальную модель с 80 ГБ памяти PCIe, предлагая 94 ГБ памяти и более высокое энергопотребление (TDP) — 400 Вт, а также поддержку NVLink для конфигураций с двумя видеокартами. Семейство H100 также включает конфигурации с 8 видеокартами в форм-факторе SXM и более новую модель H200, которая использует тот же графический процессор, но обеспечивает повышенную производительность как в форм-факторе PCIe, так и в форм-факторе SXM.
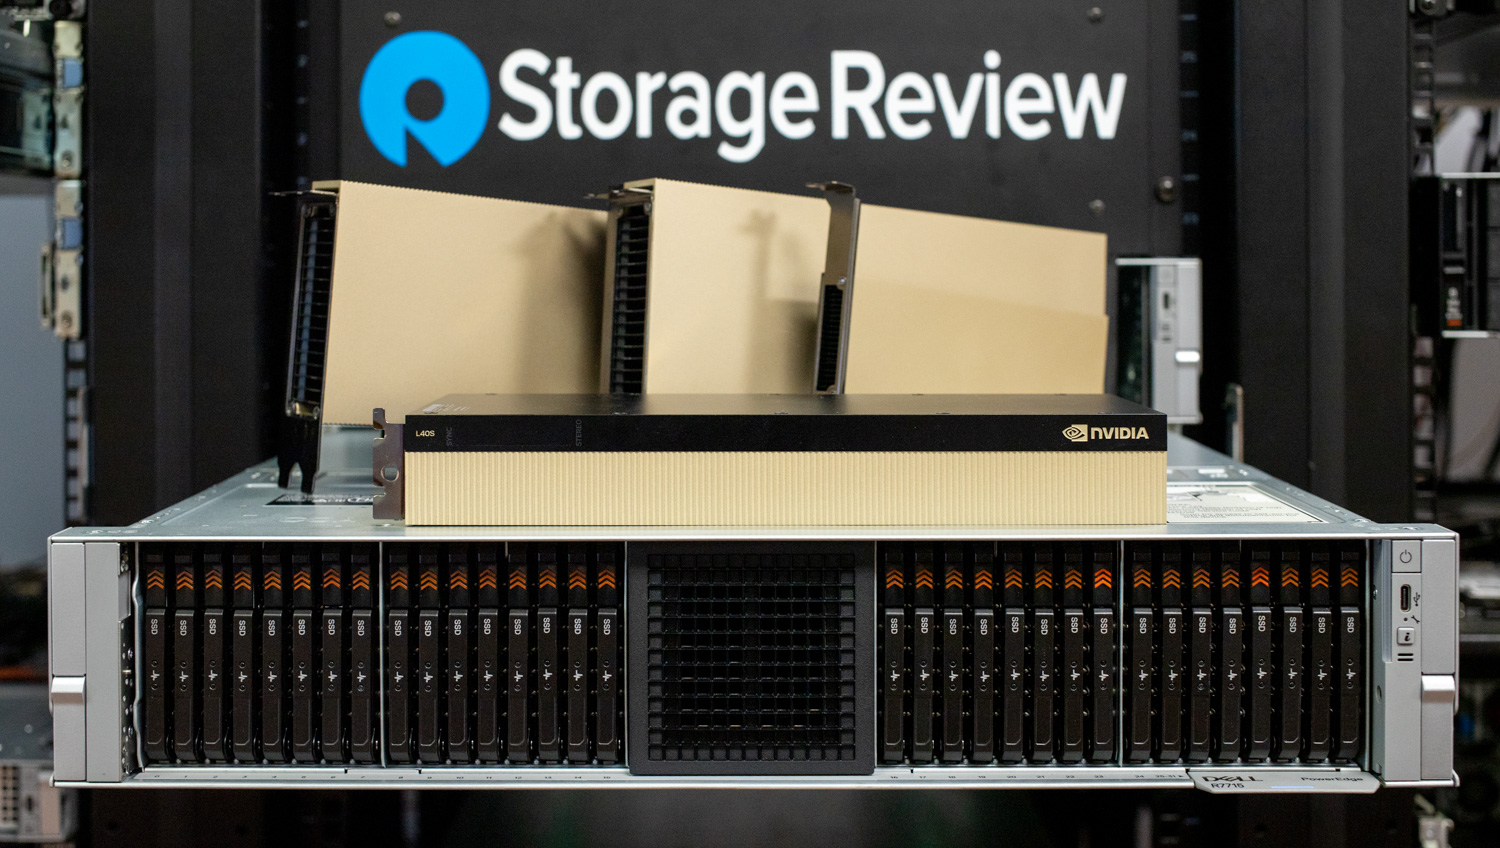
Различие между L40S и H100 подчеркивает стратегическое расхождение в проектировании графических процессоров для центров обработки данных. H100 — это карта, ориентированная исключительно на вычисления, оптимизированная для задач искусственного интеллекта и высокопроизводительных вычислений. Цель — крупномасштабное обучение ИИ, где основной задачей является максимальная вычислительная пропускная способность. Каждый аспект ее конструкции, от огромной пропускной способности памяти HBM2e до специализированных тензорных ядер, разработан для самых требовательных сценариев обучения нейронных сетей.
В отличие от них, L40S — это универсальный графический процессор, разработанный для многоцелевого использования, ориентированный на выполнение задач искусственного интеллекта, а также на ресурсоемкие графические нагрузки и развертывание виртуальных графических процессоров NVIDIA. Хотя он является компетентным и экономически эффективным решением для выполнения задач ИИ, его истинная сила заключается в поддержке широкого спектра ресурсоемких графических приложений, для которых H100 просто не предназначен.
ресурсоемкие графические задачи и профессиональные приложения
Графический процессор L40S превосходно справляется со многими задачами, требующими интенсивной обработки графики, как вычислительной мощности, так и передовых возможностей рендеринга. В 3D-рендеринге и анимации студии полагаются на L40S для рендеринга сложных сцен, где его ядра RT ускоряют вычисления трассировки лучей, которые были бы невозможны на графических процессорах, предназначенных только для вычислений. Кино- и телекомпании используют эти возможности для предварительной визуализации в реальном времени, позволяя режиссерам и операторам видеть фотореалистичные рендеры CGI-сцен во время съемок, что значительно сокращает время и затраты на постпродакшн.
Архитектурные и инженерные фирмы используют L40S для визуализации архитектуры в реальном времени и проектирования продукции, позволяя клиентам виртуально просматривать фотореалистичные изображения зданий или изучать детальные прототипы продукции до начала физического строительства. Профессиональные графические возможности карты также делают ее идеальной для рабочих станций САПР, где инженерам необходима как вычислительная мощность для сложных симуляций, так и графическое ускорение для плавной и высококачественной работы в окне просмотра.
В сфере медиа и развлечений L40S используется в рендер-фермах, обрабатывающих кадры анимации финального качества. В то же время, его возможности vGPU позволяют создавать рабочие процессы на основе облачных вычислений, где художники могут удаленно получать доступ к мощным графическим рабочим станциям. В студиях видеомонтажа и постпродакшена L40S применяется для обработки эффектов в реальном времени, цветокоррекции и композитинга, требующих как графического ускорения, так и значительных вычислительных ресурсов.
Рынок инфраструктуры виртуальных рабочих столов (VDI) представляет собой еще одну ключевую область применения, где технология vGPU в L40S позволяет нескольким пользователям совместно использовать ресурсы графического процессора для ускорения графики на виртуальных рабочих столах. Это делает профессиональные графические возможности доступными в корпоративных средах без необходимости выделения отдельных графических процессоров каждому пользователю.
Эволюция в сторону обучения искусственного интеллекта на основе физических принципов
Что еще более важно, L40S обладает возможностями, которых полностью нет у H100. Ключевое отличие заключается в 142 ядрах RT третьего поколения, которые обеспечивают трассировку лучей в реальном времени и фотореалистичный рендеринг. В то время как H100 не имеет ядер RT и не может выполнять графическое ускорение, ядра RT в L40S делают его очевидным выбором для приложений, требующих как вычислений с использованием ИИ, так и продвинутой графики.
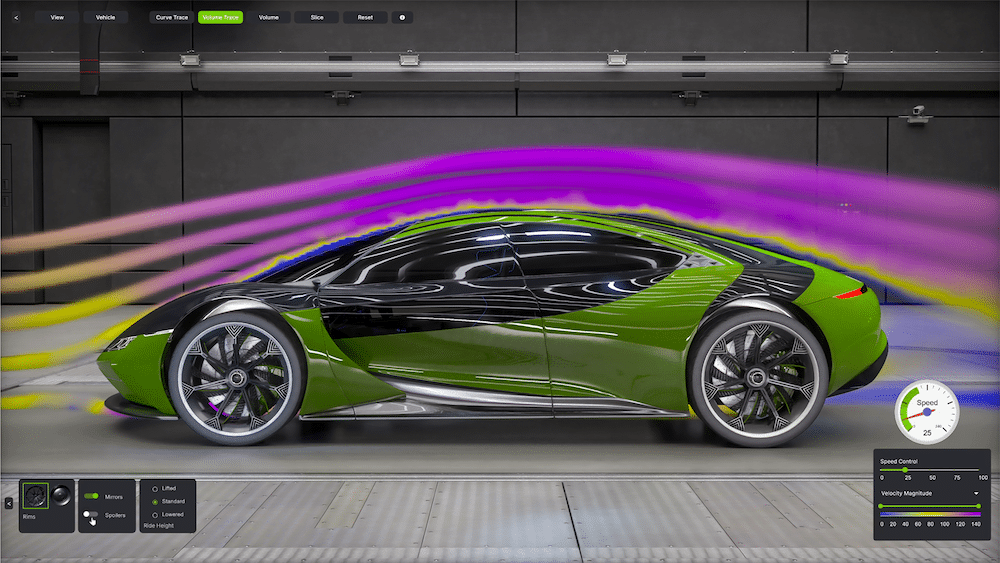
Источник: Нвидия
Это различие становится все более важным по мере роста популярности 3D-моделирования, создаваемого искусственным интеллектом, моделирования цифровых двойников и рабочих процессов Universal Scene Description (OpenUSD). Следующий рубеж в области искусственного интеллекта — это не просто обучение больших языковых моделей; это разработка моделей мира, которые понимают физику, пространственные отношения и реальные взаимодействия. Эта эволюция требует фундаментального изменения подхода к генерации обучающих данных.
В то время как обучение традиционных моделей ИИ в значительной степени опирается на флагманские вычислительные графические процессоры NVIDIA, обучение следующего поколения моделей физически обоснованного мира требует иного подхода. Этим продвинутым системам ИИ необходимы огромные объемы обучающих данных, которые охватывают не только визуальную информацию, но и физические свойства, поведение освещения, взаимодействие материалов и пространственные отношения. Графические процессоры, такие как L40S, становятся незаменимыми для генерации больших объемов обучающих данных, где их ядра реального времени позволяют создавать физически точные синтетические среды, которые служат основой для обучения более сложных моделей ИИ.
Именно эта возможность продвинутой графической отрисовки, обеспечиваемая выделенными ядрами RT, делает L40S идеальным графическим процессором для платформы NVIDIA Omniverse и более широкой экосистемы разработки искусственного интеллекта на основе физических моделей.
Omniverse
Omniverse — это платформа разработки, включающая API, SDK и сервисы, которая позволяет разработчикам создавать приложения и рабочие процессы на основе Universal Scene Description (OpenUSD). Она предназначена для создания и соединения физически точных виртуальных 3D-миров в реальном времени. Это достигается за счет интеграции технологии NVIDIA RTX для фотореалистичного рендеринга с трассировкой лучей непосредственно в рабочие процессы промышленного и роботизированного моделирования. L40S с мощными ядрами RT обеспечивает необходимое аппаратное ускорение для обработки этих ресурсоемких задач рендеринга RTX, позволяя разработчикам моделировать свет, материалы и физику с потрясающей реалистичностью.
Omniverse — это не просто инструмент визуализации, а платформа для разработки следующего поколения физического ИИ. Создавая эти реалистичные виртуальные миры, или «цифровые двойники», разработчики могут моделировать сложные промышленные объекты, тестировать целые парки роботов и проверять автономные транспортные средства в безопасной виртуальной среде до их внедрения в реальном мире. Что особенно важно, эти высокоточные симуляции становятся основой для генерации огромных объемов физически обоснованных синтетических данных; это критически важный ресурс для обучения мощных моделей ИИ, работающих на графических процессорах с высокой вычислительной мощностью.
Генерация синтетических движений для робототехники
Проект NVIDIA Isaac GR00T для генерации синтетических движений при манипулировании роботами предоставляет основу для обучения робототехнике, демонстрируя, как возможности ядра RT Core L40S позволяют создавать большие наборы данных на основе минимальных демонстраций человека. Этот рабочий процесс решает одну из ключевых проблем в разработке робототехники: трудоемкий и дорогостоящий процесс сбора достаточного количества высококачественных обучающих данных для задач манипулирования роботами.
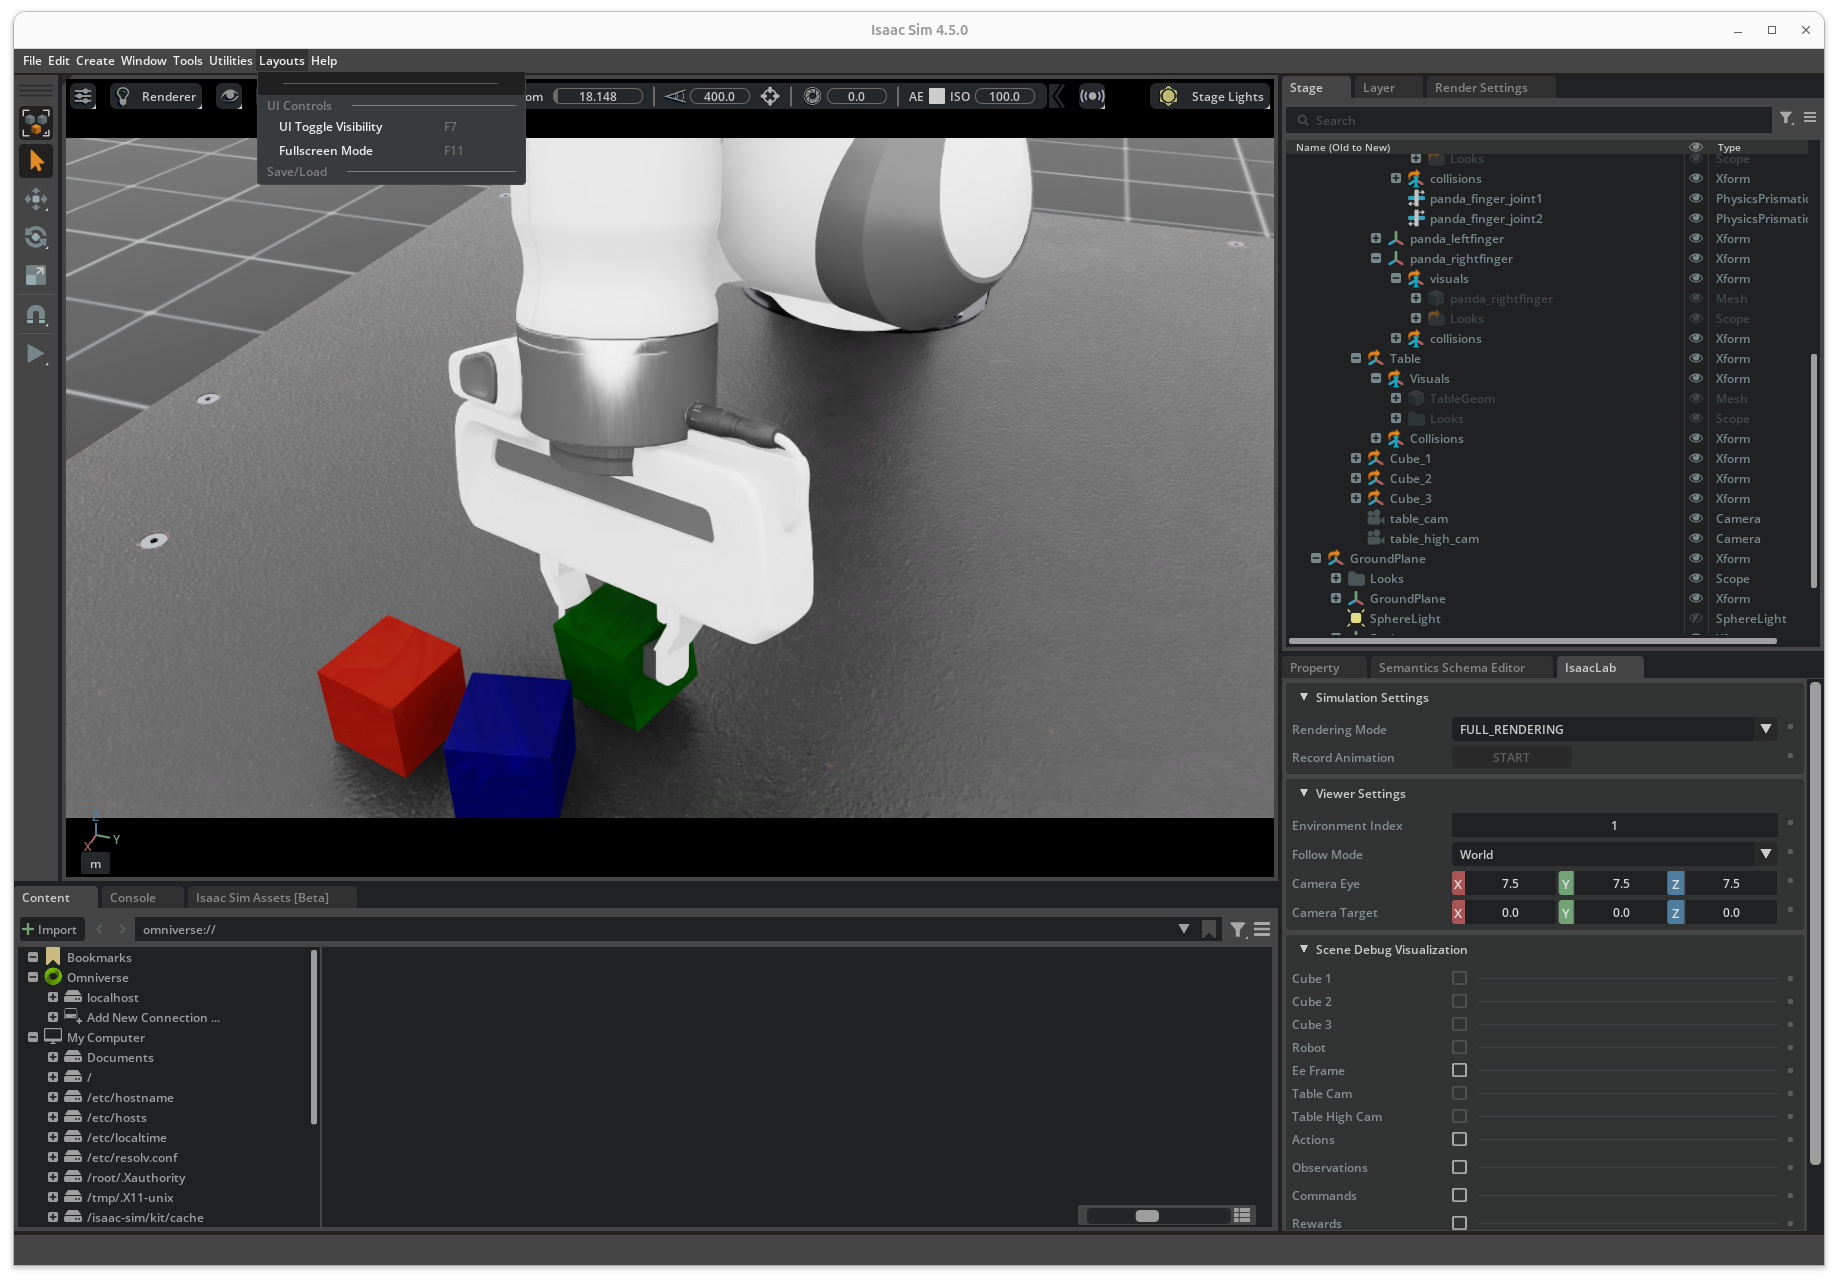
Традиционная подготовка робототехников в значительной степени опирается на контролируемое или имитационное обучение, при котором роботы приобретают новые навыки, наблюдая и имитируя демонстрации экспертов-людей. Однако создание идеальных демонстраций — сложная задача, а сбор обширных высококачественных наборов данных в реальном мире — трудоемкий, длительный и дорогостоящий процесс. Правильно обученному оператору обычно требуется около минуты, чтобы записать одну высококачественную демонстрацию, что трудно масштабировать из-за значительных усилий, необходимых от человека, и потенциальной возможности ошибок.
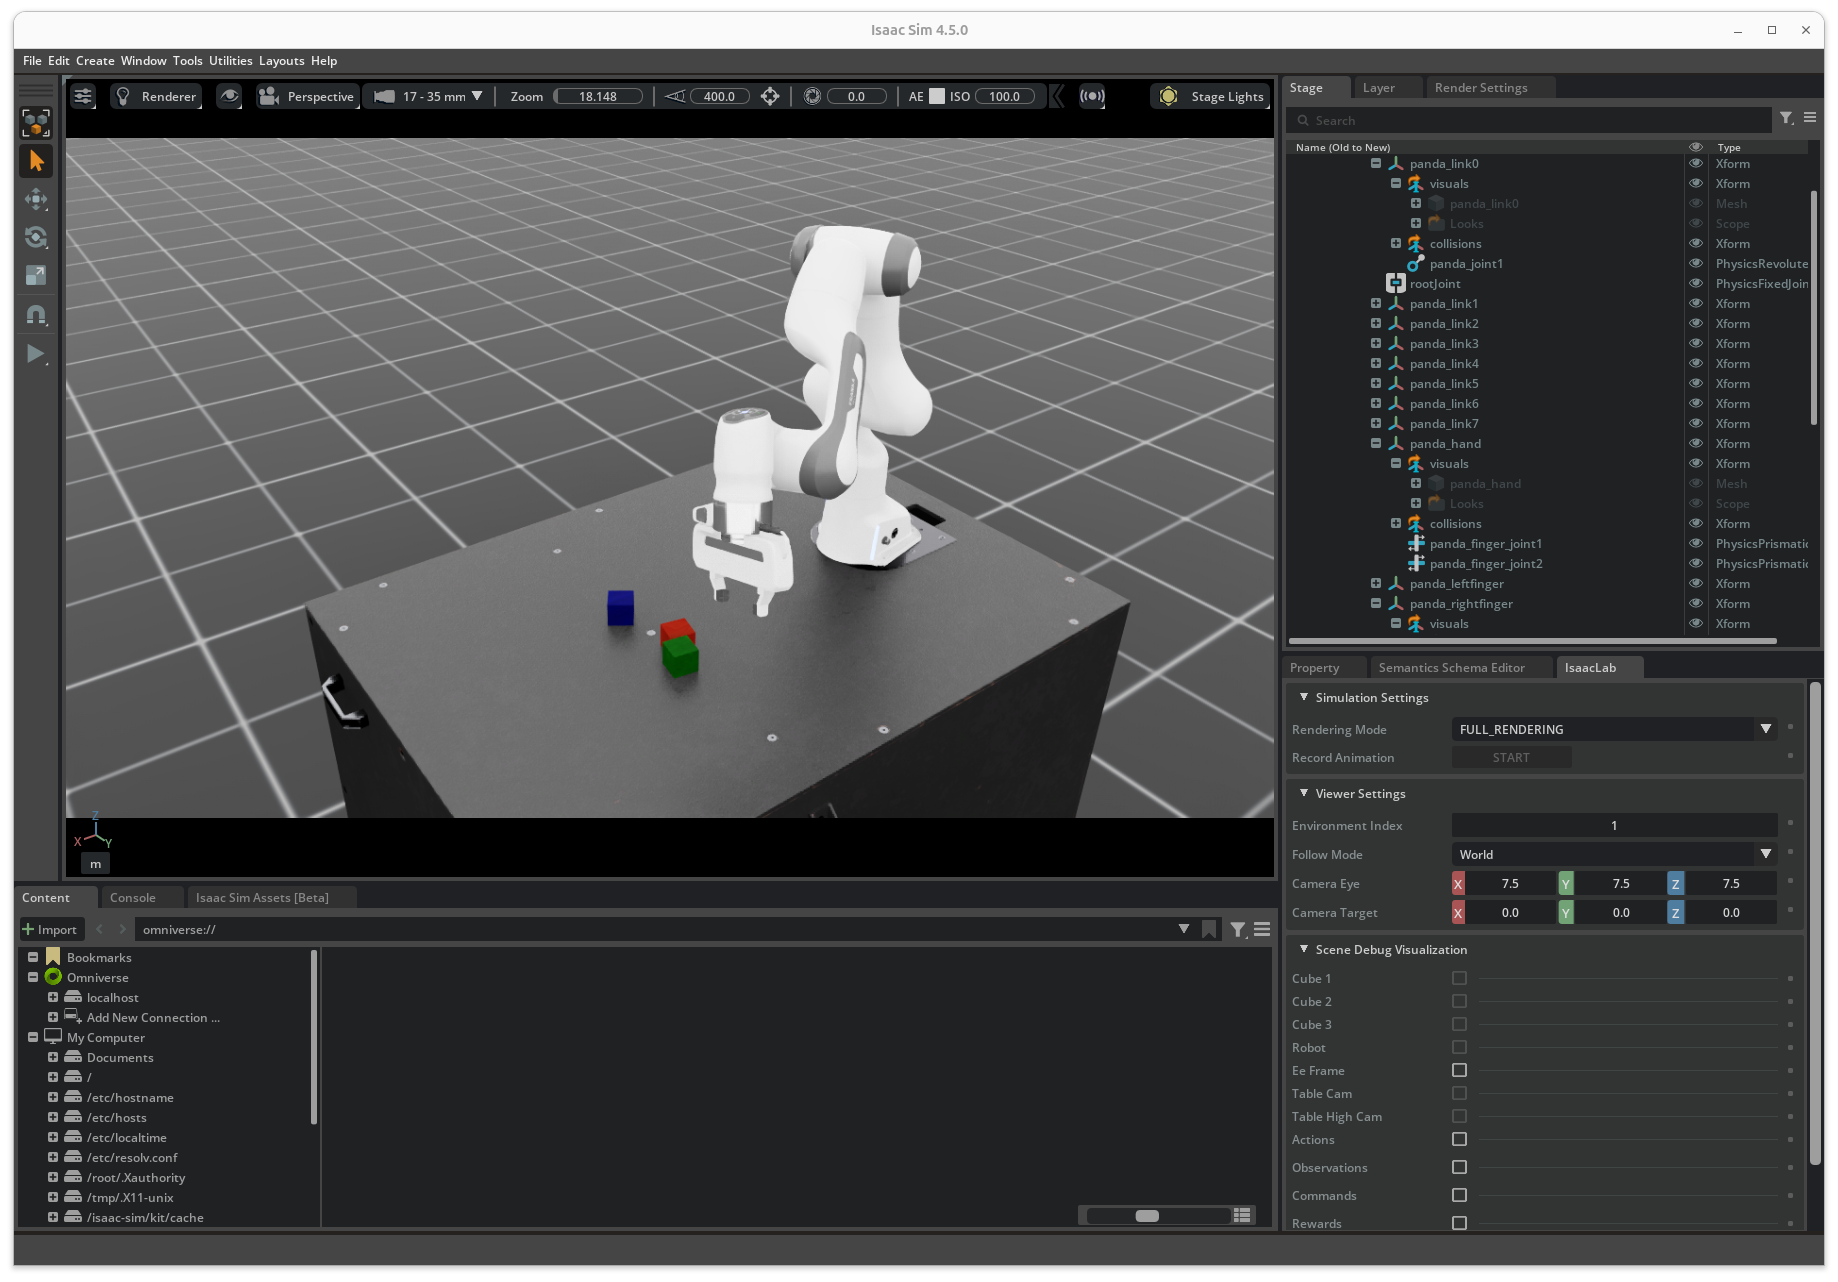
Проект Isaac GR00T решает эту проблему, используя синтетические данные, полученные в результате физически точных симуляций, для ускорения процесса сбора данных. Организации могут собрать экспоненциально больше данных всего за пару часов демонстраций с участием людей.
Проект Isaac GR00T состоит из трех ключевых компонентов, которые работают вместе, создавая комплексный конвейер генерации синтетических данных:
- GR00T-Телеоп Эта система позволяет опытным операторам управлять виртуальными роботами с помощью устройств пространственных вычислений, таких как Apple Vision Pro. Она дает возможность операторам демонстрировать сложные задачи манипулирования в фотореалистичных виртуальных средах, захватывая не только траектории движения, но и контекст окружающей среды, а также взаимодействие с объектами. Apple Vision Pro передает данные отслеживания движений рук в Isaac Lab, которая одновременно передает обратно на устройство захватывающее изображение окружающей среды робота, обеспечивая интуитивно понятное и интерактивное управление роботом.
- GR00T-Mimic Этот компонент берет записанные демонстрации и умножает их на более крупные синтетические наборы данных, используя передовые методы моделирования. Он использует записанные демонстрации в качестве входных данных для генерации дополнительных синтетических траекторий движения в Isaac Lab, поддерживая как одноручное, так и двуручное манипулирование человекоподобными роботами. Процесс включает в себя аннотирование ключевых точек в демонстрациях и использование интерполяции для обеспечения плавности и контекстной адекватности синтетических траекторий.
- GR00T-Gen Этот компонент использует платформы NVIDIA Omniverse и Cosmos для расширения синтетических наборов данных за счет 3D-масштабирования и рандомизации домена. Он добавляет дополнительное разнообразие, рандомизируя фон, освещение и другие переменные в сцене. Он улучшает сгенерированные изображения с помощью NVIDIA Cosmos Transfer, достигая фотореализма, что помогает сократить разрыв между моделированием и реальностью.
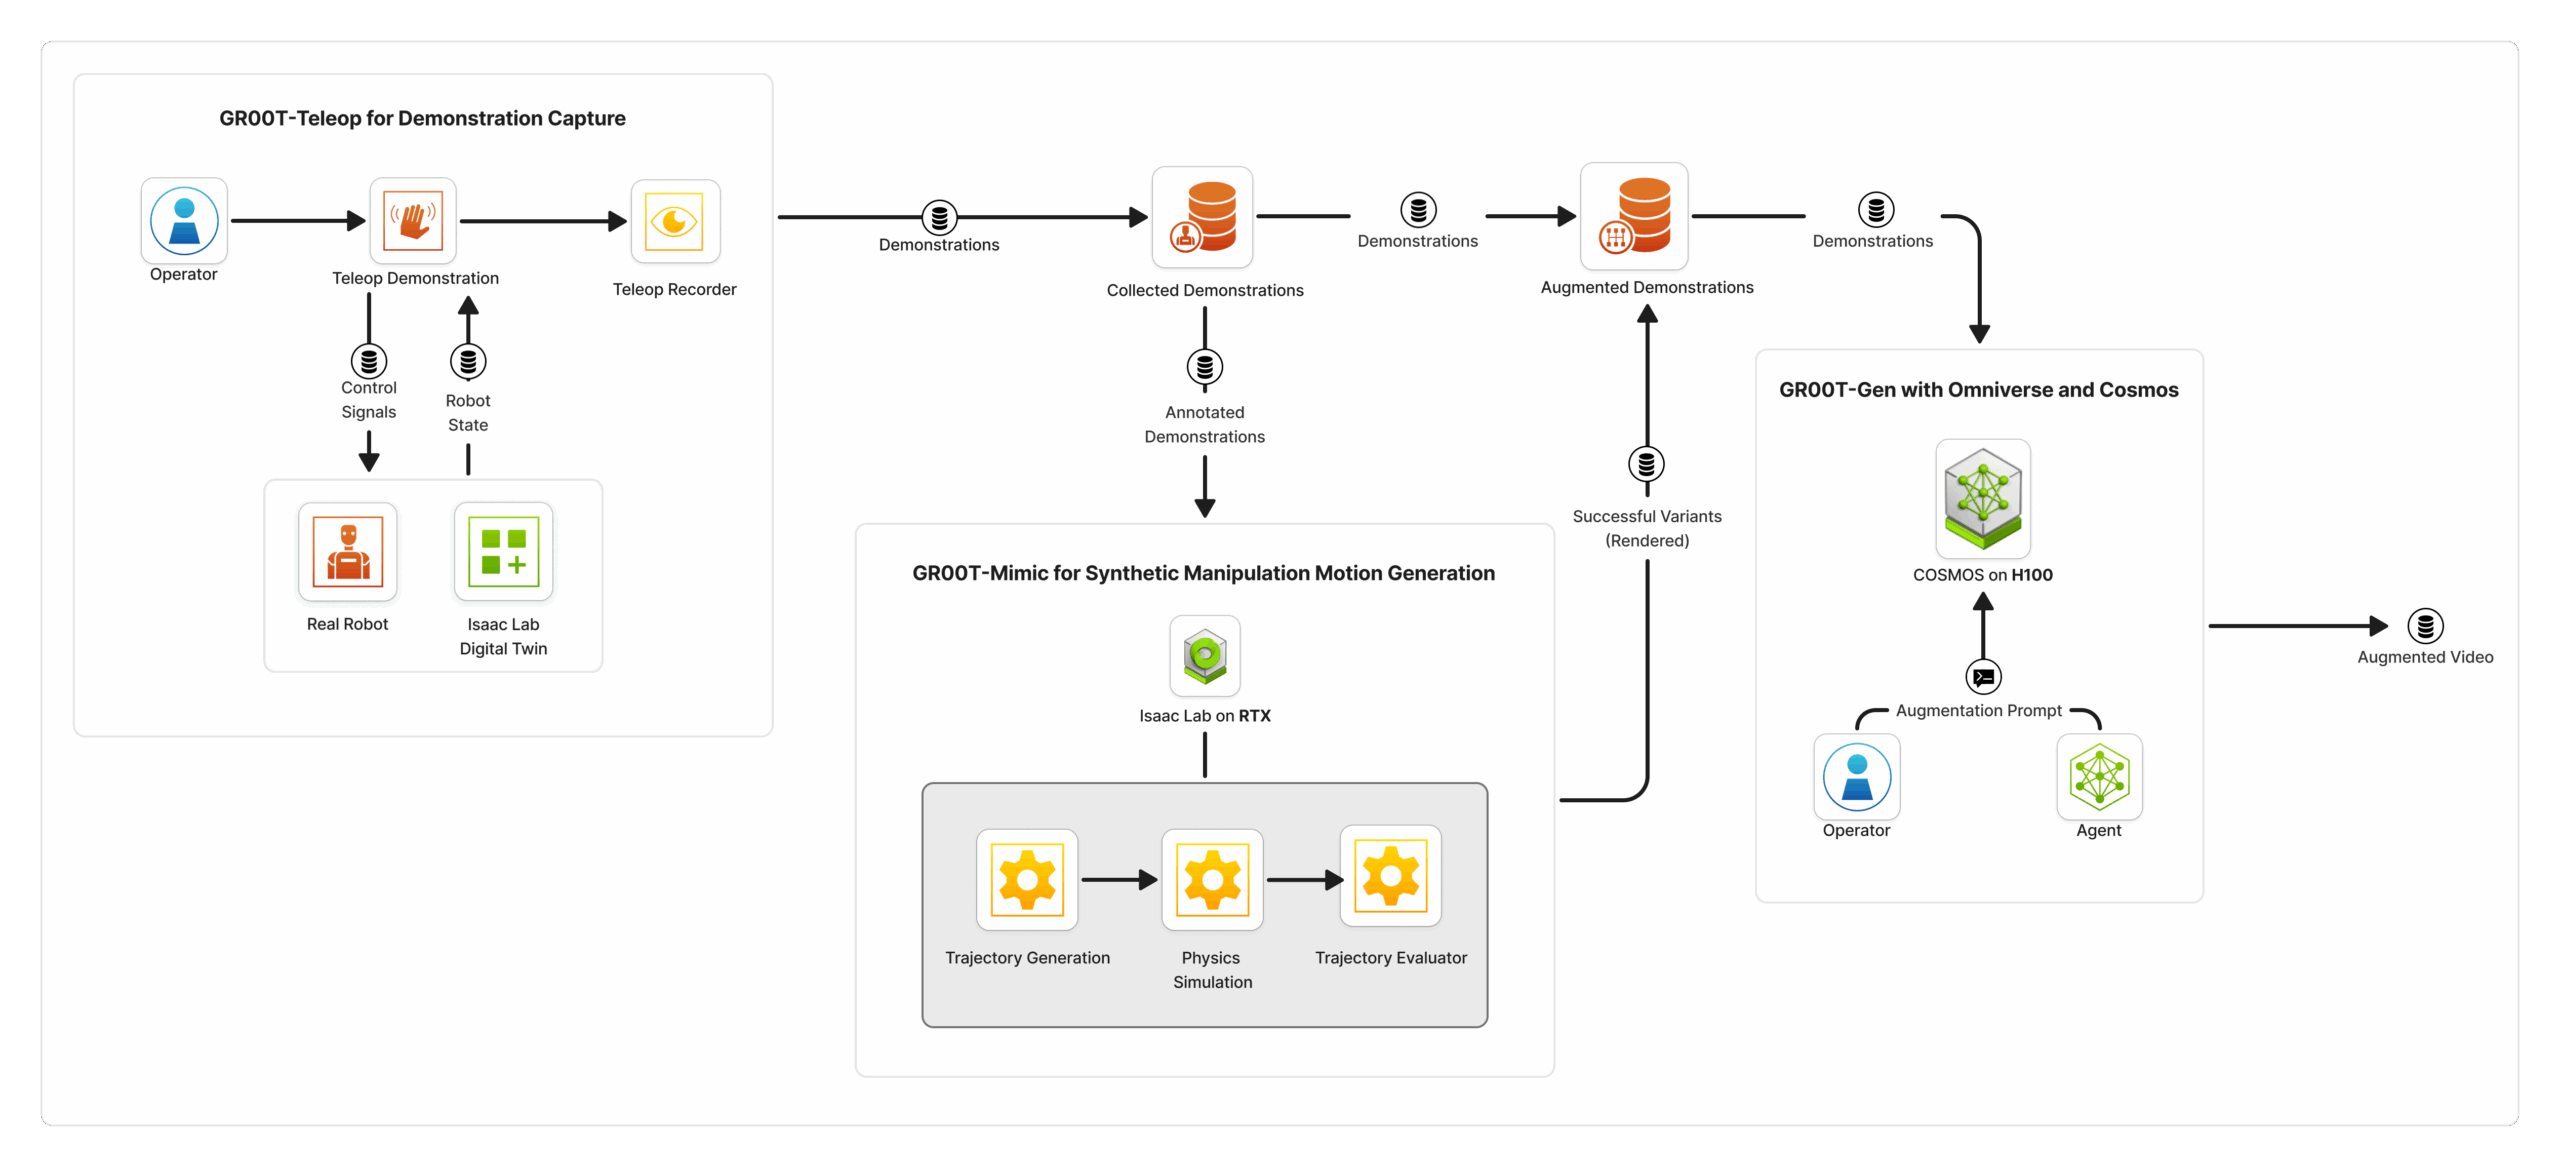
Этот конвейер прекрасно иллюстрирует специализированные, взаимодополняющие роли современных графических процессоров для центров обработки данных. L40S со своими выделенными ядрами RT выступает в роли создателя виртуального мира. Он незаменим на начальных этапах генерации данных, где обрабатывает физически корректный рендеринг, трассировку лучей в реальном времени и рандомизацию домена, необходимые для создания фотореалистичной и разнообразной виртуальной среды.
Этот высокоточный виртуальный мир затем становится холстом для следующего этапа генерации. Модели генеративного ИИ, такие как в NVIDIA Cosmos , запускаются на вычислительно-ориентированных графических процессорах, таких как H100, для получения окончательных обучающих данных. H100 использует реалистичную среду, созданную L40S, для генерации миллионов динамических, физически корректных сценариев.
Тесты производительности вывода ИИ
Еще один вариант использования, где популярны такие карты, как L40S, — это экономичное выполнение задач вывода. Чтобы оценить возможности L40S по выполнению задач вывода ИИ в реальных условиях по сравнению с H100, мы протестировали производительность LLM, используя vLLM с моделью параметров Nvidia Open Reasoning Nemotron 14B на частоте BF16 с максимальной длиной токена 32K.
Результаты сравнительного анализа vLLM
H100 демонстрирует явное лидерство по производительности, обеспечивая примерно в 4.2 раза большую пропускную способность, чем L40S. Это преимущество напрямую обусловлено удвоенной производительностью Tensor Core в H100 и более чем удвоенной пропускной способностью памяти (2 ТБ/с против 864 ГБ/с).
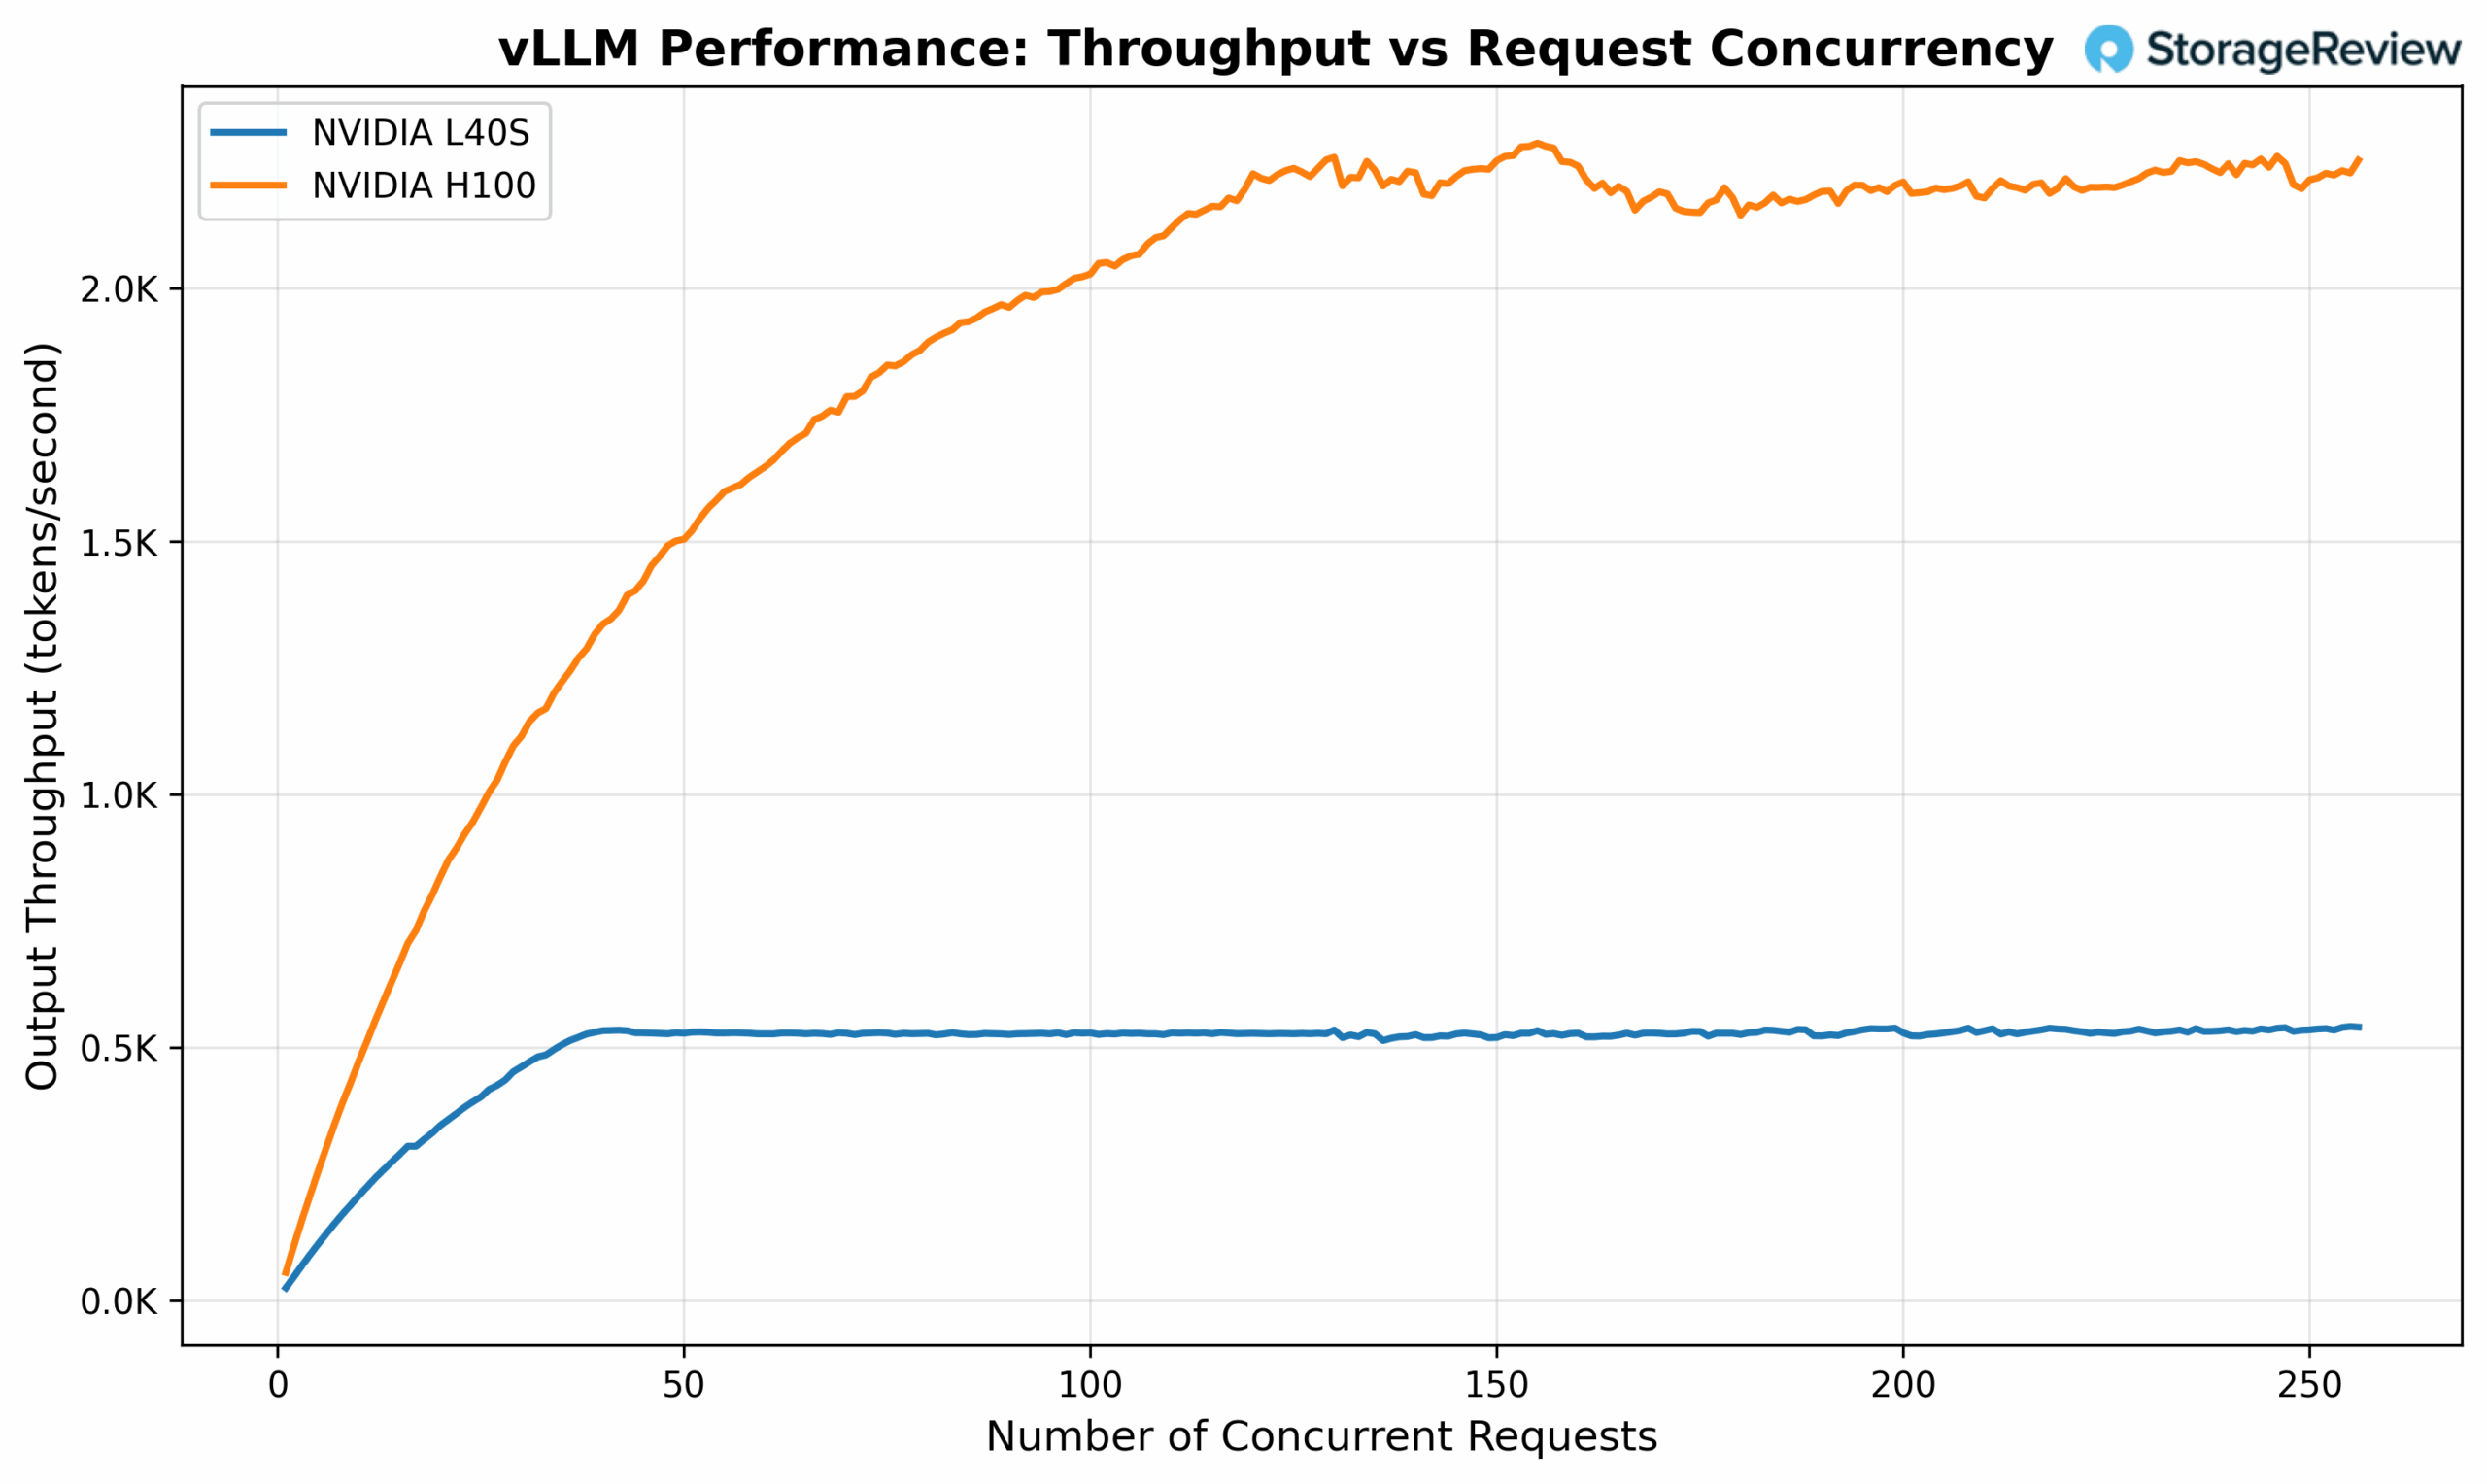
Однако соотношение производительности и цены говорит об обратном. L40S обычно стоит менее трети цены H100, что делает его более экономически выгодным для многих задач вывода данных. Организации, использующие сервисы вывода данных, где абсолютная пиковая производительность не является критически важной, часто обнаруживают, что L40S обеспечивает более низкую общую стоимость владения.
Двойным щелчком мыши по разделу с линейной производительностью мы видим, что L40S обеспечивает вполне приемлемый уровень производительности, способный обрабатывать 16 одновременных запросов с показателем TPOT (Time Per Output Token) около 52 мс.
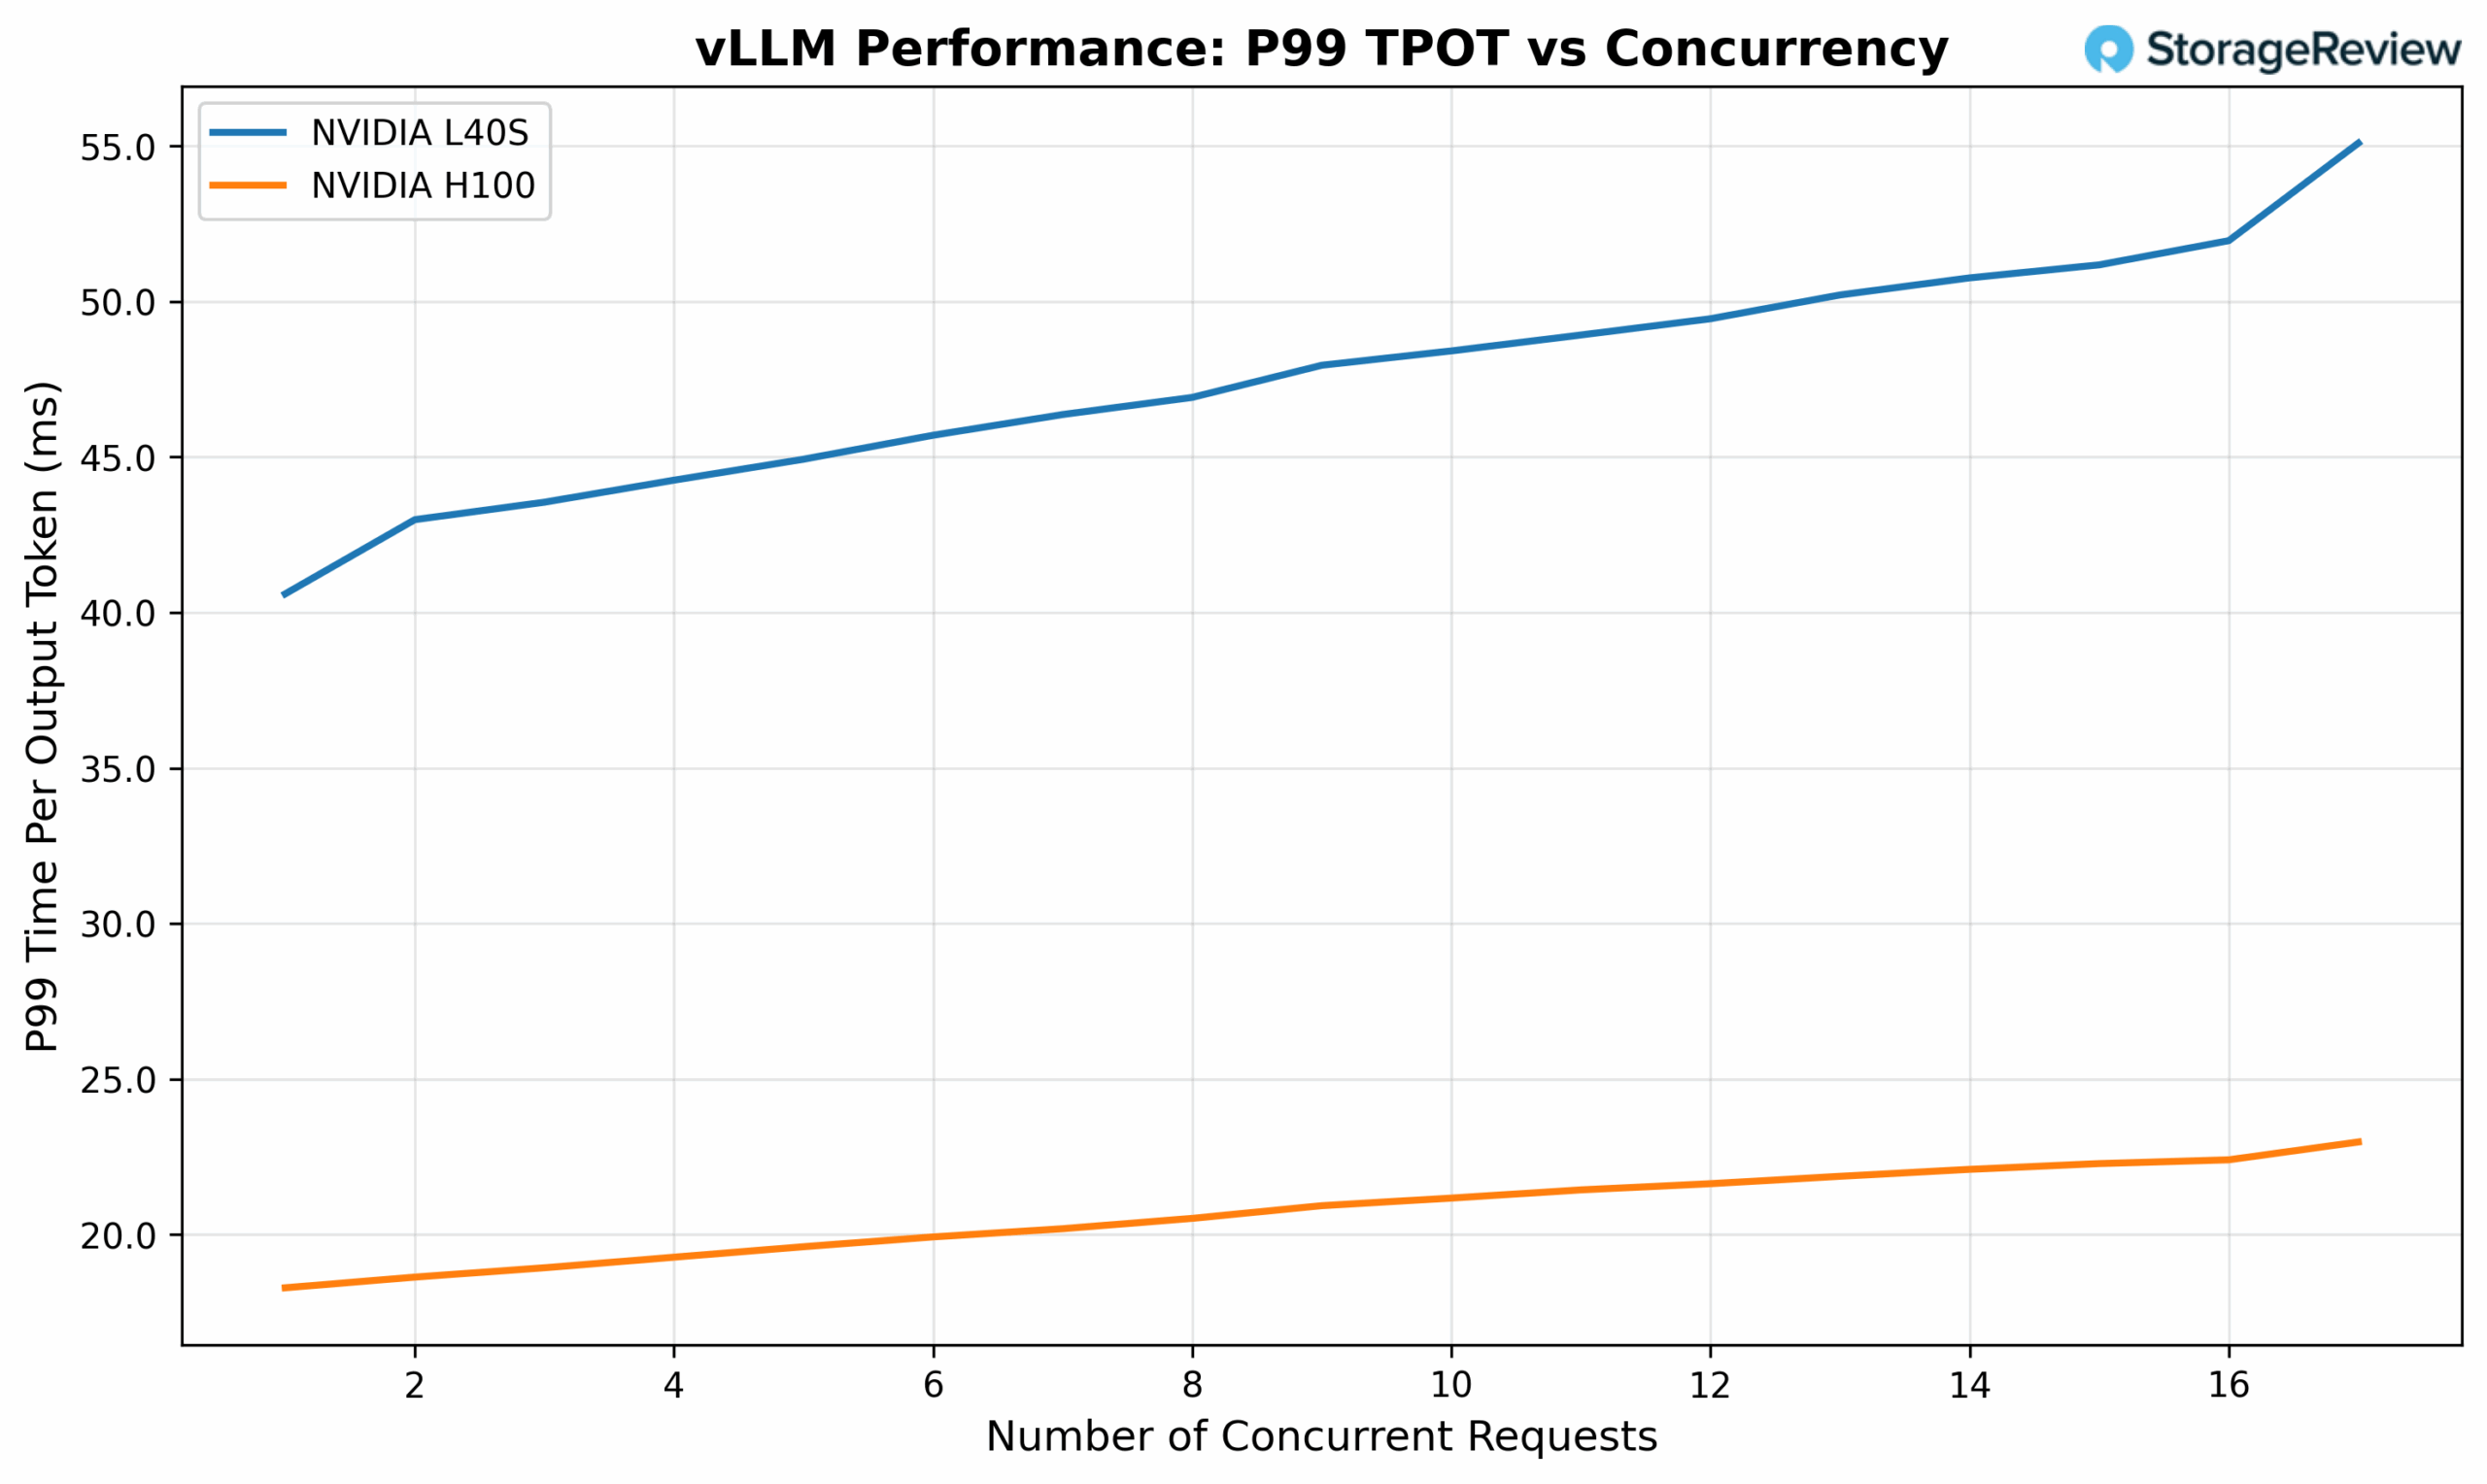
Важный фактор, который следует отметить, заключается в том, что вывод ИИ, особенно этап декодирования при генерации текста, по своей сути является операцией, требующей больших объемов памяти. Во время вывода модель должна многократно обращаться к весам, хранящимся в памяти графического процессора, для генерации каждого нового токена, что делает пропускную способность памяти критическим узким местом производительности. Эта особенность объясняет, почему H100, благодаря превосходной пропускной способности памяти и улучшенной производительности Tensor Core, естественным образом обеспечивает более высокую пропускную способность при выводе.
Однако для сценариев развертывания, требующих как обработки данных с помощью ИИ, так и графического ускорения, таких как рендеринг в реальном времени с эффектами, улучшенными с помощью ИИ, или интерактивные приложения с функциями, использующими ИИ, L40S становится единственным жизнеспособным вариантом.
Заключение
Видеокарты NVIDIA L40S и новейшие преемники Blackwell RTX Pro 6000 представляют собой стратегически важные графические процессоры, отвечающие меняющимся требованиям современных центров обработки данных, где вычисления в области искусственного интеллекта и передовые графические возможности все больше сближаются. В то время как графические процессоры классов H100 и B200 остаются бесспорными лидерами для задач обучения и вывода данных в области ИИ, L40S занимает особую и ценную нишу в качестве универсального графического процессора, который заполняет пробел между ориентированными на вычисления картами для ИИ и традиционными профессиональными решениями для визуализации.
Уникальное преимущество L40S наиболее очевидно в сценариях, требующих как возможностей вывода ИИ, так и графического ускорения. Его 142 ядра RT третьего поколения позволяют создавать приложения, которые просто невозможны на вычислительных графических процессорах, таких как H100, от трассировки лучей в реальном времени в профессиональных рабочих процессах до генерации фотореалистичных синтетических данных для обучения ИИ следующего поколения. Эта двойная возможность делает его незаменимым для новых приложений в разработке цифровых двойников, обучении ИИ на основе физических моделей и растущей экосистеме Omniverse.
С экономической точки зрения, L40S предлагает привлекательное соотношение цены и качества для организаций, которым не требуется максимальная производительность ИИ, как у H100. При стоимости примерно в три раза ниже, чем у H100, L40S обеспечивает достойную производительность при выполнении инференции, одновременно предоставляя графические возможности, которые значительно расширяют возможности развертывания в центрах обработки данных. Для многих организаций это сочетание экономичности и универсальности делает L40S более практичным выбором, чем инвестиции в отдельные решения для ИИ и графики.


 Amazon