

Обновлено 19 октября 2026 г.: Open WebUI становится вторым выбором по результатам измерений (115.32 и 75.06 токенов в секунду в бенчмарке RTX 5000 Ada против 123 и 82 в январе), в его обзоре теперь рассматривается настольное приложение для Windows и сервер версии 0.12.2, а в разделе «Руководство» размещена ссылка на обзор Open WebUI. Первоначально опубликовано 19 августа 2026 г.
Существует четыре причины запускать языковую модель на собственном оборудовании, и только одна из них носит идеологический характер. Конфиденциальность: документ, который вы передаете локальной модели, никогда не покидает машину, а это весь диалог, касающийся клиентского кода, контрактов, данных пациентов и еще не выпущенных продуктов.
Структура затрат: облачный ИИ работает по тарифам, а агентные рабочие нагрузки увеличивают количество токенов достаточно быстро, чтобы производительная рабочая станция могла окупить себя; собственное оборудование работает по цене электроэнергии. Доступность: нет ограничений скорости, нет отключений, нет уведомлений об устаревании, которые могли бы изменить ваш рабочий процесс во вторник. И контроль: вы используете проверенную вами модель до тех пор, пока не решите иначе.
Противовесом является то, что передовые облачные модели остаются более функциональными, и для долгосрочной работы с агентами разрыв реален. Локальные модели достигли паритета в ограниченных задачах: чаты, суммирование, код в одном файле и вопросы и ответы по документам. Это, как правило, то, чем большинство людей занимаются весь день. Если для вас важна максимальная производительность любой ценой, используйте облако. Если же для вас важны конфиденциальность, стоимость или контроль, локальные модели жизнеспособны уже сегодня, и эта страница — ваш путеводитель.
Такой подход должен определить ваш бюджет на оборудование, поскольку локальные затраты на ИИ в первую очередь зависят от объема памяти. 16 ГБ видеопамяти или 32 ГБ унифицированной памяти покрывают класс 7–8 бит, который справляется с ограниченными задачами, описанными выше. 24–32 ГБ видеопамяти или 48 ГБ унифицированной памяти позволяют достичь класса 30 бит, где программирование агентов перестает быть просто демонстрацией. 96–128 ГБ унифицированной памяти позволяют запускать модели объемом более 100 бит, приближающиеся к уровню передовых технологий. Избыточные затраты обеспечат скорость, которую вы можете не заметить; недостаточные затраты приведут к тому, что нужный вам класс моделей вообще не загрузится.
В наших рейтингах лучших ноутбуков и лучших настольных компьютеров для локального ИИ машины ранжированы по уровням. На этой странице описано, какие программы на них следует запускать.
Программная составляющая не развивалась так же плавно, как аппаратная. Примерно треть инструментов, которые вы найдете в результатах поиска сегодня, устарели, и большинство сайтов, которые их рекомендуют, этого не заметили.
На этой странице отслеживается, что работает и на каком оборудовании по состоянию на октябрь 2026 года. Пока что мы ранжируем по количеству звезд на GitHub, поскольку это нейтральный и проверяемый показатель, и мы указываем, когда инструмент является закрытым исходным кодом и не имеет количества звезд. Каждое название инструмента в таблицах содержит ссылку на его официальную загрузку. По мере прохождения каждым инструментом тестирования, столбец «Руководство» заполняется пошаговым руководством по настройке и нашими собственными данными, начиная с января.
На этой странице действуют три правила, начиная с различия между локальной моделью и локальным агентом . На вашем компьютере работает несколько продуктов, в то время как каждый вызов функции вывода данных отправляется в облако поставщика; это вопрос конфиденциальности, а не возможности работы в автономном режиме, и эти инструменты перечислены отдельно внизу, чтобы различие оставалось видимым. Во-вторых, каждая запись содержит реалистичный минимальный набор аппаратных ресурсов, поскольку утверждение «работает на ноутбуке» бессмысленно без указания объема памяти. В-третьих, в разделе часто задаваемых вопросов (FAQ) мы отслеживаем, что вышло из строя, с указанием дат.
Выбор
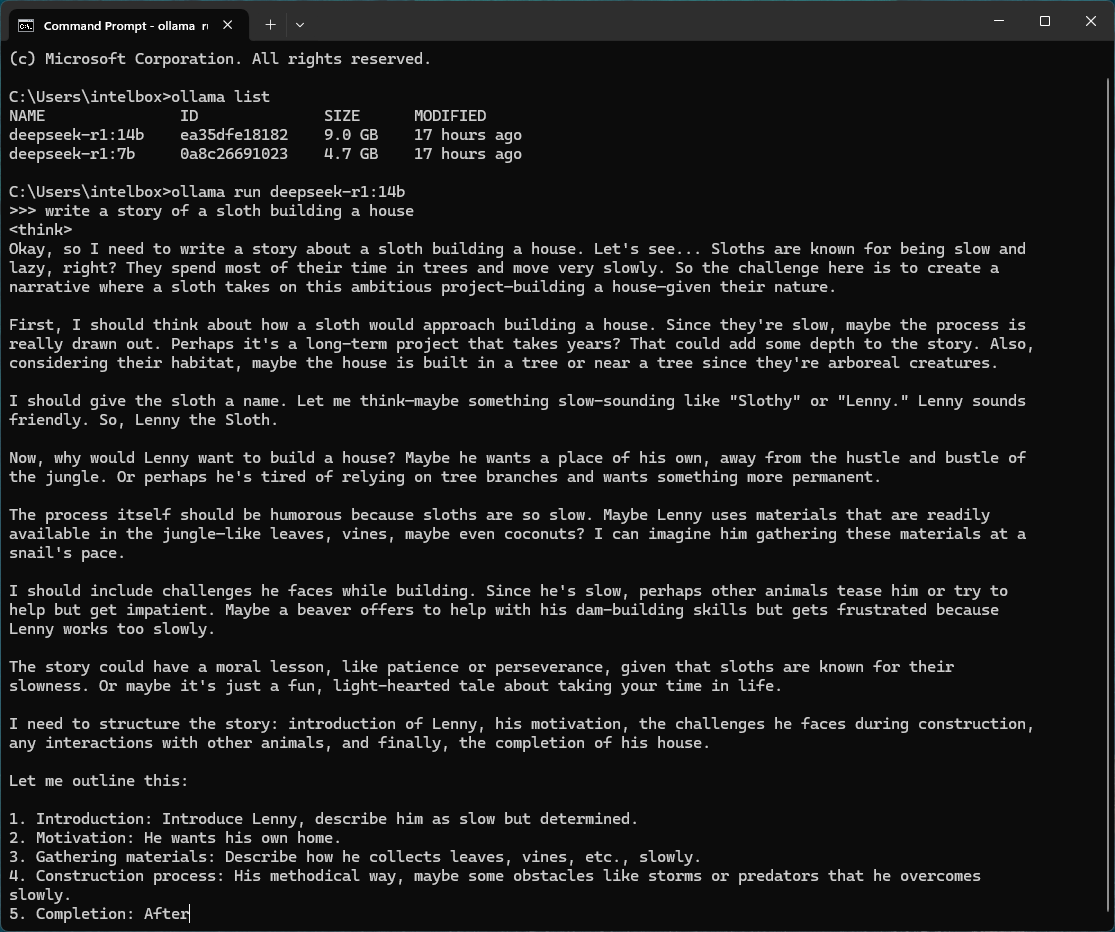
Лучшее общее время обучения по программе LLM в регионе: Ollama
Ollama — это решение по умолчанию, и именно с ним взаимодействует большинство других инструментов. Распространяется под лицензией MIT, имеет около 179 000 звезд на GitHub и теперь поставляется с графическим интерфейсом для настольных компьютеров наряду с интерфейсом командной строки. Он загружает модели одной командой, предоставляет совместимую с OpenAI конечную точку на localhost, а в январе 2026 года добавил совместимость с API Anthropic Messages, благодаря чему Claude Code теперь подключается к локальной модели. Минимальные требования: 8 ГБ системной оперативной памяти для модели 3B, 16 ГБ для 7-8B, 24 ГБ видеопамяти для класса 30B.
Лучший инструмент для тестирования производительности оборудования: LM Studio
Это программа с закрытым исходным кодом, поэтому у неё нет рейтинга, но она всё равно заслуживает своего места. LM Studio включает в себя llama.cpp и MLX и предоставляет доступ к элементам управления, которые важны при измерении производительности машины, а не при её использовании: слои разгрузки GPU, выбор квантизации, длина контекста и поведение в многопроцессорной среде. Она бесплатна для коммерческого использования с июля 2025 года. Именно этот инструмент обеспечивает большинство показателей производительности в токены в секунду на наших рабочих станциях и ноутбуках. Минимальные требования: 16 ГБ ОЗУ; 24 ГБ видеопамяти или 32 ГБ унифицированной памяти для более точных расчетов.
Лучший базовый движок: llama.cpp
Практически всё остальное на этой странице основано на llama.cpp. Лицензия MIT, примерно 124 700 звёзд, ежедневно публикуется множество помеченных сборок. Для аппаратной аудитории это важно по определённой причине: список бэкендов огромен и охватывает CUDA, ROCm, Metal, Vulkan, SYCL, CANN и OpenCL, и инженеры производителей теперь напрямую вносят в него оптимизации. Улучшение предварительного заполнения Intel Arc в сборке 8688 примерно в 5 раз увеличило производительность, и каждый пользователь Ollama и LM Studio получил его без установки чего-либо. Минимальные требования: работает только на ЦП; 8 ГБ оперативной памяти для корректной работы.
Лучшее настольное приложение, ориентированное на локальные решения: Январь
Apache 2.0, примерно 44 100 звёзд, версия 0.8.6 по состоянию на октябрь 2026 года. Ян включает в себя llama.cpp, поэтому ничего больше устанавливать не нужно, и всё работает даже без подключения к сети. Звучит как низкая планка, пока не проверишь, сколько приложений в этой категории являются облачными клиентами с полем Ollama. Это приложение лучше всего подойдёт коллеге, который никогда не будет открывать терминал.
Это также первая платформа на этой странице, для которой мы предоставили собственные данные: в нашем тесте RTX 5000 Ada, версия Jan V3.5 4B декодировала в среднем 123 токена в секунду, а Jan V2 VL High — 82, используя 4.8 ГБ и 8.2 ГБ памяти GPU соответственно, с включенным ускорением GPU при первом запуске и без настройки CUDA. Полное пошаговое руководство, от установки до API, совместимого с OpenAI, находится в нашем руководстве по использованию Jan ; в нем не рассматривается только документ RAG, посвященный этой части приложения. Минимальные требования: 8 ГБ ОЗУ.
Лучший местный документ RAG: AnythingLLM
MIT, примерно 64 800 звезд. Он включает в себя векторную базу данных и обрабатывает разбиение на фрагменты и встраивание без настройки, что делает его самым готовым к использованию чатом для работы с документами в настольном классе. Две вещи, которые мы не будем скрывать: уязвимость, обнаруженная в марте 2026 года и имеющая рейтинг CVSS 9.6, позволяла удаленное выполнение кода, запускаемое собственным потоковым ответом модели; она исправлена в версии 1.11.2, поэтому обновите приложение перед использованием. Кроме того, телеметрия включена по умолчанию в приложении, позиционируемом как локальное, но ее можно отключить в настройках. Минимальные требования: 16 ГБ ОЗУ для работы с документами.
Лучший вариант для самостоятельного размещения многопользовательской системы: Open WebUI
Примерно 149 000 звезд и самая глубокая настройка параметров получения данных, и мы протестировали сервер версии 0.12.2. Изначально это был сервер с самостоятельным размещением, использующий Docker в качестве точки входа, а теперь его можно установить с помощью настольного приложения для Windows, включающего встроенную среду Python и собственную среду выполнения llama.cpp. Прежде чем начать разработку, следует знать следующее: в апреле 2025 года лицензия изменилась с BSD-3 на пользовательскую лицензию, не одобренную OSI, добавив пункт, запрещающий удаление брендинга Open WebUI, с исключением для пользователей младше пятидесяти человек в течение любого тридцатидневного периода. Если запустить его в небольшом масштабе без изменений, для вас ничего не изменится.
Это вторая платформа на этой странице с нашими собственными данными. В наших тестах и файлах модели Jan Open WebUI Desktop декодировал Jan V3.5 4B со средней скоростью 115.32 токенов в секунду, а Jan V2 VL High — на 75.06, 6.2 и 8.5 процента ниже, чем Jan, при использовании другой сборки llama.cpp. Различия заключаются в настройке: мы зафиксировали сборку llama.cpp b11612, добавили DLL-библиотеки среды выполнения CUDA вручную и восстановили контекст на 8,192 токена после переустановки, что позволило выделить до 169 984 токенов на слот. После этого заработали предустановки, ввод изображений, веб-поиск DDGS и локальный API, как подробно описано в нашем руководстве по Open WebUI . Минимальные требования: отдельная среда выполнения плюс 4 ГБ для контейнера или настольное приложение с прилагаемым llama.cpp.
Лучший местный агент по программированию: Клайн
Apache 2.0, примерно 63 900 звезд. Компания Cline проделала больше реальной инженерной работы на локальном уровне, чем любой конкурент, включая компактную системную подсказку, специально разработанную для Ollama и LM Studio, и вызов нативных инструментов для каждого семейства моделей. Их собственная документация необычайно откровенна в отношении того, в чем облако по-прежнему выигрывает. Минимальные требования: 24 ГБ видеопамяти или 36 ГБ унифицированной памяти и установка контекста на 32 КБ или выше.
Лучший код для офлайн-терминала: Aider
Apache 2.0, примерно 48 300 звезд, и с архитектурной точки зрения это наиболее надежный локальный вариант, и этому есть причина, заслуживающая внимания. Aider вообще не использует вызовы инструментов JSON. Он анализирует форматы различий и редактирования целых файлов из обычного текста, что позволяет избежать именно того сбоя, который приводит к поломке большинства агентов в локальных моделях. Однако есть и недостатки: 96 процентов коммитов были написаны одним автором, а частота релизов сократилась примерно до одного стабильного релиза в 2026 году. Минимальные требования: 24 ГБ видеопамяти или 36 ГБ унифицированной памяти.
Лучшая платформа для самостоятельного размещения агентов: OpenHands
MIT, примерно 84 500 звезд. OpenHands должным образом документирует локальные модели и, что более полезно, сообщает, когда проблема не в вашей конфигурации: в его собственной документации указано, что если агент ведет себя как чат-бот или постоянно дает сбои в работе инструментов, то ограничением является модель. Он требует минимум 22 КБ контекста и рекомендует 32 КБ. Минимальные требования: 24 ГБ видеопамяти для квантованных моделей или 64 ГБ унифицированной памяти.
Лучший бесплатный офлайн-сюрприз: GitHub Copilot CLI
Начиная с апреля 2026 года, Copilot CLI работает с Ollama, vLLM и Foundry Local. Аутентификация GitHub необязательна, подписка на Copilot не требуется. Установка параметра COPILOT_OFFLINE отключает всю телеметрию и сетевые соединения, а его дочерние агенты наследуют ваш локальный провайдер. В большинстве сравнительных статей он по-прежнему указан как работающий только в облаке. Обратите внимание на разделение: расширение IDE по-прежнему отправляет автодополнения в облако даже при использовании собственного ключа. Минимальные требования: модель с контекстным окном 128 КБ, то есть 32 ГБ видеопамяти или 64 ГБ унифицированной памяти.
Лучший сервер с поддержкой от поставщика: Lemonade
Apache 2.0, примерно 5,400 звёзд, и единственный инструмент от стороннего производителя, который мы бы рекомендовали только за его достоинства. Его поддерживают инженеры AMD, и он работает на NVIDIA CUDA, Apple Metal, Vulkan и обычном CPU, а также на NPU Radeon и Ryzen AI. Он выходит примерно каждые две недели, а его настольное приложение было переведено с Electron на Tauri в апреле 2026 года. Минимальные требования: 16 ГБ ОЗУ; Ryzen AI серии 300 или более поздней версии для работы с NPU.
Лучший локальный RAG для всей файловой системы: Nexa AI Hyperlink
Nexa AI Hyperlink — это программа с закрытым исходным кодом, бесплатная, которая индексирует всю файловую систему устройства и отвечает с помощью встроенных ссылок. Она включена в этот список, потому что это единственный новый локальный инструмент RAG с опубликованными данными об ускорении на потребительском оборудовании: примерно в 3 раза быстрее индексирование и в 2 раза быстрее вывод результатов на RTX 5090, при этом время обработки папки размером 1 ГБ сокращается с примерно пятнадцати минут до четырех-пяти. Минимальные требования: современный графический процессор RTX; 16 ГБ оперативной памяти.
Среды выполнения: Что запускает модель?
Эти пять — это движки, а всё, что находится в следующих двух таблицах, — это интерфейс, взаимодействующий с одним из них, поэтому таблица упорядочена по звёздам GitHub, как и остальная часть страницы.
Столбец «Руководство» здесь частично совпадает с разделом приложений, поэтому его область охвата соответствует этому разделу: Ollama получает отдельное руководство, поскольку это выбор большинства других инструментов и бэкенд, на который они ориентируются; LM Studio присутствует в обеих таблицах и имеет одно руководство; llama.cpp рассматривается через приложения, которые его включают, начиная с январского обзора; а MLX рассматривается через LM Studio на Apple Silicon. vLLM — это серверный движок, и его тест уже есть в нашем обзоре кластера GB300 на двух башнях.
| Время выполнения | Звезды | Лицензия | Минимальное оборудование | Ускорение | Guide |
|---|---|---|---|---|---|
| Оллама | ~1600 | MIT | 8 ГБ ОЗУ (3B), 16 ГБ (7-8B), 24 ГБ видеопамяти (класс 30B) | CUDA, ROCm, Metal, Vulkan | Скоро |
| лама.cpp | ~1600 | MIT | 8 ГБ ОЗУ, работает только процессор. | CUDA, ROCm, Metal, Vulkan, SYCL, CANN, OpenCL | Охвачено посредством Января и Открыть веб-интерфейс практические занятия |
| MLX / mlx-lm | ~1600 | MIT | Apple Silicon, 16 ГБ объединенного оперативной памяти | Metal; бэкенд CUDA будет добавлен в 2026 году. | Через руководство LM Studio (скоро будет доступно) |
| ЛМ Студия | Закрытый источник | Собственная разработка, бесплатно для коммерческого использования. | 16 ГБ ОЗУ; 24 ГБ видеопамяти или 32 ГБ объединенной памяти | Пакеты llama.cpp и MLX | Скоро |
| vLLM | Производство и обслуживание | Apache 2.0 | 24 ГБ видеопамяти, реалистичный пол | CUDA, ROCm | Протестировано в наших Обзор кластера GB300 |
Настольные приложения и локальный RAG
Это приложения, которые устанавливает читатель, и столбец «Локально — прежде всего» — тот, который следует внимательно прочитать: в нем разделяется программное обеспечение, запускающее модель на вашем компьютере, и программное обеспечение, добавившее поле для URL-адреса Ollama.
| Приложение | Звезды | Лицензия | Местный подход прежде всего | Минимальное оборудование | Guide |
|---|---|---|---|---|---|
| Открыть веб-интерфейс | ~1600 | Пользовательская разработка, не одобренная OSI. | Функциональный сервер, а также настольное приложение для Windows, включающее файл llama.cpp. | Отдельная среда выполнения + 4 ГБ для контейнера или настольного приложения | Практическое руководство по Open WebUI |
| Что угодноLLM | ~1600 | MIT | Функционально; телеметрия включена по умолчанию. | RAM 16GB | Скоро |
| Января | ~1600 | Apache 2.0 | Да, пакеты llama.cpp | RAM 8GB | Практическое руководство от января |
| ЛМ Студия | Закрытый источник | Запантентованная | Да | 16 ГБ оперативной памяти; 24 ГБ видеопамяти — это будет интересно. | Скоро |
| Мсти | Закрытый источник | Собственный бесплатный уровень | Да, включает в себя Ollama, MLX, llama.cpp | RAM 8GB | Скоро |
| Nexa AI Hyperlink | Закрытый источник | Собственная разработка, бесплатно | Да, индексирование на устройстве. | Современная видеокарта RTX, 16 ГБ оперативной памяти | Скоро |
Инструменты программирования и агентские инструменты
Это наиболее ресурсоемкие по аппаратному обеспечению элементы на этой странице, поскольку для работы агентов требуется большое контекстное окно и длительные сеансы. 32 ГБ видеопамяти или 64 ГБ унифицированной памяти — это тот уровень, после которого демонстрация перестает быть просто демонстрацией.
| Инструмент | Звезды | Лицензия | Локальный путь | Минимальное оборудование | Guide |
|---|---|---|---|---|---|
| OpenHands | ~1600 | MIT | LM Studio, Ollama, vLLM, SGLang | 24 ГБ видеопамяти или 64 ГБ объединенной; контекст 32 КБ | Скоро |
| Cline | ~1600 | Apache 2.0 | Ollama, LM Studio, совместимая с OpenAI | 24 ГБ видеопамяти или 36 ГБ объединенной видеопамяти | Скоро |
| Гусь | ~1600 | Apache 2.0 | Ollama — первоклассная компания; теперь — Linux Foundation. | 24 ГБ видеопамяти или 36 ГБ объединенной видеопамяти | Скоро |
| помощь | ~1600 | Apache 2.0 | Ollama, совместима с OpenAI; не требует вызова инструментов. | 24 ГБ видеопамяти или 36 ГБ объединенной видеопамяти | Скоро |
| Зет | v1.0, апрель 2026 г. | Apache 2.0 | LM Studio, Ollama, llama.cpp | 24 ГБ видеопамяти или 36 ГБ объединенной видеопамяти | Скоро |
| Интерфейс командной строки GitHub Copilot | Закрытый источник | Собственная разработка, подписка не требуется. | Ollama, vLLM, Foundry Local | 32 ГБ видеопамяти или 64 ГБ объединенной; контекст 128 КБ | Скоро |
Инициативы поставщиков
Каждый производитель микросхем и операционных систем выпускает что-то для локального ИИ, и эта категория заслуживает отдельной статьи расходов, поскольку названия запутанны, а уровень смертности высок. В 2026 году тенденция остаётся неизменной: производители перестали конкурировать со сторонними разработчиками и начали предоставлять им готовые решения. NVIDIA прекратила выпуск своих собственных продуктов для локального ИИ и теперь публикует оптимизации для Ollama, llama.cpp и ComfyUI. AMD сотрудничает с LM Studio. Qualcomm выпустила свои возможности для работы с NPU, портировав чужое приложение.
Единственное, что делают инструменты от сторонних производителей, чего не могут Ollama и LM Studio: они обеспечивают доступ к нейронному процессору (NPU) . В llama.cpp нет бэкэнда NPU, поэтому на машинах с процессорами Snapdragon или Ryzen эти инструменты оставляют нейронный движок с нулевой загрузкой. Если вы заплатили за 40-60 TOPS, то использовать его можно только через сторонний сервис. Учитывайте это при планировании, поскольку NPU в настоящее время достигают максимума примерно в 7 миллиардах моделей, и преимущество заключается в экономии заряда батареи при постоянной работе с небольшими моделями, а не в производительности. Дискретный графический процессор всегда превосходит NPU по скорости.
| Производитель | Что это такое? | Тип | Требуемое оборудование | Статус | Guide |
|---|---|---|---|---|---|
| AMD Лимонад | Сервер, графический интерфейс и SDK; ~5,400 звезд, Apache 2.0 | Приложение + сервер | 16 ГБ ОЗУ; процессор Ryzen AI 300+ для NPU. Также работает на NVIDIA, Apple CPU. | Активно работает, отгрузка примерно раз в две недели. | Скоро |
| Intel OpenVINO GenAI | Среда выполнения и SDK; ~10 700 звезд | SDK | Процессоры Core Ultra, Arc A/B; 16 ГБ оперативной памяти. | Активная эксплуатация, 2026.3 в августе 2026 г. | Отслеживается, гид не планируется. |
| Модели фонда Apple | Модели устройств, предоставляемые операционной системой. | структура ОС | Apple Silicon; уже установлен. | Действует; открыт для всех поставщиков услуг на конференции WWDC 2026. | Отслеживается, гид не планируется. |
| Microsoft Foundry Local | SDK и CLI для локального вывода; ~2,400 звезд | SDK | Windows, macOS, Linux; NPU/GPU/CPU | Генеральная ассамблея, апрель 2026 г.; тщательно составленный каталог моделей. | Отслеживается, гид не планируется. |
| AMD GAIA | Локальное приложение LLM для искусственного интеллекта на базе процессоров Ryzen; ~1,400 звезд, MIT. | Приложение + SDK | Минимальные требования: процессоры Ryzen AI серии 300; 16 ГБ оперативной памяти, рекомендуется 64 ГБ. | Действует с версии 0.20.0, июнь 2026 г. | Отслеживается, гид не планируется. |
| Intel AI Playground | Приложение для ПК; ~900 звезд | Приложение | Arc A-серия 8 ГБ+, Arc B-серия, Core Ultra | Активный проект, но всё ещё находится в стадии бета-тестирования после двух лет. | Отслеживается, гид не планируется. |
| Qualcomm GenieX | Встроенная среда выполнения GGUF для NPU Snapdragon | Время выполнения | Snapdragon X / X Elite, 8 Elite | Предварительная версия для разработчиков, июль 2026 г. | Отслеживается, гид не планируется. |
| Проект NVIDIA G-Assist | Встроенный в устройство помощник 8B для управления системой | Приложение | Видеокарты серии RTX 20 или более поздней версии, 6 ГБ видеопамяти. | Активен, но пока помечен как предварительный релиз. | Отслеживается, гид не планируется. |
Название только усугубляет путаницу, поскольку «RTX AI Garage» от NVIDIA звучит как название продукта, а на самом деле таковым не является; это серия статей в блоге. Стек технологий Microsoft неоднократно переименовывался: API Copilot Runtime стали API Windows AI, Azure AI Foundry — Microsoft Foundry, а DirectML сейчас находится в режиме обслуживания, занимаясь только исправлением ошибок безопасности. Qualcomm AI Hub — это облачный сервис, который удаленно подготавливает физические устройства, а не программа, запускаемая локально.
Что обычно ломается
Большинство сообщений о том, что локальные модели «не работают», связаны с проблемами конфигурации, а не с проблемами самих моделей. Четыре из них составляют значительную долю таких сообщений, и обо всех четырех следует знать специалистам по аппаратному обеспечению, прежде чем обвинять в этом сам кремниевый чип.
1. Ollama по умолчанию использует контекст из 4,096 токенов. При превышении этого значения ошибка не возникает. Контекст автоматически обрезается, и цикл обработки событий завершается тихо. Каждому серьезному движку требуется больше: OpenHands требует не менее 22 000 токенов и рекомендует 32 000, Codex — 32 000, Copilot CLI — 128 000, а Cline устанавливает 262 144. Вероятно, именно эта единственная настройка является наиболее распространенной причиной сообщений об ошибках, которые вы найдете в интернете.
2. Квантование KV-кэша ухудшает качество вызовов инструментов , и это происходит до того, как заметно сказывается общее качество выходных данных. В документации llama.cpp об этом прямо предупреждается. Если вы используете агент, отключите его.
3. Количество инструментов — это скорее обрыв, чем склон. При использовании примерно пяти-шести инструментов некоторые модели незаметно перестают генерировать корректные JSON-запросы к инструментам и начинают вместо этого встраивать XML в тело ответа, что система интерпретирует как «инструмент не использовался». Один популярный агент по умолчанию поставлял одиннадцать инструментов и сломал свою собственную рекомендуемую модель до начала 2026 года. Мы столкнулись с подобной проблемой в ходе тестирования Open WebUI, где встроенные инструкции к инструментам привели к тому, что короткий запрос бенчмарка превысил контекст в 8,192 токена. Практическое последствие противоречит интуиции: загрузка множества MCP-серверов активно вредит локальным моделям, чего не происходит с моделями на границе.
4. Q4_K_M — это практический минимум. Ниже него надежность вызова инструмента снижается быстрее, чем общее качество, поэтому модель по-прежнему выглядит неплохо, но при этом незаметно ничего не делает.
Память — это ограничение.
Для всех инструментов на этой странице решающим фактором, определяющим возможность их запуска, является объем памяти, доступный ускорителю. Ниже представлены наиболее часто упоминаемые пары инструментов для работы с агентными вычислениями, и именно их мы намерены проверить в лаборатории.
| Металлоизделия | Модель | след | Заявленная пропускная способность |
|---|---|---|---|
| RTX 5090, 32 ГБ | Qwen3.6-35B-A3B Q4_K_M | ~ 21GB | 160-180 ток/с, контекст 262K |
| RTX 5090, 32 ГБ | Qwen3-Coder-30B-A3B Q4_K_M | ~ 19GB | 50-90 ток/с на 24 ГБ памяти |
| RTX 5090, 32 ГБ | Devstral Small 24B Q4_K_M | ~ 14GB | Специально разработан для вызова инструментов. |
| RTX PRO 6000, 96 ГБ | GPT-OSS 120B MXFP4 | ~ 63GB | Видеокарта класса 100B на одной рабочей станции; графический процессор из нашего лабораторного обзора. |
| Ноутбук с видеокартой RTX PRO 5000, 24 ГБ GDDR7. | Qwen3-Coder-30B-A3B Q4_K_M | ~ 19GB | Самая большая из протестированных нами видеокарт для ноутбуков (ThinkPad P16 Gen 3); 30-битная модель вполне подходит по размерам. |
| 96-128 ГБ унифицированный, серия M | gpt-oss-120b Q6_K | ~ 93GB | 14-20 ток/с; самый чистый JSON-код вызова инструмента среди всех моделей с открытыми весами. |
Стоит отметить, потому что в маркетинге об этом умалчивают: самые большие по весу модели не являются моделями для рабочих станций. GLM-5.2 имеет примерно 744 байта параметров и требует порядка 744 ГБ в FP8, что соответствует узлу дата-центра с восемью графическими процессорами. Kimi K2 и DeepSeek V4 относятся к той же категории. Любое руководство, рекомендующее запускать их на настольном компьютере, ошибочно.
Приведенные выше показатели пропускной способности получены на основе опубликованных сторонних тестов и материалов поставщиков и пока не являются результатами лабораторных испытаний StorageReview, за исключением показателей Jan и Open WebUI, указанных в приведенном выше списке. Мы заменим их собственными данными по мере прохождения каждым продуктом процедуры включения в руководство.
Инструменты, ориентированные на облачные технологии, и почему они не включены в этот рейтинг.
Локальный агент — это не локальная модель , и приведенные ниже инструменты демонстрируют разницу: каждый из них работает на вашем компьютере, отправляя при этом все вызовы для вывода результатов в облако поставщика.
| Инструмент | Поддержка локальной модели | Внимание |
|---|---|---|
| Курсор | Нет | В официальной документации указано, что все запросы проходят через серверы Cursor; пользовательские клавиши работают только с крупными облачными провайдерами, а автодополнение по клавише Tab всегда использует модели Cursor. Приобретена компанией SpaceX в 2026 году. |
| Девин Дескейпл (ранее Виндсёрф) | Нет | Переименовано в июне 2026 года. Все модели размещены в облаке. |
| Google Антигравитация | Нет | В документации прямо указано, что нельзя использовать Ollama, LM Studio или пользовательскую конечную точку. |
| Близнецы CLI | Нет | Локальная поддержка существует только в форках, созданных сообществом. |
| Кодо | Нет | Термин «локальная инфраструктура» относится к самостоятельно размещаемой инфраструктуре, которая по-прежнему относится к облачным моделям. |
| GitHub Copilot в IDE | Частичный | Чат может использовать локальные модели; автодополнение в строке остается облачным даже при использовании функции «принеси свою собственную клавишу». |
| ChatGPT | Нет | Настольные и мобильные приложения являются клиентами для облачных моделей OpenAI. Модели OpenAI gpt-oss с открытыми весами работают локально, но через указанные выше среды выполнения, а не через приложение ChatGPT. |
| Клод | Нет | Приложения Claude и Cowork работают на облачных моделях Anthropic. Claude Code может быть подключен к локальной модели через совместимый с Anthropic API Ollama, что работает, но является неподдерживаемой конфигурацией. |
| Генеральные агентские помощники | Нет | Инструменты этого класса работают на вашем компьютере, но для рассуждений используют облачную модель. |
Существует множество руководств типа «подключите Cursor к Ollama». Собственная документация Cursor противоречит им. Если для вас необходима работа в автономном режиме, то это различие имеет решающее значение.
Что насчёт генерации изображений и видео?
Локальная генерация изображений — одна из крупнейших областей в сфере локального ИИ. Один только ComfyUI превосходит большинство инструментов, занимающих более высокие места в рейтинге GitHub, а локальная генерация видео становится самой ресурсоемкой задачей для потребителей с точки зрения видеопамяти. Она заслуживает собственного рейтинга, и он будет; добавление четвертой категории на эту страницу затмило бы её. До тех пор аппаратная логика на этой странице переносится напрямую: работа с изображениями и видео ещё более ресурсоемка, чем работа с языковыми моделями, и применяются те же уровни.
Как работает эта страница
Для ранжирования действуют три правила, и первое из них заключается в том, что на данный момент порядок определяется звездами GitHub. Это не идеально, но это нейтрально, проверяемо и не требует от нас притворяться, что мы тестировали то, чего не тестировали. Инструменты с закрытым исходным кодом помечаются как таковые и не получают вымышленной оценки. По мере того, как наши собственные тесты будут выявлять явных фаворитов, порядок будет меняться в соответствии с измеренными результатами, и мы будем об этом говорить; у Jan и Open WebUI теперь есть лабораторные данные, так что этот сдвиг уже начался. Во-вторых, каждая запись содержит минимальное значение памяти, поскольку именно это число определяет, будет ли загружена модель.
В-третьих, раздел «Руководство» содержит обязательства, относящиеся к выбранным продуктам: для каждого продукта, вошедшего в рейтинг, предоставляется пошаговое руководство по настройке с указанием характеристик на нашем оборудовании, рассматривается среда выполнения, поставляемая в приложение, а инициативы поставщиков отслеживаются в соответствующей таблице, даже если таковых нет. Ссылка появляется здесь после публикации каждого руководства.
Часто задаваемые вопросы о местных инструментах LLM
С какого локального инструмента LLM мне следует начать?
Ollama — если вам удобнее работать в терминале, LM Studio — если вы предпочитаете окно с элементами управления, а Jan — если вам нужно что-то, что работает «из коробки» и не требует установки чего-либо ещё. Все три бесплатны, все три работают полностью в автономном режиме, и все три используют llama.cpp в качестве основы, поэтому поведение модели одинаково. Разница заключается в интерфейсе, а не в скорости.
Что случилось с NVIDIA ChatRTX, GPT4All и Continue.dev?
Они исчезли, как и удивительно большое количество аналогичных программ, и это самое полезное, что нужно знать, прежде чем следовать старой рекомендации. NVIDIA ChatRTX был объявлен устаревшим 21 января 2026 года, его репозиторий заархивирован, а форум поддержки закрыт, и замена ему пока не названа.
GPT4All — самый сложный случай: за последние двенадцать месяцев в нём не было ни одного коммита, а последний релиз состоялся в феврале 2025 года, но репозиторий не заархивирован и по-прежнему имеет большое количество звёздочек, так что он выглядит живым. Он всегда поддерживал лишь узкий набор форматов квантизации и не может загружать большинство современных версий моделей.
Continue.dev , в течение двух лет считавшийся стандартным сервисом для локального программирования, был приобретен компанией Cursor и закрыт в июне 2026 года. Roo Code прекратил работу в мае 2026 года, Void был заархивирован в июне 2026 года, Twinny — в ноябре 2025 года, а Reor — в марте 2026 года. Khoj закрыл свой хостинг-сервис в апреле 2026 года, хотя версия для самостоятельного размещения сохранилась. Что касается поставщиков, Intel IPEX-LLM был заархивирован в январе 2026 года из-за известных проблем безопасности и отсутствия опубликованного пути миграции, а NVIDIA RTX AI Toolkit был признан устаревшим в ноябре 2025 года.
Сколько видеопамяти мне потребуется для запуска локальной программы LLM?
Для чата 8 ГБ системной оперативной памяти обеспечивают работу 3-битной модели, а 16 ГБ — приемлемую работу 7-8-битной модели только на процессоре. Для достижения приемлемой скорости желательно использовать видеопамять или унифицированную память: 16 ГБ обеспечивают работу 7-14-битной модели, 24 ГБ достигают 30-битной модели на 4-м квартале, а 32 ГБ и более — это тот объем, после которого работа с программным обеспечением перестает быть сложной. При большем объеме объем памяти важнее пропускной способности, поэтому машины с 96-128 ГБ унифицированной памяти работают с моделями, которые не могут обеспечить ни одна потребительская видеокарта.
Используют ли локальные инструменты LLM мой NPU?
Обычно нет, потому что в llama.cpp нет бэкэнда NPU, поэтому Ollama и LM Studio оставляют нейронный движок на нуле на машинах с процессорами Snapdragon или Ryzen AI и работают вместо этого на CPU или GPU. В настоящее время доступ к NPU требует использования сторонних решений: Qualcomm GenieX, AMD Lemonade с его средой выполнения NPU, Intel OpenVINO или нейронного движка Apple через фреймворки ОС. Преимуществом является время автономной работы и низкое энергопотребление при постоянной работе, поскольку NPU сегодня выпускаются в масштабах около 7 миллиардов моделей, а дискретный GPU всегда превосходит его по производительности.
Какой операционный ИИ лучше запускать локально: Windows или Linux?
Что касается настольных приложений на этой странице, Windows и macOS обеспечивают более удобную установку. LM Studio, Jan, AnythingLLM и Ollama устанавливаются без проблем, драйверы для графических процессоров поставляются из обычных источников, и ничто не требует терминала. Linux занимает более низкое положение: движки для развертывания приложений, vLLM и SGLang, ориентированы в первую очередь на Linux, развертывание на нескольких графических процессорах фактически предполагает его совместимость, а некоторые из новейших путей ускорения появляются там раньше всех, включая поддержку AMD Ryzen AI NPU, которая появилась в Linux и требует очень свежего ядра.
Разрыв стал меньше, чем раньше. AMD унифицировала свои релизы ROCm для Windows и Linux в 2026 году, а WSL2 охватывает большую часть оставшихся операционных систем, благодаря чему инструменты на основе Docker, такие как Open WebUI, прекрасно работают на машинах с Windows. Практическое правило: если вы устанавливаете приложения из списка настольных приложений, оставайтесь на той ОС, которая у вас есть; если вы создаете выделенный сервер или стремитесь к максимальному ускорению, создавайте его на Linux.
Достаточно ли хороши локальные модели, чтобы заменить облачную модель для программирования?
Всё зависит от задачи, и разница гораздо чётче, чем признаёт большинство экспертов по покрытию кода. В задачах с ограниченным объёмом работы, генерацией отдельных файлов, модульными тестами, шаблонным кодом и объяснением кода, современные модели с открытыми весами на хорошей рабочей станции примерно равны моделям облачных вычислений. В задачах с долгосрочной перспективой, например, при многофайловой рефакторизации в большом репозитории, они явно проигрывают, а сбои носят неприятный характер: молчаливые бездействия и уверенно заявленная работа, которой никогда не было. Если ваша причина для перехода на локальные решения — конфиденциальность, требования к изоляции сети или стоимость, то сегодня это жизнеспособно. Если же причина — функциональность, то пока нет.
Безопаснее ли запускать модель локально, чем использовать облачный сервис?
Что касается размещения данных, то да, и именно поэтому большинство людей предпочитают локальный подход. В отношении безопасности программного обеспечения ответ по умолчанию — нет: локальное приложение ИИ, получившее рейтинг CVSS 9.6 в марте 2026 года, может быть запущено для выполнения кода на хосте на основе потоковых данных самой модели, поскольку настольное приложение было упаковано с небезопасными настройками по умолчанию. Локальный подход означает, что ваши данные остаются на месте, и это не означает, что программное обеспечение защищено, поскольку в этой категории содержится много быстро меняющегося кода.
Что такое песочница для ИИ-агента, и нужна ли она мне для локального ИИ?
Песочница — это изолированная среда, обычно контейнер или легковесная виртуальная машина, где агент ИИ выполняет сгенерированные им команды и код, поэтому ошибка или вредоносная инструкция не могут повлиять на хост-систему. Она существует потому, что агенты делают больше, чем просто отвечают на вопросы: они выполняют команды оболочки, редактируют файлы и просматривают веб-страницы, и каждое из этих действий определяется результатами работы модели, которые можно изменять. Запуск модели локально никак не меняет эту математическую модель.
Песочница предназначена для изоляции действий агента, а не места расположения модели, и описанная выше уязвимость выполнения кода как раз это продемонстрировала в приложении, ориентированном на локальную среду. Некоторые инструменты на этой странице поставляются со встроенной песочницей, и те, которые запускают агентов с неограниченным доступом к хосту, заслуживают более тщательной проверки, прежде чем они будут использоваться на важных для вас машинах. По мере внедрения агентов в бизнес-среду, ожидайте, что песочница станет ключевой функцией, и мы начнем учитывать ее при оценке этих инструментов.
Может ли локальное оборудование запускать агентные рабочие нагрузки с десятками субагентов?
Это передовой рубеж, и если коротко, то на одной рабочей станции быстро заканчивается место. Многоагентные рабочие нагрузки порождают подагентов, каждый из которых имеет свой собственный контекст, а на стороне вывода каждый активный контекст означает собственный кэш ключ-значение в памяти, поэтому занимаемое пространство масштабируется как с параллелизмом, так и с размером модели. Куда деваются эти кэши, когда они превышают объем памяти, — это отдельная инженерная проблема; наш подробный анализ переноса кэша ключ-значение во флэш-память , реализованный на оборудовании Dell и Solidigm, является лучшим из опубликованных нами материалов по этой теме.
Машина, которая без проблем справляется с одной агентской сессией класса 30B, обычно может обрабатывать несколько параллельных сессий через пакетный сервер до того, как начнет ухудшаться задержка; десятки одновременно работающих подагентов — это уже территория сервера, при наличии достаточного объема памяти для хранения множества активных контекстов и механизма обслуживания, такого как vLLM, созданного для непрерывной пакетной обработки. Существует также предел качества, поскольку локальные модели уже теряют надежность по мере роста количества инструментов, а оркестрация увеличивает количество инструментов и передач данных.
Наша точка зрения заключается в том, что работа с одним или несколькими агентами сегодня является вполне законной задачей для рабочих станций, а работа с большими группами суб-агентов – это задача, требующая инфраструктуры. Эту границу, а также оборудование, необходимое для ее преодоления, мы планируем изучить гораздо подробнее.


 Amazon